从失败到可学习的世界:面向导航智能体的策略条件化环境生成 From Failures to Learnable Worlds: Policy-Conditioned Environment Generation for Navigation Agents
WEDGE 用智能体自身失败诊断指导生成针对性训练环境,闭环适应导航策略
前置知识
ObjectNav(目标物体导航)
具身 AI 标准任务:在未见过的室内场景中,给定目标物体类别 $g$,智能体从初始状态 $s_0$ 出发,边感知边导航直到找到目标并正确停止。以成功率(SR)和路径加权成功率(SPL)衡量。
WEDGE 的诊断、环境生成与策略适应全部围绕 ObjectNav 展开,论文所有实验指标(SR/SPL)都定义在该任务上。
ProcTHOR 与 HM3D
两个具身 AI 仿真平台/数据集。ProcTHOR 支持程序化生成房屋,可直接控制布局、物体摆放、起点等因子,因此被用作环境生成空间;HM3D 是 1000 个真实扫描场景,用于检验跨仿真器泛化。
理解'为什么在 ProcTHOR 做生成、在 HM3D 验证迁移'的实验设计,以及可控因子(重放目标/改布局)为何只在程序化仿真器里可行。
DD-PPO
去中心化分布式 PPO,是训练具身导航策略的主流强化学习算法,从数十亿帧经验中训练出接近完美的 PointNav 智能体,也被用于 ProcTHOR ObjectNav 训练。
三个被测智能体之一的 DD-PPO 策略代表'可用权重更新的 RL 适应'路线,其域内已 82.1% SR,用于检验框架能否发现高水平策略的残余弱点。
SPL(路径加权成功率)
Success weighted by Path Length:只有成功才计分,且按实际路径与最短路径之比打折,$SPL=\frac{1}{N}\sum_i S_i\frac{l_i}{\max(p_i,l_i)}$,同时奖励成功与路径效率。
论文主表同时报告 SR 和 SPL,需要理解 SPL 才能判断适应是否以'绕远路'为代价换取成功率。
无监督环境设计(UED)与课程学习
用学习者自身反馈自动生成、编辑或挑选训练任务/环境的方法族(如 PAIRED 的 regret-based 环境设计、优先级关卡重放),目标是让训练难度匹配智能体当前能力。
WEDGE 属于这一谱系,但以'可解释、统计验证的弱点特征'而非 regret 驱动生成,理解 UED 才能看清其定位与差异。
上下文学习(ICL)
对闭源大模型不做参数更新,而是在 prompt 中加入少量成功示例(worked examples),让模型在推理时模仿示例中的行为模式来完成新任务。
Gemini-3.8-flash 是无法访问权重的闭源 VLM,WEDGE 把弱点匹配的成功轨迹压缩成 worked example 加入导航 prompt 来'适应'它,验证框架与学习机制解耦。
研究动机
现有环境生成管线主要优化通用属性:一类追求真实感与多样性(如 Holodeck、SceneCraft 等生成逼真、多样的室内场景),一类做任务条件化生成(围绕"找到马克杯"这类任务描述构造场景)。但它们都是策略无关的:不考虑当前策略已经掌握了什么、还在哪里失败。对预训练智能体做持续训练时,同一环境可能对一个策略是冗余的(已掌握)、对另一个才有信息量、对第三个则过难而无法提供有效学习信号。论文用诊断数据量化了这种差异:同样是 ObjectNav 任务,DD-PPO 的主导弱点是目标可见性(强/弱区间成功率差 $\Delta=28.5$ 个百分点),而 Uni-NaVid 和 Gemini 的主导弱点都是盲走路径比例($\Delta$ 分别为 37.3 和 37.6 个百分点),失败原因截然不同。可见'更真实、更多、更难'的数据并不等于对特定智能体有用的数据。
本文的目标是本文要回答的核心问题是:如何为某个特定智能体生成恰好针对它尚未掌握之处的训练环境?具体目标分三层:(1) 自动发现给定策略在 ObjectNav 中可度量、可验证的失败条件(weakness),例如目标可见性、盲走路径比例、房间跳跃数;(2) 把这些弱点映射为仿真器中可控的环境因子(目标摆放、起点配置、场景布局),构造落在'弱区间'且难度适中的环境;(3) 用这些环境按各策略原本的学习机制做适应(RL 继续训练、LoRA 微调或上下文示例),并支持多轮'再诊断—再生成'迭代。同时验证这些在 ProcTHOR 中获得的提升能否零额外训练迁移到 HM3D 真实扫描场景。
与已有工作不同的是,独特之处在于把生成条件从'任务'换成'策略'。任务条件化生成(如 EnvGen)虽用 LLM 调整环境,但依赖任务级成败反馈,不区分同一任务内不同策略失败原因的差异;无监督环境设计(PAIRED 等)以 regret 为目标自动调难度,但课程不可解释,也无法直接对应'该改哪个环境因子'。WEDGE 则先用成败对比让 LLM 提出可执行的弱点特征(Python 函数),再用覆盖率、非冗余性、预测性、增量价值四条统计准则在完整诊断集上验证,从而把'策略为何失败'翻译成'该改哪个可控因子、改到什么数值区间'——这个从行为诊断到可操作生成规格的桥梁是此前工作缺失的。
核心方法
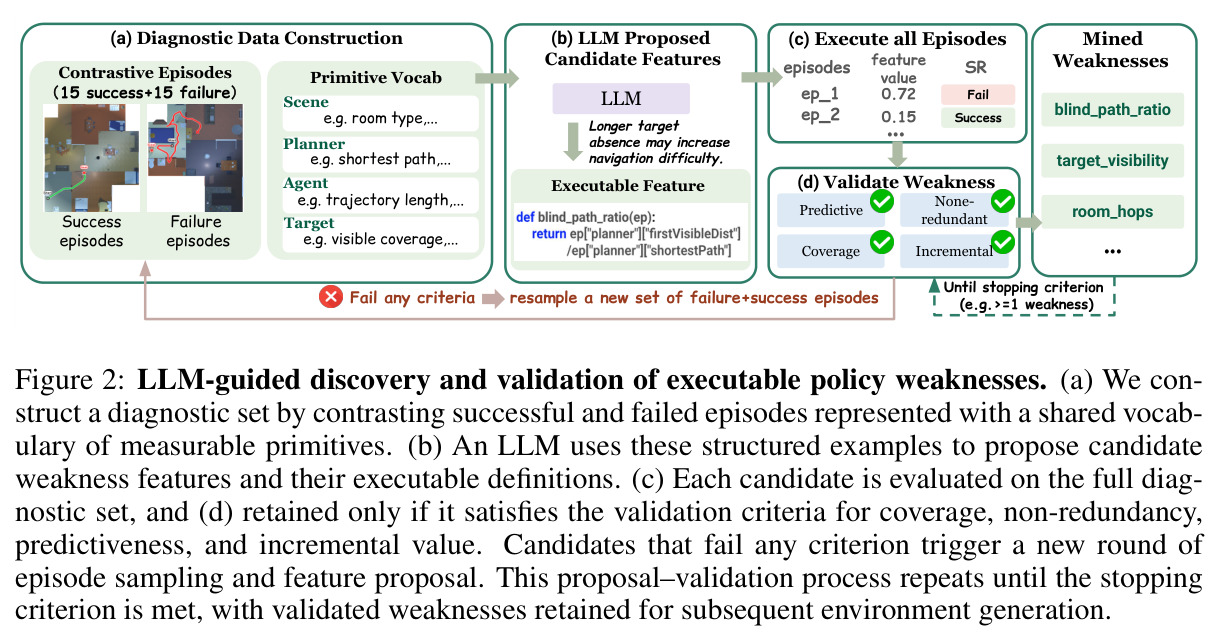
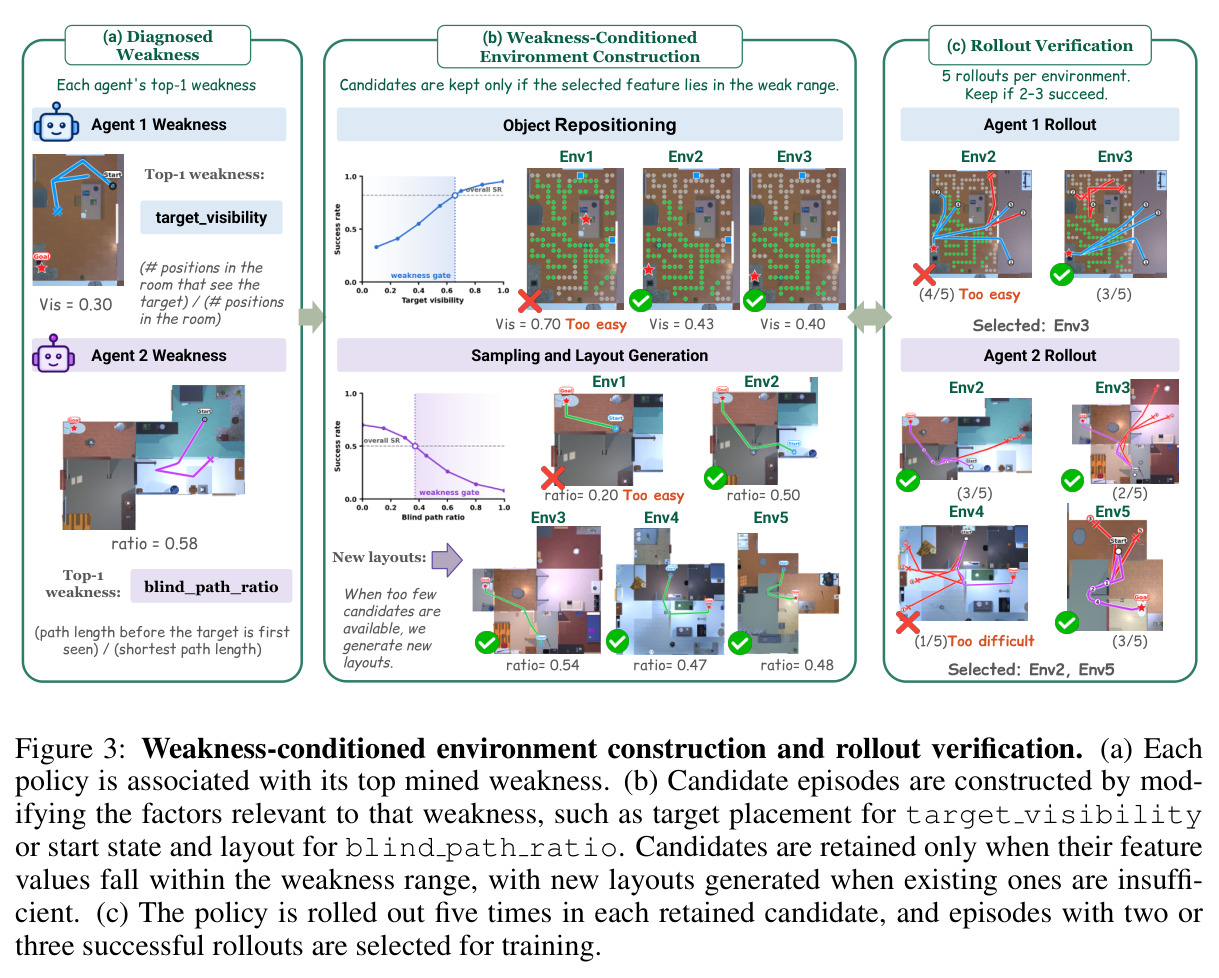
WEDGE(Weakness-guided Environment Design, Generation, and Evaluation)是'先诊断、再生成、后校准'的闭环。直觉上:与其盲目堆数据,不如先弄清策略在什么环境条件下失败,再专门造这样的环境,并保证它们处在策略'学得动'的难度范围内。技术路线分四步:(1) 在留出诊断集上执行冻结策略,收集 $(x_i,\tau_i,y_i)$,每轮采样 15 成功 + 15 失败构成对比集,用四组可测原语(场景/目标/路径/智能体)结构化表示;(2) 让 LLM(Gemini-2.5-Pro)提出候选弱点特征及其 Python 实现,在完整诊断集上按覆盖率 $\ge 0.95$、Spearman 相关 $|\rho_s|<0.85$、成功率差 $\Delta_f\ge 10$ 个百分点($p<0.05$)、五折 AUC 增量 $\ge 0.01$ 逐条验证,不过关则重采样再提案;(3) 取成功率差最大的弱点,用三个算子(重放目标、重采起点、生成新布局)构造候选环境,只保留特征值落入弱区间 $B_f$ 的候选;(4) 每个候选跑 5 次 rollout,保留成功 2–3 次的'难而可解'环境用于适应,之后重新诊断进入下一轮。
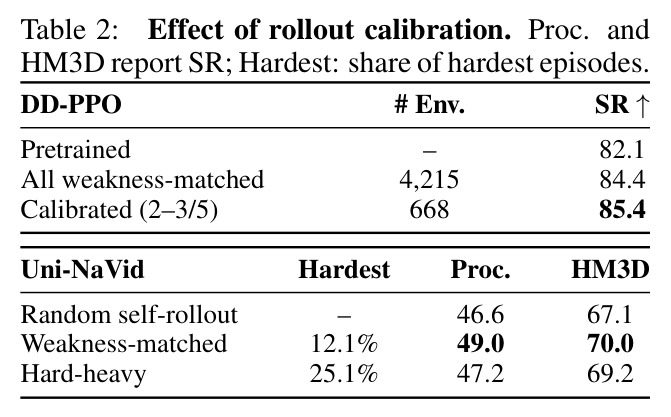
核心创新是'以策略自身失败模式为生成目标',以及连接诊断与生成的两个关键设计。其一是可执行弱点特征:LLM 不是笼统地说'策略怕复杂场景',而是输出能对单个 episode 计算的数值函数,例如盲走路径比例 = 目标首次可见前的路径长度 / 最短路径总长,既可被统计检验,又能直接映射到可控仿真因子;其二是 rollout 校准:只落在弱区间还不够,候选环境必须让策略 5 次尝试成功 2–3 次,同时过滤掉'已掌握'(无学习信号)和'完全不会'(无成功正样本)两个极端。与已有方法的本质区别:真实感/多样性管线以数据分布为中心,任务条件化生成以任务描述为中心,WEDGE 以'当前策略的学习边界'为中心——环境的价值被定义为对'这个'策略的可学性。
方法步骤详情
完整流程:(1) 诊断数据构建——在留出集执行冻结策略 $\pi$,记录 episode $x=(e,s_0,g)$、rollout $\tau$ 与成败 $y\in\{0,1\}$,每轮采 15+15 对比集,用原语词汇表(房屋面积、房间数、目标房可见覆盖率、最短路径长、房间跳跃数、首次可见前路径长、探索覆盖率等,见附录 Table 5)结构化表示;(2) 弱点提案——LLM 每次提 5 个候选特征,各配一个读 episode 字典、返回数值的 Python 函数;(3) 验证——依次检查覆盖率(可计算比例 $\ge 0.95$ 且非常数)、非冗余(与已保留特征 Spearman $|\rho_s|<0.85$)、预测性(底/顶三分位成功率差 $\Delta_f=|SR(L_f)-SR(H_f)|\ge 10$,70/30 划分外推验证,双比例 z 检验 $p<0.05$)、增量价值(五折交叉验证 AUC 提升 $\ge 0.01$);(4) 环境构造——按最弱特征依赖的因子选算子:目标可见性→房间内重放目标;盲走路径比例→重采起点或生成新布局;保留 $f(x')\in B_f$ 的候选,不足时生成新布局补充;(5) rollout 校准——每环境跑 5 次,保留 $2\le n_{succ}\le 3$ 者;(6) 策略适应——DD-PPO 混入原分布续训 10M 步;Uni-NaVid 用成功轨迹 LoRA 微调;Gemini 把成功轨迹压缩成 worked example 附进 prompt;(7) 再诊断循环,用更新后的策略重复步骤 (1)。
技术新颖性
技术新颖性体现在四点:(1) '假设-检验'式诊断范式:LLM 负责生成假设(含可执行代码),数据负责裁决,每个候选都要过覆盖率、非冗余、预测性、增量价值四道量化关卡,避免 LLM 幻觉直接进入生成环节,这比'LLM 直接调环境参数'的管线严谨得多;(2) 特征到算子的自动映射:弱点依赖哪些 episode 因子就调用哪个生成算子(重放目标/重采起点/新布局),使抽象的'失败原因'直接可操作;(3) 双重过滤(特征区间 $B_f$ + rollout 校准 $n_{succ}\in[2,3]$)对应课程学习中的'目标选择 + 难度匹配',但二者都以策略自身行为统计定义而非人工设定,且校准被证明只用 16% 的数据反而更好;(4) 框架与学习算法完全解耦:同一套诊断与生成流程同时支持 RL 续训、LoRA 微调、纯上下文适应三种异构机制,而弱点验证在 CPU 上完成、每智能体仅需约 10 次 LLM 调用,开销极低。
实验结果
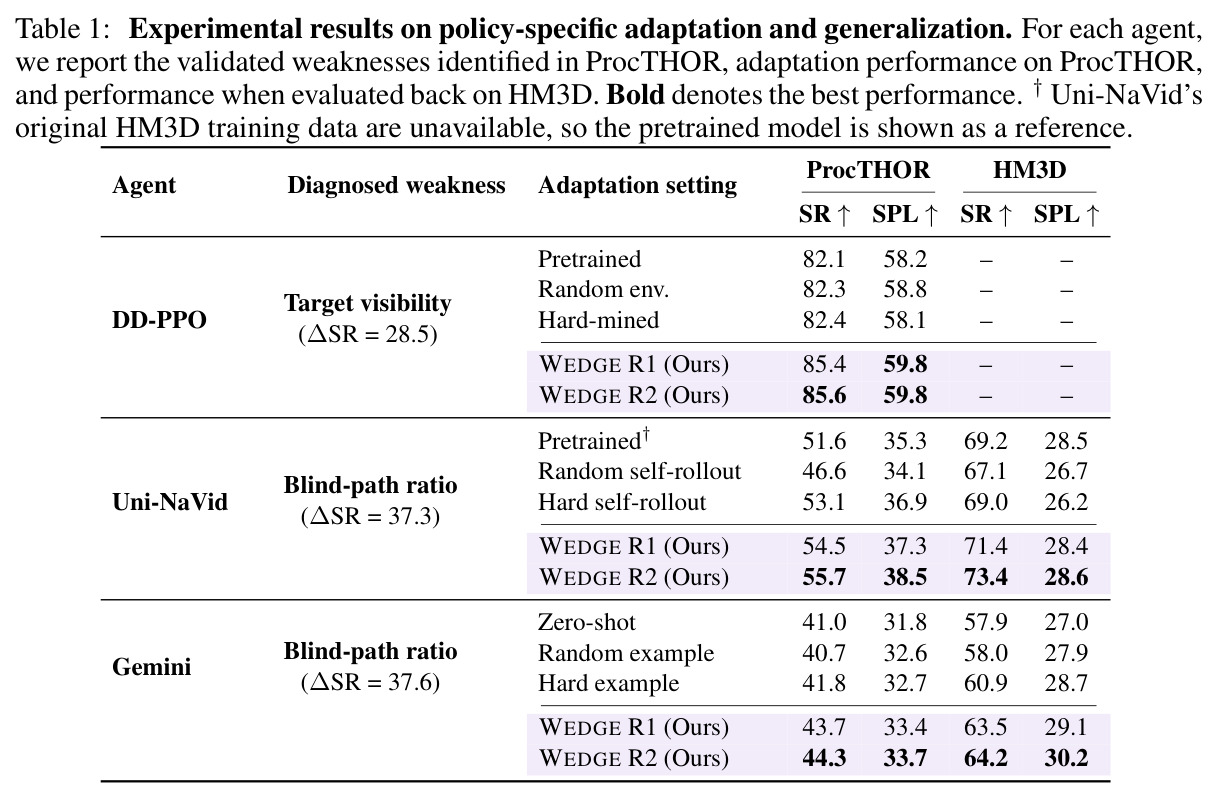
论文在三个异构智能体上系统验证 WEDGE。(1) 弱点画像因策略而异:DD-PPO 主导弱点是目标可见性($\Delta=28.5$),互补弱点为门口可见性($\downarrow 22.5$);Uni-NaVid 是盲走路径比例($\downarrow 37.3$),其次房间跳跃数($\downarrow 34.8$);Gemini 也是盲走路径比例($\downarrow 37.6$)。(2) ProcTHOR 域内适应全面胜出:DD-PPO 从 82.1 SR 提至 85.6(SPL 58.2→59.8),随机/难例环境几乎无提升(82.3/82.4);Uni-NaVid 从 51.6 SR 提至 55.7、SPL 35.3→38.5,而随机自滚出反而降到 46.6;Gemini 零样本 41.0→44.3 SR,优于随机示例 40.7 和难例 41.8。(3) 跨域迁移到 HM3D:Uni-NaVid 69.2→73.4 SR(难例基线仅 69.0,随机降到 67.1),SPL 持平 28.6 vs 28.5;Gemini 57.9→64.2 SR、SPL 27.0→30.2。(4) 消融分解增益:只挖已有 episode 49.2 SR、只靠生成 51.3、挖掘+生成 54.5;rollout 校准仅用 16% 的弱点匹配环境(668/4215)就反超全集(85.4 vs 84.4 SR)。(5) 再诊断揭示弱点演化:DD-PPO 与 Uni-NaVid 弱点保持不变(前者性能已饱和),Gemini 第一轮后主导弱点从盲走路径比例转为目标房间偏远度;增益集中于弱点区间——Gemini 长盲路径 +7.0 SR 而短路径仅 +0.6,DD-PPO 在小目标上提升最大(Bowl +13.0、Laptop +9.4、AlarmClock +8.1)。
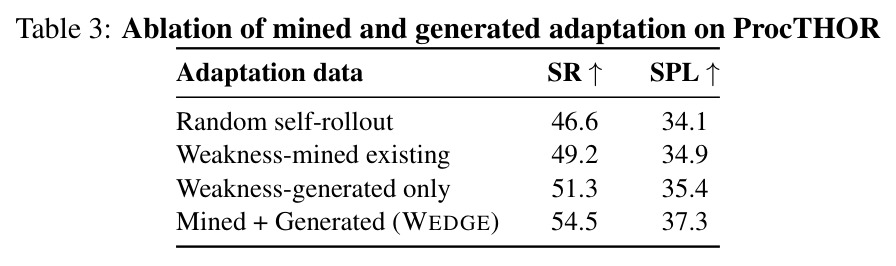
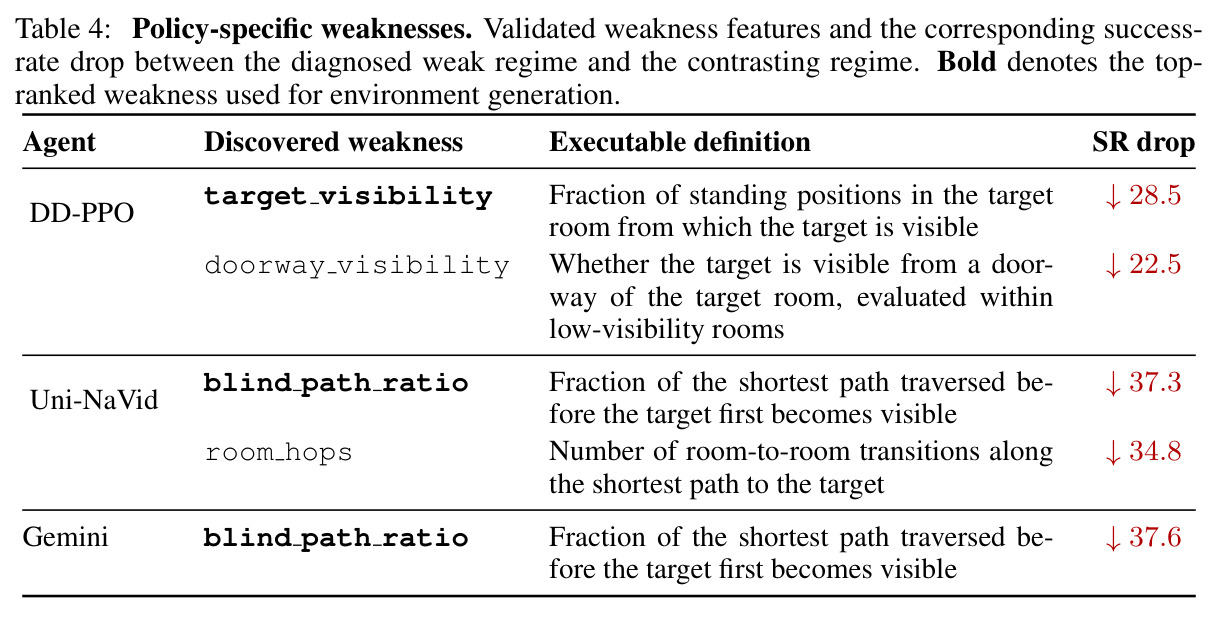
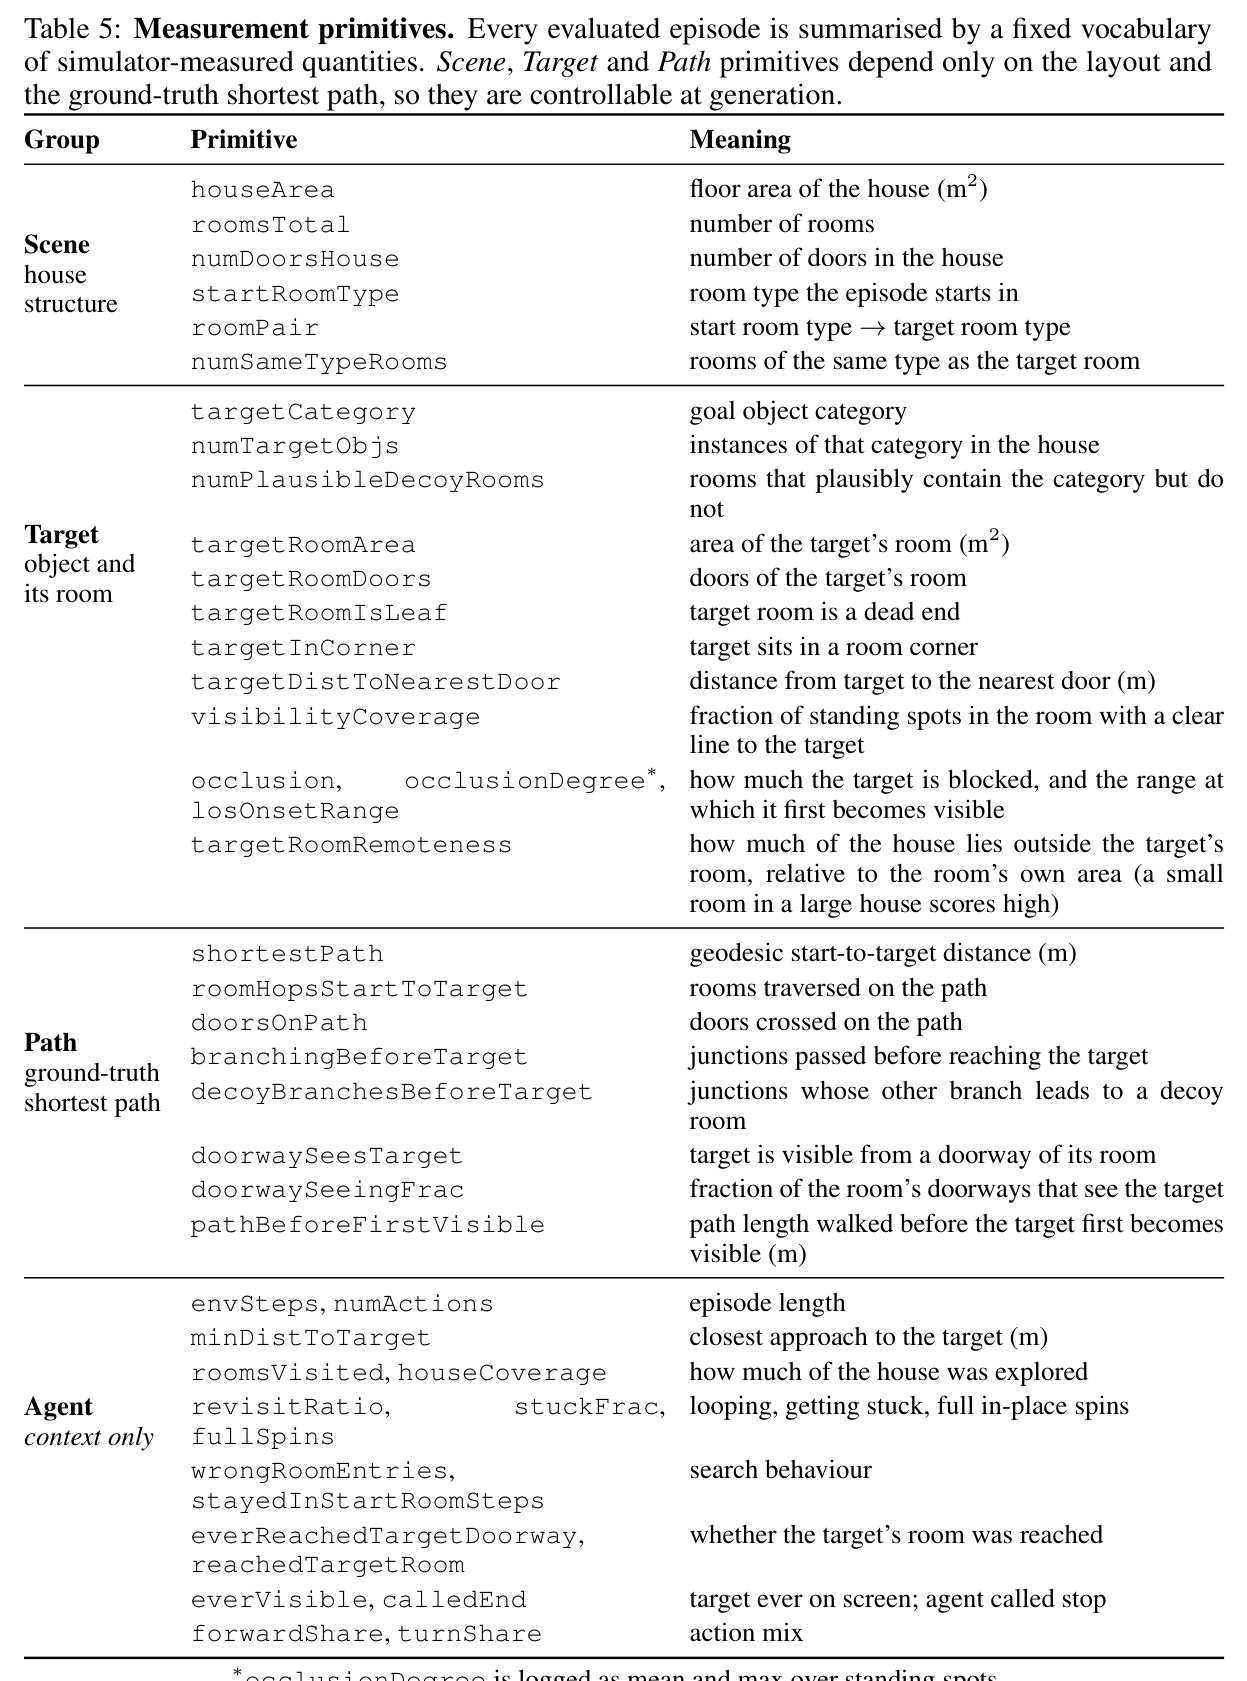
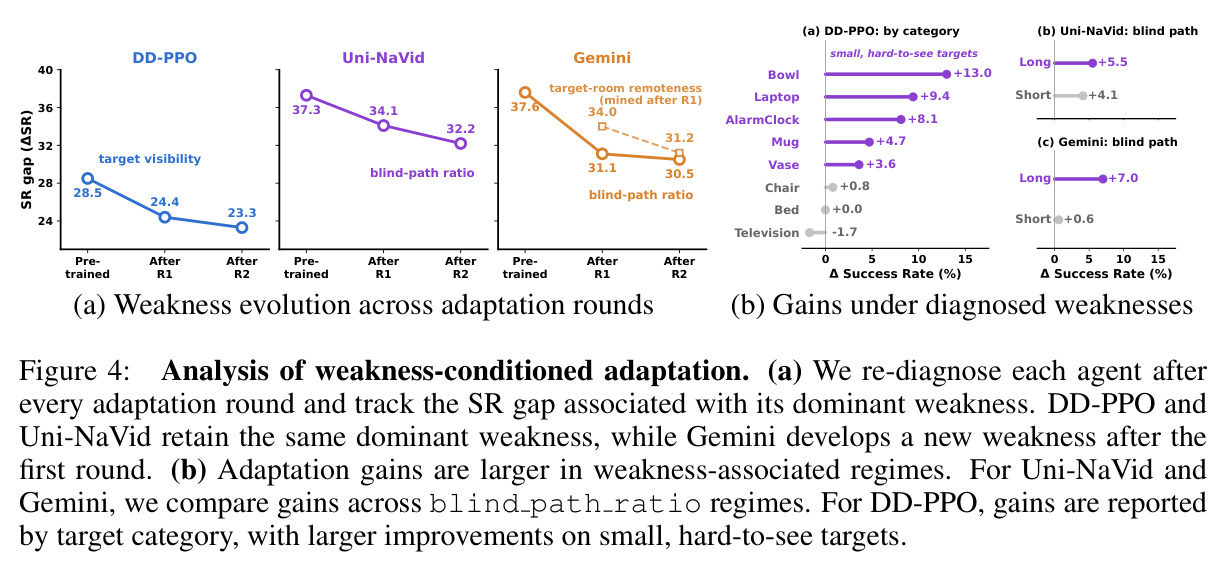
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DD-PPO ProcTHOR ObjectNav 域内适应 | SR / SPL | 85.6 / 59.8(WEDGE R2) | 预训练 82.1 / 58.2;随机环境 82.3 / 58.8;难例挖掘 82.4 / 58.1 | SR +3.5、SPL +1.6,远超两个匹配基线(均 +0.3 以内) |
| Uni-NaVid ProcTHOR 适应 | SR / SPL | 55.7 / 38.5(WEDGE R2) | 预训练 51.6 / 35.3;随机自滚出 46.6 / 34.1;难例自滚出 53.1 / 36.9 | SR +4.1、SPL +3.2,同时避免随机适应造成的 5 点 SR 退化 |
| Uni-NaVid HM3D 跨域评估 | SR / SPL | 73.4 / 28.6(R2) | 预训练 69.2 / 28.5;随机 67.1 / 26.7;难例 69.0 / 26.2 | SR +4.2 且 SPL 持平;难例基线完全不迁移 |
| Gemini-3.8-flash ProcTHOR 上下文适应 | SR / SPL | 44.3 / 33.7(R2) | 零样本 41.0 / 31.8;随机示例 40.7 / 32.6;难例 41.8 / 32.7 | SR +3.3、SPL +1.9 |
| Gemini HM3D 跨域评估 | SR / SPL | 64.2 / 30.2(R2) | 零样本 57.9 / 27.0;随机 58.0 / 27.9;难例 60.9 / 28.7 | SR +6.3、SPL +3.2,为最大跨域增益 |
局限与改进
作者承认的局限:仅在 ProcTHOR(诊断+生成)与 HM3D(跨域评估)的 ObjectNav 上验证,未涉及其他导航任务、仿真器与真实机器人;实现依赖可测量的仿真器原语与可控环境因子,真实扫描场景难以重放目标或改布局;每轮只针对排名第一的弱点以保证干预可解释,未协调多个互补弱点。我的补充观察:(1) DD-PPO 域内已 82.1 SR,第一轮后即饱和(85.4→85.6),弱点诊断对高水平策略的边际价值递减;(2) rollout 校准要求每个候选跑 5 次策略,是主要算力开销(DD-PPO 一轮约 1 GPU-天),且校准通过率仅 16%,生成仍有浪费;(3) 弱点特征依赖 ground-truth 最短路径与规划器信息(如盲走路径比例、房间跳跃数),真实部署无法获得这些量;(4) 每轮单弱点干预归因干净,但现实失败常是多因子耦合(小目标+多房间),单因子构造可能覆盖不到复合失败;(5) Gemini 适应仅用 1 条 worked example(从 64 条成功轨迹中选出),对该选择的敏感性未做充分消融;(6) LLM 提案质量依赖人工设计的原语词汇表,迁移到新仿真器需要重新设计原语。
独立分析的弱点
独立分析的弱点与改进方向:(1) 弱点稳定性缺少不确定性度量——诊断集 tercile 划分和 $\Delta_f$ 都是点估计,可用自助法重复诊断并报告置信区间,避免把采样噪声当成策略弱点;(2) 弱区间 $B_f$ 由诊断集估计,策略更新后区间会漂移,但框架要到下一轮才重新诊断,可改为在线滑动窗口更新区间;(3) 单弱点干预难以处理复合失败,可扩展为多因子联合构造与多弱点配比调度(如按各弱点 $\Delta_f$ 加权混合训练批次);(4) 三个算子(重放目标/重采起点/新布局)表达能力有限,无法改变材质、光照、家具语义混淆等因素,可引入纹理/光照扰动与资产替换算子以覆盖感知类弱点;(5) 闭源 VLM 的 prompt 级适应受上下文长度与示例检索质量限制,可结合示例库检索或把成功轨迹蒸馏成规则/权重;(6) 校准的 5 次 rollout 阈值 $[2,3]$ 是硬编码的超参,不同策略的最优难度窗口可能不同,可用自适应成功率为目标做在线调参。
未来方向
作者提出的方向:扩展到更多导航任务(如 VLN、移动操作)、更多仿真器与真实世界场景;摆脱对可测仿真原语和可控因子的依赖(例如在固定真实扫描上只做目标重放与起点采样);协调一轮内多个互补弱点的生成。基于本文成果可延伸的:(1) 与 regret-based UED 结合,用可解释弱点约束 regret 优化,兼顾可读性与自动难度调节;(2) 多策略共享弱点库,区分'共性弱点'与'个性弱点',摊薄生成与 rollout 成本;(3) 把弱点特征发展为评估基准的诊断维度,为社区提供'策略失败画像'工具;(4) 用视觉基础模型从 RGB 观测直接估计可见性、遮挡等特征,摆脱对仿真器状态信息的依赖,迈向 sim2real 闭环;(5) 把弱区间作为内在奖励或优先回放准则融入 RL 探索;(6) 研究时序性弱点(如'某类转弯后迷路')的发现与验证,需要超越标量特征的结构化/时序统计量。
复现评估
复现评估:代码已开源(github.com/zhangyuejoslin/WEDGE),项目主页 zhangyuejoslin.github.io/WEDGE。ProcTHOR 与 HM3D 均公开可得;弱点提案提示词在附录 A.3 完整给出,原语词汇表在 Table 5 全部列出,验证阈值明确($\tau_{cov}=0.95$、$\tau_\rho=0.85$、$\tau_\Delta=10$、$\tau_{AUC}=0.01$),细节对复现非常友好。算力方面:弱点发现在 CPU 上完成、每智能体约 10 次 LLM 调用;一轮完整适应 DD-PPO 约 1 GPU-天(续训 10M 步)、Uni-NaVid 约 2 GPU-天(LoRA)、Gemini 约半天加 110 美元 API 费。注意 Uni-NaVid 的原始 HM3D 训练数据不可得,只能按论文的 ProcTHOR 适应路线复现;Gemini 路线依赖闭源 API(3.8-flash 执行、2.5-Pro 提案),最便宜但受模型版本变动影响。总体难度中等偏上:RL 路线需要多 GPU 跑大规模 ProcTHOR 渲染,Gemini 路线适合低成本验证核心思想。
论文图表
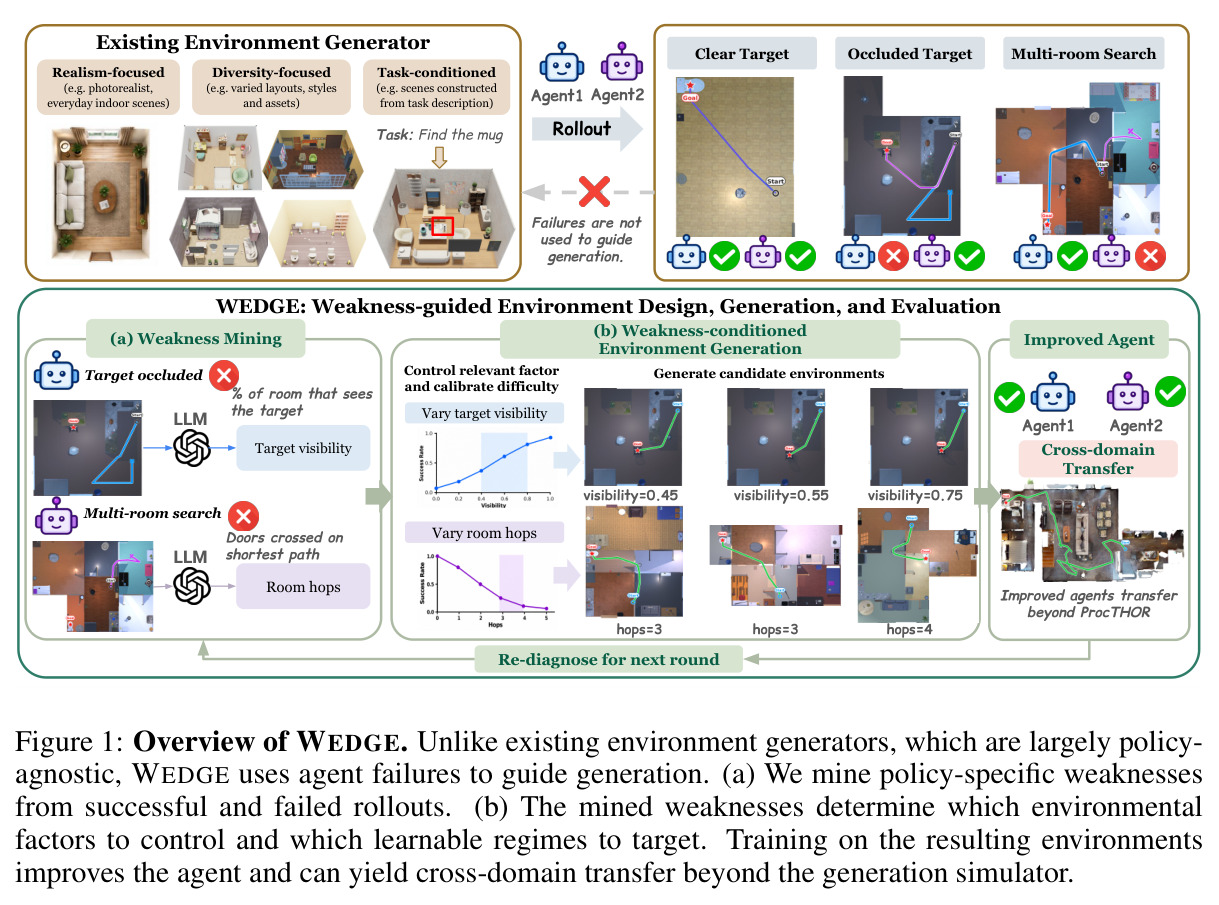
上半部分对比现有环境生成器(真实感导向、多样性导向、任务条件化)——它们都是策略无关的,失败信息未被用于指导生成;下半部分展示 WEDGE 的两阶段闭环:(a) 弱点挖掘,从成败 rollout 对比中发现'目标被遮挡'或'需跨多房间搜索'等策略特异弱点,并确定要控制的环境因子(目标可见性、房间跳跃数);(b) 弱点条件化环境生成,在弱区间内产生候选环境(visibility=0.45/0.55/0.75,hops=3/3/4),训练后提升智能体并可实现跨仿真器迁移,之后重新诊断进入下一轮。
一图看懂论文动机与整体框架,直观呈现'从失败到可学习世界'的核心思想,以及与现有策略无关生成器的本质区别,是理解全文的入口。