Fish Audio Drama 3:面向可导演表演的开源语音生成模型 Fish Audio Drama 3 Technical Report
35B MoE 语音模型统一导戏、改戏、配音、编辑与流式合成,仅用单一人类偏好奖励对齐
前置知识
RVQ 音频 tokenizer 与语义/残差码本
把波形离散成 token 的编解码器。Drama 3 沿用 S2 的 DAC 系 tokenizer:44.1 kHz 音频每帧编成 10 个码本;码本 0 是语义码(映射进 Qwen3.5 词表的 4,096 个语义 token),码本 1–9 是逐级叠加声学细节的残差 RVQ 码。
全文的架构设计(部分码本融合、码本-MTP 解码器沿码本轴堆叠)与损失函数都围绕'每帧 10 个码本'这一结构展开,不理解它就无法理解模型如何表示和生成音频。
混合专家(MoE)
把前馈网络换成多个并列的'专家'网络,由路由器为每个 token 只选少数专家计算。Drama 3 每层 MoE 有 256 个专家,每 token 路由到 8 个,外加一个所有 token 共享的专家;35B 总参数中每 token 仅激活约 3B,以稀疏性同时换取容量与速度。
解释了 35B 模型为何能高速解码:推理引擎把专家存成块缩放 FP8(每参数 1 字节),且与 RL rollout 共用同一数值格式,是效率章节与部署方案的关键。
Gated DeltaNet 与线性注意力
线性注意力用固定大小的循环状态替代随上下文增长的 KV 缓存,Gated DeltaNet 是其门控 delta 规则变体,以常数状态携带历史。Drama 3 骨干按 3:1 混合 Gated DeltaNet 层与门控全注意力层:每 4 层仅 1 层保留 KV 缓存,其余靠常数状态压缩历史。
这是适配长导演会话(参考与历史 take 累积数千音频 token)的骨干基础,也是推理引擎大量核融合优化(Gated DeltaNet decode/prefill)的作用对象。
多 token 预测(MTP)与码本-MTP 解码器
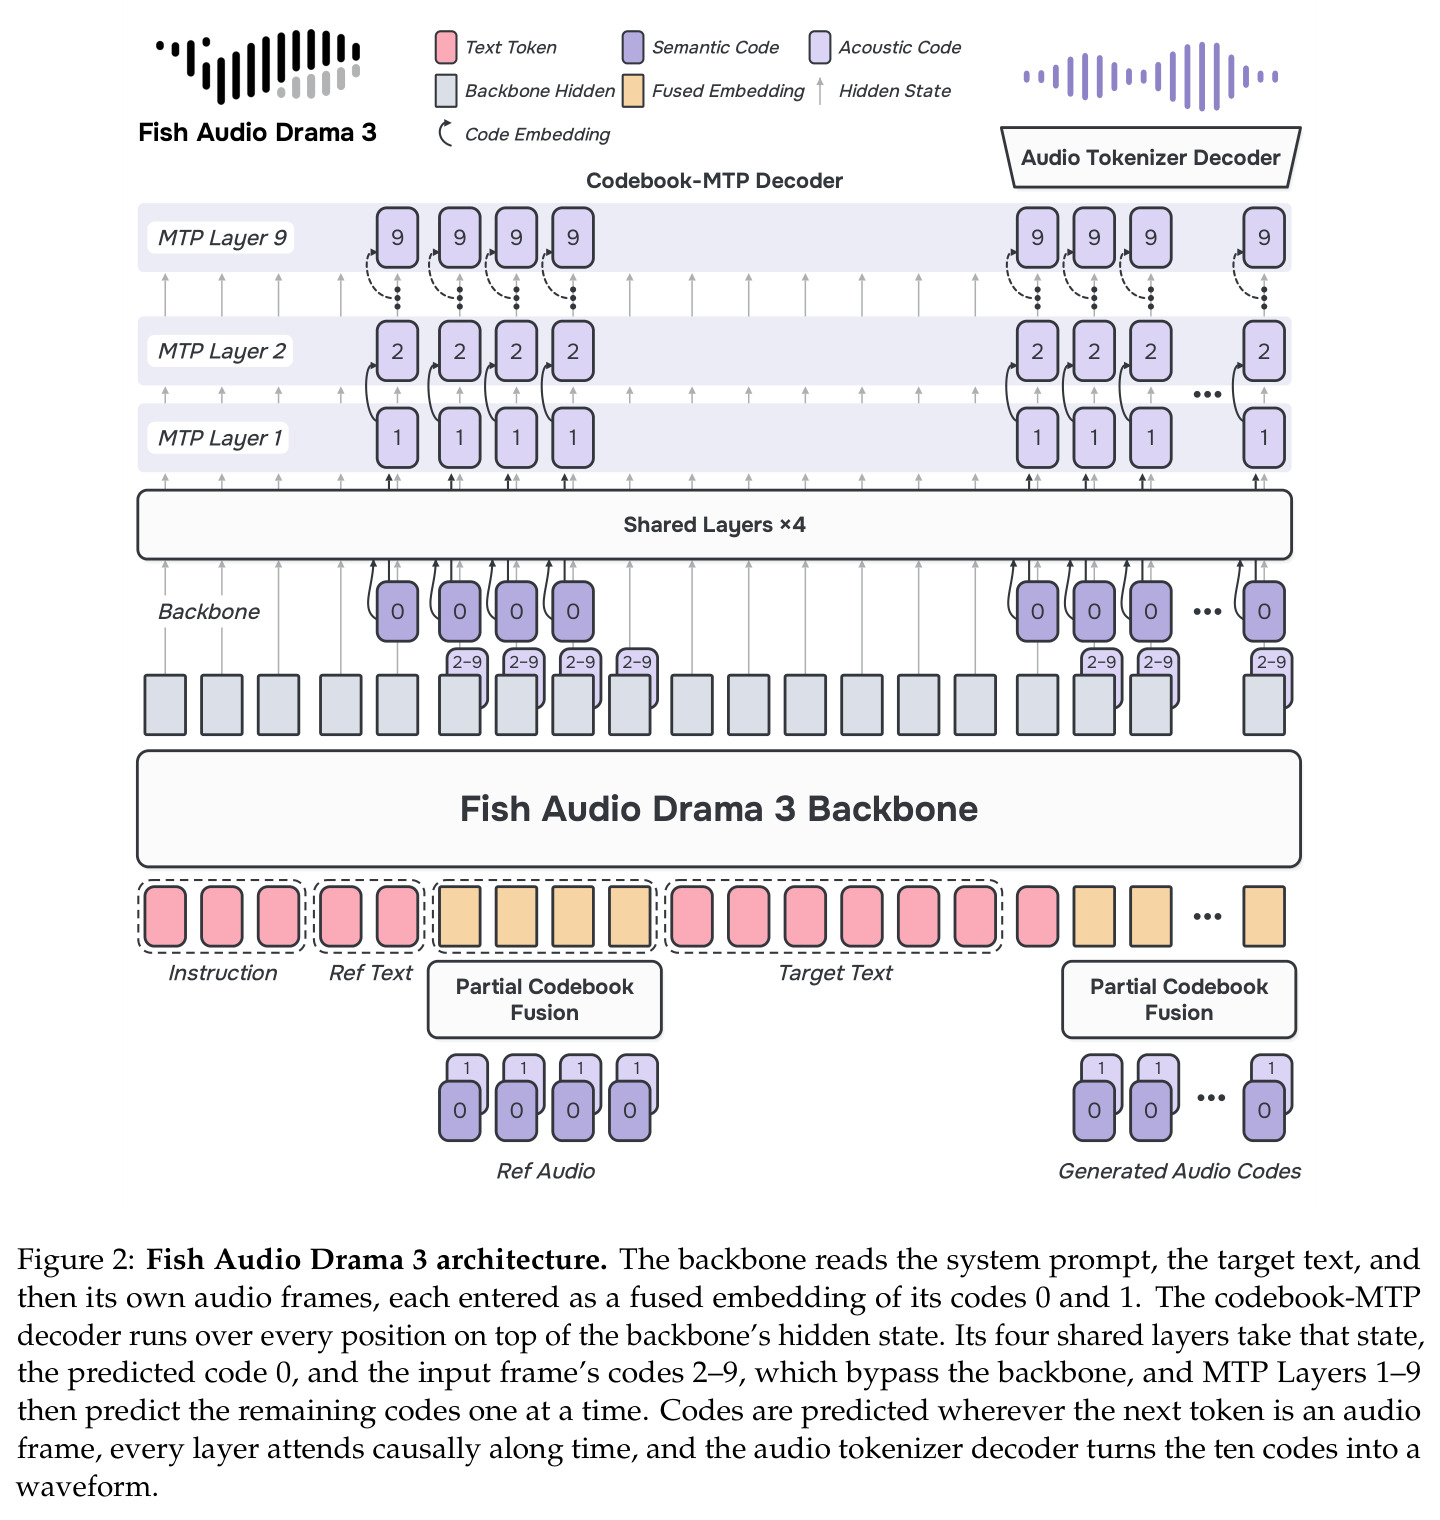
MTP 指一次前向同时预测多个未来 token(如 DeepSeek-V3 的浅层模块)。Drama 3 把该思想搬到码本轴:13 层解码器(4 共享 + 9 逐码本)沿码本轴堆叠,每层注入上一层刚选出的码并输出下一码,同时沿时间对整个序列做因果注意力,隐状态逐层向上传递。
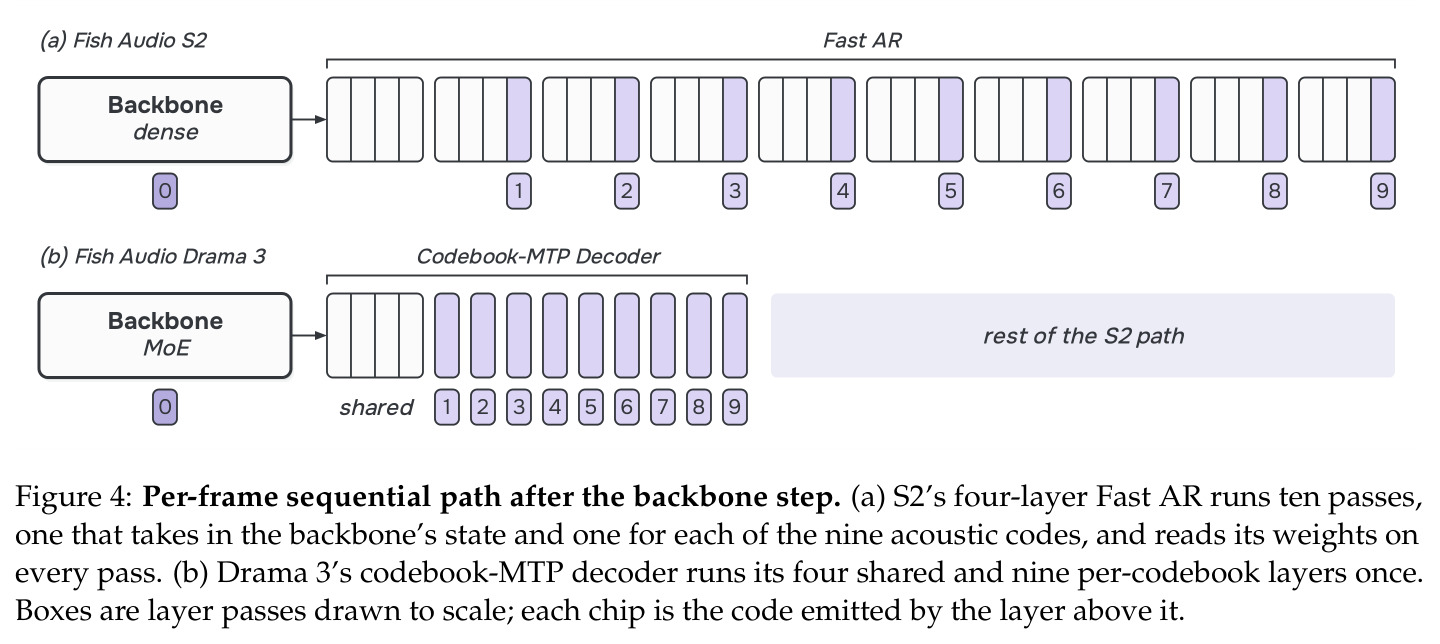
码本-MTP 解码器是本文最核心的架构创新,直接替代 S2 的 Fast AR 模块,是理解音质、克隆与推理速度提升的钥匙。
GRPO 与基于人类偏好的强化学习
GRPO 对每个 prompt 采样一组答案,用组内奖励的相对优势替代价值网络来更新策略。本文配套训练一个以 Bradley–Terry 损失拟合人类成对偏好的奖励模型,把原始分数经冻结锚标准化、截断到 $[-3,3]$ 后转成组内期望胜率作为奖励,且不使用 KL 惩罚。
第 3.3 与 5.2 节是论文训练与论证的重心:'删除全部规则奖励、只用单一偏好奖励'这一反常规设计的合理性问题,要靠这套机制与 Expresso 消融实验来支撑。
CUDA Graph、核启动开销与 Prefill–Decode 分离
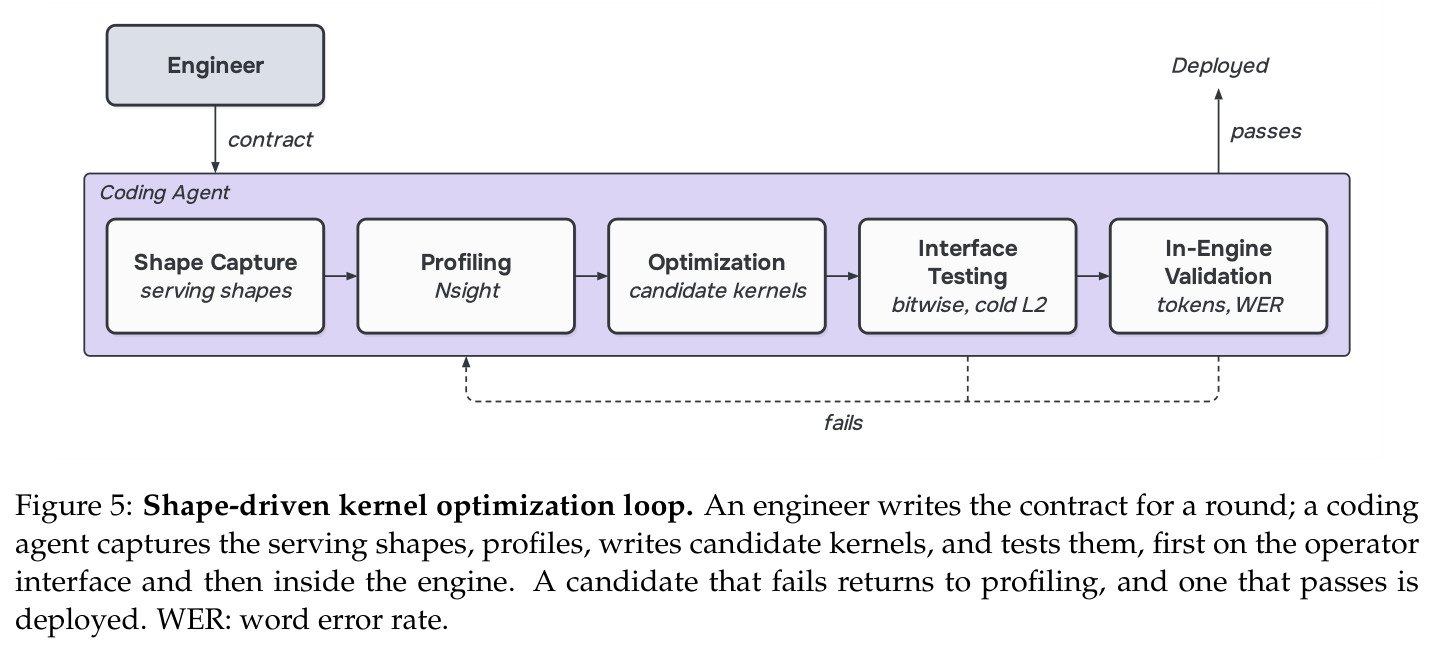
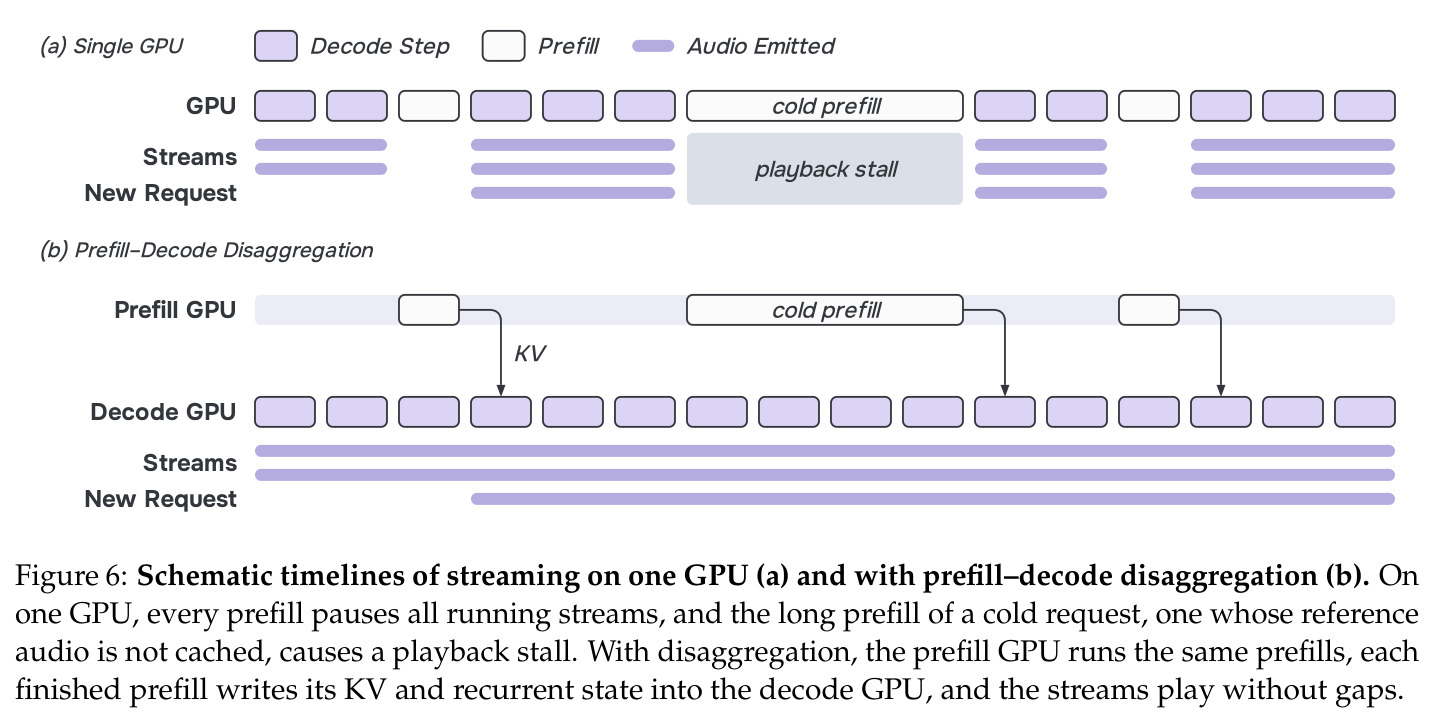
GPU 上每个 kernel 启动有固定成本;CUDA Graph 把整步录制后重放,消除主机逐个发核的开销,但对已图表化的小批量解码,剩余瓶颈是'几乎不搬数据却耗时的辅助核'。Prefill–Decode 分离把 prefill 与逐帧解码放到不同 GPU,新请求不再让正在播放的流停顿。
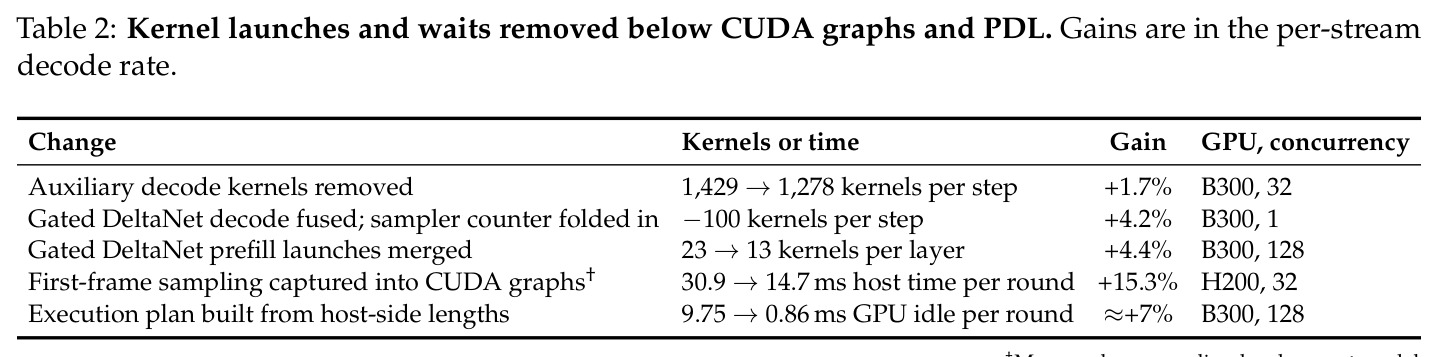
第 4 章解释了'271 帧/秒从哪里来',是理解这类模型级系统论文方法论(核普查、A/B 验证、负载建模)的必经之路。
研究动机
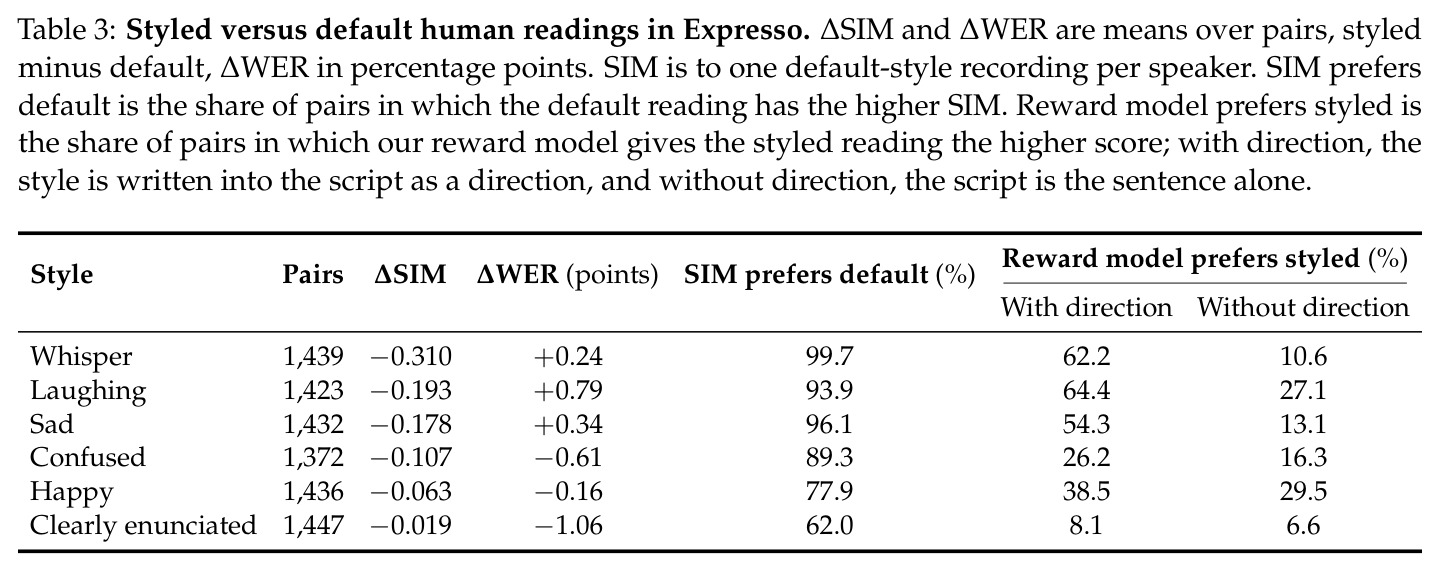
语音合成的驱动力正从'读准文本'转向'表演'。有声书、广播剧、影视游戏配音、互动角色等应用要求模型按导演意图交付台词:怎么念要用自然语言描述、多次试录后迭代打磨、放进多角色场景与其他角色配合、个别词念错时只修那一处。上一代 Fish Audio S2 已支持行内指令与多说话人,但遗留四个硬伤。其一,架构不适配长导演会话:参考音频与历史 take 累积数千个音频 token,S2 的全注意力骨干必须全部看见,而其逐帧 Fast AR 模块只能通过单个骨干状态间接感知参考音频,音色等细节在传递中丢失。其二,控制是一次性的:指令只塑造一次生成,无法对已生成的 take 在下一轮给意见重录。其三,生成全有或全无:长 take 里改一个词就得整段重生成,其余音频全变。其四,后训练优化的是代理指标:现有 TTS 强化学习普遍奖励低词错率(WER)和高说话人相似度(SIM),而富有表现力的表演恰恰合法地偏离两者——论文以 Expresso 数据量化:带笑声的朗读使 WER 上升 0.79 个百分点,耳语使 SIM 降低 0.310,相似度奖励在 62.0%–99.7% 的配对中偏好平淡的默认读法。
本文的目标是本文的目标是构建一个围绕'可导演表演'(directed performance)的开源语音生成模型 Fish Audio Drama 3,把导演工作流完整搬进一个模型:从一条或多条参考片段为角色定音色;跟随点标签([laughs])、范围标签(...)、风格前缀和自由发挥的导演意见等自然语言指导;当 take 不合意时,在下一轮给出'[softer and warmer versus previous]'式的相对意见即可多轮改戏,且历史 take 保留在上下文中;为多角色场景一次性配音,同一音色可跨语言说话;对已有录音做局部填空编辑,只重生成出错窗口、保留周围音频;支持逐句和流式的长音频合成,文本边到边说。工程上还要求单卡解码速度远超 21.5 帧/秒的播放速率以支撑流式服务,并公开全部权重,降低表现力语音生成的研究与应用门槛。
与已有工作不同的是,本文的独特之处在于把'任务多样性、架构、训练目标'三者围绕同一 token 流重新设计。任务上,克隆、导戏、多轮改戏、场景配音、填空编辑、流式合成全部写成同一种 ChatML 式对话,损失只覆盖助手轮——不需要为每个任务单独建模或加适配器。架构上,作者没有沿用'帧内小深度 transformer'这一主流路线(S2 的 Fast AR 即属此类),而是把 DeepSeek-V3 式 MTP 的'层沿深度堆叠、隐状态向上传递'搬到码本轴:九个声学码本各配一个全宽度层,所有层沿时间对整个序列做因果注意力,参考音频的细粒度声学码直接进入每一层。训练目标上,作者大胆删除全部规则奖励(WER 奖励、说话人相似度、音质模型),只用一个在'校准锚定、有界截断'分数下运行的学习型人类偏好奖励模型,让奖励作弊保持可观测;并以'大批次、少步数、无 KL 惩罚'的 GRPO 稳定对齐。系统上,RL rollout 与线上服务共用同一套 FP8 专家数值,训练与部署一体化设计。
核心方法
直觉:导演需要'看得见全剧的演员',因此每个声学码的预测都直接关注整个序列,而非经一个压缩状态。技术上,模型沿用 S2 的音频 tokenizer(每帧 10 个码本、约 21.5 帧/秒,码 0 为语义码,其余为逐级加细的残差 RVQ 码),骨干从 Qwen3.5-35B-A3B 初始化:40 层混合结构按 3:1 堆叠 Gated DeltaNet 线性注意力层与门控全注意力层,仅 1/4 层保留 KV 缓存;每层 FFN 均为 MoE,每 token 路由到 256 个专家中的 8 个外加共享专家,35B 总参数仅激活约 3B。无音频编码器,参考音频只以 token 进入。骨干在每个音频帧位置预测下一帧语义码 $q^{(0)}_{t+1}$,13 层码本-MTP 解码器(4 共享层 + 9 逐码本层)在同一位置补齐九个声学码;反馈给骨干的只有码 0/1 的融合嵌入 $x_t=\frac{1}{\sqrt{2}}(E_{LM}[s(q^{(0)}_t)]+E^{(1)}[q^{(1)}_t])$,码 2–9 绕过骨干、直接注入解码器第一共享层,以抑制 exposure bias。
核心创新是码本-MTP 解码器对'码本轴'的处理方式。编解码语言模型历来三种做法:在主流中延迟/展平码本;帧内放一个小的深度 transformer(VALL-E、S2 Fast AR);或对每个码本阶段各跑一个全序列模型。Drama 3 属第三类但合成为单个解码器:四个共享层把骨干末层隐状态、被补全帧的语义码嵌入、以及骨干从未见过的输入帧码 2–9 之和熔成一个表示,随后九个逐码本层依次注入上一层刚选出的码 $e^{(4+k)}_t=E_c^{(k)}[q^{(k-1)}_{t+1}]$、输出下一码 $q^{(k)}_{t+1}$。与 Fast AR 的本质区别有三:上下文上,每层都沿时间因果关注整个序列(含参考音频全部十个码本),参考音色等细节直达每个码本预测,而非只经一个投影状态;训练上,它直接跑在骨干自己的序列上,复用 RoPE 与注意力掩码,一次额外因果过即并行训练所有帧的所有码本;容量上,每个码本独享全宽度层、嵌入表、输出头与贯穿全序列的 KV 缓存。第二项创新是后训练只用一个学习型偏好奖励,其校准锚定、截断于 $[-3,3]$ 的分数让整批漂移保持可见,天然抑制奖励作弊。
方法步骤详情
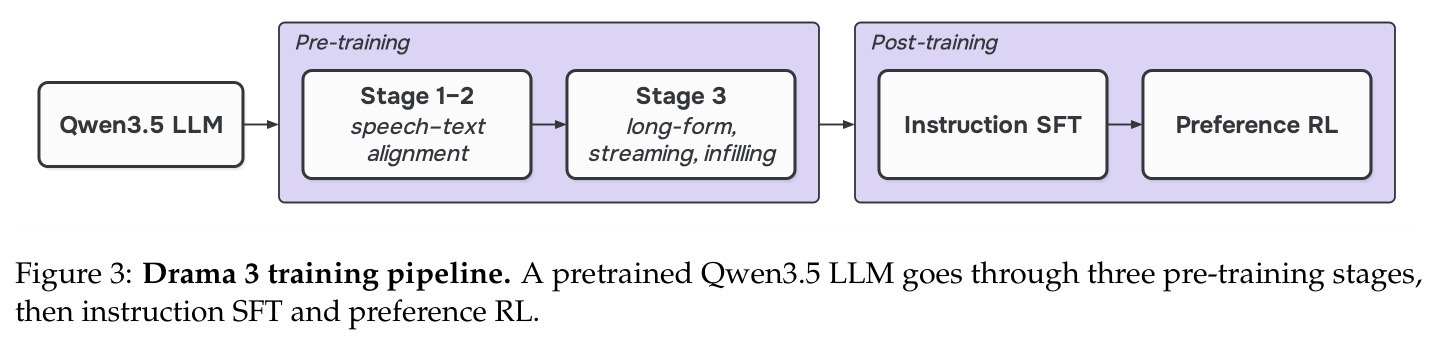
①预训练:阶段 1–2 用 8K 序列(文本文档、多轮 TTS 对话;指令/参考在系统轮、文本在用户轮、音频在助手轮,损失只算助手轮),数百 B token、80 语种,阶段 2 批次翻倍;阶段 3 升 16K,加长合成/流式/填空,打包 128K 行,Muon 优化器;损失 $\mathcal{L}=\mathcal{L}_{text}+0.5\mathcal{L}_{sem}+0.5\mathcal{L}_{cb}$ 桶内均值。②SFT:32K 序列、[Reference N] 参考块,教点/范围标签、风格前缀、导演意见、多轮改戏与多说话人配音;配方按留出语音 NLL 挑选。③奖励模型:同架构更小语音 LM(训至阶段 2)加标量头,Bradley–Terry 损失拟合人类偏好。④GRPO:每 prompt 温度 1 采 8 条,RM 分数经冻结锚标准化截断 $[-3,3]$ 转组内胜率;无 KL,<0.05 标准差组丢弃,$\epsilon_{low}=0.2$、$\epsilon_{high}=0.28$;每步 1,536 prompt,恒定学习率、无权重衰减、短日程,解码器冻结。
技术新颖性
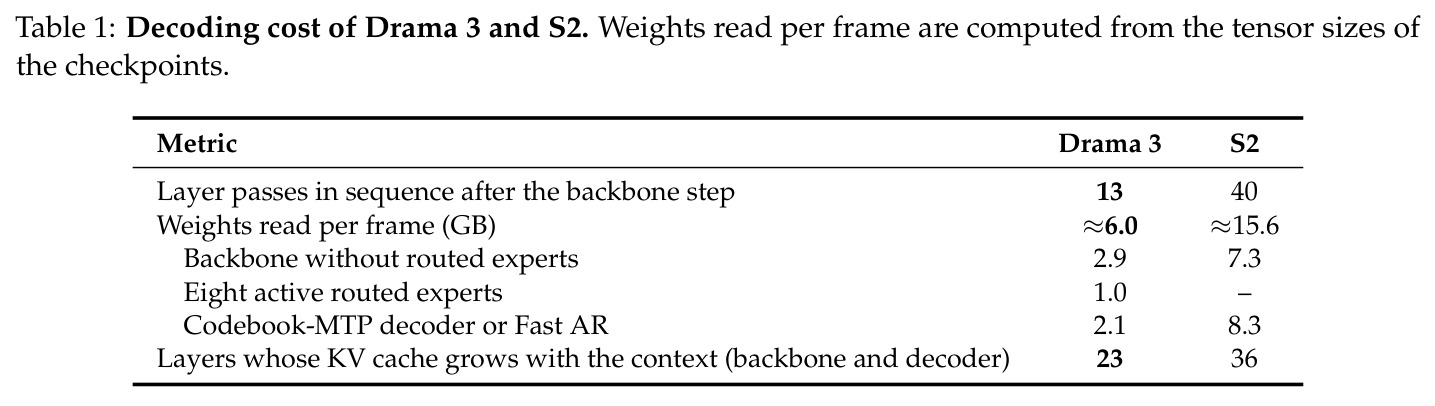
与已有工作的本质差异有三层。架构层:在 codec-LM 处理码本轴的三类做法中(主流内延迟/展平;帧内小深度 transformer;每码本各跑全序列模型),本文的码本-MTP 是第三类中首个把逐码本层做成全宽度、沿时间对骨干自身序列做因果注意力、并像 DeepSeek-V3 的 MTP 模块那样向上传递隐状态的单一解码器;其训练布局直接复用骨干的 RoPE 与掩码,一次额外因果过并行训练所有帧的全部码本,而 Fast AR 需单独的逐帧码本序列;每个码本独享嵌入、层、输出头与贯穿全序列的 KV 缓存(KV 层总数 23 对 S2 的 36 反而更少)。训练层:部分码本融合(只反馈码 0/1)在保留粗粒度声学视野的同时抑制 exposure bias;删光规则奖励、只用单一校准偏好奖励,是对'TTS RL = WER 奖励 + SIM 奖励'惯例的反常规设计,并以大批次少步数日程规避奖励过优化。系统层:RL rollout 与线上服务共用同一块缩放 FP8 专家数值;核优化以同机 A/B 实测为准,甚至否决了'单测更快'的融合核(14.5µs 对被替换核的 7.5µs)。
实验结果
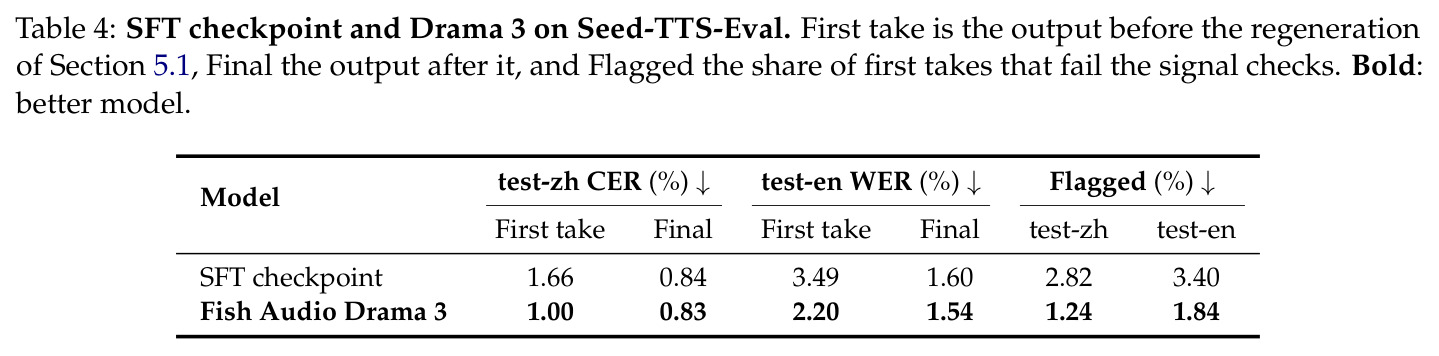
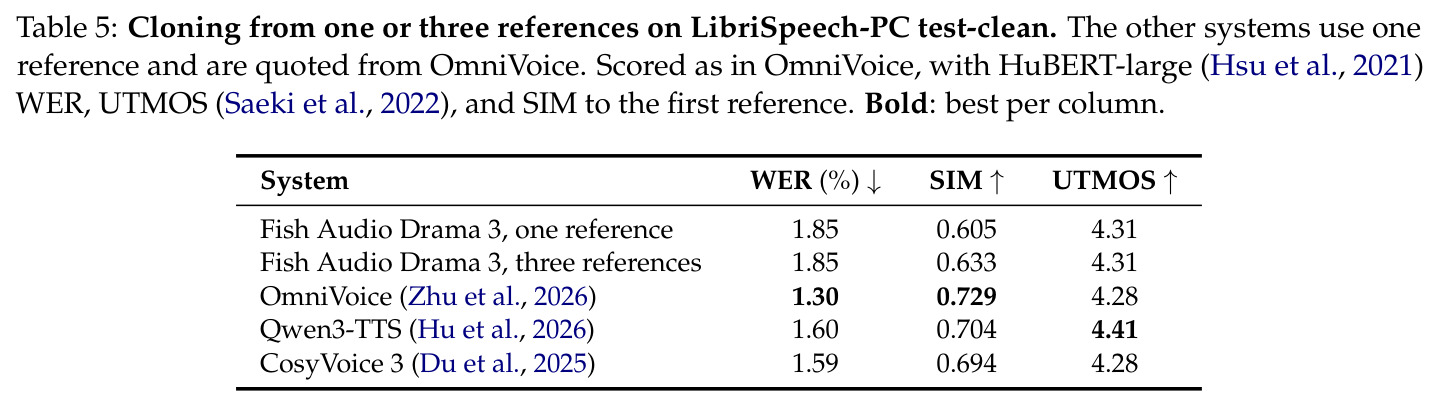
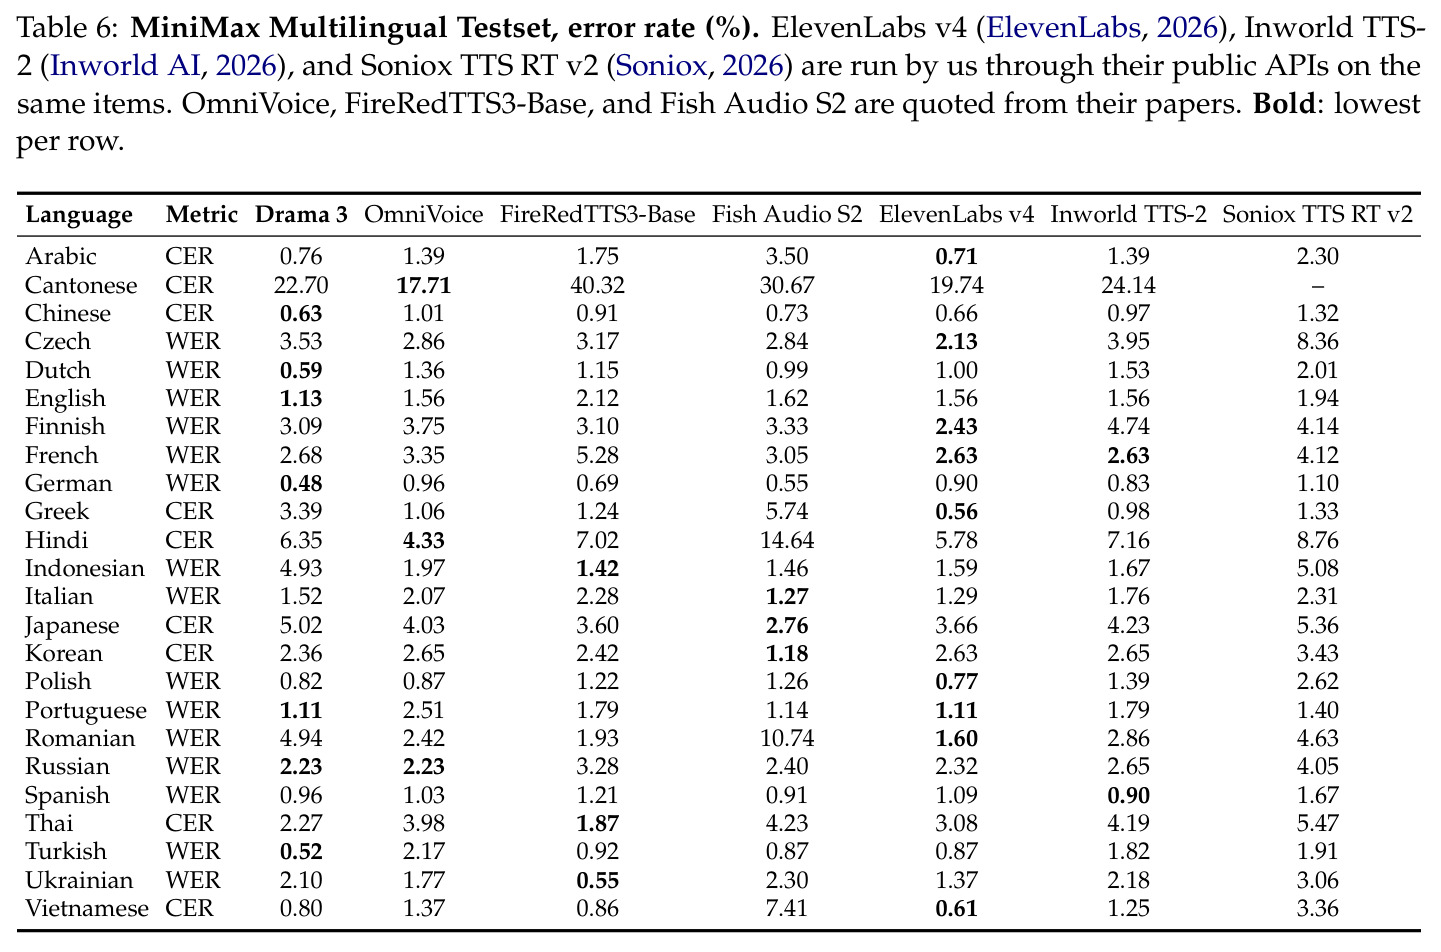
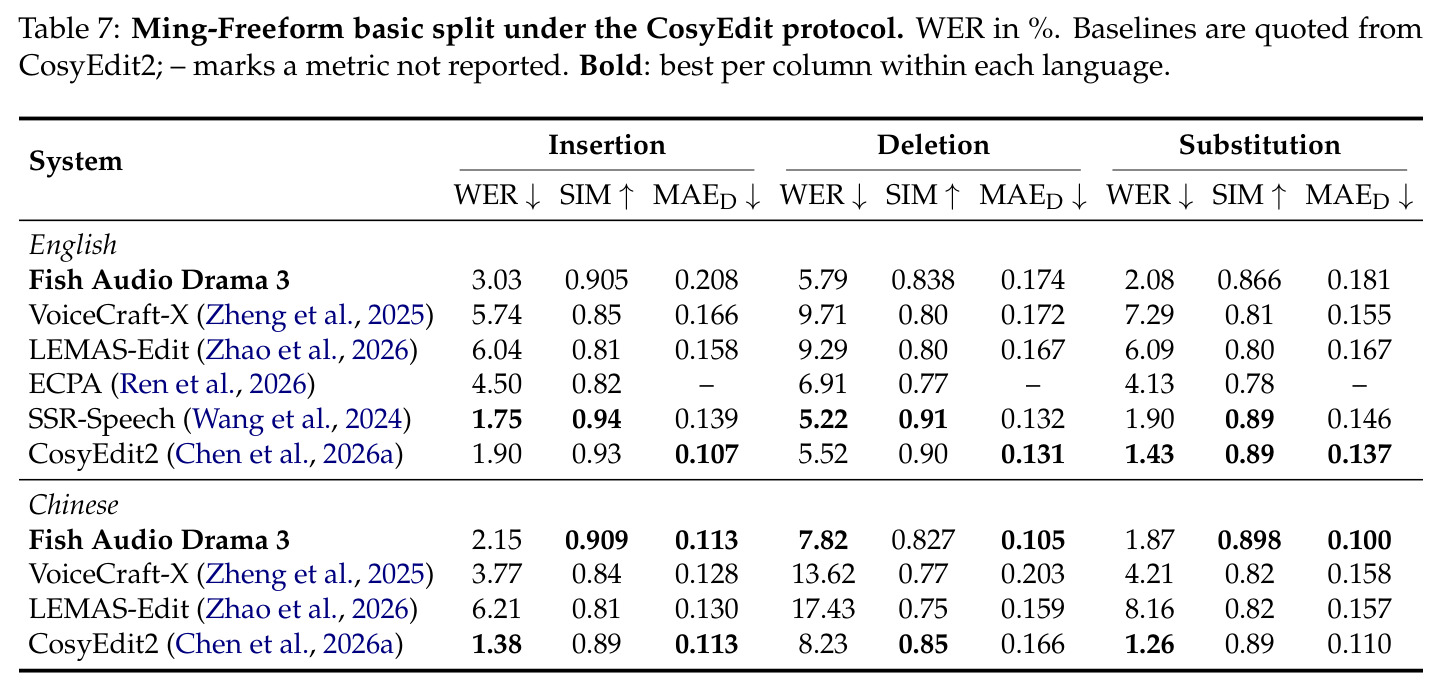
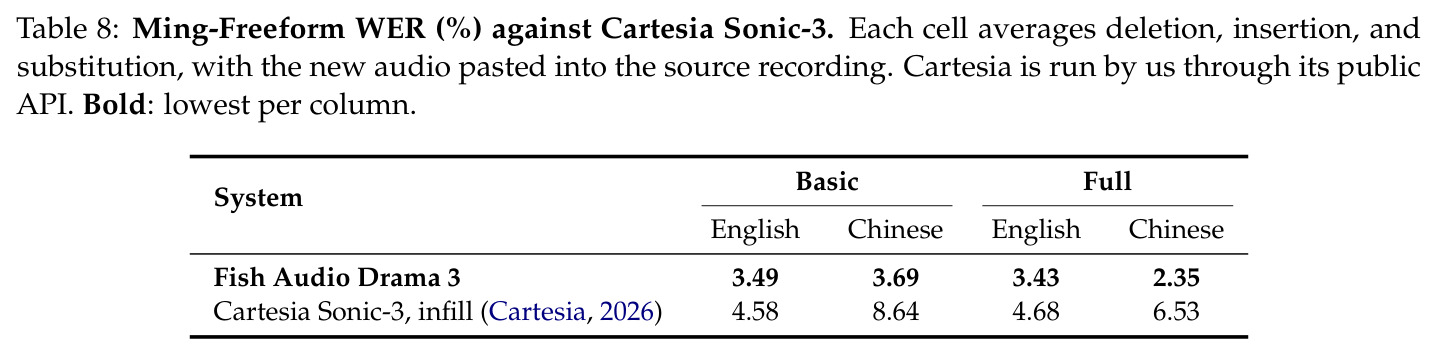
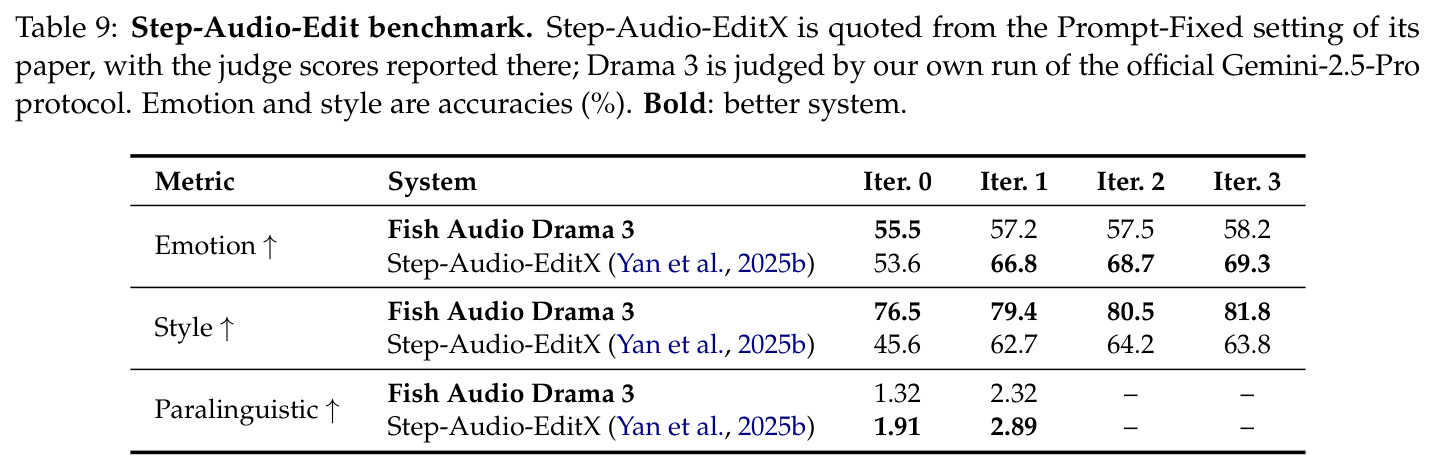
效率:H200 单流解码 271 帧/秒(S2 177),每帧读权重 6.0/15.6 GB,FP8 专家较 BF16 快 36%,PD 分离使单卡承载 10→24 路。奖励消融(Expresso):给出方向后 RM 在 62.2% 耳语对、64.4% 笑声对中偏好风格化读法,无方向仅 10.6%/27.1%。Seed-TTS-Eval:RL 使首 take 失败率 2.82%→1.24%、3.40%→1.84%,CER/WER 降至 1.00/2.20。克隆:LibriSpeech-PC WER 1.85、UTMOS 4.31,三参考 SIM 0.605→0.633;MiniMax 24 语集中文 CER 0.63、英文 WER 1.13、德 0.48、荷 0.59、土 0.52 全表最低。编辑:中文插入/替换 SIM 0.909/0.898、删除 WER 7.82 最优;对比 Cartesia Sonic-3,中文 WER 3.69 对 8.64。改戏(Step-Audio-Edit):风格 76.5→81.8(超 EditX 63.8),情绪与副语言 58.2/2.32 不敌其 69.3/2.89。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 单流流式解码(H200) | 帧率(帧/秒) | 271 | Fish Audio S2:177 | +53%;且每帧读权重约 6.0 GB 对 15.6 GB,参数量却是对方 7 倍多 |
| Seed-TTS-Eval 中文(RL 前 vs 后,首 take) | CER (%) | 1.00 | SFT 检查点:1.66 | −39.8%;首 take 信号检查失败率 2.82%→1.24% |
| Seed-TTS-Eval 英文(RL 前 vs 后,首 take) | WER (%) | 2.20 | SFT 检查点:3.49 | −37.0%;失败率 3.40%→1.84%;最终 take 1.54 对 1.60 |
| MiniMax 多语言克隆—中文 | CER (%) | 0.63 | OmniVoice 1.01 / Fish Audio S2 0.73 / ElevenLabs v4 0.66 | 全表最低(较 OmniVoice −37.6%) |
| MiniMax 多语言克隆—英文 | WER (%) | 1.13 | OmniVoice 1.56 / ElevenLabs v4 1.56 | 全表最低(−27.6%);另德语 0.48、荷兰语 0.59、土耳其语 0.52 亦全表最低 |
| Ming-Freeform 中文编辑(三类平均,basic split) | WER (%) | 3.69 | Cartesia Sonic-3 infill:8.64 | −57.3%,中文错误率不到对方一半 |
| Ming-Freeform 中文插入/替换 | SIM | 0.909 / 0.898 | CosyEdit2:0.89 / 0.89 | 均为最高;中文删除 WER 7.82 亦为最低(CosyEdit2 8.23) |
| Step-Audio-Edit 多轮风格修订(第 3 轮) | 风格准确率 (%) | 81.8 | Step-Audio-EditX:63.8 | +18.0 个百分点(情绪与副语言事件仍落后对方) |
| LibriSpeech-PC 多参考克隆 | SIM | 0.633(三参考) | 单参考 0.605;OmniVoice 0.729 | 较单参考 +0.028,UTMOS 4.31 超 OmniVoice/CosyVoice 3 的 4.28,但仍低于 OmniVoice |
| Seed-TTS-Eval 英文流式 vs 非流式 | WER (%) / SIM | 1.86 / 0.640 | 非流式:1.83 / 0.640 | 流式几乎零质量损失(1,088 句测试集) |
局限与改进
作者承认且数据可见的局限:多参考克隆 SIM 0.633 仍明显低于 OmniVoice 0.729 与 Qwen3-TTS 0.704,多参考增益有限(+0.028);Step-Audio-Edit 上情绪准确率(58.2 对 69.3)与副语言事件(2.32 对 2.89)不敌专用的 Step-Audio-EditX,说明单一偏好奖励在多目标间做了折中;粤语 CER 高达 22.70(OmniVoice 17.71),希腊语、日语、韩语等语言也不是最优,多语言覆盖不均。我的补充观察:其一,改戏与副语言评测完全依赖 Gemini-2.5-Pro 打分,LLM 裁判偏差未经人类听测交叉验证,全文没有任何 MOS 或人耳测试;其二,多个基线数字引自各自论文、评分管线不一,只有四家由作者统一重跑,可比性有折扣;其三,多说话人场景、长合成、流式文本输入等主打能力没有公开基准,论文只展示输入格式;其四,训练数据仅有'数百 B token、约 80 语言'的粗略描述,奖励模型的偏好数据规模与标注协议完全未披露;其五,RL 期间码本-MTP 解码器冻结,九个声学码从未被偏好目标直接优化。
独立分析的弱点
独立分析的弱点及改进方向:①单一奖励模型是多目标折中的单点——情绪准确率落后专用编辑模型 11 个百分点,可给 RM 增加多头/多维属性输出并在 GRPO 中按任务族加权组合,或对情绪类请求微调独立奖励头;②改戏依赖上下文里旧的 take 音频,历史越长 exposure bias 越重(模型倾向模仿自己采样出的码),目前只反馈码 0/1 部分缓解,可研究对历史 take 做重加权、噪声增强或定期裁剪上下文;③多参考克隆收益小,说明把多条参考简单拼进上下文的利用率低,可引入参考检索、注意力池化或先做说话人表征聚合再注入;④部署形态偏重:PD 分离需要多卡,核优化深度绑定 H200/B300 与特定矩阵 shape,迁移新硬件成本高,可投入编译器式自动调优以降低维护负担;⑤评测量表偏 WER/SIM 与 LLM 裁判,缺少韵律自然度、导演服从度的人类评分,容易高估实际听感;⑥删光规则奖励后,内容忠实度这类硬约束只剩信号检查加重新生成兜底,极端情况(幻觉、漏句)缺乏机制保障,可在 RM 中显式加入内容一致性维度而非退回规则奖励。
未来方向
作者提出的方向:把 Drama 3 作为表现力、可导戏语音生成的开放基座(权重已在 GitHub/HuggingFace 发布,推理经 SGLang-Omni 提供),并鼓励用户在 fish.audio 上亲自导戏。基于本文成果可自然延伸:①解冻码本-MTP 解码器参与 RL,让九个声学码也被偏好直接塑形,有望补齐副语言与情绪短板;②把 RM 扩展为可解释的多维奖励(情绪强度、节奏、音色一致性分项),支撑更细粒度的导演控制乃至'自动导演 agent';③与对话系统结合做低延迟全双工语音交互——流式文本输入已就绪,还差流式听觉与打断机制;④把'表演'从语音扩展到视频数字人与口型同步;⑤为多说话人场景配音构建公开基准(多角色、跨语言同声、长剧本一致性),填补本文自己指出的评测空白;⑥研究大批次少步数 RL 与单一偏好奖励的 scaling 规律,并覆盖更多低资源语言(粤语等失败案例是现成切入点);⑦利用 3B 激活的稀疏性蒸馏端侧模型,让消费级设备实时导戏。
复现评估
开源情况:模型权重在 GitHub(fishaudio/fish-speech)与 HuggingFace(fishaudio/drama-3)公开,官方称其为总参数最大的开放权重语音模型,推理可经 SGLang-Omni 运行。评测可复现性较好:三个基准(MiniMax Multilingual、Ming-Freeform、Step-Audio-Edit)公开且有官方脚本与评判 prompt,ASR(Whisper、Paraformer)与说话人模型(WavLM-large + ECAPA)均为公开模型;但 ElevenLabs/Inworld/Soniox/Cartesia 等基线需自购 API 重跑。主要缺口:训练数据、奖励模型及其偏好标注均未发布,'数百 B token'的预训练意味着全量复现需数十张 H200/B300 级 GPU 运行数周,只有资源充足的团队可行。相比之下,基于开放权重做下游微调或本地部署推理门槛中等:单卡 H200 即可 271 帧/秒流式服务,RTX PRO 6000 生产部署也被验证。总体评级:推理复现容易、微调可行、从头训练困难。
论文图表
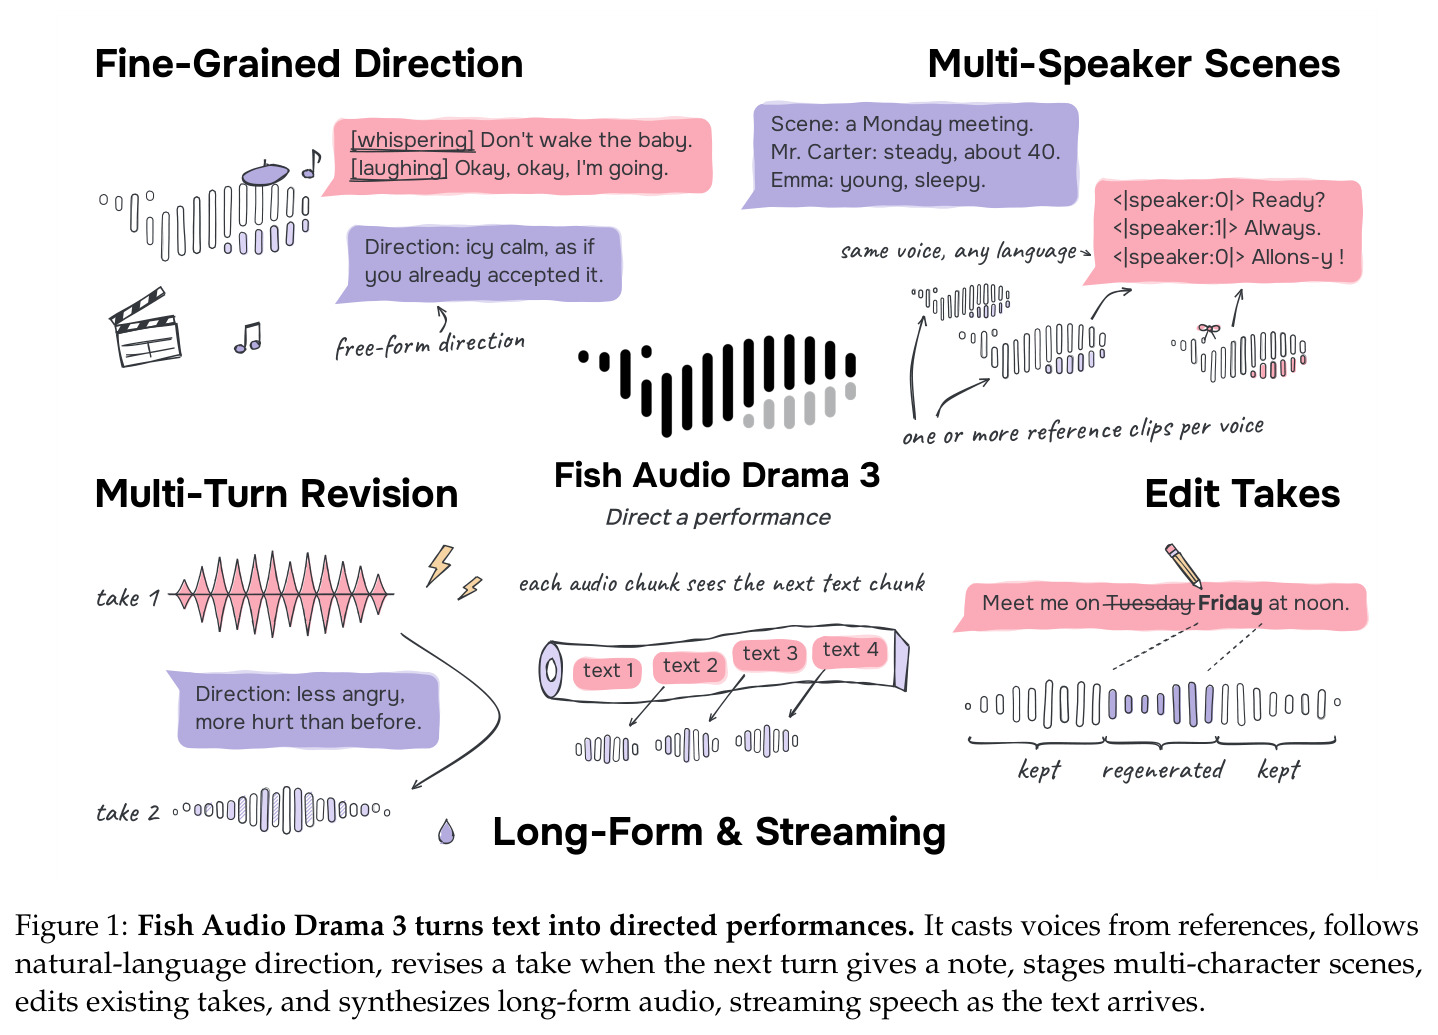
能力总览图:左侧展示细粒度方向控制([whispering] 点标签、冰冷平静的自由导演意见)与多说话人场景(一个周一会议场景中 <|speaker:0|>/<|speaker:1|> 交替、同一声音跨语言);中间与右侧展示多轮改戏(take 1 后下一轮给'少些愤怒、多些委屈'的意见生成 take 2)、对已有 take 做填空编辑(Tuesday 改 Friday,只重生成中间一段、前后保留),以及长音频与流式合成(每个音频块能看到下一个文本块)。
一图总览论文定位与五大能力,是理解'可导演表演'这一核心概念和各任务输入输出格式的入口,后续所有实验都对应图中某项能力。