学会如何记忆:GUI智能体的记忆模态选择 Learning How to Remember: Memory Modality Selection for GUI Agents
最优记忆模态随交互步骤变化,SwitchMem据此逐步动态路由文本或图像记忆
前置知识
GUI智能体(VLM-based GUI Agent)
以视觉语言模型为核心、直接以屏幕截图为观测的自动化操作智能体。每一步它读取任务指令与当前截图,预测点击、滑动、输入文本等动作,动作改变界面状态后又进入下一轮观察-决策循环,直到任务完成。代表工作包括Aguvis、UI-TARS、Mobile-Agent等。
本文的全部问题设定、记忆库构建与三大评测基准(AITW、LearnGUI、MobileMiniWoB++)都建立在GUI智能体的观察-动作循环之上,不理解这一循环就无法理解『步骤级决策』的确切含义。
记忆增强与经验检索(RAG for agents)
智能体把历史成功轨迹存入记忆库,推理时用检索器(本文用Qwen3-VL-Embedding-2B做文本向量检索)找出最相关的演示步骤,作为上下文示例提供给执行器,帮助其复用经验、避免重复犯错。检索到的内容可以用文本、图像等多种形态呈现。
SwitchMem比较的正是『同一检索结果的不同呈现形态』,而所有记忆增强基线(RAG-GUI、AppAgent、EchoTrail、AGMem等)也都属于这一范式,是理解实验对比的前提。
隐藏状态探针与AUROC
探针是在冻结模型内部表示上训练的轻量分类器(通常为逻辑回归),用来检验某种信息是否已被编码在表示中。AUROC衡量探针区分两类样本的能力,0.5等于随机猜测,1为完美区分。本文用线性探针从隐藏状态之差中预测哪一种记忆模态更优。
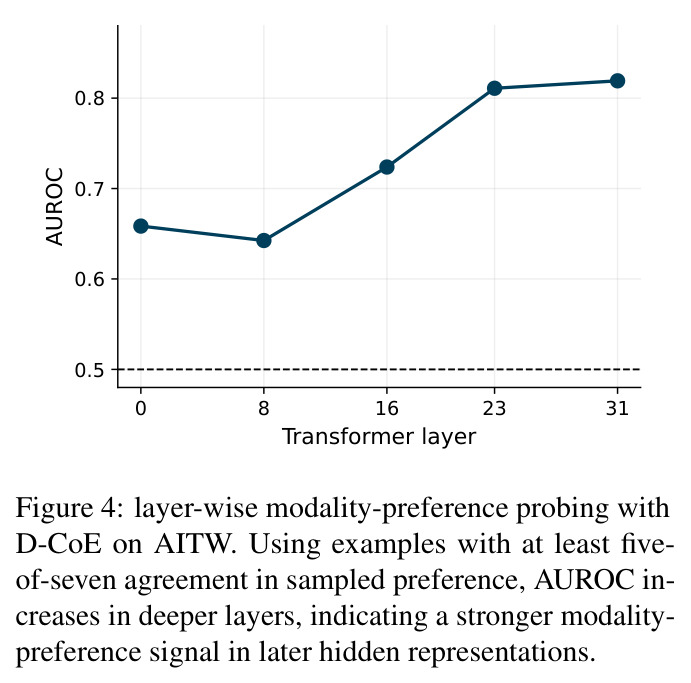
论文用『模态偏好能否被探针读出(AUROC随层加深升至0.7以上)』作为核心证据,支撑了用模型内部信号做路由监督这一关键设计。
Chain-of-Embedding与D-CoE
Chain-of-Embedding沿模型各层追踪输入条件不同时的中间隐藏表示序列,分析信息如何在网络中逐层分化。本文提出方向性版本D-CoE:对同一提示在图像/文本两种记忆条件下的逐层隐藏状态取带符号差 $d_{i,\ell}=h^{I}_{i,\ell}-h^{T}_{i,\ell}$,作为模态偏好的表征信号。
D-CoE是SwitchMem偏好目标(软标签)的直接来源,也是『模态偏好已写入执行器内部表征』这一论断的方法论核心,不搞懂它就看不懂第4节。
成对路由器(pairwise router)
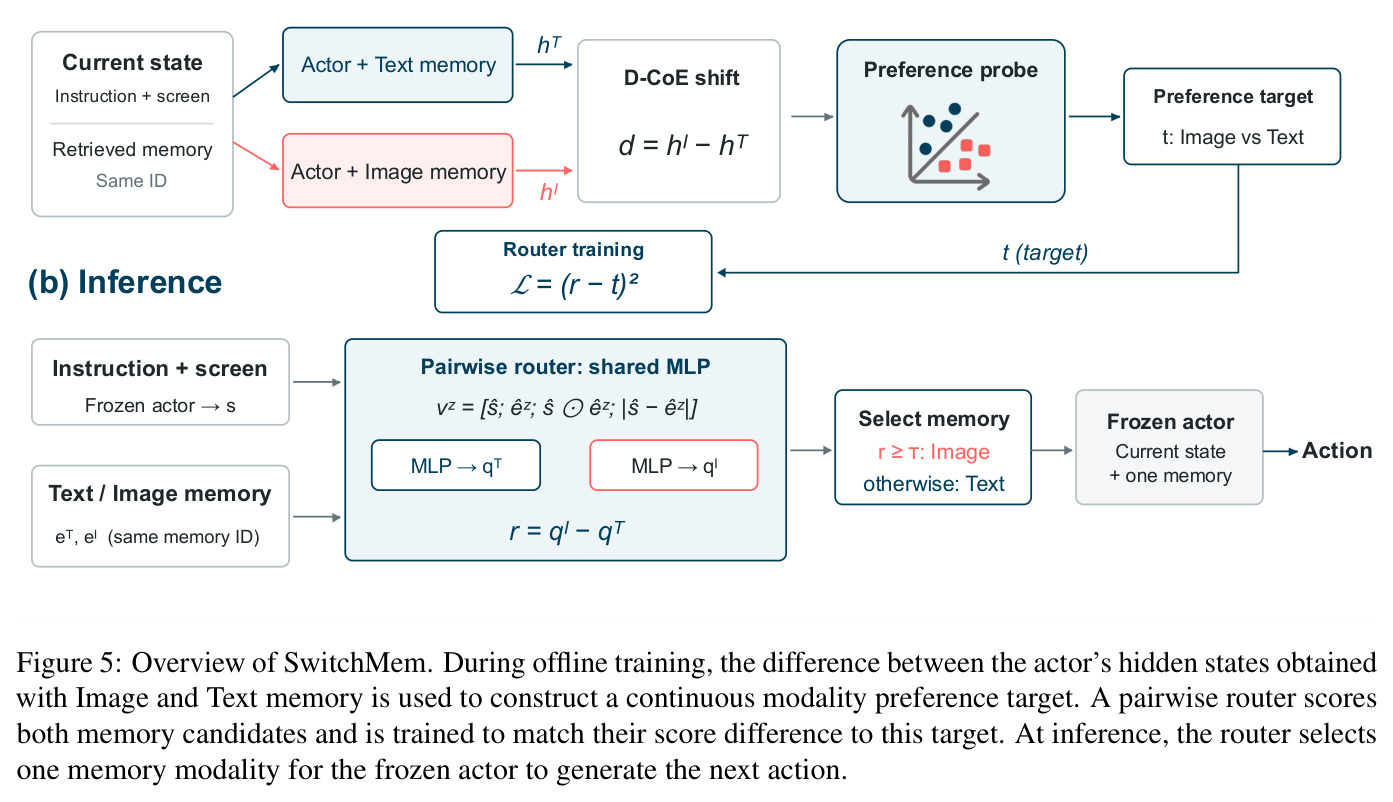
对两个候选项用同一个共享打分器分别输出标量分 $q^T$ 与 $q^I$,以分差 $r=q^I-q^T$ 作为相对偏好并与阈值 $\tau$ 比较。共享参数保证两条分支的分数可直接比较,训练目标是回归连续偏好差的MSE损失。
SwitchMem的推理开销几乎全部来自这个小路由器,理解其成对结构才能看懂它与直接效用回归基线(Utility/Binary)的差别以及延迟对比实验。
步级效用估计与采样评分
对同一状态在某种记忆条件下用带温度的解码采样 $K$ 个动作,按基准提供的动作评分器与gold动作比对后取平均,得到期望效用 $\hat{u}^z_i=\frac{1}{K}\sum_{k=1}^{K}S(a^z_{i,k},a^*_i)$。两种模态的效用差即偏好标签。
偏好目标、逐步oracle上限、配对显著性检验全部依赖这套逐步效用度量,是读懂第3节分析与全部实验数字的通用前提。
研究动机
视觉语言模型驱动的GUI智能体虽然能解读截图并执行点击、滑动等操作,但任务往往需要多步决策,一步出错会向后传播。为了让智能体从过去交互中学习,现有工作普遍引入记忆增强:从历史成功轨迹中检索相关经验,以上下文形式提供给执行器。然而这些系统几乎都采用固定的记忆表征——检索到的经验要么只以文本(UI结构化描述、操作指南)呈现,要么只以截图等视觉形式呈现,要么两者都给,一旦选定便贯穿整个交互过程。文本抽象虽紧凑,但把屏幕转成文字会丢失布局、外观等细粒度信息;图像保留细节,但当关键信息可以结构化表达时反而是冗余负担。此前VLM研究表明文本与视觉表征的相对效用取决于推理语境,但记忆增强GUI智能体领域一直没回答:单一记忆模态是否在每一步都最优?模态偏好如何随交互步骤变化?
本文的目标是本文的目标是把『记忆用什么模态表示』从一个固定的系统设计选择,重新定义为一个逐步的动态决策问题,并给出可落地的方案。具体分三层:第一,系统性地量化文本与图像两种记忆表征在同一检索结果、同一冻结执行器下的逐步效用差异,验证最优模态是否随步骤变化、固定模态到底损失多大;第二,探究这种模态偏好能否从模型内部隐藏状态中被预测出来,即执行器自身是否『知道』当前更需要哪种记忆;第三,基于这些发现构建SwitchMem——一个轻量级路由器,在每个交互步骤自适应地从文本与图像记忆中选择其一,在不微调执行器、不显著增加推理延迟的前提下,稳定超越所有静态记忆策略。
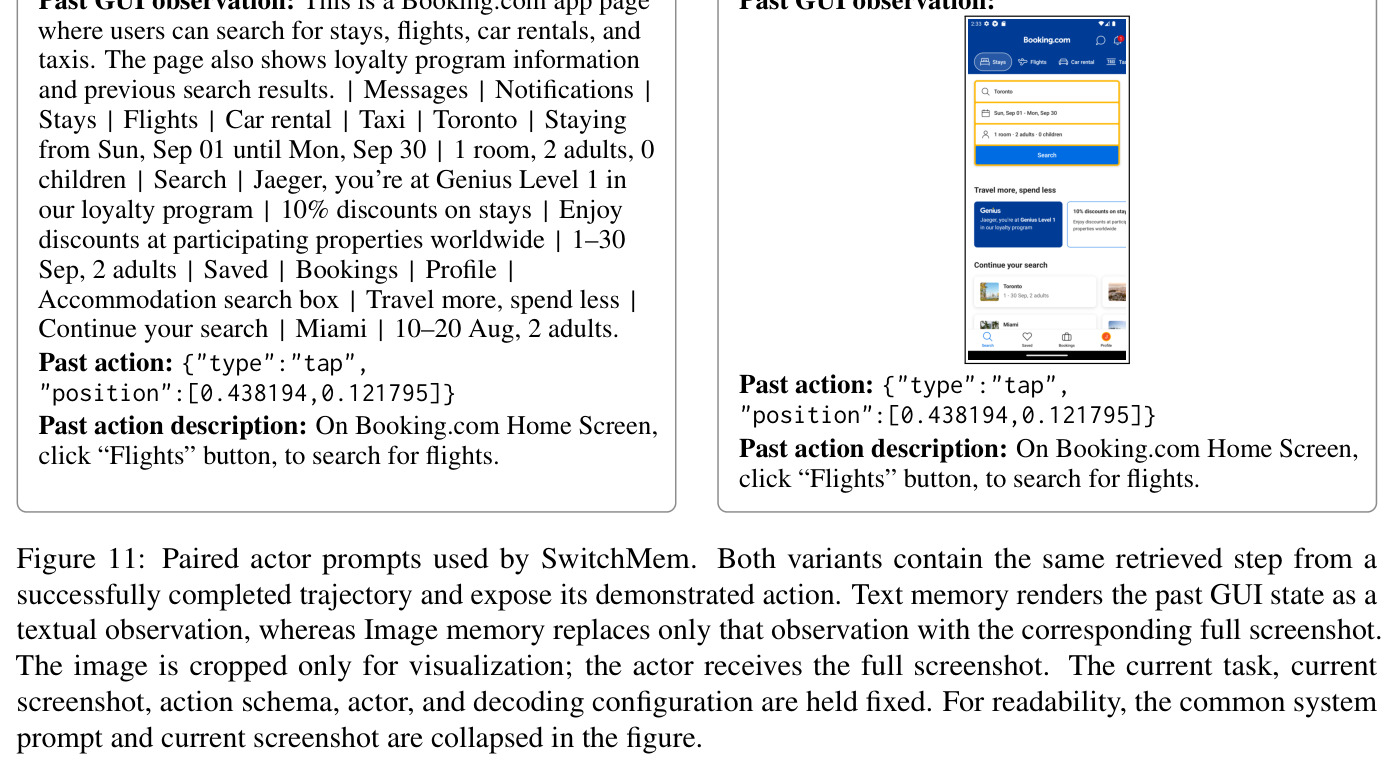
与已有工作不同的是,本文的独特之处在切入点和监督信号两方面。以往记忆系统把模态视为检索之后的固定后处理,本文则证明模态应与检索内容解耦、作为每步独立决策,并用『同一检索经验、双模态实例化』的受控对比($m^T_i=\{g_j,t_j,a_j\}$ 与 $m^I_i=\{g_j,v_j,a_j\}$ 共享同一演示ID)把表征效应从检索质量中剥离。更大的创新在偏好信号来源:作者不依赖人工标注或外部裁判,而是利用冻结执行器自身的方向性嵌入链(D-CoE)——同一提示在图像与文本两种记忆条件下最终层隐藏状态之差 $d_i=h^I_i-h^T_i$——构造连续偏好目标。这把『哪种记忆更有用』变成模型内部可读出的表征信号,使极小的MLP路由器就能学到与真实效用一致的偏好,且天然可迁移到其他执行器与基准。
核心方法
直觉上,记忆就像同事转述的一条过往经验:有时一张历史截图最直观,有时一段文字描述更省事,聪明的做法是按当前情境挑一种。技术上SwitchMem分两阶段。离线阶段:用共享的文本检索器(Qwen3-VL-Embedding-2B)为每个状态取top-1演示步骤,同一演示分别实例化为文本记忆 $m^T_i=\{g_j,t_j,a_j\}$ 与图像记忆 $m^I_i=\{g_j,v_j,a_j\}$;对每种模态从冻结执行器采样 $K=7$ 个动作并按基准评分器估计效用 $\hat{u}^z_i$,得到效用差 $\hat{\Delta}_i=\hat{u}^I_i-\hat{u}^T_i$;同时提取两种条件下最终层隐藏状态之差 $d_i$,经标准化与PCA降到64维后,用逻辑探针的决策值 $t_i=w^\top\mathrm{PCA}(\mathrm{Std}(d_i))+b$ 作为软偏好目标。在线阶段:训练成对路由器——共享MLP分别给两种记忆候选打分,取分差 $r_i=q^I_i-q^T_i$,用MSE回归 $t_i$;推理时若 $r_i\geq\tau$ 选图像记忆,否则选文本记忆,只把选中的一份记忆喂给冻结执行器生成动作。
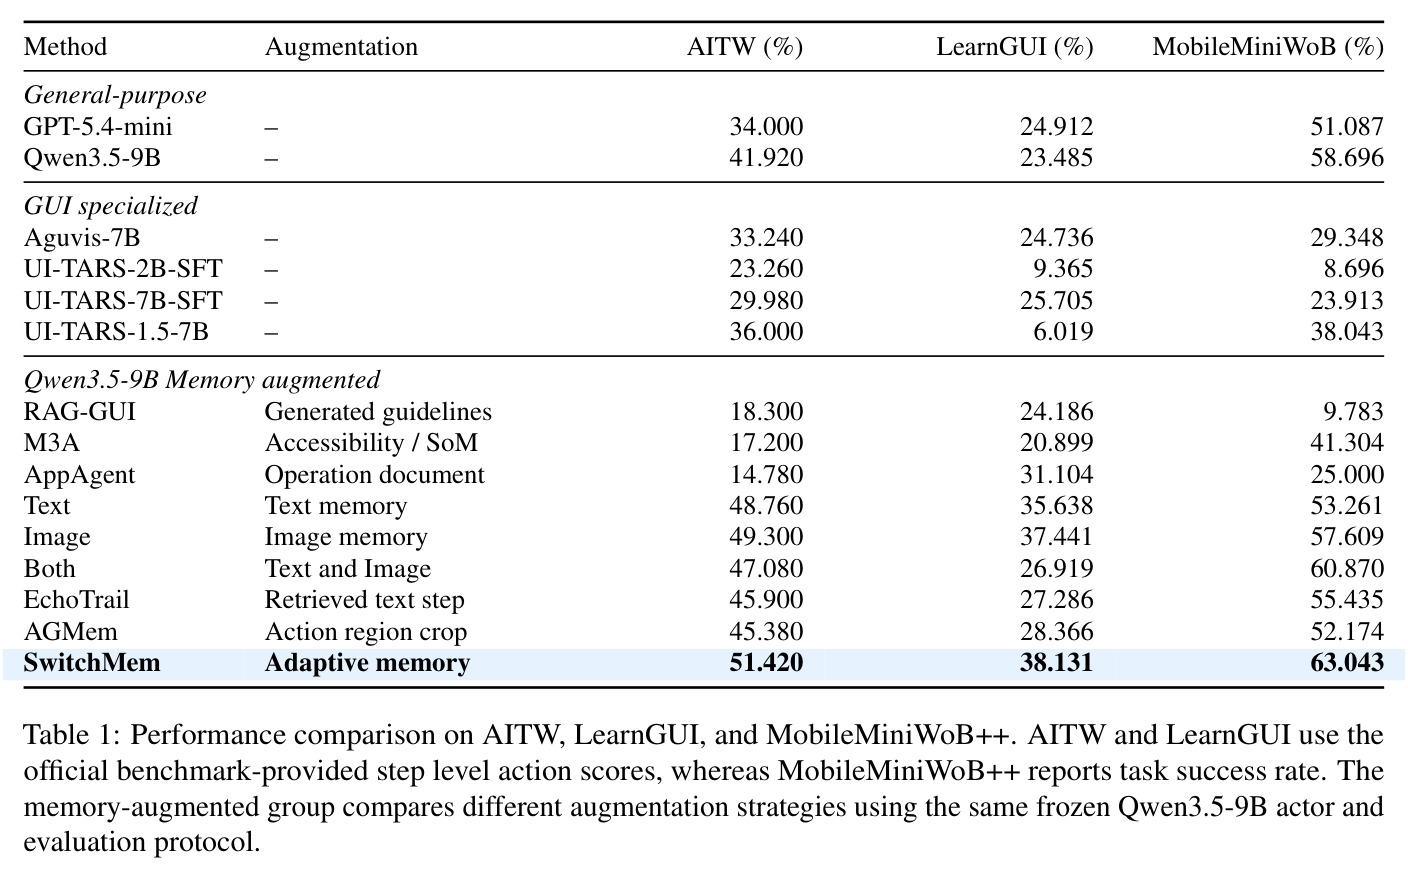
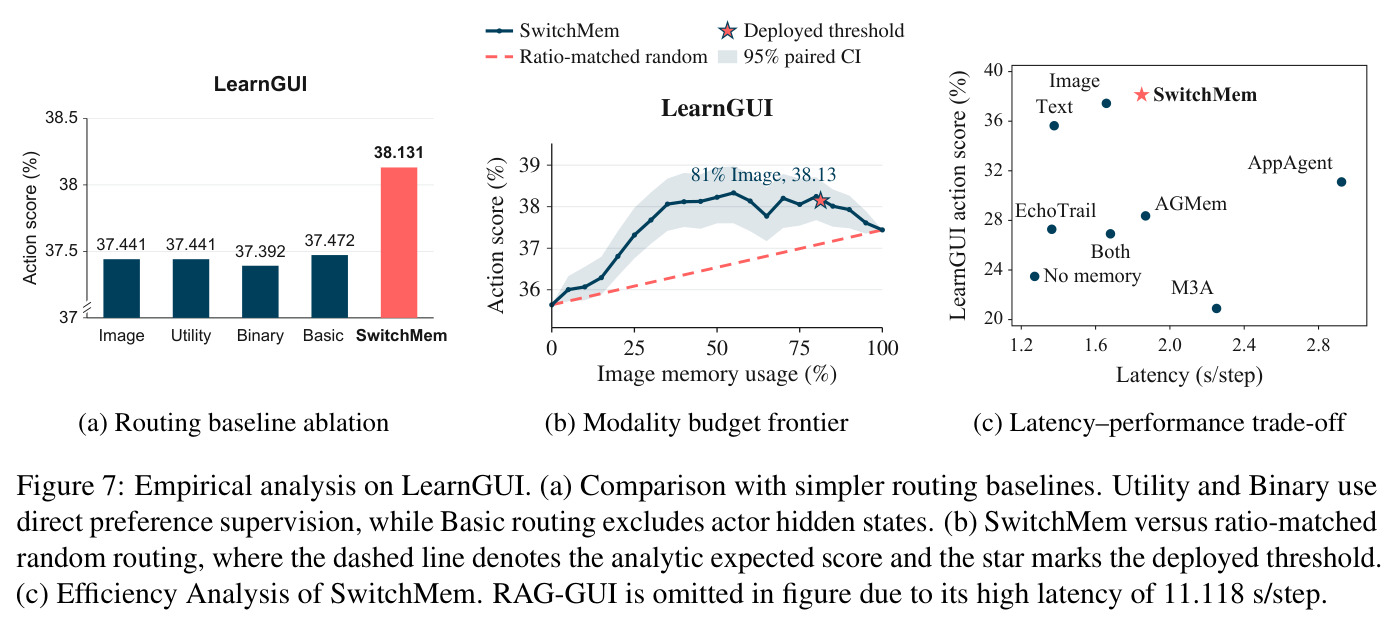
核心创新是把记忆模态选择形式化为步骤级决策,并用执行器内部表征而非外部标注作为监督。与已有方法的本质区别有三:其一,RAG-GUI、M3A、AppAgent、EchoTrail、AGMem等系统在检索之后就固定了记忆形态(生成指南、辅助信息、操作文档、文本轨迹、区域裁剪图),SwitchMem保持检索内容不变、只动态切换形态,证明『怎么呈现』与『呈现什么』同样重要——论文数据显示这些精巧方案反而不如直接注入原始经验。其二,偏好目标不是直接用采样效用回归(这正是论文对比的Utility/Binary基线),而是先用D-CoE表征差训练逻辑探针、再以其决策值为软标签,实验显示基于表征的监督更稳定有效(LearnGUI上38.131对37.441)。其三,路由器对两种模态用同一个共享MLP打分、取分差路由,保证分数可比;执行器完全冻结,路由器仅为1024→256→1的两层MLP。
方法步骤详情
完整流程五步。第一步,检索:为每个状态 $x_i=(g_i,o_i)$(指令+当前截图)用文本嵌入从成功演示库中取top-1演示 $j$,得到带过去指令 $g_j$、过去动作 $a_j$ 的候选,文本与图像两条件共用同一ID。第二步,效用估计:对每个训练状态,两种模态各用温度0.7、seeds 42–48采样7个动作,按基准评分器算 $\hat{u}^z_i=\frac{1}{7}\sum_kS(a^z_{i,k},a^*_i)$,效用完全持平的步从训练集剔除,得到非平局集合 $D_{pref}$。第三步,构造偏好目标:取最终层(第31个transformer块)最后一个输入token的隐藏状态之差 $d_i=h^I_i-h^T_i$,标准化后PCA降至64维,拟合逻辑探针,其决策值 $t_i$ 即软偏好目标(正值偏向图像)。第四步,路由器训练:当前提示的最终token隐状态 $s_i$ 与记忆嵌入 $e^z_i$ 经 $\ell_2$ 归一化后拼接特征 $v^z_i=[\hat{s}_i;\hat{e}^z_i;\hat{s}_i\odot\hat{e}^z_i;|\hat{s}_i-\hat{e}^z_i|]$,共享两层MLP(1024→256→1,GELU,dropout 0.1)输出 $q^z_i$,以 $\mathcal{L}_{route}=\frac{1}{|D_{pref}|}\sum_i(r_i-t_i)^2$ 训练(AdamW,lr 0.001),阈值 $\tau$ 在训练预测上最大化效用后冻结。第五步,推理:一次前向拿当前隐状态,路由器算 $r_i$,按阈值选一种记忆交给冻结执行器生成动作。
技术新颖性
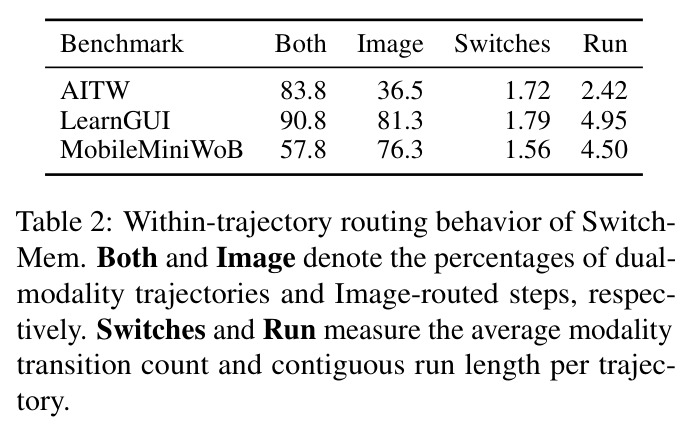
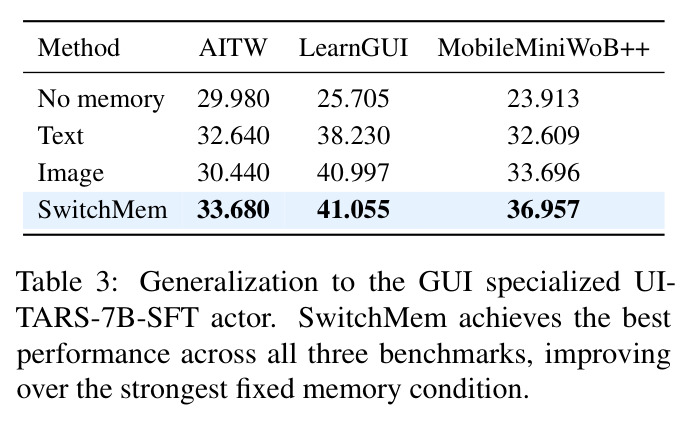
技术新颖性体现在四点。第一,D-CoE的迁移创新:Chain-of-Embedding原用于分析LLM推理中输入条件的层间分化,本文首次把它用于对比同一提示在不同记忆模态下的隐藏状态漂移,并证明该漂移含有可读出的偏好信号(AITW上AUROC随层深升至0.7以上)。第二,自监督的目标构造:偏好标签完全来自冻结执行器自身的采样效用与内部表征,无需人工标注,可直接复制到任何提供隐藏状态的模型。第三,路由的粒度与形式:区别于任务级或固定比例的模态策略,SwitchMem在步骤级做硬选择,Table 2显示其在83.8%–90.8%的轨迹内混用两种模态、平均切换1.56–1.79次且连续保持2.42–4.95步,是真正的状态自适应。第四,可迁移性:MobileMiniWoB++没有训练集,直接把LearnGUI训好的路由器零样本迁移仍取得63.043%的成功率;换用UI-TARS-7B-SFT执行器同样全面领先,说明方法绑定的是『表征级偏好信号』而非特定模型。
实验结果
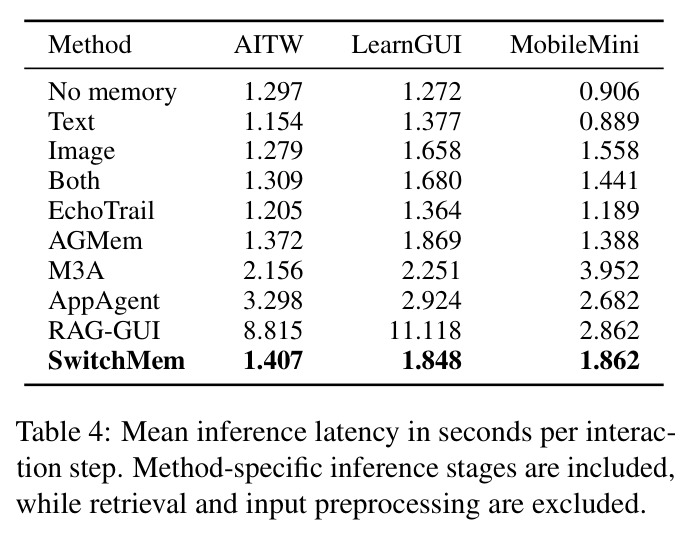
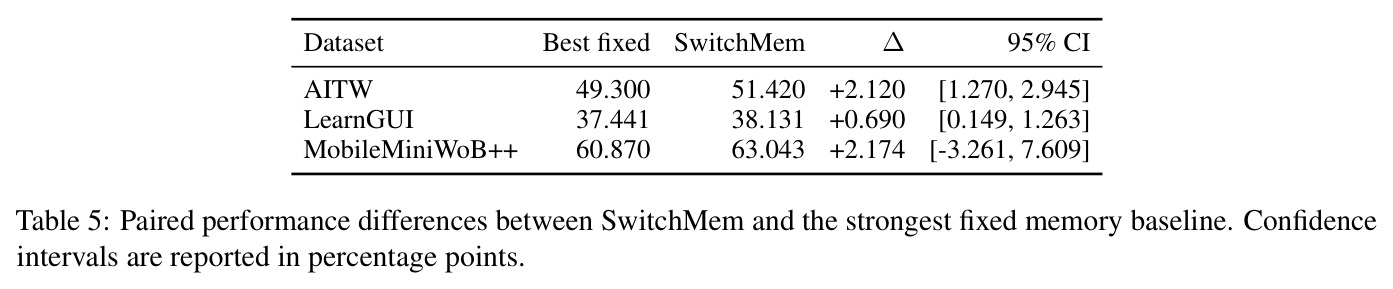
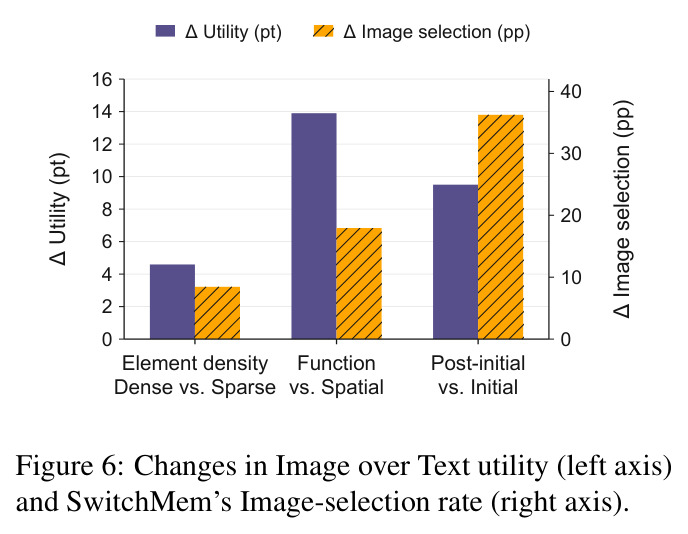
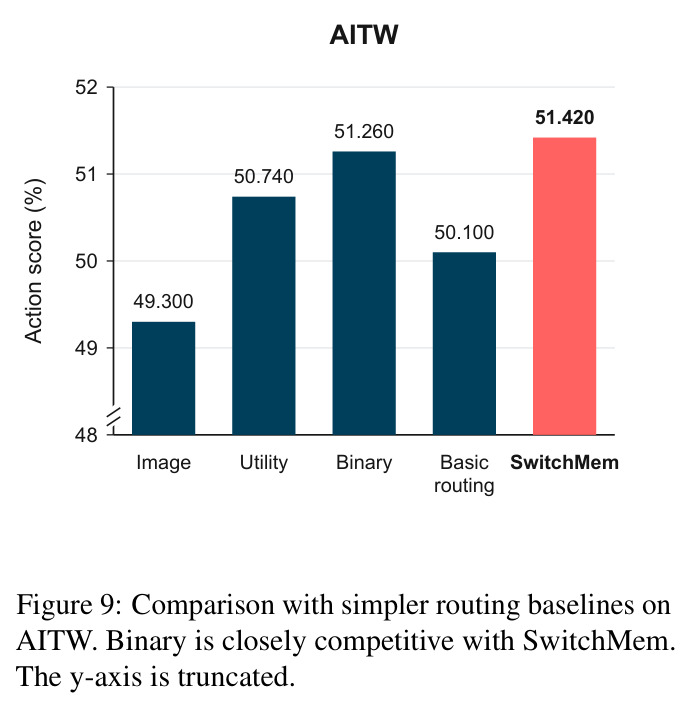
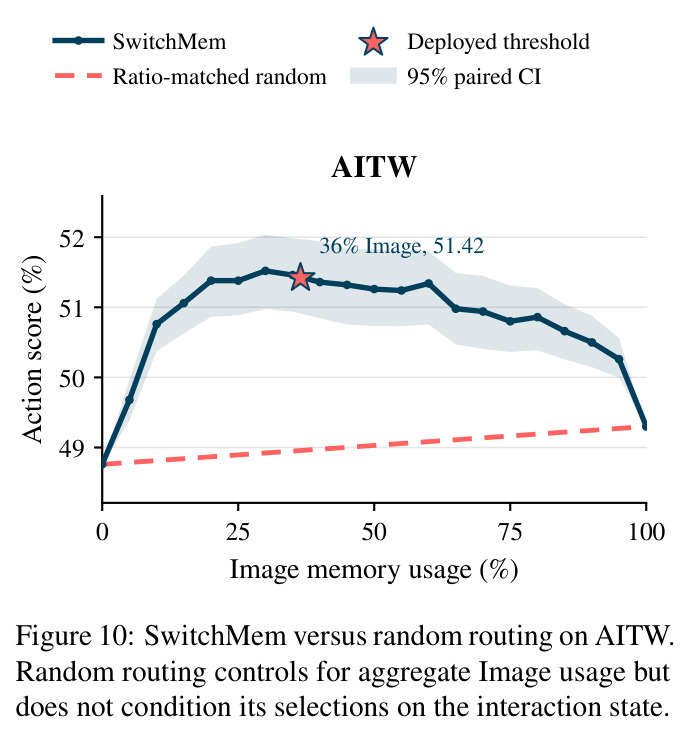
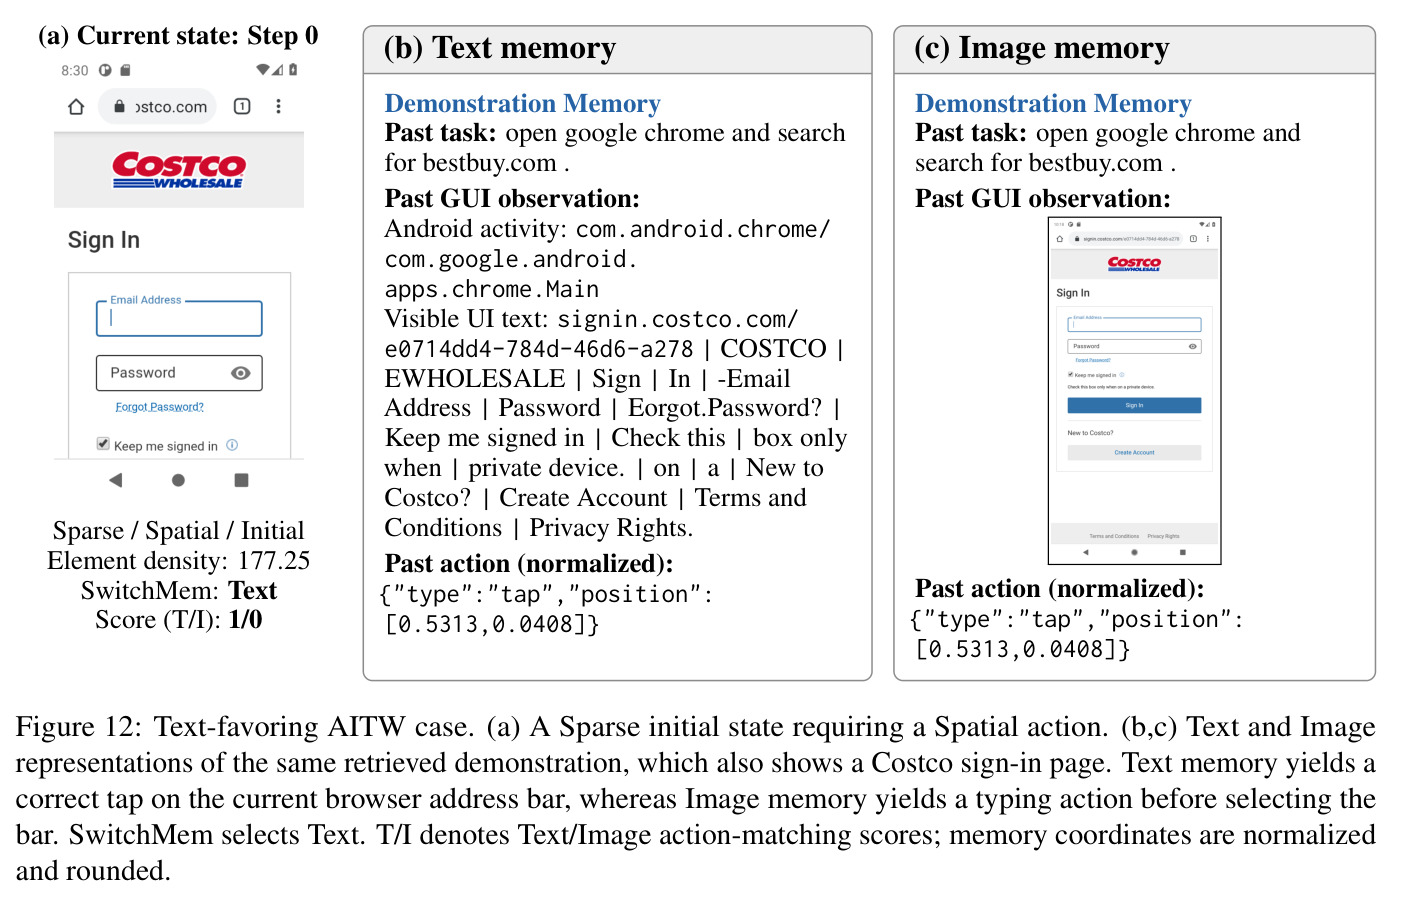
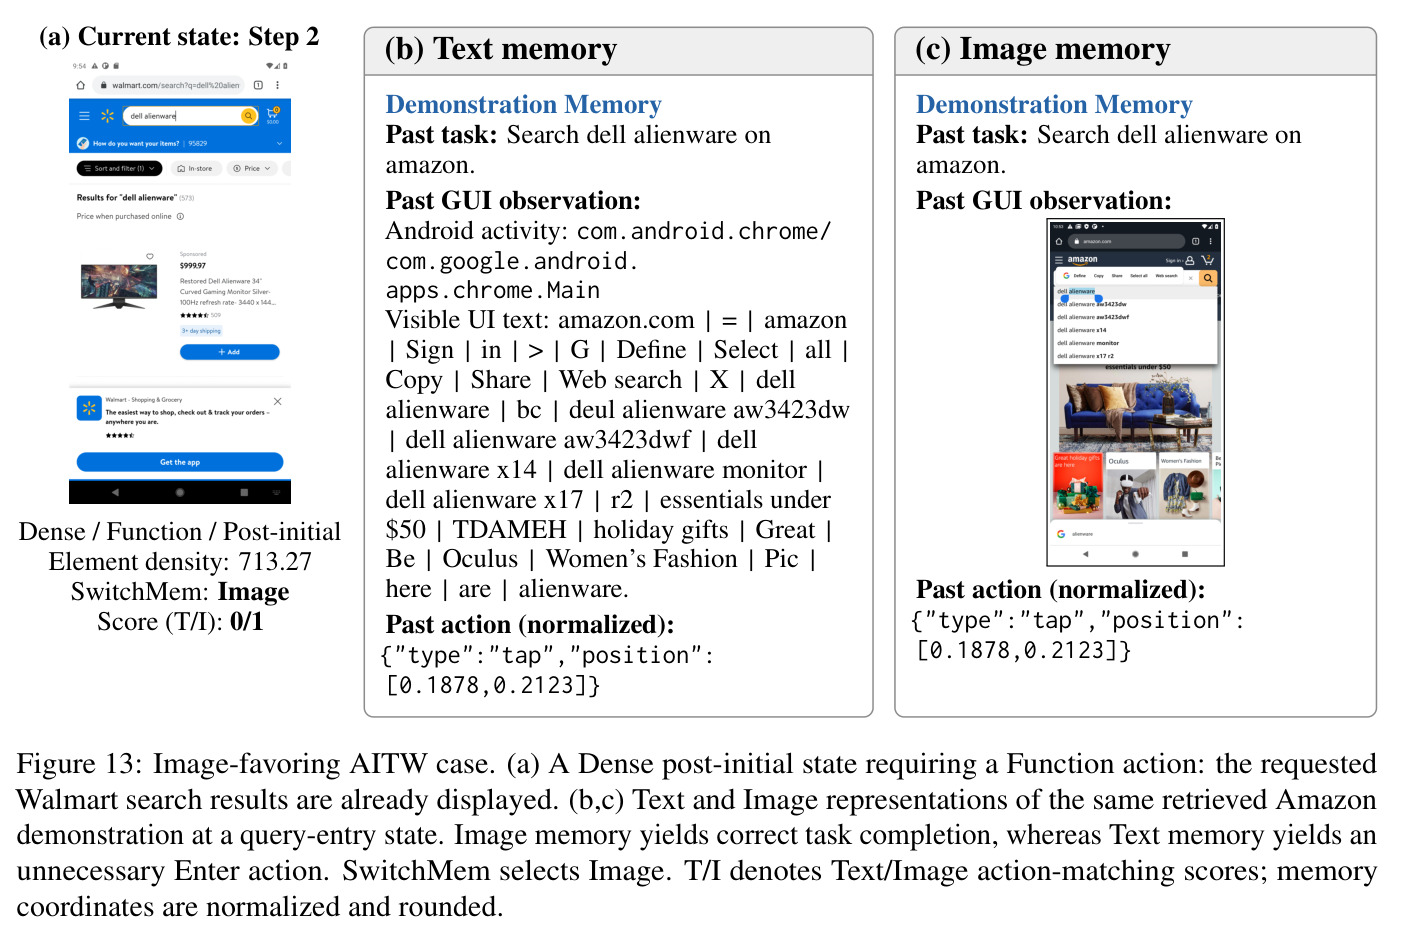
分析实验先确立核心事实:非平局步骤中文本/图像记忆的偏好接近对半分(AITW为48.0%/52.0%,LearnGUI为47.7%/52.3%),而逐步『先知』选择最优模态可把AITW得分从最强固定模态的49.3提升到55.9(+6.6pt),LearnGUI从37.4提升到43.4(+6.0pt),证明固定模态确实留了性能在桌上。主实验中SwitchMem在三个基准全部第一:AITW 51.420(最强基线Image为49.300)、LearnGUI 38.131(Image 37.441)、MobileMiniWoB++成功率63.043%(Both为60.870%);相比之下RAG-GUI、M3A、AppAgent在AITW仅18.300/17.200/14.780,精巧的记忆加工反而不如直接注入原始经验。配对显著性检验:AITW p<.001、LearnGUI p=.016、MobileMiniWoB++ p=.688(仅92个任务,CI [-3.261, 7.609])。路由行为上,57.8%–90.8%的步骤所在轨迹同时用到两种模态,平均切换1.56–1.79次、连续保持2.42–4.95步,说明是状态自适应而非锁死任务级模态。效用模式分析显示图像记忆的优势随界面元素密度上升、在Function类动作和初始步之后的状态中扩大,且路由器选择率与这些效用位移一致(Figure 6)。消融证明增益来自逐步正确指派而非图文比例:在每个图像使用率上SwitchMem都超过比例匹配随机路由;直接效用监督的Utility/Binary/Basic路由在LearnGUI仅37.39–37.47,明显低于38.131。换UI-TARS-7B-SFT执行器同样全面领先(33.680/41.055/36.957)。延迟仅比Image基线多0.128/0.190/0.304秒每步(1.407/1.848/1.862秒),远低于RAG-GUI的8.815/11.118秒。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AITW 移动GUI步级动作预测 | 步级动作得分(%) | 51.420 | Image 固定记忆 49.300(最强固定模态) | +2.120(95% CI [1.270, 2.945],p<.001) |
| LearnGUI 演示增强移动交互 | 动作执行准确率(%) | 38.131 | Image 固定记忆 37.441 | +0.690(95% CI [0.149, 1.263],p=.016) |
| MobileMiniWoB++ 在线闭环任务 | 任务成功率(%) | 63.043(58/92) | Both 双模态固定 60.870 | +2.174(95% CI [-3.261, 7.609],p=.688,不显著) |
| UI-TARS-7B-SFT 执行器迁移(AITW) | 步级动作得分(%) | 33.680 | Text 固定记忆 32.640 | +1.040 |
| UI-TARS-7B-SFT 执行器迁移(LearnGUI) | 动作执行准确率(%) | 41.055 | Image 固定记忆 40.997 | +0.058 |
| UI-TARS-7B-SFT 执行器迁移(MobileMiniWoB++) | 任务成功率(%) | 36.957 | Image 固定记忆 33.696 | +3.261 |
局限与改进
作者承认的局限:评测集中在Android移动基准与受控交互环境,尚未验证iOS及更新版本Android(视觉布局与交互习惯可能不同);在线评测用模拟器而非物理设备,无法覆盖真实渲染差异、系统中断、网络波动与硬件约束;方法需要访问执行器隐藏状态,无法直接用于不开放内部表征的闭源API模型。我的补充观察:其一,MobileMiniWoB++上的提升不显著(p=.688),且路由器是从LearnGUI零样本迁移、阈值只靠匹配图像选择率来校准,跨域稳健性的证据还比较薄;其二,动作空间是文本/图像二选一,不允许『不给记忆』或『两种都给』,而Both基线在MobileMiniWoB++(60.870%)明显好于单模态,说明该设计在部分环境下反而束住了手脚;其三,偏好目标构建需对每个训练状态做2×7次采样前向并评分,训练开销不小;其四,文本记忆依赖基准自带的UI标注做序列化(AITW的UI文本、LearnGUI的元素注释、MobileMiniWoB++的accessibility树),真实应用需要额外解析或captioning环节;其五,AITW/LearnGUI以步级动作匹配计分而非完整任务成功率,与端到端用户体验可能有差距。
独立分析的弱点
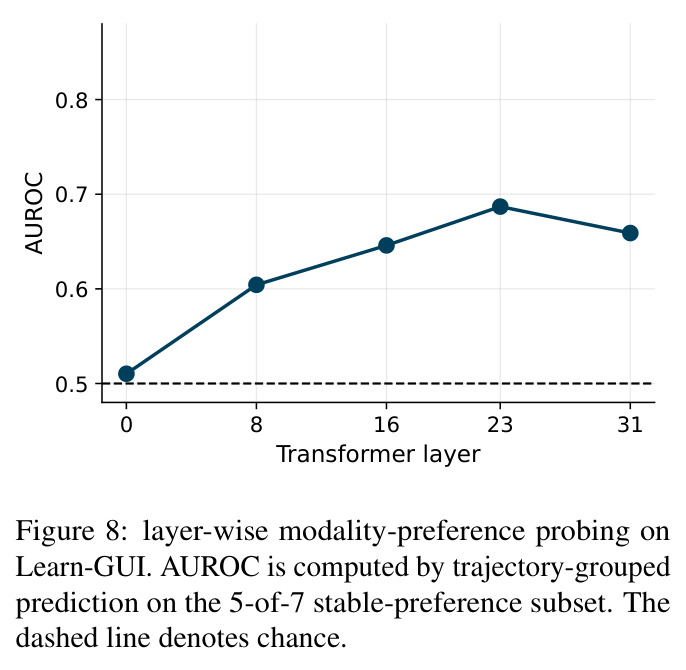
独立分析的弱点与改进方向:第一,二值模态空间太粗——真实场景中『文本+图组合』『动作区域裁剪』『多条演示』甚至『不提供记忆』都可能是更优选项,Both基线在MobileMiniWoB++上胜过单模态就是信号,可把路由扩展为K路选择或按 $r_i$ 做软加权融合;第二,对隐藏状态的依赖把GPT这类闭源API排除在外,可在开源代理模型上训练路由器,把表征信号蒸馏成API可观察量(检索相似度、OCR元素密度、步骤序号等)的函数;第三,记忆库与路由器都是离线固定,长期部署中记忆库会持续演化,应研究路由器的增量更新与分布漂移检测;第四,效用估计依赖基准评分器与gold动作,真实环境没有逐步标注,可改用自一致性、回滚成功率或critic模型来构造偏好信号;第五,探针在LearnGUI的峰值在第23层而SwitchMem统一用第31层,层选择策略粗糙,按层集成或自适应层选择可能进一步提分;第六,元素密度等效用模式分析依赖基准提供的bounding box标注,需要不依赖标注的复杂度度量才能落地。
未来方向
作者提出的方向包括:把评测扩展到物理设备与iOS等更广泛的GUI生态,以及在不暴露隐藏状态的API模型上实现模态路由。基于本文成果还可延伸:一是把步骤级模态路由与执行器强化学习联合训练,让路由信号反过来参与塑造策略,而不仅服务于冻结模型;二是把D-CoE偏好分析推广到其他记忆设计维度——检索几条演示、选择哪层抽象(原始截图/区域裁剪/结构化文本/可执行脚本)、何时遗忘旧经验——形成统一的『记忆策略路由器』;三是引入在线学习,让偏好探针与路由器随记忆库增长持续更新并监测漂移;四是研究多模态记忆的软混合而非硬二选一,例如按 $r_i$ 的置信度动态拼接文本与图像证据;五是把『记忆模态是步骤级决策』这一结论推广到桌面/Web智能体乃至更一般的多模态智能体,检验其普适性;六是探索把偏好信号用于记忆库的写入端——决定哪些经验值得存、以哪种模态存。
复现评估
复现条件总体友好。论文声明代码与项目资源已公开(『Code and project resources are available here』),基础组件全部开源可得:执行器Qwen3.5-9B、检索器Qwen3-VL-Embedding-2B,以及AITW、LearnGUI、MobileMiniWoB++三个公开基准。附录B的细节相当完整:数据划分(AITW把2万步按轨迹切分为10,019个偏好查询步与9,981个记忆步、测试用759条held-out轨迹的5,000步;LearnGUI用101条成功在线演示轨迹共1,500步;MobileMiniWoB++用seed 1001建129步记忆库、seed 43的92个模板初始状态校准阈值、seed 42评测58/92,任务实例互不重叠)、采样配置(温度0.7、seeds 42–48、5-of-7一致性过滤)与超参(MLP 1024→256→1、GELU、dropout 0.1、AdamW lr 0.001、PCA 64维、统一用第31层)。算力上推理只需单卡RTX PRO 6000,路由器训练本身很轻;主要成本在偏好目标构建(每状态约14次采样前向)。整体难度中等:最费力的部分是各基准评分协议(步级动作匹配、在线闭环执行)的实现与对齐。
论文图表
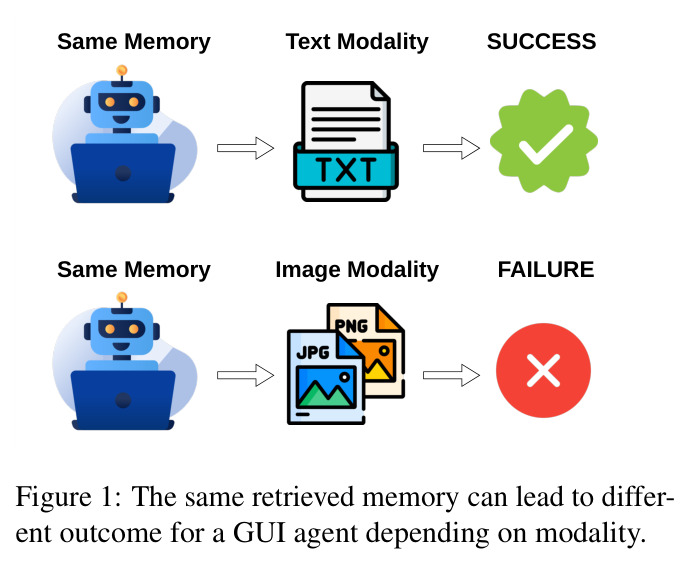
开场示意:同一份检索到的记忆,以文本模态呈现时智能体任务成功(SUCCESS),以图像模态呈现时任务失败(FAILURE),直观说明记忆模态本身就是一个会影响成败的变量。
用一图点题:模态选择不是工程细节而是实质决策,为全文『模态应逐步动态选择』的主张提供动机。
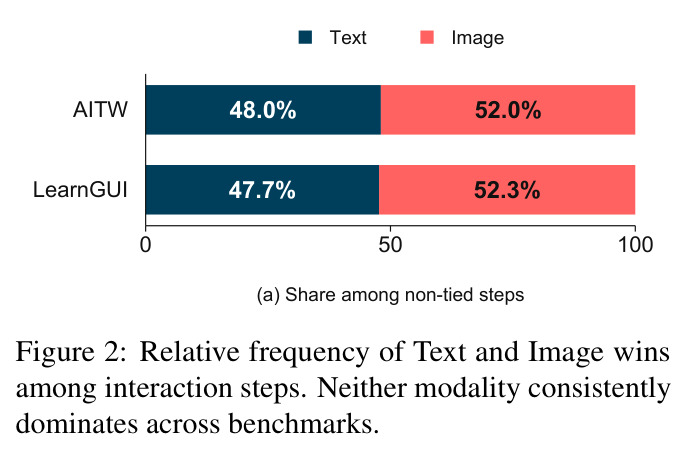
在非平局步骤中统计两种模态『获胜』的相对频率:AITW为文本48.0%/图像52.0%,LearnGUI为47.7%/52.3%。图像平均略优,但文本在近半步骤中更优。
这是论文核心论点的第一条实证证据:没有任何模态能一致占优,固定模态必然在大量步骤上选错。
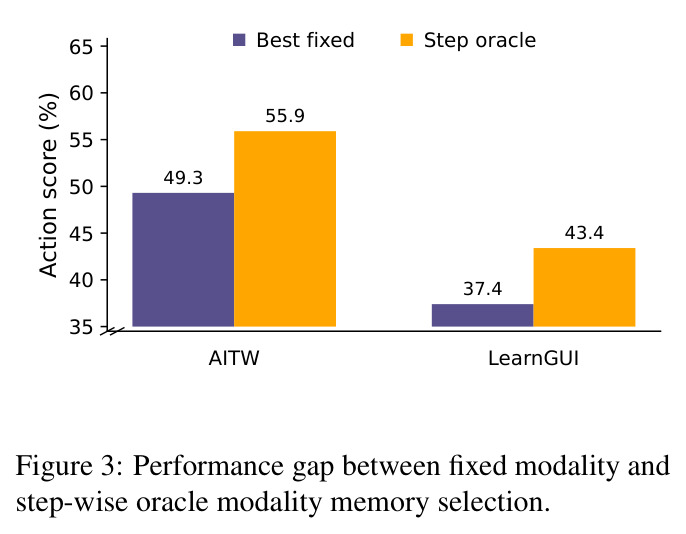
对比最强固定模态与逐步oracle(每步取两模态效用较高者):AITW从49.3提升到55.9(+6.6pt),LearnGUI从37.4提升到43.4(+6.0pt)。
量化了固定模态策略『留在桌上』的性能上限,是引入自适应路由的直接量化动机。