看见、维持与学习:多模态智能体记忆的演进 Seeing, Maintaining, and Learning: The Evolution of Multimodal Agent Memory
以双轴框架梳理297个多模态记忆架构与82个基准,刻画记忆从形成、维护到自我演进的完整生命周期。
前置知识
RAG(检索增强生成)
将模型参数与外部可查询信息源分离,推理时检索相关证据拼入上下文,使模型能访问参数知识之外的信息。标准 RAG 只解决'如何访问已存储的信息',不规定智能体如何从自身经验形成记忆、如何长期维护、如何依据后续交互修订记忆。
本文的智能体记忆是对 RAG 的推广:从外部知识检索扩展为持久经验管理。理解 RAG 的能力边界,才能看懂 Axis II 为什么要把存储、访问与更新拆开分析,以及 T1/T2/T3 分层的出发点。
记忆与上下文的区别
上下文是当前暴露给模型的输入信息;记忆是超出产生它的那一步仍然持久存在、并影响后续推理/生成/规划/动作的经验衍生状态。看一次就丢弃的图像只是观察,被存储并可复用的检索图像才既是记忆条目又是上下文。
论文用这一区分界定收录范围(排除瞬时激活与一次性思维链),也是三层记忆管理中'持久变化'这一核心概念的判定基准。
多模态表示与视觉 token
图像、视频、音频经编码器转为特征向量或离散 token(视觉 token、声学特征、体素地图等),再经投影器或交叉注意力供语言模型消费。这类编码保留了感知与时空结构,但压缩通常不可逆,且绑定特定的模型接口(投影器/Q-Former/策略网络)。
Axis I 中'源保持'与'模态专属编码'两类表示都建立在其上;理解其有损性与模型绑定特性,才能明白记忆形成中'恢复力 vs 紧凑性'这一贯穿全文的核心权衡。
结构化记忆:场景图与知识图谱
把经验组织为可寻址的实体节点、属性、关系与时空链接(如 3D 场景图 ConceptGraphs、多分辨率时序知识图谱 WorldMM),支持图遍历、关系传播与字段级更新,而非把每条记忆当独立文本段做相似度检索。
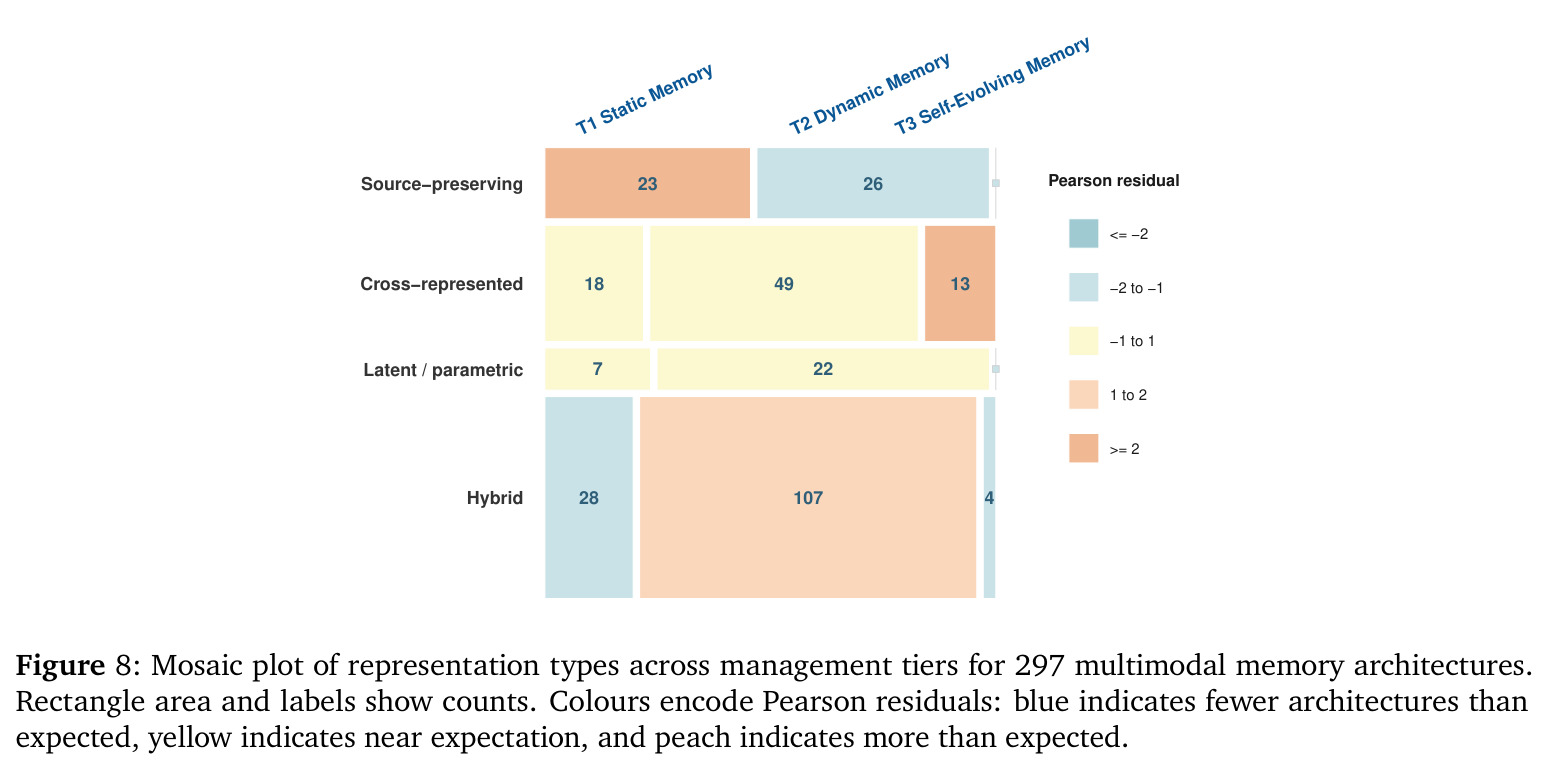
语料统计显示 17 个 T3 自演化系统全部依赖显式表示——可定位、可单独修订的图节点/记录单元是策略能从反馈中被识别和修改的前提。
KV 缓存与潜在状态记忆
Transformer 推理时注意力的键值中间态(KV cache)可被有意保留并跨请求复用;更一般地,隐藏状态、记忆 token、快慢双速循环状态等连续向量可作为持久潜在记忆,经注意力或残差连接融入后续计算,免去重复编码原始观测。
它是 Axis I 第三族(内部化潜在记忆)的技术基础,也是第 6 节系统基础设施(前缀复用、卸载、恢复、失效)讨论的对象,连接了逻辑记忆与真实运行时。
LoRA 与参数化记忆
用低秩适配器等参数高效模块把经验写入权重:冻结主干,为每个视频或任务生成独立 LoRA(如 Frames2LoRA 由超网络一次前向生成视频适配器、VLA-Pro 维护可按相似度组合的任务适配器库),推理时影响输出而无需重放原始观测。
参数化记忆是 Axis I 上离源证据最远的一端,其不可检视、易干涉遗忘的特性直接支撑了论文'表示选择约束管理能力'的中心论点,也解释了为何纯参数系统中找不到 T3 自演化。
研究动机
基础模型驱动的智能体正从单轮预测走向跨越多会话、数小时乃至数周的长时程交互,后续决策依赖的不再是当前上下文,而是累积的经验与状态。文本智能体已有较成熟的记忆方案(MemGPT 的分层记忆、MemoryBank 的遗忘曲线、Reflexion 的语言化教训、Voyager 的技能库),但真实世界智能体要处理图像、长视频、语音、GUI 截图与具身 3D 观测:这些经验高维、连续、异构,无法像文本那样无损压缩成可直接编辑的记录。两个具体困难随之出现。形成阶段要决定记住什么、以什么粒度切分(一帧、一个事件、一条物体轨迹还是完整回合)、用什么形式保存(源媒体、特征、文本摘要、结构图、潜在状态还是参数)——每种选择都在保真、成本、可编辑性与可恢复性之间做交换。管理阶段则要在新证据不断到来时保持记忆有效:家庭机器人记住'马克杯在上层架子'后物品被移走,旧记忆若不更新就会误导动作;而同一经验常同时存于源图像、文本摘要、结构化状态等多重表示,跨表示的一致性维护让问题更难。现有系统各自为战,缺乏统一框架来回答'记什么、怎么表示、在哪里适应'。
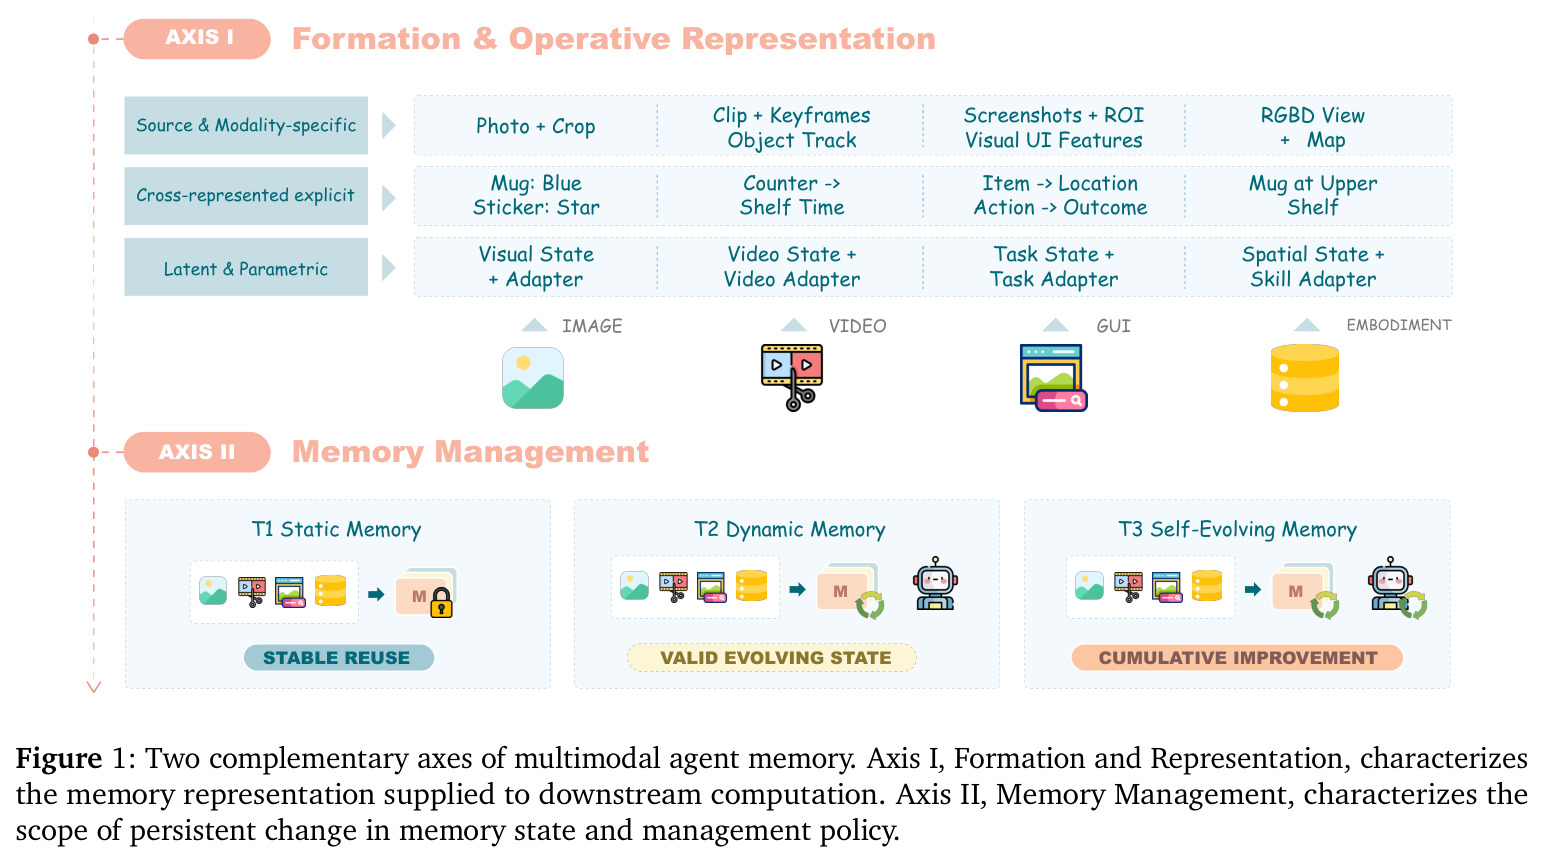
本文的目标是本文要为多模态智能体记忆建立一个统一的分析框架,把分散在图像/文档、视频/视听流、音频/语音、GUI 交互和具身/3D 环境五个领域的工作纳入同一坐标系,回答两个耦合的问题:多模态经验如何形成并以何种表示供给下游推理(Axis I:形成与表示),以及经验累积时持久适应发生在哪里(Axis II:记忆管理)。在此框架上,论文构建了含 297 个记忆架构与 82 个基准记录的语料库,综合出可复用的设计原则——源保真与抽象的平衡、时间有效性与来源追踪、记忆使用需可恢复的证据支撑、管理策略随经验演化——并系统梳理系统基础设施(存储、调度、一致性)、评测覆盖缺口与未来方向,为这个快速膨胀的领域提供一张导航地图。
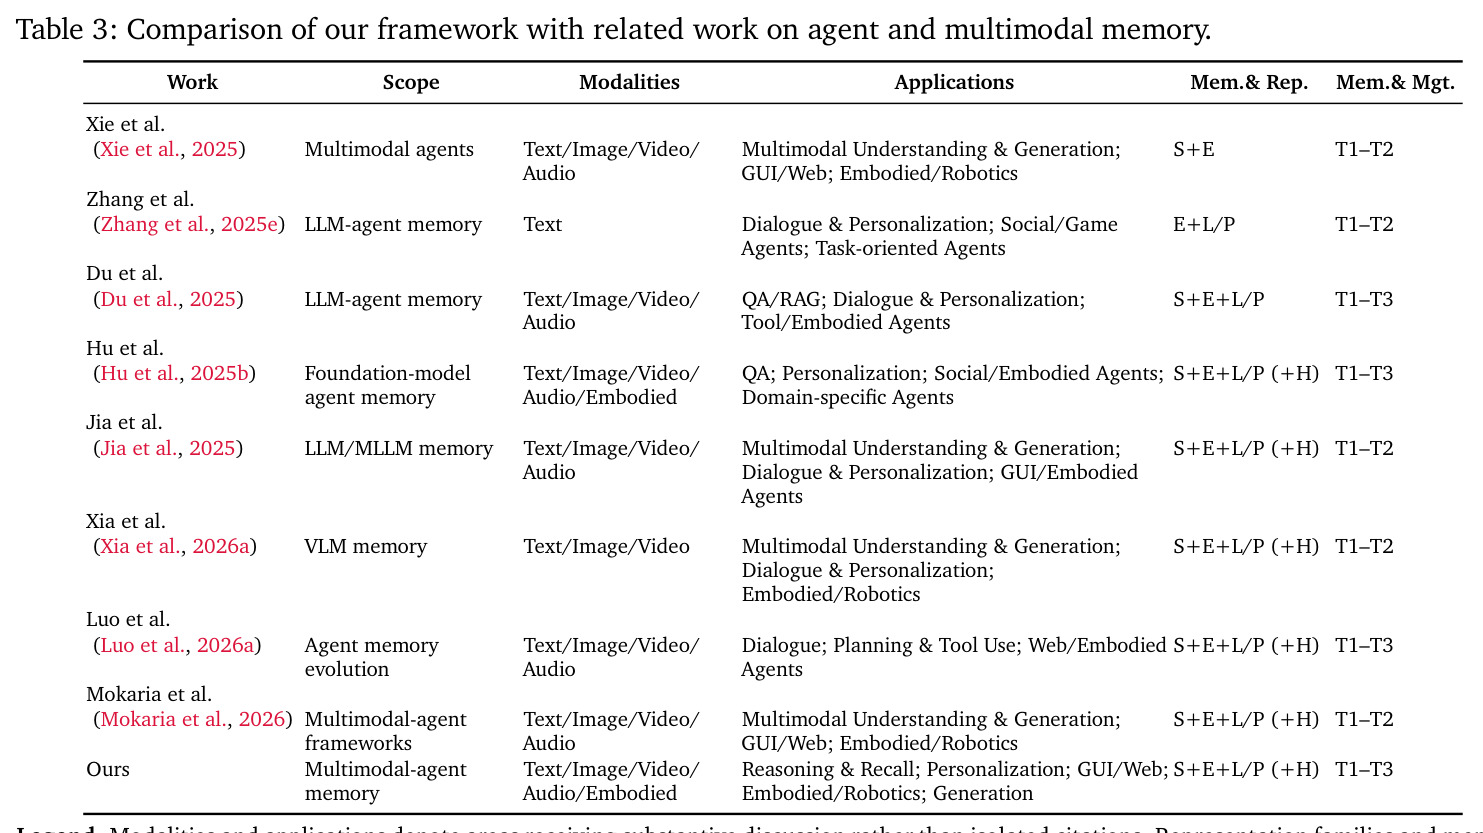
与已有工作不同的是,已有的智能体记忆综述多按来源、表示、功能、时间范围或操作对'记忆组件'做静态分类(如 Zhang et al. 2025e 面向文本 LLM 记忆、Hu et al. 2025b 面向基础模型记忆、Xia et al. 2026a 面向 VLM 记忆),或只覆盖多模态智能体的架构与基准清单(Xie et al. 2025)。本文的独特切入有三:其一,把分析单元从记忆组件换成'操作生命周期'——经验如何变成持久记忆、表示如何约束后续检索/修订/验证/撤销;其二,首次以'部署期持久变化的范围'划分管理层级,明确区分'记忆状态更新'与'管理策略演化'这两个文献中常被混用的概念,并给出形式化定义;其三,联合分析两轴,得到单轴分析看不到的语料级规律——例如部署期策略演化极其稀缺、且只出现在含显式表示的系统中,混合表示已成主流设计模式。
核心方法
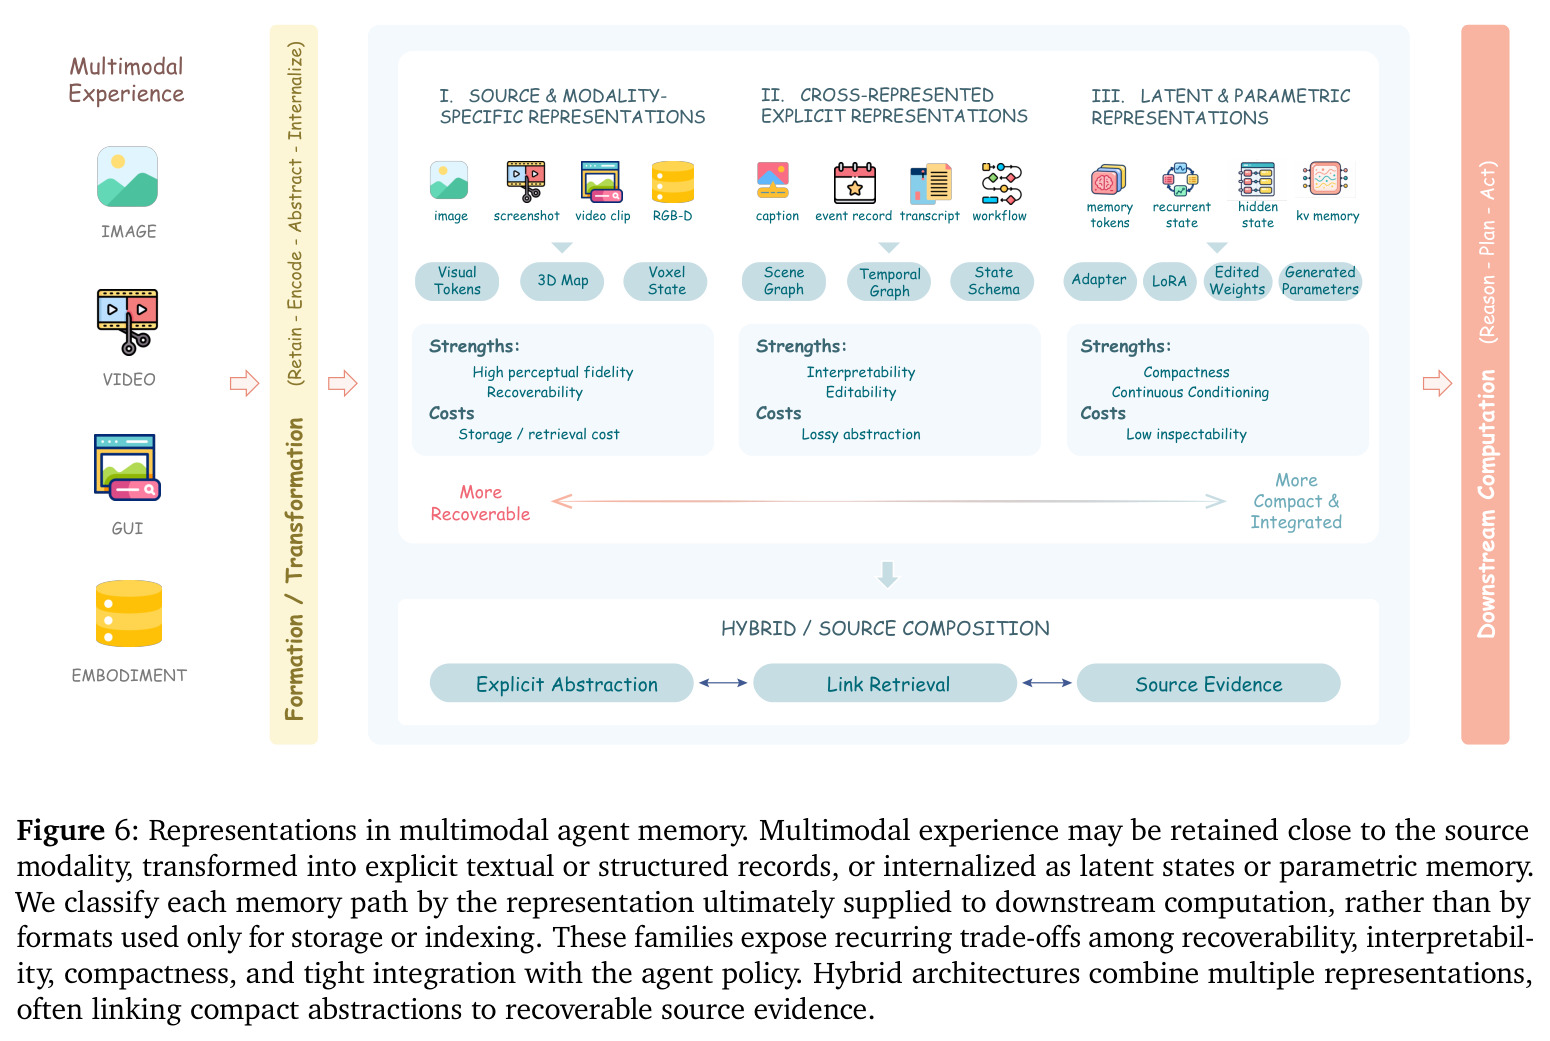
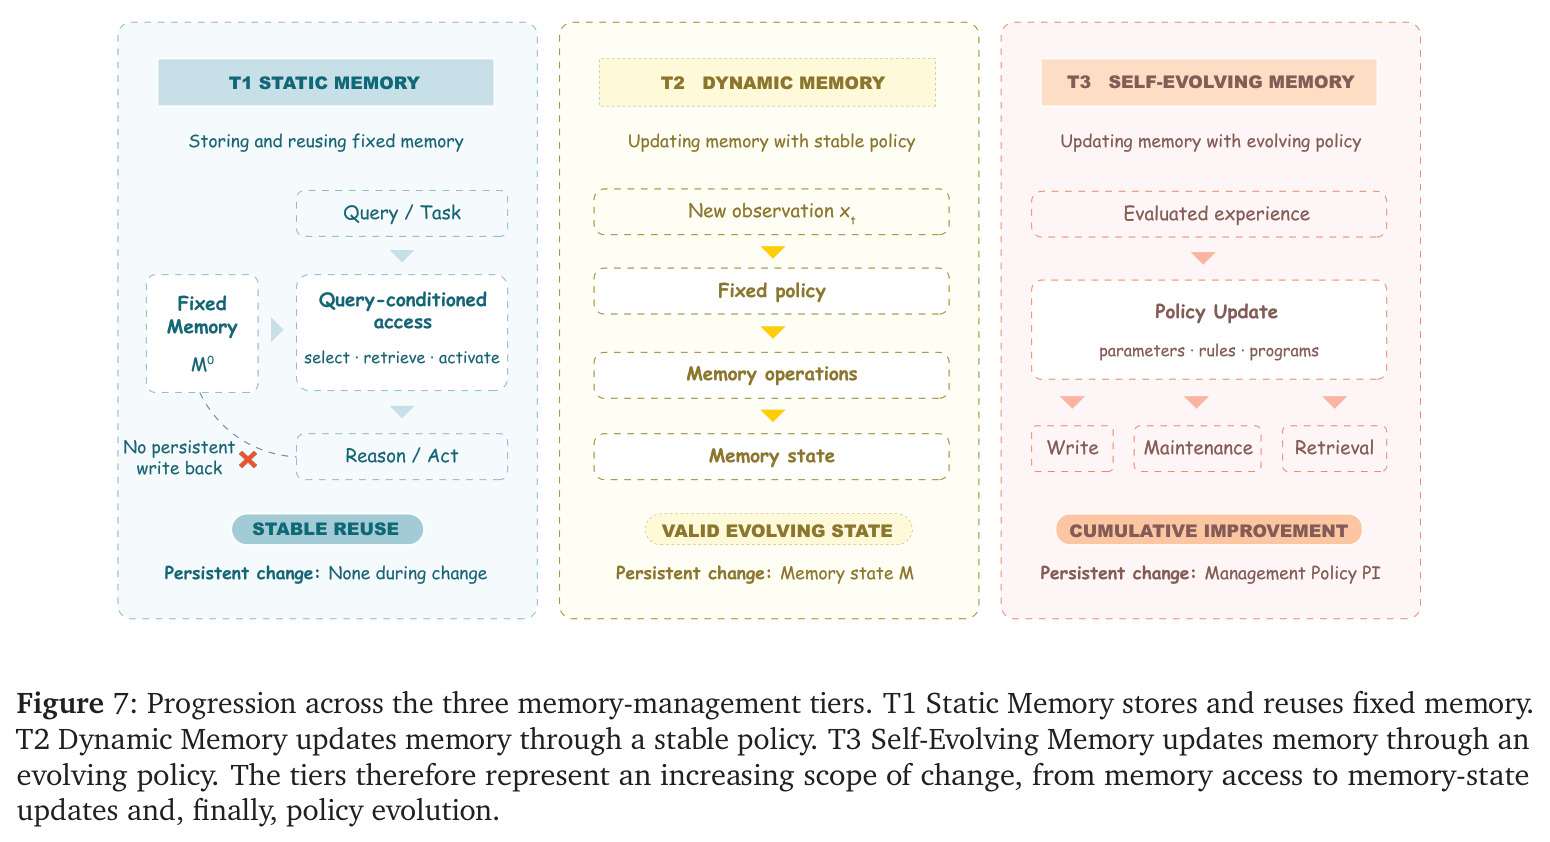
直觉上,多模态记忆像一座图书馆:采购编目决定哪些资料进馆、以何种形态上架(原片、摘要还是缩微胶片),馆藏管理决定资料如何被借阅、修补、合并与淘汰,更进一步还能根据借阅反馈改进采购与管理制度本身。对应地,论文提出两轴框架。Axis I(形成与表示)按最终供给下游计算的表示(而非仅作索引的格式)把系统分为源保持/模态专属、交叉表示显式记忆、内部化潜在/参数记忆三族,外加作为系统级组合的混合/源链接架构。Axis II(记忆管理)按持久变化范围分三层:T1 静态记忆构建一次后只复用;T2 动态记忆以稳定策略更新记忆状态;T3 自演化记忆进一步用反馈更新管理策略本身。技术上,作者以此为编码手册对 297 个架构逐一标注(每个架构归入其支持的最高管理层级与表示类别),对 82 个基准标注六项共享能力与各模态专属能力,再通过马赛克图与 Pearson 残差做跨轴统计,并单独用一章把逻辑设计映射到物理存储、数据搬运、索引调度与一致性等系统机制。
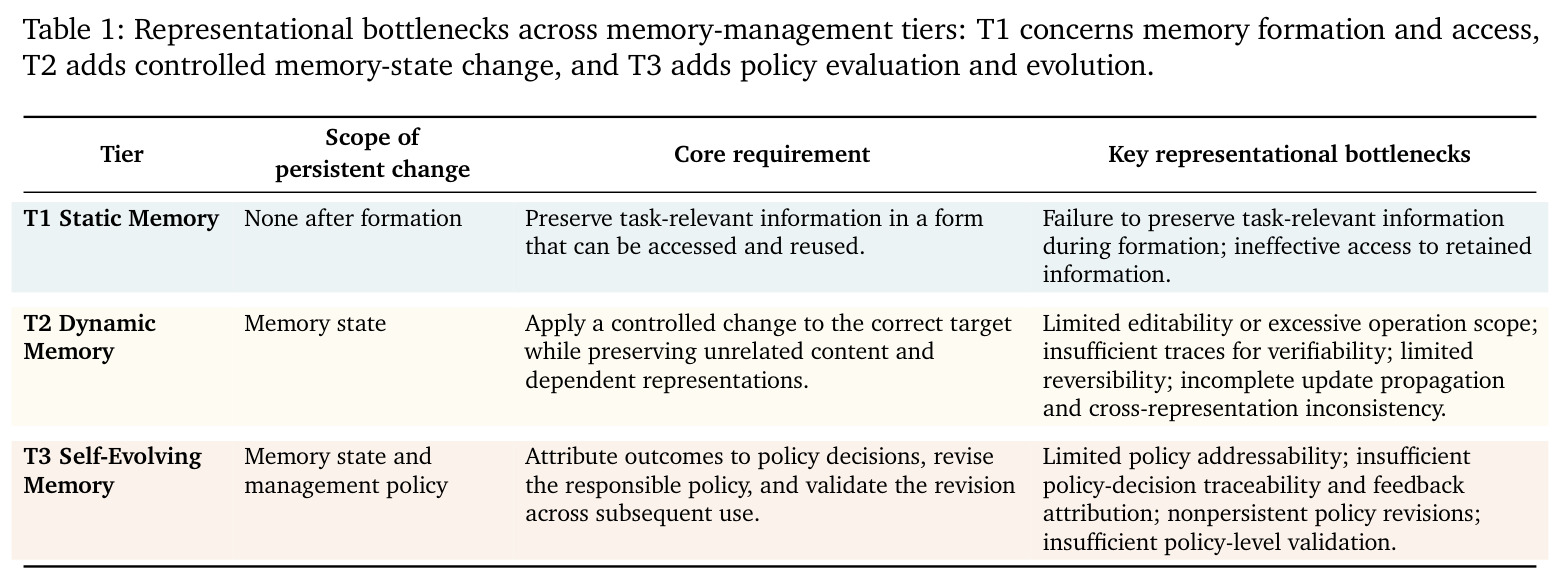
核心创新是'以持久变化范围定义管理层级'的形式化。设 $M_t$ 为记忆状态、$\pi_t$ 为管理策略、$x_t$ 为当前经验、$f_t$ 为任务结果/验证器判断/用户反馈,T2 只执行 $M_{t+1} = U_{\pi_t}(M_t, x_t)$ 而保持 $\pi_t$ 稳定;T3 则追加 $\pi_{t+1} = E(\pi_t, f_t)$,让策略本身跨任务持久演化。这一区分切中文献的普遍混淆:更新检索键、改写技能描述、累计使用统计都只改变后续检索结果,策略的选择机制未变,属于 T2;只有反馈持久修改了可复用的规则、指令、工作流、程序或学习到的策略组件才算 T3。第二个关键思想是表示与管理联合分析:T2 要求记忆可编辑、可验证、可逆、更新可传播,T3 还要求策略可寻址、反馈可归因、修订持久且经验证——这些逐层递加的'表示需求'解释了一个 otherwise 费解的统计事实:纯潜在/参数记忆系统中找不到任何 T3 自演化系统。
方法步骤详情
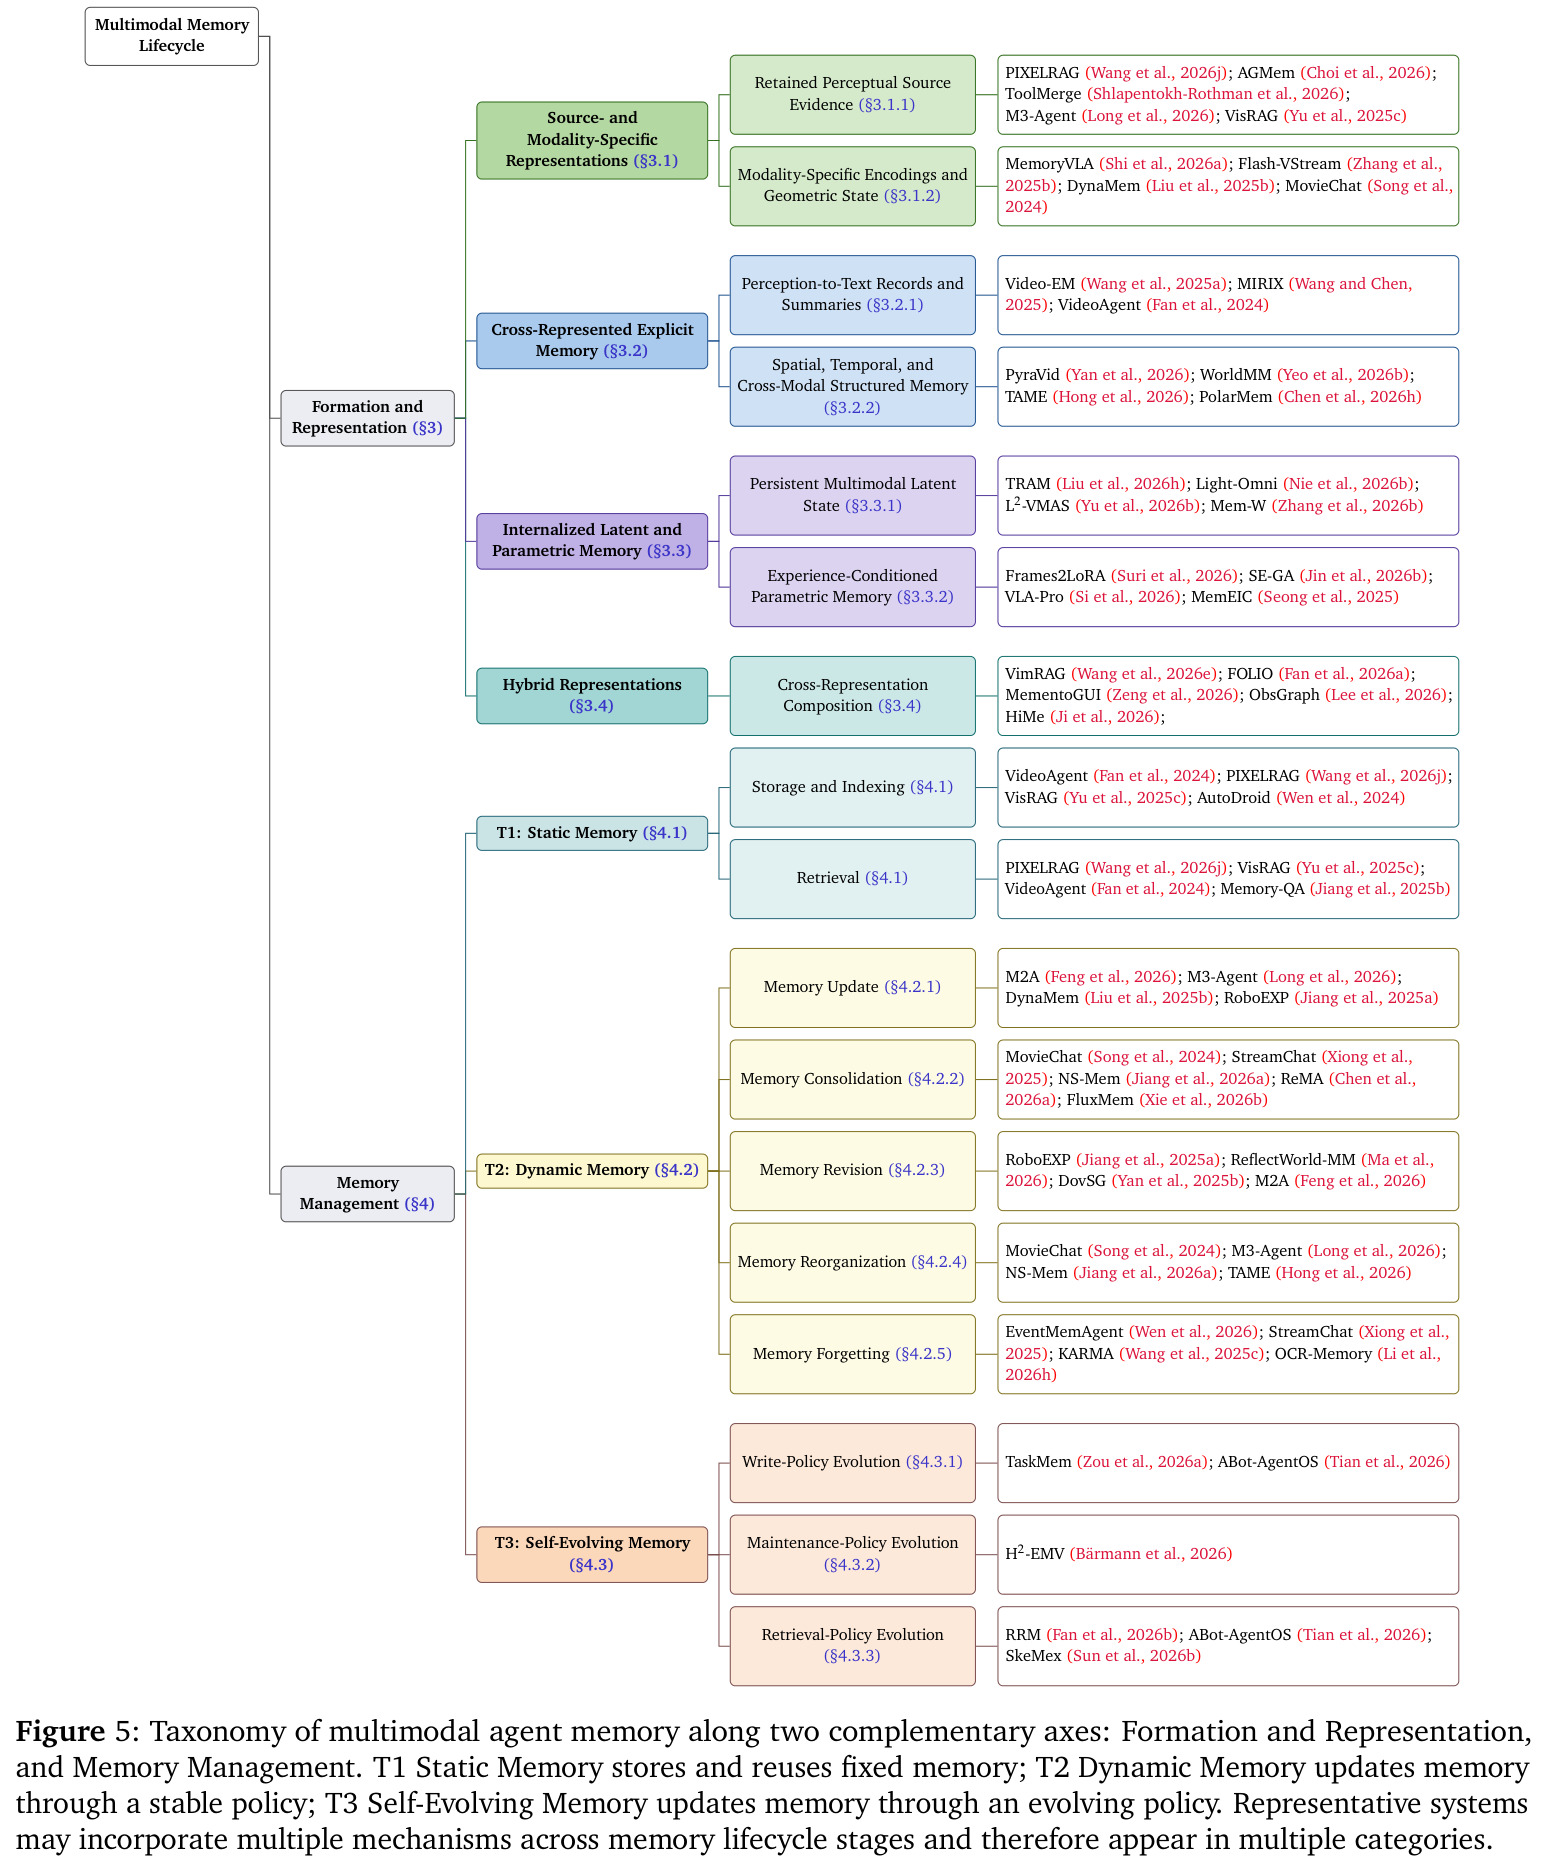
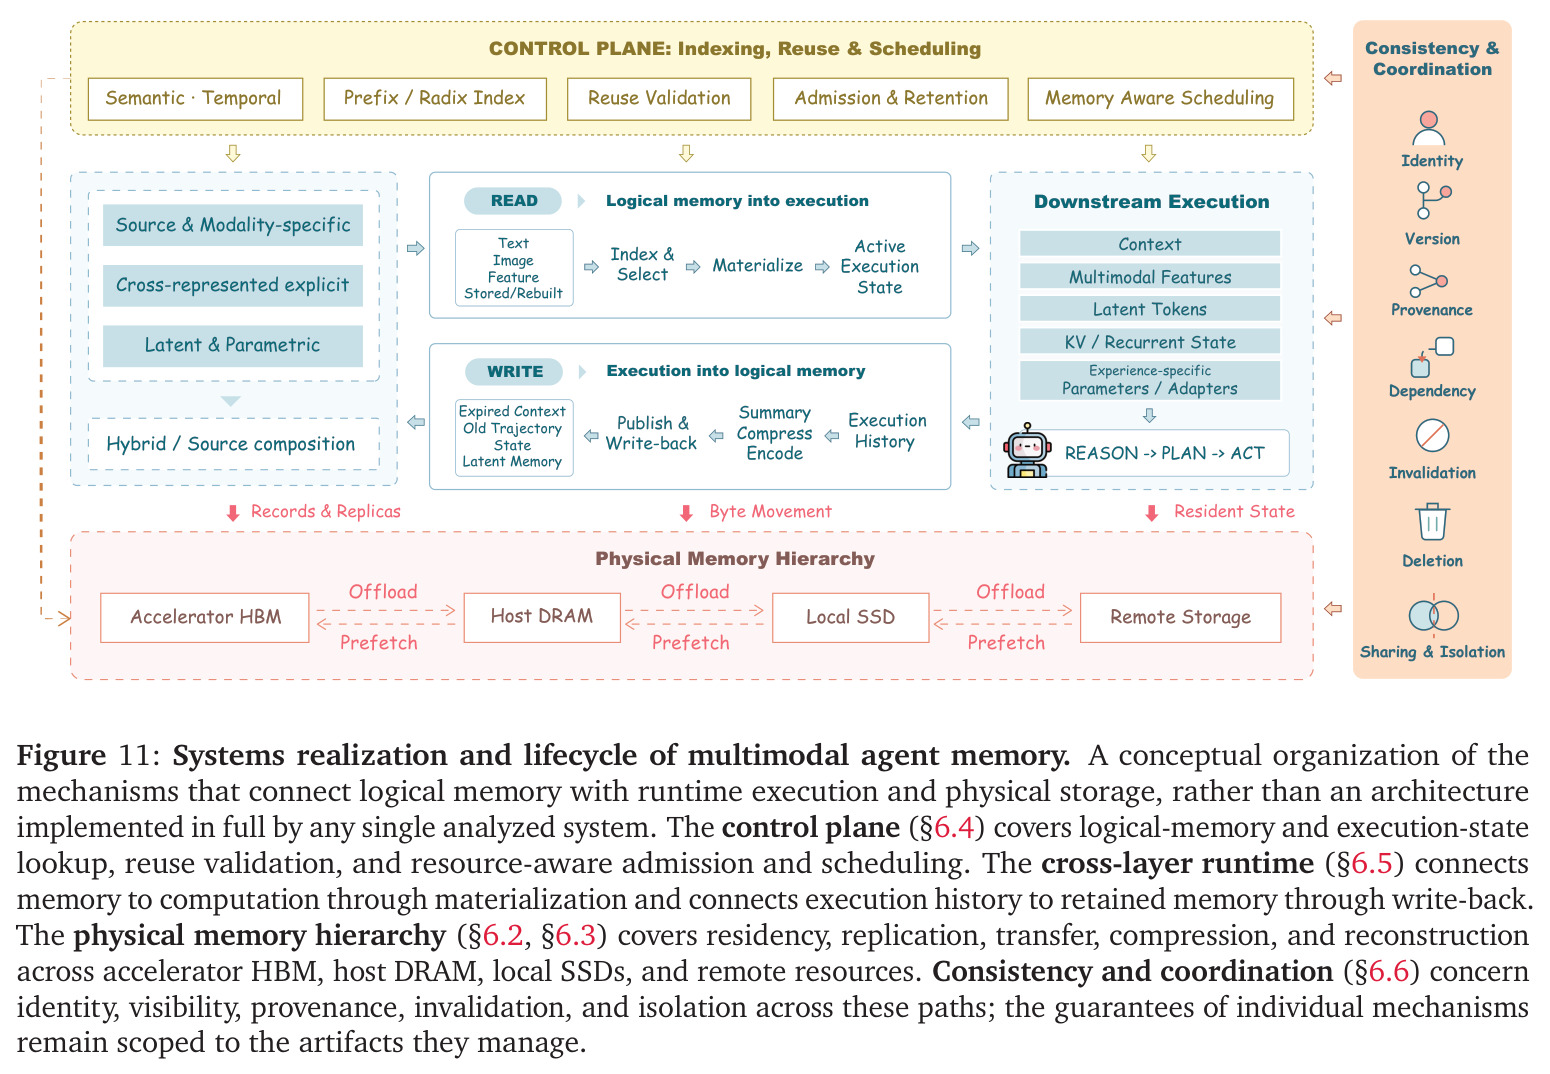
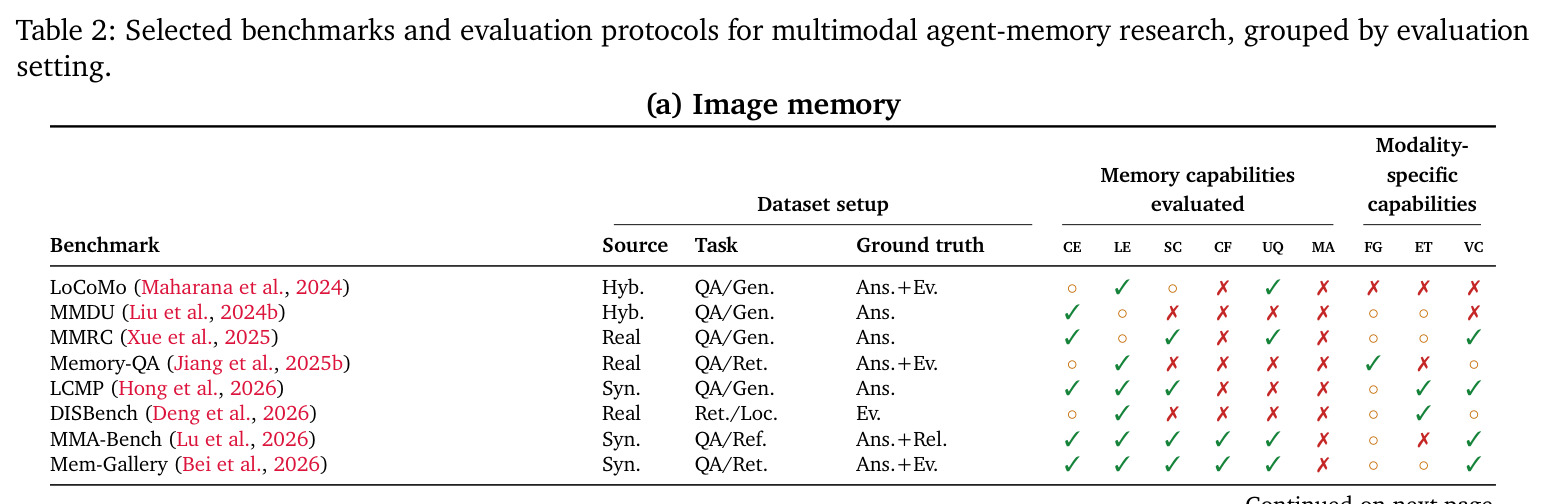
论证分六步。第一步界定范围:记忆定义为'超出产生它的步骤仍持久存在并影响后续推理/生成/规划/动作的经验衍生状态',至少一种非文本模态参与其形成或使用,排除瞬时激活与一次性思维链。第二步按 Axis I 编码:源保持证据(PixelRAG 截图块、HippoMM 视听事件)、模态编码与几何状态(Flash-VStream 视频 token、DynaMem 体素地图)、感知到文本(Video-EM 事件记录、MIRIX 六类组件)、时空跨模态结构(ConceptGraphs 场景图、PolarMem 极化图)、持久潜在状态(TRAM 快慢循环状态、ReKV 视频 KV)、参数化记忆(Frames2LoRA 视频 LoRA、VLA-Pro 适配器库)。第三步按 Axis II 编码:T2 细分为更新、巩固、修订、重组、遗忘五种操作,T3 细分为写、维护、检索三类策略演化。第四步交叉分析:给出各层表示瓶颈与 297 架构的层×表示统计。第五步系统映射:存储驻留、数据搬运压缩、索引调度、物化写回、一致性协调。第六步评测审计:82 个基准按六共享维度加模态维度标注,统计覆盖缺口。
技术新颖性
新颖性体现在四点。第一,生命周期视角:此前综述以记忆类型或组件为分类单位,本文以'什么信息活到未来计算、适应发生在哪'为单位,使 MemGPT 式上下文管理、Voyager 式技能库、Reflexion 式反思记录能在同一坐标下比较(Table 3 显示本文是唯一同时覆盖五模态、四类表示与 T1–T3 全谱系的综述)。第二,T2/T3 边界的形式化与实证:把它变成可检验的结构性事实——297 个架构中仅 17 个(5.7%)达到 T3,且全部依赖显式表示,纯源保持与纯潜在/参数类别中一个都没有,把'自演化记忆很稀缺'从印象变成统计结论。第三,把系统基础设施纳入记忆理论:KV 驻留、前缀复用(RadixAttention、Preble、Mooncake)、物化与写回、跨层一致性通常属于模型服务文献,本文论证逻辑记忆与物理驻留必须区分——层间迁移不等于逻辑重组、缓存命中不等于记忆有效、物理淘汰不等于语义遗忘。第四,提出最小来源包、表示感知预算、生命周期感知评测(形成/维护/访问/使用四阶段)等可操作概念,直接指向后续系统与基准设计。
实验结果
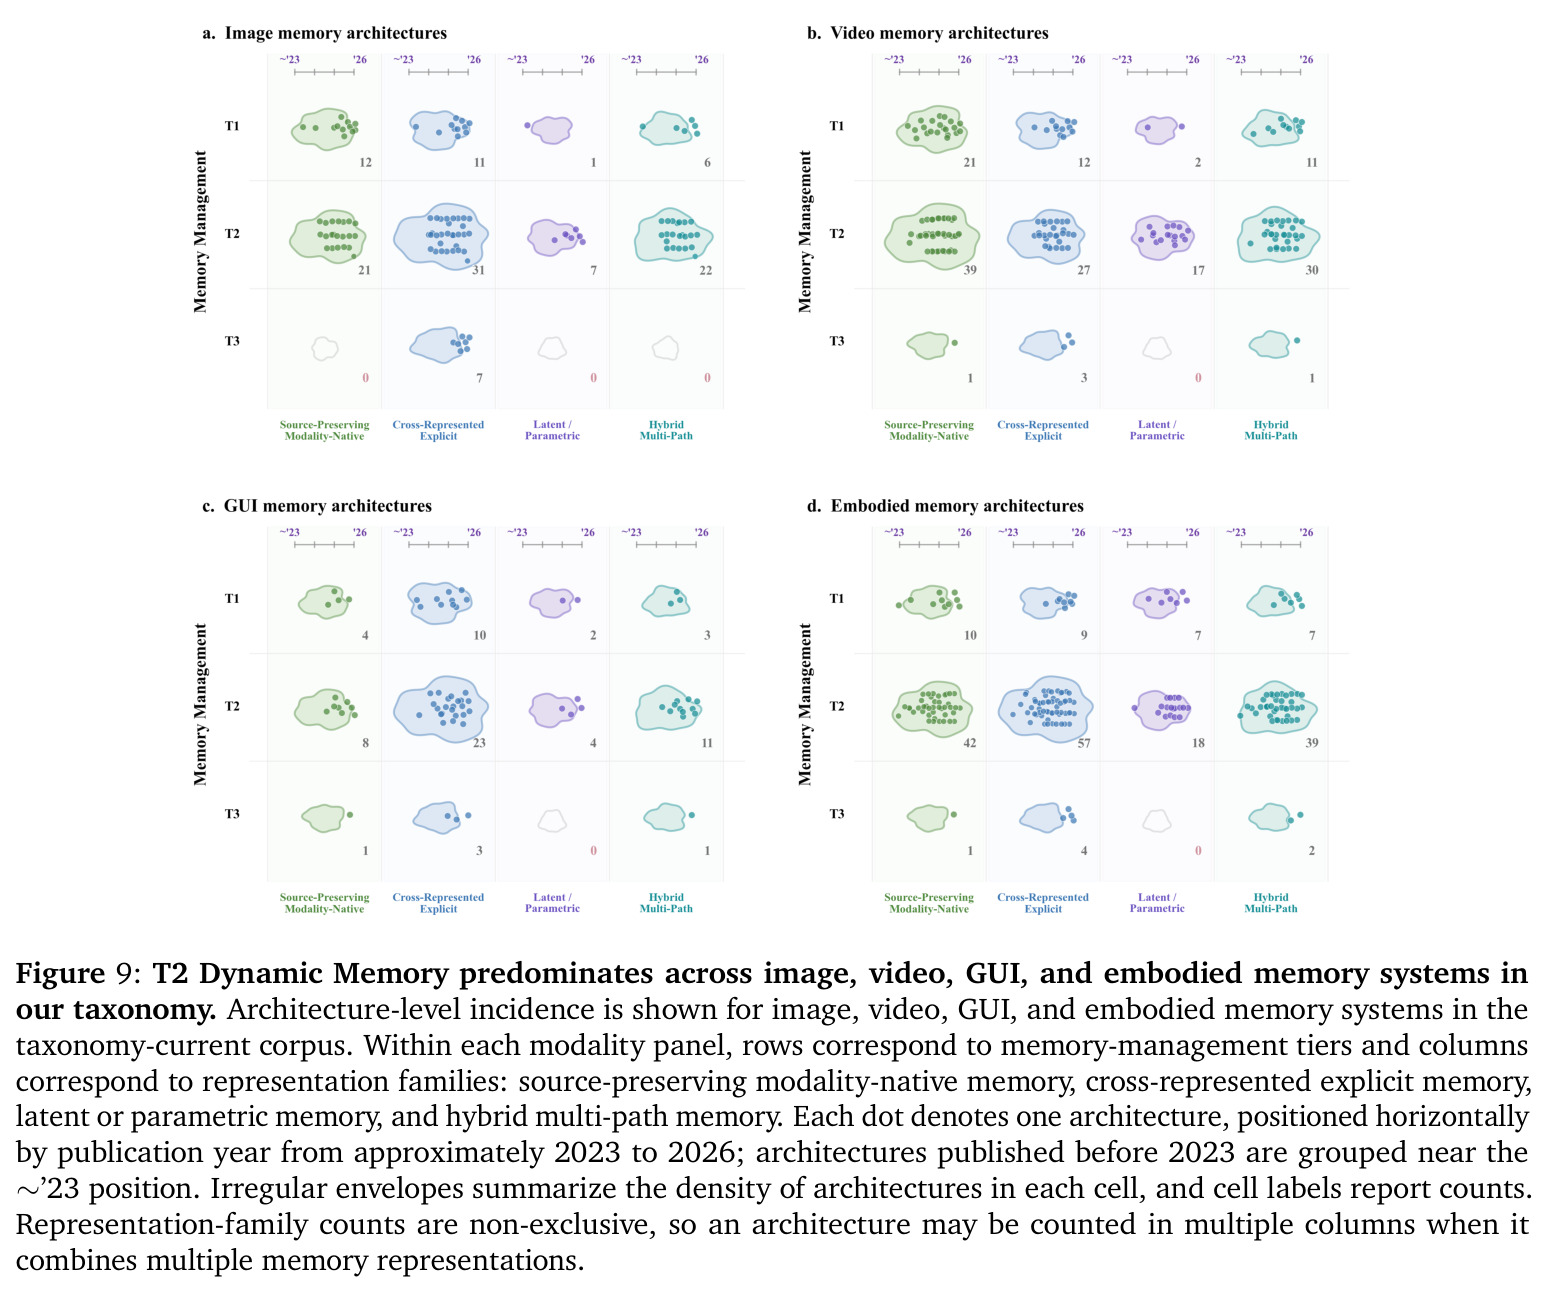
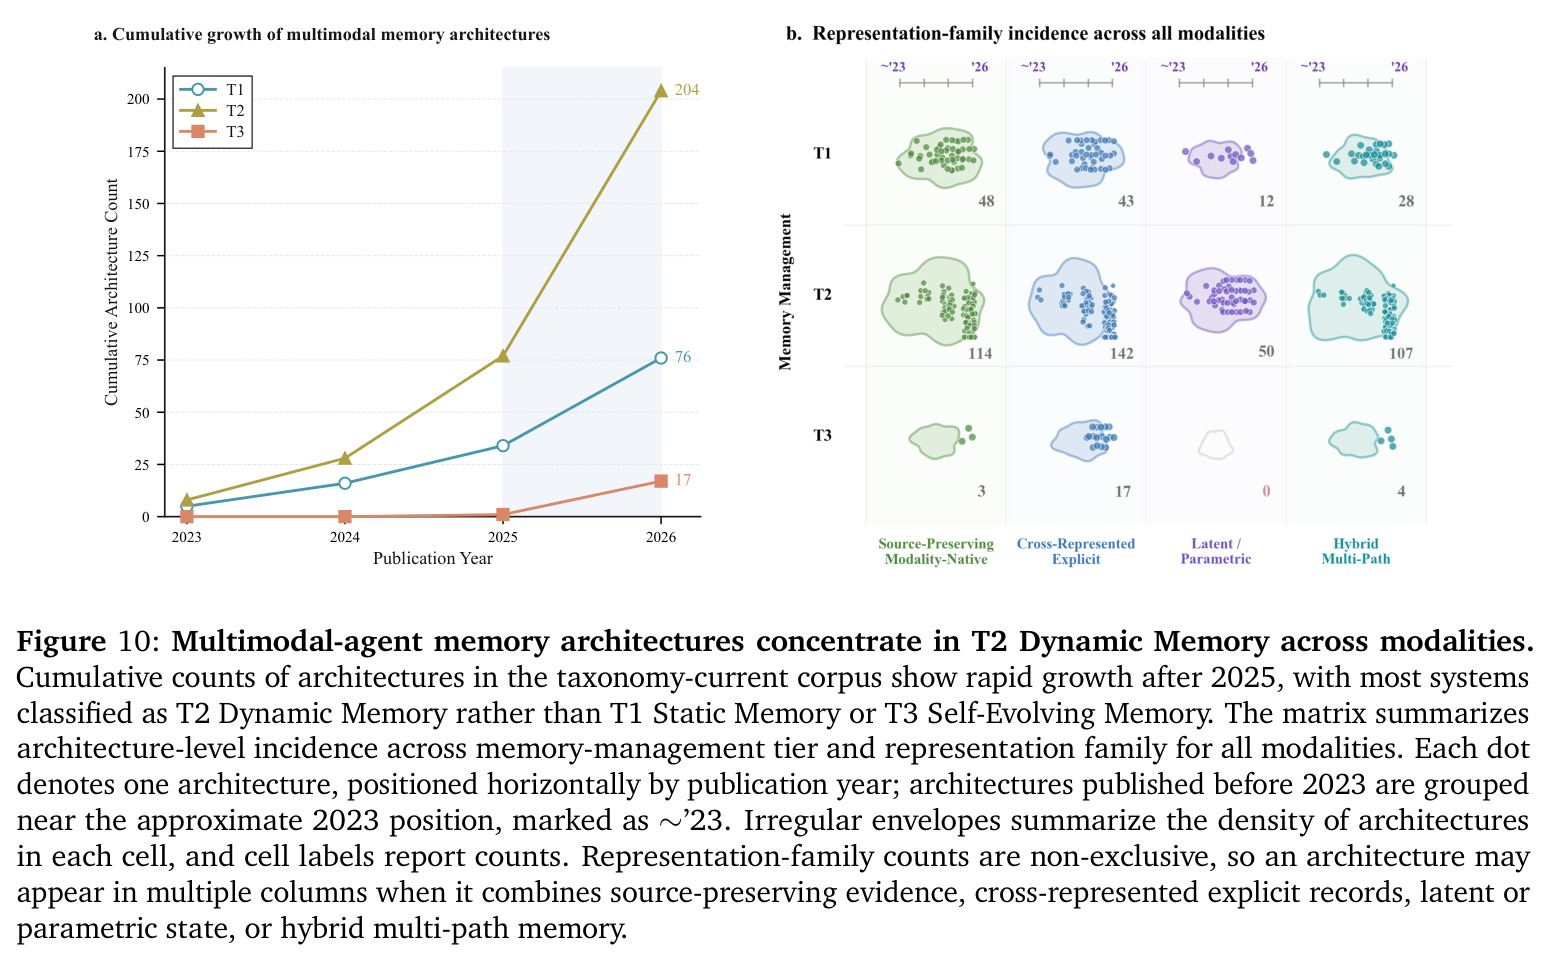
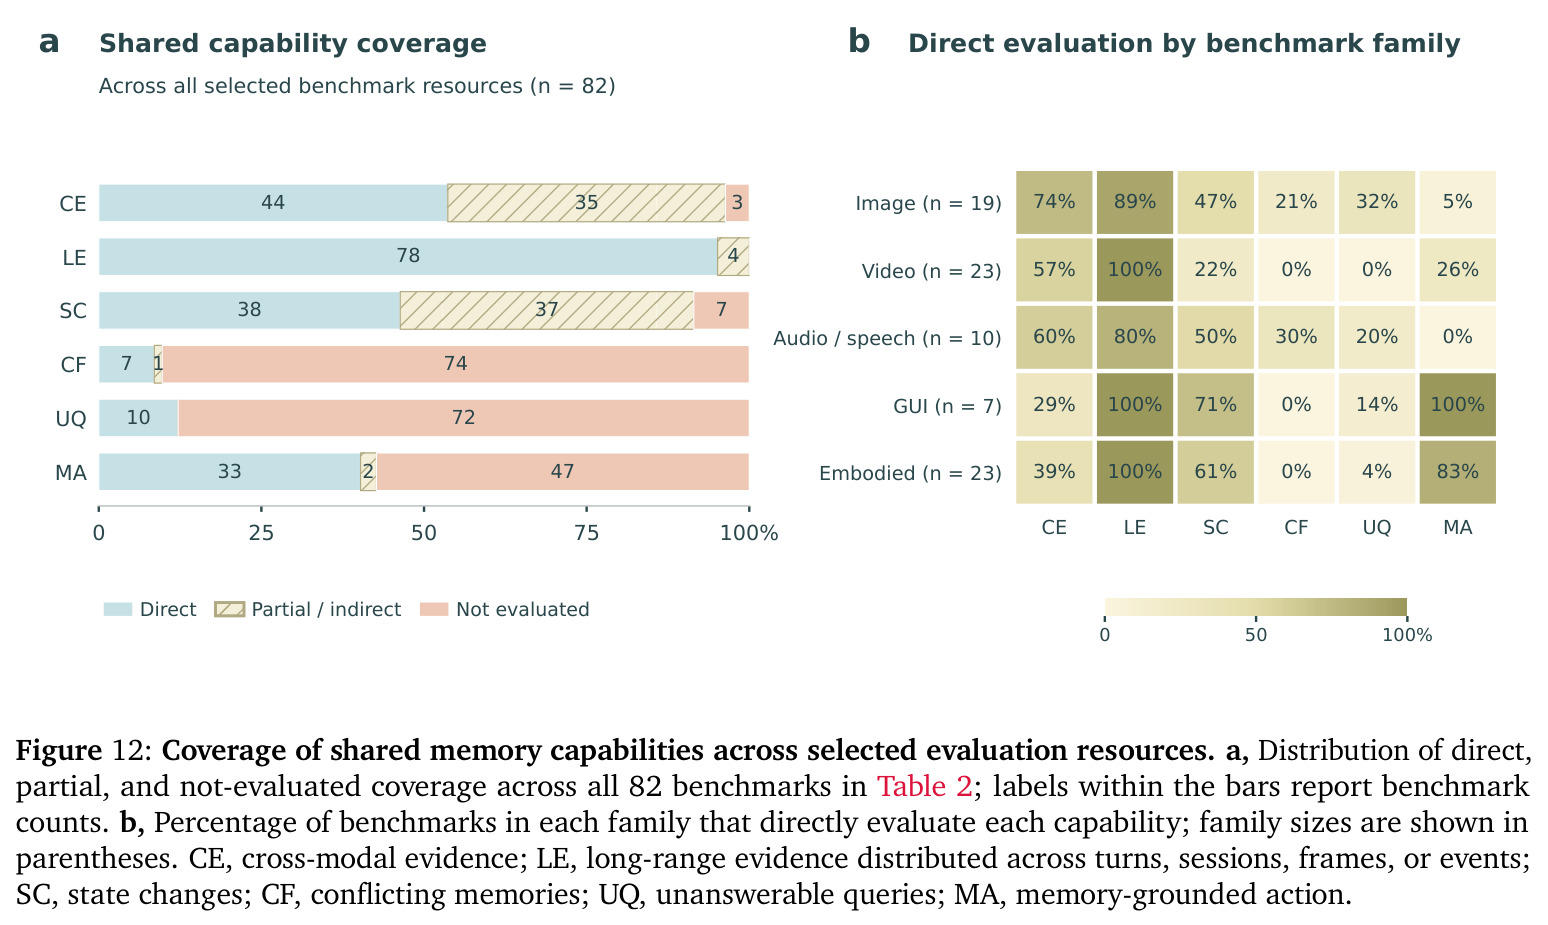
语料统计给出三个结构性发现。其一,动态更新是绝对主流:297 个架构中 221 个(74.4%)在运行期更新状态或策略,其中 T2 动态记忆 204 个(68.7%)、T1 静态 76 个(25.6%),T3 自演化仅 17 个(5.7%)。其二,混合表示最普遍:139 个(46.8%)架构组合多种表示,为最大单一类别。其三,策略演化只发生在显式记忆上:17 个 T3 系统中 13 个是交叉表示显式系统、4 个是含显式组件的混合系统,纯源保持与纯潜在/参数类别均为零。基准审计(82 个)发现严重不均衡:长程证据 LE 78 个直接覆盖(95%)、跨模态证据 CE 44 个(54%)、状态变化 SC 38 个(46%)、记忆支撑动作 MA 33 个(40%),而不可答查询 UQ 仅 10 个(12%)、冲突记忆 CF 仅 7 个(8.5%),视频/GUI/具身家族对 CF 的直接覆盖率均为 0%。时间尺度从 M3-Bench 约半小时到 EgoMonth 的 20–120 天,但连续部署协议仍缺位;增长上具身与视频最陡,音频/语音最稀疏。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多模态记忆架构统一盘点 | 语料覆盖规模 | 297 个架构(Axis I 表示 × Axis II 层级双重标注)+ 82 个基准记录 | Hu et al. 2025b、Xie et al. 2025、Du et al. 2025 等先前综述为定性分类,无统一量化语料 | 首个可量化、可复用的双轴生命周期分类语料库 |
| 记忆管理层级分布测量 | 各层级架构占比 | T1 76 个(25.6%)/ T2 204 个(68.7%)/ T3 17 个(5.7%) | 先前工作未区分'记忆状态更新'与'管理策略演化',无对应统计 | 首次量化部署期策略演化的稀缺性(仅 5.7%),确立自演化为核心缺口 |
| 表示类型 × 管理层级交叉分析 | 混合系统占比与 T3 系统表示构成 | 混合 139/297(46.8%);17 个 T3 中 13 个为显式交叉表示、4 个为含显式组件的混合,纯潜在/参数为 0 | 无先例(单轴分析在结构上无法观察到该模式) | 揭示显式可寻址单元是策略演化的前提,为潜在/参数记忆指出'语义可寻址化'方向 |
| 基准能力覆盖审计 | 直接评估某能力的基准数占比 | LE 78/82(95%)vs CF 7/82(8.5%)、UQ 10/82(12%)、MA 33/82(40%);CF 在视频/GUI/具身家族直接覆盖率为 0% | 各基准论文只报告自身任务设定,无跨基准统一能力标注 | 系统定位冲突记忆、不可答查询、记忆支撑动作三大评测盲区,指出检索型任务覆盖远好于状态维护与冲突处理 |
| 长时程评测时间尺度梳理 | 评测覆盖的时间跨度 | 梳理出 M3-Bench(约 0.5 小时)→ StreamArena(小时级)→ EgoLife(1 周)→ EgoMonth(20–120 天)的梯度 | 此前长视频评测多停留在分钟级、且多为离线冻结式查询 | 指出评测与持久助手时标仍差数个量级,连续部署协议与资源预算约束缺位 |
局限与改进
作者坦承的局限:taxonomy 标注存在主观性,架构可能横跨多个类别(Figure 5 中代表系统同时出现在多类),每个架构只归入其'最高支持层级'会低估其低层能力;82 个基准是按'评估相关性'的筛选而非穷举,文本型协议(如 CarMem)仅作对照;音频/语音领域本身研究稀疏,相关结论外推性弱。我补充几点观察:第一,T2/T3 边界在边缘案例上依赖对'策略'的定义——SE-GA 通过 RL 更新 LoRA 策略组件算 T3,普通微调后部署的冻结策略算 T2,实践中这条线并不总是清晰,标注者间信度存疑;第二,纯统计的语料分析不运行任何系统,无法回答'哪种表示/层级在具体任务上更优',两轴框架是描述性地图而非预测性理论;第三,大量被引系统为 2026 年预印本、未经社区检验,5.7% 这类比例会随领域成熟快速变化;第四,'质量-资源前沿'只有定性讨论,缺少跨系统统一成本测量,第 6 节的各系统机制来自不同假设,其可组合性恰是作者自己承认的未解问题。
独立分析的弱点
独立分析的弱点与改进方向:(1)T3 的反馈归因是最大瓶颈——写入/合并/遗忘决策的后果延迟且跨模态显现(视觉写入的记忆被后来的文本指令证伪),任务级奖励无法定位该改哪个策略组件;改进方向是为记忆决策建立决策-结果追踪记录,做跨时间、跨模态的信用分配。(2)潜在与参数记忆不可寻址、不可验证、不可逆:更新可能波及无关知识且无法检视;改进方向是结构化潜在记忆(持久状态绑定可识别槽位/实体)与模块化适配器库(VLA-Pro 已示范按需组合)。(3)遗忘与验证存在结构性冲突:保留版本史利于纠错却妨碍删除——信息扩散到摘要、嵌入、图节点、参数后难以保证语义擦除(MemLeak 基准正测此点);改进方向是把遗忘定义为跨表示结果并给出可验证的完成边界。(4)评测与架构脱节:74.4% 的系统在运行期更新状态,却几乎没有基准验证部署反馈能否产生持久的策略改进;改进方向是四阶段生命周期协议加显式资源预算。(5)系统层保证不能组合:引用计数、删除位图等单点机制各有边界,跨源媒体/语义记录/索引/执行状态的原子发布与撤回传播仍是开放问题。
未来方向
作者提出的方向:为形成记忆定义'最小来源包'(记录记忆从哪来、如何产生、由什么证据支撑),把来源当作表示的一部分而非可选元数据;显式建模时间有效性(当前/历史/被取代/不确定等状态标记,而非仅靠时间戳);把策略演化从检索扩展到写入与维护(当前 T3 集中在检索,因反馈最直接);选择性证据保留(轻量来源常备,昂贵源证据只为高影响修订保留);评估策略更新时监控证据路径是否被削弱,防止'准确率不变但隐性失去视觉接地'的退化;表示感知的预算管理;治理遗忘(跨表示删除并协调与可逆性的张力);生命周期感知评测(gold 记忆点覆盖率、幻觉写入率、证据召回/精度、反事实移除检验记忆的因果作用);长时程资源感知评测(报告记忆尺寸/增长率、写入滞后、检索延迟,区分冷热缓存);真实部署协议(实时截止、感知损坏、跨用户隔离、持续世界变化);基础设施层为身份/版本/来源/兼容性/生命周期建立互操作契约(承接 MemOS、MemoryOS)。可延伸的:多智能体共享记忆的一致性与权限模型;被遗忘权在参数记忆中的实现;把 T3 形式化为推理时策略学习并与 test-time RL 建立联系。
复现评估
作为综述,复现成本极低:无训练、无算力需求,论文脚注给出 GitHub 组织 Seeing-Maintaining-Learning/multimodal-agent-memory-evolution 作为项目主页,297 架构与 82 基准的标注语料随 taxonomy 当前版本发布,读者可直接复用分类或在其上追加标注。理解门槛主要在广度——需熟悉 RAG、KV 缓存、LoRA、场景图、serving 系统等多领域概念,对单一方向研究者是很好的补课地图。若要复现其统计(马赛克图、层×表示分布),需按作者规则把每个架构归入'最高支持层级'与表示类别,这一步含人工判断,不同标注者在 T2/T3 边界案例上可能得到略不同的比例。被引系统中 MemGPT、Generative Agents、MemoryBank、Voyager、ConceptGraphs、DynaMem 等均有开源实现,可低成本体验 T1/T2 设计;但相当一部分 2026 年引用(TaskMem、H2-EMV、RRM 等 T3 代表)是预印本,代码与基准可得性需逐一核实,复现 T3 类系统的难度显著高于 T1/T2。
论文图表
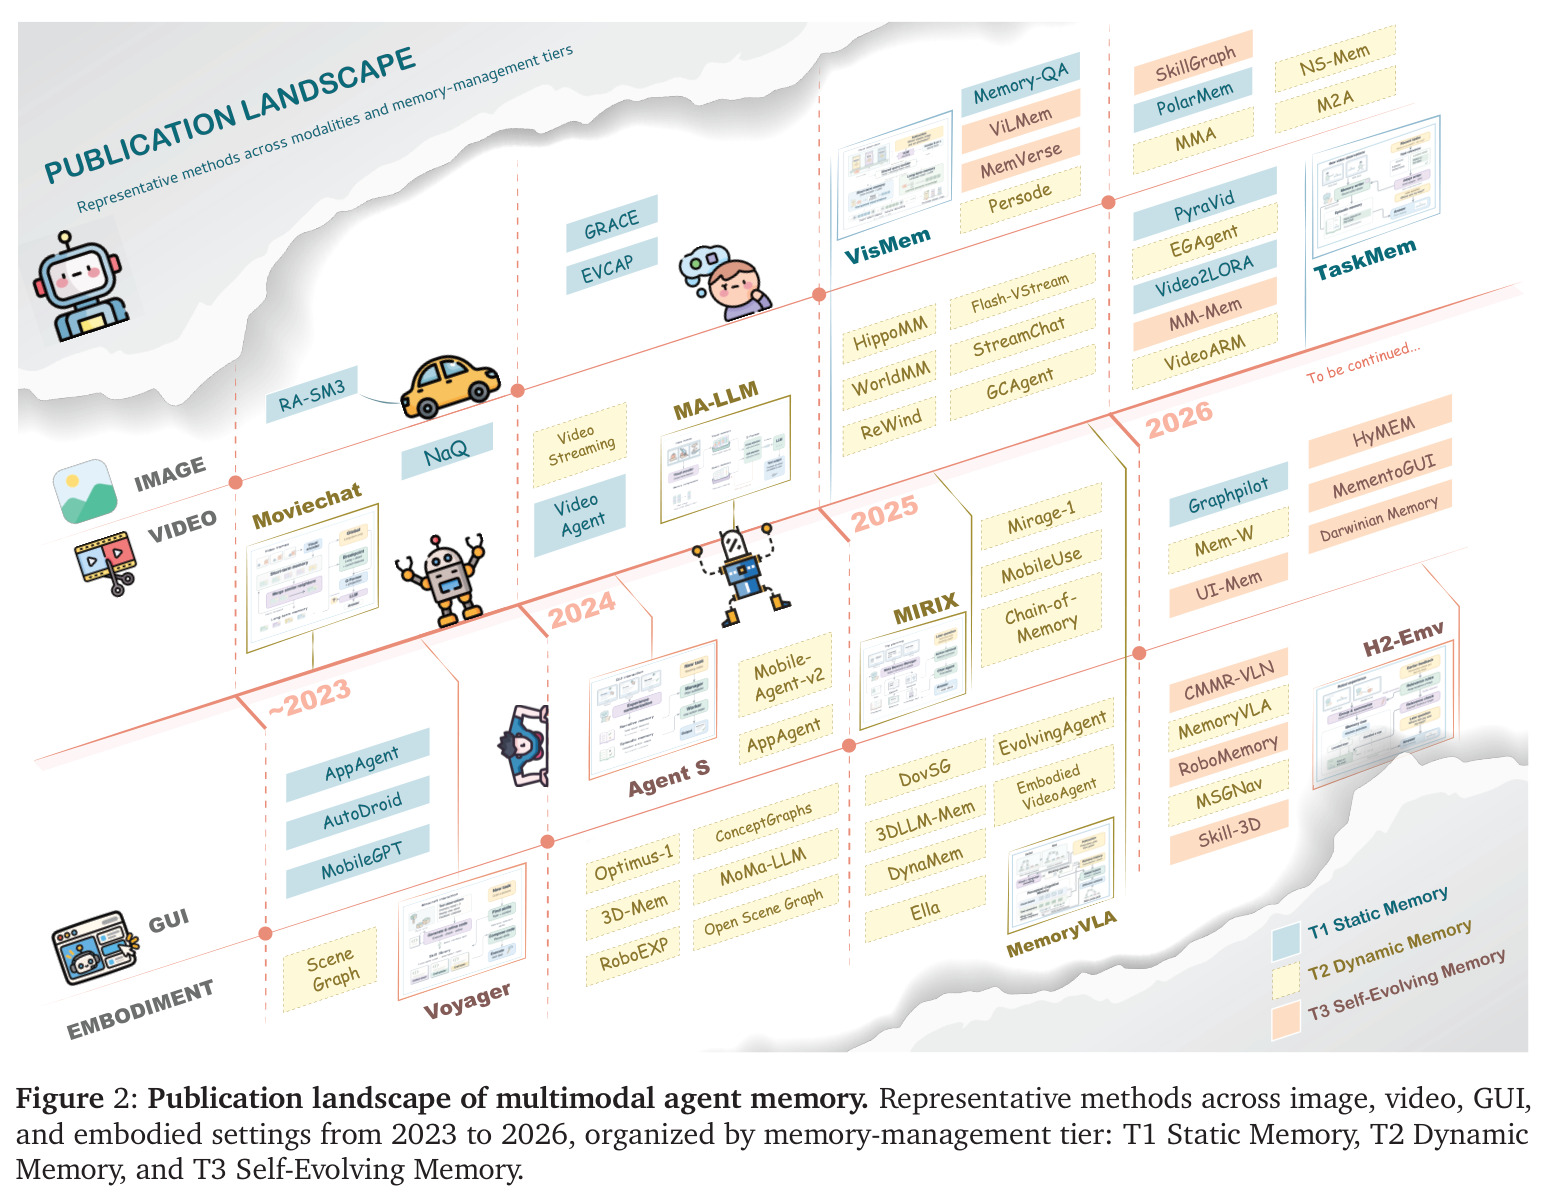
2023–2026 年代表性方法在四个模态与三个管理层级上的分布版图:图像域的 MIRIX、Memory-QA,视频域的 VideoAgent、MemoryVLA、HippoMM,GUI 域的 Mobile-Agent-v2、MementoGUI,具身域的 Voyager、DynaMem、DovSG 等,按 T1/T2/T3 分层排布。
让读者快速定位各代表系统所处的模态与层级,直观感受领域版图与 T3 极少的事实。
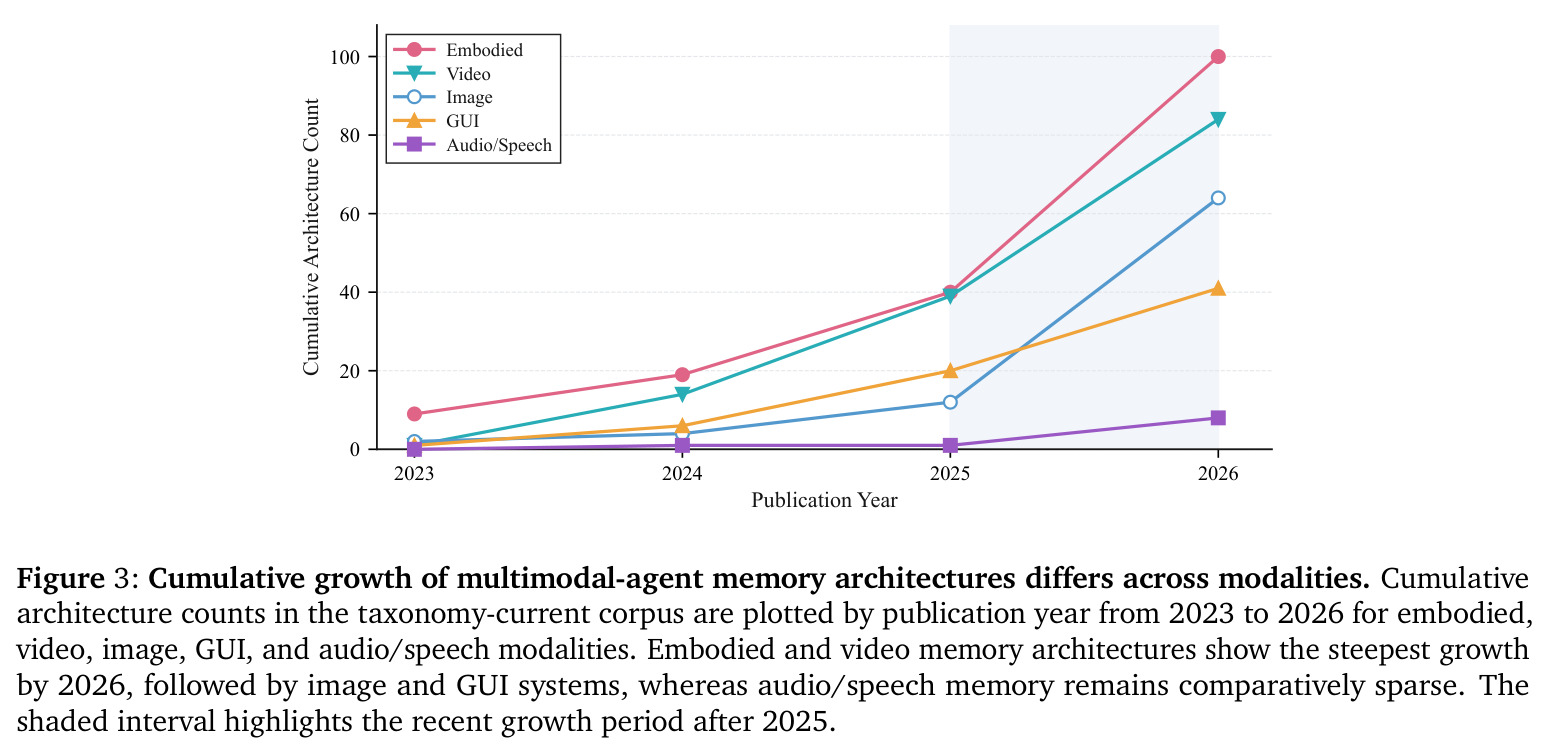
2023–2026 年按模态统计的累积架构数:具身与视频到 2026 年增长最陡,图像与 GUI 次之,音频/语音记忆架构明显稀疏;阴影区间标注 2025 年之后的快速增长期。
用语料数据刻画领域热度分布,佐证'音频记忆是被忽视的方向'这一观察,也说明该综述语料的时效性。
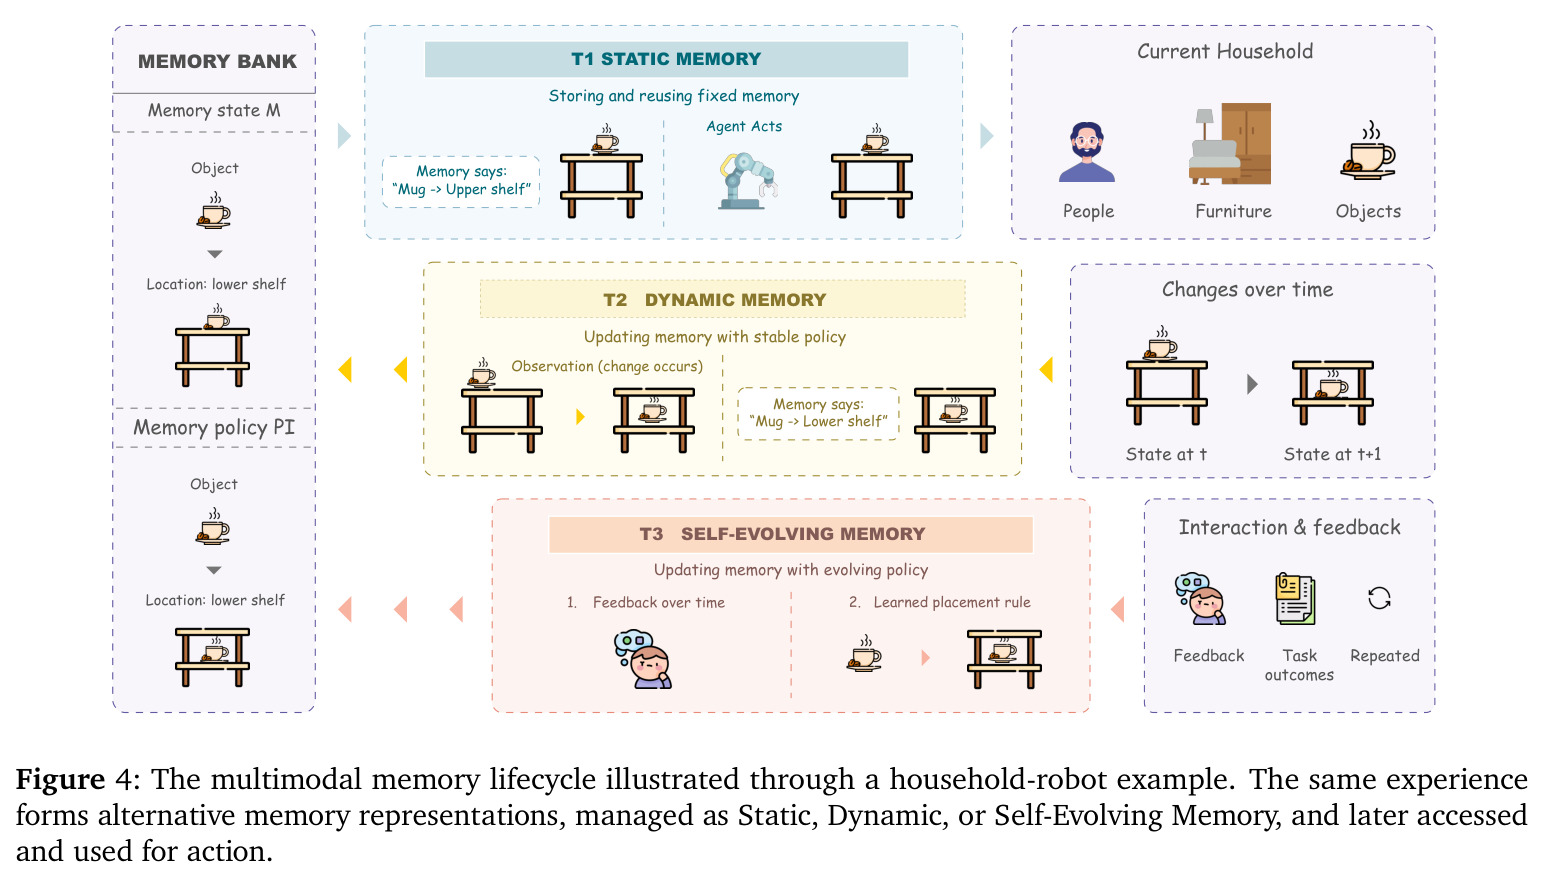
以家庭机器人与马克杯为例演示生命周期:T1 只复用'马克杯→上层架'的固定记忆;T2 在观察到物品被移动后以稳定策略把记忆更新为'下层架';T3 进一步从交互与反馈中学得'摆放规则',使写记忆的策略本身随经验演化。图中同时画出记忆状态 M 与记忆策略 π 的区别。
用一个具体场景把抽象的三层区分讲清楚,是理解 Axis II 与 T1/T2/T3 分层的最佳入口。