LLM到流的蒸馏:教会科学生成器理解自然语言目标 LLM-to-Flow Distillation: Teaching Natural Language Goals to Scientific Generators
冻结LLM当教师,用自适应子目标课程与偏好蒸馏把专用生成器对齐到自然语言科学目标
前置知识
流匹配与流模型(Flow Matching)
流模型学习一个速度场 $v_\theta$,把简单先验分布沿常微分方程连续输运到数据分布,终态密度 $p_\theta$ 就是生成分布。论文用到的 PepDFM(离散氨基酸序列流)和 FlowMol3(分子拓扑+3D几何多模态流)都是这样预训练得到的科学生成器。
LFD 微调的对象就是这类流模型;由于终态对数密度不可精确计算,其 DPO 更新必须用去噪损失代理实现,这是理解方法实现细节的前提。
DPO 与蒸馏 DPO(dDPO)
直接偏好优化从成对偏好 $(x^+,x^-)$ 直接学习,无需显式奖励模型,损失为 $\mathcal{L}=-\log\sigma\big(\beta[\log\frac{p_\theta(x^+)}{p_{\text{ref}}(x^+)}-\log\frac{p_\theta(x^-)}{p_{\text{ref}}(x^-)}]\big)$。本文使用其蒸馏变体:偏好由 LLM 教师标注获得,且每轮把当前学生模型 $p_{\theta_t}$ 本身作为参考分布。
LFD 的每一步参数更新都由这个损失驱动,参考分布取当前模型使每轮成为对当前分布的 KL 正则化小步,是课程机制能稳定推进的数学基础。
LLM-as-a-Judge 与序数反馈
让 LLM 按给定标准评估候选,可输出打分、列表排序、分类或成对比较等不同形式。其可靠性强烈依赖输出形式:绝对数值打分容易失准,相对/序数判断(谁更好、正还是负)通常更可靠。论文把这一范式扩展到科学设计判断(LLM-as-an-Expert),并系统比较了四种引出协议的成对准确率。
整篇论文的方法论前提是「LLM 序数判断可靠、绝对打分不可靠」这一实证结论(Fig 3),理解这个概念才能明白为什么 LFD 用正/负/弃权分类而非打分作为监督。
代理奖励与奖励劫持(Reward Hacking)
科学目标(如抗癌活性)无法直接测量,通常训练一个预测器作为代理奖励。优化代理时,模型会利用代理模型的误差区域刷高分数而不带来真实提升,即奖励劫持。论文中的典型案例:classifier GUIDANCE 把 ACP 代理优化到 100% 饱和,但在留出的 AntiCP2-alt 评估上只有 35.94%。
这是论文放弃显式奖励路线的直接动因,也是 LFD「不用代理奖励反而留出评估更高」这一核心卖点的对照背景。
课程学习与自适应课程
课程学习把困难任务分解为按难度递增的子任务序列,从易到难训练。经典方法使用预先设定的退火时间表;自动课程则根据学习者当前能力在线选择任务。LFD 属于后者,但它的子目标不是可执行的环境或奖励,而是 LLM 根据学生当前采样能力在线提出的自然语言科学命题。
自适应课程是 LFD 解决「OOD 目标无学习信号」问题的关键机制,也是它区别于 Motif、OAIF 等固定目标 AI 反馈方法的本质所在。
研究动机
生成式科学发现需要两种互补能力:一是对化学/生物系统的高层推理(例如哪种机制驱动疾病、哪些分子可能作用于它),二是生成符合设计空间结构约束的有效样本(哪些氨基酸序列能折叠并保持可溶、哪些晶体几何可行)。这两类能力目前分裂在两类模型中:LLM 吸收了海量科学文献却不擅长产出有效设计,而流模型/扩散模型等专用生成器能捕捉结构先验,却既缺高层科学知识也无法理解自然语言目标。主流适配方法(FlowGRPO、Adjoint Matching、DiffusionNFT 等)全部依赖显式标量代理奖励,但在实验科学中,「生成有抗癌活性的多肽」这类目标需要漫长昂贵的实验才能测量,而拟合已有数据的学习型预测器恰恰在最需要探索的分布外区域最不可靠。论文还实测了奖励劫持:classifier GUIDANCE 把所用 ACP 代理预测器优化到 100% 饱和,在留出的 AntiCP2-alt 评估上却只有 35.94%,说明代理分数的提升并不对应真实能力。
本文的目标是本文的目标可以形式化为:在只有冻结 API LLM 和一组可计算观测量 $\mathcal{O}(x)$(如 SMILES、电荷、疏水性、分子量、可旋转键数等,不含任何目标代理奖励)的条件下,把预训练流模型 $v_{\theta_0}$ 微调为 $v_\theta$,使得 $p_\theta(\Omega_g) \gg p_{\theta_0}(\Omega_g)$,其中 $\Omega_g = \{x \in \mathcal{X} : f_g(x)=1\}$ 是自然语言目标 $g$ 诱导的发现区域。同时要满足两个约束:一是初始生成器对目标区域的概率质量几乎为零($p_{\theta_0}(\Omega_g) \approx 0$)的分布外目标上方法也能工作;二是适应过程本身可解释——课程、判断理由和不确定性都可被科学家审查,而不是黑箱优化。
与已有工作不同的是,本文抓住两个被忽视的点。其一,反馈形式的选择:LLM 在科学设计上的绝对打分严重失准(三个域上归一化 MAE 达 14.9–23.6),但其诱导的相对排序一致高于随机,因此应把 LLM 当作序数判断器而非数值奖励函数——这决定了监督信号应从「打分」改为「正/负/弃权分类」。其二,冷启动问题:当目标远离生成器当前覆盖时,直接按最终目标打分几乎全是否定、无可区分信号,适配会直接停滞。作者的独特切入是把 LLM 定位为「了解学生当前水平的老师」:根据学生批量样本动态生成自然语言子目标课程(先放宽、再逐步收紧),而不是像 Motif/OAIF 那样用固定目标标注,也不是按预设退火时间表或给定奖励/验证器优化,从而把 LLM 的高层科学知识蒸馏进原本完全不懂语言的领域生成器。
核心方法
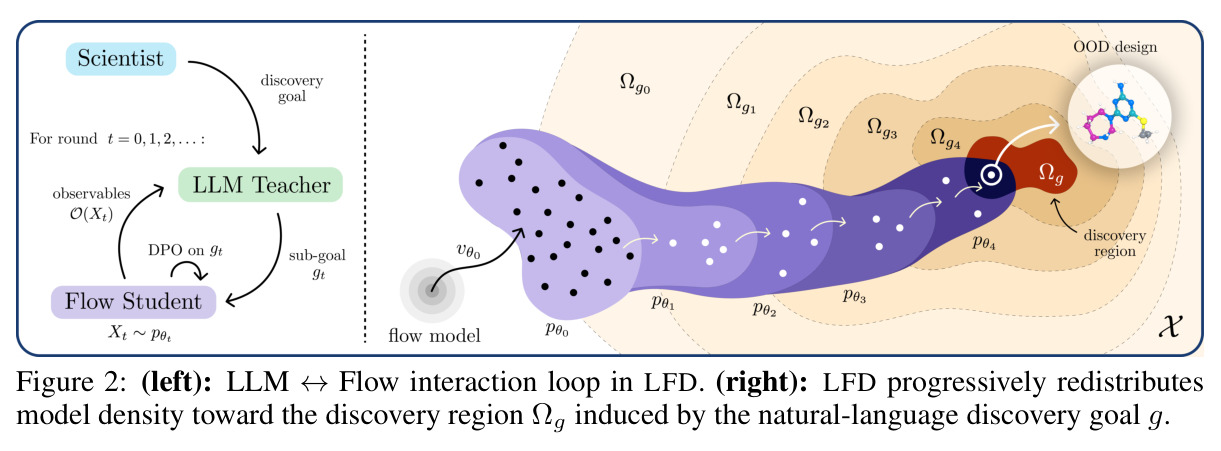
直觉上,LFD 像一位导师带学生做科研:学生(领域流模型)先按现有能力交一批「作业」(候选设计),导师(冻结 LLM)通过可计算观测量了解学生当前水平,布置一个「跳一跳够得着」的中间目标;在这个目标下把学生作品分成正/负/弃权,用正负偏好对通过 DPO 更新学生;学生进步后,导师再把目标向最终发现目标收紧一小步,如此迭代,形成目标区域序列 $\Omega_{g_0} \to \Omega_{g_1} \to \cdots \to \Omega_g$。与经典退火不同,课程不是预设时间表,而是由 LLM 依据学生当前 generable set 在线决定。技术上每轮三步:(1) SETGOAL——LLM 依据批量样本 $X_t$ 和观测量 $\mathcal{O}(X_t)$ 提出可达、与最终目标 $g$ 科学相连且构成可信进展的子目标 $g_t$,并由独立的语义审计员确认;(2) LLM-JUDGE——对每个候选做两次独立的正/负/弃权分类,仅保留两次一致的稳定标签,构造全笛卡尔正负偏好对 $D_t$;(3) 以当前模型为参考分布做蒸馏 DPO 更新(终态对数密度用去噪损失代理),得到 $\theta_{t+1}$ 后重新采样进入下一轮。
核心创新是把「对齐科学生成器」从优化显式奖励改为蒸馏 LLM 的序数科学判断,并用生成器自适应的自然语言课程解决分布外冷启动。与已有方法的本质区别有三点。(1) 反馈形式:论文实证发现 LLM 绝对分数在三个科学域上全部失准(归一化分数差的 MAE 达 14.9–23.6),但序数判断的成对准确率一致高于 50% 随机线;于是采用一次批处理即可完成、成本随样本数线性增长的正/负/弃权分类(成对对决是二次成本),弃权选项还避免对模糊样本强行监督。(2) 课程生成:子目标由 LLM 依据学生当前 generable set 在线提出,且必须通过可达性门控——稳定正例占比 $q \ge 0.5$、相对提升 $\Delta q \ge 0.1$、正负例各至少 20 个等——保证每轮都有可区分的密集监督,这正是 $p_{\theta_0}(\Omega_g)\approx 0$ 时基线全部失效而 LFD 能推进的原因。(3) 理论解释:在 Bradley–Terry 假设下,每轮 DPO 的总体最优解是 KL 正则隐式目标 $p_t^\star \propto p_{\theta_t} e^{f_{g_t}/\beta}$,即 $p_t^\star = \arg\max_q \mathbb{E}_q[f_{g_t}] - \beta D_{\mathrm{KL}}(q \| p_{\theta_t})$,整条课程因此是一串通向 $\Omega_g$ 的 KL 正则化小步。
方法步骤详情
以实际任务为例走一遍流程。第 1 步采样与观测:当前 PepDFM 生成 100 条多肽的工作队列(35 条长 12、40 条长 24、25 条长 38,采样 100 步),计算电荷、疏水性、芳香性、两亲性及粗粒度溶解性/非溶血带等观测量;分子任务用 FlowMol3 采样(250 积分步),观测量包括分子量、氢键计数、拓扑极性表面积、可旋转键数等。第 2 步设定子目标:Gemini 3.1 Pro(高推理档)作为 controller,接收最终目标 $g$、上一子目标 $g_{t-1}$ 与 $\mathcal{O}(X_t)$;首轮做 BROADEN,提出「最弱的科学上有意义且可评估」的前驱目标(如阳离子两亲性),之后每轮 TIGHTEN 只恢复一项被推迟的最终要求,且禁止直接跳到实验级断言;提议须通过另一次独立 LLM 调用(auditor)的语义审计,并满足可达性门控($q \ge 0.5$、$\Delta q \ge 0.1$、正负例各 ≥20;Goal 5 则要求 512 样本中 $p(g_t) > 0.20$)。第 3 步判断:Gemini 3.7 Flash 对每个候选在乱序批上做两次独立的 POSITIVE/NEGATIVE/ABSTAIN 分类,两次一致才进入稳定集合 $P_t, N_t$,构成全笛卡尔偏好对 $D_t = \{(x^+,x^-)\}$,弃权与不稳定样本仅留在分母。第 4 步更新:以冻结父检查点为参考做 dDPO(肽任务 100 步/轮、$B=32$、$\beta=2.6$、lr $10^{-5}$、clip 0.1;D2 任务 lr $5\times10^{-6}$、$\beta=1$、$B=8$、128 步/轮),终态对数密度用去噪损失代理。重复直到最终目标或停止条件。
技术新颖性
与奖励引导微调(FlowGRPO、Adjoint Matching、DiffusionNFT、FDC 等)相比,LFD 不需要任何预先给定的泛函或奖励,监督完全来自 LLM 的一阶原理科学推理。与让 LLM 直接编辑/优化分子或充当贝叶斯优化代理的工作相比,LFD 的教师从不生成候选设计,只做判断,学生仍是领域专用生成器——这打破了现有在线蒸馏要求师生共享输出空间的设计空间分离假设。与 Motif(离线标注固定数据集)和 OAIF(在线标注但目标固定)等 AI 反馈方法相比,关键差异是子目标随学生分布在每轮在线演化。与经典课程学习、退火方法及稀有事件采样(子集模拟、自适应多层分裂)相比,LFD 的中间目标既非预定时间表,也不是可执行奖励、验证器或预定义分数的阈值,而是自然语言科学命题,其推进由当前批次的可达性证据驱动。
实验结果
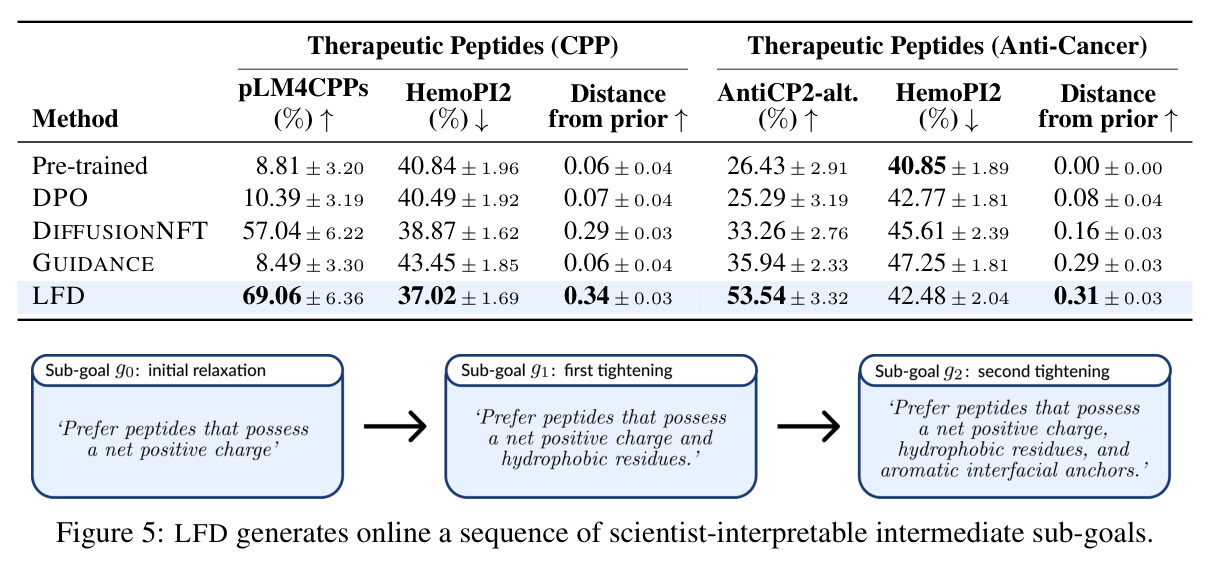
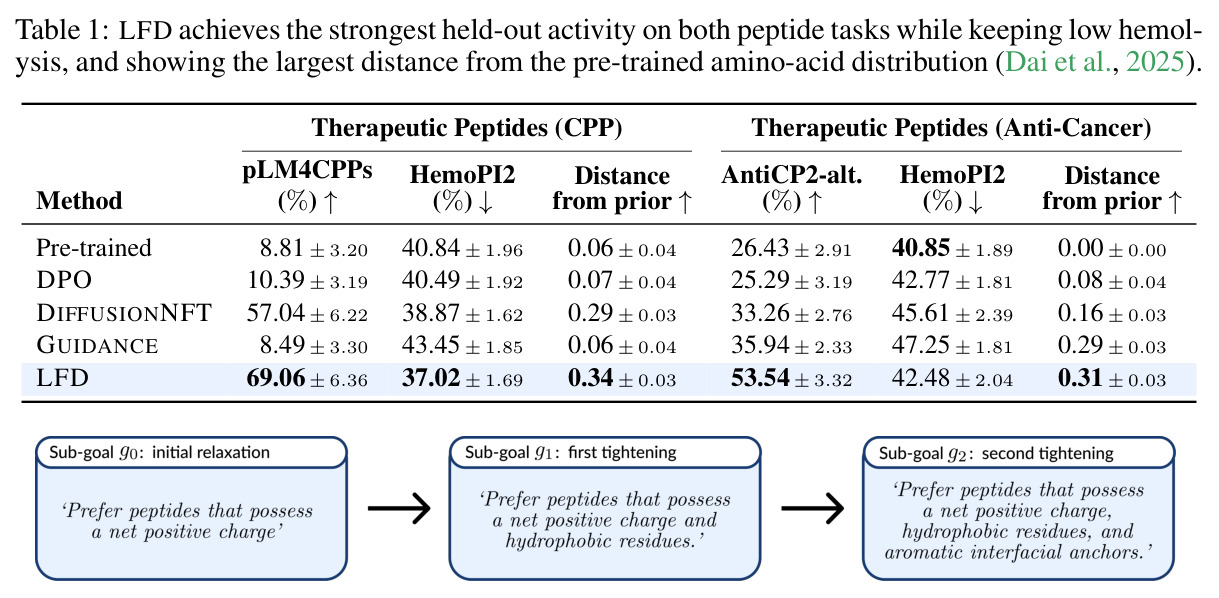
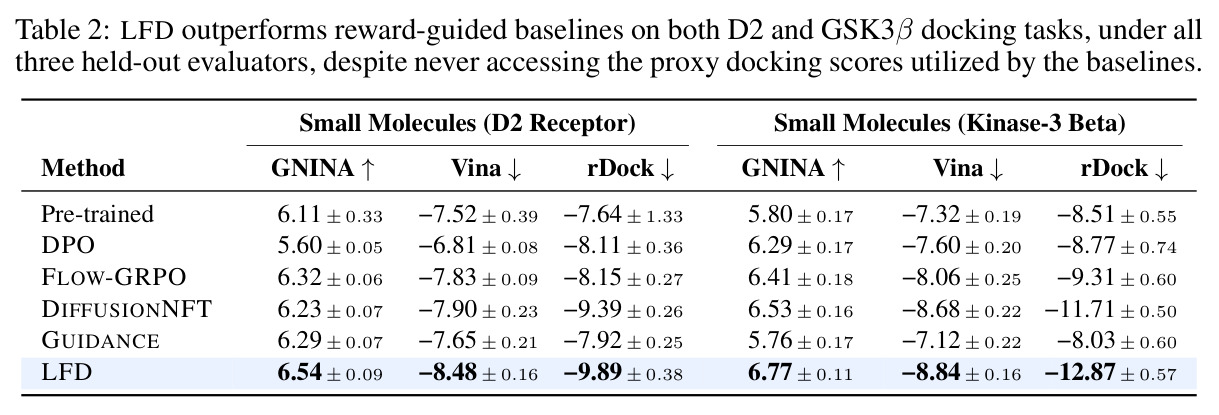
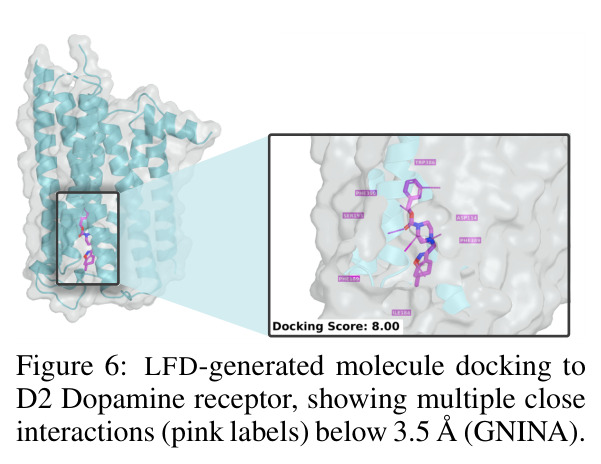
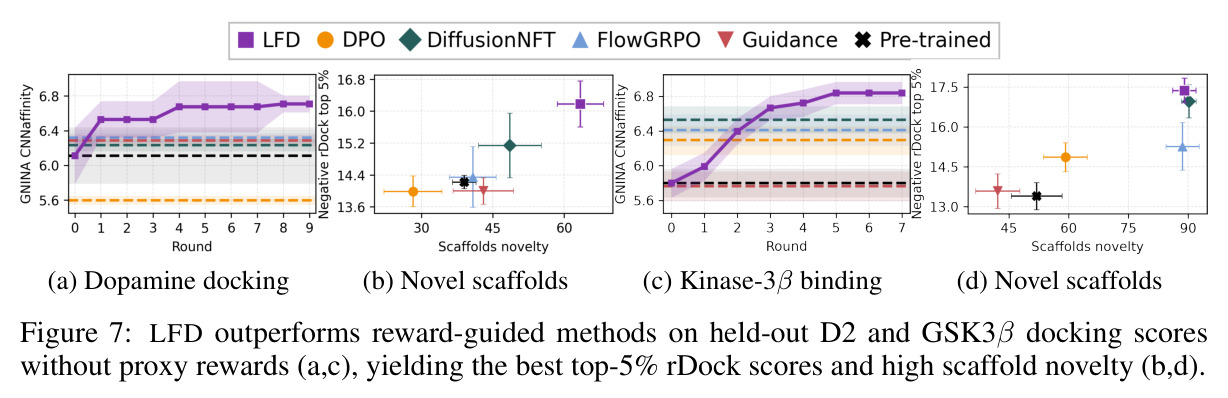
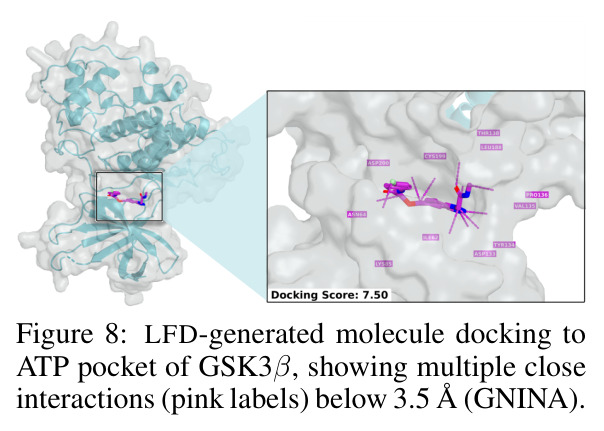
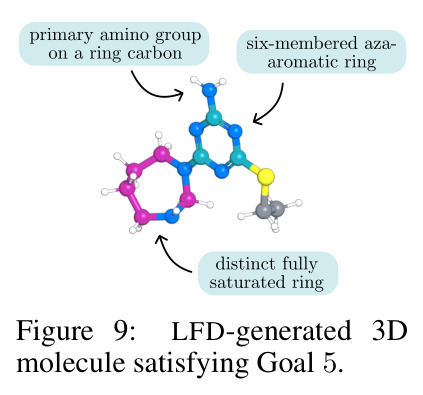
反馈可靠性研究(Fig 3):GPT 5.6 Terra、Claude Opus 5、Gemini 3.7 Flash 在三个域(多肽 α-螺旋疏水矩、晶体凸包能量、QM9 MolLogP)上的 1–100 绝对打分严重偏离 $y=x$ 线(MAE 14.9–23.6),但四种序数引出方式的成对准确率全部明显高于 50% 随机线,其中线性成本的正/负分类达到甚至超过二次成本的成对对决,故被 LFD 采用。抗癌肽(Goal 1,七个子目标 + 2 轮最终目标):LFD 在留出的 AntiCP2-alt 上达 53.54%(预训练 26.43%,最佳基线 GUIDANCE 35.94%、DiffusionNFT 33.26%),HemoPI2 毒性仅 42.48%(预训练 40.85%,GUIDANCE 达 47.25%),与先验距离 0.31 为全场最大;GUIDANCE 把代理刷到 100% 而留出仅 35.94% 是典型奖励劫持。穿膜肽(Goal 2,共 700 优化步):pLM4CPPs 从 8.81% 升至 69.06%,显著高于 DiffusionNFT 的 57.04%,且 HemoPI2 全场最低(37.02%)。D2 受体(Goal 3):GNINA 6.11→6.54 pK(Flow-GRPO 6.32),Vina −7.52→−8.48 kcal/mol(DiffusionNFT −7.90),rDock −7.64→−9.89,RDKit 有效性 98%、PoseBusters 89.5%,且一轮后就超过基线。GSK3β(Goal 4):GNINA 5.80→6.77、Vina −7.32→−8.84、rDock −8.51→−12.87,三项留出评估全部超过四个基线,有效性 96%、PoseBusters 84%。复杂约束的 Goal 5:预训练模型 38,500 个样本零命中,所有拿到「LLM 生成二值奖励」的基线因初始正例过稀全部失败;LFD 靠自适应课程在第三子目标 $g_2$ 第 6 轮的 512 样本批内即得到满足全部结构描述的分子。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 抗癌肽生成(Therapeutic Peptides, Anti-Cancer,Goal 1) | 留出 AntiCP2-alt 活性预测(%↑) | 53.54 ± 3.32(LFD,未用任何代理奖励) | 预训练 26.43;最佳基线 GUIDANCE 35.94;DiffusionNFT 33.26 | 较预训练 +27.11 个百分点,较最佳基线 +17.60 个百分点 |
| 抗癌肽毒性控制(Goal 1) | HemoPI2 溶血预测(%↓) | 42.48 ± 2.04 | 预训练 40.85;GUIDANCE 47.25;DiffusionNFT 45.61 | 活性大涨的同时毒性仅升 1.63 个百分点,为各活性提升方法中最低增幅 |
| 穿膜肽生成(CPP,Goal 2) | 留出 pLM4CPPs 活性(%↑) | 69.06 ± 6.36(LFD) | 预训练 8.81;最佳基线 DiffusionNFT 57.04 | 较预训练 +60.25 个百分点,较最佳基线 +12.02 个百分点;HemoPI2 37.02 亦为全场最低 |
| D2 受体分子设计(Goal 3) | GNINA CNN-affinity(pK↑) | 6.54 ± 0.09(LFD) | 预训练 6.11;Flow-GRPO 6.32 | +0.43 pK(较预训练),+0.22(较最佳基线) |
| D2 受体分子设计(Goal 3) | Vina / rDock 对接能(kcal/mol,越低越好) | Vina −8.48;rDock −9.89 | Vina 预训练 −7.52 / 最佳基线 −7.90;rDock 预训练 −7.64 / 最佳基线 −9.39 | Vina 改善 0.96,rDock 改善 2.25;同时保持 RDKit 有效性 98%、PoseBusters 89.5% |
| GSK3β ATP 口袋分子设计(Goal 4) | GNINA / Vina / rDock(三评估器) | GNINA 6.77 pK;Vina −8.84 kcal/mol;rDock −12.87 kcal/mol | 预训练 GNINA 5.80 / Vina −7.32 / rDock −8.51;最佳基线 DiffusionNFT GNINA 6.53 / Vina −8.68 / rDock −11.71 | 六个数值全部第一;RDKit 有效性 96%、PoseBusters 84% |
| 激酶家族复杂结构约束分子(Goal 5) | 满足完整目标描述的命中数 | 预训练 38,500 样本 0 命中;LFD 第 6 轮 512 样本批内出现命中 | 所有奖励引导基线(含获得 LLM 生成二值奖励者)均 0 命中 | 唯一能在正例极度稀疏的 OOD 目标上成功适配的方法 |
| LLM 科学反馈可靠性(三域:多肽/晶体/分子) | 成对准确率(%↑,随机为 50)与 1–100 打分 MAE(↓) | 四种序数引出方式成对准确率均高于随机;正/负分类成本线性 | 绝对打分 MAE 14.9–23.6,严重偏离 $y=x$;成对对决成本二次 | 确立「序数可靠、基数失准」结论,支撑 LFD 的监督设计 |
局限与改进
作者承认的局限:整套评估仍是 in silico,未做湿实验验证,结论以计算预测器为准;附录 C 明确说明单轮 KL 目标分析只是总体层面的解释,在有限样本、硬偏好结果、去噪损失代理和有限训练预算下,不能保证课程最终到达 $\Omega_g$。我的补充观察:(1) 教师判断本身只是「高于随机」(Fig 3 中成对准确率目测在 55–70% 区间),两次独立投票只能部分过滤噪声,多轮迭代中判断误差可能被放大,且 G01 之后采用 route-conditioned 机制锁定单一路线,早期选错路线则无法回头;(2) 可达性门控阈值($q \ge 0.5$、$\Delta q \ge 0.1$、正负例 ≥20、Goal 5 的 $p(g_t)>0.20$ 等)为各任务手工设定,作者自述「未大量调参」,跨域迁移时需要重新设计这些启发式;(3) 有一定讽刺意味的是,评估仍依赖留出的预测器(AntiCP2-alt、pLM4CPPs、GNINA 等),它们同样是代理指标,真实活性与对接仍有待湿实验确认;(4) 方法依赖闭源前沿 LLM API(Gemini 3.1 Pro / 3.7 Flash),成本、延迟、可用性与可复现性受制于外部服务;(5) OOD 迁移伴随有效性下降(D2→GSK3β:RDKit 98%→96%,PoseBusters 89.5%→84%),更远的目标可能进一步牺牲化学有效性。
独立分析的弱点
弱点一:教师单点故障。所有监督来自一个 LLM 的判断,其化学与生物学知识可能包含幻觉或过时结论;课程一旦早期选错科学路线(route-conditioned 机制会锁定 G01 路线),后续收紧只会沿错误方向越走越远。改进方向:引入多教师集成投票、要求教师输出可核查的证据链,或用小规模主动实验对课程节点做校准。弱点二:判断噪声的级联放大。序数判断仅「略高于随机」,两次投票一致性过滤有限;在 OOD 冷启动阶段,被误判为负例的稀有正样本可能被系统性清除,反而延缓对 $\Omega_g$ 的覆盖。改进方向:对高不确定性样本增加投票次数,或引入廉价领域工具(RDKit 结构过滤器、简单物理描述符)作为辅助验证器与 LLM 判断交叉验证。弱点三:成本与扩展性。每轮需要 controller 与 auditor(3.1 Pro 高推理档)各若干次调用,加上每样本两次 Flash 判断;Goal 5 的对照需要 38,500 样本级别的采样,批量扩大后 API 费用和延迟显著。改进方向:将 Flash 判断器蒸馏为可本地部署的小模型,或用累积的判断数据训练一个奖励模型来摊薄边际成本。弱点四:知识受限于观测量。LLM 只能看到 $\mathcal{O}(x)$,对真实 3D 结合构象、溶剂效应、动力学等不可观测量只能凭先验「推断」,在需要精确几何或量子层面推理的目标上可能失效;同时闭源 API 依赖也削弱了可复现性与安全性可控性。
未来方向
作者明确提出的最直接方向是把湿实验反馈接入 LFD 循环,用真实 assay 结果替代或校准 LLM 判断,形成实验在环的闭环发现系统。基于本文成果可以延伸的方向包括:把自然语言课程机制移植到晶体/材料、蛋白质复合物、催化剂等其他科学模态(论文的反馈可靠性研究已覆盖晶体域,为这一步铺路);为整条课程建立收敛性或到达保证(当前仅有单轮 KL 正则目标的总体分析);研究多条并行课程、多目标权衡与课程分支回溯机制;将教师判断在线蒸馏为本地奖励模型以降低 API 成本并提升可控性;结合分布控制方法(如熵或 CVaR 目标)在逼近 $\Omega_g$ 的同时维持样本多样性。此外,自动生成课程的能力带来新的安全问题——需要防护栏防止该方法被用于对有害发现目标的课程生成,以及人机协同接口的深化(科学家审查、否决或手动编辑子目标,Fig 4/5 已展示雏形)。
复现评估
复现材料较为完整:项目主页 llm-to-flow-distillation.github.io,附录 B/D 公开了 controller、auditor、judge 的完整系统提示词模板,以及每个任务的 LFD 配置(DPO 步数、$\beta$、学习率、clip、门控阈值、队列构成)和课程实际执行轨迹(各子目标轮数)。所依赖的生成器与数据均公开:PepDFM、FlowMol3、GEOM-Drugs、QM9、MatterGen/MatterSim;评估器 AntiCP2-alt、pLM4CPPs、HemoPI2、GNINA、Vina、rDock、RDKit、PoseBusters 皆可公开获取。主要门槛有两个:一是需要 Gemini 3.1 Pro 与 3.7 Flash 的付费 API 权限,成本主要来自每轮 100 样本 ×2 次判断加若干 Pro 级推理调用;二是微调流模型的 GPU——每轮仅 100–150 步 DPO,单卡即可承担。总体复现难度中等:算法本身轻量,但工程细节多(稳定标签、语义审计、门控与检查点选择规则),好在论文把协议写得相当透明,论文未明确承诺开源代码,需关注项目页更新。
论文图表
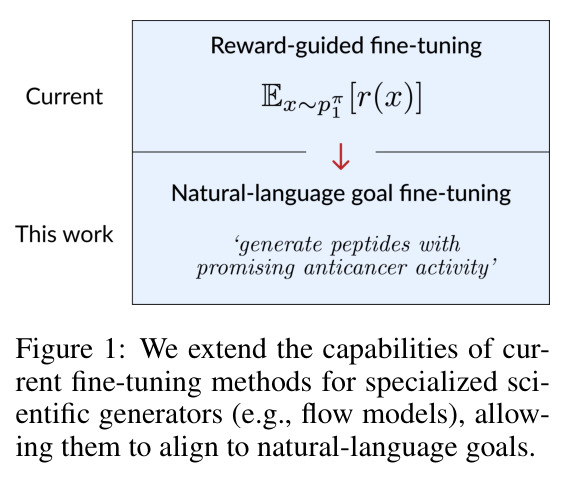
对比示意图:现有微调方法(FlowGRPO、Adjoint Matching、DiffusionNFT 等)需要显式代理奖励函数才能把专用科学生成器适配到下游任务,而 LFD 让冻结 LLM 充当教师,使生成器直接对齐到「生成有抗癌活性的多肽」这类自然语言发现目标。
一图点明论文要填补的能力空白与研究定位——把生成器控制从「奖励驱动」扩展到「语言驱动」,是理解全文动机的入口。
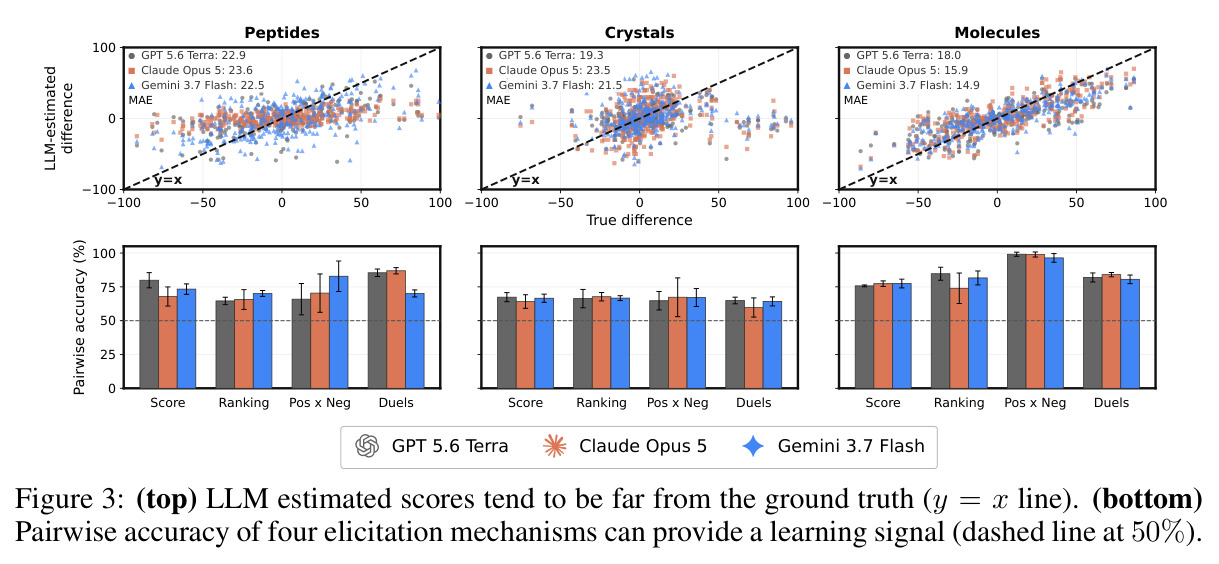
上排三个散点图显示 GPT 5.6 Terra、Claude Opus 5、Gemini 3.7 Flash 在多肽(疏水矩)、晶体(凸包能量)、分子(MolLogP)三个域上的 1–100 打分差与真实差值严重偏离 $y=x$ 线(MAE 分别为 22.9/19.3/18.0、23.6/23.5/21.5、22.5/21.5/14.9);下排柱状图显示打分、列表排序、正/负分类、成对对决四种序数引出方式的成对准确率全部高于 50% 随机线。
它是全文方法论成立的实证基石:为什么用序数偏好而非绝对分数做监督、为什么选正/负分类而不是成对对决,答案全在这张图里(Insight 0 的来源)。
展示一条被拒多肽的完整判断轨迹:序列 MLKGRWPDEQKKNHLMNYNFMLIVFVLTFNISFQSSNI(电荷指数 +2.1、疏水性 47.4%、非溶血下三分之一带),LLM 给出拒绝理由——存在过长连续疏水段 MLIVFVL、违反当前子目标 $g_3$,同时声明体外溶血阈值与聚集状态是无法从现有信息确定的不确定性来源。
直观展示 LFD 的可解释性与人类可监督性:每次拒绝都有可审查的科学理由和明确的不确定性声明,这是 LLM 教师相对黑箱奖励模型的独特优势。