X-Ragent:面向证据支撑胸片推理的工具增强强化学习后训练框架 X-Ragent: Tool-Augmented Reinforcement Learning for Evidence-Grounded Chest X-Ray Reasoning
工具增强SFT+GRPO后训练与有效性门控,让8B模型按需取证、拒收无效测量,胸片推理SOTA
前置知识
GRPO(组相对策略优化)
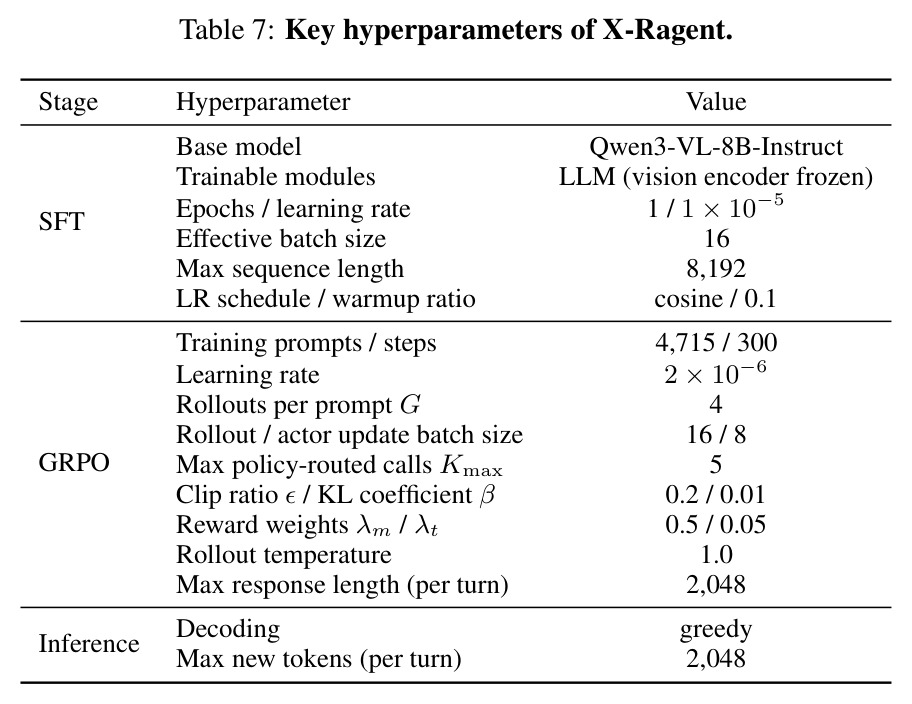
DeepSeek-R1 等采用的在线强化学习算法:对每个问题从旧策略采样一组 $G$ 条回答,用组内奖励归一化 $A_i=(r_i-\mathrm{mean})/\mathrm{std}$ 作为优势,配合 PPO 式重要性裁剪 $\mathrm{clip}(\rho,1-\epsilon,1+\epsilon)$ 与 KL 正则更新策略,无需训练价值网络。本文在 4715 道可验证题上以 $G=4$、学习率 $2\times10^{-6}$ 训练 300 步。
论文第二阶段训练与全部奖励设计都建立在 GRPO 的组内比较机制上,不理解它就无法理解奖励如何塑造工具调用与证据整合行为。
准确性门控奖励(accuracy-gated reward)
一种奖励结构:把过程级奖励(测量一致性 $R_{\mathrm{CXR}}$、工具成本 $R_{\mathrm{tool}}$)乘进最终答案正确性 $R_{\mathrm{acc}}\in\{0,1\}$ 内,即 $R(\tau)=R_{\mathrm{format}}+R_{\mathrm{acc}}[1+\lambda_m R_{\mathrm{CXR}}-\lambda_t R_{\mathrm{tool}}]$。由于 $\lambda_t K_{\max}<1$ 且 $R_{\mathrm{CXR}}\ge 0$,任何正确轨迹的奖励必然高于任何错误轨迹,过程项只在正确轨迹之间细化偏好排序。
这是防止『过程好看但诊断错误』的轨迹被强化的核心机制,表 3 的奖励消融(无门组合 69.8% vs 门控 71.7%)是本文最关键的设计证据。
有效性门控(validity-gated measurement)
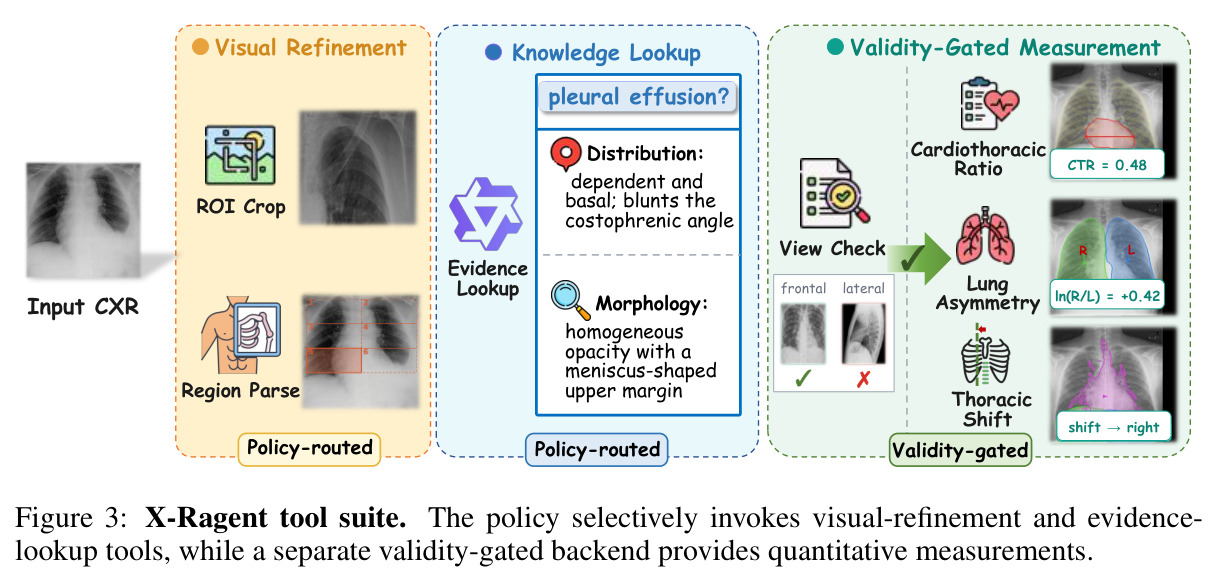
确定性影像测量(如心胸比 $\mathrm{CTR}=w_c/w_t>0.5$ 提示心脏增大)只在标准 PA 正位投照下才成立。有效性门 $g(I)=g_{\mathrm{view}}(I)\,g_{\mathrm{quality}}(I)$ 用 OpenCXR 判断投照体位、用解剖掩膜质量检查决定是否暴露测量包,失败则 $M(I)=\varnothing$——缺失明确表示『证据不可用』而非『表现正常』。
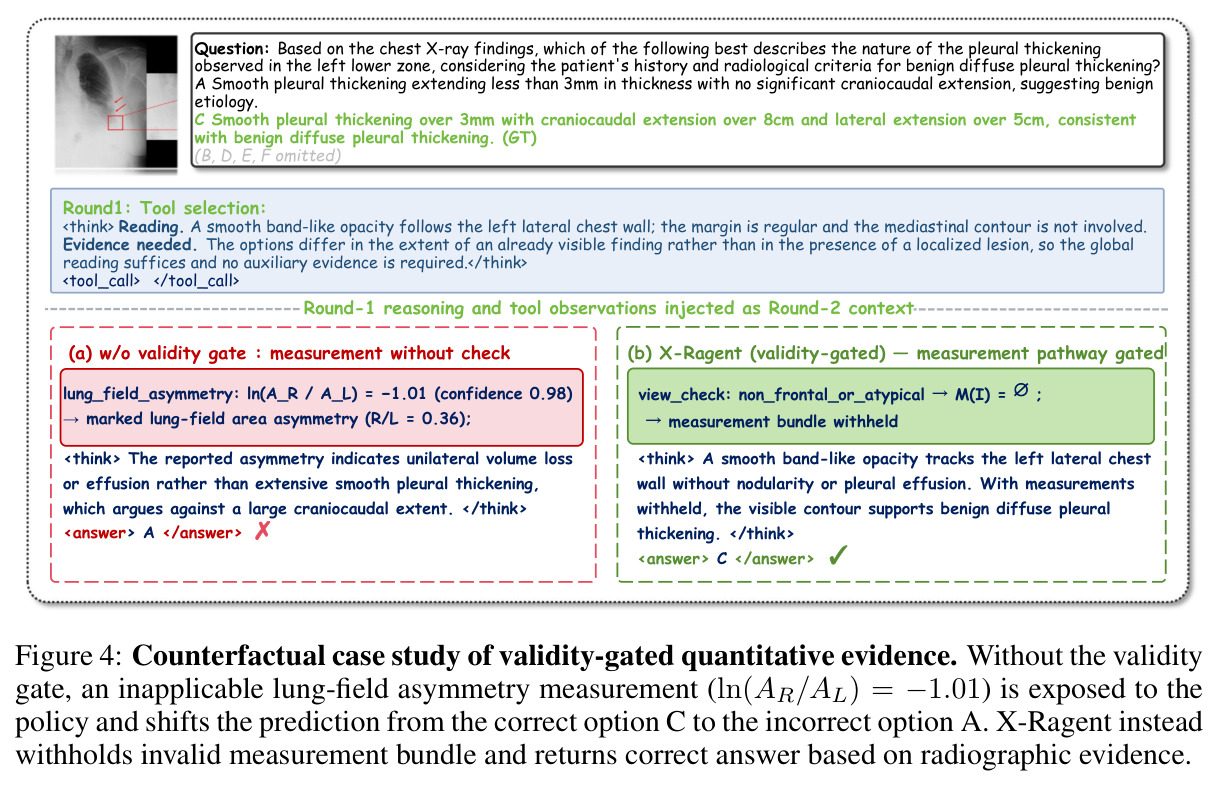
这是本文与既有医学智能体最本质的差异点,图 4 反事实案例与表 6 控制实验都围绕它展开,是读懂论文贡献的前提。
两轮工具增强智能体交互
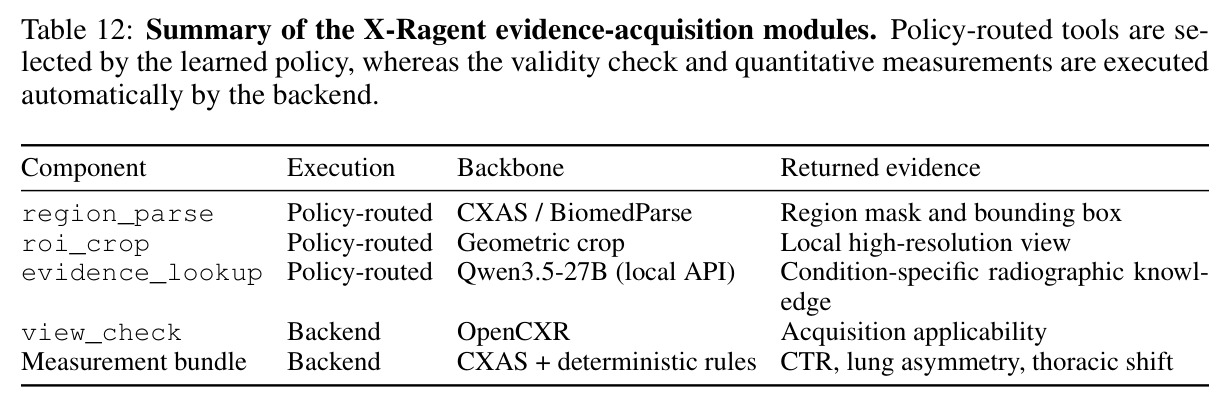
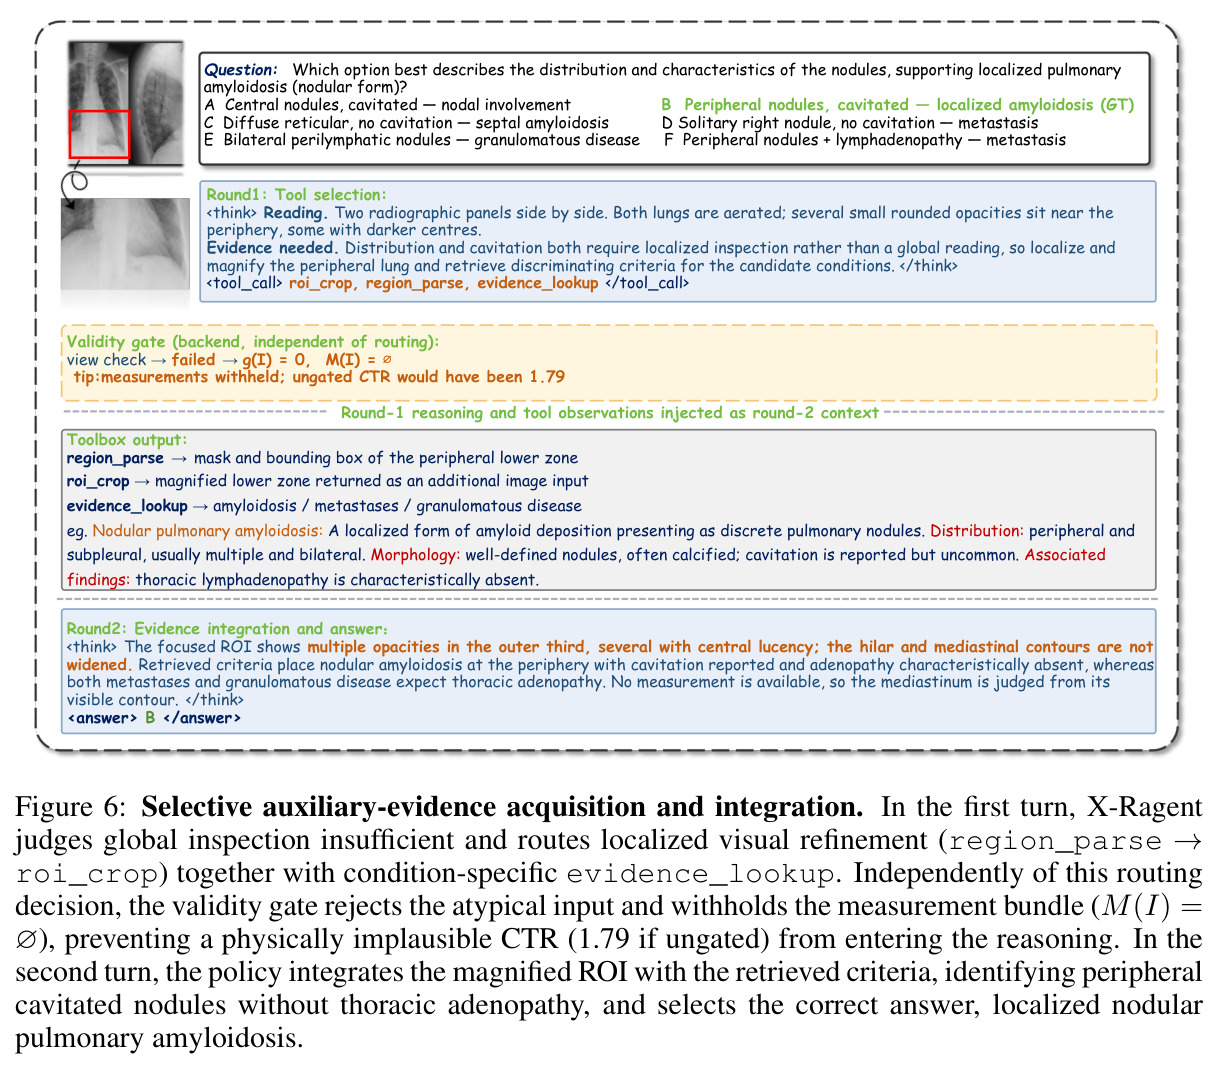
智能体把模型从单次问答变成『推理→行动→观测』循环。X-Ragent 固定为两轮:第一轮全局读片并输出可选工具计划 $\mathcal{T}_\pi=\{\texttt{region\_parse}, \texttt{roi\_crop}, \texttt{evidence\_lookup}\}$(至多 $K_{\max}=5$ 次调用),有效性门独立决定是否附上测量包;第二轮整合观测与测量输出 $\langle R, A\rangle$。工具观测严格在请求动作之后注入,保持因果一致。
论文的问题形式化、Rad-CoT 数据格式、SFT 掩码策略与推理协议全部基于这个两轮结构,是理解方法的骨架。
SFT 冷启动与损失掩码
在 RL 之前用示范数据做监督微调以建立结构化行为。本文的 agentic SFT 只对策略生成的 token 计算 $\mathcal{L}_{\mathrm{SFT}}=-\mathbb{E}_{\mathcal{T}}\big[\sum_{t=1}^{T}\log p_\theta(s_t|X,I,s_{<t})\big]$,外部注入的工具观测 span 被从损失中掩码,防止模型学会模仿工具输出而非学习调用决策。
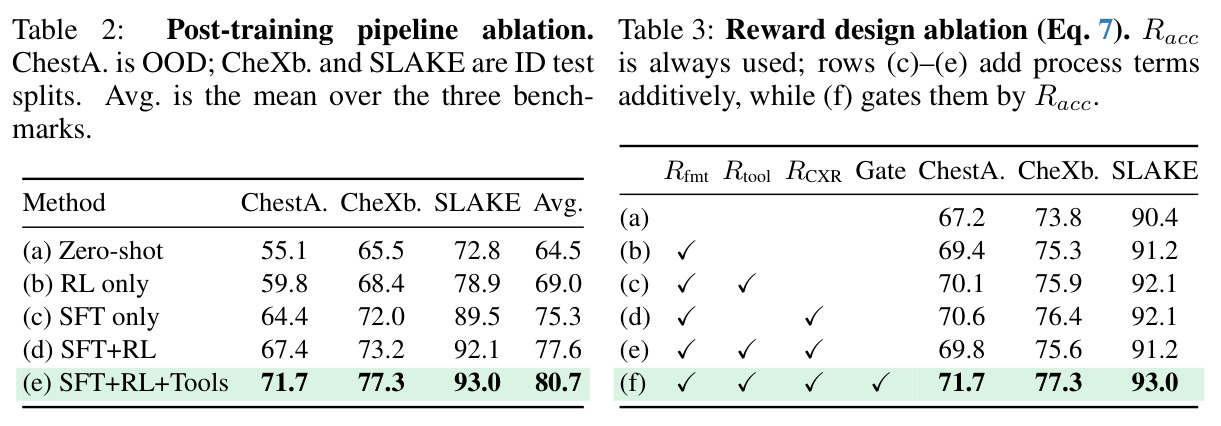
表 2 显示仅 RL 只有 69.0 分而冷启动后达 80.7 分,理解掩码设计才能明白为什么 7.7K 合成轨迹能教会模型『何时调用工具』。
研究动机
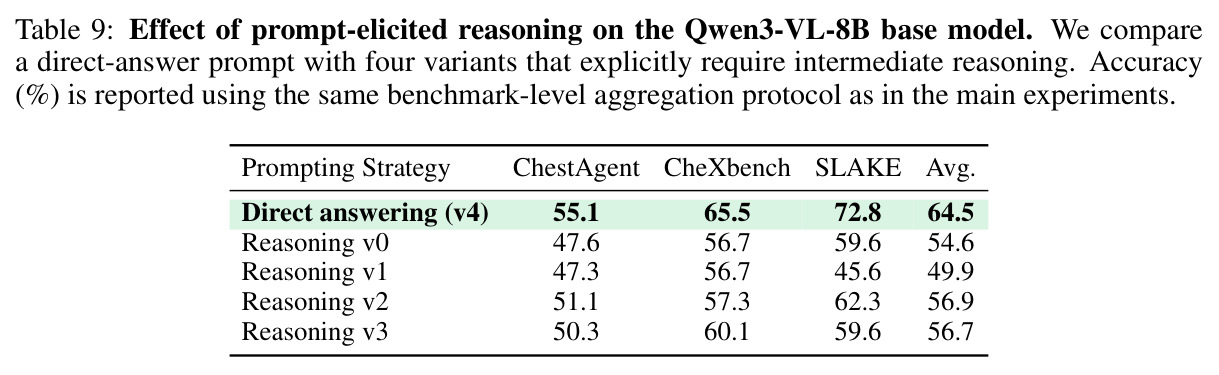
胸片(CXR)是临床最常开具的影像检查,但现有视觉语言模型做诊断推理时存在三个具体缺口。其一,视觉-诊断鸿沟:模型对图像做全局感知,却难以把弥散的视觉线索对应到局灶解剖结构与定量指标上——面对『右中肺野肿块伴胸腔积液和心影增大』这类需要局灶证据的题目,单次前向的 Qwen3-VL-8B 在 ChestAgentBench 2500 道六选一题上只有 55.1%,GPT-4o 也只有 56.4%。其二,证据-诊断不一致:MedRAX 这类工具编排智能体虽能调用分割、检索等外部模块,却经常用文本先验覆盖工具返回的客观证据,产生看似合理却无证据支撑的诊断(如无视工具输出仍答 A)。其三,不适定测量:心胸比等确定性测量只在标准 PA 正位投照下才有意义,缺乏适用性检查时,侧位或非典型片上算出的数值会以可信的样子误导诊断。更麻烦的是,作者发现仅靠提示词要求基座模型『逐步推理』反而有害:直接回答三个基准平均 64.5%,而四种强制推理提示最高只有 56.9%。
本文的目标是本文目标是让一个 8B 级 MLLM 学会『证据支撑的胸片推理』,具体拆解为三项协同能力:证据分诊规划——根据临床问题和初始读片判断是否需要辅助证据,按需调用 ROI 放大、区域解析或知识检索($K$ 可为 0),而不是默认全开;忠实证据整合——把异构工具观测与视觉发现相互印证而非盲信,避免跨模态幻觉;适用性门控测量——CTR、肺野不对称度 $\mathrm{LFA}=\ln(A_R/A_L)$、胸廓偏移等确定性测量只在采集条件满足时才进入推理上下文。工程目标是仅用 7.7K 合成轨迹做 SFT 冷启动、再用 GRPO 在 4.7K 可验证题上强化,就应在三个基准上超越基于 GPT-4o 的 MedRAX 智能体,并在完全未见过的 ChestAgentBench 上取得显著 OOD 提升(最终实现 63.1%→71.7%)。
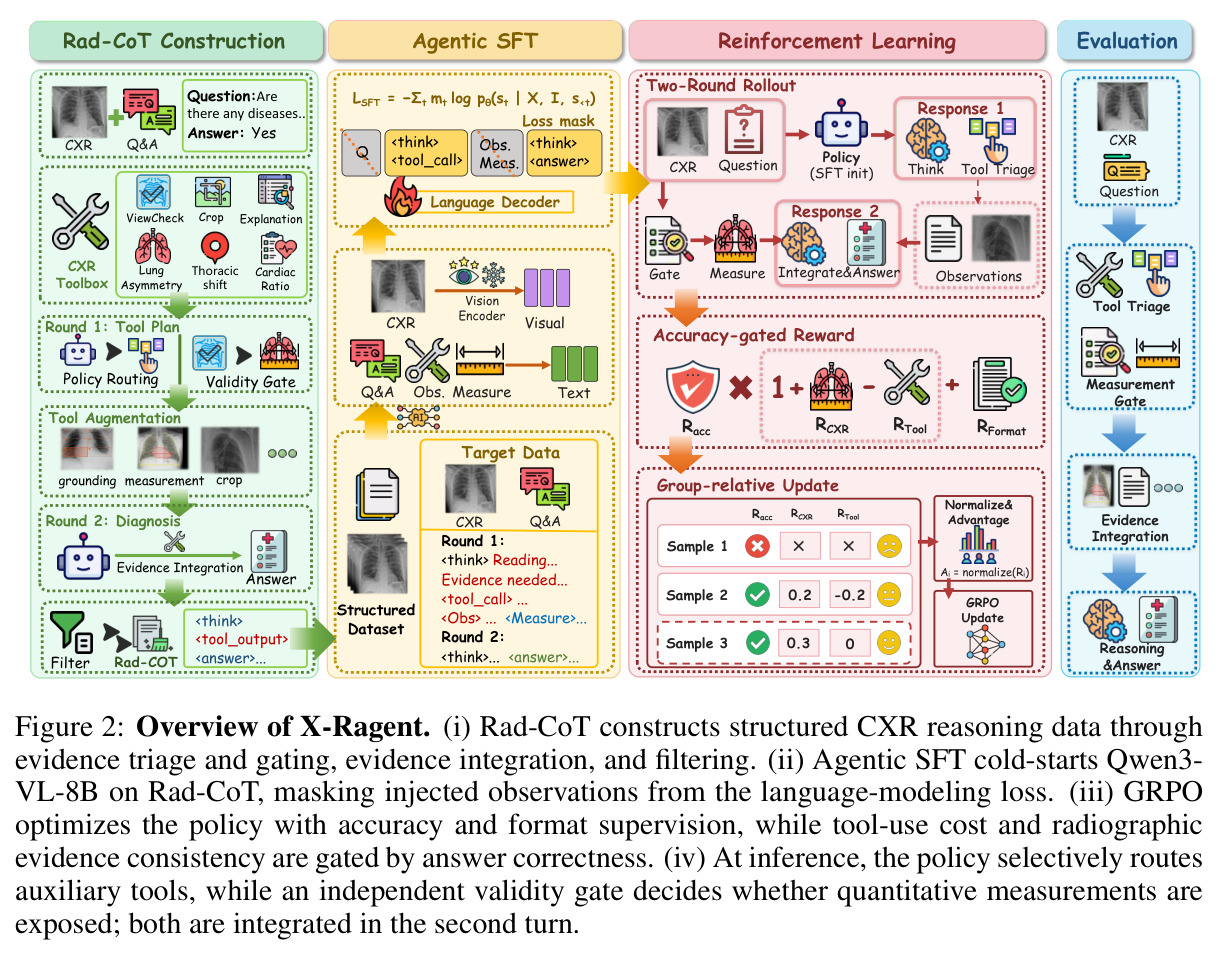
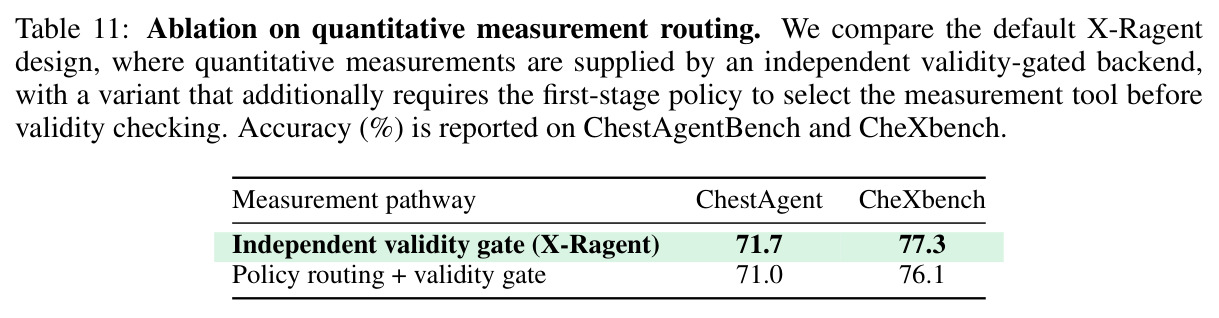
与已有工作不同的是,与 MedRAX、MMedAgent 等用提示词编排现成工具的智能体不同,X-Ragent 的独特切入有三点。第一,『学』与『门』解耦:哪些可选证据值得获取由策略通过 RL 学出来,而定量测量是否可信由一个独立的规则驱动有效性门 $g(I)=g_{\mathrm{view}}(I)\,g_{\mathrm{quality}}(I)$ 决定,二者互不干扰——表 11 显示若把测量也交给策略路由,准确率反而从 71.7% 降到 71.0%,因为策略倾向漏调这些线索。第二,准确性门控奖励:总奖励 $R(\tau)=R_{\mathrm{format}}+R_{\mathrm{acc}}[1+\lambda_m R_{\mathrm{CXR}}-\lambda_t R_{\mathrm{tool}}]$ 把过程级项乘在 $R_{\mathrm{acc}}$ 内,错误轨迹无法靠『调了工具、引了测量』这类表面好看的过程行为获得补偿,从机制上杜绝证据-诊断不一致被强化。第三,因果有序的两轮数据构造:Rad-CoT 中工具观测严格在请求动作之后注入,与推理时交互结构一致,且 SFT 损失掩码掉观测片段,防止模型学会模仿工具输出。
核心方法
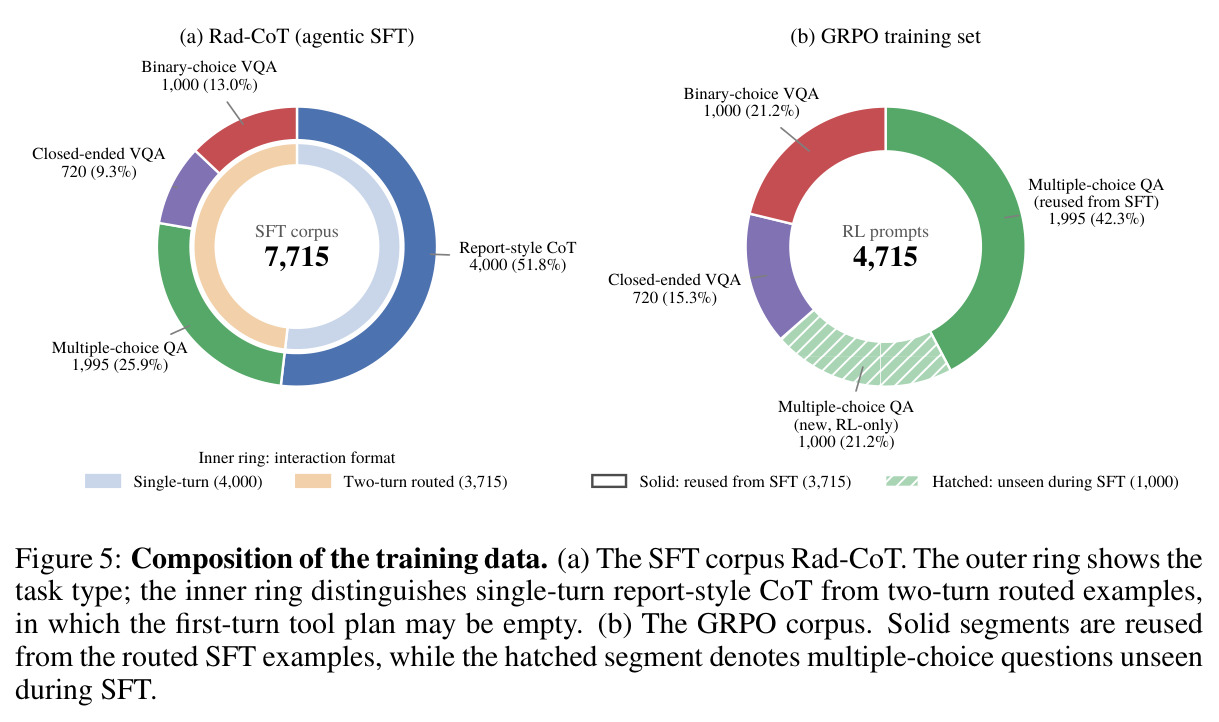
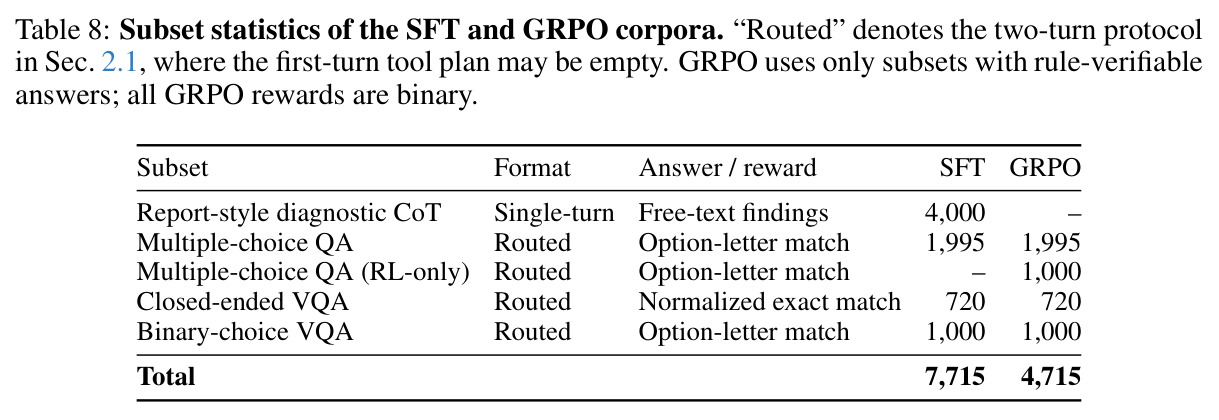
X-Ragent 是一个后训练框架,整体分四步。第一步构造 Rad-CoT 数据:把 MIMIC-CXR-JPG 的 PA 正位片与 LLaVA-Rad 结构化标注配对,用本地部署的 Qwen3.5-122B-A10B-FP8 生成两轮式工具轨迹和报告式思维链,经确定性过滤(剔除提示泄漏、畸形、与参考发现相似度超过 0.82 的理由,要求 40-900 词)得到 7715 条样本(3715 条两轮路由 + 4000 条单轮报告式 CoT)。第二步 agentic SFT 冷启动 Qwen3-VL-8B:损失只算在策略生成的 token 上、注入的工具观测被掩码,学习率 $1\times10^{-5}$、1 个 epoch、冻结视觉编码器。第三步 GRPO 强化:在 4715 条可验证题上训练 300 步,每题采 $G=4$ 条 rollout,组内归一化得优势 $A_i=(r_i-\mathrm{mean})/\mathrm{std}$,奖励 $R=R_{\mathrm{format}}+R_{\mathrm{acc}}[1+0.5\,R_{\mathrm{CXR}}-0.05\,R_{\mathrm{tool}}]$。第四步推理采用两轮协议:第一轮全局读片并输出可选工具计划($K\le 5$),有效性门独立判断是否暴露测量包;第二轮把裁剪图、掩膜、检索知识与(若有效)测量整合后输出答案。
核心创新是把『学习式证据获取』与『门控式定量测量』彻底解耦,并用乘法准确性门控的过程奖励保证整合忠实性。已有医学智能体要么把所有工具都暴露给策略由提示词编排(如 MedRAX),要么用 RL 统一学习所有工具调用;X-Ragent 则区分两类证据:策略可路由的可选工具(视觉细化、知识检索)由 GRPO 学习『何时值得调』;而 $\mathrm{CTR}=w_c/w_t$、$\mathrm{LFA}=\ln(A_R/A_L)$、胸廓偏移这类可验证的确定性测量由后端自动计算,只有当 view_check 确认为 PA 正位且解剖掩膜通过质量检查时才以结构化观测暴露,否则 $M(I)=\varnothing$。关键语义约定是:缺失的测量表示『证据不可用』而非『表现正常』,策略须从可见轮廓另行判断。另一个关键设计是 $R_{\mathrm{acc}}$ 的乘法门控:由于 $\lambda_t K_{\max}<1$,任何正确轨迹的奖励必然高于任何错误轨迹,过程奖励只用于在正确轨迹之间排序。消融(表 3)显示不加门的组合(69.8%)甚至比只加工具成本(70.1%)更差——不加门时错误轨迹也能赚 $R_{\mathrm{CXR}}$,而工具成本又不分对错地惩罚取证——加上门控才达 71.7%。
方法步骤详情
第一步,数据构建。筛选 MIMIC-CXR-JPG 中有图像且参考发现非平凡的 PA 研究,分层抽取约 6000 例候选;本地 Qwen3.5-122B-A10B-FP8 以『图像+参考发现』为条件生成诊断理由(答案条件化生成,参考发现保留为监督目标以防目标漂移);过滤掉提示泄漏、畸形或异常长度、与参考发现相似度超过 0.82 的理由(保留 40-900 词的最长有效段),得到 4000 条报告式 CoT;另构造 1995 道多选题、720 道封闭式 VQA、1000 道二选一 VQA 的两轮工具轨迹(共 3715 条),合计 7715 条,并用 CheXbert 校验 14 类标签覆盖。第二步,agentic SFT:最小化 $\mathcal{L}_{\mathrm{SFT}}=-\mathbb{E}_\mathcal{T}[\sum_t \log p_\theta(s_t|X,I,s_{<t})]$,仅覆盖策略 token,观测 span 掩码;学习率 $1\times10^{-5}$、有效批 16、序列上限 8192、1 epoch。第三步,GRPO:4715 条 prompt(3715 条复用 SFT 两轮题 + 1000 道新多选题),300 步,$G=4$,学习率 $2\times10^{-6}$,clip $\epsilon=0.2$,KL 系数 $\beta=0.01$;$R_{\mathrm{CXR}}=\max(1,\sum_k a_k s_k/\sum_k a_k)$ 只对与问题相关($r_k$)且被门控暴露($b_k$)、即 $a_k=r_k b_k$ 的测量计分,$R_{\mathrm{tool}}$ 统计策略生成的可选调用次数(重复调用分别计数)。第四步,推理:第一轮输出思维与工具计划;region_parse 用 CXAS/BiomedParse 返回掩膜与边界框,roi_crop 按框 $I_{\mathrm{crop}}=I[y_1:y_2,x_1:x_2]$ 放大区域,evidence_lookup 从本地 Qwen3.5-27B 检索候选疾病的影像学特征;门 $g(I)$ 通过时附上测量包;第二轮整合后输出 $\langle R,A\rangle$。
技术新颖性
技术新颖性体现在三处。其一,相对通用工具学习范式(Toolformer、ReAct、HuggingGPT),本文引入临床采集有效性这一被长期忽视的维度:确定性测量只在特定投照条件下成立。论文用反事实案例(图 4)展示一个不适定的肺野不对称测量 $\ln(A_R/A_L)=-1.01$($R/L=0.36$)如何把正确答案 C 翻成错误答案 A,而门控扣留后模型保持正确——『证据本身也可能有毒』这一视角在医疗智能体文献中少见。其二,奖励工程上,把过程项乘进 $R_{\mathrm{acc}}$ 的门控形式比常见的线性加权更稳健:表 3 显示无门组合(ChestA 69.8%)反而低于单项(70.1%/70.6%),门控组合达 71.7%,提供了一个可直接复用的奖励设计模式。其三,训练数据上,Rad-CoT 的两轮因果有序构造加观测掩码,把『学会调用』与『学会模仿工具输出』分开监督;配合答案条件化蒸馏(教师只生成推理过程、参考发现保留为答案)降低目标漂移,加上相似度阈值、词数范围、CheXbert 分布校验与评测图零重叠检查,构成合成轨迹质量控制的较完整范式。
实验结果
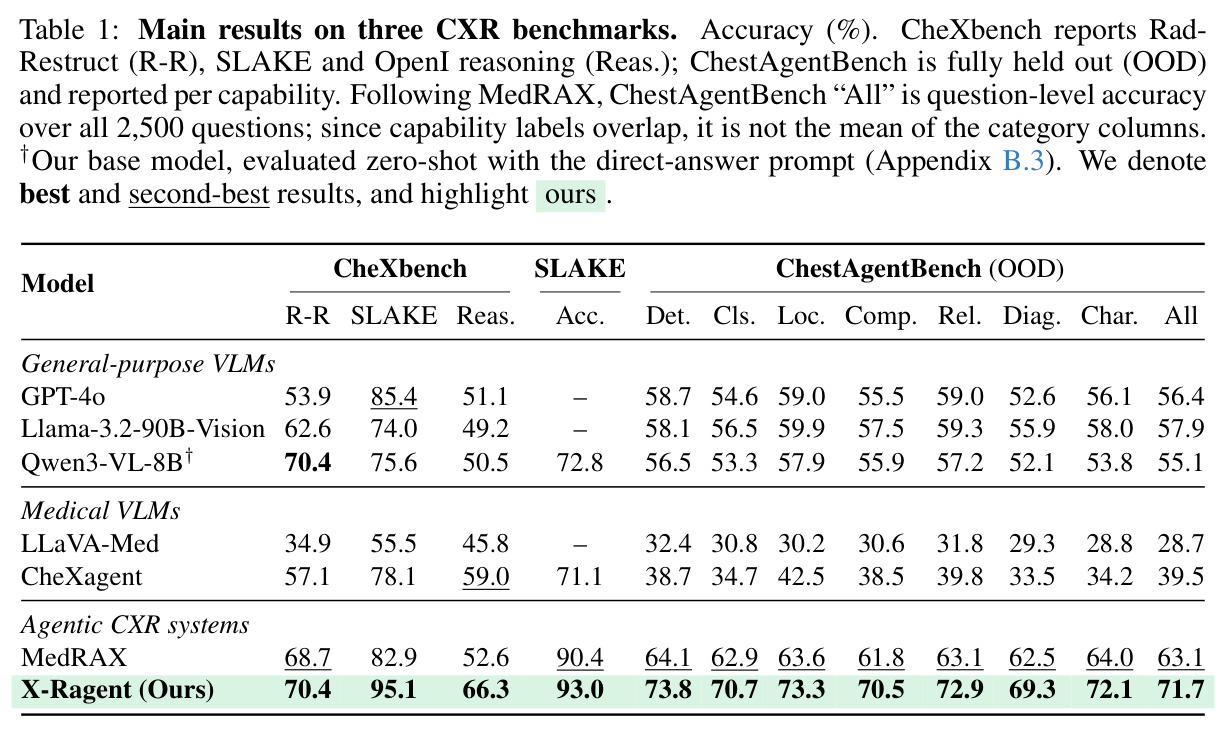
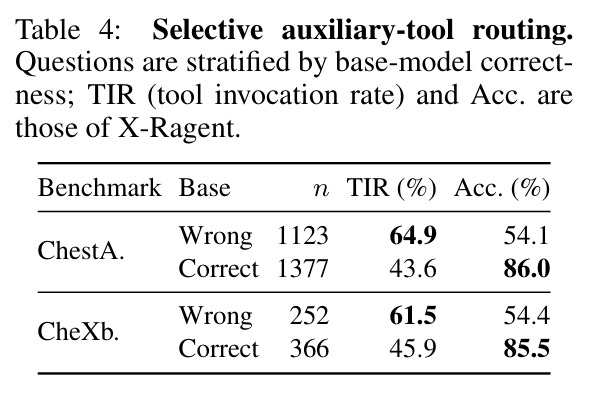
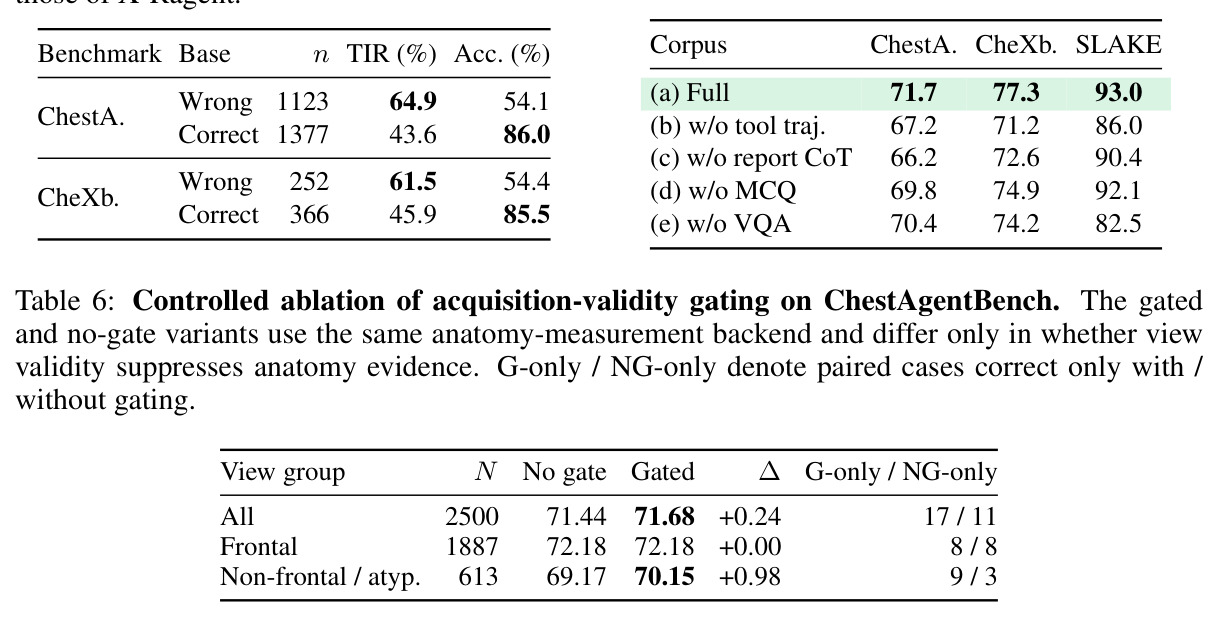
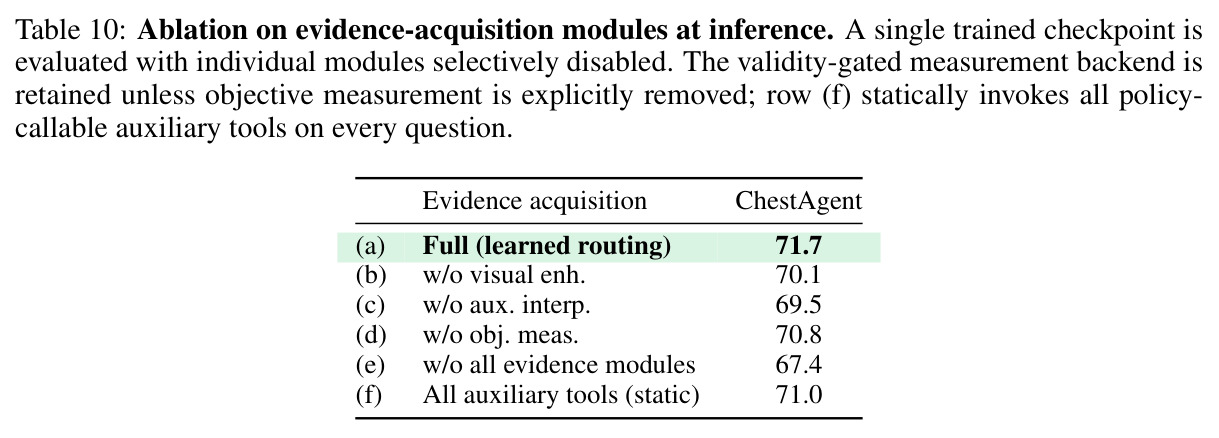
主结果(表 1):X-Ragent 在三个基准全面 SOTA。ChestAgentBench(2500 道六选一题,完全 held-out)71.7%,超最强基线 MedRAX(63.1%)8.6 分,七个能力子项全部第一:检测 73.8、分类 70.7、定位 73.3、比较 70.5、关系 72.9、诊断 69.3、表征 72.1;CheXbench 三子集平均 77.3%(Rad-ReStruct 70.4、SLAKE 95.1、OpenI 推理 66.3),超 MedRAX 9.2 分;SLAKE 93.0% 超 MedRAX 2.6 分。相对基座 Qwen3-VL-8B 分别提升 16.6、11.8、20.2 分,8B 模型超过 GPT-4o(56.4%)和 Llama-3.2-90B(57.9%)。流水线消融(表 2,三基准平均):零样本 64.5 → 仅 RL 69.0 → 仅 SFT 75.3 → SFT+RL 77.6 → 加工具 80.7;SFT 是最大单项增益(+10.8),RL 主要提升迁移(ChestA +3.0 > CheXb +1.2),工具增益集中在多步推理基准(ChestA +4.3、CheXb +4.1)而接近饱和的 SLAKE 仅 +0.9(114 题、单题值 0.88%)。奖励消融(表 3):仅 $R_{\mathrm{acc}}$+格式 69.4/75.3/91.2;无门双项组合反降至 69.8/75.6/91.2;门控组合 71.7/77.3/93.0 最优。选择性路由(表 4):基座做错的题上工具调用率 64.9% vs 做对的 43.6%(1.49×),纠正/退化比 3.15×(CheXb 2.58×),整体仅 53.2% 的问题调用工具。数据消融(表 5):去工具轨迹掉 4.5/6.1/7.0 分,去报告式 CoT 在 OOD 掉 5.5 分,去 VQA 在 SLAKE 掉 10.5 分。门控控制实验(表 6):view_check 对 24.5% 输入阻止测量执行(31% 最终被扣留),非正位/非典型 613 张子集 69.17→70.15(+0.98),正位 1887 张不变,整体 +0.24。附录表 10:推理时去掉全部证据模块掉 4.3 分(部分能力已内化),静态全调用 71.0% 反而低于学习路由 71.7%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ChestAgentBench(2500 道六选一题,完全 held-out / OOD) | 总体准确率 (%) | 71.7 | MedRAX 63.1(基座 Qwen3-VL-8B 55.1,GPT-4o 56.4,Llama-3.2-90B 57.9) | +8.6 vs MedRAX;+16.6 vs 自身基座 |
| CheXbench(Rad-ReStruct + SLAKE + OpenI 推理) | 三子集宏平均准确率 (%) | 77.3(70.4 / 95.1 / 66.3) | MedRAX 68.1(68.7 / 82.9 / 52.6) | +9.2(SLAKE 子集 +12.2,OpenI 推理 +13.7) |
| SLAKE 独立测试集(114 道封闭式题) | 精确匹配准确率 (%) | 93.0 | MedRAX 90.4(基座 72.8) | +2.6 vs MedRAX;+20.2 vs 基座 |
| ChestAgentBench 七项能力子集 | 各能力准确率 (%) | 69.3–73.8 全部第一(检测 73.8 最高,诊断 69.3 最低) | MedRAX 62.5–64.1 | 每项较基座提升 14.6–18.3 分 |
| ChestAgentBench 非正位/非典型胸片子集(613 张) | 准确率 (%) | 70.15(有效性门控开启) | 同一测量后端、无门控 69.17 | +0.98(9 纠正 vs 3 退化) |
局限与改进
作者承认的局限:X-Ragent 是研究原型而非医疗器械,不能用于临床决策;有效性门控的整体收益不大(ChestAgentBench 上仅 +0.24),收益集中在 613 张非正位/非典型片子(+0.98),价值依赖测试集中不适定样本的比例;Rad-CoT 只基于 MIMIC-CXR-JPG 的 PA 图像、由本地 Qwen3.5 教师生成,合成数据偏差可能被继承。我的补充观察:其一,测量套件只有 CTR、肺野不对称、胸廓偏移三个指标且只适用 PA 正位,离真实报告所需定量证据的覆盖面还很远;其二,两轮固定结构加 $K\le 5$ 的调用上限限制了多轮探索,无法对工具结果追问、复核或修正;其三,三个评测都是多选/VQA 精确匹配,未涉及报告生成、放射科医生评估或临床下游结局;其四,$R_{\mathrm{CXR}}$ 依赖人工设定的测量-任务对应表 $r_k$,每新增一个测量都要重新设计规则与阈值;其五,只在 Qwen3-VL-8B 一个基座上验证,结论对其他 MLLM 的普适性未测;其六,CheXbench 的 Rad-ReStruct 子集仅与基座持平(70.4%),说明获益主要来自多步推理而非所有任务类型。
独立分析的弱点
独立分析的弱点及改进方向:第一,教师偏置——Rad-CoT 由 Qwen3.5-122B 生成,其诊断风格与知识边界会成为策略先验,而基于形式的过滤(词数、相似度、畸形)无法验证医学正确性,改进方向是放射科医生抽检或多教师交叉验证。第二,evidence_lookup 调用一个 27B 通用 LLM 获取『疾病的典型影像表现』,这类教科书知识可能过时、与具体病例不符且无引用溯源,可改为检索结构化临床指南或带出处的影像图谱库。第三,view_check 用 OpenCXR 把图像分为 PA/AP/侧位/非胸片四类并只对 PA 放行测量,体位分类错误会级联为错误暴露或错误扣留,可在边界样本上引入不确定性估计、拒绝测量并显式告知模型原因。第四,SLAKE 仅 114 题(单题值 0.88%),部分结论(如工具仅 +0.9)统计功效不足,应报告置信区间或换用更大评测集。第五,奖励权重 $\lambda_m=0.5$、$\lambda_t=0.05$ 为手工设定且只在 8B 基座上调过,跨规模与跨基座的敏感性未知。第六,『缺失=不可用』的语义约定目前只有案例级证据(图 6),缺少系统量化:可构造含缺失测量的对照集,统计模型把缺失误读为正常的比例。第七,两轮协议意味着测量包在第一轮就已注入,策略无法基于第一轮读片结果再决定是否需要测量(表 11 显示交给策略又会漏调),这说明门控与路由的折中尚未最优。
未来方向
作者方向上,论文暗示但未展开的有:把有效性门控推广到更多确定性测量与更多投照条件(AP、侧位、卧位片)及更细的掩膜质量控制;把 Rad-CoT 数据管线扩展到其他影像模态或报告生成任务。基于成果可自然延伸的方向:其一,把规则门控升级为可学习的不确定性感知门控,对每个测量输出置信度并让策略以『证据可信度』为条件推理,同时保留缺失语义;其二,打破两轮固定结构,做多轮 ReAct 式交互的 GRPO,允许策略在观测后追加调用(需重新设计信用分配与工具成本归账);其三,与测量幻觉检测(如 FactChecker)闭环,把 $R_{\mathrm{CXR}}$ 从三个指标扩展到报告级声明验证,实现生成报告的定量事实核查;其四,把『准确性门控过程奖励』迁移到其他工具增强 RL 任务——论文引用的 FactGuard(视频取证)、IndusAgent(门控 RL 工具调用)表明该设计模式正在成形,值得系统化;其五,前瞻性临床验证:在有金标准的多读者研究中量化门控对诊断安全性的净效应,这是走向医疗器械级系统的必经之路;其六,探索测量缺失时的主动澄清行为,让模型学会在证据不可用时输出不确定性而非强行作答。
复现评估
复现条件总体友好但有关卡。数据方面:MIMIC-CXR-JPG 与 LLaVA-Rad 标注需 PhysioNet 凭证协议,Rad-CoT 承诺仅通过 PhysioNet 发布(截至论文尚无明确时间表),SLAKE、OpenI、Rad-ReStruct 需分别申请;论文的评测切分工作较细(OpenI 评测 452 张唯一图像与训练集零重叠、报告级兄弟图像泄漏为零),可直接沿用其协议。代码方面:论文未给出开源链接,但工具栈全部可用开源件复刻——CXAS、BiomedParse、OpenCXR、Qwen3-VL-8B-Instruct 均公开,evidence_lookup 需本地部署 Qwen3.5-27B 的 OpenAI 兼容 API,测量后端为 CXAS 掩膜加确定性规则(CTR、$\ln(A_R/A_L)$、胸廓偏移的公式完整给出)。算力方面:SFT 冻结视觉编码器、序列 8192、有效批 16、仅 1 epoch(7.7K 样本),单节点 8×A100/H100 一天内可完成;GRPO 300 步、每步 16 prompt × 4 rollout、每条轨迹至多 5 次工具调用加一次外部 LLM 查询,配合测量预计算缓存约数天量级;最重的是数据生成:Qwen3.5-122B-A10B-FP8 本地推理约 6000 例候选(FP8 量化,2×H100 起步可行)。超参(表 7)与全部提示词(附录 E)已完整公开,主要工程量在数据管线与两轮交互编排,总体复现难度中等。
论文图表
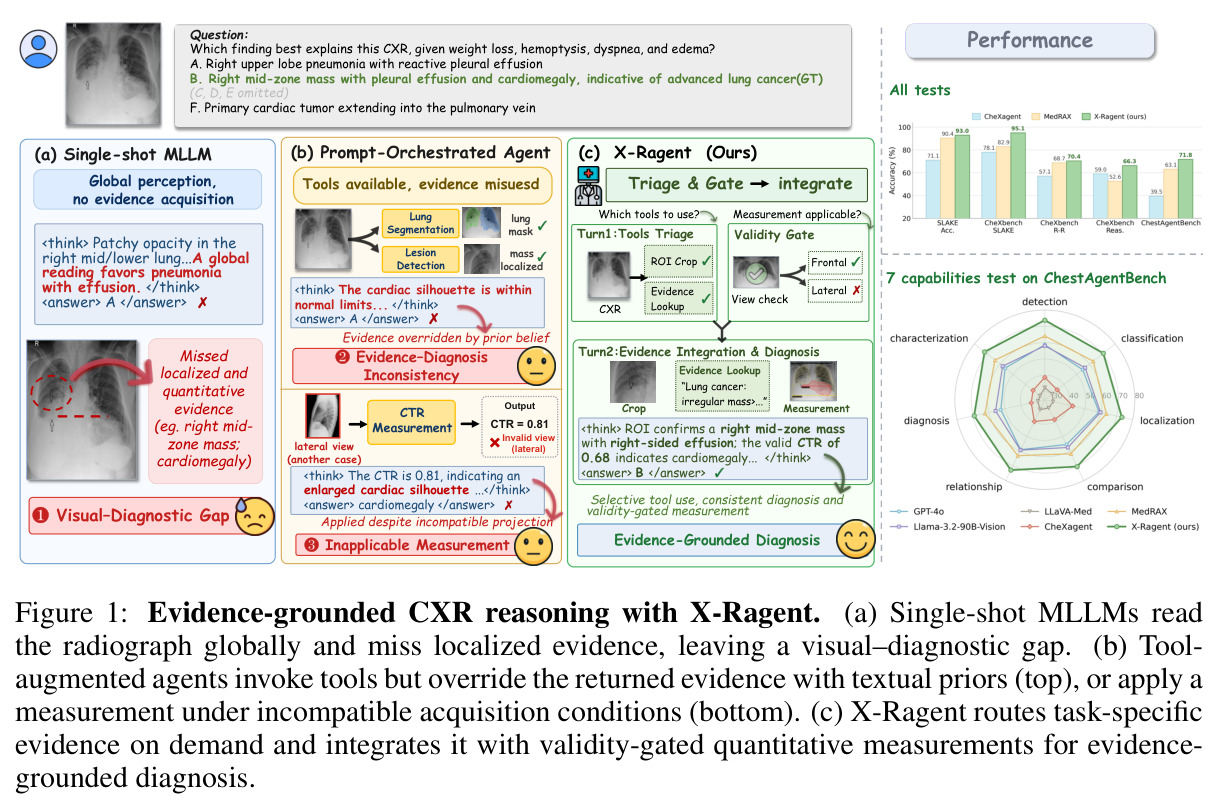
三栏对比图,用一个具体病例(体重下降、咯血、呼吸困难伴水肿的胸片)展示三种范式的差异:(a) 单次前向 MLLM 全局读片、缺乏局灶证据获取,答错选 A;(b) 提示词编排的智能体虽然能调工具,但上半例用文本先验覆盖工具返回的客观证据、下半例在不兼容投照体位上强行使用测量(CTR=0.81 判心影增大),同样答错;(c) X-Ragent 第一轮做工具分诊(区域解析、ROI 裁剪、文献检索被勾选,侧位检查被排除),第二轮结合有效性门控通过的 CTR=0.81 等定量证据给出证据支撑的正确答案 B。
一图讲清论文要解决的三个缺口(视觉-诊断鸿沟、证据-诊断不一致、不适定测量)与解法全貌,是理解全文动机与方法的最佳入口。
流水线消融:零样本(平均 64.5)、仅 RL(69.0)、仅 SFT(75.3)、SFT+RL(77.6)、SFT+RL+工具(80.7,即完整版 71.7/77.3/93.0)。SFT 是最大单项增益(+10.8),仅 RL 比 SFT-only 低 6.3 分,工具增益集中在 OOD 的 ChestAgentBench(+4.3)与 CheXbench(+4.1)而接近饱和的 SLAKE 仅 +0.9。
回答了『每个训练阶段各贡献多少』:SFT 建立核心推理行为、RL 提升迁移、工具增强提供外部证据,这一分解直接支撑两阶段冷启动设计的必要性。
数据构成消融(保持总量不变重采样):(a) 完整版 71.7/77.3/93.0;(b) 去掉工具轨迹后 67.2/71.2/86.0(分别掉 4.5/6.1/7.0);(c) 去掉报告式 CoT 在 held-out ChestAgentBench 掉最多(-5.5);(d) 去多选题 -1.9 左右;(e) 去 VQA 主要伤 SLAKE(-10.5)。
说明三类监督各自的作用:工具轨迹教调用与整合、报告式 CoT 教可迁移的诊断推理、VQA 教封闭式作答格式,为构造同类数据提供配方。