InfoVis:统一的幻灯片图像生成与编辑 InfoVis: Unified Slide Image Generation and Editing
构建1300万级幻灯片数据引擎与专用基准,训练统一9B模型将生成与编辑做到逼近最强闭源系统
前置知识
扩散Transformer与文生图基座模型(FLUX.2)
扩散模型靠逐步去噪成像:训练时加噪、模型学预测噪声,推理时从纯噪声迭代去噪(50 步 FlowMatch)。FLUX.2 是 Black Forest Labs 的开源扩散 Transformer,klein-base-9B 内置 Qwen3 文本编码器与 VAE,是 InfoVis 起点。
InfoVis 不从零训练,而是在 FLUX.2-klein-base-9B 上做领域后训练;论文几乎所有结论(+1.64 分提升、统一与专家的权衡、与 32B FLUX.2-dev 的对比)都以这个基座为参照系。
持续预训练(CPT)与监督微调(SFT)
持续预训练是在已训练好的基座上用大规模领域数据继续训练,让模型适应新分布;监督微调则用更小规模、高质量、精确配对的指令-目标数据对齐任务格式。本文 CPT 超过 1300 万条、SFT 约 190 万条,两者指令形式一致(短请求、详细描述、style_json 三档),差别在规模与质量过滤强度。
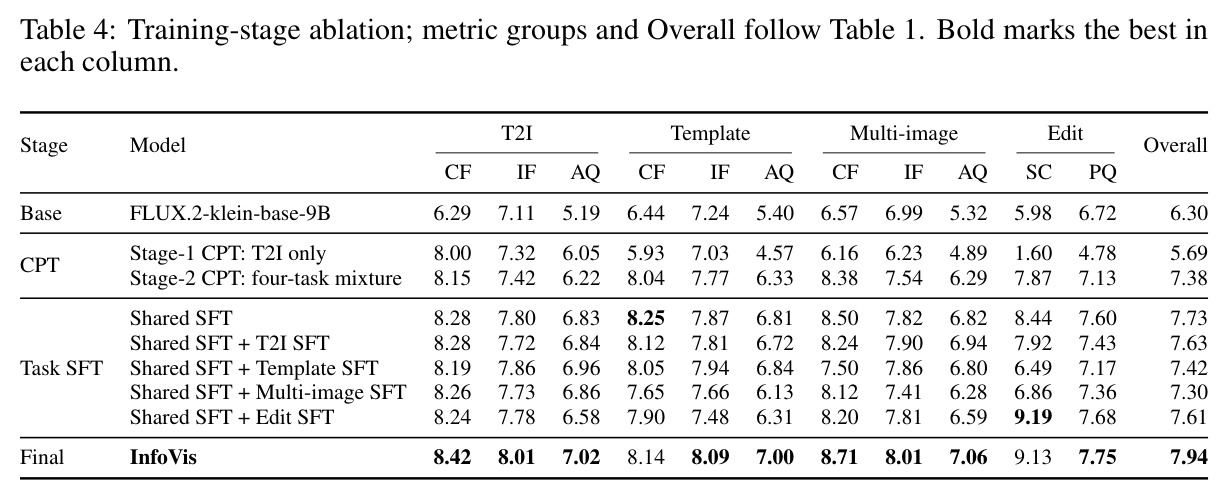
三阶段训练(slide-native CPT → 四任务混合 CPT → 任务 SFT 与融合)是本文方法骨架;消融证明跳过任何阶段都会能力塌陷,例如只做 T2I CPT 会让编辑 SC 从 5.98 跌到 1.60。
模型融合(Model Fusion / Model Soup)
对同一基座在不同任务上微调得到的多个权重检查点做线性加权平均 $\theta=\sum_k \alpha_k \theta_k$,在不增加推理成本的前提下保留各专家能力、缓解多任务微调的任务间干扰,源自 Model Soups 与 task arithmetic 工作。
InfoVis 最终模型就是把 T2I、模板、多图、编辑四个任务专家线性融合而来,是『统一模型不牺牲专家性能』这一核心结论(编辑 SC 9.13 对专家 9.19)的技术关键。
指令式图像编辑(Instruction-based Editing)
给定源图像和自然语言指令(如『把标题改成红色』),输出执行了编辑且无关内容不变的图像。评测拆成编辑是否执行(SIF)与无关内容是否保留(SEC)两维,本文用 $SSC=\min(SIF,SEC)$ 同时硬性要求两者,再以 $S_{Edit}=\sqrt{SSC\cdot SPQ}$ 汇总。
幻灯片编辑是四大任务之一,其训练数据来自可执行的 PPTX 变换;理解『确定性编辑对』与『模型生成式编辑对』(主题切换、图像替换)的区别,才能判断数据可信度与评测口径。
OCR 归一化编辑距离(文本渲染保真度)
用 OCR 读取生成图像中的文字,与指令要求的文本逐串计算 Levenshtein 编辑距离并按目标长度归一化:$S_{text}=\max(10-9N_e/N_{tgt},\,1)$,$N_e$ 为最小编辑距离之和、$N_{tgt}$ 为目标字符总数。它把『字有没有写对』变成可复现的数值指标。
Content Faithfulness 是幻灯片生成最重要的维度,也是 InfoVis 相对基座提升最大的指标(三个生成任务 +1.70 至 +2.14);理解该指标才能读懂主结果表与『剩余差距按主观性排序』的分析。
评测器-人类一致性(Kendall's $\tau_b$ 与 Spearman's $\rho$)
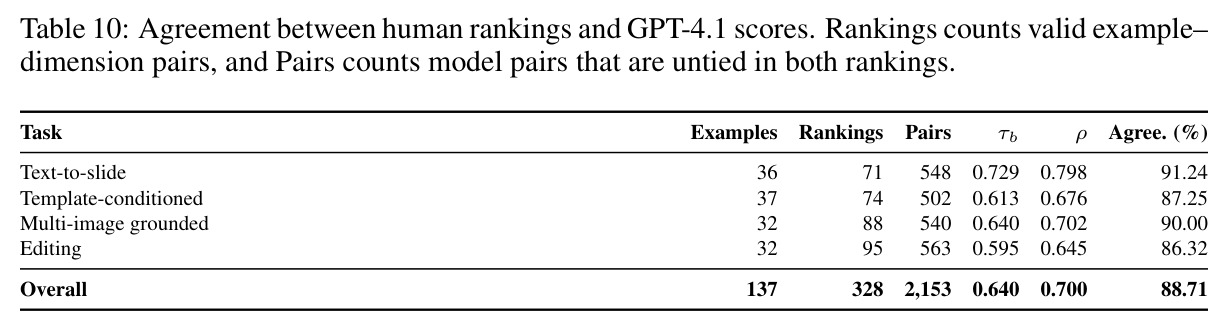
用自动评测器(GPT-4.1)对多个模型输出排名,与人类专家盲评对比:Kendall's $\tau_b$ 是考虑并列的成对顺序一致率,Spearman's $\rho$ 是秩相关。本文 $\tau_b=0.640$、一致率 88.71%(2,153 个有效模型对)。
VisSlideBench 的所有分数都来自自动评测器,该验证决定『benchmark 是否可信』,也是它区别于大量缺少人评校验的同类 benchmark 的核心依据。
研究动机
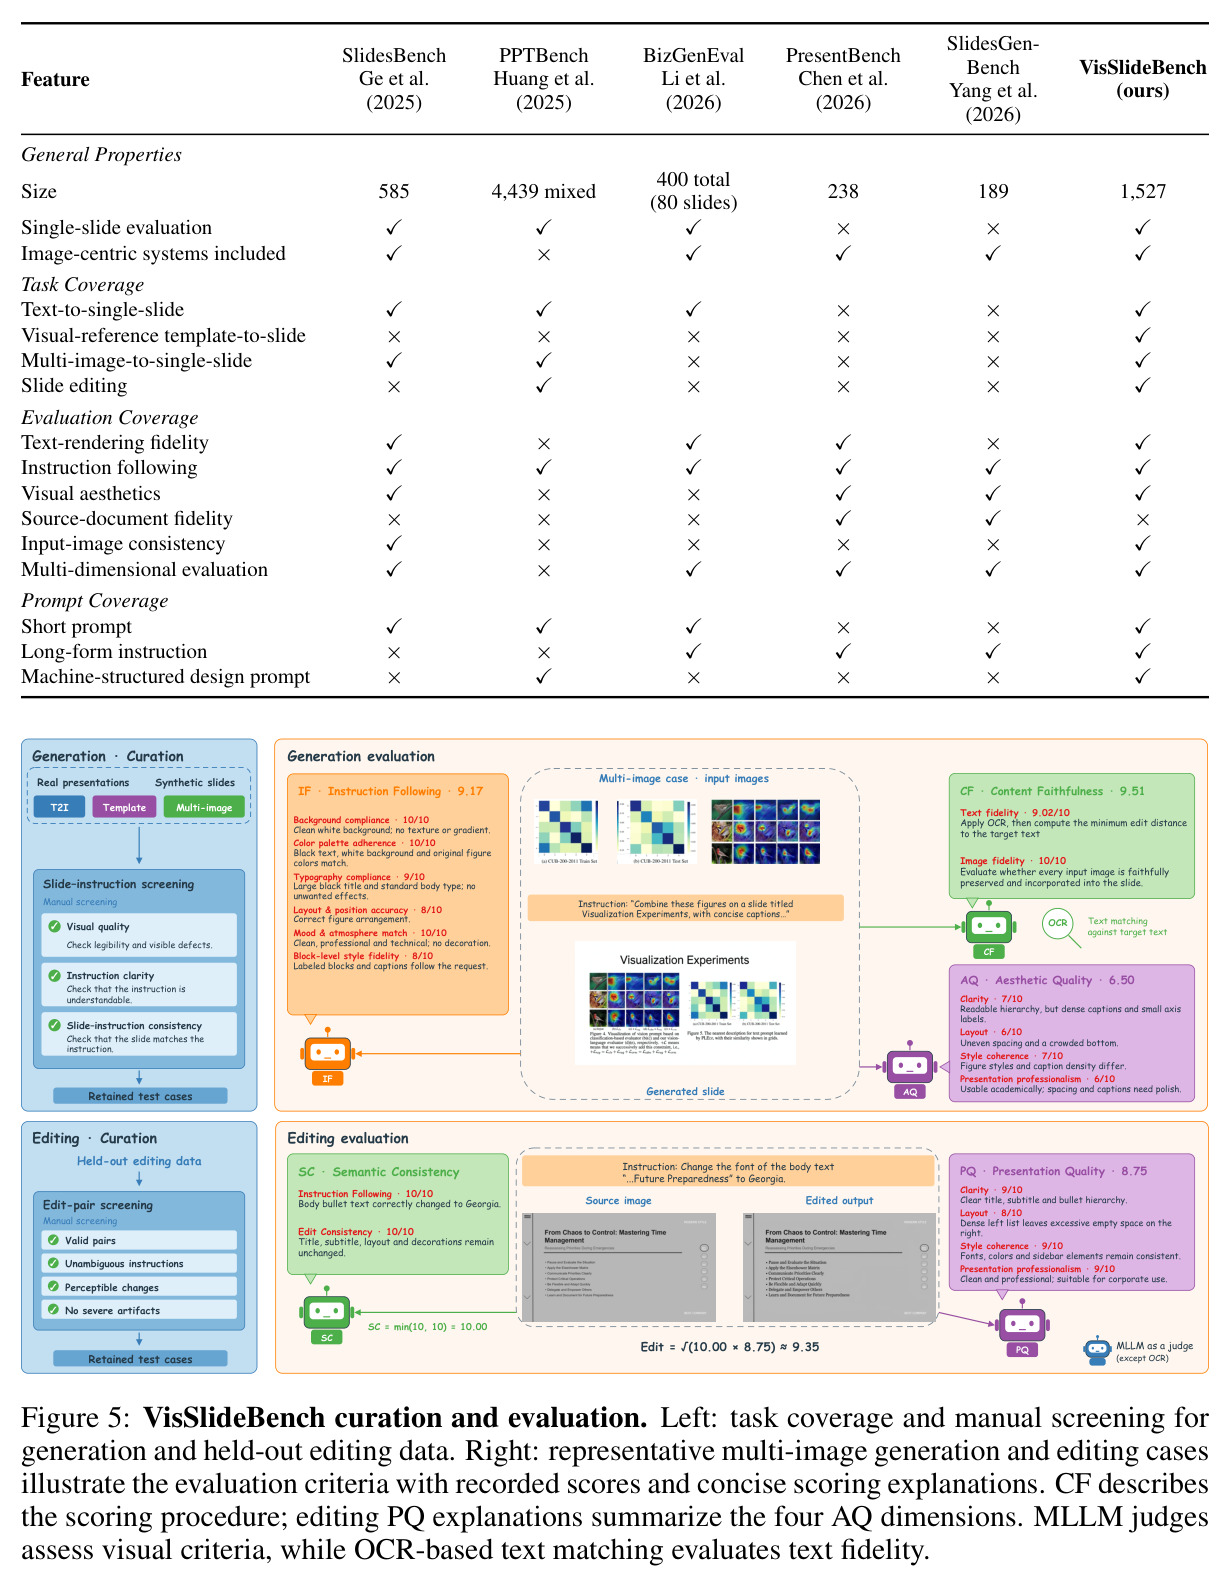
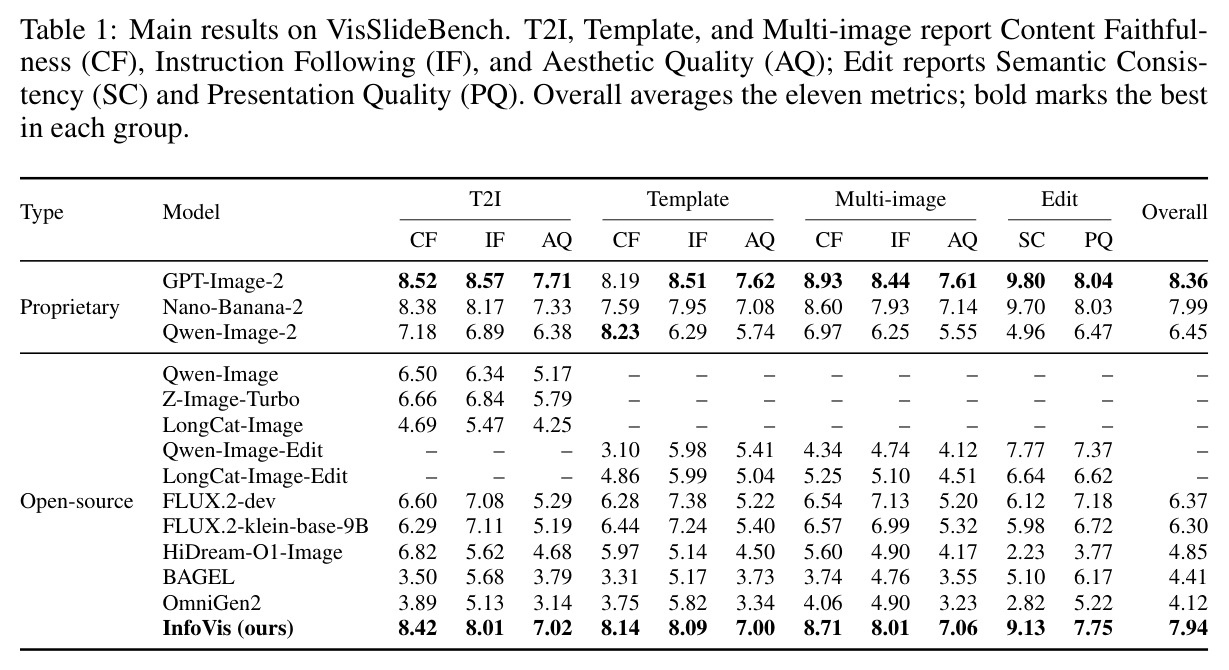
制作演示幻灯片图像对现有生成模型是复合挑战:模型必须在同一画布上同时准确渲染大段文字、把标题/要点/图表/装饰等异构元素组织成连贯版式、忠实嵌入用户提供的视觉素材,并在编辑时只改请求处而保持其余内容不动。这些能力在通用模型里各自发展、拼在一起时不可靠:开源的 Qwen-Image 在本文 T2I 测试上文本渲染仅 6.50 分、FLUX.2-dev 6.60;统一的生成-编辑模型 BAGEL、OmniGen2、HiDream-O1-Image 在 VisSlideBench 上总分仅 4.1-4.9,编辑上大幅落后专家 Qwen-Image-Edit。更深层障碍是监督与评测两头缺失:通用生成器在自然图像分布上训练,缺少幻灯片特有的内容-版式-设计关系监督;现有 benchmark(SlidesBench、PPTBench、BizGenEval、SlidesGen-Bench 等)要么面向程序化或整套演示文稿生成,要么把幻灯片当商业视觉内容的子集,都没有系统隔离『单页幻灯片图像生成与编辑』所需的文本保真、模板一致、视觉 grounding 与编辑保持能力。
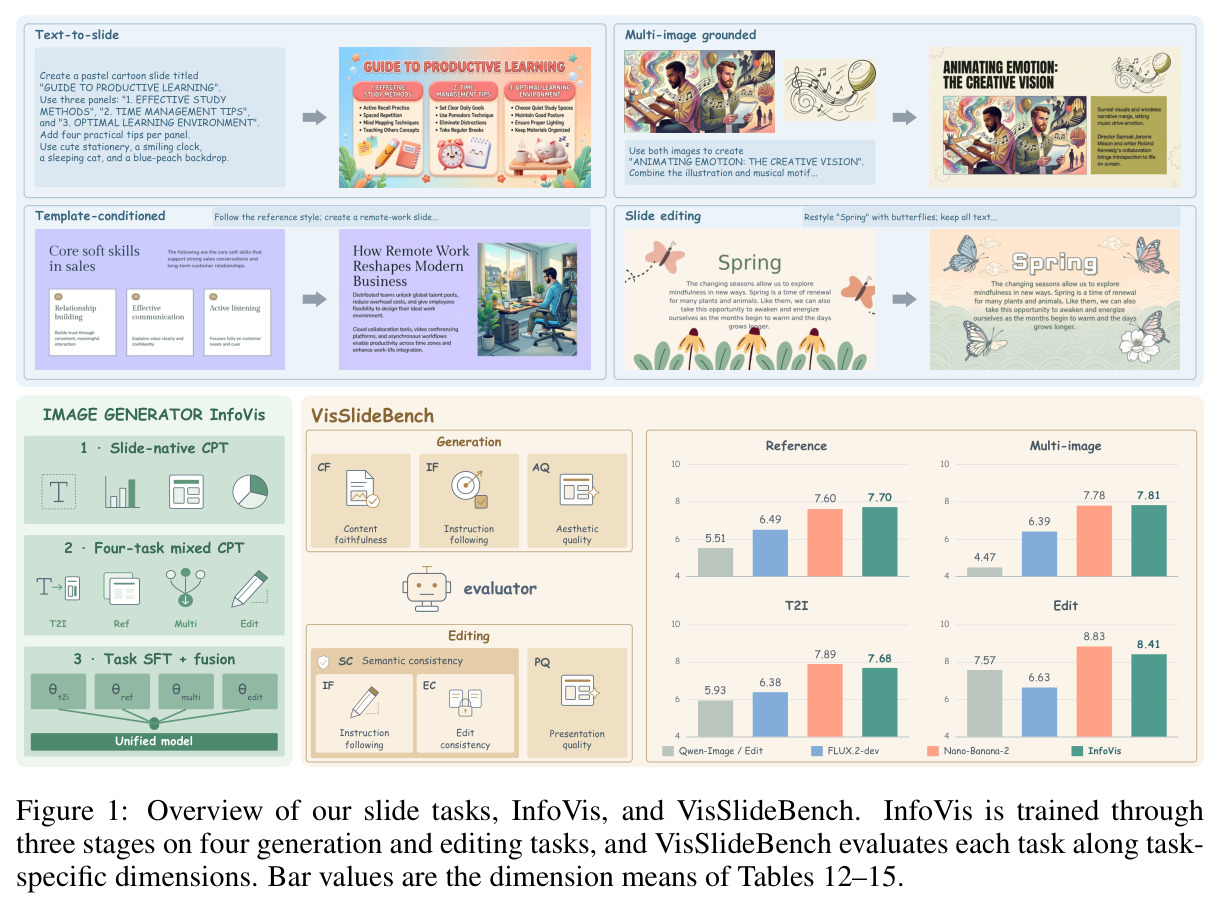
本文的目标是本文要回答的问题是:能否用一个模型、在单一『文本+可选图像』接口下可靠完成幻灯片创作全链路?为此设立四个具体目标。其一,形式化四个互补任务:纯文本生成幻灯片(T2I)、模板条件生成(参考页定风格)、多图 grounded 生成(必须保留并合理安置 1-4 张输入素材)、指令式幻灯片编辑。其二,构建可扩展的幻灯片原生数据引擎,产出超过 1300 万条持续预训练记录和约 190 万条 SFT 记录,覆盖全部四个任务的条件形式与三种指令粒度。其三,发布 VisSlideBench:1,527 个人工筛选实例,覆盖四任务,每个任务有专属多维指标(生成的 CF/IF/AQ 与编辑的 SC/PQ),且自动评测与盲评人类排名一致($\tau_b=0.640$)。其四,训练统一的 9B 模型 InfoVis,在全部 11 个指标上领先所有开源模型,并把整体分数逼近最强专有系统 Nano-Banana-2(7.94 对 7.99)。
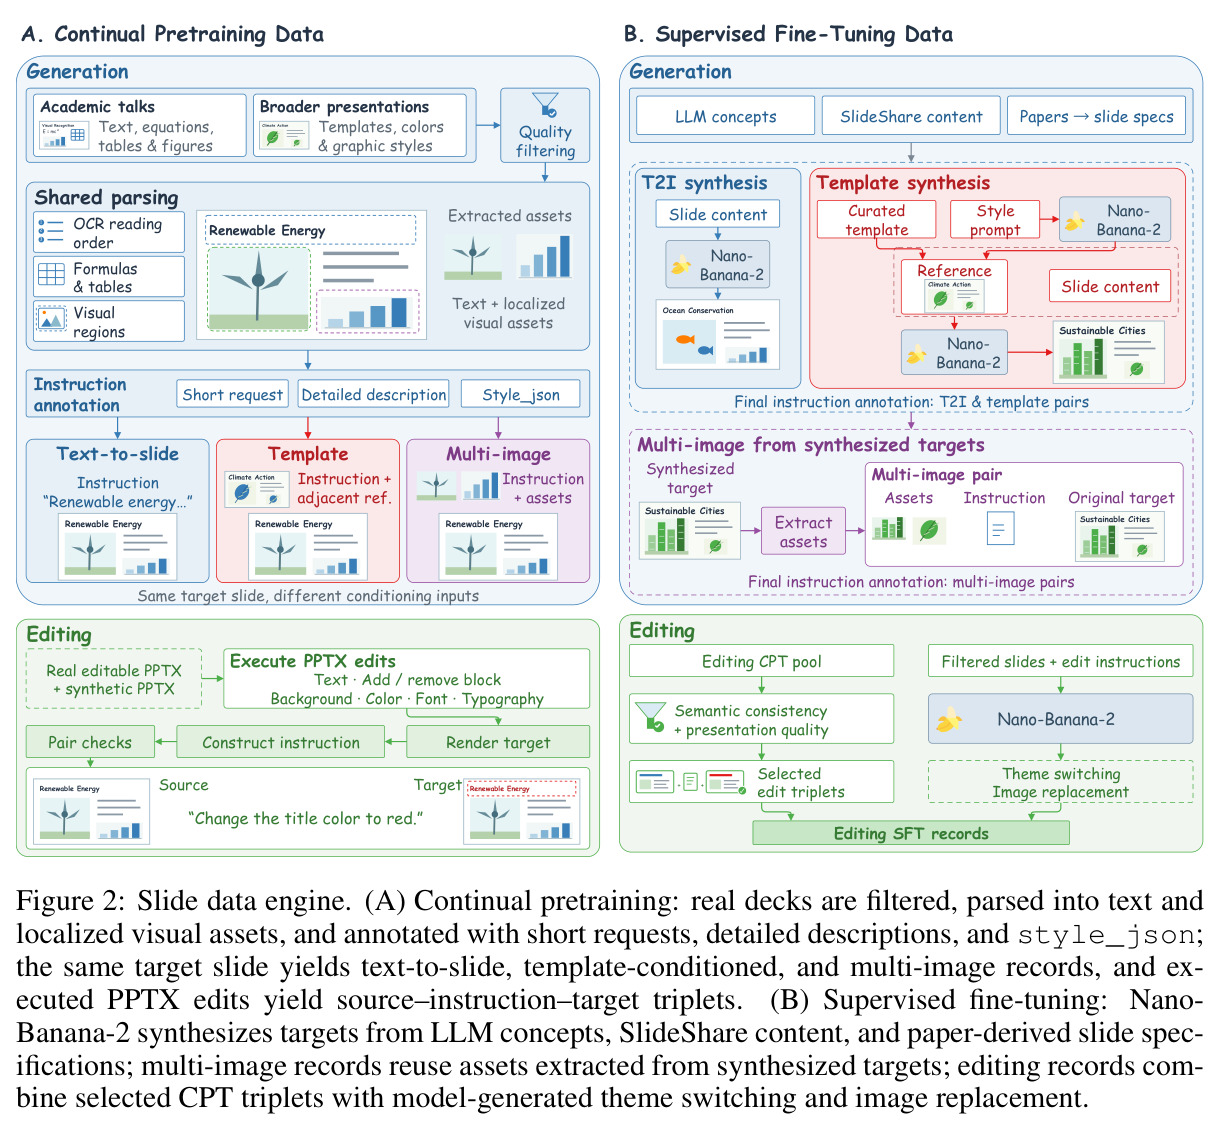
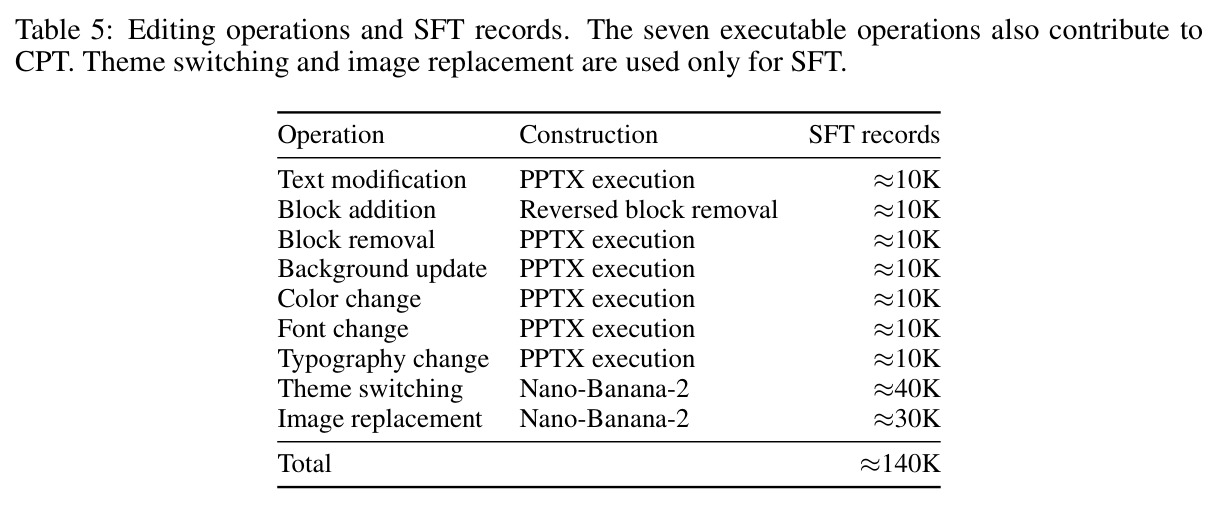
与已有工作不同的是,独特切入有三点。第一,视角统一:不为幻灯片单独设计流水线,而是把四种创作方式统一成条件视觉合成 $y = G_\theta(x, I)$——文字条件 $x$ 有短请求、详细描述、结构化 style_json 三档粒度,图像条件 $I$ 在四任务中分别扮演无输入、风格参考、内容素材、待编辑源图的角色;于是同一张目标页可以派生多条不同条件的训练记录(T2I 约 5.16M、模板约 3.92M、多图约 2.25M、编辑约 2.12M 条 CPT 记录),内容-版式-设计监督天然共享。第二,数据真实性分层:编辑数据不靠模型凭空生成,而是对真实与合成 PPTX 执行七种确定性变换(改文本、增删块、改背景/颜色/字体/排版),再让 LLM 依据『源图+目标图+实际执行的动作』反写指令,从根上保证指令-目标一致;只有主题切换和图像替换这两种无法程序化执行的操作才交给 Nano-Banana-2 生成并重写指令以描述实际发生的变化。第三,训练策略直面多任务冲突:用任务专家微调再线性融合(而非直接混合训练)来同时保住专家峰值与统一性能,并用三阶段课程把『领域适应』与『任务对齐』两个目标解耦。
核心方法
核心思路是『基座已会画图,缺的只是幻灯片知识、任务形态与评测』,路线是数据引擎+三阶段后训练+专用 benchmark。基座选 FLUX.2-klein-base-9B,保留架构与文本编码器,仅把 prompt 上限升到 4,096 tokens 容纳 style_json(长 1,102-3,731 tokens)。数据引擎采集 7.2 万套、220 万页演示文稿(学术讲稿+共享网站),Qwen3.5-27B 过滤、PaddleOCR-VL 解析出文本与图表资产;同一目标页派生 T2I、模板、多图三种记录;编辑分支用 PPTX 执行引擎产出七种操作三元组。训练三阶段:Stage 1 T2I CPT(13,500 步);Stage 2 四任务混合 CPT(16,500 步);Stage 3 共享 T2I SFT 后分出四个任务专家 $\theta_{t2i},\theta_{ref},\theta_{multi},\theta_{edit}$,线性融合为最终模型。学习率 $5\times10^{-5}$,编码器与 VAE 冻结,最多 96 张 H100。
核心创新是『同一目标页、多种条件视图』的数据构造与『专家融合』的训练结构,二者共同让 9B 模型以数据而非规模取胜。与已有方法的本质区别:通用生成-编辑模型(BAGEL、OmniGen2 等)用一套数据通吃所有视觉任务,在密集文本、强版式约束的幻灯片领域全面失守;此前的设计图像工作(海报、信息图)只优化单一产物,不支持模板条件、多图 grounding 与指令编辑的组合。InfoVis 把内容-版式-设计关系显式编码进数据:T2I 记录的指令必须完整描述包括视觉资产在内的整页;模板记录用同 deck 相邻页做参考并用 VLM 校验背景、配色、字体一致性;多图记录复用 OCR 定位的 1-4 个视觉区域并要求指令描述其安置方式;编辑记录来自『先执行、后描述』的 PPTX 变换,指令由 LLM 观察源图、目标图与实际动作生成,杜绝指令与结果不符。训练消融证明:单任务 CPT 让编辑崩塌(SC 5.98→1.60),四任务混合 CPT 恢复之;各任务 SFT 互相拉扯(模板 SFT 使编辑 SC 降到 6.49),线性融合则保住专家峰值(编辑 SC 9.13 对 9.19)。
方法步骤详情
第一步,采集解析:收集 72K 套、220 万页演示文稿,Qwen3.5-27B 过滤低质页,PaddleOCR-VL 解析出阅读顺序文本与图表资产。第二步,生成 CPT:VLM 为每页生成短请求、300-800 词描述、style_json 三种指令;模板配同 deck 相邻页并校验风格一致;多图复用 1-4 个资产。第三步,编辑数据:对真实与合成 PPTX 执行文本、块增删、背景、颜色、字体、排版七种操作并渲染,LLM 依三元组写指令并过滤缺陷对。第四步,SFT 数据:三种内容源由 Nano-Banana-2 渲染约 300K 张 16:9 目标页并反标指令;多图分支裁剪图表约 580K 条,编辑分支每操作选约 10K 加主题切换 40K、图像替换 30K。第五步,三阶段训练:T2I CPT 13,500 步→四任务混合 CPT 16,500 步→共享 T2I SFT 后派生四专家(学习率 $5\times10^{-5}$)线性融合。第六步评测:OCR 编辑距离算 CF,GPT-4.1 判 IF/AQ,编辑 $SSC=\min(SIF,SEC)$。
技术新颖性
技术新颖性有四。数据层面:首次把『同一目标页的多条件视图』作为大规模数据引擎的组织原则(CPT 超 1300 万条:T2I 5.16M、模板 3.92M、多图 2.25M、编辑 2.12M),三种指令粒度对齐人类与机器使用者;编辑数据『可执行变换+事后描述』比模型重构式编辑对可靠,主题切换与图像替换两个无法程序化的操作被隔离到 SFT 并重写指令。任务层面:把模板条件与多图 grounded 生成纳入幻灯片场景并给出可诊断的分维度定义,VisSlideBench 是唯一同时覆盖四任务、三档 prompt 粒度和任务专属指标的基准。训练层面:三阶段课程把领域适应与任务对齐解耦,『共享检查点→四专家→线性融合』回应统一模型落后专家的问题——BAGEL、OmniGen2 在编辑上大幅落后 Qwen-Image-Edit,InfoVis 编辑 SC 反超。评测层面:CF 用指令要求文本驱动的 OCR 归一化编辑距离;IF 与 AQ 显式分离;编辑分取 $\min$ 防止『改了却破坏无关内容』;协议经 2,153 个人工对比验证($\tau_b=0.640$、一致率 88.71%)。
实验结果
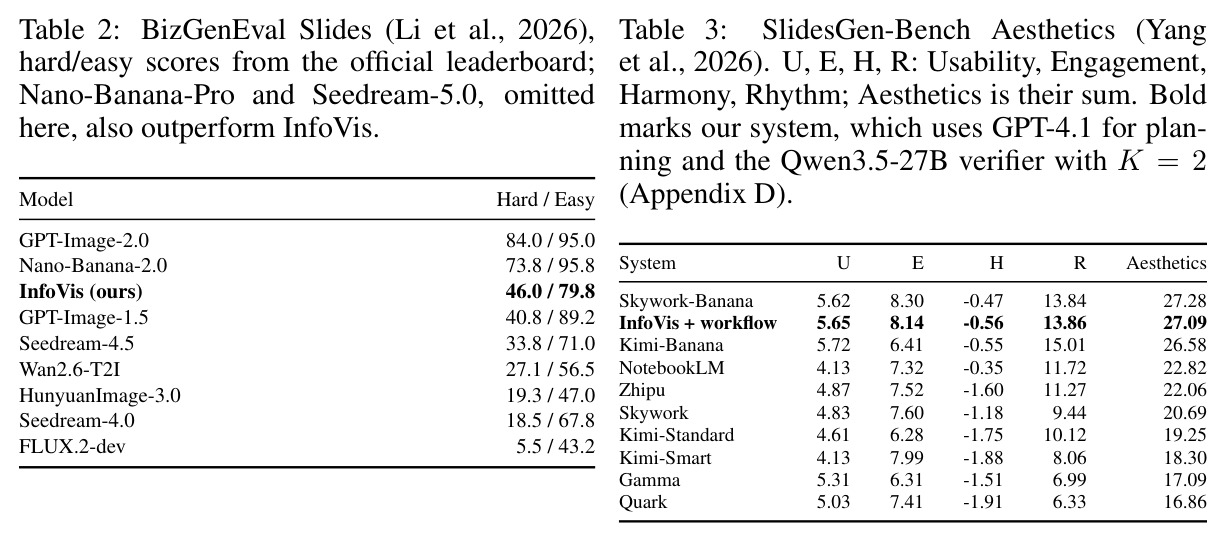
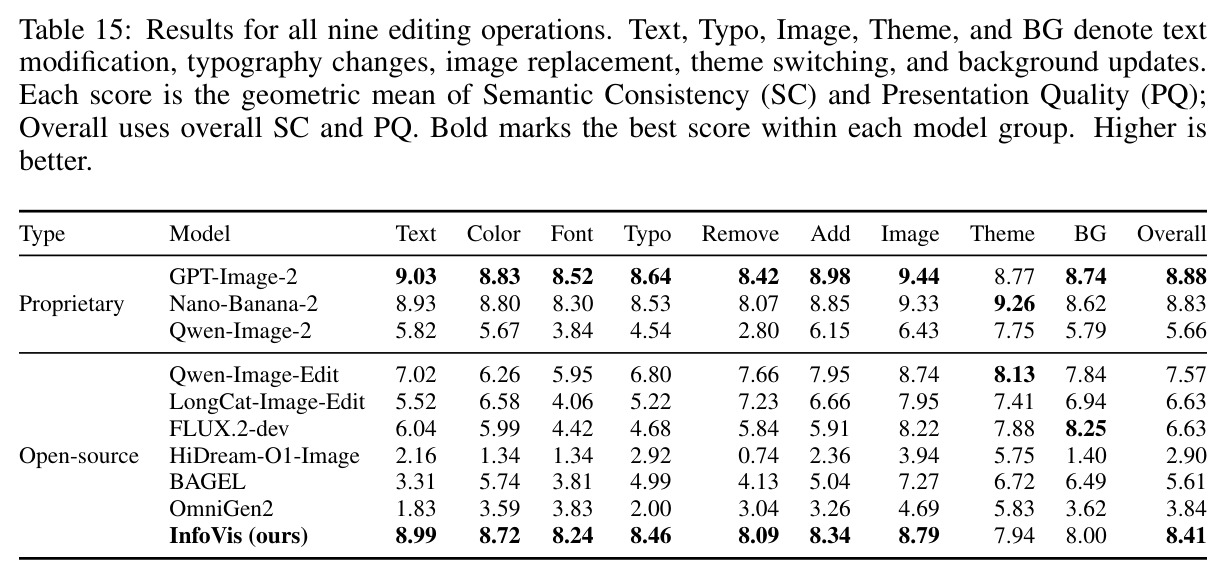
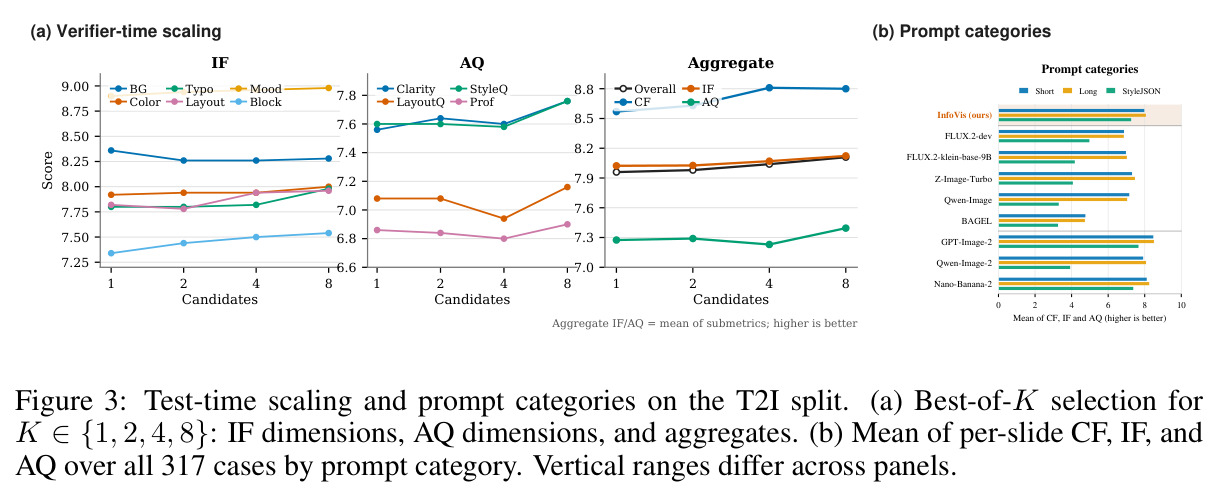
主结果:VisSlideBench 11 指标 7.94 居开源首,距 Nano-Banana-2(7.99)0.05、GPT-Image-2(8.36)0.42。分项:T2I 的 CF/IF/AQ=8.42/8.01/7.02,模板 8.14/8.09/7.00,多图 8.71/8.01/7.06,编辑 SC/PQ=9.13/7.75。发现一:增益源于专用监督而非规模:较基座 +1.64,CF +1.70~+2.14、AQ +1.60~+1.83、编辑 SC +3.15,9B 超 32B 的 FLUX.2-dev。发现二:统一无代价:专家评测反低于共享检查点(7.30-7.63 对 7.73),融合编辑 SC 9.13 平专家 9.19。发现三:对 GPT-Image-2 差距随主观性增大:CF 0.05-0.22、IF 0.42-0.56、AQ 0.55-0.69。外部:BizGenEval 46.0/79.8 开源最佳,SlidesGen-Bench 27.09 第二;best-of-8 使 T2I 7.96→8.11;StyleJSON 掉 0.9 内而基线掉 1.5-4.2。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| VisSlideBench 总体(11 指标平均) | Overall | 7.94 | FLUX.2-klein-base-9B 6.30(基座);Nano-Banana-2 7.99;GPT-Image-2 8.36 | 较基座 +1.64;距 Nano-Banana-2 仅 0.06(9 个生成指标无可检出差异),领先全部开源模型 |
| 文本生成幻灯片(T2I) | Content Faithfulness(OCR 文本渲染保真) | 8.42 | 基座 6.29;GPT-Image-2 8.52 | +2.13,与最强专有模型差距缩至 0.10 |
| 幻灯片编辑 | Semantic Consistency(SC = min(SIF, SEC)) | 9.13 | Qwen-Image-Edit 7.77(开源编辑专家);基座 5.98 | 对基座 +3.15;对开源编辑专家 +1.36 |
| BizGenEval Slides(分布外单页生成) | Hard / Easy | 46.0 / 79.8 | FLUX.2-dev 5.5 / 43.2;Seedream-4.5 33.8 / 71.0;GPT-Image-2.0 84.0 / 95.0 | 开源最佳,超过 Seedream-4.5 与 GPT-Image-1.5 等多个专有系统 |
| SlidesGen-Bench(文档到幻灯片工作流,分布外) | Aesthetics(U+E+H+R 总分) | 27.09(GPT-4.1 规划 + Qwen3.5-27B 验证器 K=2) | Skywork-Banana 27.28(第一);NotebookLM 22.82;Quark 16.86 | 十个系统中排名第二,与最佳仅差 0.19 |
局限与改进
作者承认的局限:其一,VisSlideBench-Edit 与编辑训练数据同一流水线,只测分布内编辑质量,分布外证据仅来自 BizGenEval 和 SlidesGen-Bench;其二,AQ 是差距最大维度(0.55-0.69),视觉打磨最难;其三,BizGenEval hard split 这类知识推理密集幻灯片超出专用监督范围;其四,生成 SFT 目标与 benchmark 合成半区都用 Nano-Banana-2 渲染,训练分布与部分评测绑到专有风格(Table 16 因此分真实/合成报告);其五,仅覆盖英文。我的补充:主题切换(7.94 对 Nano-Banana-2 的 9.26)、背景更新(8.00 对 8.74)等全局编辑明显弱于局部操作,全局风格迁移掌控不足;多图 SFT 池全合成,真实页素材『贴得过大或被重绘』(Table 17:真实 CF 8.64→7.99),域差未消除;评测依赖 GPT-4.1 与 PaddleOCR,评测器偏差传导到结论;共享检查点取自 T2I SFT 第 1,500 步的敏感性未消融。
独立分析的弱点
独立分析出四个弱点。第一,编辑局部性不可靠:附录 G 显示模型能识别要改什么,却会把改动溢出请求区域——只要求替换左侧两张折线图,输出却变成四张散点图并删除了本应保留的右侧表格,源于对『无关区域保持不变』缺少显式监督;改进方向是编辑区域定位辅助任务、非目标区域加权损失,或用高保真奖励做在线 RL。第二,视觉素材保真度:输入图表会被『重绘』,图例、坐标轴、柱组结构损坏,模型把素材当风格参考而非像素级证据;改进方向是素材特征级拷贝机制(类似 IP-Adapter)或推理时对素材区域 inpaint 拼接。第三,美学天花板:AQ 差距最大(0.55-0.69)且最难自动衡量,SFT 目标全由 Nano-Banana-2 渲染,美学上限被单一教师锁死;可引入人类美学偏好做 DPO/RLHF 或混合多教师蒸馏。第四,全局编辑(主题切换 7.94、背景更新 8.00)与局部编辑(文本 8.99)落差明显,且仅支持英文排版,限制落地;可用 PPTX 母版替换等可执行构造扩充全局变换数据,并建设多语言语料。
未来方向
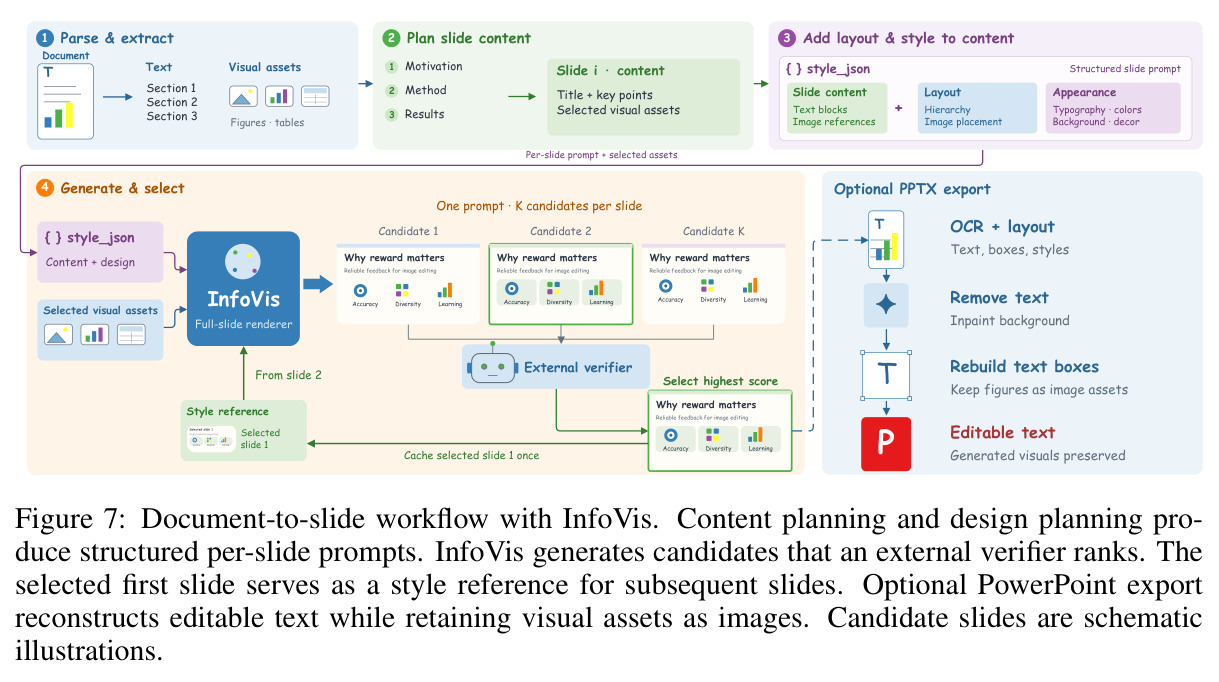
作者给出的延伸:文档到幻灯片工作流(解析→GPT-4.1 内容规划→style_json 设计规划→生成 K 候选→验证器选优→可选 PPTX 导出)已在 SlidesGen-Bench 拿到第二(27.09),且 best-of-8 显示验证器选优在文本渲染这类可验证维度获益最大(8.57→8.80),自然延伸是用可验证奖励做在线 RL(作者团队 EditScore 的路线);PPTX 导出目前只还原文本框、图表仍是图片,可向原生可编辑图表延伸。基于成果可延伸:其一,把四任务接口推广到海报、信息图、UI 设计稿等结构化视觉,检验『同一目标页多条件视图』范式的可迁移性;其二,数据引擎的标注-过滤闭环接入自我训练循环,用融合模型替换 Nano-Banana-2 以摆脱专有教师;其三,为分布内编辑评测补充分布外编辑集(真实 PPTX 变换之外的自然语言编辑);其四,多轮编辑与 deck 级风格一致性是验证器只看单页遗留的空白;其五,StyleJSON 若成为机器可读设计规格标准,可打通『LLM 设计智能体+幻灯片渲染器』生态。
复现评估
复现前景相当好。作者承诺开源模型权重、训练与评测代码、训练数据与数据引擎、VisSlideBench(GitHub: VectorSpaceLab/InfoVis),每条真实幻灯片记录登记来源以便追踪移除。算力:Stage 1 用 48 张 H100、Stage 2 与多数 SFT 用 80 张、多图/编辑 SFT 用 96 张(合计约 3.9 万步、1300 万级数据),学术实验室偏重,但可只做 SFT 或缩小 CPT。外部依赖:Qwen3.5-27B(开源权重,标注过滤)、Nano-Banana-2(专有 API,渲染约 300K 张 SFT 目标及主题切换/图像替换约 70K 条记录)、GPT-4.1(评测判官,收费)与 PaddleOCR,完全摆脱专有 API 复刻数据引擎有难度。评测复现最容易:1,527 例全部人工筛选,评估协议(prompt 模板、聚合方式、温度、截断处理)在附录 B.5/C.1 完全公开。总体判断:用官方权重推理与继续微调属低到中难度;从零复刻数据引擎因专有依赖与训练量属中高难度;跑通评测属低难度。
论文图表
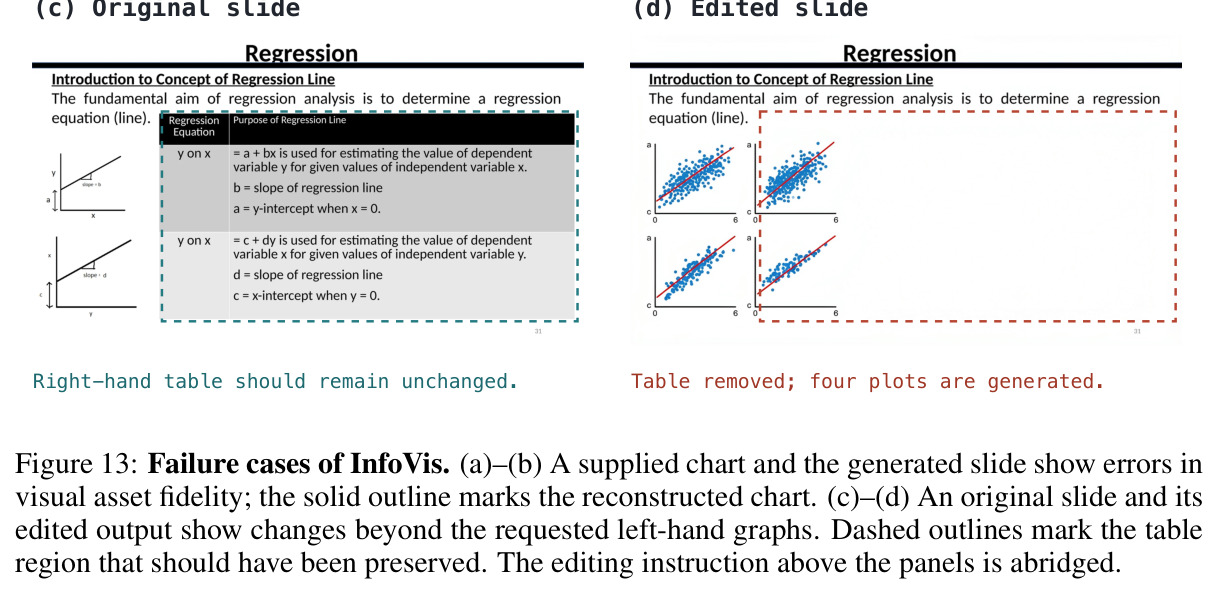
两组失败案例:(a)-(b) 多图生成中输入图表被『重绘』而非忠实保留——图例条目、坐标轴标签损坏、柱组结构改变;(c)-(d) 编辑局部性失败——指令只要求把左侧两张折线图替换为垂直堆叠的散点图,输出却生成四张图并删除了右侧应保持不变的表格(虚线框标出应保留区域)。
具体展示模型两大系统性缺陷:素材像素级保真不足与编辑改动越界,是理解局限性和改进方向的最直接证据。