EAU:面向以用户为中心智能体训练的环境-智能体-用户协同演化框架 EAU: Environment-Agent-User Co-evolution for Training User-Centric Agents
元智能体在RL训练中在线诊断并修改环境、用户模拟器与训练配置,实现三者协同演化
前置知识
PPO(近端策略优化)
一种策略梯度强化学习算法,通过裁剪目标函数 $\mathcal{L}^{\mathrm{CLIP}}(\theta)=\mathbb{E}[\min(r_t A_t,\ \mathrm{clip}(r_t,1-\epsilon,1+\epsilon)A_t)]$ 限制每次策略更新幅度,其中 $r_t$ 是新旧策略的概率比。PPO 通常配备学习到的价值函数(critic)$V_\phi$ 来估计优势函数。与 GRPO 等无 critic 方法相比,带 critic 的 PPO 能做逐步信用分配,但计算开销更大。
本文刻意固定使用带 critic 的 PPO 作为底层算法,而非当下主流的 GRPO:作者指出无 critic 方法在多轮用户交互任务中信用分配稀疏(中间奖励被累加成单一轨迹级奖励),且模拟用户的随机性使相同状态难以复制、无法做群组优势估计。EAU 可调的熵系数、KL 系数等旋钮也直接作用于 PPO 的训练动力学,不懂 PPO 无法理解第 4.4 节的智能体侧干预。
POMDP(部分可观测马尔可夫决策过程)
用五元组加观测函数 $\langle S,A,T,R,Z,O\rangle$ 刻画的决策过程:智能体只能通过 $O:S\to\Delta(Z)$ 观测到状态的部分信息,转移 $T:S\times A\to\Delta(S\times O)$ 可以是随机的。在以用户为中心的任务里,用户隐藏的真实意图就是不可观测状态的一部分,智能体必须通过提问逐步揭示。
论文第 3 节将每个任务形式化为 POMDP,并把模拟用户并入环境:状态分解为 $S=S_{\mathrm{tool}}\otimes S_{\mathrm{user}}\otimes S_{\mathrm{query}}$,动作空间分为工具调用 $A_{\mathrm{tool}}$ 与对话 $A_{\mathrm{user}}$,工具交互确定性、用户交互随机性。理解这个设定才能读懂其双层优化目标(公式 1)以及为什么诊断要区分用户侧与环境侧两类故障。
LLM 用户模拟器
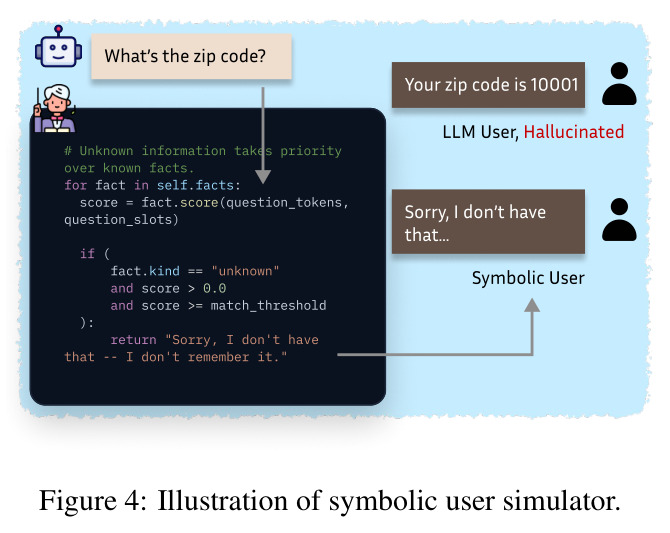
用 LLM 扮演持有隐藏意图的用户,与智能体进行多轮对话,按人设和规则决定何时披露哪些信息,从而让大规模自动评估与 RL 训练成为可能。但 LLM 用户基于随机采样生成,会漂移人设、提前泄露本应被诱导的信息、在相似回合间改变意图,产生的奖励信号噪声大、不稳定,甚至导致策略过拟合固定用户行为后训练崩溃。
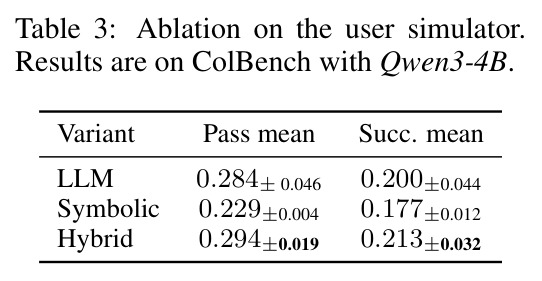
本文的核心论点是:固定的用户模拟器与环境是交互式 RL 不稳定的关键根源,而非仅仅是噪声。EAU 的符号用户、$\epsilon$-混合策略、人设与温度调控都是为了驯服这个组件;Table 3 的消融实验(LLM vs 符号 vs 混合)也完全围绕它展开。
稀疏奖励与奖励塑形
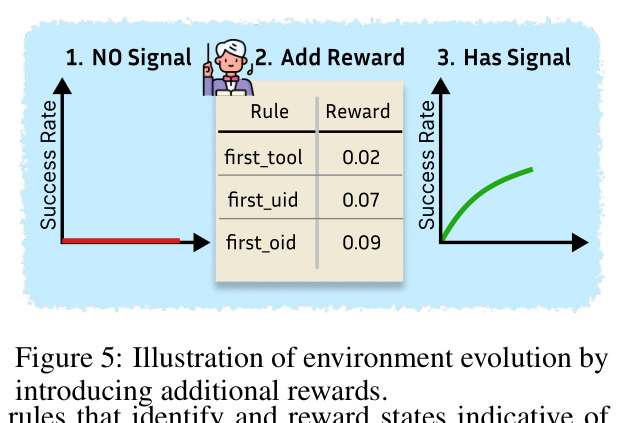
稀疏奖励指只有任务最终成功/失败时才给出可验证信号,中间步骤没有反馈,智能体难以有效探索。奖励塑形通过给指示进展的中间状态追加额外奖励来稠密化信号,例如首次正确调用某工具给 0.02 分。塑形设计不当时会诱发 reward hacking——智能体刷中间分而不完成最终目标,或间接掩盖不良行为。
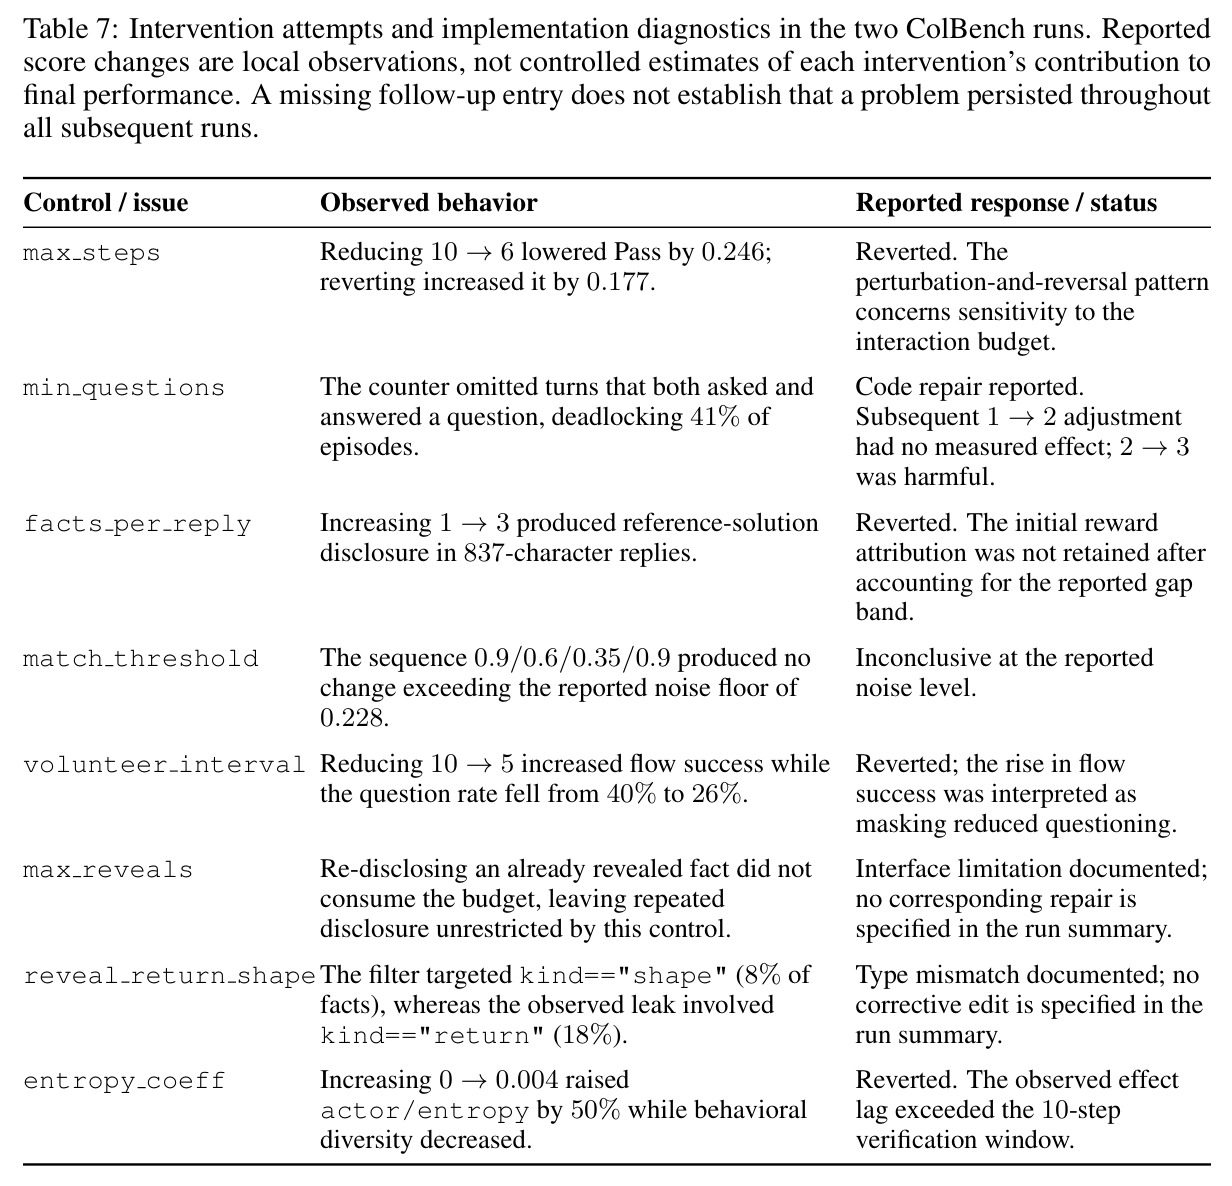
EAU 环境侧演化的主要手段就是动态增删中间奖励规则(Figure 5 中的 first_tool 0.02、first_uid 0.07、first_oid 0.09)。附录 Table 7 还记录了塑形引发真实事故的案例:facts_per_reply 从 1 调到 3 导致参考答案在 837 字符的回复中被泄露,最终被迫回滚。
GAE(广义优势估计)
计算优势函数的标准方法:$\hat{A}_t^{\mathrm{GAE}}=\sum_{l=0}^{|y|-t-1}(\gamma\lambda)^l\delta_{t+l}$,其中时序差分项 $\delta_t=r_t+\gamma V_\phi(s_{t+1})-V_\phi(s_t)$,通过 $\lambda$ 在偏差与方差之间折中。本文还把 critic 与优势限制在动作 token 上计算,使一轮对话的优势不被周围观测文本稀释。
这是论文公式 (3) 的核心内容,解释了带 critic 的 PPO 为什么更适合多轮用户交互场景:对话奖励 $r_{\mathrm{conv}}$ 逐轮给出、与任务奖励 $R_{\mathrm{task}}$ 时机错位,需要跨动作的逐步信用分配而非轨迹级汇总。
元智能体与训练系统自动优化
用一个 LLM(通常是具备读写代码能力的编程智能体,如 Claude Code、Codex)监督、诊断并修改另一个正在训练的系统:调整超参、修改奖励代码、修复 bug、更坏情况下重启训练。相关范式包括 ADAS、EvoTrainer、AI Scientist 等,但多数只在训练开始前或两次训练之间(inter-run)做修改。
EAU 本身就是一个元智能体,本文的独特之处在于它能在训练进行中(intra-run)热替换修改,且只使用训练侧反馈(不接触评估集)来指导干预。理解这一范式才能分清 EAU 与 EvoTrainer、Claudini、Darwin Godel Machine 等相关工作的本质差别。
研究动机
现有多轮交互式智能体 RL(ColBench 后端编程、UserGym 偏好澄清、$\tau^2$-bench 客服等基准)的训练信号由三个组件共同产生:策略、LLM 用户模拟器与环境,但后两者在训练全程保持固定。模拟用户由随机采样生成,会漂移出设定人设、提前泄露本应由智能体引导用户说出的信息、在本质相似的回合间改变意图;环境则可能存在对特定参数静默失败的工具、不完整的状态覆盖、不可达任务乃至错误的验证器(把成功的轨迹判为失败)。更隐蔽的问题是:随着策略变强,固定的模拟器和环境会持续产生冗余、无信息量或错配策略当前弱点的轨迹。已有工作(UserRL 的部分进展信用奖励塑形、InfoPO 的信息驱动稠密监督)只在下游学习信号上做文章——如果工具静默失败或验证器错误拒绝成功轨迹,再怎么改下游奖励也救不回被破坏的交互本身,最终奖励高度波动甚至系统性误导,多轮 RL 极不稳定。
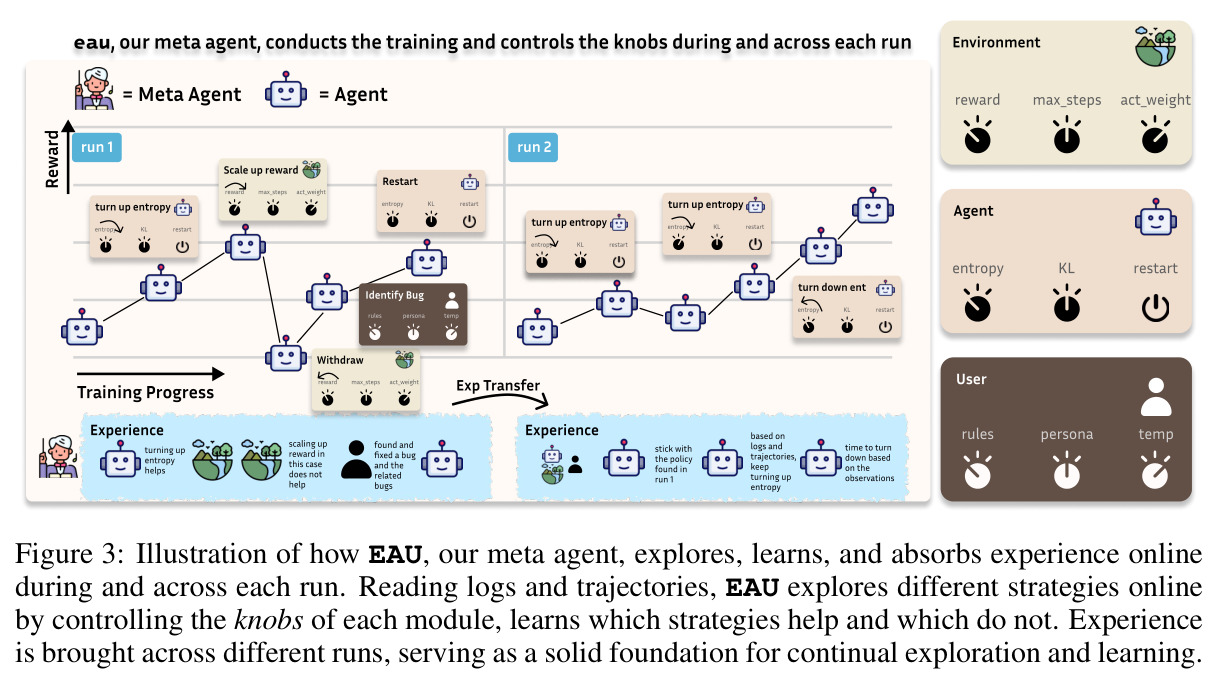
本文的目标是本文的目标是提出 EAU:一个元智能体框架,在 RL 训练进行的同时持续监督并改进产生学习经验的整个系统。EAU 观察 rollout 轨迹、工具调用痕迹、奖励曲线与训练统计量,诊断有问题的或无信息量的交互究竟源自策略、用户模拟器、环境还是训练配置,然后提出针对性干预——修正环境或验证器缺陷、改进模拟用户的人设与信息披露行为、调整奖励项或 RL 超参数。候选修改经有界完整性门控验证后被热替换进正在运行的训练循环,使训练设置无需反复推倒重来即可随策略一起演化;这些改动还会跨 run 持久化,后续训练能在已发现的改进之上继续,而不是每次都从固定配置起步。
与已有工作不同的是,本文的独特切入是把干预点从下游的学习信号上游移动到产生学习信号的交互过程本身。与 UserRL、InfoPO 等把用户模拟器和环境当作固定基础设施、只优化监督信号的方法不同,EAU 直接把用户模拟器与环境变成可编辑对象。与 EvoTrainer、Claudini、AutoResearch 等 run 间(inter-run)元智能体不同,EAU 支持 run 内(intra-run)热替换,能在线做"扰动—回滚—反转"式的因果检验。与 Yu et al. 2026 联合训练用户、FrogNano 等用预定义更新规则演化世界的方法不同,EAU 由编程智能体灵活决定改什么、何时干预、怎么改。此外 EAU 只使用训练侧反馈指导干预,评估集、评估轨迹与分数均不参与提案或经验更新,避免了评估污染问题。
核心方法
先给一个直觉:把训练系统想象成"考生(agent)—考官(user simulator)—考场(environment)"的组合,与其只给考生更好的评分标准,不如派一位资深教练(元智能体)全程旁观训练日志,随时修考场 bug、调考官出题方式、改考生训练计划。技术上,任务形式化为 POMDP,模拟用户并入环境,状态 $S=S_{\mathrm{tool}}\otimes S_{\mathrm{user}}\otimes S_{\mathrm{query}}$;策略是神经 LLM,用带 critic 的 PPO 训练,critic 损失 $\mathcal{L}^{VF}_\phi=\mathbb{E}[(V_\phi(q,y_{<t})-R)^2]$,优势用公式 (3) 的 GAE 且只在动作 token 上计算。整体目标(公式 1)是双层优化:外层最大化任务奖励 $R_{\mathrm{task}}$(可验证但稀疏),内层约束策略在对话奖励 $r_{\mathrm{conv}}$(稠密但噪声大)上做策略梯度。元智能体用现成编程智能体(Claude Code/Codex)实现,以固定间隔读取日志,通过可编辑接口修改符号用户规则、环境奖励、episode 上限与 PPO 超参数,并在文件系统上维护经验池文档。
核心创新是"非对称协同演化":不要求环境与用户是被独立学习的模型,而是通过程序化干预让它们演化。用户侧引入符号用户模拟器 $u_{\mathrm{sym}}$——一组显式规则把从智能体输出解析出的交互状态确定性地映射为回复,从而精确控制"什么信息在什么条件下披露"(例如:未知事实且匹配分达阈值时回答"抱歉我不记得")。符号与 LLM 模拟器通过 $\epsilon$-混合结合:$u_\epsilon$ 以概率 $\epsilon$ 取符号用户、$1-\epsilon$ 取 LLM 用户,混合系数本身也是元智能体可调的旋钮。环境侧则动态增删中间奖励(如首次调用工具 $+0.02$)来稠密化稀疏可验证奖励。与以往"固定世界 + 更聪明监督"范式的本质区别在于:世界本身成为可编辑对象,而且编辑发生在训练循环之内、由训练反馈驱动。
方法步骤详情
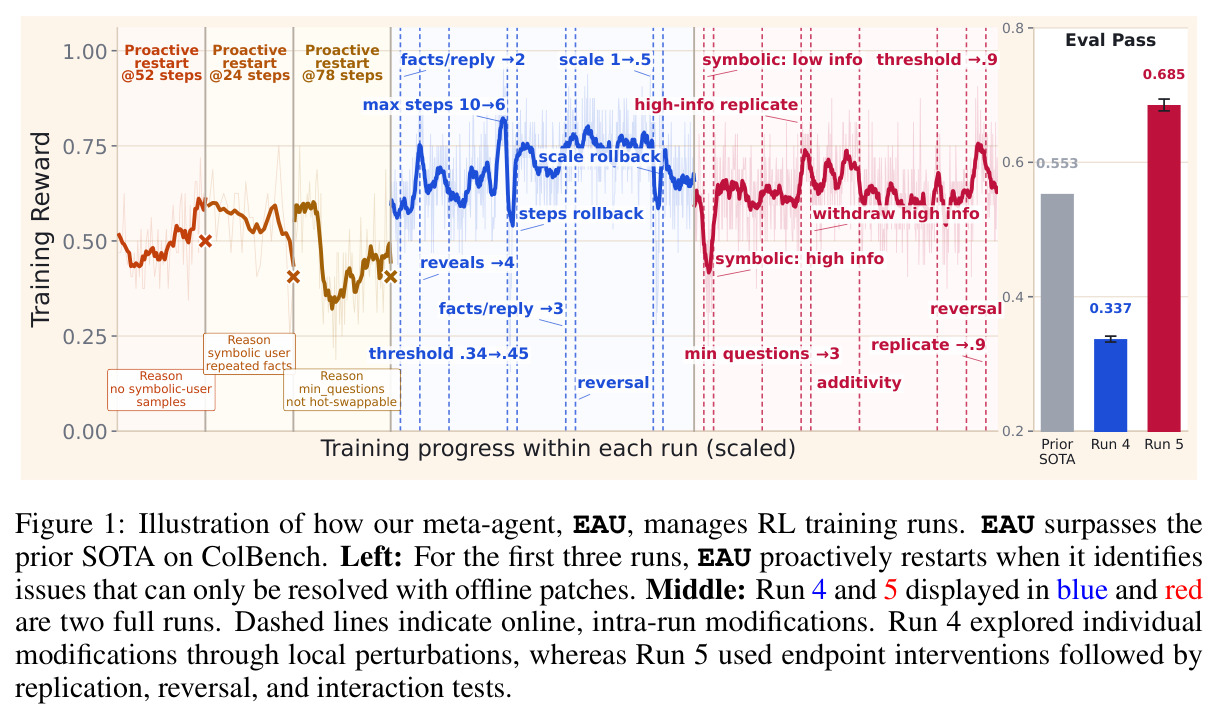
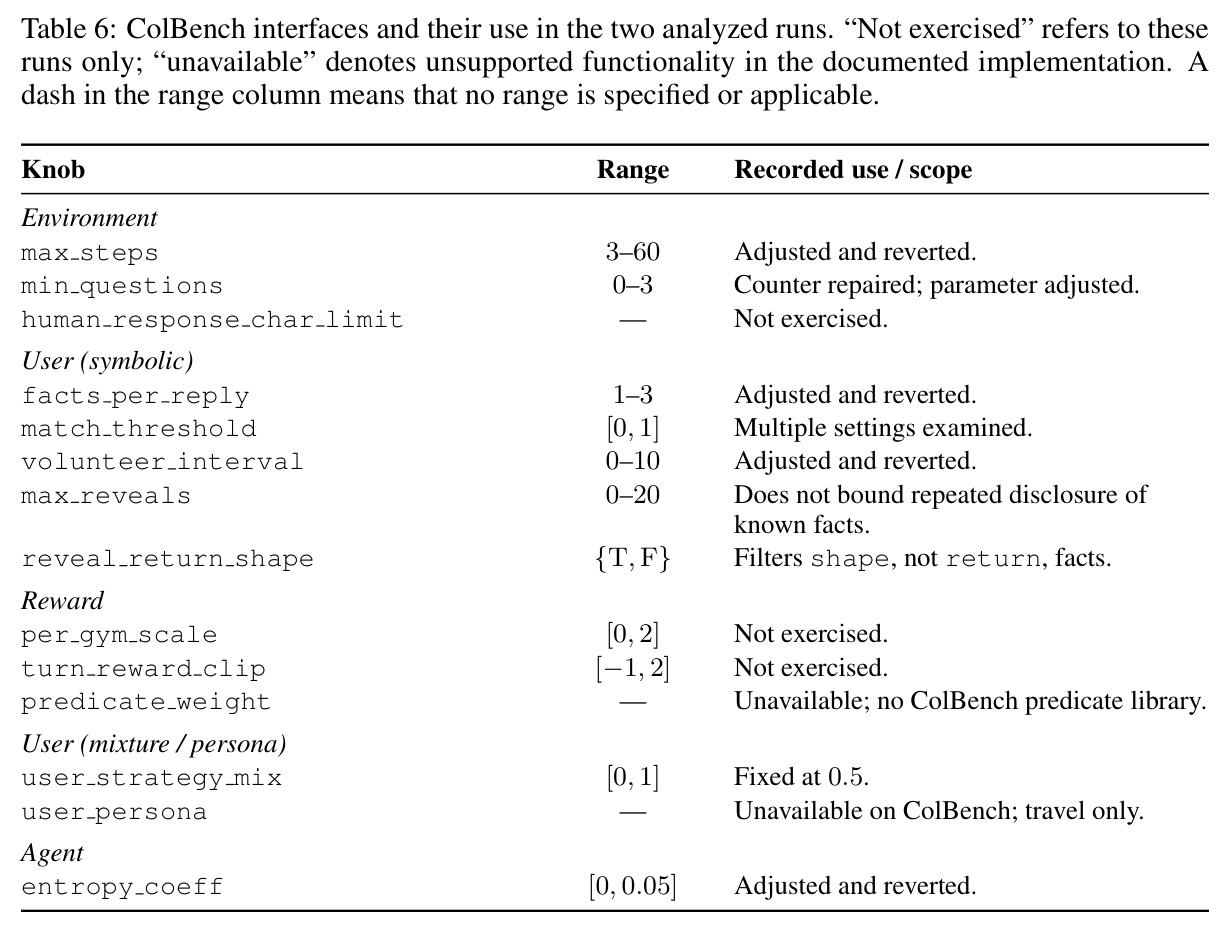
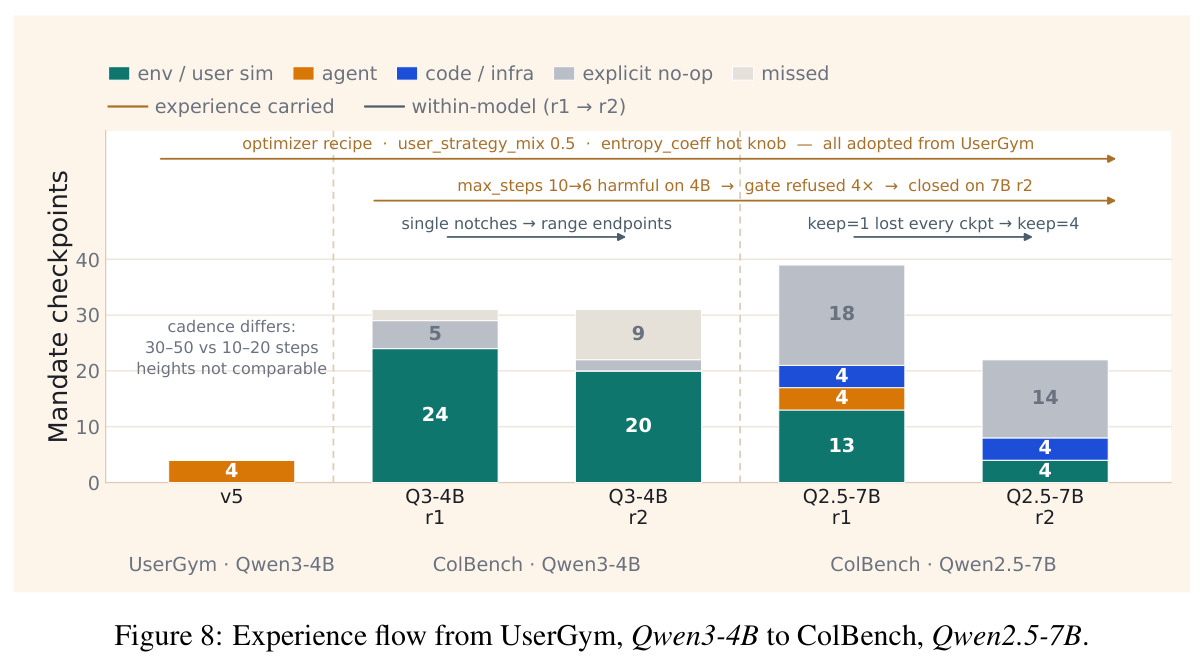
完整流程分七步。(1) 初始化:选定策略 backbone(Qwen3-4B 或 Qwen2.5-7B-Instruct)、训练模拟器(CoSER,微调的 Llama-3.1-8B)、旋钮清单(max_steps 3–60、facts_per_reply 1–3、match_threshold $[0,1]$、entropy_coeff $[0,0.05]$ 等)。(2) 训练循环:PPO rollout,轮数上限 UserGym 16、ColBench 10、$\tau^2$-bench 50,每轮 1024 token。(3) 监控:元智能体按固定间隔读取训练日志(rollout 熵、对数似然等)、完整轨迹与工具痕迹。(4) 诊断与提案:定位死锁、reward hacking、模板坍缩等具体问题(如发现 min_questions 计数器漏计既提问又回答的轮次,导致 41% 的回合死锁,先修代码再调参数)。(5) 完整性门控:写检查强制参数在声明范围内,且"提高任务难度"的改动要求近期训练成功率 $\ge 0.80$ 才放行(ColBench 记录中该规则拒绝了 4 次 max_steps 修改)。(6) 热替换或重启:可在线生效的改动直接换入运行中的循环;不可逆故障则主动重启——ColBench 前三次 run 分别在第 52、24、78 步被主动重启,run 间迭代总数上限为 5。(7) 经验沉淀:新发现写入经验池文档目录,跨 run 复用,例如把 UserGym 上学到的配方(user_strategy_mix 0.5、entropy_coeff 热旋钮)迁移到 ColBench 的 Qwen2.5-7B 训练。
技术新颖性
技术新颖性可分三层看。(1) 问题层面:首次把"固定的用户模拟器与环境"明确为交互式 RL 的关键瓶颈,而不是把不稳定笼统归因于奖励噪声。(2) 机制层面:符号用户 + $\epsilon$-混合是新的可控化设计,消融数据支持其互补性——纯符号用户 Succ 仅 0.177(交互过于僵硬),纯 LLM 用户 0.200 但方差高达 $\pm 0.044$,混合后 0.294/0.213 最佳;run 内热替换则让因果检验成为可能,例如 max_steps 从 10 降到 6 使 Pass 下降 0.246,回滚后回升 0.177,这种扰动—回滚—反转的证据链是 inter-run 方法拿不到的。(3) 实现层面:整个工作流被压缩成一个 skill(指令+脚本)交给现成编程智能体执行,并在 Table 5 证明换用 Codex/GPT-5.6-Sol 或叠加在 UserRL/InfoPO 上依然有效,说明框架与具体底层算法、元智能体实现解耦,这是与需要定制训练管线的 EvoTrainer 类方法的重要差异。
实验结果
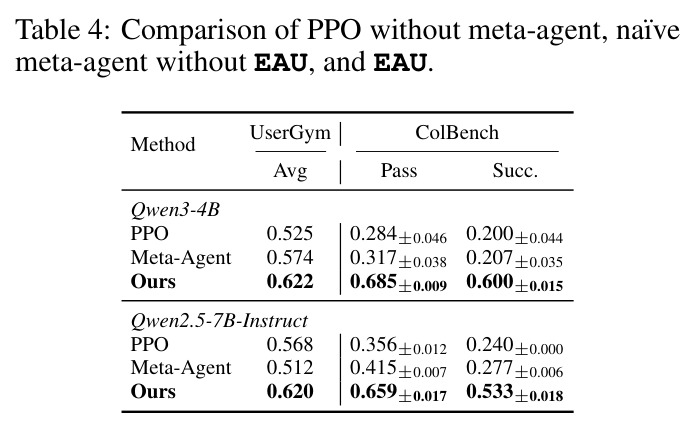
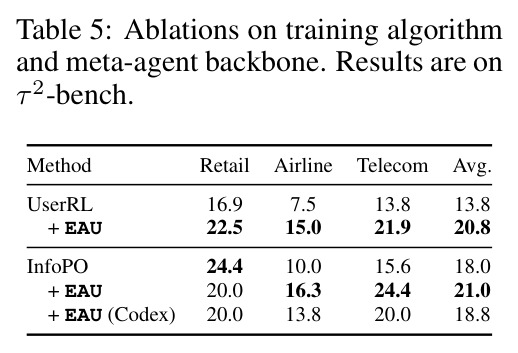
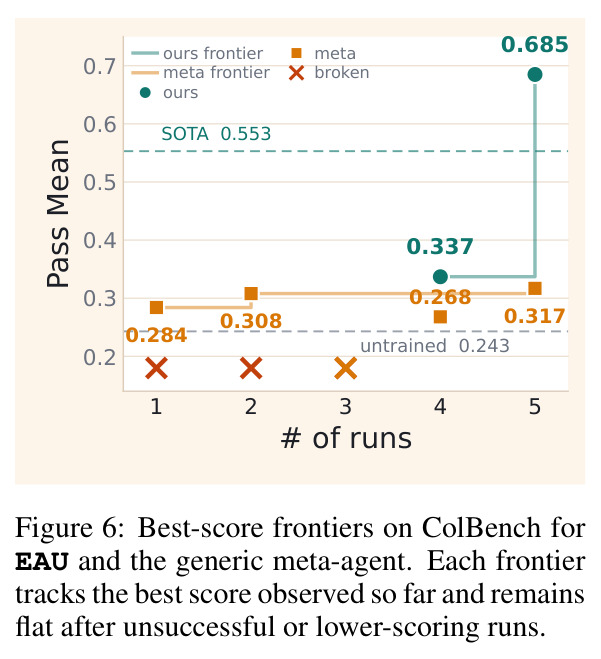
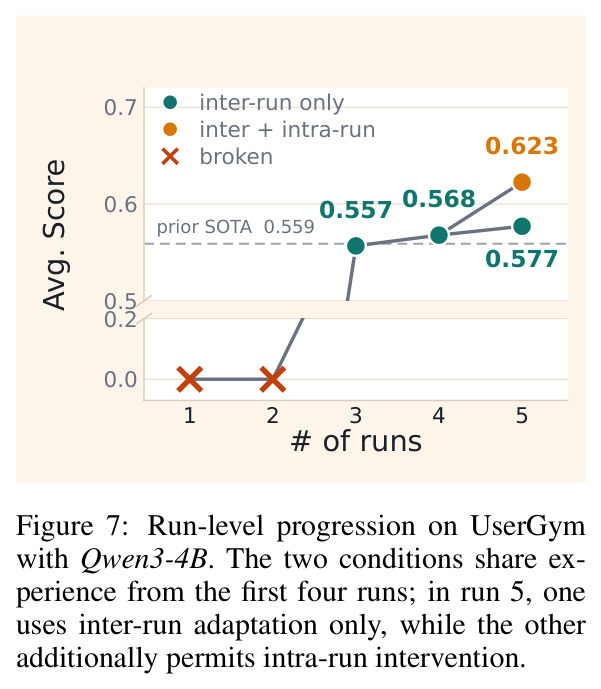
主实验(Table 1):在两个 backbone、三个基准上 EAU 全面超越最强 RL 基线 InfoPO——Qwen3-4B 总分从 0.545 提至 0.627(+15.0%),Qwen2.5-7B-Instruct 从 0.544 提至 0.615(+14.7%);4B 版本的整体分甚至超过闭源的 Gemini-3-Flash(0.606)与 GPT-4.1(0.568)。分基准看:ColBench 提升最猛,Qwen3-4B 上 Pass 0.553$\to$0.685(+23.9%)、Succ 0.439$\to$0.600(+36.7%)、平均 0.496$\to$0.643(+29.6%);7B 上 Succ 0.426$\to$0.533(+25.1%),且更严格的 Succ 指标提升更大,说明改进不依赖宽松判定。UserGym:平均分从 InfoPO 的 0.559 提至 0.622(+11.3%),7 个评估环境中 6 个最优,held-out 环境 Inten 达 2.023(InfoPO 1.862),显示跨环境泛化;但 Tele 得 0.512 略低于 InfoPO 的 0.542,泛化增益并不均匀。$\tau^2$-bench(Table 2):从 PPO 的 18.5 提至 21.5(+16.2%),Airline 28.8、Telecom 21.3 均为最佳,Retail 18.1 不敌 InfoPO 的 24.4。消融(Table 3/4/5):混合用户模拟器最优(Succ 0.213 vs LLM 0.200 vs 纯符号 0.177);移除符号用户与干预技能的朴素元智能体结果好坏参半,在 7B UserGym 上反而退化到 0.512(低于 PPO 的 0.568),证明设计组件的必要性;EAU 叠加在 UserRL/InfoPO 上分别把 $\tau^2$-bench 从 13.8 提到 20.8、从 18.0 提到 21.0。训练动态分析(Figures 6/7):run 内干预加经验复用使第 5 个 run 达 0.623,而只有 run 间适应时仅 0.568;附录干预记录显示两个分析 run 中有 15 次参数写入、2 次测得明确危害、3 次归因被撤回。
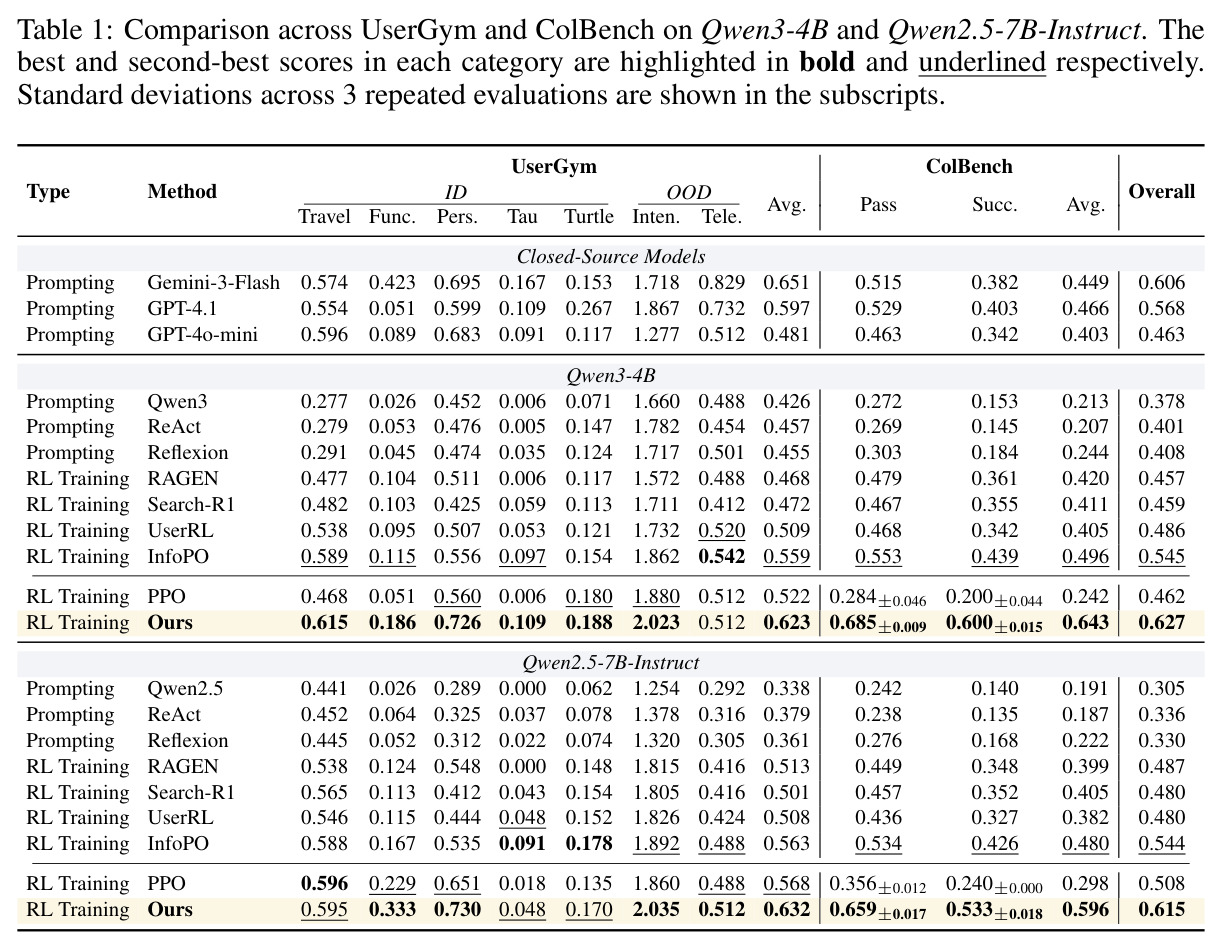
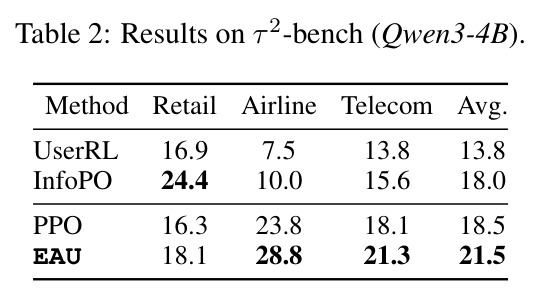
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ColBench 后端编程(Qwen3-4B) | Succ(任务成功率) | 0.600 | InfoPO 0.439 | +36.7% |
| ColBench 后端编程(Qwen3-4B) | Pass(通过率) | 0.685 | InfoPO 0.553 | +23.9% |
| ColBench(Qwen2.5-7B-Instruct) | Overall 平均分 | 0.615 | InfoPO 0.544 | +14.7% |
| UserGym(Qwen3-4B) | 平均环境奖励 | 0.622 | InfoPO 0.559 | +11.3% |
| UserGym(Qwen2.5-7B-Instruct) | 平均环境奖励 | 0.620 | InfoPO 0.563 | +12.3% |
| $\tau^2$-bench(Qwen3-4B) | 三域平均分 | 21.5 | PPO 18.5 | +16.2% |
| 三基准总体(Qwen3-4B) | Overall 平均分 | 0.627 | InfoPO 0.545 | +15.0% |
局限与改进
作者承认的局限:所有实验都在模拟用户与基准环境上进行,不能推断与真实用户交互时的安全或可靠行为;接口写检查只约束可写范围,不保证改动达到预期的行为效果;报告的训练与搜索预算并非匹配的端到端算力——元智能体推理成本与所有被放弃的 run 都未计入;增益不均匀,UserGym 的 Tele 环境(0.512 vs InfoPO 0.542)与 $\tau^2$-bench 的 Retail 域(18.1 vs InfoPO 24.4)均落后于最强基线;Table 4 的消融把符号用户与干预技能同时移除,只能评估组合设计而无法区分各自贡献。我自己的观察:元智能体依赖闭源前沿模型(Claude Opus-5),成本高且第三方难以复现;被详细分析的两个 ColBench run 中混合系数始终固定在 0.5,"动态调整 $\epsilon$"这一设计卖点实际未被实验验证;两条模拟器臂成功率相差 0.29,混合指标掩盖了不同交互条件下的差异;匹配阈值扰动(0.9/0.6/0.35/0.9)在 0.228 的噪声底之下无法判定效果,说明单 run 局部观测的信噪比对小效应干预不够用;框架只在每实验 $\le 5$ 次 run 的小搜索预算上验证,其可扩展性未与大规模自动环境生成路线对比。
独立分析的弱点
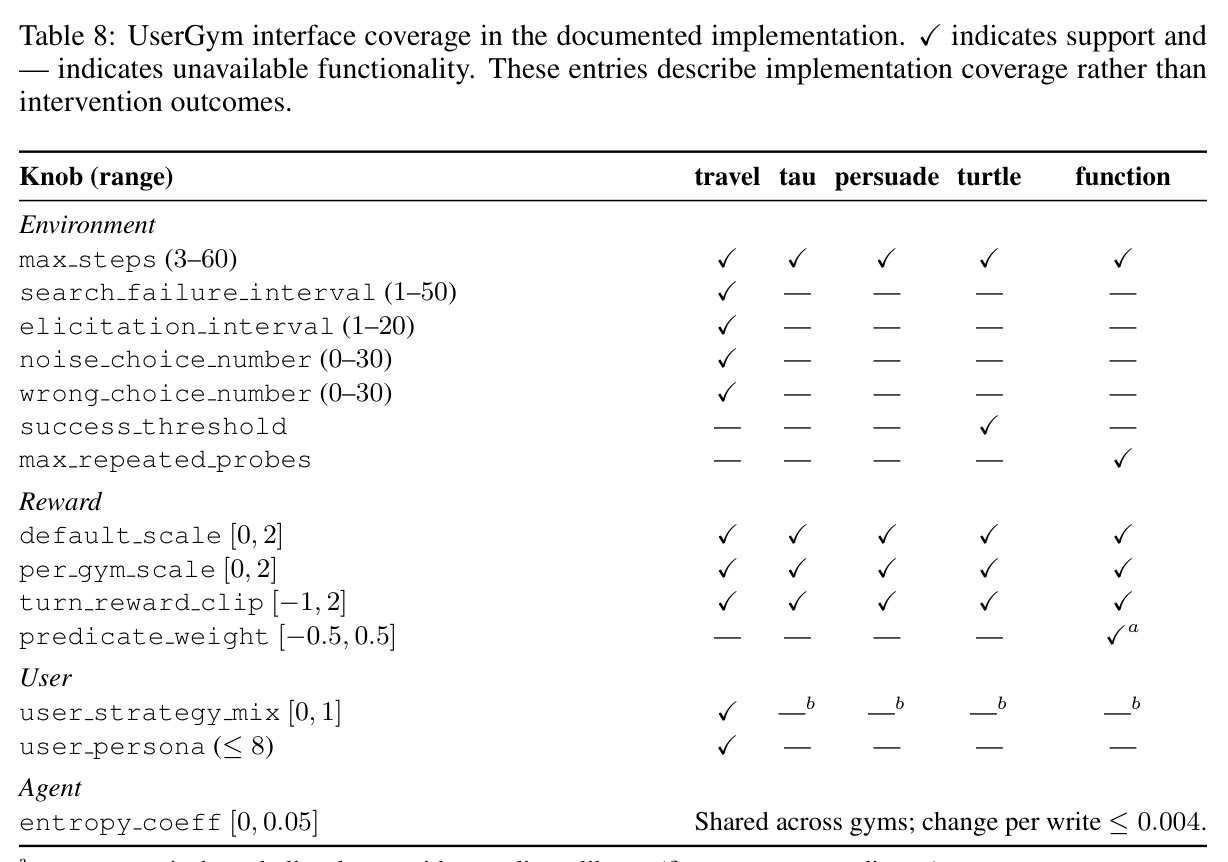
独立分析有五个弱点。(1) 元智能体是闭源前沿模型:每步诊断与代码修改都要调用 Opus-5,成本与延迟高,改进方向是蒸馏或微调开源小模型专司训练管理(作者在结论中也提到这一方向)。(2) 干预归因困难:附录 Table 7 显示 15 次写入中仅 2 次测得明确危害、3 次归因被撤回,熵系数 0$\to$0.004 的效果滞后超出 10 步验证窗口而被错误回滚——应引入受控 A/B 干预与更长的因果验证窗口。(3) 完整性门控只做数值范围检查:接口级缺陷如 max_reveals 不约束重复披露、reveal_return_shape 过滤条件类型不匹配(针对 kind=="shape" 占 8% 的事实,而实际泄漏发生在 kind=="return" 占 18%)都未被门控捕获——应加入语义级验证或单元测试门。(4) 符号用户规则仍需人工设计原型,元智能体只能调参、不能从零综合整套规则——可让元智能体参与规则自动综合。(5) 经验迁移依赖脆弱的键控机制:mixture selector 只识别 travel/colbench/tau2 三个键,UserGym 其余四个环境的键解析为 None,tau 键甚至匹配不上 tau2,跨任务泛化路径应改为语义匹配。
未来方向
作者明确提出的方向:训练开源模型来自主执行这种协同演化,摆脱对闭源前沿编程智能体的依赖。基于本文成果可延伸的方向:(1) 把"诊断—修改—验证"闭环做成自动化的因果推断,利用 run 内扰动—回滚—反转数据学习每种干预类型的预期效应,减少试错;(2) 扩展接口覆盖并允许元智能体自行新增旋钮、修复接口缺陷(论文已出现 EAU 自行修复 min_questions 计数器的先例,可以系统化);(3) 与自动环境生成路线(ScaleEnv、EnvHarness)结合,让世界生成与世界演化统一在同一个元智能体之下;(4) 在真实用户的 A/B 场景中检验 sim2real 差距,尤其是符号用户规则能否迁移为真实用户行为模型;(5) 为协同演化建立理论:修改后的任务分布漂移与策略最优性、以及"提高难度需成功率 $\ge 0.80$"这类门控规则的最优阈值,目前都只有经验证据;(6) 用符号用户的确定性判断替代部分 LLM 评估以降低验证成本,并探索验证器本身的自动校验。
复现评估
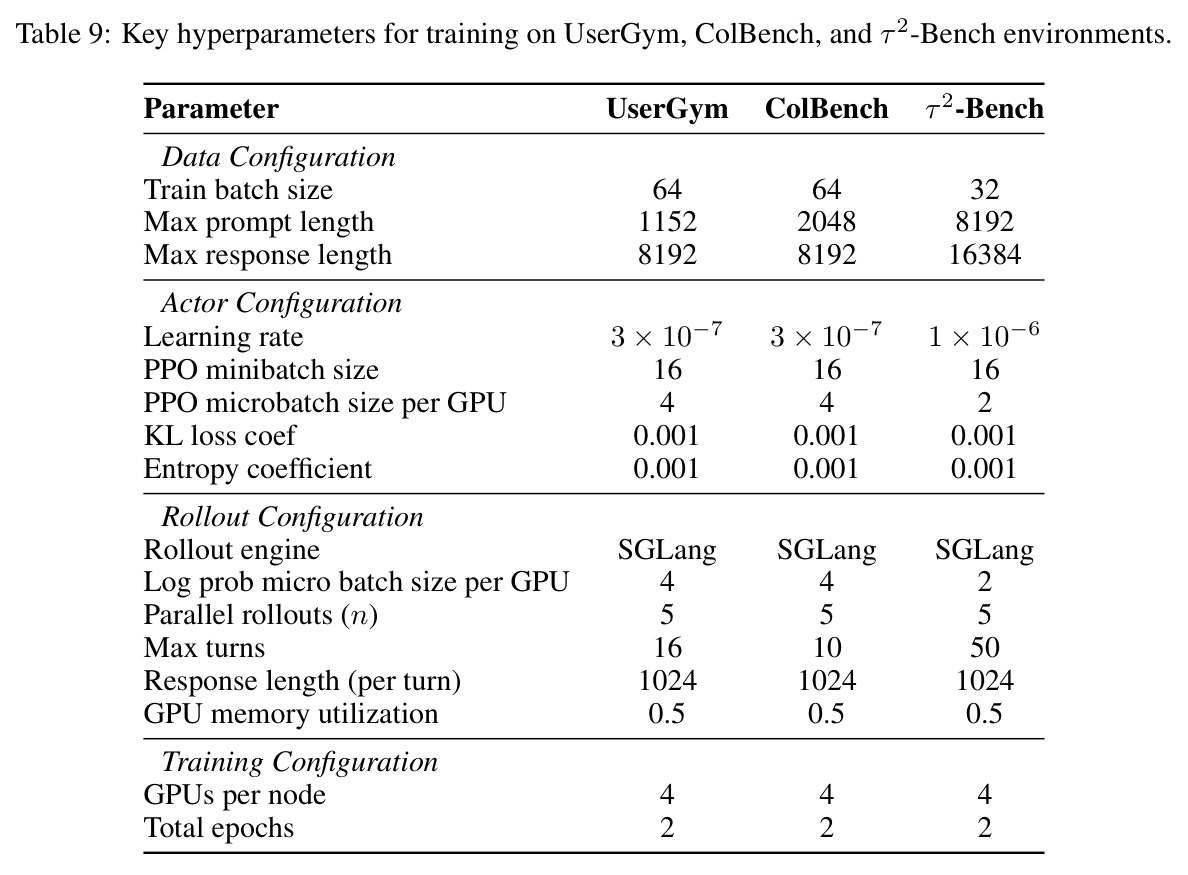
复现评估:难度中高。论文复现信息较充分:Table 9 给出完整超参(学习率 UserGym/ColBench $3\times10^{-7}$、$\tau^2$-bench $1\times10^{-6}$,batch 64/64/32,2 个 epoch,每节点 4 GPU,SGLang rollout 引擎);附录 A 公开了全部干预接口清单、范围限制与真实干预记录(Table 6-8),这在同类工作中少见地诚实;有项目页 eau-meta-agent.github.io,但正文未见明确的代码开源承诺。硬性外部依赖是复现的最大门槛:需要 Claude Code + Claude Opus-5(或 Codex + GPT-5.6-Sol)等闭源编程智能体,CoSER(微调 Llama-3.1-8B)训练模拟器与 GPT-4o-mini 评估模拟器的 API。算力方面每实验最多 5 次 run(含主动重启的失败 run),总算力还包含元智能体推理成本,未做匹配披露。作者也明确说明:报告的标准差只覆盖重复评估,不覆盖"训练+适应"全过程的随机性。对拥有 4-GPU 节点和相应 API 预算的团队,按附录接口可较有信心地复跑;预算有限者可先复现 PPO 基线与符号用户部分。
论文图表
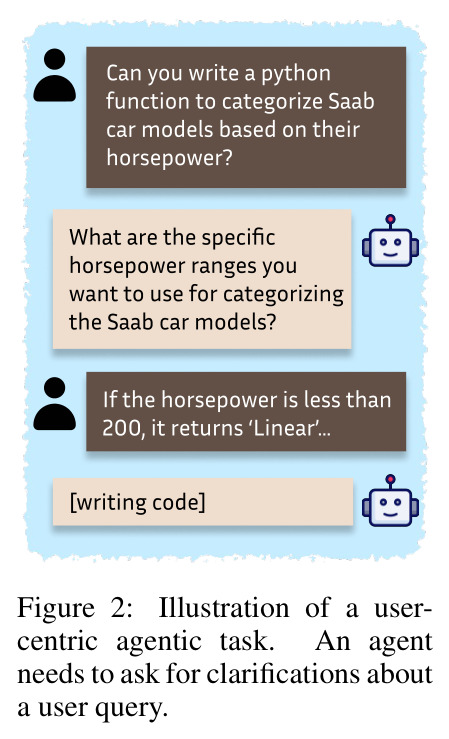
一个具体例子:用户请求"写一个按马力给萨博车型分类的 Python 函数",任务规格不完整——用户只说"马力小于 200 返回 Linear"。智能体在写代码的同时需要主动提问澄清("你想用哪些马力区间分类?"),用户逐步补充隐藏信息。
定义了"以用户为中心的智能体任务"这一研究对象:初始需求系统性欠规格,智能体必须在"继续提问"与"直接行动"之间权衡。这是理解所有三个基准(ColBench、UserGym、$\tau^2$-bench)共通任务结构的前提。