GeoFix:面向4D一致生成的几何修复 GeoFix: Geometry Fixing for 4D Consistent Generation
用单一FOV校准的深度一致性奖励,同时提升视频几何一致性与画质,训练推理皆可用
前置知识
视频扩散模型(VDM)
在大规模视频数据上训练的扩散/流匹配生成模型,在时空压缩的视频 latent 空间中逐步去噪生成视频,代表工作如 Wan2.2、CogVideoX。它学到了极强的视觉外观先验,但并不显式建模 3D 结构,因此相机移动时背景可能出现变形、漂移等几何不一致。
本文所有对齐操作都围绕基座模型 Wan2.2-TI2V-5B 展开,奖励信号最终通过微调或推理引导作用于其 latent 去噪过程,理解 VDM 的 latent 扩散机制是读懂方法的前提。
4D Gaussian Splatting(4DGS)
把动态场景表示为随时间演化的 3D 高斯基元集合(3D 空间加时间维),配合每帧相机位姿与运动速度,可从任意新视角实时可微渲染。相比点云或网格,它天然支持高质量新视角合成与动态场景编辑。
本文的最终产物是从视频 latent 解码出的 4DGS 场景,所有评估(渲染新视角视频再打分)都建立在这种表示之上,奖励模型本身也会顺带输出 4DGS。
深度重投影一致性
用估计的深度图把一个视角的像素反投影为 3D 点,再经相对位姿 $T_{i\to j}=T_j^{-1}T_i$ 投影到另一视角,与目标视角的深度图比较。误差小说明两个视角对场景 3D 结构的理解相互一致;它是纯几何度量,不依赖颜色与纹理匹配,也无需点跟踪对应。
FOCAL 奖励的主体就是这个误差转成的 PSNR 分数,理解重投影误差的定义才能明白奖励到底在优化什么、以及后续校准修的是什么偏差。
扩散模型奖励对齐(DiffusionNFT / Best-of-N / DPS)
用打分函数为生成样本提供反馈来控制扩散模型:训练时用 RL 类目标微调,如 DiffusionNFT 用奖励加权正向过程流匹配损失、无需对反向过程评分;推理时用 Best-of-N 生成 $N$ 个样本选奖励最高者,或 DPS(Diffusion Posterior Sampling)在去噪每步用奖励对干净 latent 预测 $\hat{z}_{0|t}$ 的梯度 $\eta_t\nabla_{z_t} R$ 调整采样方向。
GeoFix 的核心卖点是一个奖励即插即用于这三种代表性对齐方式,论文的训练与推理实验全部建立在这些算法之上。
模型拼接(Model Stitching)
把网络 A 的前几层替换成一个轻量适配层 $S_\phi$,使其输出直接对齐网络 B 中间层(第 $k$ 层)的特征空间,再接上 B 的剩余层 $R_\psi$,从而绕过 A 的解码与 B 的浅层计算。VIST3A 证明这种拼接比'先解码 RGB 再送 3D 重建器'更快,且对生成 latent 的扰动更鲁棒。
FOCAL 需要在对齐循环中反复从视频 latent 提取深度与相机,拼接的 4D 重建器是这条高速计算路径的基础,也是奖励可微、免 VAE 解码的原因。
FOV 重叠 $\Omega$
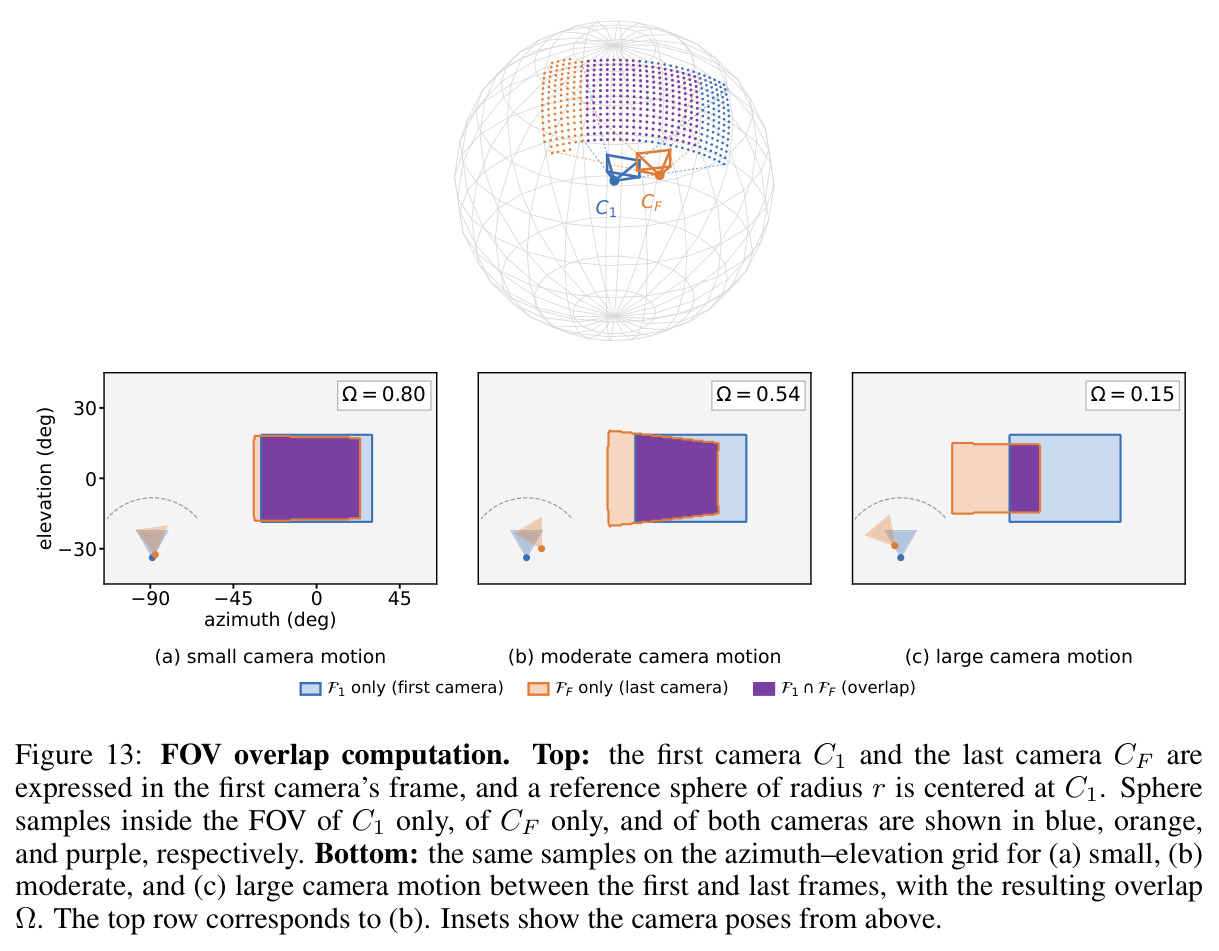
量化两个相机视野重合程度的指标:在以首个相机为球心、半径取预测深度 75 分位的参考球上,按方位角-仰角均匀采样 360×180 点,取首末帧相机视场所覆盖球面区域的面积加权(权重 $\cos e$ 修正极区过采样)IoU。$\Omega=1$ 表示两帧看到同一区域,$\Omega=0$ 表示完全不重叠。
重叠偏差的发现与校准是全文最核心的贡献:原始深度一致性分数随 Ω 系统性变化,不校准就会奖励'少动相机';因此 Ω 是校准公式中的自变量,必须理解其定义。
静态区域掩码(运动分割)
用预训练运动分割网络 SegAnyMo 从视频中逐帧标出独立运动物体(行人、车辆等)区域,其余为静态背景。几何一致性检验只在静态区域进行,避免把合理的物体运动误判为几何不一致,同时掩码随深度一起变换以保证破坏测试的公平。
这是 FOCAL 能'只约束结构、不惩罚合理动态、不伤画质'的关键设计之一,也是破坏测试公平性的保障;理解它才能理解单一奖励为何不退化为静态视频。
研究动机
视频扩散模型(VDM,如 Wan2.2)虽能生成视觉保真度很高的视频,但输出常含几何不一致:相机移动时背景结构会变形、漂移(例如平移镜头下建筑边缘扭曲、墙体纹理游动、地面结构漂移)。这类缺陷使其难以直接充当 4D 生成的先验——4D 表示要求场景结构与动态在时间和视角间保持连贯。近期工作转用奖励后训练修复,但存在两类缺陷:间接反馈(偏好模型、VLM 评分)把几何错误与外观、渲染保真度混在一起,无法定位结构错误;直接反馈(RGB 重建误差、对极约束、深度一致性、跟踪对应)在优化时会产生捷径——VIST3A 报告仅优化重建一致性会得到模糊输出,Epipolar-DPO 报告特定对应估计器会导致过饱和。为此现有方法被迫引入辅助画质奖励、近静态惩罚或偏好数据过滤,带来奖励权重平衡、样本选择阈值等额外的设计负担与调参成本。
本文的目标是本文要回答的核心问题是:能否仅用单一几何奖励,同时提升几何一致性与视频质量,而不需要任何辅助奖励?具体目标是设计这样一个奖励:(1) 只约束场景的 3D 结构,不直接约束颜色纹理,从而不压缩预训练模型的视觉丰富度;(2) 不把合理的物体运动误判为几何不一致;(3) 消除'相机少动=几何更好'的度量偏差;(4) 直接在视频 latent 空间计算且可微,能够不加修改地插入训练时对齐(DiffusionNFT 后训练)与推理时对齐(Best-of-N 选择、DPS 梯度引导),并在计算奖励的同时顺带产出显式 4D 高斯场景表示。作者的核心主张是:几何不一致本身就是视觉缺陷,因此修复结构错误理应同时改善观感。
与已有工作不同的是,本文的独特切入有三层。其一,度量选择:放弃 RGB 信号,只在静态区域测跨视角深度一致性——镜面反射等视角相关效应使 RGB 成为不可靠的几何信号,而深度重投影只评价 3D 结构的跨视角一致性,无需颜色匹配或点跟踪。其二,一个被先前方法普遍忽视的实证发现——重叠偏差:即使在干净的真实视频和多视角 4D 数据集上,FOV 重叠越大深度重投影误差越小,原始分数无法区分'几何好'与'相机几乎没动',直接最大化反而奖励更小的相机运动;作者系统量化了这一偏差并提出数据驱动的校准方案。其三,工程路线:用模型拼接把 4D 重建器直接接到视频 VAE 的 latent 上,奖励计算绕过 VAE 解码与重建器浅层,更快、更抗生成 latent 噪声、且对 latent 可微。
核心方法
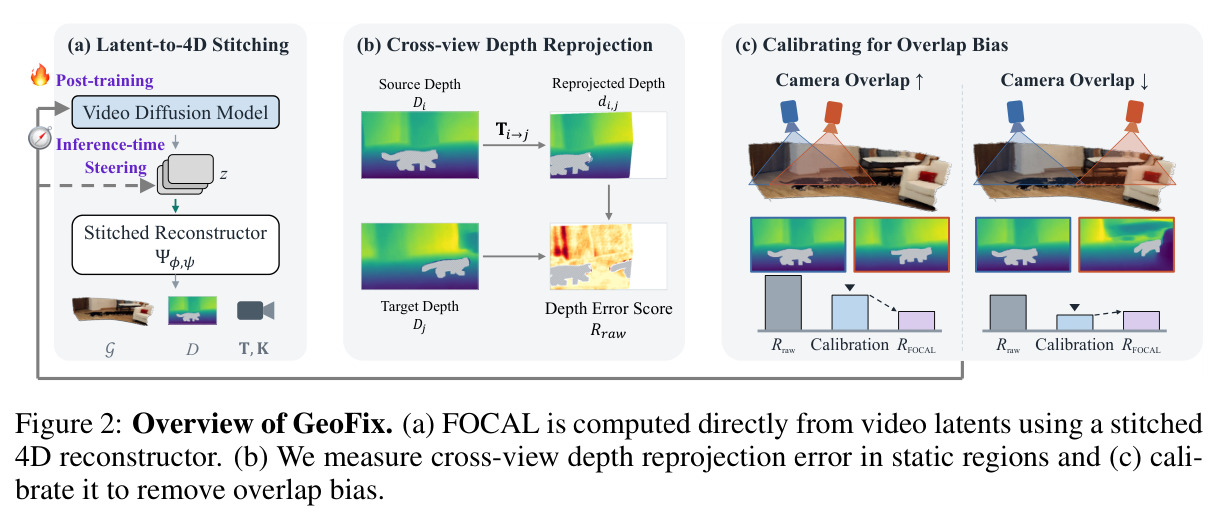
直觉上,几何不一致本身就是视觉缺陷:背景漂移、结构扭曲的画面观感必然差,修复结构错误应同时改善画质;因此奖励只需回答'场景结构在不同视角下是否一致',不必管纹理细节。技术路线由三部分组成。(1) 拼接的 4D 重建器:轻量拼接层 $S_\phi$ 把 Wan2.2 的视频 latent 映射到预训练 4D 重建器(NeoVerse)第 $k$ 层的输出特征空间,接上从原网络后半段 $F_{k+1:L}$ 初始化的可训练模块 $R_\psi$,一次前向同时输出 4D 高斯 $\mathcal{G}$ 与每帧深度 $D_f$、位姿 $T_f$、内参 $K_f$。(2) FOCAL 奖励:在静态区域做跨视角深度重投影,得到 PSNR 形式的原始分 $R_{\text{raw}}$,再减去由参考视频拟合的、随 FOV 重叠 $\Omega$ 变化的期望项 $\hat\beta\log_{10}\Omega$,得到对相机运动不敏感的 $R_{\text{FOCAL}}$。(3) 对齐框架:该奖励即插即用于 DiffusionNFT 后训练、Best-of-N 与 DPS 引导,训练与推理共用同一个冻结的拼接重建器与校准系数 $\gamma=0.7$,全程无辅助奖励。
核心创新是'重叠偏差'的发现与校准。作者观察到:即使完全干净的真实视频与多视角 4D 数据集,当首末帧相机 FOV 重叠 $\Omega$ 大(相机几乎不动)时,跨视角深度重投影误差天然更小——重投影点落在图像中心、入射角接近垂直、被遮挡与新露出的表面更少,深度预测本来就容易。因此 $R_{\text{raw}}=\alpha+\beta\log_{10}\max(\Omega,\epsilon_{\text{fov}})+\xi$ 中 $\beta$ 显著为正,直接最大化 $R_{\text{raw}}$ 的模型学到的捷径是缩小相机运动而非改善几何:消融显示去掉校准($\gamma=0$)后 Dynamic Degree 从 0.425 跌至 0.395。FOCAL 用参考视频估计这条期望线,从每个生成视频的分数中减去 $\hat\beta\log_{10}\max(\Omega,\epsilon_{\text{fov}})$,最终 $R_{\text{FOCAL}}=10\log_{10}\frac{D_{\max}^2}{(\text{MSE}+\epsilon)\,\max(\Omega,\epsilon_{\text{fov}})^{\gamma}}$,度量的是'相对该相机运动幅度下的期望深度一致性,实际达到了多少'。与已有方法的本质区别:先前方法用外加动态惩罚或画质奖励补救一致性奖励的副作用(多奖励权衡),FOCAL 把观测条件内化到奖励定义本身,单一奖励即可同时改善几何与画质。
方法步骤详情
完整流程分五步。第一步,训练拼接重建器:冻结 NeoVerse 教师与 Wan2.2 VAE 编码器,训练拼接层 $S_\phi$(按 VIST3A 方式挑选回归误差最低的编码器块)与由教师后半层初始化的 $R_\psi$(backbone 用 rank-64 LoRA),以 $\ell_1$ 输出蒸馏(点图、位姿、内参、深度、高斯属性、动态场景速度)先在 DL3DV 静态场景、再在 UltraVideo 动态视频上训练;输入 latent $E(x)$,输出 $\Psi_{\phi,\psi}(z)=\{\mathcal{G},\{D_f,T_f,K_f\}_{f=1}^F\}$。第二步,计算原始深度一致性:对帧对 $(i,j)$(按步长 $s$ 采样),把 $D_i(p)$ 用 $K_i$ 反投影为 3D 点 $X_i(p)$,经 $T_{i\to j}=T_j^{-1}T_i$ 投影到帧 $j$ 得 $(y_{i,j}(p),d_{i,j}(p))$,与双线性采样的 $D_j(y_{i,j})$ 比较;仅统计静态区域(SegAnyMo 掩码之外)、投影在界内且目标深度为正的像素,求 MSE 后转为 $R_{\text{raw}}=10\log_{10}\frac{D_{\max}^2}{\text{MSE}+\epsilon}$。第三步,量化 FOV 重叠:首末帧相机在以首帧相机为球心、半径取深度 75 分位的参考球(360×180 网格)上标出视场,计算 $\cos e$ 加权面积 IoU 得 $\Omega$。第四步,校准:在参考视频上拟合 $\beta$,令 $\gamma=\hat\beta/10$(实验取 0.7)并全程冻结。第五步,对齐:训练时用 DiffusionNFT,每步从 VideoUFO 提示采样 8×8=64 个 rollout(13 帧、10 步去噪、无 CFG)打分,与 MultiCamVideo(120,460 段)+UltraVideo(42,184 段) 上的监督损失联合优化;推理时 Best-of-N 取 $N=20$ 个完整样本中奖励最高者,或 DPS 在第 3–17 步用 $\eta_t\nabla_{z_t}R_{\text{FOCAL}}(\hat z_{0|t})$ 引导——硬 $\Omega$ 前向保留精确值、梯度经 sigmoid 软近似 $\tilde\Omega$ 回传(直通估计器)。
技术新颖性
技术新颖性可从四个层面评估。奖励设计层面:以往几何奖励(RGB 重建、对极约束、深度一致、对应一致)都被默认为'分数越高几何越好'的直接目标,本文第一个系统量化了它们与相机运动的混淆,并给出数据驱动的校准方案——Figure 3 显示包括 PickScore 等间接奖励在内的多种度量都与 FOV 系统性相关,而校准后的分数在留存视频上回归斜率近零。目标函数层面:$\gamma$ 只在参考视频上估计一次并冻结,无需多奖励权重搜索,与 VIST3A(重建+画质双奖励)、Epipolar-DPO(偏好过滤)形成方法论对比。系统层面:latent-to-4D 拼接让奖励免 VAE 解码、对生成 latent 扰动更鲁棒,且同一前向顺带产出 4DGS,训练推理共用;拼接模型在新时间合成上 PSNR 反而比 RGB 输入的教师高 1.68 dB(Table 6)。可微性层面:对零测度梯度的硬 FOV 重叠设计直通估计器(前向精确 $\Omega$、反向软松弛),使 DPS 这类一阶梯度方法可行。这些组合使 GeoFix 成为首个'单一几何奖励、训练+推理统一'的 4D 一致性对齐框架。
实验结果
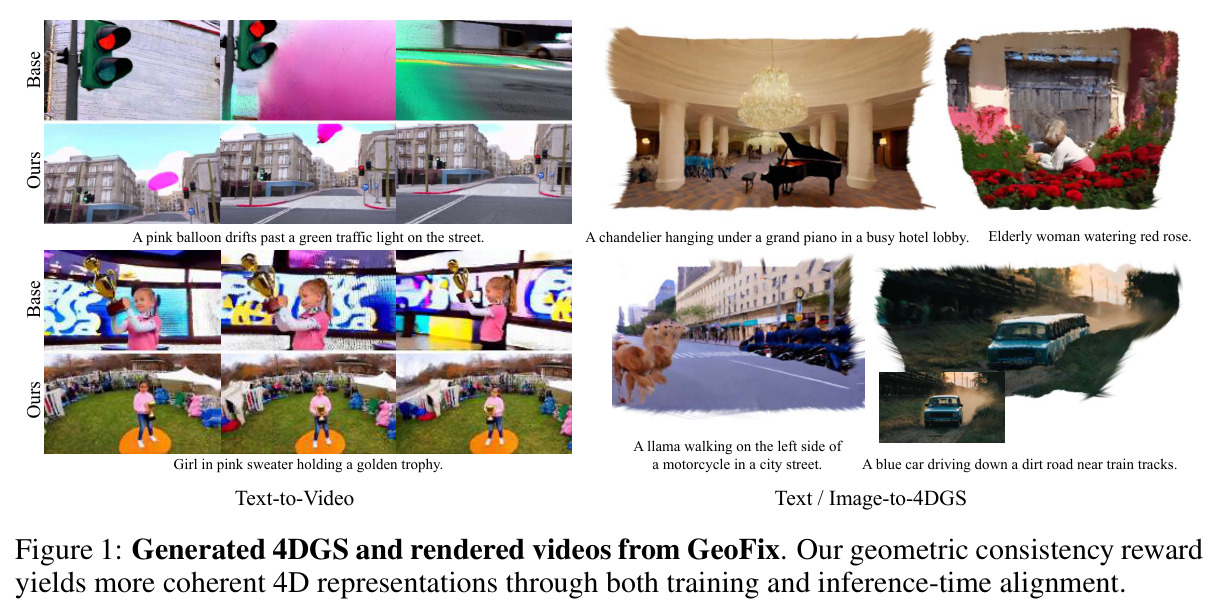
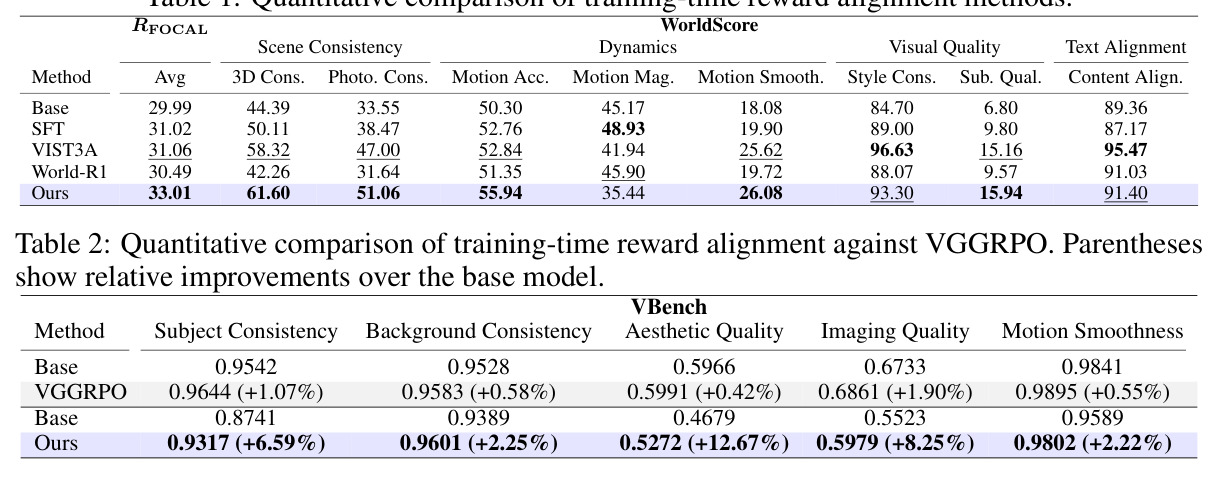
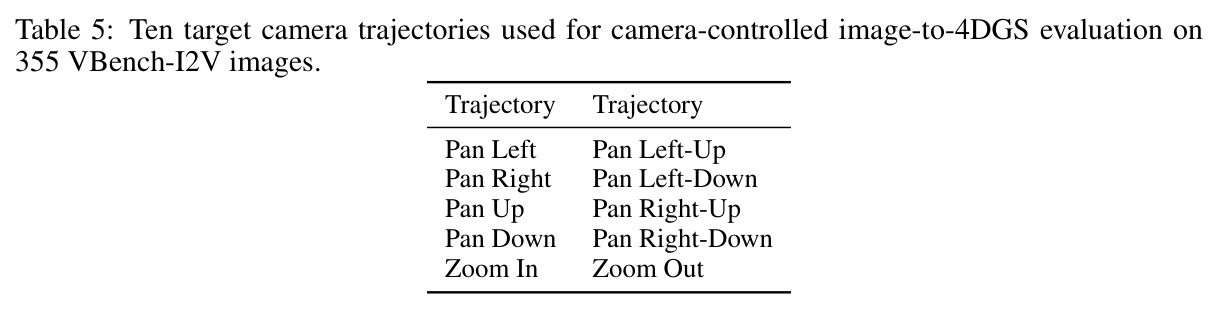
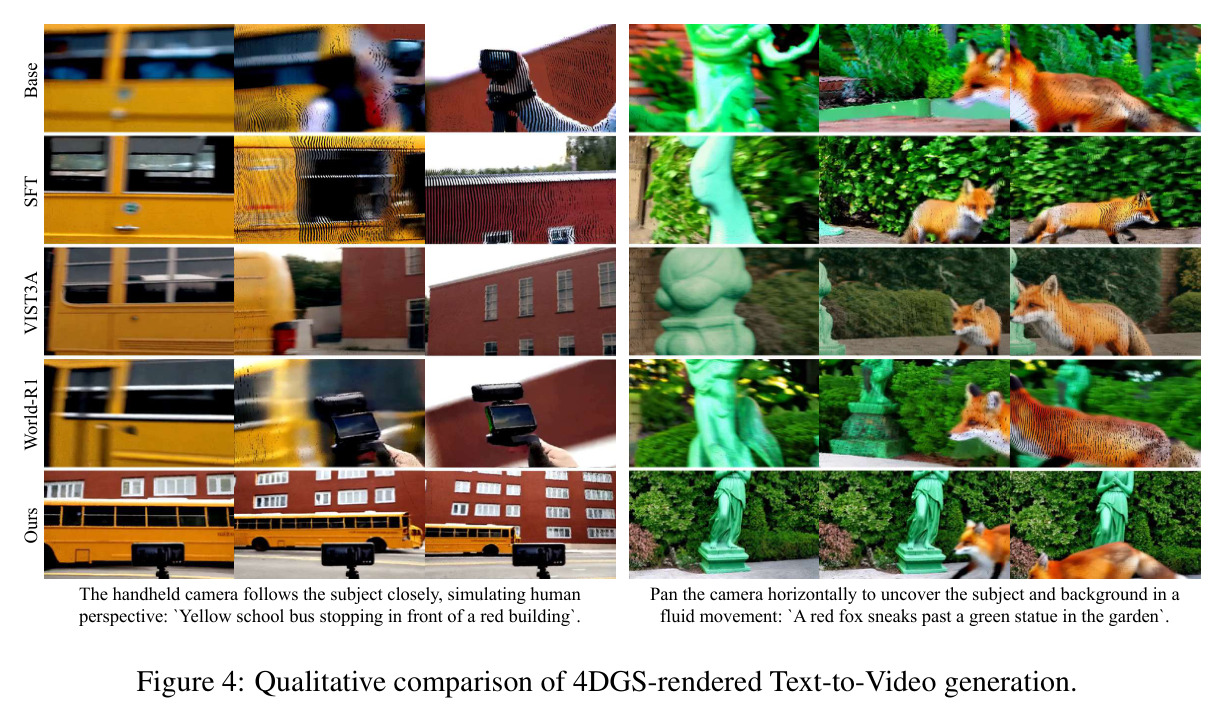
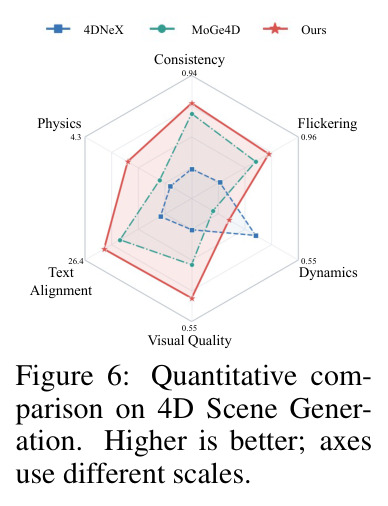
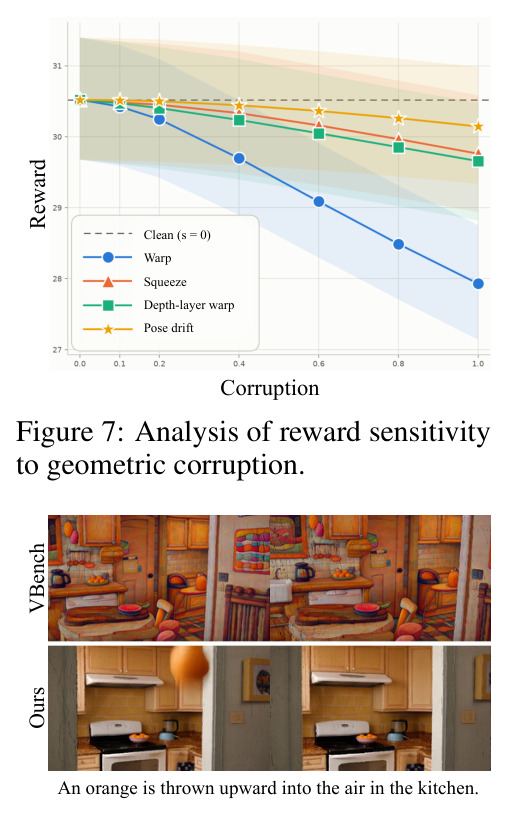
训练时对齐(Table 1,Wan2.2-TI2V-5B,200 条 T2V-CompBench 提示的 4DGS 渲染视频):FOCAL 平均分 29.99→33.01,WorldScore 3D 一致性 44.39→61.60(+39%),光度一致性 33.55→51.06,运动准确性 50.30→55.94,运动平滑 18.08→26.08,主观质量 6.80→15.94,全部超过 SFT/VIST3A/World-R1;VBench Quality Score 0.7272→0.7588(+4.3%);代价是运动幅度 45.17→35.44。SFT 单独只有中等收益,说明增益主要来自奖励而非监督数据。与 VGGRPO 对比(Table 2)各维度相对提升全面占优:Subject +6.59% vs +1.07%,Background +2.25% vs +0.58%,Aesthetic +12.67% vs +0.42%,Imaging +8.25% vs +1.90%,Motion Smooth +2.22% vs +0.55%——而这些画质指标都不是训练奖励。推理时(Table 3,355 张 VBench-I2V 图 ×10 条相机轨迹):BoN 把旋转误差从 2.040° 降到 1.751°,3D 一致性 75.43→78.00、光度一致性 76.06→78.33;DPS 亦有效(旋转 1.977°、3D 一致性 76.49),证明奖励梯度可用;运动准确性仅微降(44.81→44.59/44.42)。4D 场景生成(Figure 5/6,100 张 VBench-I2V,对比 4DNeX/MoGe4D):一致性指标全面最优,4DNeX 的高动态度实为帧间结构抖动,MoGe4D 几乎不动,GeoFix 叠加可视化中背景保持锐利对齐。消融:破坏测试(Figure 7)中奖励对 Warp/Squeeze/Depth-layer warp/Pose drift 四种破坏单调下降;VBench 奖励直接微调产生饱和、黑屏、网格伪影(Figure 8/14);FOV 校准消融(Table 4)中 $\gamma=0.7$ 取得最佳 VBench Avg 0.6861 与 Dynamic 0.425;拼接重建器(Table 6)新时间合成 PSNR 21.98,比同 backbone 的 NeoVerse 20.30 高 1.68 dB。
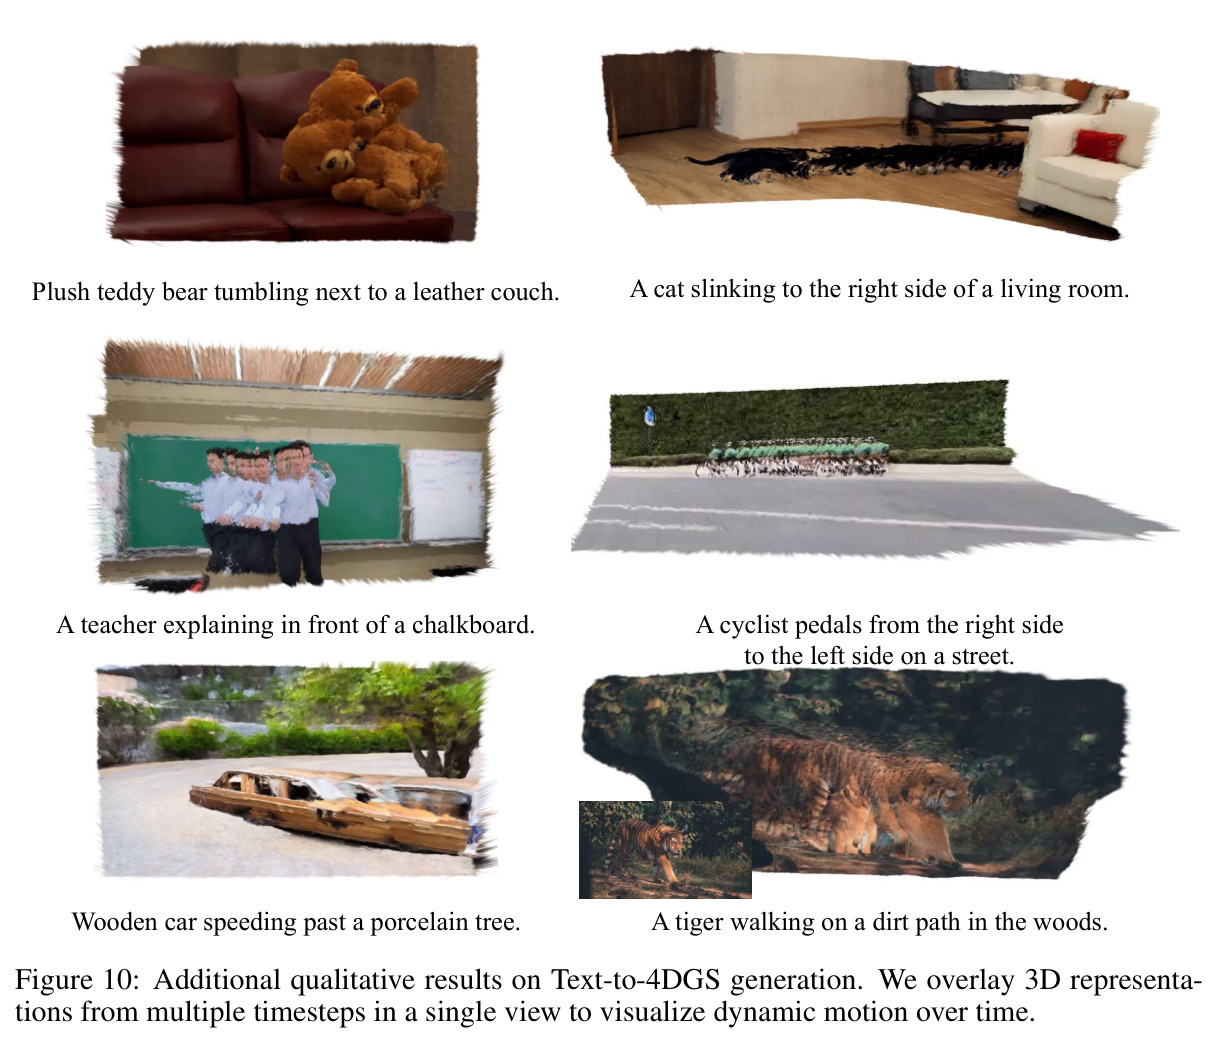
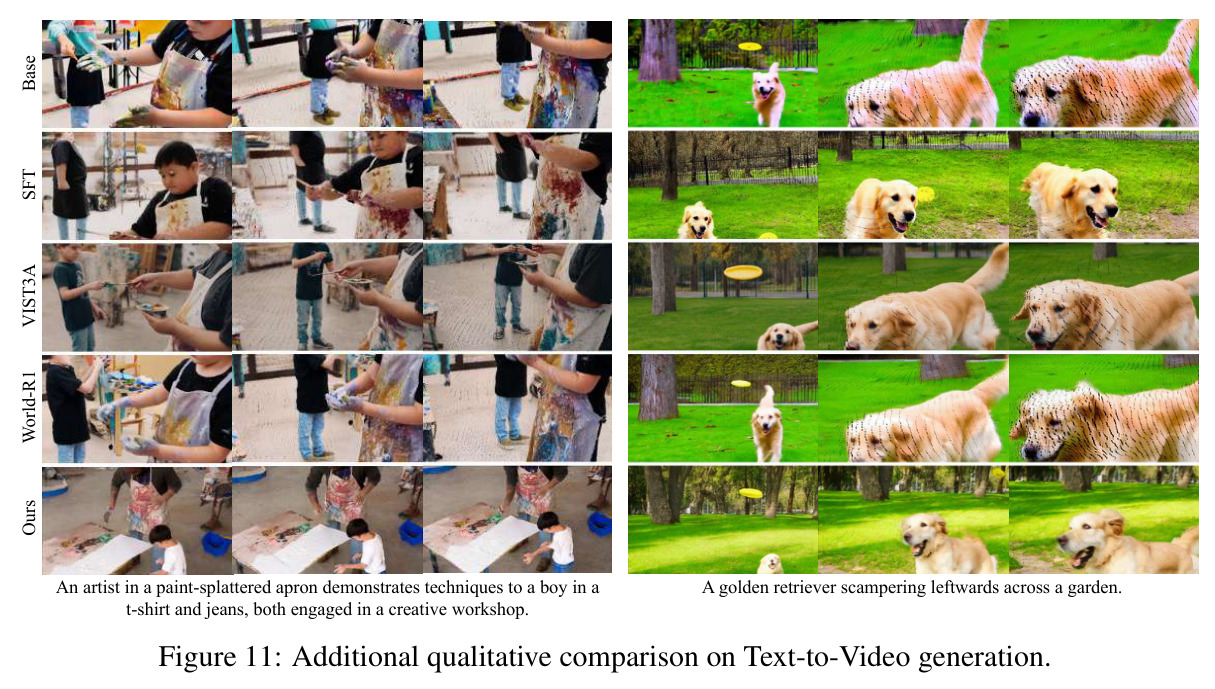
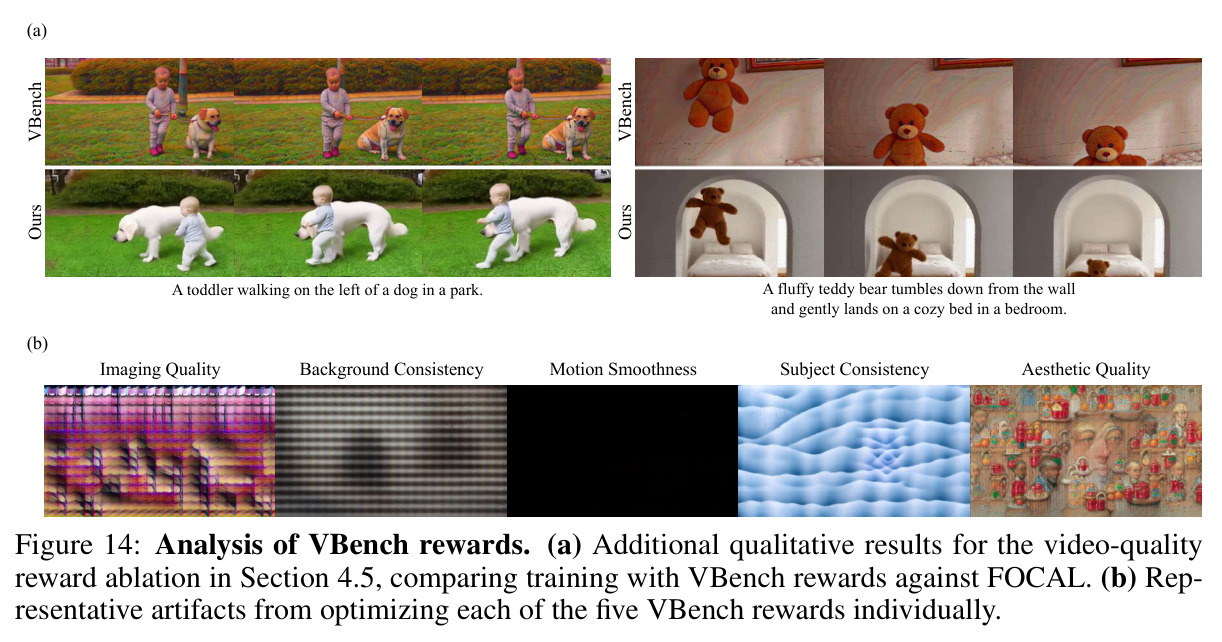
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 训练时对齐·世界生成质量(200 条 T2V-CompBench 提示的 4DGS 渲染) | WorldScore 3D Consistency | 61.60 | Base 44.39 / SFT 50.11 / VIST3A 58.32 / World-R1 42.26 | +39%(vs Base,摘要口径);超最强基线 VIST3A +3.28 |
| 训练时对齐·世界生成质量 | WorldScore 光度一致性(Photo. Cons.) | 51.06 | Base 33.55 / VIST3A 47.00 | +52.2% vs Base,超最强基线 +4.06 |
| 训练时对齐·视频质量(VBench,WAE 解码视频,对 VGGRPO 协议) | Aesthetic Quality 相对提升 | +12.67% | VGGRPO +0.42% | +12.25 个百分点 |
| 训练时对齐·视频质量(VBench) | Subject/Background/Imaging/Motion Smooth 相对提升 | +6.59% / +2.25% / +8.25% / +2.22% | VGGRPO +1.07% / +0.58% / +1.90% / +0.55% | 五个维度全面领先 |
| 推理时相机控制引导(355 张 VBench-I2V × 10 轨迹) | 相机旋转误差(°,越低越好) | 1.751(Best-of-N)/ 1.977(DPS) | 无引导 2.040 | -14.2%(BoN) |
| 推理时相机控制引导 | WorldScore 3D Consistency | 78.00(BoN)/ 76.49(DPS) | 无引导 75.43 | +2.57(BoN) |
| 拼接重建器重建质量(MultiCamVideo 子集) | 新时间合成 PSNR(dB) | 21.98 | NeoVerse 20.30 / MoVieS 19.12 / 4DGT 17.72 | +1.68 dB(vs 同 backbone 教师 NeoVerse) |
| FOV 校准消融 | VBench Avg / Dynamic Degree | 0.6861 / 0.425($\gamma$=0.7) | 无校准 $\gamma$=0:0.6802 / 0.395;$\gamma$=1:0.6823 / 0.425 | +0.0059 / +0.030(vs 无校准) |
局限与改进
作者承认的局限(附录 E):方法继承预训练 VDM 与 4D 重建器的偏差——深度与相机由 NeoVerse 蒸馏而来,教师失败即产生错误奖励信号;动态分割(SegAnyMo)出错时会惩罚合理运动或漏约束不一致区域;计算奖励需运行拼接重建器与运动分割网络,DPS 还需对整个重建器反传梯度,训练与推理成本都增加。我的补充观察:其一,3D 一致性 +39% 的同时运动幅度从 45.17 降到 35.44,部分收益可能来自相机运动更保守,'几何变好'与'动得变少'尚未完全解耦;其二,校准曲线只在参考视频分布(DL3DV/MultiCamVideo/UltraVideo)上拟合与验证,分布外场景(极端俯仰角、超广角、水下)$\gamma$ 未必成立,虽然留存集上斜率近零,但覆盖面有限;其三,FOCAL 既是训练奖励又是主报告指标,存在自评循环风险(WorldScore/VBench 等外部指标部分缓解但未消除);其四,透明、反光、弱纹理表面的深度估计天然不可靠,这些区域的奖励噪声更大;其五,全部实验仅基于 Wan2.2-5B + NeoVerse 组合,对其他 VDM 与重建器的泛化性未报告。
独立分析的弱点
独立分析的弱点与改进方向:(1) 运动幅度下降 45.17→35.44——校准只减去期望趋势的对数项,对相机运动的残余抑制仍在,可引入运动量下限正则,或按参考视频运动分布做第二重归一化;(2) 奖励质量受限于单一教师 NeoVerse——快速运动、大面积遮挡、透明表面时教师失败即奖励失准,可集成多个重建器并用预测方差对像素加权,低置信区域自动降权;(3) 动态掩码是硬边界且来自 2D 分割网络——分割误差直接变成奖励噪声(惩罚合理运动或漏掉不一致区域),可改用软掩码加置信度,或用多视角一致的 3D 运动场检验替代 2D 分割;(4) 全局单一标定系数 $\gamma$——室内/室外、近景/远景、不同焦距下 $R_{\text{raw}}$–$\Omega$ 斜率可能不同,可按场景类别或深度范围条件化拟合曲线,甚至在线更新 $\hat\beta$;(5) 评估协议部分自我循环——FOCAL 既是奖励又是首要报告指标,应补充第三方几何一致性评测(如 SGC、GeoCo)与人工研究;(6) 计算开销——奖励前向含重建器加分割网络,DPS 需全链路反传,可蒸馏轻量奖励头、缓存静态掩码与 $D_{\max}$、仅在关键帧做重投影以摊薄成本。
未来方向
作者提出的方向:随 4D 重建器与动态跟踪技术的进步,奖励信号会继续变得更准、更便宜,GeoFix 框架可随之受益。基于本文成果可延伸的研究:(1) 把重叠校准推广为通用原则,应用到对极误差、对应一致性、RGB 重投影等一切随相机运动变化的度量,构建一族'无重叠偏差'的几何奖励并比较其互补性;(2) 与极少量外观或物理奖励组合,同时保持'少奖励、免调权'的设计哲学,探索多目标情形下校准是否需要交互项;(3) 扩展到长时序、多物体交互与流式世界模型,检验长程漂移下校准曲线是否需要在线重估 $\hat\beta$;(4) 与相机控制生成(ReCamMaster 类方法)形成闭环——Table 3 已显示相机精度提升,可进一步做可控世界模型的训练时对齐;(5) 系统研究推理时引导的效率边界:引导步数(当前第 3–17 步)与 BoN 的 $N$ 如何随模型规模与奖励成本伸缩;(6) 把'修复几何即提升画质'的假设推广到图像扩散模型与 3D 生成,检验其普适性。
复现评估
复现评估:论文为 preprint,正文与附录未明确声明开源代码或 checkpoint(项目页 yeobinhong.github.io/GeoFix 目前展示结果)。有利条件是所有组件均基于公开资产:Wan2.2-TI2V-5B、NeoVerse、VIST3A 的拼接初始化方案、数据集 DL3DV/MultiCamVideo(120,460 段多相机视频)/UltraVideo 短片切分(42,184 段)/VideoUFO 提示,评测工具 VBench、WorldScore、VideoPhy-2、SegAnyMo、ReCamMaster 轨迹全部开源;附录 A 给出极详细的超参:LoRA rank 4/$\alpha$=8 作用于自/交叉注意力 QKVO,lr 1e-4、AdamW、1000 步、每步 8 提示×8 rollout、10 步去噪无 CFG、$\beta_{\text{KL}}$=5e-3、$\gamma$=0.7,推理 480×832/41 帧/50 步/CFG 5.0,4DGS 解码 518×294。难点:拼接重建器需在 DL3DV+UltraVideo 上做输出蒸馏训练(rank-64 LoRA),5B 模型训练与 rollout 采样需要多卡 GPU 且论文未披露 GPU 时数;DPS 引导需对重建器全链路反传,显存压力大;与 VGGRPO 的对比因对方未放码只能对论文数字,属弱协议。总体复现难度中等偏上:若有开源代码,主要成本是算力;若无,需自行复刻蒸馏、校准与直通估计器等细节。
论文图表
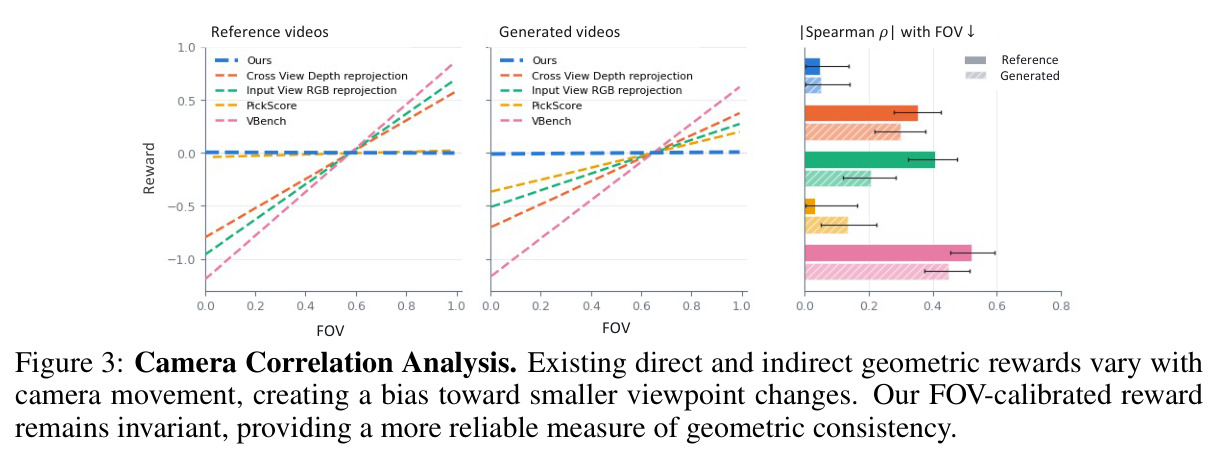
相机相关性分析:对参考视频(真实视频与 4D 数据集)与生成视频,绘制多种已有直接/间接几何奖励(跨视角深度重投影、输入视角 RGB 重投影、PickScore 等)随 FOV 重叠变化的曲线,并给出各奖励与 FOV 的 Spearman $\rho$。几乎所有现有奖励都随重叠增大而显著升高,而 FOCAL 校准后趋势基本持平。
这是论文核心论点'重叠偏差'的定量证据,直接支撑校准设计的合法性,是理解本文与先前几何奖励工作本质区别的关键图。
Image-to-4D 生成定性对比(4DNeX/MoGe4D/Ours,输入如骑沙滩车的人、泥地中跳跃的男孩、森林中行走的大象、林间飞过的秃鹰):将多个时间步的 3D 表示叠加渲染到同一视角。Ours 的背景在各时间步保持锐利对齐、运动物体沿轨迹清晰划过;4DNeX 的背景漂移产生重影与涂抹,MoGe4D 几乎没有运动。
直观解释'高动态度不等于高质量':4DNeX 的高动态来自帧间结构抖动而非真实运动,多时间步叠加可视化是辨别真假运动的巧妙手段。
VBench 奖励对比:按 DDRL 方式用五个 VBench 奖励(Subject/Background Consistency、Motion Smoothness、Imaging/Aesthetic Quality)直接微调的模型,在'橘子被抛向厨房空中'提示下输出过度饱和、 unnatural 色偏的视频,训练更久出现模糊与网格伪影;FOCAL(Ours)微调的输出自然、结构干净。
反向证明本文主张:优化通用画质奖励会产生退化解,而几何奖励反而提升画质——'修几何即修画质'最直观的对照实验。
VideoPhy-2 物理常识评测的官方查询模板:将视频输入经 VideoCon-Physics 微调的 mPLUG-Owl-Video(LLaMA-7B backbone)模型,要求按 1–5 分评定视频是否符合物理规律(5 为完全符合),评测时取 32 帧贪心解码取均值。
说明 4D 生成实验中物理合理性指标的评测协议,保证 Figure 6 雷达图 Physics 轴数字的协议透明与可复现。
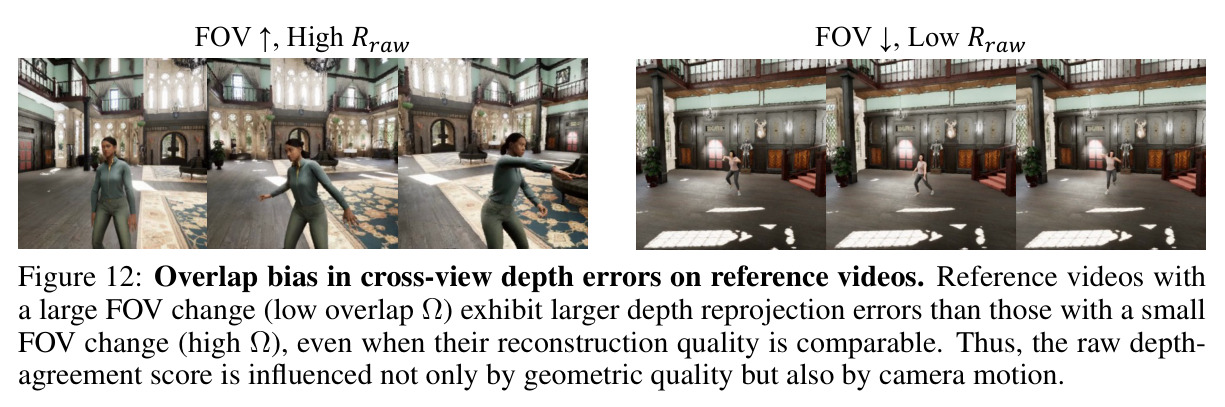
参考视频上重叠偏差的可视化(MultiCamVideo 数据集):FOV 变化大($\Omega$ 低)的片段,即使重建质量相当,跨视角深度重投影误差也显著大于 FOV 变化小($\Omega$ 高)的片段;图中并排展示高 $R_{\text{raw}}$(FOV 大重叠)与低 $R_{\text{raw}}$(FOV 小重叠)的参考与生成视频样例帧。
用真实数据证明偏差源自观测配置——小重叠时重投影点落在图像边界、掠射角、遮挡与新露出表面上,深度预测天然更难——而非几何质量,是校准动机最直接的证据。
训练时奖励对齐定量主表(Wan2.2-TI2V-5B,200 条 T2V-CompBench 提示的 4DGS 渲染视频,WorldScore 八指标):Ours 的 FOCAL 平均 33.01、3D 一致性 61.60、光度一致性 51.06、运动准确性 55.94、运动平滑 26.08、主观质量 15.94 全部第一;Base 3D 一致性仅 44.39,World-R1 甚至低于 Base(42.26);代价是运动幅度 35.44 低于 Base 的 45.17。
核心主表:证明单一几何奖励同时改善几何一致性与多数画质指标;SFT 对照(各指标中等增益)说明收益主要来自奖励而非监督数据。
推理时对齐定量对比(Wan2.2-Fun-5B-Control-Camera,50 NFE,355 张 VBench-I2V 图 ×10 条相机轨迹):BoN 使旋转误差 2.040°→1.751°、平移方向误差 34.97°→34.57°、归一化 ATE 0.2563→0.2507,WorldScore 3D 一致性 75.43→78.00、光度一致性 76.06→78.33;DPS 同向改善但幅度较小(旋转 1.977°、3D 一致性 76.49);两法的运动准确性与幅度仅微降。
证明奖励在免训练设定下同样有效,尤其 DPS 的改善说明奖励对 latent 可微且携带有效梯度信号——这是 latent 拼接与直通估计器设计的直接回报。
FOV 校准消融:$\gamma=0$(无校准)VBench Avg 0.6802、Dynamic Degree 0.395——模型靠减少相机运动敛分、丢失动态;$\gamma=0.7$(Ours)0.6861、0.425;$\gamma=1$ 为 0.6823、0.425。
直接量化核心设计(校准)的贡献:不加校准会牺牲动态,$\gamma=0.7$ 在画质与动态之间取得最佳平衡,是理解为什么必须做重叠校准的消融证据。
拼接重建器在新时间/新视角合成上的对比(MultiCamVideo 子集):Ours 新时间合成 PSNR 21.98/SSIM 0.6451/LPIPS 0.2605,比同 backbone 的 NeoVerse(20.30/0.5793/0.2917)PSNR 高 1.68 dB;新视角合成 PSNR 17.65/SSIM 0.5187/LPIPS 0.3748,亦优于 4DGT(16.35/0.5015/0.5167)、MoVieS(16.83/0.4904/0.4271)与 NeoVerse(17.23/0.5117/0.3716)。
验证 latent-to-4D 拼接不仅没有损失精度,反而因视频 VAE 的时空压缩提升了时序连贯性——这是奖励计算模块本身的质量保证,也是方法可靠性的地基。