SpatialASM:将主动空间心理想象内化进视觉语言模型 SpatialASM: Internalizing Active Mentalization for Spatial Reasoning
用训练期新视角生成器教会模型主动规划视角并在脑内想象场景,提升空间推理。
前置知识
LVLM(大型视觉语言模型)
LVLM 以视觉编码器提取图像特征,再由大语言模型融合图文信息进行推理与生成,代表工作如 Qwen3-VL 系列。它们在图像描述、VQA 等静态感知任务上表现强,但面对需要视角变换、跨视图对应、推断未观测区域的三维空间问题时性能明显下滑。
本文的全部工作都围绕提升 LVLM 的空间推理展开,四个骨干模型(Qwen3-VL-4B/8B/30BA3B、Qwen3.5-9B)均属于此类,理解其输入输出形态是读懂方法的前提。
非自我中心(allocentric)视角表示
描述一个观察位置时不用『前进 1.5 米再右转 20°』这类以相机为中心的动作序列(egocentric),而是直接指定场景中的绝对位置与朝向。本文定义为四元组 $v=(i,x,y,d)$:锚定图像编号 $i$、该图上的像素坐标 $(x,y)$、观察方向 $d$,一次查询即可锁定目标视角。
allocentric 单步视角查询是本文 NVG 与所有 egocentric 世界模型的本质区别,也是消融实验中准确率更高的关键原因,不理解它就无法理解方法的核心设计。
新视角合成(Novel View Synthesis)与图像编辑模型
给定场景观测与目标视角,生成从该视角看到的图像。FLUX.2-klein-9B 这类扩散图像编辑模型天然支持『参考图+指令→新图』,本文将其微调为新视角生成器 NVG:输入场景图像集与视角条件 $v$,输出 $I_{edit}=G(\mathcal{I},v)$。
NVG 是整个框架的『训练期空间模拟引擎』,轨迹合成和 RL 任务的数据都由它渲染产生,它的训练方式与数据构成直接决定监督信号的质量。
Chamfer 距离与点云几何
Chamfer 距离衡量两个点集的相似度:对每个点找另一集合中最近点的距离,双向取平均。本文用前馈三维重建模型 $F$ 从原图集得到点云 $\mathcal{M}_{orig}$,把渲染图加入后再重建得到 $\mathcal{M}_{aug}$,两者之间的 Chamfer 距离即 GeoP 指标,值越小说明渲染视图与原场景几何越一致。
GeoP 是贯穿全文的数据过滤闸门(SFT 阈值 $\theta$ 与 RL 阈值 $\theta_{RL}$),消融证明有过滤比无过滤平均高 0.6-1.5 分,不懂 Chamfer 距离就看不懂质量控制机制。
SFT 与 GRPO 强化学习
SFT(监督微调)用人工构造的完整推理轨迹训练模型模仿输出;GRPO 是一种组相对策略优化 RL 算法,对同一问题采样多个回答,以组内相对奖励更新策略,无需训练价值网络。本文先 SFT 教会『规划-想象-推理』结构,再用 GRPO 在可自动验证的视角选择题上强化视角条件化想象。
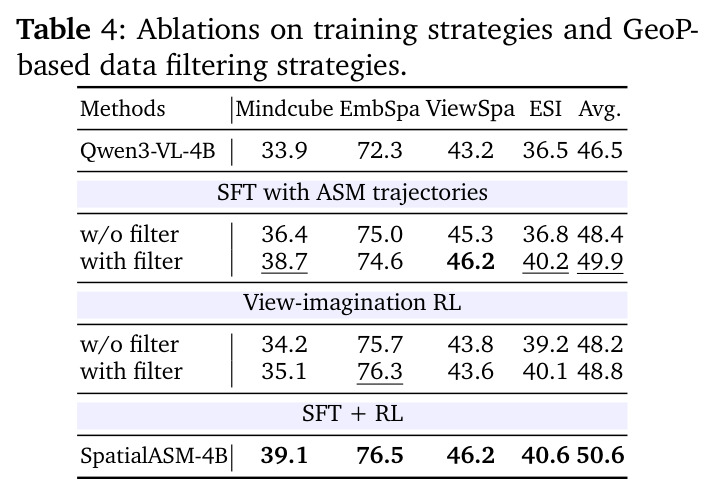
两阶段后训练是 SpatialASM 的训练骨架,消融表显示二者互补:SFT 擅长显式视角变换任务(MindCube +4.8),RL 强在感知型基准(EmbSpa),合起来最优。
思维链(CoT)监督
CoT 监督指训练数据中包含中间推理步骤而非只有最终答案,让模型学会『怎么想』而不只是『答案是什么』。开源空间数据集大多是 answer-only 的 QA 对,缺少示范如何选取信息视角、如何在脑中构建场景的轨迹,这是本文要填补的监督空白。
论文反复强调的核心论点是:空间推理瓶颈不在数据量而在 CoT 监督缺失,SpatialASM 的价值在于把 answer-only 数据自动升级为 ASM 轨迹。
研究动机
当前 LVLM 在需要视角变换、跨视图对应和推断未观测区域的空间任务上系统性失败。图 1 的例子中,问『以黑椅朝向为前,电脑在黑椅哪个方向』,Qwen3-VL-8B 只在单图内做平面相对位置判断答成 B,正确答案是 D,因为它无法关联第二张图的椅子位姿与第一张图的桌面布局。作者认为根源是缺失『主动空间心理想象』(ASM)——主动决定从哪个视角能获得有用证据,并在脑中构建该视角下的场景。现有补救各有硬伤:数据侧,HoliSpatial、VST 等大规模数据集由 3D 标注、视频或模拟器合成,但几乎全是 answer-only QA 对,没有示范如何选视角、如何想象的 CoT 轨迹,且 LVLM 自举这种监督不可靠,从零生成常产生错误视角规划和幻觉场景;工具侧,MindJourney、Think3D 等在推理时外挂世界模型补充观测,把空间推理绑死在外部模拟器上且增加开销,并普遍采用 egocentric 接口,每次查询需多步动作序列。ESI-Bench 亦表明被动观察远不如主动探索,但依赖物理交互的探索无法内化。
本文的目标是本文目标是在不修改模型架构、不在推理时依赖任何外部模拟器的前提下,把『视角规划 + 视角想象』这一联合能力内化为 LVLM 的自发推理行为。具体拆成三个可操作目标:其一,构建一个能用单次 allocentric 查询渲染任意视角的 NVG(新视角生成器),把假设视角锚定在真实视觉证据上;其二,把现成 answer-only 空间 QA 数据自动升级为显式 ASM 轨迹(规划-想象-推理三段式 CoT)用于 SFT,并用可自动验证的视角取替任务构造 RL 数据;其三,在保持通用视觉能力不退化的约束下(通用 VQA 变化控制在 0.6 分内),在七个空间基准、四种骨干上取得一致提升。最终模型只看原始输入图像,就要在推理文本中自发写出『我应该站在哪、朝哪看、会看到什么』。
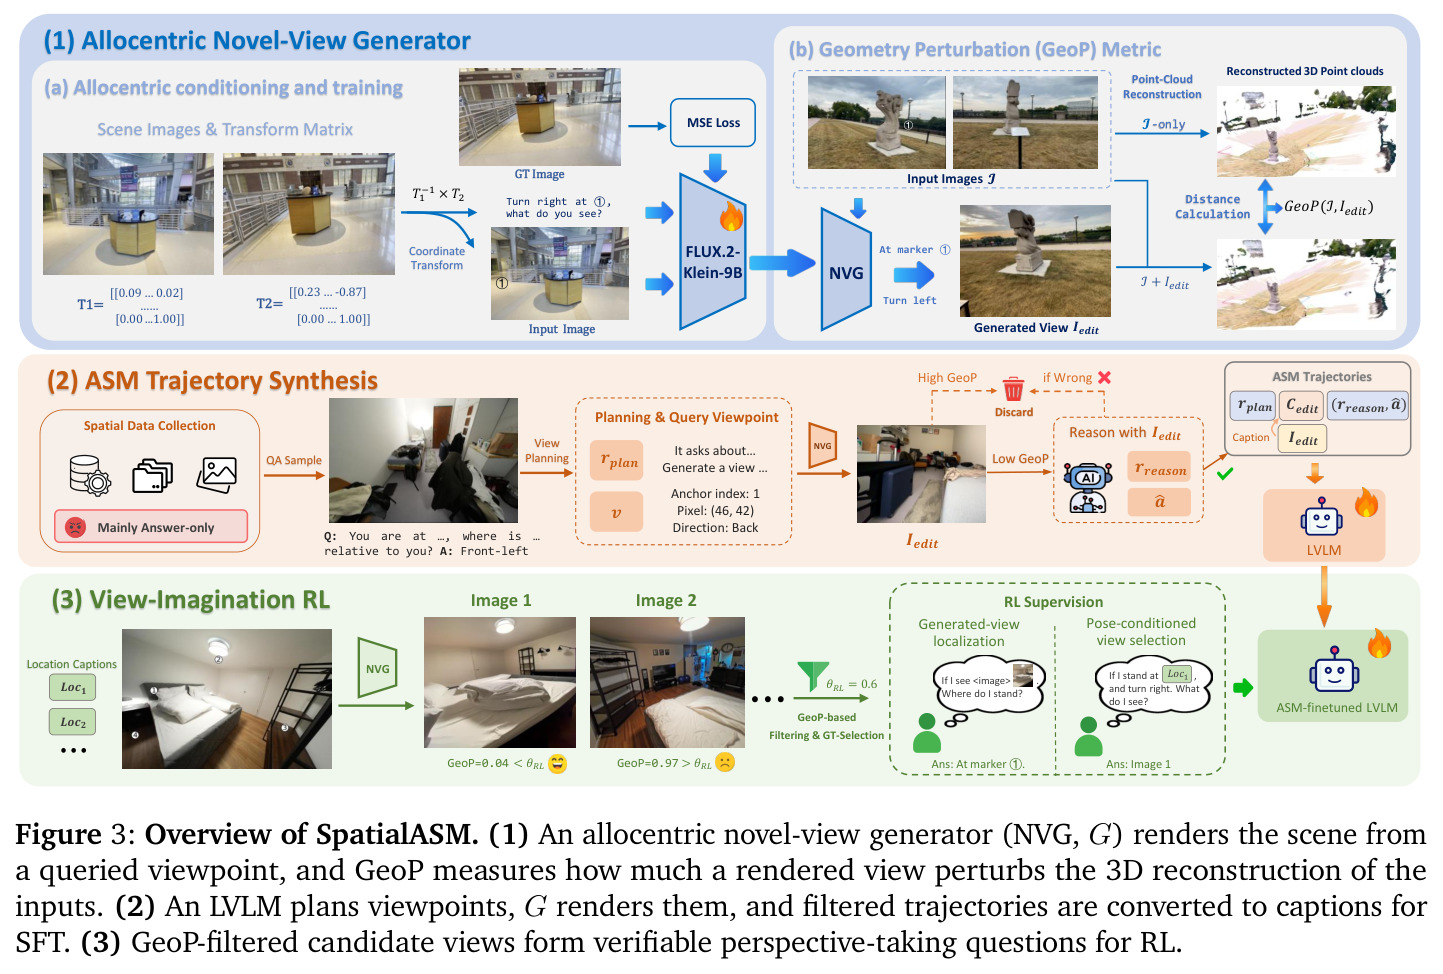
与已有工作不同的是,本文的独特切入是三个设计决策的组合。第一,训练期而非推理期用世界模型:World2VLM 等也只在训练时用世界模型,但蒸馏的是与问题无关的运动条件视图关联,没有推理轨迹;SpatialASM 蒸馏的是问题条件的视角规划 + 视角条件的想象,且写成显式文本轨迹,教模型『何时何地想象』而非『给定运动视图如何变』。第二,allocentric 单步视角接口:不做多步 egocentric 动作滚动,直接查询『在锚定图像某像素处朝某方向看』,视角位置还在原图上打标记,使原图与生成观测的空间对应关系对 LVLM 更易理解。第三,-caption 替换的脚手架设计:渲染图只在数据构造期存在,最终 SFT 数据里被描述 2D 布局的文本 caption 替换,逼模型学会『想象』观测而非『消费』观测图像,推理时无需调用 NVG。此外提出的 GeoP 几何扰动指标为渲染质量提供了可计算的代理过滤标准。
核心方法
SpatialASM 是三模块后训练框架,直觉是先借外部模拟器让模型学会换位思考,再撤掉模拟器使其内化。模块一训练 allocentric 新视角生成器 $G$:在 FLUX.2-klein-9B 图像编辑模型上,用 DL3DV 的 10k 场景构造 SpatialASM-edit140k 训练对——同场景两帧互为锚定图与真值观测,由相对相机位姿导出 $v=(i,x,y,d)$,$(x,y)$ 以视觉标记画在锚定图上、方向 $d$ 用文本提示,MSE 损失监督。模块二定义 GeoP 指标:用前馈重建模型 $F$ 分别从原图集 $\mathcal{I}$ 与加入渲染图的 $\mathcal{I}^+=\mathcal{I}\cup\{I_{edit}\}$ 重建点云,GeoP 即两片点云的双向 Chamfer 距离,渲染图若强迫重建几何大改则判为不一致。模块三据此产出两种监督:供 SFT 的『规划-想象-推理』显式轨迹,和自动可验证的视角取替选择题供 GRPO 强化学习,把 answer-only 空间 QA 升级为高质量空间 CoT 监督。
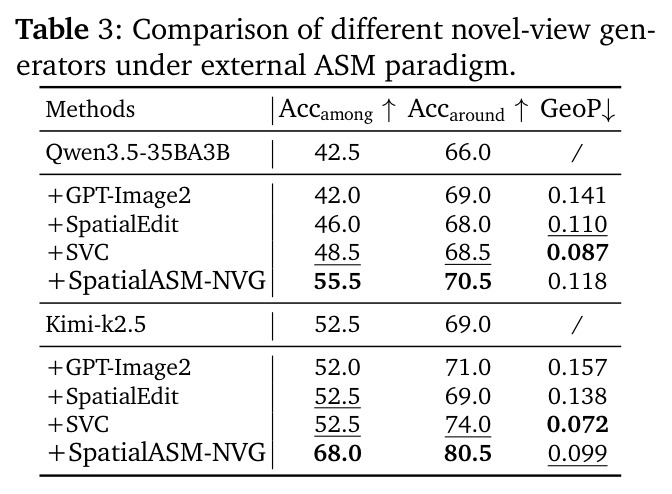
核心创新是『渲染即脚手架,监督全文本化』的内化机制。已有工作要么推理时调用世界模型(把想象外包、推理慢且依赖外部),要么蒸馏感知工具,要么如 World2VLM 蒸馏与问题无关的运动条件视图关联;SpatialASM 的 SFT 轨迹中,LVLM 规划的 $K$ 个视角渲染图只在构造期出现一次,随后被描述 2D 布局的 caption $C_{edit,k}=M_{cap}(I_{edit,k})$ 替换进最终数据,模型学到的是从原始图像出发在文本中重建空间布局,而非消费额外输入图像。第二个创新是 allocentric 单步视角 $v=(i,x,y,d)$:不做多步 egocentric 动作滚动,直接查询『在锚定图某像素处朝某方向看』并在原图打标记;消融显示即便 SVC 的 GeoP 更低(0.072 vs 0.099),SpatialASM-NVG 因跨图空间对应更易理解,Kimi-k2.5 骨干上 Among 准确率 68.0 对 52.5。第三,GeoP 把『渲染图是否与场景 3D 几何自洽』变成可自动计算的过滤闸门,替代对大视角变化失效的 PSNR/SSIM 类指标。
方法步骤详情
五步流程。① 微调:用 DL3DV 帧对训练出 NVG $G$。② 规划:对 HoliSpatial 等开源空间 QA,先让 LVLM $M$ 仅凭原图作答,答对即弃;答错的提示 $M$ 输出视角规划 $(r_{plan},\{v_k\})$。③ 渲染复答:$G$ 渲染各视角图 $I_{edit,k}$,交回 $M$ 二次作答得 $(r_{reason},\hat{a})$。④ 过滤替换:仅保留『原答错、见渲染图后答对、$\max_k GeoP<\theta$』的轨迹,渲染图换成 2D 布局 caption,得 SpatialASM-128k(实际用 HoliSpatial 子集 66k 做 SFT)。⑤ RL:锚定图上随机采 4 视角渲染候选,构造生成视图定位与姿态条件选图两类可验证选择题,以 $GeoP<\theta_{RL}$ 选真值,得 SpatialASM-RL-58k。配置:SFT 10 epoch、学习率 $5\times10^{-6}$;GRPO batch 128、学习率 $1\times10^{-6}$、300 步;4B/8B 全参微调,其余用 LoRA。
技术新颖性
技术新颖性体现在四点。一是范式定位:与推理时调用世界模型的 MindJourney、Think3D、Astra、AVIC 划清界限——那些方法即便训练模型决定『何时想象』,想象本身仍由外部模拟器在推理时完成;SpatialASM 的渲染只存在于训练期,推理是纯内生的。二是蒸馏内容:World2VLM 蒸馏运动条件的视图关联(轨迹与问题无关、无推理痕迹),VST-R 的分步轨迹教模型从给定证据推结论;SpatialASM 蒸馏的是问题条件的视角规划与视角条件的想象构成的完整 reasoning trajectory。三是 allocentric 接口本身:所有 egocentric 世界模型用带量化平移旋转的动作序列逐步逼近目标视角,本方法的单步查询加原图标记设计被消融证明更利于 LVLM 建立跨图对应。四是 GeoP:首个基于『加入渲染图是否扰动前馈 3D 重建』的渲染几何一致性代理指标,模型无关、无需参考视图,可同时用于 SFT 过滤、RL 真值选择和生成器横向对比。
实验结果
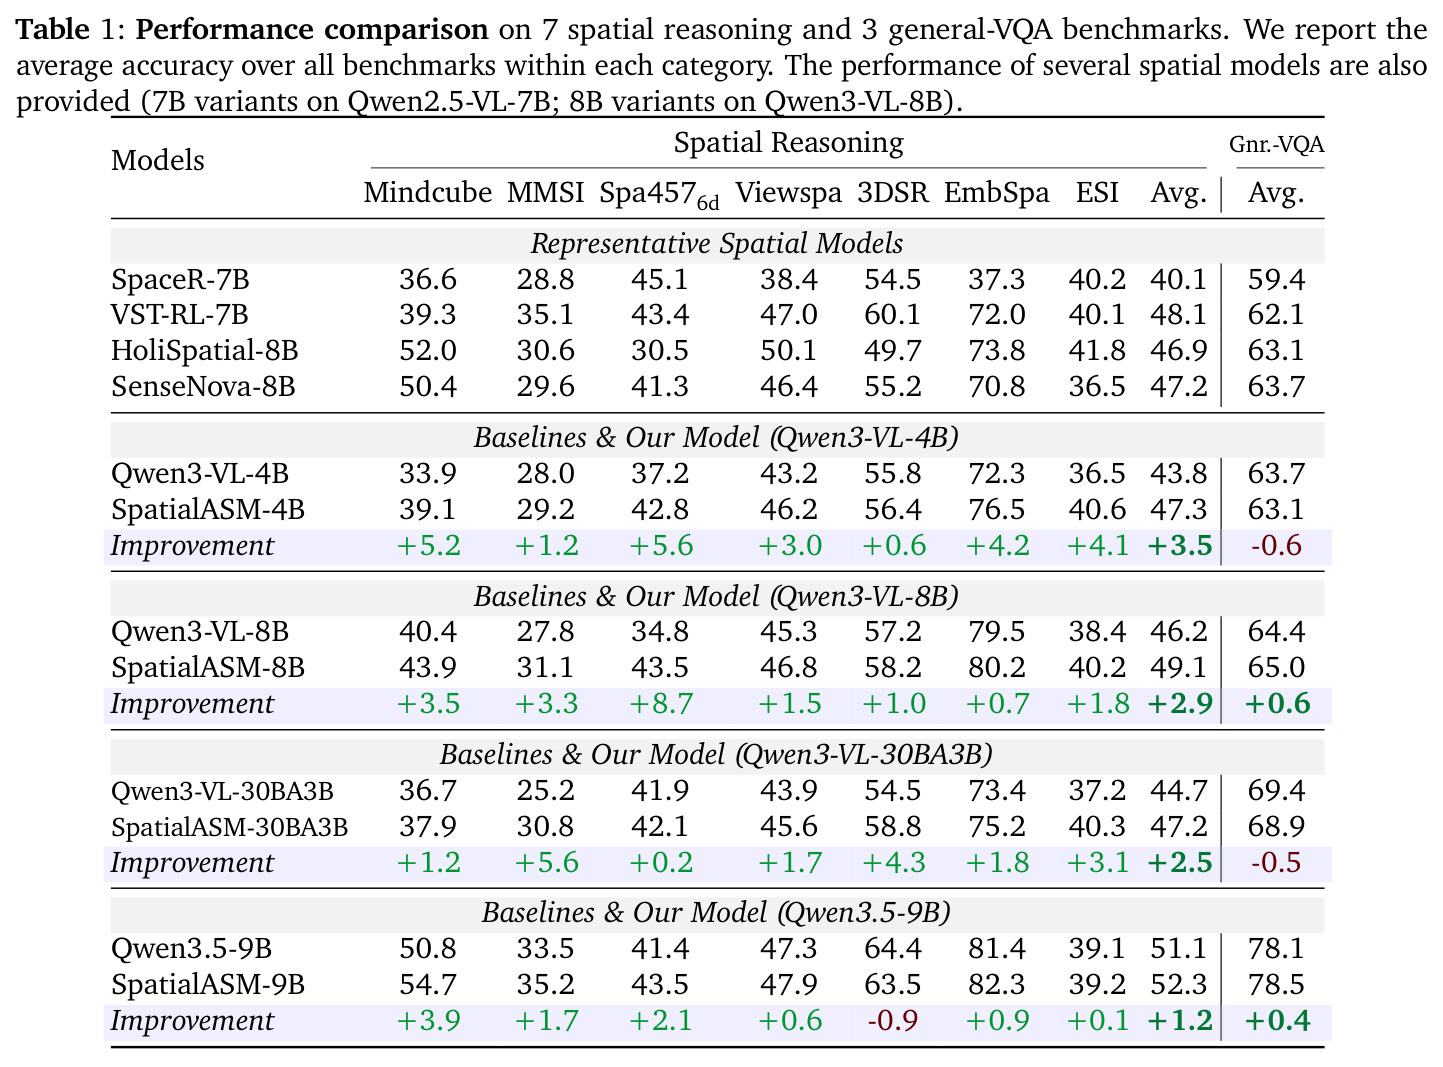
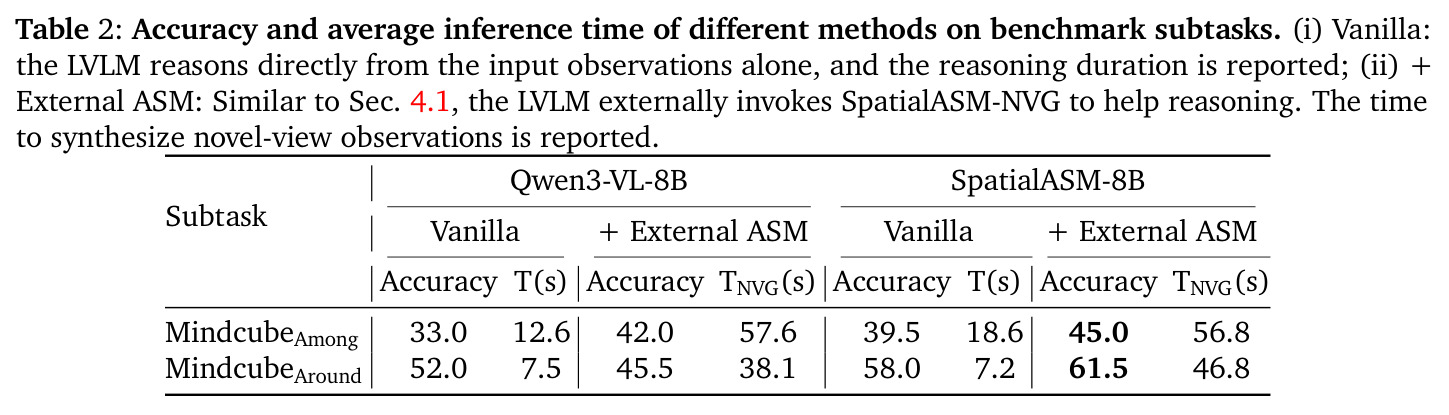
Table 1:四骨干 7 基准一致提升:4B 平均 43.8→47.3(+3.5),8B 46.2→49.1(+2.9,最大单项 Spa457-6d +8.7),MoE 30BA3B 44.7→47.2(+2.5,MMSI +5.6),Qwen3.5-9B 51.1→52.3(+1.2);通用 VQA 变化均在 ±0.6 内(8B 升至 65.0),超过 VST-RL-7B(48.1)等代表性空间模型。Table 2 显示内外互补:Around 上外置使基线 52.0 跌至 45.5,SpatialASM-8B 反从 58.0 升至最高 61.5;Among 上基线 33.0→42.0,SpatialASM-8B 39.5→45.0。Table 3:Kimi-k2.5 骨干上 SpatialASM-NVG 达 Among 68.0,GeoP 最低的 SVC 仅 52.5,几何一致性≠推理有用性。Table 4 消融(四基准平均):基线 46.5,SFT+过滤 49.9、RL+过滤 48.8、SFT+RL 达 50.6,SFT 强在显式视角变换、RL 强在感知型 EmbSpa。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 7 个空间基准平均(Qwen3-VL-4B) | 平均准确率 (%) | 47.3(SpatialASM-4B) | 43.8(Qwen3-VL-4B) | +3.5 |
| 7 个空间基准平均(Qwen3-VL-8B) | 平均准确率 (%) | 49.1(SpatialASM-8B) | 46.2(Qwen3-VL-8B) | +2.9 |
| Spatial457-6d 6D 推理(Qwen3-VL-8B) | 准确率 (%) | 43.5 | 34.8 | +8.7(全文最大单项增益) |
| MindCube(Qwen3-VL-4B) | 准确率 (%) | 39.1 | 33.9 | +5.2 |
| MMSI(Qwen3-VL-30BA3B) | 准确率 (%) | 30.8 | 25.2 | +5.6 |
| 3 个通用 VQA 平均(Qwen3-VL-8B) | 平均准确率 (%) | 65.0 | 64.4 | +0.6(四骨干变化均 ≤0.6) |
| 外置 ASM 协同(Mindcube-Among) | 准确率 (%) | 45.0(SpatialASM-8B + 外置 NVG) | 33.0(Qwen3-VL-8B vanilla) | +12.0 |
局限与改进
作者承认的局限:方法面向静态场景,未覆盖动态环境、具身交互与长时程三维推理;GeoP 是依赖重建模型 $F$ 的代理指标而非真值,阈值 $\theta$、$\theta_{RL}$ 预先设定。我的观察:其一,GeoP 低不代表视图对推理有用——Table 3 中 SVC 的 GeoP 最低(0.072)但准确率显著低于 SpatialASM-NVG,过滤只保证下限,视角规划智能仍完全来自 LVLM,规划差会产生大量被浪费的渲染;其二,caption 替换是有损压缩,$M_{cap}$ 只描述 2D 布局,精确度量几何(距离、角度)在文本化中丢失,这可能解释感知型 EmbSpa 增益偏小(8B 仅 +0.7);其三,过滤要求『原本答错、看过渲染答对』,先答对的样本被直接丢弃,数据利用率未报告;其四,外置 ASM 每次渲染需 38-57 秒,叠加外置仍有收益,但论文未分析内化的蒸馏上限;其五,四个骨干全来自 Qwen 家族,跨架构普适性未验证。
独立分析的弱点
第一,caption 瓶颈:视角想象被压成 2D 布局文字,几何精度不可控,可改用结构化场景图或少量可学习视觉 token 兼顾内化与保真。第二,GeoP 与下游有用性脱钩(SVC 反例),可学习一个以『答案是否被扭转』为弱标签的一致性评分器,或与答案一致性联合排序替代硬阈值。第三,过滤浪费算力:先答对即弃在简单子任务上浪费大量 NVG 渲染,可按题目难度动态分配渲染预算,并把『答对但规划更优』的样本纳入监督。第四,视角规划全靠提示的基线 $M$:Qwen3-VL-8B 随机规划都会掉分,规划弱则流水线上限受限,可用上一代 ASM 模型迭代自举做规划器。第五,RL 任务(定位/选图)是识别型而非生成推理型,与真实推理分布有差距,可引入以最终答案为奖励、以 GeoP 约束想象文本的过程奖励模型。第六,评估集中在静态室内基准,缺少人评或机器人闭环验证,想象质量对下游规划的价值未在具身设定下检验。
未来方向
作者明确提出的方向:内化其他形式的工具辅助推理(如深度估计、测量工具),把 ASM 扩展到动态真实场景、具身交互和更长时程的三维推理。基于本文成果可自然延伸的方向:其一,内化+外置联合推理的系统研究——Table 2 已证明二者互补(Among 45.0、Around 61.5 均为最高),值得训练一个元控制器学习何时调用外置模拟器;其二,把 allocentric 视角条件从静态 $(x,y,d)$ 扩展到时序场景,支持『想象 5 秒后从该视角看到什么』的视频空间心理模拟;其三,GeoP 可推广为通用『观测一致性』指标,用于过滤任何生成式世界模型的输出(视频预测、可驾驶区域合成等);其四,把 SpatialASM-RL-58k 式自动可验证任务构造法迁移到其他『内部模拟』能力,如物理直觉(想象物体倒下)与 affordance 推理;其五,与 3D 高斯/神经场结合,让想象从文本升级为可微的内部 3D 表示,弥合 caption 有损压缩的缺陷。
复现评估
复现条件较好但算力门槛不低。开源:代码位于 github.com/InternLM/SpatialASM;数据全部可自建——NVG 训练用公开 DL3DV(10k 场景带相机矩阵),轨迹源为公开 HoliSpatial、VST-500k、Mindcube-train,RL 数据由 NVG 自动生成无需标注。算力:需微调 FLUX.2-klein-9B 作 NVG;骨干中 4B/8B 全参 SFT 10 epoch 加 GRPO 300 步(batch 128),30BA3B 与 Qwen3.5-9B 用 LoRA rank=32,估计需多卡 A100/H100 集群,NVG 训练与轨迹渲染(每样本 $K$ 次渲染加 GeoP 两次 3D 重建)是隐性大头。难度:组件皆标准技术(图像编辑微调、前馈重建、SFT、GRPO),难点在视角位姿数据构造精度与过滤阈值调参($\theta$、$\theta_{RL}$ 未给具体数值,需自行标定);评估依赖 VLMEvalKit(ESI-Bench 用 passive-single 设定),附录 B/C 提供数据与训练细节,整体难度中等偏上。
论文图表
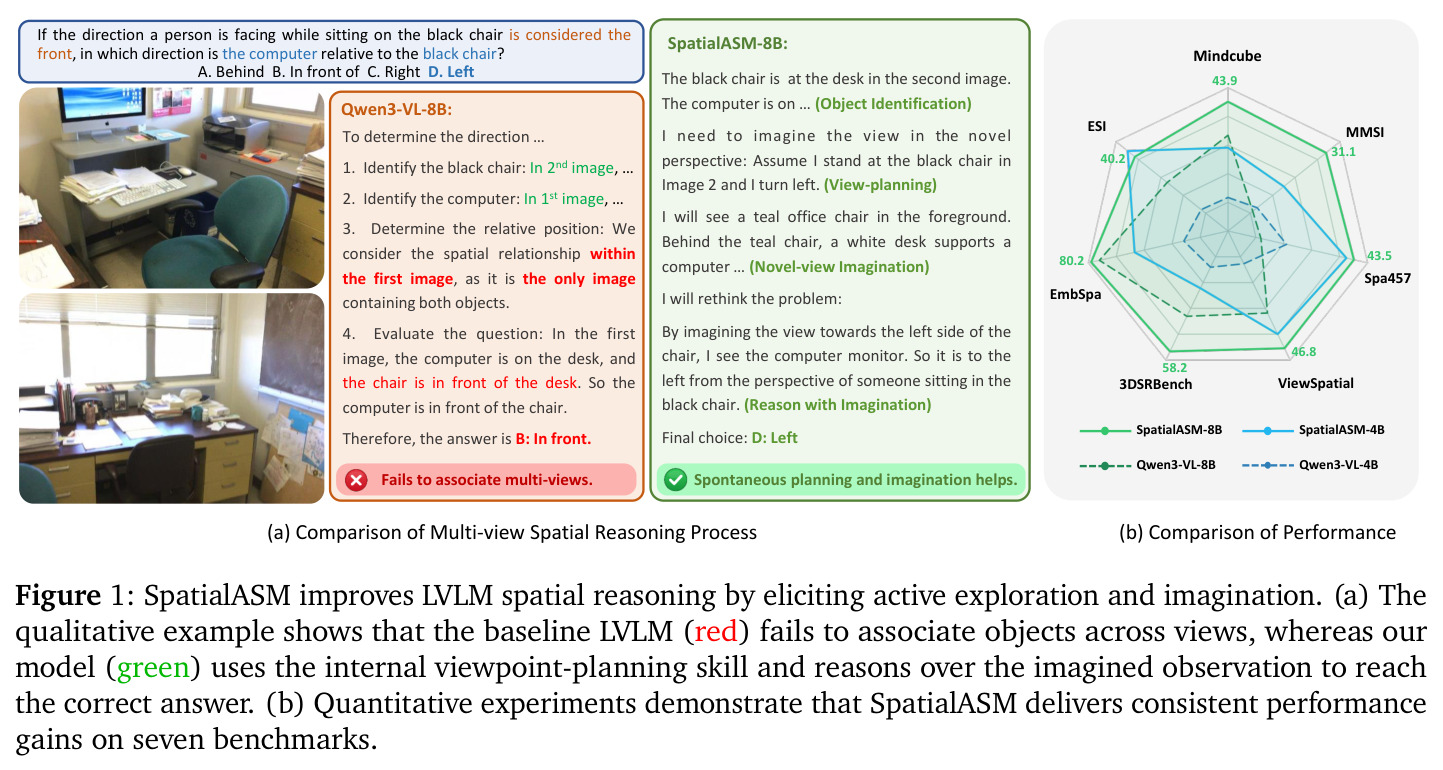
左半是定性对比:多视图问题(以黑椅朝向为前,判断电脑方位)中,基线 Qwen3-VL-8B(红色)在第 2 图识别物体、在第 1 图做平面相对位置判断,因无法跨视图关联椅子位姿而答错(B);SpatialASM-8B(绿色)自发写出『假设我站在黑椅处向左转,会看到前景是青色办公椅、其后白色桌子支撑着电脑』的想象文本,答对(D)。右半是雷达/柱状对比图,标注 8B 模型在 Mindcube 43.9 vs 40.2、MMSI 31.1 vs 27.8、Spa457 80.2 vs 79.5、3DSRBench 58.2 vs 57.2、ViewSpatial 46.8 vs 45.3 等数字,展示 SpatialASM-8B/4B 相对 Qwen3-VL-8B/4B 在七个基准上的全面领先。
这张图同时给出论文的问题(基线不会跨视图联想)与解法(自发的规划-想象-推理 CoT 文本),配合量化增益,是向读者第一眼建立『主动想象有效』直觉的最佳材料。
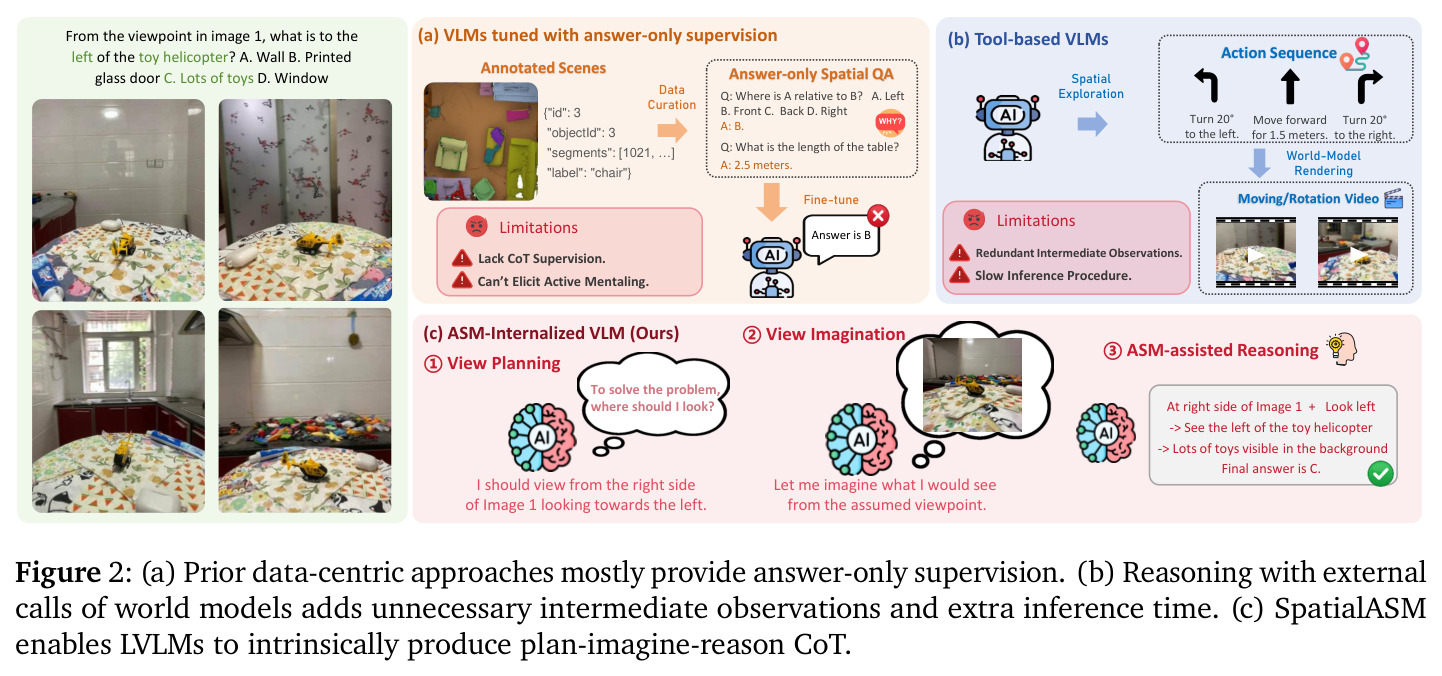
三栏范式对比图。(a) 数据中心路线:从标注场景策划 answer-only 空间 QA 微调,局限是缺 CoT 监督、无法激发主动心理想象;(b) 工具路线:LVLM 生成『左转 20°、前进 1.5 米』式的动作序列调用世界模型渲染中间观测,局限是冗余中间观测与慢推理;(c) 本文路线:模型先做视角规划(『我该从图像 1 右侧朝左看』),再文本想象该视角观测(『能看到玩具直升机左边有很多玩具』),最后推理出答案 C,全程内生、无外部调用。
该图把 SpatialASM 放在两条已有技术路线的坐标系中,清晰呈现『内化 vs 外挂』『规划-想象-推理 vs 动作序列』的差异,是理解论文定位与贡献声明的关键。
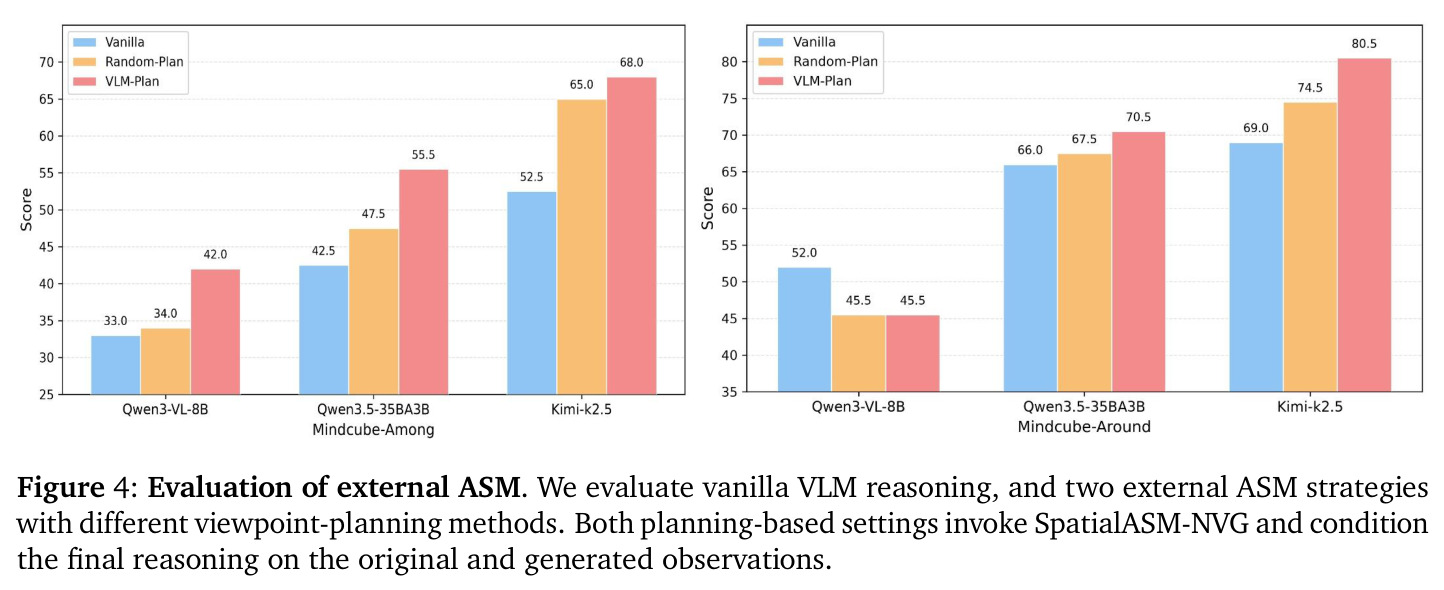
内化前的先行实验:对比三种推理设置——Vanilla(仅凭原始观测直接推理)、Random-Plan(随机选视角交给 SpatialASM-NVG 渲染)、VLM-Plan(LVLM 显式规划问题相关视角后再渲染),所有规划式设置都在原始+生成观测上联合推理。结果显示规划式外置 ASM 总体优于 vanilla,且 VLM-Plan 一致地不低于甚至优于 Random-Plan,说明现有 LVLM 已具备在显式提示下识别信息视角的潜在能力。
它为『内化』提供动机证据:能力存在但不会自发激活(vanilla 时模型不规划视角),这直接支撑了『ASM 尚未成为 LVLM 内在能力、需要训练内化』的核心论点。