SpatialSpeak:面向空间思维链推理的局部与全局上下文问答式重建 SpatialSpeak: QA-Native Reconstruction with Local and Global Context for Spatial Chain-of-Thought Reasoning
用问答式重建预训练与带视觉补偿的空间思维链微调,让VLM显式用几何推理解答空间问题
前置知识
视觉语言模型(VLM/MLLM)
以大语言模型为核心、接收图像或视频 token 与文本指令并自回归生成回答的多模态模型。典型结构是视觉编码器把每帧图像切成 patch token,经 MLP 投影对齐到 LLM 隐藏维度,再与问题 token 拼接输入解码器。本文基线为 VG-LLM 风格架构,骨干是 Qwen3-VL-4B,训练时仅微调 LLM 参数,视觉编码器、几何编码器与投影层全部冻结。
全文的方法载体就是 VLM,理解其特征编码、token 融合方式以及只微调 LLM 的训练设定,是读懂两阶段训练流程和消融实验的前提。
多视图3D重建与点图(pointmap)
从无相机位姿的多张图像同时恢复场景几何与相机轨迹的任务。点图把每个像素映射为三维坐标,DUSt3R、MASt3R、CUT3R、VGGT、MapAnything 等前馈模型可一次前向直接预测。评测常用 Acc./Comp. 误差(单位 cm),并区分无对齐与 GT Sim(3) 对齐两种协议,对齐后误差通常大幅缩小。
Stage I 的重建预训练效果和表5的重建评测都围绕点图误差展开,分清两种对齐协议才能正确解读 8.9cm 与 5.0cm 这两组数字的含义。
VGGT(Visual Geometry Grounded Transformer)
一个冻结即可用的多视图几何基础模型,能联合处理 N 帧图像,输出 3D 感知特征、相机位姿、深度等属性。本文中它与视觉编码器并行工作,其几何特征被融合进视觉 token,为 LLM 提供几何先验;整个训练过程它保持冻结,只作为外部几何提供者。
它是基线和 SpatialSpeak 共用的几何来源。论文的关键区分在于:注入 VGGT 特征只是给了几何先验,而 QA-RP 是通过文本监督教会模型主动表达和使用几何,理解这一点才能抓住本文卖点。
空间思维链(Spatial Chain-of-Thought)
让模型在给出最终答案前显式输出中间推理步骤,本文特指几何版本:先列出与问题相关物体的 3D 中心与尺寸估计,再做任务特定演算(例如扣除物体近似半径求最近点距离),最后输出答案。SpatialSpeak 进一步在链条末尾附加可靠性 token(HIGH/LOW),几何不可靠时回退到视觉观察修正答案。
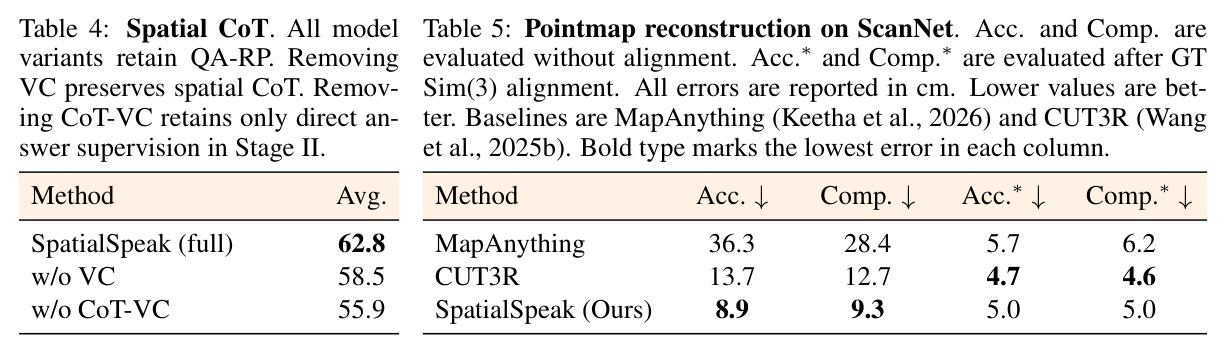
Stage II 的全部贡献就是把这条推理轨迹本身变成监督信号。不理解 CoT 模板的构成,就无法理解消融表中 CoT-VC 带来 6.9 分、其中视觉补偿贡献 4.3 分这些核心结论。
VSI-Bench 与 ReVSI 基准
两个室内视频空间智能评测基准,任务类别包括物体计数、绝对距离、物体尺寸、房间尺寸、相对距离、相对方向、路线规划以及(VSI-Bench 独有的)顺序逼近,数值题与多选题混合计分。ReVSI 是对 VSI-Bench 的修正版,修复了标注错误并降低了答案分布偏差,本文所有消融实验都在 ReVSI 上进行。
论文所有主表与消融表都基于这两个基准的七/八类任务平均分,只有熟悉类别划分和计分方式,才能看懂 62.8、63.3、73.0 这些数字之间的对比关系。
下一词预测(next-token prediction)
自回归语言模型的标准训练目标:给定前文最大化下一个 token 的概率,等价于负对数似然损失 $\mathcal{L}=-\sum_i \log p(y_i|\cdot)$。本文的特别之处是连 3D 坐标、物体类别与中心列表这类几何目标也全部序列化成文本,用这同一个损失训练,全程不引入任何辅助 3D 回归头或几何损失。
论文标题中的 QA-Native 核心主张就建立在所有任务共享这一自回归接口之上,这是理解方法新颖性以及为什么几何学习能直接服务后续推理的钥匙。
研究动机
现有多视图 VLM 的主流做法是把预训练重建模型的特征注入语言模型:VG-LLM 直接把几何 token 加到视觉 token 上,Spatial-MLLM 采用语义与几何双编码器,VLM-3R 用交叉注意力让视觉表示查询几何 token,GeoThinker 做多级选择性融合;G2VLM、Omni-View 则进一步加入重建或生成训练目标。然而这些方法训练空间问答时几乎都采用""只监督最终答案""的方式:中间的几何估计(物体 3D 中心、尺寸、距离)以及如何用它们推出答案,完全没有直接的梯度信号。这对量化类问题尤其致命——本文基线(特征融合+纯答案监督)在 ReVSI 上平均仅 52.4 分,其中物体计数只有 36.3,远低于其他类别。答案级监督让推理过程保持隐式:模型既不会显式表达与问题相关的几何量,也学不会可靠的几何演算,而可靠的量化空间回答恰恰同时依赖准确的几何估计与恰当的几何推理。
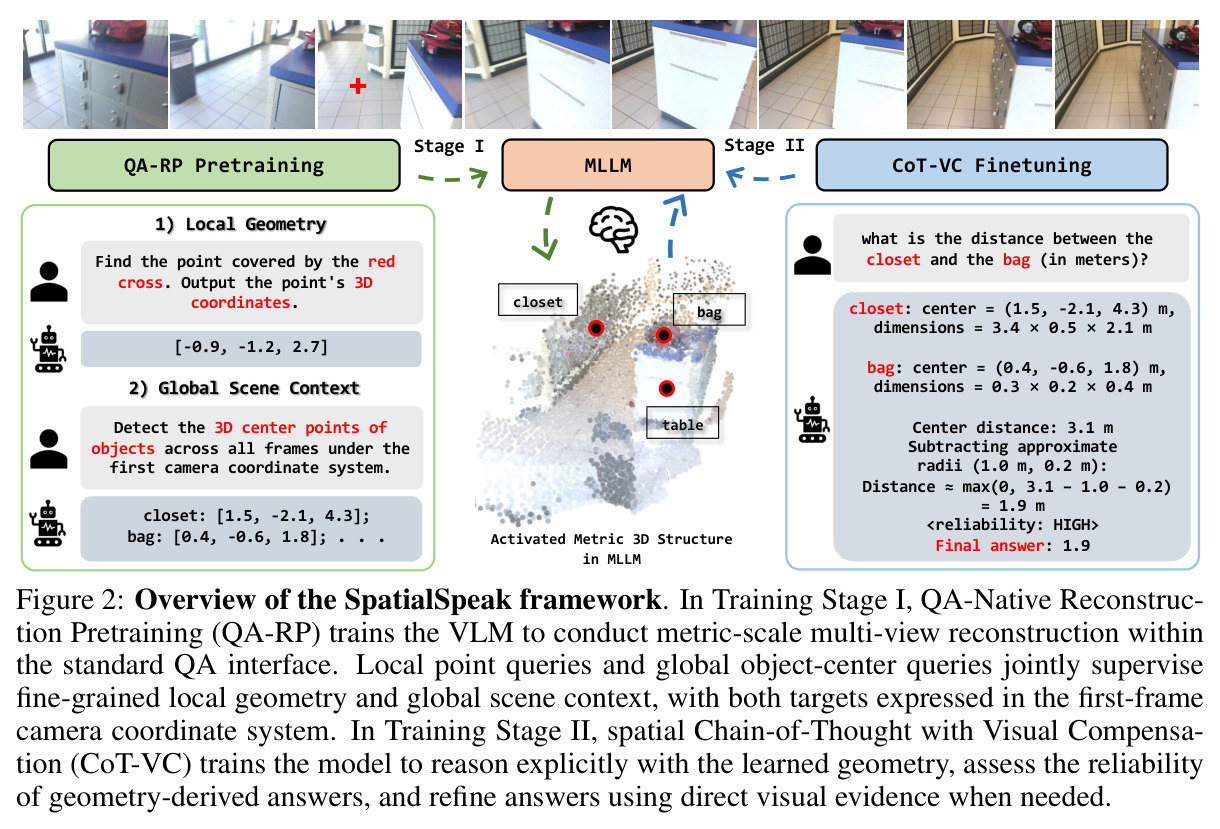
本文的目标是本文的目标是构建一个""先重建、后推理""的两阶段学习框架 SpatialSpeak,让 VLM 在同一自回归接口内打通从度量级多视图重建到显式空间推理的链路。具体包括:Stage I 提出 QA 原生重建预训练(QA-RP),把带标记点的局部 3D 定位与全局物体中心枚举统一为文本问答,用标准下一词预测损失联合训练局部几何与全局场景上下文;Stage II 提出带视觉补偿的空间思维链微调(CoT-VC),显式监督与问题相关的几何估计表达、任务特定的答案推导、可靠性评估,以及在几何不可靠时用直接视觉证据修正答案。最终目标是以 4B 规模模型在 ReVSI、VSI-Bench、SPAR-Bench 三个基准上全面超越现有最强方法,并验证核心假设:重建预训练能放大思维链监督的收益(CoT-VC 增益从 2.6 分升至 6.9 分)。
与已有工作不同的是,本文的独特切入有两点。其一,重建本身被写成 QA:不同于以往通过辅助 3D 回归头(GAP-MLLM、G2VLM 的专用预测头)或特征融合/蒸馏(3DRS、Spatial Forcing、SpatialStack 的多层几何特征堆叠)注入几何,QA-RP 把几何预测完全表述为文本问答目标,无需任何辅助损失头,几何学习与后续空间推理共享同一个 next-token 预测接口,天然对齐。其二,首次显式监督""几何估计→演算→可靠性判断→必要时视觉补偿""的完整推理轨迹:CoT-VC 不仅要求模型给出中间几何量,还训练它在推导不可靠时承认局限并回退到视觉观察,这是答案级监督和纯特征注入范式都不覆盖的监督信号。作者还用消融证明两阶段存在协同效应:QA-RP 把 CoT-VC 的增益从 2.6 分放大到 6.9 分,说明""先有几何基础、再学显式推理""的次序本身就有价值。
核心方法
直觉上,空间思维链要发挥作用,模型必须先会做度量级重建,再学如何用几何解题。技术路线上,基线采用 VG-LLM 架构:Qwen3-VL-4B 骨干,每帧 RGB 经视觉编码器得到 patch token,冻结的 VGGT 几何编码器并行提取 3D 感知特征并与视觉 token 融合,经 MLP 投影进 LLM,仅微调 LLM 参数。Stage I(QA-RP)在 ScanNet 上用两类文本 QA 联合训练:局部任务在帧中用红叉标记 2D 点并要求输出其 3D 坐标,全局任务要求枚举所有帧可见物体的语义类别与 3D 中心,两者统一到第一帧相机坐标系,训练 1 个 epoch、全局 batch 32、峰值学习率 $5\times10^{-6}$。Stage II(CoT-VC)从 Stage I 权重出发,在四类确定性生成器构造的空间 CoT 数据上微调 1 个 epoch、全局 batch 64、峰值学习率 $1\times10^{-5}$,并混入 LLaVA-Hound 与 SPAR-7M 数据。所有阶段每个视频采样 32 帧。
核心创新是""QA 原生重建预训练 + 带视觉补偿的空间思维链""这对组合,与已有方法的本质区别有两处。第一,几何学习不再依赖辅助回归头或特征级注入,而是以纯文本 QA 目标进入与推理完全相同的自回归输出接口;且局部与全局互补——局部点查询把标记图像点锚定到 3D,提供细粒度几何监督,全局物体中心查询枚举可见物体的类别与 3D 中心,提供场景级布局监督,两者共享第一帧坐标系。第二,推理监督不再只给最终答案,而是显式给出问题相关的几何估计与任务特定演算步骤,并附加可靠性 token([HIGH]/[LOW]):几何推导可靠时直接采用 3D 推导答案,不可靠时声明局限、调用视觉检查并输出修正答案。这种可靠性条件化的视觉补偿让模型学会评估自身几何估计的质量并知道何时该改用视觉证据,是此前答案级监督或特征注入方法完全没有的监督信号。
方法步骤详情
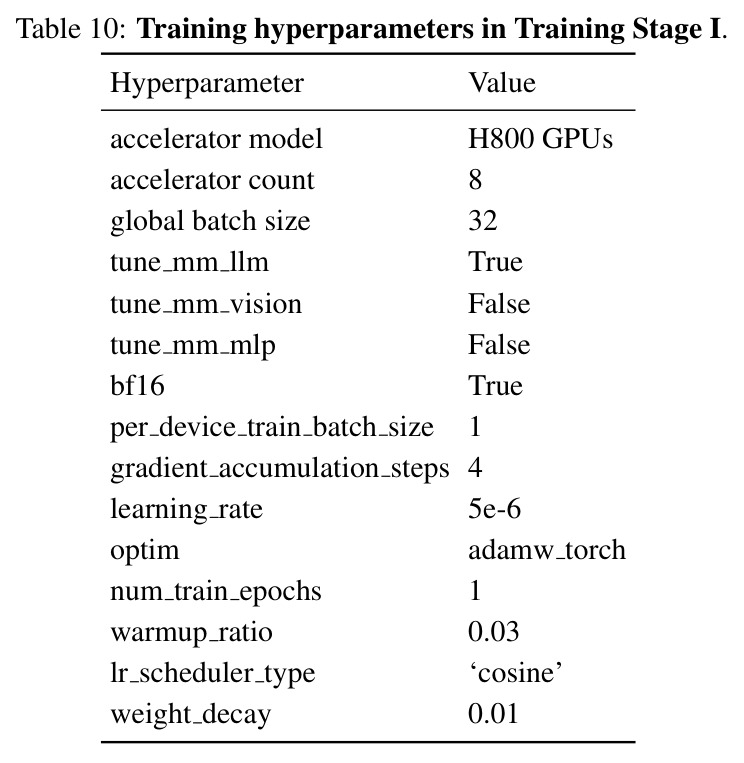
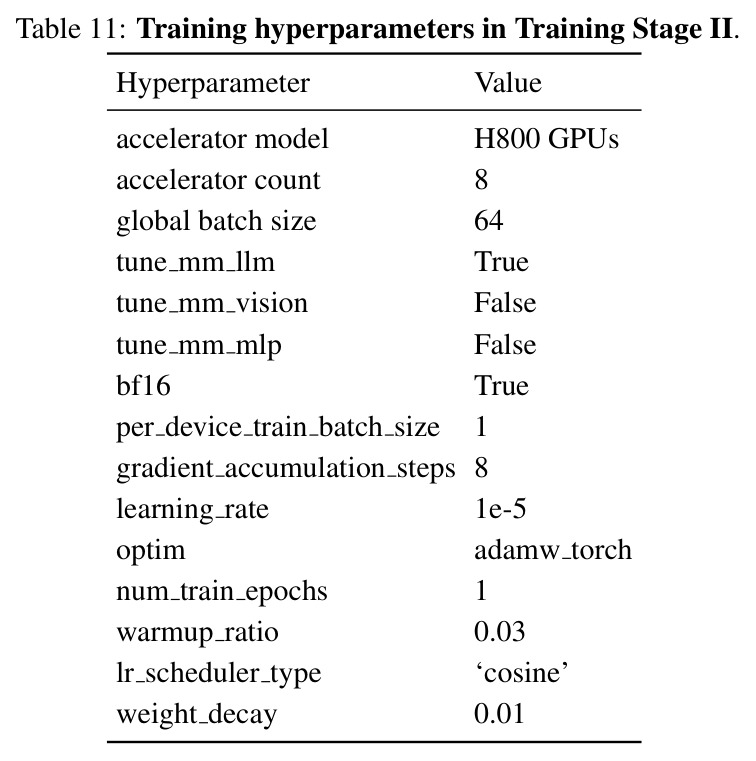
(1)特征编码:$N{=}32$ 帧各经视觉编码器得 token,冻结的 VGGT 联合提取 3D 特征并融合,MLP 投影后与问题 token 拼接,LLM 自回归生成回答。(2)Stage I 局部任务:在第 $i$ 帧标记 2D 点,提问""输出红叉覆盖点的 3D 坐标"",真值由 ScanNet 深度与外参变换到第一帧坐标系:$p^{(1)}=R_{i\to1}\,p^{(i)}+t_{i\to1}$。(3)Stage I 全局任务:枚举所有帧可见物体的语义类别与 3D 中心,按首次出现帧及帧内空间位置排序以保证输出确定。(4)联合训练:$\mathcal{L}_{Stage\,I}$ 为局部与全局两数据集上下一词预测期望之和,无辅助 3D 损失。(5)Stage II CoT 构造:距离题用 $d_{cp}=\max(0,\|\mathbf{c}^{(1)}_1-\mathbf{c}^{(1)}_2\|_2-r_1-r_2)$($r_k$ 为 AABB 平均半边长);尺寸题取最长边换算厘米;计数题要求等于真值;最近物体题对每选项算 $d_{cp}$ 取最近;估计与真值相对误差 $\le\tau{=}0.3$ 标 HIGH,否则 LOW。(6)CoT 模板:$y_{CoT}=C_{3D}\oplus[\text{HIGH}]\oplus\hat{a}$,不可靠时 $C_{3D}\oplus[\text{LOW}]\oplus\mathcal{V}\oplus a^\star$,$\mathcal{V}$ 为视觉修正说明。(7)未覆盖题型保留直接答案监督;超参见原文表10/11(8×H800,bf16,AdamW,cosine,warmup 0.03)。
技术新颖性
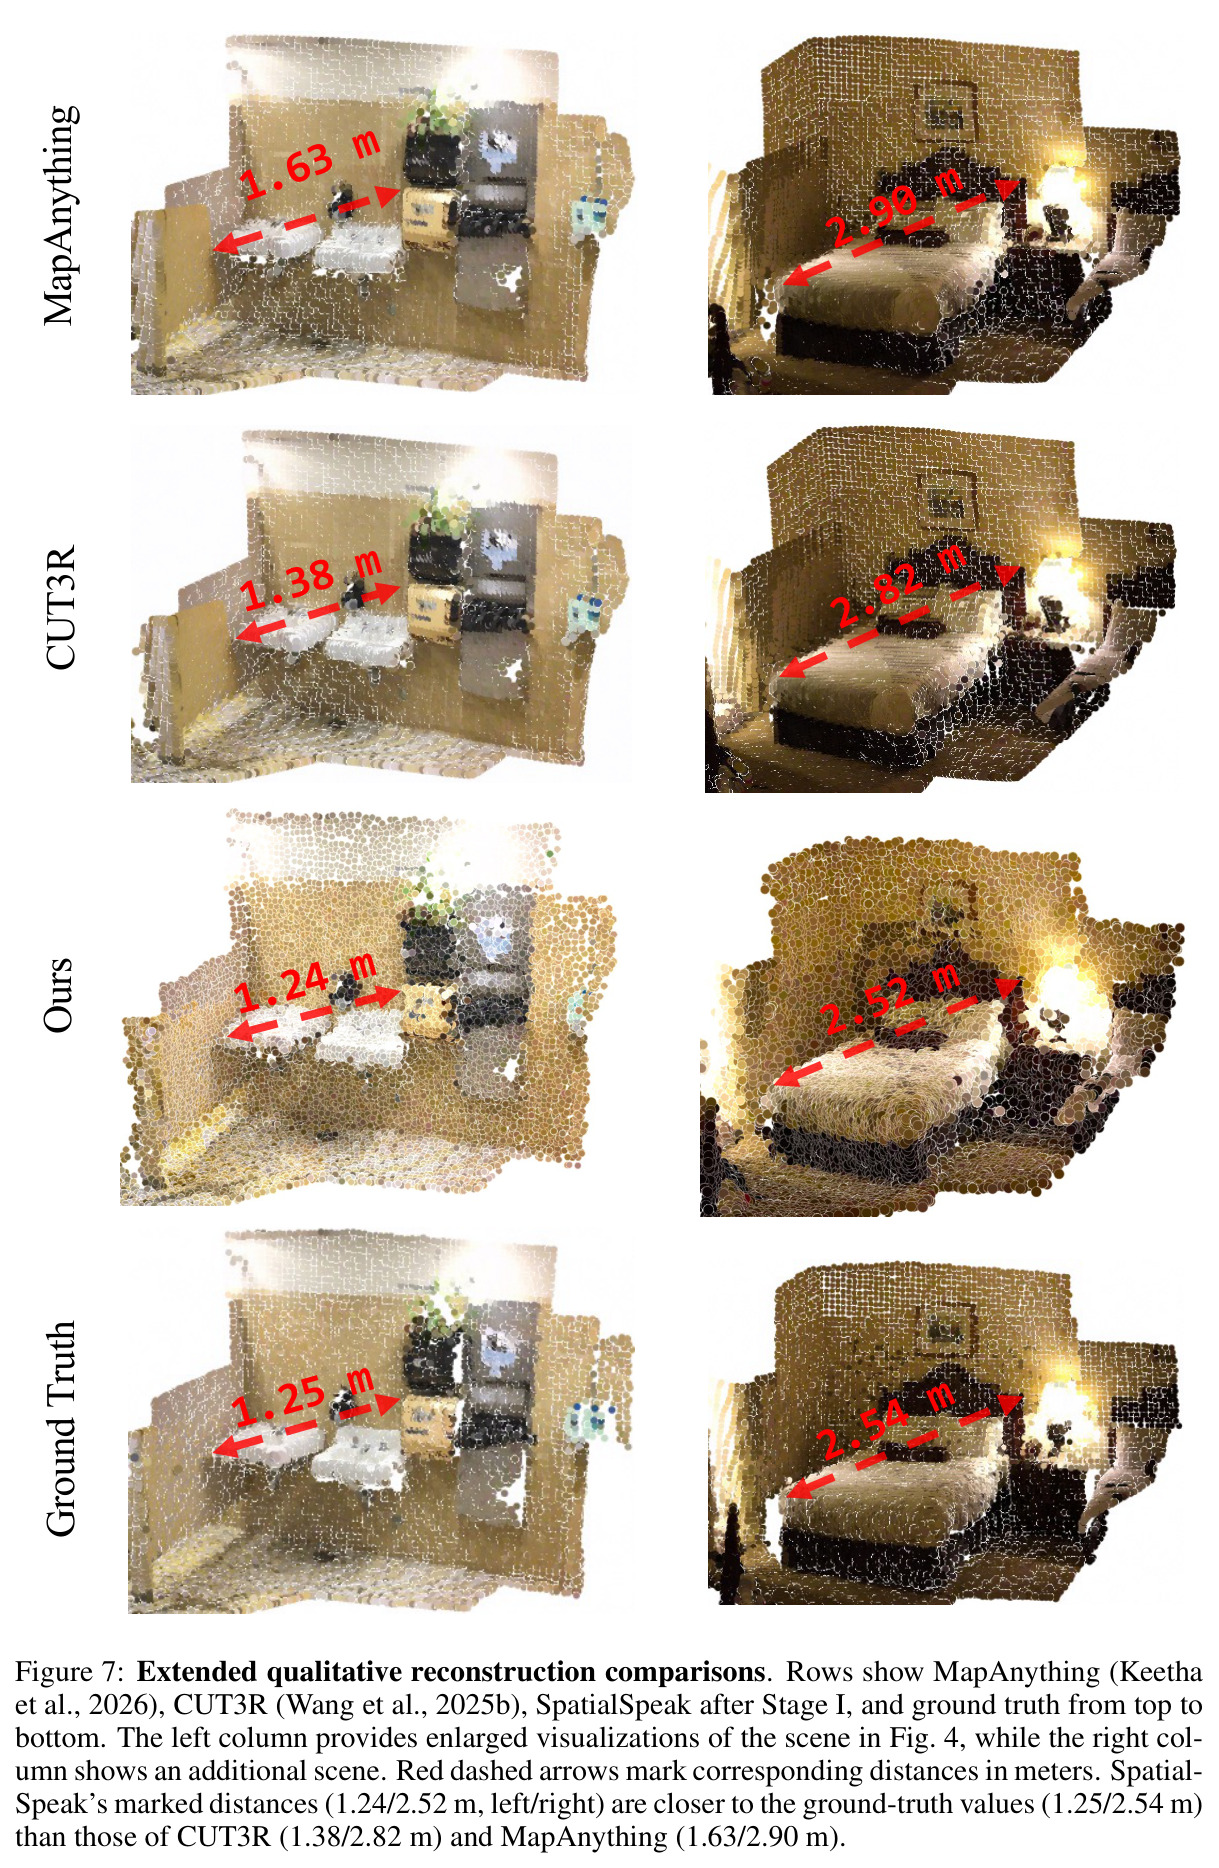
技术新颖性体现在三个层面。第一,QA 原生范式:几何预测被彻底文本化,避免了多任务学习中回归头与语言头的接口冲突,让重建能力以""会说话的几何""形式沉淀在 LLM 权重里——这解释了为什么 Stage I 后的模型在 ScanNet 未对齐点图评测中以 8.9/9.3cm 超越专用重建模型 CUT3R(13.7/12.7cm)与 MapAnything(36.3/28.4cm),尽管它本质上是个语言模型。第二,确定性全局枚举:物体按首次出现与帧内空间位置排序,把集合预测问题转化为顺序可学的序列生成问题,稳定了计数与空间布局的学习。第三,可靠性条件化的视觉补偿:用相对误差阈值 $\tau$ 自动构造 [HIGH]/[LOW] 标签,训练模型表达置信并在必要时回退视觉证据,消融显示 VC 在纯空间 CoT(58.5 分)基础上再带来 4.3 分提升。三个新颖点共同支撑了论文的核心主张:重建预训练与思维链监督不是简单叠加,而是协同放大(增益 2.6→6.9 分)。
实验结果
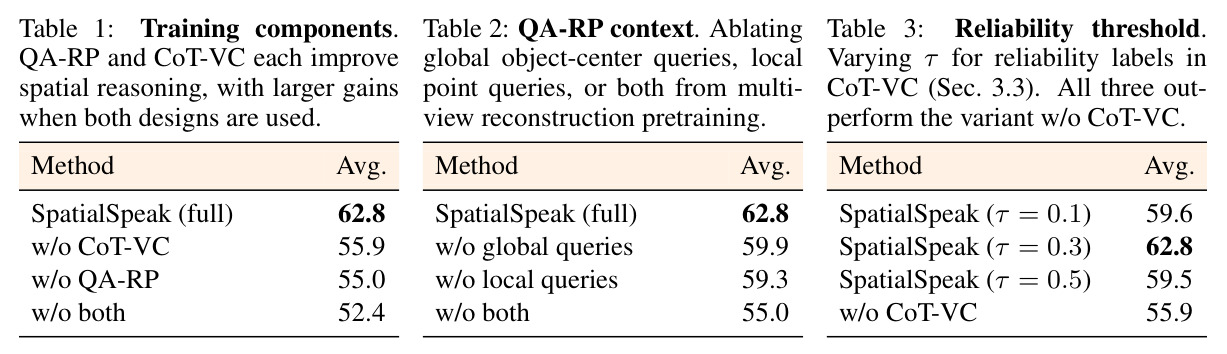
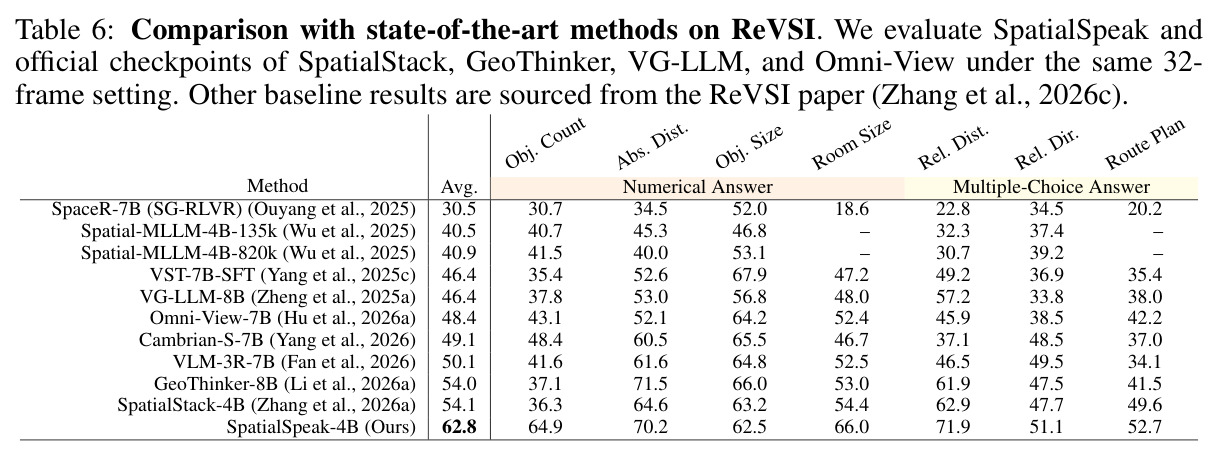
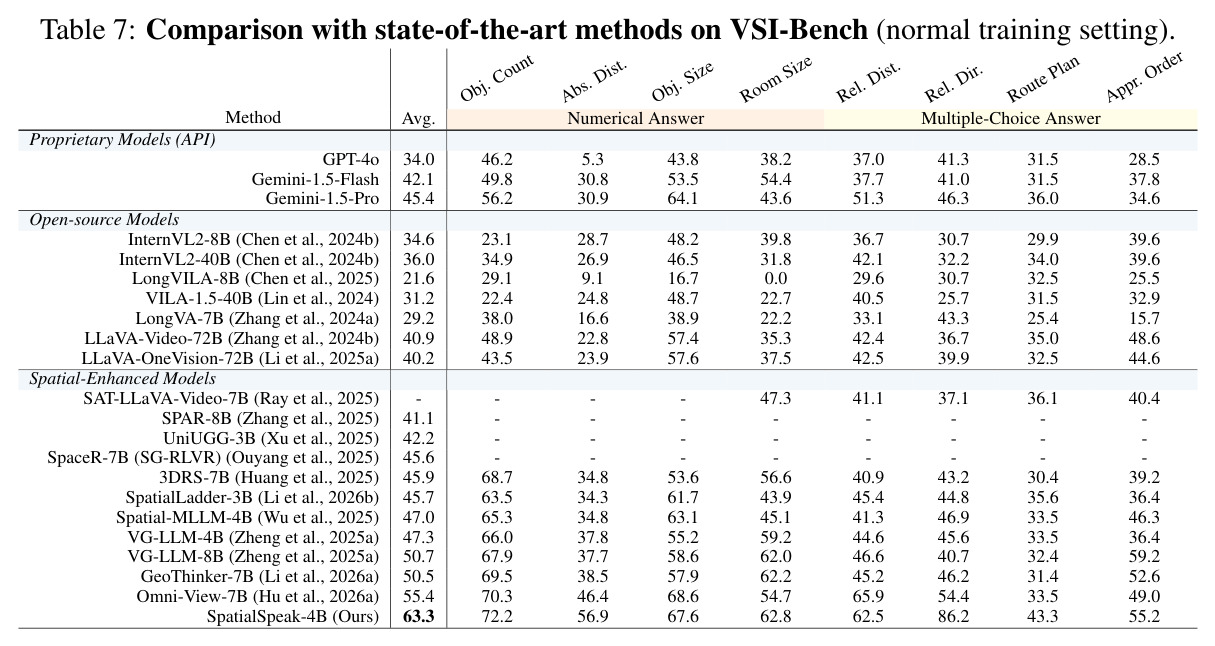
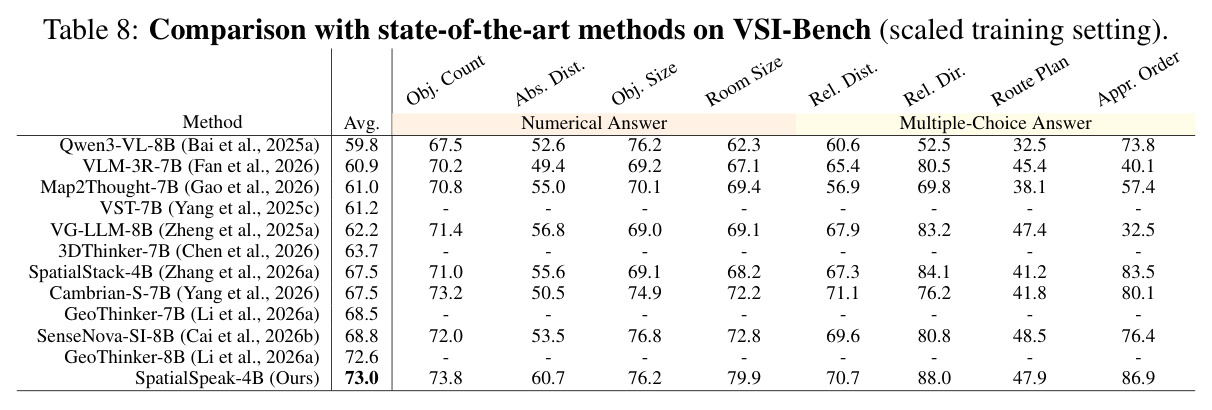
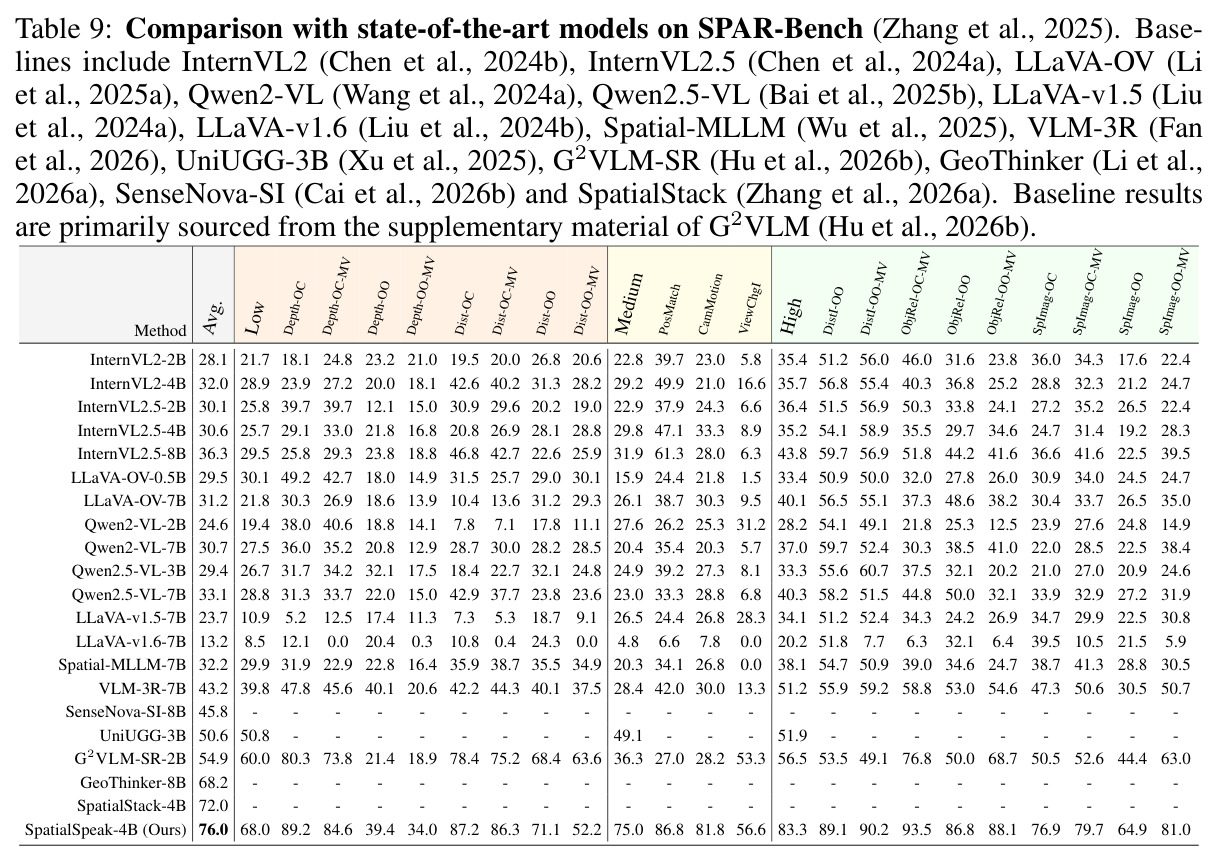
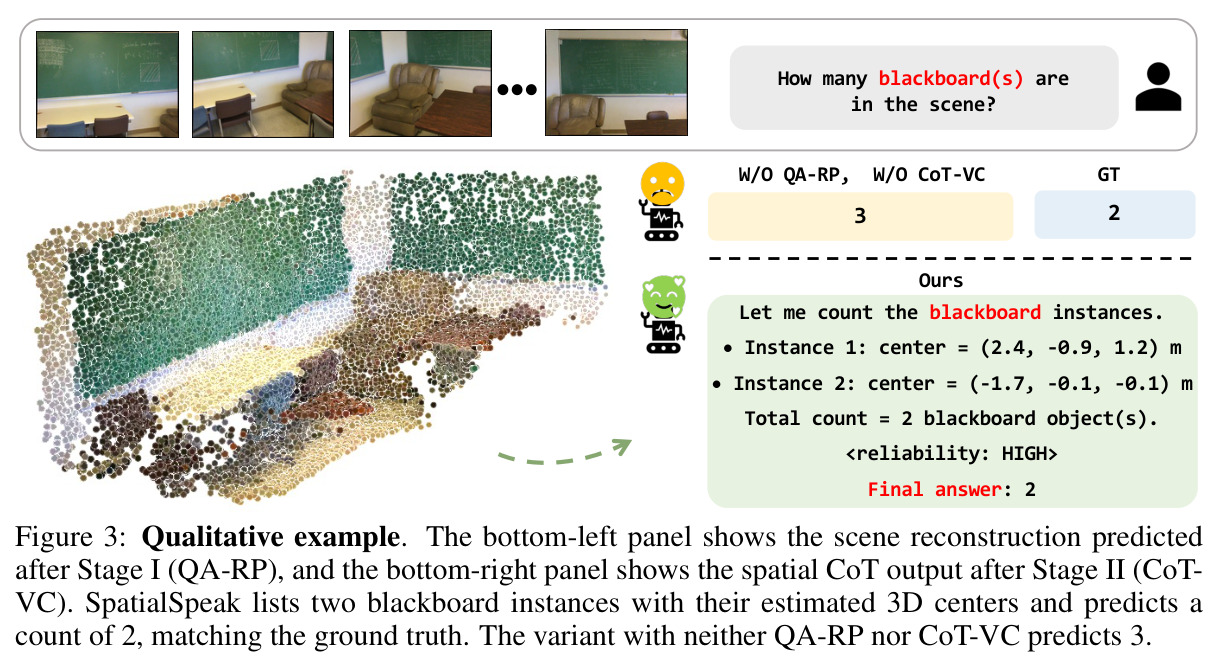
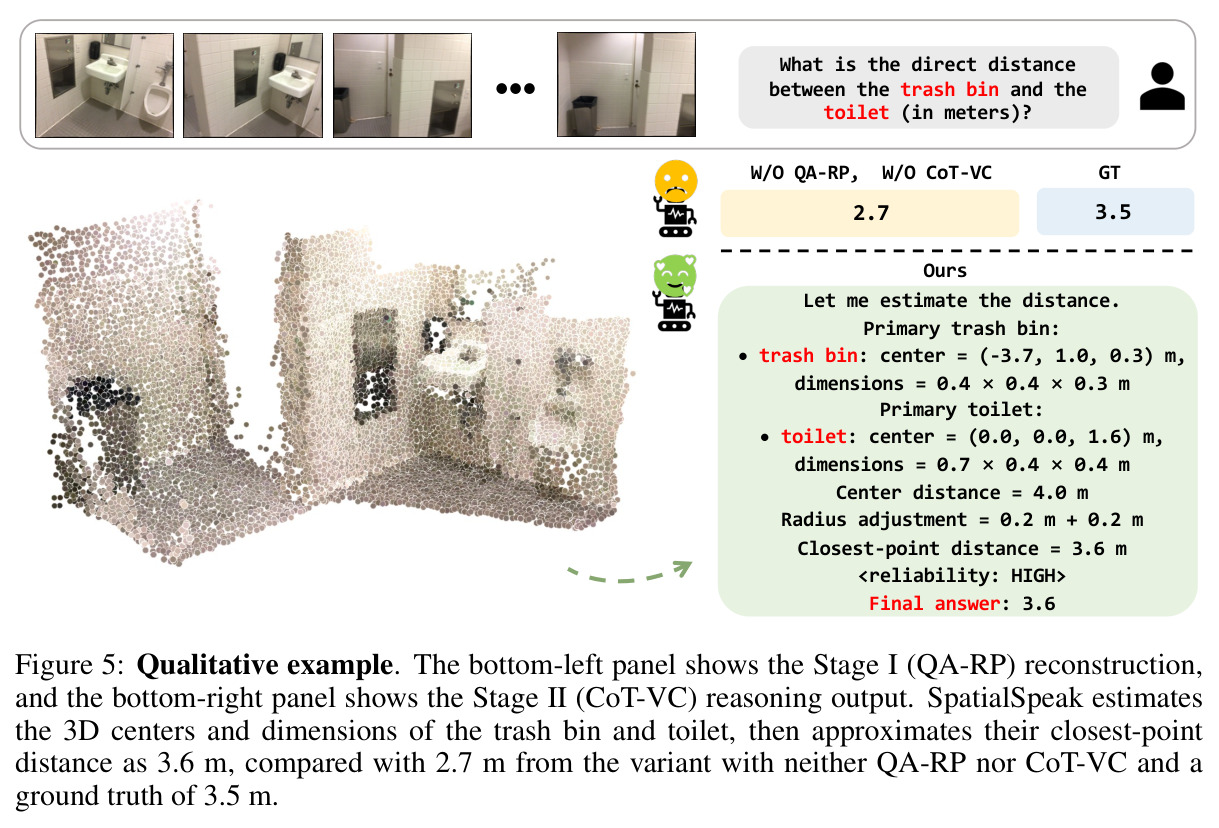
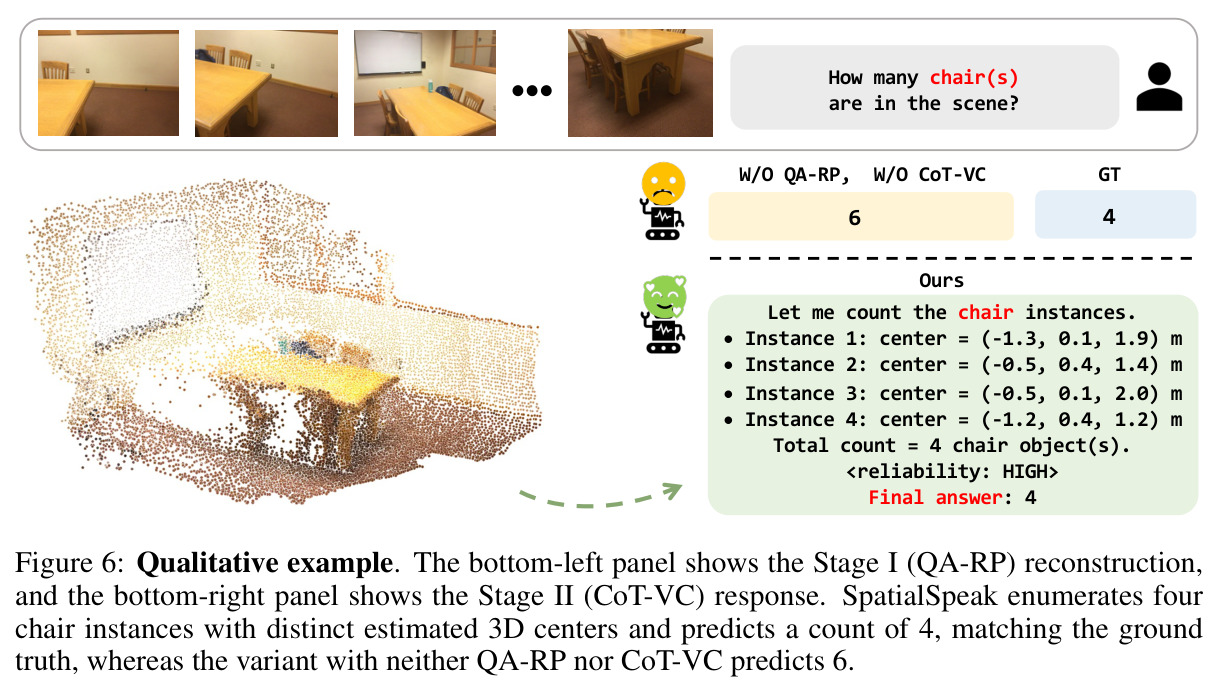
消融(ReVSI 平均):完整方法 62.8 分;去掉 CoT-VC 降至 55.9,去掉 QA-RP 降至 55.0,两者皆无 52.4;无 QA-RP 时 CoT-VC 仅增益 2.6 分,有 QA-RP 时达 6.9 分,证明两阶段协同放大。QA-RP 内部:去全局物体中心查询 59.9,去局部点查询 59.3,两者皆去 55.0,说明局部与全局监督互补。可靠性阈值 $\tau{=}0.3$ 最优(62.8),$\tau{=}0.1/0.5$ 为 59.6/59.5。VC 消融:仅空间 CoT 58.5,加 VC 达 62.8(+4.3)。重建(ScanNet 200 个留出场景):未对齐 Acc./Comp. 为 8.9/9.3cm,优于 CUT3R(13.7/12.7)与 MapAnything(36.3/28.4);Sim(3) 对齐后 5.0/5.0cm,优于 MapAnything(5.7/6.2)略逊 CUT3R(4.7/4.6)。主结果:ReVSI 62.8 超 SpatialStack-4B(54.1)8.7 分,7 类中 5 类最佳,物体计数 64.9 对 36.3、房间尺寸 66.0 对 54.4、相对距离 71.9 对 62.9;VSI-Bench 常规设定 63.3 超 Omni-View-7B(55.4)7.9 分,相对方向 86.2;扩展设定 73.0 以 4B 骨干超 GeoThinker-8B(72.6);SPAR-Bench 76.0 超 SpatialStack-4B(72.0)与 GeoThinker-8B(68.2)。定性上:黑板计数答 2(基线 3)、椅子 4(基线 6)、垃圾桶-马桶距离 3.6m 对真值 3.5m。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 空间推理(ReVSI 平均,7 类任务) | 平均分(含物体计数、绝对/相对距离、物体/房间尺寸、相对方向、路线规划) | 62.8(SpatialSpeak-4B) | SpatialStack-4B 54.1(次优),GeoThinker-8B 54.0 | +8.7 分,7 类中 5 类最佳 |
| ReVSI 物体计数(Obj. Count) | 计数准确率 | 64.9 | SpatialStack-4B 36.3 | +28.6 分,为最大单项提升 |
| 室内视频空间问答(VSI-Bench 常规训练设定) | 8 类任务平均分 | 63.3 | Omni-View-7B 55.4(次优) | +7.9 分;相对方向类 86.2 |
| 室内视频空间问答(VSI-Bench 扩展训练设定) | 8 类任务平均分 | 73.0(4B 骨干) | GeoThinker-8B 72.6,SenseNova-SI-8B 68.8 | +0.4 分,以更小模型取得最高分 |
| SPAR-Bench | 平均分 | 76.0 | SpatialStack-4B 72.0;GeoThinker-8B 68.2 | +4.0 / +7.8 分 |
| ScanNet 点图重建(无对齐,200 个留出场景) | Acc. / Comp.(cm,越低越好) | 8.9 / 9.3 | CUT3R 13.7 / 12.7;MapAnything 36.3 / 28.4 | 误差全面最低 |
| ScanNet 点图重建(GT Sim(3) 对齐) | Acc.* / Comp.*(cm) | 5.0 / 5.0 | CUT3R 4.7 / 4.6;MapAnything 5.7 / 6.2 | 优于 MapAnything,略逊 CUT3R |
局限与改进
作者承认的局限:GT Sim(3) 对齐后重建精度略逊于专用模型 CUT3R(5.0 对 4.7cm),说明几何表达仍有提升空间;VSI-Bench 常规设定下路线规划(Plan Route 43.3)与顺序逼近(Order Appr 43.3)两类仍明显弱于计数(72.2)和相对方向(86.2),CoT 模板未覆盖的题型仍依赖直接答案监督。我的补充观察:其一,训练监督依赖 ScanNet 的真值深度图、相机外参与 3D 框标注,难以直接迁移到无位姿标注的真实视频;其二,可靠性标签由几何估计与真值答案的相对误差离线决定(阈值 $\tau$ 需人工调到 0.3),模型学到的可能更多是""按题型与误差分布模仿标签"",而非真正的几何置信度校准;其三,CoT 由确定性模板生成,推理风格单一,泛化到需要灵活多步推理的问题存疑;其四,视觉编码器、几何编码器与投影层全程冻结,只微调 LLM,可能限制几何-语义融合的上限;其五,扩展训练设定下对 GeoThinker-8B 的领先仅 0.4 分,优势规模依赖更大训练数据。
独立分析的弱点
独立分析的弱点及改进方向:(1)域覆盖窄——训练与评测集中在 ScanNet 式室内场景,户外、大尺度或物体高度密集场景中全局物体枚举查询的可扩展性未知,可引入 ARKitScenes 等真实扫描与室外数据联合训练;(2)监督构造成本高——局部点真值需要真值深度加外参,全局真值需要 3D 框标注,改用自监督点图一致性约束或用现成前馈重建模型生成伪标签可大幅降低门槛;(3)可靠性学习可能退化——[HIGH]/[LOW] 由相对误差规则离线生成,模型可能学会按题型猜测标签而非真正评估几何质量,应引入期望校准误差(ECE)等校准指标与测试时几何自检;(4)两阶段割裂——Stage II 无法反过来修正 Stage I 的几何盲区,可探索联合训练,或依据推理误差回传筛选/加权重建预训练数据;(5)模板化 CoT 限制推理多样性——面对需要假设、回溯的复杂空间问题可能失效,可在可验证答案上用 RLVR 优化自由形式的推理轨迹;(6)多选题(如路线规划 43.3 分)收益有限,说明纯几何演算对拓扑/语义型空间任务不够,需引入地图或拓扑记忆等外部结构。
未来方向
作者在结论中希望这项工作能激发""重建增强推理""的进一步探索。基于其成果可延伸的方向:一是把 QA-RP 扩展到时序 4D(动态物体轨迹)与开放词汇查询,让全局上下文覆盖可移动目标,服务机器人导航;二是将 CoT-VC 的可靠性机制与强化学习结合,以最终答案正确性为奖励优化几何演算策略,替代规则生成的 CoT 模板;三是探索重建与推理的联合训练或交错课程,检验协同效应(2.6→6.9 分)能否进一步增强;四是把框架嫁接到 8B/72B 更大骨干或专有模型,研究扩缩规律;五是利用模型输出本身就是可消费的空间 API(物体 3D 中心与尺寸)这一特性,在真实机器人与 AR 场景中验证度量级几何回答的实用价值;六是改进对齐协议下的重建精度,让通用 VLM 的几何能力逼近甚至超过专用前馈重建模型,打通""一个模型同时做感知、重建与推理""的路线。
复现评估
复现评估:论文提供项目页(yangcaoai.github.io/SpatialSpeak/),但正文未明确承诺开源代码与权重。训练配置披露完整:表10/11 给出 Stage I(8×H800,全局 batch 32,峰值学习率 $5\times10^{-6}$,1 epoch)与 Stage II(8×H800,全局 batch 64,峰值学习率 $1\times10^{-5}$,1 epoch)的全部超参,均为 bf16、AdamW、cosine 调度、warmup 0.03;基座 Qwen3-VL-4B 与 VGGT 均公开可得。数据需要 ScanNet(含真值深度、外参与 3D 框标注)、LLaVA-Video-178K 的 LLaVA-Hound 子集与 SPAR-7M,扩展设定再加 SPAR、VLM-3R 与 VSI-590K;评测依赖 ReVSI、VSI-Bench、SPAR-Bench 及各官方 baseline checkpoint。整体复现难度中等偏高:算力门槛为两阶段各 8 张 H800,四类 CoT 生成器与可靠性标注管线需按论文描述自行实现(物体排序等细节文中已给出)。
论文图表
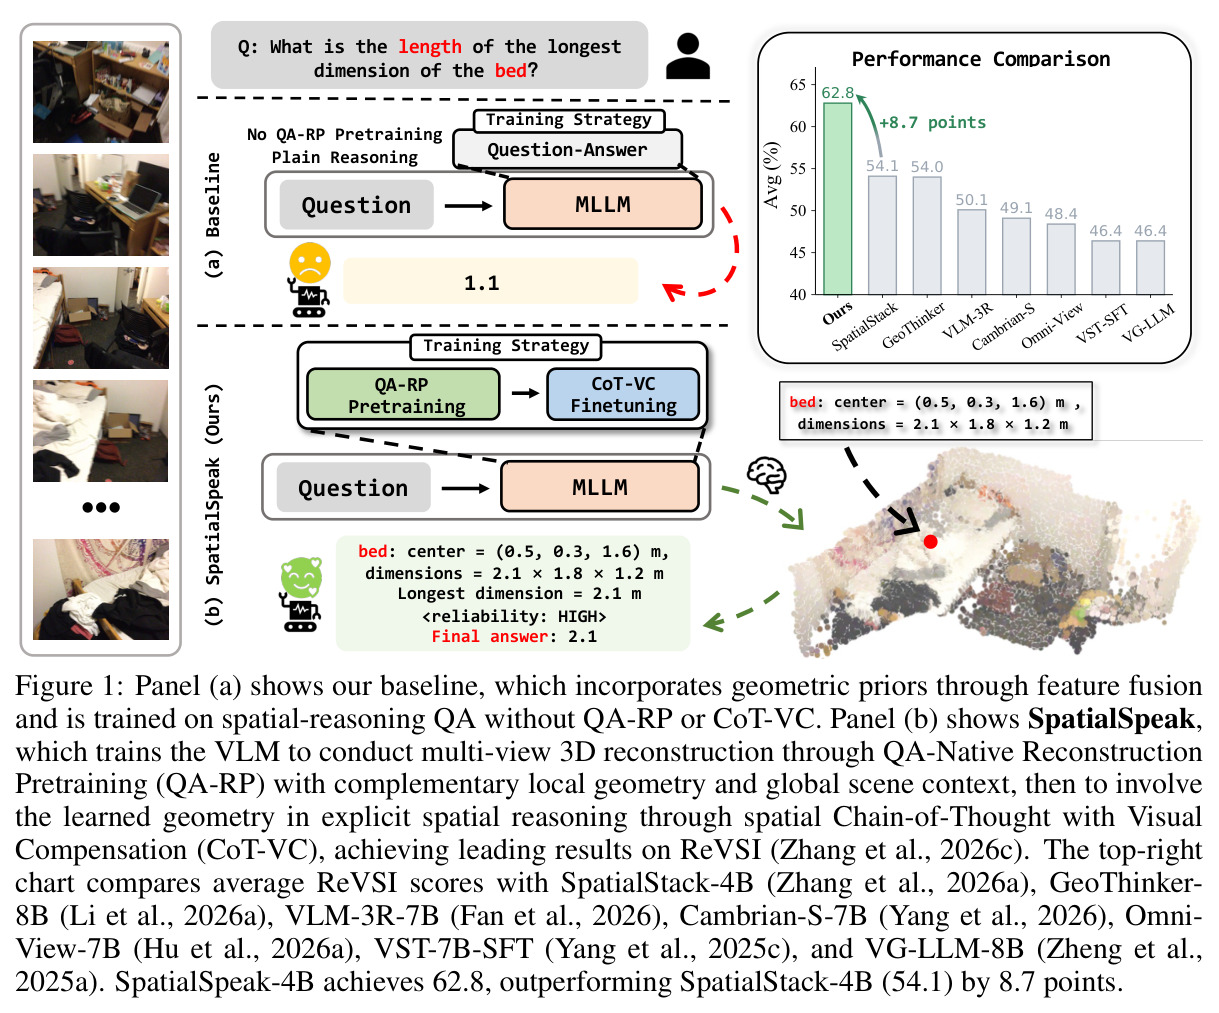
左右对比两种训练策略:(a) 基线只把 VGGT 几何特征融进视觉 token 并用答案级监督训练空间 QA;(b) SpatialSpeak 增加两个训练阶段,模型输出包含物体 3D 中心与尺寸、推理演算、可靠性标记和最终答案。柱状图列出与 SpaceR、VST-SFT、VG-LLM、Omni-View、Cambrian-S、VLM-3R、GeoThinker、SpatialStack 的 ReVSI 平均分对比。
一张图讲清论文的动机(答案级监督缺中间几何监督)、方法概貌(两阶段)与主要卖点(62.8 对 54.1),是读者建立全局认识的最佳入口。
同一场景的地面真值、SpatialSpeak Stage I 重建、CUT3R 与 MapAnything 重建并排展示,标注同一两点间距离:本文 1.38m 一列为其他模型结果,核心数字是本文 1.24m 对真值 1.25m。
用定性可视化支撑表5的定量结论:Stage I 的 VLM 确实学到了度量级准确的几何,而不是只会答题。
检验局部与全局两类重建监督的独立贡献:完整方法 62.8,局部与全局各有约 3 分贡献,同时保留两者才达到最佳,说明细粒度点几何与场景级物体布局互补。
论证论文标题中局部与全局上下文设计的必要性,是方法设计合理性的直接证据。
改变构造 [HIGH]/[LOW] 标签所用相对误差阈值 τ:过严(0.1)导致过多 LOW 标签,过松(0.5)导致过多 HIGH 标签,两者都比 0.3 差 3 分以上。
揭示可靠性标签质量对视觉补偿机制的关键影响,说明该超参需要仔细调节。
对比 Stage I 模型与两个专用前馈重建模型的点图精度,误差单位 cm、越低越好,分无对齐与 GT Sim(3) 对齐两种协议。
证明 QA 式训练让通用 VLM 在无对齐协议下超越专用重建模型,是几何通过文本接口可学好这一主张的定量支撑。