SimVTA:面向驾驶世界动作模型的仿真接地视频-轨迹对齐 SimVTA: Simulation-Grounded Video-Trajectory Alignment for Driving World Action Models
用3DGS仿真器为高奖励候选轨迹渲染匹配视频,与轨迹GRPO联合后训练驾驶世界模型
前置知识
世界动作模型(WAM)
同时建模未来场景与自车动作的驾驶模型:预训练时从「轨迹-未来视频」成对数据中学习,既预测未来画面(提供稠密视觉监督、帮助学习表征),又预测轨迹(提供规划输出)。近年趋势是训练时保留视频预测、推理时直接出轨迹以省掉视频生成开销,本文的 Epona 骨干(共享编码器 + TrajDiT + VideoDiT)就是典型代表。
全文讨论的就是如何给 WAM 的后训练补上视觉监督,理解 WAM 的双头结构(轨迹头与视频头共享编码器)是理解「视频梯度回流共享编码器」这一核心发现的前提。
GRPO(组相对策略优化)
源自 DeepSeekMath 的 RL 算法:对同一观测采样一组(本文 $G=32$ 条)候选,用组内奖励归一化得到相对优势 $A_i=(R_i-\bar{R})/(s_R+\varepsilon_{adv})$,无需训练价值网络。本文按 Flow-GRPO 的 SDE 采样形式实现,对去噪转移分数做截断并按 $\gamma_d=0.6$ 跨去噪步折扣。
SimVTA 的轨迹损失 $\mathcal{L}_{traj}$ 完全建立在 GRPO 之上,奖励来自 NAVSIM PDM 评分器,理解组相对优势才能看懂轨迹优化部分以及消融中对不安全候选优势置零的处理。
3D高斯泼溅(3DGS)
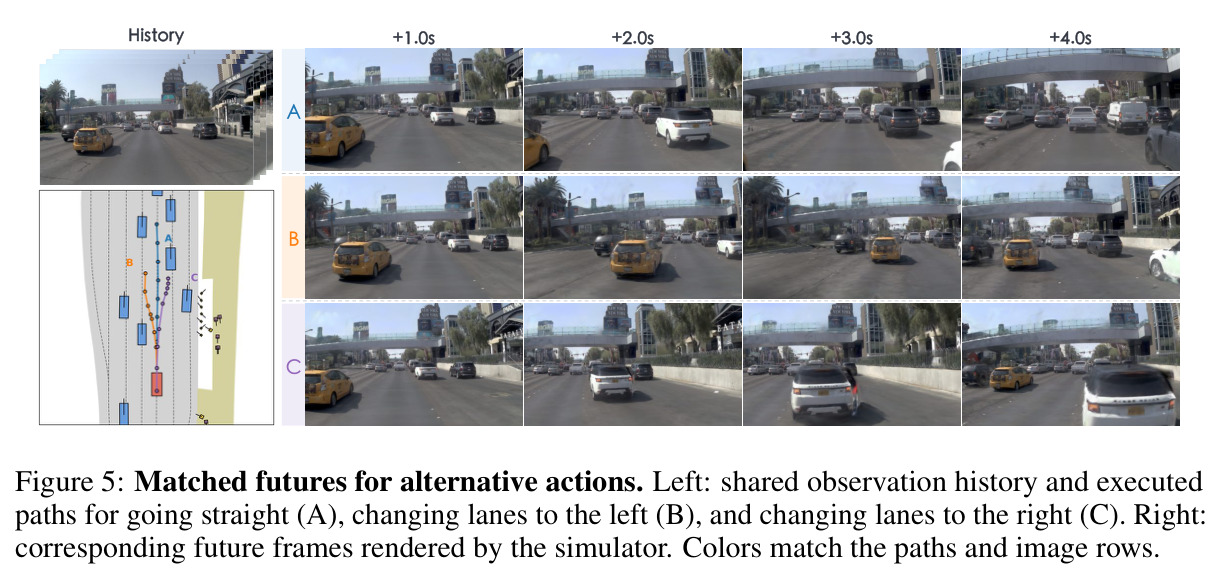
用数百万带颜色和不透明度的各向异性高斯基元显式表示三维场景,可从任意相机位姿实时光栅化渲染照片级图像。只需对真实驾驶场景做一次重建,就能沿任意轨迹的位姿序列渲染出「假如这样开会看到什么」的画面。
本文的视频监督全部来自 World Engine 中基于 3DGS 的渲染器:沿候选轨迹执行路径渲染的未来视频就是训练目标,理解 3DGS 才能理解「预测无关的匹配监督」从何而来及其质量局限。
Flow Matching(流匹配)
一类生成建模方法:学习一个速度场,把高斯噪声沿线性插值路径 $x_t = t z + (1-t)\epsilon$ 输运到数据 $z$,训练目标是让速度网络拟合 $u^\star = z - \epsilon$。相比扩散模型路径更直、采样更少,常用于视频与轨迹生成。
SimVTA 的视频损失就是对渲染目标潜变量做流匹配,轨迹 GRPO 的采样也借用 Flow-GRPO 的 SDE 公式,两处核心机制都以流匹配为基础。
NAVSIM 与 PDMS 指标
NAVSIM 是数据驱动的非反应式驾驶评测基准:给定日志观测,执行规划器输出的轨迹并用 PDM 评分器打分。PDMS 由碰撞豁免 NC、可行驶区域合规 DAC、碰撞时间 TTC、舒适度 Comfort 和自车进度 EP 加权聚合;v2 的 EPDMS 进一步加入驾驶方向、红绿灯、车道保持等分量。
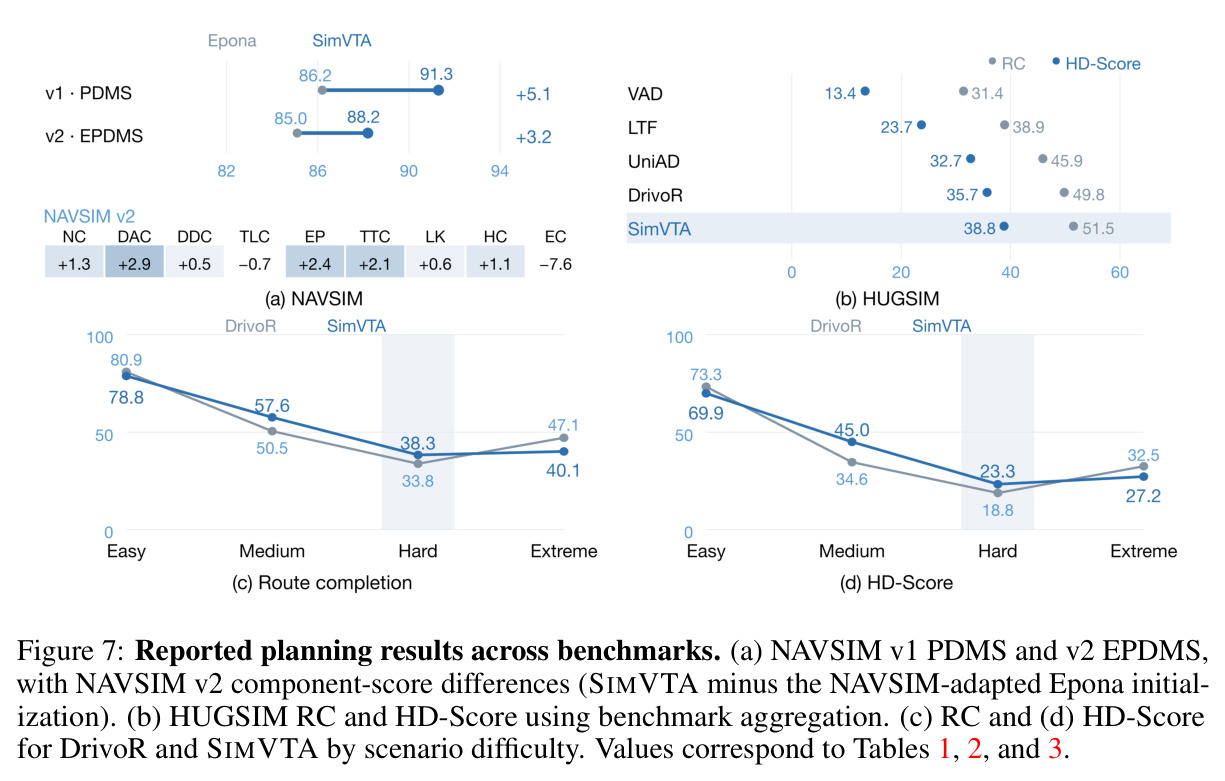
本文主结果(v1 PDMS 86.2→91.3、v2 EPDMS 85.0→88.2)和训练奖励 $R_i=NC_i\cdot DAC_i\cdot(10\,EP_i+5\,TTC_i+2\,Comfort_i)/17$ 都定义在这些分量上,是读懂所有实验表的钥匙。
研究动机
驾驶世界动作模型(WAM)在预训练阶段依赖成对的「轨迹-未来视频」监督:驾驶日志中每条人类轨迹都有对应的真实未来画面,这种稠密视觉信号弥补了稀疏轨迹标签的不足。但进入强化学习后训练阶段后,矛盾暴露出来:策略会采样大量偏离日志记录的候选轨迹。例如在日志车直行的场景里,某条候选轨迹选择左转,而日志视频只记录了直行的画面,完全没有展示左转后的视觉后果。此时只有两种糟糕的选择:复用日志视频会制造「轨迹-视频」错配的假监督;干脆不给这些候选轨迹配视频,则它们完全失去视觉监督。作者将此称为后训练阶段的监督鸿沟:当前策略探索出的轨迹缺乏与之匹配的未来视频目标。NAVSIM 上的数据也印证了信号缺失的代价——仅用轨迹 GRPO 的 Exp0 只能把 PDMS 从 86.2 提到 89.1。
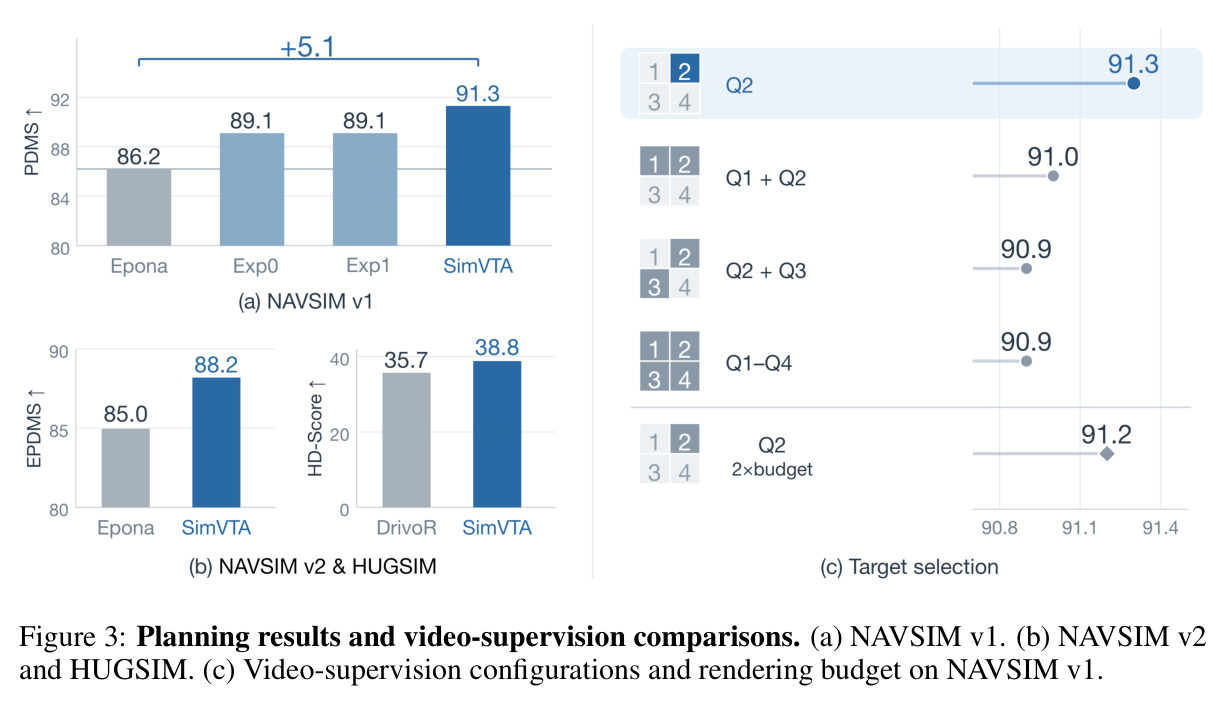
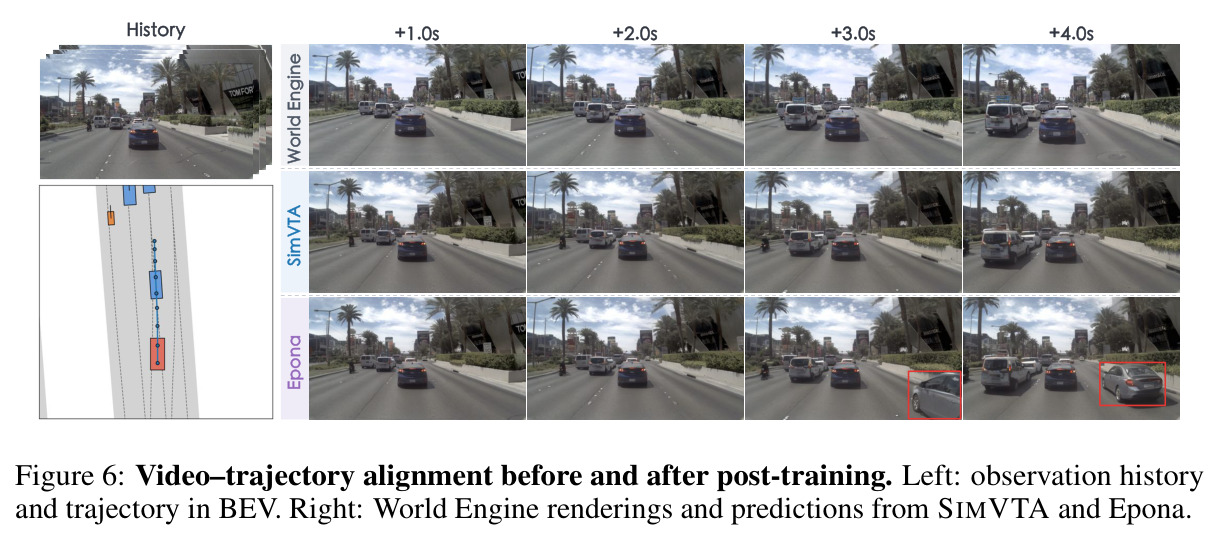
本文的目标是本文的目标是为驾驶 WAM 的强化学习后训练补上「轨迹-视频对齐」这块拼图:让每条被选中的高奖励候选轨迹都拥有与其执行路径几何和运动完全一致的未来视频监督,同时不增加任何推理开销。具体而言,作者希望在训练时利用仿真器渲染预测无关的视频目标,把视频损失的梯度注入与轨迹规划共享的表征,从而同时提升规划质量(NAVSIM v1 PDMS 从 86.2 提升到 91.3,v2 EPDMS 达到 88.2,HUGSIM 闭环 HD-Score 平均 38.8)与视频预测质量(FVD 从 105.4 降到 46.3);而在推理时模型直接从观测历史预测轨迹,不需要调用仿真器、不生成未来视频、也不做基于视频的重排序,保持部署效率与纯轨迹规划器一致。
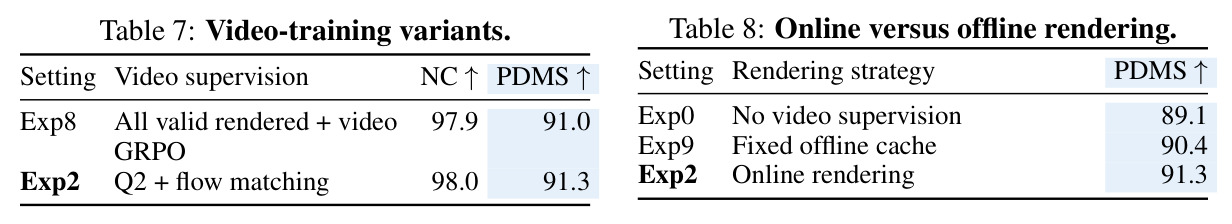
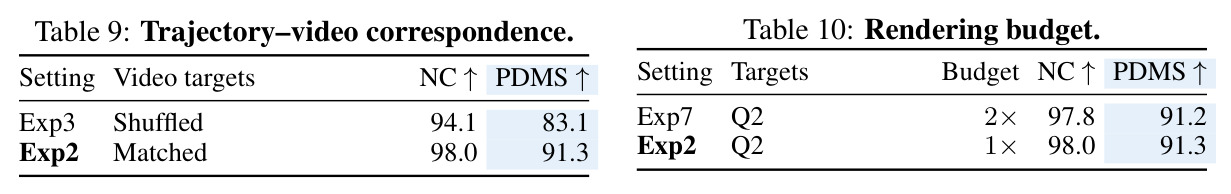
与已有工作不同的是,已有工作的切入点各不相同:SimWAM、Fast-WAM 沿袭「训练保留视频预测、推理时省略」的思路,但视频监督仍局限于日志轨迹;CausalDrive 用学习式渲染器生成目标,渲染质量受模型自身分布限制;ReSim 在仿真合成的非专家轨迹上训练视频仿真器,关注动作可控性而非真实场景后训练。SimVTA 的独特之处有三:一是用 World Engine 的 3DGS 渲染器在重建的真实场景中沿候选轨迹执行路径渲染画面,目标与模型自身预测完全解耦,天然规避自我确认偏差;二是把「选哪些轨迹探索」与「选哪些视频做监督」解耦——先按奖励选渲染池,再按预测误差挑出高奖励且高误差的 Q2 子集重点监督;三是在线渲染随策略更新刷新目标,消融证明比固定离线缓存高 0.9 分(91.3 对 90.4),而打乱轨迹-视频配对会让 PDMS 崩到 83.1,证明收益确实来自正确配对而非视频监督本身。
核心方法
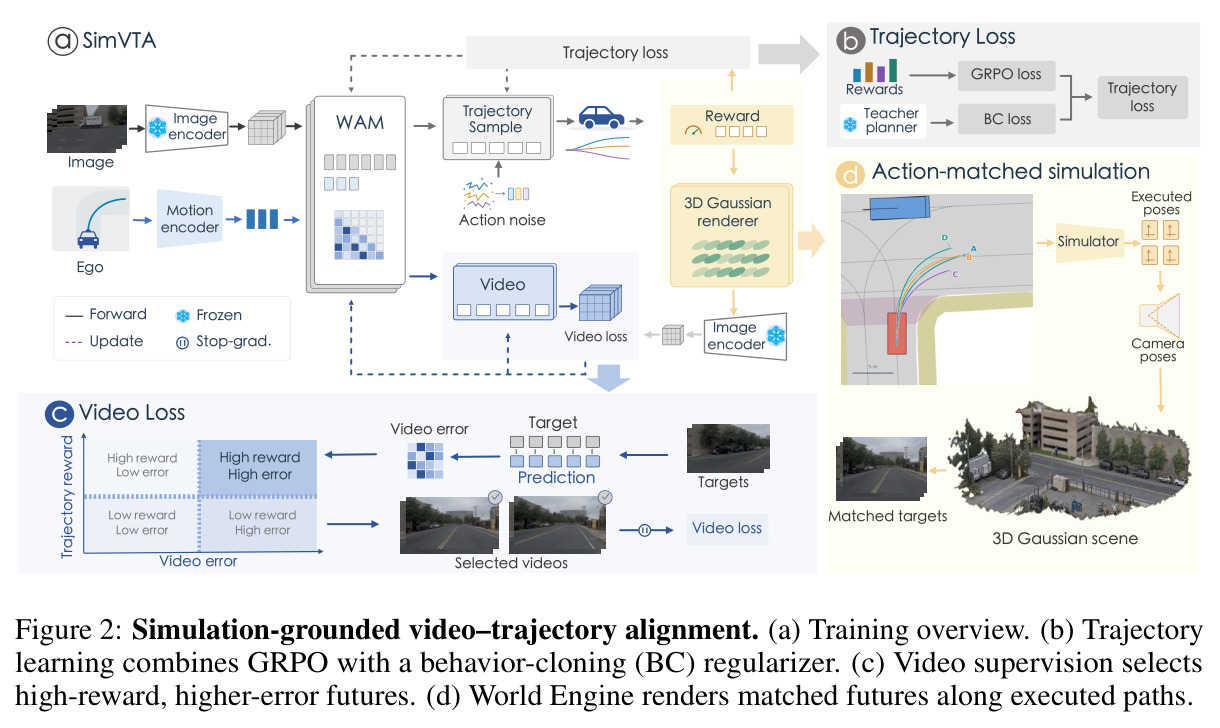
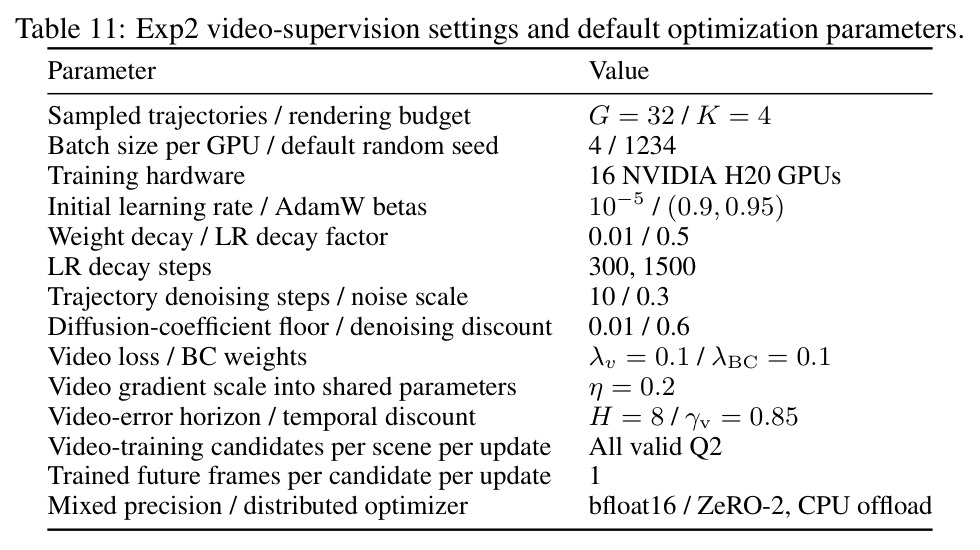
直觉上,SimVTA 把仿真器当作「能看到平行世界的眼睛」:日志只拍下实际走的那条路,仿真器却能告诉我们「如果当时左转会看到什么」。技术路线分四步:先从当前策略采样 $G=32$ 条候选轨迹,用 NAVSIM 的 PDM 执行器转成可执行路径并计算奖励 $R_i$;再过滤合法且安全的候选,按奖励排序,在渲染预算 $K=4$ 内用 World Engine 的 3DGS 渲染器沿执行路径渲染未来视频;接着对每条渲染候选计算 teacher-forced 潜空间误差 $ETF_i$,同场景内保留误差不低于均值的候选构成 Q2 集合;最后联合三项损失更新模型——轨迹 GRPO 损失 $\mathcal{L}_{traj}$、Q2 目标上的流匹配视频损失与行为克隆正则,即 $\mathcal{L}=\mathcal{L}_{traj}+\lambda_v\mathcal{L}^{sel}_{video}+\lambda_{BC}\mathcal{L}_{anchor}$($\lambda_v=\lambda_{BC}=0.1$),视频梯度以 $\eta=0.2$ 缩放流入共享编码器。推理时只保留轨迹分支,无仿真器调用。
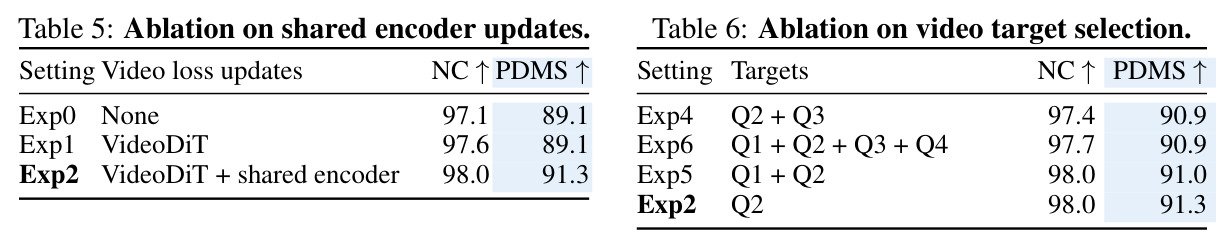
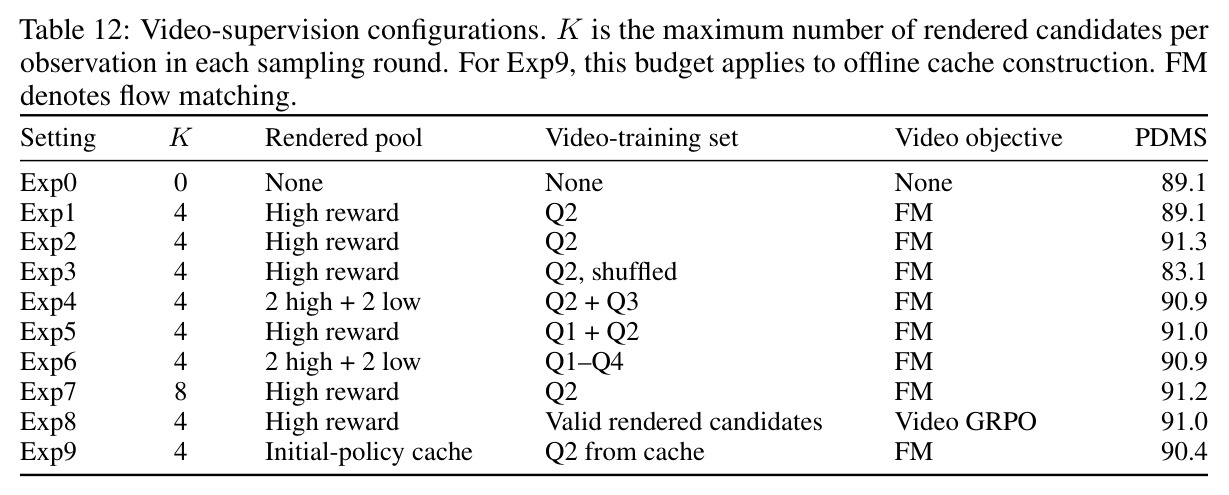
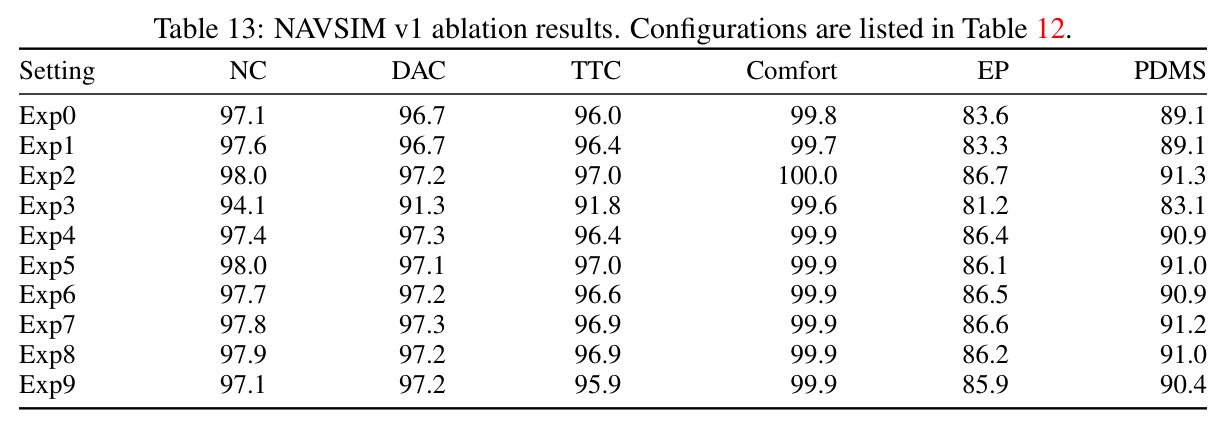
核心创新是「仿真接地的视频-轨迹对齐」。以往 WAM 的视频监督全部来自日志,天然只覆盖被记录的动作;SimVTA 用 3DGS 在真实重建场景中沿候选轨迹渲染目标视频,得到与模型预测无关、且与候选运动精确匹配的监督信号。这带来两个关键设计:其一,视频梯度必须流入共享表征——消融显示若视频损失只更新 VideoDiT(Exp1),PDMS 停在 89.1,与无视频监督的 Exp0 完全相同;允许更新共享编码器后(Exp2)立刻涨到 91.3,说明收益来自「用视觉后果重塑规划表征」而非单独训好视频头。其二,监督要挑「高奖励但模型预测得差」的未来:同样渲染池下监督 Q2 得 91.3,扩展到 Q1+Q2 反而降到 91.0,渲染预算翻倍也只到 91.2,说明定向选择比盲目堆渲染量更有效。与直接对渲染候选做 video GRPO 的 Exp8(91.0)相比,流匹配加选择性监督也略胜一筹。
方法步骤详情
(1) 编码观测历史得 $F=h_\theta(o)$,用 SDE 采样($N=10$ 去噪步、$\nu=0.3$)生成 $G=32$ 条候选;(2) PDM 执行器执行各候选,按 $R_i=NC_i\cdot DAC_i\cdot(10\,EP_i+5\,TTC_i+2\,Comfort_i)/17$ 计算奖励并组内归一化;(3) 过滤:执行成功、位姿变化在视频头支持内($|\Delta y|\le 1.5$ m、$|\Delta yaw|\le 32°$ 等)且 NC/DAC/TTC/DDC $\ge 0.999$,按奖励排序选渲染池;(4) World Engine 沿选中路径渲染视频(预算 $K=4$)并编码为潜变量;(5) 在 $t^\star=0.5$、共享噪声下计算 teacher-forced 误差 $ETF_i$:0.7 帧重建加 0.3 运动加权时域项(权重截断 $[0.25,4]$、折扣 $\gamma_v=0.85$);(6) 保留误差不低于场景均值者(Q2),每次更新随机训练一帧 $r=1+(s\bmod 8)$,并从冻结 TrajDiT 生成 BC 教师链;(7) 联合更新:GRPO 组相对优势加权截断转移分数(折扣 $\gamma_d=0.6$),视频损失以 $\eta=0.2$ 缩放进共享编码器;AdamW lr $10^{-5}$,16 张 H20。
技术新颖性
从技术谱系看,SimVTA 站在三条线的交汇处且都有增量创新:相对 Flow-GRPO、PlannerRFT、ReCogDrive 等纯轨迹 RL 后训练,它引入了与动作精确配对的视觉监督,并首次证明视觉梯度回流共享编码器才是收益来源(Exp1 与 Exp0 同为 89.1 的对照非常干净);相对 ReSim、CausalDrive 等仿真/渲染工作,它把渲染目标限定为当前策略实时采样的候选轨迹,强调在线刷新与配对保真,而非离线数据增广;相对 SimWAM、Fast-WAM 的「训练有视频、推理省掉视频」范式,它解决了后训练期探索轨迹无监督的根本矛盾。两个细粒度设计也具原创性:以奖励和误差双维度划分象限(Q1–Q4)并定向监督 Q2,把「探索」与「监督目标选择」解耦;teacher-forced 误差中用运动加权的时域变化项区分动态与静态区域,使误差度量更关注运动一致性而非静态重建质量。
实验结果
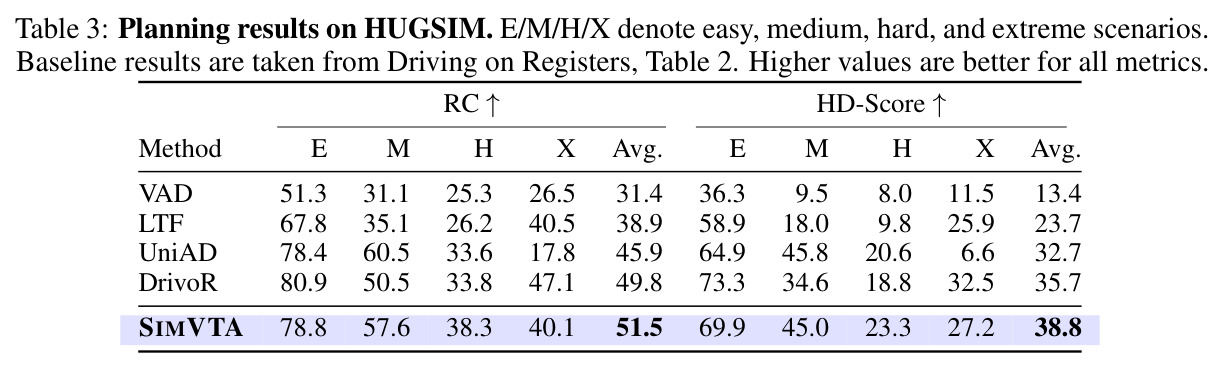
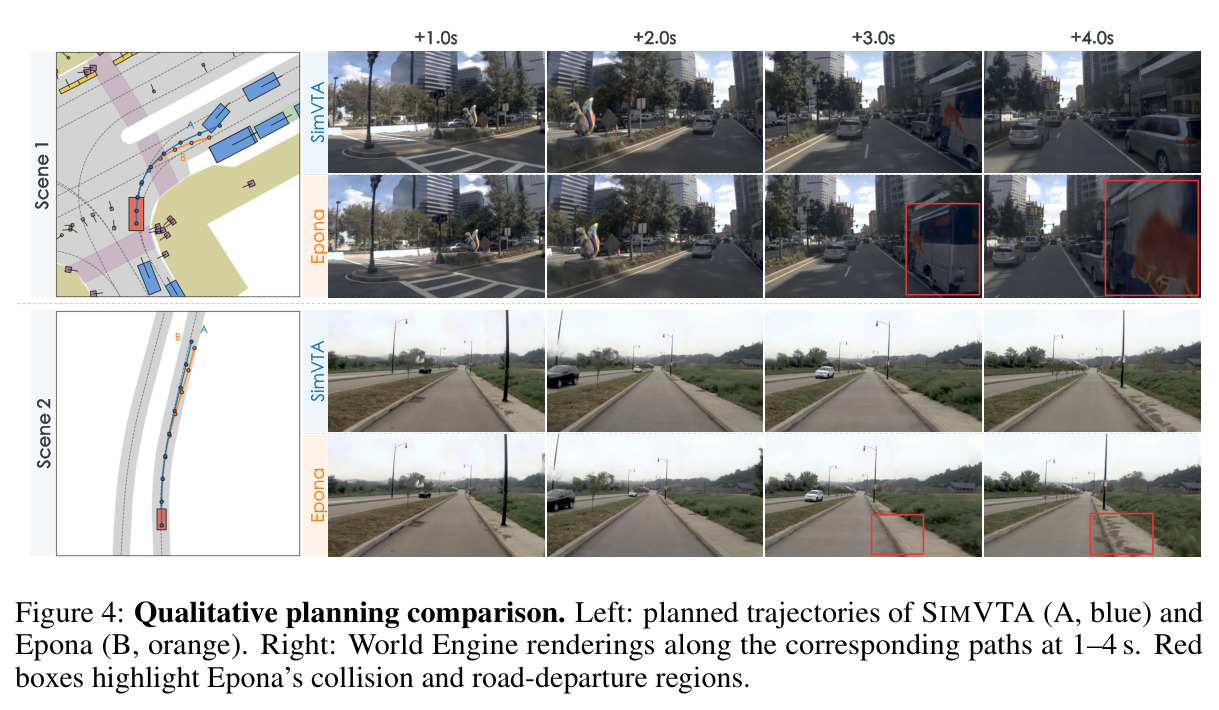
NAVSIM v1:从 Epona 初始化 86.2 PDMS 提到 91.3(+5.1),EP 80.3→86.7、TTC 93.9→97.0、DAC 95.0→97.2、NC 98.0,超过 SGDrive 91.1 与 ReCogDrive 90.8。NAVSIM v2:EPDMS 85.0→88.2(+3.2),EP 达 90.8,但 EC 67.6→60.0、红绿灯 99.7→99.0 有取舍。HUGSIM 闭环:345 场景平均 RC 51.5、HD-Score 38.8,超 DrivoR(49.8/35.7)1.7/3.1 分,hard 场景领先(38.3/23.3),extreme 不及 DrivoR(40.1/27.2)。消融:视频梯度须更新共享编码器(Exp1 89.1→Exp2 91.3);Q2 目标最优(Q1+Q2 91.0、Q2+Q3 与 Q1–Q4 均 90.9);打乱轨迹-视频配对暴跌至 83.1;离线缓存 90.4 低于在线渲染 91.3;渲染预算翻倍无增益(91.2);video GRPO 变体 91.0。视频质量:FID 20.4→13.1、FVD 105.4→46.3(渲染目标本身 7.6/21.8)。三种子稳定(91.3±0.1)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| NAVSIM v1 NavTest 端到端规划 | PDMS | 91.3 | Epona 初始化 86.2;此前最佳 SGDrive 91.1 | +5.1(对初始化),+0.2(对最佳基线) |
| NAVSIM v2 NavTest 规划 | EPDMS | 88.2 | Epona 初始化 85.0;此前最佳 SafeDrive 87.5 | +3.2(对初始化),+0.7(对最佳基线) |
| HUGSIM 闭环驾驶(345 场景) | HD-Score / RC 平均 | 38.8 / 51.5 | DrivoR 35.7 / 49.8 | +3.1 / +1.7 |
| 视频预测质量(NAVSIM v1) | FID / FVD | 13.1 / 46.3 | 仅轨迹 GRPO(Exp0)20.4 / 105.4;World Engine 渲染 7.6 / 21.8 | FID −7.3、FVD −59.1(对 Exp0) |
| 视频目标选择消融(NAVSIM v1) | PDMS | 91.3(Q2) | Q1+Q2 91.0;video GRPO 91.0;离线缓存 90.4;打乱配对 83.1 | +0.3 至 +8.2 |
局限与改进
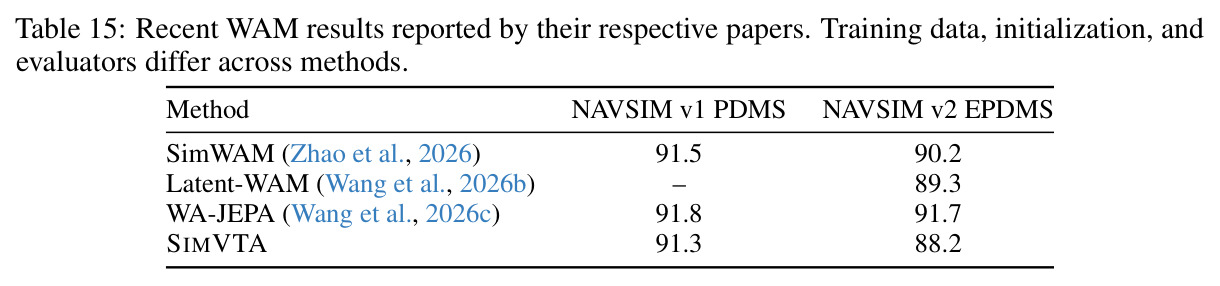
作者在附录 G 承认四点局限:3DGS 重建在遮挡和位姿覆盖不足处会退化,渲染伪影仍可能出现,高预测误差可能来自糟糕的仿真目标而非模型缺陷,需要质量感知过滤;观测历史仍来自日志、存在分布偏移,teacher-forced 选择无法捕捉自回归误差累积;框架仅在 Epona 骨干上验证,泛化到其他 WAM 架构未知;在线渲染、误差评分和视频优化显著增加训练成本。我补充观察:NAVSIM v2 上 EC(67.6→60.0)与红绿灯合规(99.7→99.0)的退化提示奖励函数中 EP 权重 10 可能诱导更激进驾驶;HUGSIM extreme 场景(RC 40.1 对 DrivoR 47.1)说明闭环长尾鲁棒性有缺口;候选安全过滤要求 NC/DAC/TTC/DDC≥0.999 相当严格,可能系统性丢弃最有学习价值的危险场景;评测用非反应式交通,未检验与反应式交通体的交互;与 SimWAM(91.5/90.2)、WA-JEPA(91.8/91.7)等论文自报数字相比,本文在各自训练配置下并非全面领先。
独立分析的弱点
独立分析几个弱点。第一,对场景级 3DGS 重建的强依赖:训练样本必须具备 World Engine 重建,数据规模和场景多样性受重建管线制约,改进方向是把渲染换成潜空间或前馈式新视角合成,降低逐场景重建需求。第二,奖励仍来自 PDM 规则评分器,本质是「用规则指标定义好驾驶」,可能继承其对激进驾驶的偏置——v2 上 EC 降到 60.0 即为佐证,可引入学习式或 VLM 参与的奖励并加风格约束。第三,Q2 的误差阈值是场景内相对均值,当某场景渲染质量普遍差时会把「渲染烂」误判为「模型差」,应加入渲染不确定性估计做绝对化阈值。第四,16 张 H20 的算力门槛与每轮「采样-执行-渲染-评分-更新」的串行依赖使训练昂贵且难以扩容,可探索误差评分异步化与低频渲染调度。第五,安全过滤阈值 0.999 过严且不安全候选的优势被截断置零(Exp4/Exp6 才有此处理,主设置 Exp2 没有),危险场景的反事实价值未被充分利用,可设计专门的负样本课程。
未来方向
作者提出的方向包括:渲染质量感知过滤与替代位姿下的评估;在偏移观测历史和反应式交通(如 Bench2Drive 系列)下检验鲁棒性;把框架推广到 Epona 之外的 WAM 架构。基于本文成果还可延伸:把 3DGS 渲染目标替换为可学习神经渲染器并在线蒸馏,兼顾质量与成本;将视频监督从潜空间像素级扩展到语义/几何一致性(深度、光流、占据)约束,缓解渲染伪影误导;在奖励中加入交互合理性与交通规则项,修复 EC 与红绿灯合规的退化;把视频预测误差用作推理期不确定性信号,触发多模式重排序;以及在机器人操作等同样缺乏反事实视频监督的具身领域复用「渲染-选择-联合更新」范式,构成通用的后训练方法论。
复现评估
复现条件中等偏上。代码与 demo 已开源(github.com/OpenDriveLab/SimVTA),NAVSIM v1/v2 数据集、PDM 执行器与评测协议均为公开资产,HUGSIM 沿用 Driving on Registers 的校正评估器与控制器。门槛有二:一是训练样本依赖 World Engine 的场景级 3DGS 重建,重建管线开放程度与 NavTrain 覆盖范围不明确;二是需要 16 张 NVIDIA H20(bfloat16、ZeRO-2、CPU offload),$G=32$ 采样、$K=4$ 渲染的在线循环成本不低。好消息是附录给出近乎完整的超参表(lr $10^{-5}$、weight decay 0.01、lr 在 300/1500 步各减半、$\lambda_v=\lambda_{BC}=0.1$、$\eta=0.2$、$H=8$、$\gamma_v=0.85$、$N=10$)以及三种子稳定性(91.3±0.1),Exp0–Exp9 配置映射全部公布,忠实复现路径清晰,但算力与重建数据是硬性壁垒。
论文图表
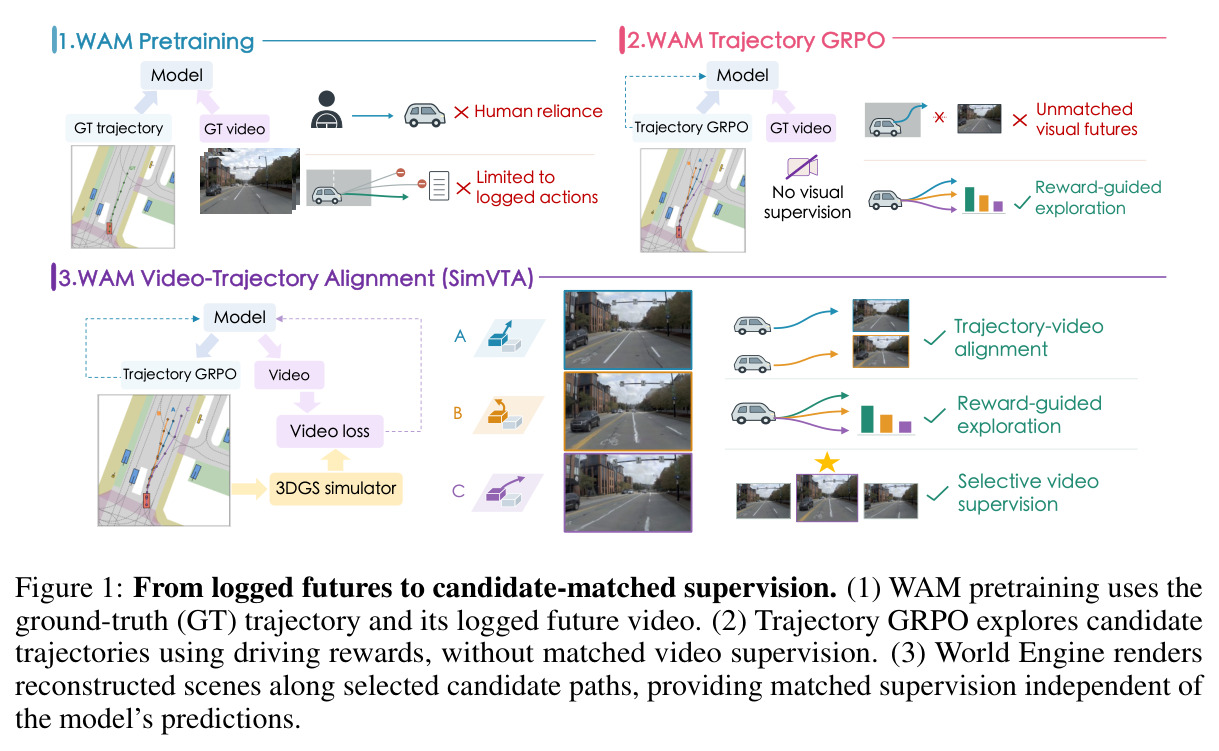
三段对比图:(1) WAM 预训练使用 GT 轨迹与其日志未来视频,受限于日志动作;(2) 轨迹 GRPO 用驾驶奖励探索候选轨迹,但探索出的未来画面没有匹配视频监督;(3) SimVTA 用 World Engine 的 3DGS 仿真器沿选中的候选路径渲染重建场景,提供与模型预测无关的匹配监督,将轨迹 GRPO、视频损失与选择性视频监督统一为轨迹-视频对齐。
一图讲清全文动机:RL 探索与日志视觉监督之间的鸿沟是什么、SimVTA 如何用仿真器填补,是理解论文叙事的起点。
NAVSIM v1 主结果表,按传统端到端、VLM、世界模型三类列出基线:UniAD 83.4、DiffusionDrive 88.1、ResAD 90.6、ReCogDrive 90.8、SGDrive 91.1、Epona 初始化 86.2 等;SimVTA 达 NC 98.0 / DAC 97.2 / TTC 97.0 / Comfort 100.0 / EP 86.7 / PDMS 91.3,为表内最高。
核心主表之一,给出 +5.1 PDMS 提升的完整分量分解和与最强外部基线的横向对比。
NAVSIM v2 九分量结果表:SimVTA 取得 98.5 NC / 98.5 DAC / 99.8 DDC / 99.0 TLC / 90.8 EP / 98.5 TTC / 97.5 LK / 99.0 HC / 60.0 EC,EPDMS 88.2,超过 SafeDrive 87.5、DreamerAD 87.7 与 Epona 初始化 85.0。
展示 v2 上的 +3.2 提升,同时暴露 EC 仅 60.0、TLC 99.0 的短板,是分析奖励设计副作用的关键证据。
视频质量表:以真实视频为参照比较 FID/FVD——World Engine 渲染(沿日志 GT 轨迹)FID 7.6、FVD 21.8;仅轨迹 GRPO 的 Exp0 预测为 20.4/105.4;SimVTA(Exp2)降至 13.1/46.3。
量化两件事:仿真器目标本身的质量上限,以及视频监督对模型视频预测质量的大幅改善,支撑「联合训练重塑表征」的论点。
视频目标选择消融:Q2(高奖励高误差)91.3 最优;Q1+Q2 为 91.0;Q2+Q3 与 Q1–Q4 均为 90.9。说明在同样高奖励渲染池下,聚焦高误差子集优于扩大监督范围。
支撑「定向监督」这一核心设计:不是监督越多越好,挑模型学不好的高价值目标才有效。
视频训练方式对比:Exp8 对全部有效渲染候选直接做 video GRPO 得 91.0;Exp2 先按 $ETF_i$ 选 Q2 子集再用流匹配损失得 91.3,两者都允许视频梯度更新共享编码器。
隔离「目标选择 + 流匹配」相对「直接视频 RL」的增益,说明选择性监督本身贡献了性能差异。
轨迹-视频配对消融:Exp3 在选择后于同场景内打乱渲染目标与轨迹条件的配对,PDMS 从 91.3 暴跌到 83.1(NC 降至 94.1),甚至低于无视频监督的 Exp0;Exp2 保持正确配对为 91.3。
最有说服力的控制实验:证明收益来自正确的轨迹-视频对应关系而非「有视频监督」本身,错误配对反而是毒药。
三随机种子(1234、20260901、20260910)下的 PDMS:Exp0 89.1±0.1、Exp2 91.3±0.1、Exp5 91.0±0.1、Exp7 91.2±0.1,Exp2 在每个种子上都最优。
证明 +2.2 的核心消融差距远超种子方差(±0.1),结论具有统计稳健性,而非随机波动。