重新审视在线策略蒸馏中的相对策略差异迁移 Rethinking Relative Policy Differences Transfer of On-Policy Distillation
把专家与参考模型的策略差异当作隐式奖励做任意到任意的蒸馏,并系统刻画何时可迁移
前置知识
在线策略蒸馏(OPD)
学生模型自己采样轨迹,教师在学生访问的每个状态上对所有 token 给出 $\log\pi_T(a|s)$ 式的稠密监督,通常最小化反向 KL $D_{KL}(\pi_\theta\|\pi_T)$,其梯度等价于以 token 级奖励 $r_t=\log\pi_T-\log\pi_\theta$ 做策略梯度。由于在学生自己访问的状态上训练,它比离线 SFT 分布偏移更小、更抗遗忘。
OPD 是本文要改进的对象:全文的推导(A2-OPD 目标)和所有实验都围绕 OPD 的监督信号展开,不理解 OPD 的奖励来源与'教师必须显著强于学生'这一限制,就无法理解相对差异迁移到底在解决什么问题。
KL 正则化策略优化与隐式奖励
在奖励期望与偏离参考策略的 KL 惩罚间权衡:$\max_\pi \mathbb{E}_\pi[r]-\tau D_{KL}(\pi\|\pi_{ref})$,闭式最优解为 $\pi^*(a|s)\propto\pi_{ref}(a|s)\exp(r/\tau)$。反过来看,$\log\frac{\pi^*}{\pi_{ref}}$ 就编码了缩放后的奖励——即隐式奖励,DPO 同款思想。
本文的核心推导:把专家与参考模型的 log 概率比 $\Delta_\phi=\log\frac{\pi^+_\phi}{\pi_\phi}$ 解释为一段隐式奖励,从而证明'传差异'和'传奖励'在数学上等价,这是 A2-OPD 目标函数的理论根基。
策略梯度与优势中心化
score-function 梯度 $\nabla_\theta J=\mathbb{E}[u(s,a)\nabla_\theta\log\pi_\theta(a|s)]$。给 $u$ 减去与动作无关的 baseline(动作维度中心化,得 advantage 类的量),不改变期望但显著降方差,是 REINFORCE 类算法的标准技巧。
A2-OPD 的实际训练损失依赖这一技巧:隐式奖励里含不可计算的配分函数偏移 $\alpha\log Z_\phi(s)$(与动作无关),通过对 $u_\theta$ 做动作中心化即可消去它,得到可以直接用 $\Delta_\phi$ 和 $\ell_\theta$ 计算的训练信号。
RL 与 SFT 两类后训练
RL(如可验证奖励的 GRPO)让基座沿明确任务奖励迭代变强;SFT 用拒绝采样筛出的正确轨迹做监督微调。两者都把模型分布沿任务相关方向推开;而单纯放大参数规模带来的提升未必对应显式任务方向——这是本文核心自变量。
实验的核心自变量就是策略差异的来源:任务导向训练(RL/SFT)产生的差异 vs 单纯规模放大产生的差异。论文最重要的结论——'更强的模型不一定是更好的老师'——直接建立在对这两类差异的区分上。
研究动机
常规在线策略蒸馏(OPD)直接让学生逼近教师的绝对输出分布,其 token 级奖励 $r_t=\log\pi_T(a_t|s_t)-\log\pi_\theta(a_t|s_t)$ 决定了它只有在教师显著强于学生时才有信息量:当师生能力接近时奖励趋近于零、信号消失,教师更弱时甚至会损害学生已有能力。工业界后训练管线(Qwen3 先离线蒸馏再 OPD 对齐、MiMo-V2-Flash 用多个领域 RL 教师蒸馏出 309B/15B-active 学生)都因此必须依赖大幅领先的教师。近期出现的相对策略更新迁移(ExOPD、P-OPD 等)改传'教师如何变强'而非'教师是谁',放松了这一要求,但已有研究只考察了'专家=在参考模型上做强化学习'这一类狭窄的源对;SFT 产生的差异、单纯参数规模放大产生的差异是否同样有用,专家/参考/目标三方如何共同决定迁移成败,此前完全没有系统答案。
本文的目标是本文要做两件事。理论侧:从隐式奖励视角出发,把'相对策略差异迁移'形式化为一个统一的 KL 正则化策略优化目标,推导出代理对(专家+参考)与目标模型解耦的 any-to-any 蒸馏目标 A2-OPD,并把传统 OPD 及已有相对迁移方法收为特例。实证侧:在该框架下系统变化差异来源(RL、SFT、模型规模)和目标模型(不同规模、训练阶段、模型代),回答三个问题——哪些策略差异提供有用监督?专家的哪部分能力被迁移、参考起什么作用?哪些目标模型能真正兑现一段有用的差异?
与已有工作不同的是,本文的独特切入是把问题从'教师比学生强多少'换成'策略差异编码了什么、目标能否消化它'。通过隐式奖励推导,代理对的 log 比值 $\Delta_\phi=\log\frac{\pi^+_\phi}{\pi_\phi}$ 成为可独立于目标使用的迁移信号,从而把长期被混为一谈的两个问题干净地分开:源对是否编码了有用的改进(源的问题),与给定目标能否实现该改进(目标的问题)。此外,它把参考模型从陪衬提升为可设计的'过滤器'——滤掉专家与目标已共享的行为、只留残差供迁移——并用干预实验证明换一个合适的参考能救活原本失败的迁移,而原始策略距离完全不能预测可迁移性。
核心方法
直觉上:与其把学生硬拽向一个可能不相容的教师分布,不如只传“相对改进的方向”。技术上分三步。第一步,假设代理专家 $\pi^+_\phi$ 是由代理参考 $\pi_\phi$ 经一步 KL 正则化奖励最大化得到的:$\pi^+_\phi=\arg\max_\pi \mathbb{E}_\pi[r^*(s,a)]-\tau D_{KL}(\pi\|\pi_\phi)$,解出闭式解可得相对差异 $\Delta_\phi(s,a)\triangleq\log\frac{\pi^+_\phi(a|s)}{\pi_\phi(a|s)}=\frac{1}{\tau}r^*(s,a)-\log Z_\phi(s)$,即差异编码隐式奖励。第二步,把该差异施加到任意目标上,最大化 $J_{A2}(\theta)=\mathbb{E}_{s\sim d_{\pi_\theta},a\sim\pi_\theta}[\alpha\Delta_\phi(s,a)]-\beta D_{KL}(\pi_\theta\|\pi_{ref})$,其中 $\pi_{ref}$ 是目标自己的参考,$\alpha/\beta$ 控制迁移强度。第三步,闭式最优策略为 $\pi^*_\theta(a|s)\propto\pi_{ref}(a|s)\left(\frac{\pi^+_\phi(a|s)}{\pi_\phi(a|s)}\right)^{\alpha/\beta}$:目标用自己的参考做底座、按代理对的相对变化重新加权,实现相对分布匹配而非绝对匹配。
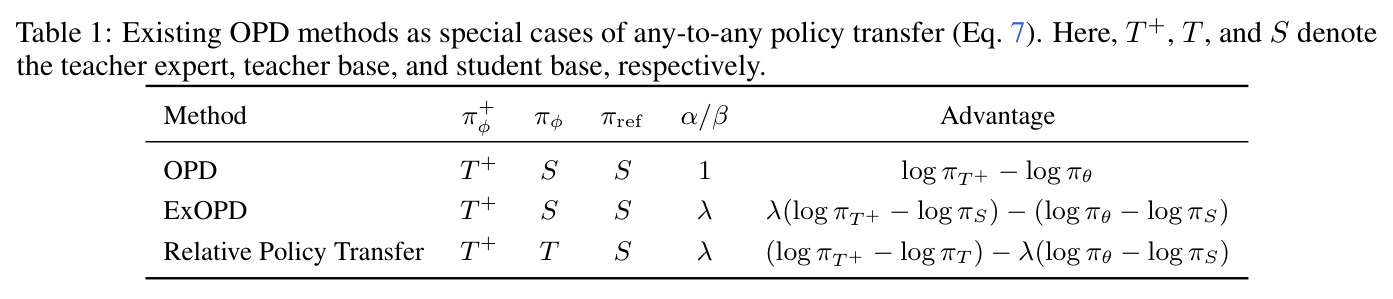
与常规 OPD 的本质区别在于'解耦'。常规 OPD 中同一个参考策略既出现在奖励项 $\log\frac{\pi_T}{\pi_{ref}}$ 又出现在 KL 正则项里,两处相互抵消,目标退化为对教师分布的绝对匹配——这正是它要求教师必须远强于学生的原因。A2-OPD 让两者分离:代理对 $(\pi^+_\phi,\pi_\phi)$ 只负责决定'改什么'(提供隐式奖励的方向),目标参考 $\pi_{ref}$ 只负责决定'在谁身上改'(提供被重加权的底座),两者不再抵消。由此带来两个直接后果:专家不需要强于学生,只需要强于自己的参考;参考也不再必须是专家的训练起点,而是一个可任意选择的过滤器——它滤掉专家与参考已共享的行为,只把残差呈现给目标。设 $\pi^+_\phi=\pi_T$、$\pi_\phi=\pi_{ref}$、$\alpha=\beta$ 即恢复传统 OPD,ExOPD 与 Relative Policy Transfer 也都是该目标的特例。
方法步骤详情
(1) 构造代理对:在 DeepMath-103K(数学)/ Eurus-RL-Code(代码)上用可验证奖励做 RL(数学 500 步,另取 100/1200 步作 Early/Late 检查点;代码 300 步),或用 Skywork-7B 拒绝采样轨迹做 SFT;参考默认为对应基座,也可换任意替代模型。(2) 采样与打分:目标策略每个 prompt 采 8 条响应(temperature 1.0、top-p 1.0),沿轨迹逐 token 计算 $\Delta_\phi$ 与 $\ell_\theta=\log\frac{\pi_\theta}{\pi_{ref}}$;为效率只保留 top-16 token 分布,跨 tokenizer 经文本对齐、失败 token 丢弃。(3) 组成权重 $u_\theta=\alpha\Delta_\phi-\beta\ell_\theta$,在动作维度中心化得 $A_\theta$,消去不可计算的 $\alpha\log Z_\phi(s)$ 且降方差、不改变期望梯度。(4) 以 $\mathcal{L}(\theta)=-\mathbb{E}[\mathrm{sg}(A_\theta)\log\pi_\theta]$ 更新(batch 1024、lr $10^{-6}$、最长 16384 token,源模型冻结)。(5) 数学训 80 步、代码 150 步;用 $G_P$、$G_T$、实现率 $R_{perf}=G_T/G_P$,分布级指标 $K_{Base}$、$K_{Induced}$、$R_{KL}$ 及 top-16 重叠率 $O_{E,R}$ 做诊断。
技术新颖性
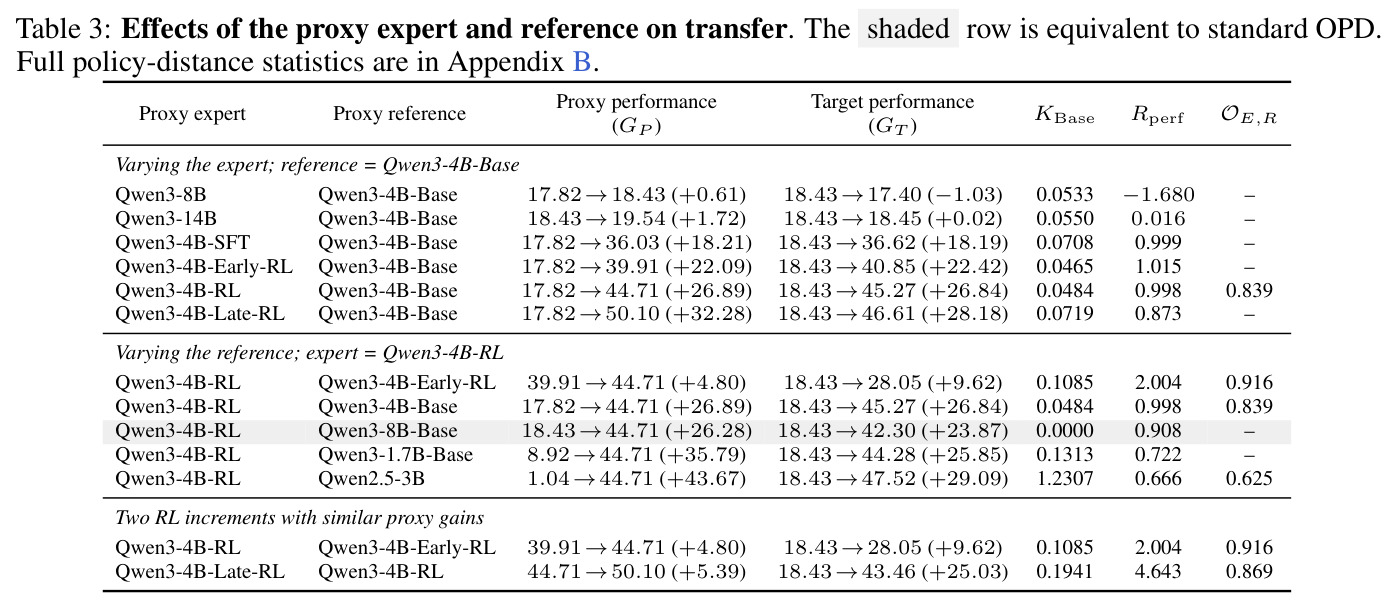
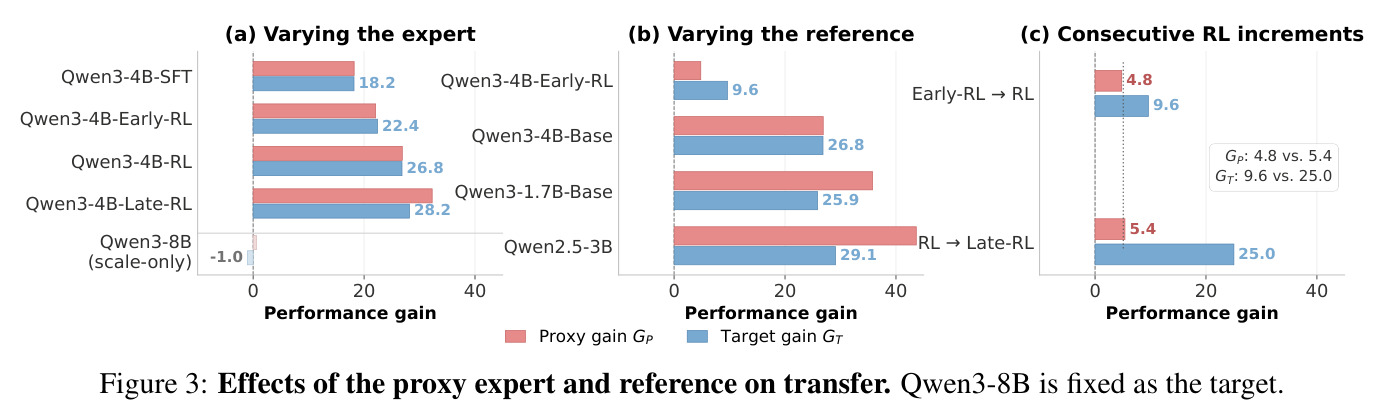
技术新颖性体现在三处。理论统一:首次把 OPD、ExOPD、Relative Policy Transfer 统一写成一个 KL 正则化目标的特例(论文 Table 1),并给出闭式最优策略 $\pi^*_\theta\propto\pi_{ref}\left(\pi^+_\phi/\pi_\phi\right)^{\alpha/\beta}$,使 $\alpha/\beta$ 成为显式的迁移强度旋钮——此前的相对迁移工作只是各自提出算法、没有共同的优化视角。概念重构:把参考模型从'必须与专家配对的基础模型'重新定义为可任意替换的残差过滤器,并用专家-参考 top-16 重叠率 $O_{E,R}$ 给过滤强度以定量刻画(0.916→0.839→0.625 对应目标增益 9.62→26.84→29.09)。实验范式:因子式扫描 9-10 个代理对 × 6 个目标 × 2 个领域,配合 $K_{Base}/K_{Induced}/R_{perf}/R_{KL}$ 等分布级诊断,用对照(任务对 vs 规模对、$K_{Induced}$ 相近但效果悬殊)和干预(只换参考的家族)而非单纯相关性来确立因果结论,这是此前'只报增益'的工作不具备的。
实验结果
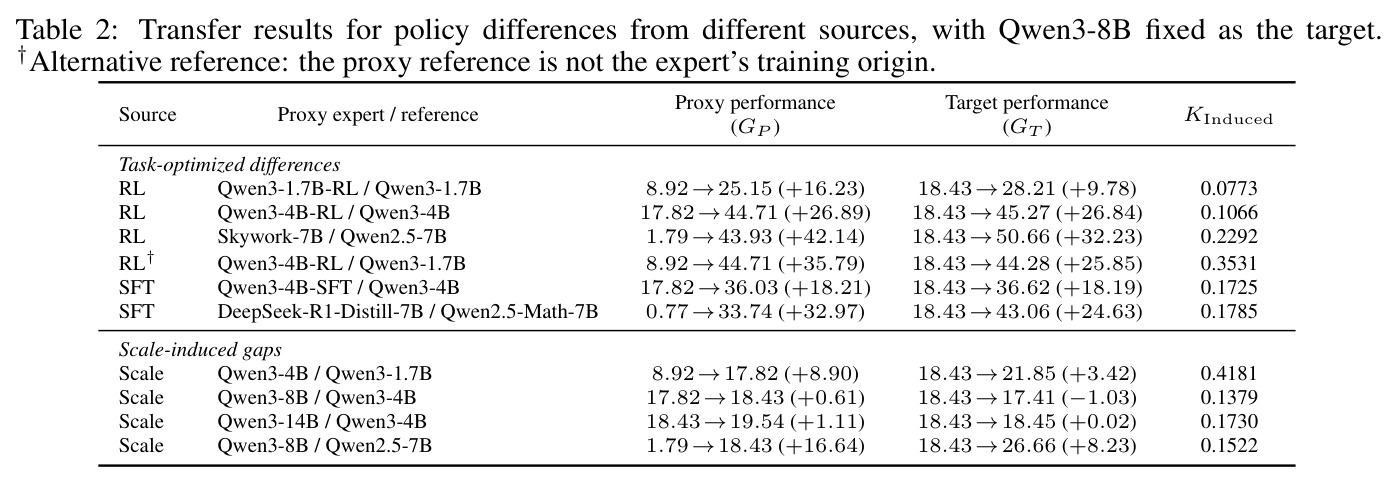
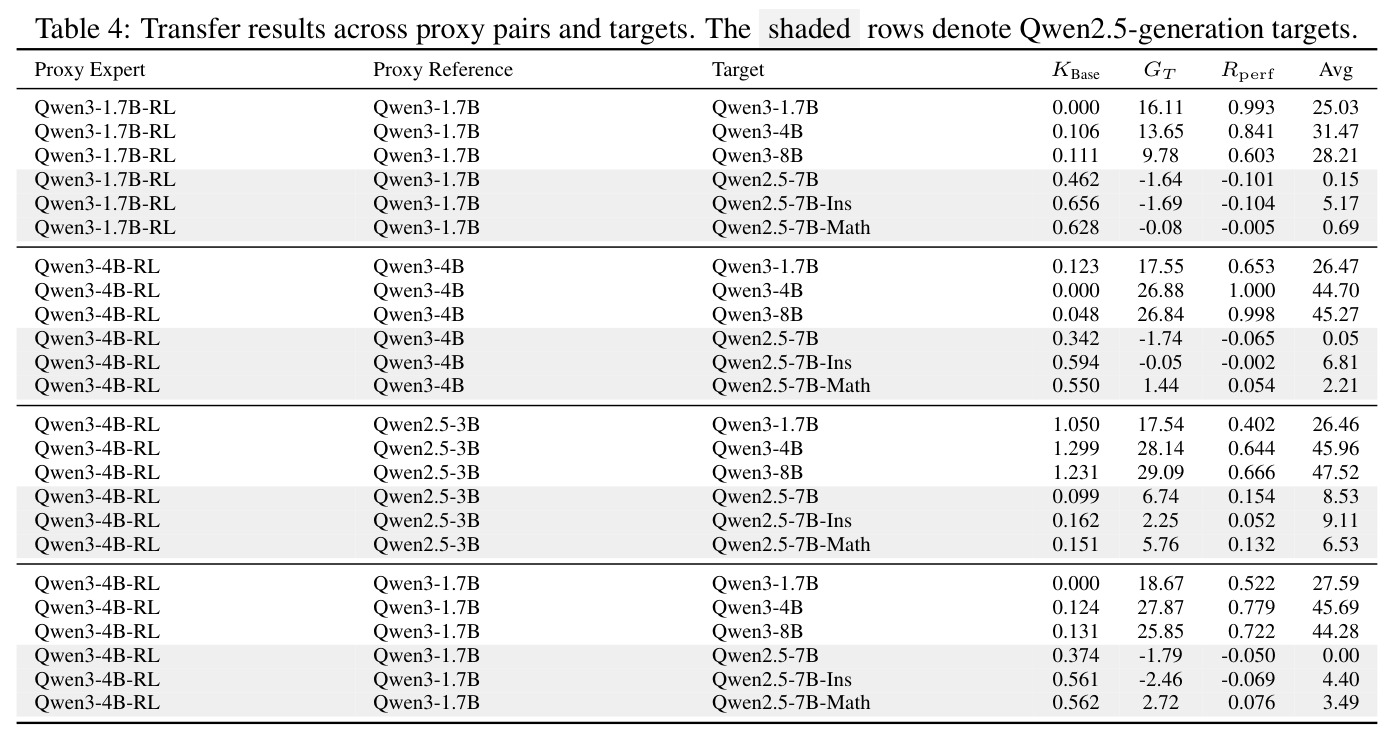
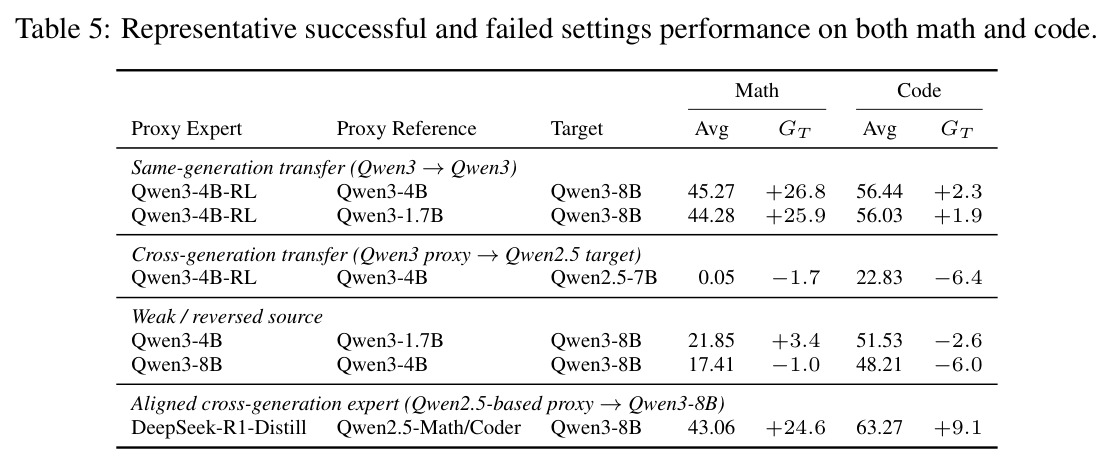
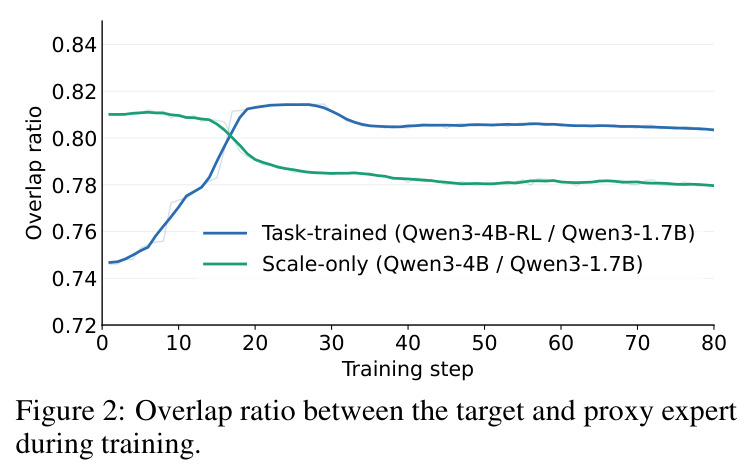
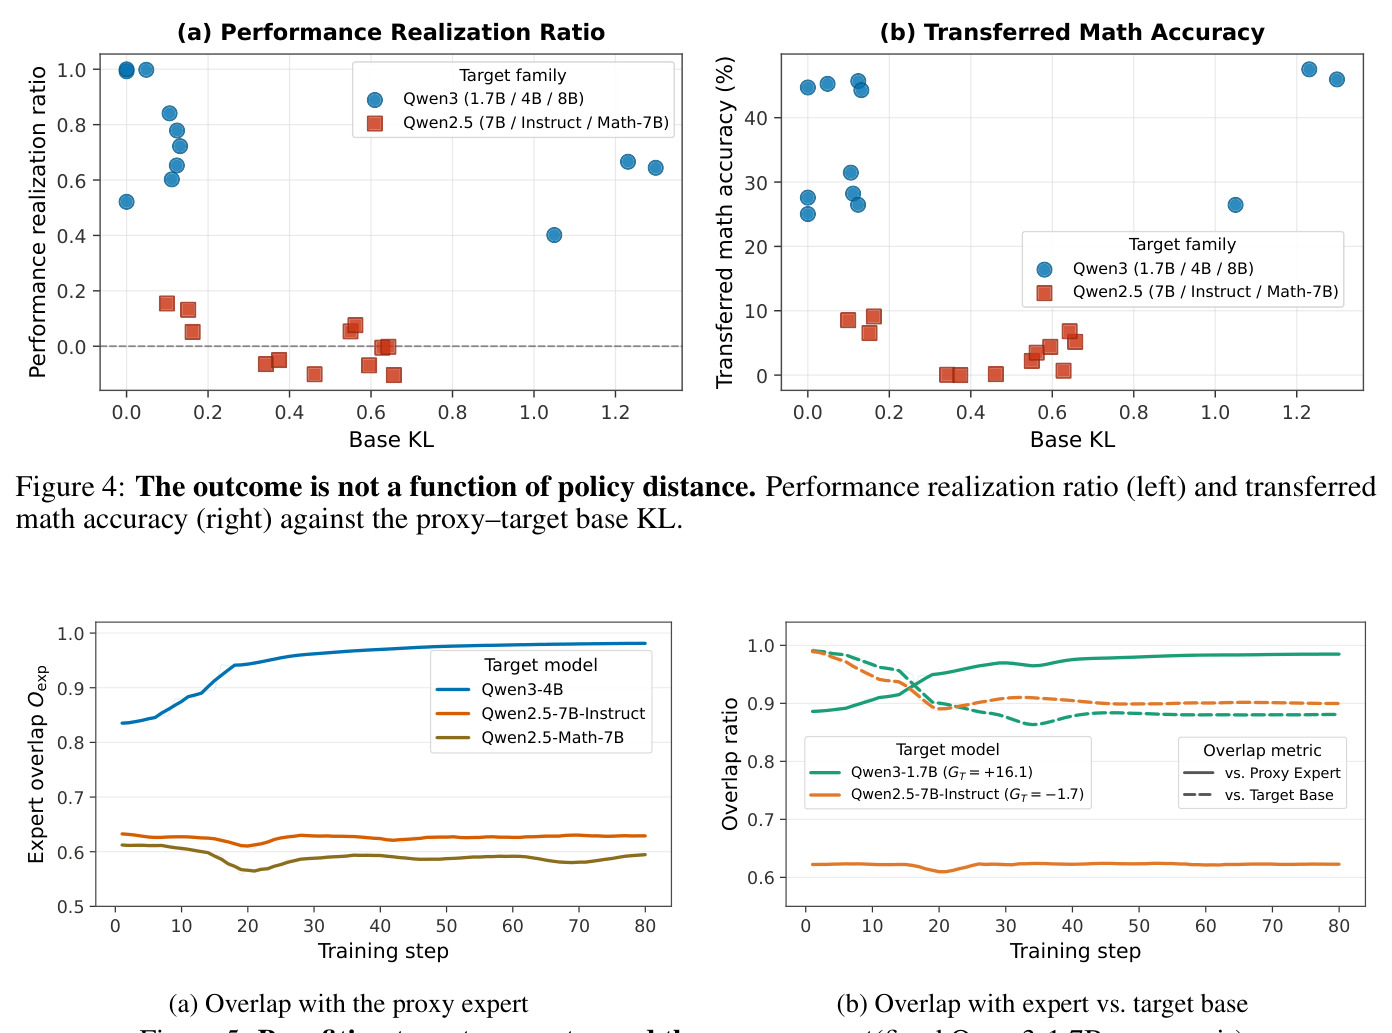
发现一(Table 2、Figure 1):任务导向差异可迁移,规模差异不行。固定 Qwen3-8B 为目标,RL 对 $G_T$ 从 +9.78 到 +32.23(Skywork-7B/Qwen2.5-7B),SFT 对 +18.19 与 +24.63;四个规模对最多 +8.23,Qwen3-8B/4B 甚至 −1.03。$G_P$ 与 $G_T$ 强相关(Pearson r=0.96),但幅度不决定成败:任务对 4B-RL/1.7B 与规模对 4B/1.7B 的 $K_{Induced}$ 相当(0.3531 vs 0.4181),$G_T$ 却是 25.85 vs 3.42。发现二(Table 3、Figures 2-3):专家定容量、参考定残差。专家从 Early→常规→Late RL(100/500/1200 步),$G_T$ 22.42→26.84→28.18,实现率 $R_{perf}$ 却从 1.015 降至 0.873;参考换 Early-RL 使 $G_T$ 掉到 +9.62,换 Qwen2.5-3B(重叠率最低 0.625)反而最高 +29.09;相邻两个 RL 增量 $G_P$ 相近(4.80 vs 5.39)但 $G_T$ 为 9.62 vs 25.03;训练中目标与任务专家的重叠从 0.75 升至 0.81,规模对则降至 0.78(Figure 2)。发现三(Table 4、Figures 4-6):目标兼容性决定兑现。Qwen3 目标全部获益(+9.78~+29.09),Qwen2.5 目标配 Qwen3 参考几乎全灭(−2.46~2.72),且 $R_{perf}$ 对 $K_{Base}$ 非单调(Qwen3 目标在 $K_{Base}>1.2$ 处仍有约 0.65);仅把参考换成 Qwen2.5-3B 即令 Qwen2.5 目标转正(+6.74/+2.25/+5.76)。失败目标对专家与基座都不靠近,且训练准确率升而验证近零——是无法泛化而非欠训练。发现四(Table 5):模式跨领域一致——同代迁移数学 +26.8/+25.9、代码 +2.3/+1.9,跨代失败 −1.7/−6.4,Qwen2.5 系代理迁移到 Qwen3-8B 为数学 +24.6、代码 +9.1,符号与排序两领域一致。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(AIME24/25/26、SMT25、CMIMC25、HMMT25-Feb/Nov、HMMT26-Feb 八基准平均,Mean@16),目标 Qwen3-8B | 目标增益 $G_T$(百分点) | 任务导向 RL 代理对 Skywork-7B/Qwen2.5-7B:+32.23(18.43→50.66) | 纯规模代理对 Qwen3-8B/Qwen2.5-7B:+8.23;规模对 Qwen3-8B/Qwen3-4B:−1.03 | 比最强的规模对高约 24 个百分点,证明任务训练差异远优于同等幅度甚至更大 $G_P$ 的规模差异 |
| 数学推理(同上八基准),标准 OPD 对照,目标 Qwen3-8B | 目标增益 $G_T$(百分点) | A2-OPD 代理对 Qwen3-4B-RL/Qwen3-4B:+26.84(实现率 $R_{perf}$=0.998) | 标准 OPD 配置(专家作教师、目标基座作参考)Qwen3-4B-RL/Qwen3-8B:+23.87 | 两者接近,且 A2-OPD 保留了可用任意参考替换的自由度 |
| 跨代迁移:Qwen3 代理对 → Qwen2.5-7B 目标(数学) | 目标增益 $G_T$(百分点) | 参考换成同代 Qwen2.5-3B:+6.74 | Qwen3-4B 参考(跨代参考):−1.74 | 由负转正(约 +8.5 个百分点),证明换参考可救活失败迁移 |
| 代码生成(HumanEval+、MBPP+、LiveCodeBench 平均,Mean@8),目标 Qwen3-8B | 目标增益 $G_T$(百分点) | 对齐代际的 Qwen2.5 系代理对 DeepSeek-R1-Distill/Qwen2.5-Math/Coder:+9.1(54.16→63.27) | 跨代失败配置 Qwen3-4B-RL/Qwen3-4B → Qwen2.5-7B:−6.4;弱/反向源对:−2.6 与 −6.0 | 展示跨代代理对可以成功反向迁移,且成败模式在代码领域与数学领域同号同序 |
局限与改进
作者承认的局限:实验只覆盖数学与代码两类有可验证奖励的任务;模型族限于 Qwen3 与 Qwen2.5 两代;迁移强度固定 $\alpha/\beta=1$,未做敏感性分析;为效率只保留 top-16 token 分布,不同 tokenizer 用文本作中间表示对齐、失败 token 直接丢弃;训练步数(数学 80 步、代码 150 步)以梯度平稳为准,未探索更长训练。我自己的观察:其一,规模差异实验里 Qwen3-8B/14B 在数学上本身只比 4B 强 0.61~1.72 个点,代理增益 $G_P$ 太小,可能低估了规模差异的真实可迁移性——缺少一个'规模带来大幅增益'的对照(例如百亿到千亿级);其二,'代际兼容'的机理仍停留在相关性加干预层面,论文没有解释为什么 Qwen2.5 目标无法在 Qwen3 参考的底座上泛化(词表差异、分词对齐损失、预训练数据配比都是候选原因,未被拆解);其三,重叠率 $O_{E,R}$ 只统计 top-16 集合交集,对低概率但关键的推理 token 不敏感;其四,未报告多种子方差与显著性检验;其五,缺少与直接 SFT 蒸馏专家输出、self-improvement 等朴素基线的横向对比。
独立分析的弱点
弱点一:参考选择目前只有'匹配模型代际'这一经验规则,当目标来自更新、更冷门或混合血统的模型族时,使用者无从判断该选谁,论文也未给出失败时的自动预警——改进方向是用小规模探针训练快速估计 $R_{perf}$,或基于词表重叠、训练数据谱系自动推荐参考。弱点二:top-16 截断加文本级 tokenizer 对齐可能在长尾推理 token(恰恰是数学难题的关键步)上系统性丢失监督,且被丢弃的 token 未做任何补偿——改进方向是基于表面形式概率加权对齐或共享子词映射,并评测全词表下结论是否变化。弱点三:每个新目标都要重跑 80~150 步 on-policy 训练,论文没有给出成本-收益分析,也未探索一段差异能否被多个目标缓存复用——改进方向是研究多目标共享同一代理对时的蒸馏效率曲线与差异的'预计算'表示。弱点四:失败模式(训练准确率升、验证不动)只能事后诊断,无法在训练中提前止损——改进方向是把专家重叠率的上升斜率作为在线指标,用于早停或自动换参考。
未来方向
作者提出的方向:把 A2-OPD 推广到更广的模型谱系与任务域(多模态、智能体、开放对话等无可验证奖励的场景);从理论上解释代际兼容性的成因,而非停留在干预实验。基于其成果可延伸的方向:其一,多代理对混合——对多个专家差异 $\Delta_{\phi_1},\Delta_{\phi_2}$ 加权组合,实现'能力拼装'式蒸馏;其二,$\alpha/\beta$ 课程化调度,先大步迁移后小步精修,或与奖励模型结合做半监督迁移;其三,利用 Early-RL→RL→Late-RL 检查点链构造渐进式参考序列,观察是否比单步迁移更稳;其四,把 reference-filtering 思想反哺模型合并领域——参考的选择本质上等价于选择合并底座;其五,在全词表、多卡 FSDP 设置下验证 top-16 结论的稳健性,并研究不同 tokenizer 家族间更精细的 token 对齐方案。
复现评估
复现条件较好。开源情况:代码托管在 GitHub(KnowledgeXLab/A2-OPD),仓库链接在论文首页给出。模型全部公开:Qwen3-1.7B/4B/8B/14B 与 Qwen2.5 系列、Skywork-OR1-Math-7B、DeepSeek-R1-Distill-Qwen-7B、Qwen2.5-Coder/Math;数据公开:DeepMath-103K(数学 RL/SFT)、Eurus-RL-Code(代码)。超参交代完整:每 prompt 采样 8 条、temperature 1.0、top-p 1.0、batch 1024、学习率 $10^{-6}$、最长 16384 token、top-16 截断、数学 80 步/代码 150 步,RL 专家分别为 500 步(数学,另有 100/1200 步检查点)与 300 步(代码)。算力需求:涉及 1.7B~8B 级模型的多组训练(先训专家再跑目标),单组蒸馏在 4B~8B 规模约需数张 A100/H100 训练数天,完整复现全部 24+ 组配置则要相当可观的算力预算;评测为 8 个数学基准 Mean@16 加 3 个代码基准 Mean@8,负担中等。总体难度中等:流程与超参清楚、无私有数据,主要风险在 RL 专家训练的随机性以及跨 tokenizer 文本对齐的实现细节。
论文图表
(a) 以 Qwen3-8B 为目标时十几个代理对的目标增益 $G_T$ 柱状图:Skywork/Qwen2.5-7B 最高(32.2),各任务导向对(RL/SFT)集中在 9.8~32.2,规模对仅 3.4、3.1、0.0 甚至 −1.0;(b) 代理增益 $G_P$ 对目标增益 $G_T$ 的散点图,按差异来源着色(RL/SFT/规模),相关系数 Pearson r=+0.96、Spearman +0.96。
一图总览论文的第一核心结论'更强的模型不一定是更好的监督来源':相关性高说明源增益重要,而按来源的分层说明'增益从哪来'更重要,是理解全文实验设计的入口。
(a) 目标与代理专家的重叠率随训练步变化:Qwen3-4B 稳步上升,Qwen2.5-7B-Instruct 全程平坦;(b) 同时追踪获益目标与失败目标相对专家和自身基座的重叠:获益目标($G_T$=+16.1)离开基座、走向专家,失败目标($G_T$=−1.7)对两者都不靠近。
给出'成功迁移 = 朝专家移动且离开自身基座'的机制性证据,把性能层面的成败翻译成策略空间的几何运动。
(a) 各目标训练/验证准确率曲线:跨代失败的 Qwen2.5-Math-7B 训练准确率上升甚至出现尖峰,验证准确率始终近零;(b) 换参考的干预:同代参考 Qwen2.5-3B($D_{base}$=0.10)下专家重叠与验证准确率同步回升,跨代参考 Qwen3-4B($D_{base}$=0.34)与 Qwen3-1.7B($D_{base}$=0.37)则双双崩塌。
排除'训练不够久'的替代解释,并用控制变量的方式证明参考代际匹配对迁移成败的因果作用,是全文干预实验的关键一环。