基于合成自蒸馏的小型模型持续后训练 Continually Post-training Small Models via Synthetic Self-distillation
把自蒸馏重写外包给稍大的同家族模型并配合拒绝采样,让小模型学新领域能力而不遗忘旧能力。
前置知识
灾难性遗忘(catastrophic forgetting)
神经网络学习新任务时,参数被新数据的梯度更新覆盖,导致旧任务性能骤降的现象。在 LLM 持续后训练中表现为:用新领域 SFT 数据微调后,模型在通用基准(MMLU、HumanEval、MBPP 等)上的准确率大幅下滑,通常用微调前后在保留测试集上的性能差 $\Delta$ 来度量。
本文两大目标之一就是抑制遗忘,所有方法对比都围绕“获取-保留”权衡展开,理解遗忘的度量方式才能读懂实验设计。
SFT 与 teacher forcing(off-policy 训练)
监督微调对固定的 gold 目标序列逐 token 计算交叉熵/NLL 损失;由于训练输入与目标都来自外部数据集而非模型自身生成,称为 off-policy。目标文本分布由数据决定,若与模型原生分布差异大,训练会把参数拉离原始流形,引发遗忘。
SynthSelf 的最终训练步骤仍是 SFT,但通过改写目标文本来控制分布;理解 off-policy 的含义是理解其与 SDFT 取舍的前提。
On-policy 与 off-policy 蒸馏
on-policy 蒸馏(如 Agarwal et al. 2024)让学生从当前策略采样输出、教师在这些学生状态上给出目标分布并用 $D_{\mathrm{KL}}$ 匹配,训练信号更贴近学生真实行为分布(DAgger 思想);off-policy 蒸馏则直接在教师预先生成的静态数据上训练,可离线批量生产与过滤。SDFT 是 on-policy 的特例:教师就是加了演示上下文的模型自己。
论文反复对比 on-/off-policy 蒸馏,只有理解两者的偏差与可控性权衡,才能理解为何本文反常地选择 off-policy 并由此解锁拒绝采样。
KL 散度与 NLL
$D_{\mathrm{KL}}(P\|Q)$ 衡量两个分布的差异,非对称且非负。当目标退化为点质量 $\delta_{\hat{y}}$ 时,$D_{\mathrm{KL}}(\delta_{\hat{y}}\|\pi)$ 恰好等于模型 $\pi$ 下的负对数似然(NLL)。本文用 KL 既做训练损失(式 1、式 4),又做诊断指标:度量微调前后策略分布的偏移量。
全文核心论证是“分布偏移与遗忘线性相关”,量化手段就是 KL/NLL,不懂这个度量就看不懂 Figure 2 和 aligner 选择准则(式 6)。
In-context learning(ICL)
大模型无需梯度更新、仅凭提示词中的演示示例就能完成新任务的能力。SDFT 正是利用它:把 gold 演示放进上下文,让模型自己生成分布对齐的“自我改写”作为蒸馏目标。但 ICL 能力随模型规模缩小急剧退化,这是 SDFT 在小模型上失效的直接原因。
理解 SDFT 的机制及其在小模型上失效的根因(Figure 3)必须先懂 ICL,这是本文要解决的起点问题。
拒绝采样与可验证奖励
先生成候选输出,再用可自动核验的规则(如抽取答案与 gold 精确匹配,$r(x,\hat{y})=\mathbb{I}[a(\hat{y})=a(y)]$)过滤,只保留正确样本进入训练集。它能提升监督数据质量,而小规模模型恰恰对数据质量高度敏感;代价是要求任务答案可自动判定。
拒绝采样是 SynthSelf 相比 SDFT 的关键工程优势来源(只有 off-policy 生成才能离线过滤),也是其局限(开放域任务不可用)的根源。
研究动机
语言模型的持续后训练(在已训练模型上继续注入新能力)面临“获取”(学会新能力)与“保留”(不忘旧能力)的双重挑战:用新领域 SFT 数据做 teacher forcing 往往引发灾难性遗忘。SDFT(Self-Distillation Fine-Tuning)通过把演示放进上下文、让模型在自身分布内隐式改写后再做 on-policy 蒸馏,同时优于 re-invoke、DFT 等 off-policy 持续微调方法。但 SDFT 的前提是模型具备强大的上下文学习(ICL)与指令遵循能力——这恰恰是小模型的短板。Figure 3a 显示,SDFT 相对 SFT 的优势随学生规模从 7B 降到 0.5B 单调衰减,到 0.5B 甚至不如直接 SFT;Figure 3b 量化了根因:0.5B–3B 模型自重写的平均答案准确率仅 60%,且 8.2% 的样本会直接丢失思维链(CoT)。而小模型正是端侧部署、低延迟专用模型、draft model、verifier 及大小协同系统的关键载体。因此,如何在 0.5B–3B 规模上兼顾新能力获取与旧能力保留,是一个悬而未决的实际问题。
本文的目标是本文的目标是让 0.5B、1.5B、3B 的 Qwen2.5-Instruct 小模型在持续注入新领域知识(科学、工具调用、医学及四学科混合)的同时,几乎不遗忘既有的指令遵循、常识、知识、代码与数学能力(共 14 个保留基准)。为此作者先回答一个诊断性问题:SDFT 为什么会成功?他们假设“训练目标偏离模型原生分布(OOD)是获取失败与遗忘的主要驱动力”,并用两组受控实验加以检验;在确认 in-distribution 学习是关键、而小模型又无法靠自身完成 in-distribution 重写之后,设计一种小模型可行的替代方案:既能提供高质量监督,又不破坏基座原始分布,还保持低计算成本且免调参(对比之下 SDFT 还需要调 skip-token 超参数)。
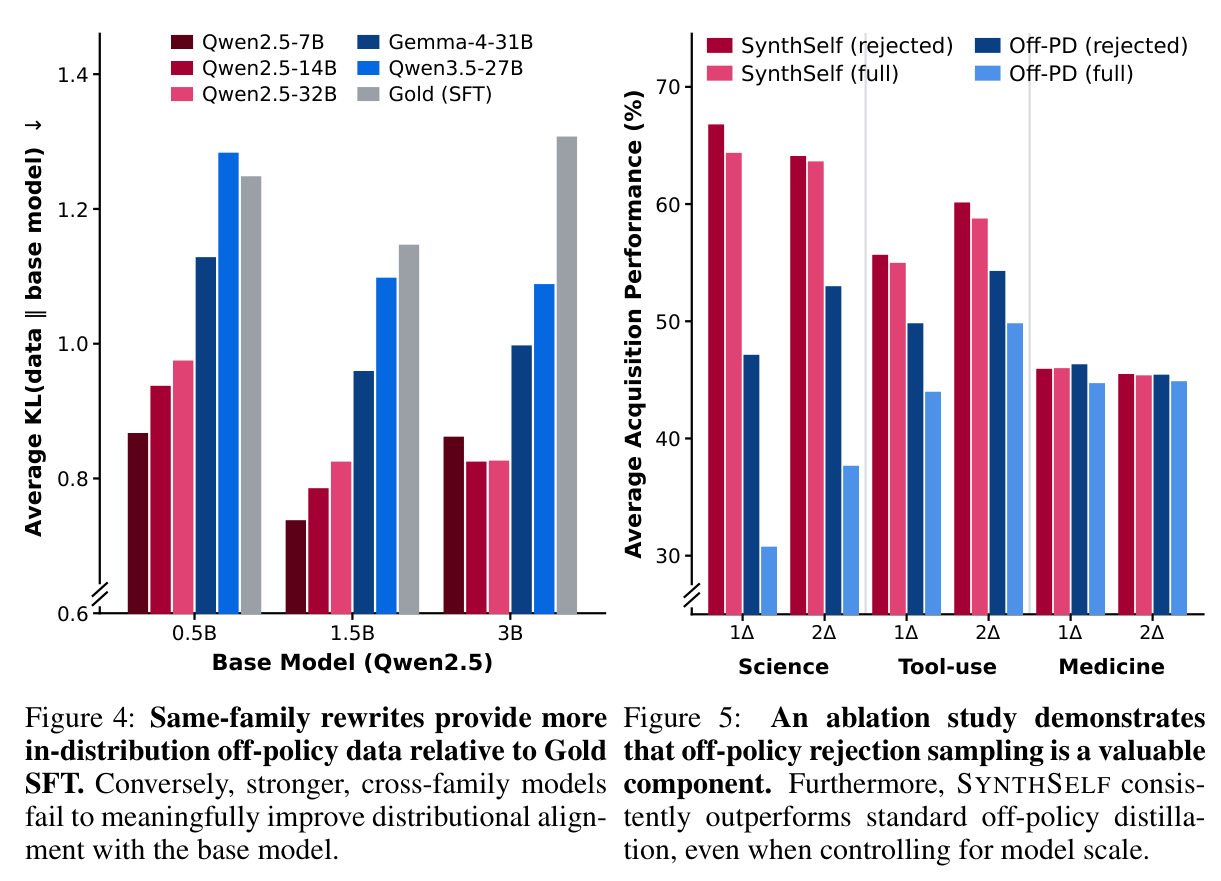
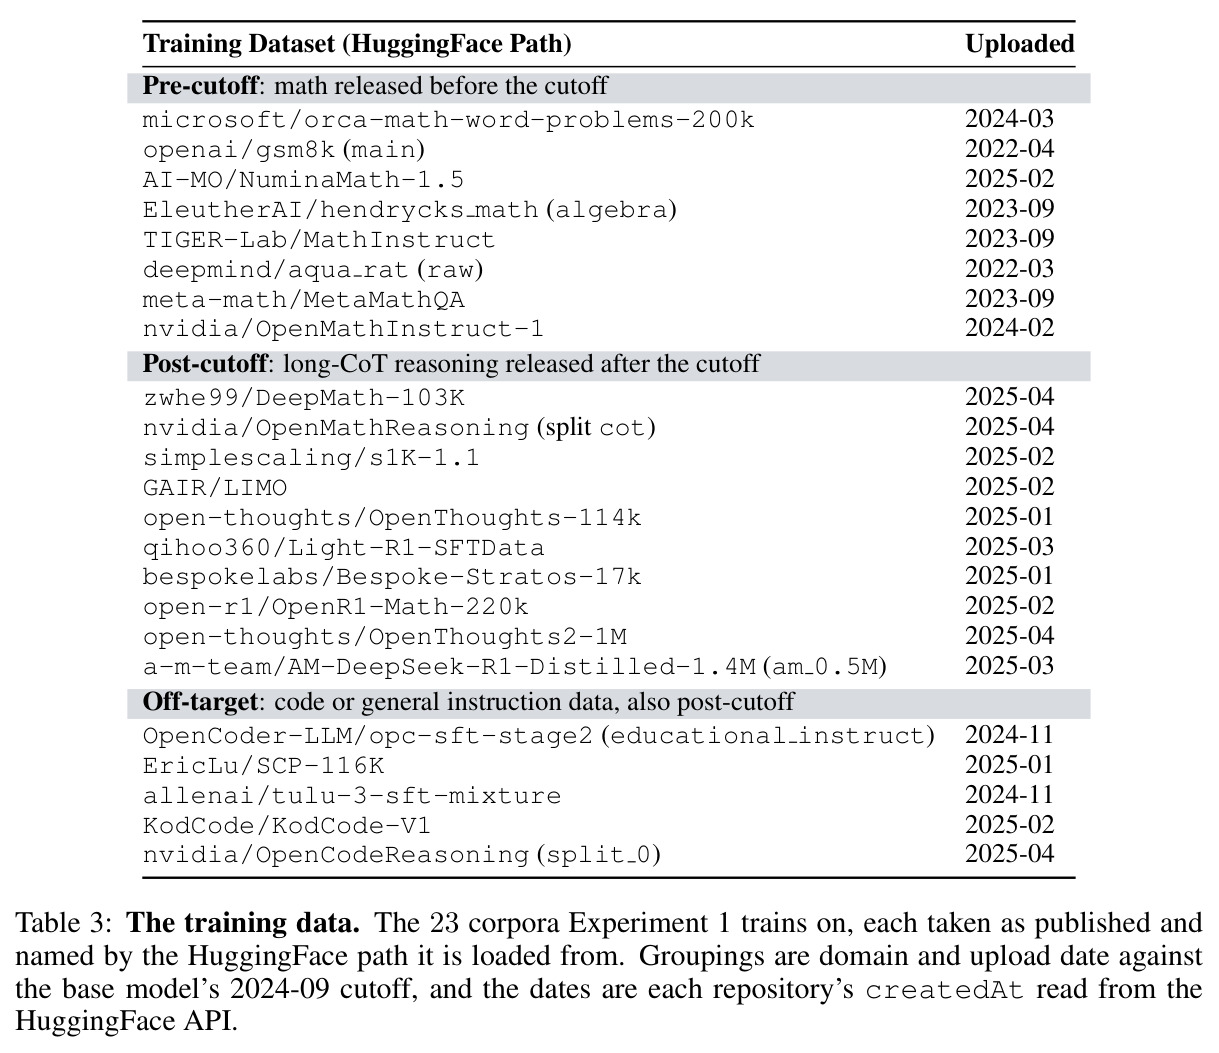
与已有工作不同的是,本文的独特切入分三层。第一,先做归因:通过 23 个数学语料的迁移实验(分布偏移与遗忘的 Spearman $\rho=-0.85$)和同一语料 HI/MID/LO 三档偏移的受控实验,把“分布偏移导致遗忘”从猜想变成可量化的规律,为方法设计提供因果依据。第二,机制外包:SDFT 的本质是让模型自己把 gold 演示“翻译”成自己的话,本文提出把这一隐式重写外包给一个只大一到两档的同家族 aligner,绕开小模型 ICL 能力不足的死结。第三,反常识的取舍:主动放弃 on-policy 监督、改用 off-policy,从而解锁按可验证奖励进行的拒绝采样过滤;并给出形式化的 aligner 选择准则(式 6)——在质量约束与分布约束下选离学生分布最近的教师。由此提炼出反直觉的核心结论:分布匹配比教师强度更重要,“更弱的同家族教师”胜过“更强的跨家族教师”。
核心方法
直觉上,SDFT 有效是因为它把训练目标从外部 gold 文本挪回模型自己的语言流形内,参数更新对既有能力的扰动小;但小模型没有能力完成这种“自我翻译”。SynthSelf 的解法是请一位“学长”:同家族、只大一到两档的模型(学生为 Qwen2.5-0.5B/1.5B/3B 时用 Qwen2.5-7B 或 14B)。技术路线分三步:其一,用固定改写指令(Prompt A:“用你自己的话重写回答,保持相同的最终答案与格式”)让 aligner 对每个 $(x,y)$ 做 greedy 解码,得到确定性改写 $\hat{y}$——保留 gold 答案与格式、但用 aligner 自己的措辞重述推理;其二,用答案抽取器 $a(\cdot)$ 校验 $a(\hat{y})=a(y)$,通过拒绝采样的样本才进入离线数据集 $\hat{D}$;其三,对 $\hat{D}$ 做普通 SFT。形式化地,学生学的是改写点质量 $\delta_{\hat{y}}$,其 KL 损失退化为 NLL(式 4),与 gold SFT(式 5)形式相同,只是目标文本换成了分布对齐的合成重写。整个流程零新增超参数。
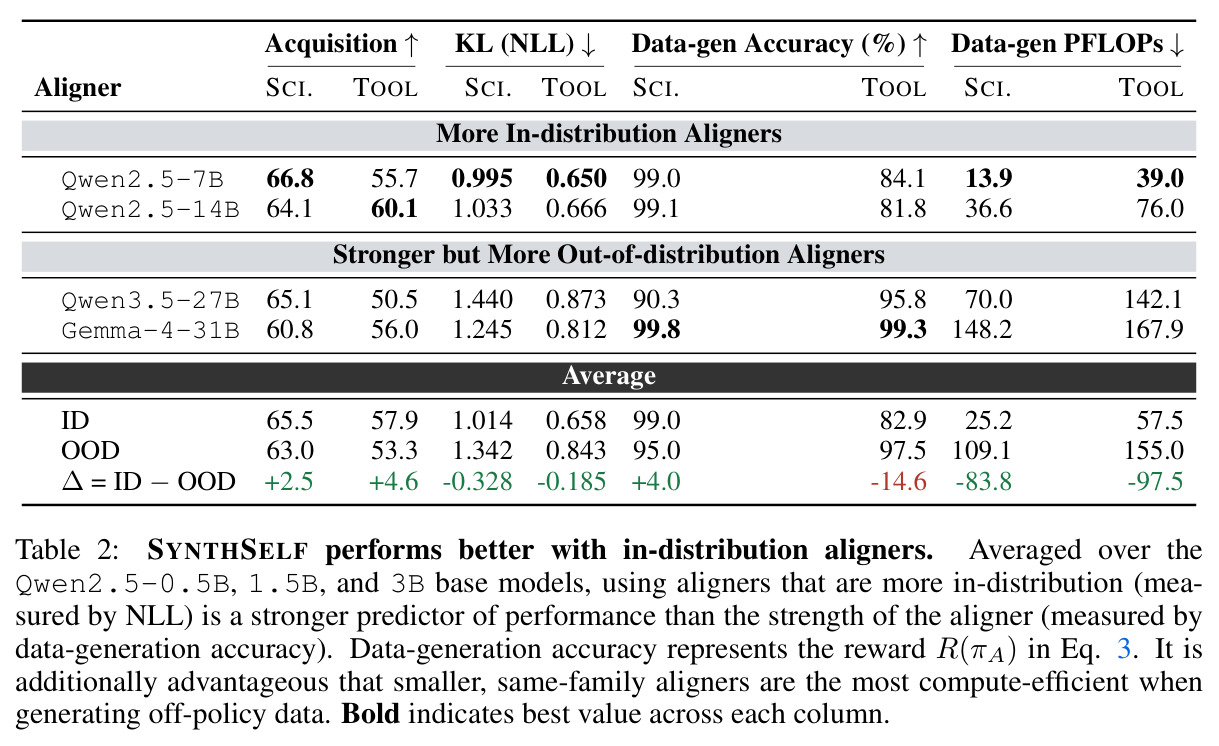
核心创新是把“自蒸馏”里的“自”外包出去,并由此重建质量与对齐的双重保证。与 SDFT 的本质区别有二。第一,监督来源不同:SDFT 的小模型自重写准确率仅 60%、8.2% 样本丢 CoT,监督质量随规模崩塌;SynthSelf 用同家族 aligner 重写,science 域数据准确率升至约 99%,且 off-policy 生成使拒绝采样成为可能,这对数据质量极敏感的小模型至关重要。第二,教师选择哲学不同:本文证明学生视角 NLL 是比教师强度更强的性能预测因子——更强但跨家族的教师(Qwen3.5-27B、Gemma-4-31B)数据准确率高达 90–99%,却引入 1.24–1.44 的 NLL 偏移,获取成绩反而低于同家族 7B/14B(NLL 0.65–1.03)。数学上,式 6 把选教师表述为约束优化:$\pi^*_A=\arg\min \mathcal{L}(\pi_A)$,s.t. $\mathcal{L}(\pi_A)<\mathcal{L}_{gold}$ 且 $\mathcal{R}(\pi_A)>\mathcal{R}(\pi)$,同家族升档恰好同时满足质量、对齐、低成本三个条件。
方法步骤详情
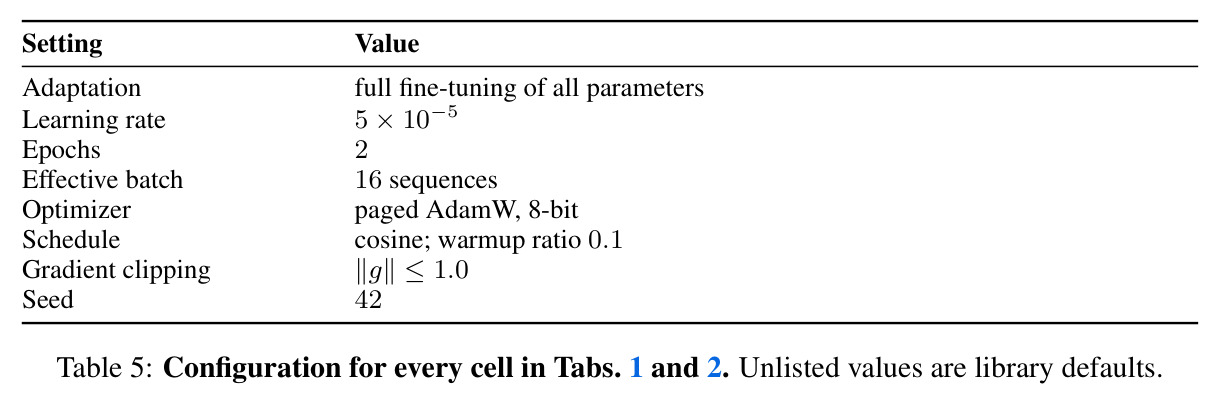
完整流程即 Algorithm 1。输入:演示集 $D_{train}=\{(x_i,y_i)\}$、基座 $\pi_\theta$、aligner $\pi^*_A$、改写指令 $P_{rewrite}$、答案抽取器 $a(\cdot)$。第一步:置空离线数据集 $\hat{D}$。第二步(分布内改写):对每条样本,aligner 以 greedy 解码生成 $\hat{y}_i=\arg\max_y \pi_A(y|P_{rewrite}(x_i,y_i))$,保留 gold 答案与格式、以自身措辞重述推理(附录 D 给出碳-14 半衰期题目的改写示例)。第三步(拒绝采样):若 $a(\hat{y}_i)=a(y_i)$,将 $(x_i,\hat{y}_i)$ 并入 $\hat{D}$,否则丢弃。第四步(off-policy SFT):$\hat{\theta}=\arg\min_\theta \mathbb{E}[-\log\pi_\theta(\hat{y}|x)]$。aligner 选择(式 6):取学生视角 NLL 最低、且同时满足 $\mathcal{L}(\pi_A)<\mathcal{L}_{gold}$ 与 $\mathcal{R}(\pi_A)>\mathcal{R}(\pi)$ 者,实践中 Qwen2.5-7B(1Δ)或 14B(2Δ)即可。训练配置(Table 5):全参微调、学习率 $5\times10^{-5}$、2 epochs、batch 16 序列、paged AdamW 8-bit、cosine 加 0.1 warmup、A100、seed 42。
技术新颖性
技术新颖性体现在四个层面。其一,问题级:首次系统解释 SDFT 的小模型失效机制(自监督质量随规模退化),并把“分布内学习是持续学习关键”上升为定量规律(偏移与遗忘呈 $\rho=-0.85$ 的强相关)。其二,方法级:现有工作要么修改目标函数(DFT、ASFT)但仍在 gold 文本上训练,要么依赖 on-policy 自监督(SDFT、on-PD)而受制于学生自身能力,要么跨家族蒸馏(用同一 aligner 的 Off-/On-PD)分布不对齐;SynthSelf 用“同家族外包重写 + 拒绝采样”首次同时满足高质量监督与分布对齐两个需求。其三,准则级:式 6 把“选哪个教师”形式化为受约束优化问题,并实证 NLL 是比数据生成准确率更强的下游性能预测因子。其四,工程级:免调参(SDFT 需调 skip-token 超参 $T$),且同家族 aligner 使数据生成推理成本降低 62.9%–76.9% FLOPs。
实验结果
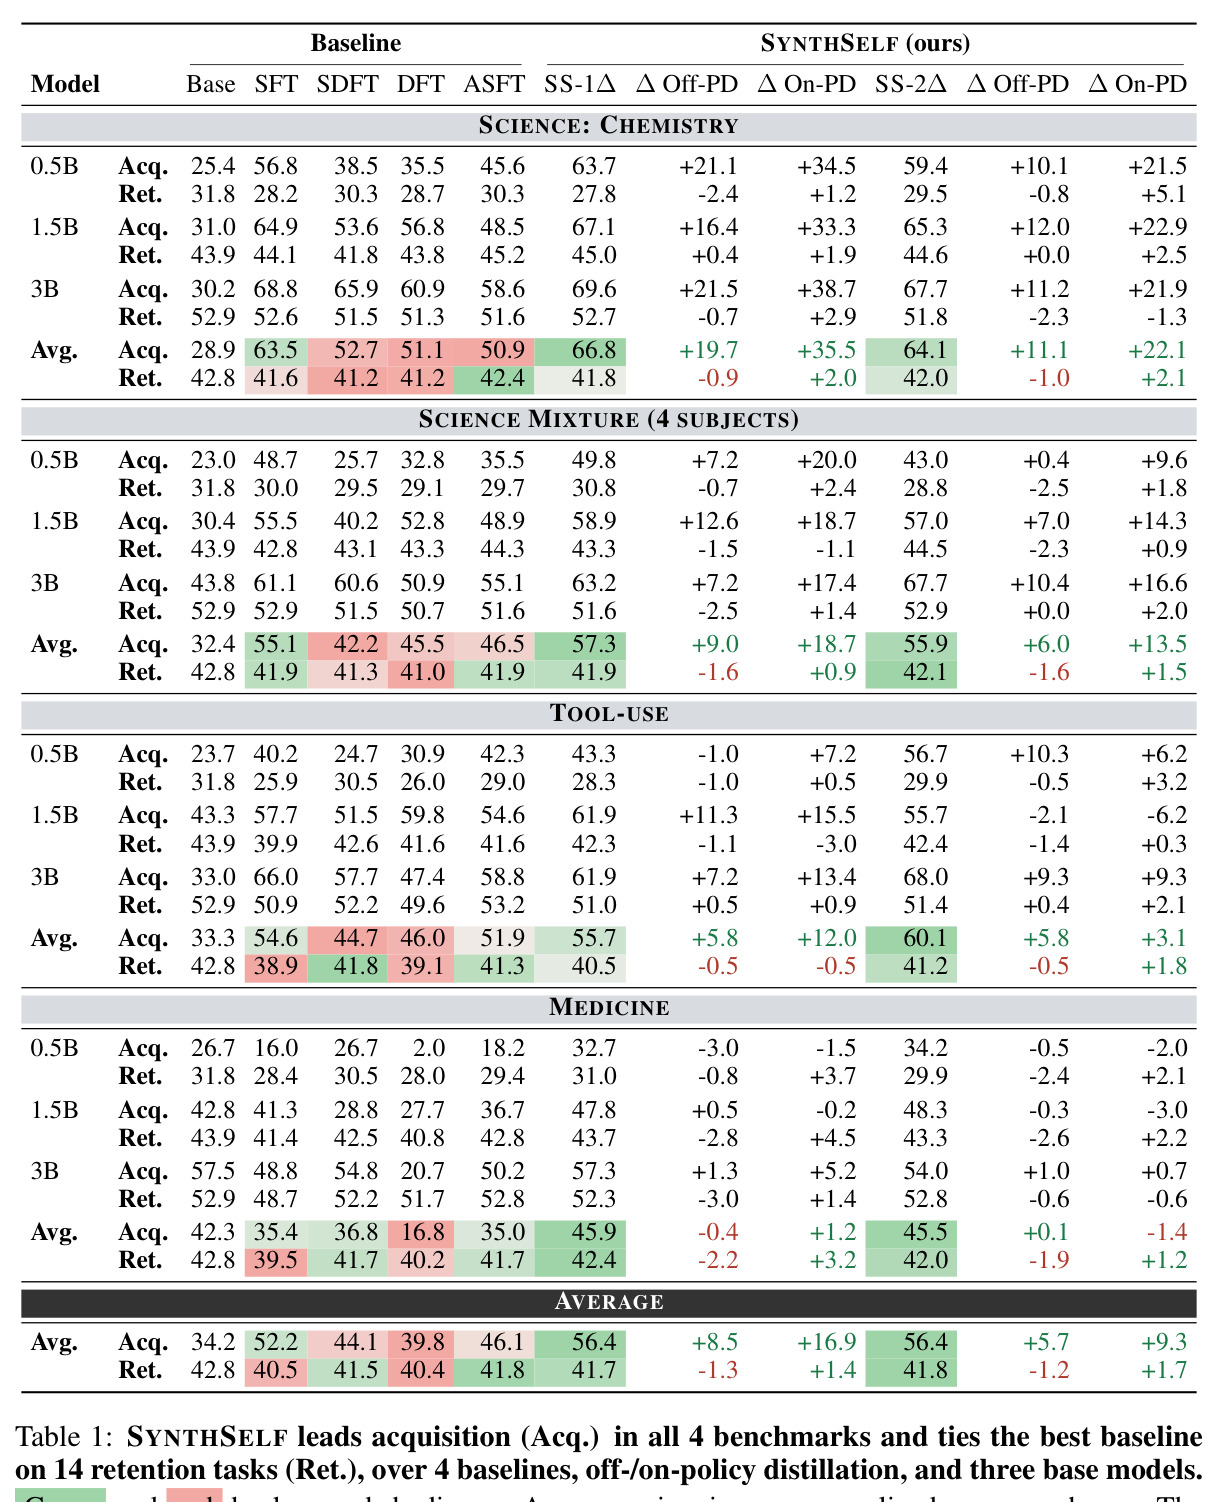
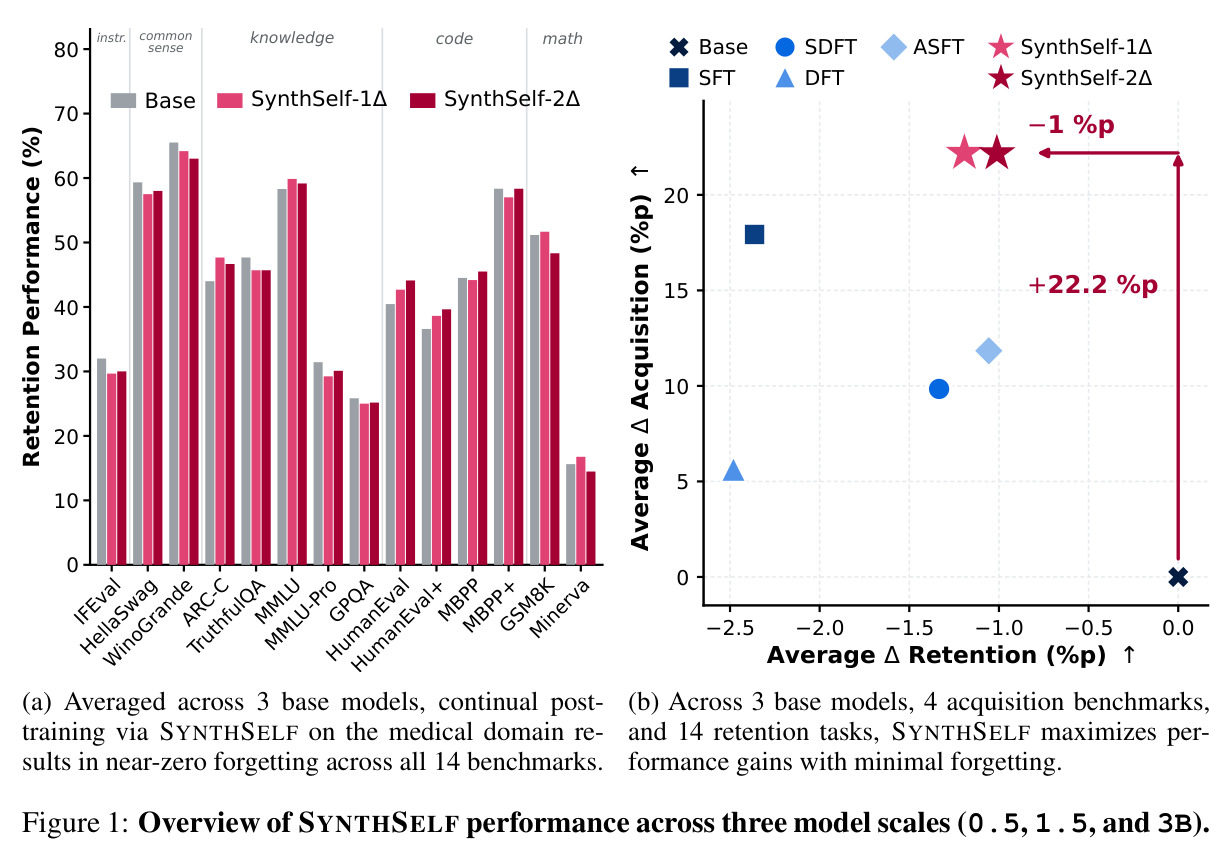
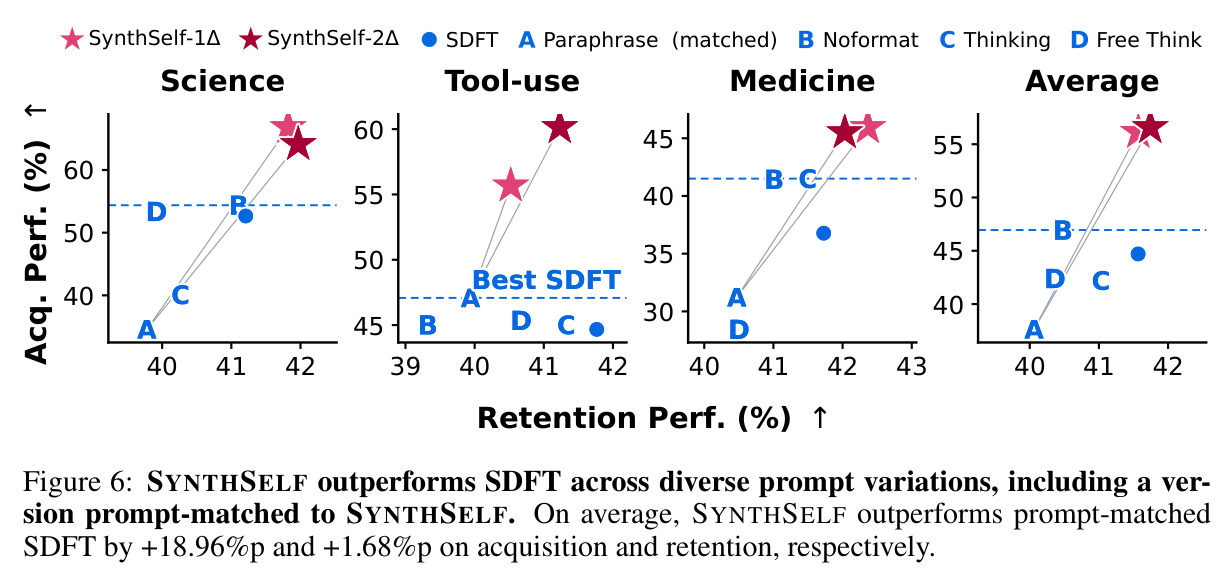
主实验(Table 1)覆盖 4 个获取数据集(SciKnowEval Chemistry L-3、四学科混合、ToolAlpaca、MedMCQA)× 3 个规模(0.5/1.5/3B)× 8 种方法。SynthSelf 平均获取 56.4%,领先 SFT 52.2、SDFT 44.1、DFT 39.8、ASFT 46.1;平均保留 41.7–41.8,与最强基线 ASFT 持平,仅比基座 42.8 低约 1 个点。分域看:Science 域 SS-1Δ 平均 66.8(SFT 63.5),0.5B 上 63.7 远超 SDFT 38.5;混合域 0.5B 上 49.8 vs SDFT 25.7;Tool-use 域 SS-2Δ 平均 60.1(SFT 54.6);Medicine 域是唯一例外,SynthSelf 45.9 与 Off-/On-PD 差距缩小(aligner 已掌握 MedMCQA、演示注入冗余),但仍大幅领先 SFT 35.4 与崩溃的 DFT 16.8(0.5B 仅 2.0)。控制教师规模后,SynthSelf 比 Off-PD 平均 +5.7%p、比 On-PD 最高 +16.9%p,证明收益来自分布对齐的演示注入而非教师规模。Table 2 显示 ID aligner 比更强 OOD aligner 获取高 2.5–4.6%p,且生成成本低 62.9%–76.9% FLOPs;Figure 6 比 prompt 完全匹配的 SDFT 获取 +18.96%p、保留 +1.68%p;Figure 5 确认拒绝采样对两方法一致有益。尽管拒绝采样使训练集缩小(tool-use 减 17.1%),获取仍比 SFT 高 4.2%p,说明收益源于监督质量而非数量。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Science(SciKnowEval Chemistry L-3)获取 | Acquisition (%),3 模型平均 | 66.8(SS-1Δ) | SFT 63.5 / SDFT 52.7 / ASFT 50.9 | +3.3 vs SFT,+14.1 vs SDFT |
| Tool-use(ToolAlpaca)获取 | Acquisition (%),3 模型平均 | 60.1(SS-2Δ) | SFT 54.6 / SDFT 44.7 | +5.5 vs SFT,+15.4 vs SDFT |
| Medicine(MedMCQA)获取 | Acquisition (%),3 模型平均 | 45.9(SS-1Δ) | SFT 35.4 / DFT 16.8 | +10.5 vs SFT,+29.1 vs DFT |
| Science 混合域(0.5B)获取 | Acquisition (%) | 49.8(SS-1Δ) | SFT 48.7 / SDFT 25.7 | +24.1 vs SDFT |
| 保留能力(14 个基准平均) | Retention (%),3 模型平均 | 41.7–41.8 | 基座 42.8 / SFT 40.5 / ASFT 41.8 | 与最佳基线持平,较 SFT +1.2 以上,较基座约 −1.0 |
| 同教师对照(4 设置 × 3 规模平均获取) | Acquisition (%) | 56.4(SynthSelf) | Off-PD 47.9–50.7 / On-PD 39.5–47.1 | +5.7%p ~ +8.5%p vs Off-PD;+9.3%p ~ +16.9%p vs On-PD |
局限与改进
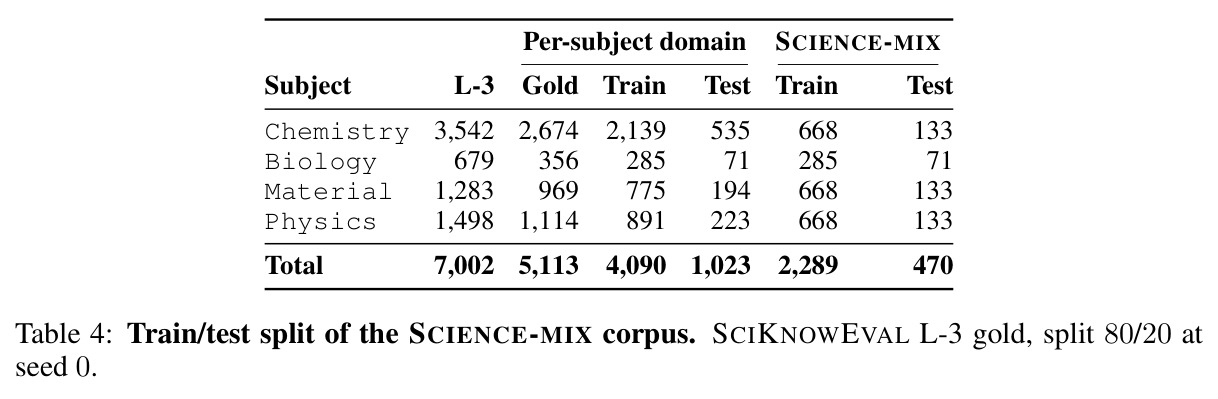
作者承认的局限:方法依赖存在更大的同家族 aligner(幸运的是 Qwen、Llama 3、Gemma、OLMo 2 等主流开源家族都提供规模谱系,且小模型常由大模型蒸馏而来);Medicine 域收益有限,因 aligner 已内化数据知识、演示注入冗余;方法只验证了单次任务注入。我补充的观察:第一,拒绝采样依赖可验证答案(多选、代码、数学的精确匹配),无法直接用于开放式生成任务;第二,实验仅在 Qwen2.5 一个家族上完成,同家族优势可能部分来自共享 tokenizer 与聊天模板,跨家族推广性未验证;第三,“保留”只在单任务注入后测量,多任务顺序持续学习下的累积遗忘未知;第四,主表每个单元格只用单一 seed 42,无方差报告;第五,Science 混合域测试集仅 470 题、单科仅 71–535 题,统计功效有限;第六,保留仍比基座低约 1.0–1.1 个点,并非真正零遗忘(Figure 1a 的“接近零遗忘”仅限医学域展示)。
独立分析的弱点
独立分析的弱点及改进方向。其一,同家族假设是硬约束:若基座没有更大的同家族兄弟版本(部分自研或深度精调模型),方法不可直接套用。改进:按作者提示把基座自己的答案放进上下文,引导跨家族 aligner 做分布内改写;或给跨家族教师挂轻量 LoRA 适配器、在基座分布上正则化后再改写。其二,可验证奖励瓶颈:开放域任务(写作、多轮对话、Agent 轨迹)没有 gold answer 可精确匹配,拒绝采样失效。改进:用 reward model、基座自评审或执行反馈替代精确匹配。其三,greedy 解码只产生单一改写,覆盖与多样性不足,且可能传播 aligner 的系统性措辞偏差。改进:按作者建议扩展 pass@k 用推理算力换覆盖,或按学生 NLL 主动挑选改写。其四,单任务注入范式:多任务顺序持续学习下反复“重写-SFT”的误差累积与任务干扰未被研究。改进:结合 LoRA 参数隔离或向基座分布做锚定回放。其五,Medicine 域经验表明 aligner 已内化领域知识时演示注入趋于冗余,方法收益边界尚缺理论刻画。
未来方向
作者提出的方向:适配 out-of-family aligner 使其产生 in-distribution 监督,一个有希望的方案是把基座模型自己的答案放入上下文、配合恰当 prompt 引导分布内改写;同时可利用同家族蒸馏谱系(Qwen、OLMo 2、Llama 3、Gemma 等均满足条件)低成本落地。基于本文成果可延伸:第一,把“分布内演示注入”推广到 RLHF/DPO 的持续偏好学习与 Agent 经验的在线积累;第二,多任务顺序持续学习——研究改写链的误差传播,设计锚定基座分布的回放或正则项;第三,用可学习 reward 替代精确匹配拒绝采样,把方法扩展到开放域;第四,从理论上解释为何学生视角 NLL 比 aligner 强度更能预测下游性能,给出 aligner 选择的缩放律;第五,与模型合并、模块化 LoRA、weight averaging 等遗忘缓解手段正交组合;第六,系统消融 pass@k 缩放下推理算力与最终性能的 Pareto 前沿。
复现评估
复现条件较好。未附官方代码仓库,但方法仅是离线生成加标准 SFT(Algorithm 1 逻辑简单,几十行可实现),无需专有框架。数据全部公开:Table 3 列出 23 个训练语料的 HuggingFace path 与上传日期;评测用 SciKnowEval、ToolAlpaca、MedMCQA 及 IFEval、HellaSwag、MMLU-Pro、HumanEval/+、GPQA、MBPP/+、GSM8K、Minerva 等 14 个公开基准;完整超参数在 Table 5,全部改写 prompt 原文在附录 A,定性示例在附录 D。算力:A100 节点训练 0.5B–3B 学生,aligner 离线推理约 13.9–76 PFLOPs(7B/14B),拥有数张 A100 的学术实验室可负担。注意点:SciKnowEval 的思维链演示由 GPT-4o(化学,沿用 SDFT 发布数据)与 gpt-5.6-luna(其余三学科)生成,复现者需重新生成或获取;主表为单 seed 42、无方差报告;MedMCQA 结果可能受 aligner 预训练数据污染影响。总体复现难度:中等偏低。
论文图表
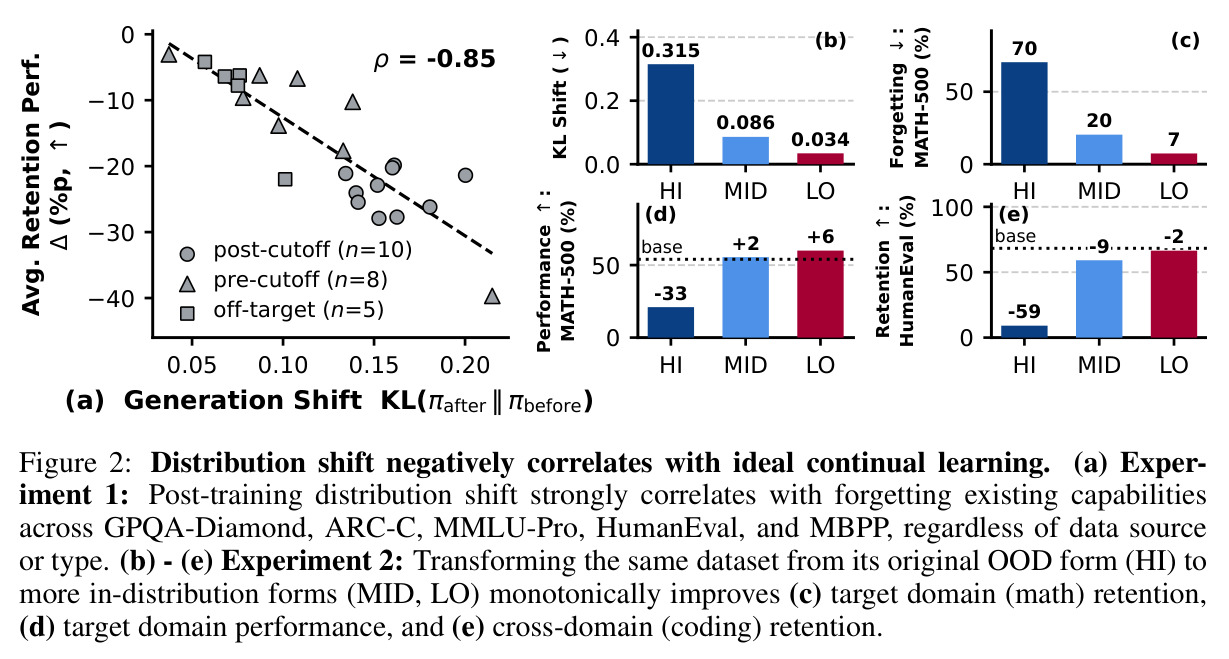
两组归因实验。(a) 实验 1:对 Qwen2.5-3B-Instruct 用 23 个规模对齐(各 2.5M completion tokens)的数学语料分别微调,微调前后策略的 $D_{KL}(\pi_{after}\|\pi_{before})$ 与 5 个非数学基准(GPQA-Diamond、ARC-C、MMLU-Pro、HumanEval、MBPP)的平均遗忘呈强负相关,Spearman $\rho=-0.85$,且该规律不受数据是 pre-cutoff、post-cutoff 还是 off-target 的影响。(b)-(e) 实验 2:固定 OpenR1-Math-220k 语料与 prompt,构造 HI(完整 R1 长 CoT 轨迹)/ MID(仅最终解答)/ LO(模型自身验证正确的解答,经自拒绝采样筛选)三档偏移目标,策略 KL 偏移约按 0.315/0.086/0.034 单调下降;随偏移减小,(c) 数学域保留、(d) 目标域成绩、(e) 跨域编码保留均单调改善。
这是全文因果论证的基石,把“in-distribution 学习是持续学习关键”从直觉变成可量化的实验规律,直接决定了后续方法设计。
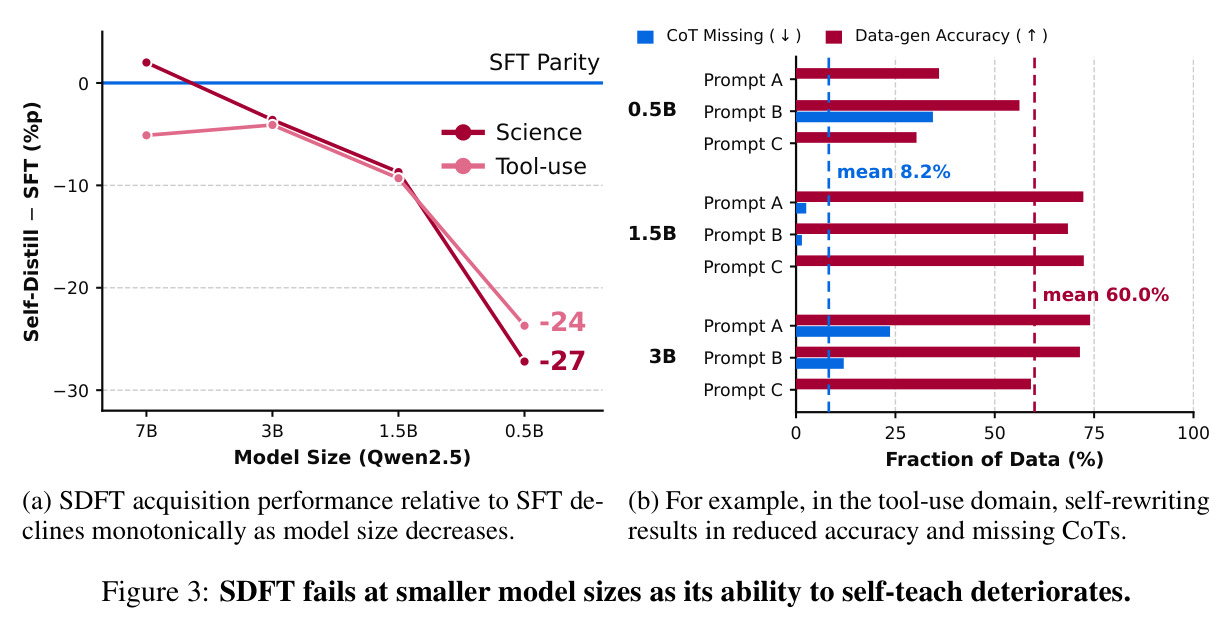
(a) 在 Science、Tool-use 等域上,SDFT 相对 SFT 的获取性能差随模型规模从 7B 降到 0.5B 单调下滑,在 0.5B/1.5B 上跌至 −24 到 −27 个百分点的负值区间,说明小模型上 SDFT 已不如直接 SFT。(b) 用离线数据集近似评估 on-policy 教师质量:在 tool-use 域,0.5B/1.5B/3B 模型在三种改写 prompt(A/B/C)下的自重写平均答案准确率仅 60%,且平均 8.2% 的样本完全丢失 CoT 推理。
精确定位 SDFT 在小模型失效的根因是自监督质量崩塌而非目标函数问题,是“把重写外包给更大同家族模型”这一设计决策的直接动机。
在 Science、Tool-use、Medicine 三域、1Δ 与 2Δ 两档 aligner 上,对比 SynthSelf(完整版,含拒绝采样)与 SynthSelf(去除过滤)、Off-PD(完整版)与 Off-PD(去除过滤)的获取性能。结果显示:启用拒绝采样后两种方法成绩均一致提升(例如 SynthSelf 在多数设置提升数个百分点),且 SynthSelf(完整版)在所有设置下始终高于 Off-PD(完整版)。
隔离“拒绝采样”这一组件的独立贡献,证明 off-policy 路线的价值不只是逼近 SDFT,而是过滤机制本身对质量敏感的小模型必要且有效。