少训练多学习:不确定性引导的渐进收缩实现高效推理后训练 Learning More by Training Less: Uncertainty-Guided Progressive Contraction for Efficient Reasoning Post-Training
用过程级不确定性两阶段收缩推理监督,0.22%训练预算即可追平甚至超越全量SFT。
前置知识
思维链蒸馏(CoT Distillation / SFT)
让强教师模型为每个问题生成分步推理轨迹 $\tau=(s_1,\ldots,s_m,\hat{a})$,经标准答案校验过滤后,用这些轨迹对学生模型做监督微调(SFT),训练目标是对响应token的负对数似然,使学生模仿教师的逐步推理行为。这是当前推理后训练最主流的范式,DeepSeek-R1 等模型的冷启动阶段都依赖它。
本文研究的正是'蒸馏语料该怎么选、怎么用':所有压缩与路由操作都施加在CoT监督数据和SFT优化预算上,不了解这一范式就无法理解方法的问题定位与效率声明。
蒙特卡洛 rollout(前缀条件延续采样)
在推理轨迹的某个中间前缀状态 $h_{i,t}$ 处,冻结已生成内容,让模型独立采样 $K$ 条续写,各自走到最终答案并用标准答案判分。重复结果服从 $\mathrm{Bernoulli}(p)$ 分布,$p$ 即'从该状态出发最终答对的可达率',用 $K$ 次成功频率 $\hat{p}_{i,t}=K^{-1}\sum_k Z^{(k)}_{i,t}$ 估计。
这是本文不确定性度量的数据来源:蒙特卡洛推理树(MCRT)正是在每个中间状态做 $K$ 次 rollout 构建的,理解 rollout 的统计性质才能理解不确定性估计为何可靠、代价在哪里。
过程级不确定性(Bernoulli 归一化方差)
对每个中间状态定义 $U_{i,t}=4p_{i,t}(1-p_{i,t})\in[0,1]$,即Bernoulli分布的归一化方差。它有直观解释:等于从同一状态出发的两条独立续写'最终对错不一致'概率的2倍。$U$ 高说明该状态是'推理分叉点'——貌似可行的延续会走向成败两极,而非单纯困难或错误的状态。
这是全文的核心信号:教师侧语料收缩完全由它驱动,作者还用统计证明它与终端置信度/正确率显著不一致(30.5%的正确CoT落入高不确定尾部),是方法立论之本。
LoRA(低秩适配微调)
冻结原模型全部权重,只在每层注入低秩分解矩阵 $\Delta W=BA$(秩 $r\ll d$)作为可训练参数,大幅降低显存与算力开销,是参数高效微调的代表方法。本文所有学生SFT均基于LoRA实现,在单台2×H200服务器上即可完成全部训练。
论文的训练配置与GPU开销数字(如8.47小时全量SFT vs 0.01小时)都建立在LoRA设定之上,复现和评估其效率声明时必须知道这不是全参数SFT。
研究动机
推理后训练的主流做法是用越来越大的CoT语料做SFT,但数据规模扩张带来的成本增长远超性能收益,边际递减明显。现有改进分两条路:一是把监督'造得更好'(更强教师生成、轨迹增广,如STaR类自举),二是在固定语料上按正确率、难度或静态质量分做过滤与路由(如DeepDistill、LESS、RHO-Loss)。两条路线都做不到极端的训练效率:前者仍要全量训练,后者的信号(终端对错、难度、质量)无法定位真正的学习价值所在。更关键的是,终端信号会掩盖脆弱的中间推理——作者统计发现,即使只取教师置信度前5%的CoT,仍有18.1%落在全局不确定性前10%的尾部;而30.5%答案正确的CoT同样落入该尾部。换言之,'看起来对且自信'的轨迹里藏着大量摇摆不定的中间状态,把它们与真正稳健的样本同等对待,浪费了大量优化预算。
本文的目标是本文要回答一个极简的问题:推理监督到底能压缩到什么程度而不牺牲能力?具体目标是把学生侧SFT优化预算压到全量3-epoch训练的1%以下(最好低于0.3%),同时保持、并在多数基准上超过全量SFT的推理性能。为此必须把'监督构造'与'下游训练分配'耦合起来:先暴露学习价值藏在哪里(哪些轨迹在教师推理空间中信息量最大),再随学生训练状态演化,把优化逐步集中到'学生尚未掌握'的轨迹上。同时方法必须只依赖可观察行为——文本前缀、采样续写、可验证结果——以兼容闭源API教师和弱教师等实际受限场景。
与已有工作不同的是,独特切入有三层。第一,视角上:把每条教师CoT不当作'一次已实现的推理路径',而当作教师推理空间中的'主干'(backbone),在其每个中间状态周围用MC延续采样构建推理树(MCRT),暴露过程级不确定性——即'推理分叉点'(reasoning forks)处的结果不稳定性,这是区别于正确率/难度/质量等终端信号的全新监督价值信号。第二,结构上:提出两阶段渐进收缩——教师侧不确定性收缩与学生感知的在线路由解耦,前者学生无关、一次构建可跨模型族复用,后者随学生状态在线适应,二者沿互补的轴收敛。第三,工程上:全程只用可验证行为,无需logits、隐状态或梯度访问,因此同一框架可直接迁移到DeepSeek-V4-Pro、Kimi-K2.6等API黑盒教师,甚至实现1.7B弱教师提升14B强学生的弱到强场景。
核心方法
直觉:推理是非均匀的,一条解法往往取决于少数几个'分叉'中间状态;含分叉多的轨迹信息量大,而学生还没学会的轨迹才值得继续花算力。技术路线分两段。第一段(教师侧收缩):对每条经答案校验的正确CoT,在每个中间前缀状态 $h_{i,t}=(x_i,s_{i,1:t})$ 处采样 $K$ 条独立续写,估计答对可达率 $\hat{p}_{i,t}$,计算归一化Bernoulli方差 $\hat{U}_{i,t}=4\hat{p}_{i,t}(1-\hat{p}_{i,t})$,对整条轨迹取长度归一均值得到过程不确定性 $\bar{U}_i$,作为教师侧价值分 $q_i^T$;保留分数最高的top-$\rho$比例构成候选池 $P_\rho=\mathrm{Top}_\rho(C;q^T)$。第二段(学生侧收缩):先用一个'探测epoch'在 $P_\rho$ 上做一遍前向,计算每条轨迹的长度归一化响应损失 $\ell_i$,挑出损失最大的 $M$ 条构成激活集 $H_M$,之后两个epoch只在 $H_M$ 上训练。总预算 $B=(\lfloor\rho N_c\rfloor+2M)/(3N)$,实践中低于全量SFT的0.74%,最低到0.22%。
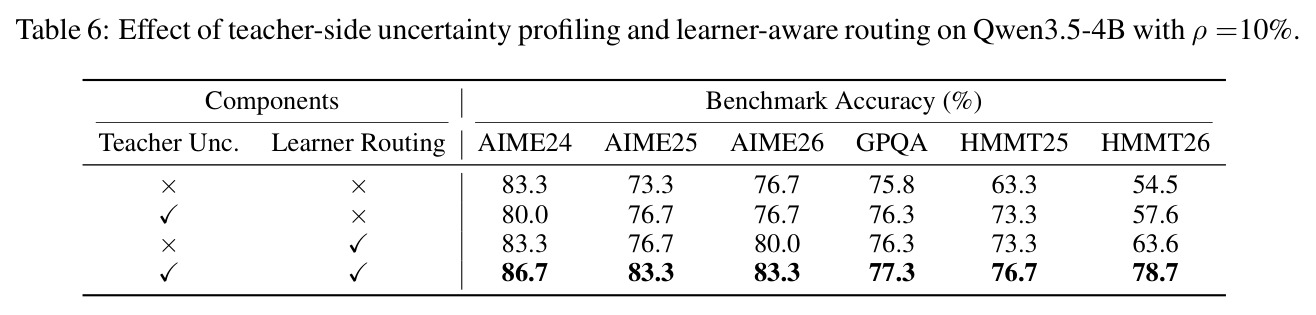
核心创新是不确定性引导的渐进收缩。信号层面:用 $U_{i,t}=4p_{i,t}(1-p_{i,t})$ 度量过程不确定性,作者证明它等价于 $U_{i,t}=2\cdot\Pr[Z^{(1)}_{i,t}\neq Z^{(2)}_{i,t}\mid h_{i,t}]$,即两条独立续写最终对错相异的概率——它标记的是'貌似可行的延续会走向成败两极'的分叉状态,而不是单纯困难或错误的状态。这解释了为何高置信、高正确率的CoT仍可能藏着脆弱推理(前5%自信者中18.1%、正确者中30.5%落入高不确定尾部)。结构层面:与已有'训练前一次性静态选数据'不同,收缩是渐进的——教师侧收缩保留学生无关的信息结构,学生侧收缩再按响应损失把优化集中到'当前学生尚未掌握'的轨迹上;Table 6显示两个信号组合的增益远超任一单组件,证明它们确实互补。行为化度量使整套流程对黑盒API教师即插即用,这是与需要模型内部访问的过程奖励模型方法的本质区别。
方法步骤详情
完整流水线六步。(1) 轨迹生成:教师 $T$ 对每个问题 $x_i$ 生成结构化CoT $\tau_i=(s_{i,1},\ldots,s_{i,m_i},\hat{a}_i)$,每个 $s_{i,t}$ 是一个语义连贯的推理步;经答案校验保留正确轨迹得语料 $C$($N_c$ 条)。(2) MCRT剖析:把 $\tau_i$ 当主干,对每个前缀状态 $h_{i,t}=(x_i,s_{i,1:t})$ 独立采样 $K$ 条续写 $R^{(k)}_{i,t}\sim\pi_T(\cdot\mid h_{i,t})$,判分 $Z^{(k)}_{i,t}=\mathbb{I}[\hat{a}^{(k)}_{i,t}=a_i]$,估计 $\hat{p}_{i,t}=K^{-1}\sum_k Z^{(k)}_{i,t}$,再算 $\hat{U}_{i,t}=4\hat{p}_{i,t}(1-\hat{p}_{i,t})$。(3) 教师侧收缩:轨迹均值 $\bar{U}_i=\frac{1}{m_i}\sum_t\hat{U}_{i,t}$ 作为 $q_i^T$,取top-$\rho$ 得池 $P_\rho$(式5);此池学生无关,可跨学生家族复用。(4) 探测epoch:学生在 $P_\rho$ 上过一遍数据,只前向不更新,记录每条轨迹响应token的长度归一化负对数似然 $q_i^S=\ell_i=-\frac{1}{|R_i|}\sum_{j\in R_i}\log p_\theta(\tau_{i,j}\mid x_i,\tau_{i,<j})$(式6)。(5) 学习者感知路由:取损失最大的 $M$ 条为 $H_M=\arg\max_{H\subseteq P_\rho,|H|=M}\sum_{i\in H}\ell_i$(式7),此后两个epoch只在 $H_M$ 上做SFT,路由分数随训练在线更新以适应学生状态变化。(6) 预算核算:总曝光 $\lfloor\rho N_c\rfloor+2M$ 除以全量 $3N$ 得 $B$(式8)。标准'3遍全量'被改写为'1遍压缩池+2遍激活集'。
技术新颖性
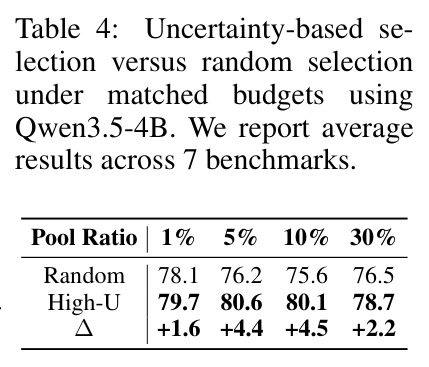
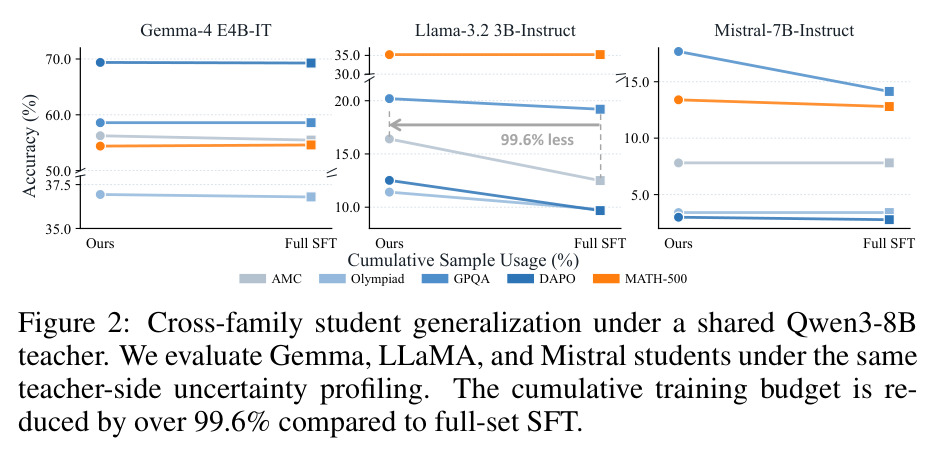
新颖性有四点。其一,监督价值信号新:现有蒸馏数据选择依赖正确性过滤、难度分级(DeepDistill)、质量评分或梯度/影响函数(LESS、RHO-Loss),本文首次把'过程级不确定性的Bernoulli方差'用作轨迹级价值分,且证明该信号与正确率正交——Table 4中匹配预算下高不确定性选择比随机选择高1.6至4.5个百分点。其二,无内部访问的过程探针:与需要logits/隐状态的PRM类方法(如RLCM的置信度过程监督)不同,MCRT只需前缀采样加答案判分,直接适用于闭源API教师(Fig 3,最高提升13.4%),也天然支持教师弱于学生的设定。其三,两阶段解耦:教师剖析学生无关、一次构建可在Qwen/Gemma/Llama/Mistral四个家族间共享(Fig 2),把昂贵的剖析成本摊薄;学习者侧路由只用普通前向损失在线适应,无需辅助模型。其四,压缩极限新:把SFT预算压到0.22%至1.91%仍能持平或超越全量训练,远超以往数据选择工作通常几十个百分点的剪枝幅度,把'少即是多'推到了极端。
实验结果
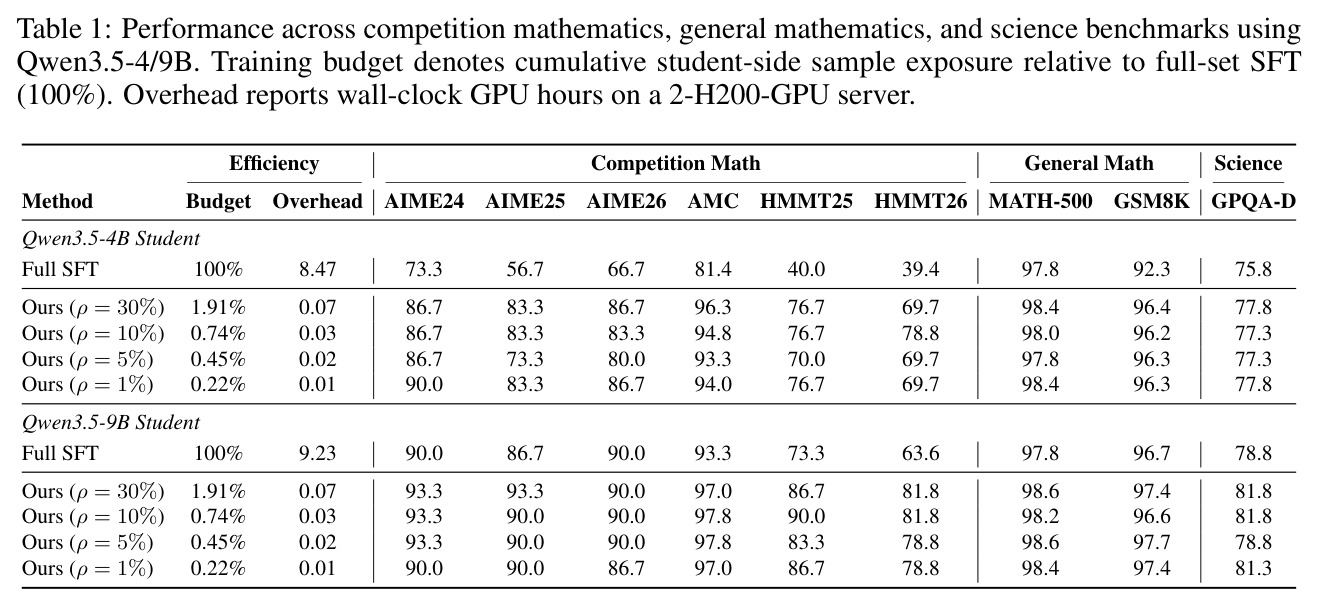
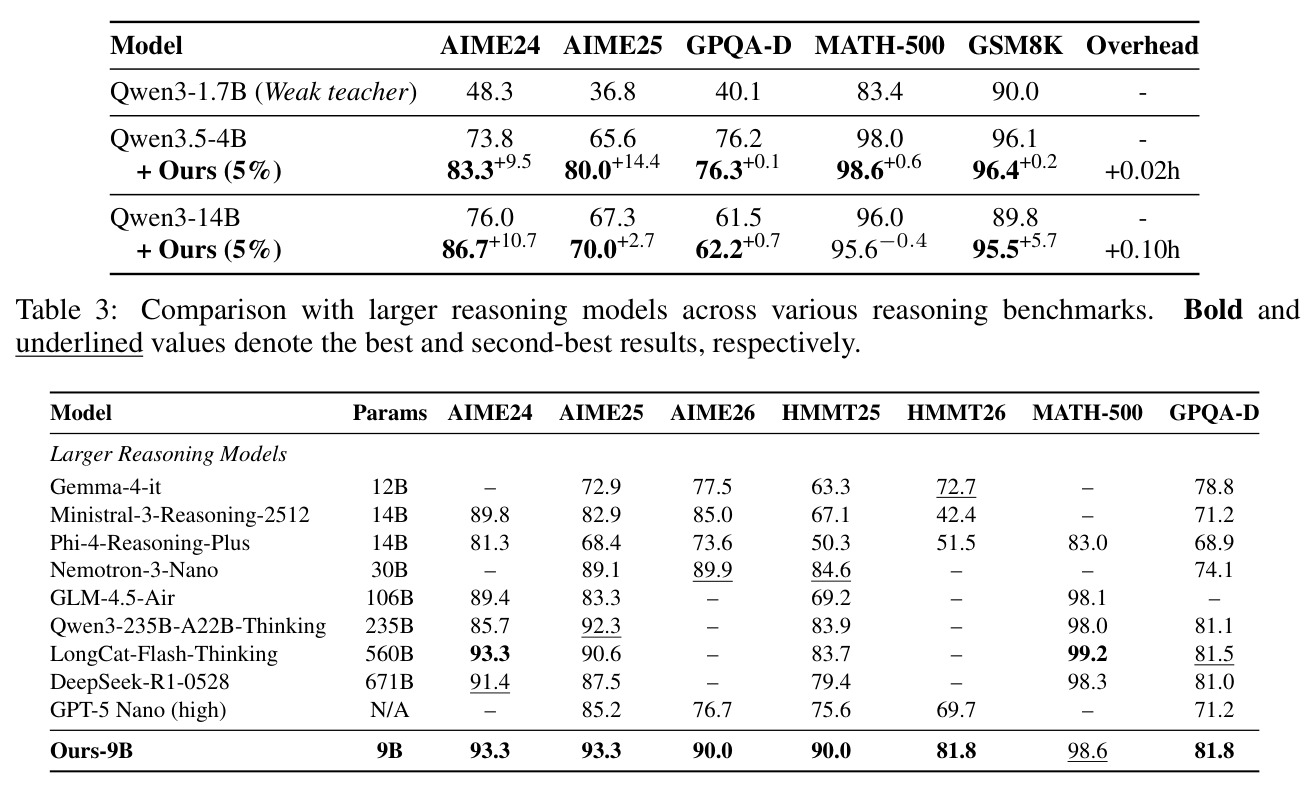
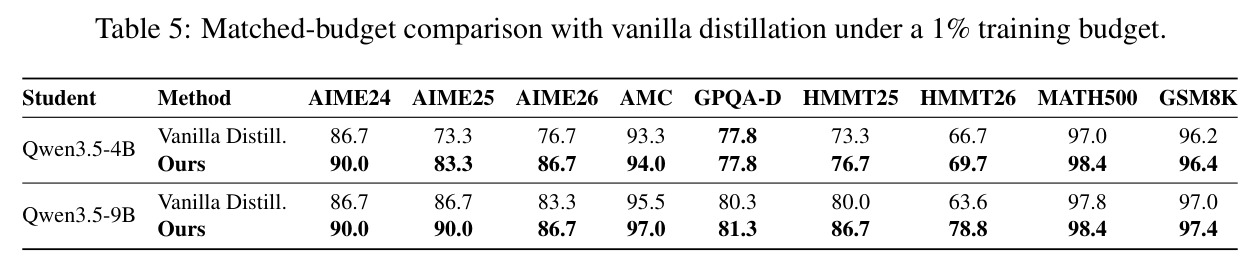
主实验(Table 1):以Qwen3-8B为教师、DAPO-17K为训练数据,Qwen3.5-4B学生全量SFT需100%预算(8.47 GPU时),AIME24/25/26为73.3/56.7/66.7、HMMT25仅40.0;本文ρ=1%时预算仅0.22%(0.01 GPU时,>800×墙钟加速),AIME24/25/26升至90.0/83.3/86.7,AMC 81.4→94.0,HMMT25 40.0→76.7,HMMT26 39.4→69.7,MATH-500 98.4,GSM8K 96.3,GPQA-D 77.8,几乎所有基准持平或大幅超越。9B学生同样如此:ρ=30%时预算1.91%(0.07 GPU时),AIME24/25达93.3/93.3、HMMT25 90.0、HMMT26 63.6→81.8、GPQA-D 81.8,全面高于全量SFT。跨家族(Fig 2):同一Qwen3-8B不确定性画像复用于Gemma-4-E4B、Llama-3.2-3B、Mistral-7B三个异构学生,预算约0.45%(>200×加速,削减>99.6%),性能均持平或提升。弱到强(Table 2):1.7B弱教师(自身AIME24仅48.3)+ρ=5%使Qwen3.5-4B的AIME25提升14.4(65.6→80.0)、AIME24提升9.5;使Qwen3-14B的AIME24提升10.7、GSM8K提升5.7,学生侧开销≤0.1 GPU时。黑盒教师(Fig 3):DeepSeek-V4-Pro配4B学生、Kimi-K2.6配9B学生在Nemotron-Math前1000题上,较普通蒸馏最高提升13.4%,且估计器零修改。对标大模型(Table 3):9B学生AIME24 93.3、HMMT25 90.0、GPQA-D 81.8,与30B Nemotron-3-Nano、106B GLM-4.5-Air、235B Qwen3-235B-A22B、560B LongCat-Flash、671B DeepSeek-R1-0528相当甚至多数指标更优。消融:Table 5在严格匹配1%预算时比vanilla蒸馏平均高3.6%(4B)/4.0%(9B),证明增益来自预算分配而非数据量;Table 4显示高不确定性选择比随机选择高1.6~+4.5;Table 6显示教师不确定性与学习者路由单独均有效、组合最佳(如HMMT26 54.5→78.7);优化轨迹分析显示本文150步内超越全量SFT,而全量SFT需约1500步才达峰值,优化步数少10×。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 竞赛数学+通用推理(Qwen3.5-4B学生,DAPO-17K) | 各基准准确率 / 训练预算 / GPU小时 | Ours ρ=1%:AIME24 90.0、AIME25 83.3、AIME26 86.7、HMMT25 76.7、HMMT26 69.7,预算0.22%(0.01 GPU时) | Full SFT:AIME24 73.3、AIME25 56.7、AIME26 66.7、HMMT25 40.0、HMMT26 39.4,预算100%(8.47 GPU时) | AIME24 +16.7、AIME25 +26.6、HMMT25 +36.7(百分点),训练时间约800×加速 |
| 竞赛数学+通用推理(Qwen3.5-9B学生) | 各基准准确率 / 训练预算 | Ours ρ=30%:AIME24 93.3、AIME25 93.3、HMMT25 90.0、HMMT26 81.8、GPQA-D 81.8,预算1.91% | Full SFT:AIME24 90.0、AIME25 86.7、HMMT25 73.3、HMMT26 63.6、GPQA-D 78.8,预算100% | AIME25 +6.6、HMMT25 +16.7、HMMT26 +18.2、GPQA-D +3.0,预算降至1.91% |
| 弱到强迁移(Qwen3-1.7B弱教师 → Qwen3.5-4B学生,ρ=5%) | AIME25准确率 | 80.0(+14.4),额外开销仅+0.02 GPU时 | Qwen3.5-4B基线65.6;弱教师Qwen3-1.7B自身AIME25仅36.8 | +14.4个百分点,教师远弱于学生仍能有效指导 |
| 匹配预算对照(1%预算 vs vanilla CoT蒸馏) | 9基准平均准确率 | Qwen3.5-4B平均+3.6、Qwen3.5-9B平均+4.0(如4B AIME26 86.7 vs 76.7、AIME25 83.3 vs 73.3) | 同预算vanilla蒸馏(普通教师CoT全量可见、随机选子集) | 预算严格一致,增益纯粹来自更好的优化预算分配 |
| 跨家族学生泛化(Gemma-4-E4B / Llama-3.2-3B / Mistral-7B) | 整体推理性能 / 训练预算 | 三个家族均持平或提升,预算≈0.45%,共享同一Qwen3-8B教师画像 | 各家族全量SFT(100%预算) | 预算削减>99.6%(>200×加速),教师画像跨家族零成本复用 |
| 对标大规模推理模型(Ours-9B) | AIME24 / HMMT25 / GPQA-D | 93.3 / 90.0 / 81.8 | DeepSeek-R1-0528(671B):91.4/79.4/81.0;Qwen3-235B-A22B-Thinking:85.7/83.9/81.1;Nemotron-3-Nano(30B):–/84.6/74.1 | 9B模型达到或超越30B–671B级专用水推理模型的多数指标 |
局限与改进
作者在正文中几乎未明确承认局限,主要靠留白体现:效率分析只统计学生侧开销(Table 1的Overhead为2×H200墙钟小时),教师侧MCRT剖析的成本——每条轨迹每个中间状态都要K次rollout——未单独报告,对长CoT语料这是一笔线性于'轨迹数×平均步数×K'的推理开销,工程上可能吞掉学生侧节省的一部分。我的补充观察:(1) 方法依赖可验证答案,数学/科学竞赛题有标准答案,开放生成任务难以直接套用;(2) 全程使用LoRA而非全参数SFT,极端压缩结论能否外推到全参数训练与更大语料存疑;(3) 评测集中在竞赛数学与GPQA-D,缺少代码、agentic、多模态等推理维度;(4) 超参ρ与M的选择只在{1,5,10,30}%网格上报告,没有自适应确定准则,跨任务迁移时需重调;(5) 4B学生全量SFT基线明显偏弱(AIME25仅56.7,低于其ρ=1%后的83.3超过26个点),基线弱会使加速比与增益显得更夸张,需谨慎解读'800×';(6) 发表版中两处Appendix引用显示为'Appendix ??',有限样本集中度证明与算法伪代码不可考,且论文未在正文给出开源代码链接。
独立分析的弱点
独立分析四点弱点。其一,教师侧成本黑箱:MCRT要求对每条轨迹的每个中间状态做K次续写并判分,若用GPT-4级API教师剖析百万级语料,API费用可能远超学生LoRA训练的电费,论文只报了学生侧0.01–0.07 GPU时,没有端到端的总成本核算——改进方向:状态级剪枝(仅在高熵token邻域展开采样)、早停(连续多个低不确定性状态则跳过剩余步骤)、或用小模型代理教师做画像。其二,选择偏差风险:高不确定性轨迹往往更长、更'摇摆',轨迹均值 $?ar{U}_i$ 虽做了长度归一却未对题目难度归一,简单题上稳健的轨迹可能被系统性低估;且'分叉多'不必然等于'教学价值高',对容量极小的学生可能引入噪声——改进方向:按难度分层后在各层内做不确定性排序,或引入课程式ρ调度(先宽后窄)。其三,路由信号冷启动:探测epoch时学生尚未训练,长度归一化损失对长度与风格偏置敏感,损失最高的样本可能只是学生格式不适应而非价值最高——改进方向:把教师不确定性与学生损失做加权融合,而非两段硬性先后选择。其四,验证域窄:只测了LoRA+数学/科学,代码生成、工具调用等存在不可验证中间步的场景是否成立未知——改进方向:用单元测试通过率、执行反馈作为 $Z_{i,t}$ 的替代验证信号,把MCRT搬到可执行验证的领域。
未来方向
作者提出的方向:把渐进收缩从SFT推广到RLVR/RL后训练的样本与轨迹分配(结论暗示训练负担削减是普适工具),并为算力有限的社区提供构造强推理模型的实用路径。基于成果可自然延伸:(1) 理论补全——把附录提及的有限样本集中度结果与两阶段选择的统计保证形式化,给出 $\rho$、$M$、$K$ 与下游泛化差距的显式关系,指导超参选取;(2) token级细化——把轨迹级 $\bar{U}_i$ 下沉为token/步级加权SFT损失,而非整条轨迹硬丢弃,可能进一步榨取被丢弃轨迹中的信息;(3) 动态ρ——随学生收敛程度自适应放大或收缩候选池,形成真正的自动课程学习;(4) 开放域验证器——用LLM裁判或rubric打分代替标准答案判分,把MCRT扩展到代码、agent轨迹、多模态推理;(5) 与弱到强对齐结合——Table 2显示1.7B教师可提升14B学生,值得研究过程不确定性画像能否作为'能力边界探测器'服务于可扩展监督(scalable oversight);(6) 基础设施化——教师画像跨学生可复用的特性适合做成公开'不确定性画像库',像OpenThoughts的数据配方一样成为社区共享资产。
复现评估
复现要素大多可得:训练数据公开(DAPO-17K、Nemotron-Math前1000题);评测基准全部公开(AIME24/25/26、AMC、HMMT25/26、MATH-500、GSM8K、GPQA-Diamond);教师Qwen3-8B与学生Qwen3.5-4B/9B、Gemma-4-E4B、Llama-3.2-3B、Mistral-7B均为开放权重。学生训练用LoRA在2×H200上完成,全量SFT也只需8.47/9.23 GPU时,本文方法0.01–0.07时,算力门槛很低。不利因素:正文未给出开源代码链接;两处附录引用断裂('Appendix ??'),算法流水线与有限样本集中度证明在当前版本不可读;剖析关键超参K(每状态rollout数)、M(激活集大小)、推理步的语义切分实现等细节未在正文交代;闭源教师实验(DeepSeek-V4-Pro、Kimi-K2.6)需付费API,普通研究者难以复现该组数字。总体评估:方法概念简单、组件均为标准件(采样+判分+LoRA SFT+top-k筛选),复现难度中等——主要工程量在MCRT的步级采样与判分管线上;若官方放码则较容易,不放码则需自行补齐剖析超参并做网格搜索;鉴于基线偏弱的现象,建议以自己的全量SFT基线复核增益幅度后再采用其结论。
论文图表
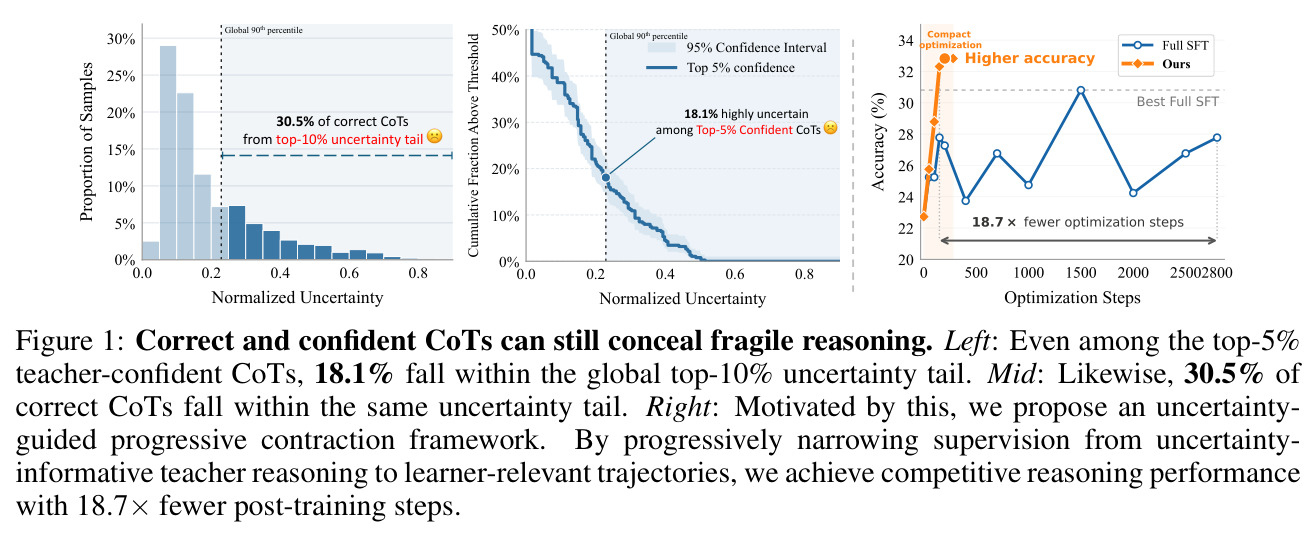
三联图:左侧展示教师置信度前5%的CoT中仍有18.1%落在全局不确定性前10%尾部;中间展示30.5%的答案正确CoT同样落入该尾部;右侧给出不确定性引导渐进收缩框架示意——从不确定性信息丰富的教师推理逐步收窄到学生相关的轨迹,最终以18.7×更少的后训练步数取得有竞争力的推理性能。
这是全文立论图:用两个统计数字证明终端置信度/正确率不能刻画监督价值,从而引出过程不确定性这一新信号,并一图概括两阶段方法与最终收益,是理解动机与方法的入口。
(a) DeepSeek-V4-Pro配Qwen3.5-4B学生、(b) Kimi-K2.6配Qwen3.5-9B学生,在Nemotron-Math前1000题上的多基准对比:无需对不确定性估计器做任何修改,渐进收缩在两个闭源API教师与多个推理基准上一致优于普通蒸馏,最高提升13.4%。
行为化不确定性度量的杀手级应用:证明框架无需logits、隐状态或权重即可用于API黑盒教师,这是多数需要模型内部访问的过程监督方法做不到的差异化能力。
1.7B弱教师(自身AIME24仅48.3、AIME25仅36.8)+ρ=5%:Qwen3.5-4B的AIME24 73.8→83.3(+9.5)、AIME25 65.6→80.0(+14.4);Qwen3-14B的AIME24 76.0→86.7(+10.7)、GSM8K 89.8→95.5(+5.7),学生侧额外开销仅+0.02/+0.10 GPU时。
证明监督价值不完全由教师强度决定——不确定性画像能从弱教师的行为中提炼出对强学生有效的信息,是'弱到强迁移'主张的直接证据,也为可扩展监督提供了想象空间。