后训练中的锐化税 Sharpening Tax in Post-Training
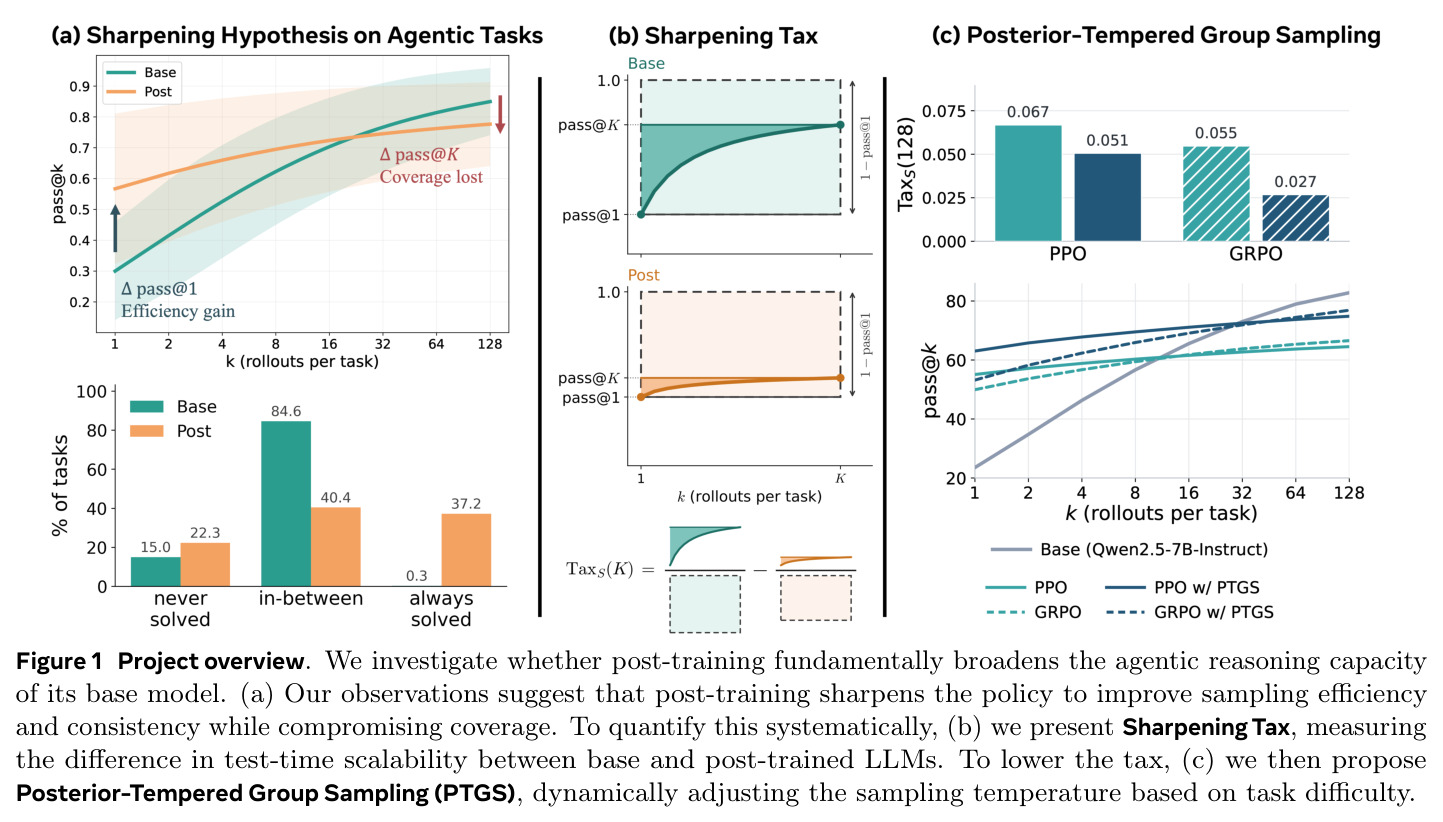
RL后训练用解覆盖率换取采样效率:锐化税量化此代价,PTGS按题难度自适应调温减税
前置知识
pass@k 指标族
衡量LLM在重复采样下推理边界的标准指标。对任务 $x_i$ 采 $n_i$ 条rollouts、成功 $c_i$ 条:$\text{pass@1}_i=c_i/n_i$ 是单次命中率(采样效率);$\text{pass@k}_i=1-\binom{n_i-c_i}{k}/\binom{n_i}{k}$ 是 $k$ 次内至少一次成功的覆盖率(用无偏估计器计算);$\text{pass}^k_i=\binom{c_i}{k}/\binom{n_i}{k}$ 是 $k$ 次全部成功的一致性。数据集级指标对所有任务取平均。
全文实证都建立在这三个量上:锐化假说即『pass@1升、pass@k降』,锐化税由pass@k曲线下面积定义,PTGS的效果用pass@1与pass@128同时提升来衡量。
RL后训练与分布锐化
预训练之后用强化学习(PPO、GRPO等,常配可验证奖励)继续训练LLM,使其成为推理模型或智能体。锐化(sharpening)指训练把原本分散的概率质量集中到少数高奖励行为模式上:策略熵下降、输出趋同。SFT与DPO同样具有锐化效应。『锐化还是解锁』之争即:后训练只是放大基座已有的行为,还是创造全新能力。
本文的核心命题就是量化锐化的代价——税衡量的是任意后训练策略相对其基座在测试时可扩展性上的损失,不依赖具体训练配方。
测试时并行扩展
不改模型权重、靠对同一prompt反复采样并择优(best-of-N、重复采样加验证器)来换取性能的算力维度。Brown et al. (2024) 的大语言猴子实验表明足够多的随机样本能覆盖极难题目,pass@k是其标准度量,且增长遵循可预测的推理时scaling law。
锐化税度量的正是后训练对这种可扩展性的损害:税为正意味着多花rollouts买不回基座原本能买到的解覆盖率,这直接关系到推理预算该怎么花。
Beta-Binomial后验与Thompson采样
把某prompt的未知成功率 $p_x$ 建模为Beta分布先验 $\mathrm{Beta}(a,b)$;观察到 $s$ 成功、$f$ 失败后更新为后验 $\mathrm{Beta}(a+s, b+f)$。Thompson采样每步从后验抽一个 $\hat p$ 并按它决策,天然平衡探索与利用。本文用折扣计数(遗忘因子 $\gamma=0.95$)应对策略非平稳性。
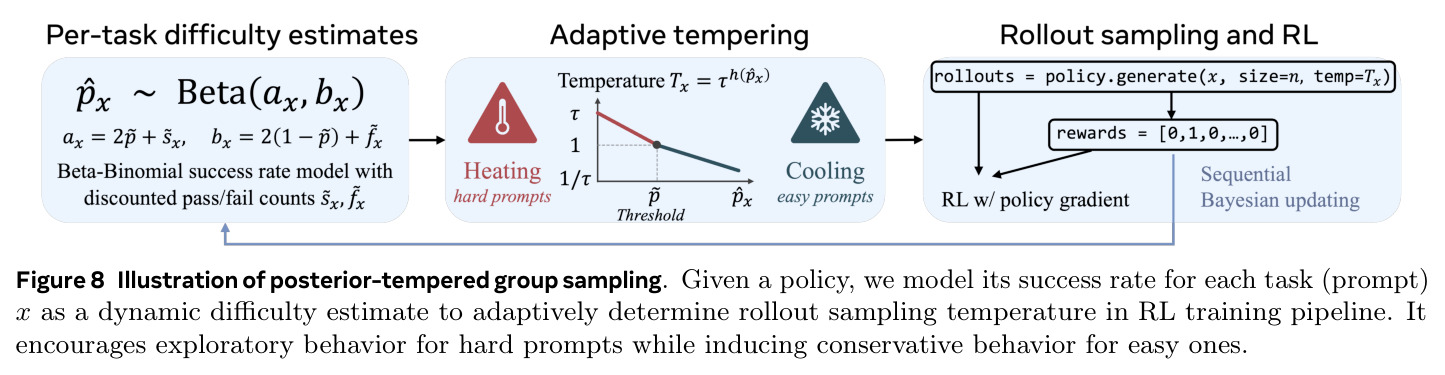
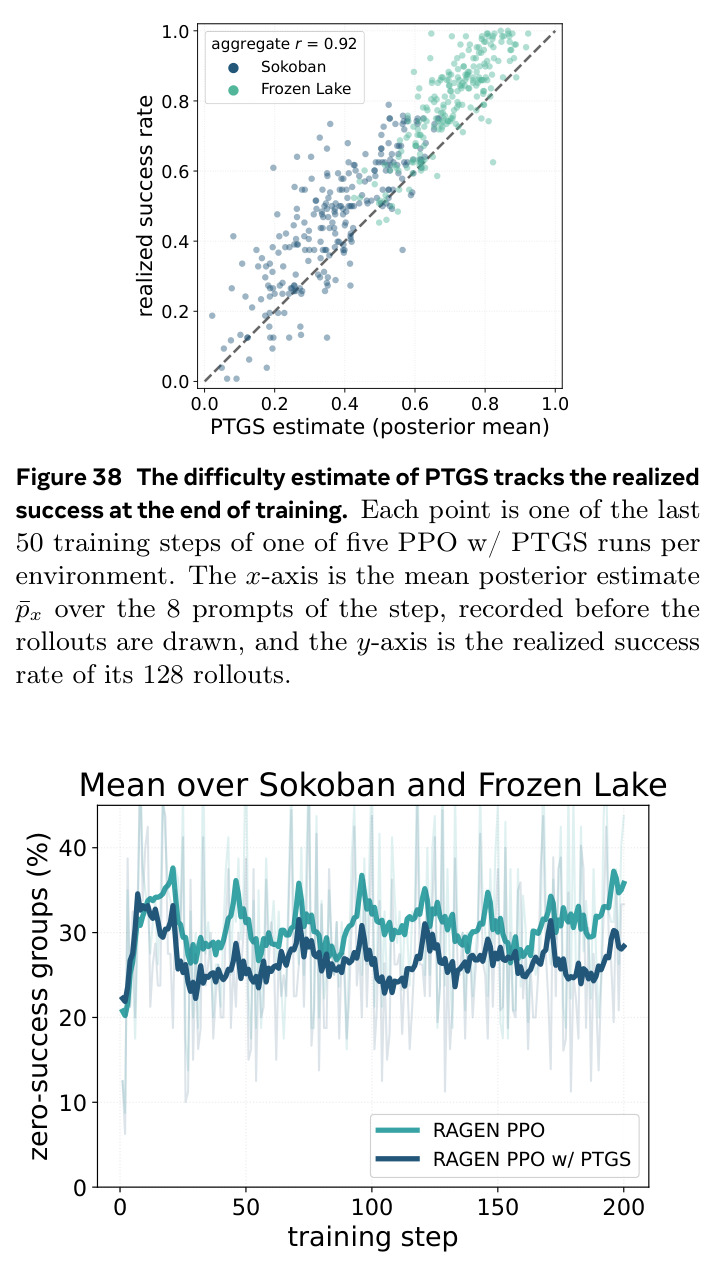
PTGS用它在线估计每个prompt的难度,再把难度映射成采样温度:难prompt加热以探索、易prompt冷却以利用,这是方法的核心机制。
采样温度
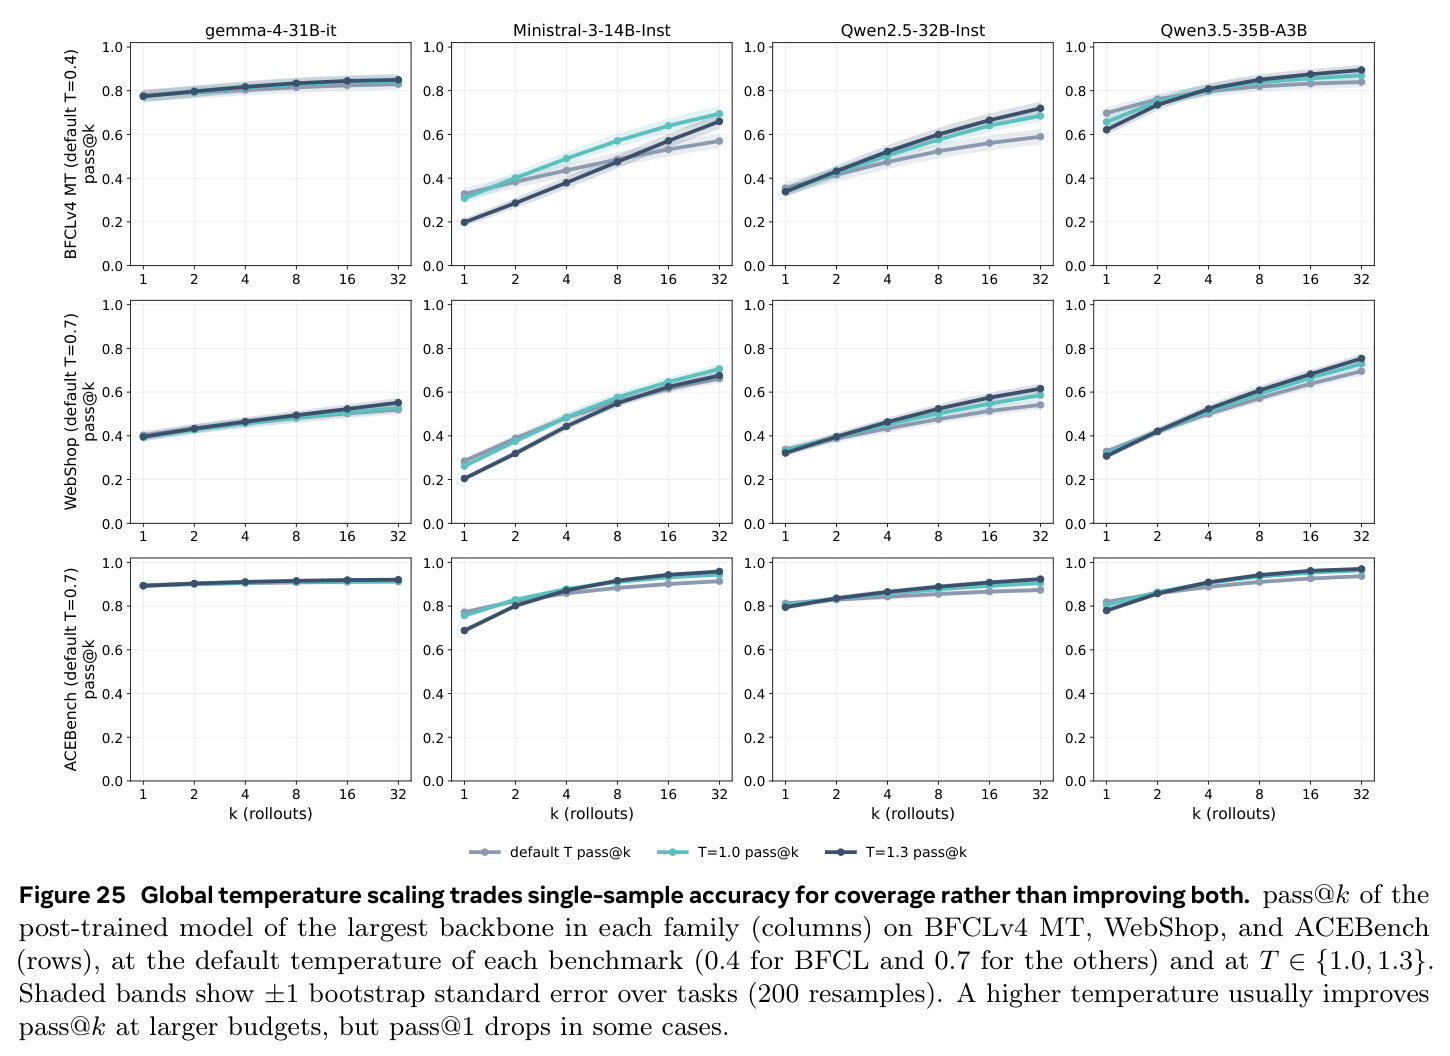
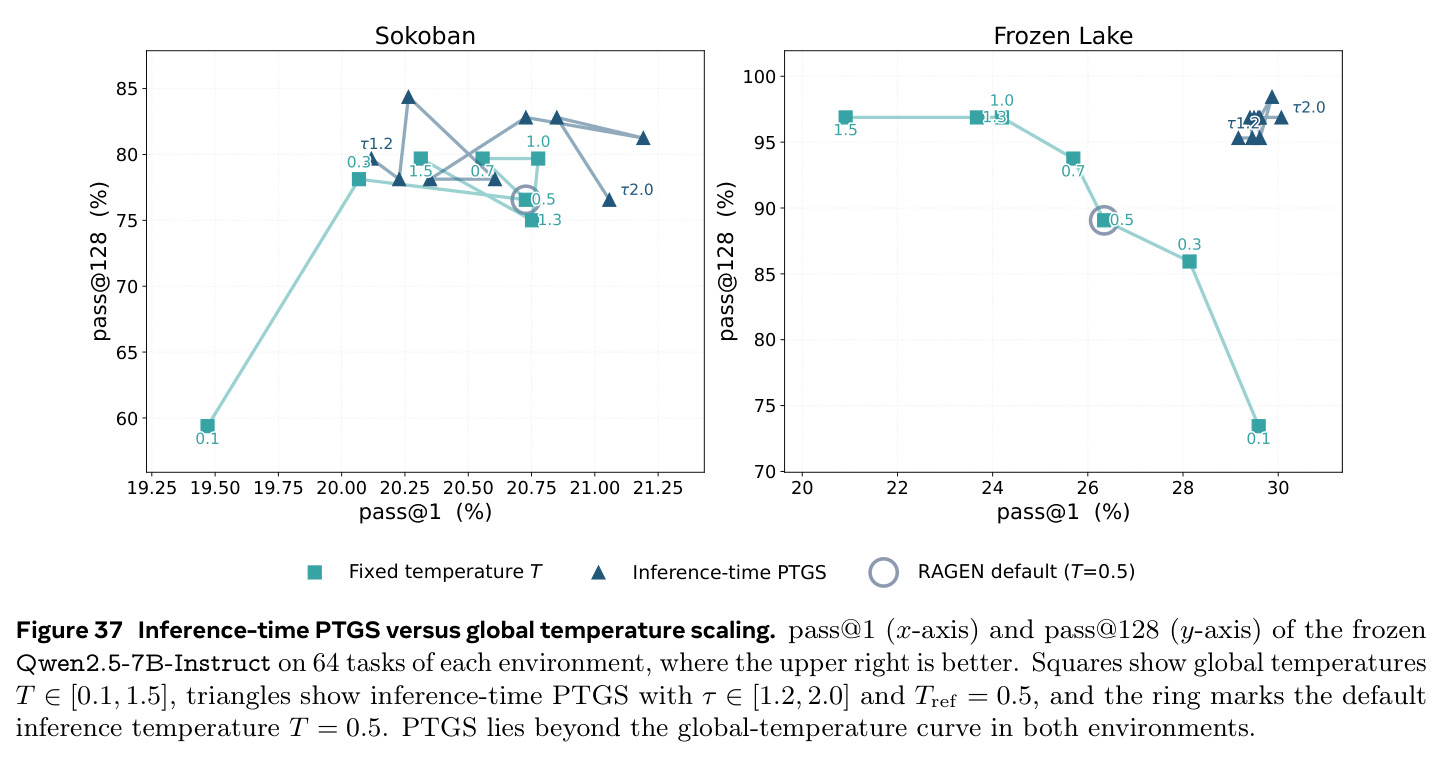
解码时对logits除以温度 $T$ 再做softmax:$T$ 越低分布越尖(利用、高一致性),越高越平(探索、高多样性)。论文Figure 25证明全局调温只能在精度与覆盖率之间滑动:升温常改善大预算的pass@k,但12个面板中无一改善pass@1。
理解温度的作用才能理解本文干预的逻辑:把全局温度改为per-prompt自适应温度 $T_x\in[1/\tau,\tau]$,才能把精度-覆盖率的帕累托前沿整体外推。
研究动机
RL后训练已成为把预训练模型变成推理模型与智能体的标准步骤,主流叙事认为RL『解锁』了基座不具备的新能力。但2025年以来多项工作(Yue et al. 2025、Zhao et al. 2025等)观察到相反迹象:RL提升单次命中率pass@1的同时,解覆盖率pass@K反而低于基座模型,即后训练只是『锐化』了基座已有的少数高奖励行为。问题在于,这些证据几乎全部来自数学与代码任务,存在两个系统性混淆:其一,预训练语料充斥数学与代码,基座模型早已编码大量候选解法,在这样的域里难以证伪锐化假说;其二,这些基准多只校验最终答案,错误推理链蒙对答案也能得分,会虚高pass@K。而真实智能体任务要求结构化动作、经场景特定接口调用工具、在不确定反馈下多轮交互并保持长程一致,这些行为在预训练数据组合中罕见,普遍被认为必须靠后训练习得——按此逻辑,若锐化在agentic域依然成立,『后训练扩展能力边界』的信念将受到严重挑战;但此前没有人在过程级校验的智能体环境里系统检验过这一点。
本文的目标是本文的目标分三层。第一层实证:在多轮工具调用与环境交互的智能体任务上,系统比较基座模型与其后训练版本的推理边界,回答『后训练在agentic域是否真的扩展了能力』——为此给基座配一个轻量、与数据无关、模型无关的推理harness,使基座也能正确发起工具调用,从而实现公平比较。第二层度量:把『目测pass@K曲线』升级为单一标量的诊断指标Sharpening Tax,量化后训练造成的测试时可扩展性损失,并验证它跨4个模型族14对checkpoint、3个基准(共42个组合)的普遍性,以及用少量rollouts估计的可预测性和与其他指标的相关性。第三层干预:既然锐化的机制是把任务推向『总能解』与『永远解不出』两个极端、摧毁重试的价值,就设计一种采样策略,在RL训练中对难prompt保留探索、对易prompt加强利用——后验温度化组采样PTGS,目标是同时改善pass@1与pass@K、降低税,且不改动RL更新规则、不增加计算开销。
与已有工作不同的是,本文的独特切入角度有三处。其一,把『锐化还是扩界』之争从数学/代码搬到过程级校验的智能体环境(BFCL v4多轮、WebShop、ACEBench):中间动作与状态转移都被环境打分,错误轨迹无法靠幸运的最终答案得分,从根上排除了coverage虚高的混淆。其二,方法上不满足于画scaling曲线,而是把重复采样从『涨分手段』重新用作『诊断工具』:利用曲线下面积 $A(K)$ 的等待时间/生存分析解释(预算内首次成功前的期望失败次数),导出可校准、可外推、可预测的锐化税,并证明『按比例 $\lambda$ 锐化即收 $\lambda A_{\text{Base}}(K)$ 的税』。其三,干预上虽属采样侧方案,但与已有温度调度不同:PTGS以每个prompt的Beta-Binomial后验难度为指导做双向调温(难加热、易冷却),而非全局或单向加热;且配套组学习信号定理——加热同时提高『至少一成功组』概率 $I_n$ 与『混合组』概率 $J_n$,直接改善PPO/GRPO能从rollout组中提取的梯度信号。
核心方法
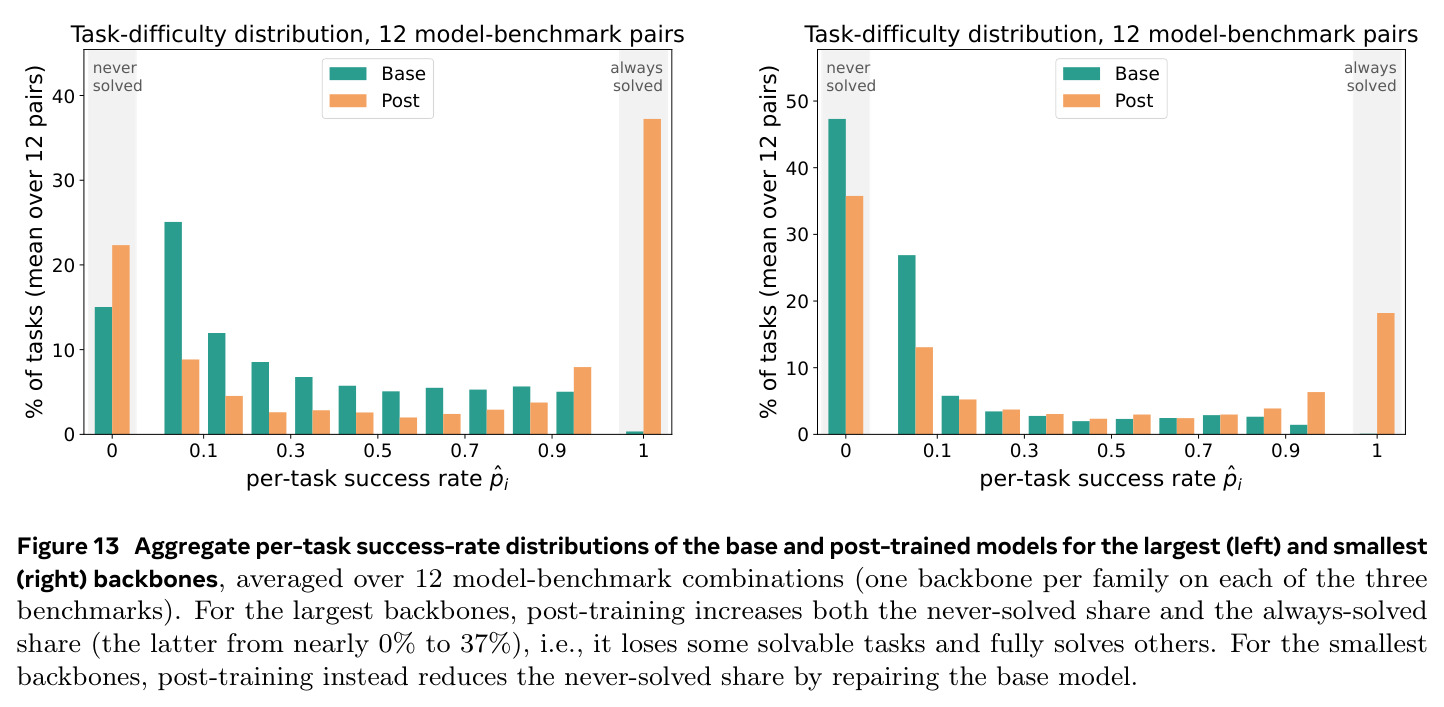
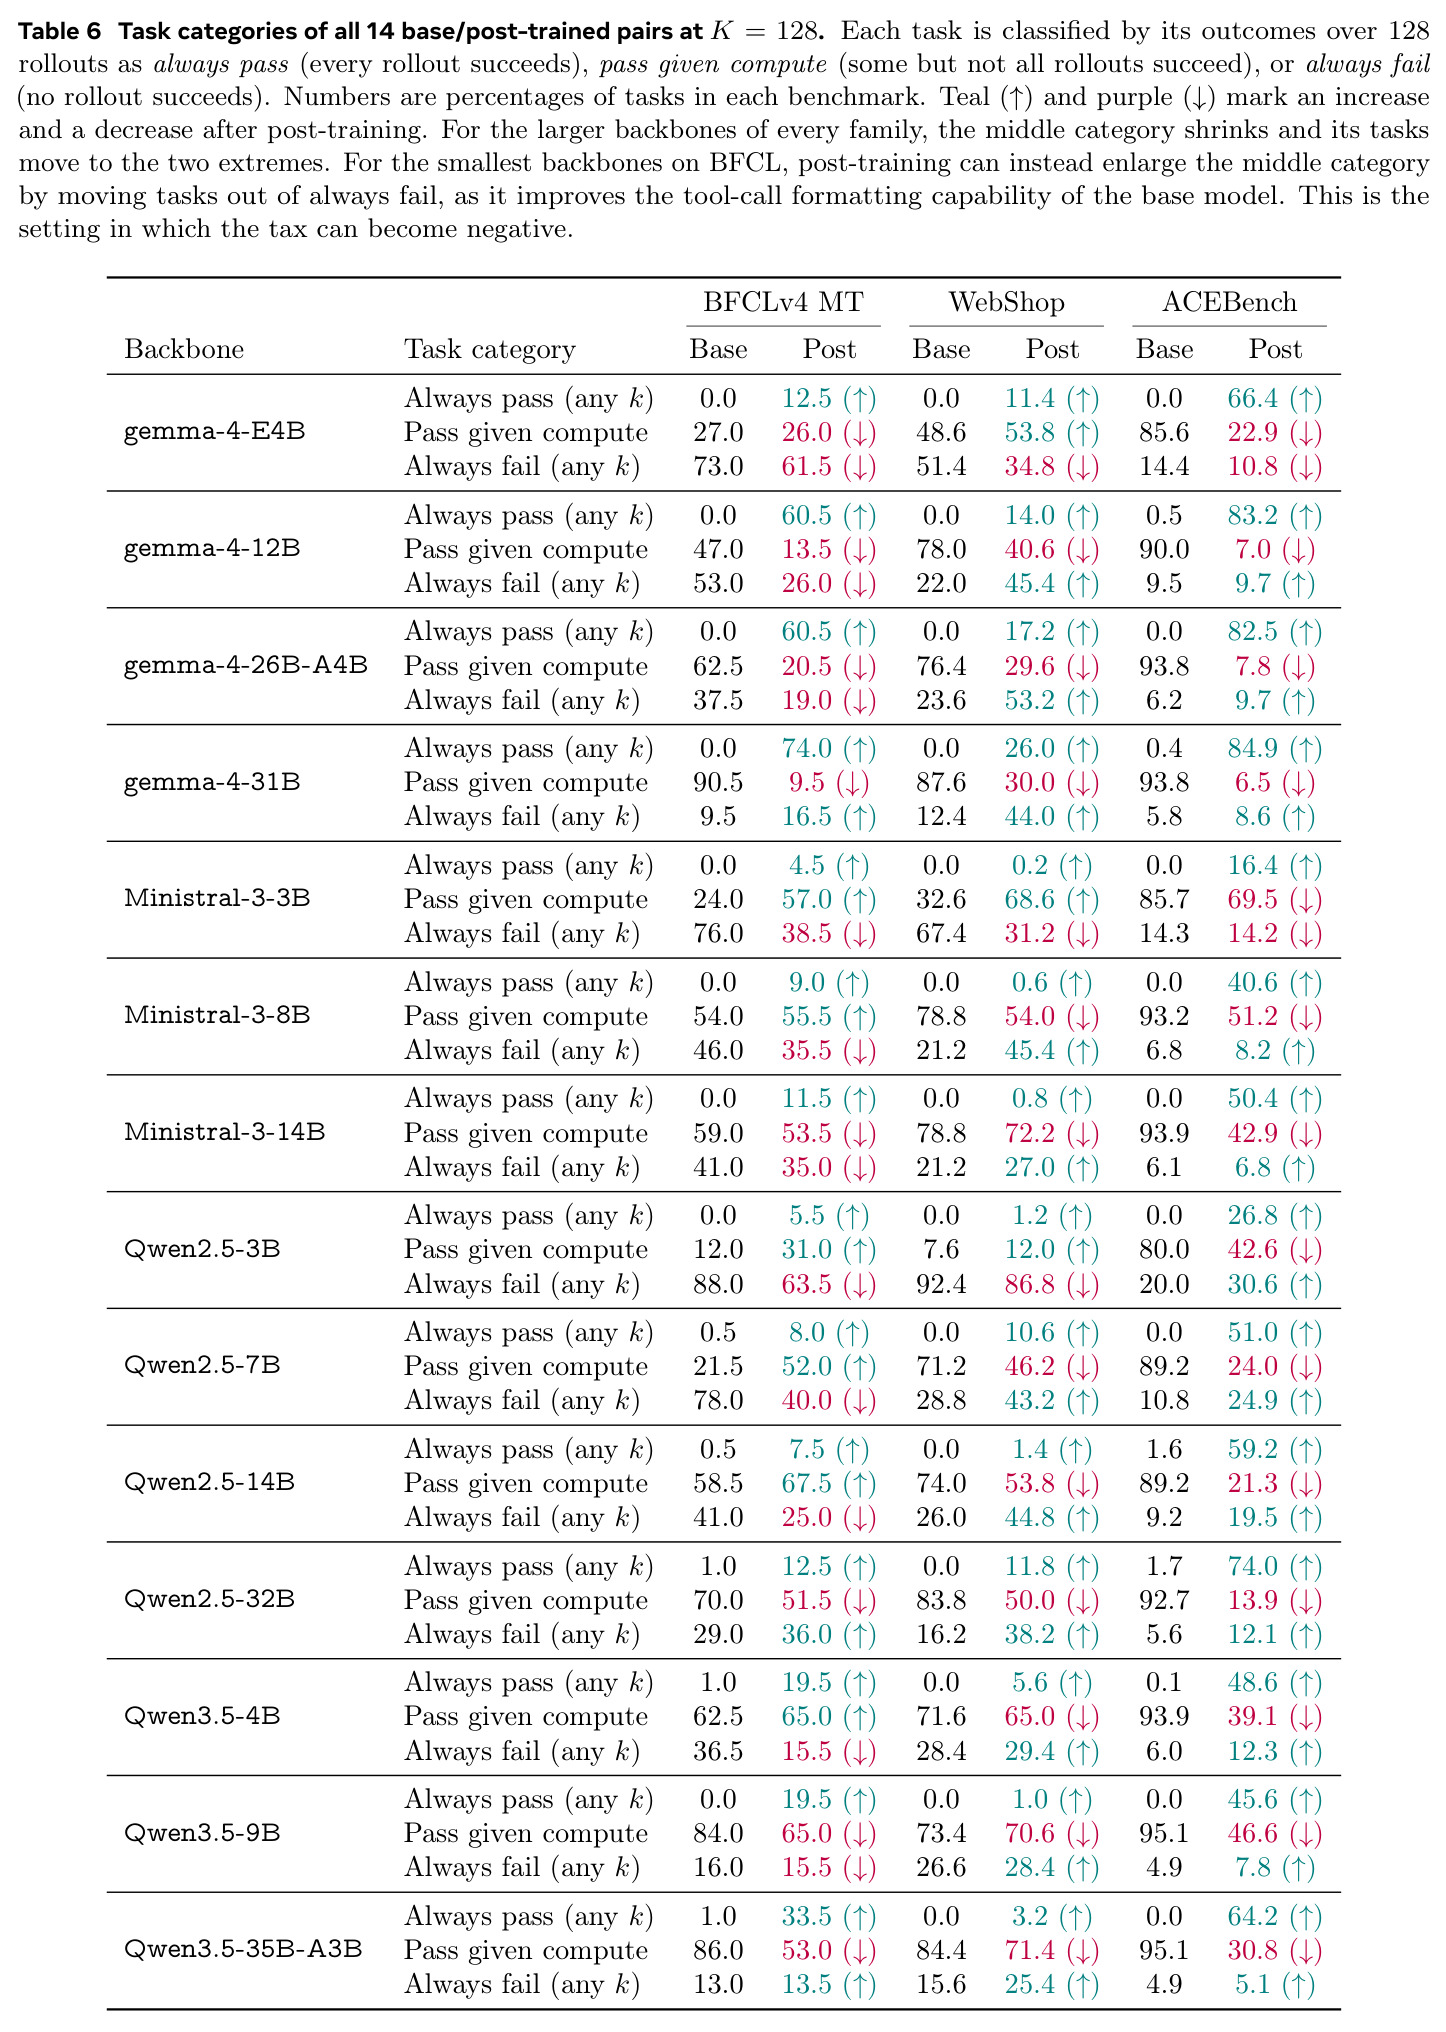
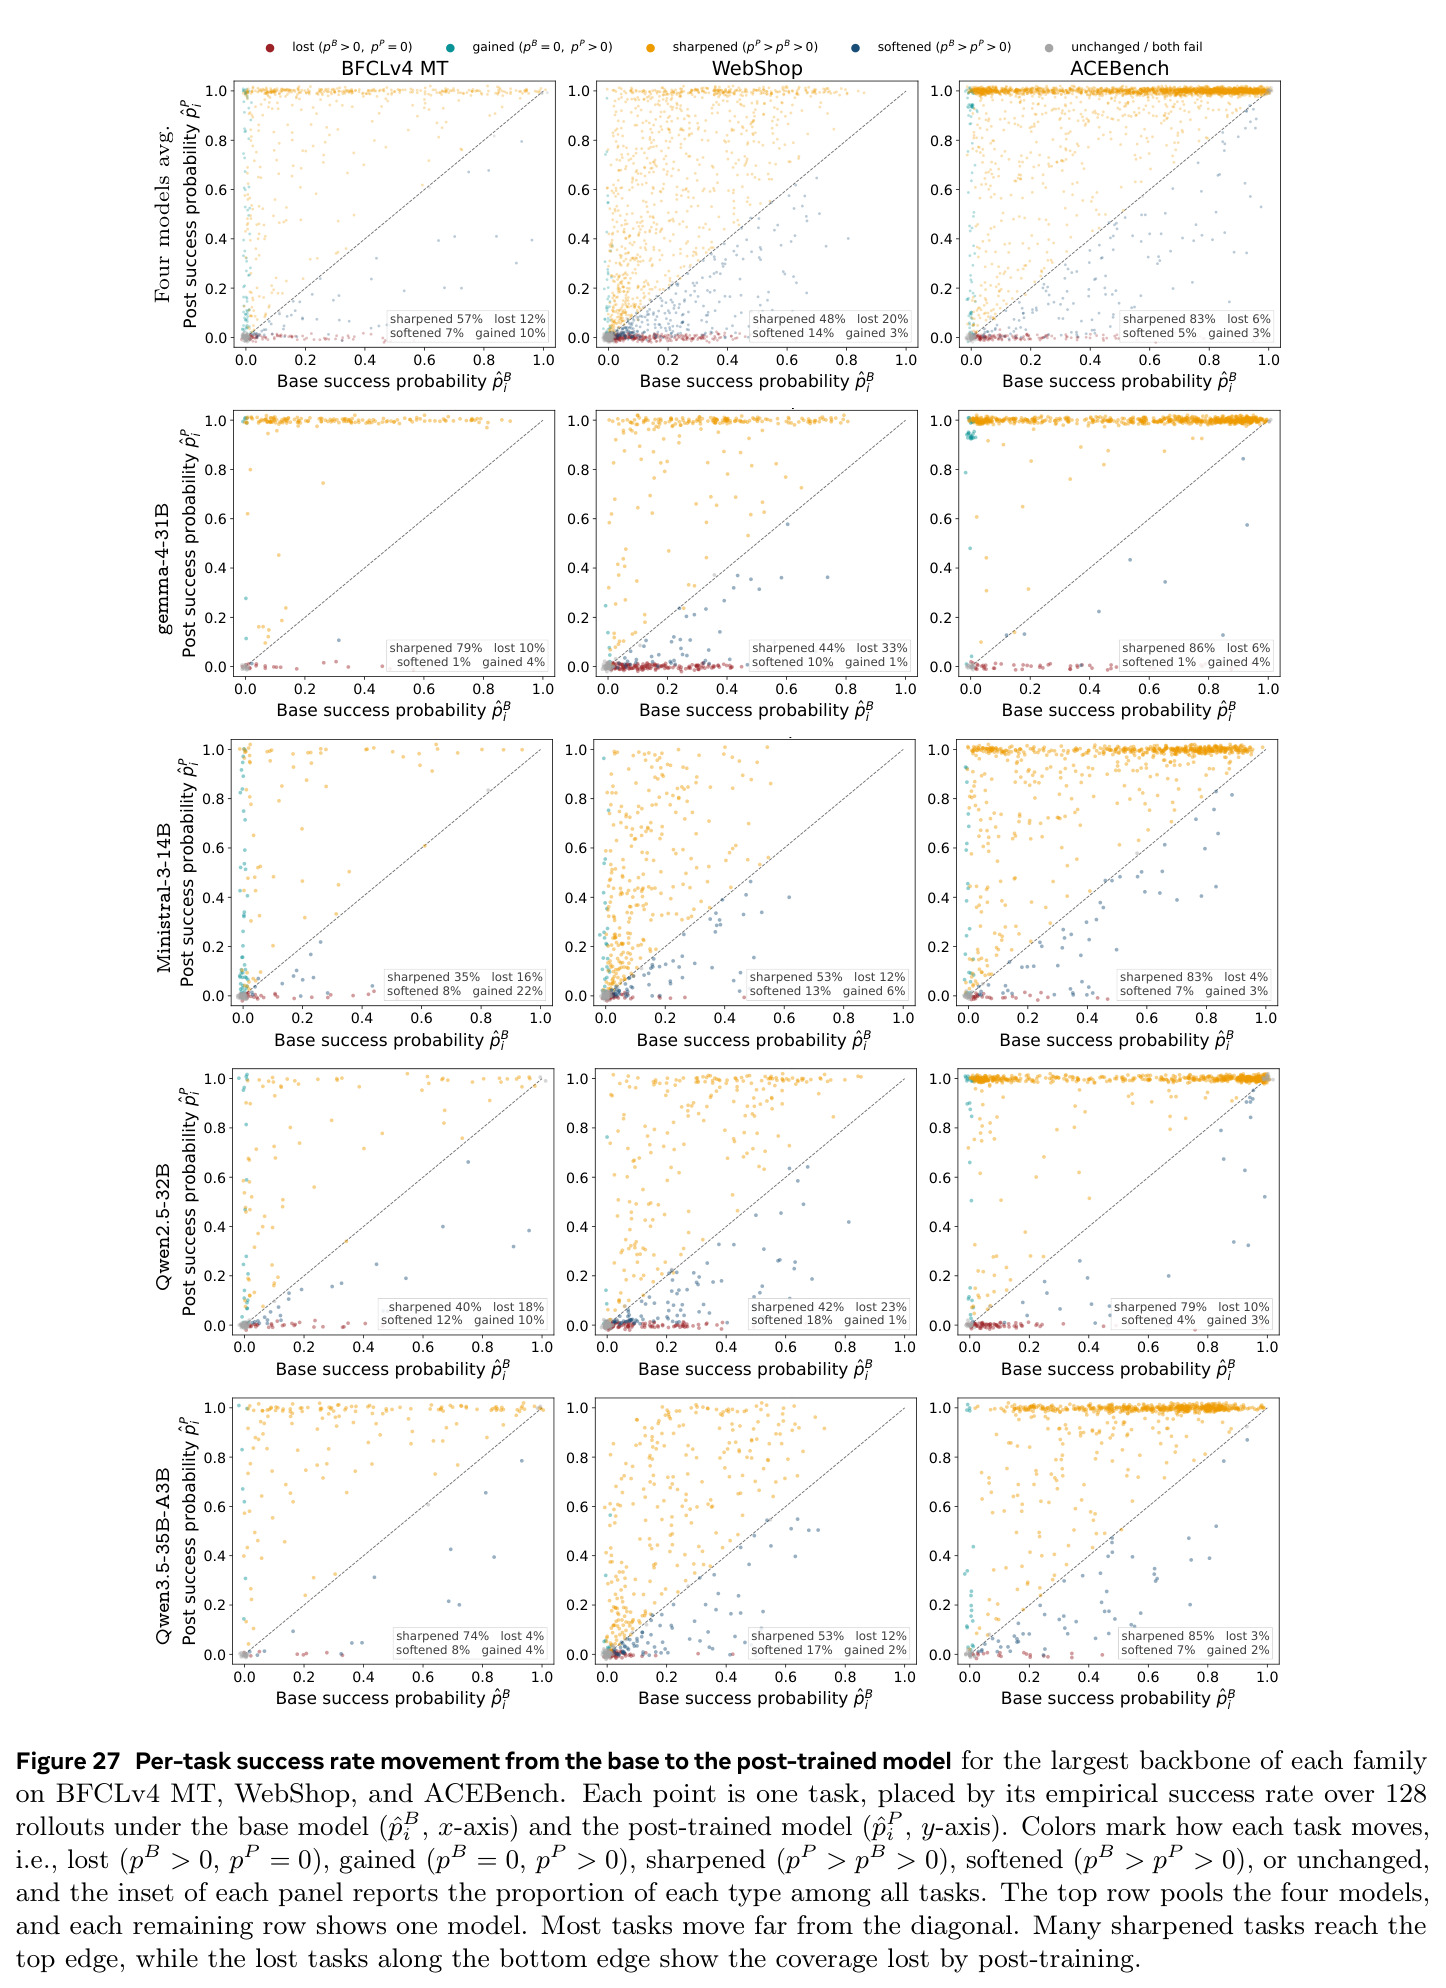
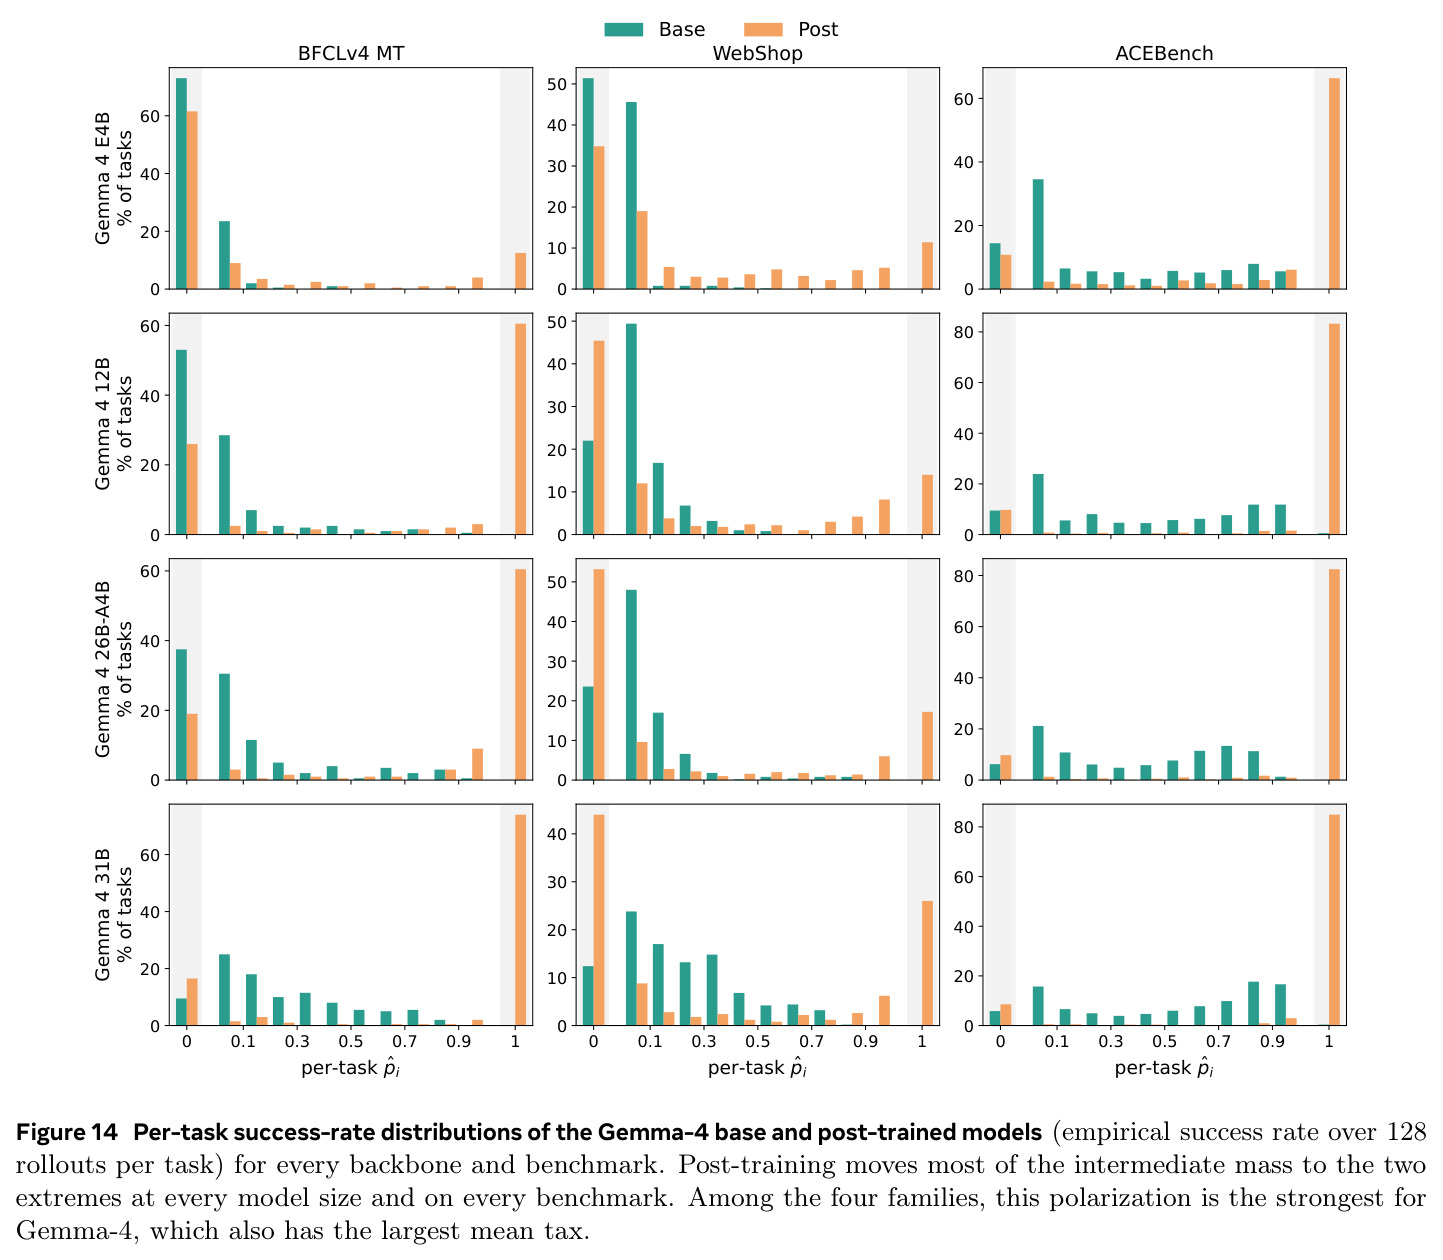
直觉上,后训练像把每个任务的成功概率往0或1两端推:原本『多试几次总能解出』的中间地带任务,一部分被固化成稳定解(往1推),更多则被推向永远解不出(往0推)。pass@1因此上升,但重试的价值被摧毁——pass@K曲线过早饱和。技术路线分三步。第一步实证:14对开源基座/后训练checkpoint(Gemma-4、Ministral-3、Qwen2.5、Qwen3.5,3B至35B)乘以3个agentic基准、每任务128 rollouts,基座配轻量harness、后训练模型用各自原生脚手架,画pass@K曲线,并把任务按128次结果三分类(always pass、pass given compute、always fail),观察成功率分布的双峰化。第二步量化:定义原始可扩展性 $A(K)=\sum_{k=1}^{K-1}(\text{pass@}K-\text{pass@}k)$(pass@K曲线下面积),校准版 $S(K)=\frac{A(K)}{(K-1)(1-\text{pass@1})}\in[0,1]$,税为 $\text{Tax}_X(K)=X_{\text{Base}}(K)-X_{\text{Post}}(K)$,$X\in\{A,S\}$。第三步干预:PTGS在RL训练中为每个prompt维护折扣成功/失败计数,构成Beta后验并经Thompson采样得到难度估计 $\hat p_x$,按 $T_x=\tau^{h(\hat p_x)}$ 自适应设定采样温度——难prompt加热至 $\tau$、易prompt冷却至 $1/\tau$——其余RL流程完全不变。
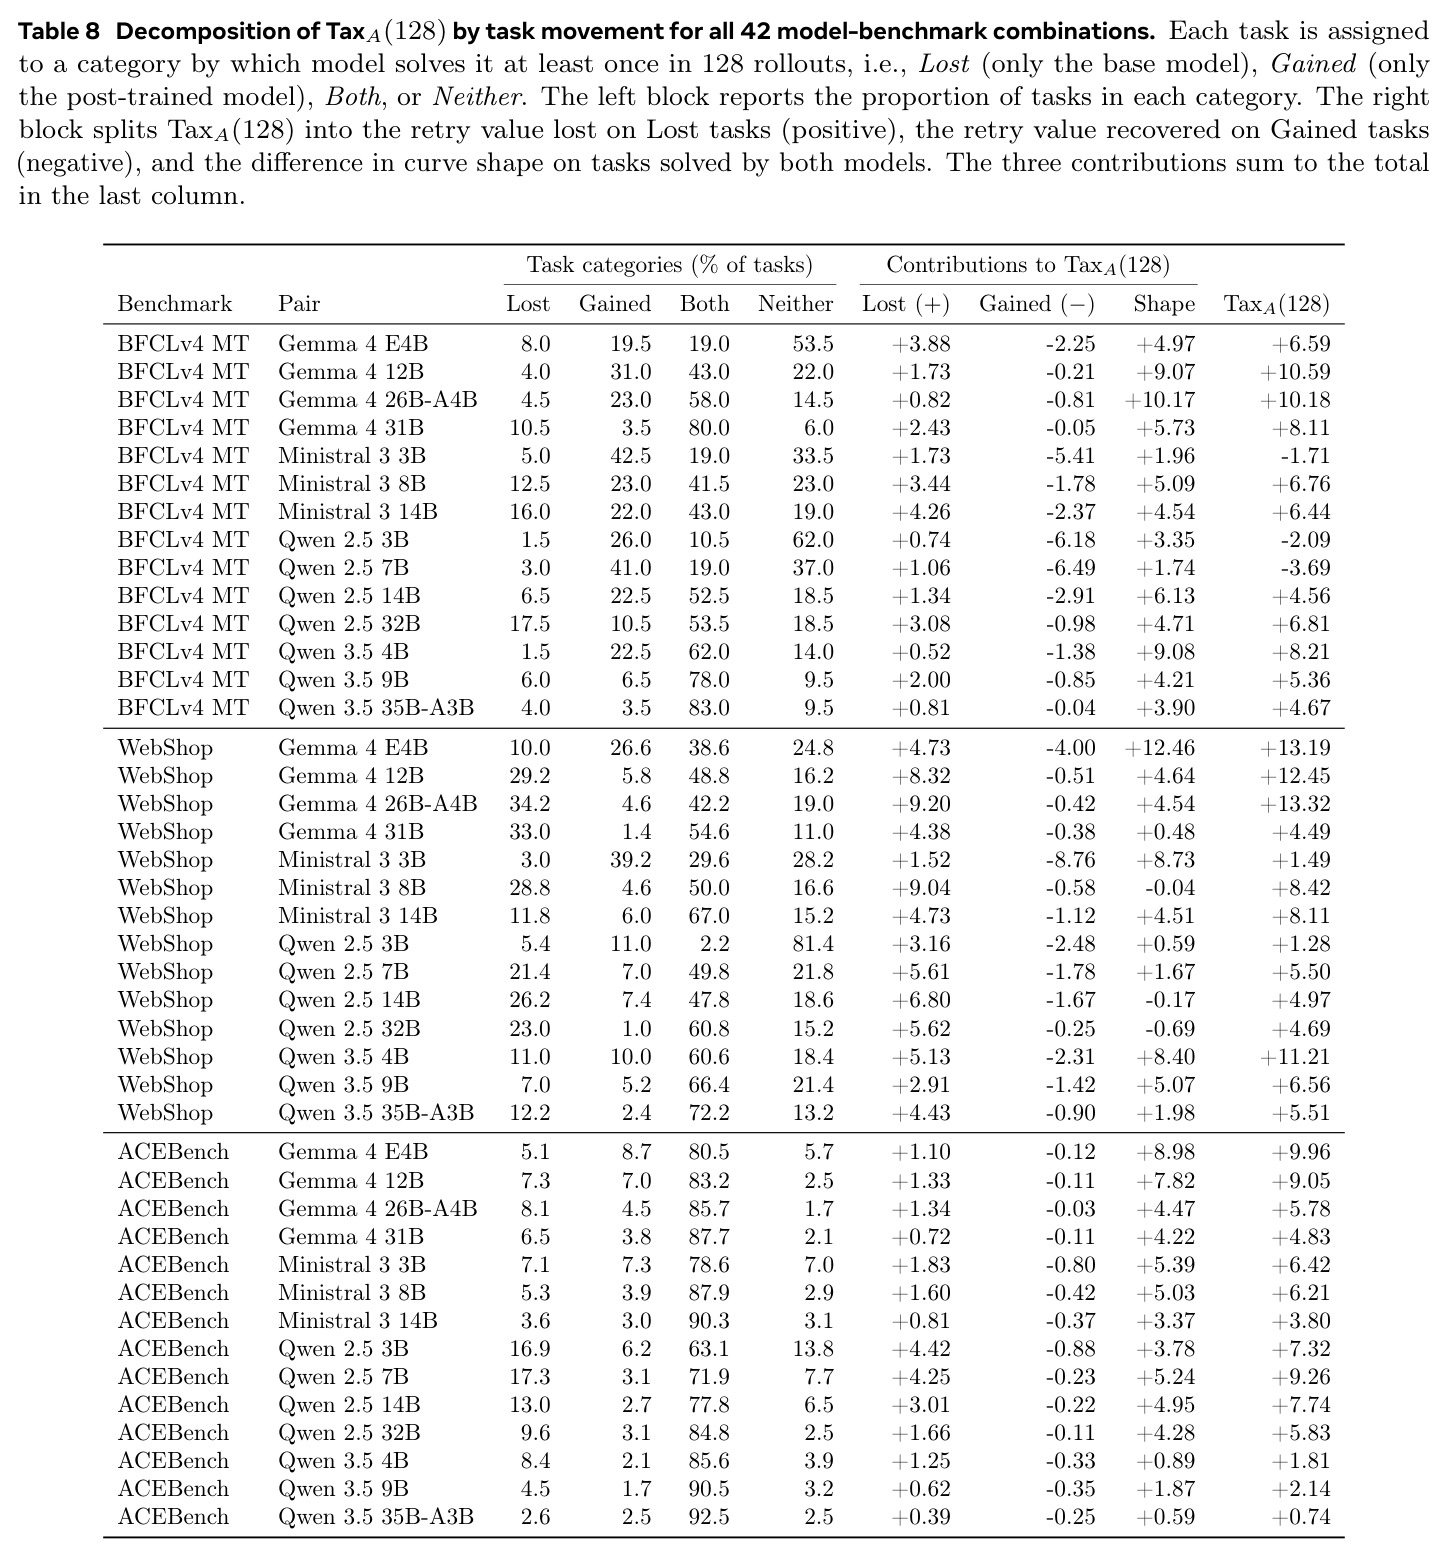
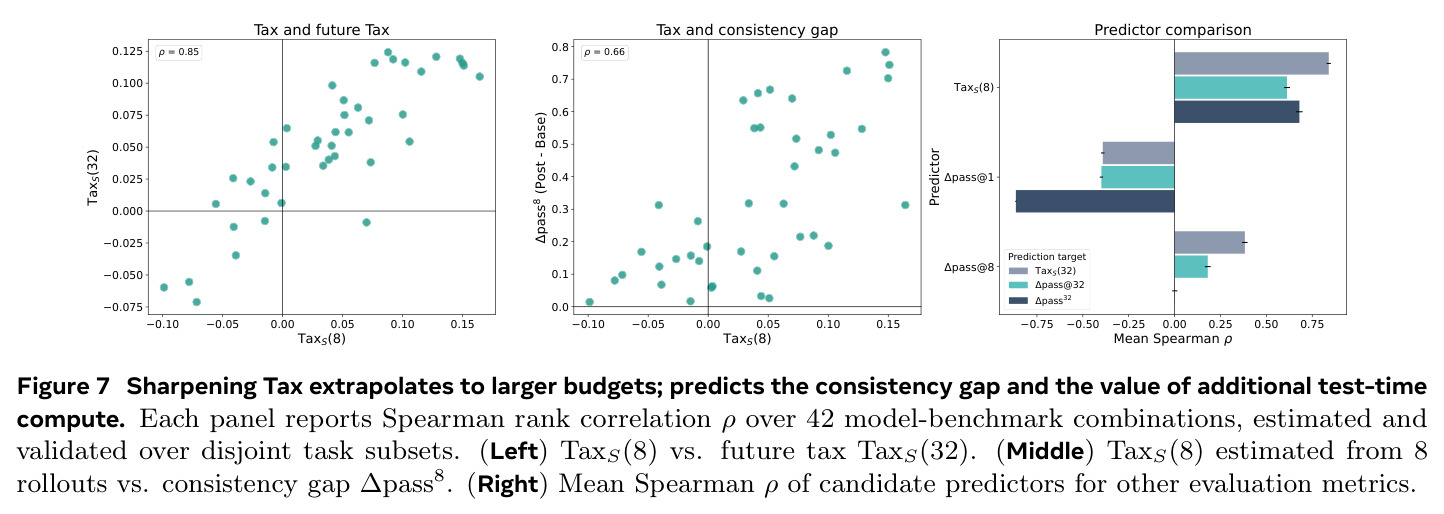
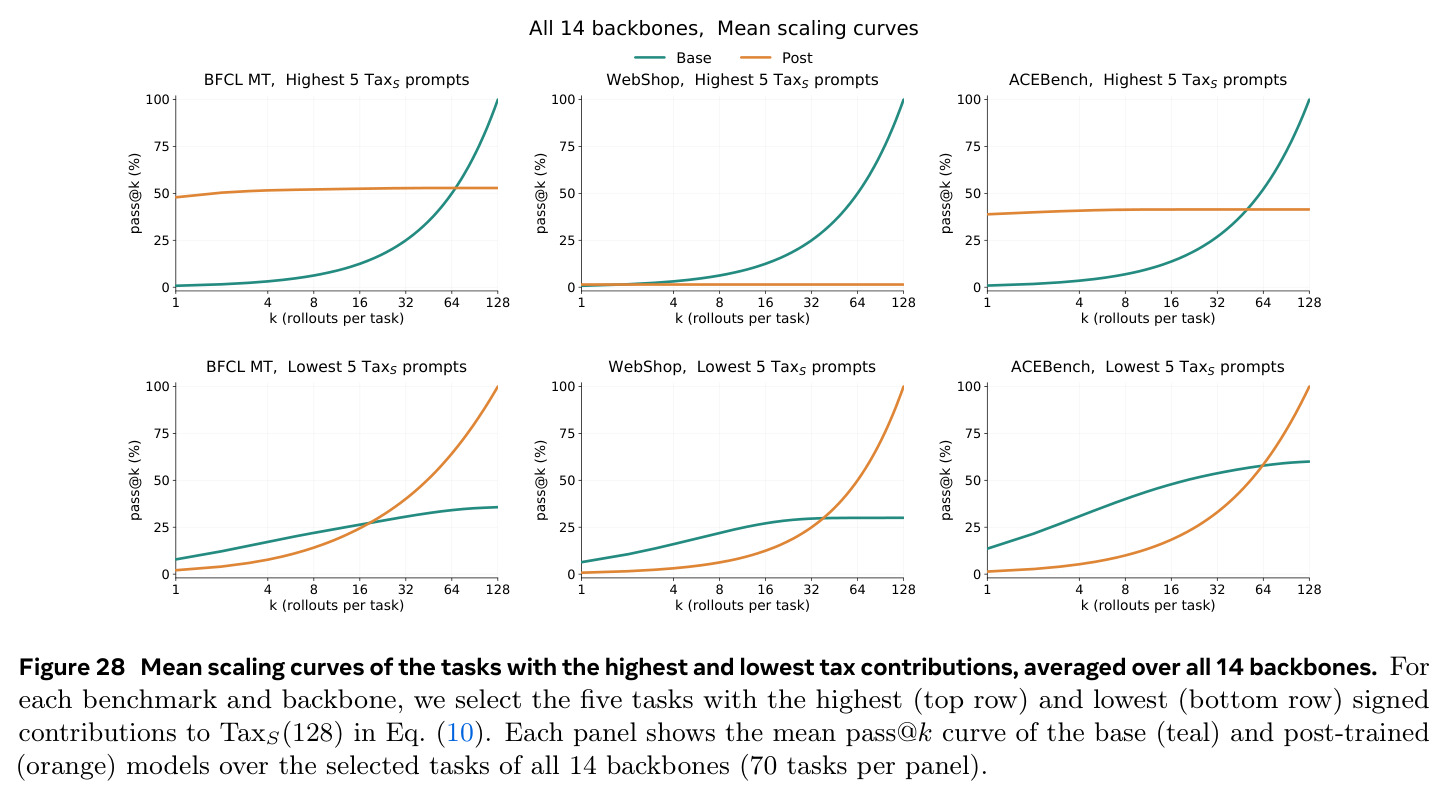
核心创新是把『重试的价值』形式化为可测的量。Proposition 1证明:设 $H$ 为首次成功rollout的序号,则 $A(K)=\mathbb{E}[(H-1)\mathbf{1}\{H\le K\}]$,即预算内首次成功之前的期望失败次数——首次尝试即成功或永不成功的任务贡献为零,只有靠重试翻盘的中间任务才有贡献。Theorem 2进一步证明:若后训练以比例 $\lambda$ 把任务锐化到两个极端(与原成功率无关,$\lambda_0\le\lambda$ 为被推向0的比例),则 $\text{Tax}_A(K)=\lambda A_{\text{Base}}(K)$,税与被锐化比例严格成正比;且即使pass@1改善,只要存在被推向0的任务($\lambda_0>0$),校准税仍严格为正,因为 $S_{\text{Post}}/S_{\text{Base}}=\frac{(1-\lambda)\epsilon}{(1-\lambda)\epsilon+\lambda_0}<1$($\epsilon=1-\text{pass@1}_{\text{Base}}$)。与已有工作的本质区别:先前工作只报告『大K下基座反超后训练』的现象并停留在可视化;本文给出有明确概率含义的单标量指标,证明其可预测性(8 rollouts的 $\text{Tax}_S(8)$ 外推 $\text{Tax}_S(32)$,Spearman $\rho=0.85$),并针对机制本身设计干预——按难度做贝叶斯自适应温度,而非加大熵奖励或全局升温。
方法步骤详情
步骤一(评测协议):每任务采 $N=128$ 条rollouts,用Chen et al. (2021)的无偏估计器计算pass@1、pass@k、pass^k;基座模型走纯文本completion接口,harness把工具目录渲染成Python函数签名、要求模型输出JSON格式的tool_call代码块,并用三个停止序列(### Tool Output、### User、结尾围栏)截断回合;后训练模型用各自原生chat模板与工具解析器;所有支持thinking的模型统一关闭thinking,保证『按rollout数计的预算』公平。步骤二(诊断):对每对模型画pass@K曲线,计算 $A(K)$、$S(K)$ 与两种税 $\text{Tax}_A$、$\text{Tax}_S$,用配对任务bootstrap(1000次重采样)给出95%置信区间;同时把任务三分类并做税的lost/gained/shape分解。步骤三(PTGS训练循环):初始化每prompt计数 $(\tilde s_x,\tilde f_x)=(0,0)$;每个RL step对batch内prompt $x$:计算后验参数 $a_x=2\tilde p+\tilde s_x$、$b_x=2(1-\tilde p)+\tilde f_x$(先验总质量2、中心在目标成功率 $\tilde p$);Thompson采样 $\hat p_x\sim\mathrm{Beta}(a_x,b_x)$;由 $T_x=\tau^{h(\hat p_x)}$ 定温,其中 $h(p)=\frac{\tilde p-p}{\tilde p}$($p\le\tilde p$,加热至 $\tau$),否则 $h(p)=\frac{\tilde p-p}{1-\tilde p}$(冷却至 $1/\tau$);在 $T_x$ 下生成 $n=16$ 条rollouts并统计成功数 $s_x$;用 $(\tilde s_x,\tilde f_x)\leftarrow(\gamma\tilde s_x+s_x,\ \gamma\tilde f_x+n-s_x)$ 更新计数($\gamma=0.95$);最后按PPO/GRPO规则更新策略,log-prob按同温计算保持on-policy。训练中 $\tilde p$ 从0.25线性升至0.5,因为混合组概率 $J_n$ 的组内方差 $p(1-p)$ 在 $p=1/2$ 处最大。
技术新颖性
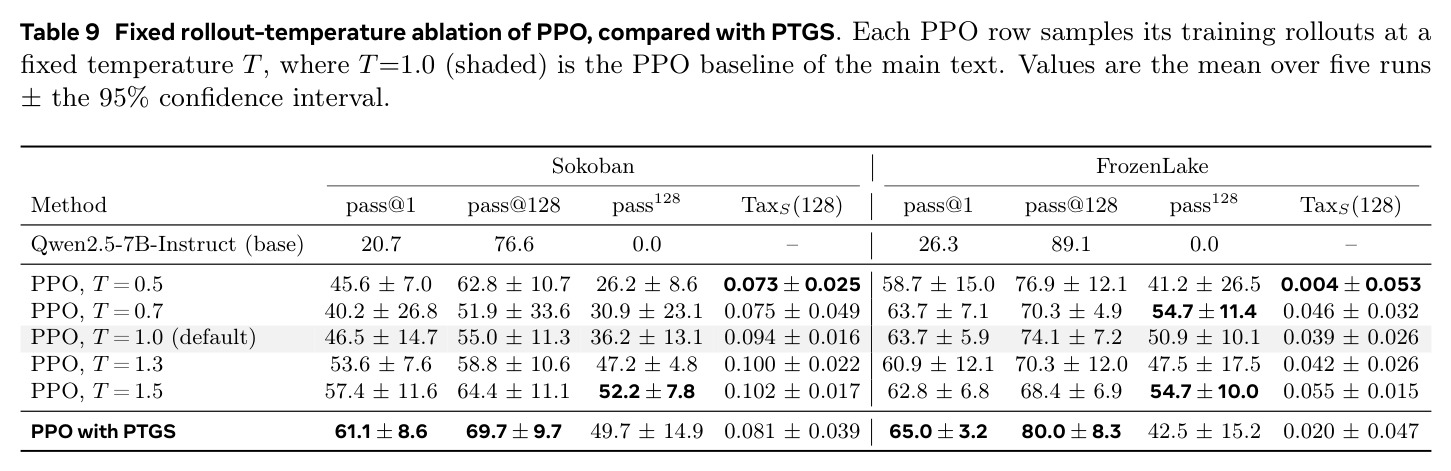
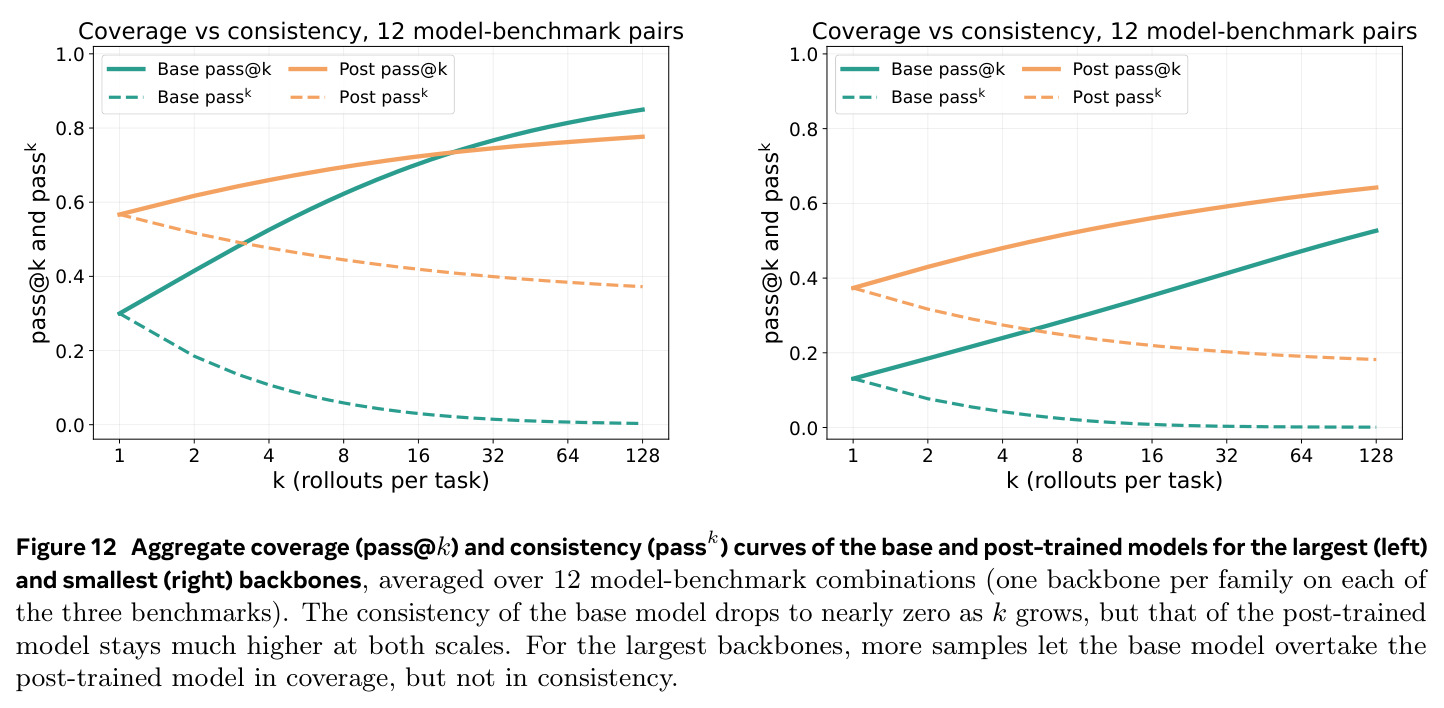
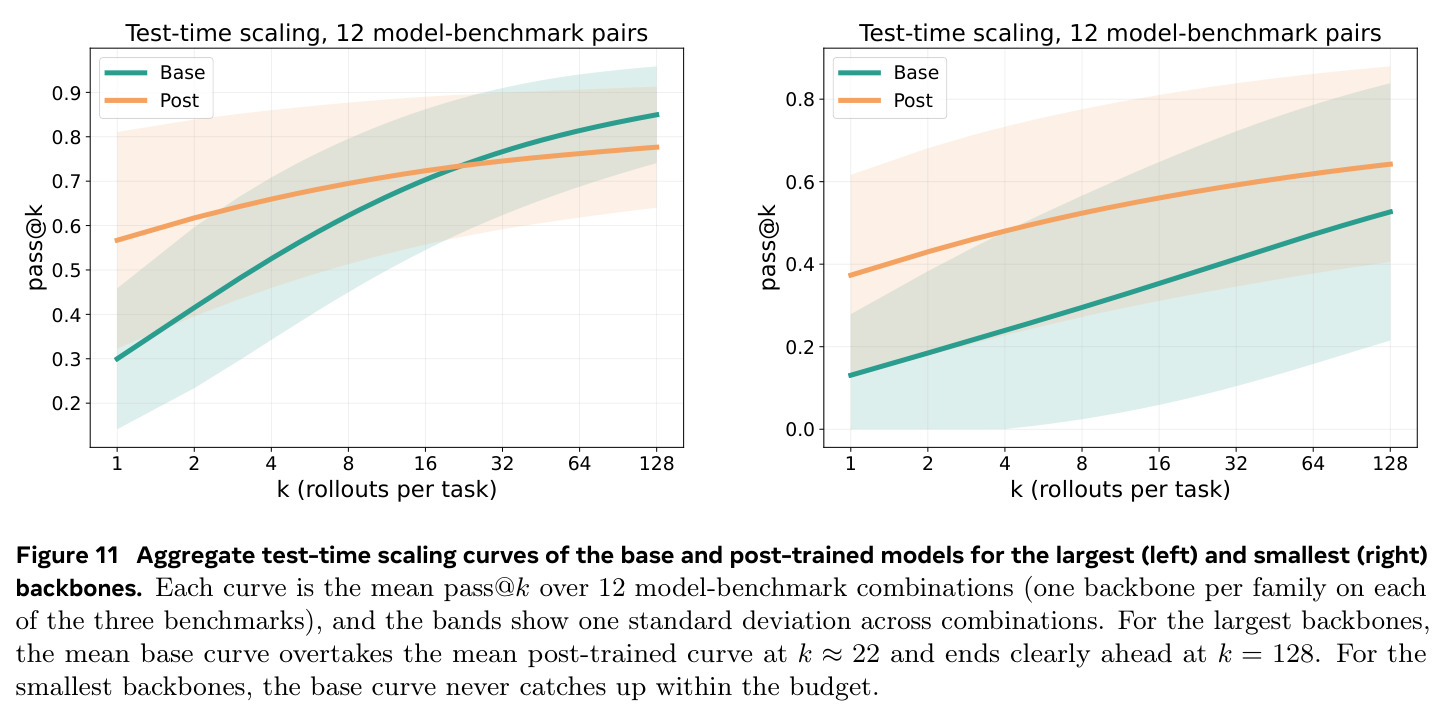
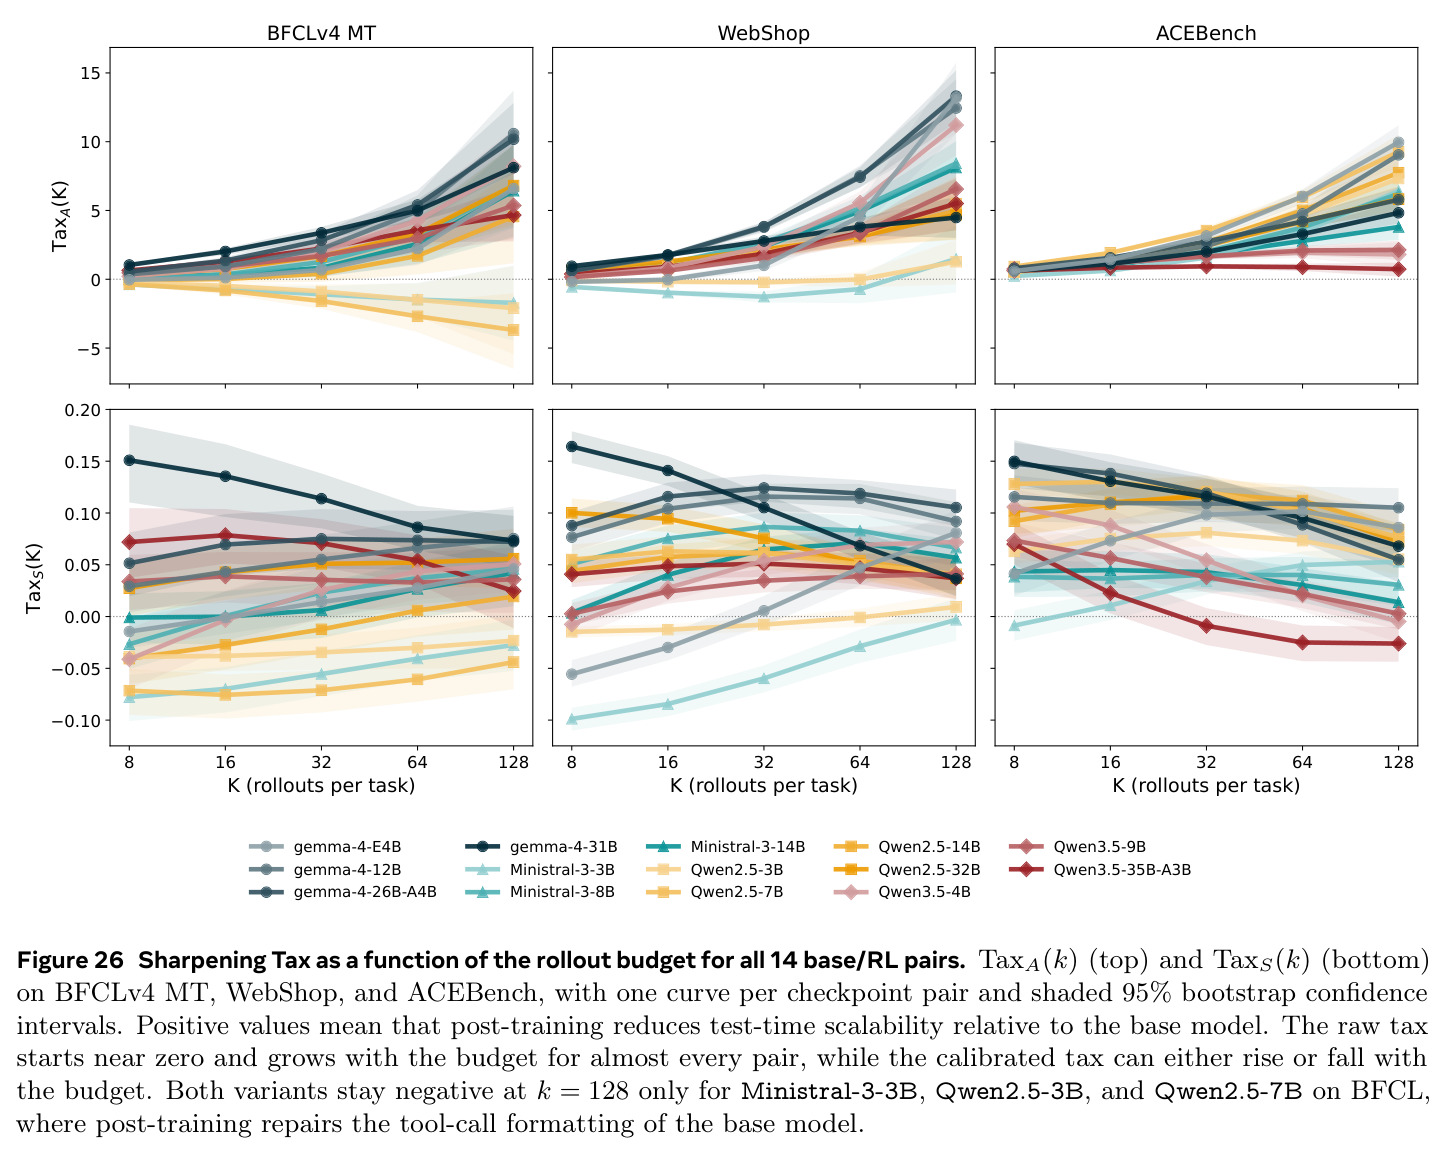
技术新颖性有四点。第一,指标创新:$A(K)$ 与经典等待时间/生存分析相连(Sheps 1964;Berkson-Gage 1952),把pass@K曲线的形状压缩为一个有概率含义的数——这是把重复采样文献从『性能工具』转为『诊断工具』的视角转换,用曲线形状而非端点揭示后训练对策略做了什么。第二,实证创新:首次在过程级校验的agentic环境中检验锐化假说,并揭示模型规模的调节作用——小模型(3-4B)的后训练主要是补技能(修复工具调用格式),税常为负;大模型的后训练主要是丢覆盖,税几乎处处为正;聚合曲线上最大骨干在 $k\approx22$ 被基座反超、最小骨干永不反超。第三,算法创新:PTGS属采样侧方案,但与已有温度调度(全局升/降温、训练进程调度、功率分布估计)的区别在于以Beta-Binomial后验难度为指导的双向per-prompt调温,零额外计算、不改RL更新、可直接套在PPO/GRPO上;消融证明固定温度($T\in\{0.5,0.7,1.0,1.3,1.5\}$)与截断解码(top-p/top-k/min-p)都做不到精度与覆盖同升。第四,理论闭环:Theorem 3证明加热难prompt同时提高 $I_n(q)=1-(1-q)^n$(组内至少一成功,PPO可强化信号的来源)与 $J_n(q)=1-q^n-(1-q)^n$(混合组,GRPO非零优势的唯一来源,在 $q<1/2$ 时随 $q$ 单调上升),把采样行为与学习信号直接挂钩。
实验结果
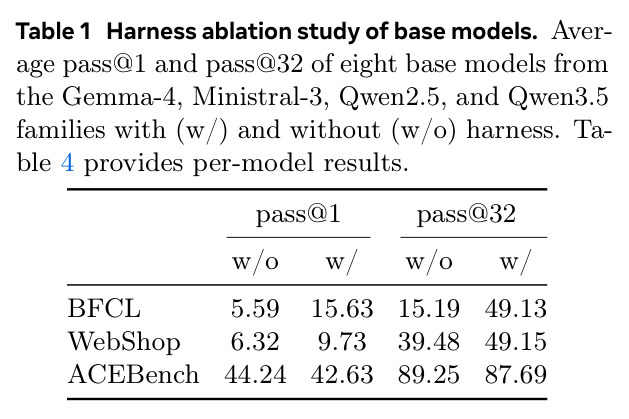
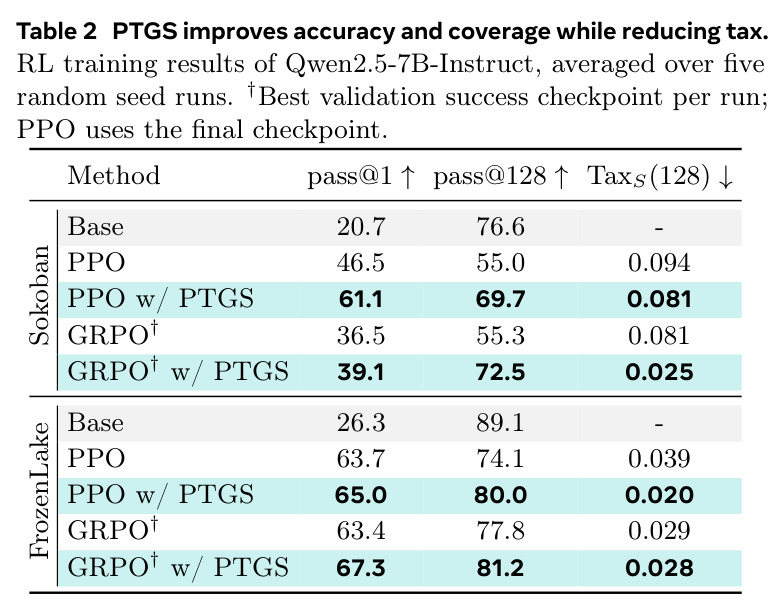
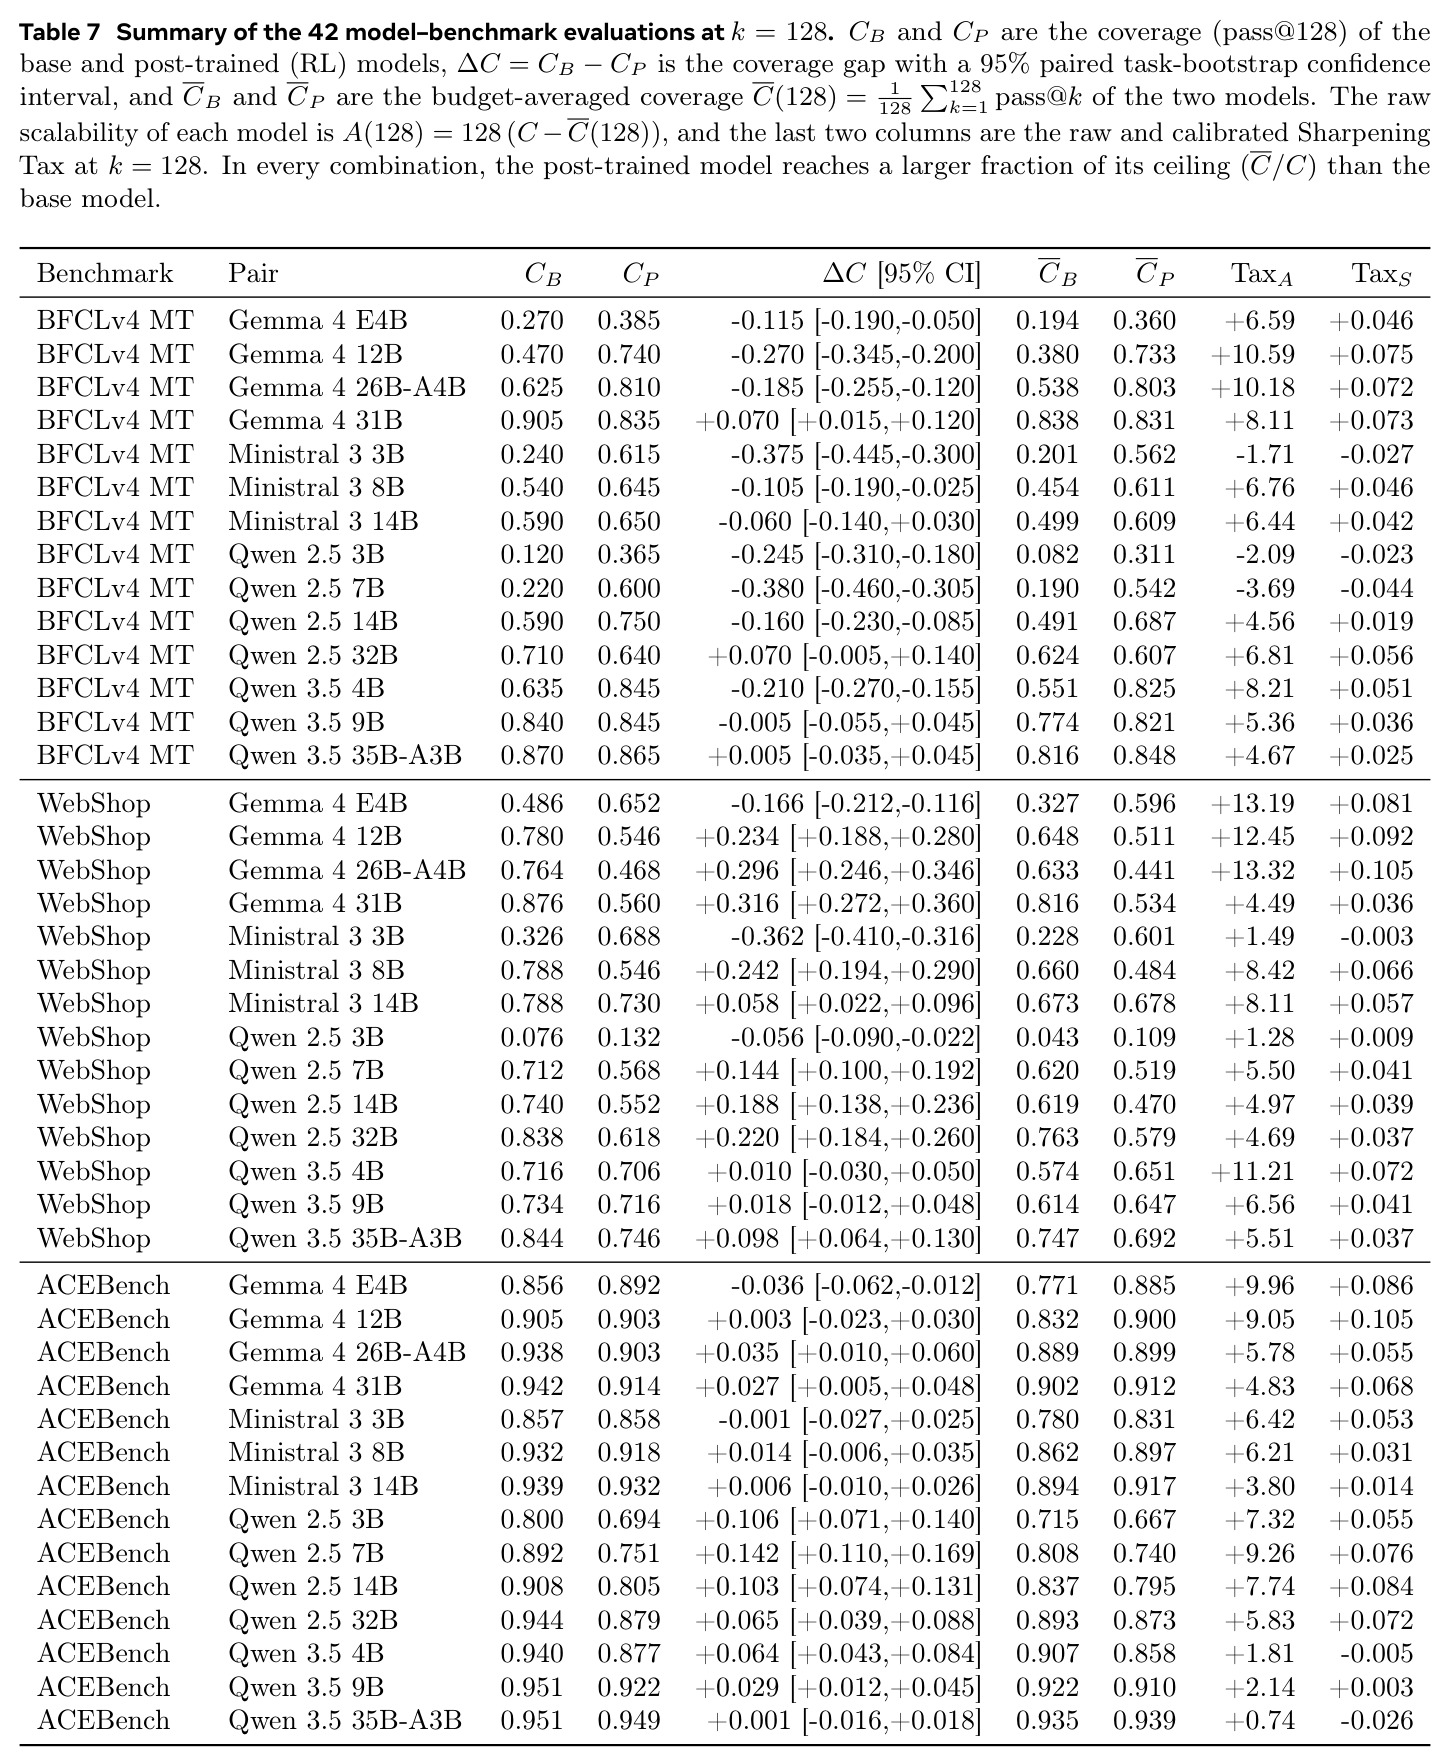
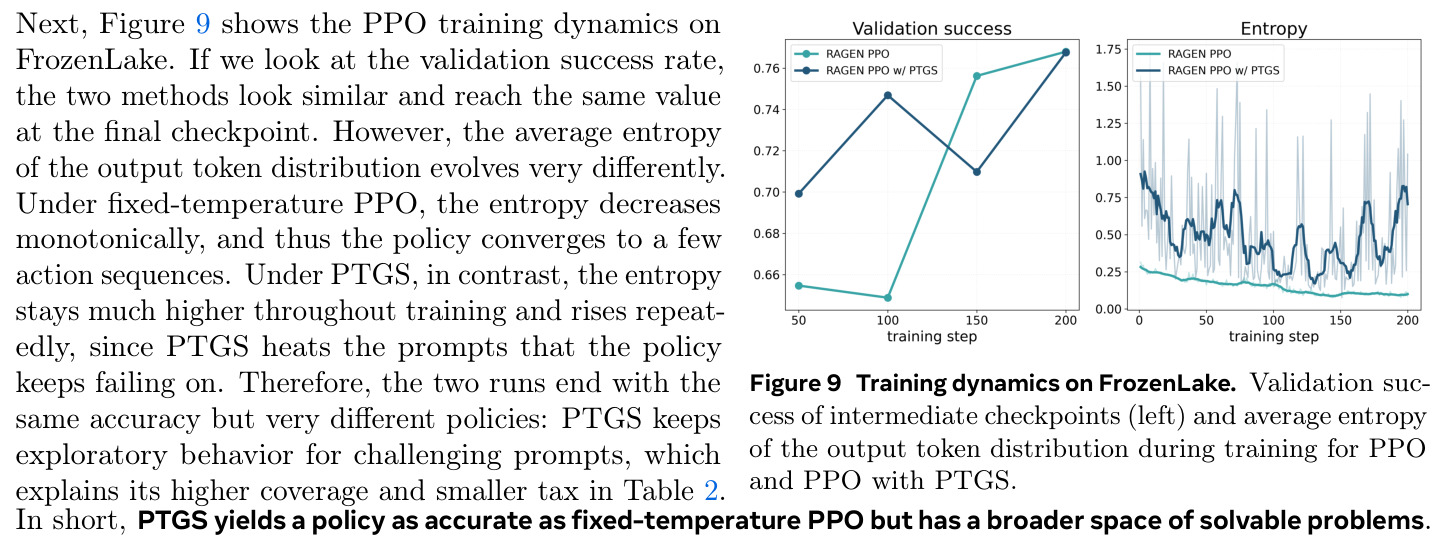
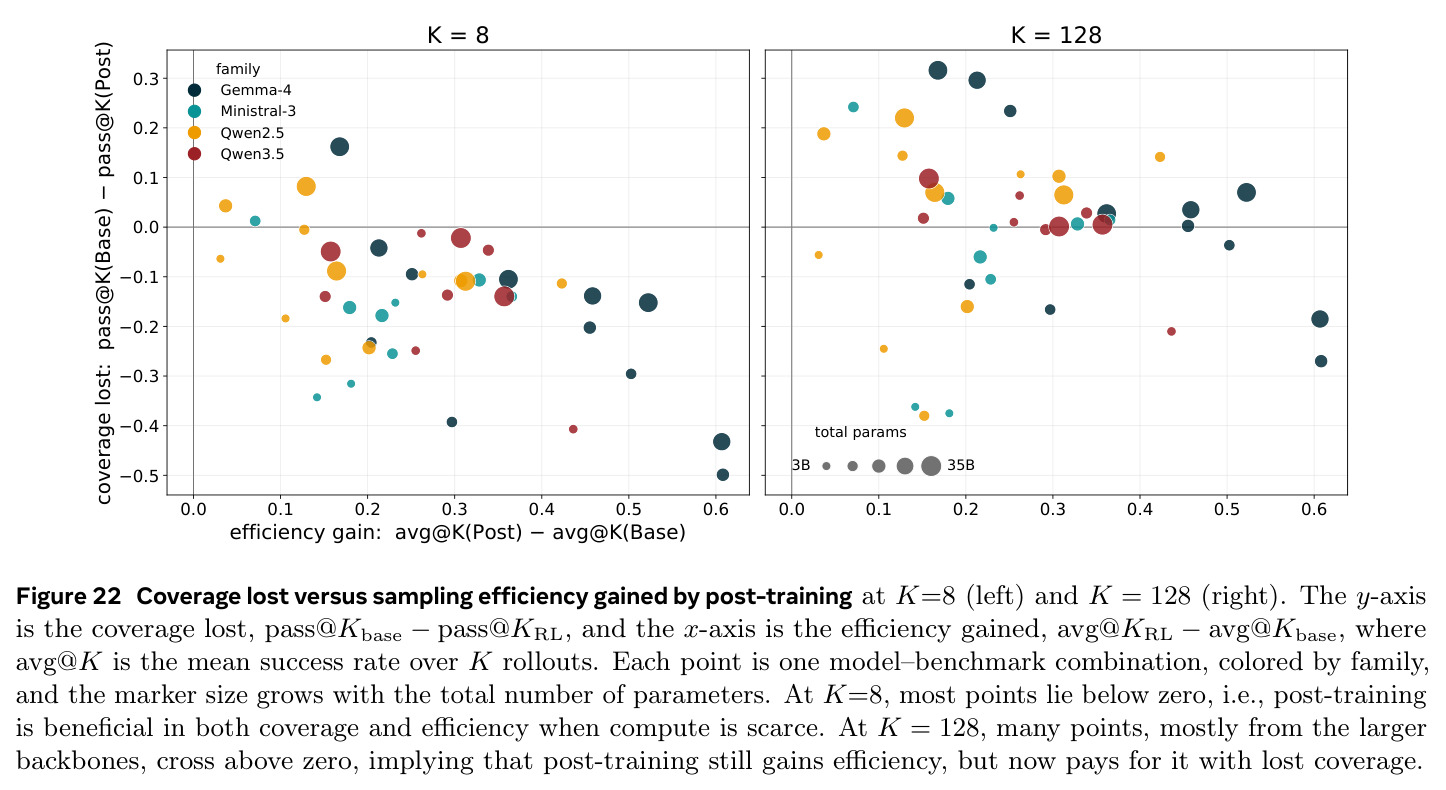
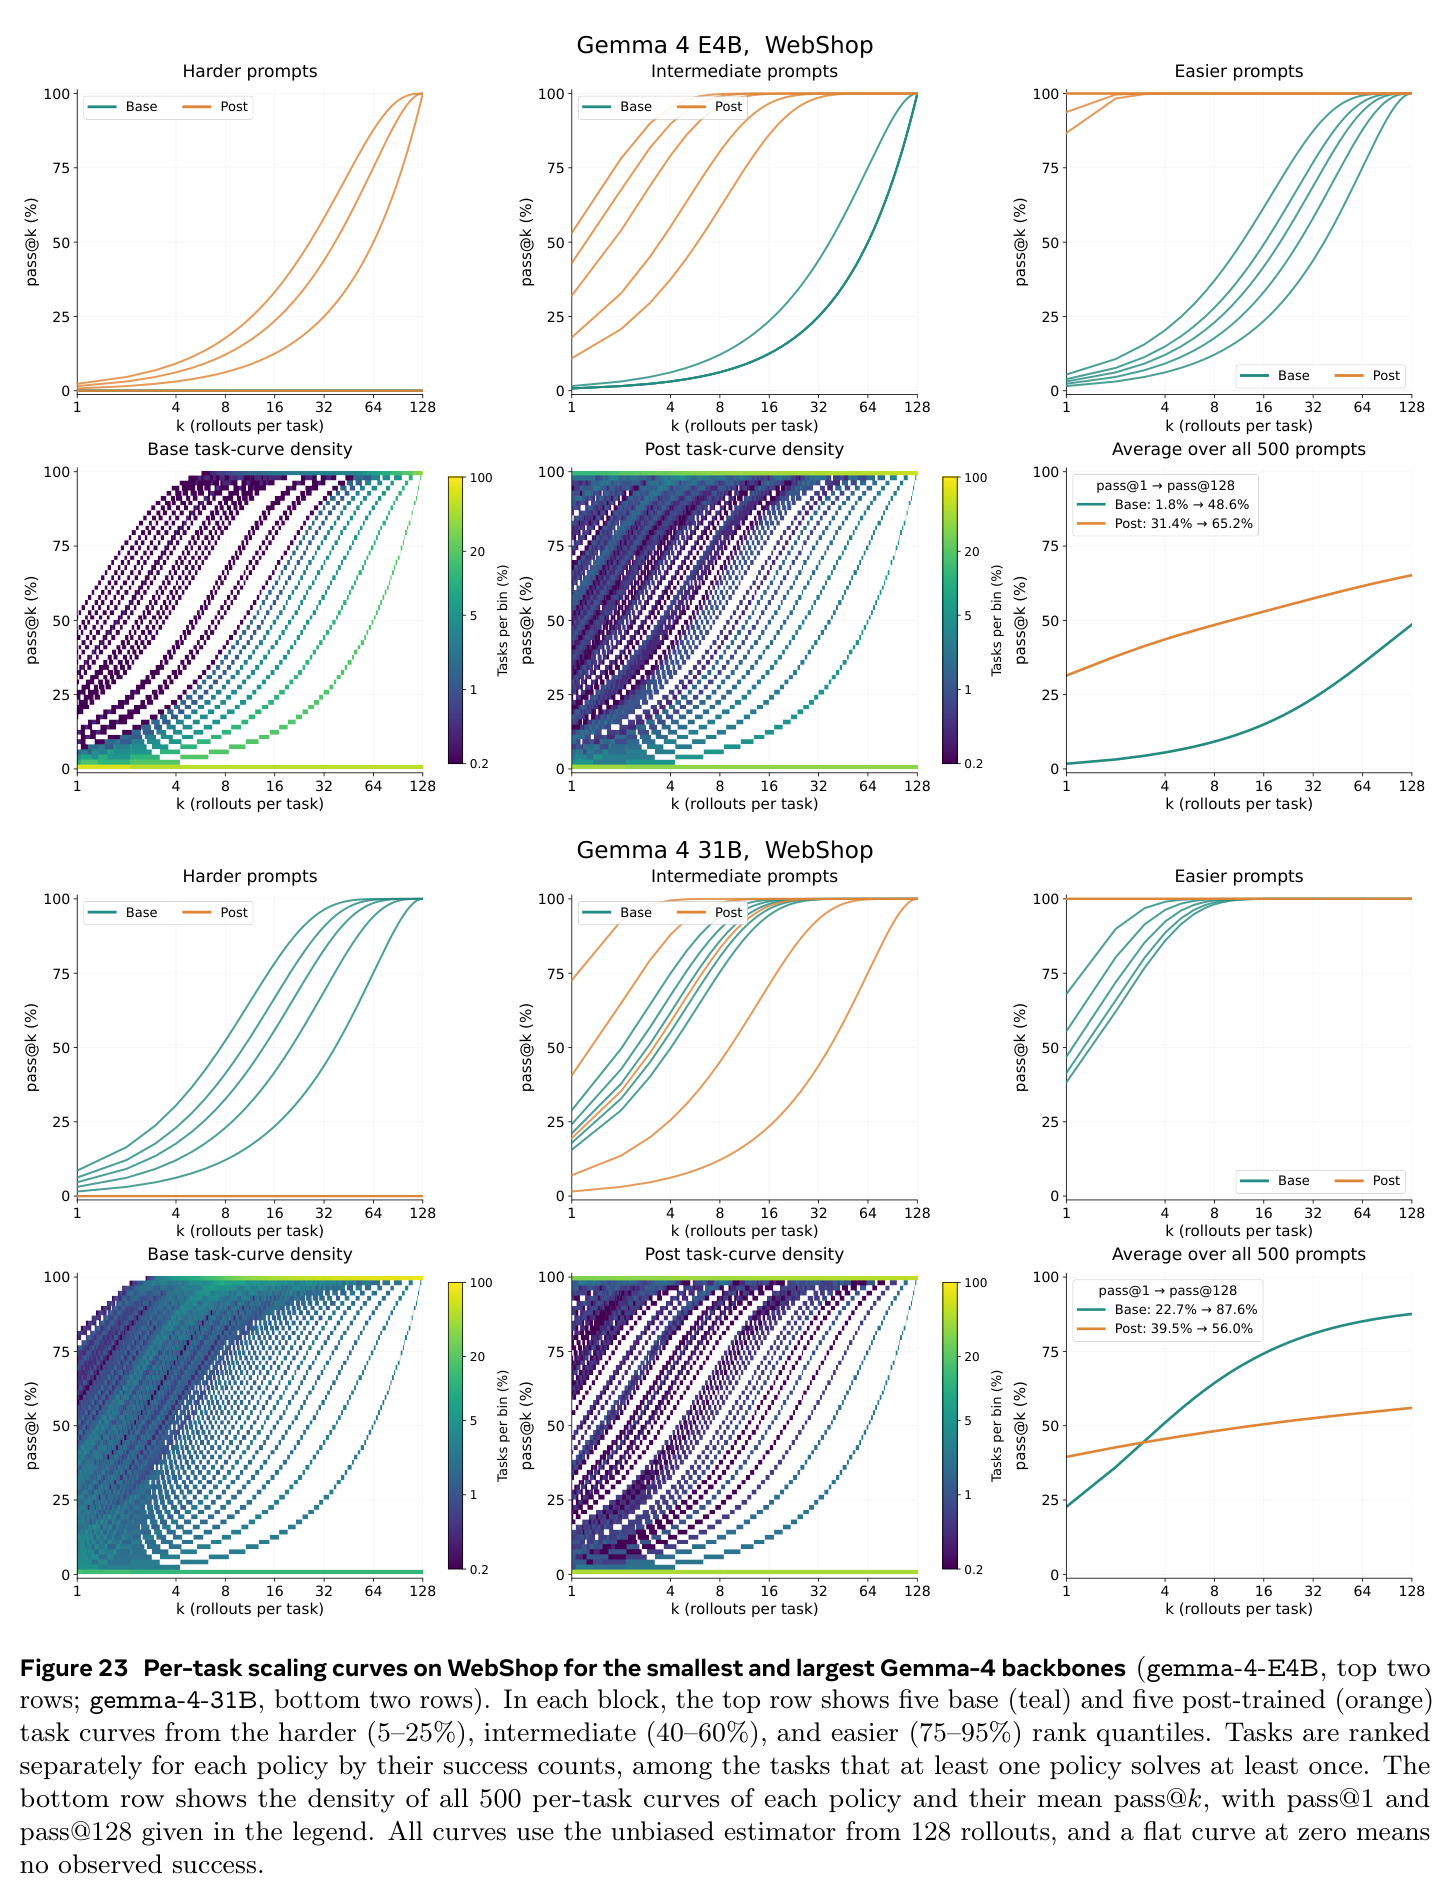
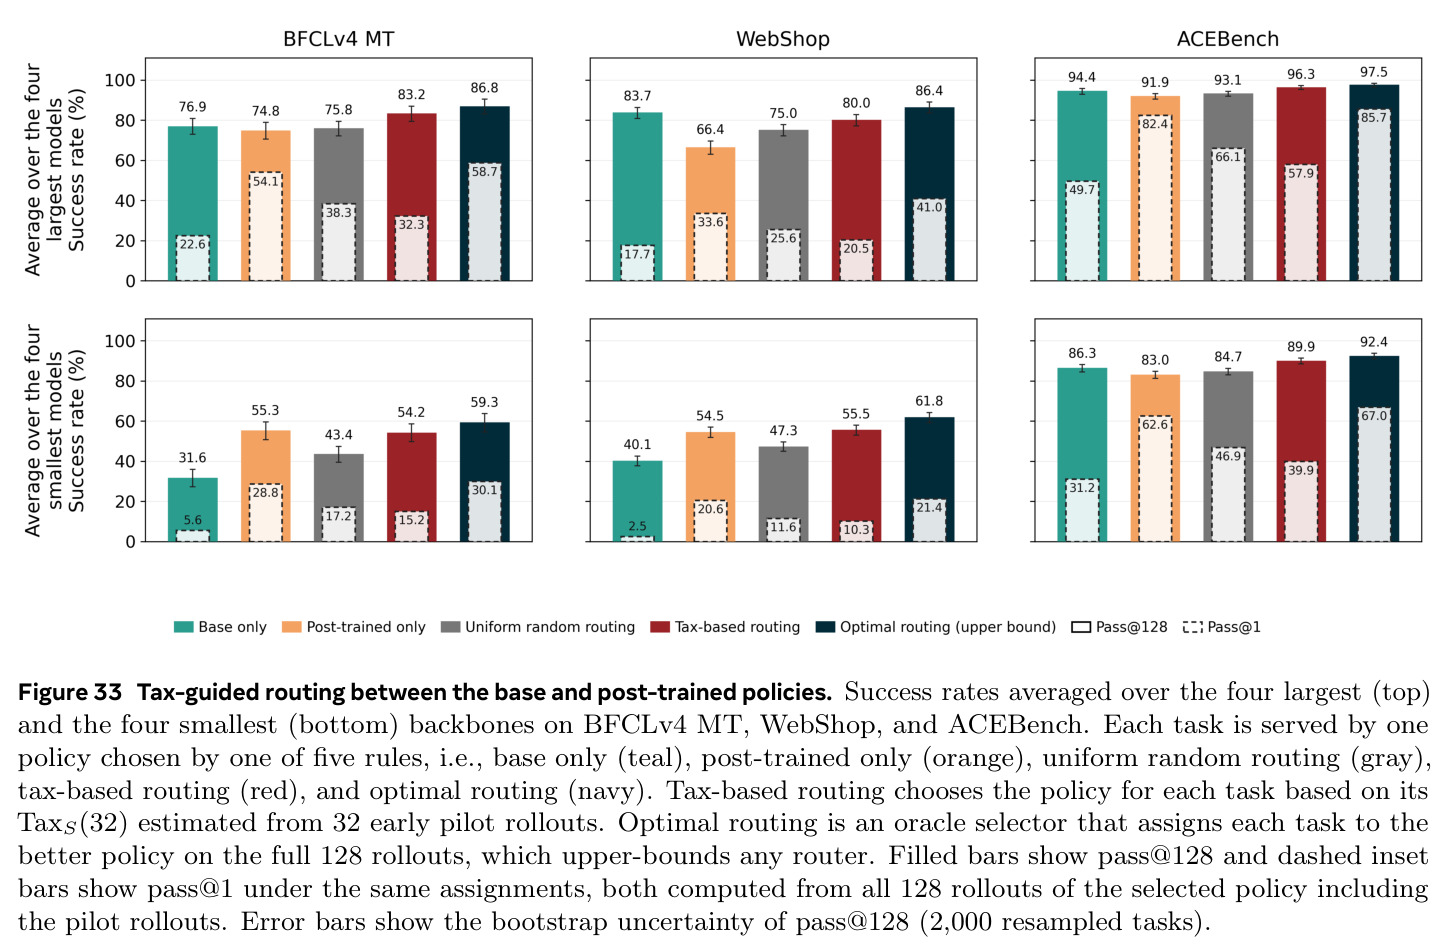
实验一(基座是被低估的智能体):BFCL上8个基座模型加harness后平均pass@1从5.59升至15.63、pass@32从15.19跃至49.13(六个基座不加harness得分为0);gemma-4-31B在WebShop上基座pass@1=22.7%但pass@128=87.6%,后训练版pass@1=39.5%、pass@128仅56.0%——预算足够大时基座反超。交叉预算 $k^*$ 随规模骤降:WebShop上从E4B的 $k^*>128$ 降到31B的 $k^*\approx3$(12B为16、26B-A4B为11)。实验二(双峰化机制):gemma-4-31B在WebShop的『多试能解』中间类从87.6%缩至30.0%,always pass从0.0%升至26.0%、always fail从12.4%升至44.0%;最大骨干聚合的always-solved份额从近0%升至37%。实验三(税的普遍性):42个模型-基准组合中36个 $\text{Tax}_S(128)>0$;最大骨干几乎处处为正且gemma-4-31B最大;最小骨干在 $k\le8$ 常为负(Ministral-3-3B最明显)、随预算转正;仅Ministral-3-3B与Qwen2.5-3B/7B在BFCL上为负(后训练修复了格式技能)。实验四(可预测性):$\text{Tax}_S(8)$(一半任务上估计)预测held-out任务的 $\text{Tax}_S(32)$,$\rho=0.85$;与一致性差 $\Delta\text{pass}_8$ 相关 $\rho=0.66$;且是唯一对 $\text{Tax}_S(32)$、$\Delta\text{pass@32}$、$\Delta\text{pass}_{32}$ 三个未来目标都有强统计显著的8-rollout预测器。实验五(PTGS,5种子均值):Sokoban上PPO从46.5/55.0/税0.094提升到61.1/69.7/0.081(pass@1/pass@128/$\text{Tax}_S(128)$),GRPO从36.5/55.3/0.081到39.1/72.5/0.025;FrozenLake上PPO从63.7/74.1/0.039到65.0/80.0/0.020,GRPO从63.4/77.8/0.029到67.3/81.2/0.028——精度与覆盖率同升、税下降。实验六(路由应用):用32个pilot rollouts的税估计做base/post路由,6个面板中5个pass@128超过后训练模型(最高+13.6点),4个面板同时超过两个单策略,pass@1处处高于基座。实验七(推理时PTGS):冻结Qwen2.5-7B-Instruct上以128 pilot+128 solution rollouts做估计后采样,在FrozenLake上同时逼近最冷温度的pass@1与最热温度的pass@128,全面位于全局温度帕累托曲线外侧。
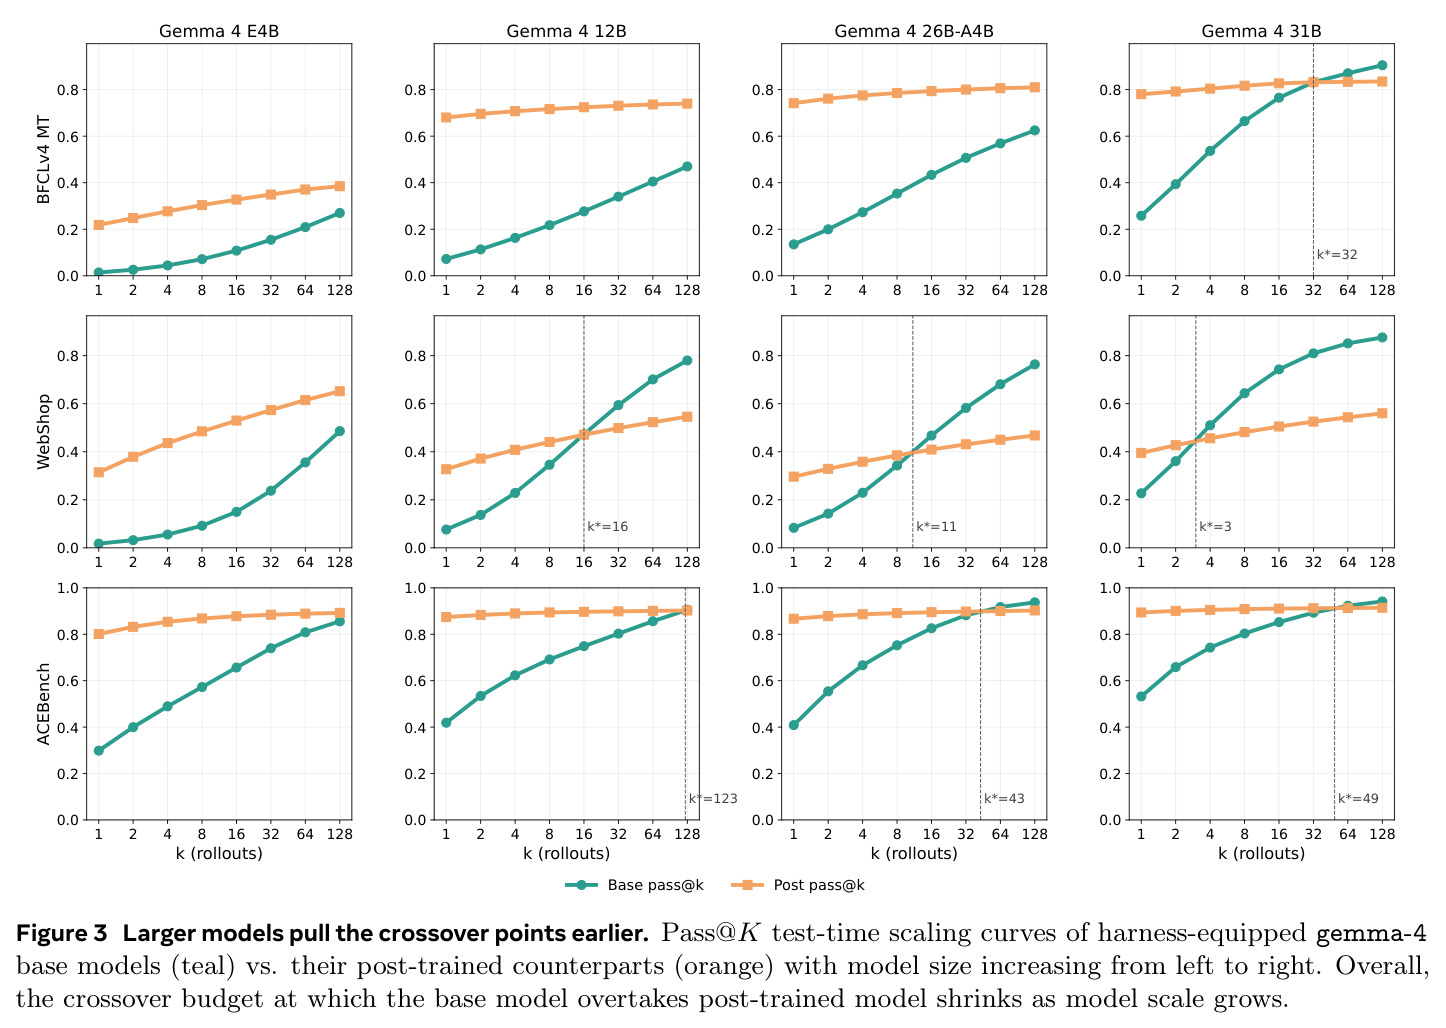
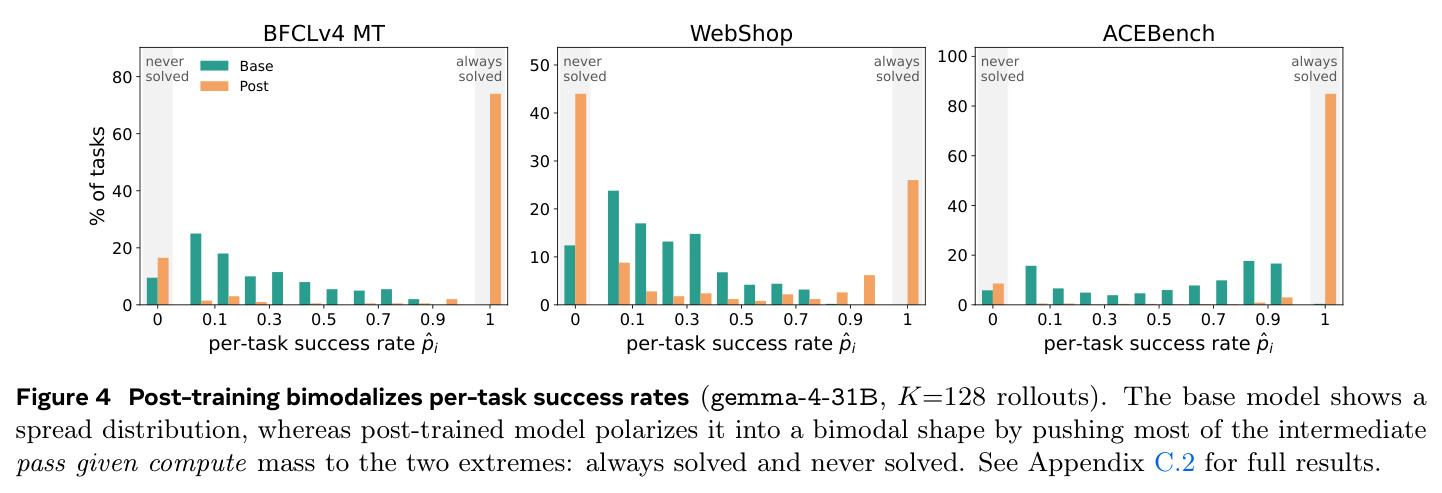
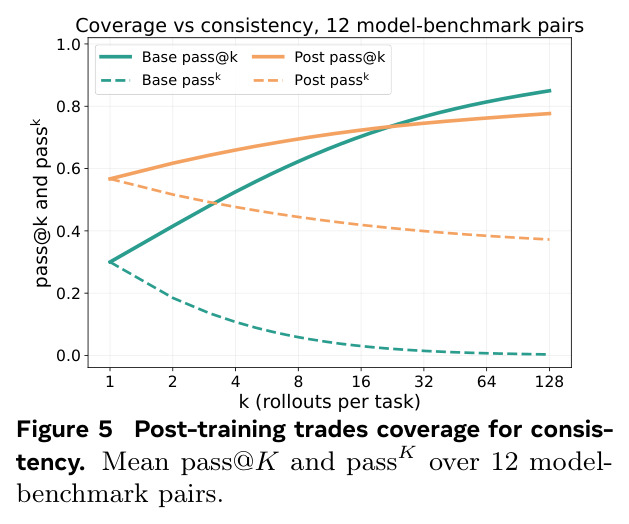
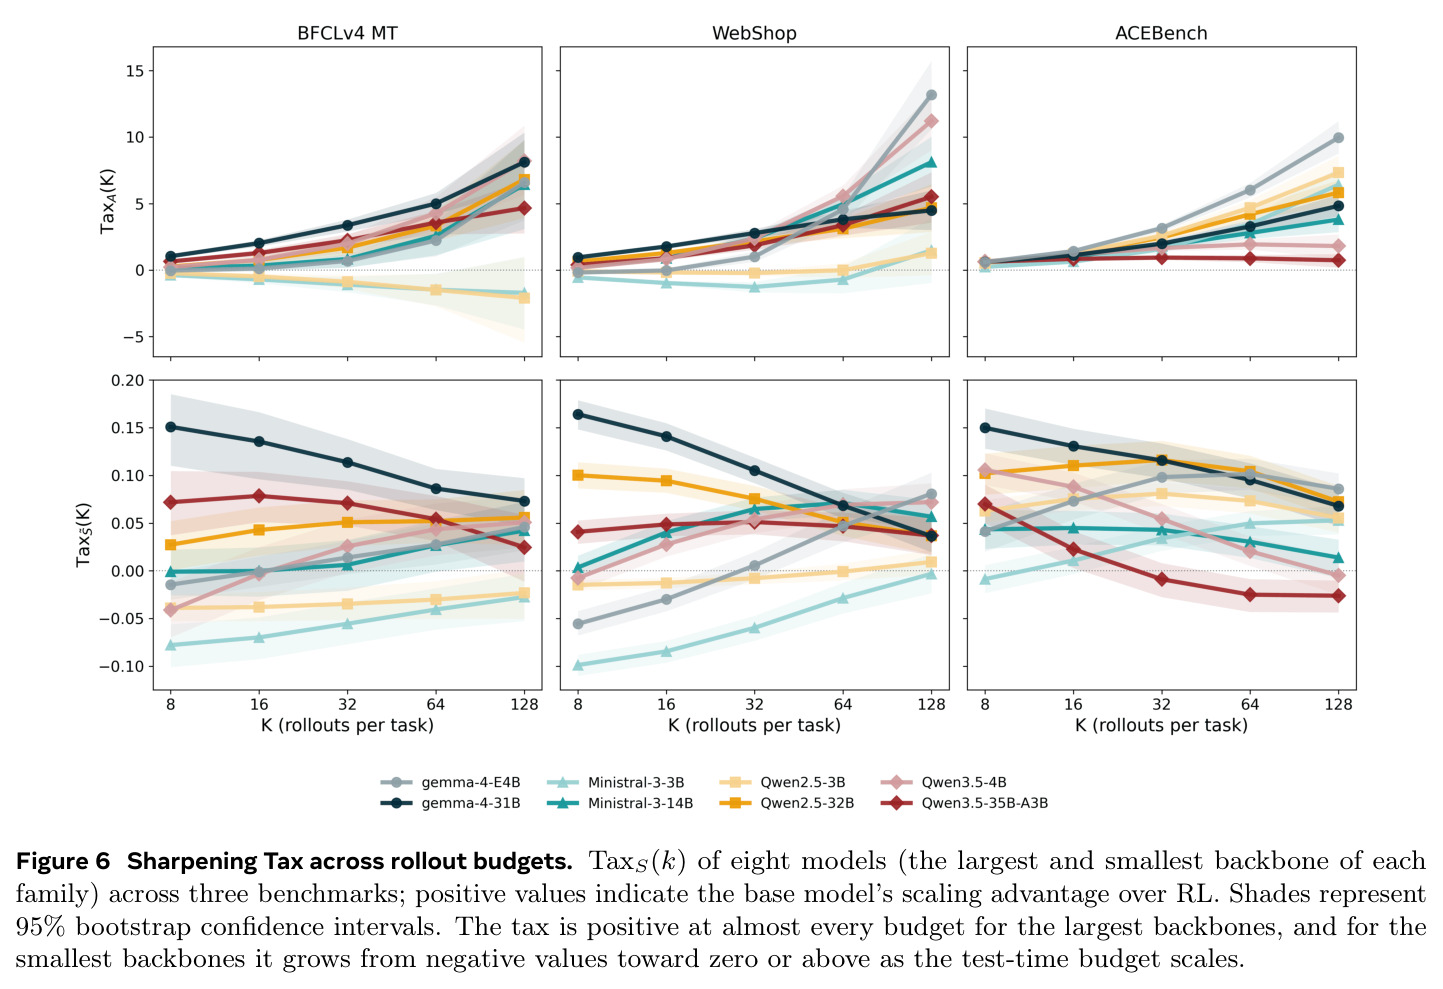
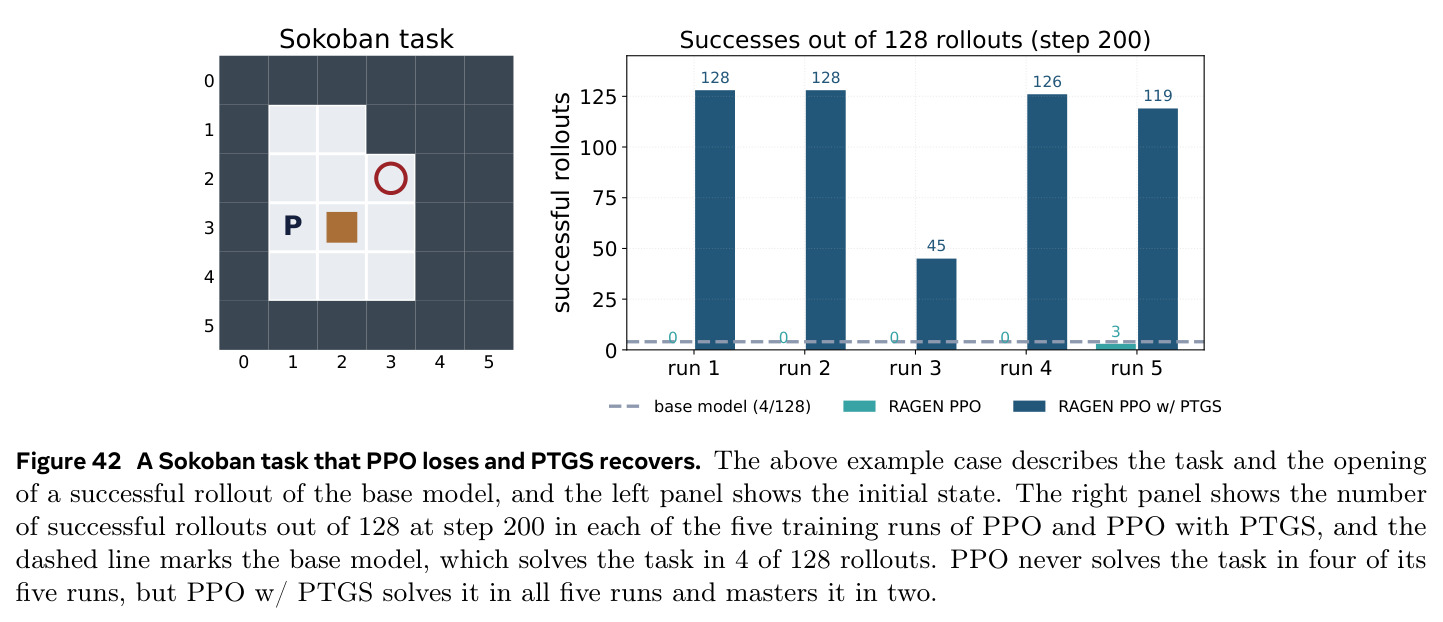
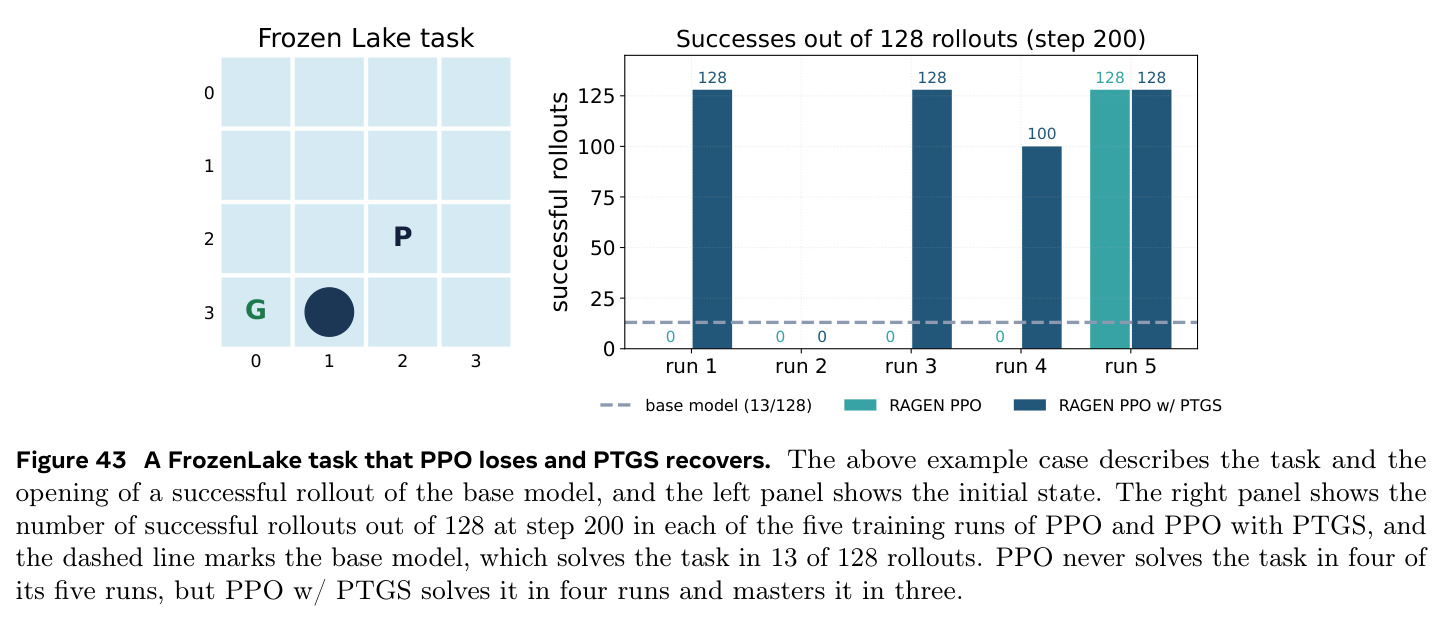
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 智能体工具调用(BFCL v4 多轮,基座harness消融) | pass@1 / pass@32(8个基座模型平均) | 加harness:15.63% / 49.13% | 无harness:5.59% / 15.19% | +10.0 / +33.9 个百分点 |
| 智能体购物环境(WebShop 500任务,gemma-4-31B) | pass@128(覆盖率) | 基座+harness 87.6% | gemma-4-31B-it 后训练 56.0% | +31.6 个百分点(同时pass@1低16.8点,体现权衡) |
| 锐化税普遍性(14对模型×3基准) | TaxS(128) 为正的组合数 | 36/42 组合为正 | 仅小模型+BFCL的3个组合为负 | 证明现代后训练普遍以覆盖换效率 |
| 税收早期预测(42组合,半数任务估计) | Spearman ρ | TaxS(8)→TaxS(32) ρ=0.85 | Δpass@1/Δpass@8/Δpass@32 等替代预测器无法同时预测三个目标 | 8 rollouts即可外推未来税收 |
| Sokoban 多轮RL(PPO,Qwen2.5-7B-Instruct) | pass@1 / pass@128 / TaxS(128) | PPO+PTGS:61.1 / 69.7 / 0.081 | 固定温度PPO:46.5 / 55.0 / 0.094 | +14.6 / +14.7 / 税降0.013 |
| Sokoban 多轮RL(GRPO) | pass@1 / pass@128 / TaxS(128) | GRPO+PTGS:39.1 / 72.5 / 0.025 | GRPO:36.5 / 55.3 / 0.081 | +2.6 / +17.2 / 税降0.056 |
| FrozenLake 多轮RL(PPO) | pass@1 / pass@128 / TaxS(128) | PPO+PTGS:65.0 / 80.0 / 0.020 | PPO:63.7 / 74.1 / 0.039 | +1.3 / +5.9 / 税降0.019 |
| 税引导路由(base vs post 按任务分配) | pass@128(最大骨干,WebShop) | 税引导路由,超后训练模型最多13.6点 | 仅用后训练模型 | 6面板中5个超post、4个双超单策略 |
局限与改进
作者承认的局限:分析是观察性而非干预性的——开源模型的预训练/后训练数据不公开,无法做因果归因,需要在数据完全可控的设置中复制;未比较不同后训练配方(RL、SFT、on-policy蒸馏)各自收多少税;范围限于文本LLM智能体,多模态与视觉-语言-动作模型的『精度-一致性-覆盖』三难是否成立未知;税依赖二值成功信号,开放性生成需换成质量门控的多样性度量。我的补充观察:其一,14对checkpoint的后训练配方不透明(-it模型混合SFT/DPO/RL,比例未知),虽然作者论证锐化不依赖具体配方,但机制归因仍显模糊;其二,评测脚手架不对称(基座用harness、后训练用默认脚手架),尽管Table 4消融显示harness对后训练模型平均有害,这一设计仍引入额外自由度;其三,PTGS仅在两个玩具网格环境(6×6 Sokoban、4×4 slippery FrozenLake、200任务池、Qwen2.5-7B)上验证,与真实RLVR场景(代码、工具调用)的奖励结构和轨迹长度差距较大;其四,每组合128 rollouts乘数百任务乘42组合的诊断成本高昂;其五,校准税以基座为参照,当基座本身极弱时(如Qwen2.5-3B在WebShop上pass@128仅13.2%)税的解释力下降;其六,PTGS超参($\tau$、$\gamma$、$\tilde p$ 调度)按环境手工挑选(GRPO在Sokoban用 $\tau=1.4$、FrozenLake用 $\tau=1.2$),缺乏自动选择准则。
独立分析的弱点
独立分析的弱点与改进方向:(1) PTGS验证域过窄——网格游戏奖励稀疏、轨迹短(每回合最多5轮),在多轮工具调用RL(如τ-bench、BFCL训练环境)的长轨迹、部分奖励场景下是否仍同时改善pass@1与pass@K未知,改进方向是先在中等规模代码/工具RLVR上复现。(2) 依赖per-prompt历史计数——任务池大、每个prompt只被采样几次时Beta后验不准(本文池仅200任务、每步8任务),改进方向是用语义嵌入聚类共享后验,或用奖励模型/难度预测器做冷启动。(3) 税的计算需要base/post配对评测且每任务128 rollouts,成本高——作者已示范8 rollouts外推(ρ=0.85),可进一步改为直接从训练rollout流式估计,做成训练仪表盘的免费副产品。(4) 理论假设同一prompt的rollouts条件独立,实际LLM采样存在模式趋同(尤其低温下),会高估重试价值、低估税。(5) 二值化丢信息——WebShop的密集奖励被二值化(仅reward=1.0算成功),部分正确的长轨迹被无视,可用部分信用扩展税定义。(6) 路由实验的pilot开销(32次rollouts)在小预算场景不划算,可探索更便宜的难度代理(prompt困惑度、任务长度)替代。
未来方向
作者提出的方向:(1) 在预训练/后训练数据完全已知的受控设置中做因果分析,回答锐化何时、如何出现;(2) 系统比较RL、经典SFT、on-policy蒸馏各自收税的差异;(3) 把精度-一致性-覆盖三难与PTGS推广到多模态LLM与视觉-语言-动作模型;(4) 把税扩展到开放性生成——用质量门控的多样性度量替代pass@k,考察对齐训练造成的输出多样性坍缩;(5) 刻画锐化如何改变依赖base/post对的技术(对比解码、模型合并、过程奖励模型)。基于本文成果可自然延伸:(a) 把税引导路由扩展为多模型/多温度服务层的成本优化器,用pilot rollouts在线分配推理预算;(b) PTGS与目标侧方法(熵bonus、pass@k感知目标、DAPO式方差过滤)正交组合,检验叠加收益;(c) 利用 $A(K)$ 的『期望失败重试次数』解释指导验证器设计与best-of-N预算分配;(d) 在更长训练(超过200步)与更大模型上检验PTGS是否延缓熵坍缩,并自动化 $\tilde p$ 调度;(e) 把 $\text{Tax}_S(128)$ 作为模型卡指标:发布后训练checkpoint时同时报告相对基座的税,让『可靠性与可达性共同增长』成为可核查的承诺。
复现评估
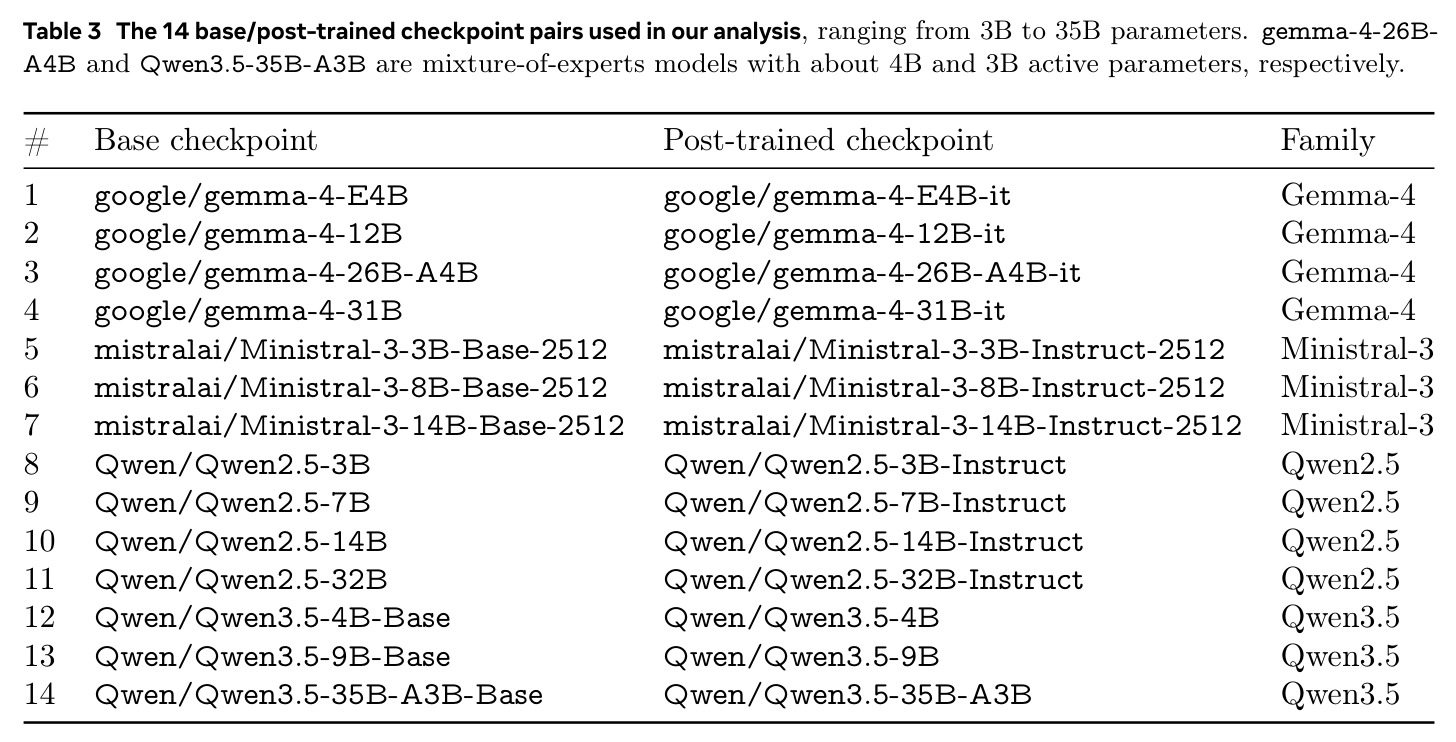
复现条件良好。代码与项目页已开源(github.com/changdaeoh/sharpening-tax,changdaeoh.github.io/sharpening-tax)。模型全部为HuggingFace公开checkpoint(Gemma-4、Ministral-3、Qwen2.5、Qwen3.5共14对,3B至35B),用vLLM 0.19.0(gemma-4-12B用0.23)serving;基准全公开:BFCL v4 multi_turn_base(200任务,每轮最多20次工具调用)、WebShop前500任务(1000商品索引、30步上限)、ACEBench 770任务子集。附录给出harness完整prompt模板与停止序列、解码配置(BFCL温度0.4、其余0.7,top_p=0.95,每任务128 rollouts)以及税计算的伪代码(Listing 1)。PTGS部分基于RAGEN/StarPO框架微调Qwen2.5-7B-Instruct:200步、每步8任务×16 rollouts=128条轨迹、AdamW actor学习率 $10^{-6}$、critic $10^{-5}$、DAPO式非对称clip 0.2/0.28、无KL惩罚、5个随机种子,在64个held-out任务×128 rollouts、$T=0.5$ 下评估;超参齐全($\gamma=0.95$、PPO $\tau=1.5$、GRPO按环境1.4/1.2、$\tilde p$ 从0.25升至0.5)。算力上,诊断部分推理量大(42组合×两策略×数百任务×128次rollout),单对单卡可行、全量需多卡集群;RL部分为7B模型200步,属中等规模(单节点多卡)。难度评估:复现诊断结论中等(主要是推理预算问题),复现PTGS训练中偏高(需熟悉RAGEN/StarPO与多轮RL基础设施)。
论文图表
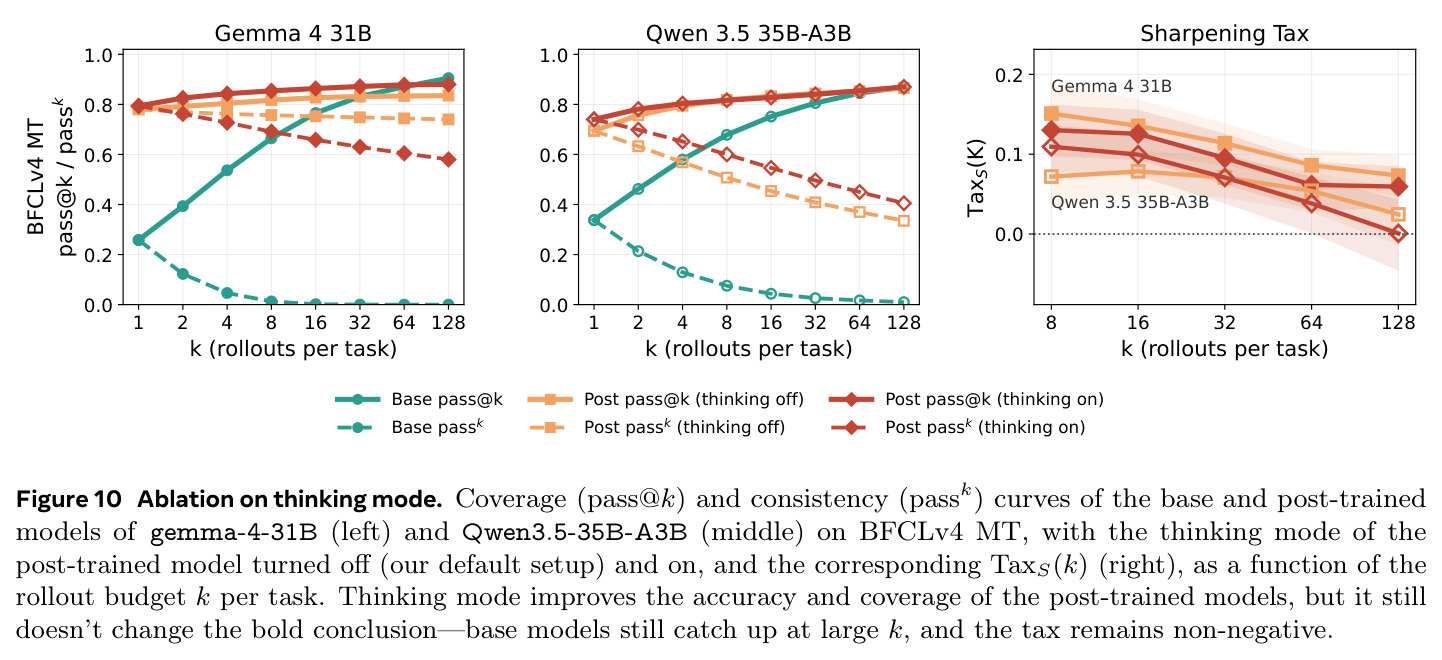
在BFCL上对比后训练模型thinking开/关:打开thinking改善精度与覆盖率,但基座模型在large k处仍追平,税仍非负——主结论不因关闭thinking而改变。
排除『结论依赖统一关闭thinking模式』的质疑,说明预算按rollout数计的公平性设定不影响结论。