语言模型的自保护:任务库自生成重放与目标选择 Self-Preservation in Language Models
模型可自生成重放数据保护旧能力,较大模型还能挑选重放目标。
前置知识
灾难性遗忘与持续学习(Catastrophic Forgetting / Continual Learning)
预训练模型在新数据上微调时,新任务的梯度更新会覆盖旧能力的参数表征,导致旧任务性能骤降,即灾难性遗忘。持续学习(CL)的目标是让模型学新不忘旧,常见手段包括正则化约束参数更新、动态扩展结构,以及重放旧数据。本文的持续指令微调指在指令数据上连续训练而不丢失通用能力。
全文围绕'如何在适配新任务时保留旧能力'展开,所有实验设计和指标都针对遗忘的度量与缓解,不懂这个框架无法理解论文动机。
重放(Replay)与自生成重放(Self-Replay)
重放是把旧任务样本混入新任务训练中以提供保护信号的经典方法。当原始训练数据不可得时,可以让模型自己生成旧任务的伪样本(如 LAMOL 生成伪示例、Self-Synthesized Rehearsal 合成并筛选实例)。本文的 Task-Bank Self-Replay 由冻结的更新前模型按任务库条目生成'问题+答案'作为重放数据。
自生成重放是本文方法的基础组件,理解它与真实数据重放的区别是解读实验对照(SFT / 单任务重放 / 真实重放 / 自生成重放)的前提。
任务库(Task Bank)
本文提出的紧凑任务条目集合 $B=\{b_1,\dots,b_m\}$,每个条目包含任务名、行为与输入输出格式的文字描述、可选的少量演示样例。它只记录'打算排练什么行为',与实际生成的重放样本解耦,因此库的覆盖广度(选哪些条目)与样本深度(每条目生成多少)成为两个独立可调的设计变量。
任务库是本文所有实验的组织中枢:库组成实验、目标选择实验、held-out 评估都建立在'先声明要保护什么、再生成数据'这一解耦之上。
成对 Retention 指标
$\text{Retention}=\dfrac{\#(\text{训练前答对且训练后仍答对})}{\#(\text{训练前答对})}$,即在相同评测样本上追踪'原先正确的答案是否保持正确'的比例。它与任务级准确率变化并列报告,因为新纠正的答案会掩盖丢掉的旧正确答案:本文实验中 3.56% 的对→错被 3.61% 的错→对抵消,净变化仅 +0.05 pp。
这是本文评估协议的核心创新点,全文几乎所有结论(合并库、目标选择、学习率扫描)都以 Retention 为主指标,不懂它就读不懂结果表。
Held-out 任务隔离
指一组评测任务,其样本、标签、任务描述和分数全部被排除在任务库构造与重放目标选择之外,只在训练后用于评测。本文中 ARC-Challenge、WinoGrande、PIQA、SVAMP 四个任务被隔离,而 MMLU、HellaSwag、GSM8K、BoolQ 进入任务库,MedQA 和 C-STANCE 作为新任务。
只有在这种严格隔离下,held-out 任务上的保护效果才能归因于'保护外溢到了清单之外',而不是评测数据泄漏;这是论文主张成立的方法论基石。
研究动机
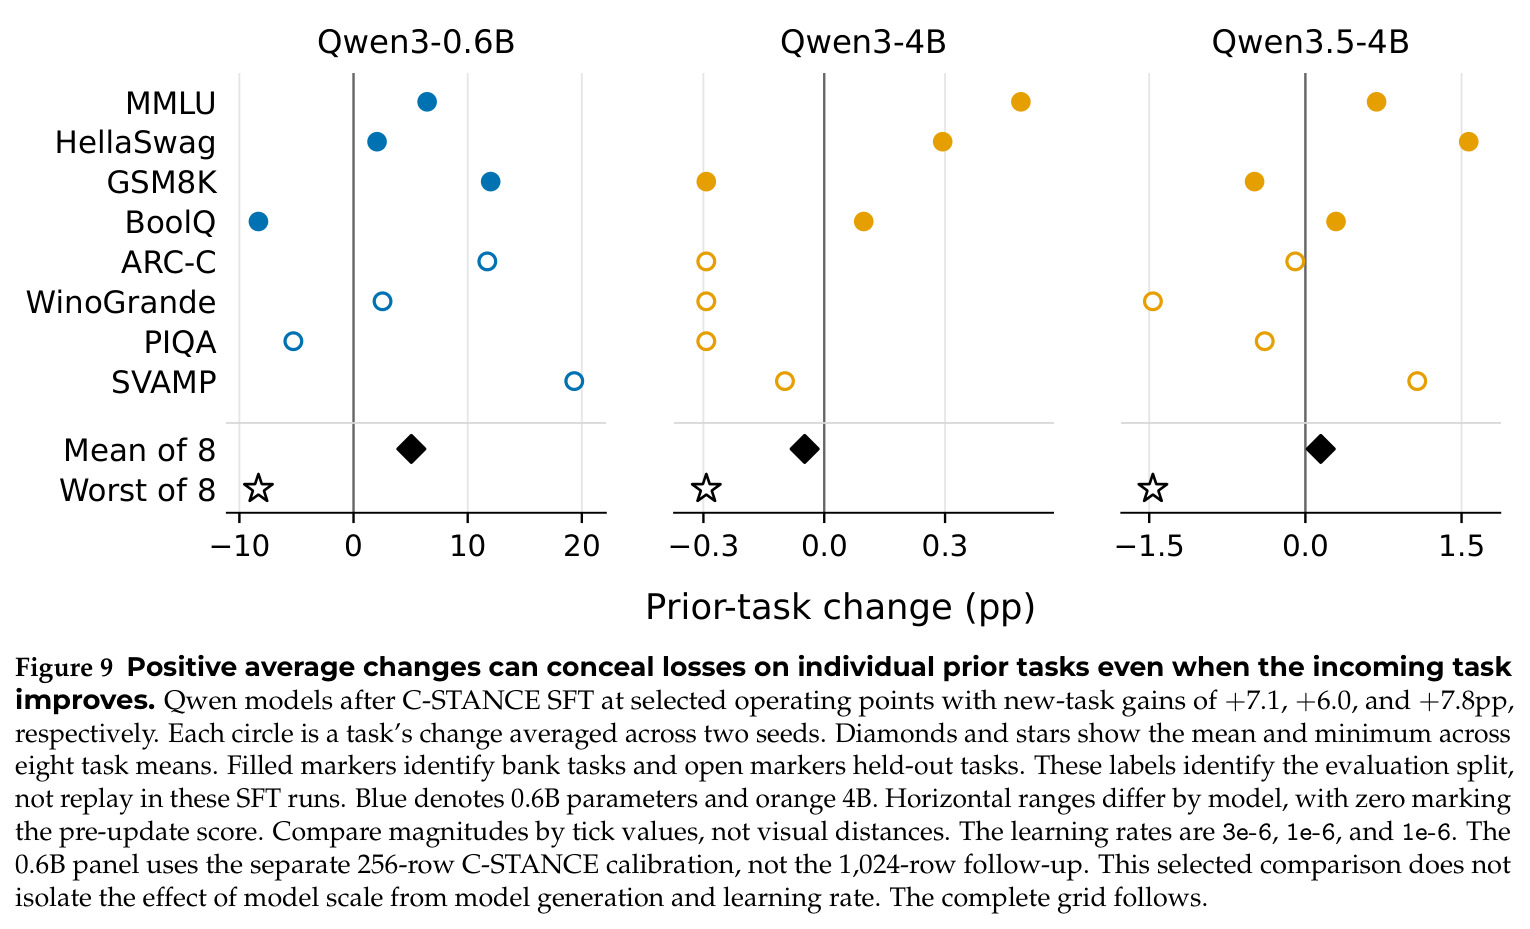
持续学习希望模型在学新任务时不丢旧能力,但现有做法面临两个具体困难。其一,提供给保护机制的任务只覆盖模型能力的一小部分,而遗忘会蔓延到清单之外:作者在 Qwen3-4B 上用 256 条 MedQA 数据做一次 SFT(学习率 $10^{-6}$、1 epoch),发现四个从未参与训练的 held-out 任务(ARC-C、WinoGrande、PIQA、SVAMP)平均有 3.56% 的原本答对样本变错,同时有 3.61% 的原本答错样本变对,净变化只有 +0.05 pp——只看平均准确率几乎察觉不到任何损失,但模型实际上丢掉了大量原本正确的答案。其二,遗忘形态高度依赖训练配置:36 组扫描实验(3 个模型 × 2 个新任务 × 3 种学习率 × 2 种子)显示,同一模型在 MedQA 与 C-STANCE 上训练,各旧任务的涨跌模式完全不同;而学习率 $10^{-5}$ 时六个模型-任务组合的新任务准确率全部下降,说明是适配失败而非必要的取舍。传统重放依赖原始训练数据,当数据不可得时,保护证据天然残缺,无法覆盖模型真正需要保留的能力。
本文的目标是本文要回答的核心问题是'自保护'(self-preservation):模型能否利用自身知识,帮助决定在适配新任务时应保护什么、以及如何产生保护证据?这被拆解为三个可检验的子问题。第一,用冻结的更新前模型为给定任务条目自生成'问题+答案'作为重放数据(Task-Bank Self-Replay),能否保护那些从未进入重放构造的 held-out 任务?第二,把两个不完整的任务库合并以扩大覆盖,是否比单独使用任一库保护得更好?第三,让模型参与挑选重放目标——尤其是把'新任务是什么'的信息提供给选择器——能否优于随机挑选?作者同时要求评估必须兼顾保留与新学:既看新任务准确率增益,也看旧任务准确率变化和成对 Retention(原先答对、训练后仍答对的比例),因为平均准确率会掩盖损失,而重放在固定样本预算下还可能挤占新任务学习。
与已有工作不同的是,已有工作证明了模型能自生成重放数据:LAMOL 用伪样本排练旧任务,Self-Synthesized Rehearsal 用上下文演示合成实例并做多样性筛选,Marek 等的 Self-Replay 研究自生成重放与容量、优化的交互,CPLUS 用锚点与自探针梯度把保护扩展到锚点任务之外。但这些方法都把'重放什么'当作给定条件,没有系统研究任务库的组成方式,也没有让模型参与选择重放目标;MIR 虽按预期干扰挑选重放样本,但那是样本级、生成之后的选择。本文的独特切入是把'保护目标的选择'上升为显式设计决策:用任务库把'要排练什么行为'与'生成了哪些样本'解耦,并将四个 held-out 任务的样本、标签、描述和分数全部排除在库构造与目标选择之外,从而首次能严格度量'保护是否外溢到清单之外',同时把选择器输入(无信息/仅库信息/库加新任务信息)作为受控变量。
核心方法
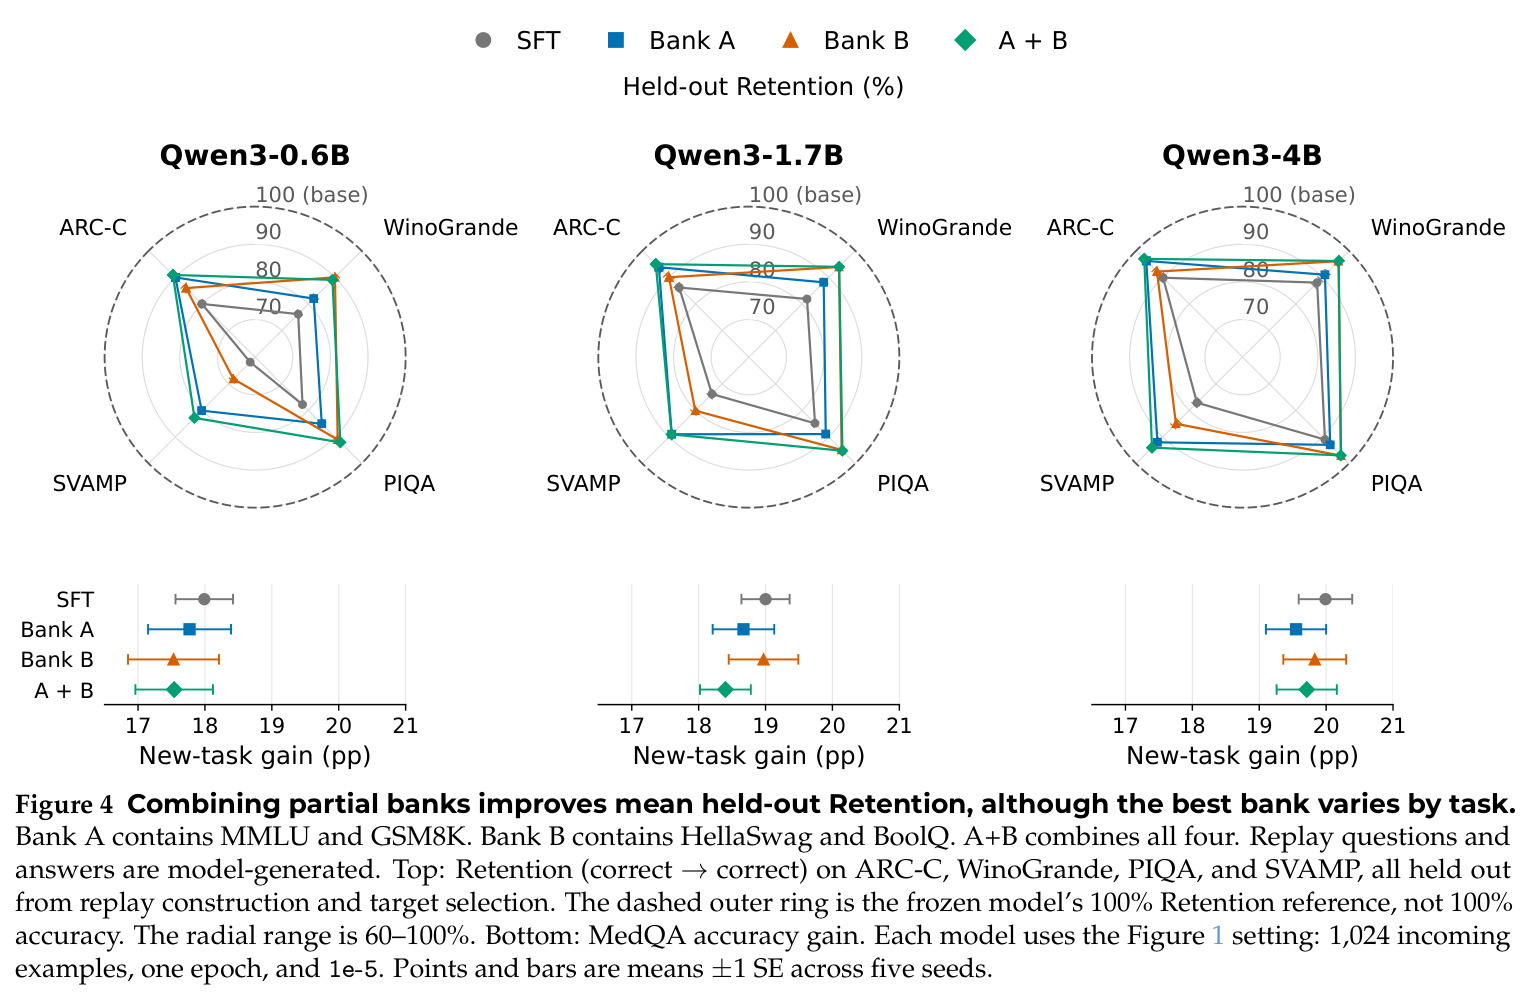
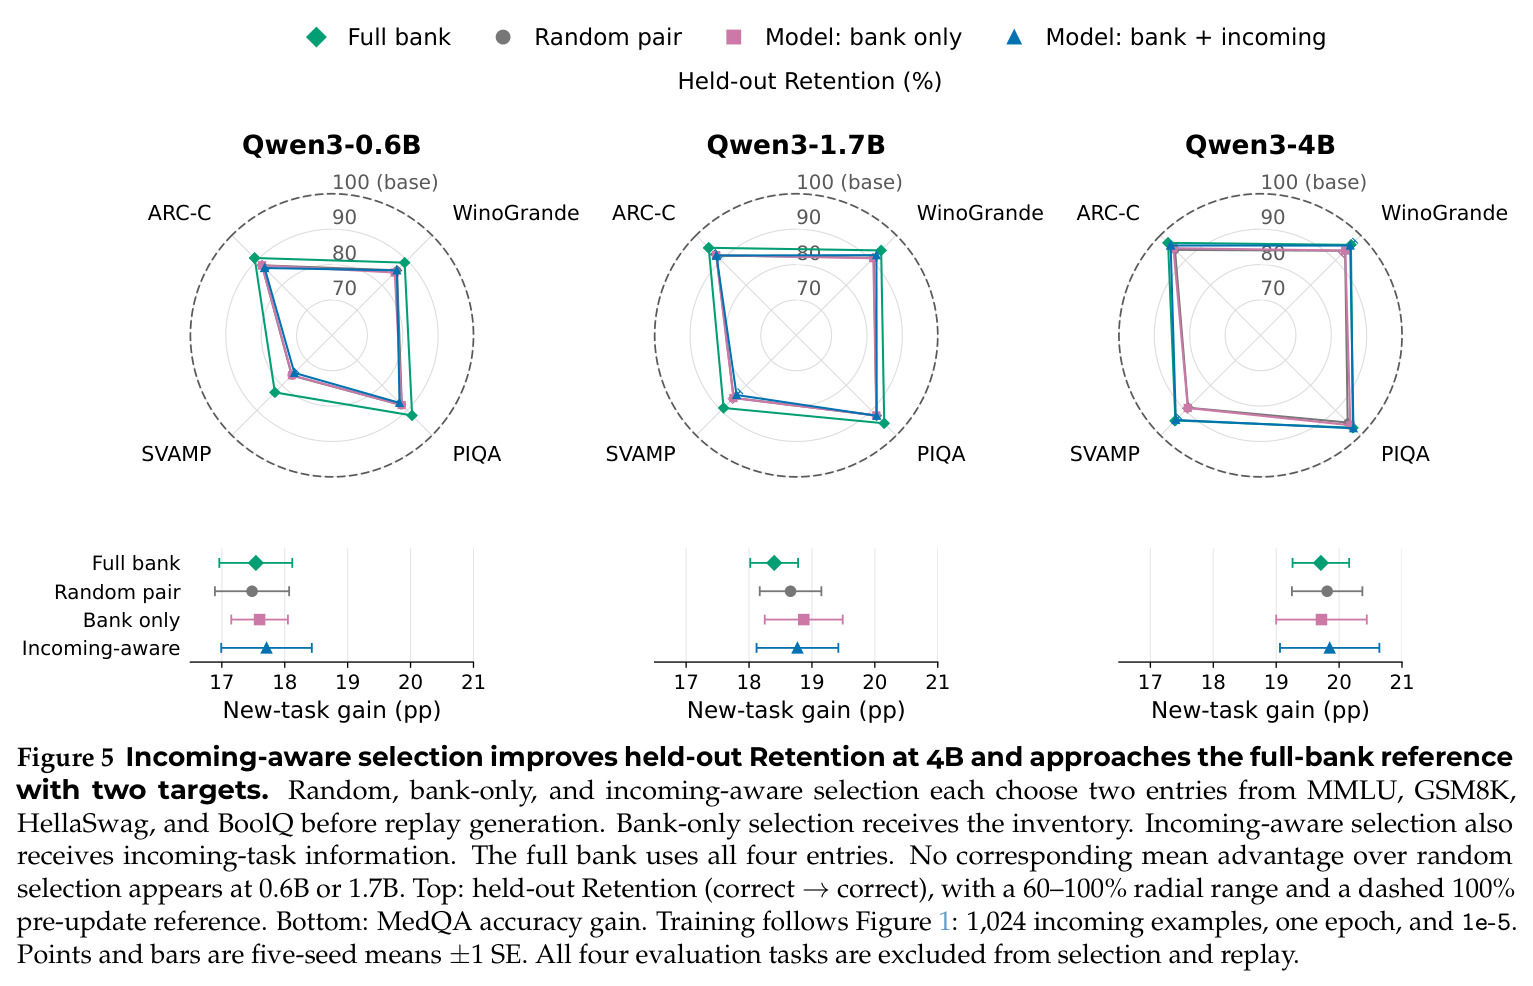
方法的直觉是:与其只靠外部提供的少量旧数据,不如让模型把'我大概会什么'写成任务条目清单(Task Bank),再由冻结的旧模型按选中条目生成重放样本,混入新任务数据一起做 SFT。技术路线分四层。第一层构造任务库 $B=\{b_1,\dots,b_m\}$,条目 $b_i$ 含任务名、行为与输入输出格式描述、可选演示;主实验的库由 MMLU、HellaSwag、GSM8K、BoolQ 组成,可拆成 Bank A(MMLU+GSM8K)与 Bank B(HellaSwag+BoolQ)。第二层目标选择:生成重放之前先选出子集 $S\subseteq\{1,\dots,m\}$,比较随机选两条、仅用库信息选、用库加新任务信息选三种方式。第三层重放生成:冻结的更新前模型为选中条目生成问题和答案(固定预算实验改为'给定问题、给两条已验证演示、不给原答案'让模型自答),生成在更新前一次完成。第四层学习:学习者在新任务样本与重放的混合集上最小化 SFT 损失(全参数 AdamW,1 epoch),参考模型全程冻结;选择器、生成器、学习者即使共用检查点,角色也保持分离。评估时新任务增益、库内变化、held-out 变化与成对 Retention 分别报告。
核心创新在于把持续学习中的'生成式重放'从一个固定配方升级为一组可比较的设计决策,并首次把部分选择权交给模型。与 LAMOL、Self-Synthesized Rehearsal 等'为给定任务生成数据'的方法相比,本质区别有三。其一,库与样本解耦:Task Bank 只声明'打算排练什么行为',生成器按条目产出样本,使库的组成(广度)与每个目标的样本量(深度)成为独立旋钮,直接支撑'合并部分库是否更好'的对照实验。其二,选择输入被严格控制:随机、仅库信息、库加新任务信息三种选择器共用同一生成器与样本预算,因此 Retention 的任何差异都可归因于模型在选择上的贡献,而非生成质量差异。其三,评估协议保证外溢可测:四个 held-out 任务的样本、标签、描述、分数全部不参与库构造与选择,Retention 按成对样本计算(正确→正确),把'保住原本会的'与'新学会的'分开计量,避免了平均准确率制造的假象(净 +0.05 pp 背后是 3.56% 对→错与 3.61% 错→对的相互抵消)。
方法步骤详情
以 Qwen3-4B 学习 MedQA(1024 例、学习率 $10^{-5}$、1 epoch、5 个种子)为例。第一步,构造任务库:收集 MMLU、GSM8K、HellaSwag、BoolQ 的任务描述与可选演示,形成 Bank A、Bank B 与合并库 A+B;ARC-C、WinoGrande、PIQA、SVAMP 被隔离为 held-out。第二步,选择目标:随机选择器从四个条目抽两条;仅库选择器只看条目描述挑两条;新任务感知选择器额外拿到 MedQA 的任务信息再挑两条(附录 C.6 给出提示词)。第三步,生成重放:把选中条目的描述喂给冻结的更新前模型,让其生成'问题+答案'对;固定预算实验则给定问题与两条已验证演示、隐去原答案让模型自答。第四步,混合训练:学习者在新任务样本与重放的混合集上做全参数 AdamW 的 SFT,主实验 1 个 epoch;固定分配实验用 256 行输入(59 行重放 + 197 行新任务),并与其他条件对齐更新步数(16 次更新)。第五步,评估:报告新任务准确率增益(pp)、库内与 held-out 任务准确率变化、成对 Retention,误差棒为跨种子标准误;C-STANCE 对照实验并列比较 SFT、单任务重放、真实数据重放与 Task-Bank Self-Replay 四种条件。
技术新颖性
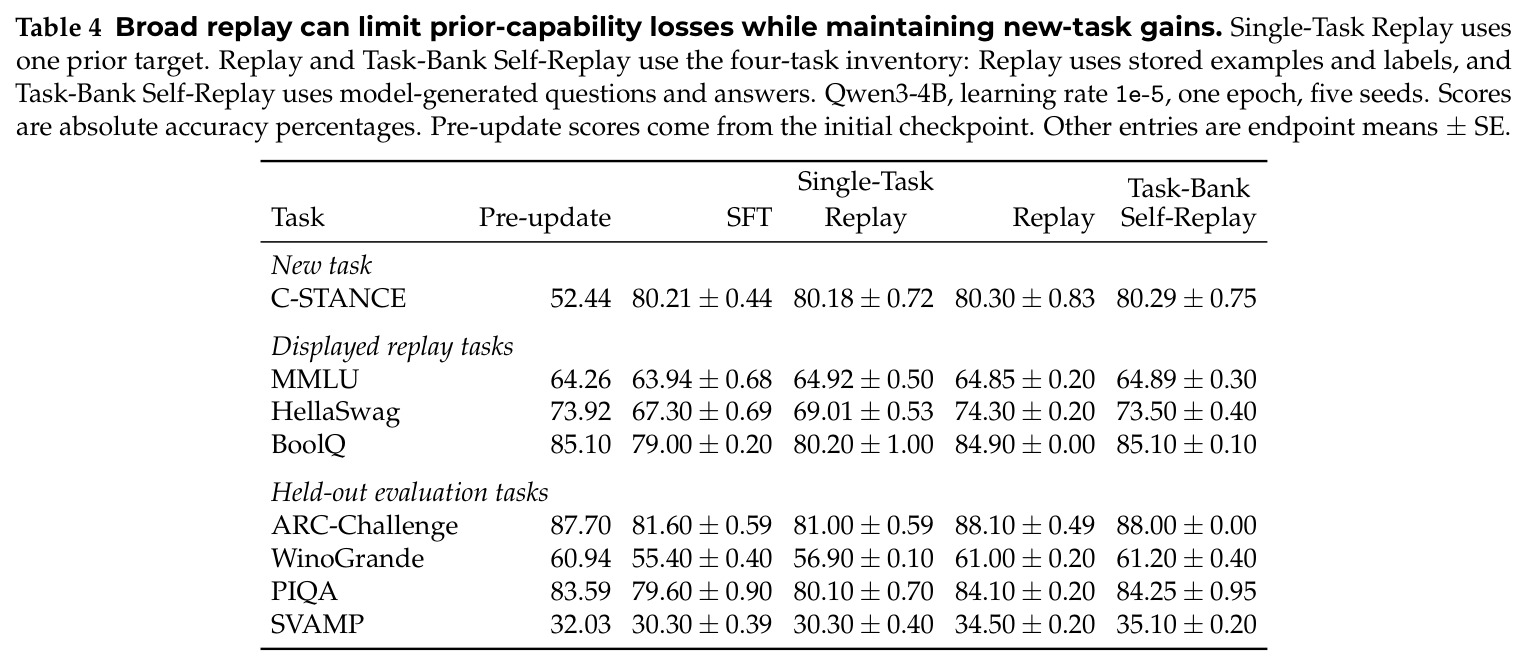
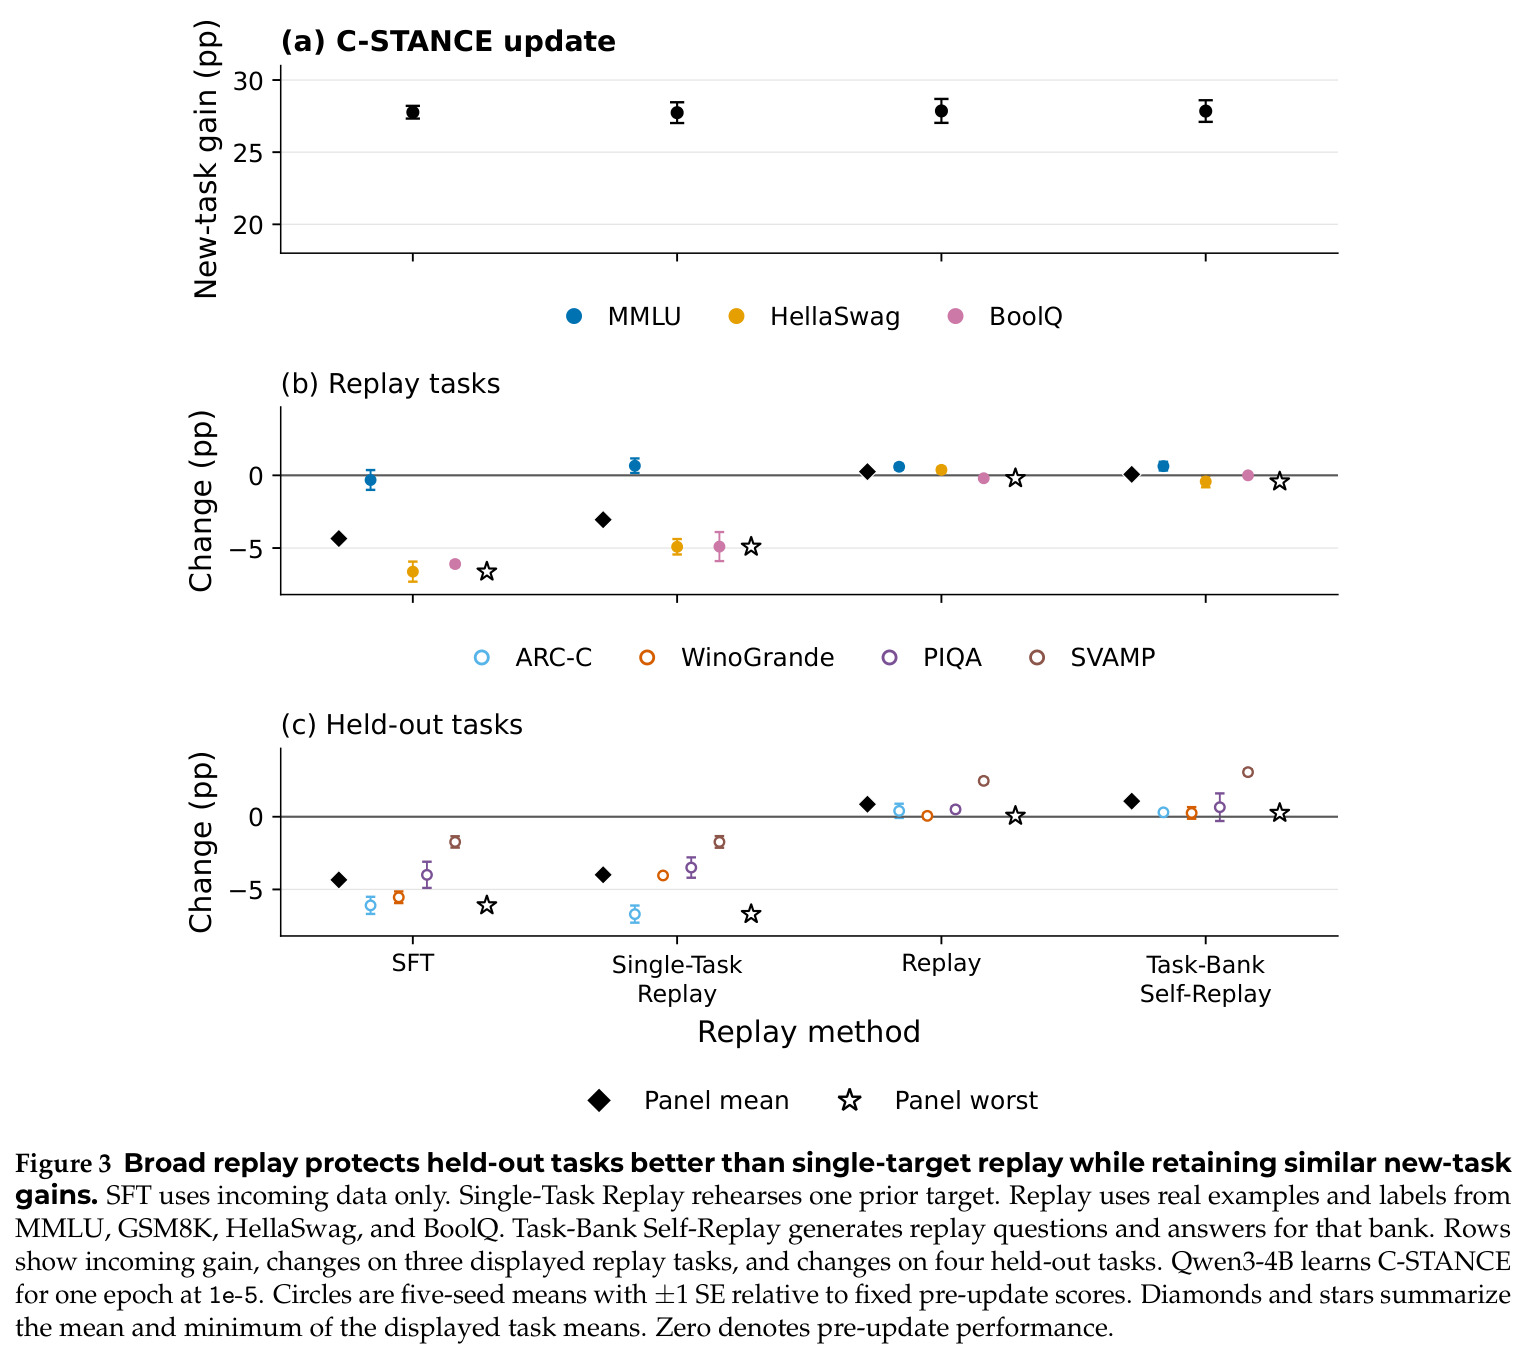
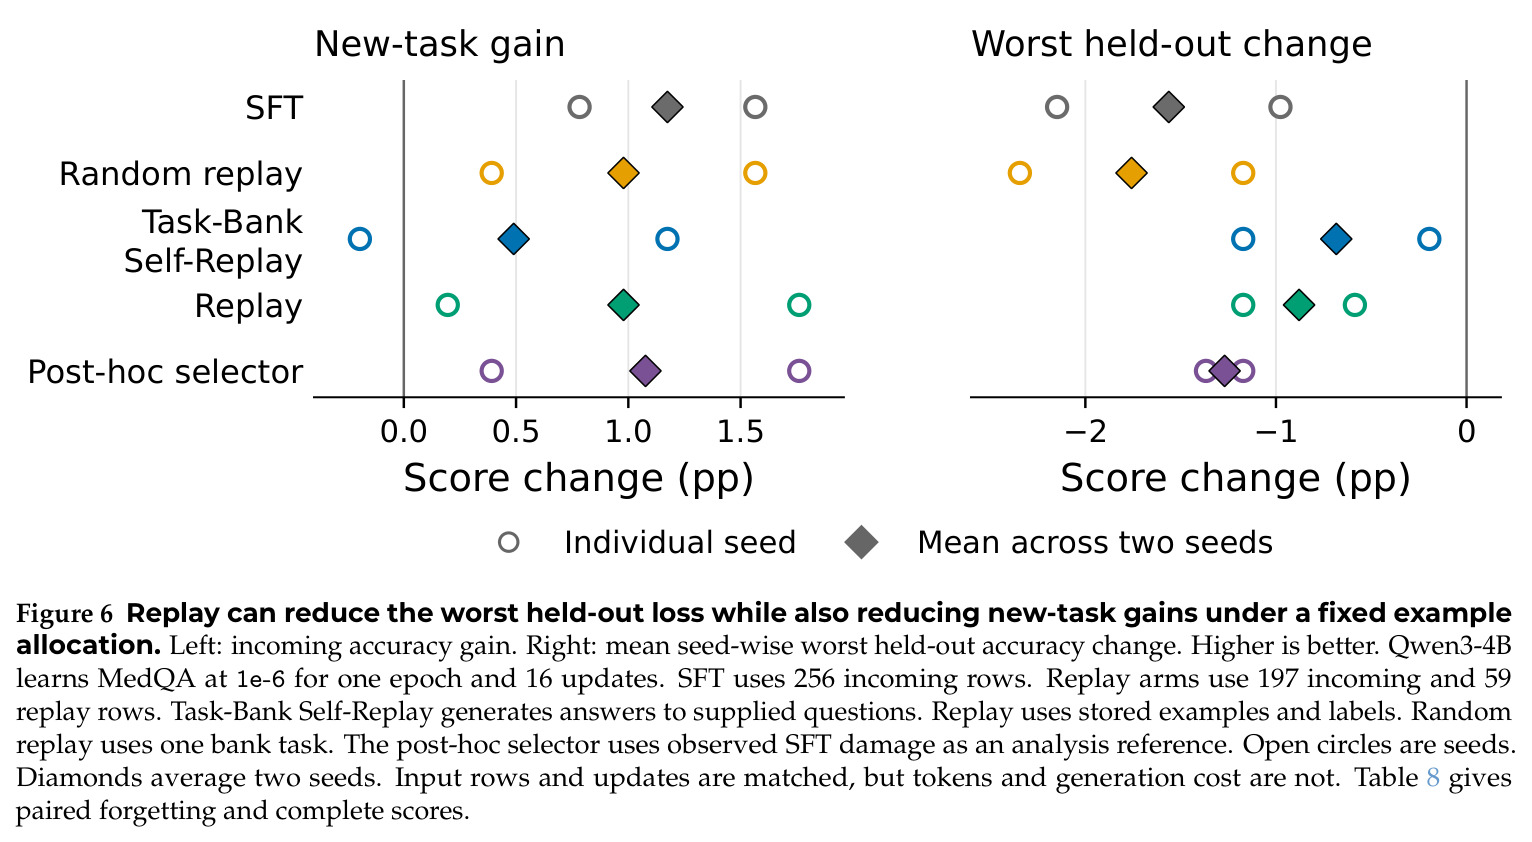
本文的新颖性体现在评估协议与实验设计,而非某个新算法模块。第一,'保护外溢'的度量是新的:此前自生成重放工作只验证库内或给定任务不被遗忘,本文用完全隔离的 held-out 任务证明保护能外溢,例如 C-STANCE 实验中 Task-Bank Self-Replay 把四个 held-out 任务的平均变化从 SFT 的 −4.34 pp 提升到 +1.07 pp。第二,成对 Retention 与任务级准确率并列报告,揭示了净变化 +0.05 pp 背后 3.56% 对→错与 3.61% 错→对的相互抵消,是把大规模后训练分析(Harmon 等, 2025)的方法论移植到持续学习场景。第三,选择实验把'模型能否自选目标'操作化为三个严格对照的臂(随机/仅库/库加新任务),并诚实报告该优势只在 4B 出现(+2.75 pp),0.6B 为 −0.76 pp、1.7B 约为零——这种带负结果的报告在同类工作中少见。第四,固定样本分配实验部分解耦了'重放内容收益'与'新任务曝光减少'两个因素,并明确承认收益不能只归因于重放内容、该比较不构成更优的习得-保留前沿。
实验结果
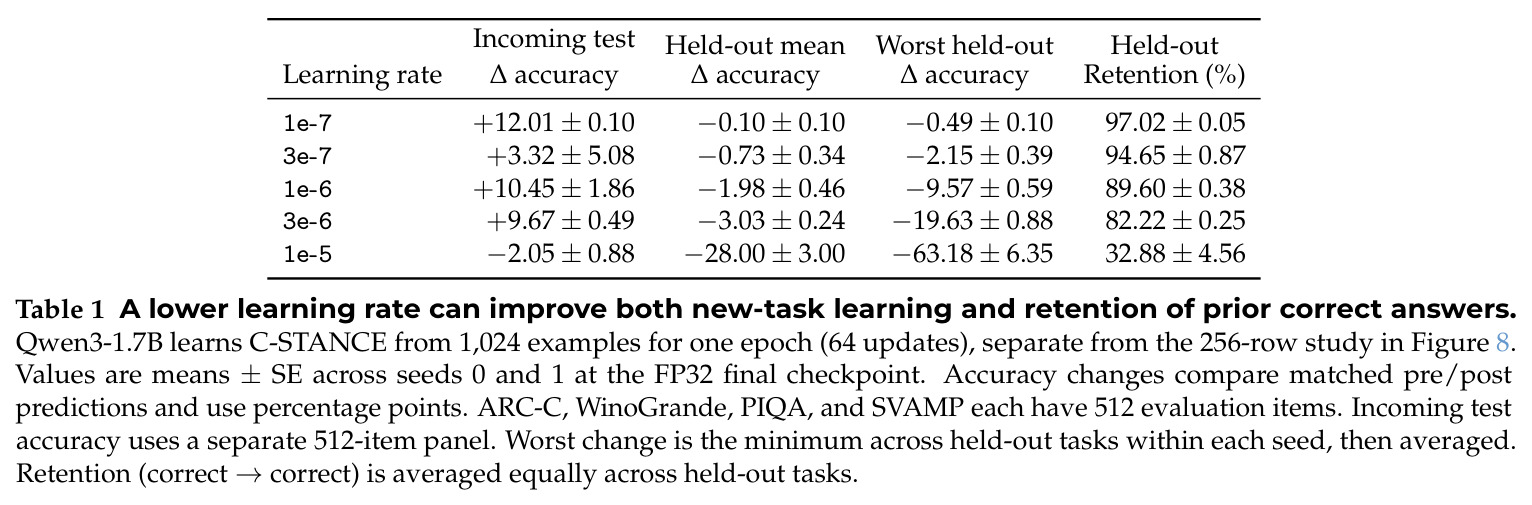
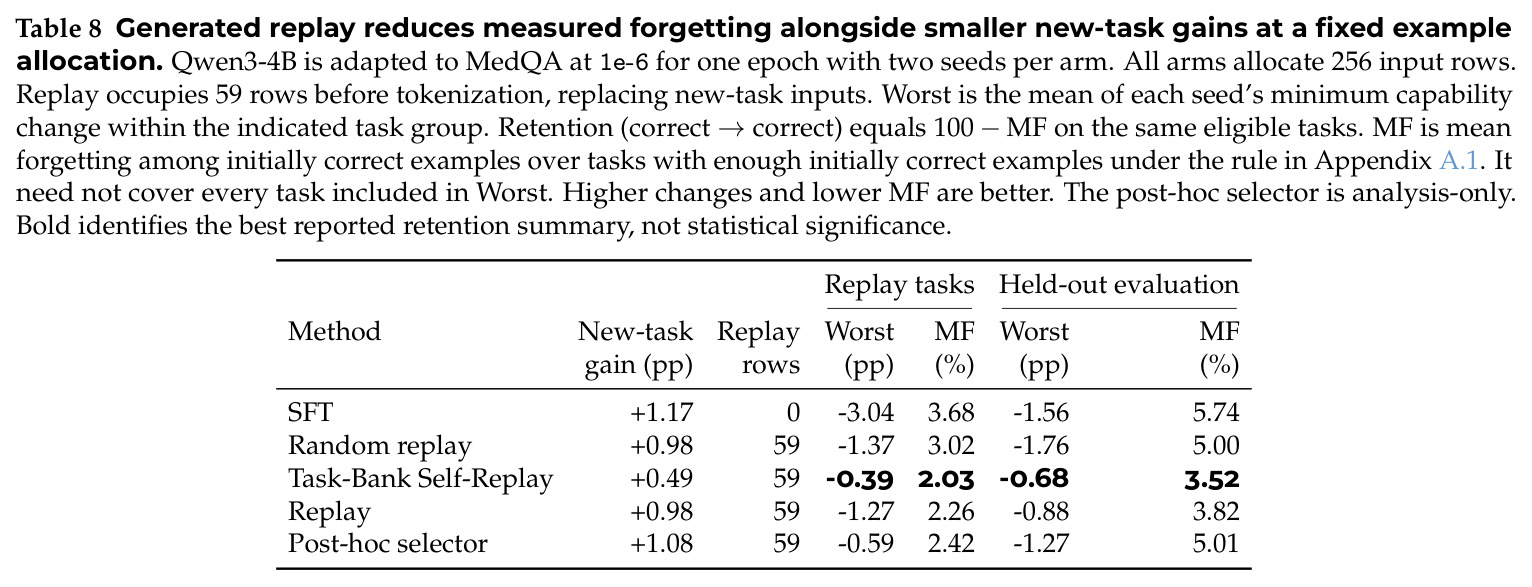
论文在 Qwen3-0.6B/1.7B/4B(诊断另用 Qwen3.5-4B)上得到五个发现。一,平均准确率掩盖损失(图 2):Qwen3-4B 用 256 条 MedQA($10^{-6}$)训练后,四个 held-out 任务平均 3.56% 样本由对变错、3.61% 由错变对,净变化仅 +0.05 pp。二,广谱重放保护外溢(图 3):Qwen3-4B 学 C-STANCE 时,held-out 平均变化为 SFT −4.34 pp、单任务重放 −3.99 pp、真实数据重放 +0.86 pp、Task-Bank Self-Replay +1.07 pp,新任务增益几乎不变(+27.74 至 +27.86 pp)。三,合并部分库全面更优(图 4):A+B 合并库在 0.6B/1.7B/4B 的平均 held-out Retention 达 88.70%/93.28%/96.01%,比各自较好的部分库高 4.42/3.32/2.99 pp,代价是新任务增益比 SFT 低 0.45/0.60/0.28 pp。四,模型选择目标仅在 4B 有效(图 5):4B 上新任务感知选择达 95.69%,高于随机的 92.94%(+2.75 pp)与仅库的 93.42%,只用 2/4 目标即逼近全库(差 0.32 pp 内);0.6B 反而 −0.76 pp,1.7B 约为零。五,固定预算下的权衡(图 6):59/256 行给重放后,最差 held-out 变化从 SFT 的 −1.56 改善到 −0.68 pp,但 MedQA 增益从 +1.17 降到 +0.49 pp;学习率扫描(表 1)显示 $10^{-7}$ 兼得 +12.01 pp 增益与 97.02% Retention,而 $10^{-5}$ 双输(−2.05 pp、32.88%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| C-STANCE 持续学习(Qwen3-4B,1e-5,5 种子)四个 held-out 任务 | 准确率变化(pp) | Task-Bank Self-Replay:+1.07 pp | 仅 SFT:−4.34 pp;单任务重放:−3.99 pp;真实数据重放:+0.86 pp | 较 SFT 提升 5.41 pp,较单任务重放提升 5.06 pp,同时新任务增益保持在 +27.74~+27.86 pp 区间 |
| MedQA 持续学习,合并任务库(Bank A + Bank B) | 平均 held-out Retention(%,正确→正确) | 0.6B / 1.7B / 4B 分别为 88.70 / 93.28 / 96.01 | 各自较好的部分库(Bank A 或 Bank B) | 分别高出 4.42 / 3.32 / 2.99 pp,新任务增益仅比 SFT 低 0.45 / 0.60 / 0.28 pp |
| MedQA 持续学习,Qwen3-4B 自选 2 个重放目标 | 平均 held-out Retention(%) | 新任务感知选择:95.69 | 随机选择 92.94;仅库信息选择 93.42 | 较随机 +2.75 pp,新任务增益还高 0.04 pp;仅用 2/4 目标即达到距全库 0.32 pp 以内 |
| 固定样本分配实验(Qwen3-4B 学 MedQA,256 行,1e-6,16 次更新) | 最差 held-out 变化(pp)/ 新任务增益(pp) | Task-Bank Self-Replay:−0.68 / +0.49;真实数据重放:−0.88 / +0.98 | SFT:−1.56 / +1.17 | 最差损失改善 0.88 pp,但新任务增益让出 0.68 pp,呈现明确的保护-习得权衡 |
| 学习率扫描(Qwen3-1.7B 学 C-STANCE,1024 例,64 次更新) | 新任务增益(pp)/ held-out Retention(%) | 学习率 $10^{-7}$:+12.01 / 97.02 | 学习率 $10^{-5}$:−2.05 / 32.88;$10^{-6}$:+10.45 / 89.60;$3\times10^{-6}$:+9.67 / 82.22 | 低学习率同时改善新任务学习与保留,挑战'保留-习得必然对立'的直觉 |
局限与改进
作者明确承认的局限包括:目标选择的优势只在 4B 出现,且'学习者、选择器、生成器强度'没有独立变化,无法把优势归因到具体角色;让模型自提新任务条目的单臂库扩展试点产生了负的准确率变化,两次更新、单种子的规定新增试点结果好坏参半,说明'模型自主扩充能力清单'远未成熟;固定分配实验中重放收益无法与'新任务曝光减少'完全解耦,作者强调这不构成更优的习得-保留前沿;本文只研究 SFT,而已有工作显示 SFT 的遗忘比 on-policy RL 与蒸馏更严重,结论能否迁移未知。我的补充观察:四个 held-out 任务与库内任务都是英文通用基准,与新任务 MedQA/C-STANCE 的分布差异可能偏小,外溢效应在更陌生的领域(代码、多语言、长上下文)未必保持;重放生成的推理成本与 token 曝光差异未计价,缺少成本效益分析;任务库只有 4 个条目、2 种拆分方式,库组成结论的外推性有限;Retention 依赖每任务 512 题的评测面板,在 4B 已达 96% 以上,天花板效应会削弱指标区分度。
独立分析的弱点
第一,选择优势只在 4B 出现且机制不明:论文没展示选择器究竟选了什么、为何新任务信息有帮助(例如是否因 MedQA 与 MMLU 子任务重叠)。改进方向:对选择决策做归因分析,用能力表示(embedding 或 probing)预测'哪些条目能缓解即将到来的损伤',并在更多规模上定位优势阈值。第二,任务库依赖人工常识构造:Bank 条目是人工挑选的四个通用基准,真实场景中'该把什么放进库'仍是开放问题。改进方向:把条目参数化为可优化的行为描述,用 held-out Retention 做黑盒优化,或让模型自举扩充并设置'增量保护价值、已证明能力、行为不重叠'三条入库门槛。第三,保护-习得权衡只被记录而未被优化:固定预算实验显示两者此消彼长,但没有方法在给定预算下寻找帕累托最优点。改进方向:按训练中的 Retention 代理信号动态调节重放占比,或用 on-policy 蒸馏替代部分重放预算。第四,评测面板小且趋于饱和:每任务 512 题、4B 的 Retention 已达 96%+,天花板效应会掩盖细粒度退化。改进方向:采用更难的评测集、更大的配对样本量,或按能力维度构造更细粒度的剖面。
未来方向
作者在讨论部分明确指出三条延伸:其一,'清单的持续修订'——跨多次连续更新时如何维护有用的任务库,要求新条目具备已证明的能力、不重叠的行为覆盖与增量保护价值,而单臂扩展试点与两次更新试点已经显示此事不易;其二,把评估框架搬到 on-policy RL 与蒸馏等训练机制上,检验 held-out Retention 与目标选择结论是否成立,不同学习信号是否改变有用目标的选择;其三,对目标选择、范围与成本做系统分析(附录 G)。基于本文成果还可延伸:用模型内部信号(激活漂移、梯度干扰估计,类似 MIR 的思路但上升到任务级)替代或增强文本提示式选择器;把 Task Bank 与能力自动发现(Automated Capability Discovery)结合,形成'发现→验证→入库→按需重放'的闭环;建立重放生成的成本-收益模型,刻画何时用真实数据、何时用生成数据;在多语言、代码、长上下文等与库差异更大的域检验保护外溢;以及研究 successive updates 下的能力保持,即不仅保住预训练能力,还要保住先前更新中学到的新能力。
复现评估
复现条件较好。代码已在 GitHub 开源(github.com/umamicode/self-preservation),模型全部为开放的 Qwen3-0.6B/1.7B/4B(诊断另用 Qwen3.5-4B),十个评测任务(MedQA、C-STANCE、MMLU、HellaSwag、GSM8K、BoolQ、ARC-C、WinoGrande、PIQA、SVAMP)均为公开基准,每个 held-out 任务配 512 个配对评测项。协议披露充分:主实验 5 个种子、1 epoch、学习率 $10^{-5}$、1024 例 MedQA;扫描实验 36 组 SFT 运行(2 种子、256 行);表 1 的五档学习率研究用 64 次更新与 FP32 检查点;附录 A 给出模型分配、优化器设置与分配网格,附录 C 给出生成接口、混合损失、选择提示词与探索流程。算力方面,0.6B–4B 全参数 AdamW 短程微调在单张 80GB 级 GPU 上可行,主要开销在重放生成的推理调用与多臂多种子网格。难度评估:复现主结果(图 3、4)中等偏易;完整复现全部研究(固定分配、三种选择对照、36 组扫描、诊断)需要可观 GPU 时与流水线工程,但对有持续学习实验经验的小团队现实可行。
论文图表
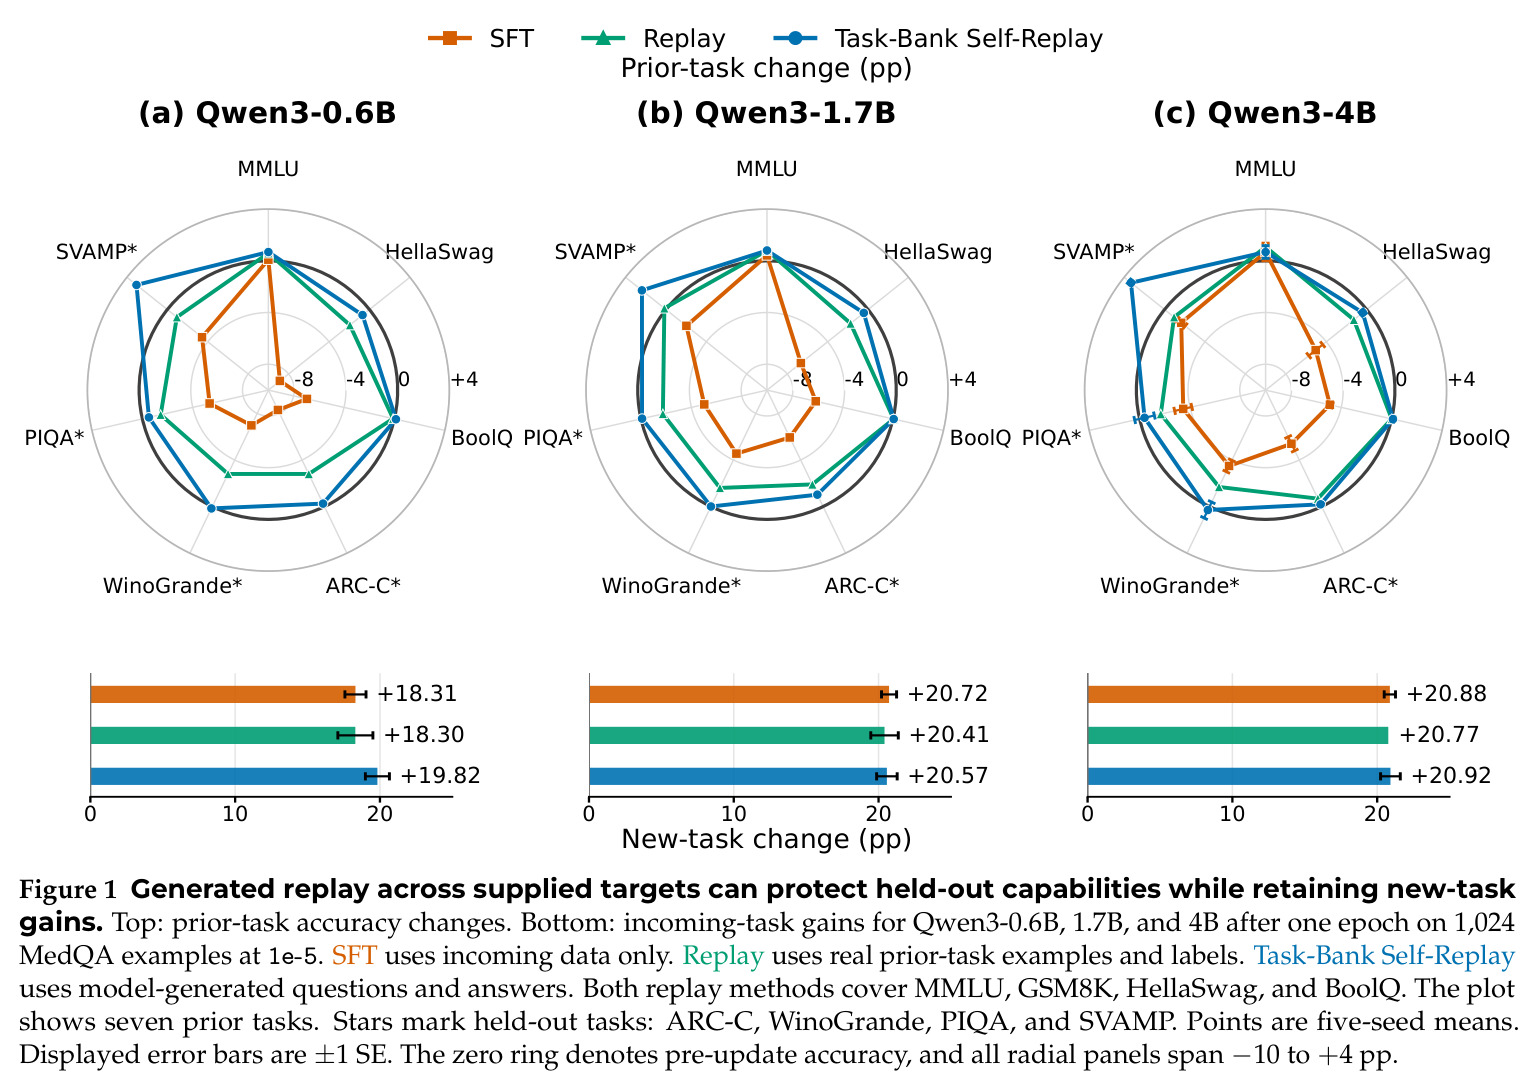
SFT、真实数据重放、Task-Bank Self-Replay 三种条件在 Qwen3-0.6B/1.7B/4B 上学习 1024 条 MedQA(1e-5、1 epoch、5 种子)后的雷达图对比:上方为七个旧任务的准确率变化(pp),下方为新任务增益。带星号的 ARC-C、WinoGrande、PIQA、SVAMP 是 held-out 任务。Self-Replay 在 held-out 任务上的损失明显小于 SFT,而三种条件的新任务增益接近(约 +18.3 至 +20.9 pp)。
这是全文的鸟瞰图:一张图同时呈现核心问题(SFT 的外溢遗忘)与核心结论(自生成重放的外溢保护、且不牺牲新任务学习),并定义了贯穿全文的任务角色划分。
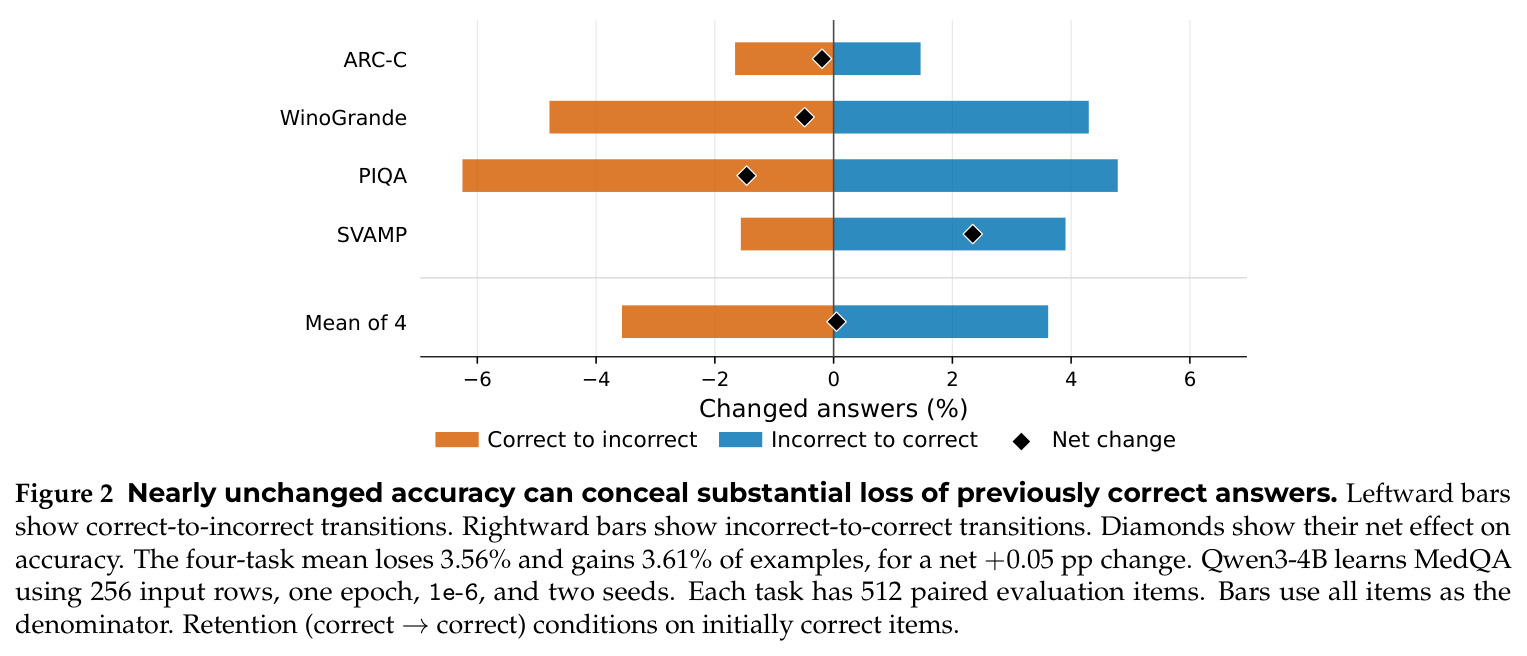
Qwen3-4B 用 256 条 MedQA(1e-6、2 种子)训练后,四个 held-out 任务各 512 个配对评测项中,正确→错误(左向条)与错误→正确(右向条)的转变比例及净变化(菱形标记)。四任务平均失去 3.56%、找回 3.61%,净变化仅 +0.05 pp。
解释了论文为何坚持报告成对 Retention 而非只看准确率变化:平均指标会掩盖大量被新纠正答案抵消的真实损失。这是理解全文评估方法论的关键。
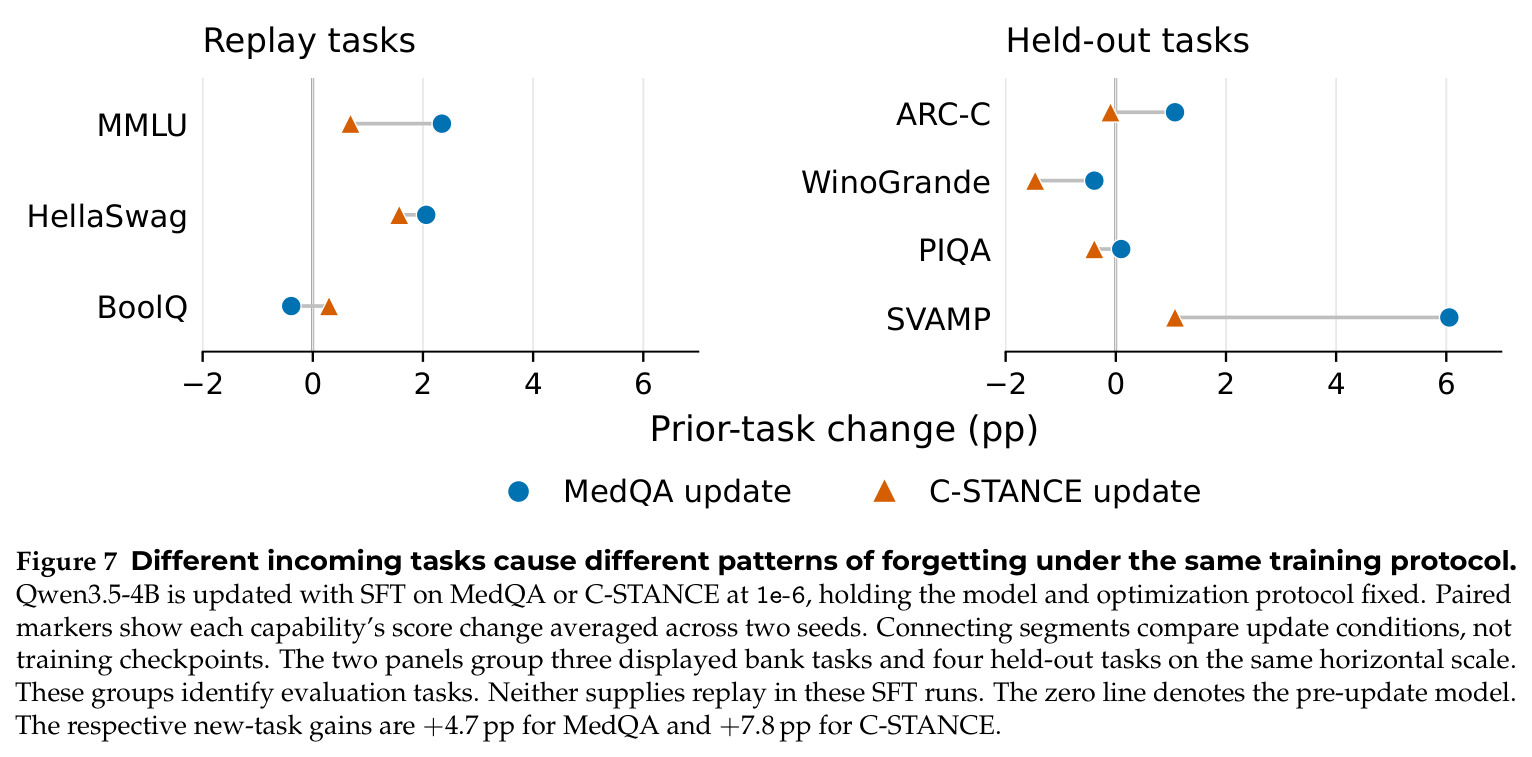
Qwen3.5-4B 分别用 MedQA 与 C-STANCE 做 SFT(1e-6、256 行、2 种子),同协议下各能力的成对变化剖面:新任务增益分别为 +4.7 与 +7.8 pp,但 SVAMP 在 MedQA 更新后约 +6 pp、C-STANCE 后仅约 +1 pp,MMLU、HellaSwag 等任务的模式也各不相同。
说明遗忘不是单一标量而是依赖新任务的能力剖面,为'把新任务信息提供给重放目标选择器'提供了直接动机。