局部支撑学习:用门控限制更新作用域来防止大模型灾难性遗忘 Local Support Learning
用 GMM 门控把微调更新的影响限制在新数据支撑域内,让大模型学新不忘旧
前置知识
灾难性遗忘(Catastrophic Forgetting)
神经网络顺序学习多个任务时,学习新任务的梯度更新会大幅覆盖旧任务学到的权重,导致旧能力骤降。对现代大模型而言,成本最高的预训练能力(数学、代码、指令遵循)最容易被后续微调破坏。经典对策如经验回放(存储旧数据重放)、EWC 等数据相关正则、梯度投影(把更新约束在与旧梯度正交的子空间)都需要访问旧数据,在万亿 token 的预训练规模下不可行。
本文研究的正是该问题在大模型后训练场景的表现与解法,全篇的动机分析、理论推导和实验评估都围绕“如何在完全不访问旧数据的前提下防止遗忘”展开。
LoRA 低秩适配器
一种参数高效微调方法:冻结预训练权重 $W$,为每个权重矩阵增加低秩增量 $\Delta W = BA$($B \in \mathbb{R}^{d \times r}$,$A \in \mathbb{R}^{r \times k}$,秩 $r \ll d$),只训练 $A, B$。优点是训练显存小、可按任务挂载独立适配器;缺点是它只约束了参数规模,并不约束更新在输入空间上的作用范围,因此依然会遗忘(Biderman et al. 2024 的“学得少忘得少”)。
LSL 的适配器部分就是标准 LoRA,训练流程完全不变;理解 LoRA 才能看清 LSL 到底加了什么(门控)、以及论文中内存/延迟/训练时间效率对比的基准是什么。
高斯混合模型(GMM)与 EM 算法
用 $K$ 个高斯分量的加权叠加 $\Phi(x) = \sum_k \pi_k \mathcal{N}(x \mid \mu_k, \Sigma_k)$ 拟合数据分布的概率模型,通常用 EM 算法最大化似然求解。关键性质:高斯密度随离均值的马氏距离指数衰减,因此 GMM 的似然在远离训练数据处迅速趋近于零——这种“天然外推保守”的归纳偏置正是本文选它做门控的原因。
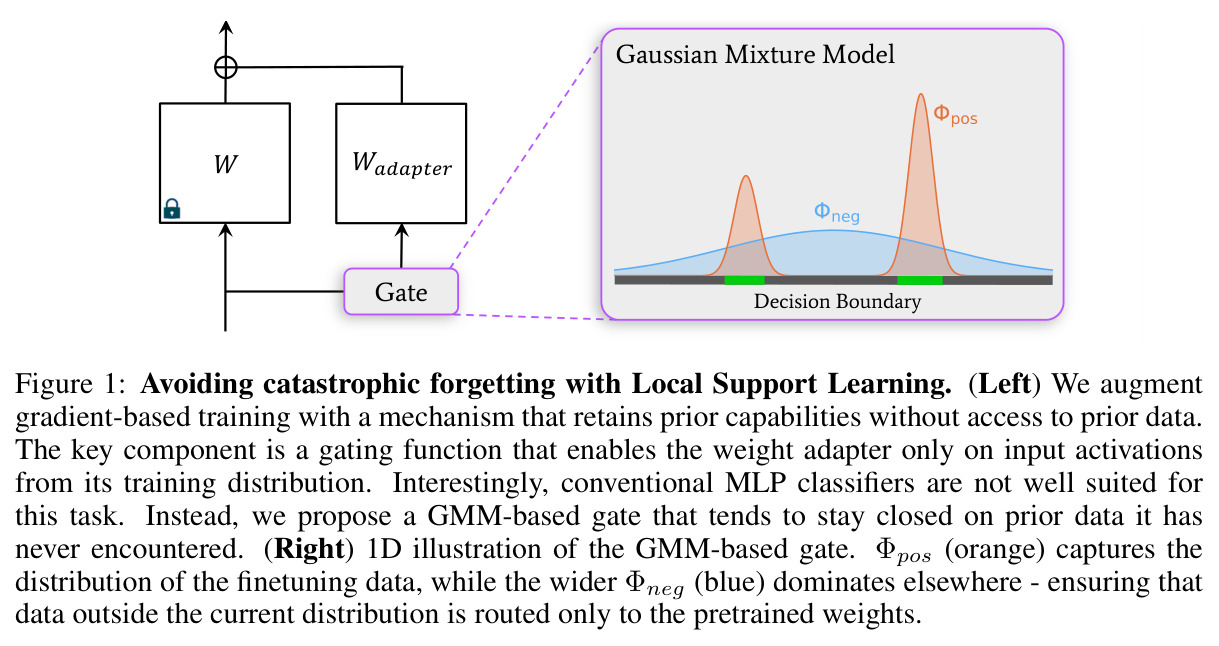
LSL 的门控由两个 GMM 的似然比较构成:$\Phi_{pos}$ 拟合当前阶段激活,$\Phi_{neg}$ 拟合通用预训练参考样本;GMM 的密度衰减特性是整个方法成立的数学基础。
分布的支撑集(Support)
随机变量密度大于零的取值区域,即数据“实际可能出现的位置”。本文中每个权重矩阵的输入激活构成一个分布,其支撑集就是该阶段数据所在的输入区域。最优门控定义为支撑集的指示函数 $g^* = \mathbb{1}[x \in \mathrm{supp}\, P]$,门控误差用它接受集与支撑集对称差的体积来度量。
“局部支撑”是方法命名的由来:把权重更新的影响限制在当前数据支撑集内,支撑集估计的质量直接决定遗忘程度;附录 E 的全部理论都围绕对称差体积的分解与控制展开。
奇异值分解与正交子空间更新
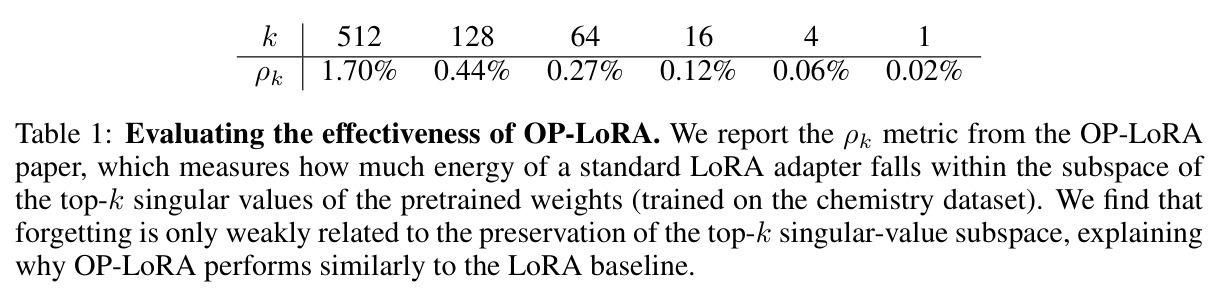
任意矩阵可分解 $W = U \Sigma V^T$,按奇异值大小排序,top-$k$ 奇异向量张成权重“最重要”的方向。OP-LoRA 等方法让微调更新正交于预训练权重的 top-$k$ 奇异方向以减少干扰。本文 Table 1 实测标准 LoRA 更新能量落在 top-$k$ 子空间内的比例 $\rho_k$ 最高仅 1.7%($k=512$),说明遗忘与这些方向关系很弱。
这是理解本文为何否定现有“权重空间”方案的钥匙:论文用 $\rho_k$ 实证说明正交化 top-$k$ 奇异子空间并不能防遗忘,从而引出在激活空间做门控的新路线。
研究动机
现代大模型遵循“大规模预训练 + 多阶段后训练”范式,但每个新阶段的梯度更新都会改写旧能力,造成灾难性遗忘。例如对 Qwen2.5-7B-Instruct 这样已具备数学(GSM8K)、代码(HumanEval)、指令遵循(IFEval)能力的模型做化学或网络安全指令微调,常规 LoRA 在新任务上适配良好的同时,预训练基准平均分大幅下滑;多阶段顺序训练时,逐阶段合并 LoRA 的基线在第一阶段结束后预训练任务平均分就暴跌 44%。论文用一个 6 类二维分类的玩具实验直观展示机制:第一阶段学到的完美决策边界在第二阶段训练后被严重变形。深层原因在单个权重矩阵层面:更新 $\Delta W^{(s)} = -\alpha \cdot \frac{dL}{dv} x^{(s)T}$ 作用于所有输入,任何与训练样本不正交的旧输入 $x_{pre}$ 的 logits 都会被改变($\Delta v_{pre} = -\alpha \cdot \frac{dL}{dv} x^{(s)T} x_{pre} \neq 0$);Adam、Muon 等优化器只是重缩放或正交化梯度,产生的仍是全局更新的 $\Delta W$。而经典对策(回放缓冲、EWC、梯度投影)都需访问旧数据,在预训练规模下不可行。
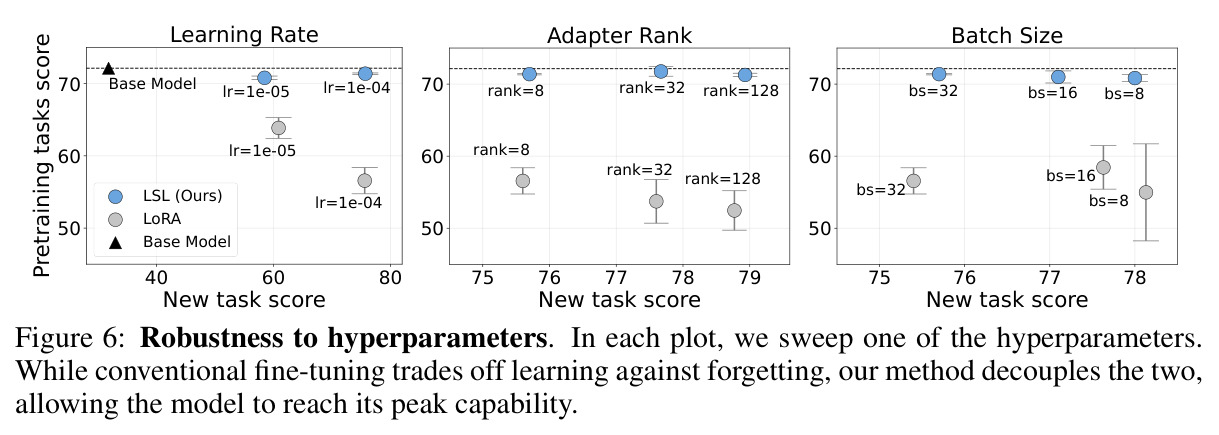
本文的目标是本文的目标是构建一个通用的后训练框架:在完全不访问任何历史数据(尤其是预训练语料)的前提下,让模型在每个新学习阶段以“全容量”学习新任务,同时几乎无损地保持预训练能力以及此前各微调阶段的能力。具体验收标准包括:在 7B 级 LLM 的三组多样化后训练中,新任务成绩与标准 LoRA 相当、预训练基准保持率接近 100%;多阶段顺序训练时新旧能力同时保持;对学习率(3e-6 到 3e-4)、adapter 秩(8 到 512)、批大小(8 到 64)等超参数不敏感,彻底解耦“学新”与“忘旧”的传统权衡;额外内存开销与 LoRA 同量级且与训练 token 数无关;推理延迟接近标准 adapter;并展现出随模型规模(1.5B/3B/7B)增大的良好缩放趋势。
与已有工作不同的是,已有防遗忘方法的切入点几乎都在“权重空间”:LoRA 把更新限制在低秩子空间,OP-LoRA 把更新投影到与预训练权重 top-k 奇异方向正交的子空间,O-LoRA/InfLoRA 让不同微调阶段的 adapter 互相正交(只能保护微调阶段、不保护预训练),还有工作从权重近似预训练数据的正交补(Xiong & Xie 2025;Nayak et al. 2025,作者在附录 C 证明该近似并不充分);LwF 则从函数空间用知识蒸馏约束输出。本文的独特视角是把遗忘看作“每个权重矩阵输入空间中的几何问题”:自然的保持目标应当是“更新只影响产生它的输入区域,即当前阶段分布的支撑集”。作者证明所有梯度类优化器产生的更新都违背这一目标——它们全局作用于所有输入。作者还实测遗忘与 top-k 奇异子空间关系很弱($\rho_k \le 1.7\%$),说明权重正交化思路不对症,从而另辟蹊径:直接在激活空间用密度估计器构建门控,把更新的作用域局部化到当前数据分布上。
核心方法
直觉上,一条权重更新本来只应该服务于“看起来像它的训练数据”的输入,对其余输入应保持原有权重映射不动。技术路线上,LSL 在每个新学习阶段为每个权重矩阵挂载两个分工明确的组件:一个标准权重适配器(LoRA),照常用梯度下降最小化新任务损失;一个门控函数,估计当前阶段数据在该矩阵输入激活空间中的支撑集 $\mathcal{M}$。推理时门控逐 token 独立决策:仅当激活落入 $\mathcal{M}$ 时才把 adapter 输出叠加到预训练权重输出上,否则只走原始权重路径。门控由两个 GMM 的似然比较实现:$\Phi_{pos}$ 用当前阶段数据拟合,$\Phi_{neg}$ 用仅约 1M token 的通用预训练参考数据拟合(约占 Qwen 预训练集的 0.0000067%),决策规则为 $\Phi_{pos}(x) - \Phi_{neg}(x) > 0$。高斯密度随距离指数衰减,使门控在从未见过的旧数据上天然趋于关闭;$\Phi_{neg}$ 提供输入相关的自适应阈值,免去手工调节固定阈值的麻烦。再配一个指数滑动平均做时序平滑,利用“任务边界不会以 token 频率变化”的事实进一步降低误开率。
核心创新一是视角转换:保持目标从“约束权重更新的方向”转为“限制更新在输入空间的作用域”。标准微调等价于永远敞开的门(全局更新),LSL 让每个更新只在其来源分布上生效(局部更新),从机制上消除了对旧输入的干涉。创新二是解决门控的根本悖论:门控只在当前阶段数据上训练,却要对所有历史阶段的数据正确关闭。附录 E 证明:门控误差的对称差可分解为 deficit(漏开的支撑集内部)与 excess(门外误开的区域,正是遗忘的来源),而任何基于当前分布 $P$ 加权的损失对 excess 完全盲——这解释了为何表达力更强的 MLP 分类器门控反而失效。作者进一步证明密度估计器可以恢复最优门控:$\mathrm{vol}(\hat{A} \triangle A^*) \le \|\hat{P} - P\|_1 / \min\{\tau, c - \tau\}$,即 $L^1$ 密度误差控制对称差体积;GMM 的指数衰减密度恰好提供了控制 excess 的归纳偏置。$\Phi_{neg}$ 的关键洞察是:门控只需捕捉预训练分布的“宽度”而非完整支撑,这解释了为何 1M token 的参考样本就足够。
方法步骤详情
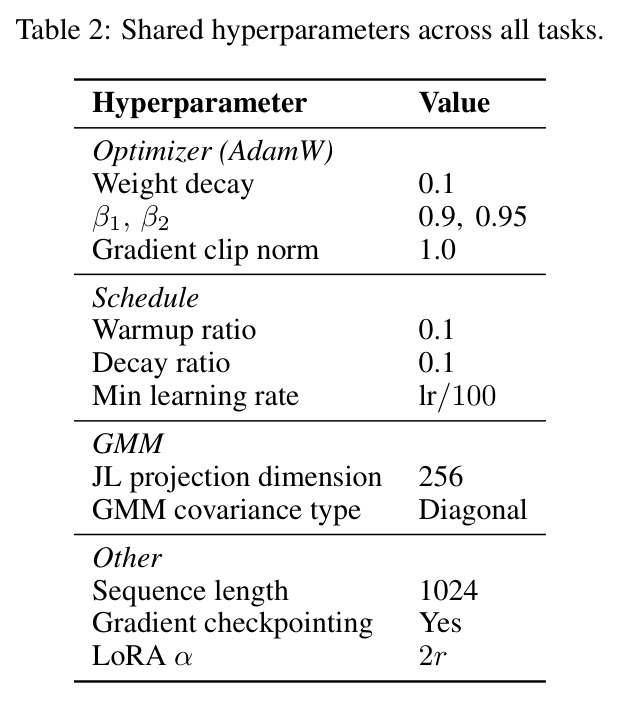
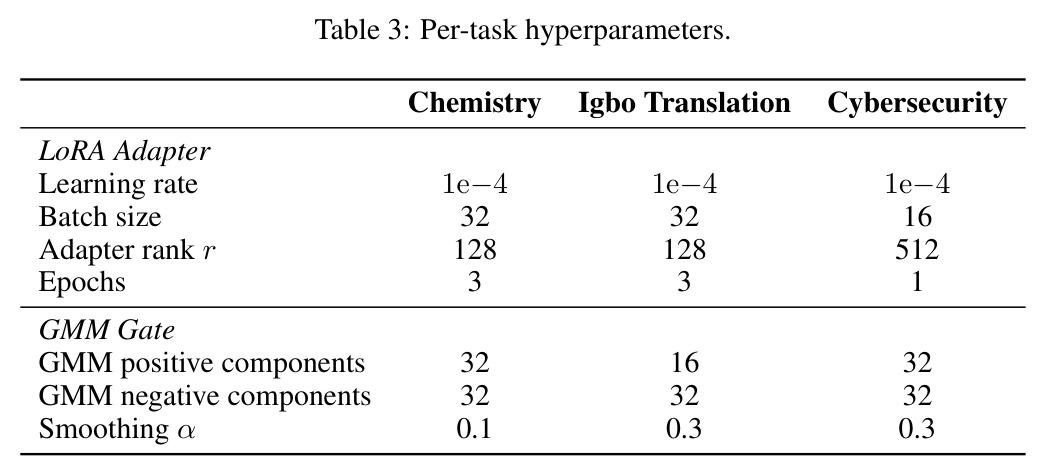
训练(Alg. 1/3/4):第一步用通用预训练参考数据一次性拟合所有模块的 $\Phi_{neg}$(EM 算法);随后进入第 $i$ 阶段:先照常训练 LoRA adapter(AdamW,weight decay 0.1,学习率 1e-4 量级),训练期间门控全程保持全开——因为该阶段数据全部来自新分布,这一设计避免了 bootstrap 问题(否则 $\Phi_{pos}$ 需要在 adapter 学出新表征之前初始化);训练完成后逐模块拟合 $\Phi_{pos}$:对每个模块前向一遍收集其输入激活、用 EM 拟合 GMM、立即丢弃激活再处理下一模块,以控制内存。效率设计:门控输入经 Johnson–Lindenstrauss 随机投影压缩到 256 维,GMM 用对角协方差,相同输入的矩阵(如 $W_q/W_k/W_v$)共享门控(门数减少 43%),使内存复杂度降到 $O(PLKE + LDE)$、时间 $O(PBL(DE + KE))$,其中 $E \ll D$。推理(Alg. 2,逐模块逐 token):先算预训练权重输出 $v = W_{pretrained} x$;对每个历史阶段 $i$ 计算门控 $g = \mathbb{1}\{\Phi_{pos}^{(i)}(x) - \Phi_{neg}(x) > 0\}$,再做指数滑动平均 $s^{(i)} \leftarrow \alpha g + (1-\alpha) s^{(i)}$;仅当 $s^{(i)} > 0.5$ 时叠加该阶段 adapter 输出。整个推理在 prefill 阶段与标准 MLP 一样完全可并行。
技术新颖性
与最接近工作的本质区别:(1)相对 Saha et al. 2021 的梯度投影记忆,本文不估计旧数据子空间再把更新约束到其正交补(需要旧数据,预训练规模不可行),而是估计当前数据支撑集本身,只需当前数据加一个极小的通用参考集;(2)相对 O-LoRA/InfLoRA 的阶段间正交约束,LSL 同时保护预训练能力,而非只保护之前的微调阶段;(3)相对 OP-LoRA 的权重奇异子空间正交化,作者用 $\rho_k$ 指标实证遗忘与 top-k 奇异子空间几乎无关(实测最高 1.7%),从机制上解释了为何 OP-LoRA 与 LoRA 表现几乎相同;(4)相对 LwF 的函数空间蒸馏,LSL 不需要每步额外做基座前向,且从“更新的作用域”这一更根本层面解决问题;(5)相对 GRACE/WISE 等键值缓存式模型编辑,LSL 是训练全模型、面向完整数据集的通用学习框架,而非单层单事实编辑;(6)理论上首次把“最优门控 = 支撑集指示函数”与“密度估计”连接起来,并系统解释了为何假设类不同的门控(局部的 UoS、参数化的 GMM、判别的 MLP)在 excess 控制上表现截然不同。
实验结果
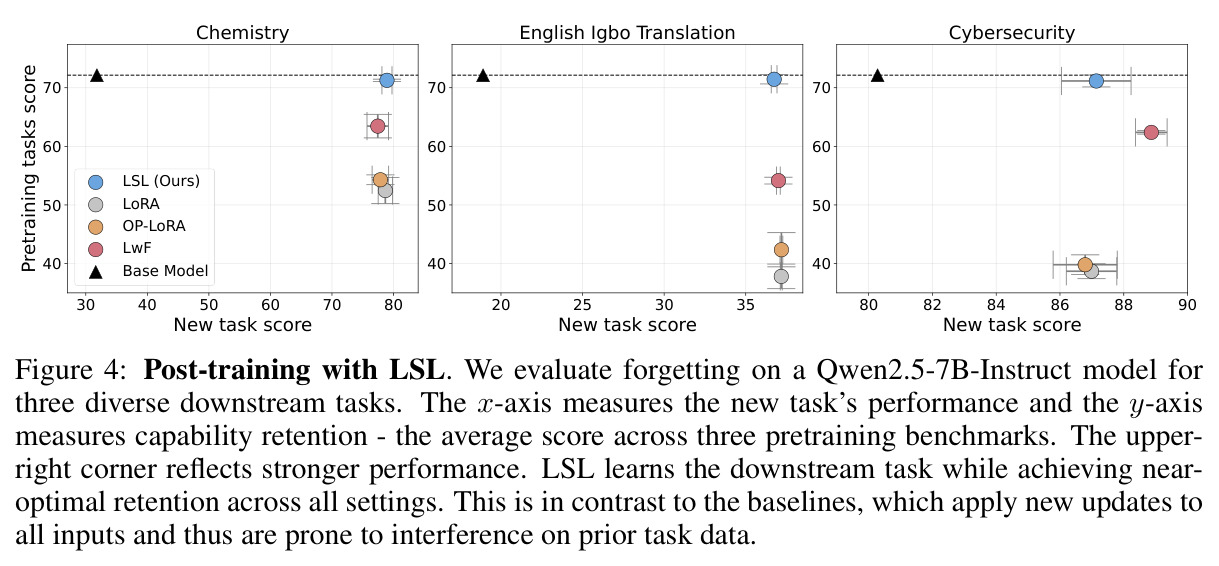
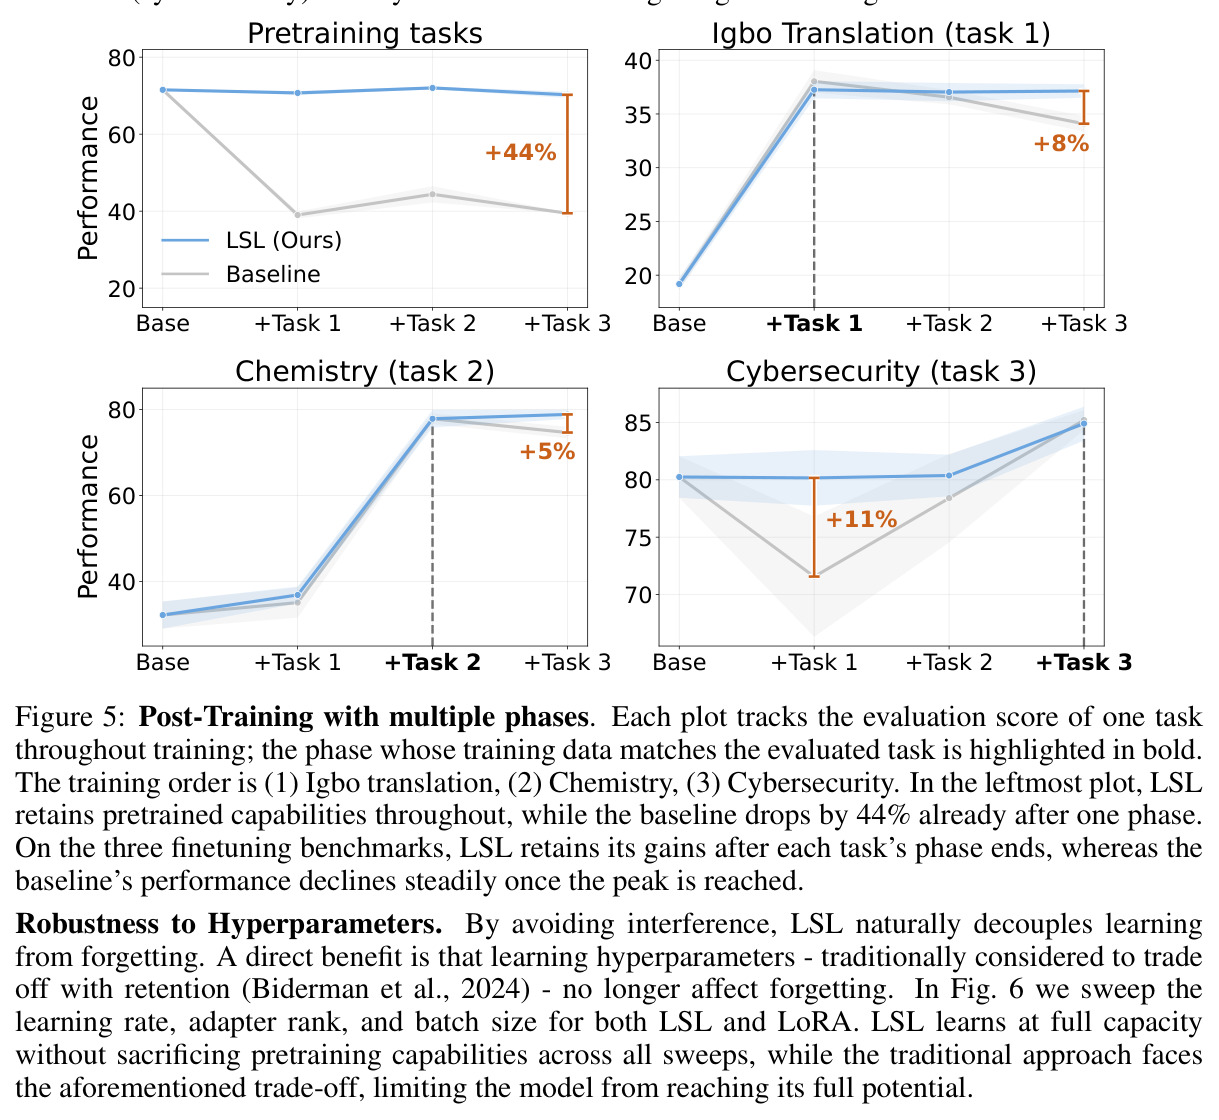
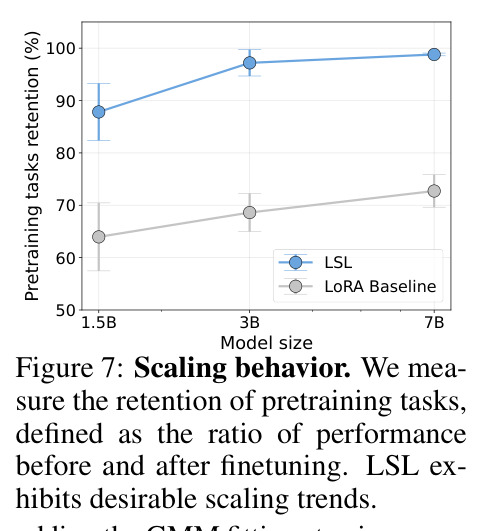
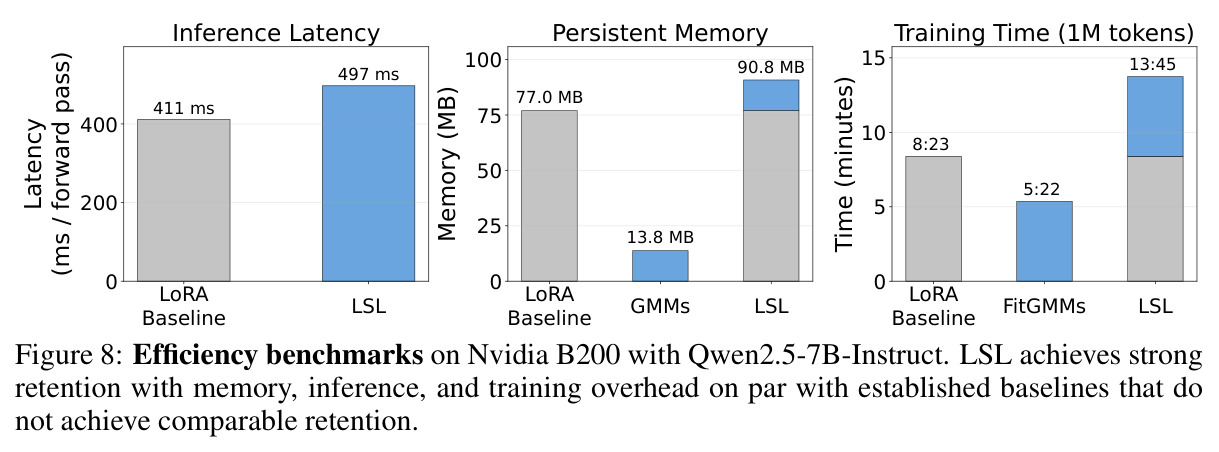
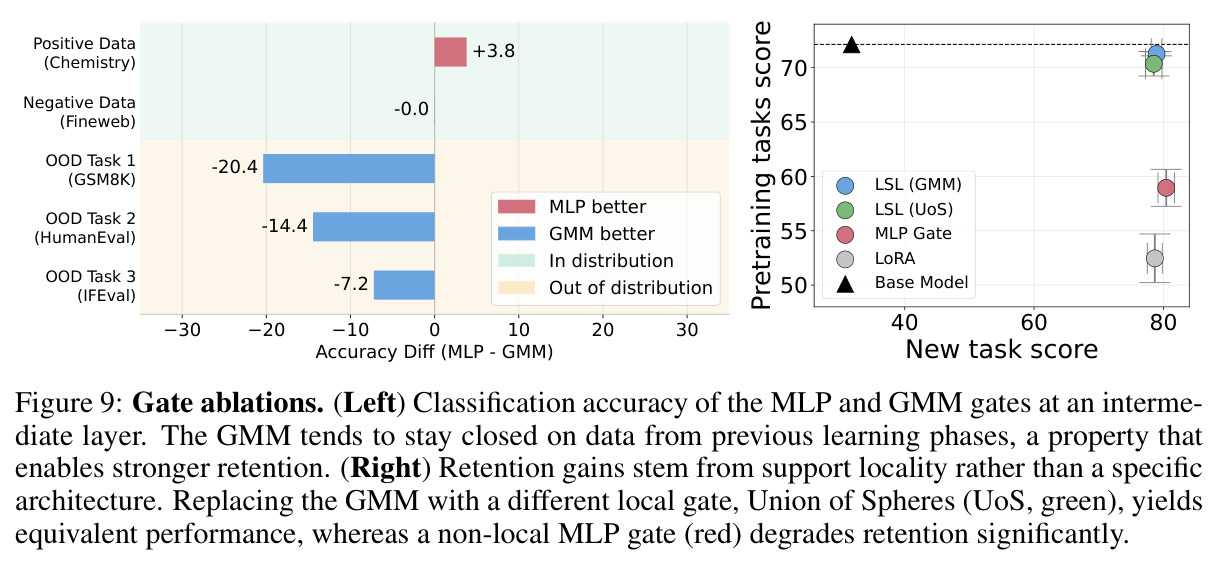
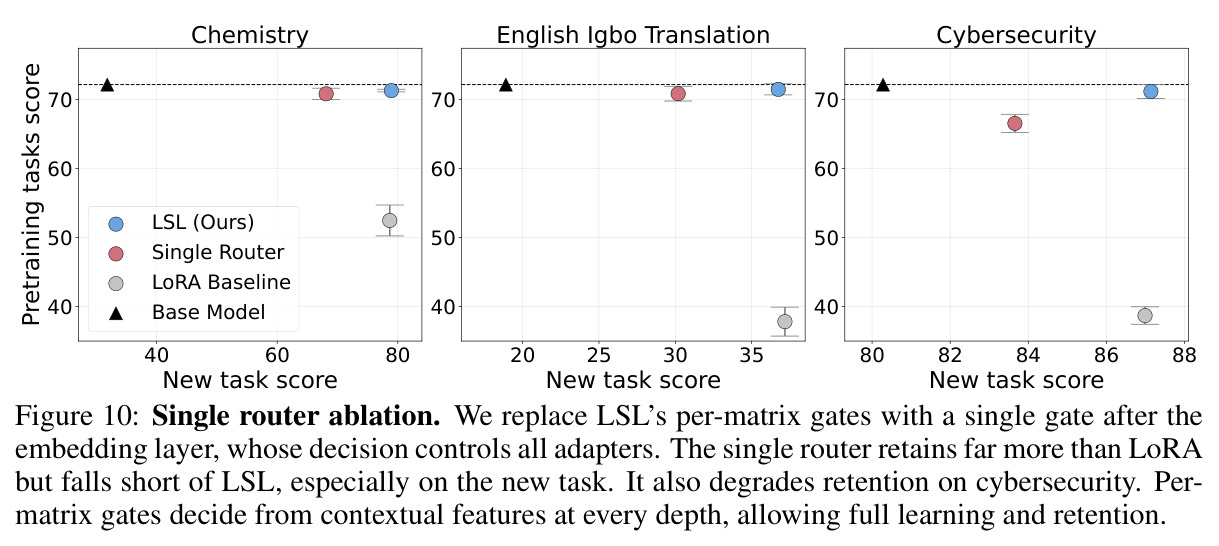
在 Qwen2.5-7B-Instruct 上评估三组后训练(化学指令微调→ChemBench、英语→伊博语翻译→chrF、网络安全指令微调→SecEval),用 GSM8K/HumanEval/IFEval 三项平均衡量预训练能力保持,每实验 3 个 seed 取平均。Fig. 4:LSL 在三个任务上同时达到接近最优的新任务成绩与接近基座的保持率;LoRA 全线遗忘;OP-LoRA 与 LoRA 几乎重合(因遗忘与 top-k 奇异子空间弱相关);LwF 略好但仍全面落后。Fig. 5 多阶段实验(翻译→化学→安全顺序训练):逐阶段合并 LoRA 的基线预训练任务平均分在第一阶段后暴跌 44%,LSL 全程保持;阶段间干扰也被消除——基线翻译峰值后掉 8%、化学掉 5%、安全 zero-shot 掉 11%,LSL 均避免。Fig. 6 超参扫描(lr 3e-6~3e-4、rank 8~512、bs 8~64):LSL 在所有设置下保持率不变,LoRA 始终面临学习-遗忘权衡。Fig. 7 缩放实验:1.5B/3B/7B 上 LSL 保持率随规模提升且处处高于 LoRA。Fig. 8 效率:GMM 仅增 13.8MB 内存(每阶段 +6.9MB,$\Phi_{neg}$ 共享),推理延迟 497ms vs LoRA 411ms(每前向 +86ms),1M token 训练 5:22(LoRA)→8:23(LSL adapter)→13:45(含 GMM 拟合,×1.64)。消融(Fig. 9/11):GMM 把保持率从 76.6%(无门控)提升到 96.6%,时序平滑再提升到 98.8%;GMM 成分数低至 2 仍近最优;局部的 UoS 门控与 GMM 性能相当但需 5.67GB 内存,MLP 门控在 OOD 数据上显著变差(GSM8K 上比 GMM 差 20.4 个点精度);单 router 只能恢复 LSL 新任务提升的 50-77%。Fig. 12/13 从函数空间验证:分布内数据上 LSL 与 LoRA 改变行为相当,预训练基准上 LSL 的行为改变比 LoRA 小一个量级。
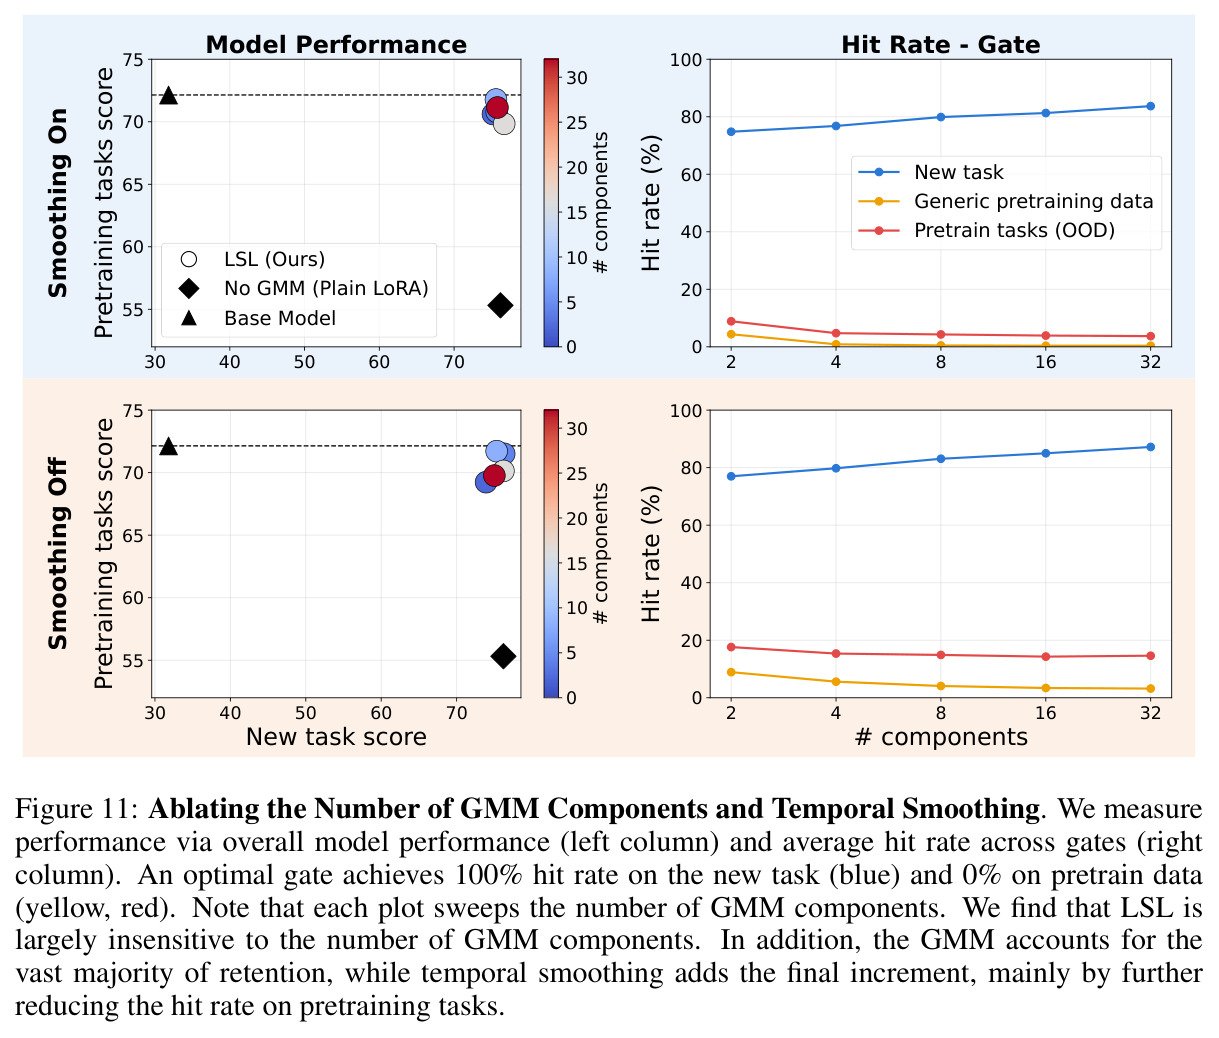
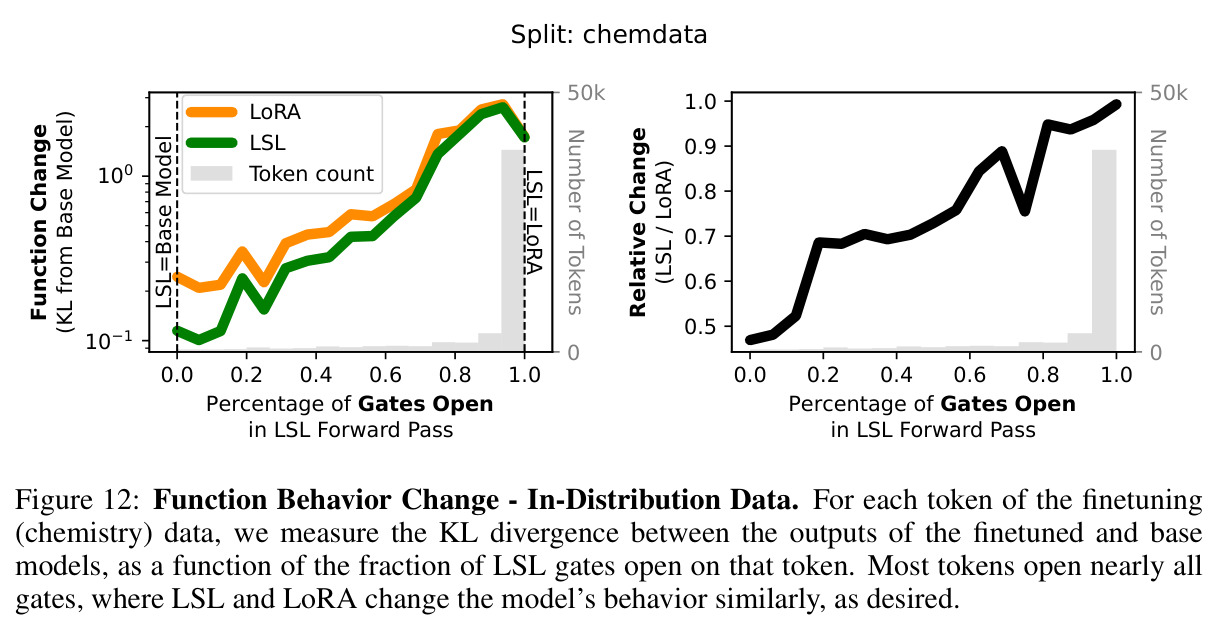
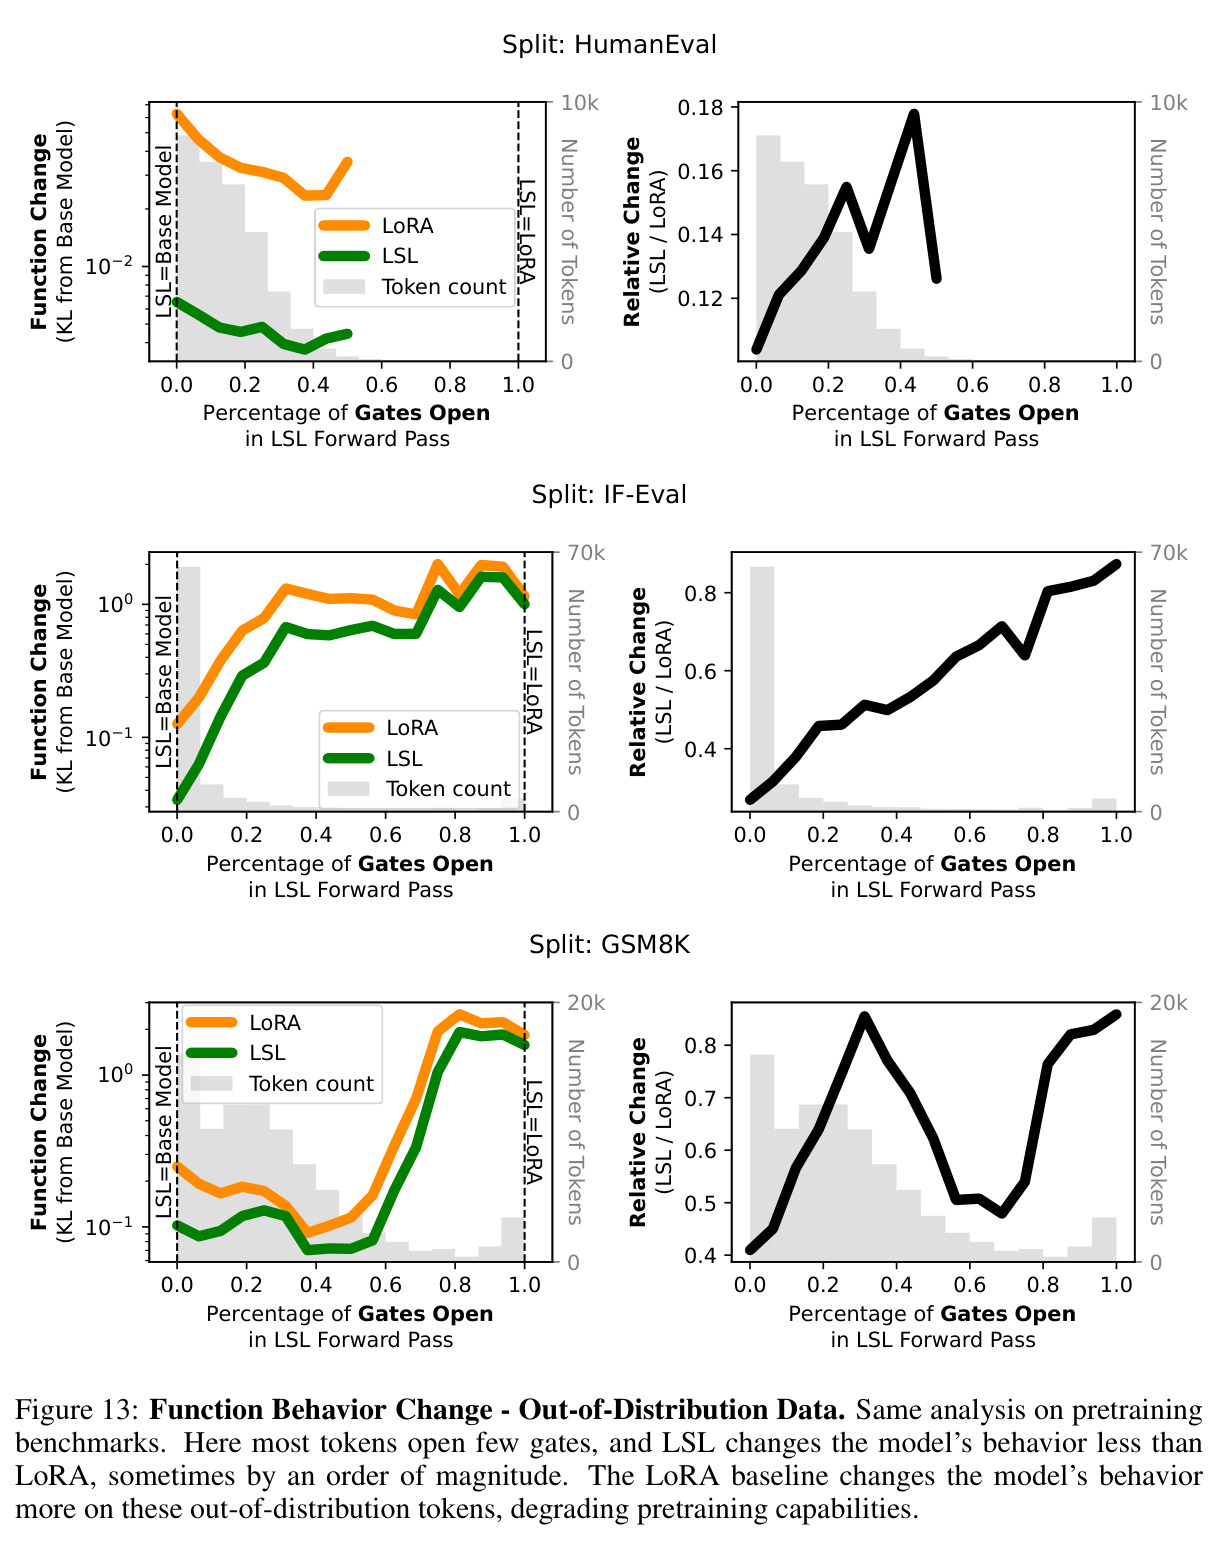
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 化学指令微调后的预训练能力保持 | GSM8K+HumanEval+IFEval 平均保持率(相对基座) | 98.8%(GMM+时序平滑;仅 GMM 为 96.6%) | LoRA / OP-LoRA 明显遗忘,LwF 略好但仍落后(Fig. 4) | 保持率从约 76.6%(无门控的 plain LoRA)提升到 98.8% |
| 三阶段顺序后训练(翻译→化学→安全)中的预训练保持 | 预训练任务平均分随训练阶段的变化 | 全程保持、无显著下降 | 逐阶段合并 LoRA:第一阶段后 -44% | 约 44 个百分点 |
| 阶段间干扰(伊博语翻译,任务 1) | 任务训练结束后的 chrF 保持 | 保持峰值水平 | LoRA 基线在两个后续阶段后 -8% | 8 个百分点 |
| 阶段间干扰(网络安全 zero-shot 迁移) | 任务 1 训练后安全任务 zero-shot 分数变化 | 保持基座水平、无退化 | LoRA 基线 -11% | 11 个百分点 |
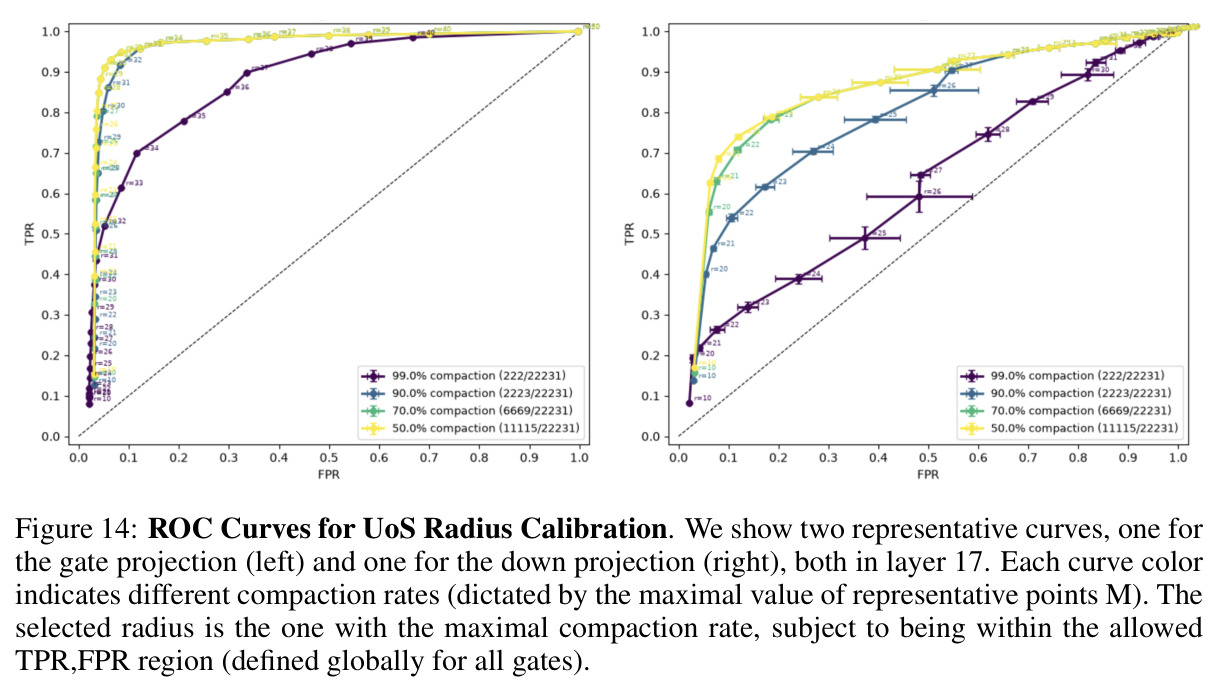
| 门控架构消融(化学任务) | 预训练任务保持率(UoS vs GMM vs MLP 门控) | GMM 与 UoS 均接近最优保持,GMM 仅需 13.8MB 内存 | MLP 门控显著退化;UoS 需 5.67GB 内存 | 在 400 倍更小的内存下达到同等保持 |
| OP-LoRA 机制检验 | $\rho_k$:LoRA 更新能量落在预训练权重 top-k 奇异子空间内的比例 | 实测最高 1.7%(k=512),k=1 时仅 0.02% | OP-LoRA 假设保护该子空间可防遗忘 | 证明遗忘与 top-k 奇异子空间弱相关,解释 OP-LoRA 为何无效 |
局限与改进
作者承认的局限:其一,LSL 的 adapter 无法合并进基础权重(门控依赖逐 token 路由),推理开销随阶段数 $P$ 线性增长,虽然各 adapter 可完全并行、能以算力换时延,且 $P$ 计的是阶段而非任务(一个阶段可混合多任务),但长链多阶段场景成本仍会累积。其二,理论分析只针对单个权重矩阵,扩展到整个多层网络目前只有实证支持、没有形式化证明。其三,方法依赖基座模型的表征质量——门控假设每个阶段的激活可被 GMM 捕捉,缩放实验中模型越大保持率越高正源于此。我的补充观察:(1)实验任务规模偏小(约 1M token、最多 3 epoch、只有 3 个阶段),尚未验证工业级后训练(RLHF、数百万样本、数十上百阶段)的表现;(2)仅测试 Qwen2.5 家族的纯文本 LLM,其他架构与模态未知;(3)$\Phi_{neg}$ 依赖“通用预训练分布”假设,若目标领域与参考分布差异极端、或新旧阶段激活空间高度重叠,门控质量可能退化;(4)时序平滑系数与 GMM 成分数仍需小规模扫描,逐 token 硬门控在长上下文任务边界处的鲁棒性未深入分析。
独立分析的弱点
独立分析的弱点:其一,推理延迟随阶段数线性增长(每阶段每前向约 +86ms),数十个阶段后将成为瓶颈——改进方向是门控层级化/级联路由、按激活分布相似度聚类合并 adapter、或将多阶段能力蒸馏回单一模型。其二,逐 token 硬门控的误判会不可逆地影响该 token 的全部下游计算;且 UoS 消融表明“局部性”虽是保持的关键,但 UoS 需要 5.67GB 内存和逐门 ROC 校准,GMM 则有模型误设风险(附录 E 给出反例:单高斯拟合双均匀分布会永远接受中间间隙)——改进方向是引入 kNN 密度、normalizing flows 等更灵活且仍可控的密度估计,或不确定性加权的软门控。其三,存在训练-推理不匹配:训练时门控全开,推理时门控对分布外预训练数据仍有约 16%(平滑后 5%)的误开率,这对精度敏感任务(如代码生成)的累积影响未量化——可探索在训练后期插入随机门控采样以对齐训练与推理分布。其四,实验只有 3 个阶段、3 个任务,$P$ 增大时各阶段门控误开率的复合效应(假阳性随阶段累积)缺乏理论界——需要给出 excess 随 $P$ 的累积上界,并设计相应的自动化校准协议(类似附录 I 的 ROC 校准流程)。其五,多阶段训练时旧阶段 adapter 与 GMM 在当前阶段全程活跃,若新旧阶段数据分布重叠,旧门控误开可能干扰当前训练,这一场景未被系统分析。
未来方向
作者提出的方向:扩展到更大模型(7B 以上)、其他模态(视觉、语音)、强化学习目标(RLHF 场景下的防遗忘),以及扩展到数百个学习阶段——后者将开启 test-time training:目前测试时训练因遗忘不可预测而在实践中被回避,若 LSL 能让模型安全地把新知识写入权重而非上下文,就能以极低代价实现真正的持续学习。作者还提到可探索其他局部门控函数与进一步的推理加速。基于本文成果可延伸的方向:(1)与 on-policy RL 防遗忘方法(如 RL's Razor、self-distillation 等论文引用的近期工作)正交结合——前者改训练目标与数据,LSL 改架构与更新作用域,二者机制互补;(2)把 GMM 门控思想引入 MoE 路由或模型合并,为每个专家/每份权重估计激活支撑集;(3)把单矩阵理论推广到整网,分析各层门控误差沿深度的传播与放大,给出端到端保持的形式化保证;(4)在激活空间探索更高效的支撑集参数化(低秩 GMM、流模型、对比学习的 OOD 打分器);(5)反向应用:既然可以做到“只在新数据上生效”,同样可以设计“只对特定数据生效的选择性遗忘”机制,服务隐私合规与模型修正。
复现评估
复现条件良好。论文提供项目网站与源码(https://assafbk.github.io/lsl),附录 D 给出全部实验配置:模型 checkpoint 全部来自 HuggingFace(Qwen2.5-1.5B/3B/7B-Instruct),数据集全部公开(Trendyol 网络安全指令集 v2.0、英-伊博语翻译数据、ChemLLM 化学指令集;评测用 GSM8K/HumanEval/IFEval/ChemBench/SecEval),并给出共享与逐任务两张超参数表(Table 2/3,含优化器、调度、JL 投影维度 256、GMM 成分数、平滑系数等)。算力门槛低:7B 实验单张 Nvidia B200 即可完成,1M token 的 adapter 训练约 8 分 23 秒、加 GMM 拟合约 13 分 45 秒,本质是 LoRA 级训练加轻量 EM;GMM 用 Pomegranate 库实现,训练框架为 PyTorch。所有实验为 3 个 seed 取平均,多阶段实验将每个基准的评测样本截断到 300。附录 E 提供完整理论推导。总体复现难度中低:数据与模型全公开、算力要求低;主要工作量在于正确实现逐模块 GMM 拟合流水线(Alg. 3)、JL 投影与门控共享等工程细节,以及复现 UoS 基线的 ROC 半径校准(附录 I);核心主结果用朴素实现(不对角协方差、不共享门控)也应可以复现,只是更慢。
论文图表
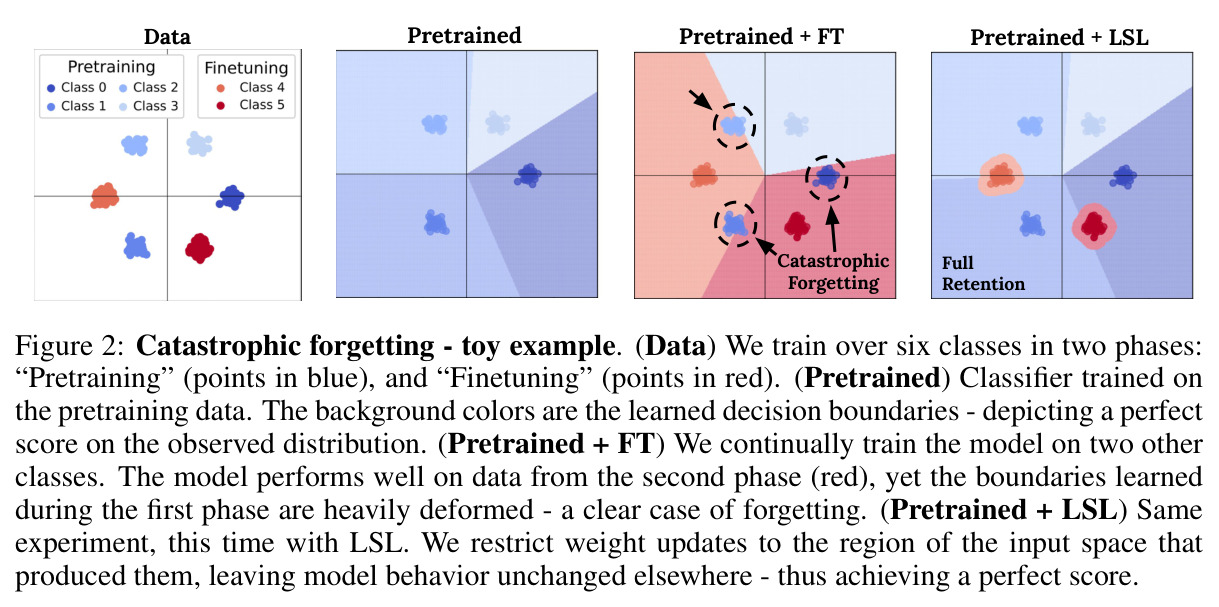
二维玩具实验:6 个类别分两个阶段训练(预训练 4 个蓝色类、微调 2 个红色类),模型是线性分类器 $W \in \mathbb{R}^{6 \times 2}$。四张子图分别展示:训练数据分布;预训练后完美覆盖蓝色类别的决策边界;继续常规微调后红色类别分类正确但第一阶段边界严重变形(灾难性遗忘);使用 LSL 后决策边界只在红色数据支撑集附近改变、其余区域完全不变,两个阶段都得到完美分类。
用最简单的设定复现并解决了问题,直观展示了“全局更新导致遗忘、局部更新避免遗忘”的核心论点,是理解论文动机和“局部支撑”含义的最佳入口。
并列展示 LSL 的训练算法(Alg. 1)与逐模块推理算法(Alg. 2)。训练:先在参考数据上拟合 $\Phi_{neg}$,然后每个阶段先正常拟合 adapter、再拟合对应的 $\Phi_{pos}$。推理:先算预训练权重输出,再对每个历史阶段的门控做决策并做指数滑动平均 $s^{(i)} \leftarrow \alpha g + (1-\alpha)s^{(i)}$,平滑值大于 0.5 才叠加该阶段 adapter 输出。
给出方法的完整伪代码,明确了“训练时门控全开、推理时逐 token 门控+平滑”的全部实现细节,是复现方法和理解推理开销来源的关键。
展示三个微调数据集的真实样本:网络安全任务要求回答如何增强 IoT 端点上休眠恶意软件静态分析的方案;英语→伊博语翻译给出一句叙事句及其伊博语译文;化学任务给出 SMILES 分子式表示的反应物到产物的转化及 73.0 的理论产率。
让读者直观了解三个评测任务的难度与多样性(专业领域知识、低资源语言开放生成、分子结构理解),说明实验选择是有意覆盖不同能力维度。