单模型循环一切:语言模型的弹性潜在循环 One Model to Loop Them All: Elastic Latent Recurrence for Language Models
门控增量更新+步内混深训练,循环模型一圈不掉点、多圈持续涨点
前置知识
潜在循环模型(Looped LM)
把 Transformer 的一段层堆叠(循环块)作为共享权重重复执行 $k$ 次,每次迭代精炼同一个隐状态,从而用推理计算换表达能力。有效深度 $D_{\text{eff}}(k)=L_{\text{in}}+kL_{\text{rec}}+L_{\text{out}}$,多跑一圈就多执行一遍循环块的算力,但参数量不变。思想源自 Universal Transformer 与深度权重复用。
全文围绕『循环块共享权重、按圈数伸缩』展开,不理解循环执行机制就无法理解弹性深度和一圈税。
弹性深度(Elastic Depth)
训练时从某个分布采样圈数 $k$,使同一个 checkpoint 在推理时能以训练范围内的任意 $k$ 服务,圈数成为类似推理努力(reasoning effort)的算力旋钮,但不像思维链那样生成额外 token。本文 ELR 的目标就是训练出在 $k\in\{1,\dots,4\}$ 上都好用的单一模型。
『不交一圈税的弹性深度』正是论文的标题级目标,需要先理解弹性深度指训练多深度、推理任选。
一圈税(One-Loop Tax)
现有弹性深度模型在 $k=1$ 时远逊同规模非循环模型的现象。例如 Huginn 以平均循环 32 训练,800B token 后 ARC-Easy 只有 34.9 分,而固定深度基线为 46.4;Parcae 一圈时同样低于 Transformer 基线。付税模型必须先跑几圈才能追平基线,延迟敏感场景仍需单独的非循环模型。
这是论文定义并要消除的核心问题,三个设计选择全部为它服务。
KV 缓存
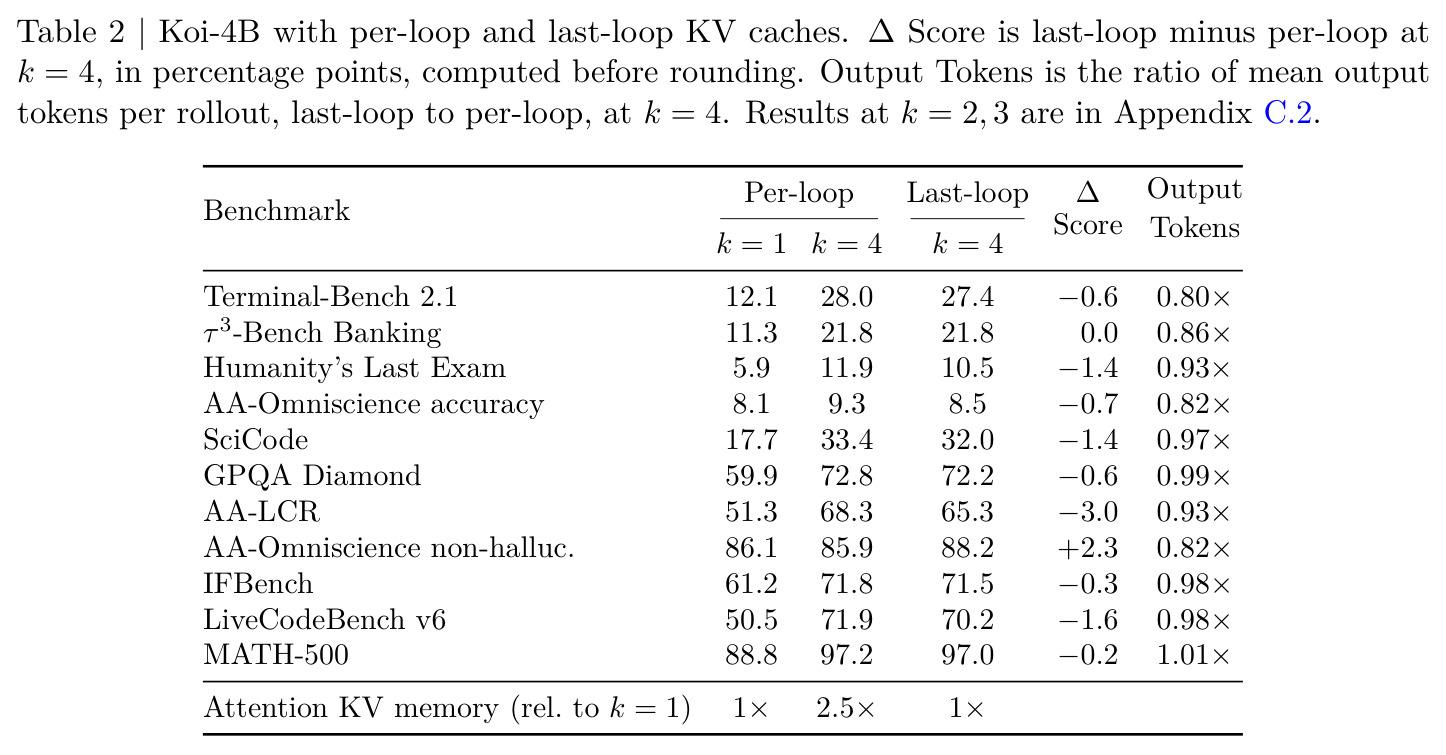
自回归解码时缓存每层注意力的 Key/Value 以免重算历史 token。循环模型若每圈各存一份缓存,显存随 $k$ 线性增长:Koi-4B 在 128K token、BF16 下逐圈缓存 $k=4$ 需 7.5 GiB,一圈只要 3.0 GiB。GDP 线性注意力层的状态不随序列长度增长,可忽略。
论文的 last-loop KV caching 用一个被逐圈覆盖的共享缓存把显存压回一圈水平,是部署可行性的关键。
混合专家(MoE)
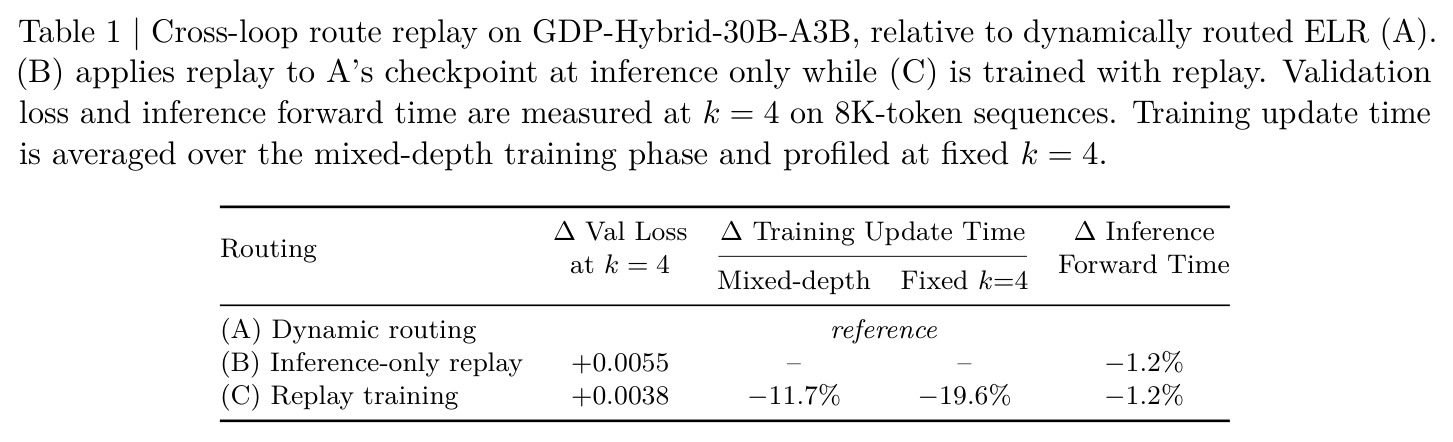
由路由器把每个 token 分派给少量专家 FFN 计算的稀疏层,30B-A3B 表示总参数约 30B、每 token 激活 3B。循环模型里每圈都会重新执行路由并重算负载均衡损失,产生重复开销,由此引出跨圈路由重放:首圈算一次路由,后续圈复用。
论文在 GDP-Hybrid-30B-A3B 上验证路由重放,把混合深度训练更新时间砍掉 11.7%,是 MoE 特有的优化。
研究动机
潜在循环模型把一组共享层反复执行,用更多推理算力换精度,理论上非常适合按延迟预算伸缩质量。但现有弹性深度模型都欠着严重的『一圈税』:只跑一圈时精度远低于同规模非循环模型。Huginn 以平均循环 32 训练、吃完 800B token 后,ARC-Easy 仍只有 34.9 分,固定深度基线却是 46.4;Parcae 一圈时也低于其 Transformer 基线。本文消融进一步显示,即便把圈数均匀采样在 1 到 5 之间,一圈端点依旧落后。后果是付税模型必须先花几圈『回本』,额外算力才开始净赚,在延迟敏感的服务档位上,单独训练的非循环模型始终是更优选择,弹性深度失去部署价值。
本文的目标是本文要给出一份名为弹性潜在循环(ELR)的训练配方,使模型在 $k=1$ 时与同数据、同规模的非循环基线精度相当(不交一圈税),而同一个 checkpoint 每多一圈都继续涨精度。同时要求配方可廉价施加:混合深度训练只需放在预训练最后四分之一(估计约 16% 额外训练 FLOPs,对比全程混深的 62%);对循环 MoE 要消除逐圈重复路由的开销;推理时注意力 KV 显存要停在 $k=1$ 的水平。最终还要端到端做出一个走完后训练的模型 Koi-4B,让单一 checkpoint 仅凭圈数就把 AA-Index 从 18 调到 29。
与已有工作不同的是,已有工作大多在问『循环是否是计算效率更高的扩参方式』(Loopie、Parcae、Schwethelm 等),而本文换了一个问题:把非循环模型视为给定基线,问『把它做成弹性要付出什么代价、如何把代价降为零』。独特切入是三个机制的精确归因:门控自适应增量更新(而非直接覆盖状态)保住一圈端点;把混合圈数放进同一个优化器步内(而非 Huginn 式每步单一深度的锁定采样);按圈索引与预算做条件化并在切换点零初始化嫁接。配套的晚期混深调度、跨圈路由重放和 last-loop KV 缓存,则是训练配方与推理系统工程交叉处的新组合。
核心方法
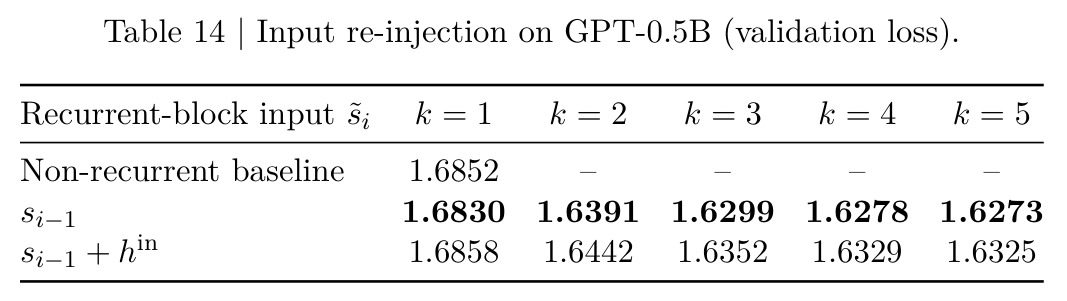
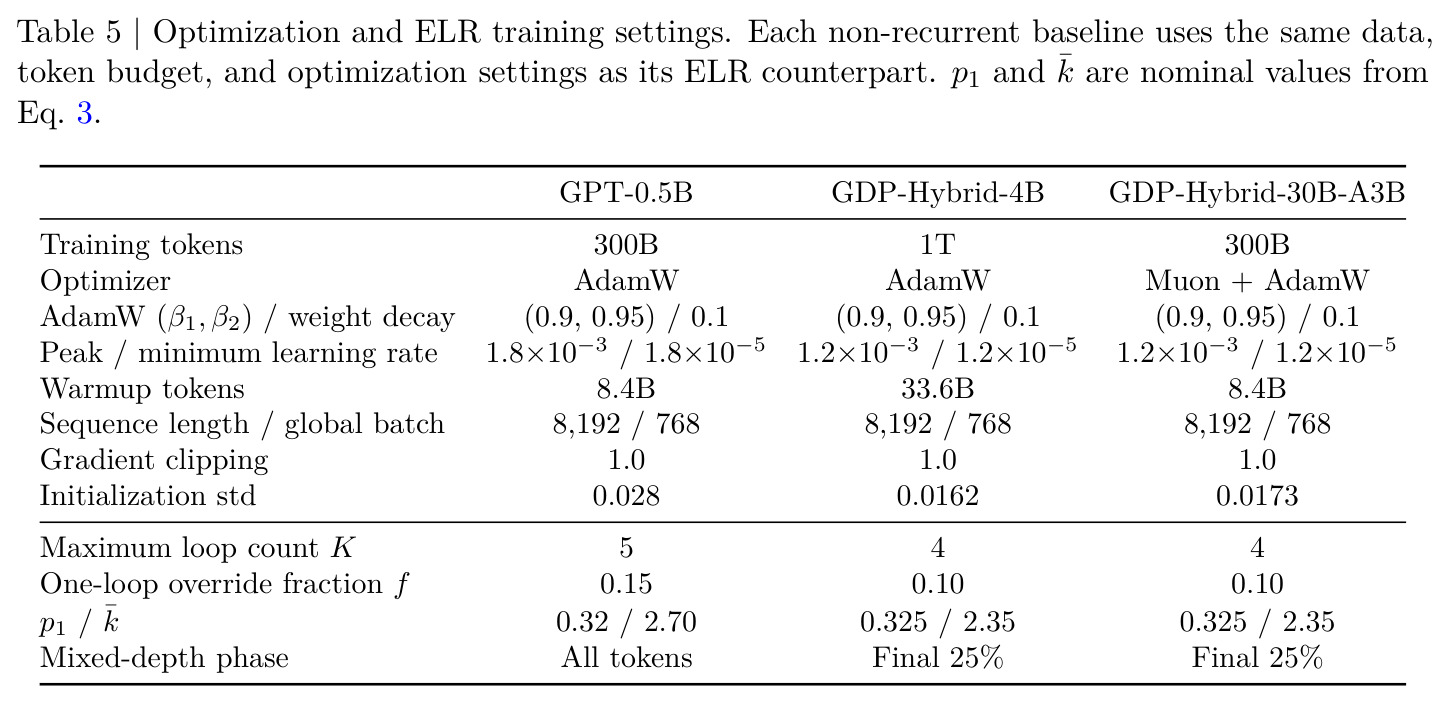
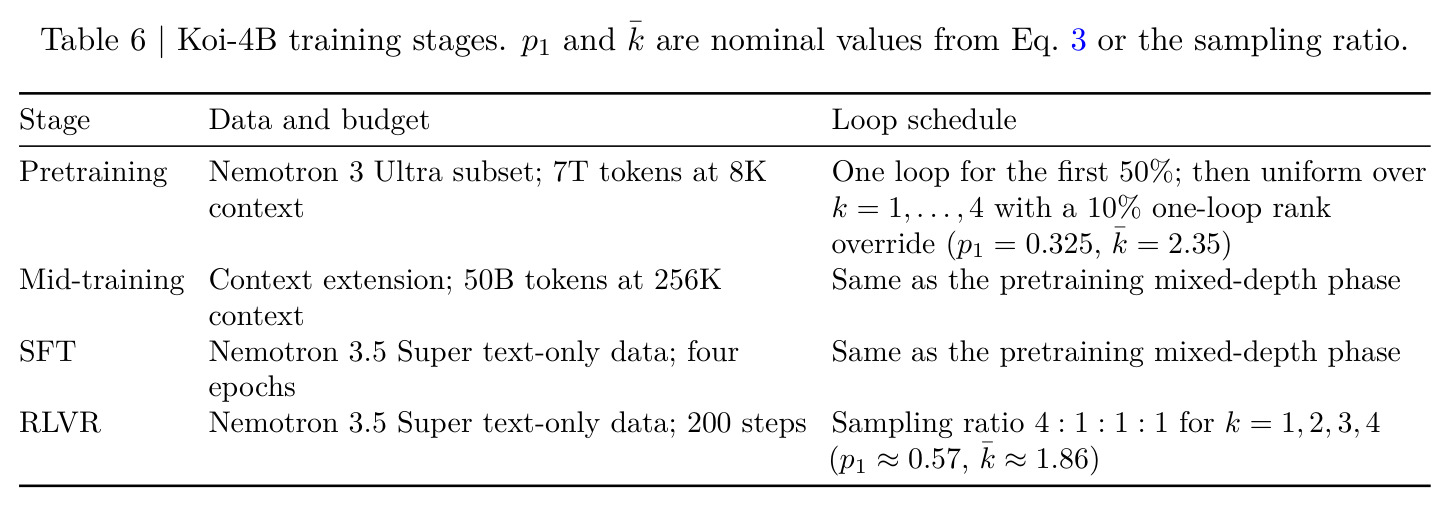
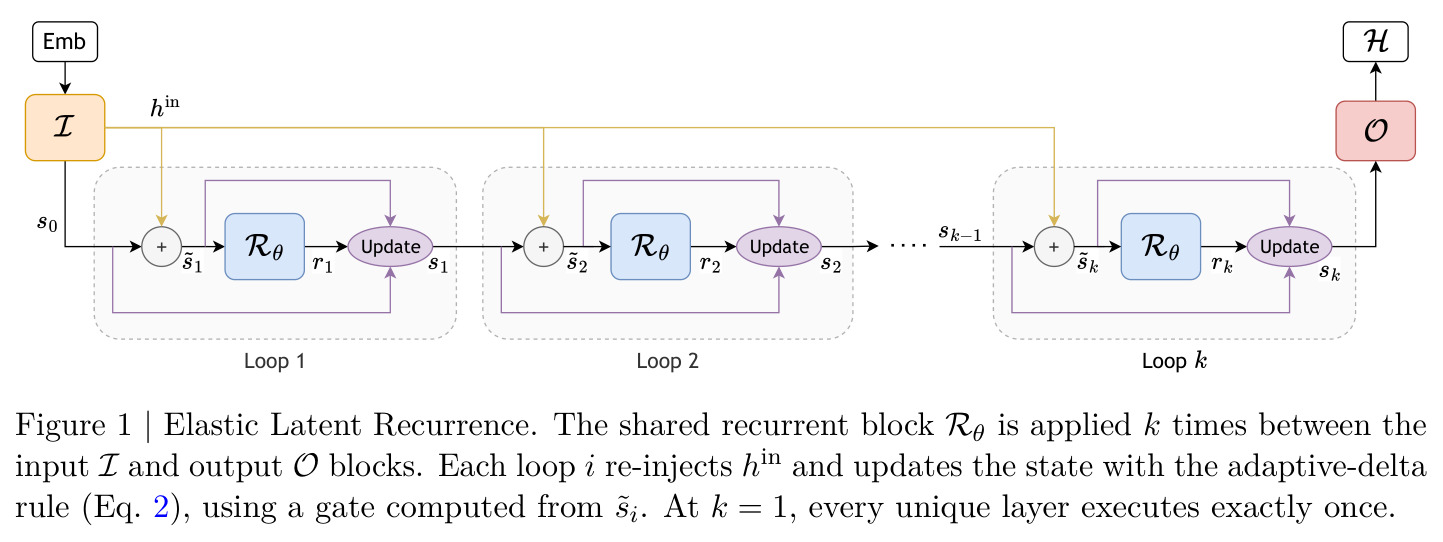
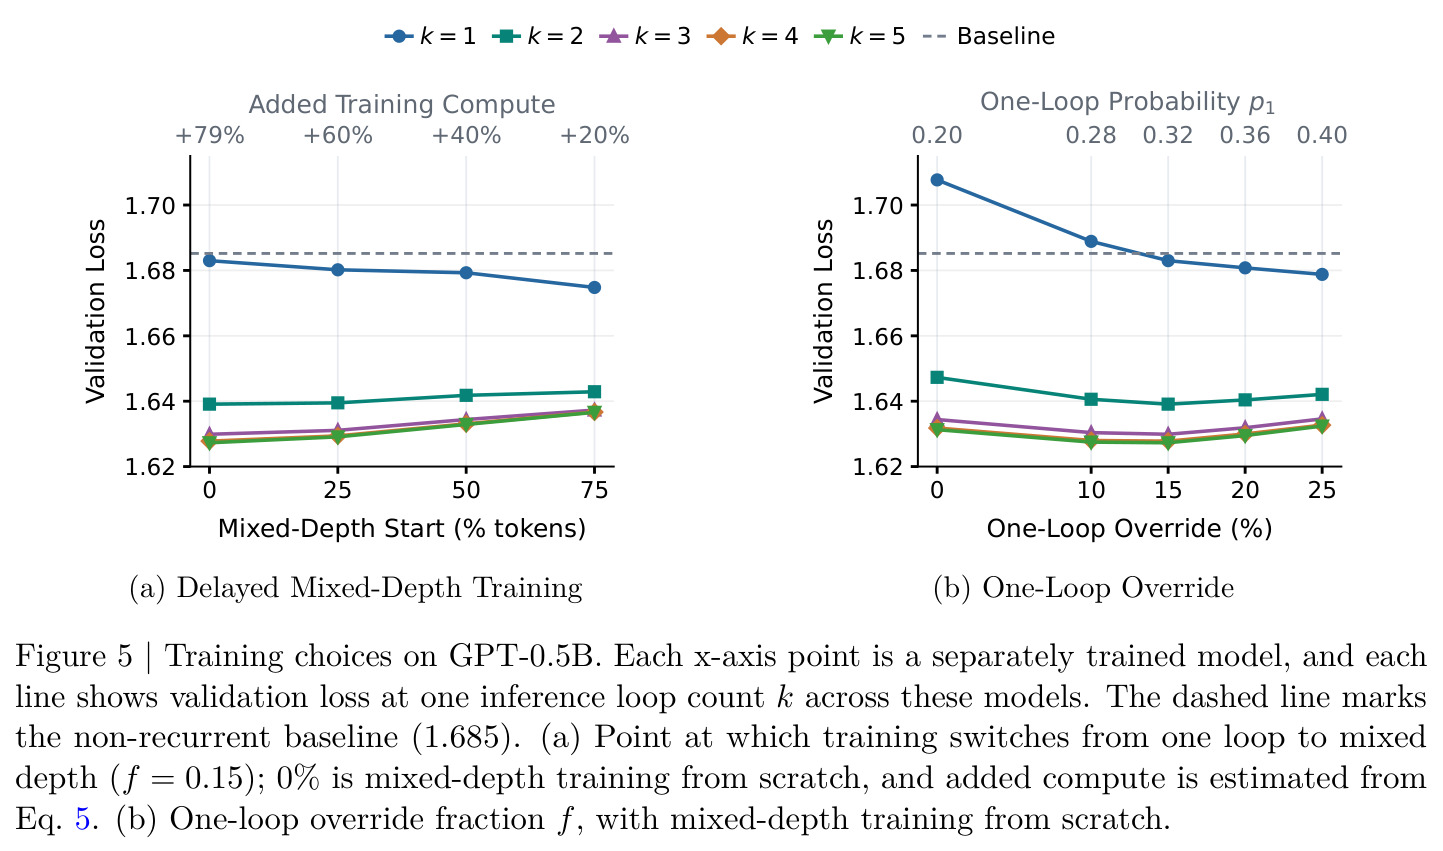
直觉上,一圈要等于普通模型、多圈只加分,需满足三点:一圈时每个独立层恰好执行一次、更新规则天然稳定、一圈与多圈梯度混在同一训练更新里。技术上 ELR 把 52 层骨干划成输入块 $\mathcal{I}$(14 层)、共享循环块 $\mathcal{R}_\theta$(24 层)与输出块 $\mathcal{O}$(14 层),$k=1$ 时 $D_{\text{eff}}(1)=D_{\text{unique}}$,参数与算力同非循环模型。状态 $s_0=h_{\text{in}}$,每圈重注入 $\tilde{s}_i=s_{i-1}+h_{\text{in}}$ 后算 $r_i=\mathcal{R}_\theta(\tilde{s}_i)$,再做自适应增量更新 $s_i=s_{i-1}+\beta_i\odot(r_i-s_{i-1})$,门控 $\beta_i=\sigma(W_\beta\tilde{s}_i+b_\beta)\odot\text{softplus}(\gamma)$ 是逐 token 逐通道步长,初始约 0.35。训练时每 microbatch 均匀采圈数,并强制轮转 10% 的数据并行 rank 每批跑一圈($p_1=0.325$、$\bar{k}=2.35$),让一圈与多圈梯度在同一更新内平均;再按进度 $\tau_i=i/k$ 与预算 $\kappa=k/K$ 做 AdaLN 调制并在切换点零初始化;前 75% token 固定一圈后才开混深;MoE 用首圈路由重放,推理用 last-loop KV 单缓存。
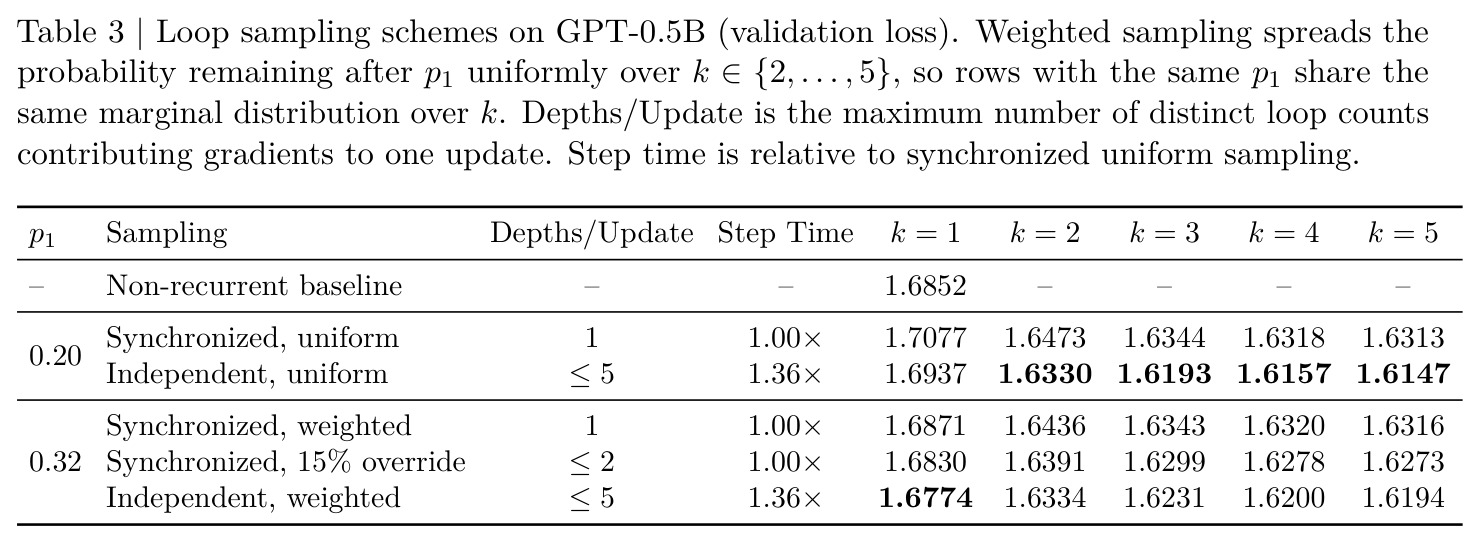
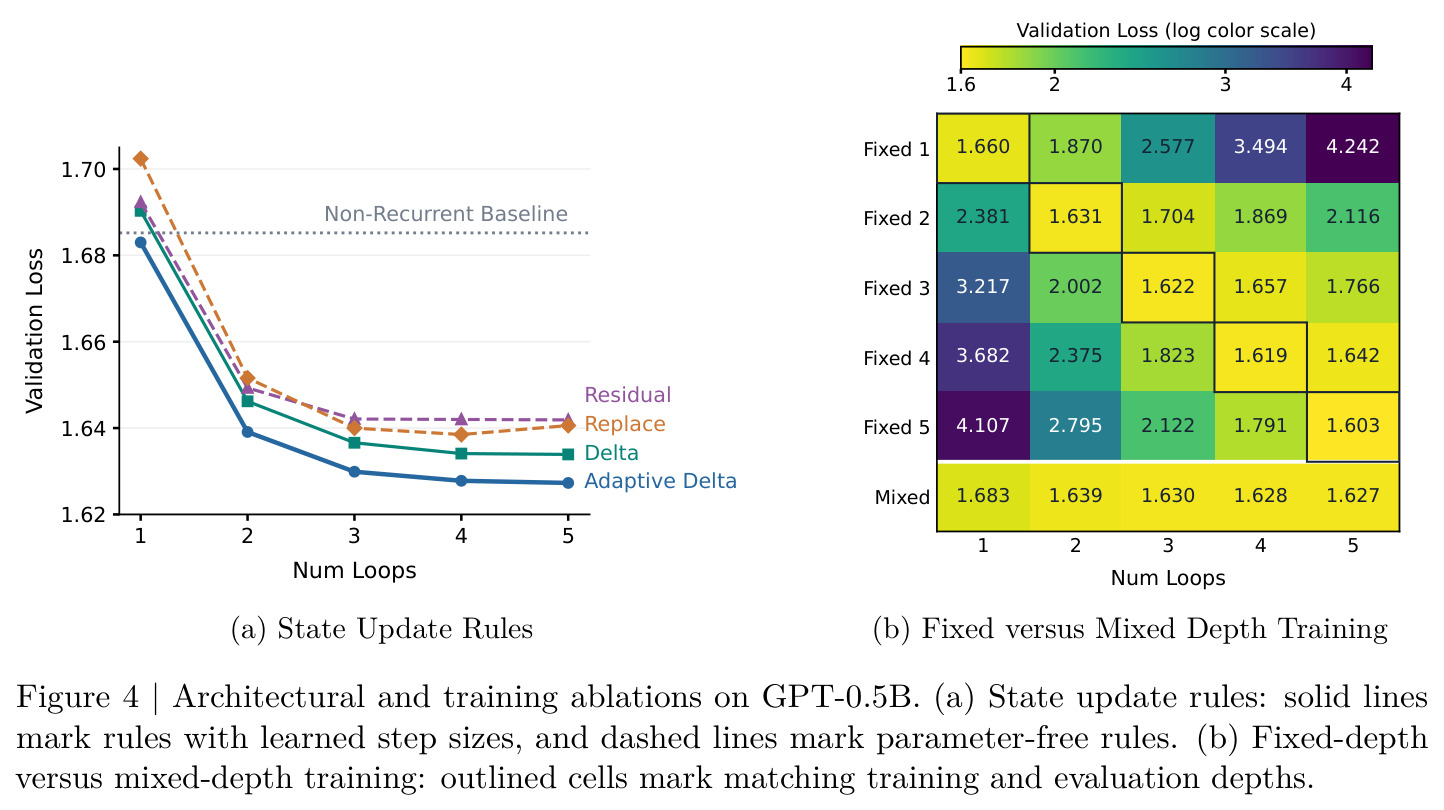
核心是『保住一圈端点』的两件事加『每圈增值』的一件事。第一,用门控自适应增量替代常见的直接覆盖 $s_i=r_i$ 或残差相加 $s_i=s_{i-1}+r_i$:每圈只沿 $r_i-s_{i-1}$ 方向走一个学习到的步长,一圈时门控退化为可学习跳连。消融显示 replace 一圈损失最高、residual 三圈后停滞,固定逐通道率的 delta 每档落后自适应 delta 0.006–0.007,唯有自适应增量在所有深度最低损失且一圈 1.660 低于基线 1.685。第二,混合圈数必须发生在同一优化器步内:Huginn 式每步单一深度即使三分之一概率抽到一圈也不保端点;ELR 让轮转的 rank 子集每个 microbatch 都跑一圈,数据并行归约把不同深度的梯度放进同一更新——同为 $p_1=0.32$,同步加权采样一圈损失 1.6871 仍高于基线,加 15% 覆盖后降到 1.6830。第三,按 $(i,k)$ 条件化让各圈特化,且在混深切换点零初始化嫁接,起始函数与一圈 checkpoint 在精确算术下完全一致。
方法步骤详情
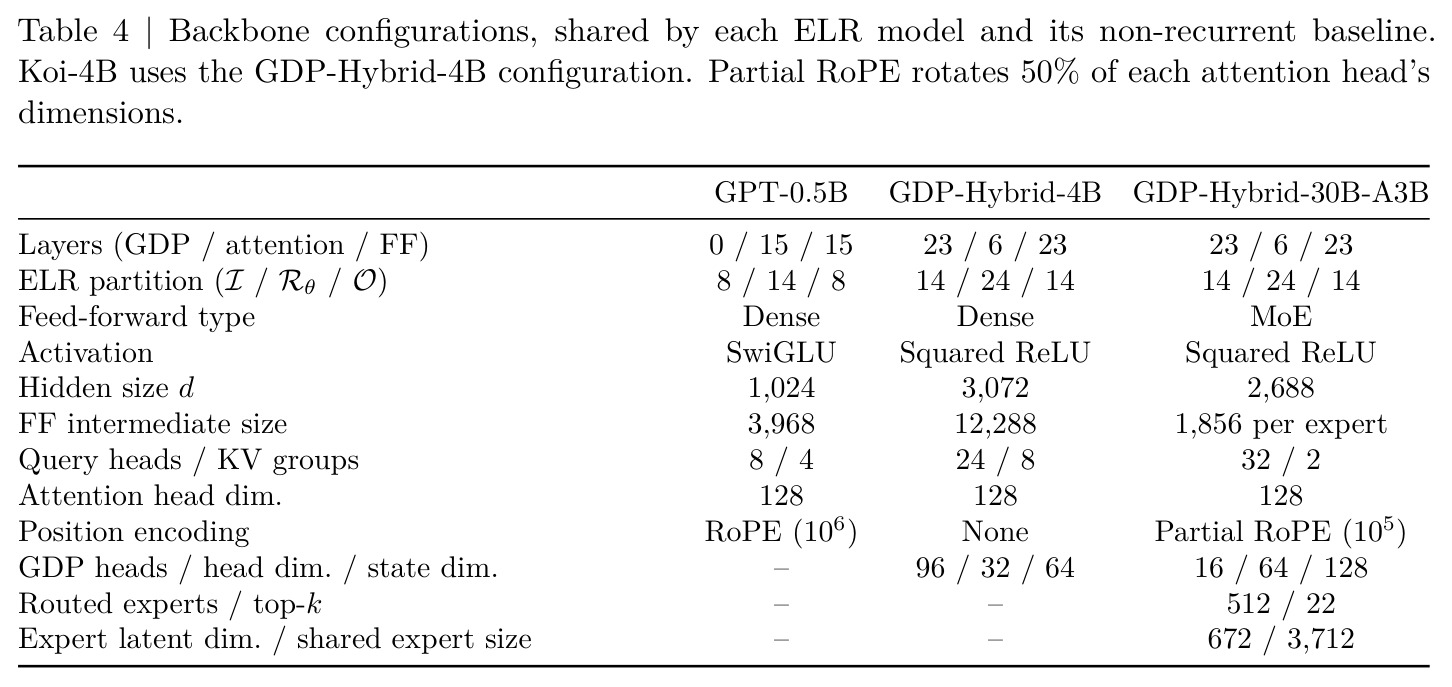
第一步,把 52 层混合骨干(23 层 Gated DeltaProduct、6 层注意力、23 层 FFN/MoE)切成 14 输入 + 24 循环 + 14 输出,$s_0=h_{\text{in}}$。第二步,逐圈前向:重注入 $\tilde{s}_i=s_{i-1}+h_{\text{in}}$,过循环块得 $r_i$,再做门控增量更新;门控参数零初始化,只增 $d^2+2d$ 个参数且与 $k$ 无关。第三步,混深训练:每 microbatch 均匀采 $k\in\{1,\dots,K\}$,$K=4$ 配 10% 一圈覆盖;先固定一圈训 75% token 再续训,总算力约 1.16 倍基线(从头混深则 1.79 倍),优化器状态无缝延续。第四步,切换点嫁接圈条件化:$\tau_i=i/k$、$\kappa=k/K$ 正弦嵌入经 MLP 得 $c_i$,AdaLN 式调制缩放平移加低秩修正,所有头零初始化,起始精确等价一圈 checkpoint。第五步,MoE 跨圈路由重放:首圈算一次路由与负载均衡损失(按实际 $k$ 缩放),后续圈复用。第六步,推理用 last-loop KV:单缓存被逐圈覆盖,解码读历史 token 末圈 K/V 加本圈 K/V,KV 显存恒为一圈水平。
技术新颖性
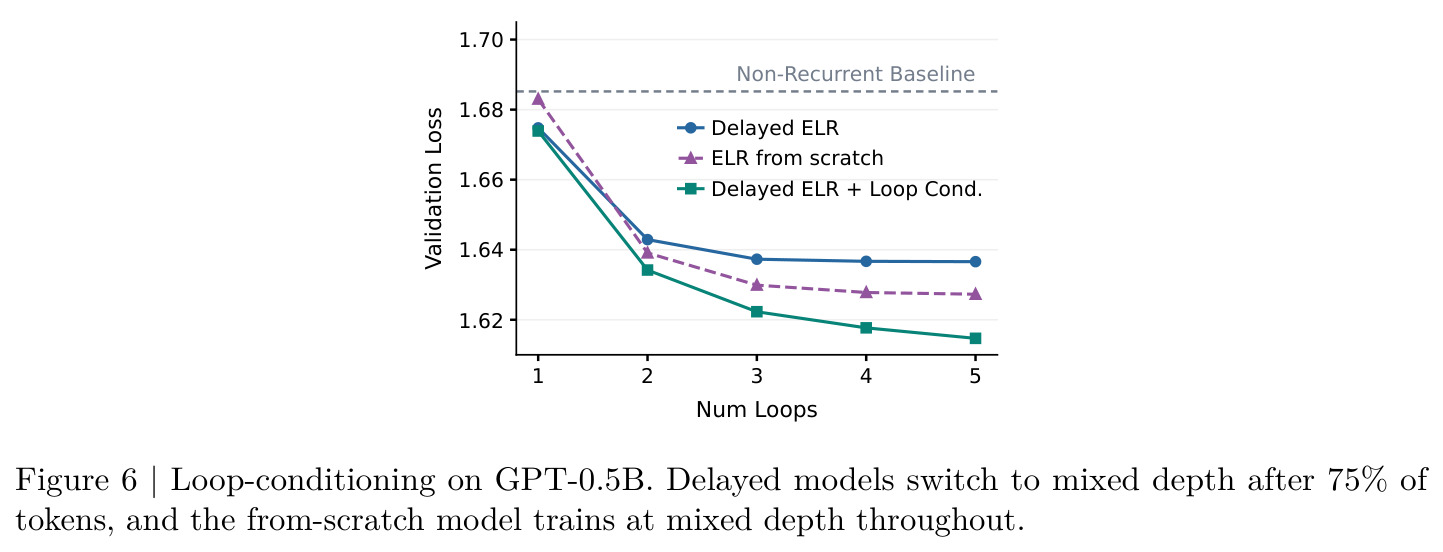
相对 Huginn/Ouro 等已有循环模型,ELR 的新颖性有四点。其一,不需要任何深度专属参数就达到一圈持平:RINS 要靠深度专属线性适配器才能在 600M 模型上一圈匹配基线,LoopFormer 的对比无法同时匹配独立参数与块级推理 FLOPs,而 ELR 一圈内每个独立层恰好执行一次。其二,圈条件化不是从头训练,而是零初始化嫁接到已训好的一圈 checkpoint 上,结果是晚期调度反而胜过从头混深(五圈损失 1.6147 对 1.6273),绕开了 Huginn 报告的步索引条件化损害深度外推的问题。其三,一圈 rank 覆盖利用数据并行归约在同一更新内混不同深度的梯度,证明收益来自梯度混合而非提高一圈的边际采样概率。其四,跨圈路由重放与 last-loop KV 缓存是首次针对『同 checkpoint 多圈服务』的系统性方案,前者把 MoE 路由器从每圈 53 次评估降到 23 次,后者以零重训代价冻结 KV 显存。
实验结果
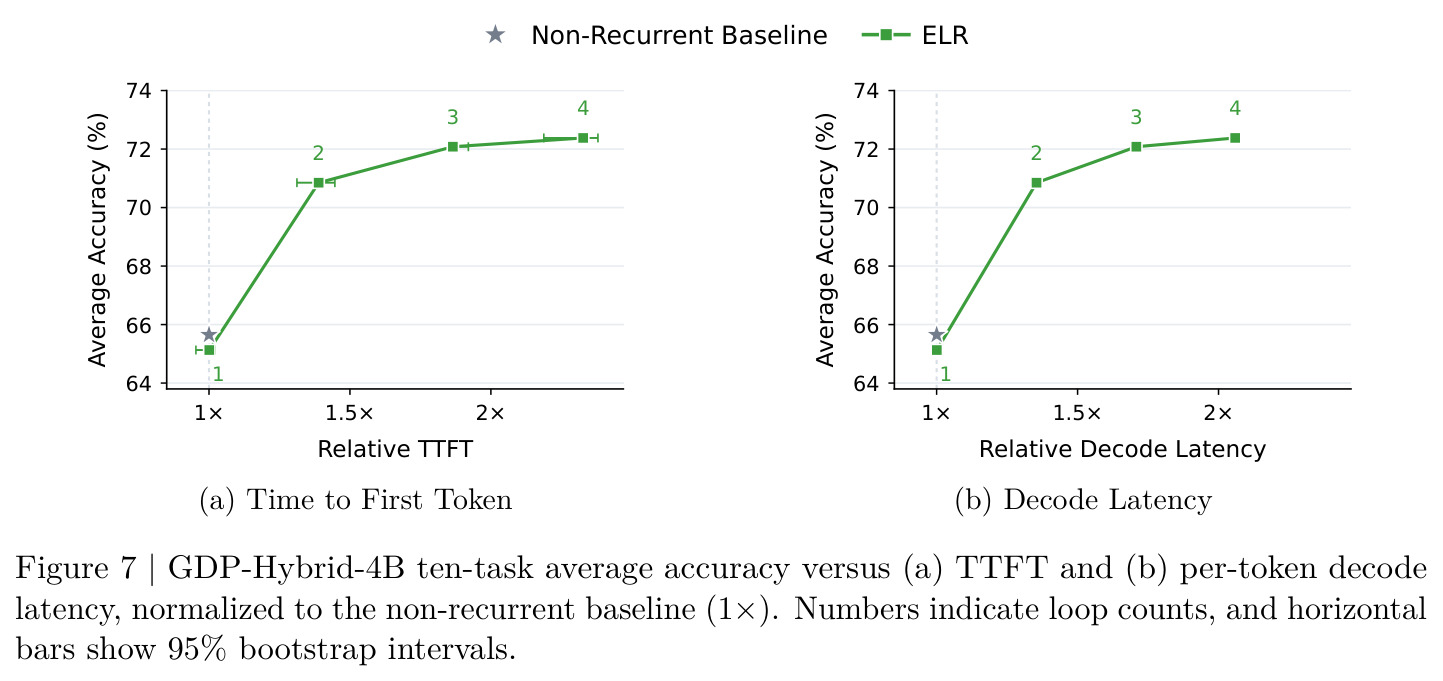
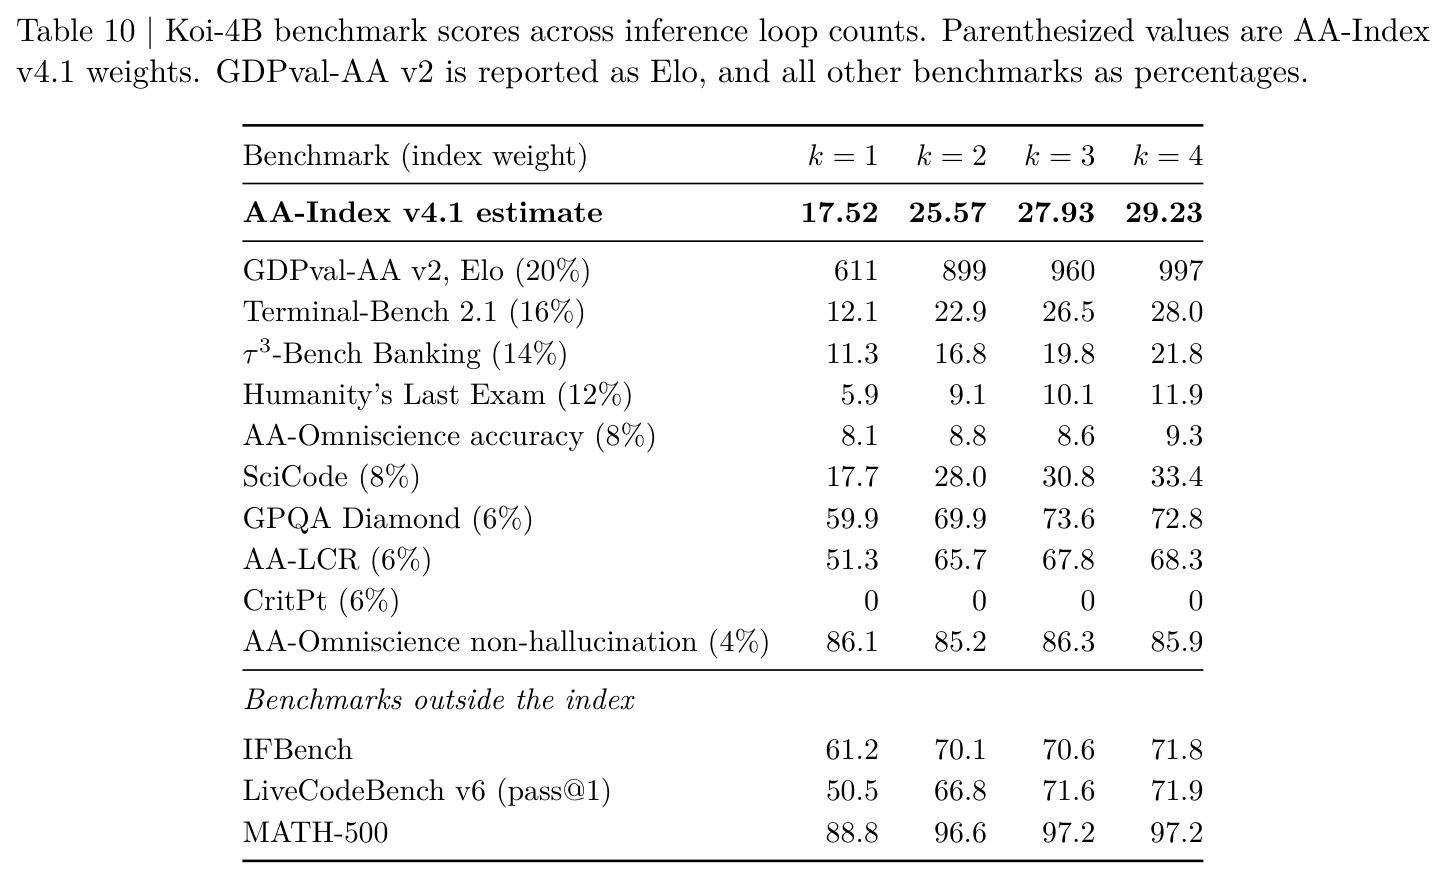
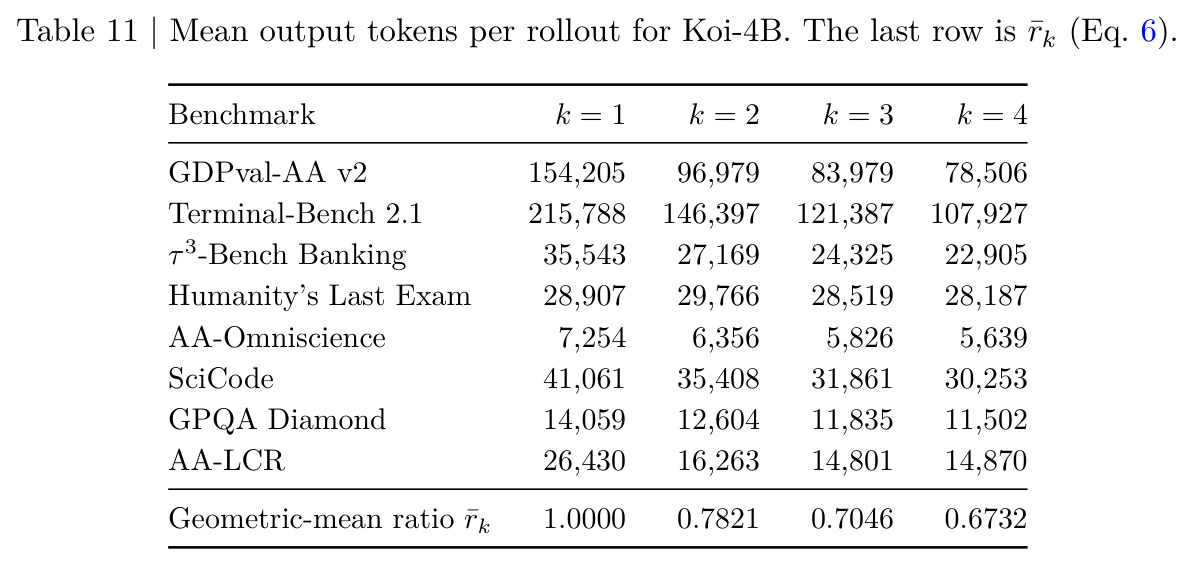
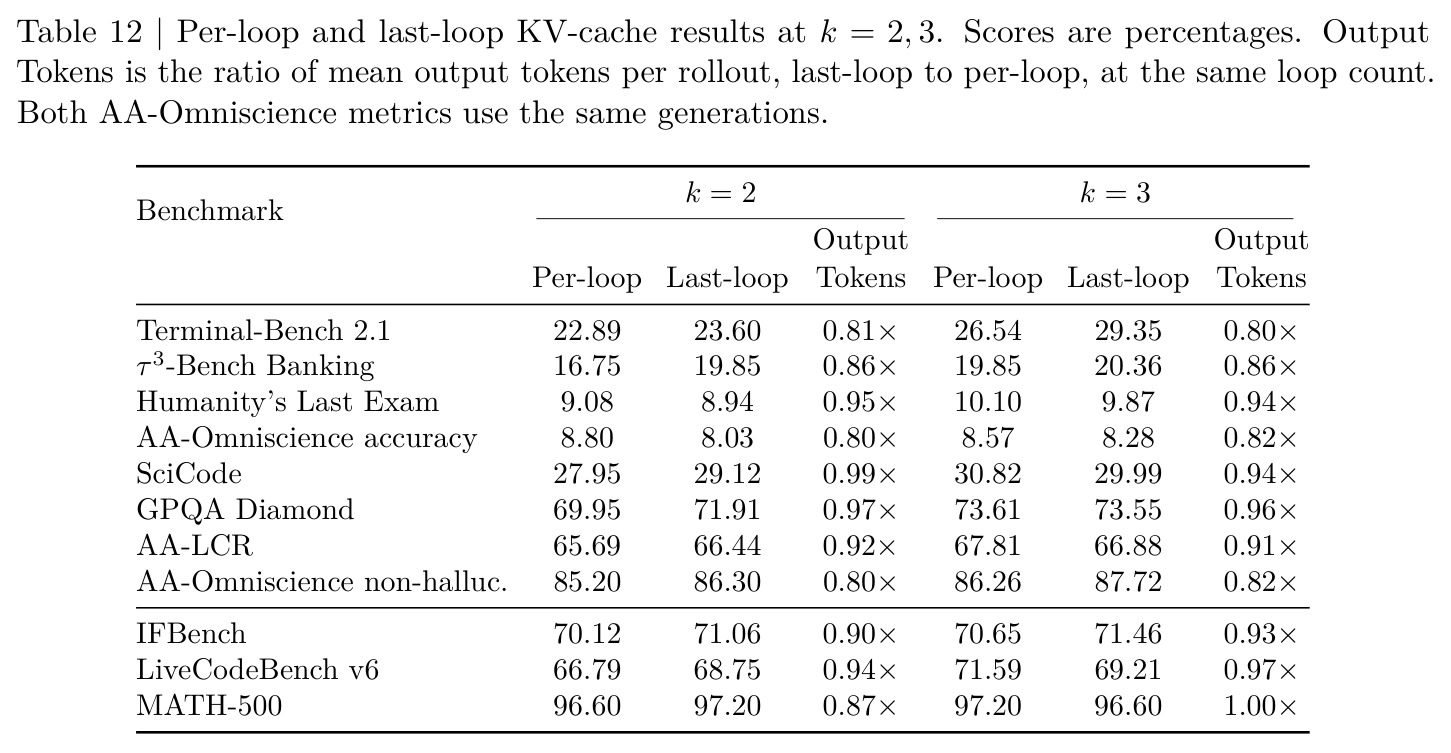
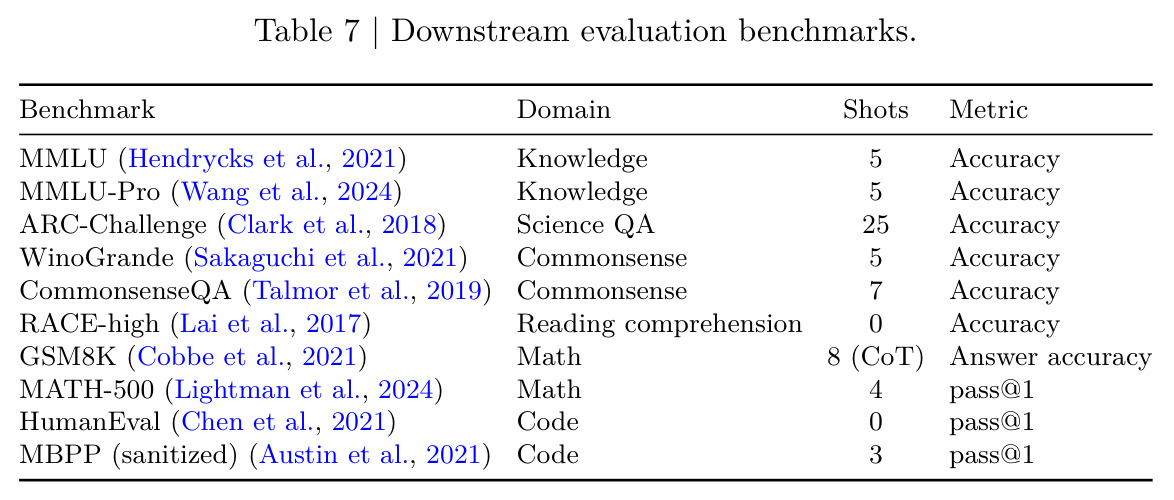
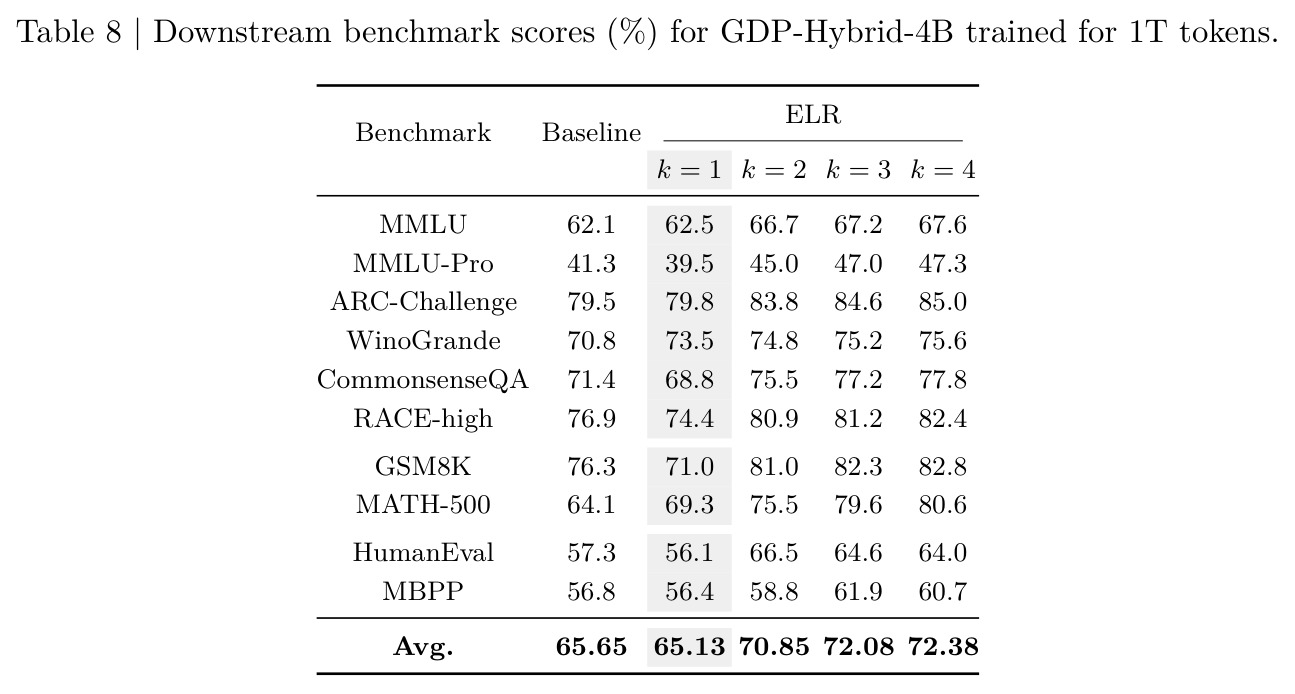
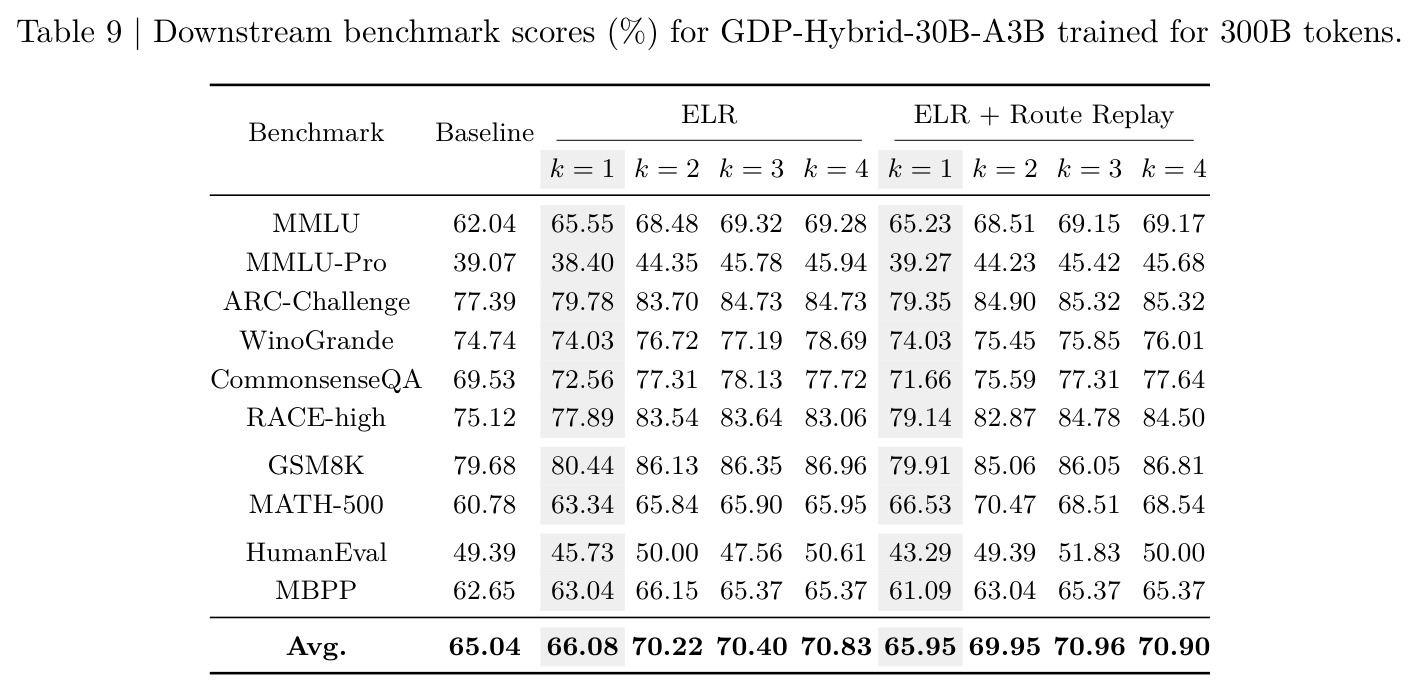
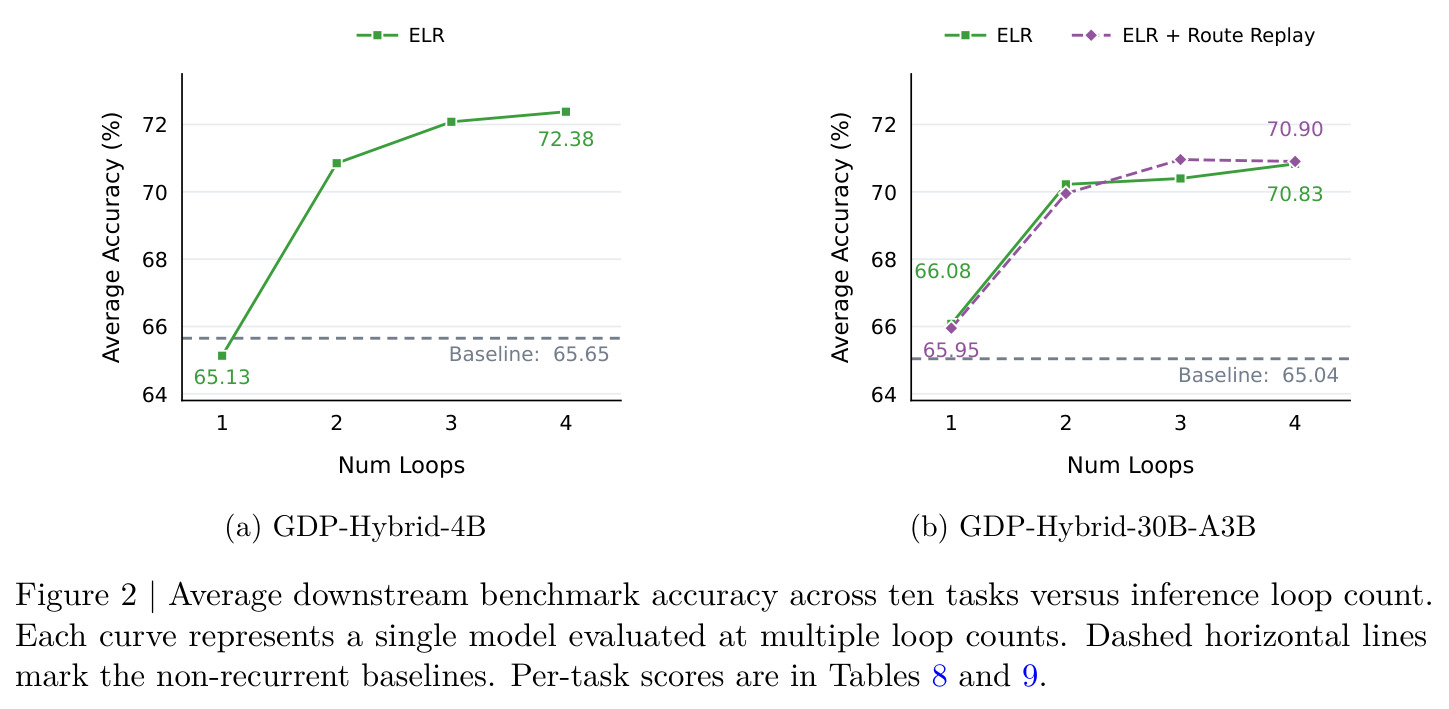
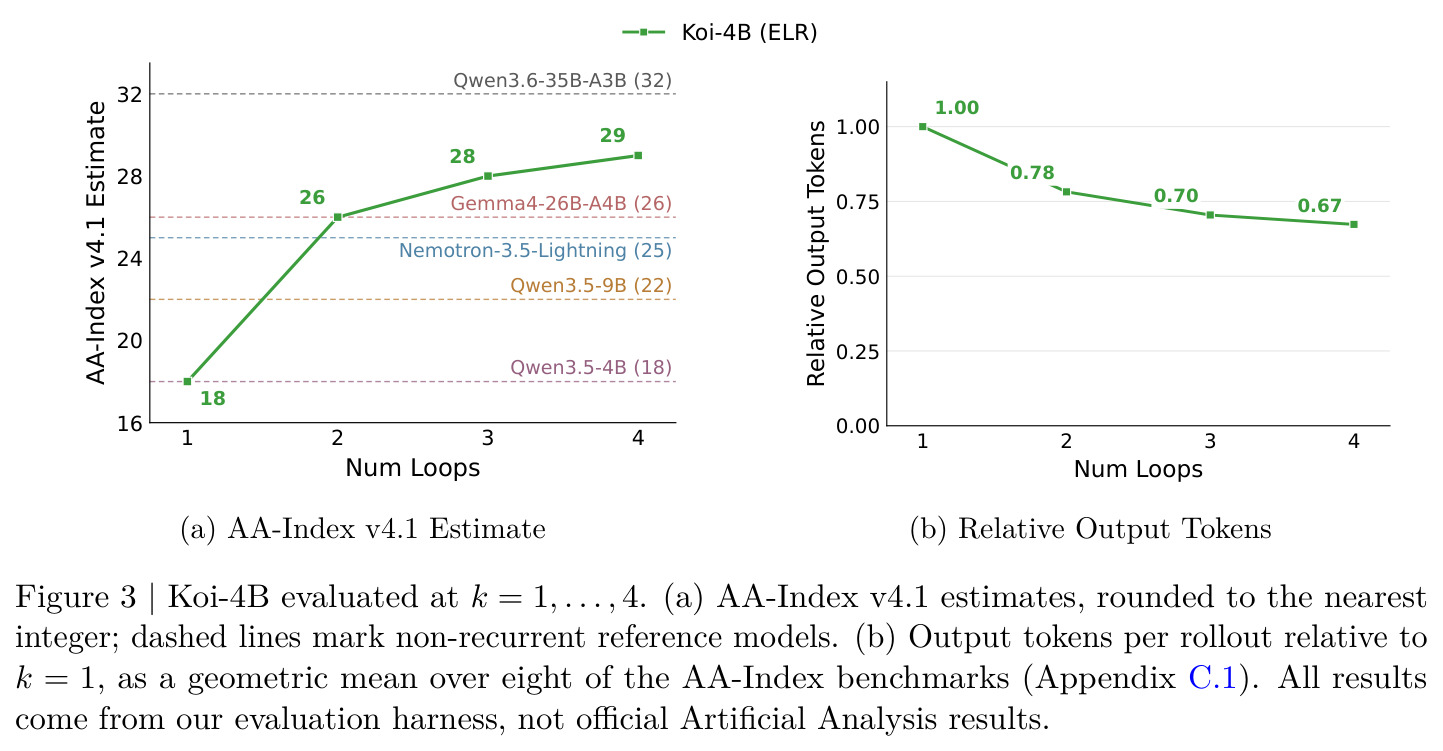
GDP-Hybrid-4B(1T token):一圈十任务平均 65.13,仅比基线 65.65 低 0.52,四圈 72.38、净增 7.25(GSM8K +11.8、MATH-500 +11.3)。GDP-Hybrid-30B-A3B(300B token,MoE):一圈 66.08 反超基线 65.04 达 1.04,四圈 +4.75;两圈/三圈捕获 79%/96%(4B)与 87%/91%(30B)的增益。推理成本:四圈 TTFT 2.33 倍、解码 2.06 倍,三圈以 1.87 倍拿 96% 增益。路由重放:四圈验证损失仅 +0.0038,混深更新时间 -11.7%(固定 $k=4$ 时 -19.6%),十任务 70.90 对 70.83 持平。Koi-4B:AA-Index 一圈 18(平 Qwen3.5-4B)、两圈 26(超 Qwen3.5-9B 的 22,平 Gemma4-26B-A4B)、四圈 29;输出 token 缩短 21.8%/29.5%/32.7%,两圈每 rollout 解码仅 +6%。Last-loop KV:$k=4$ 分数降 0–3%,KV 显存 1 倍而非 2.5 倍。消融(GPT-0.5B):自适应增量一圈 1.660 低于基线 1.685 且全档最优;15% 一圈覆盖以同步步时达 1.6830,独立 rank 更低(1.6774)但步时 +36%;75% 切换把算力从 1.79 降到 1.20 倍仍保 84% 五圈增益;圈条件化嫁接后五圈 1.6147,反超从头混深的 1.6273。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 十任务下游平均(MMLU、MMLU-Pro、ARC-C、GSM8K、WinoGrande、CSQA、RACE-H、HumanEval、MBPP、MATH-500),GDP-Hybrid-4B | 平均准确率 (%) | ELR 一圈 65.13,四圈 72.38 | 非循环基线 65.65 | 一圈 -0.52;一圈→四圈 +7.25 |
| 同上十任务平均,GDP-Hybrid-30B-A3B(MoE,300B token) | 平均准确率 (%) | ELR 66.08(四圈 70.83);ELR+路由重放 65.95(四圈 70.90) | 非循环基线 65.04 | 一圈 +1.04;四圈 +4.75 至 +5.86 |
| 混合深度训练更新耗时(30B-A3B) | 相对动态路由的时间变化 | 重放训练 -11.7%(固定 $k=4$ 时 -19.6%),推理前向 -1.2% | 动态路由(参考组) | 代价仅四圈验证损失 +0.0038,十任务持平(70.90 vs 70.83) |
| Artificial Analysis Intelligence Index v4.1(自建 harness 估计),Koi-4B | AA-Index 估计分 | 一圈 18 → 两圈 26 → 三圈 28 → 四圈 29 | Qwen3.5-4B 18(一圈持平);Gemma4-26B-A4B 26;Qwen3.6-35B-A3B 32 | 一圈→四圈 +11 分,四圈超 6.5 倍参数的 Gemma4-26B-A4B |
| 注意力 KV 显存(128K token、BF16),Koi-4B $k=4$ | 相对一圈的倍数 | Last-loop KV 1×(约 3.0 GiB) | 逐圈缓存 2.5×(约 7.5 GiB) | 显存 -60%,分数代价仅 0–3% |
局限与改进
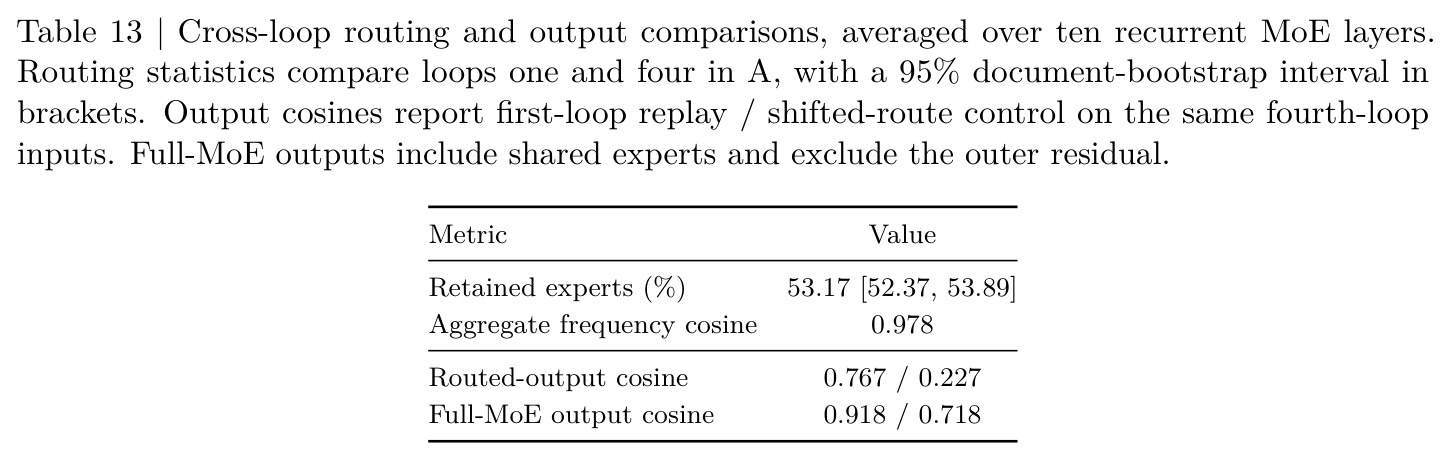
作者承认的局限:第二圈后收益明显递减(两圈已拿 79%–87%),未测试重新加权圈数分布能否恢复后段增益;圈条件化收窄了中间深度与固定深度专家的差距,但端点仍不闭环且原因未查明;服务时每个请求固定圈数,未与逐请求或逐 token 自适应深度结合(预算条件使 token 级自适应更复杂);MoE 变体只做了预训练验证,未走后训练。我的补充观察:4B 一圈仍低 0.52 分且 GSM8K 落后基线 5.3 分,严格说是接近持平而非持平,门控跳连未完全消除循环化损伤;Koi-4B 没有同数据非循环对照,18 分只能与开源模型横向比较;所有 AA-Index 分数来自自家 harness 而非官方 Artificial Analysis,与公开数字可能有偏差;路由重放依赖首圈路由后续仍可用的假设——逐 token 仅保留 53% 首圈专家、输出余弦相似度 0.767,在更长圈数或漂移更大的任务上可能劣化;条件化模块在 0.5B 模型上就占 6.34% 参数,小模型上开销不小。
独立分析的弱点
第一,一圈并非零代价:4B 十任务 -0.52、GSM8K -5.3,说明门控跳连与架构重排仍有残余损伤,改进方向是在混深阶段对一圈输出加显式一致性约束,或对门控做正则使其在一圈时严格退化为恒等。第二,增益高度集中在前两圈,三、四圈在混深训练中仅出现在 45% 和 22.5% 的样本里,属训练分布欠采样,可用圈数课程(后期逐渐偏向高圈)或重要性重加权恢复后段增益。第三,last-loop KV 在 AA-LCR 上 -3.0 分、HLE 与 SciCode 各 -1.4,长程推理任务对历史 K/V 的圈一致性敏感,可探索跨圈 K/V 插值、只对关键注意力层保留逐圈缓存的混合策略。第四,路由重放只省 1.2% 推理前向、主要收益在训练侧,且依赖路由漂移小的假设,可加一个漂移检测器在高漂移层回退动态路由。第五,固定圈数 per request 浪费了预算条件化的灵活性,可与难度预测器结合做动态深度批处理(与 Continuous Depth Batching 正交结合),让简单请求跑一圈、难题自动跑四圈。
未来方向
作者明确提出:重新加权圈数分布以恢复三圈以后的收益;查明条件化在端点为何无法完全闭合差距;把 ELR 与逐请求、逐 token 的自适应深度结合(预算条件 $\kappa=k/K$ 使 token 级自适应变得复杂);对 MoE 变体做后训练。基于成果可延伸的方向:把『零初始化嫁接』推广为一种通用的事后能力嫁接范式——任何新能力(工具调用、长上下文)都可以零初始化适配器保底、不损害原 checkpoint;研究潜层深度与显式思维链 token 的联合伸缩律,本文已显示多圈可替代 21.8%–32.7% 的输出 token,值得量化两种计算的最优配比;测试超过 4 圈的训练与深度外推;将路由重放推广为更广泛的跨圈缓存(注意力模式、归一化统计量);在 KV 显存受限的边缘设备上实测 last-loop KV 与连续深度批处理的组合收益。
复现评估
论文来自 NVIDIA,正文未提及开源权重或代码,Koi-4B 目前无法直接下载。复现门槛极高:GDP-Hybrid-4B 训 1T token、30B-A3B 训 300B token、Koi-4B 预训练 7T token 再加 50B token 的 256K 上下文中训与后训练,连 0.5B 消融也要 300B token,均需大规模 GPU 集群。有利条件是方法与消融描述异常细致:门控初始化($W_\beta,b_\beta$ 为零、$\gamma=0$)、覆盖比例与边际概率的换算(式 3)、75% 切换点、条件化零初始化、重放的负载均衡缩放规则都有显式公式,训练架构(GDP+注意力+FFN 的 23/6/23 布局)也完全公开。想验证核心思想的研究者可在 0.5B、$K=5$ 的规模上复现趋势(基线 1.685、自适应增量一圈 1.660 这条曲线是关键判据);但要复现下游任务与 AA-Index 结果,需自建 Nemotron 3 Ultra 数据子集、十任务评测与 AA harness,存在一定不确定性。
论文图表