单块多深度:深度编程专家的循环视觉Transformer One Block, Multiple Depths: Recurrent Vision Transformers with Depth-Programmed Experts
单个Transformer块循环复用,深度编程专家恢复逐层计算,参数省70%精度持平
前置知识
混合专家
MoE 用多个并行 FFN(专家)加一个路由器替代单一 FFN:路由器为每个 token 或样本计算权重,只激活或混合部分专家,从而以受控的额外计算换取更大的参数容量。常见形式有两类:token 分发(每个 token 经 top-K 稀疏激活选中专家,如 DeepSeek-V3、MoEUT)与输出混合(所有专家都参与计算、按门控权重叠加输出,如 Soft-MoE、ReMoE),还有一类做权重空间合并(如 SMEAR、Lory),先把专家参数按权重合并成单个 FFN 再执行。
reViT 的全部设计围绕“哪种专家组合形式适合完全权重共享”展开,论文在统一循环骨干上受控比较了七种 MoE 机制(Table 3/4),并按名义 FFN 计算比 $U$ 统一预算口径;不理解 MoE 的门控、稀疏激活与负载均衡,就无法读懂这些对照实验。
循环/权重共享 Transformer
让同一个 Transformer 块反复执行 L 次,替代 L 个独立参数化的块(代表工作:Universal Transformer、ALBERT、语言侧的 MoEUT 与 Mixture-of-Recursions)。这样做参数量与深度解耦、存储大幅下降,但纯权重绑定会丢失逐层特异性计算,精度明显下降;视觉侧的 Raptor 用 k=4 个不同块模板循环,恢复了大部分精度但仍保留多个块。
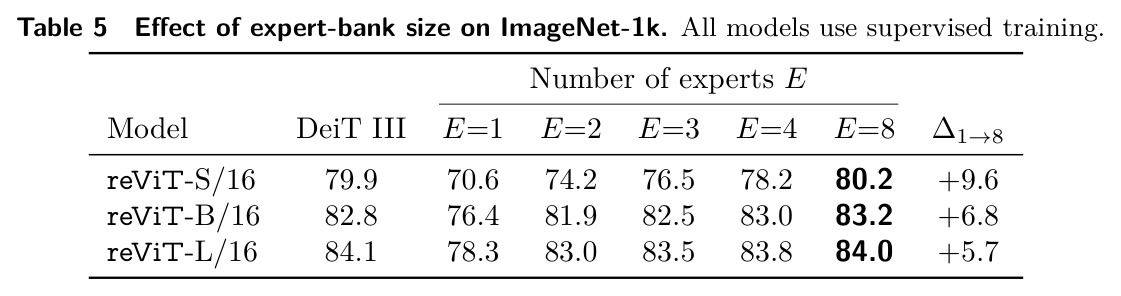
reViT 把共享推到极限(全模型只有一个块),论文的动机、E=1 纯绑定基线(ImageNet 仅 70.6% vs DeiT III 79.9%)以及与 Raptor 的对比全部建立在这一概念之上。
归一化深度坐标与超网络
把层序号 t 映射到 [0,1] 的连续坐标 $s_t = t/(L-1)$,再用一个小网络(超网络思想,源自 Ha et al. 2017)把条件信号映射为参数或系数。因为坐标连续,改变推理深度 L 只是换一个采样网格,同一“深度程序”无需重训练即可重用。reViT 的路由器就是一个受约束的超网络:输入一维坐标 $s$,输出 E 个专家 logits 的两层 MLP。
这是 reViT 区别于按图像特征路由(CondConv/SMEAR/Lory)的核心:理解 $s_t$ 如何编程专家混合、以及弹性深度推理(改 L 重采样坐标网格)都必须先掌握坐标条件化的思想。
知识蒸馏与冻结骨干探针
知识蒸馏让小模型(学生)模仿大模型(教师)的输出或内部特征。本文只用教师最终层 post-LayerNorm 特征的均方误差:$\mathcal{L}_{dist} = \frac{1}{Td}\|\mathrm{LN}(X_L) - Y\|_F^2$,刻意不用中间层对齐。冻结骨干探针指训练后冻结编码器,仅训练轻量读出头:ImageNet 线性分类、ADE20k 线性分割头、NYUv2 线性/两层 MLP 深度头,用 Top-1、mIoU、RMSE 衡量表征质量。
Table 2 的全部指标来自这套评估协议;论文强调“仅最终层监督也能追平教师”,与 Raptor 使用中间特征蒸馏形成关键对照,不理解蒸馏目标的差异就看不懂两文贡献的边界。
CKA 与有效秩
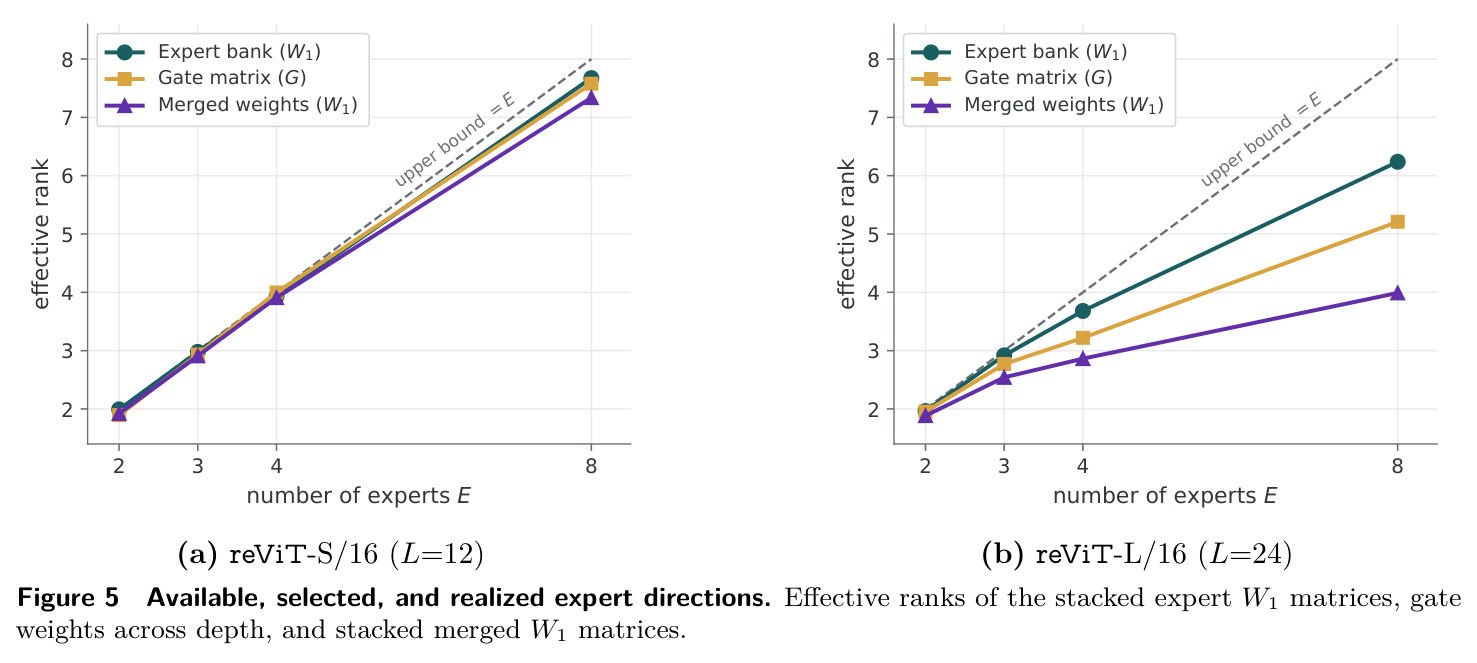
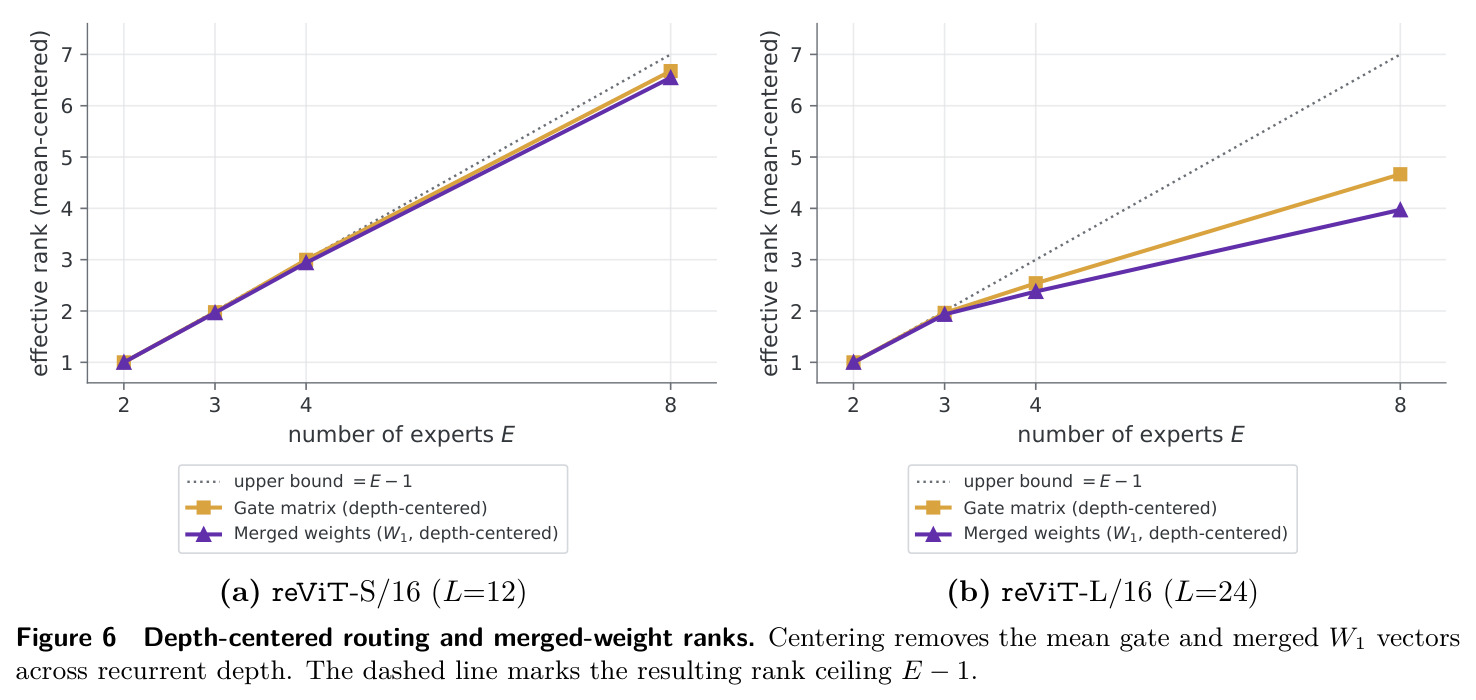
CKA(中心核对齐,Kornblith et al. 2019)度量两组表示矩阵的相似性,取值约 0 到 1,越高越相似,常用于跨模型比较层间结构(自 CKA 看模型内部深度轨迹,交叉 CKA 看学生步与教师层的对应)。有效秩 $r_{eff} = \exp(-\sum_i p_i \log p_i)$($p_i$ 为归一化奇异值平方)衡量矩阵实际占据的方向数:单一方向主导时趋近 1,k 个等强度方向时约为 k。
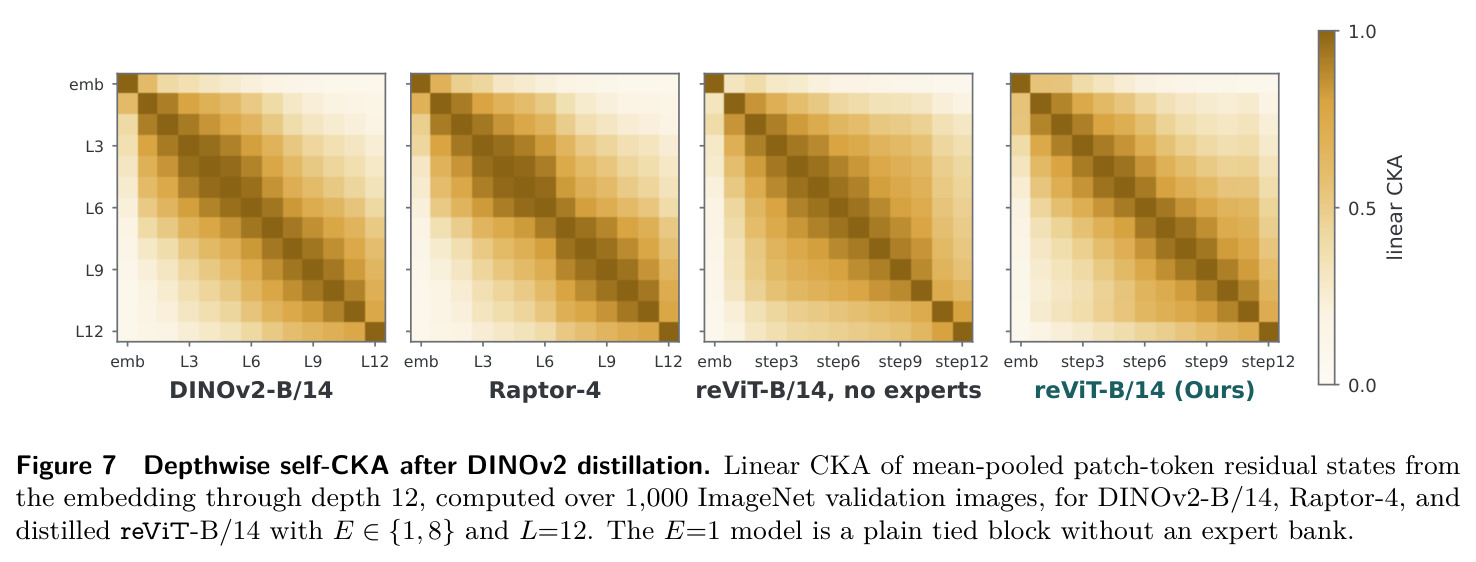
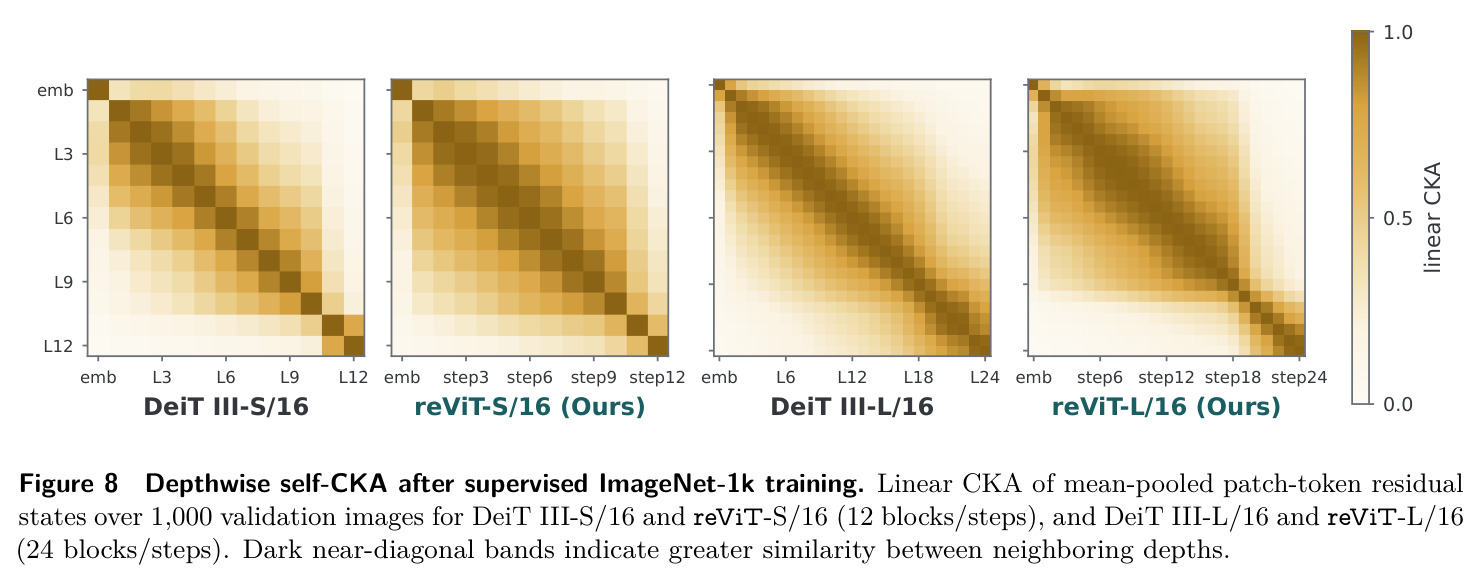
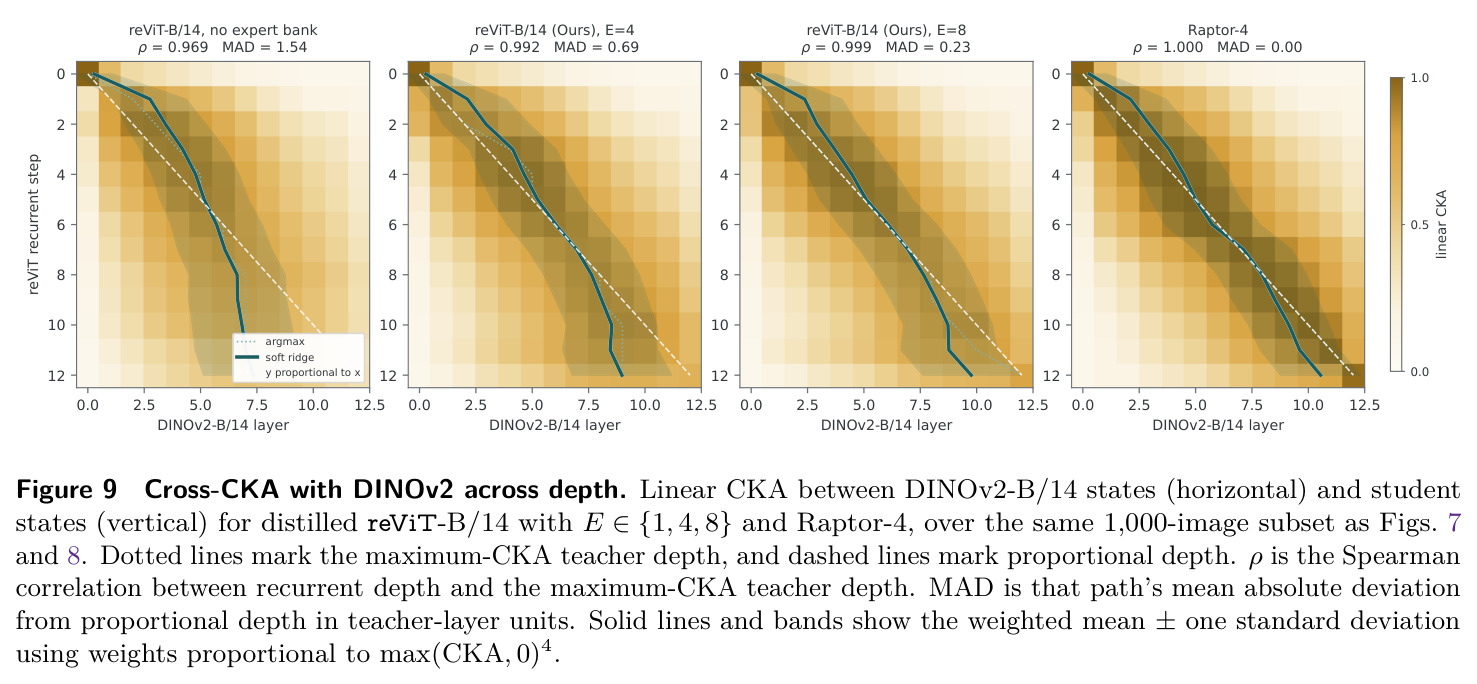
论文第 5 节用 CKA 做专家消融与置换实验、度量学生轨迹对教师深度进程的覆盖(Fig. 4/9/10),用有效秩解释为何大模型从更多专家获益更少(Fig. 5/6);不懂这两个指标就读不懂分析章节。
研究动机
标准视觉 Transformer(ViT)把图像 token 送入 $L$ 个独立参数化的块,参数量随深度线性膨胀:DeiT III-S/16 为 22.1M、B/16 达 86.6M、L/16 高达 304.4M。已有证据暗示深度冗余:Raghu et al. (2021) 的 CKA 分析发现 ViT 各层表示比 CNN 相似得多;Raptor(Jacobs et al., 2026)发现训练好的 ViT 块自组织成少数连续计算阶段,用 $k=4$ 个块模板循环复用,但仍保留多个块、需对齐教师中间层特征做蒸馏、性能低于被逼近的原网络。更早的纯权重绑定方案(ALBERT、Universal Transformer、MiniViT)丢失深度特异性计算——本文实验中纯绑定模型(E=1)在 ImageNet-1k 上仅 70.6%(S/16),比 DeiT III 的 79.9% 低 9.3 个百分点。另一边,主流 MoE 按 token 分发(DeepSeek-V3、Qwen3、MoEUT)或在输出端混合(Soft-MoE、ReMoE),门控与深度无关,并不回答\u201c全深度共享下如何恢复逐层差异\u201d。
本文的目标是本文要回答的核心问题是:能否用单个 Transformer 块循环 $L$ 次,在推理 FLOPs 相当的条件下追平完整深度 ViT 的精度,且不依赖中间层特征蒸馏?具体目标有四:(1) 提出 reViT,用归一化深度坐标 $s_t = t/(L-1)$ 编程一个小型共享 FFN 专家库,在每个循环深度把 $E$ 个专家凸组合成一个稠密 FFN,恢复深度相关的变换;(2) 在同一循环骨干、同一任务损失、同一基础训练配方下公平比较七种 MoE 机制(DeepSeek-V3、Qwen3、MoEUT、ReMoE、Soft-MoE、Lory、SMEAR),找出与完全共享最兼容的专家组合方式;(3) 让一个训练好的 checkpoint 通过重采样深度坐标网格支持多个推理深度(弹性深度),并可折叠为固定深度稠密图部署;(4) 在有监督 ImageNet-1k 训练与仅用 DINOv2-B/14 教师最终层特征的蒸馏两种模式下验证该设计,并用线性探针检验分类、分割、深度估计的迁移能力。
与已有工作不同的是,已有工作的切入角度各有局限:Raptor 用 $k$ 个离散块模板并对齐教师中间特征,仍未解决全共享;Universal Transformer/ALBERT 纯绑定导致精度大跌;CondConv、SMEAR、Lory 虽也做权重空间合并,但门控来自输入图像特征,逐样本不同,无法预先计算,也无法在改变推理深度时重用;token 分发与输出混合 MoE 的门控同样与深度无关。reViT 的独特之处是把\u201c归一化循环深度\u201d这一标量作为唯一路由信号:门控 $g_t$ 只依赖 $s_t=t/(L-1)$,对所有 token 和图像共享,每深度只算一次;专家参数在执行前合并成单个稠密 FFN,只评估合并结果。由于 $s$ 是 $[0,1]$ 上的连续坐标,学到的\u201c深度程序\u201d是 FFN 参数空间中的一条连续轨迹,可在任意深度网格上重采样而无需重训练。这把\u201c存储的专家容量\u201d(E 个专家)与\u201c执行的深度\u201d(L 步)解耦,是循环 Transformer 与 MoE 两支文献此前都没有过的组合。
核心方法
直觉上,ViT 各层表示高度相似,深度差异可能集中在 FFN,让共享块在每个深度使用\u201c不同的 FFN 权重\u201d即可补回逐层特异性。技术上 reViT 是 pre-norm 循环模块:MHSA、两个 LayerNorm、路由器和 E 个专家 FFN 全部跨深度共享。对深度 $t$,先算归一化坐标 $s_t=t/(L-1)$;路由器 $\psi$(两层 MLP、16 隐藏单元、SiLU、输出零初始化)输出 $z_t=\psi(s_t)$,经 $\tau=1$ 的 softmax 得门控 $g_t$;再按 $g_t$ 对 E 个专家 FFN 的投影和偏置凸组合:$\bar{\theta}^{\mathrm{ffn}}_t=\sum_{e=1}^{E}g_{t,e}\,\theta^{\mathrm{ffn}}_e$,只执行合并后的单个 FFN。每个循环步为 $H_t=X_t+\mathrm{MHSA}(\mathrm{LN}_{attn}(X_t))$,$X_{t+1}=H_t+\mathrm{FFN}_t(\mathrm{LN}_{ffn}(H_t))$,最后 LayerNorm 接任务头。这些混合随深度在 FFN 参数空间描出一条连续轨迹,替代标准堆叠中独立学习的各层 FFN。
核心创新是\u201c深度编程的权重空间专家合并\u201d,与四类已有方法存在本质区别。(1) 与纯权重绑定的循环 Transformer(Universal Transformer、ALBERT、MiniViT)不同:FFN 权重随深度连续变化,仅把 E 从 1 提到 4 就能让 S/16 从 70.6% 升至 78.2%,补回大部分逐层计算。(2) 与 Raptor 的 $k=4$ 离散块模板不同:这里只有一个块,深度差异由连续坐标程序化生成,改变推理深度 $L$ 只是重采样坐标网格,无需重训练或设计适配器插值规则。(3) 与 token 分发(DeepSeek-V3、Qwen3、MoEUT)和输出混合 MoE(Soft-MoE、ReMoE)不同:门控与输入无关、所有 token 共享,因此每个深度的合并 FFN 可预先算好、折叠进固定稠密计算图,完全消除在线路由与合并。(4) 与静态超网络的每深度学习独立嵌入不同:连续坐标天然支持弹性深度。此外蒸馏只需教师最终层 post-LN 特征的 MSE,无需 Raptor 式的中间层对齐,监督信号显著简化。
方法步骤详情
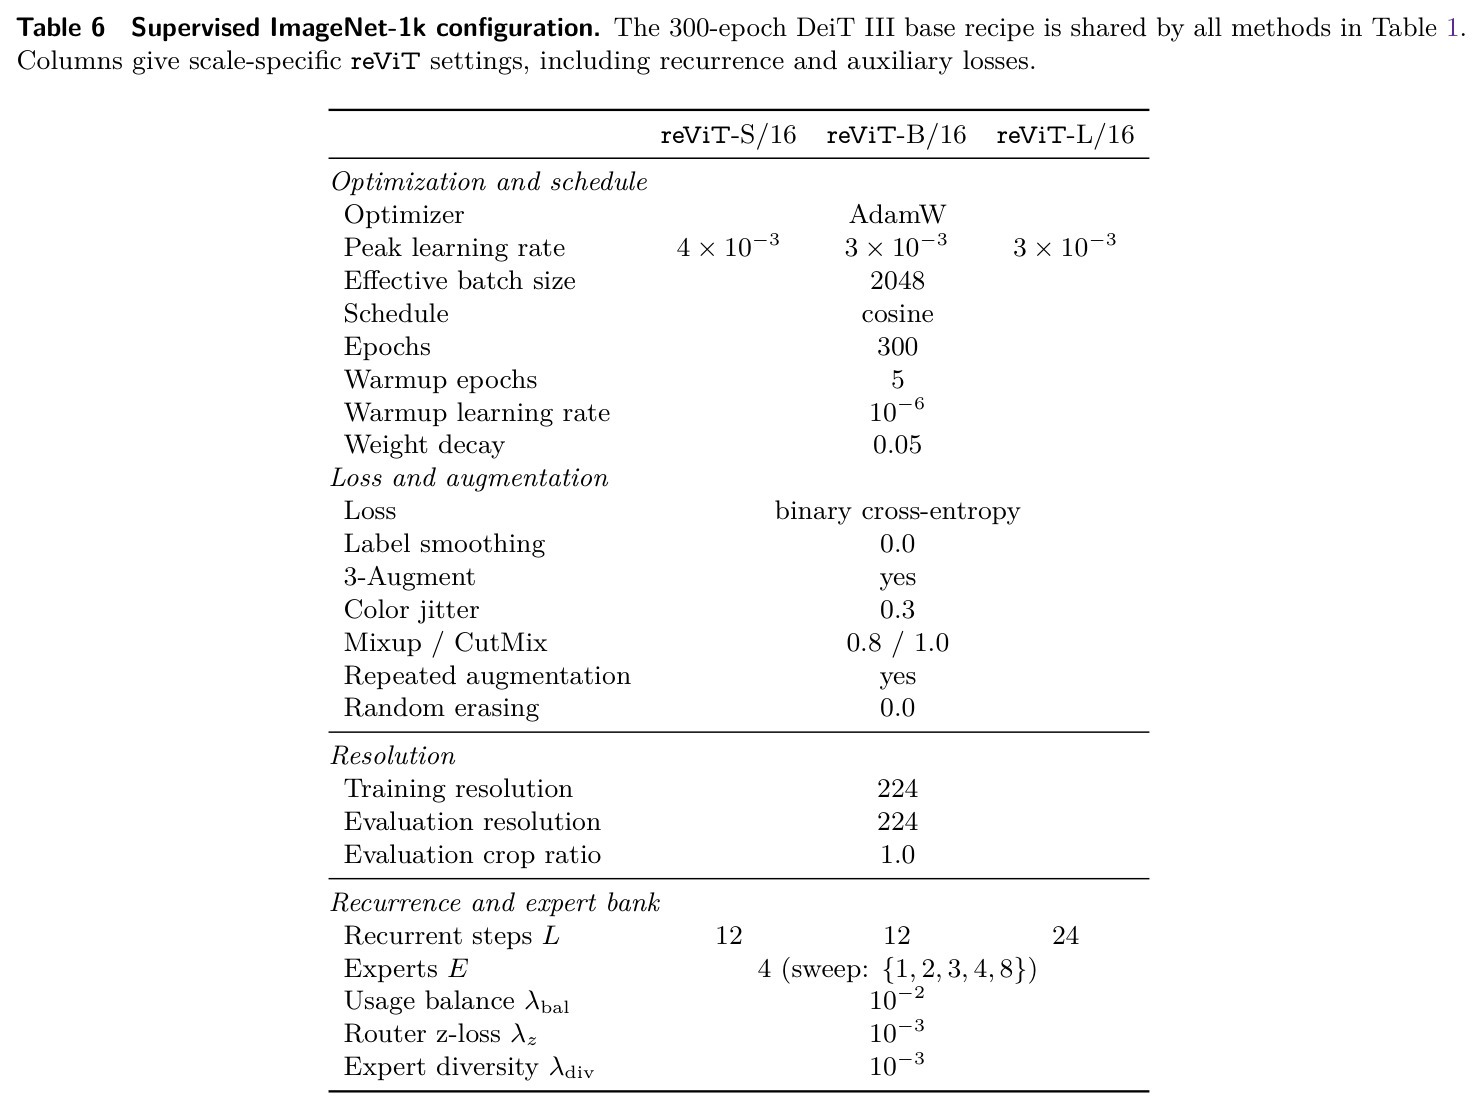
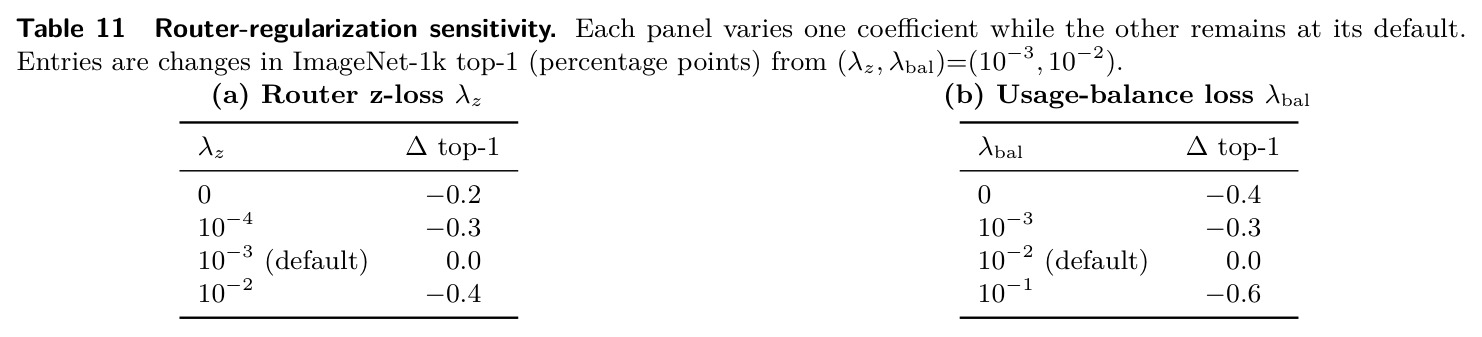
流程分五步。第一步,图像经 patch embedding、类别 token 与位置编码得 $X_0\in\mathbb{R}^{T\times d}$。第二步,每个深度 $t$:把 $s_t=t/(L-1)$ 送入两层 MLP 路由器(16 隐藏单元、SiLU、零初始化输出)得 $z_t$,softmax 得 $g_t$;把 E 个专家的 $(W_1^e,b_1^e,W_2^e,b_2^e)$ 按 $g_{t,e}$ 凸组合成稠密 FFN $\bar{\theta}^{\mathrm{ffn}}_t$,执行一次先 MHSA 后 FFN 的循环步,共 $L$ 步。第三步,训练目标:有监督沿用 DeiT III 300-epoch 配方(AdamW、batch 2048、峰值 lr $4\times10^{-3}/3\times10^{-3}$、权重衰减 0.05、二值交叉熵),深度取原生 ViT 深度(S/B 为 12,L 为 24);蒸馏最小化学生最终 post-LN 特征与冻结 DINOv2-B/14 教师特征的 MSE。第四步,E>1 时加三项辅助损失:使用均衡 $\mathcal{L}_{bal}=\frac{1}{L\log E}\sum_t(1-H(g_t))$、路由器 z-loss、专家多样性,系数 $10^{-2}/10^{-3}/10^{-3}$;E=1 时全部省略。第五步,弹性深度:训练时以 0.3 概率对每图整步 DropPath,保留步重编号并把坐标重铺 [0,1];推理时选定深度 L 重算网格,或把 L 个合并 FFN 物化成固定稠密图。
技术新颖性
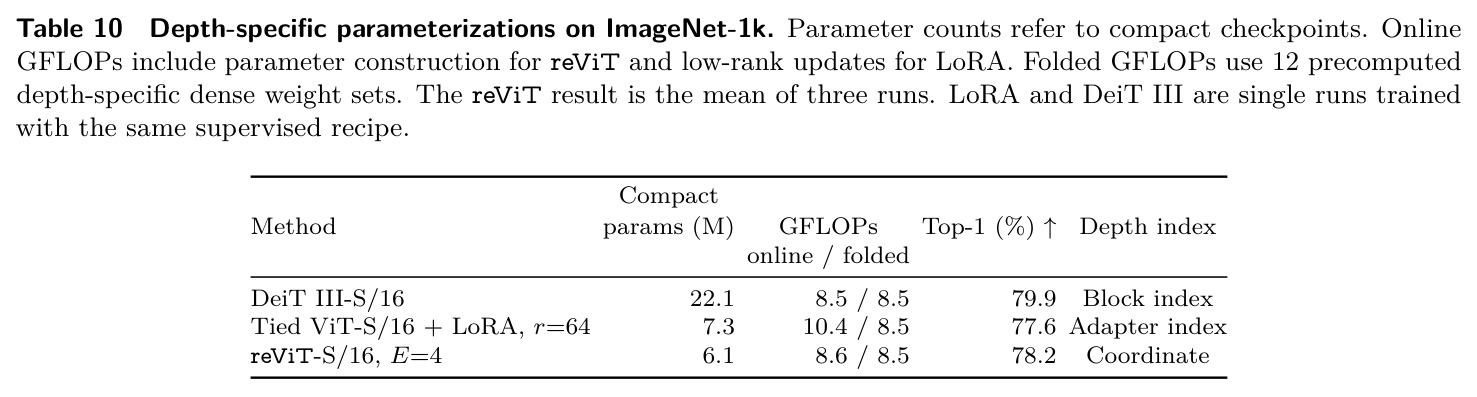
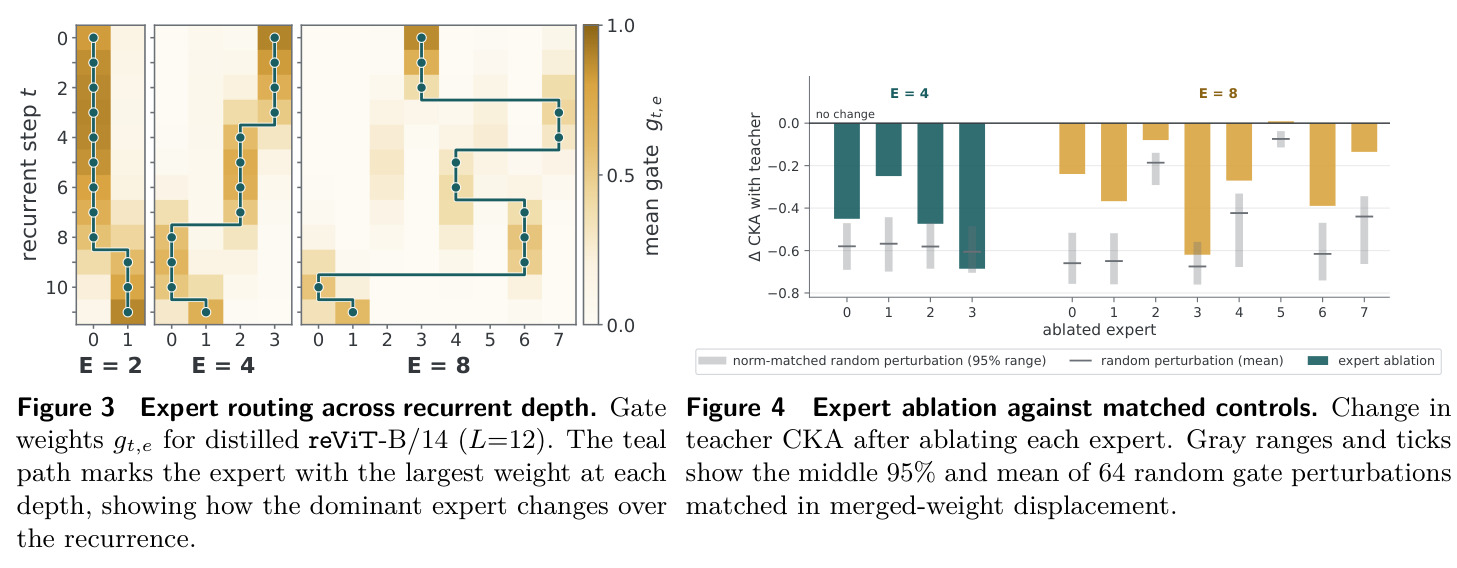
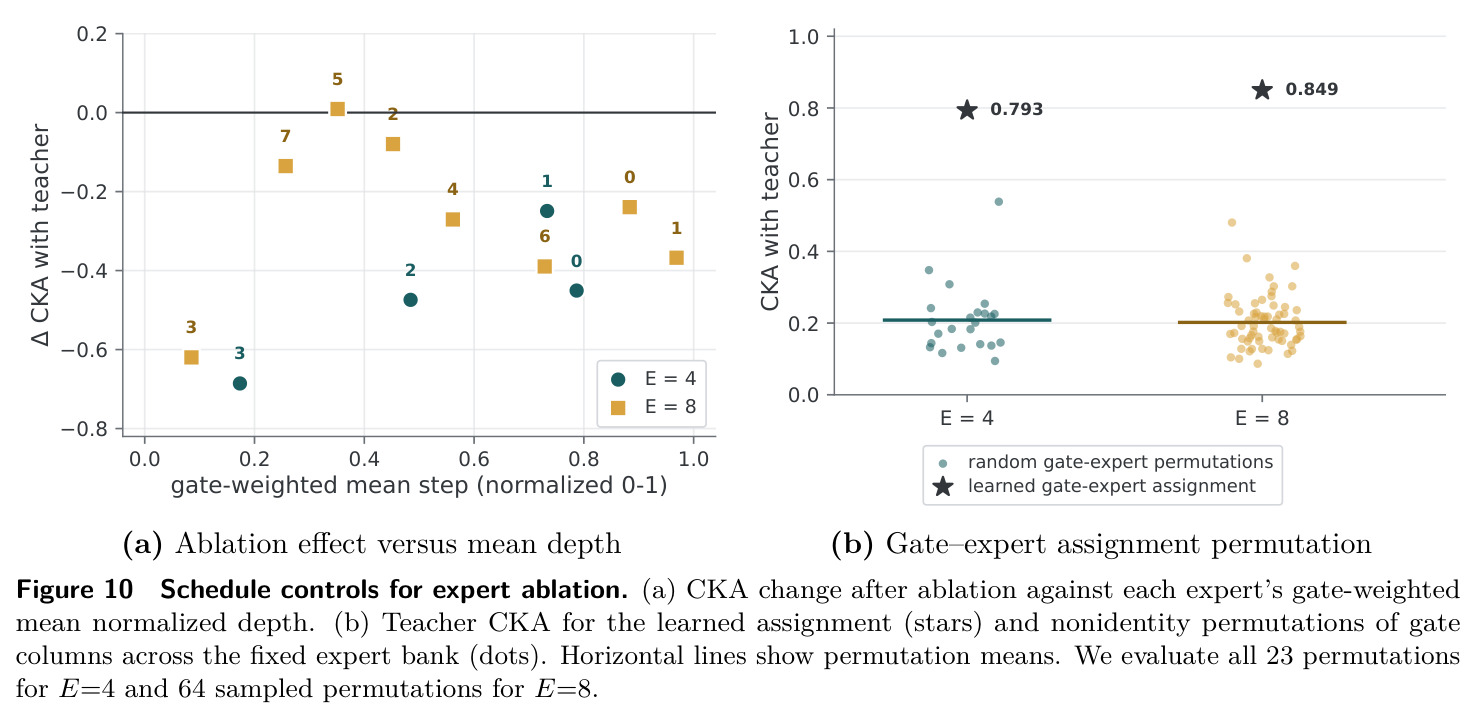
新颖性体现在四个层面。机制上:把权重合并式 MoE 的条件信号从图像特征(CondConv/SMEAR/Lory)换成归一化循环深度,路由器成为输入一维连续坐标的受约束超网络,深度程序成为从 $[0,1]$ 到 FFN 参数空间的可重采样连续映射。系统上:首次证明 $k=1$ 的完全深度复用在视觉中可行,补上 Raptor 明确留下的\u201c最后一步\u201d,且无需中间特征蒸馏、无需按深度存适配器(对比逐层 LoRA:6.1M 对 7.3M 参数且更准,78.2% 对 77.6%)。评测上:在同一循环骨干、同一任务损失与基础配方下受控改造并比较七种 MoE,用名义 FFN 计算比 $U$($U=1$ 即一个稠密 FFN 的算术量)统一预算口径,并逐一记录各基线适配细节(附录 B),弥补文献中缺失的对照实验。分析上:路由器在无显式监督下学出类似 Raptor 预设分段的分相位结构——主导专家只切换少数几次、占据连续深度区间(Fig. 3);且置换门控-专家配对使教师 CKA 从 0.793 跌至平均 0.208(E=4),说明学到的分配承载与教师对齐相关的语义。
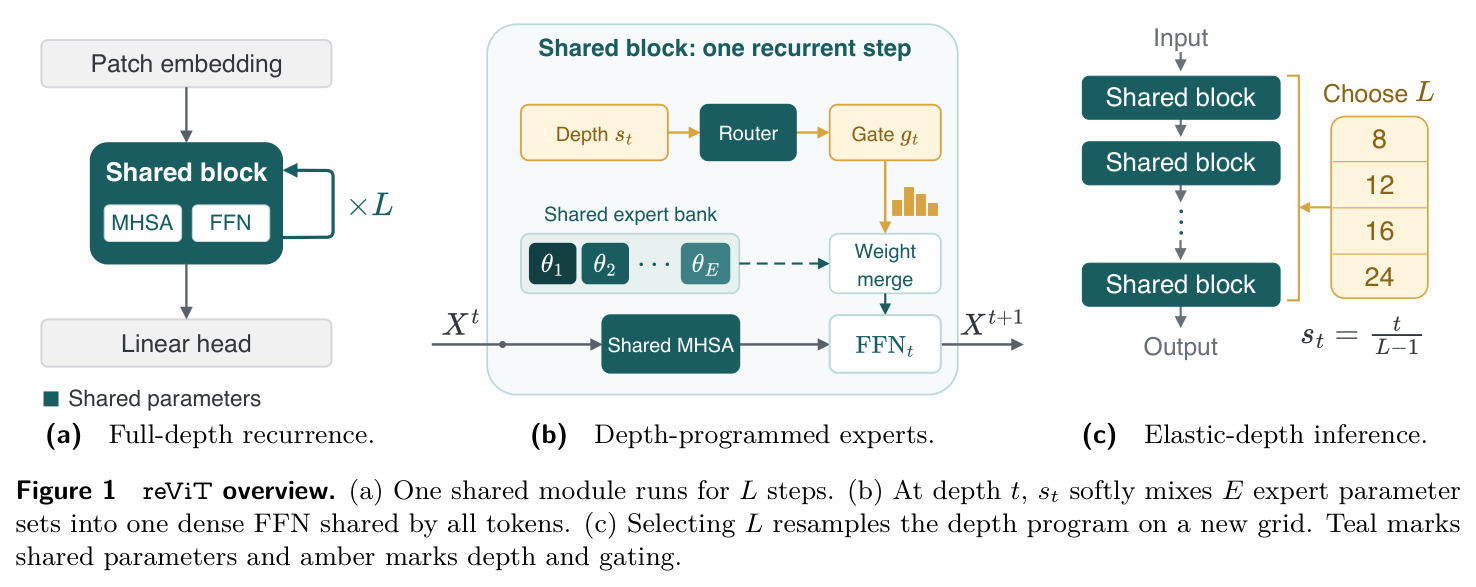
实验结果
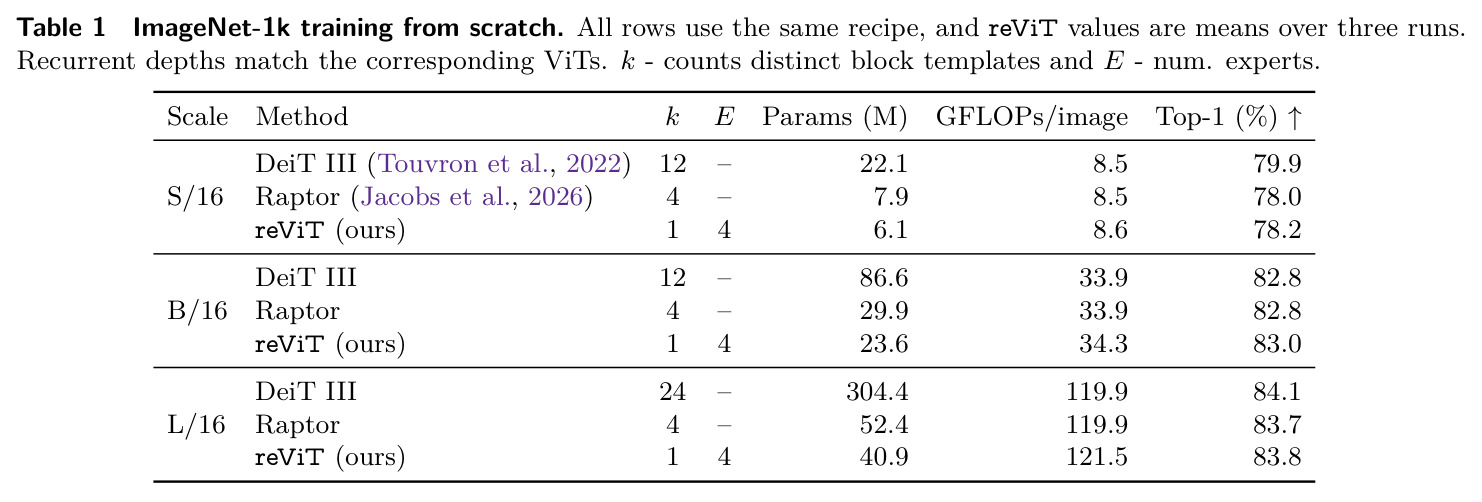
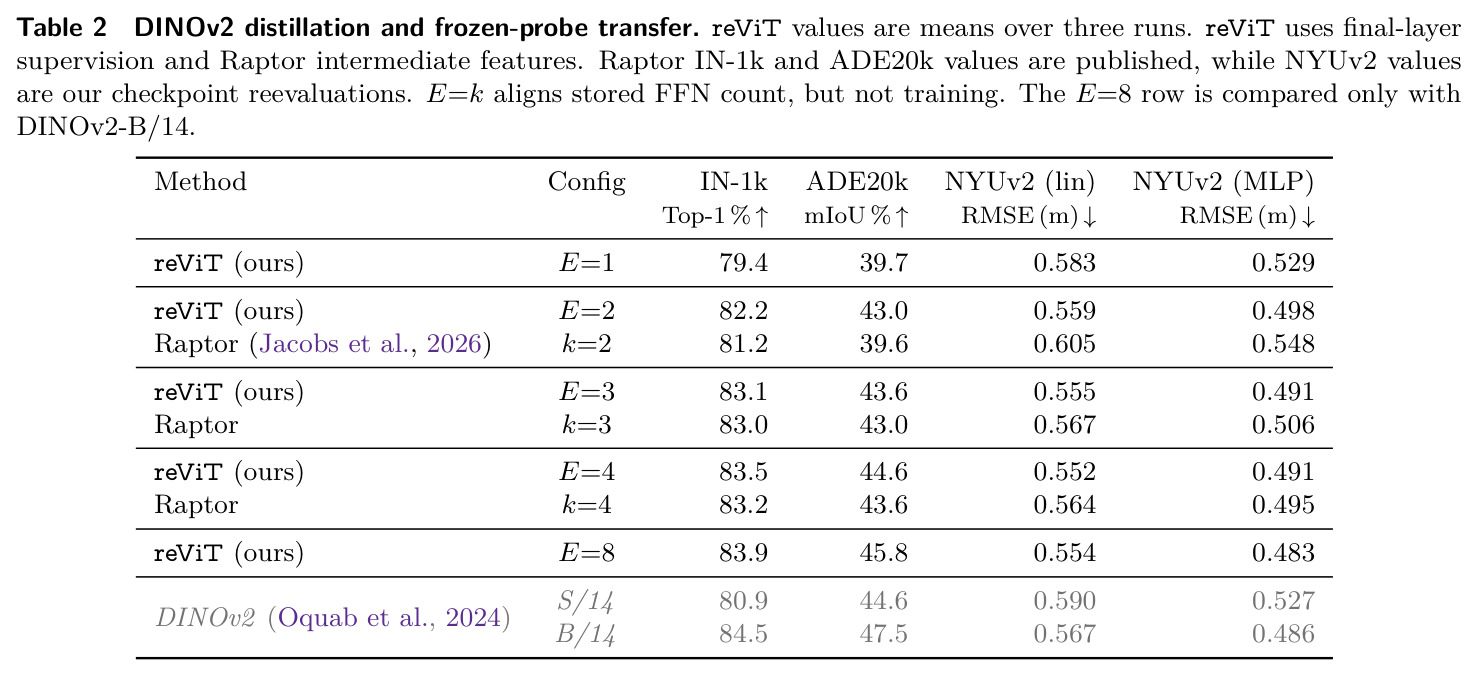
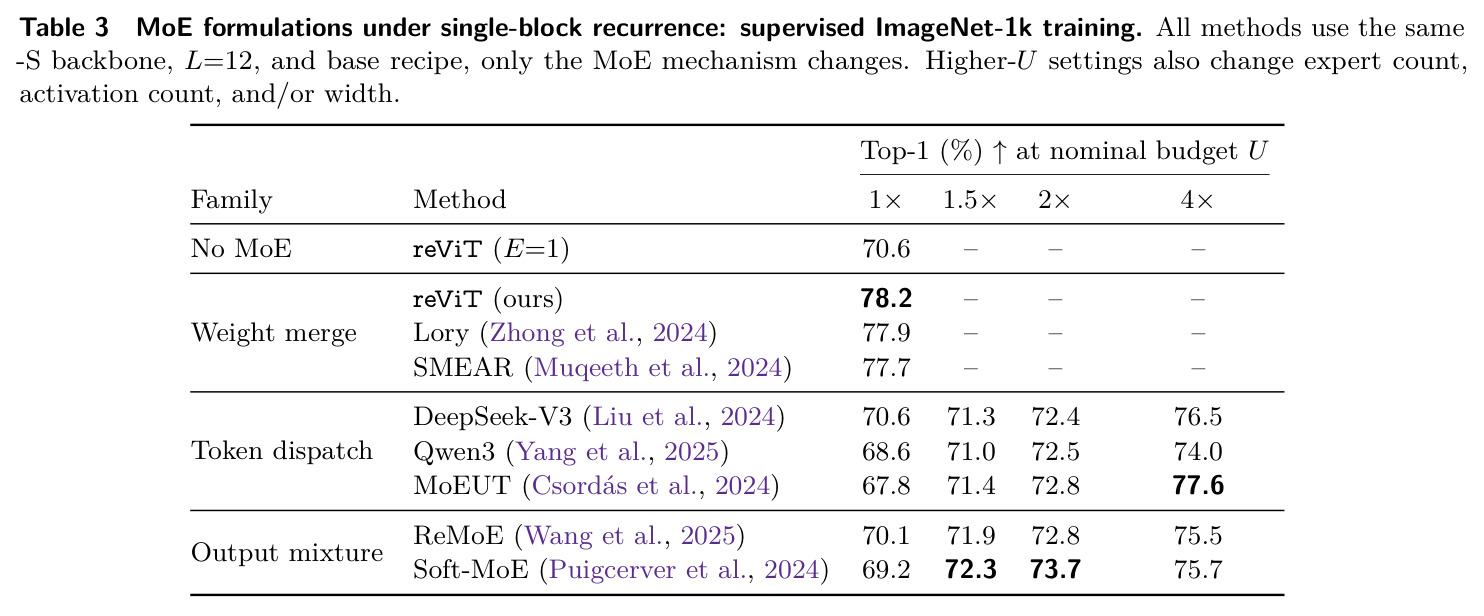
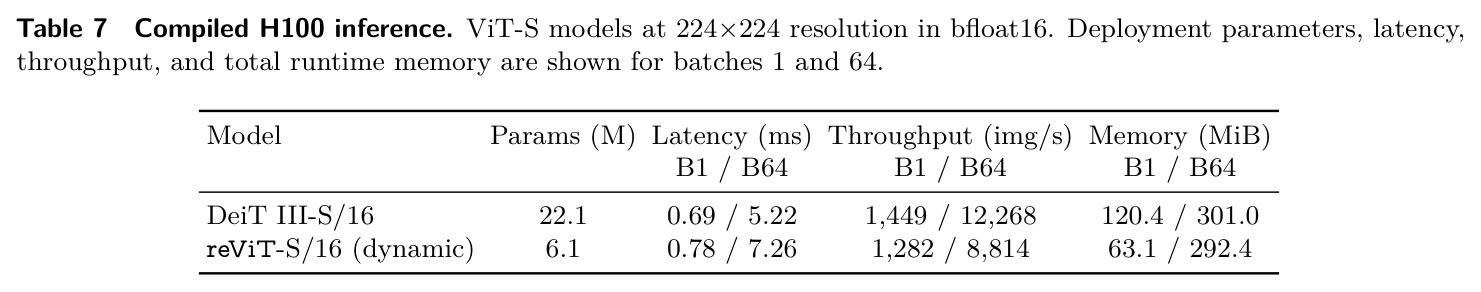
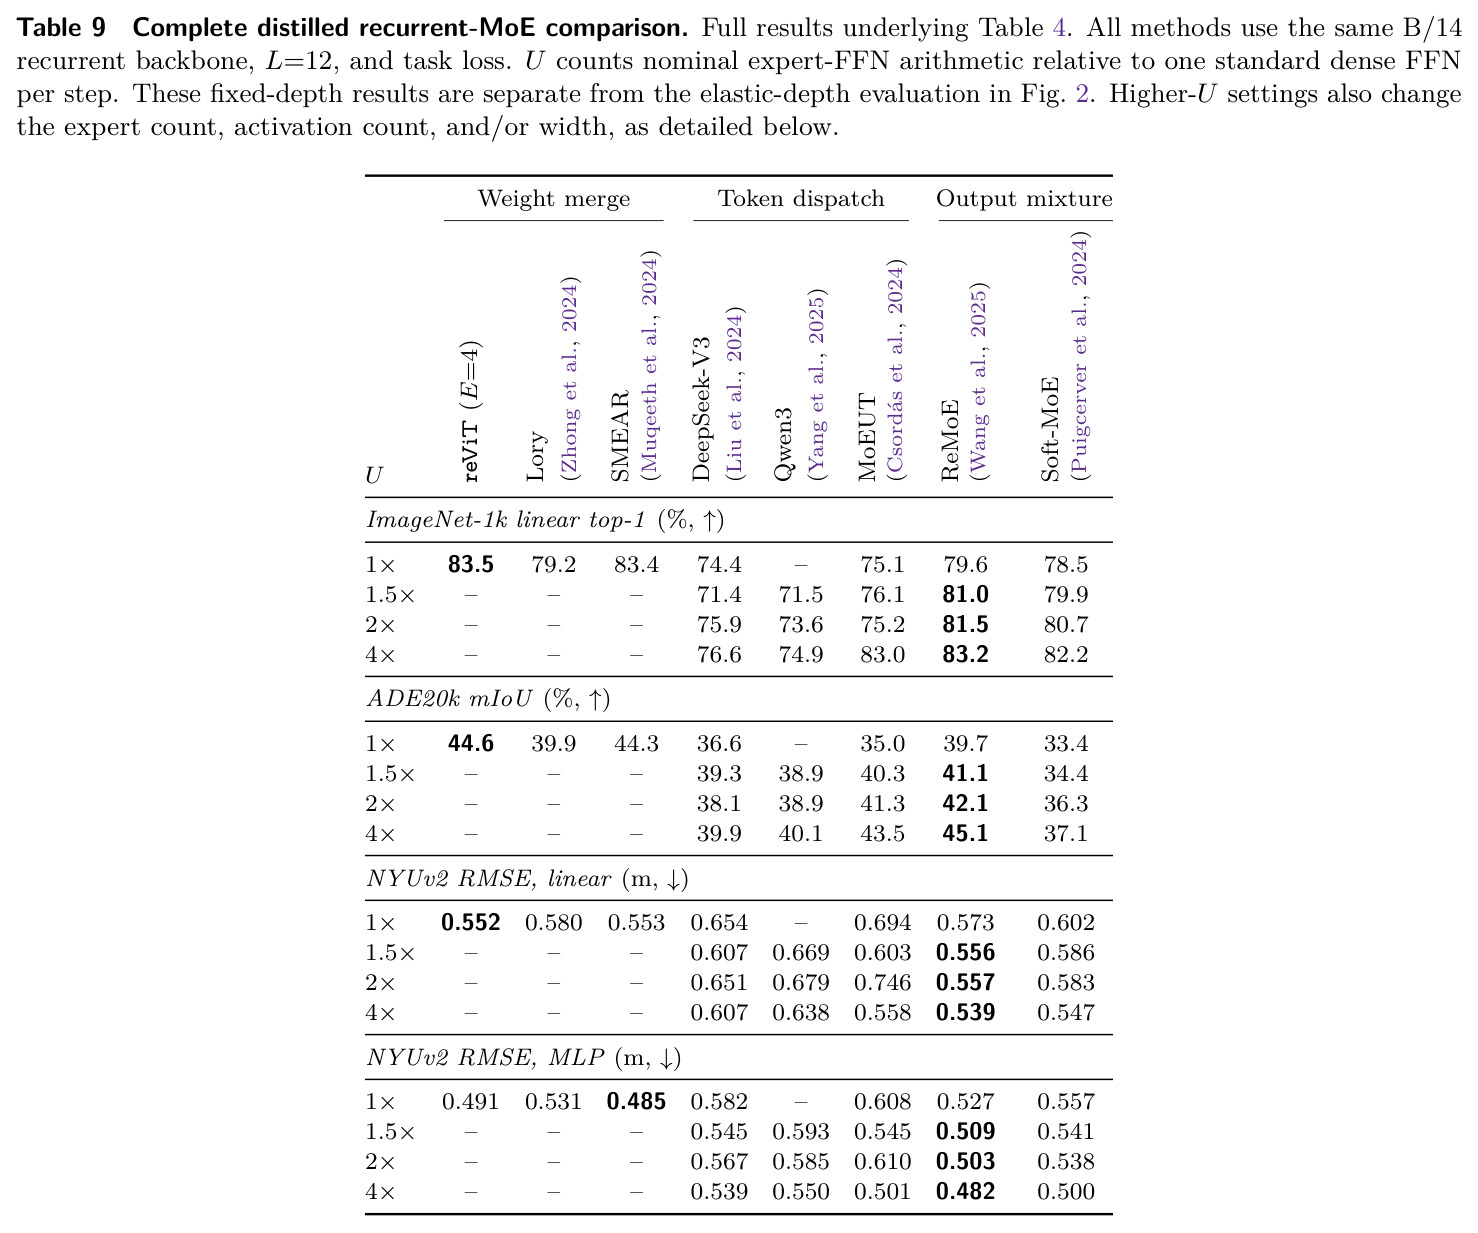
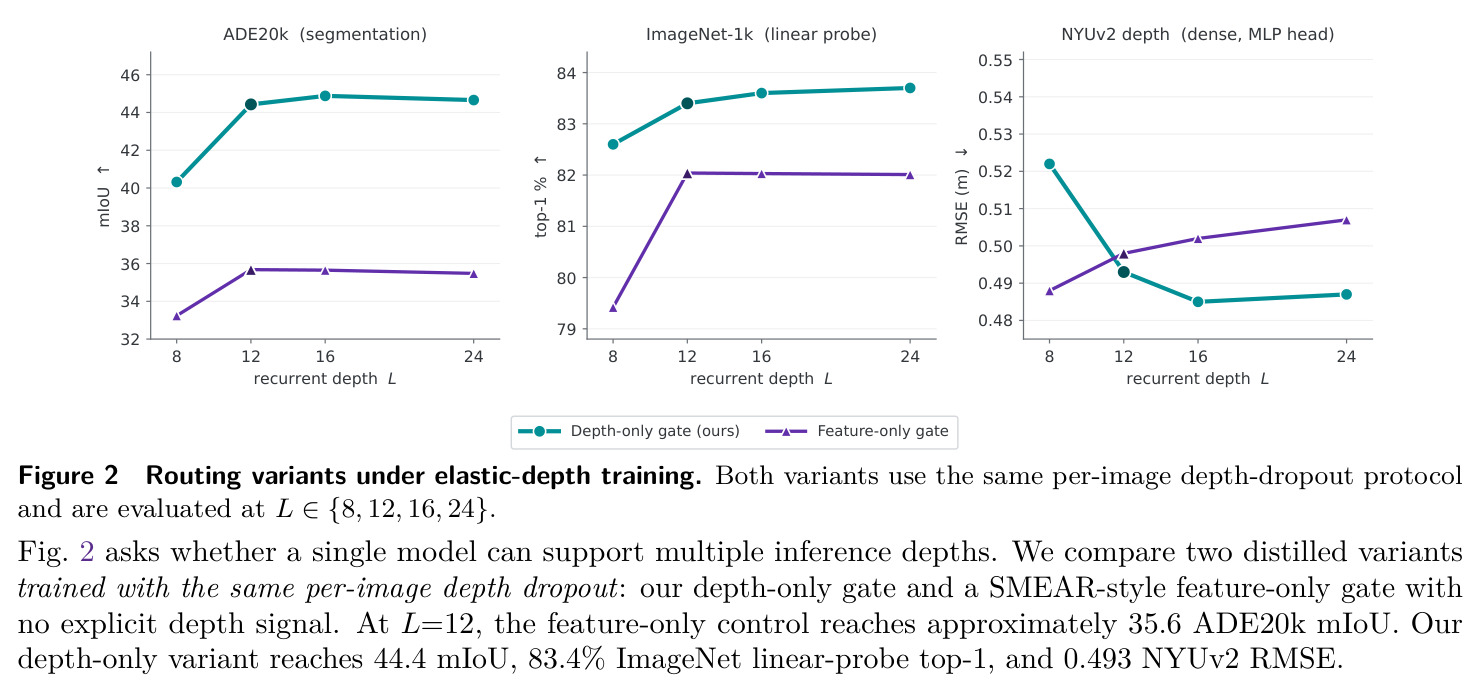
实验覆盖五个问题。(1) 有监督 ImageNet-1k(Table 1):reViT-B/16(E=4)达 83.0% 反超 DeiT III 的 82.8%,参数 23.6M 比其 86.6M 少约 73%;L/16 为 83.8% 对 84.1%(40.9M 对 304.4M,约 7 倍差距);S/16 为 78.2% 对 79.9% 仍差 1.7 点;三尺度均超 k=4 的 Raptor 0.1–0.2 点。(2) DINOv2 蒸馏(Table 2):仅用教师最终层特征,E=8 线性探针 83.9% 对教师 84.5%、ADE20k 45.8 对 47.5;E=k∈{2,3,4} 上四探针全面优于 Raptor(E=4: 83.5/44.6/0.552/0.491 对 k=4: 83.2/43.6/0.564/0.495)。(3) MoE 受控比较(Table 3/4):U=1 时权重合并领先——reViT 78.2%、Lory 77.9%、SMEAR 77.7%,其余方法全落 67.8–70.6%;U=4 时 MoEUT 监督下达 77.6%、ReMoE 蒸馏下 83.2% 领先。(4) 弹性深度(Fig. 2):深度门控在 L=16 达 ADE20k 44.9、ImageNet 83.7%、NYUv2 0.485,均优于 L=12 的 44.4/83.4/0.493;特征门控对照在 L>12 后持平甚至恶化。(5) 专家数量(Table 5):E 从 1 到 8,S/B/L 分别 +9.6/+6.8/+5.7 点,最大跳变在 E=1→2。部署上(Table 7)部署图小 3.6 倍、B1 内存省 48%,延迟 +13%(B64 达 39%)。有效秩分析显示 S/16 几乎用满 E=8 个方向(7.7/7.6/7.3),L/16 合并权重仅 4.0,解释大模型获益更少。
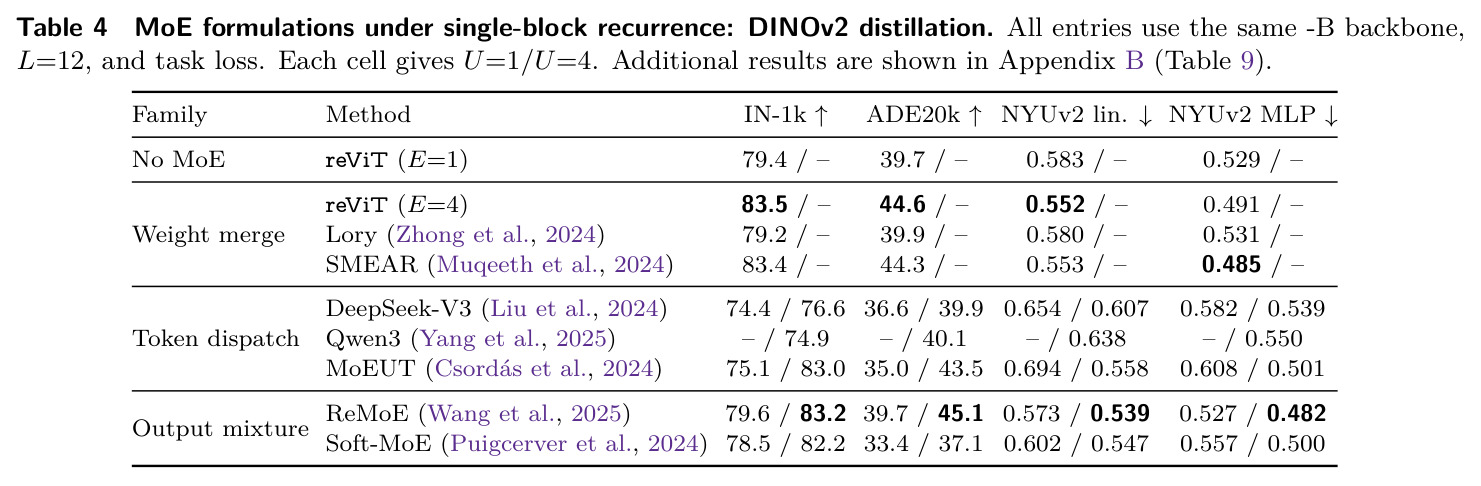
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet-1k 有监督训练(B/16) | Top-1 准确率 (%),参数量 (M) | reViT E=4: 83.0%,23.6M 参数,34.3 GFLOPs | DeiT III: 82.8%,86.6M;Raptor k=4: 82.8%,29.9M | 精度 +0.2 点,参数较 DeiT III 减少 73%;较 Raptor +0.2 点且参数更少 |
| ImageNet-1k 有监督训练(L/16) | Top-1 准确率 (%),参数量 (M) | reViT E=4: 83.8%,40.9M 参数 | DeiT III: 84.1%,304.4M;Raptor k=4: 83.7%,52.4M | 参数约为 DeiT III 的 1/7,精度仅 -0.3 点;较 Raptor +0.1 点且参数更少 |
| DINOv2-B/14 蒸馏 · ImageNet-1k 线性探针 | Top-1 (%) | reViT E=8: 83.9%(E=4: 83.5%) | 教师 DINOv2-B/14: 84.5%;Raptor k=4: 83.2% | 仅用最终层蒸馏即与教师差 0.6 点;较 Raptor +0.7 点 |
| DINOv2 蒸馏 · ADE20k 线性分割 | mIoU (%) | reViT E=8: 45.8 | 教师: 47.5;Raptor k=4: 43.6 | 较 Raptor +2.2 点,与教师差 1.7 点 |
| MoE 机制受控比较(U=1,监督 S/16) | Top-1 (%) | reViT 深度编程合并: 78.2% | Lory 77.9% / SMEAR 77.7% / MoEUT 67.8% / Soft-MoE 69.2% | 单 FFN 预算下为最强测试方法,超 token 分发与输出混合家族 7.6–10.4 点 |
| 弹性深度推理(蒸馏模型,L=16) | ADE20k mIoU (%) / ImageNet Top-1 (%) / NYUv2 RMSE (m) | 深度门控: 44.9 / 83.7 / 0.485 | 同模型 L=12: 44.4 / 83.4 / 0.493;特征门控对照在 L>12 近乎持平或变差 | 深度编程门控使增加循环步持续获益,对照则无法利用更深计算 |
| H100 编译推理(S/16,bfloat16,batch 1) | 延迟 (ms) / 部署参数 (M) / 运行内存 (MiB) | reViT-S 动态图: 0.78 / 6.1 / 63.1 | DeiT III-S/16: 0.69 / 22.1 / 120.4 | 部署图小 3.6 倍、内存 -48%,延迟 +13%(batch 64 时开销升至 39%) |
| 逐层 LoRA 参数化对比(S/16 监督) | Top-1 (%) / 紧凑参数 (M) | reViT E=4: 78.2% / 6.1M | Tied ViT + LoRA r=64: 77.6% / 7.3M | +0.6 点且参数更少;LoRA 每深度一组适配器,换深度需插值规则,reViT 直接重采样坐标 |
局限与改进
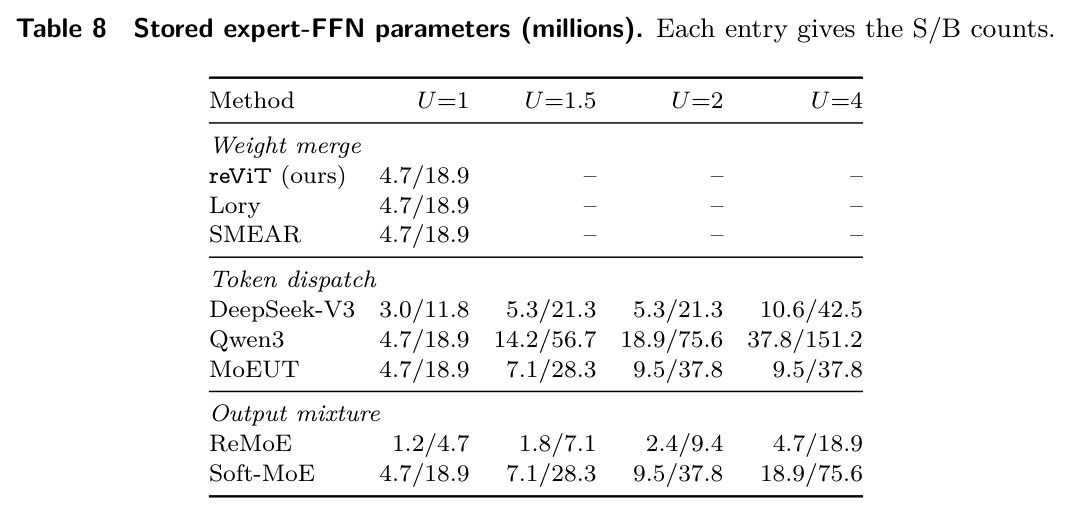
作者承认的局限:S/16 与 DeiT III 仍有 1.7 点差距(78.2 vs 79.9),小模型下完全共享代价更大;当前 PyTorch 直接实现需在线合并权重,batch 1 延迟增加 13%、batch 64 增加 39%,未用定制核或跨输入缓存;折叠成固定深度部署虽消除路由,但需存储 $L$ 个合并 FFN,部署存储从 E 个专家扩张为每深度一份;与 Raptor 的蒸馏比较并非严格受控实验(本文仅最终层监督、Raptor 用中间特征),作者自己也标注为\u201c参考性比较\u201d。我的补充观察:U>1 的高预算配置同时改变了专家数量、宽度与激活数,各方法只匹配名义 U 而不匹配参数量与延迟(Table 8),跨方法结论在 U=1 之外应谨慎解读;Qwen3 在 U=1 蒸馏下无法收敛到可用解,暗示某些稀疏路由机制在该设定下训练不稳定;专家消融实验中多数删除的伤害小于同幅度随机扰动,\u201c每个专家有独立角色\u201d的证据主要依赖置换实验间接支撑;所有结论基于 ViT-S/B/L 规模与 DINOv2-B 教师,未验证更大规模、语言任务或真实检测/生成下游。
独立分析的弱点
(1) 在线权重合并的开销随 batch 放大(batch 64 延迟 +39%),对吞吐敏感场景不友好——改进方向:按深度预计算并缓存合并 FFN、实现融合 CUDA 核、或默认折叠模式部署。(2) 只有 FFN 被深度编程,MHSA 完全共享;若深度差异也体现在注意力模式(浅层局部、深层全局),共享注意力可能限制上限——可对 QKV/输出投影做深度混合或分组共享。(3) 门控仅依赖深度、与输入无关,单张图无法自适应计算量;可结合逐图早退或自适应计算时间,按样本选择深度。(4) 弹性深度只评估到 L=24 且 dropout 固定 0.3,更深网格、更细采样或课程式深度训练的效果未知。(5) E=1 纯绑定掉点严重(S/16 仅 70.6%),框架对专家库敏感,冷启动稳定性值得研究,如专家 warmup 或随训练渐进增加 E。(6) 蒸馏只对齐最终层,可能丢失教师中间层的细粒度结构,可补充注意力图蒸馏或极轻量中间对齐,但需观察是否破坏\u201c无中间监督\u201d卖点。(7) U>1 的跨方法比较未匹配参数量与延迟(Table 8),后续可补参数对齐对照强化结论。
未来方向
作者明确提出的方向:把深度编程合并推广到语言模型的循环 Transformer(与 MoEUT、Mixture-of-Recursions 一脉衔接);分析章节揭示的\u201c大模型有效秩低、专家冗余\u201d(L/16 合并权重有效秩 4.0 vs S/16 的 7.3)提示可设计随尺度自适应的专家数或更强的多样性正则。基于成果可延伸的方向:(1) 输入感知的混合门控(深度+特征双条件),在保留可折叠性的同时引入样本自适应;(2) 弹性深度与逐 token 早退结合,实现按图动态深度与延迟预算控制;(3) 把连续深度程序用作模型编辑接口:沿坐标轴插值、按门控质量剪枝低贡献深度区间、或渐进式训练后再压缩;(4) 部署侧研究折叠图的跨深度压缩,例如对合并 FFN 的差值做低秩分解,缓解\u201c存储从 E 个专家膨胀到 L 份 FFN\u201d的问题;(5) 在 LLM 参数高效微调场景以深度编程专家替代逐层 LoRA(Table 10 已显示参数与精度双重优势);(6) 用更大教师(如 DINOv2-G/H)检验仅最终层蒸馏的上限是否依然成立。
复现评估
复现门槛中等偏高但文档完善。附录给出全部关键细节:DeiT III 300-epoch 配方(AdamW、有效 batch 2048、峰值 lr $4\times10^{-3}/3\times10^{-3}$、权重衰减 0.05、3-Augment、Mixup/CutMix 0.8/1.0)、辅助损失系数 $10^{-2}/10^{-3}/10^{-3}$、路由器结构(两层 MLP、16 隐藏单元、SiLU、零初始化、$\tau=1$)、弹性深度 dropout 0.3,以及 7 个 MoE 基线的逐项适配(附录 B)。算力:每个模型需 8×H100 训练 1–2 天(约 192–384 GPU 小时),Table 1/2 结果为三次独立训练均值;蒸馏需冻结 DINOv2-B/14 公开教师;探针遵循 Raptor 协议(ImageNet 线性分类、ADE20k 线性分割头、NYUv2 线性/MLP 深度头),数据集全部公开。论文文本未给出开源代码链接,若无官方实现需自行实现模型与 MoE 基线改造,全量复现约需数千 GPU 小时;低成本路径是先复现 S/16 缩短配方与 E∈{1,2,4} 消融(Table 5 趋势清晰)。
论文图表
将每个专家的门控权重逐深度置零并重归一化后,测量学生-教师最终特征 CKA 的变化,并与 64 个在合并权重位移上匹配的随机门控扰动对照。多数专家删除造成的 CKA 下降小于同幅度随机扰动;E=8 时删除专家 5 甚至使 CKA +0.009 无不利影响;最大损失出现在最早使用的专家上。
提供了严谨的因果检验设计(匹配位移的随机对照),说明单个专家的\u201c独立性\u201d有限、消融代价主要由其在调度中的位置决定,防止对专家可解释性的过度解读,是理解第 5.1 节结论的关键。