Pumpire:度量距离估计统一基准 Pumpire: Unified Benchmark for Metric Distance Estimation
首个以卷尺实测距离直接评测3D基础模型点对距离估计能力的统一基准,覆盖四类设置
前置知识
相机内参矩阵与反投影
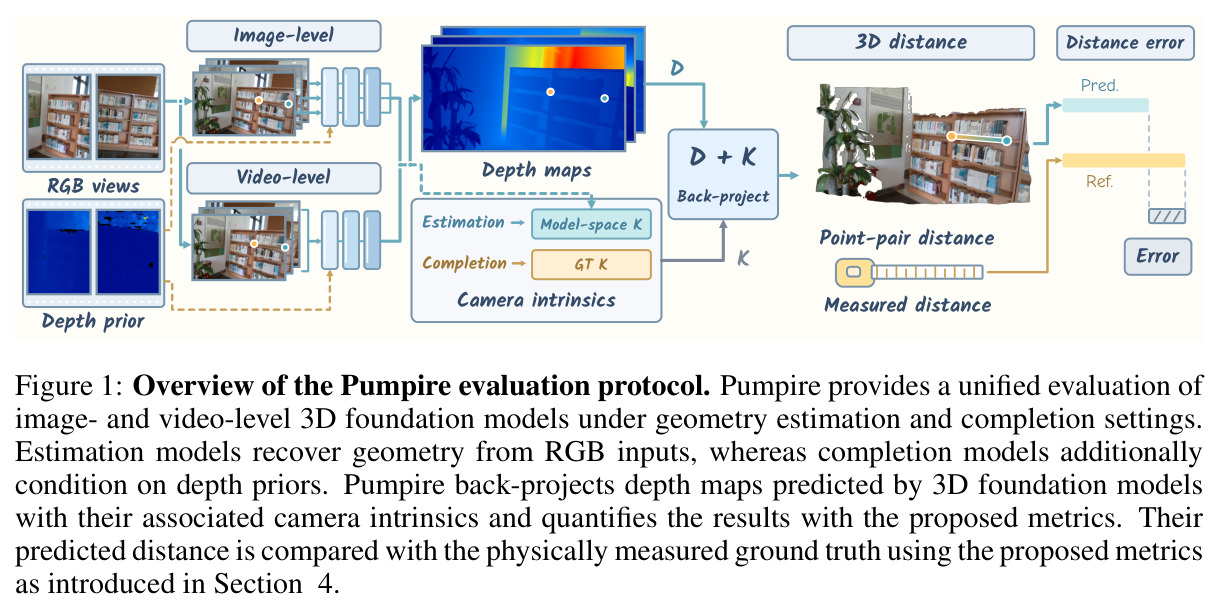
内参矩阵 $K$ 描述相机把三维点投影到像素平面的固有参数(焦距 $f_x, f_y$ 与主点 $c_x, c_y$)。反投影是其逆过程:已知深度图 $D$ 中像素 $(u,v)$ 处的深度,可通过 $P = D(u,v)K^{-1}[u,v,1]^\top$ 恢复该点在相机坐标系下的三维坐标。Pumpire 正是用该公式把两个标注像素反投影成 3D 点再算欧氏距离。
本文的核心评测公式(式 1)就是反投影,且关键发现之一——深度与内参的耦合性——直接建立在对该几何过程的理解上,不懂反投影就无法理解整个评测协议。
度量深度与相对深度
相对深度只预测场景中点的深浅排序或任意尺度的深度值,而度量深度预测以米为单位的真实物理深度。Metric3D、Unidepth、MoGe-2、Depth Pro 等显式建模相机几何以恢复米制尺度;Depth Anything v2 这类相对深度模型泛化好但无绝对尺度。本文只评测能输出绝对尺度的度量 3D 模型。
只有度量模型才能与卷尺实测的距离真值直接比较,这是入选 29 个基线配置的前提,也解释了为何部分知名相对深度模型未被纳入评测。
深度补全(Depth Completion)
深度补全指在稀疏或含噪的传感器深度测量(先验)条件下,结合 RGB 图像推断完整密集深度图的任务,与纯 RGB 的几何估计相对。补全模型把传感器测量当作度量约束输入,如 Lingbot-Depth、PriorDA、Omni-dc、PromptDA 等;CAPA 则把补全表述为参数高效的测试时适配,把冻结的基础模型适配到深度观测上。
补全与估计是 Pumpire 统一评测的两大范式,论文核心发现 3——两类模型鲁棒性模式截然不同(补全精度高但会灾难性退化)——正是围绕这一区分展开。
3D 基础模型与点图
指在海量数据上预训练、可零样本重建场景几何的大模型。DUSt3R 开创了从图像对直接回归点图的范式,VGGT、MASt3R、MUSt3R、CUT3R、Depth Anything 3、MapAnything、pi3x 等把它扩展到多视角,一次前向输出所有视角的相机姿态、深度与 3D 点。点图即每个像素对应的 3D 坐标,取 z 分量即可得到深度。
这些模型正是被评测的对象;理解从点图取 z 坐标得到深度、再配合内参反投影的流程,是看懂实验设置的必要前提。
阈值精度 δτ 与 RSD
$\delta_\tau$ 是深度估计常用指标:预测与真值之比 $r$ 满足 $\max(r, 1/r) < \tau$ 的样本占比,本文取 $\tau \in \{1.05, 1.10, 1.25\}$,$\delta_{1.05}$ 即预测偏差在 5% 以内的命中率。RSD(相对标准差)衡量同一场景内预测距离的跨视角变异系数,越小越一致。
论文几乎所有结论都围绕 $\delta_{1.05}$ 和 RSD 展开(如传感器 79.32% 对 CAPA-VGGT 91.44%),RSD 还被双重用于场景难度划分与模型一致性评价,不理解这两个指标就读不懂各表格。
研究动机
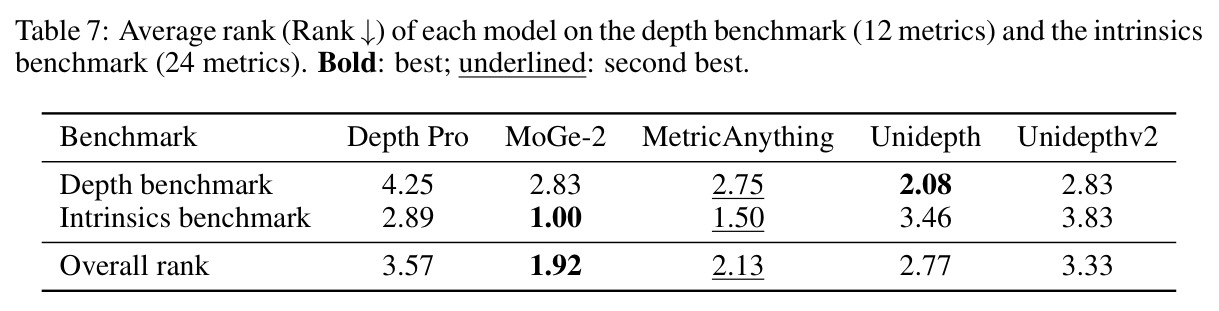
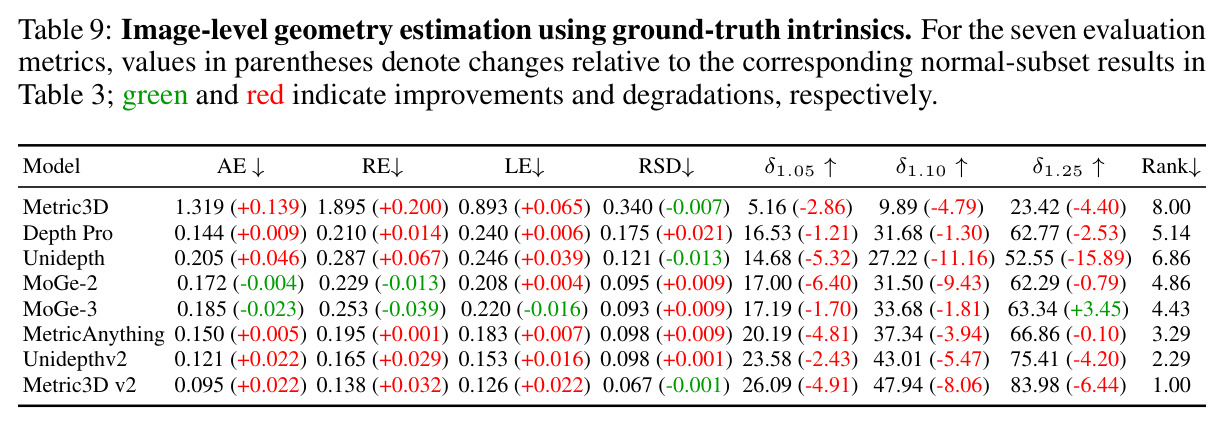
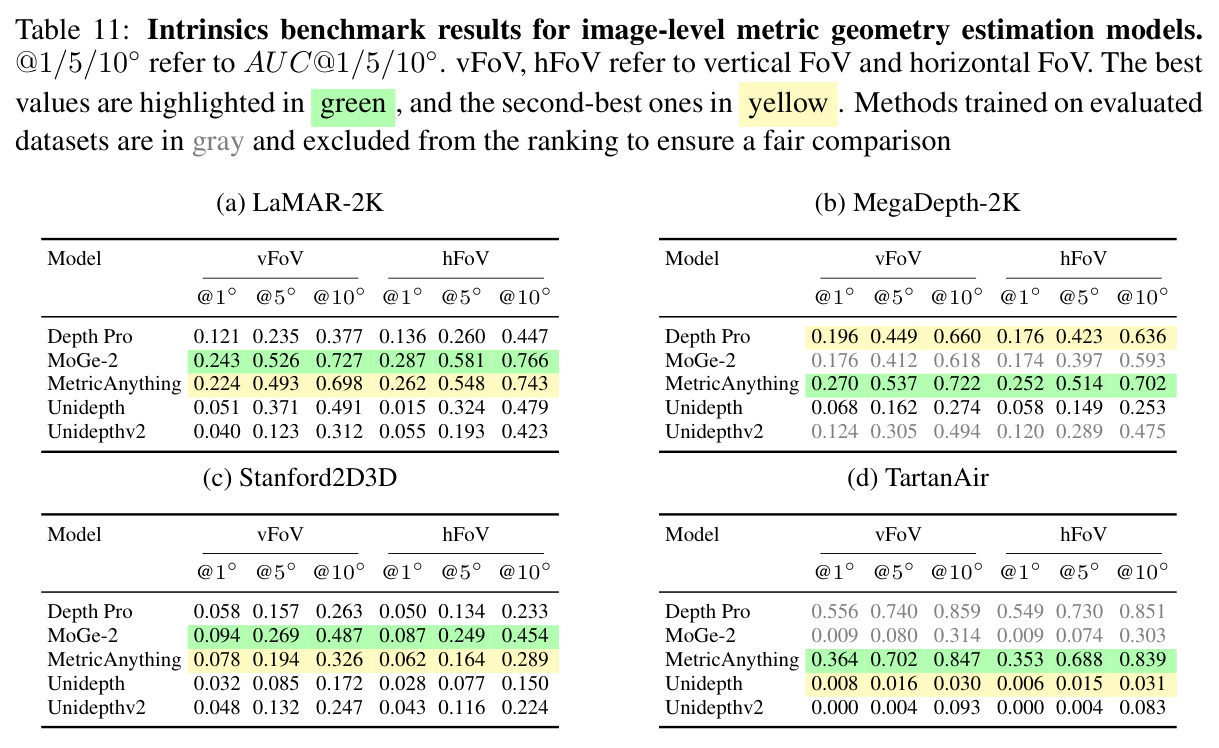
现有评测体系无法回答一个根本问题:模型能否准确估计两点之间的物理距离?第一,深度基准(NYUDv2、KITTI、ETH3D、DIODE)与相机内参基准(LaMAR、MegaDepth、Stanford2D3D、TartanAir)历来分开评测,而点对距离同时依赖两者:论文实验显示 MoGe-2 在深度加内参的综合排名最好(平均名次 1.92),但在 Pumpire 距离基准上却输给综合排名仅 3.33 的 Unidepthv2;更惊人的是,把 8 个图像级模型的预测内参换成真值内参后,56 个模型-指标对中有 47 个反而退化。第二,点云基准用 Chamfer Distance、F-Score 等几何相似度指标,空间推理基准(SpatialVLM、SpatialRGPT 等)只做物体级问答,都不直接评测点级距离。第三,图像级/视频级乘以估计/补全共四种设置的评测彼此割裂,无法统一比较。此外,用传感器深度当真值本身不可靠:在透明、反光表面和细长结构、锐利边缘处误差巨大,合成数据的完美深度又有域差距。
本文的目标是论文要构建第一个直接评测点对度量距离估计能力的统一基准。具体目标有三:其一,采集真值可信的数据集 pumpire-6k——100 个真实场景(40 室内加 60 室外)、每场景 64 帧、共 6,400 帧 1280×720 图像,每个场景用卷尺人工实测两个贴纸中心之间的物理距离作为真值,从源头避开传感器深度误差;其二,建立统一评测协议,把图像级估计、图像级补全、视频级估计、视频级补全四类设置放进同一套反投影加距离误差指标的框架,使 29 个基线配置可直接横向对比,并新增跨视角一致性指标 RSD 与基于传感器可靠性的场景难度划分(76 正常加 24 挑战);其三,通过大规模实验产出可指导落地的经验结论:传感器与模型谁更可靠、估计与补全两类模型的鲁棒性差异、深度先验的稀疏度与视角覆盖如何影响精度等。
与已有工作不同的是,本文的独特之处在于把评测对象从中间量换成最终物理量。以往工作分别评测深度图误差或内参误差,再隐含假设两者都好则几何就好;论文用真值内参替换实验证明该假设不成立——预测深度与预测内参是耦合的,必须端到端地直接评测距离,这为全新基准提供了不可替代的存在理由。第二个独特角度是真值来源:完全不信任任何传感器,直接用卷尺测量贴纸中心距离,并用传感器距离的跨视角变异系数 RSD(阈值 0.1)筛出 24 个传感器不可靠的挑战场景,既保留了含透明、反光、细结构等困难表面的场景,又保证真值无误。第三,它不把补全与估计、图像与视频视为不同任务分而治之,而是统一到任意 3D 基础模型输出几何、反投影、与实测距离比较的单一路径上,首次实现跨设置公平比较。
核心方法
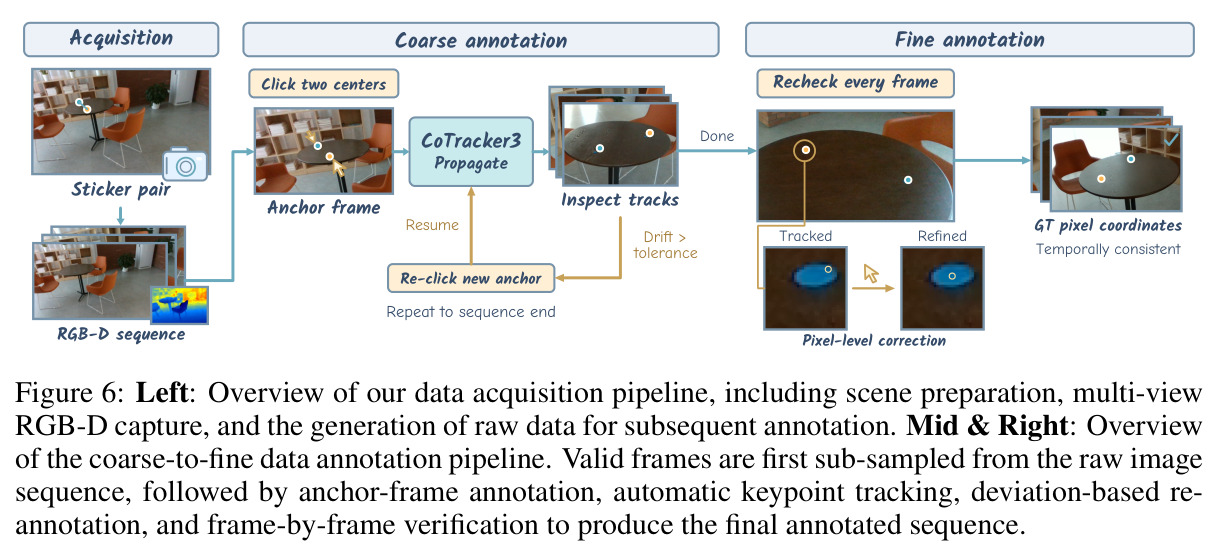
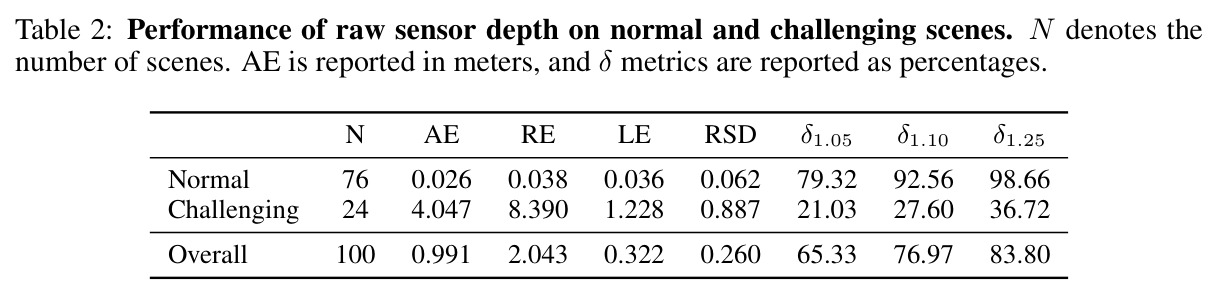
直觉上,机器人抓取的成功率、自动驾驶的碰撞率取决于两个点在物理世界相距多少米,而不是每像素深度误差,所以评测应该直接测距离。技术路线分三步。第一步建数据:在真实场景贴一对半径 10mm 的圆形贴纸,沿随机化轨迹采集 200 至 300 帧 1280×720 的 RGB-D 序列并均匀采样 64 帧,用卷尺实测贴纸中心距离作真值,用 CoTracker3 辅助的粗到细流水线标注每帧贴纸像素坐标,共得 100 个场景、6,400 帧。第二步定协议:把模型预测的深度(或点图 z 坐标)按式 $P_i = D(u_i,v_i)K^{-1}[u_i,v_i,1]^\top$ 反投影到相机坐标系,计算 $d_{pred}=\|P_0-P_1\|_2$,与实测 $d_{gt}$ 比较得到 AE、RE、LE、$\delta_\tau$ 四个指标,另用 RSD 衡量同一场景内预测距离的跨视角一致性;以传感器深度自身 RSD 大于 0.1 为阈值划分 76 个正常场景与 24 个挑战场景。第三步跑评测:29 个基线配置统一推理、统一算分,再做七组深入分析实验。
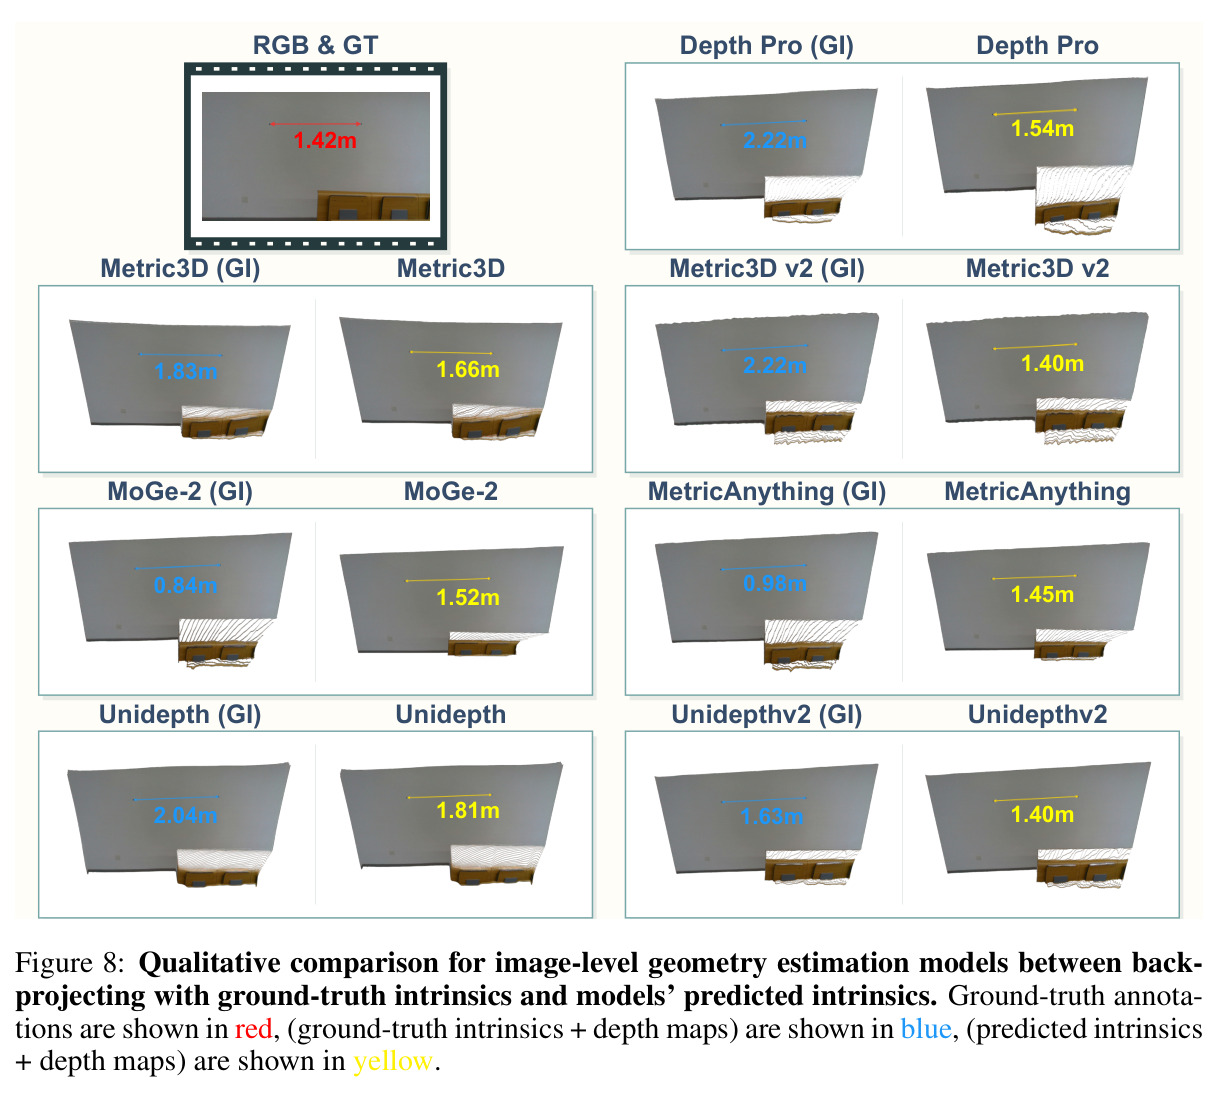
核心创新有三层。第一,直接评测距离本身:论文证明深度与内参存在耦合——把 8 个图像级估计模型的预测内参换成真值后,56 个模型-指标对中 47 个退化(如 Unidepth 的 $\delta_{1.05}$ 从 20.00% 掉到 14.68%),说明深度图离开配套内参就失效,分项评测无法预测距离能力。第二,真值获取方式:现有真实数据集的深度标注在光学敏感(透明、反光)、结构脆弱(细长结构、锐边)表面会出错,合成数据有域差距;卷尺实测加贴纸像素级标注把真值误差与模型误差彻底解耦,这是任何传感器标注数据集做不到的。第三,统一性:用同一套指标贯穿图像、视频与估计、补全四种设置,并让 RSD 一箭双雕——既作为传感器可靠性的代理来划分场景难度,又作为模型跨视角一致性的度量来评价模型。
方法步骤详情
完整流程如下。(1)采集:布置场景并贴一对 10mm 半径贴纸,用 RGB-D 相机沿随机化轨迹(双向远近切换、朝向变化、贴纸随机入画位置)拍摄 200 至 300 帧,均匀采样 64 帧,保留 1280×720 RGB、对齐深度图与内参。(2)像素标注:粗阶段人工在锚点帧点击两个贴纸中心作为 CoTracker3 的查询点并自动传播,轨迹漂移超容忍度就重设锚点;细阶段逐帧人工复核做像素级修正。(3)真值:卷尺测量两贴纸中心距离得 $d_{gt}$,同一场景 64 帧共享。(4)难度划分:用传感器深度反投影出的距离算跨视角变异系数,阈值 0.1 分出 24 个挑战场景(传感器 AE 4.047m)与 76 个正常场景(AE 0.026m)。(5)模型推理:估计模型用预测内参(Metric3D 系用 canonical 内参)反投影,补全模型用真值内参;视频级每场景以固定随机种子采 32 组、每组 10 帧。(6)算分:逐帧算误差与比率,聚合成 AE、RE、LE、$\delta_\tau$ 四个指标再对场景平均,RSD 评一致性。(7)再做耦合必要性、传感器对比、鲁棒性、稀疏先验、先验比例、跨设置、采样步长七组分析。
技术新颖性
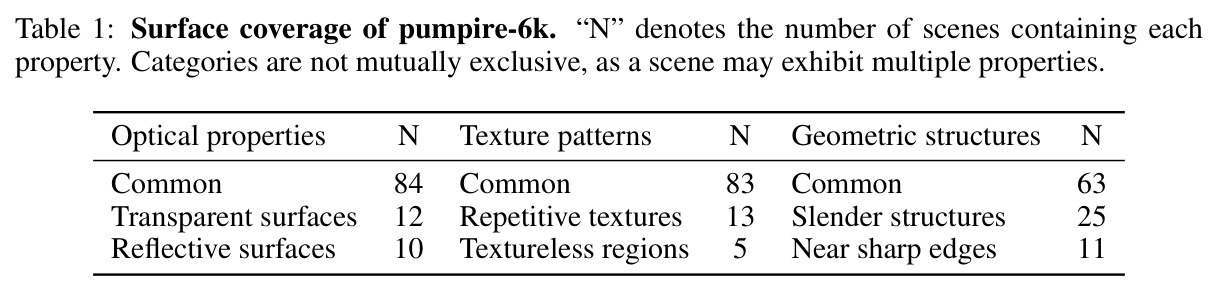
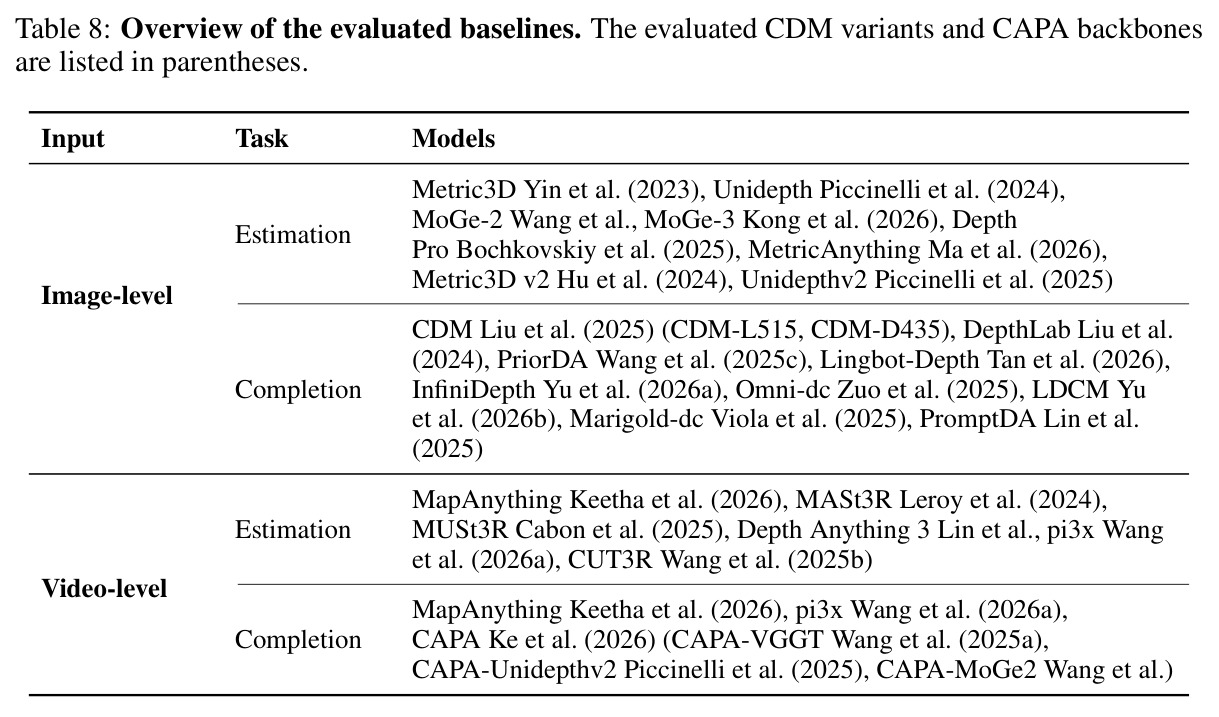
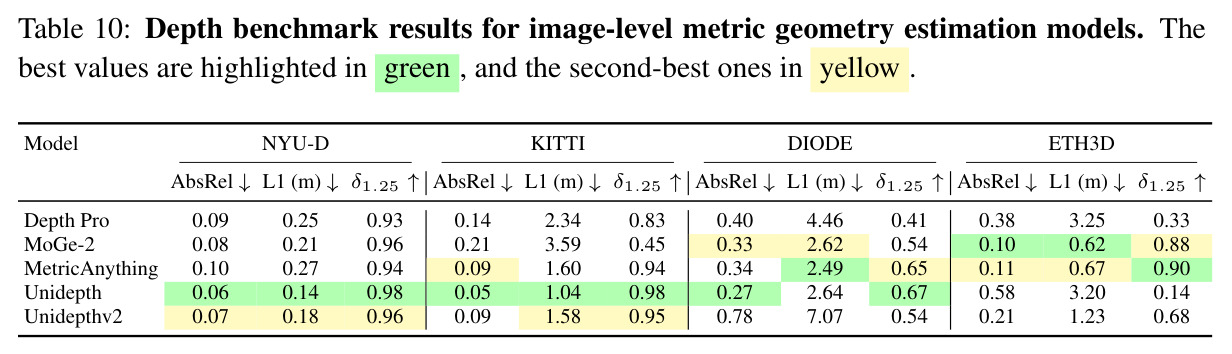
从技术新颖性看:数据层面,pumpire-6k 是首个以人工实测点对距离为真值的大规模序列基准(100 场景、6,400 帧),表面覆盖统计显示含 12 个透明、10 个反光、25 个细长结构、11 个锐利边缘场景,这是传感器标注数据集无法安全覆盖的;标注流水线用 CoTracker3 传播加漂移重锚加逐帧校验,在保证像素级精度的同时把人工成本压到可行范围。协议层面,反投影式距离评测公式本身并不新,但把它作为统一评测的主指标、并用真值内参替换实验量化深度-内参耦合(47/56 退化)是新的实证贡献;RSD 的双重使用(传感器可靠性代理加模型一致性度量)也是巧妙设计。实验层面,29 个配置覆盖 2023 至 2026 年几乎所有代表性度量 3D 模型(Metric3D v2、Depth Pro、MoGe-2/3、Unidepthv2、MASt3R 系、VGGT 系、CUT3R、DA3、MapAnything、pi3x、CAPA 等),首次给出四类设置的横向结论与七条可操作的发现。
实验结果
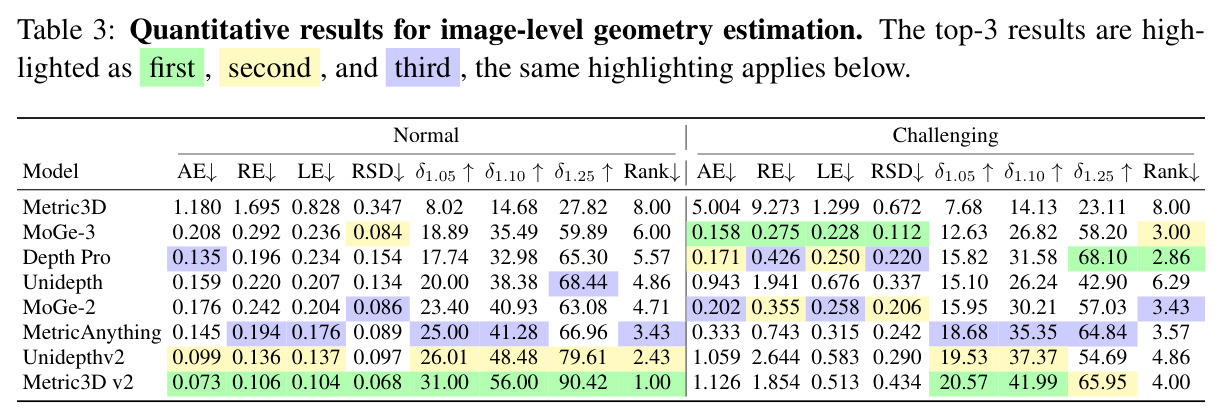
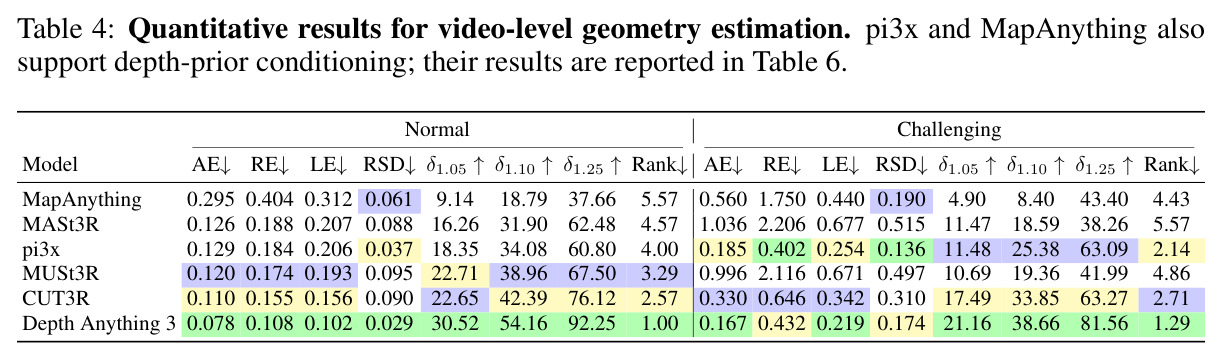
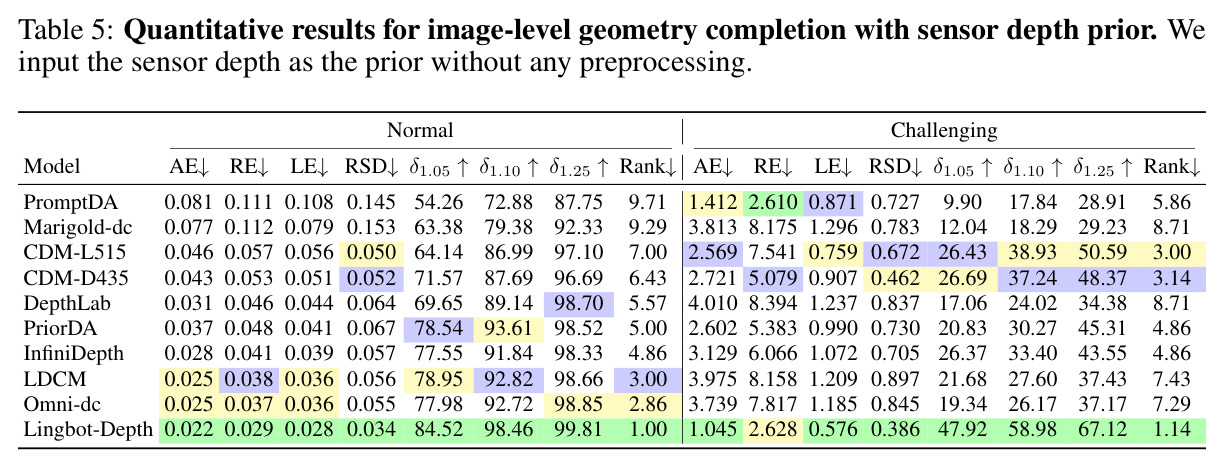
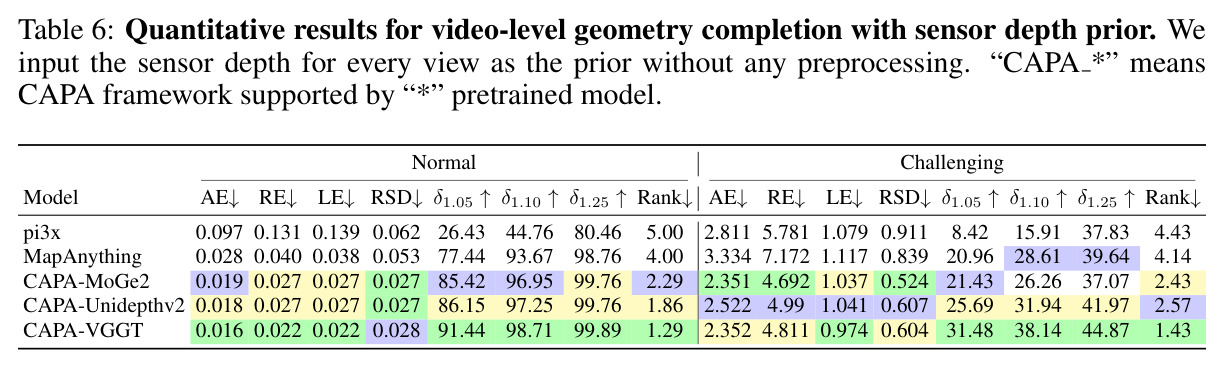
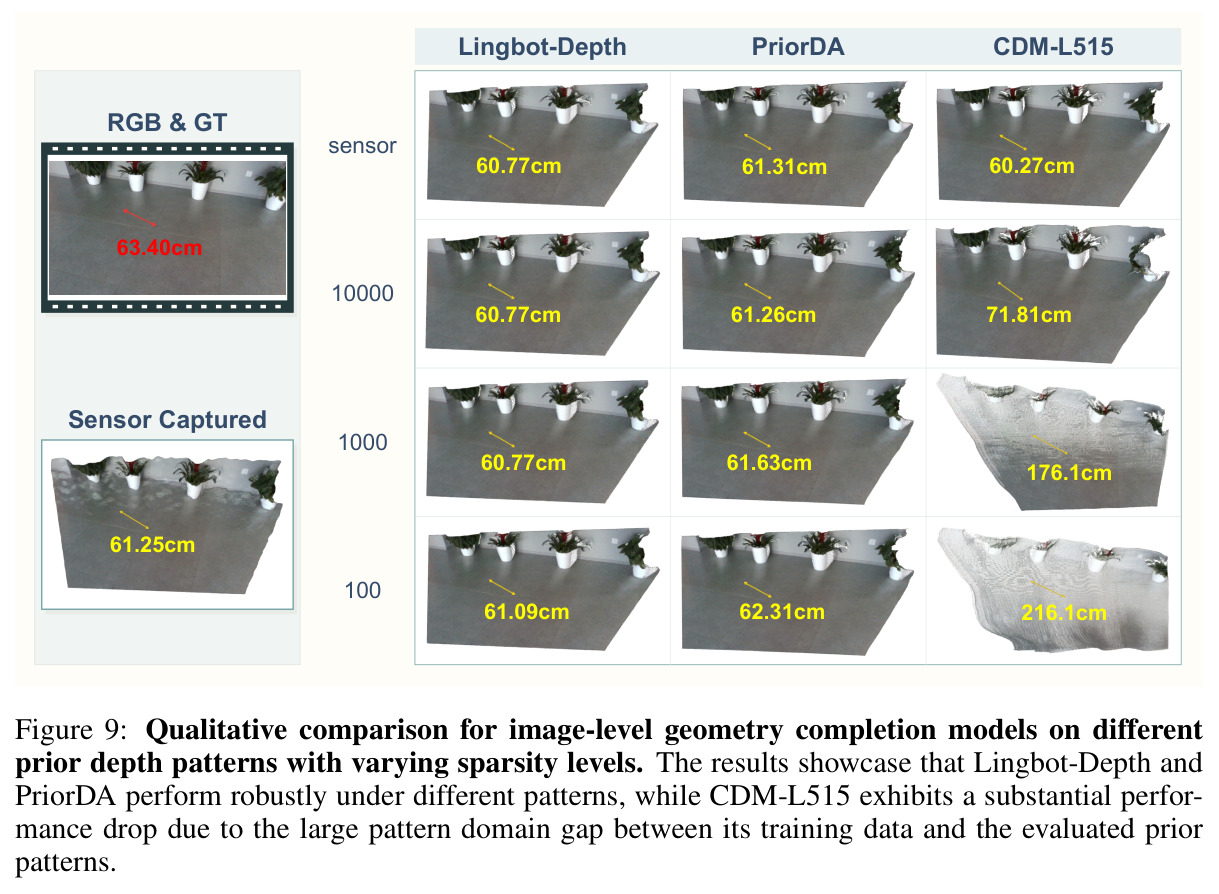
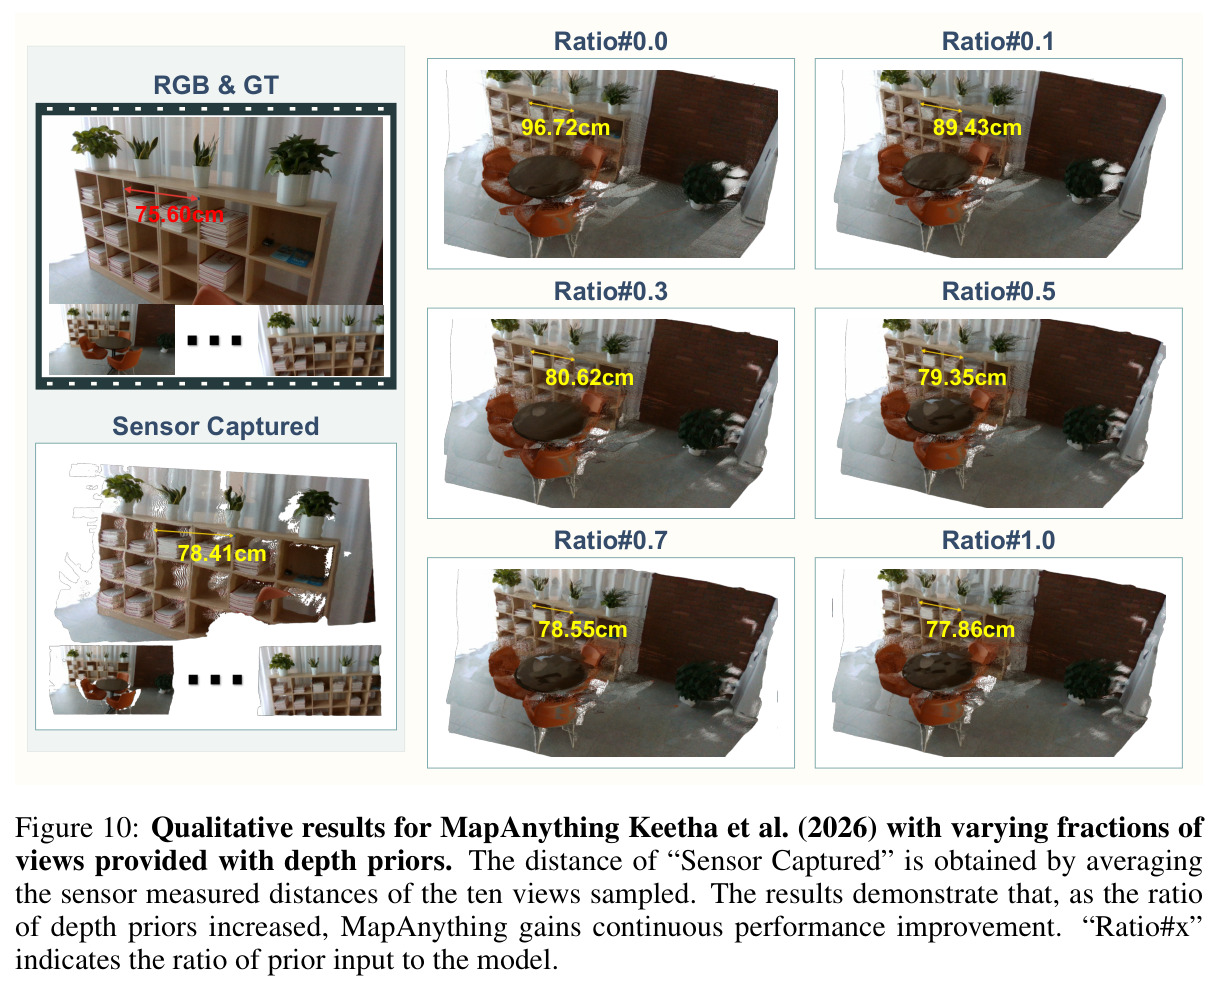
四大设置各有冠军。图像级估计(表3):Metric3D v2 正常场景第一(AE 0.073m、$\delta_{1.05}$ 31.00%、名次 1.00),挑战场景跌至第 4(AE 1.126m);Depth Pro 挑战第一(AE 0.171m)。视频级估计(表4):Depth Anything 3 双榜第一(正常 $\delta_{1.05}$ 30.52%、$\delta_{1.25}$ 92.25%、RSD 0.029)。图像级补全(表5):Lingbot-Depth 双榜第一(正常 AE 0.022m、$\delta_{1.05}$ 84.52%;挑战 47.92%)。视频级补全(表6):CAPA-VGGT 全场最佳(正常 AE 0.016m、$\delta_{1.05}$ 91.44%、$\delta_{1.25}$ 99.89%)。七条发现:一、真值内参替换使 56 对中 47 对退化,证实深度-内参耦合;二、正常场景传感器很强($\delta_{1.05}$ 79.32%,18 个配置仅 5 个补全模型赶上),挑战场景传感器崩坏(AE 4.047m、21.03%),16/18 模型反超;三、估计模型挑战对正常 RE 比率 1 至 20 倍,补全 20 至 210 倍,后者峰值更高但会灾难性失灵;四、稀疏先验非越密越好,多模型中等密度最佳;五、先验视角比例 0.1 到 1.0 时 RE 单调下降,MapAnything 受益大于 pi3x;六、多视角改善一致性(RSD 0.067 到 0.029),补全改善精度,CAPA-VGGT 兼得;七、步长 s=16 对多数模型最佳,MASt3R 与 CUT3R 峰值在 s=8。
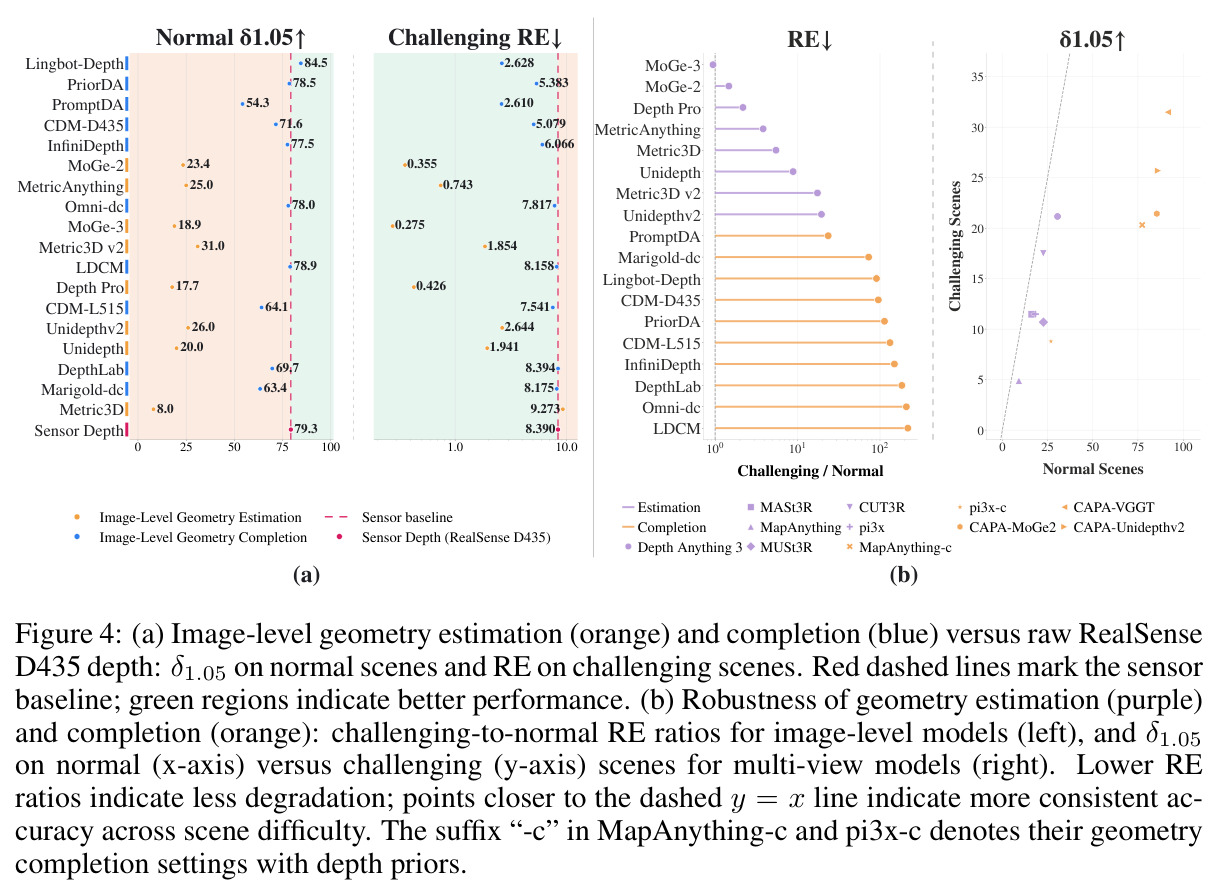
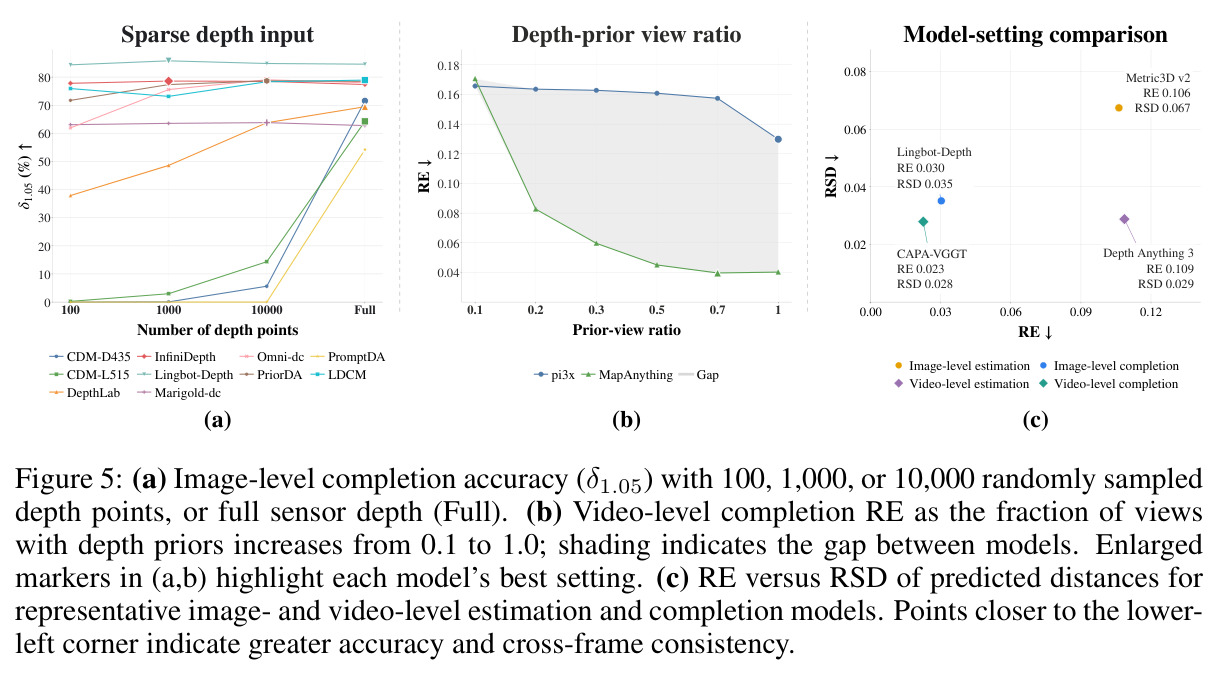
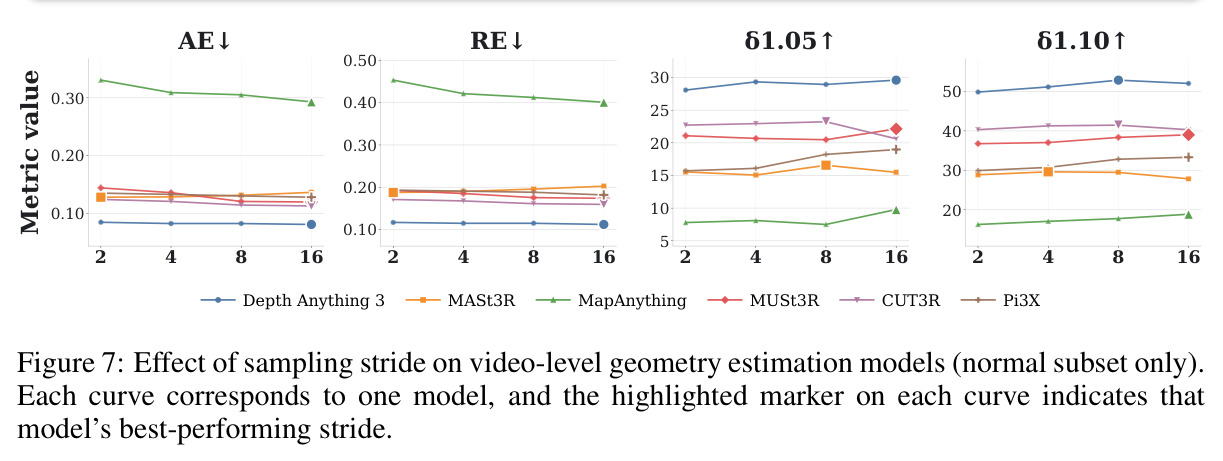
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 视频级几何补全(正常场景) | δ1.05(预测距离比率<1.05 的帧占比,%) | CAPA-VGGT 91.44(全基准最佳) | 原始传感器深度(RealSense D435)79.32 | +12.12 个百分点 |
| 图像级几何补全(正常场景) | δ1.05(%) | Lingbot-Depth 84.52(AE 0.022m) | 原始传感器深度 79.32 | +5.20 个百分点 |
| 视频级几何估计(正常场景) | RSD(跨视角一致性,越小越好) | Depth Anything 3:0.029 | 最佳图像级估计 Metric3D v2:0.067 | 跨视角波动降低约 57%(RE 相当:0.109 对 0.106) |
| 图像级几何估计(挑战场景) | AE(绝对误差,米) | Depth Pro:0.171 | 正常场景第一名 Metric3D v2:1.126 | 误差降低约 85%,证明正常场景优势不向挑战场景泛化 |
| 原始传感器深度基线(挑战场景) | AE(米) | 传感器自身:4.047(δ1.05 仅 21.03%) | 传感器在正常场景:0.026(δ1.05 79.32%) | 退化约 155 倍,被 18 个模型配置中的 16 个反超 |
局限与改进
作者未设独立的局限章节,以下结合原文与自己的观察。第一,真值密度极低:每个场景只有一个贴纸对、一个实测距离,100 个场景共 100 个距离值,无法刻画场景内全局几何、多点拓扑或物体级尺度,结论只对稀疏单点对这一狭窄任务成立。第二,贴纸本身是场景中的异物,10mm 高对比度圆贴可能落在模型训练分布之外,也可能帮助特征跟踪,与真实无标记场景存在偏差。第三,距离量程受限:卷尺手动测量天然适合米级近中距,无法覆盖街景级、无人机级的大尺度评测。第四,场景全部静态且只用单一传感器(RealSense D435),难度划分又依赖传感器 RSD 作代理——传感器的失败模式与学习模型的失败模式并不总一致(估计模型在正常场景的失败就与传感器不同源),可能错分难度子集。第五,各估计模型的 $\delta_{1.05}$ 普遍只有 20% 到 30%,说明任务本身很难,但论文未提供人类水平参照,难以判断指标天花板。第六,协议只覆盖输出绝对尺度的模型,未讨论相对深度加先验标定的轻量方案。
独立分析的弱点
独立分析的弱点:其一,单点对标注统计功效低——一个场景 64 帧都围绕同一个距离打转,场景级平均容易被少数难例场景主导(论文自己承认聚合指标被难例淹没才做了子集划分),改进方向是每场景布设贴纸阵列,一次测多对距离并引入点间拓扑约束。其二,补全模型 20 至 210 倍的灾难性退化说明该家族在先验不可靠区域缺乏不确定性估计,改进方向是让补全模型输出置信度或在低置信区域自适应回退到估计模式。其三,难度划分以传感器 RSD 为代理,但图 4b 显示估计模型与传感器的失败模式并不同源,改用模型无关的几何复杂度指标或多传感器一致性会更公允。其四,评测协议强依赖模型输出哪套内参这一工程细节(估计用预测内参、补全用真值内参、Metric3D 系用 canonical 内参),规则虽合理但增加了复现出错的概率,需要官方代码把每种情形写死并验证。其五,视频级固定 32 组乘 10 帧的采样,而附录 F 表明 MASt3R、CUT3R 对步长敏感(峰值在 s=8 而非 16),只报告单一采样策略的均值可能掩盖方差。
未来方向
作者方向上,论文把点对距离与自动驾驶碰撞率、机器人抓取成功率直接挂钩,最直接的延伸是在具体下游任务上验证 Pumpire 排名与任务成功率的相关性。基于本文成果还可延伸:一是把实测距离作为训练监督信号,构建实测距离微调数据集,专门修复深度-内参耦合失配;二是为补全模型设计抗噪声先验机制(发现 3 与 4 表明噪声与稀疏联合决定性能,且补全在挑战场景会崩溃);三是扩展到大尺度与动态场景,加入无人机航拍、街景与运动物体,检验基础模型在数十米到公里级尺度上的外推能力;四是把点级距离评测与空间推理 VLM 评测打通,检验几何准是否带来推理准;五是研究深度与内参的联合输出架构,例如显式加入反投影一致性损失,从根上解决耦合失配;六是引入 LiDAR、事件相机、IMU 等更多先验类型统一进补全评测框架。作者给出的七条发现本身就是一份研究路线图,尤其是估计与补全鲁棒性互补的结论,提示了两者融合的混合架构机会。
复现评估
复现评估:项目页 pumpire.github.io 已上线,被评测的 29 个配置全部是公开模型(Metric3D v2、Depth Pro、MoGe-2/3、Unidepthv2、MASt3R/MUSt3R、VGGT、CUT3R、Depth Anything 3、MapAnything、pi3x、CAPA 等均有开源权重),推理阶段单张消费级 GPU 即可运行大多数模型,成本最高的是视频级模型每场景 32 组乘 10 帧的采样推理,主要是时间开销。协议本身极轻:反投影加标量指标,无训练、无敏感超参;视频级采样固定随机种子(附录 C),保证所有模型拿到完全相同的多视角样本,结果确定性可复现。数据方面,pumpire-6k 含 RGB、对齐深度、内参、贴纸像素坐标与实测距离,若按承诺开源则可直接复现全部表格。最大的门槛在数据采集侧:需要 RGB-D 相机、100 个真实场景与卷尺人工测量,标注依赖 CoTracker3 加逐帧人工校验,人力成本中等偏高;但评测研究只需使用数据而非重建数据。总体属于中等偏易的复现难度,关键变量是数据集与代码的实际开源完整度。
论文图表
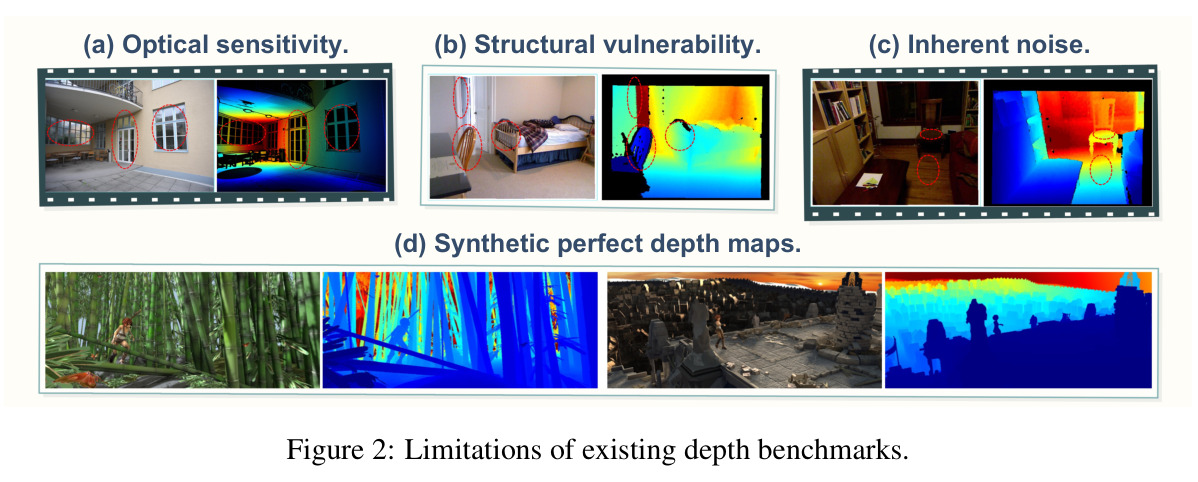
四组对比:(a) 光学敏感性——透明与反光表面上传感器深度失真;(b) 结构脆弱性——细长结构与物体边界处深度出错;(c) 固有噪声——普通表面上的传感器噪声;(d) 合成数据的完美深度图——无噪声但存在域差距。说明无论真实传感器标注还是合成标注都不适合充当距离真值。
这是为什么必须用卷尺实测真值的直观证据,直接支撑数据集设计的动机。
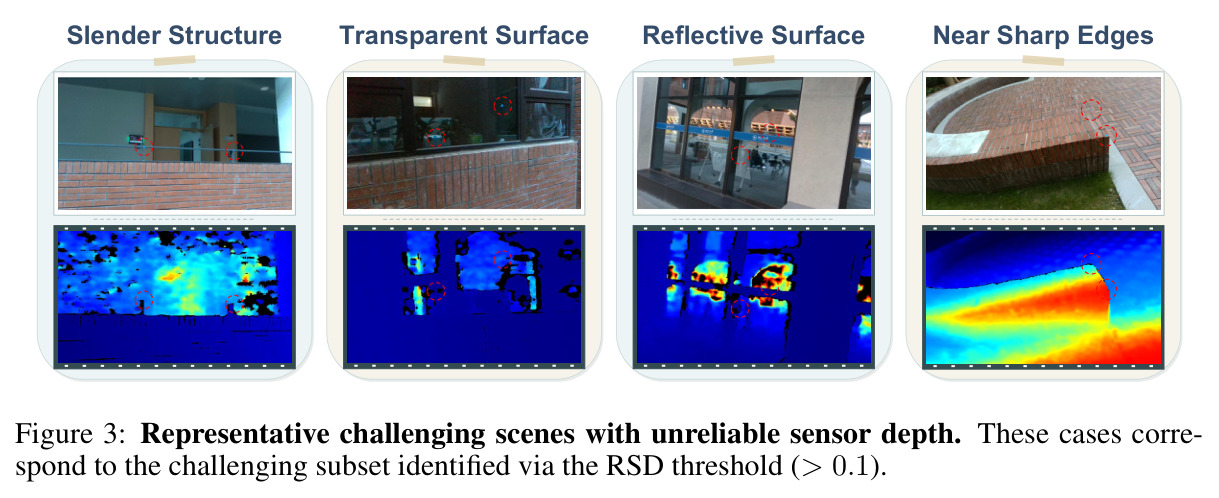
展示被 RSD 大于 0.1 阈值识别为挑战子集的代表性场景,按细长结构、透明表面、反光表面、近锐利边缘四类排列,这些场景中传感器深度反投影出的距离跨视角波动剧烈(AE 高达 4.047m)。
直观解释 24 个挑战场景的构成,帮助理解难度划分标准与挑战子集的物理含义。