TokenRouter:面向 token 级 LLM 路由的高效服务系统 TokenRouter: Efficient Serving System for Token-Level LLM Routing
请求中心编程、模型中心执行的服务系统,让 token 级路由吞吐提升 2–64 倍
前置知识
token 级路由
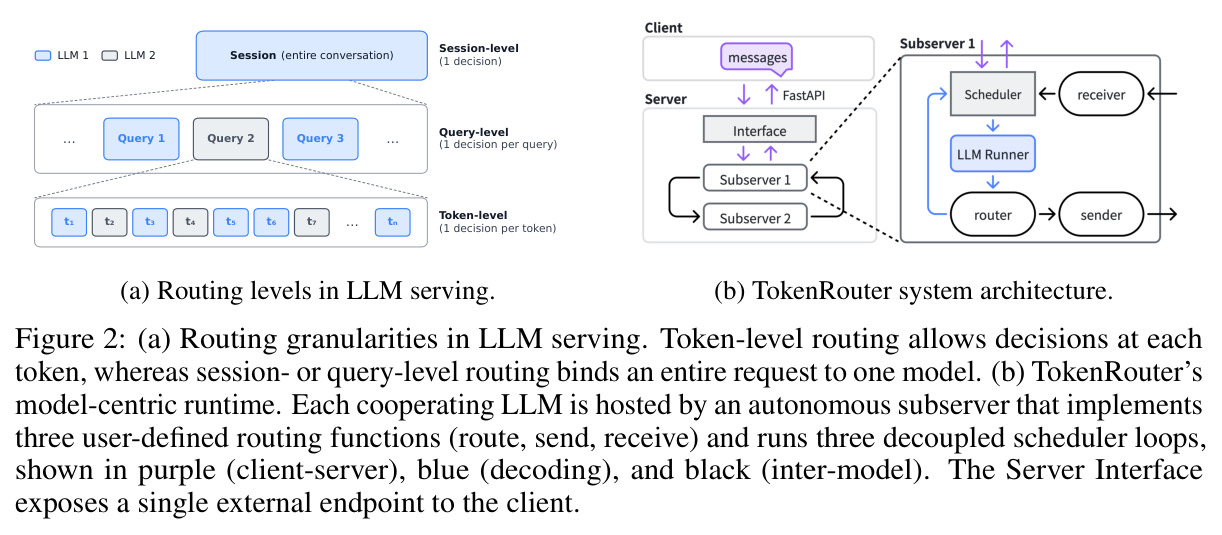
在自回归生成的每个解码步(或短片段)上动态选择由哪个模型继续生成的技术。与会话级、查询级路由一次决策绑定整个请求不同,token 级路由依据每步信号(置信度、熵、预测偏差等)逐 token 切换模型,例如 R2R 只需把 5% 的 token 交给大模型即可匹配其质量,而查询级路由要把约 40% 的查询交给大模型。
本文全部问题定义与系统设计都围绕 token 级路由独特的执行形态展开,不理解它就无法理解步级去同步、批次准入延迟等挑战的来源。
连续批处理
vLLM、SGLang 等现代 LLM 服务器的核心调度技术:解码循环每次迭代动态决定哪些请求参与本步 batch,完成的请求即时退出、新请求随时加入,无需等整批结束。它隐含一个关键假设——同一服务器上所有请求同步推进、属于同一个模型。
TokenRouter 在每个 subserver 内部保留连续批处理,理解它才能看出 token 级路由为何会打破现有调度器的设计前提。
KV 缓存与前缀缓存
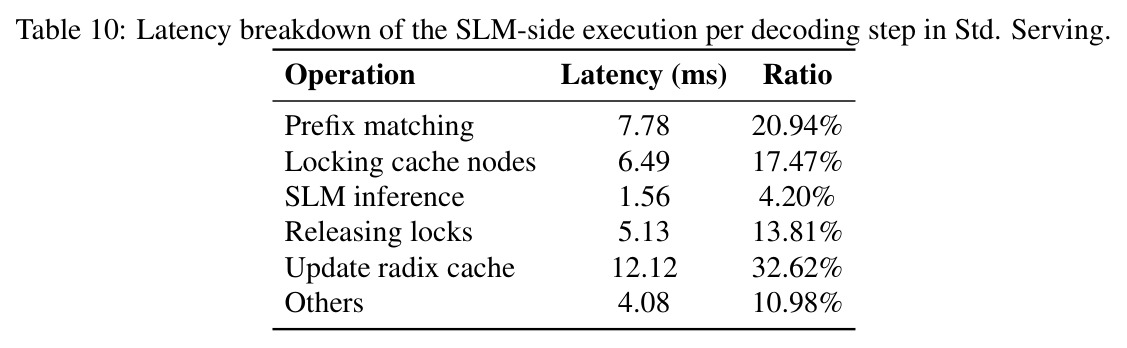
Transformer 推理时缓存每个 token 位置的键值向量避免重复计算;前缀缓存进一步识别不同请求间的公共前缀并复用其 KV。若一个跨模型切换后返回的请求被当作新请求处理,就必须重做前缀匹配和 KV 缓存分配,开销显著。
论文 handoff-resume 机制的动机正是消除这些重复开销,把跨模型切换简化为一次 token 追加,这是吞吐收益的重要来源。
投机解码
用小模型快速起草多个 token、大模型并行验证的推理加速技术。其两模型以周期性 draft-verify 模式紧耦合运行,访问模式可预测。
论文用投机解码作对比:token 级路由是数据依赖的随机模型访问,投机解码的服务优化方式无法直接套用,这一区分解释了 TokenRouter 架构的必要性。
研究动机
LLM 路由已成为提升推理性价比的主流范式:ChatGPT、Cursor 等产品在会话或查询级把请求分发给不同规模的模型,学术系统 RouteLLM 也证明查询级路由能以更低成本逼近大模型质量。但查询级粒度太粗——一旦请求被路由,整段回答只能由单一模型生成。算法研究表明 token 级路由能解锁查询级无法企及的收益:R2R 只需把 5% 的 token 交给 32B 模型即可匹配其质量,查询级路由则要把约 40% 的查询交给 32B;token 级路由还支持多模型在单条回答内协作、提供平滑的成本-质量调节。然而现有服务系统 SGLang、vLLM 都建立在单一 LLM 假设上,所有请求每个解码步同步推进。token 级路由允许目标模型逐步切换,带来三大难题:一是步级去同步,不同模型单步延迟差异巨大,同步批处理迫使每步都等最慢模型,快模型闲置;二是批次准入延迟,频繁换模使 routed 请求到达时目标模型还在处理上一个 batch,产生空泡和 batch 碎片化;三是实现复杂,系统不提供逐步路由的编程接口,在深度耦合连续批处理与前缀缓存的大型代码库中改造成本极高。
本文的目标是构建一个既高效又对开发者友好的 token 级 LLM 路由服务系统,把算法社区已证明的理论收益转化为真实部署加速。具体目标有三:其一,提供简洁编程接口,开发者无需理解底层异步批处理即可表达任意 token 级路由算法,只需从单请求视角描述它如何在多个 LLM 之间流动;其二,消除步级去同步,让每个模型按自身节奏独立解码,同时把跨模型切换开销压缩到接近一次 token 追加;其三,降低批次准入延迟,用可控的延迟凑批把稀疏不规则的跨模型请求汇聚成更大同模型 batch,并由数学模型解析推导最优超参数。系统对外暴露与 vLLM、SGLang 协议相同的单一接口,可作为标准单模型服务器的即插即用替代品。最终目标是在多种路由算法、工作负载和模型对上取得数量级的吞吐提升,实测达成 2.01–64.15 倍。
与已有工作不同的是,本文的独特切入是「请求中心编程、模型中心执行」的分层抽象。已有系统要么针对单模型服务优化(SGLang、vLLM),要么把多模型协作硬编码为投机解码那样的固定耦合模式,都没有为数据依赖的逐步模型切换提供原生支持。作者观察到所有 token 级路由算法共享同一请求生命周期:receive → decode → route → send → 对端 receive → 对端 decode → …,据此提炼出 route-send-receive 三函数接口,把「算法语义」与「服务优化」彻底解耦:开发者只描述单个请求的流转逻辑,运行时以每个 LLM 一个自治 subserver 的方式异步执行,从而同时获得编程简洁性与跨模型联合优化的空间。这套抽象使同一运行时无需改动即可承载基于置信度、熵、偏差预测、集成权重等不同信号的路由算法,这是与在单模型引擎里魔改路由逻辑的既有做法的本质差异。
核心方法
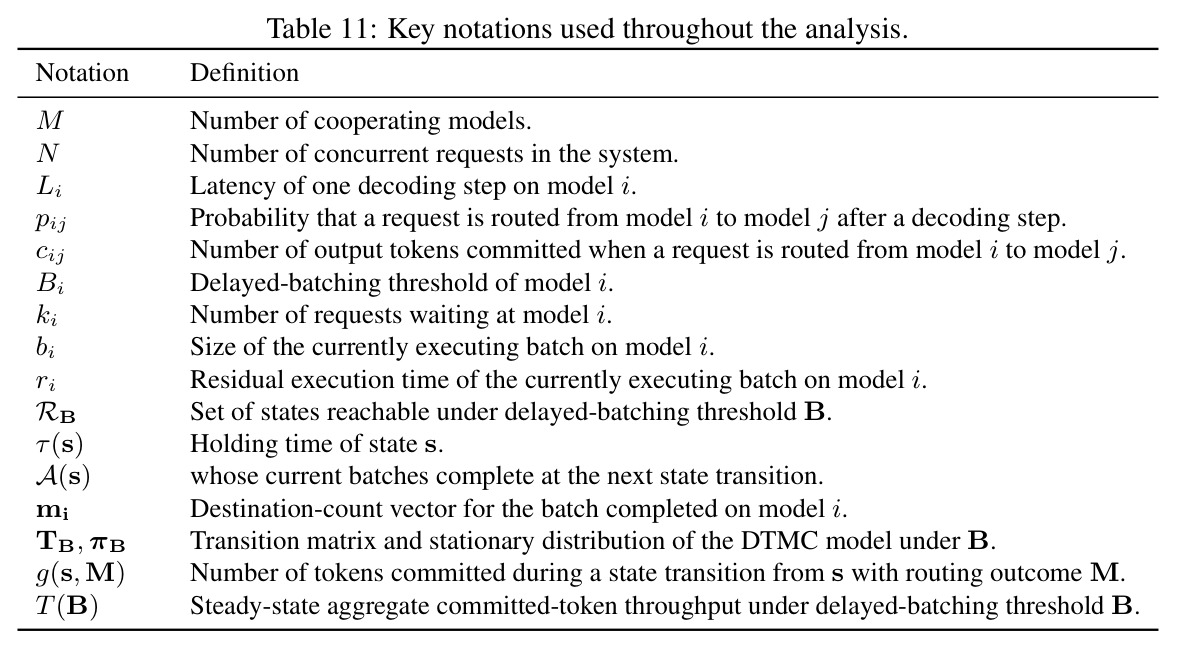
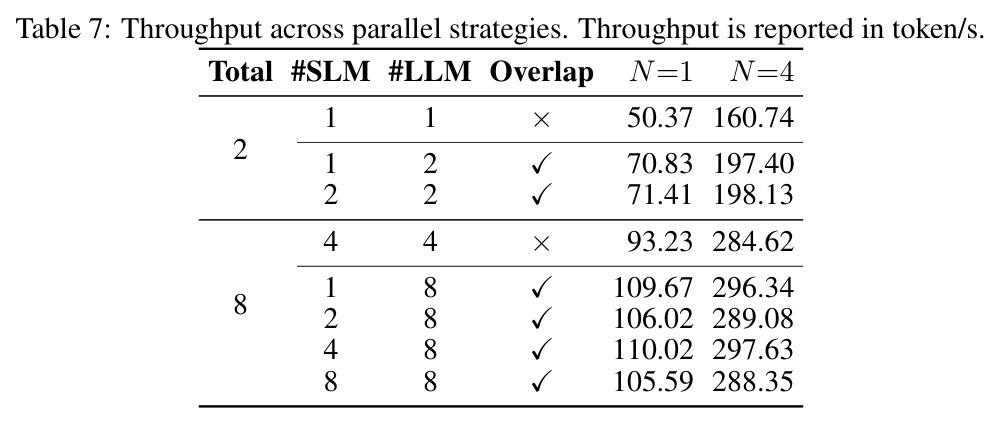
直觉上,TokenRouter 把每个候选 LLM 封装成一个自治 subserver:各自拥有调度器、带私有 KV 缓存池的 runner 和用户定义的 route/send/receive 三函数;subserver 之间通过异步 peer 请求通信,外部只暴露与标准单模型服务器协议一致的入口,可无缝替换 vLLM/SGLang。技术上由三部分组成:第一,解耦三循环执行——在传统服务器的客户端-服务器循环与解码循环之外增加第三个跨模型循环,专门收发 peer 请求,被路由走的请求让出本地 batch、其余请求按本地节奏继续解码;第二,handoff-resume 机制把跨模型切换简化为一次 token 追加;第三,延迟凑批调度器,缓冲跨模型请求、凑满阈值 $B$ 才启动 batch,最优值 $B^*$ 由离散时间马尔可夫链(DTMC)吞吐模型在给定并发 $N$、路由概率 $P$ 和单步延迟 $L_i$ 下解析求出。实现构建于 SGLang,并附带扩展 CUDA Graph 等工程优化。
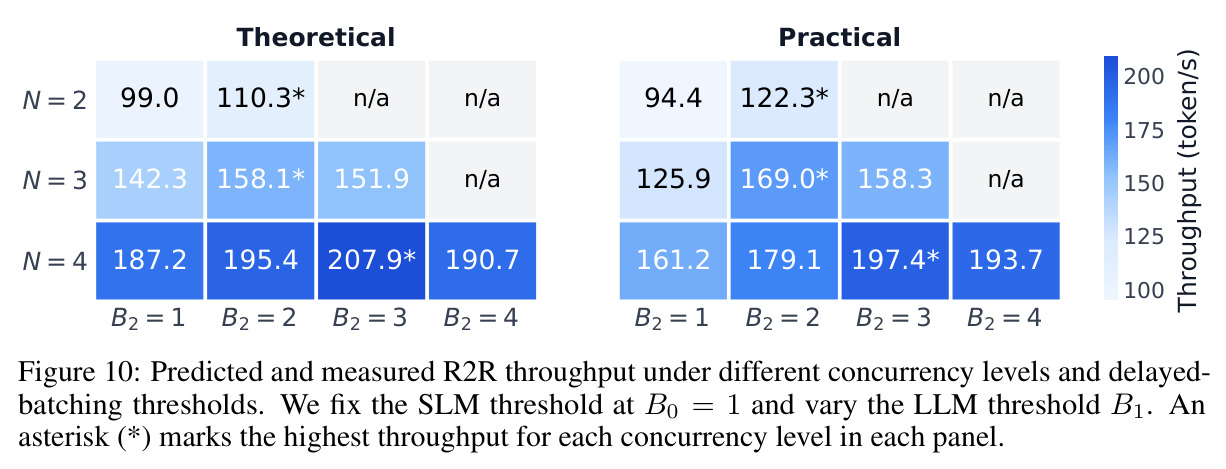
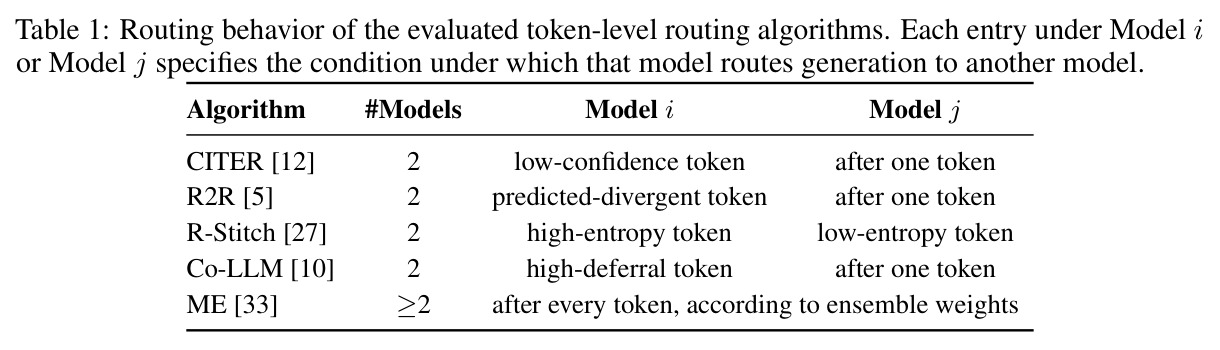
核心创新有三,本质区别在于把多模型协作从单模型的同步假设中解放出来。第一,route-send-receive 接口:route 在每步解码后基于前向结果(隐藏态、logits、采样 token)为 batch 内每个请求输出目的地索引,0 表示留本地、非零指向对端;send 把请求封装成 PeerReq,只携带对端未见过的 token 后缀并附带位置锚点 req.loc;receive 默认全量接收返回 token,仅算法语义特殊时覆写。CITER、R2R、R-Stitch、Co-LLM、ME 五个算法全部用这一套接口表达。第二,handoff-resume:引入介于 running 与 finished 之间的 pending 状态,切换时保留服务态,续跑时切回 running 并追加新 token,省掉把返回请求当新请求处理的前缀匹配与 KV 重分配。第三,延迟凑批:不同于收到 peer 请求就立即执行的 eager-async(会造成反复准入停顿),刻意等待凑满 $B$ 个请求再执行,用可控等待降低平均准入延迟,且 $B^*$ 由吞吐模型闭式推导而非手调。
方法步骤详情
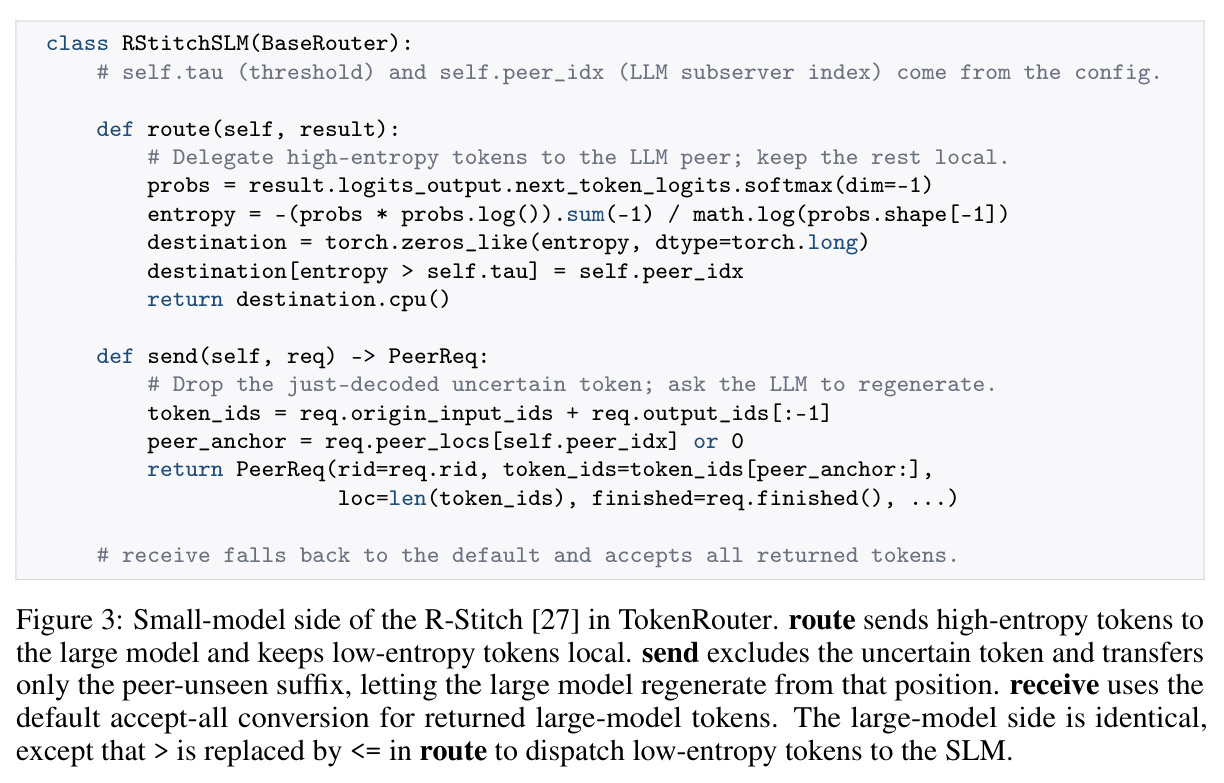
完整流程分五步。步骤一,开发者实现三函数:route(result) 在每步解码后计算目的地(如 R-Stitch 在 SLM 侧对归一化熵 $H=-\sum_v p_v\log p_v/\log|V|$ 超阈值 $\tau$ 的 token 路由到大模型);send(req) 构造 PeerReq,含请求 ID、对端未见过的 token 后缀(R-Stitch 丢弃刚采样的不确定 token、要求大模型重生成)、finished 状态与位置锚点;receive(peer_req) 把 PeerReq 转本地格式。步骤二,客户端请求经统一入口进入 entry subserver,参与本地连续批处理解码。步骤三,route 判定需切换后,跨模型循环将该请求标记为 pending 并调用 send 发出,本地调度器跳过它但保留服务态。步骤四,对端 subserver 收到 PeerReq,调用 receive 转换格式,延迟凑批调度器在缓冲达到 $B^*$ 后合成 batch 解码。步骤五,结果沿原路返回,源 subserver 把 pending 切回 running 或 finished,追加新 token 原地续跑,不重做前缀匹配与 KV 分配。
技术新颖性
技术新颖性体现在三处。其一,与投机解码服务系统相比:投机解码的 draft-verify 是周期性紧耦合模式,可用专门流水线优化,而 token 级路由是数据依赖的随机模型访问,产生不规则的模型本地到达与碎片 batch;TokenRouter 用自治 subserver 加三循环异步架构首次系统性支持这一执行形态,同时保留每个模型本地的连续批处理与前缀缓存。其二,与在 SGLang/vLLM 内部魔改的做法相比:pending 状态的 handoff-resume 是全新机制——把返回请求从「当新请求」(重做前缀匹配、重分配 KV)变成「原地续跑」(一次 token 追加);对照实验显示缺乏该机制的 Std. Serving 基线每步都要支付这些代价,是延迟差距的主因。其三,调度参数不再手调:把路由过程建模为 DTMC,以并发 $N$、路由概率 $P$、单步延迟 $L_i$ 为输入解析求出吞吐最优阈值 $B^*$,这种「服务参数由数学模型推导」的设计在 LLM 服务系统中相当少见,且模型对算法形态的假设(几何分布切换间隔)覆盖了绝大多数 token 级路由方法。
实验结果
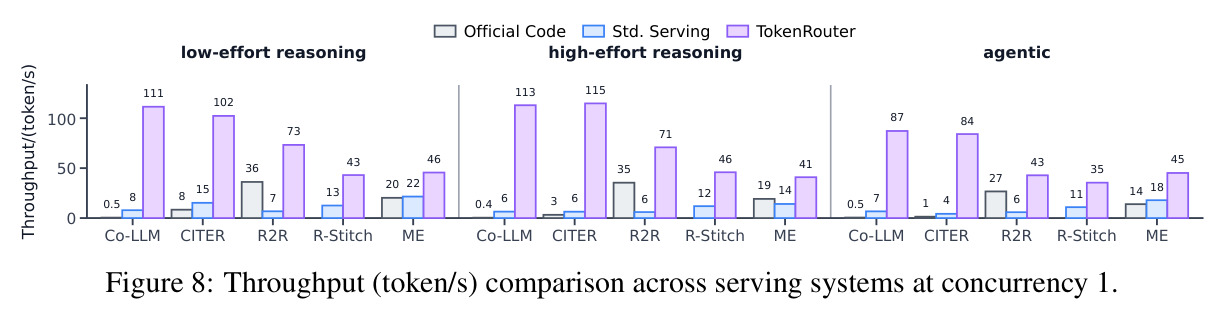
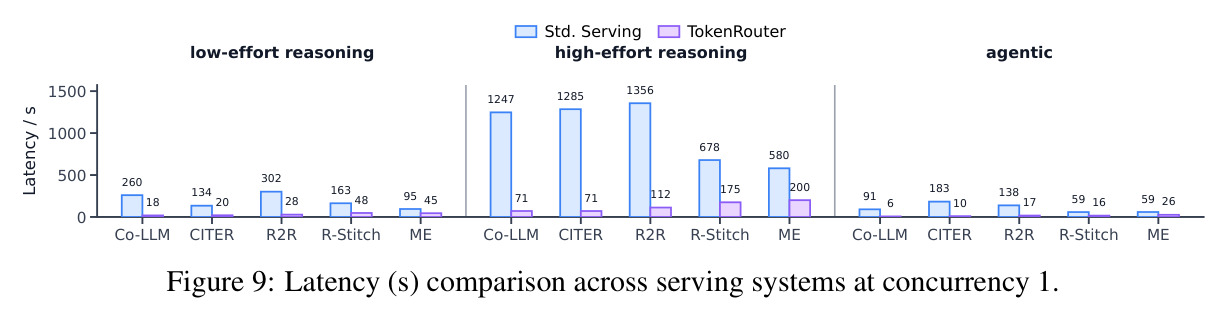
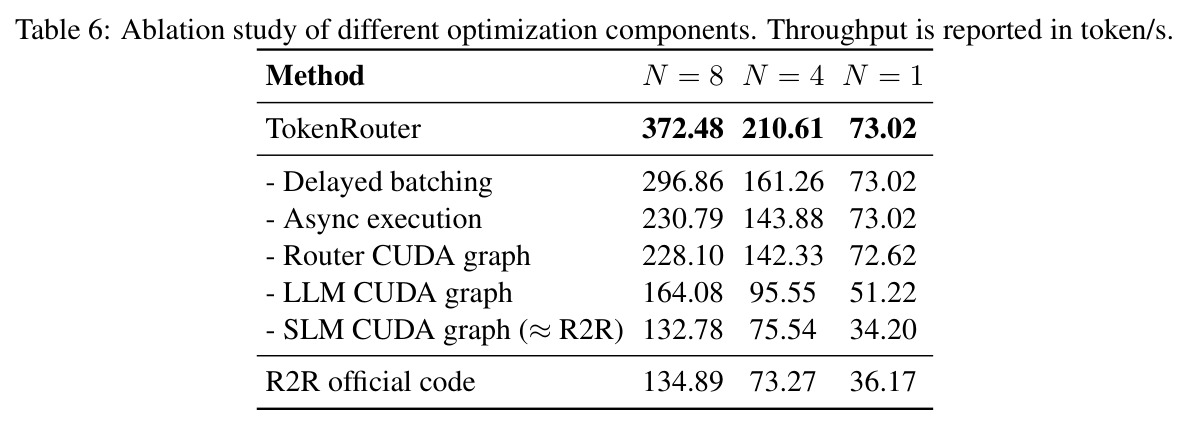
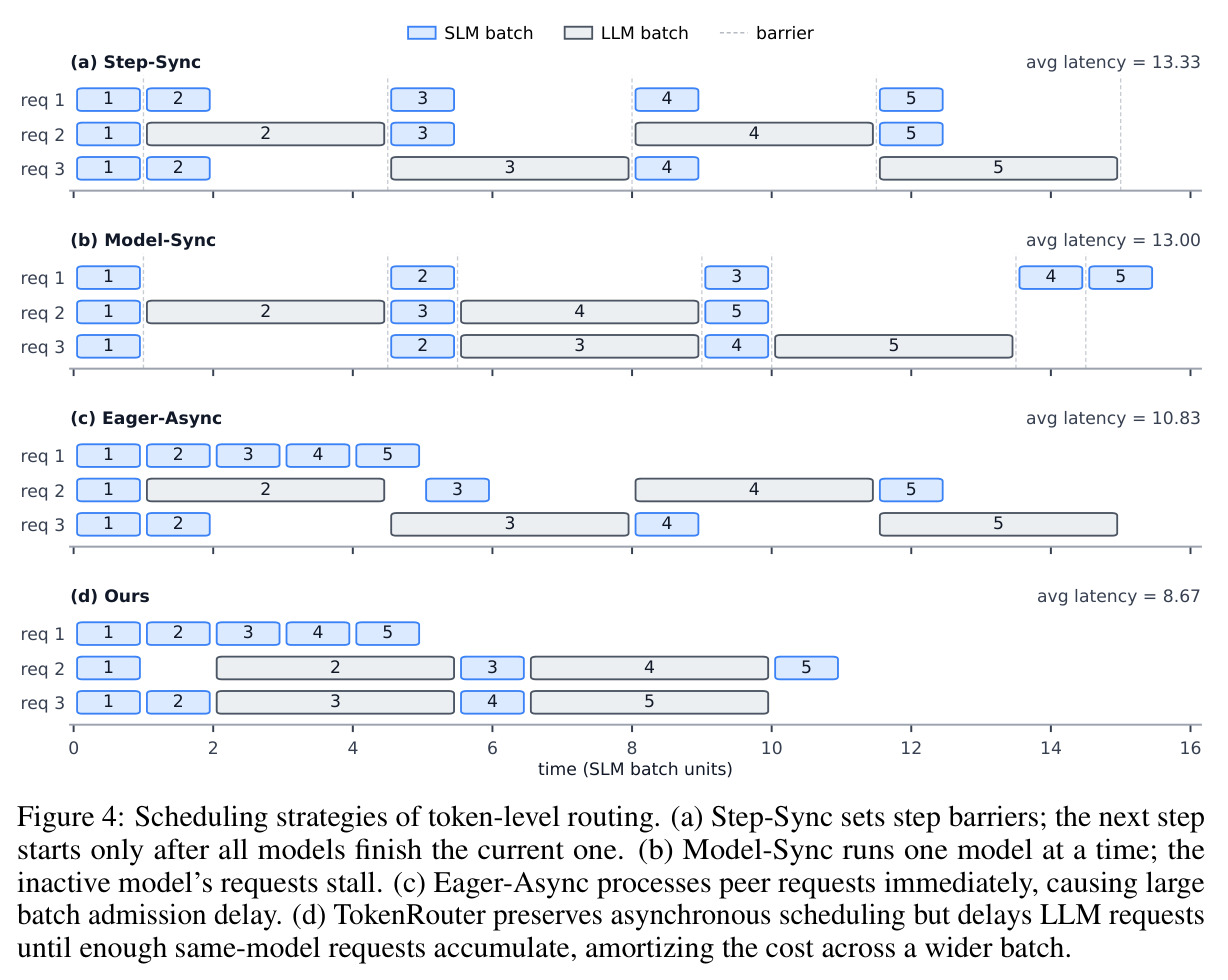
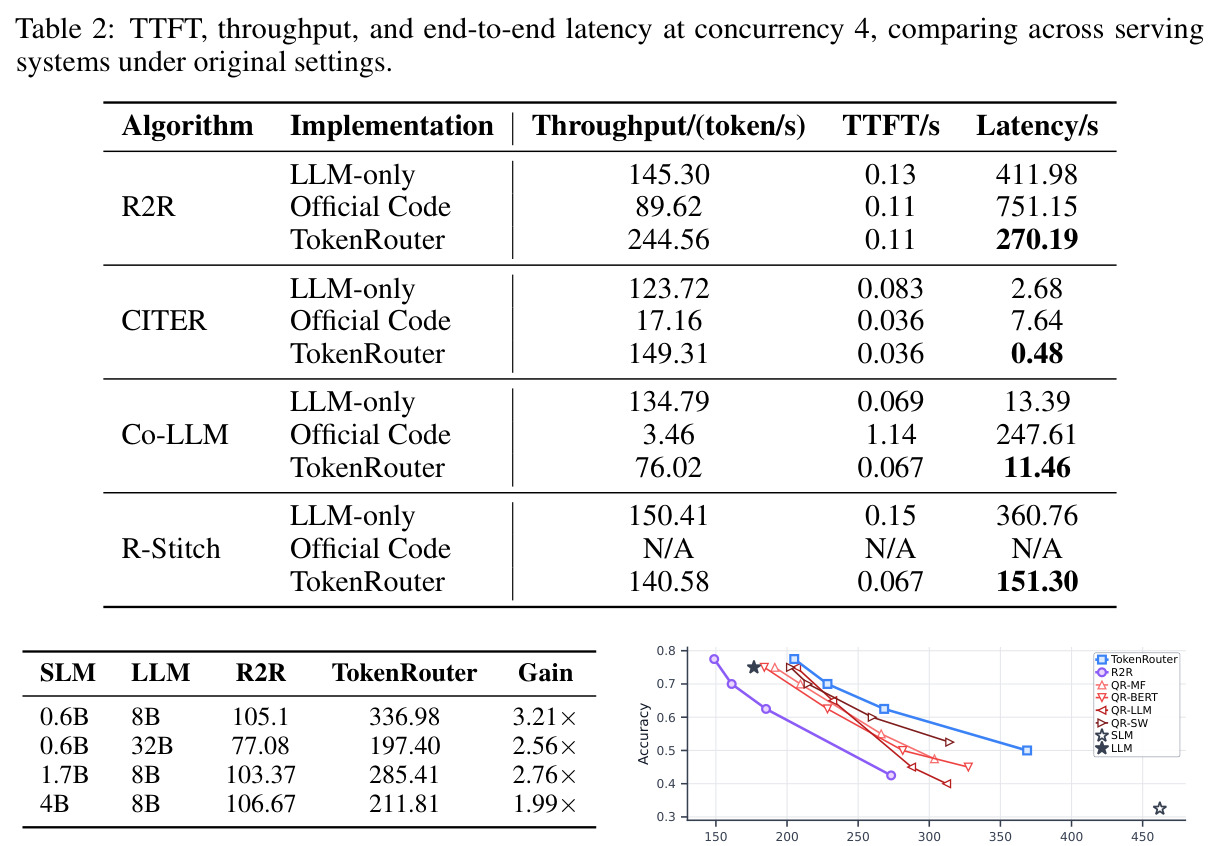
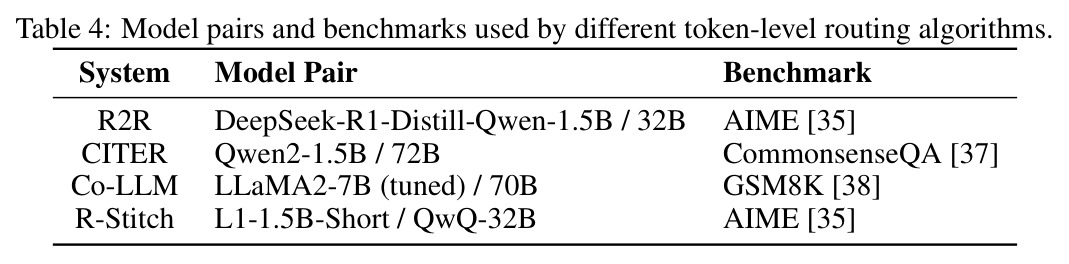
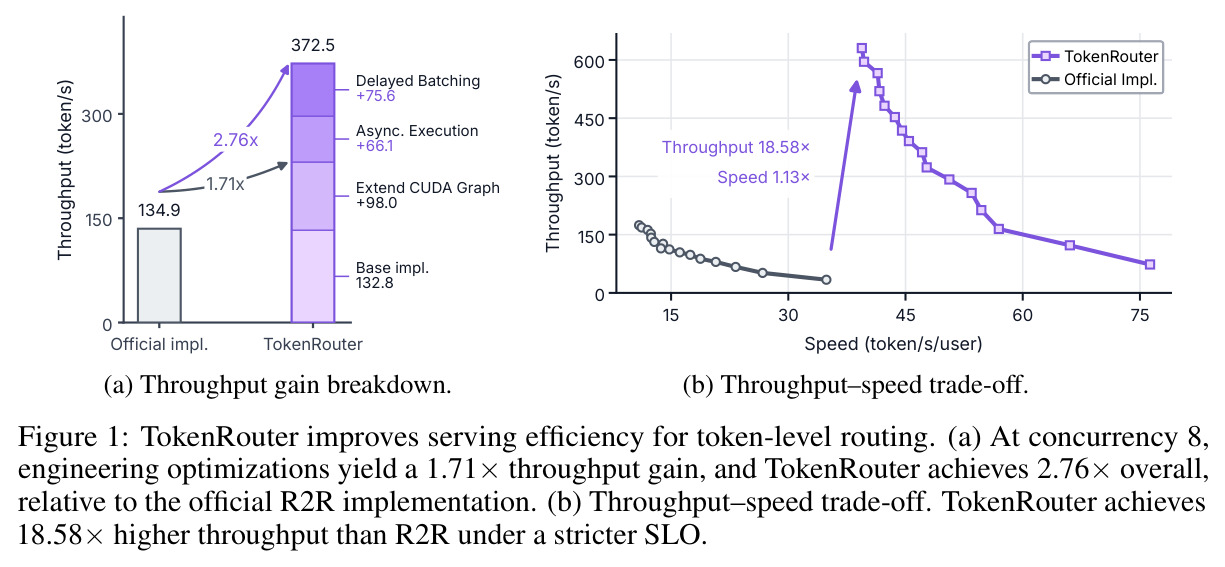
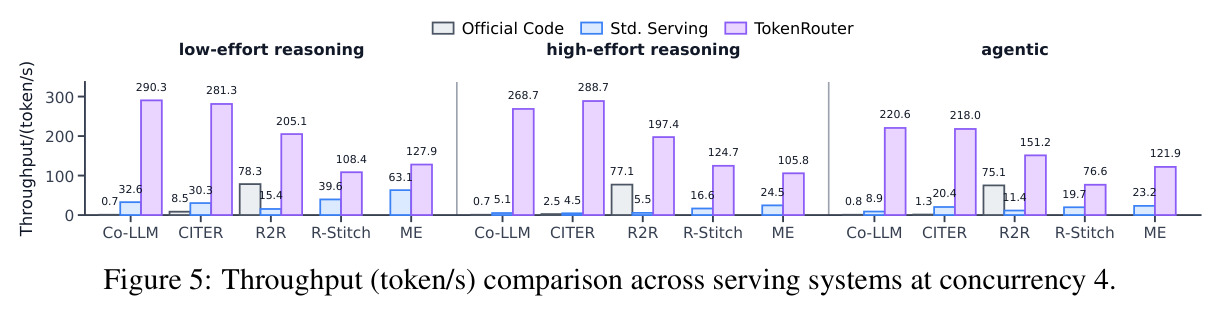
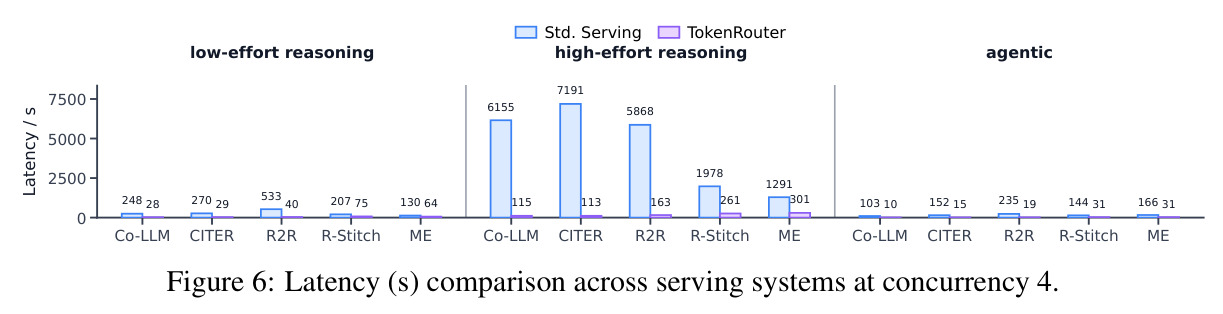
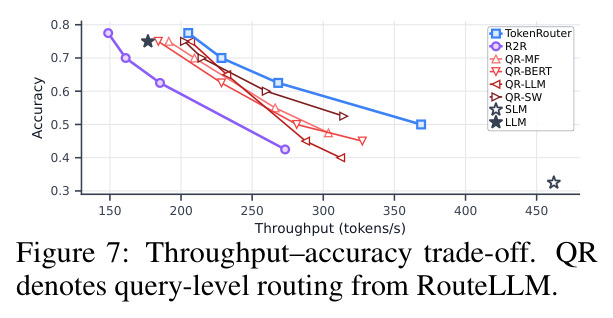
核心结论:在 5 种算法×3 类工作负载共 15 种组合上,TokenRouter 相对最强基线 Std. Serving 吞吐提升 2.01–64.15 倍,端到端延迟降低 2.03–63.64 倍。收益分解(Figure 1a,并发 8):基础实现 132.78 token/s,扩展 CUDA Graph 提到 230.79(1.71 倍于官方 R2R 的 134.9),异步执行 296.86,延迟凑批 372.48,总体 2.76 倍。吞吐-速度权衡(Figure 1b):并发 1→16 时 TokenRouter 吞吐增 8.61 倍、保留 51.7% 单用户速度(R2R 仅 5.14 倍、31.3%);并发 16 吞吐是并发 1 官方 R2R 的 18.58 倍且单用户速度还高 1.13 倍。原论文设置(Table 2):R2R 89.62→244.56 token/s、延迟 751.15→270.19s;CITER 17.16→149.31、7.64→0.48s;Co-LLM 3.46→76.02、247.61→11.46s;R-Stitch 官方未开源,TokenRouter 达 140.58 token/s。跨模型对(Table 3)增益 1.99–3.21 倍。调度模拟(Figure 4)平均延迟 8.67 个 SLM batch 单位,优于 Step-Sync 13.33、Model-Sync 13.00、Eager-Async 10.83。AMC23 上(Figure 7)token 级路由形成新 Pareto 前沿、反超 RouteLLM 查询级路由。高推理负载下 Std. Serving 丢 58.1–85.2% 吞吐,TokenRouter 保持稳定。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| token 级路由服务吞吐(5 算法×3 负载,并发 4) | 解码吞吐 | 相对最强基线一致领先 | Std. Serving(每模型一个 SGLang 服务器 + 外部逐 token 调度器) | 2.01–64.15 倍 |
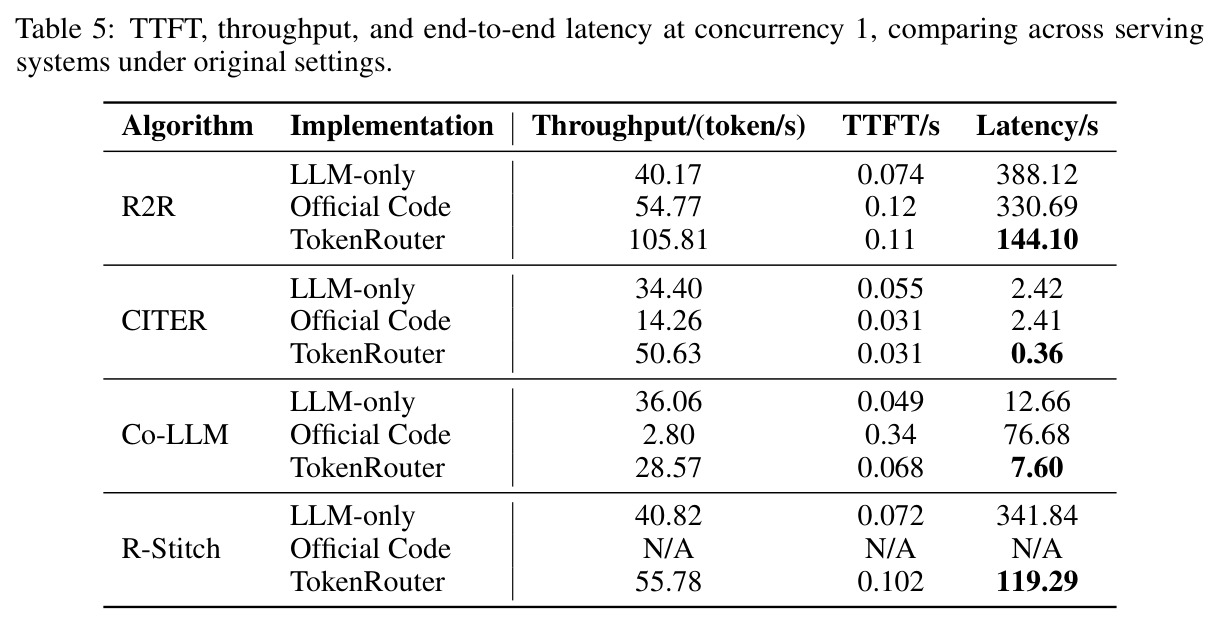
| R2R 原论文设置 | 吞吐 / 端到端延迟 | 244.56 token/s / 270.19s | 官方实现 89.62 token/s / 751.15s | 吞吐 2.73 倍,延迟 2.78 倍 |
| CITER 原论文设置 | 吞吐 / 延迟 | 149.31 token/s / 0.48s | 官方实现 17.16 token/s / 7.64s | 吞吐约 8.7 倍,延迟约 15.9 倍 |
| Co-LLM 原论文设置 | 吞吐 / 延迟 | 76.02 token/s / 11.46s | 官方实现 3.46 token/s / 247.61s | 吞吐 21.97 倍,延迟 21.61 倍 |
| R-Stitch 原论文设置 | 吞吐 / TTFT | 140.58 token/s / 0.067s | 官方代码未开源(N/A) | 首个可用的高效系统实现 |
| 跨 SLM-LLM 模型对(R2R) | 吞吐(token/s) | 0.6B/8B: 336.98;1.7B/8B: 285.41;4B/8B: 211.81;0.6B/32B: 197.40 | 官方 R2R:105.1 / 103.37 / 106.67 / 77.08 | 1.99–3.21 倍 |
| 吞吐-速度权衡(并发 1→16) | 吞吐增益 / 单用户速度保留率 | 8.61 倍 / 51.7%;并发 16 吞吐为并发 1 官方 R2R 的 18.58 倍 | 官方 R2R:5.14 倍 / 31.3% | 严格 SLO 下吞吐 18.58 倍且单用户速度仍高 1.13 倍 |
| 质量-吞吐 Pareto(AMC23,Qwen3-0.6B+32B,贪心解码,最大 8192 输出) | 准确率-吞吐曲线 | token 级路由形成新 Pareto 前沿 | RouteLLM 查询级路由(QR-MF/QR-BERT/QR-LLM/QR-SW 变体,SGLang 框架) | 同吞吐下准确率显著更高,反超查询级路由 |
局限与改进
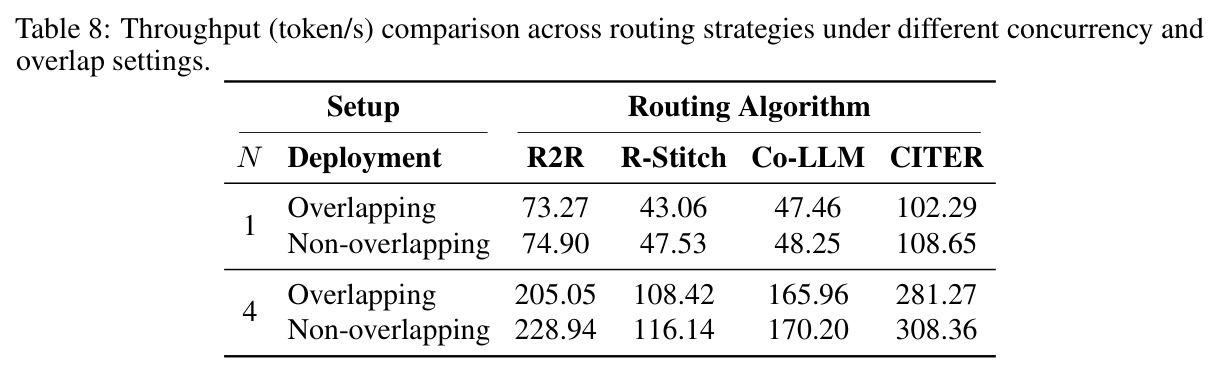
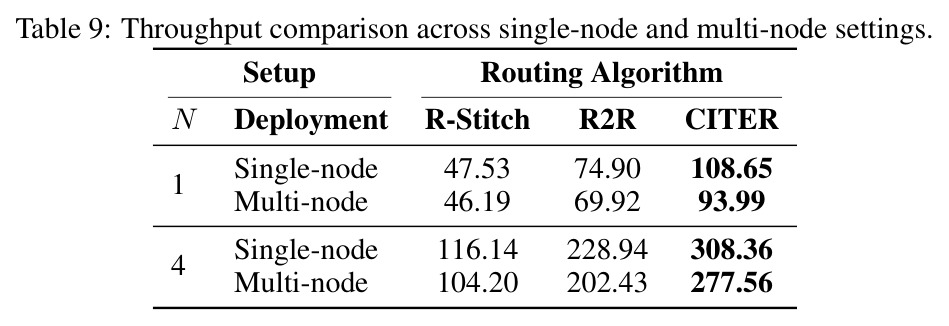
作者承认的局限:吞吐模型假设相邻两次 send 之间的 token 数服从几何分布,这只对大多数 token 级路由算法成立,违反假设的角落案例留待未来工作。我的补充观察:其一,实验全部在 8×A100-80G 上进行,两模型经 CUDA MPS 共享 GPU 的部署假设在显存紧张或不支持 MPS 的环境未必可行;其二,评测集中于 Qwen3 家族,PeerReq 传递的是 token ID,跨家族异构模型(tokenizer 不同)的 handoff 语义与词表映射未讨论;其三,延迟凑批收益本质来自批量摊销,单请求低并发场景收益会明显缩小;其四,$B^*$ 依赖离线给定的路由概率 $P$,线上分布漂移时需重新标定;其五,质量评测仅覆盖 AMC23 数学推理,开放式生成与多轮 agentic 任务的 Pareto 前沿未验证;其六,长后缀传输(如 R2R 预测发散后累积 token)的序列化开销缺少定量分析。
独立分析的弱点
独立分析三个弱点。弱点一,跨模型切换需传输 token 后缀,当切换间隔长(如 R2R 预测 divergence 后累积大量 token)时序列化与传输开销不可忽略,改进方向是传增量 KV 缓存或建立跨 subserver 的分布式 KV 缓存池,把 handoff 压到近零拷贝。弱点二,DTMC 吞吐模型假设几何分布且路由概率 $P$ 需离线获知,实际负载的 $P$ 随领域、温度、提示长度剧烈变化,改进方向是在线估计 $P$ 并自适应更新 $B^*$,或用轻量学习型调度器替换闭式解。弱点三,系统未处理请求间公平性与异构 SLO:延迟凑批刻意让早到请求等待,对尾延迟敏感的交互式应用可能拉长 P99,改进方向是按 SLO 分级准入,对高优先级请求放宽 $B$ 或旁路缓冲。另外,评测局限于单机 8 卡(LLM TP=2 经 CUDA MPS 共享),多机跨网络场景下三循环异步的鲁棒性与通信开销尚未验证;DTMC 模型解析解的数值稳健性也只在附录给出,缺少 sensitivity 分析。
未来方向
作者明确提出的方向:处理违反几何分布假设的角落案例,推广吞吐模型的适用范围。基于本文成果可延伸的方向:其一,把 route-send-receive 接口扩展到 MoE 专家路由,用同一运行时统一 token 级模型路由与层内专家路由两类细粒度调度;其二,针对三个及以上模型的 ME 式集成(目前每模型独占一张 GPU)研究 subserver 拓扑与批量传输,探索共享 KV 缓存降低切换成本;其三,把 DTMC 模型推广到马尔可夫调制等非几何切换间隔,并支持在线参数估计与 $B^*$ 自适应;其四,与投机解码结合——大模型只验证路由决策存疑的片段,进一步压低大模型调用频次;其五,研究 SLO 感知调度与多租户公平性,把延迟凑批与优先级队列统一到同一调度框架;其六,在开放式生成、多轮 agentic 与长上下文任务上系统验证 token 级路由的质量-成本 Pareto 前沿,目前质量评测仅覆盖 AMC23/AIME 数学推理场景。
复现评估
复现条件较好。代码已在 GitHub 开源(thu-nics/TokenRouter),实现基于 SGLang;R2R 可直接使用官方路由器与阈值,R-Stitch 官方未开源但论文给出熵阈值 $\tau=0.03$ 与完整接口代码示例(Figure 3),CITER 需自行训练路由器($\tau=0.98$),Co-LLM 需微调 Qwen3-0.6B($\eta=0.15$),ME 设集成权重 0.5/0.3/0.2。评测模型全部为开源的 Qwen3-0.6B/1.7B/4B/8B/32B,工作负载使用公开的 AIME2024、SWE-Smith、AMC23 数据集,数据门槛低。主要成本是算力:完整复现需 8×A100-80G(LLM 张量并行 2 卡、经 CUDA MPS 与 SLM 共享 GPU),缩小规模(如 0.6B+8B 各占一卡)可在单机双卡验证核心机制;延迟凑批阈值 $B^*$ 的 DTMC 推导在附录 D,正文未给出解析式的完整推导细节,复现调度器时需仔细对照附录。总体复现难度中等,关键是环境对 CUDA MPS 与扩展 CUDA Graph 的支持。
论文图表