文本中的混沌:揭示混合模态检索器中的模态偏好 Chaos in the Text: Revealing the Modality Preference in Mixed-Modality Retrievers
检索器系统性高估文本分数致混合语料检索失稳,Trident以共享softmax多正例对比学习修复
前置知识
稠密检索与 NDCG@10
稠密检索用神经编码器把查询和文档映射为向量,按余弦相似度对候选统一排序。NDCG@10 衡量排序列表前 10 位的质量:既看相关文档是否进入前列,也按位置给予折扣得分,是检索研究的标准报告指标。
全文所有结论(V 形曲线、混沌现象、Trident 的提升幅度、干涉率的影响)都以 NDCG@10 度量,不理解该指标就无法解读实验数字。
InfoNCE 对比学习目标
对比学习把匹配的查询-文档对作正例、其余文档作负例,用 softmax 推高正例概率:$\mathcal{L}=-\log\frac{\exp(sim(q,d^+)/\tau)}{\sum_j \exp(sim(q,j)/\tau)}$,$\tau$ 为温度。它只约束正例分数高于负例。
Trident 的核心改动正是把 InfoNCE 从各模态独立归一化改为共享归一化并扩展为多正例版本;理解原目标的这个盲点,才能理解创新点为何成立。
双塔 CLIP 与 VLM 统一嵌入
CLIP 类模型(CLIP、SigLIP、Jina-CLIP-v2)用独立的文本塔和图像塔分别编码,再在共享对齐空间中比较;VLM 类模型(Qwen3-VL-Embedding、UniME)用单一 Transformer 处理交错的文本与图像 token,直接输出统一向量。
论文在两类架构上同时验证现象与方案,并发现 VLM 因 token 空间统一、经训练后曲面几乎完全平坦,而双塔仍有残余波动——架构差异是解读实验对比的关键背景。
模态鸿沟 vs 模态偏好
模态鸿沟(modality gap)指对比训练后文本与图像嵌入在超球面上占据两个分离锥体的几何现象;模态偏好(modality preference)是本文提出的排序层面概念:模型给文本表示系统性更高的相似度分数,使无关文本能反超相关图像。
论文最重要的概念贡献是区分二者:几何鸿沟在单模态候选池中因偏移抵消而无害,模态偏好才真正腐蚀混合语料的排序,理解这对概念才能抓住论文的立论逻辑。
研究动机
现有多模态检索器(CLIP-ViT-L/14、SigLIP2、Jina-CLIP-v2、Qwen3-VL-Embedding-2B/8B、VisRAG-Ret、UniME 等)的训练与评测几乎都建立在单模态语料上:BEIR、MTEB 及 ChartQA、SlideVQA 等文档基准要么纯文本要么纯图像。但真实语料往往同时含纯文本、纯图像和图文融合文档,要求检索器跨模态比较相关性并在统一列表中排序。论文用模态替换协议量化风险:把图像文档逐步替换为语义等价的文本描述后,多个模型在 ChartQA 和 SlideVQA 上的 NDCG@10 均呈明显 V 形——纯图像库和纯文本库表现好,两模态共存时跌入谷底。更严重的是文本中的混沌:向纯图像语料加入最多 20 万条来自 Wikipedia 的无关文本后,Qwen3-VL-E-8B 在 SlideVQA 上平均 NDCG@10 暴跌 0.51、Jina-CLIP-v2 下跌 0.47,而加入 5 万张同样无关的图像影响却小得多;Jina-CLIP-v2 上 94.6% 的查询其相关图像正例被无关文本负例反超,真正含答案的图像被挤出 Top-K。
本文的目标是本文目标分三层。第一,系统量化:构造文本、图像、融合三类文档比例可自由组合的混合语料,扫描完整配比空间绘制性能曲面,回答混合语料检索到底有多不可靠。第二,定位根因:为每篇文档构造语义等价的三种模态表示(文本描述、原图、图文融合),对同一查询对比三者的相似度分布,检验排序是否真的只由语义相关性决定,把现象归因到模态偏好——模型给文本表示系统性更高的分数,即使只看正样本对也是如此。第三,给出修复:提出 Trident 训练框架,通过模态平衡数据构造与多正例视图 InfoNCE,在 CLIP 双塔与 VLM 两类架构上同时消除该偏好,使混合语料检索对模态配比和文本干扰不再敏感,且不牺牲、甚至提升单模态检索性能。
与已有工作不同的是,以往研究模态鸿沟的工作(Liang et al. 2022 起)只做几何测量,且在跨模态对齐任务上评估——那里所有候选同模态,模态间的均匀偏移在排序中会相互抵消,因此无害。GR-CLIP 等事后校准方法虽专门针对混合检索,但依赖在大规模领域参考语料上预计算模态统计量,迁移性差,论文实验显示校准后 V 形退化模式依旧存在,只是幅度缩小。本文的独特之处在于把问题从嵌入几何转移到混合候选池中的分数可比性:用模态替换协议、三维性能曲面、干扰递增实验、正例-硬负例散点图层层递进,证明腐蚀排序的不是几何鸿沟而是模型内部的模态偏好;并进一步从理论上指出,各模态独立归一化的 InfoNCE 对模态内统一分数偏移不变,原理上无法约束跨模态分数基线,从而把解法落到训练目标层面而非事后修补。
核心方法
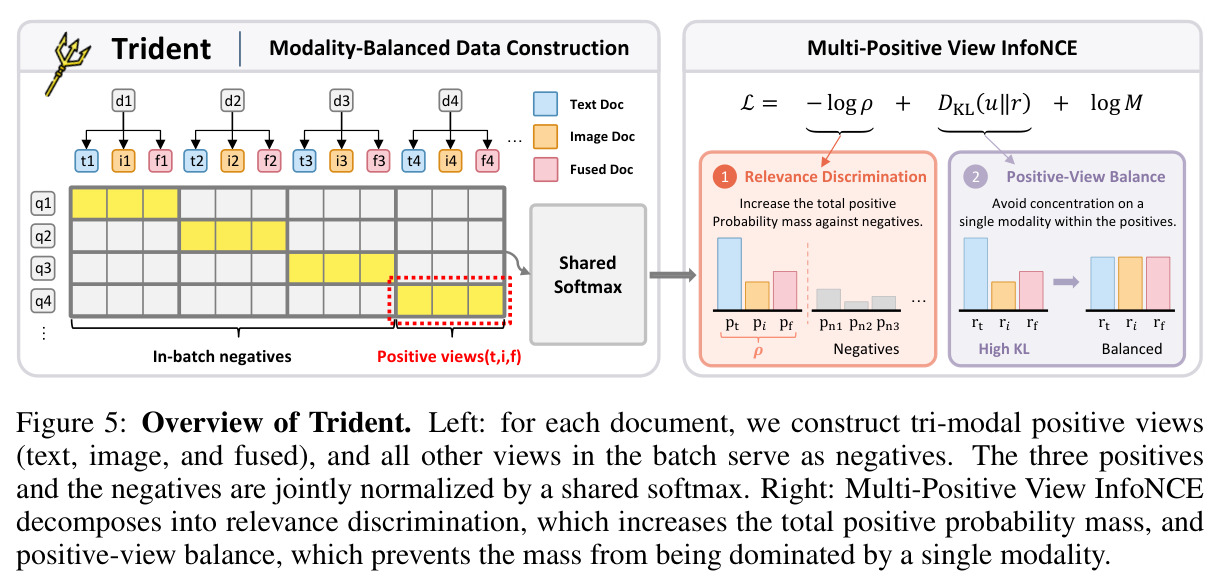
直觉上,一篇文档无论以文本、图像还是图文形式呈现,它与查询的相关性应当相同,排序不应因其模态而变。Trident 沿数据和目标两条线落实这一原则。数据侧是模态平衡数据构造:用 Qwen3-VL-235B-A22B-Instruct 为每张图像文档生成一段详细描述和一段简短摘要,详细描述构成 Text 视图、原图构成 Image 视图、摘要配原图构成 Fused 视图,三个视图与同一查询配对、作为地位等同的正例。目标侧是多正例视图 InfoNCE:$\mathcal{L}_{trident}(q) = -\frac{1}{|\mathcal{P}|}\sum_{p\in\mathcal{P}}\log\frac{\exp(sim(q,p)/\tau)}{\sum_{j\in\mathcal{P}\cup\mathcal{N}}\exp(sim(q,j)/\tau)}$,把三个正例视图与批内负例放进同一个 softmax 竞争空间。这样在把相关文档与无关文档分开的同时,阻止正例概率质量集中到最容易匹配的文本模态上,把模态平衡的监督信号转化为对跨模态相对分数的显式约束,从机制上抑制模态偏好。
核心创新是共享归一化。若每个模态各自用独立归一化的 InfoNCE 训练,给该模态所有候选分数加同一偏移 $c_m(q)$ 后 softmax 概率完全不变(式 3),即模态间的分数基线在原理上不可学习、不可约束——这正是模态偏好能存活的结构性原因。Trident 把三个正例与批内负例放进同一个 softmax,目标可精确分解为 $\mathcal{L}_{trident}(q) = \underbrace{-\log\rho}_{\text{relevance disc.}} + \underbrace{D_{KL}(u\|r)}_{\text{view balance}} + \log M$,其中 $\rho$ 是正例总概率质量,$r_m$ 是视图 $m$ 在正例内的份额,$u$ 是均匀分布。梯度分析显示:概率低于 $1/M$ 的正例分数被推高、过高的被压低,高分的无关文本负例受到与其分数成正比的更强惩罚。这与各模态单独训练、GR-CLIP 事后校准有本质区别:只有训练时共享候选空间,才能同时约束模态内排序与跨模态分数基线,让语义相关性而非文档模态决定排名。
方法步骤详情
流程分五步。第一步,视图生成:对训练集 OpenDocVQA 的 41k 样本中每张图像文档,调用 Qwen3-VL-235B-A22B-Instruct 生成详细描述与简短摘要,构造 Text/Image/Fused 三视图。第二步,配对:每个查询与同一文档的三个视图构成正例,批内其余视图充当负例,训练时做跨 GPU 负例共享与假负例屏蔽。第三步,优化:以 $M=3$ 的多正例视图 InfoNCE 训练;Qwen3-VL-2B 骨干用 last-token 池化与检索指令模板,仅对语言塔加 LoRA、视觉塔冻结;jina-clip-v2 双塔全参数微调,Fused 视图用文本与图像嵌入等权平均融合;在 8×A100-80GB 上以 bfloat16 训练 1 个 epoch。第四步,推理:查询与三类文档视图分别编码,按余弦相似度在共享候选池统一排序。第五步,评测:Origin 在六个视觉文档基准各自原始纯图像库上检索;Mix 把六库转为混合模态后合并为统一候选池;另在四个自然图像基准上验证泛化。
技术新颖性
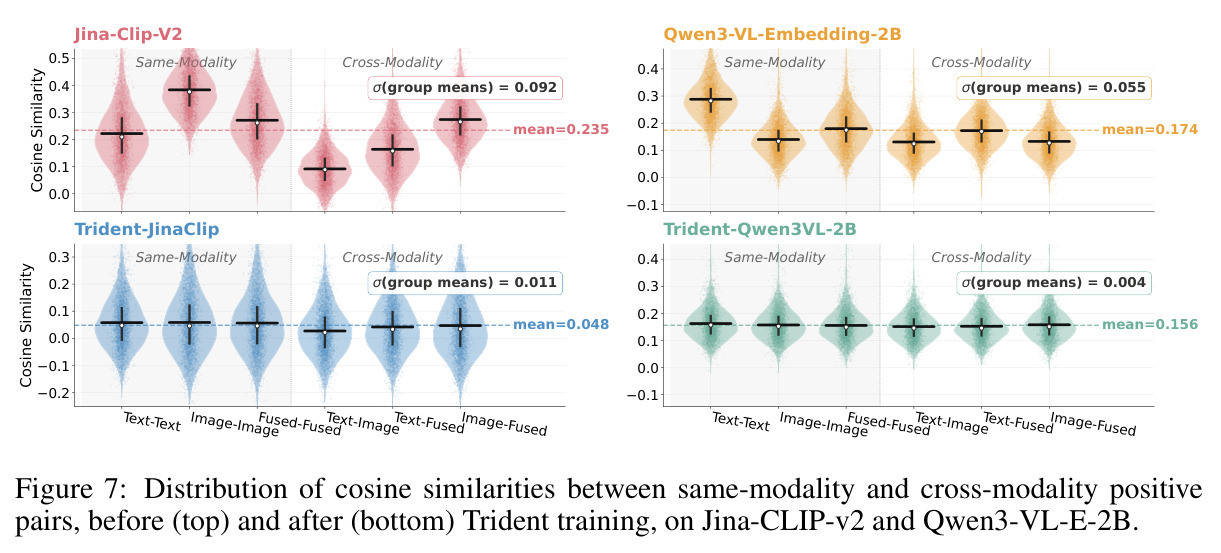
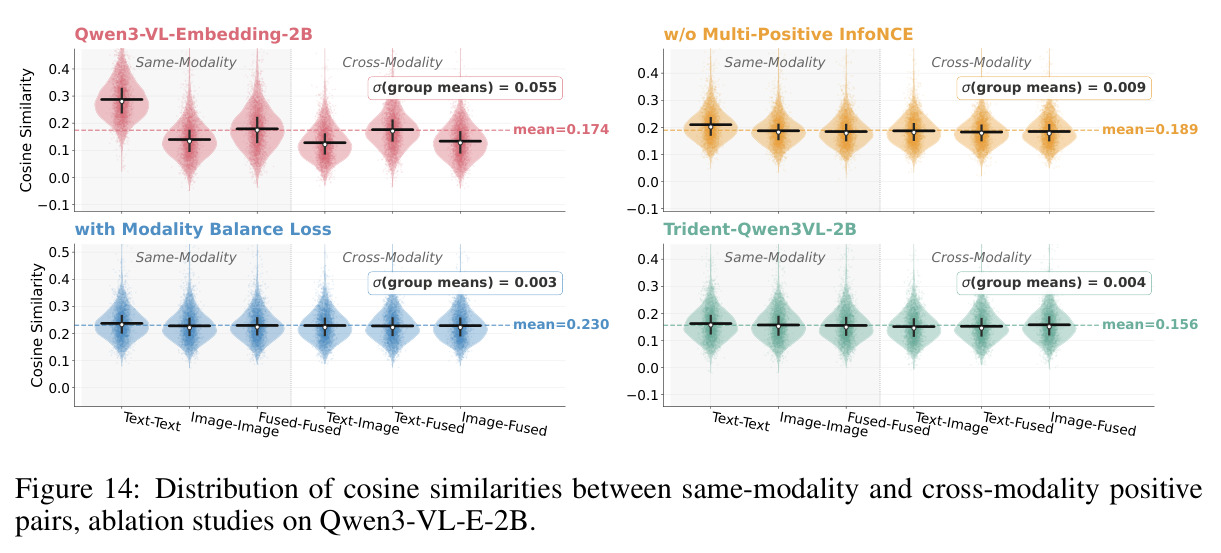
新颖性有四点。其一,正例轴的选取:多正例在检索中并不罕见(多个相关文档、多种查询表述),但把同一文档的不同模态表示作为共等正例、专门用于对冲模态偏见是新的。其二,目标层面的理论刻画:把共享 softmax 的多正例 InfoNCE 精确分解为相关性判别与正例视图平衡两项,并给出正例/负例分数梯度的闭式解,说明该目标自动实现扶弱抑强,无需显式平衡损失——加权重 $w=200$ 的显式 Modality Balance Loss 把视图相似度标准差进一步压到 0.003,最终 NDCG 反而略低于 $w=0$ 的 0.004 水平,说明平衡概率质量不同于强行拉平相似度。其三,数据级与目标级互补:仅做平衡数据构造即可把六组相似度均值的标准差从 0.055 降到 0.009,加上共享目标进一步降到 0.004。其四,与 GR-CLIP 事后校准的系统对照,证明只有训练时的约束才能根治跨模态分数基线漂移。
实验结果
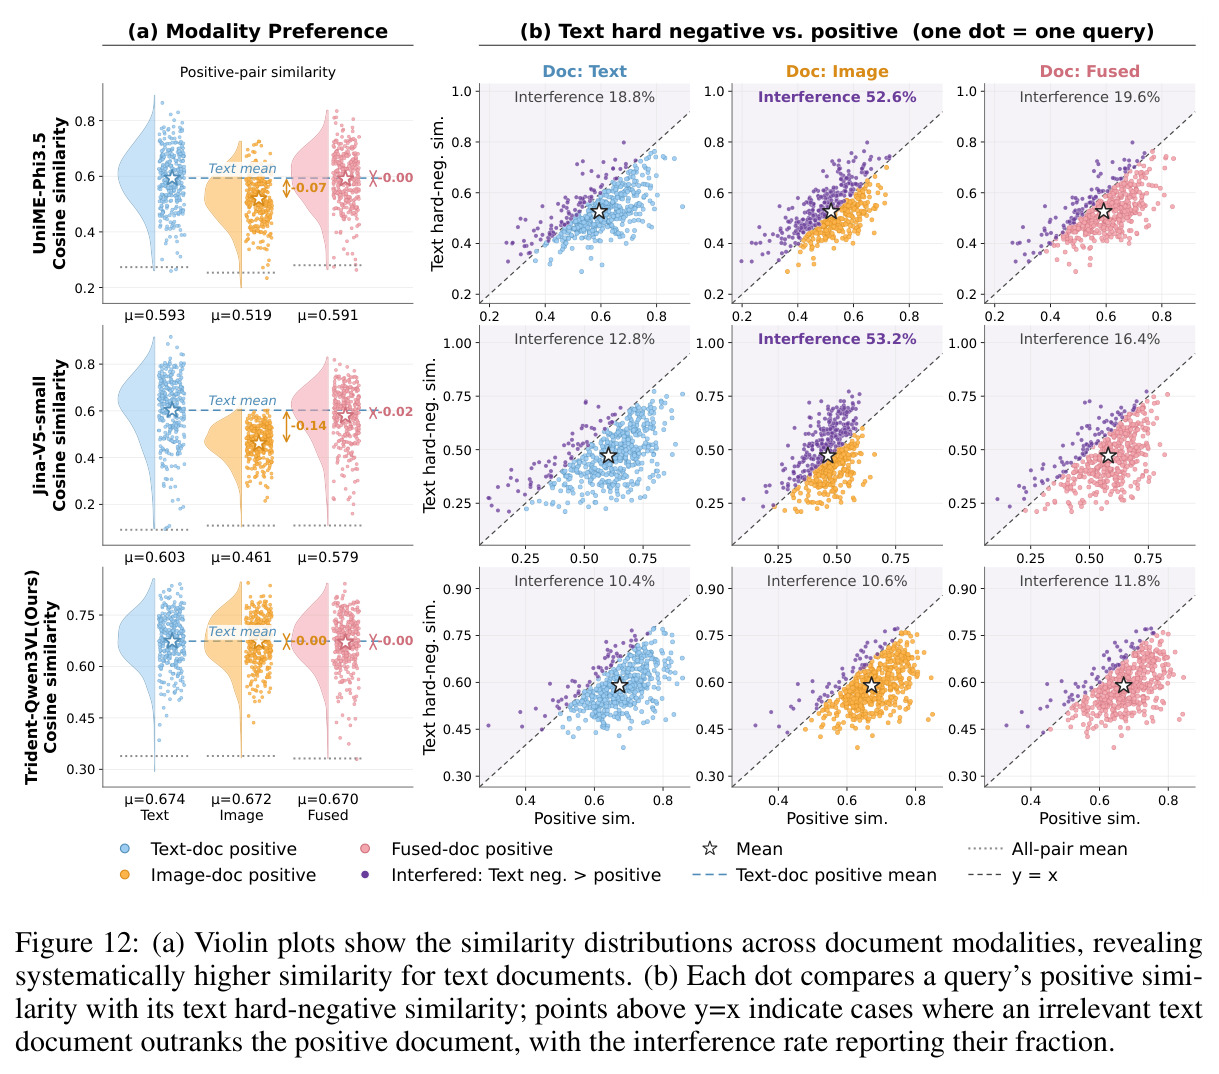
诊断有三。一,V 形曲面:图像文档被语义等价文本替换后,NDCG@10 在混合配比处跌入谷底(Fig.2)。二,文本混沌:加 20 万条无关文本使 Qwen3-VL-E-8B 在 SlideVQA 的平均 NDCG@10 下降 0.51,5 万张无关图像影响远小(Fig.3)。三,模态偏好:正例相似度均值 text/image/fused 为 Jina-CLIP-v2 的 0.531/0.308/0.494、Qwen3-VL-E-2B 的 0.664/0.484/0.510,图像正例被文本硬负例反超率达 94.6%/87.8%(Fig.4)。修复:Trident-Qwen3VL-2B 六基准 Mix 平均 NDCG@10 达 73.90(基线 40.12),Trident-JinaCLIP 达 55.51(基线 42.68),2B 即超 8B 的 47.17;Origin 不降反升(80.51 vs 77.59);消融后 Mix 跌到 66.36(Table 1)。训练后干涉率降至约 11%、σ 降至 0.004(Fig.12/14);自然图像上 Mix 平均亦领先(Table 4)。
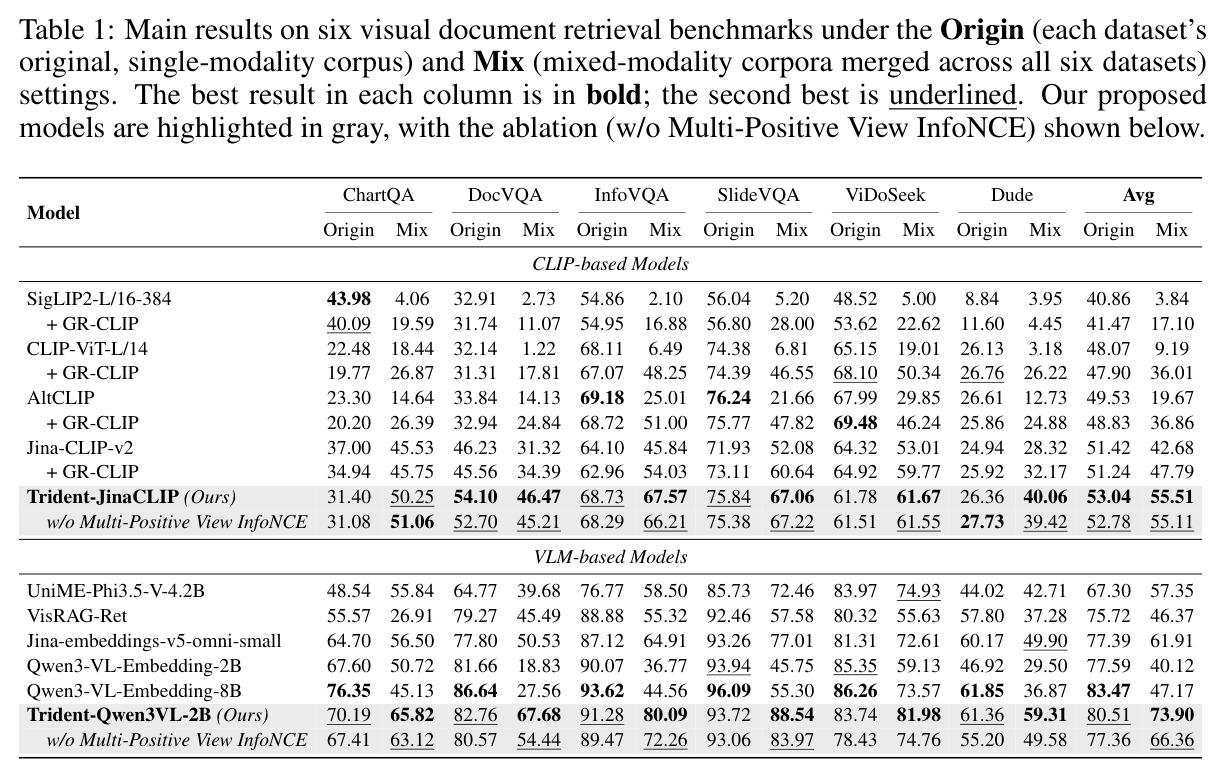
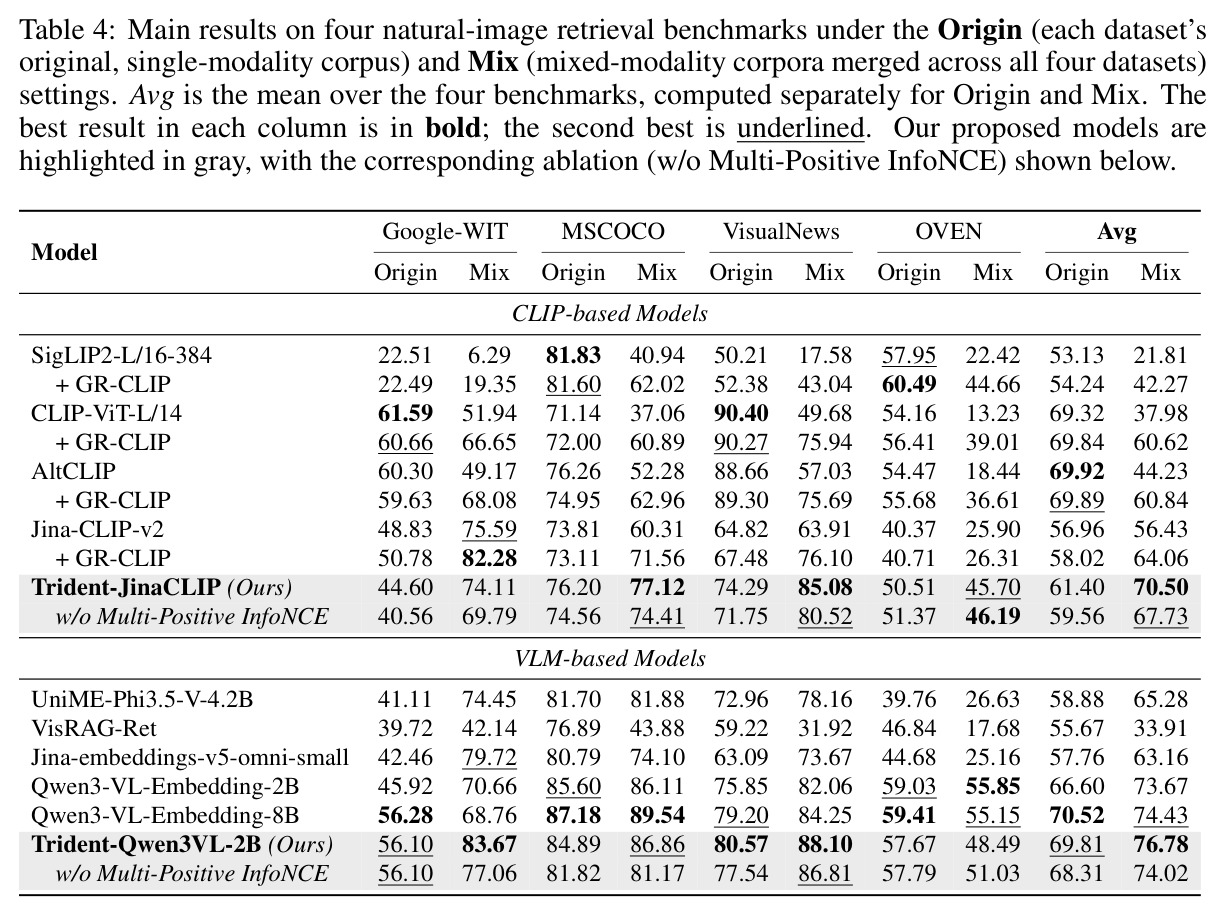
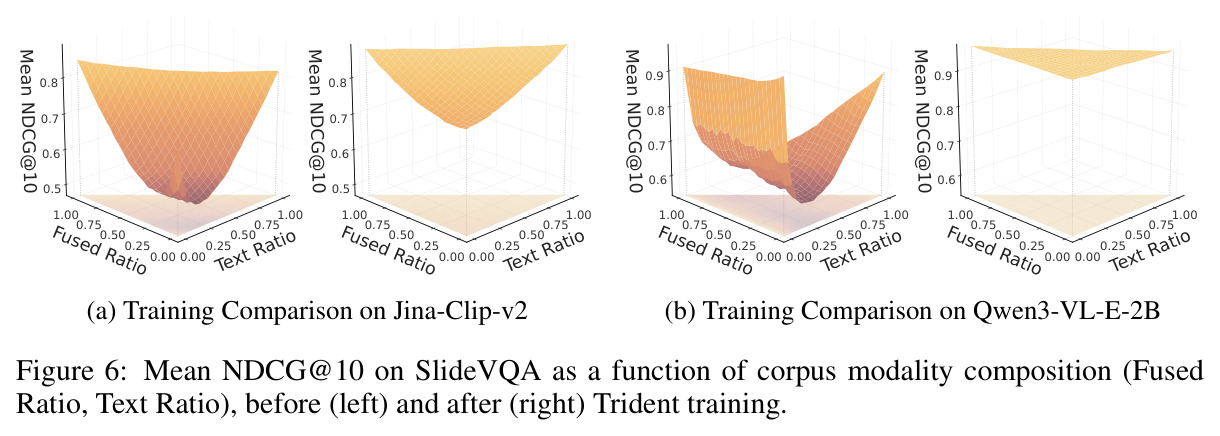
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 视觉文档检索,六基准合并 Mix 语料(VLM 类) | NDCG@10 平均 | 73.90(Trident-Qwen3VL-2B) | 40.12(Qwen3-VL-Embedding-2B);最强外部基线 Jina-embeddings-v5-omni-small 为 61.91,8B 模型为 47.17 | 对直接基线 +33.78,对最强基线 +11.99,且以 2B 规模超过 8B 模型 |
| 视觉文档检索,六基准合并 Mix 语料(CLIP 类) | NDCG@10 平均 | 55.51(Trident-JinaCLIP) | 42.68(Jina-CLIP-v2);GR-CLIP 事后校准后 47.79 | 对基线 +12.83,对 GR-CLIP +7.72 |
| 视觉文档检索,六基准原始单模态语料 Origin(VLM 类) | NDCG@10 平均 | 80.51(Trident-Qwen3VL-2B) | 77.59(Qwen3-VL-Embedding-2B) | +2.92,单模态性能不降反升 |
| 自然图像检索,四基准 Mix 语料(CLIP 类) | NDCG@10 平均 | 70.50(Trident-JinaCLIP) | 56.43(Jina-CLIP-v2) | +14.07 |
| 自然图像检索,四基准 Mix 语料(VLM 类) | NDCG@10 平均 | 76.78(Trident-Qwen3VL-2B) | 73.67(Qwen3-VL-Embedding-2B) | +3.11 |
| 相关图像正例被无关文本硬负例反超的干涉率(SlideVQA) | Interference rate | 11.8%(Trident-Qwen3VL-2B,图像正例) | 87.8%(Qwen3-VL-E-2B);UniME-Phi3.5 为 52.6%,Jina-V5-small 为 53.2% | 较直接基线降低 76.0 个百分点,三视图干涉率趋于一致(10.4%/11.8%/11.8%) |
局限与改进
作者承认的局限:其一,CLIP 双塔架构即使经 Trident 训练,InfoVQA 和 DocVQA 上的性能曲面仍有轻微波动,因为文本与图像经分离编码器仅靠共享嵌入空间对齐,彻底的模态不变性难以达成,而 VLM 骨干曲面几乎完全平坦;其二,自然图像实验中 Origin 到 Mix 的变化混合了数据集特性与鲁棒性(自然图像语义稀疏,语义等价的文本替代反而更易检索),只能靠同一 Mix 语料上的横向比较判断;其三,视图构造依赖生成模型的质量。我的补充观察:第一,Text 视图是图像的有损压缩,描述可能遗漏查询所需细节甚至产生幻觉,语义等价假设并不严格成立;第二,三视图生成依赖 235B 级大模型,成本与质量风险都系于此;第三,CLIP 侧 Fused 视图仅用 0.5/0.5 嵌入平均,表示能力偏弱;第四,索引需为每篇文档存最多三个向量,检索系统存储膨胀近三倍;第五,评测仅报告 NDCG@10,未覆盖大 K 召回与端到端 RAG 下游效果。
独立分析的弱点
独立分析四点弱点。第一,视图生成瓶颈:若目标领域高度专业化(医学影像、财报图表),通用大模型的描述会漏掉关键数值与符号,Text/Fused 视图质量下降会直接污染训练信号——改进方向是用领域 OCR 与表格解析器合成描述,或对描述做查询覆盖度过滤与多模型集成。第二,索引开销:三视图意味着每文档最多三个向量,亿级文档库的向量存储与检索延迟都会近三倍增长——可蒸馏出单视图学生模型,或结合 Matryoshka 截断与向量量化压缩(论文只做了维度截断实验,未报告存储-精度联合优化)。第三,负例规模差距:训练用批内负例(跨 GPU 共享),而混沌现象在 20 万干扰规模下才充分暴露,训练时的负例压力远小于真实语料——应引入大规模硬负例挖掘或负例缓存库,进一步压低文本负例的分数上限。第四,视图族不完备:现实语料还有表格、幻灯片、视频帧、音频转写等形态,三视图框架虽在公式上支持任意 $M$,但哪些视图组合最优、视图间信息冗余如何处理尚无答案——可研究视图自动选择与自适应加权。此外,显式平衡损失无效的发现暗示最优解在概率分配而非相似度对齐,值得更细致的机理研究。
未来方向
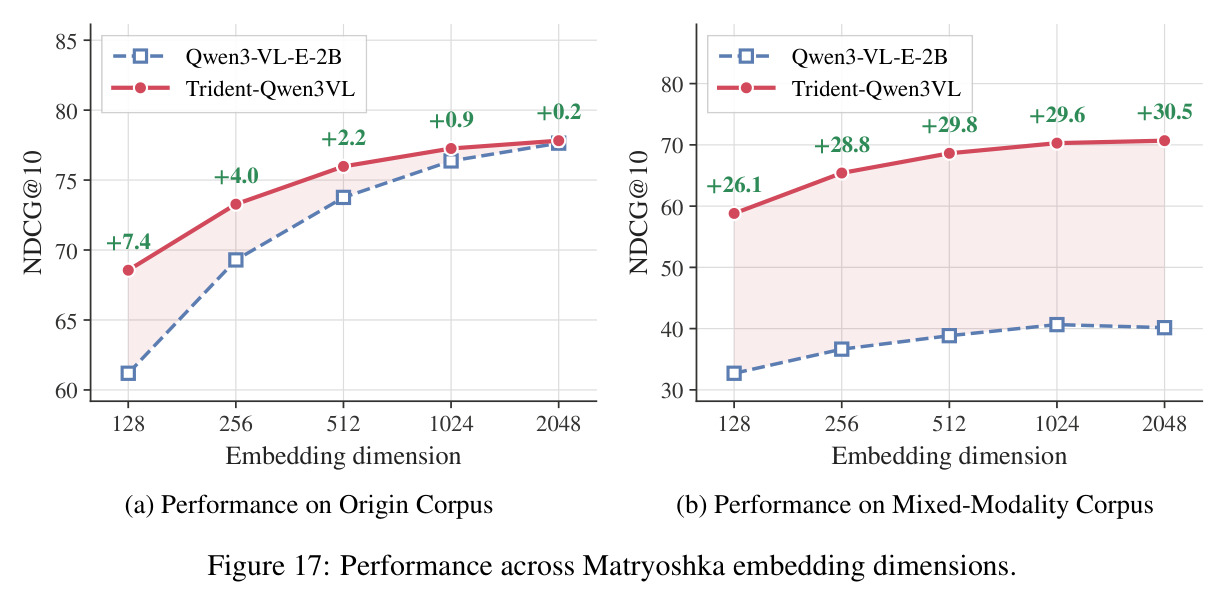
论文直接指向的方向:一是架构层面,作者发现 VLM 统一 token 空间比双塔更适合实现模态无关检索,暗示下一代通用嵌入模型应优先考虑统一骨干;二是 Matryoshka 实验中低维下 Trident 优势更大(128 维 Mix 领先 26.1~30.5),说明消除模态偏好后的表示更紧凑,可与表示学习理论结合深入研究。基于成果可延伸的方向:把视图族从文本/图像/融合扩展到视频、音频、表格、UI 截图等,验证 $M\ge 3$ 时多正例 InfoNCE 的缩放行为;与 reranker 级联,考察首轮排序稳定性对精排的影响;在真实生产级混合语料(企业文档库、网页)上做端到端 RAG 评测;从理论上刻画模态偏好的成因——是否源于预训练语料的模态信息不平衡或对比温度设定,能否在预训练阶段预防而非仅在微调时矫正;以及把共享归一化多正例思想迁移到多知识库、多语言等异质候选池排序问题。
复现评估
复现条件总体较好。代码已在 GitHub(OpenBMB/Trident)开源;训练数据 OpenDocVQA(41k 样本)公开;两个骨干(Qwen3-VL-2B-Instruct、jina-clip-v2)均为公开权重;训练配置完整披露(Table 2/3:LoRA $r=32$、$\alpha=64$,1 epoch,学习率 $1\times10^{-4}$ 余弦调度,每卡 batch 8、梯度累积 2,bfloat16)。主要门槛有三:其一,视图生成需调用 Qwen3-VL-235B-A22B-Instruct 为 41k 图像文档各生成描述与摘要,大模型推理成本不低;其二,训练需 8×A100-80GB,虽然 2B 骨干只用 LoRA 且视觉塔冻结,个人研究者难以原样复现,但缩小数据规模、单卡 LoRA 的降配版本应当可行;其三,混合模态评测语料需按论文协议自行采样构造(生成描述与摘要后按比例采样视图),自然图像侧可直接采用 MixBench 混合库。总体难度中等:流程与超参清晰,算力与视图生成是主要障碍。
论文图表
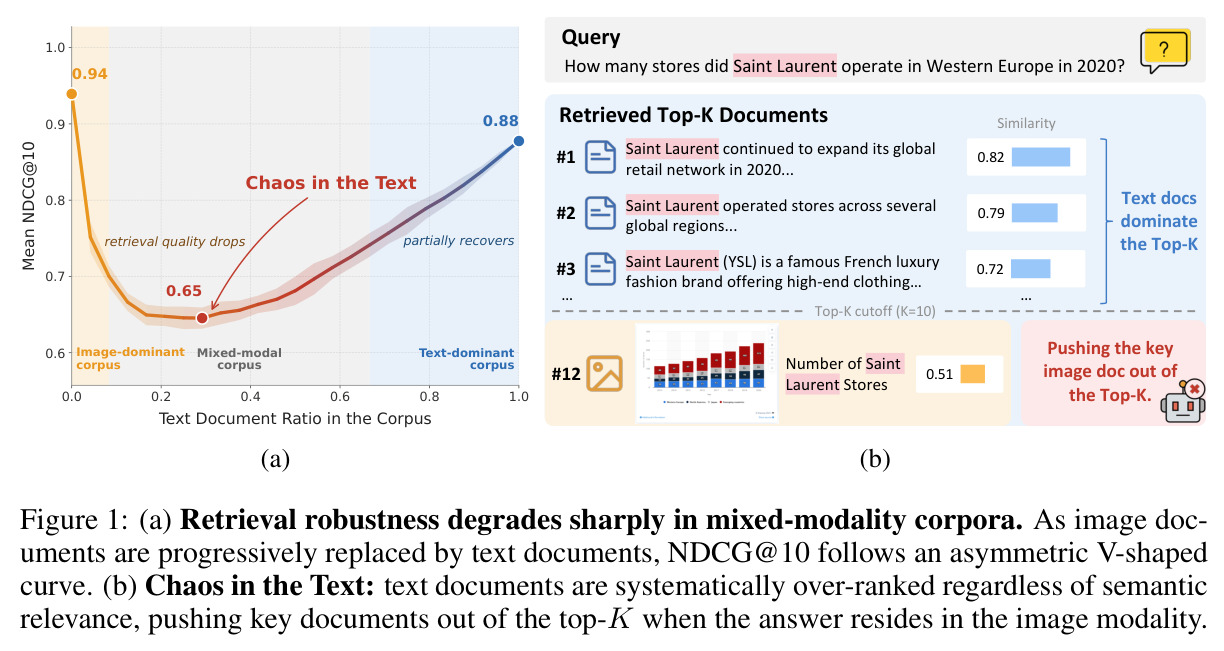
(a) 展示随语料中文档比例从纯图像过渡到纯文本,平均 NDCG@10 呈不对称 V 形曲线,在混合区间跌入谷底;(b) 以 Saint Laurent 门店数查询为例,展示 Top-10 检索结果中无关文本文档(相似度 0.82/0.79/0.72 等)占据前列,而含答案的关键图像文档(相似度 0.51)被挤出 Top-K,直观呈现混沌现象。
这是全文的开篇图,同时给出两个核心现象:V 形退化曲线和 Chaos in the Text 的具体案例,是理解问题动机的最快入口。
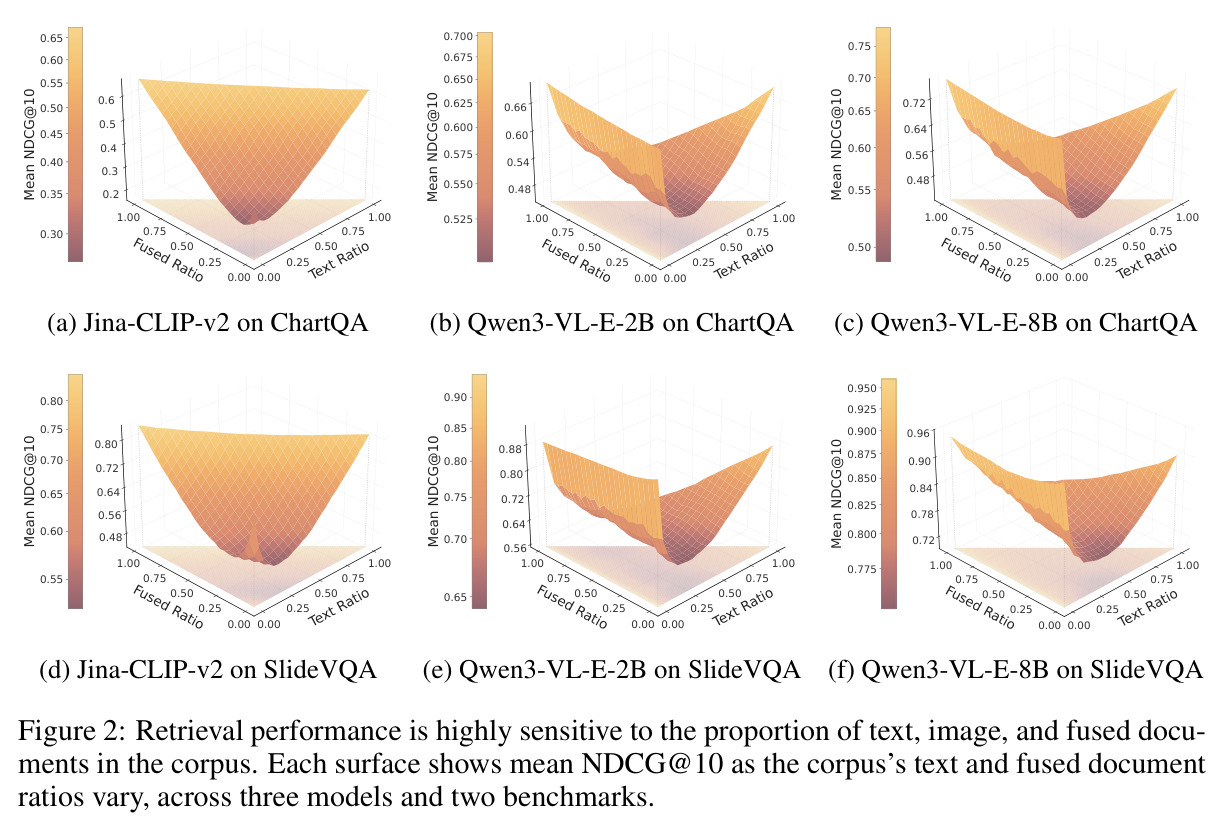
以三维曲面展示 Jina-CLIP-v2、Qwen3-VL-E-2B/8B 在 ChartQA 和 SlideVQA 上,语料的文本比例与融合比例扫描全空间时的平均 NDCG@10。六个曲面都出现明显谷底(混合区间),而提高融合文档比例不引发 V 形退化反而缓解下降。
提供最系统的量化证据,说明退化不是个别模型的怪癖而是跨架构、跨规模的普遍现象,并揭示融合文档与纯文本文档的截然不同影响。
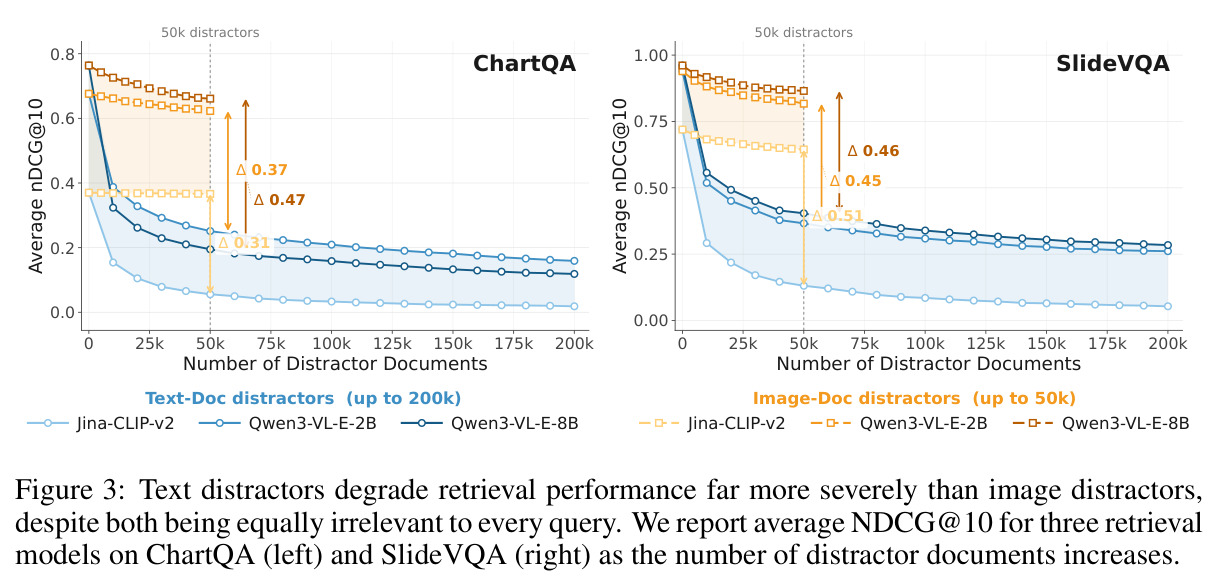
从纯图像语料出发,分别加入最多 20 万条无关文本文档和 5 万张无关图像,跟踪平均 NDCG@10 的变化。三个模型的文本干扰曲线均急剧下跌(Jina-CLIP-v2 降 0.47、Qwen3-VL-E-2B 降 0.37、Qwen3-VL-E-8B 在 SlideVQA 降 0.51),而图像干扰影响平缓,两条曲线的差距 Δ 随干扰数量扩大。
这是命名词 Chaos in the Text 的关键实验:同为无关干扰,文本的破坏力远超图像,直接指向模型存在跨模态的系统性打分偏差。
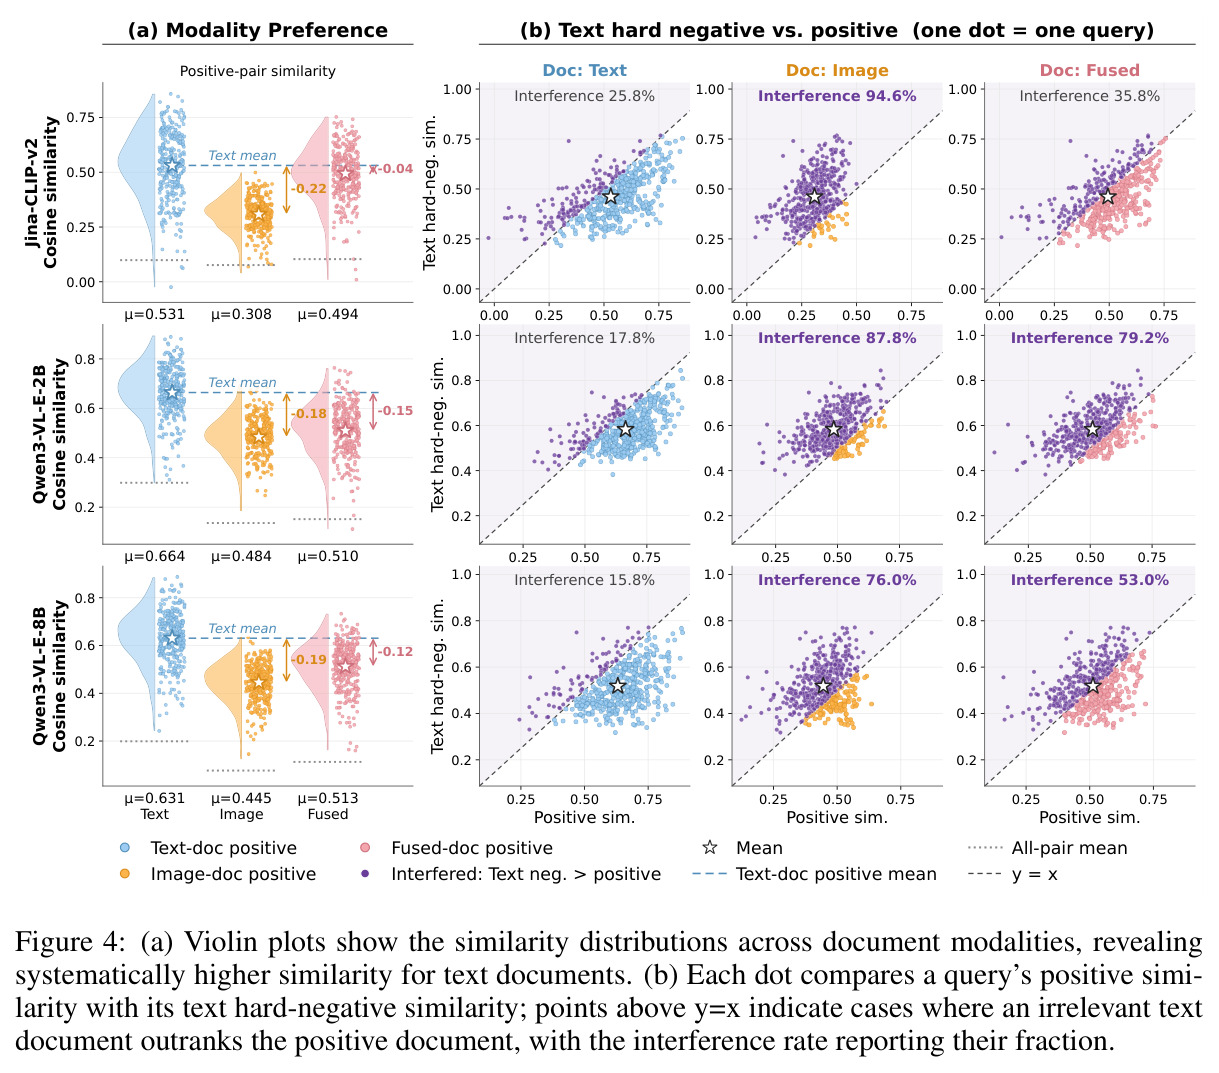
(a) 小提琴图显示三个模型对同一查询集的正例相似度分布:文本视图均值最高(如 Qwen3-VL-E-2B 的 0.664 vs 图像 0.484、融合 0.510)。(b) 散点图逐查询对比正例相似度与文本硬负例相似度,对角线上方的点表示无关文本反超相关文档;图像正例的干涉率达 94.6%(Jina-CLIP-v2)、87.8%(Qwen3-VL-E-2B)、76.0%(Qwen3-VL-E-8B)。
把现象归因到机制的证据图:证明即使只看相关样本对,分数也系统性依赖模态;且这种偏差能直接颠覆相关与无关文档的排序,而不只是均值漂移。