Memento 3:基于反思式规则书的模型化递归自我改进 Memento 3: Model-Based Recursive Self-Improvement through Reflective Rulebooks
冻结LLM把环境规则写成自然语言规则书并编译为可执行世界模型,靠预测误差循环修订实现递归自我改进。
前置知识
贝叶斯自适应POMDP(Bayes-adaptive POMDP)
部分可观测马尔可夫决策过程(POMDP)用元组 $M=\langle S, A, O, T, \rho, G\rangle$ 描述智能体只能看到观测 $o_t=\rho(s_t)$、看不到真实状态的环境。贝叶斯自适应版本进一步把『环境规则本身未知』纳入不确定性:增广隐藏状态是 $(s_t, m^\star)$,其中 $m^\star$ 是真实的转移/观测/目标模型,信念 $b_t(s,m)=\Pr(s_t=s, m^\star=m \mid H_t)$ 同时刻画对当前状态和世界规则的双重不确定。
本文把『在陌生环境中边交互边学规则』形式化为对该联合信念的推断与近似,而方法的核心产物(规则书+可执行模型+重放验证)正是对这个信念的确定性点近似。
版本空间与最小描述长度(MDL)
有限的交互历史通常对应一整族都能解释全部观测的程序,称为版本空间;它们在已见状态上一致、在未见状态上预测各异。最小描述长度原则主张在同等解释力的假设中选描述最短者,形式上等价于取先验 $\mu_0(\psi,\theta)\propto 2^{-L(\psi)-L(\theta\mid\psi)}$ 下的最大后验(MAP)估计。
论文反复强调『重放一致不等于泛化正确』,作者用MDL偏置做模型选择(SimplifyLLM),又用种群扩展近似保留版本空间,理解这两点是读懂方法动机与局限的关键。
世界模型与模型基强化学习
世界模型是环境的内部模拟器,能在执行动作前预测其后果。模型基RL先从交互数据学出动力学模型(神经网络或程序),再基于模型做规划(想象 rollout、树搜索、MPC),代表工作有 Dyna、Dreamer、EfficientZero 等。代码世界模型(code world model)用可执行程序作模型,可被规划器反复查询、便于人工与自动检验。
本文是 Memento 系列的『模型侧』延续:用程序而非网络参数承载世界模型,规划、验证、反思全部围绕这个可执行模拟器展开;Pong 案例也直接与模型基RL的样本效率对标。
递归自我改进(RSI)
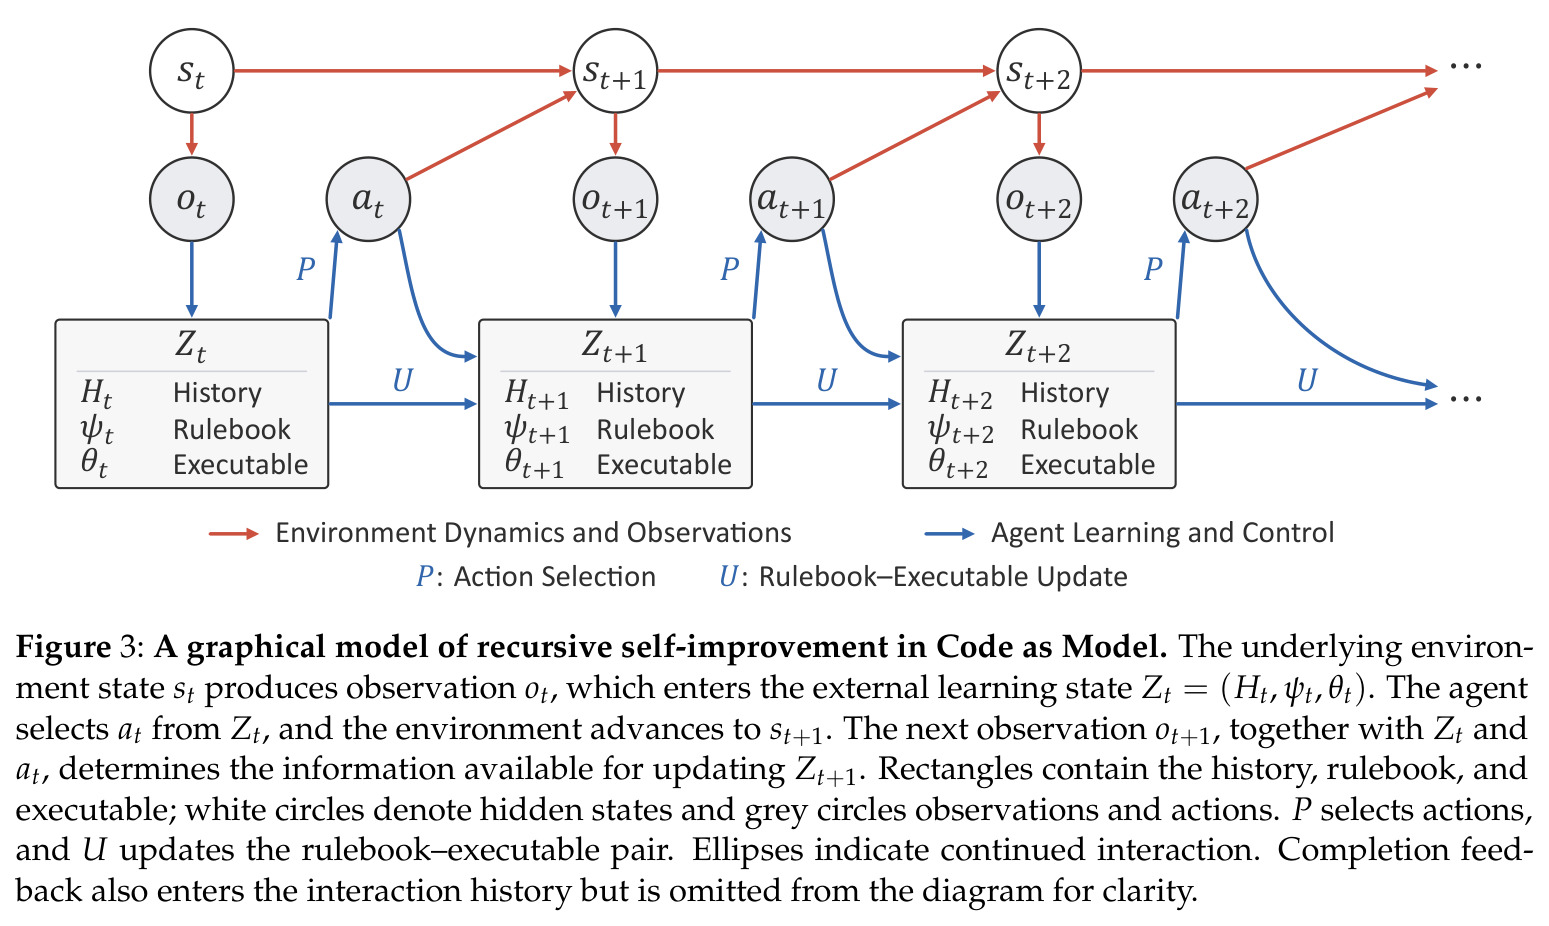
指AI系统自主设计并改进支撑自身推理与学习的组件、后续版本继续这一过程的反馈机制。本文给出一个受限且可实证研究的版本:模型化RSI——智能体用当前世界模型假设 $h_t=(\psi_t,\theta_t)$ 指导规划与探索,探索产生新证据,证据再用于修订出 $h_{t+1}$,如此循环,而底层LLM参数满足 $\phi_{t+1}=\phi_t$,全程冻结。
这是论文标题的落点:被改进的对象不是LLM权重,而是外部记忆中的规则书与代码,理解『冻结底座、进化记忆』这一框架才能把握所谓递归的确切含义与安全讨论的边界。
逐格精确重放(cell-exact replay)
把记录的历史动作在 newly 编译的模型中从头执行一遍,将预测观测与真实记录逐项比对;在 ARC-AGI-3 上要求预测的 $64\times64$ 帧每一个格子都与真实帧完全一致,任何一格不符即判为不合格。它定义了观测似然 $\mathcal{L}_{obs}(h)=\mathrm{verify}(\theta;H_t)$,是一个确定性的通过/失败检验。
这是方法中唯一的『硬』验收标准:新代码必须解释此前全部证据才能被采纳,与LLM对代码-规则书一致性的语义判断互补,共同构成假设接受条件(式11),也决定了该方法目前只适用于确定性环境。
研究动机
在陌生环境里行动的智能体不仅要知道『做什么』,还要知道『我的动作会产生什么后果』。近年兴起的代码世界模型(WorldCoder、GIF-MCTS、ARC-AGI-3 的 baseline1 等)让 LLM 从交互中学出可执行的 Python 动力学程序,用『预测与观测一致』来验证模型。但作者指出一个根本缺陷:有限交互历史只能确定一个版本空间——大量程序都能复现已见转移,却在未见状态上给出不同预测。论文举例:若迄今观测到的墙都在第 7 列,『箱子停在墙边』与『箱子停在第 7 列』两个假设完全兼容同一轨迹,可当墙出现在别处时预测截然不同。重放验证只能否决与证据矛盾的程序,无法在兼容证据的候选中挑出正确的泛化规则;更糟的是,智能体一旦基于某个貌似合理但错误的模型做规划,其行动产生的证据可能永远不暴露模型错误(自我确认)。另一条线索是:Memento 系列此前工作(情景记忆、反思学习、技能记忆)都在改进『策略侧』——学该做什么;而『模型侧』——世界规则本身——仍是空白。
本文的目标是本文的目标是让参数完全冻结的LLM智能体在黑盒交互中持续学习显式的世界模型,并以此研究一条模型化的递归自我改进路线。具体而言:智能体在不被告知环境源代码、规则或任务描述的条件下(ARC-AGI-3 只提供按键/点击接口和 $64\times64$ 像素观测),维护一个可检验、可修订的世界模型假设;用它执行前预测动作后果、在预算内规划到达目标的动作序列;当预测与现实不符时,区分『规则理解错了』与『代码写错了』并相应修订。形式化目标由式(12)给出:在动作预算 $B$ 内最大化到达目标的概率 $p_B=\Pr(\tau_G \le B)$,在成功率相同时最小化条件动作成本 $c_B=\mathbb{E}[\tau_G \mid \tau_G \le B]$;最终在 ARC-AGI-3 的 25 个公开游戏上以不超过人类的动作预算通关全部 183 个关卡,并验证同一机制能否支撑 Pong 这类反馈控制任务。
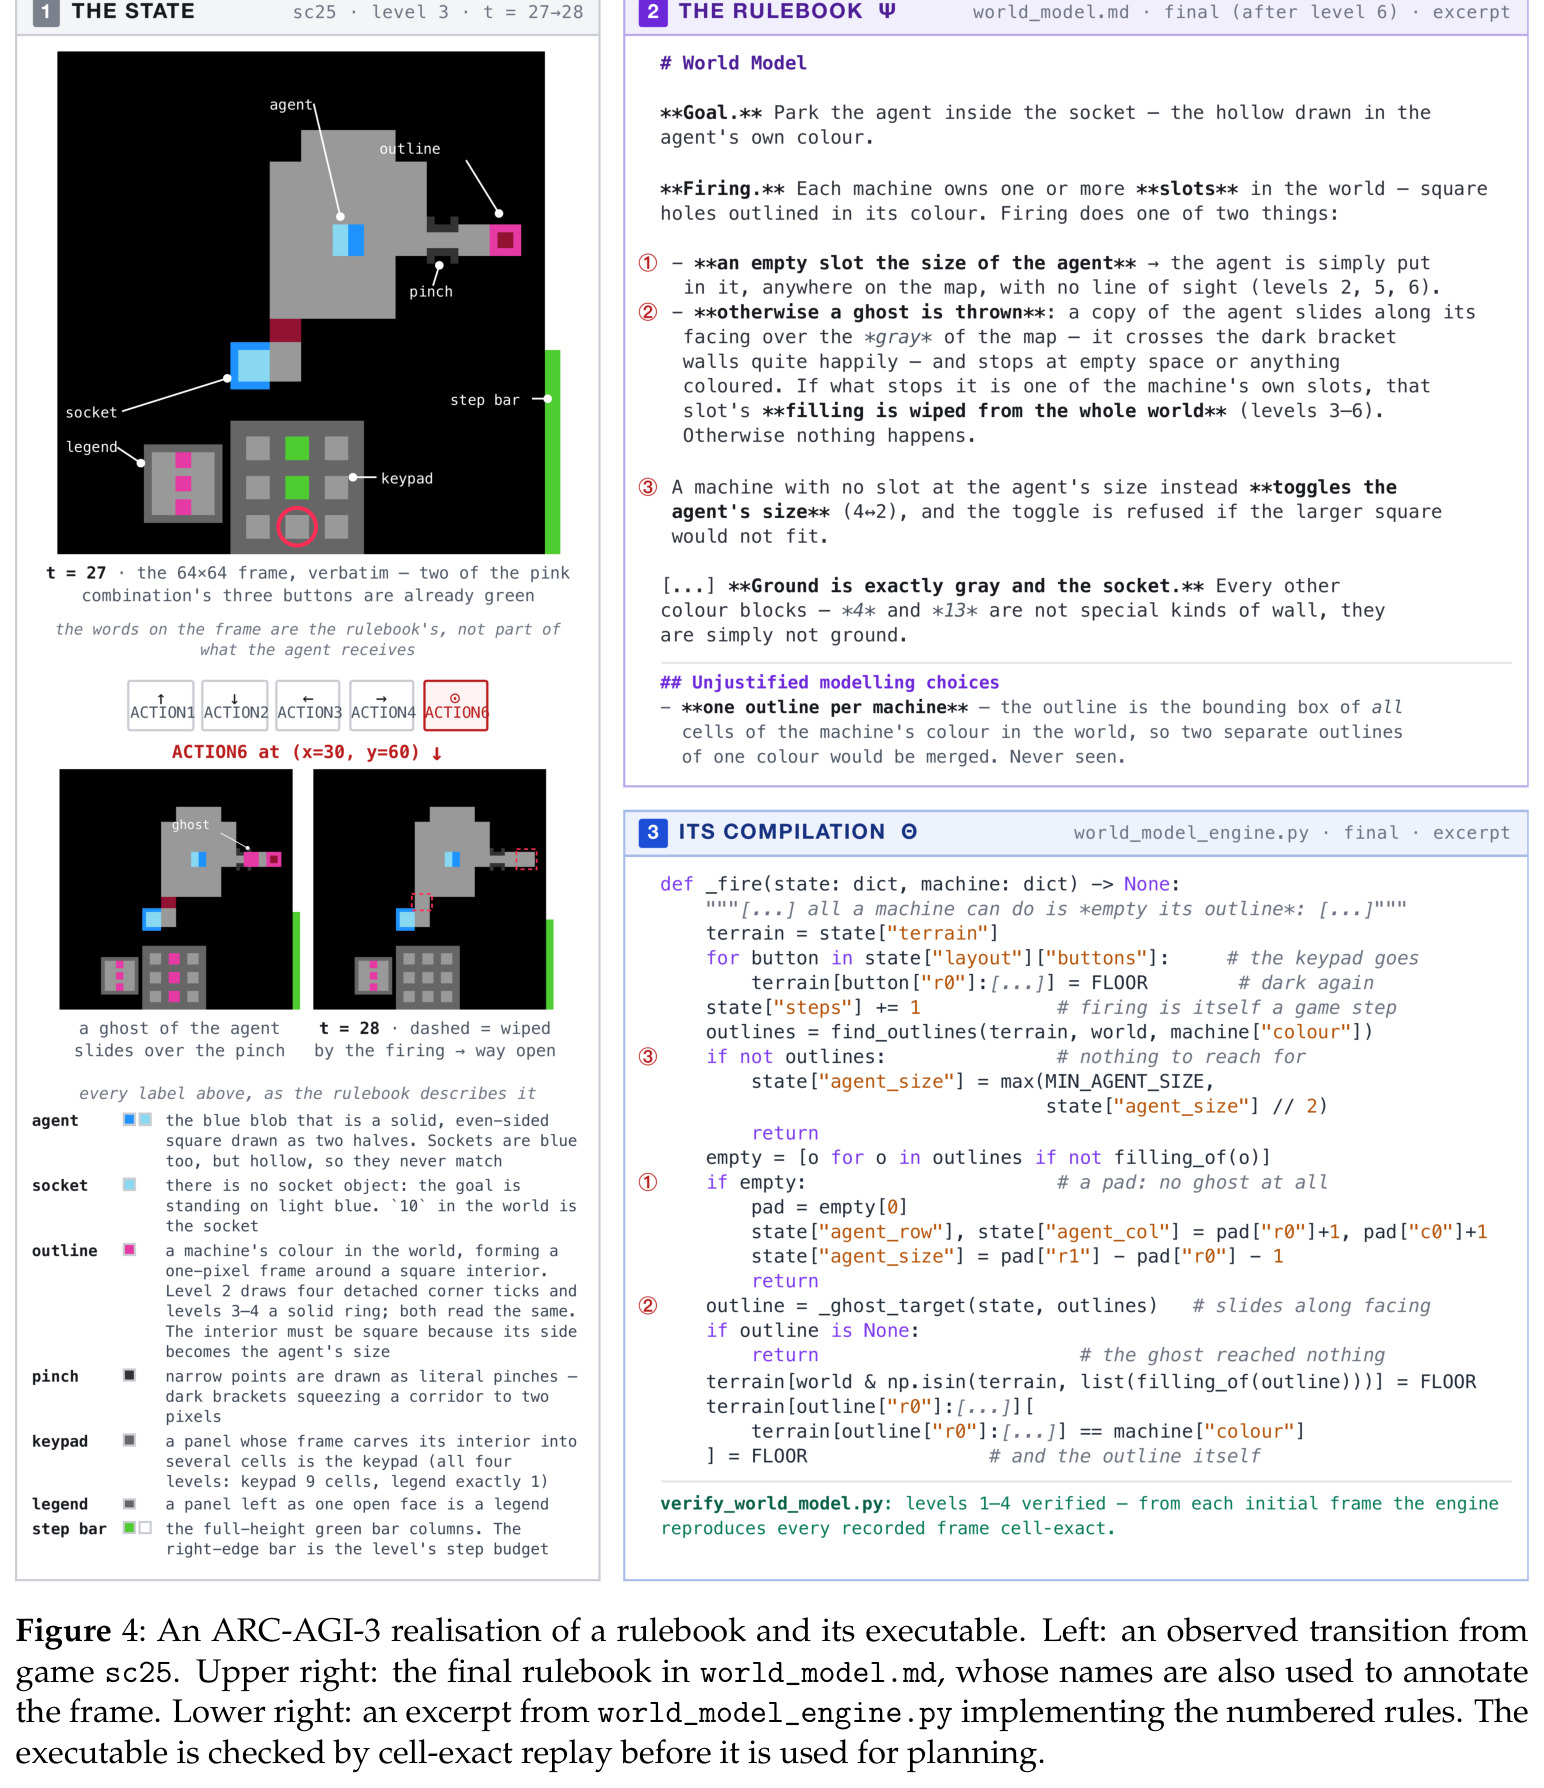
与已有工作不同的是,作者的独特切入点是把世界模型本身当作智能体的外部语义记忆(『Code as Model』),并给它配了双重表征:自然语言规则书 $\psi_t$ 记录『我相信世界遵循什么规则』,允许故意留白;可执行代码 $\theta_t$ 是规则书的一个具体实现,固定这些规则『如何被应用』。与已有代码世界模型的本质区别有三:其一,修订被显式分为『改规则』(revise_rulebook)与『修代码』(repair_code)两类,语义层与实现层的错误分开处理,而先前工作把模型当成一整块代码来修补;其二,假设接受不依赖 LLM 的自信度或排名(作者引用假设搜索文献表明 LLM 排名会排除正确候选),而是『LLM 审查代码-规则书忠实度 + 逐格精确重放全部历史』的双重验证;其三,为对抗单模型的自我确认,作者把单点信念推广为 $N$ 个规则书-代码对共享同一交互历史的种群,按行为等价类均匀采样规划——相当于把 posterior sampling 的探索思想搬到离散程序假设空间。
核心方法
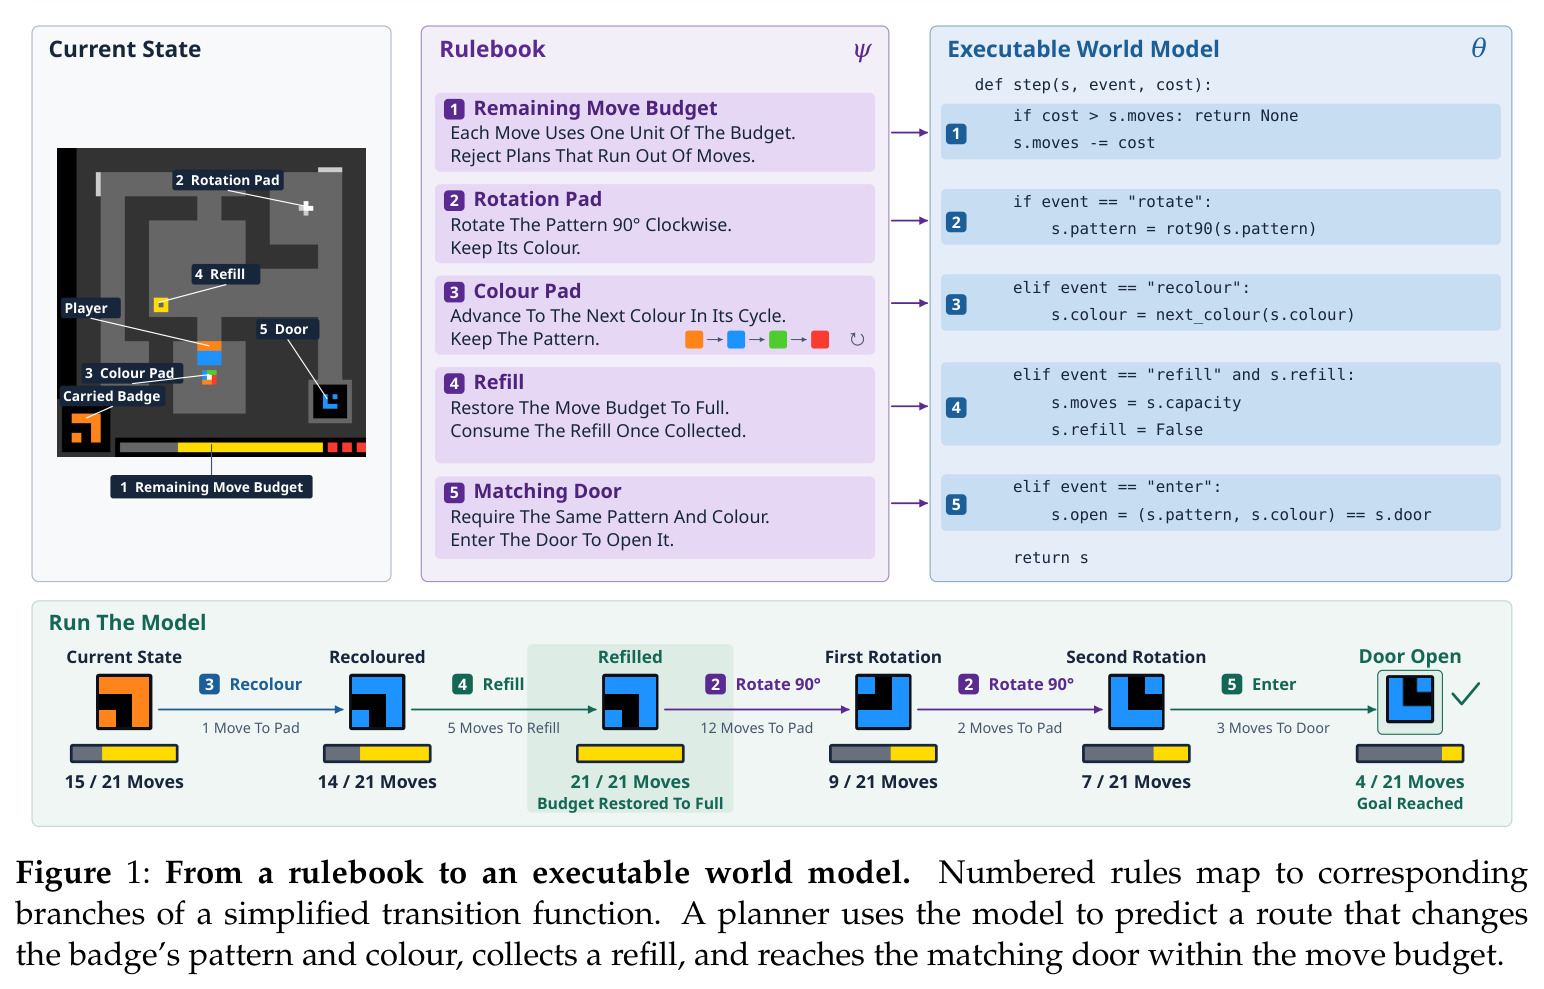
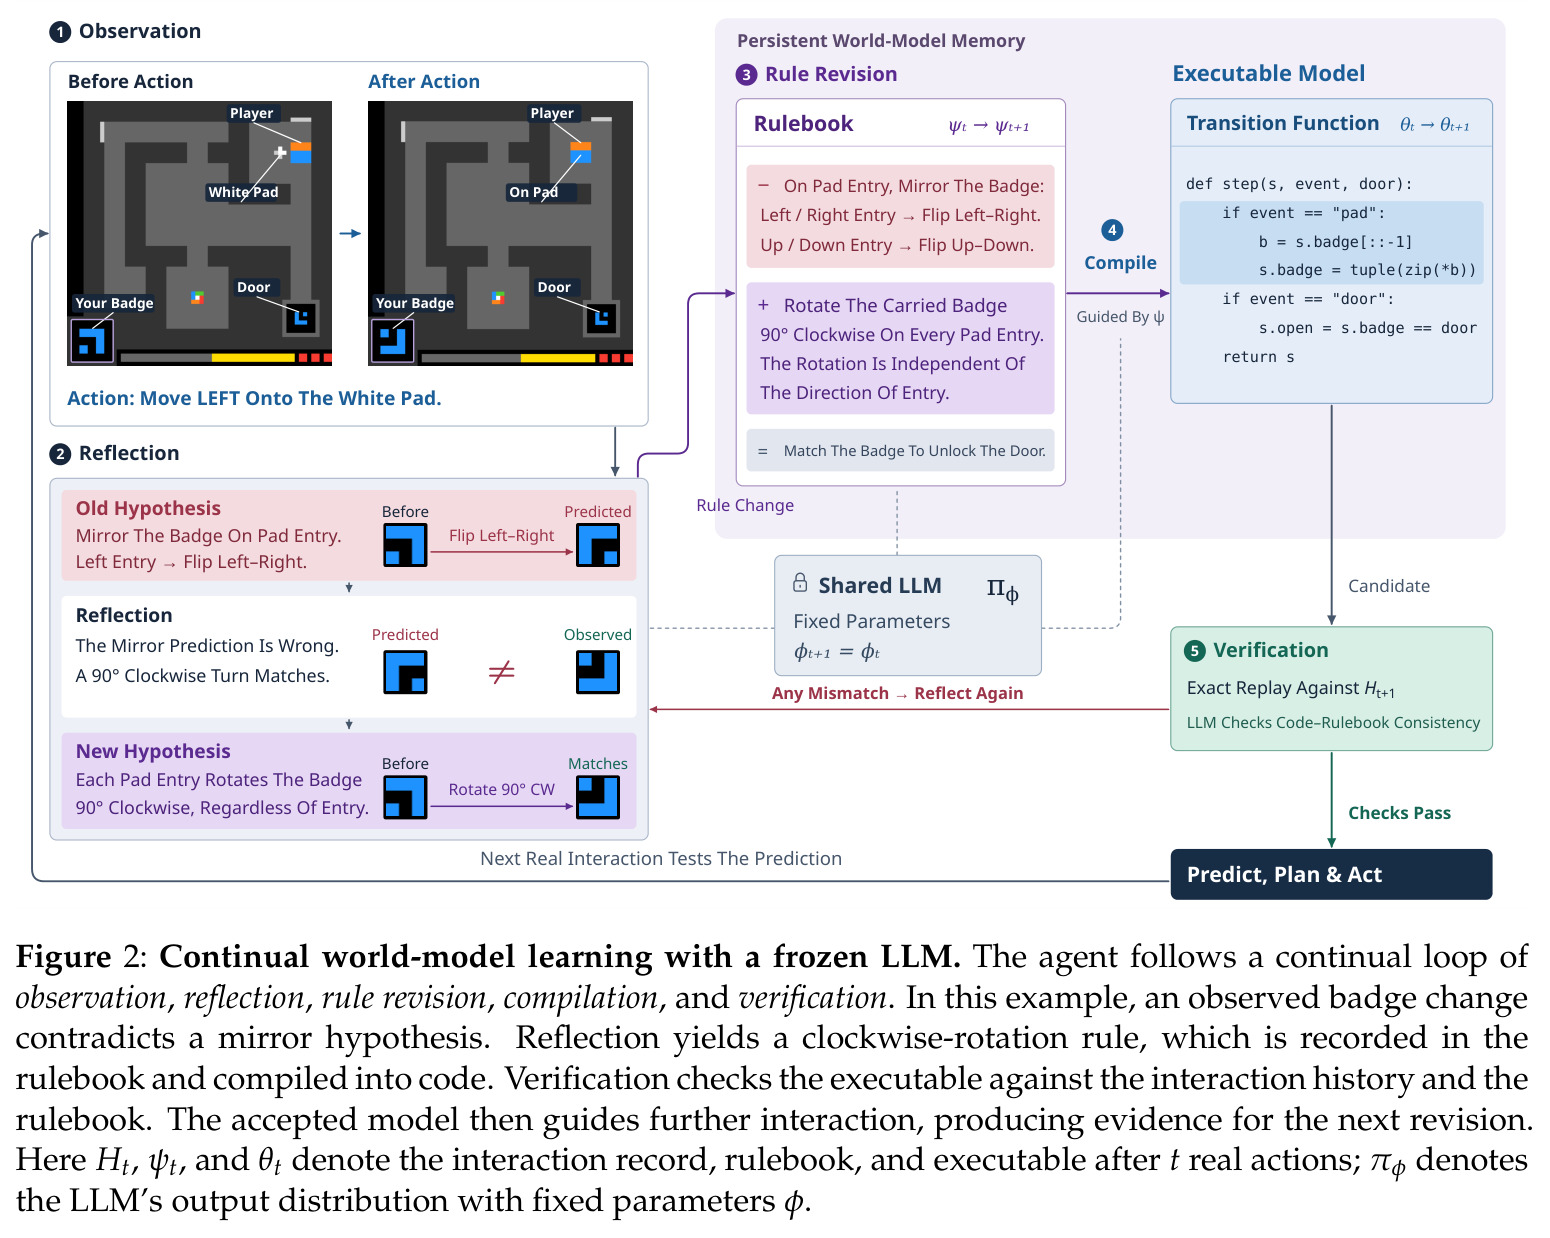
方法的直觉是让 LLM 像科学家一样工作:先写下对世界规则的猜想(规则书),再把猜想实现成可运行的模拟器(代码),拿真实观测当实验数据来检验和修正理论;整个过程 LLM 大脑不变,变的是实验记录本和理论文档。技术路线是五阶段循环(图2):(1) 观测:执行动作 $a_t$,把 $(a_t, o_{t+1})$ 追加进交互记录 $H_{t+1}=H_t\parallel(a_t,o_{t+1})$;(2) 反思:冻结LLM $\pi_\phi$ 从更新后的历史与当前假设 $(\psi_t,\theta_t)$ 中选择修订决策 $d_{t+1}\in\{$retain, revise_rulebook, repair_code$\}$;(3) 规则修订:若需改规则,LLM 调用修订算子 $\Delta_\phi$ 产出新规则书 $\tilde\psi_{t+1}=\Delta_\phi(\psi_t;H_{t+1})$;(4) 编译:规则书引导的编译器 $C_\phi$ 依据 $(\theta_t,\tilde\psi_{t+1},H_{t+1})$ 产出候选代码 $\tilde\theta_{t+1}$;(5) 验证:新代码必须通过逐格精确重放全部历史、且被LLM判定忠实实现规则书,才被采纳为 $h_{t+1}$。实现上规则书是 Markdown 文件 world_model.md,代码是 world_model_engine.py,全部历史存入 Git 仓库并按迭代打 tag,智能体可以 diff 任意两版规则书、找回被后续修改破坏的旧代码。规划时在模型中从重放重建的当前状态搜索到目标的最短路径并逐步执行,预测失配立即停止并把反例交回反思。
核心创新是把『世界模型』拆成语言层与代码层两个持久记忆对象,让二者承担互补角色:规则书承载可泛化的规则假设(包括尚未定论的竞争假设),代码承载确定性的执行语义。这带来一个关键能力:预测失配时系统能诊断失配源于『假设错误』还是『实现错误』——前者必须先改 world_model.md 再重编译,后者只动 Python 不动规则书。与已有方法的本质区别在假设的生成与验收方式:先前工作(如 WorldCoder)直接让 LLM 修补代码直到重放通过,而本文要求每个候选先被语言层约束($\tilde\theta\in[[\tilde\psi]]$,落在规则书的指称集合内),再通过 LLM 忠实度审查与精确重放双门验收;在通过验证的可行集 $\mathcal{V}_t$ 内用 SimplifyLLM 近似最小描述长度目标 $\arg\min_{(\psi,\theta)\in\mathcal{V}_t}[L(\psi)+L(\theta\mid\psi)]$,其 MAP 解释是先验 $\mu_0\propto 2^{-L(\psi)-L(\theta\mid\psi)}$ 下的后验最大化。种群扩展进一步把单点信念 $\hat b_t=\delta(h_t,\hat s_{\theta_t}(H_t))$ 推广为经验分布 $\hat b^{(N)}_t=\frac{1}{N}\sum_{i=1}^{N}\delta(h^i_t,\hat s_{\theta^i_t}(H_t))$,缓解『一个早期随机假设决定整局』的问题。
方法步骤详情
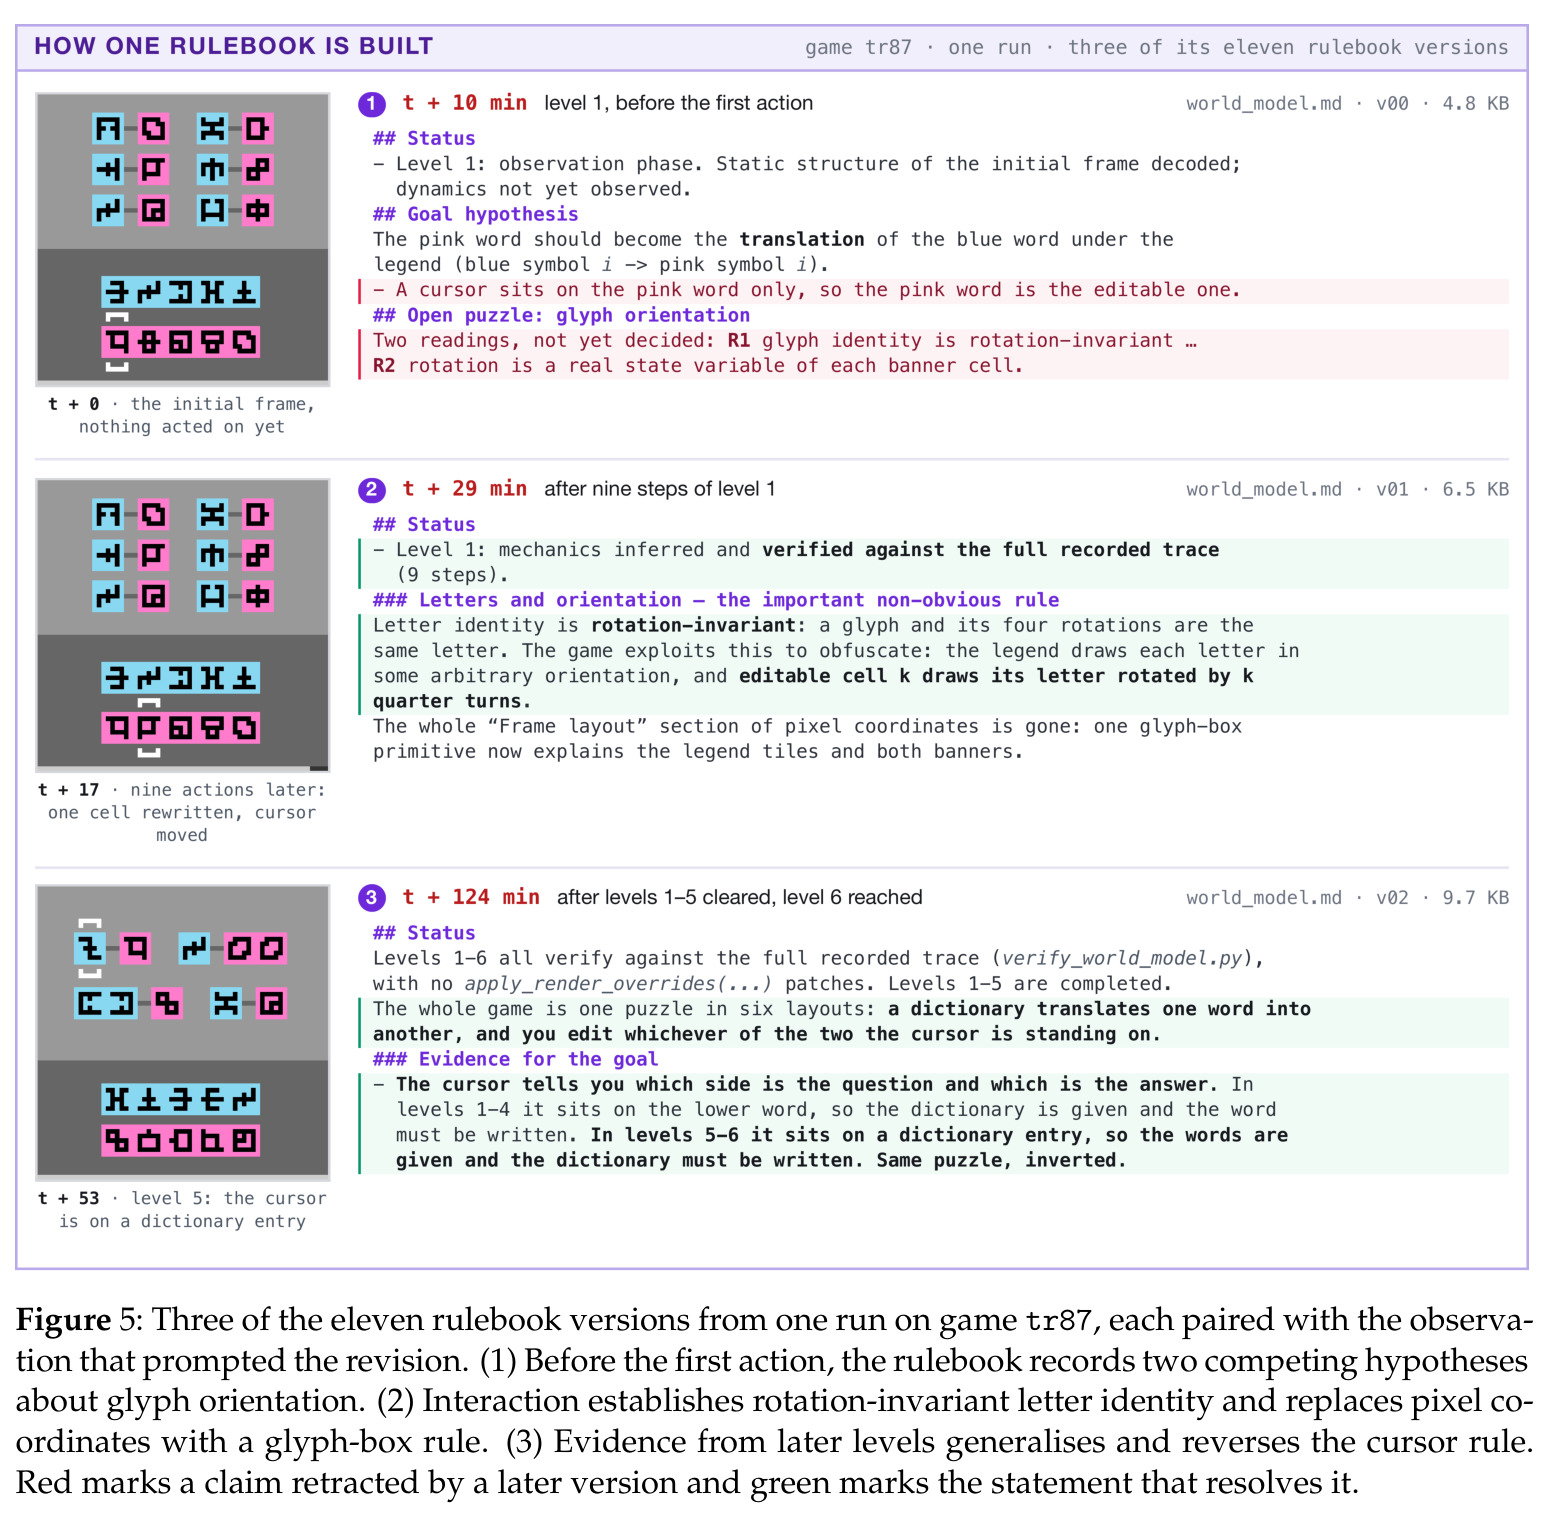
完整流程按每次真实交互推进。第一步,控制算子 $\mathcal{P}$ 用当前模型规划:重放 $H_t$ 得到内部状态 $\hat s_{\theta_t}(H_t)$,在确定性内部模型 $\hat M_\theta=\langle\hat S_\theta,A,f_\theta,\hat G_\theta\rangle$ 上按 $V_\theta(x)=1+\min_{a}V_\theta(f_\theta(x,a))$(目标处为0)递归求最短路径,执行 $\pi_\theta(H_t)=\mathrm{first}(\mathrm{plan}_\theta(\hat s_{\theta_t}(H_t)))$ 的第一个动作,逐动作比对预测与观测、失配即停;若无通往目标的路径,LLM 依据历史和规则书中未决假设选择中间目标(测试某机制、揭示未知区域、接触未解释物体),辅助规划器搜索到达该目标的序列。第二步,观测返回后进入更新算子 $\mathcal{U}$ 的五阶段(式15-21):观测追加、反思定夺、规则修订、编译、验证,验证要求 $\mathrm{verify}(\theta;H_t)=\prod_{i<t}\mathbb{1}[\hat o_\theta(H_i,a_i)=o_{i+1}]=1$ 且 $\theta\in[[\psi]]$,不通过则回到反思重试。第三步,验收通过后在可行集内做简化选择并提交 Git。ARC-AGI-3 实现中:验证器用 $\iota_\theta(o_0)$ 初始化后重放全部动作,要求每帧 $64\times64$ 全部格子一致;规则与代码跨关卡、跨尝试持续存在,后期关卡引入新机制时继续触发修订(tr87 一局共产生 11 个规则书版本)。输入输出上:反思的输入是全历史+当前假设、输出是修订决策;编译的输入是旧代码+新规则书+新证据、输出是候选 Python 模块;规划的输入是重放重建状态、输出是动作序列。
技术新颖性
技术新颖性体现在四个层面。理论层面:作者给出模型化RSI的形式定义(Definition 1)——智能体自主修订持久世界模型假设 $h_t$、用它指导后续预测规划探索、再用产生的证据构造 $h_{t+1}$,并把点信念近似 $\hat b_t=\delta(h_t,\hat s_{\theta_t}(H_t))$ 明确表述为贝叶斯自适应POMDP联合信念的确定性等价近似,使『LLM提案+重放验收』的工程流程获得严格的推断论解读(式13-14的理想贝叶斯更新 vs 式22的近似)。表征层面:语言规则书+可执行代码的双层记忆是新的——规则书可含糊、可记录竞争假设(图5显示 tr87 开局同时记录两个相互竞争的字形朝向假设,等待证据裁决),这在纯代码世界模型中无法表达。机制层面:『LLM忠实度审查+精确重放』双门验收有明确动机——基于LLM排名选假设会排除正确候选,因此把可行后果全部交给执行检验。探索层面:行为等价类定义 $\theta\sim_{H_t}\theta'\Leftrightarrow\mathrm{plan}_\theta(\hat s_\theta(H_t))=\mathrm{plan}_{\theta'}(\hat s_{\theta'}(H_t))$ 保证种群保留的是行为上不同的假设而非同一程序的语法变体,并证明重放一致的候选按先验几率保留(式34)。Git 版本化记忆让智能体能 diff 与回滚自身的历史假设,虽是工程细节,也直接服务于反思机制。
实验结果
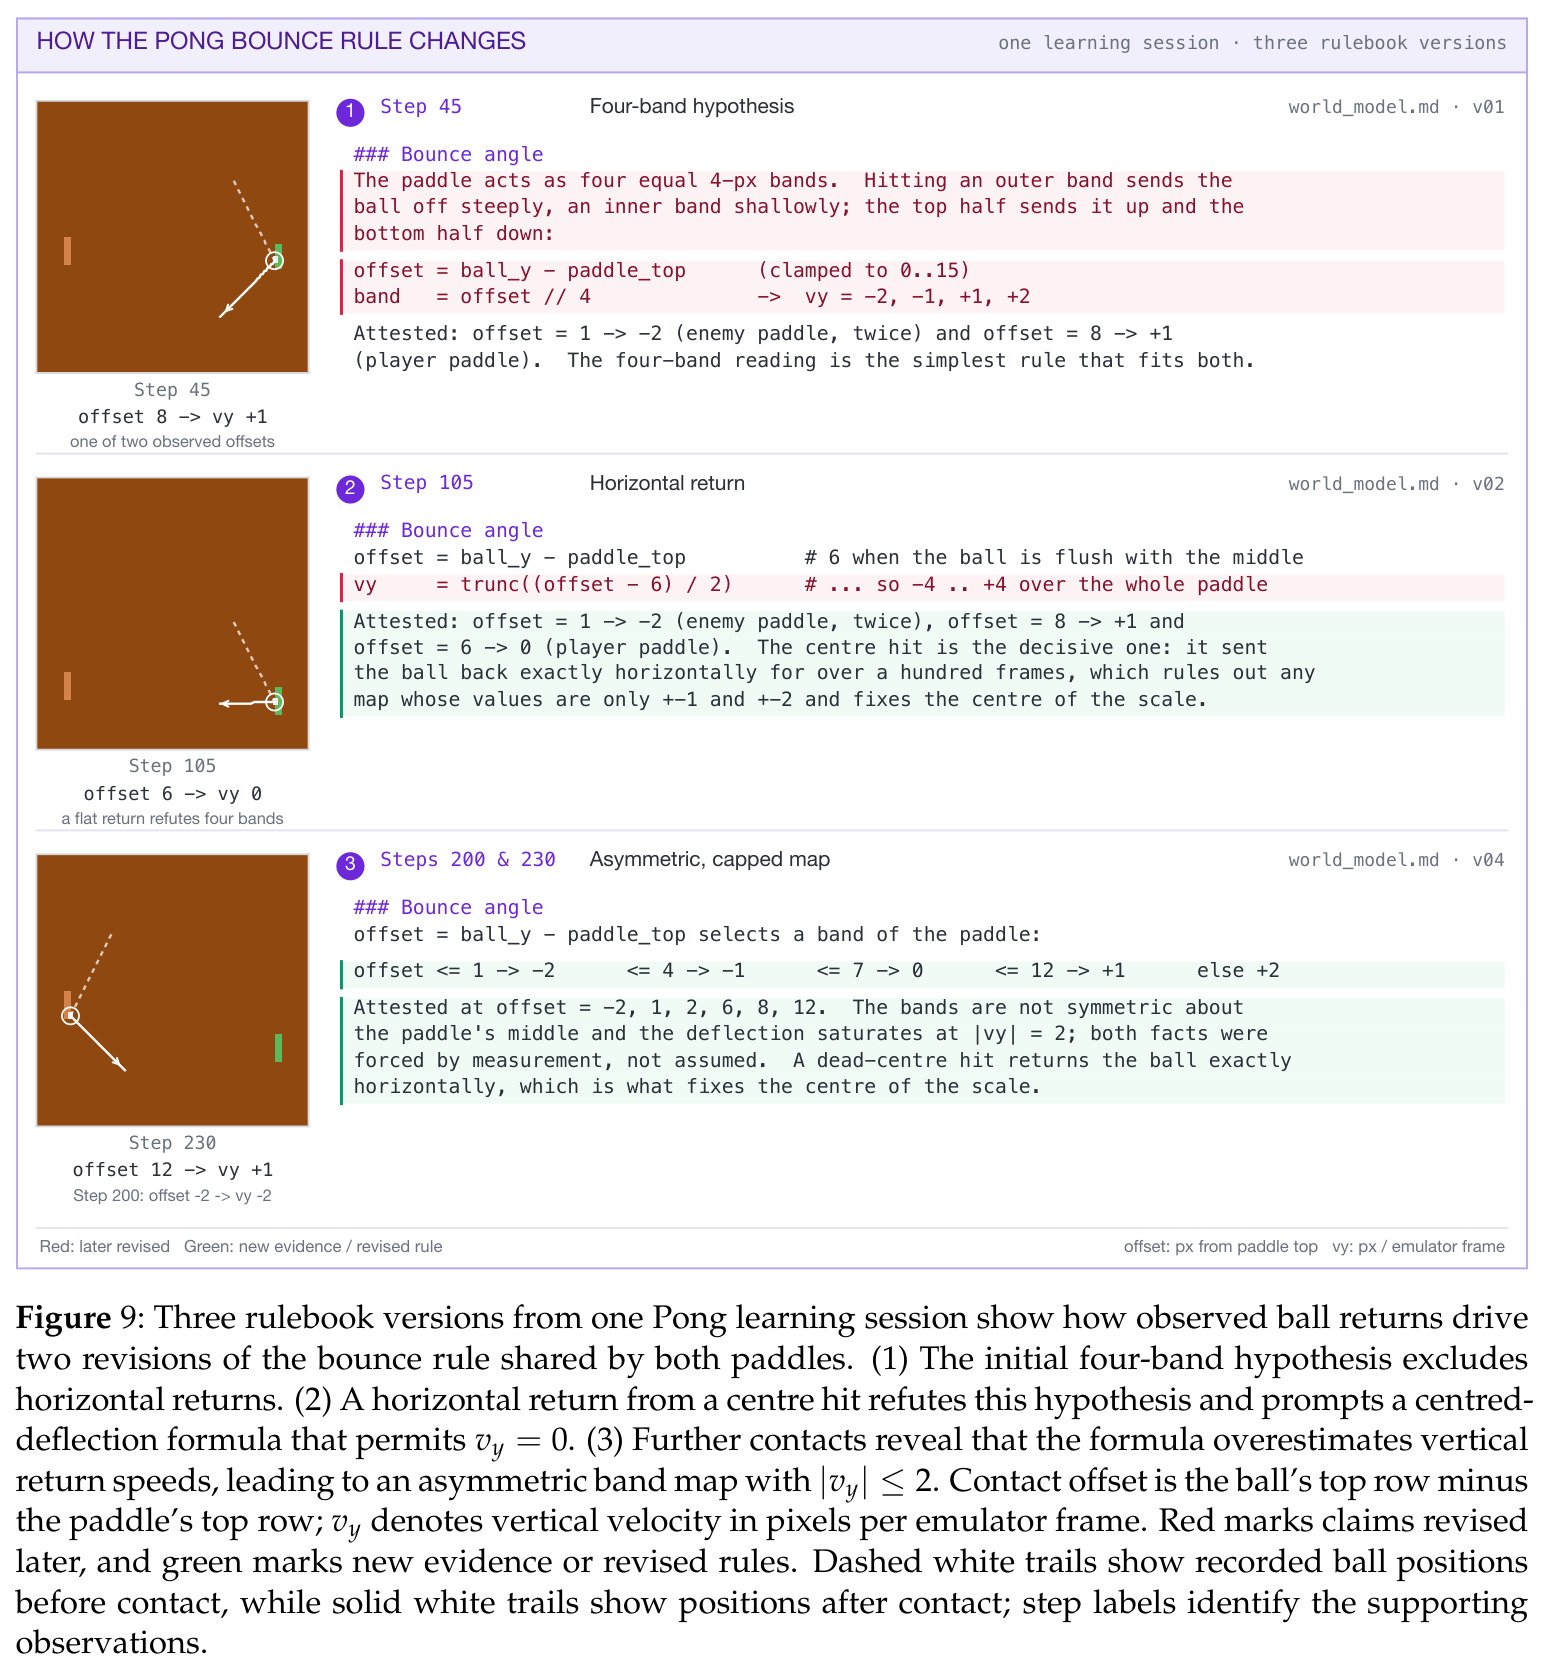
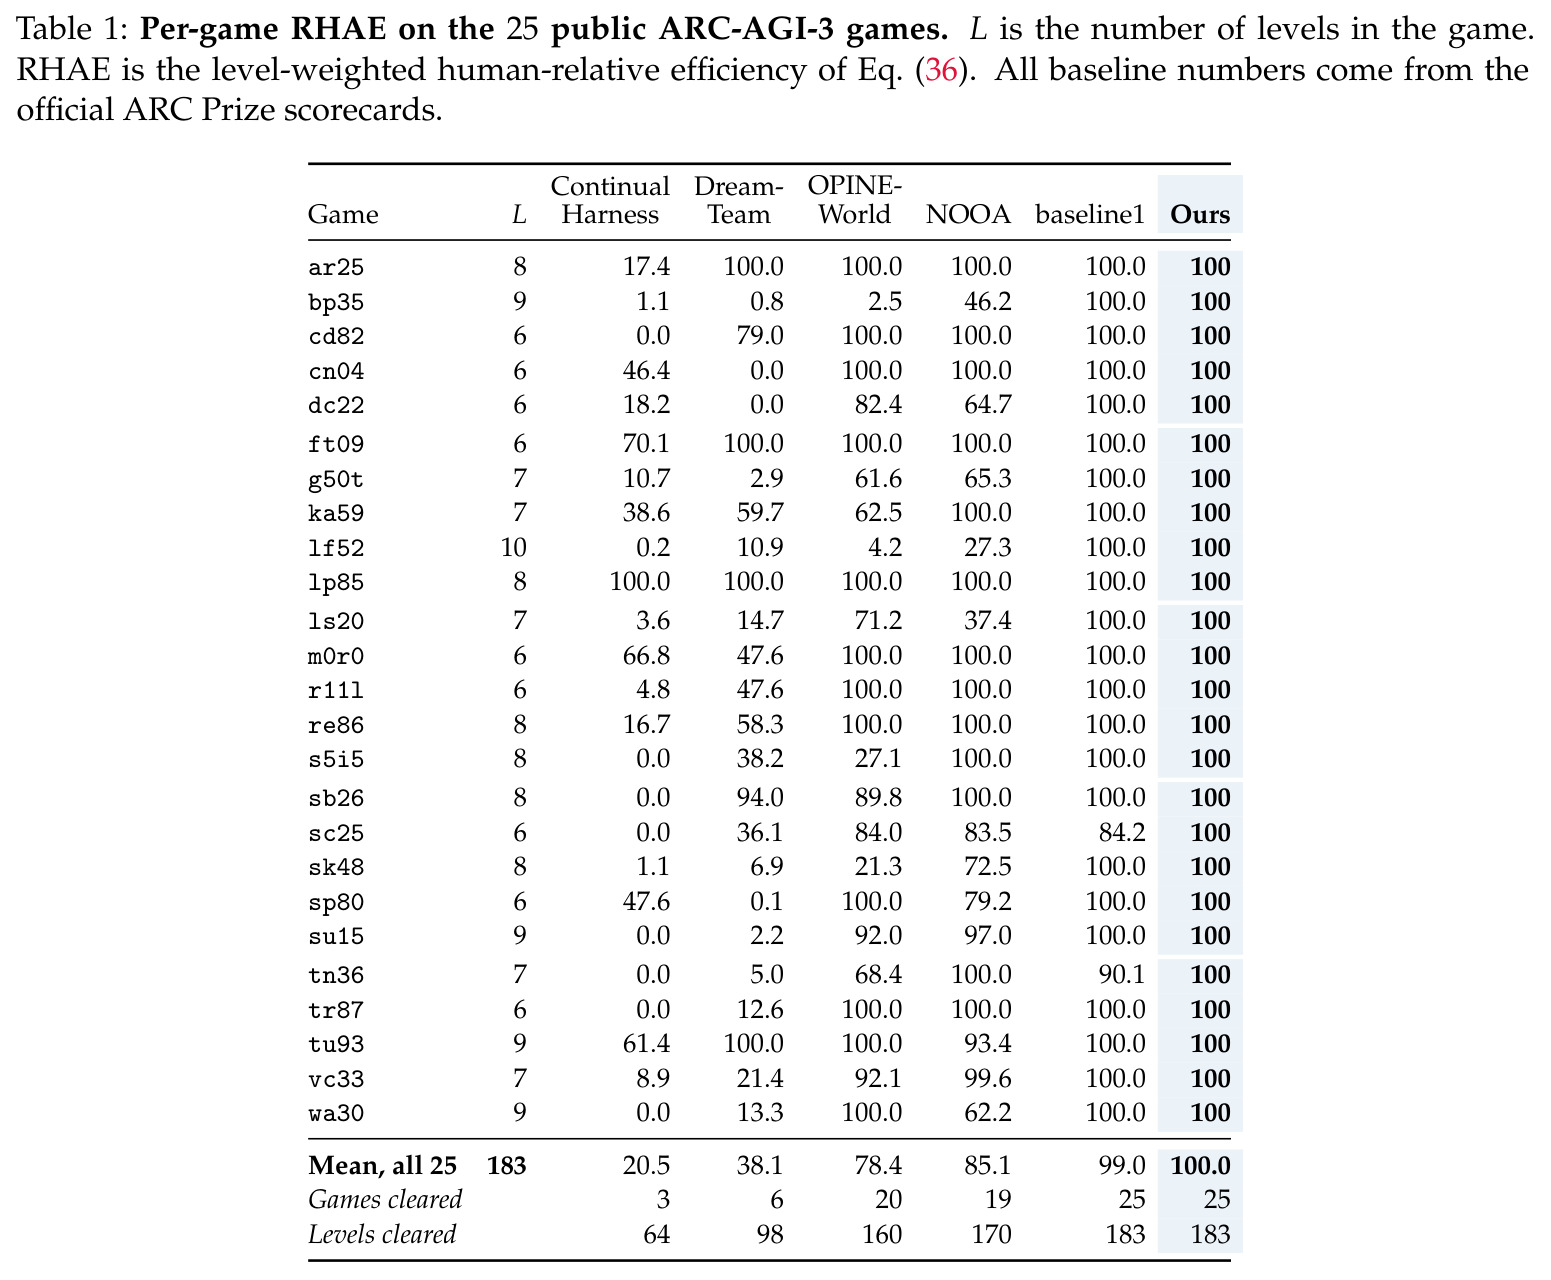
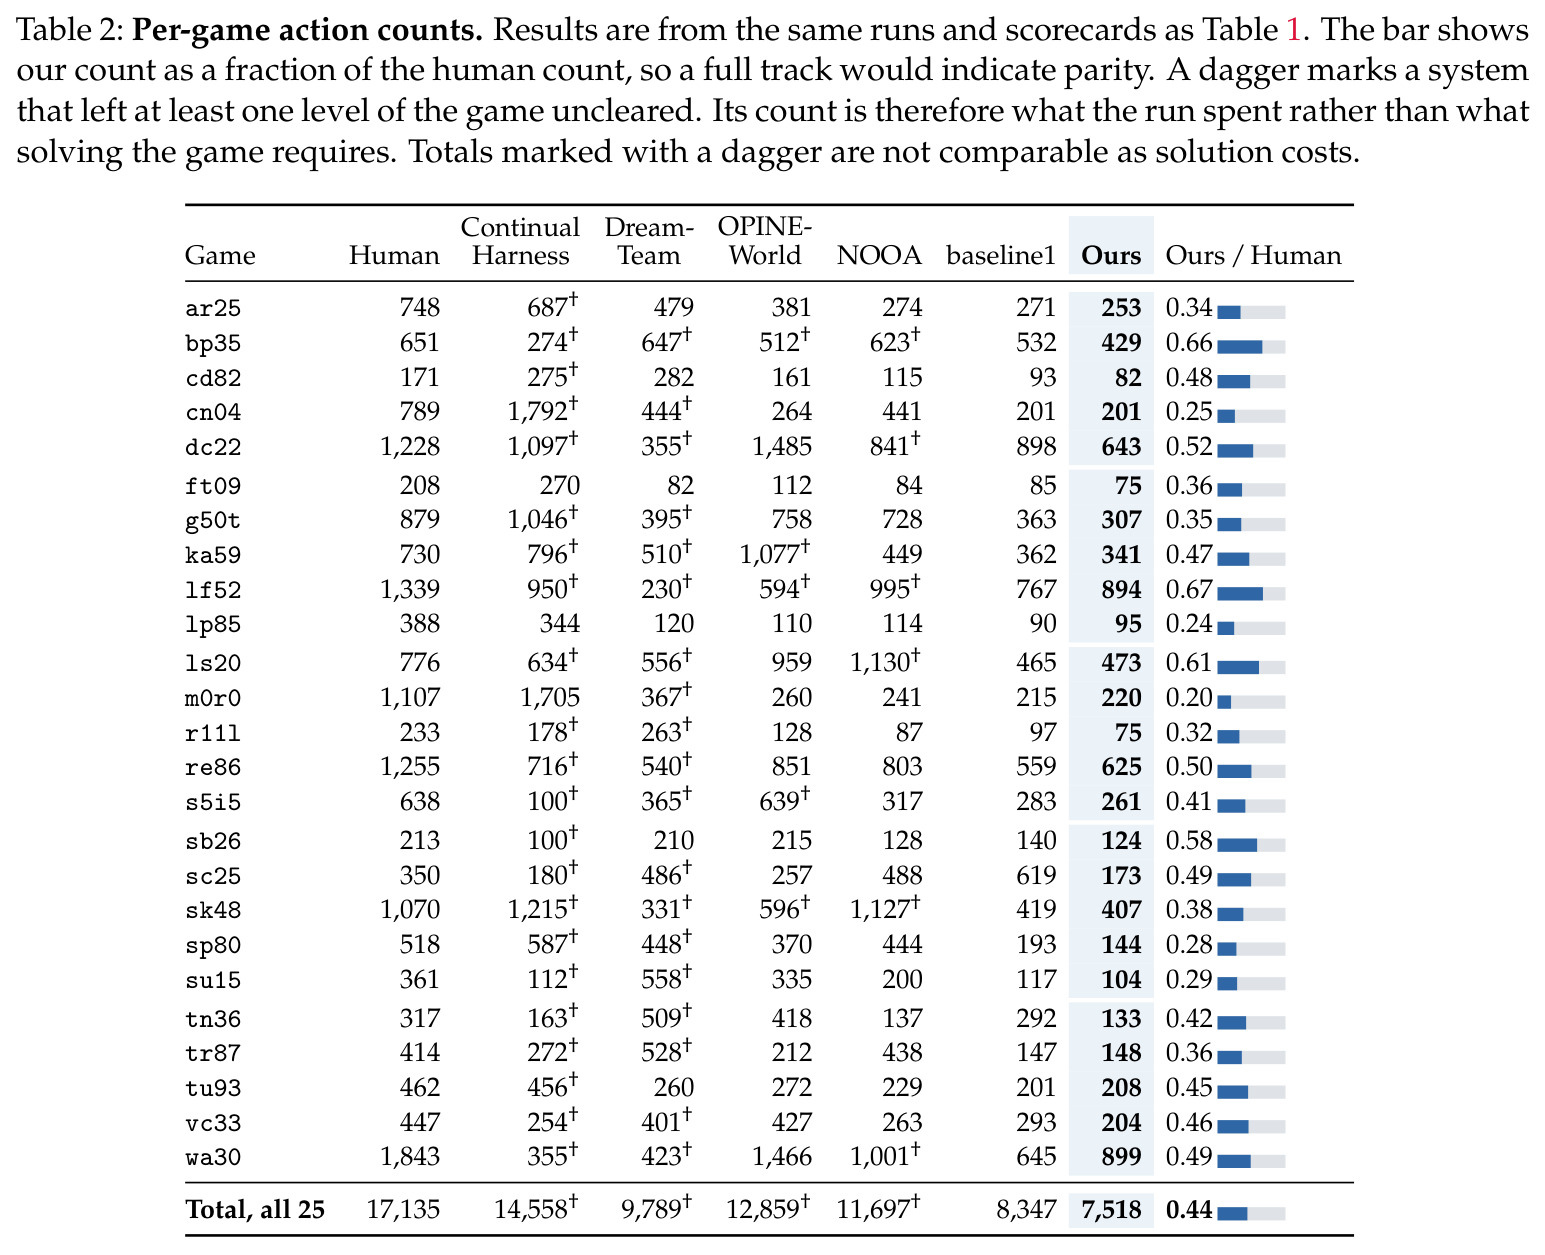
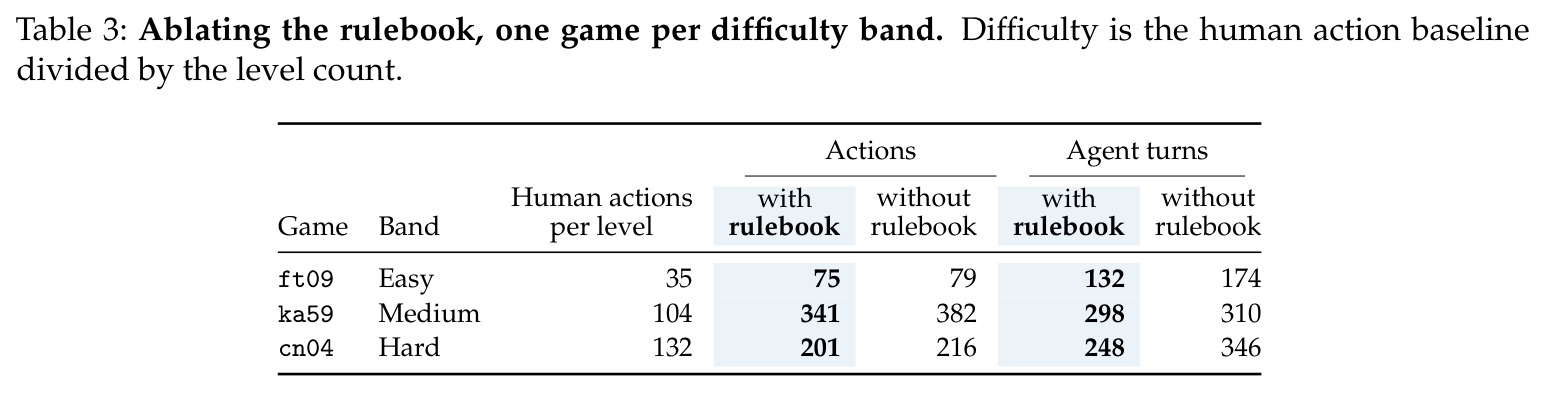
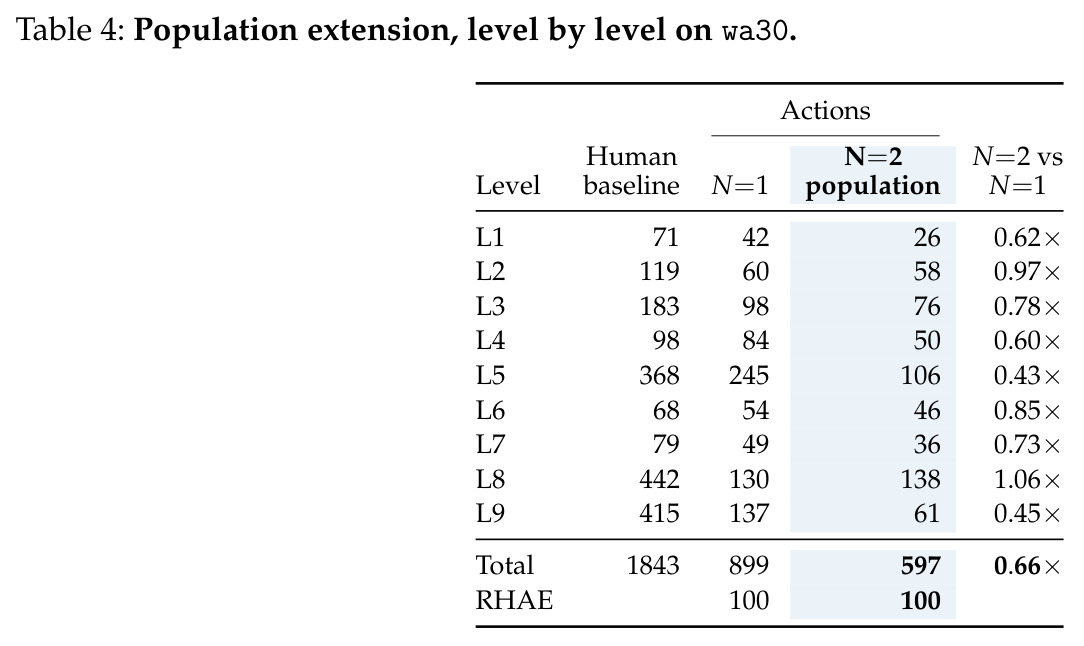
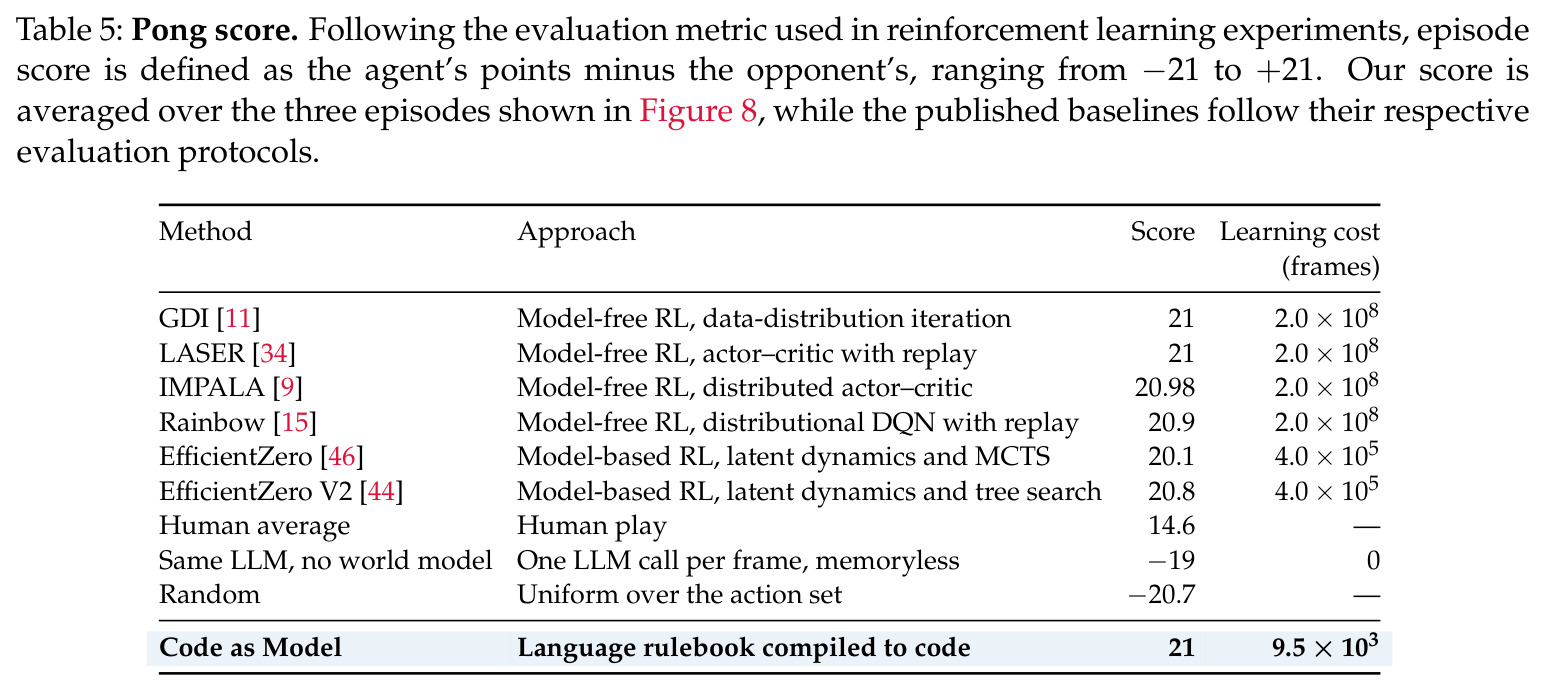
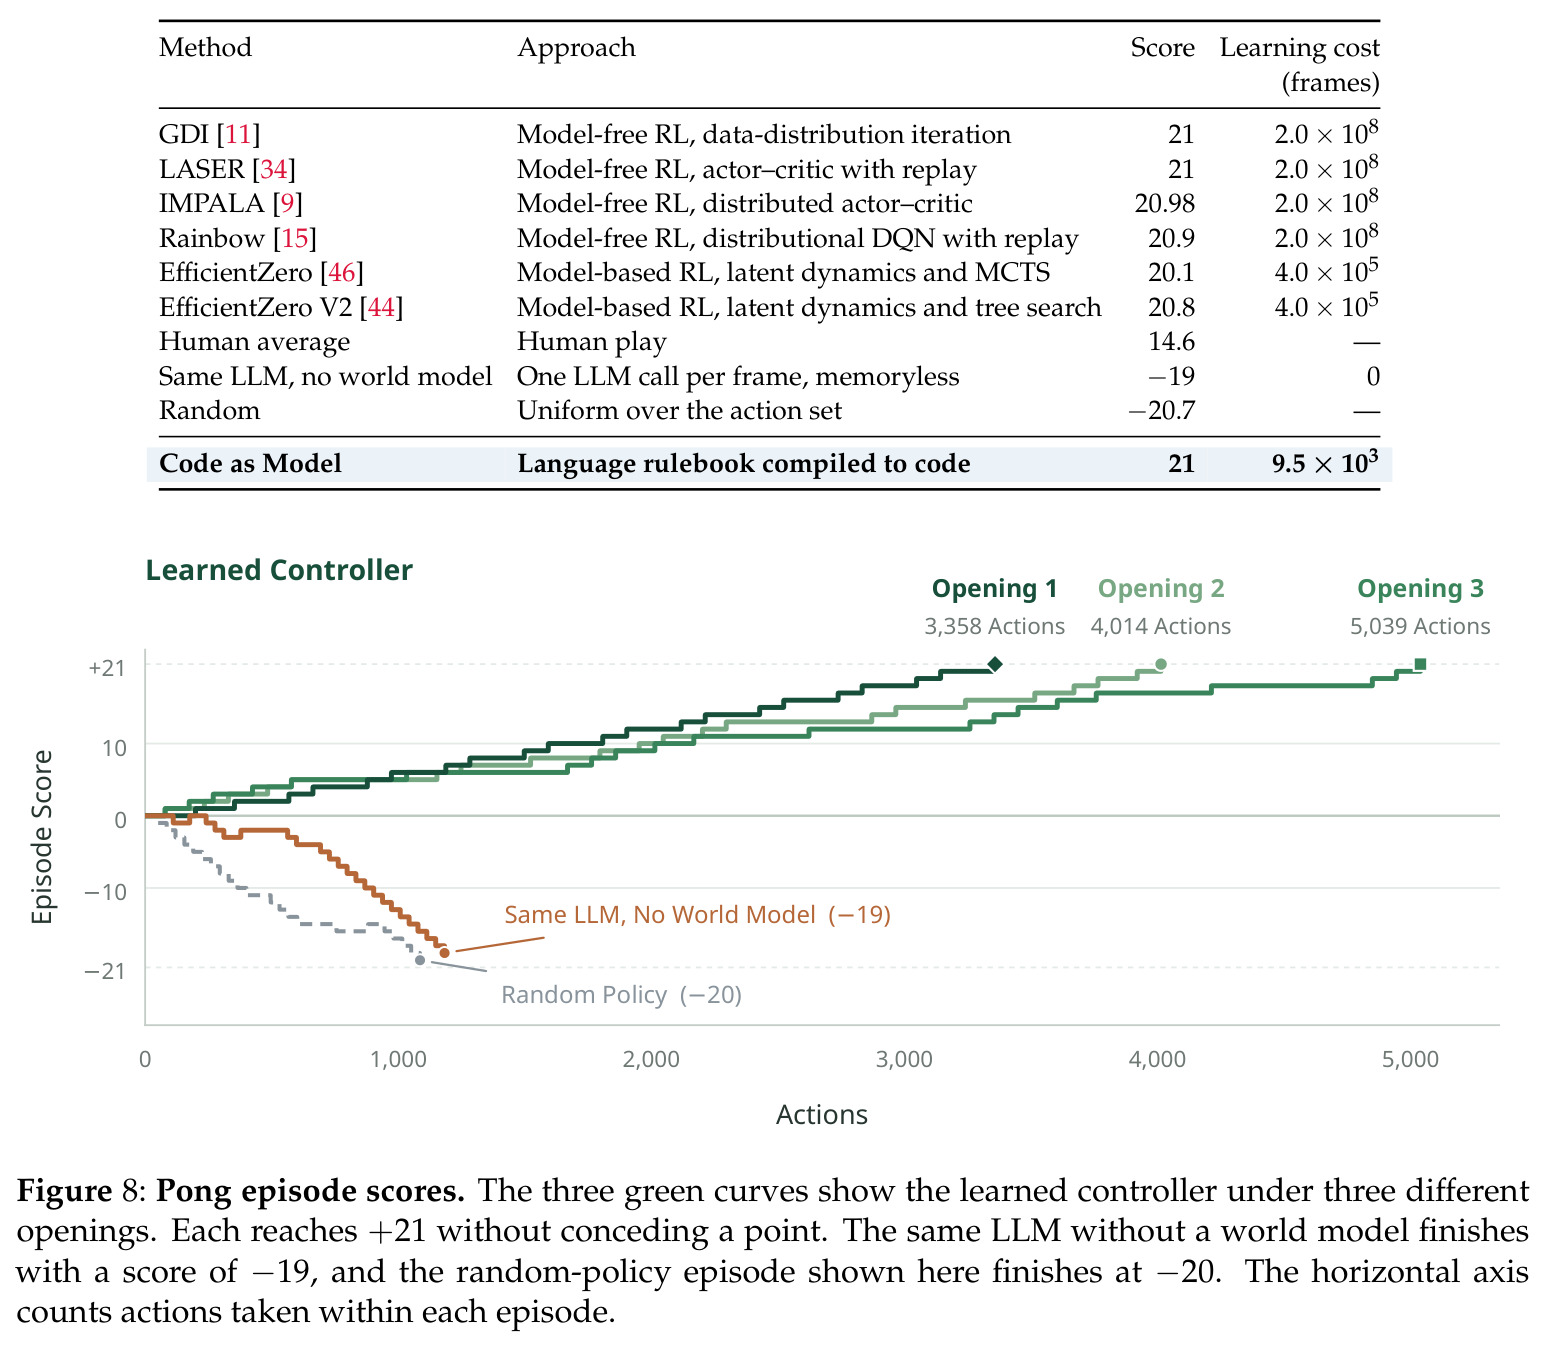
ARC-AGI-3 主实验(表1、表2):单模型智能体通关全部 25 个公开游戏的 183 个关卡,平均 RHAE 达满分 100.0,总动作数 7,518,仅为人类基线 17,135 的 44%(单游戏比值从 m0r0 的 0.20 到 lf52 的 0.67,中位数 0.42)。对比所有有论文支撑的排行榜系统:baseline1 以 99.0 居第二(也通全关,但用 8,347 动作、为人类预算的 0.49);NOOA 85.1(通关 19/25)、OPINE-World 78.4(20/25)、DreamTeam 38.1(6/25)、Continual Harness 20.5(3/25);相对使用 ARC Prize 标准 harness 的 Claude Opus 5,本文平均 RHAE 高出 59.3 分。规则书消融(表3):保持 harness、重放验证器、执行器、骨干模型与推理档位完全不变、仅移除规则书,在易/中/难三档(ft09、ka59、cn04)上仍全部通关且 RHAE=100,但有规则书版本用 617 动作 vs 677(省 9%)、678 agent turns vs 830(省 18%),说明规则书主要加速收敛而非改变可达性。种群扩展(表4):在人类基线最大的 wa30 上以 N=2 运行,双臂都全通 9 关且 RHAE=100,总动作从 899 降到 597(0.66×),9 关中 8 关持平或更优(仅 L8 为 1.06×)。Atari Pong 案例(表5、图8):学得的反馈控制器在三个不同开局的评估局中全部 21:0 获胜(分别用 3,358/4,014/5,039 动作),学习成本仅 9,504 模拟帧——约为无模型RL基线($2.0\times10^8$ 帧)的 $2.1\times10^4$ 分之一、模型基RL(EfficientZero V2,$4.0\times10^5$ 帧)的 42 分之一;同 LLM 但无世界模型的基线得 −19,随机策略 −20.7。图9展示规则书真实演化:从『四段拍面』假设,到中心水平回球否证它并改为 $v_y=\mathrm{trunc}((\mathrm{offset}-6)/2)$,再到非对称、$|v_y|\le2$ 封顶的分段映射,每次修订都由具体触球证据强制。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ARC-AGI-3 逐游戏动作效率 | 平均 RHAE(100为天花板) | 100.0(25/25 游戏全通,183/183 关卡) | baseline1 99.0(25/25);NOOA 85.1(19/25);OPINE-World 78.4(20/25);DreamTeam 38.1;Continual Harness 20.5 | 较最强全通基线 +1.0 分;较 Claude Opus 5 + 标准 harness +59.3 分 |
| ARC-AGI-3 交互成本 | 总动作数(含失败与重置) | 7,518(人类的 0.44,中位单游戏比 0.42) | 人类 17,135;baseline1 8,347(0.49) | 动作数比最强基线再省 10%,比人类省 56% |
| 规则书消融(ft09/ka59/cn04 三难度档) | 动作数与 agent turns(通关且 RHAE=100 前提下) | 有规则书:617 动作 / 678 turns | 无规则书(其余完全相同):677 动作 / 830 turns | 动作 −9%,agent turns −18% |
| 种群扩展(wa30,N=2) | 总动作数(通关且 RHAE=100 前提下) | N=2 种群 597 动作 | N=1 单模型 899 动作(人类基线 1,843) | 0.66×,9 关中 8 关持平或更优 |
| Atari Pong(ALE,frame-skip 4) | episode 得分(−21~+21)/ 学习帧数 | 21(三开局全部 21:0)/ 9.5×10³ 帧 | GDI、LASER 21 / 2.0×10⁸ 帧;EfficientZero V2 20.8 / 4.0×10⁵ 帧;人类 14.6;同 LLM 无世界模型 −19 | 比无模型RL省约 2.1×10⁴ 倍帧数,比模型基RL省 42 倍,且分数并列最高 |
局限与改进
作者承认的局限:其一,公开集已现饱和——作者在相关工作中明确指出 Tycho 与 Rodionov 的组件研究已用更强前沿模型报告公开集饱和或近饱和,因此『通关 25 个公开游戏』本身不能隔离世界模型架构的贡献,必须结合模型选择、推理预算、动作效率、重复运行稳定性与 held-out 评估来比较;其二,每个 Claude Code 实验运行的时间与金钱成本可观,导致消融只在 3 个游戏上进行、主结果未报告多种子方差。我观察到的额外局限:其一,整个框架建立在确定性环境假设上(重放是精确的通过/失败判定),随机转移或渲染噪声会直接破坏验证机制,Pong 中残差渲染与拍板运动误差已迫使作者引入专门的诊断手段;其二,RHAE 只计环境动作、不计 LLM 调用成本,7,518 动作背后的 token 开销(Opus 5、extra-high 推理档)未被量化,跨系统的成本效率比较因此不完全公平;其三,种群扩展仅在 1 个游戏、N=2 上验证,且依赖一个人工设计的『同步通信机制』保持成员一致,通用性未知;其四,全部结果共享 Claude Opus 5 的先验知识,方法收益与模型先验收益的边界无法区分。
独立分析的弱点
弱点一:精确重放无法容忍噪声。真实环境(机器人、网页)普遍存在随机性与观测噪声,『每格必须全对』的验收会永远失败或被迫放宽到失去辨别力。改进方向:把验证改为统计假设检验(如对预测残差做序贯检验)或在规则书上为每条规则标注确定性等级,分级验收。弱点二:单模型存在自我确认风险。式(29)表明只要 $E(\theta)\cap R(\theta)=\varnothing$,错误模型可以在自己的策略轨迹上永不露馅,而论文只在 1 个游戏上试了 N=2。改进方向:主动设计判别性实验——当多个存活假设对同一动作预测不同时优先执行该动作(Bayes 最优探索的自然推论),并按式(34)的后验几率加权采样而非均匀采样。弱点三:对前沿模型的依赖未被量化。全部结果绑定 Opus 5 + extra-high,若换用小模型,规则修订与编译质量如何退化没有数据。改进方向:报告跨模型规模的学习曲线,并利用 Git 记忆做『失败修订自动回滚』以增强鲁棒性。弱点四:成本核算不透明。RHAE 只计环境动作,而主实验的 LLM 调用次数与 token 成本未披露(消融中仅 3 游戏已达 678 agent turns)。改进方向:报告『每 RHAE 点的计算成本』作为补充指标。弱点五:Pong 案例的停止条件是『达到 21:0 才停』,这隐式使用了环境真值胜负信号作为学习终止判据,与 ARC-AGI-3 上纯内生目标推断的设定并不完全对齐,推广到无清晰胜负信号的任务时需要重新设计。
未来方向
作者方向:把比较迁移到 held-out 评估与重复运行稳定性(作者在相关工作中明确提出这是社区应关注的维度);扩展种群机制——文中已证明重放一致候选按先验几率保留(式34),自然延伸是按后验加权而非均匀采样、动态增删成员以逼近完整版本空间。基于成果可延伸的方向:其一,随机环境的世界模型——为规则书引入概率规则(如『门以概率 $p$ 开启』),重放验证改为似然检验,可把框架推向更真实的交互环境;其二,与 Memento-Skills 的模型侧-策略侧融合——规则书描述世界、技能库描述操作,共享同一反思循环,可能产生『知道世界如何运作+知道如何行动』的完整智能体;其三,跨游戏规则迁移——ARC-AGI-3 的 25 个游戏共享不少机制原型(推进、拾取、钥匙-门),预训练一个『规则先验库』再逐游戏特化,有望进一步压缩动作数;其四,理论工作——种群规模 $N$ 与探索效率的定量关系、MDL 选择在何种条件下可避免自我确认,都有定理化空间;其五,安全性研究——本文是 RSI 的受控研究范本(改进对象是外部记忆而非权重),可用来实证研究自我改进循环的失控条件与刹车机制。
复现评估
复现条件评估。有利因素:实验基座 baseline1 代码库公开;ARC-AGI-3 的 25 个公开游戏免费可玩,所有基线数据来自官方 ARC Prize scorecard、计数口径统一;Pong 使用标准 Arcade Learning Environment(frame-skip 4);论文形式化(式1-34)相当完整,更新算子、验证条件、选择目标均有精确数学表述;方法本质是『LLM 提示工程+重放测试』的组合,无模型训练、无需 GPU 集群。不利因素:作者未承诺开源自己的 harness 与规则书工件;『LLM 审查代码-规则书忠实度』这一语义验收依赖具体提示词设计,论文未给出提示词模板,是复现中最不确定的环节;骨干模型为 Claude Opus 5 且推理档位 extra-high,作者明言每次运行成本可观——按消融 3 游戏 678 agent turns 外推,完整 25 游戏复现需数千到上万次高质量 LLM 调用,API 费用不低。综合判断:有 LLM 工程经验的团队若严格遵循论文的验收逻辑(精确重放+忠实度双门+MDL 简化+Git 记忆),在单游戏上复现出定性趋势(通关+低动作数)可行,难度中等偏上;完全复现 RHAE 100.0 的具体数值则受模型版本漂移影响,存在不确定性。
论文图表
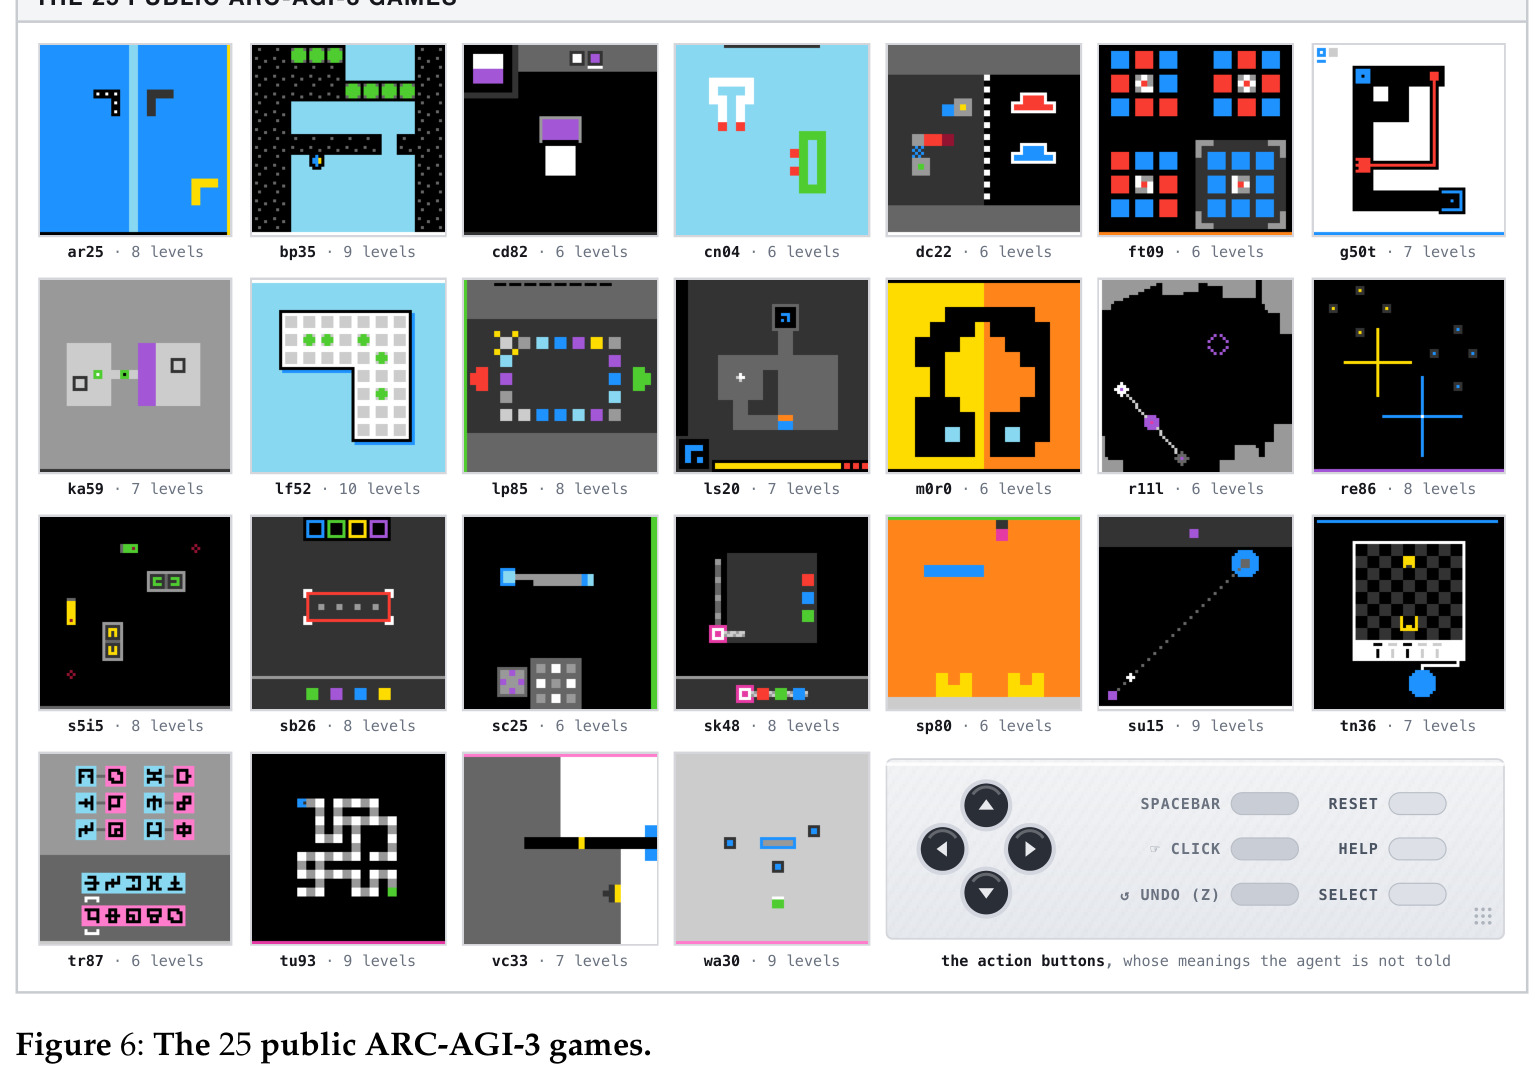
列出全部 25 个公开 ARC-AGI-3 游戏的截图网格,标注每个游戏的代号与关卡数(如 ar25·8 levels、lf52·10 levels 等),并显示游戏界面上的动作按钮(SPACEBAR、RESET、CLICK、UNDO、SELECT 等),这些按钮的含义不会告知智能体。
让读者直观了解评测任务的视觉形态与动作接口,以及观测为 64×64 像素网格这一关键设定,是理解『智能体只看到像素与按键』的前提。
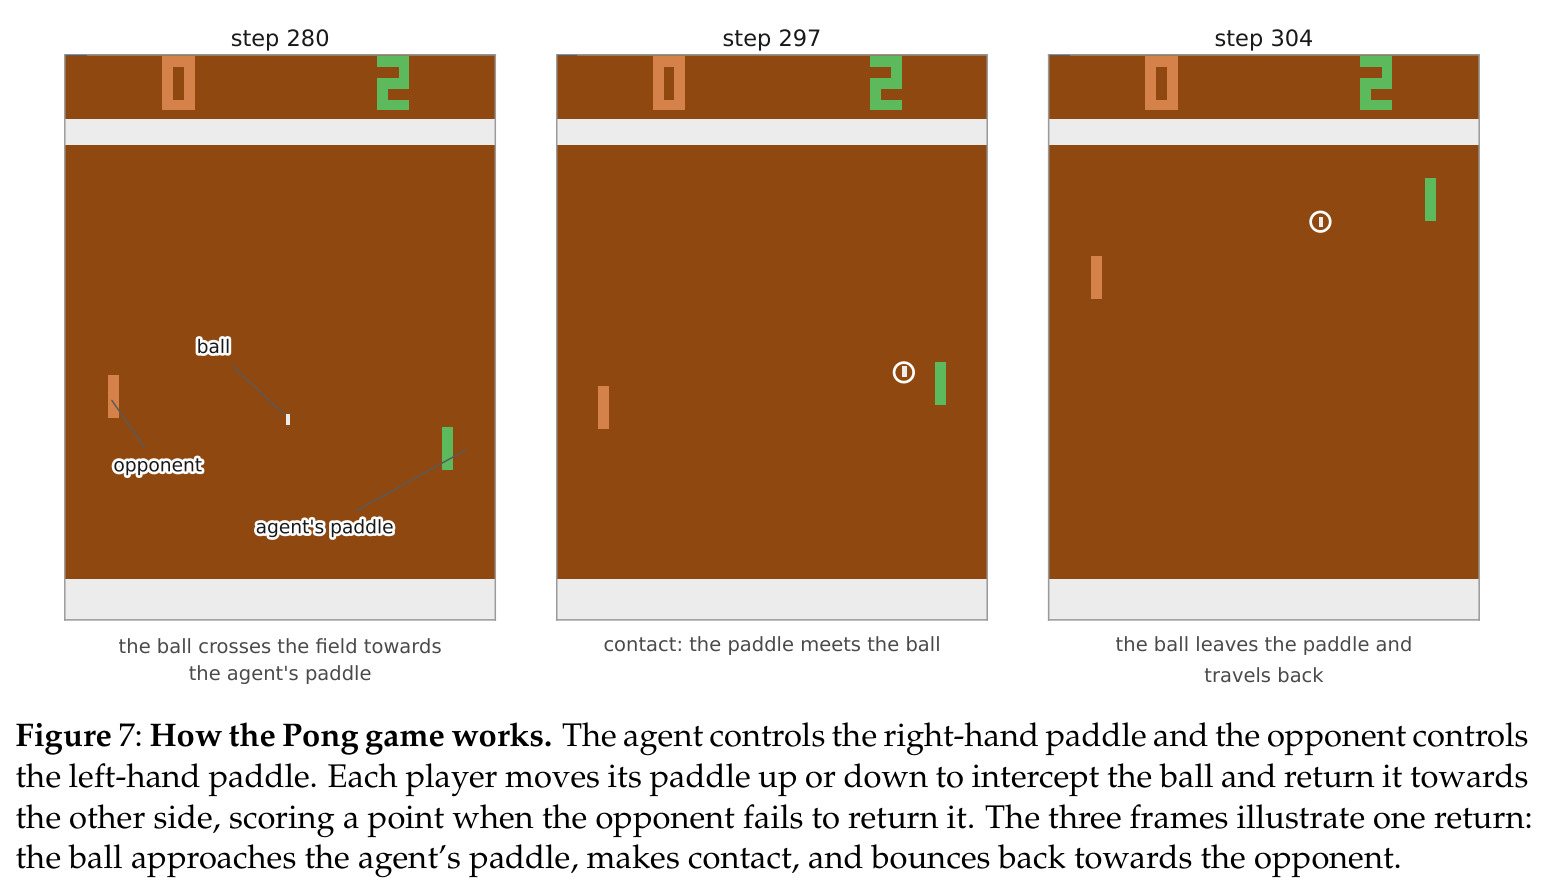
三帧连续画面解释 Pong 机制:智能体控制右侧球拍,对手控制左侧;三帧分别对应球飞向己方球拍(step 280)、球拍触球(step 297)、球被击回(step 304)。
为不熟悉 Pong 的读者提供案例研究的最低背景,并说明反馈控制任务(每帧依据新观测更新决策)与 ARC-AGI-3 离散规划的任务差异。