基于结构化框架的增量式开放式深度研究 Incremental Open-Ended Deep Research with Structured Harness
把研究报告当作持续演化的状态,用结构化框架做增量更新,省钱又连贯
前置知识
OEDR(开放式深度研究)
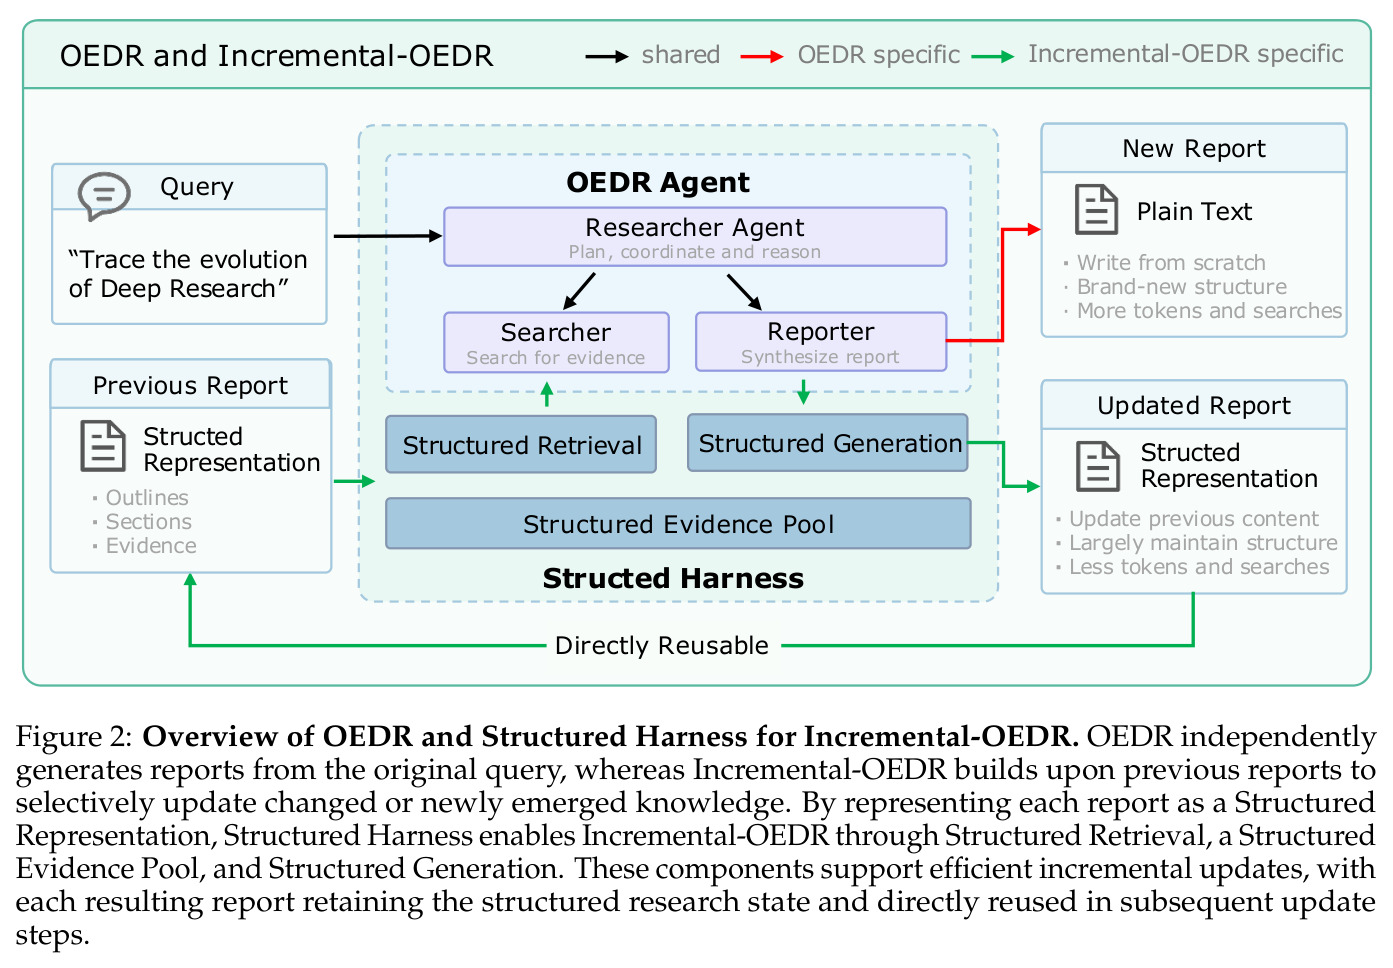
Open-Ended Deep Research 指让 LLM Agent 自主完成「规划研究策略→多轮搜索→验证证据→综合成报告」全流程的系统,产出有证据支撑的长篇研究报告。分两派:workflow 派按固定流水线(大纲→检索→写作)执行,agent 派由模型根据中间发现动态决定下一步动作(搜索、读源、改计划、写报告)。典型代表有 ms-agent、WebWeaver 等。
本文的核心论点就是现有 OEDR 都是「一次性从零生成」,作者提出的 Incremental-OEDR 是对 OEDR 任务设定的直接扩展,不理解 OEDR 的动作循环就无法理解增量更新改了什么。
RACE 评测
DeepResearch Bench 官方报告质量评测方法,用评委 LLM 将生成报告与参考报告对比,从四个维度打分:全面性(Comprehensiveness)、深度与洞察(Insight/Depth)、指令遵循(Instruction-Following)、可读性(Readability),总分为加权求和。本文按新官方协议使用 GPT-5.5 作为评委模型计算 RACE Overall 分数。
论文的主实验表(Table 1)全部以 RACE Overall 分数衡量报告质量,理解其四维打分机制才能正确解读「增量更新不掉点」这一结论。
报告连续性指标(ROUGE-L / BLEU-4 / EM F1)
ROUGE-L 基于最长公共子序列衡量两段文本的相似度,BLEU-4 基于 4-gram 精确率,两者都用于内容级连续性;大纲级连续性则取报告前三层标题,用 ROUGE-L F1 和精确匹配率(EM F1)衡量前后版本结构的一致性。这些指标原本用于摘要/翻译评测,这里反过来用:分数高说明更新没有「推倒重来」。
本文最大的贡献数字(内容级 ROUGE-L F1 提升 0.51、大纲级 EM F1 提升 0.63)全部来自这组指标,它是「报告连续性」这一新评测维度的具体落点。
时间受控评测(temporal evaluation)
通过搜索 API 的 end_date 参数(本文用 Tavily)把 Agent 可见的信息限制在某个历史时间点 $t$ 之前,从而模拟「回到 2016 年做研究」。同一个 query 在不同时间戳下检索到的世界信息不同,可以测出报告质量随信息环境的漂移,也能构造「从 $t-1$ 更新到 $t$」的增量任务对。
本文全部实验(2016–2025 十个时间戳、SST/LCT 两种任务、更新间隔实验)都建立在这个模拟机制上,这是理解其实验设计的钥匙,也是作者自认的局限所在。
ms-agent
ModelScope 开源的 OEDR Agent 框架,采用 Researcher 主 Agent 协调 Searcher(搜证据)和 Reporter(写报告)子 Agent,用文件系统保存研究工件,是 DeepResearch Bench 排行榜上的开源 SOTA 系统。
本文不另起炉灶,而是把 ms-agent 作为底层 OEDR Agent 加装 Structured Harness 改造成增量系统,因此论文里所有 MS-Agent(OC)/(PC) 基线本质上就是「同一系统的从零重跑版」,对比非常公平。
研究动机
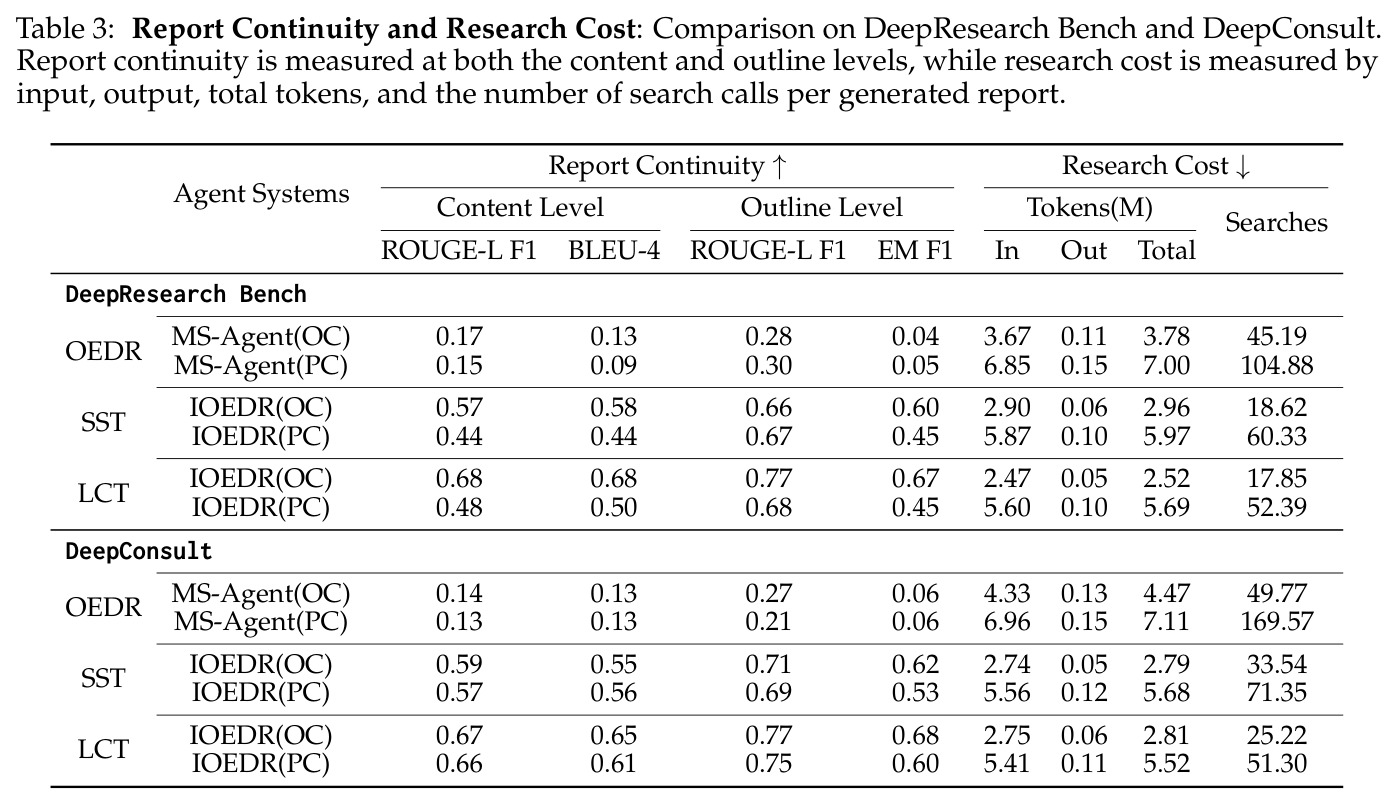
现有 OEDR 系统(无论 workflow 派还是 agent 派)都默认「一次性从零生成报告」:每次给定 query $q$,系统重新规划、重新搜索、从空白文档写起。但在真实业务里,报告是需要长期维护的活文档——AI 行业分析要不断纳入新发布的模型,经济报告要随新统计指标滚动更新。最朴素的做法是每次更新时把 OEDR 整个重跑一遍,这有两个严重代价:其一是浪费,旧报告的大部分内容在新时间点依然成立,重跑等于对未变化的知识反复支付检索和生成的算力(本文实测 MS-Agent(OC) 在 DeepResearch Bench 上平均每份报告要烧 3.78M token、发起 45.19 次搜索调用);其二是不一致,每次独立运行都会产生结构和措辞大相径庭的报告——重跑后内容级 ROUGE-L F1 只有 0.17、大纲级 EM F1 只有 0.04,意味着读者熟悉的章节结构被无谓打乱,长期追踪同一主题的用户体验极差。
本文的目标是作者要建立一个新的研究设定 Incremental-OEDR:给定上一版报告 $R_{t-1}$ 和新时间戳 $t$ 的目标,产出下一版 $R_t = F(q, R_{t-1}, I_t)$,要求同时做到三件事——保留仍然有效的知识、修订过时或不完整的内容、纳入新出现的信息。并配套一个可量化评测的框架:把 2016–2025 十年每个 12 月 31 日设为时间戳,用 Single-Step Task(SST,单次更新)和 Long-Chain Task(LCT,最长九年连续更新链)两种任务,从 Report Quality、Report Continuity、Research Cost 三个维度系统评估增量更新是否「不掉质量、大幅提连贯、显著降成本」。
与已有工作不同的是,已有 OEDR 工作的竞争焦点都在「单次生成的质量」上——更好的规划、更好的记忆、更好的图结构(如 WebWeaver、DualGraph),没有人把「报告的演化维护」本身当作研究问题。本文的独特切入点是:报告不该是一次性产物而是持续演进的研究状态,而阻碍增量化的瓶颈不在 Agent 的推理能力,而在表示层——纯文本报告无法被程序化地局部检索、局部比对、局部改写。于是作者把问题重构为「给 OEDR Agent 提供一个结构化操作界面」:只要报告被表示为大纲+章节+证据的结构化对象,重用、检索和编辑就都成了可定义的工具调用。这个「先改数据结构、再改研究过程」的视角是全文最与众不同的地方。
核心方法
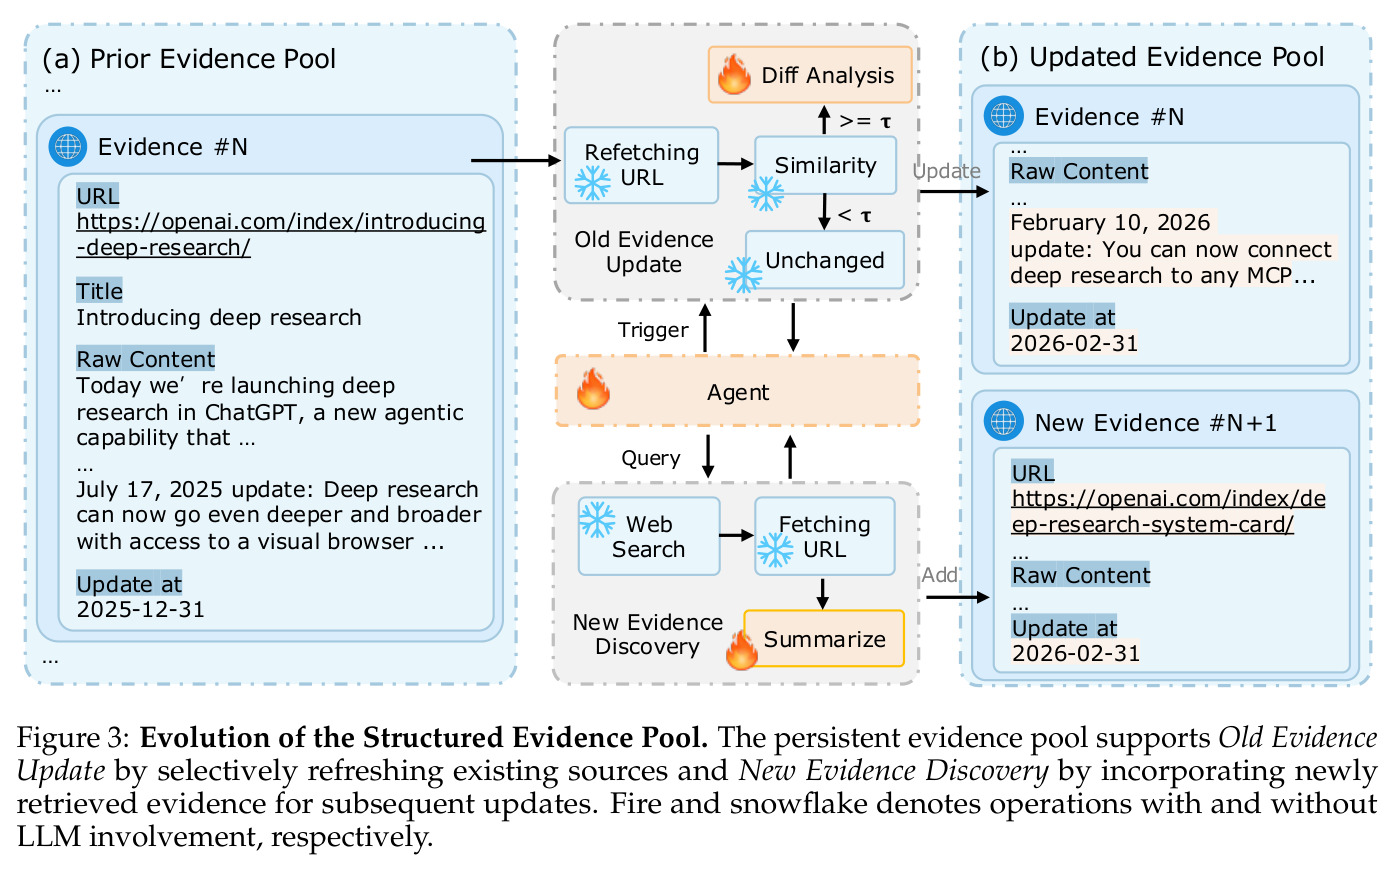
直觉上,一个负责任的分析师在季度更新行业报告时,不会推倒重写,而是先翻旧报告定位哪些章节过时、哪些证据需要复查、哪些新进展要补进去,然后只改动必要的部分。Structured Harness 就是把这套人类工作流工程化。技术上它由「一个表示 + 三个能力」组成:结构化表示把报告 $R_t$ 形式化为三元组 $R_t = \langle o_t, s_t, e_t \rangle$,其中 $o_t$ 是大纲、$s_t$ 是章节单元集合、$e_t$ 是支撑证据集合;结构化检索让 Agent 按当前信息需要只读取报告的相关部分(相关大纲、特定章节及其引用);结构化证据池持久保存每条证据的来源 URL、标题、原文和更新时间戳,支持旧证据批量刷新和新证据自动入库;结构化生成则约束写作过程为「直接对报告组件做编辑操作」——章节可保留、可修订、可扩展。整体叠加在 ms-agent 的 Researcher/Searcher/Reporter 架构上,把 OEDR 从无约束的重新生成变成「研究重用 → 证据刷新 → 报告编辑」的结构化流程。
核心创新是把增量更新的难点从「让模型记住旧报告」转移到「给模型一个可操作的研究状态」。与已有方法的本质区别有三点:第一,先前系统即使带记忆(如 WebWeaver 的记忆机制)也是为单次生成服务,更新时仍从零规划;本文显式把 $R_{t-1}$ 写进研究函数 $R_t = F(q, R_{t-1}, I_t)$,与一次性的 $R_t = F(q, I_t)$ 形成对照。第二,证据池不是被动缓存而是带变更检测的活跃状态:刷新工具重新抓取网页后先算字符级相似度,只有低于阈值 $\tau=0.9$ 才触发 LLM 做 claim 级 diff 分析,把「是否需要动脑」变成了可量化的路由决策,这是省钱的关键。第三,结构化生成把自由文本生成问题转化为带约束的编辑问题,输出天然继承旧结构,从而使「连续性」从运气变成了系统属性。
方法步骤详情
完整流程如下:第一步,加载上一版报告的结构化表示 $R_{t-1} = \langle o_{t-1}, s_{t-1}, e_{t-1}\rangle$(若来自普通 OEDR 则先做结构化解析;若来自上一轮 Incremental-OEDR 则证据池直接可用,这也是 LCT 比 SST 更省的原因)。第二步,结构化证据池的旧证据更新:对池中每条证据,批量重新抓取其源 URL,用 Crawl4AI 解析后计算新旧文本的字符级相似度;若相似度 $\ge \tau=0.9$ 判定未变化直接跳过(纯程序操作,无 LLM 开销),若 $< \tau$ 才调用 LLM 做 claim 级 diff 找出具体变了什么。第三步,Researcher Agent 基于结构化检索按需读取旧报告的相关大纲、章节和证据,决定研究计划;对新信息执行搜索(底层走 Tavily,带 end_date 时间限制),新检索到的证据连同 URL、标题、原文、时间戳自动写入证据池(新证据发现)。第四步,Reporter 以结构化生成模式产出 $R_t$:逐章节判断保留、修订还是扩展,未受影响的内容和整体大纲原样继承。第五步,更新后的 $R_t$ 连同刷新过的证据池成为下一轮更新的输入,形成 $R_{t-1} \to R_t \to R_{t+1} \to \cdots$ 的演化链。
技术新颖性
技术新颖性体现在四个层面。表示层:$\langle o, s, e \rangle$ 三元组让大纲、章节、证据成为一等公民,报告从「一份文本」升格为「一个可查询、可修改的数据库」,这是后续一切操作的前提。检索层:结构化检索提供的是「对已有研究的定向视图」而非全文塞进上下文,Agent 第 $k$ 步按 $a_k \sim \pi_\theta(\cdot \mid q, c_k)$ 选择的动作可以只携带需要的报告切片。成本层:证据池的相似度门控 $\tau=0.9$ 把昂贵的 LLM diff 分析只花在真正变化的来源上,配合新证据跨轮复用,实测搜索调用从 45.19 次降到 17.85 次(LCT)。评测层:十年时间跨度 + SST/LCT 双任务 + 质量/连续性/成本三维指标是方法论贡献——作者发现同一 OEDR 系统 2016 年的 RACE 分数(47.57)和 2025 年(49.28)相差超过 1.7 分,说明只在「最新信息」上评测会系统性高估或低估系统,这一发现独立于方法本身也有价值。
实验结果
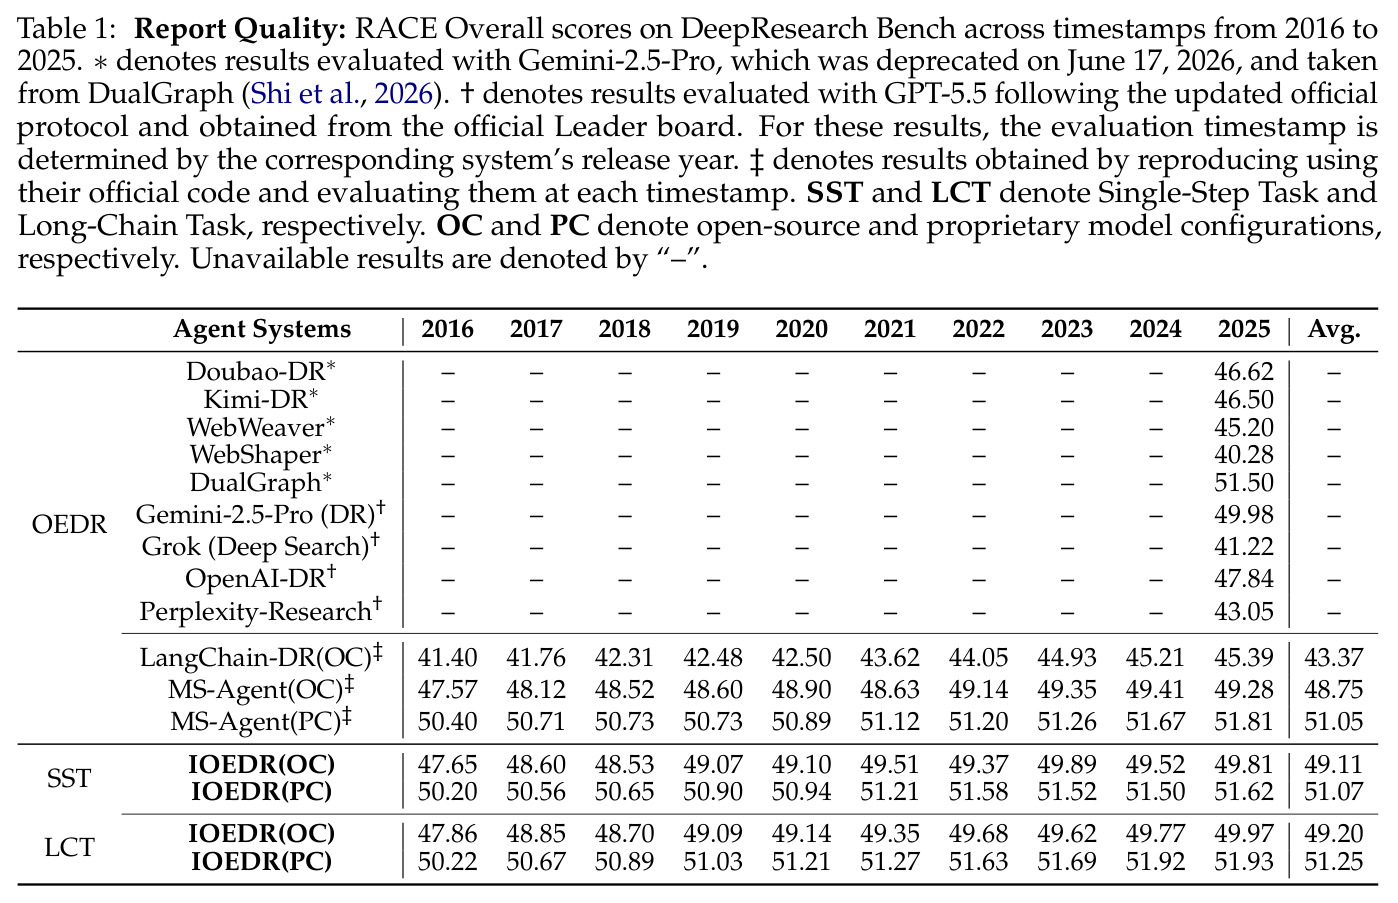
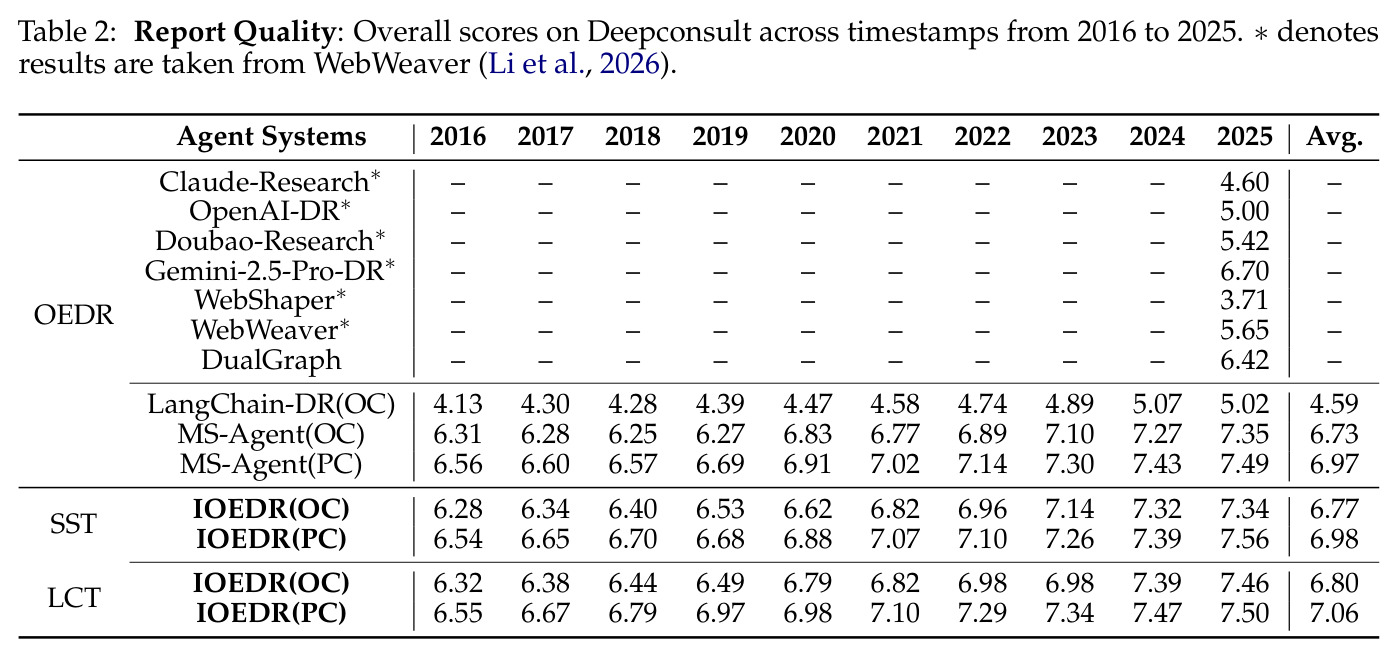
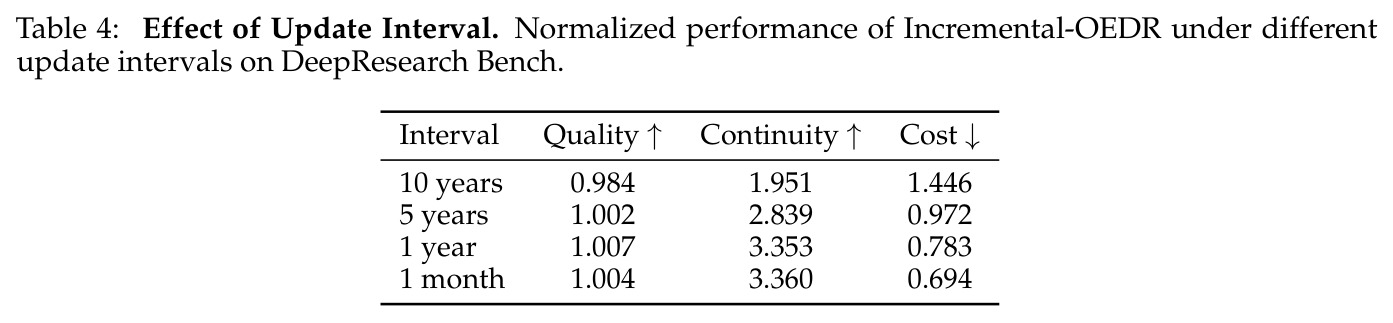
主实验覆盖 DeepResearch Bench(100 个博士级任务、22 个领域,RACE Overall 评分)和 DeepConsult(商业咨询类 query,GPT-4.1 打平均质量分 1–10),在 OC(Qwen3.5-397B-A17B 做 Researcher + Qwen3.5-122B-A10B 做子 Agent)和 PC(GPT-5 做 Researcher + Qwen3.5-397B-A17B)两种配置下于 2016–2025 十个时间戳评估。质量方面:Bench 上 IOEDR(OC) 平均 RACE 49.11(SST)/49.20(LCT),略高于 MS-Agent(OC) 的 48.75;PC 下 51.07/51.25 vs 51.05;DeepConsult 上 6.77/6.80 vs 6.73,PC 下 6.98/7.06 vs 6.97——增量更新完全没有以质量换效率,LCT 甚至微弱反超,说明九年连续更新不会累积劣化。连续性方面收益巨大:Bench 内容级 ROUGE-L F1 从基线的 0.17/0.13 升到 0.57(SST)/0.68(LCT),大纲级 EM F1 从 0.04 飙到 0.60/0.67;DeepConsult 内容级从 0.14 升到 0.59/0.67。成本方面:Bench 上总 token 从 3.78M 降到 2.96M(SST,-22%)再降到 2.52M(LCT,-33%),搜索调用从 45.19 次降到 18.62/17.85 次(-59%/-61%);DeepConsult 上 token 从 4.47M 降到 2.79M/2.81M,搜索从 49.77 降到 33.54/25.22。两个后续分析很精彩:其一,同一系统不同年份的分数差异(MS-Agent(OC) 47.57→49.28)揭示时间受控评测的必要性;其二,更新间隔实验(Table 4)显示 1 年间隔下质量比 1.007、连续性比 3.353、成本比 0.783 是甜点,10 年间隔成本反超基线(1.446×)且质量下降(0.984),1 个月间隔收益递减。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DeepResearch Bench 报告质量(SST) | RACE Overall(GPT-5.5 评委) | IOEDR(OC) 平均 49.11(2016–2025 十时间戳);IOEDR(PC) 51.07 | MS-Agent(OC) 48.75;MS-Agent(PC) 51.05 | +0.36(OC)/ +0.02(PC),质量持平略升 |
| DeepResearch Bench 报告质量(LCT) | RACE Overall | IOEDR(OC) 49.20;IOEDR(PC) 51.25 | MS-Agent(OC) 48.75;MS-Agent(PC) 51.05 | +0.45(OC)/ +0.20(PC),长链更新仍不掉点 |
| DeepConsult 报告质量 | GPT-4.1 平均质量分(1–10) | IOEDR(OC) 6.77/6.80(SST/LCT);IOEDR(PC) 6.98/7.06 | MS-Agent(OC) 6.73;MS-Agent(PC) 6.97 | +0.04~+0.09,两个配置均为正向 |
| DeepResearch Bench 报告连续性 | 内容级 ROUGE-L F1 / 大纲级 EM F1 | 0.57/0.60(SST)、0.68/0.67(LCT),IOEDR(OC) | MS-Agent(OC) 0.17/0.04(内容/大纲) | 内容级最高 +0.51,大纲级最高 +0.63 |
| DeepResearch Bench 研究成本 | 总 token(M)/ 每报告搜索次数 | 2.96M / 18.62(SST)、2.52M / 17.85(LCT) | MS-Agent(OC) 3.78M / 45.19 | token 最多 -33%,搜索最多 -61% |
| 更新间隔敏感性(SST, OC, Bench) | 相对 OEDR 基线的归一化质量/连续性/成本 | 1 年间隔:1.007 / 3.353 / 0.783 | 10 年间隔:0.984 / 1.951 / 1.446 | 1 年是甜点:质量更高、成本更低;10 年全面劣化 |
局限与改进
作者坦承两点:一是时间模拟依赖 Tavily 的 end_date 参数,只能控制「哪些网页可见」,无法模拟同一网页内容随时间的演化——而现实中旧证据失效恰恰多发生在原页面被改写时,这使得旧证据更新模块的实测收益可能被低估或失真;二是实验借用现有 OEDR 基准,它们并非为增量维护设计,参考报告本身没有「演化」语义,专门的增量基准(带真实时间演化的来源)仍属空白。我自己的观察还有几点:评测的连续性指标存在被「讨好评」的风险——极端情况下复制粘贴旧报告能拿满分连续性,ROUGE 类指标无法区分「合理保留」与「懒惰不更新」,论文虽有质量分兜底但二者联合的博弈空间值得警惕;其次所有结论建立在 ms-agent 单一底座上,Structured Harness 与该框架的 file-system 工件机制耦合较深,可移植性未验证;另外 $\tau=0.9$ 这单一相似度阈值对不同语言、不同更新节奏的来源是否鲁棒没有做消融;十年模拟里的「参考报告」如何处理时间一致性也未详述,评委 LLM(GPT-5.5/GPT-4.1)本身的知识截止时间可能对早期时间戳的评分引入偏差。
独立分析的弱点
第一个弱点是变更检测粒度太粗:字符级相似度 $\tau=0.9$ 是全局信号,一个页面上 5% 的关键数字更新(如某模型参数量)可能让相似度仍有 0.95 而被跳过,反之大量无害的排版改版会把相似度打到阈值以下、浪费 LLM diff 调用。改进方向:对证据做 claim 级索引,按 claim 粒度做嵌入相似度比对,或先用轻量分类器判断「变化是否实质」。第二个弱点是连续性与质量的联合优化没有显式建模:系统没有任何机制防止 Agent 为省事而过度保留旧内容,建议在生成阶段引入「时效性约束」——对带时间戳的陈述强制要求证据池中存在不早于 $t$ 的佐证,否则标记为待验证。第三个弱点是评测的裁判可信度:GPT-5.5 评委自身的知识截止于训练数据,评 2016 年的「当时最优报告」时可能用未来知识打分;改进方向是像检索一样给评委也做时间 masking,或用同时期的历史文档做 blind 参照。第四个弱点是单底座依赖:Harness 的工具接口绑定 ms-agent 的文件系统,换到 LangChain-DR 或其他 Agent 框架的成本不明,抽象出一套标准的「研究状态 API」(类似 MCP 之于工具)会大大增强说服力。第五,证据池的存储与一致性没有讨论:九年链式更新后池中证据数量、陈旧证据的淘汰策略、以及多报告共享同一池时的冲突处理都未涉及。
未来方向
作者明确提出:构建专门的 Incremental-OEDR 基准,包含真实随时间演化的研究场景和明确被更新的信息源(例如用 Wayback Machine 的历史网页快照替代 end_date 模拟),并让网页内容演化可被仿真。在此之上可以延伸出几个方向:一是把相似度门控升级为学习式变更检测器,用「哪些证据最终导致章节修订」做弱监督训练;二是研究更新链上的知识漂移——LCT 跑九年质量反而微升,但更长时间(20 年、50 年)或领域剧变(如金融危机)下结构化继承会不会变成「锚定偏差」,需要专门的失败模式分析;三是多报告协同维护:同一证据池服务一个机构的多份相关报告(AI 行业报告与芯片供应链报告共享证据),可以进一步摊薄搜索成本;四是对话式增量研究:把「报告更新」与「用户反馈」结合,让用户指定关注点,结构化表示恰好是接收这种细粒度指令的理想接口;五是蒸馏:用 IOEDR 的(旧报告,新报告,diff)三元组训练专门的「报告编辑器」小模型,把 33% 的 token 节省进一步放大。
复现评估
复现条件总体友好但有门槛。有利因素:底层 ms-agent 开源(GitHub: modelscope/ms-agent),DeepResearch Bench 和 DeepConsult 均为公开基准且官方提供评测协议与排行榜,检索端 Tavily、抓取端 Crawl4AI 都是公开服务,论文附录 B 承诺提供实现细节和完整 prompt,且方法本身的设计目标是省算力——OC 配置下每份报告仅 2.5–3M token、约 18 次搜索,跑完 100 题 × 10 时间戳的 SST 大约是 3B token 量级,用开源 Qwen3.5 API 或自托管均可负担,LCT 因共享证据池更省。不利因素:论文未附开源代码链接(仅有项目页 ioedr-project.github.io),Structured Harness 的结构化解析、证据池 schema、diff 分析 prompt 都需要自行实现;PC 配置需要 GPT-5 权限;10 年时间戳 × 每时间戳的 OEDR 初始化报告是隐性的前置成本(基线部分约 45 次搜索/报告);RACE 评测依赖指定的评委模型(GPT-5.5),评委 API 费用与版本漂移会影响分数可比性。综合估计:一个有 Agent 开发经验的小团队复现 OC 主表约需 1–2 周,主要工作量在证据池与结构化生成的工程细节上。
论文图表
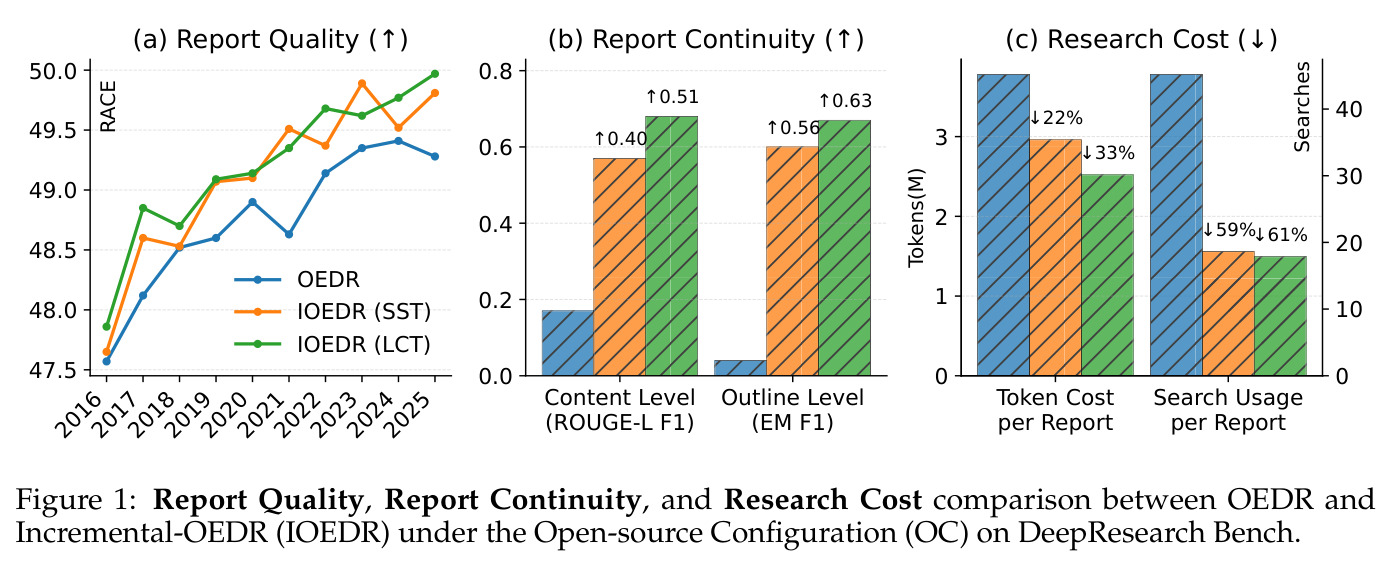
三联柱状图:(a) 报告质量(RACE,越高越好)显示 2016–2025 每年 IOEDR(LCT) 与 OEDR 分数几乎重合甚至略高;(b) 报告连续性(越高越好)显示内容级 ROUGE-L F1 提升 0.51、大纲级 EM F1 提升 0.63;(c) 研究成本(越低越好)显示每报告 token 降 33%、搜索次数降 61%。
这是论文的「一图流」总结,用三个维度(质量不掉、连贯暴涨、成本大降)一眼呈现全文核心主张,是向他人介绍本文时的最佳入口。