GRACE:面向高效视频生成的生成感知潜空间压缩 GRACE: Generation-aware latent compression for efficient video generation
双潜空间表示+DiT特征对齐,token压缩约8倍,质量持平且推理提速11-15倍
前置知识
Diffusion Transformer (DiT)
把噪声潜变量按 patch 切成 token 序列,用 Transformer 逐块去噪的生成骨干网络(如 Wan2.1-14B,40 个块、隐藏维 5120)。其自注意力的计算量随 token 数平方增长,因此 token 数直接决定推理成本。
本文加速视频生成的根本手段就是减少 DiT 要处理的 token 数,所有设计都围绕'如何让 DiT 在更少 token 上照常工作'展开。
潜空间视频扩散与视频自编码器
视频自编码器(VAE)用 3D 因果卷积把视频 $x$ 压缩成潜变量 $z=E(x)$,空间压缩 $f$ 倍、时间压缩 $t$ 倍(常见 f8t4),DiT 在潜空间去噪,最后由解码器 $\hat{x}=D(z)$ 还原像素。token 数由 $f,t$ 和 patch 大小 $p$ 共同决定。
本文的对象就是预训练好的 Wan2.1-VAE + DiT 管线,要做的是把自编码器从 f8t4p2 进一步压到 f16t8p2 而不破坏整条管线。
Rectified Flow / Flow Matching
一种扩散训练形式:噪声水平 $\tau\in[0,1]$ 下构造 $z_\tau=(1-\tau)z_0+\tau\epsilon$,网络 $v_\theta$ 预测 $(\epsilon-z_0)$,损失为 $\mathcal{L}_{velocity}=\mathbb{E}\|v_\theta(z_\tau,\tau,c)-(\epsilon-z_0)\|^2$。时间表经 shift 函数 $\tau=\psi_s(u)$ 映射,$u=1$ 为纯噪声、$u=0$ 为干净 latent。
本文的非对称去噪就是在 flow-matching 时间表上给 base/residual 两个分量安排不同的 $u$,读懂式(11)-(14)必须先掌握这套记号。
重建-生成困境
VA-VAE 等工作发现:重建指标(PSNR/SSIM)更好的 latent 不一定更容易被扩散模型生成;而为保重建在高压缩下增加 latent 通道数,又会拖慢 DiT 收敛甚至损害生成质量,二者存在此消彼长。
这是全文的核心论点:论文用 Table 1 系统证明'重建好≠生成好',并据此提出在 DiT 特征空间里对齐 latent 的生成感知目标。
LoRA 低秩适配
冻结预训练权重 $W$,只训练低秩增量 $\Delta W=BA$($B\in\mathbb{R}^{d\times r},A\in\mathbb{R}^{r\times k}$),秩 $r\ll d$,大幅降低大模型微调的参数量与显存。
Stage 2 中 14B 的 DiT 只靠 LoRA(秩 512)加部分全微调的投影层完成适配,总预算仅 30 H200 GPU 天,这是方法低成本的关键。
研究动机
视频扩散模型的算力瓶颈集中在 DiT 上:注意力随 token 数平方增长,而 token 数由视频自编码器的压缩率决定。Wan2.1-VAE(f8t4p2)在 480×832×81 分辨率下产生约 32.8k 个 token,50 步采样在 A100 上要 851.5 秒(736p 下高达 3361.3 秒),完全无法实时。直接提高压缩率会显著损失重建质量;为保住重建,现有高压缩自编码器(LTX-VAE、Video DC-AE、Step-Video-VAE)转而把每个 token 的通道加宽到 128 维,但高维 latent 已被证明会拖慢 DiT 收敛并损害生成质量——Open-Sora 2.0 复用预训练 DiT 去适配从零训练的 Video DC-AE,在 160 张 GPU 上训练后视频仍然模糊、未完全收敛。而这些自编码器均从零训练,既丢掉预训练知识又成本高昂;即便给预训练 VAE 外挂压缩块、只按重建目标微调,latent 分布也会漂移出 DiT 熟悉的空间,生成质量照样下降。
本文的目标是本文的目标是:在不从头训练任何大模型的前提下,把 Wan2.1 管线的自编码器从 f8t4p2 压缩到 f16t8p2(空间 16×、时间 8×),使 480×832×81 的 token 数从 32.8k 降到 4.3k(约 8 倍);同时保持与预训练 DiT 的兼容性,让 VBench 生成质量与压缩前的原管线持平,端到端延迟降低一个数量级,并把总训练预算控制在 38.5 H200 GPU 天以内。更进一步,作者希望打破'为生成牺牲重建还是为重建牺牲生成'的两难,让压缩后的 latent 同时对解码器和生成器友好。
与已有工作不同的是,独特的切入角度是:不把'压缩自编码器'当作独立的重建问题,而是利用'预训练自编码器与 DiT 已经是彼此对齐的生成管线'这一事实,让管线自己指导自己的压缩。这与三条已有路线都不同:(1) 从零训练高压缩 VAE(DC-AE、LTX-VAE)会产生全新 latent 空间,把适配负担全转嫁给 DiT;(2) DC-Gen 等后训练方法是在 latent 已经分叉之后再去修补 DiT;(3) 用视觉基础模型(如 V-JEPA)正则 latent 的 VA-VAE 路线需要从零训练生成器。GRACE 反其道而行:base latent 直接取自冻结的预训练编码器、对齐损失放进冻结 DiT 的中间特征空间、生成时 base 先于 residual 去噪,三者共同保证 DiT 只需 LoRA 级别的轻量适配。
核心方法
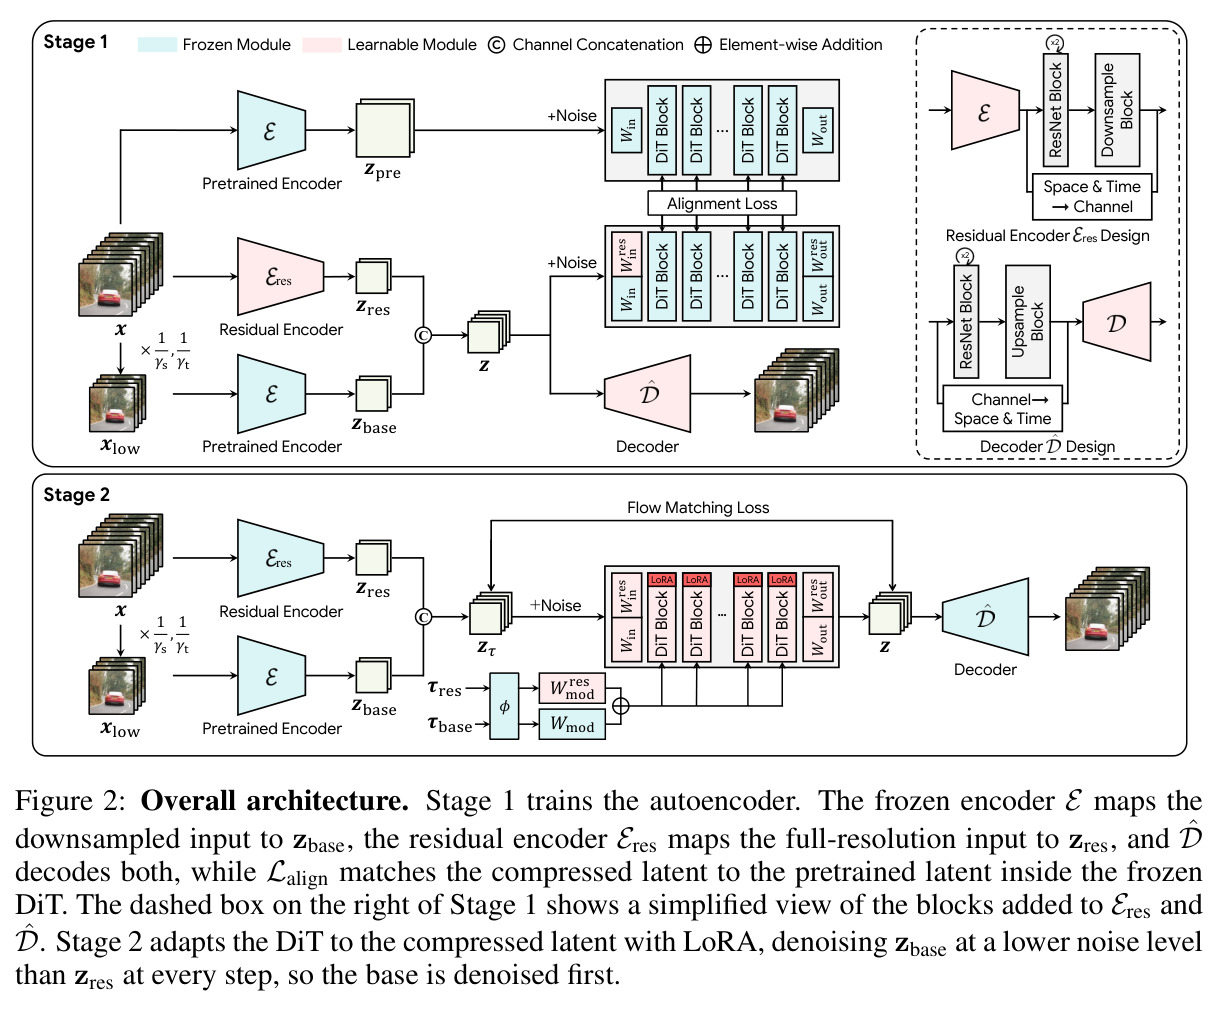
先说直觉:压缩 latent 必然丢信息,与其让一个全新 latent 硬扛全部信息、再逼 DiT 重新学习,不如把'预训练管线已经会表达的部分'和'压缩丢掉的部分'拆开——前者原样保留(DiT 无需重新学),后者用少量附加通道补齐。技术路线分两阶段。Stage 1 微调自编码器:把输入先空间 $r_s{=}2$、时间 $r_t{=}2$ 降采样后送入冻结的预训练编码器得到 base latent $z_{base}=E(x_{low})$;新增的 residual 编码器 $E_{res}$ 吃全分辨率视频,用 $C'{=}16$ 个附加通道携带 base 丢掉的空间细节与帧间运动;二者沿通道拼接为 $z=[z_{base};z_{res}]$。同时引入生成感知对齐损失 $\mathcal{L}_{align}$,在冻结 DiT 的前 10 层特征空间里让压缩 latent 与原 latent 的特征做余弦对齐。Stage 2 冻结自编码器,用 LoRA 适配 DiT,并以非对称去噪训练:base 的噪声水平始终比 residual 低一个偏移 $\delta$,residual 始终建立在基本成形的 base 之上。整个框架中,'压缩前的管线'一直在指导'压缩后的管线'如何训练。
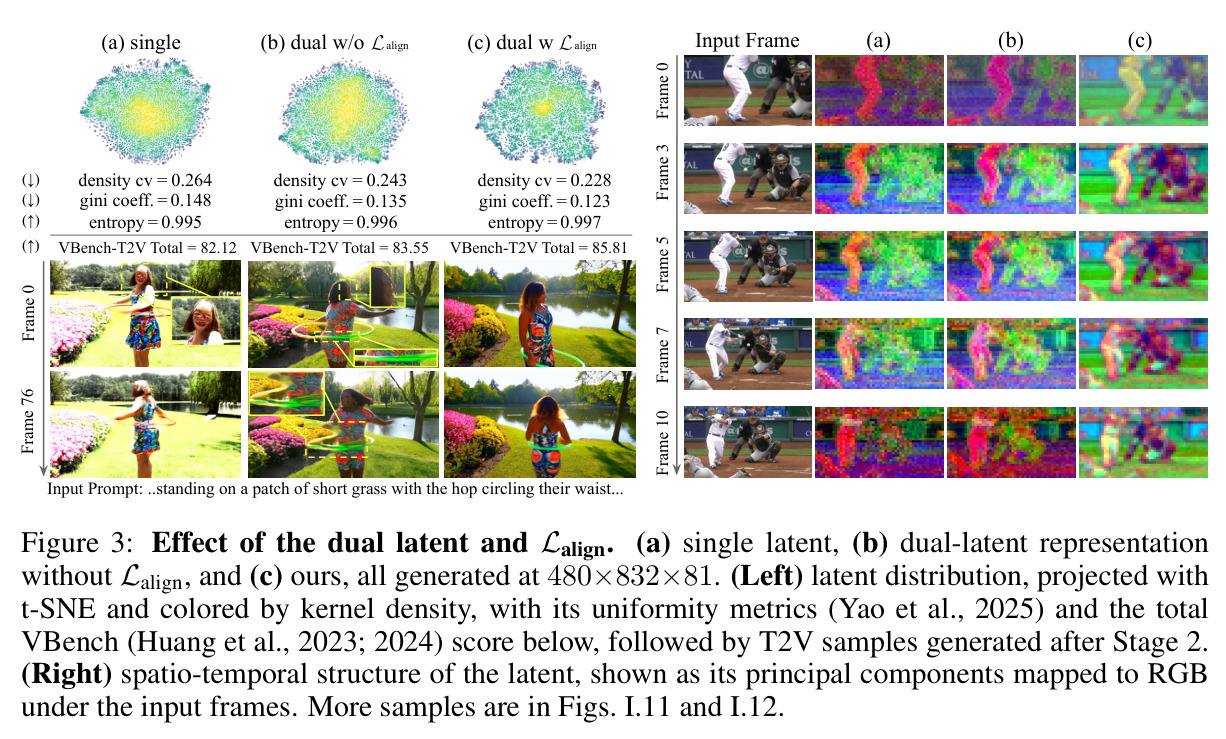
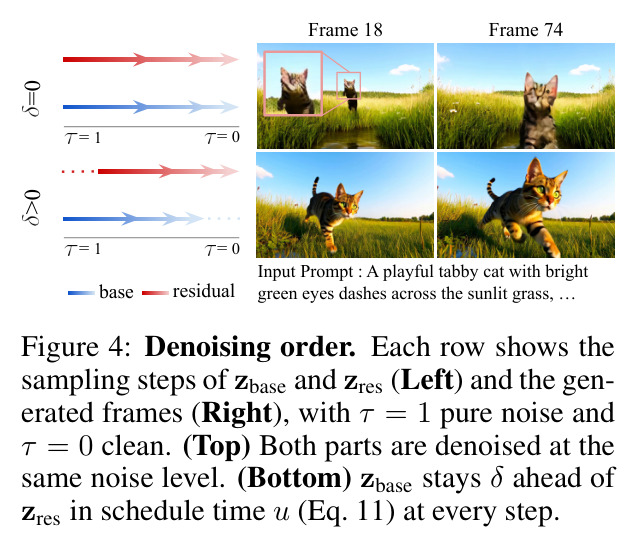
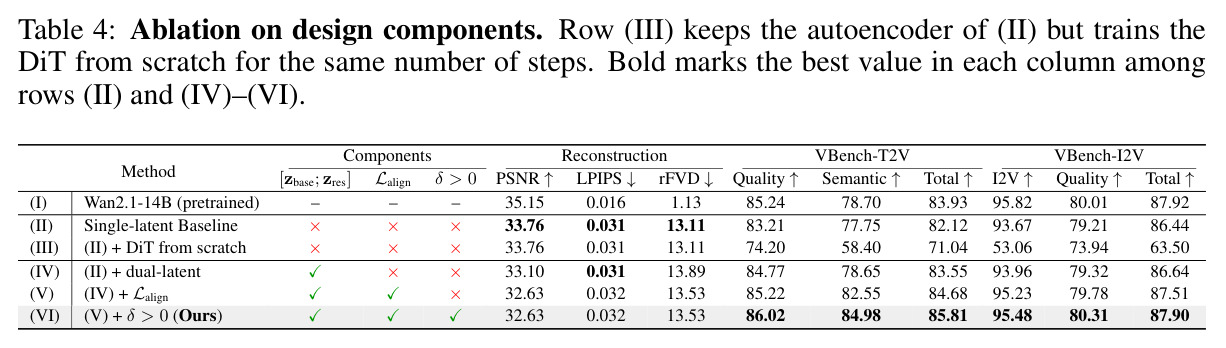
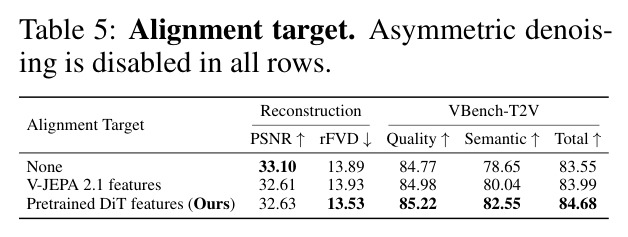
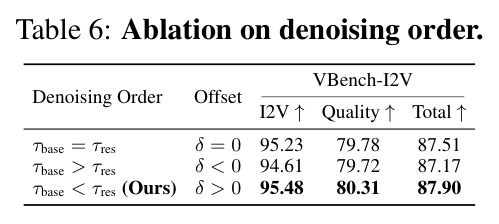
核心创新有三点。其一,双 latent 表示:base latent 来自冻结的预训练编码器,天然落在 DiT 预训练时见过的分布内,residual 只需补差,从结构上保证兼容性;而已有方法训练出全新 latent 空间,DiT 适配负担完全转嫁给生成模型。其二,生成感知对齐:作者实证发现仅优化重建会让 latent 漂移出 DiT 熟悉的分布(单潜基线 PSNR 33.76 更高但 VBench-I2V 只有 86.44),因此把对齐损失放进冻结 DiT 的中间层特征空间——消融显示对齐到 DiT 特征比对齐到 V-JEPA 2.1 特征的 T2V 语义分高 2.51(82.55 vs 80.04),说明'相关的结构正是 DiT 已经表示的那种'。其三,非对称去噪:base 在时间表上领先 residual($u_{base}=\max(\hat{u}-\delta,0)$,$u_{res}=\min(\hat{u},1)$),residual 的目标随 base 定形而愈发清晰、更容易生成;且两部分在同一次前向中完成去噪,推理零额外开销。Table 6 显示方向反过来会掉到 87.17,证明'base 先行'这一方向性本身才是关键。
方法步骤详情
Stage 1(自编码器,共 8.5 H200 GPU 天,Panda-70M 训练):(1) 输入视频 $x$ 经双线性降采样 $r_s{=}2$、时间抽帧 $r_t{=}2$ 得 $x_{low}$,冻结编码器 $E$ 输出 $z_{base}=E(x_{low})$;(2) $E_{res}$(预训练权重初始化,在中段块与输出头之间新增一个下采样块,配参数无关的'空间时间折进通道'shortcut)编码全分辨率 $x$ 得 $z_{res}$(16 通道);(3) 拼接 $z=[z_{base};z_{res}]$,解码器 $\hat{D}$(残差通道零初始化,训练起点即原重建质量)解码,I2V 时首帧经 $E_{res}$ 编码后通过门控交叉注意力注入 $\hat{D}$;(4) 以 $\mathcal{L}=\mathcal{L}_{recon}+w_{adaptive}\mathcal{L}_{align}$ 训练,$\mathcal{L}_{align}$ 对噪声化的两个 latent 过冻结 DiT,取前 10 个块特征做逐 token 余弦相似,低分辨率特征经三线性上采样加零初始化投影 $P_l$ 后对齐,权重 $w_{adaptive}=\|\nabla\mathcal{L}_{recon}\|/\|\nabla\mathcal{L}_{align}\|$(对 $E_{res}$ 末层卷积的梯度范数比);(5) 第二阶段在 512×512×81 上只微调解码器。Stage 2(DiT 适配,30 H200 GPU 天):输入/输出投影扩到 $C{+}C'$ 通道、RoPE 索引按 $r_s,r_t$ 缩放;每视频采样 $\delta\sim U(0,0.5)$、$\hat{u}\sim U(0,1+\delta)$,按 $z^\tau_{base}=(1-\tau_{base})z_{base}+\tau_{base}\epsilon_{base}$ 分别加噪,调制 $m=W_{mod}\phi(\tau_{base})+W^{res}_{mod}\phi(\tau_{res})$($W^{res}_{mod}$ 零初始化),flow matching 损失取两部分平均;LoRA 秩 512。推理固定 $\delta=0.15$,50 步采样覆盖 $\hat{u}\in[0,1+\delta]$,guidance 5.0、shift 3.0。
技术新颖性
与已有工作的本质区别:(1) 相比从零训练高压缩自编码器(DC-AE、LTX-VAE、Step-Video-VAE、Reducio),GRACE 完全复用预训练 VAE 权重,只加一个下采样块和 16 个残差通道,自编码器训练成本仅 8.5 H200 GPU 天;(2) 相比 DC-Gen 这类'先分叉再修补'的后训练适配,GRACE 从源头阻止 latent 分叉——base 通道就是 DiT 训练时见过的分布,Table 4 中同一 latent 从头训练 DiT 的 VBench-T2V 仅 71.04,而复用+对齐达 85.81;(3) '重建好≠生成好'虽由 VA-VAE 指出,但本文第一次把它落地到'压缩已有管线'场景,并给出直接可优化的目标——冻结 DiT 特征空间的对齐——而非间接正则,Table 5 证明其显著优于 V-JEPA 2.1 特征对齐;(4) 非对称去噪是一种新的'双时间表流匹配'训练方案:两个时间步共享 $\phi$、经两个投影进入 AdaLN,推理时无需额外前向,与 DC-AE 1.5 的结构化 latent 思路互补而非重叠。
实验结果
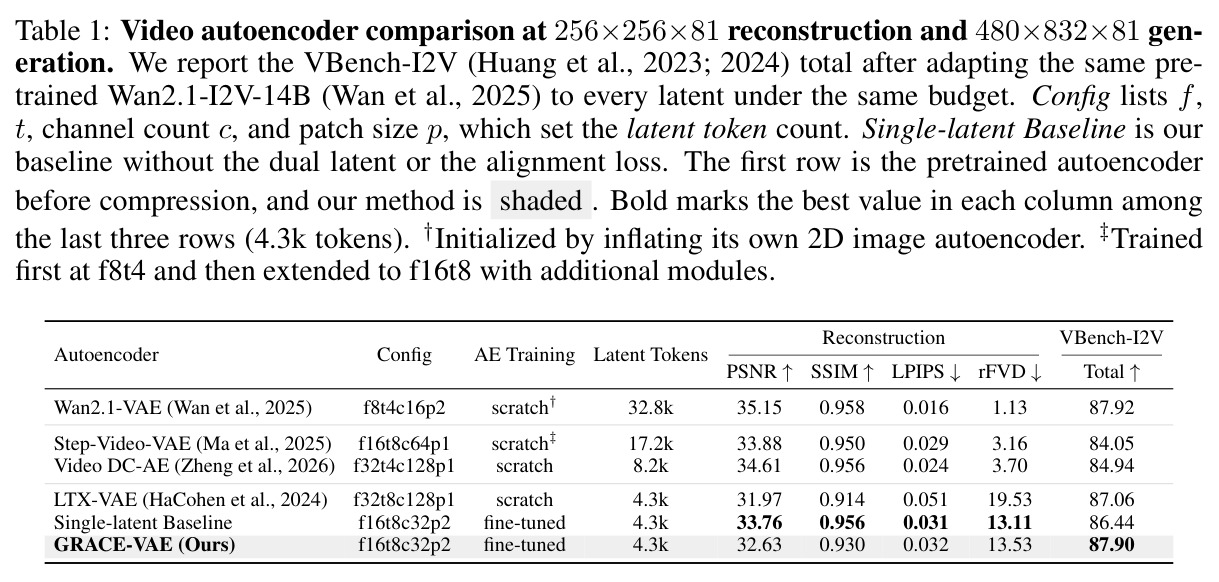
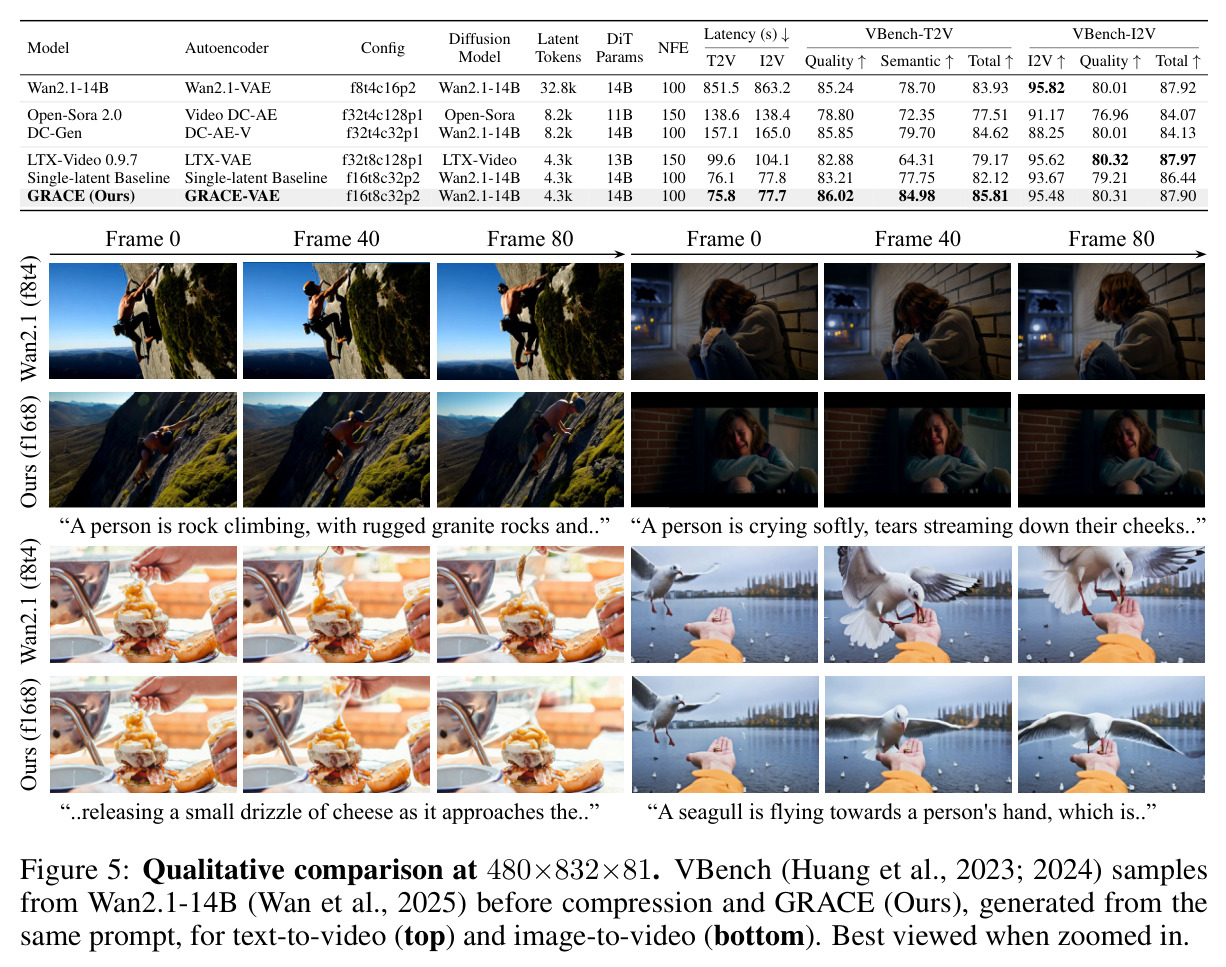
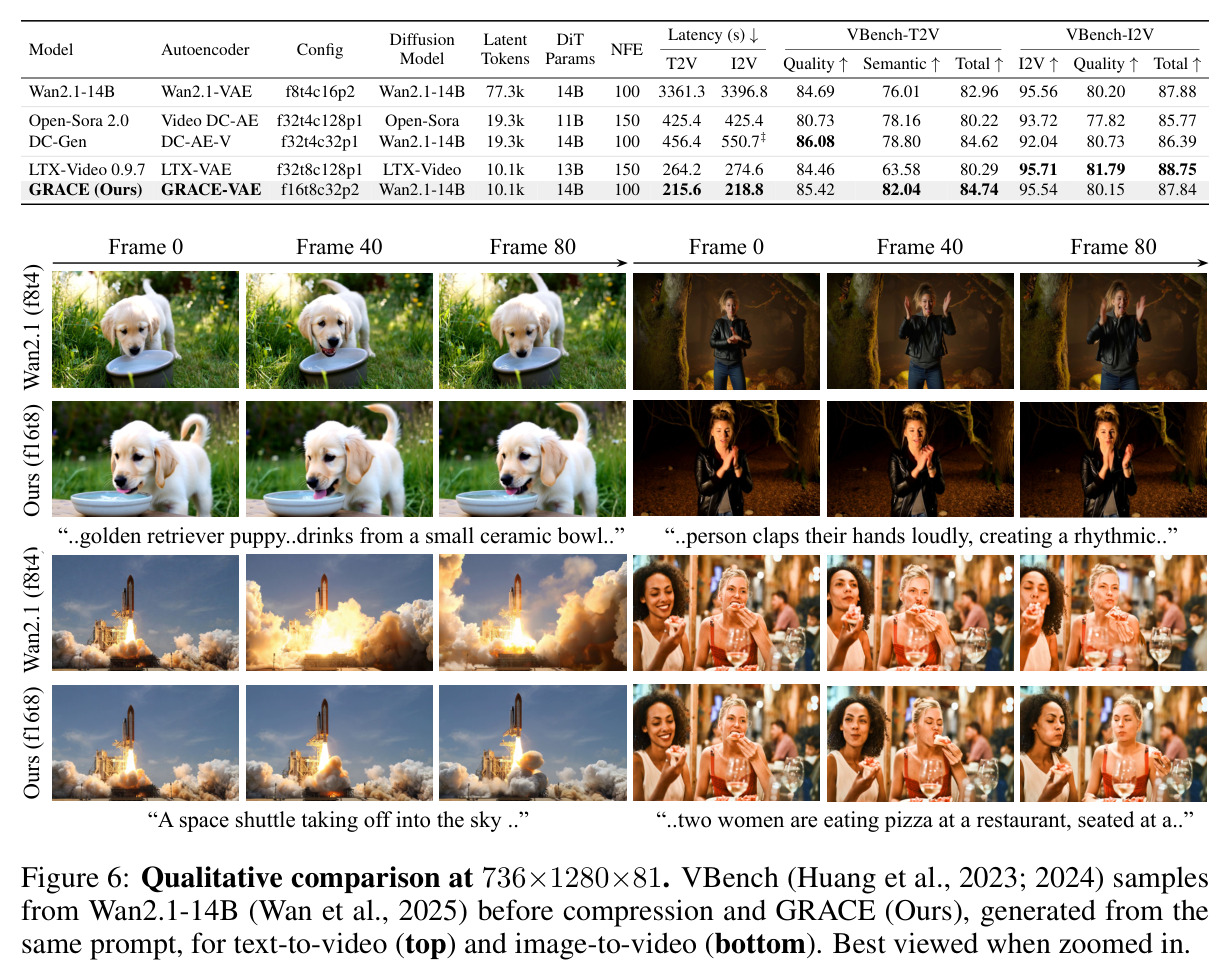
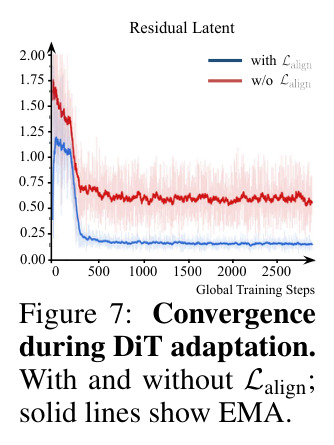
核心结果如下。(1) 压缩与速度:token 从 32.8k 降到 4.3k(约 7.6×),480×832×81 下端到端延迟 T2V 851.5s→75.8s(11.1×)、I2V 863.2s→77.7s;736×1280×81 下 3361.3s→215.6s(15.5×),且速度优势随分辨率增大。(2) 生成质量:VBench-I2V 总分 87.90 vs 原管线 87.92(差仅 0.02);VBench-T2V 总分 85.81 vs 83.93(反超 1.88),增益主要来自语义分 84.98 vs 78.70(领先第二名 DC-Gen 5.28),其中 color 97.29 vs 89.68、spatial relationship 91.16 vs 78.94、human action 99.00。(3) 重建-生成解耦的证据:Step-Video-VAE 重建比 LTX-VAE 高 1.91 dB 但 VBench-I2V 低 3.01;单潜基线 PSNR 比 GRACE-VAE 高 1.13 dB 却低 1.46 分,说明重建保真度不决定生成质量。(4) 组件消融(Table 4):单潜基线 82.12 → +双 latent 83.55 → +对齐 84.68 → +非对称去噪 85.81,各组件均有正贡献且对 I2V 的增益主要来自对齐(87.51→87.90)。(5) 对齐目标(Table 5):DiT 特征 84.68 vs V-JEPA 2.1 特征 83.99 vs 无对齐 83.55(T2V 总分)。(6) 收敛(Fig 7):$\mathcal{L}_{align}$ 让 residual 通道的 flow matching 损失收敛更快、终值更低,base 通道则几乎不受影响。(7) 人类盲评(Table D.3,39 人):对 DC-Gen 视觉质量胜率 71.2% vs 17.3%;对原管线 T2V 三项全部领先(46.8–52.6% vs 25.6–35.3%),I2V 略逊(22.4–29.5% vs 34.6–44.9%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文生视频 T2V(VBench,480×832×81,50 步) | VBench-T2V 总分 / 延迟 | 85.81 / 75.8s(4.3k token,100 NFE) | Wan2.1-14B 压缩前 83.93 / 851.5s(32.8k token);DC-Gen 84.62 / 157.1s;LTX-Video 79.17 / 99.6s;Open-Sora 2.0 77.51 / 138.6s | 超原管线 +1.88,延迟 11.1× 加速;超同骨干最强对手 DC-Gen +1.19 且 token 再省一半、快 2 倍 |
| 图生视频 I2V(VBench-I2V,480×832×81) | VBench-I2V 总分 / 延迟 | 87.90 / 77.7s | Wan2.1-14B 压缩前 87.92 / 863.2s;DC-Gen 84.13;LTX-Video 87.97 / 104.1s | 与原管线持平(-0.02),延迟 11.1×;比 DC-Gen 的 I2V 项高 7.23(95.48 vs 88.25);LTX 总分略高但更慢且漏动作 |
| T2V/I2V(VBench,736×1280×81) | VBench 总分 / 延迟 | T2V 84.74 / 215.6s;I2V 87.84 / 218.8s(10.1k token) | Wan2.1-14B 压缩前 T2V 82.96 / 3361.3s,I2V 87.88 / 3396.8s(77.3k token);DC-Gen T2V 84.62 | T2V 超原管线 +1.78、I2V 持平(-0.04),延迟 15.5× 加速;T2V 总分为所有对比模型最高 |
| 视频重建(Panda-70M,256×256×81) | PSNR / VBench-I2V 总分 | 32.63 dB / 87.90 | 单潜基线 33.76 dB / 86.44;Video DC-AE 34.61 / 84.94;Step-Video-VAE 33.88 / 84.05;LTX-VAE 31.97 / 87.06 | 重建低 1.13 dB 但生成质量最高(87.90),直接证明重建≠生成 |
局限与改进
作者承认的局限:(1) 高压缩下每帧 token 变少,小物体受害最重——远处人脸、招牌文字、细长结构常丢失或破碎,好在整体场景与运动保持完整,且在 736×1280 下因同压缩率 token 更多而缓解;(2) GRACE-VAE 为生成优化牺牲了重建保真,同 token 数下 PSNR 比单潜基线低 1.13 dB;(3) 想增加残差通道恢复细节,但把预训练 DiT 适配到更高维 latent 本身就很困难(Open-Sora 的前车之鉴);(4) 方法与管线绑定:base latent 依赖该管线的冻结编码器、$\mathcal{L}_{align}$ 依赖其 DiT,每换一个新预训练管线都要重跑一次 Stage 1(8.5 H200 GPU 天)。我的补充观察:(1) VBench 的美学分由 LAION 美学预测器驱动,已知偏好饱和画面,DC-Gen 美学分反超但总分更低,指标噪声不小;(2) T2V 的'反超'主要由语义类分(color、spatial relationship、scene)贡献,画质类如 aesthetic quality(64.77 vs 70.41)反而下降,'超越原管线'需谨慎解读;(3) 监督层数(前 10 层)、$\delta$ 范围 [0,0.5]、推理 $\delta=0.15$ 均为经验选择,跨管线/跨压缩率的最优配置未知。
独立分析的弱点
(1) 残差容量是手工拍定的 $C'{=}16$,480p 下每帧仅约 53 个 token,细节丢失不可避免——招牌文字、远处人脸等应用场景会直接受影响。改进方向:借鉴 DC-AE 1.5 把残差通道结构化,或按内容复杂度自适应分配通道数。(2) I2V 人类评测仍输给原管线(视觉质量 23.7% vs 43.6%),说明压缩对以首帧为条件的精细保真仍有实质伤害;可加强首帧交叉注意力的容量、让 residual 显式负责首帧邻近帧的高频,或只在首帧附近降低压缩率。(3) T2V/I2V 需要各训一套自编码器($\mathcal{L}_{align}$ 的监督 DiT 不同),工程上繁琐;可探索任务无关的对齐目标或多任务联合训练一套 VAE。(4) '反超原管线'的结论部分依赖 VBench 语义分,而 aesthetic quality(64.77 vs 70.41)、imaging quality 均下降,且人类评测 I2V 落后——应在更大规模人类评测与下游任务(如视频编辑、可控生成)中验证。(5) 非对称去噪的 $\delta$ 采样区间与推理值是网格搜索出来的经验值,缺乏理论支撑,换压缩率或换管线时需要重新调参,可以研究 $\delta$ 与压缩率/信噪比的解析关系。
未来方向
作者提出的方向:增加残差通道数以恢复更多细节(同时需解决高维 latent 难适配的问题,或可结合结构化 latent 设计);把 GRACE 推广到其他预训练管线(每个管线重训一次 Stage 1)。基于其成果可延伸:(1) 把'冻结 DiT 特征空间对齐'推广为高效生成的通用正则,用于 token 剪枝、token 合并等其他加速手段;(2) base/residual 更细的分工——residual 只编码高频纹理、运动由低帧率 base 插值恢复,与可变帧率/流式生成结合;(3) 渐进级联压缩:从 f16t8 继续向 f32t8 推进时,把当前 GRACE 输出当作新 base,逐级放大压缩率;(4) 与少步蒸馏正交叠加,延迟有望再降一个量级(75.8s → 实时区间);(5) 在 1080p 以上验证速度优势是否继续放大(论文趋势暗示会);(6) 用 DiT 更浅层的特征或特征蒸馏降低 Stage 1 的显存与算力门槛,使学术实验室也能复现。此外,I2V 保真短板提示可以在对齐目标中加入首帧条件相关的约束。
复现评估
复现友好度较高但算力门槛不低。论文的附录非常详尽:Appendix A/B 给出自编码器与 DiT 适配的全部架构改动与超参(Table A.1:AdamW,lr 8e-5/4e-5 两阶段,batch 32/64,$\lambda_{L1}{=}1.0$、$\lambda_{LPIPS}{=}3.0$、$\lambda_{KL}{=}3e{-}6$,对齐模块 lr 1e-4;Table B.1:DiT lr 1e-4,batch 128,LoRA 秩 512/α 512,$\delta\in[0,0.5]$,shift $s\in[2,5]$,推理 guidance 5.0、shift 3.0、$\delta{=}0.15$);Appendix C 描述对比方法的 DC-Gen 适配与完整评测协议(50 步、单张 A100 SXM4-80GB bf16 计时、逐模型 prompt 管线),并附逐维度 VBench 分数与人类评测细节。依赖均为公开资产:Wan2.1-14B 权重、Panda-70M 数据、DC-Gen/V-JEPA 2.1 开源实现。总训练成本 38.5 H200 GPU 天(Stage 1 共 8.5 天 + Stage 2 共 30 天),需要多卡高端集群;推理复现便宜(单卡 A100,每条视频约 76 秒)。项目主页 cvlab-kaist.github.io/GRACE 已建,但正文未明确说明代码与权重是否开源,这点需关注后续发布。总体难度:中等偏高,主要风险在 Stage 1 对齐训练的稳定性(自适应权重)与 Stage 2 的 LoRA 配置细节。
论文图表
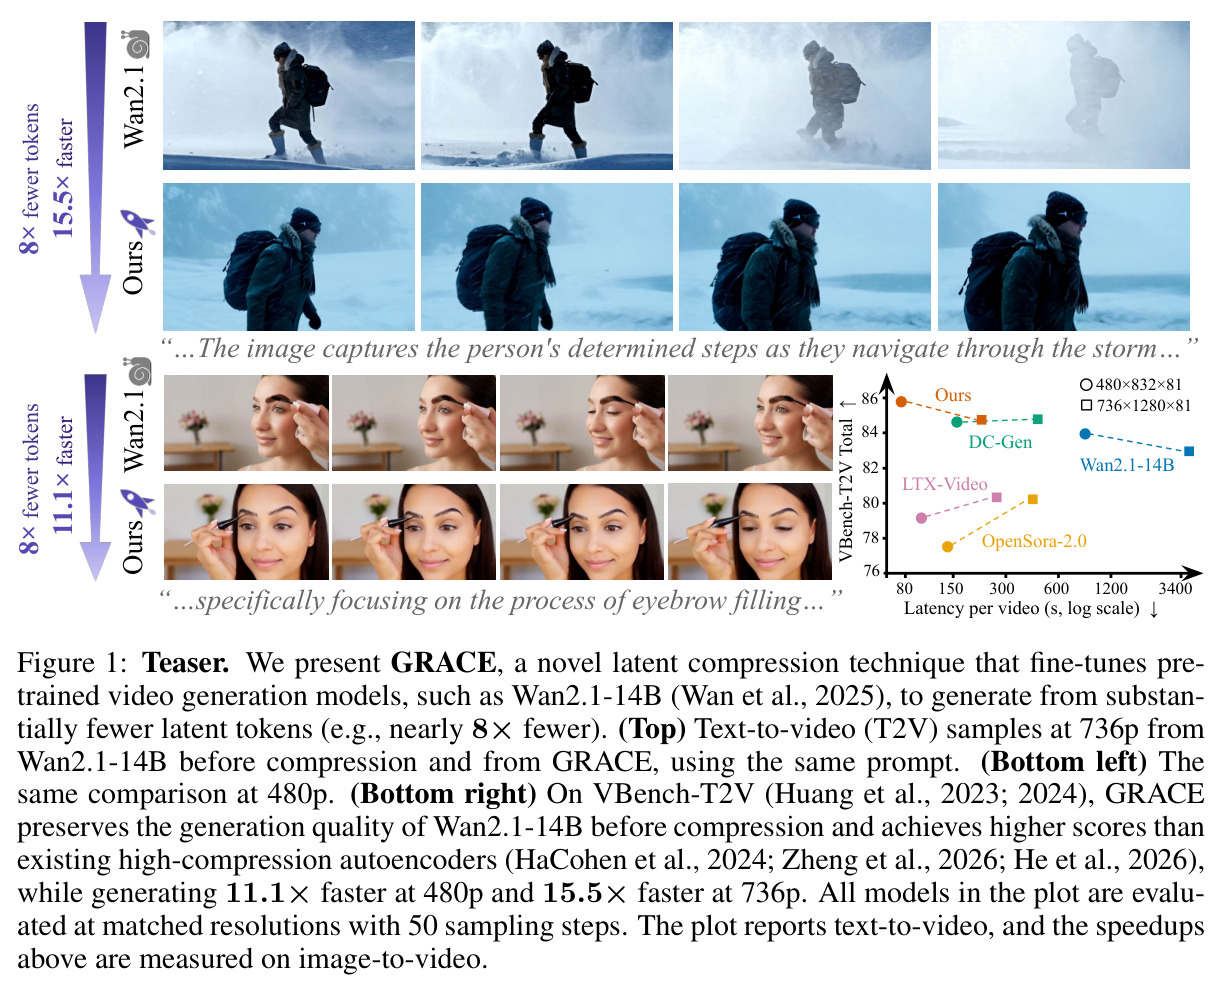
上排与左下为同 prompt 下 Wan2.1-14B 压缩前(f8t4,32.8k token)与 GRACE(f16t8,4.3k token)在 736p/480p 的 T2V 视觉对比;右下散点图以对数延迟为横轴、VBench-T2V 总分为纵轴,GRACE 以 75.8 秒拿到 85.81 分,而 DC-Gen、LTX-Video、Open-Sora 2.0 更慢且分数更低,原管线 851.5 秒仅 83.93 分。
一张图概括全文卖点:token 减少约 8 倍后质量不降反升、延迟降低一个数量级,且速度优势随分辨率从 11.1× 增至 15.5×。
主结果表:GRACE 4.3k token、100 NFE、延迟 75.8/77.7s,VBench-T2V 质量/语义/总分 86.02/84.98/85.81、I2V 总分 87.90;原管线 32.8k token、851.5/863.2s、T2V 83.93、I2V 87.92;DC-Gen 8.2k token、157.1s、84.62;LTX-Video 4.3k token、99.6s、T2V 79.17/I2V 87.97;Open-Sora 2.0 8.2k token、138.6s、77.51。
量化主结论的来源:质量持平(I2V -0.02)+ T2V 反超 +1.88 + 11.1× 加速,并给出与所有对比模型的公平对照。
高分辨率结果:GRACE 10.1k token、215.6/218.8s,T2V 84.74(全场最高)、语义分 82.04;原管线 77.3k token、3361.3/3396.8s、T2V 82.96、I2V 87.88;GRACE I2V 87.84 基本持平;DC-Gen T2V 84.62、LTX-Video 80.29、Open-Sora 80.22。
验证速度优势随分辨率放大到 15.5×,且质量结论在高分辨率下保持成立。
39 名评分者对 40 个 VBench prompt 的盲测 A/B 对比:GRACE 对 DC-Gen 全面占优(视觉质量 71.2% vs 17.3%,时间一致性 64.7% vs 14.1%);对原管线 Wan2.1-14B 在 T2V 三项领先(46.8–52.6% vs 25.6–35.3%),但在 I2V 落后(22.4–29.5% vs 34.6–44.9%)。
补充 VBench 之外的人类偏好证据,也如实暴露了 I2V 精细保真仍逊于原管线的短板。
成本明细:Stage 1 全自编码器 6.9 天 + 仅解码器高分辨率阶段 1.6 天,Stage 2 为 30 天,合计 38.5 H200 GPU 天;推理延迟原管线 T2V/I2V 851.5/863.2s,GRACE 75.8/77.7s。
量化'低成本压缩预训练管线'的核心承诺,是评估复现门槛与方法性价比的关键数据。