SGF+:解耦梯度流的自回归视频生成 SGF+: Decoupling Gradient Flows for Autoregressive Video Generation
给上下文写入与去噪分配独立参数以消除梯度冲突,5秒训练外推生成24小时视频
前置知识
自回归视频扩散模型(Autoregressive Video Diffusion)
把视频切成帧或块,像语言模型一样逐块生成:每一步先用去噪网络把带噪潜变量还原成干净内容,再把干净结果编码成键值(KV)表示写入缓存,作为后续块生成的历史条件。代表如 Self Forcing、SkyReels-V2,支持低延迟流式生成和超出训练时域的推理。
本文的全部讨论都建立在这种"边去噪边写缓存"的双角色计算结构上,理解了它才能明白为什么会出现两个角色的梯度冲突。
KV 缓存与上下文写入(Context Writing)
Transformer 用因果注意力读取历史时,历史内容以 K/V 矩阵形式存放在缓存中。自回归视频模型把每帧干净潜变量以 $t_{ctx}=0$ 前向一遍,把隐藏状态投影成 K/V 追加进缓存,供未来帧查询。这个"写入"调用与去噪调用使用同一套模型参数。
SGF 系列的核心是让"未来生成损失"能通过可微的 KV 写入路径反向传播去监督写入质量,而 SGF+ 进一步把写入器拆成独立参数。
Teacher Forcing 与 Self Forcing(暴露偏差)
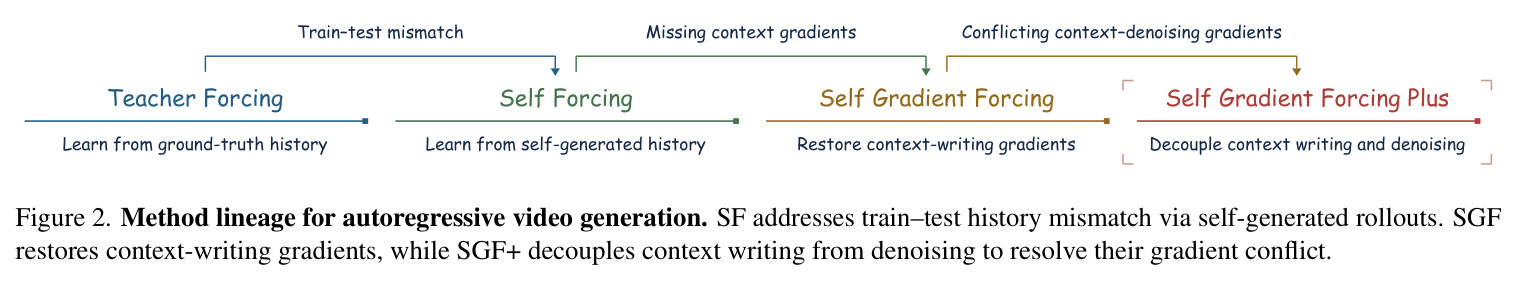
Teacher Forcing 用真实干净历史训练,推理时却读自己生成的历史,产生训练-测试失配即暴露偏差。Self Forcing(SF)让模型在训练时就基于自生成 rollout 学习,用视频级分布匹配损失缩小失配;但为控制计算量,SF 把历史 KV 缓存当作冻结状态,未来损失无法监督早期帧的写入。
SGF 与 SGF+ 都以 SF 的自生成 rollout 框架为基础,SF 的"上下文梯度缺口"正是 SGF/SGF+ 要解决的问题起点。
分布匹配蒸馏(DMD)与 fake-score 网络
分布匹配蒸馏用真实教师分数与学生 fake-score 网络之差构造梯度,使学生少步生成逼近教师的数据分布。本文损失记为 $L_{DMD}$,配合冻结的 Wan2.1-T2V-14B 真教师与单独训练的 fake-score 网络,实现 4 步去噪的实时生成。
SGF+ 不引入任何辅助损失,上下文写入的监督完全来自这同一个 $L_{DMD}$ 经 KV 路径的反传,这是"只用原始生成目标联合训练两角色"的关键。
梯度冲突与余弦相似度
若同一参数收到两组梯度 $g_C$ 与 $g_D$,其夹角超过 90°(余弦为负)时称二者冲突:相加后分量互相抵消,优化被拉向折中方向。本文用 $s(g_C,g_D)=\frac{\langle g_C,g_D\rangle}{\|g_C\|_2\|g_D\|_2}$ 度量,并用 t-SNE、平均方向夹角、逐对余弦三种方式可视化。
"两种角色梯度系统性负对齐"是全文的核心实证发现,也是参数分离这一设计决策的直接依据。
研究动机
自回归视频扩散模型生成每一帧时同时承担两个角色:一是去噪,把当前带噪潜变量还原成干净内容;二是上下文写入,把干净结果编码成键值(KV)表示写进缓存,供后续帧预测读取。实践中这两个角色通常由同一套 DiT 参数承担。前作 Self Forcing(SF)为解决训练-测试历史失配采用自生成 rollout 训练,但为了计算可行性把历史 KV 缓存当作冻结的 rollout 状态,造成"未来损失只能监督后续 token 如何读历史、无法监督早期帧如何把内容写入 KV"的历史上下文梯度缺口。SGF 通过两遍训练补上了这条监督路径,但两种角色仍在同一套参数上累积更新。作者在 SGF 训练中实测:128 个 prompt × 4 个去噪步的测量中,上下文写入与去噪梯度的平均方向夹角在 Attention 和 FFN 中分别达 104.2° 和 106.3°,双双超过 90°,且全部 512 对配对余弦相似度均为负值,即系统性负对齐。后果是共享参数上冲突梯度相互抵消:长序列出现残余退化,少数视频首帧质量甚至低于 SF——首帧没有历史上下文,恰好是纯去噪质量的探针,说明冲突连基础画质都在拖累。
本文的目标是本文的目标是在完全不改变训练目标、不增加数据和训练时域的前提下,消除共享参数导致的梯度冲突。具体约束是:保留 SGF 框架的全部优点——自生成 rollout、可微 replay、仅 5 秒视频窗口的训练时域、不引入任何辅助损失、不需要额外视频训练数据、不做长视频微调——只修改一个基础设计选择:给上下文写入与去噪各配一套独立参数。期望同时提升帧级(framewise)与块级(chunkwise)生成中的视觉质量和长时程一致性,并保持推理延迟几乎不变,最终实现"原生长时程外推"(native long-horizon extrapolation):只在 5 秒时间窗内训练的模型能够连续生成最长 24 小时的视频。
与已有工作不同的是,既有工作几乎都在"历史怎么构造、监督怎么给"的维度上改进:Diffusion Forcing 对不同时间 token 独立采样噪声水平;SF 用自生成历史缓解暴露偏差;Resampling/Rolling/Mask Forcing 等改造 rollout 探索与噪声调度;Causal Forcing 系列换用自回归教师或因果一致性蒸馏改善初始化;LongLive、Self-Forcing++ 等用更长监督窗或流式长视频微调换取时长。本文的独特切入是把矛头指向更底层、却被所有前作默认的参数共享机制:先定量证明同一生成目标下两种角色的梯度需求系统性冲突(平均夹角超 90°、配对余弦全负,且冲突在 Teacher Forcing 初始化阶段就已存在),再用最直接的"参数分离"解决,并给出局部优化理论(附录 G)证明在相同更新预算下拆分更新的一阶下降必然不劣于共享更新。这一干预与历史构造、上下文管理、谱修正、位置适配等方向正交互补。
核心方法
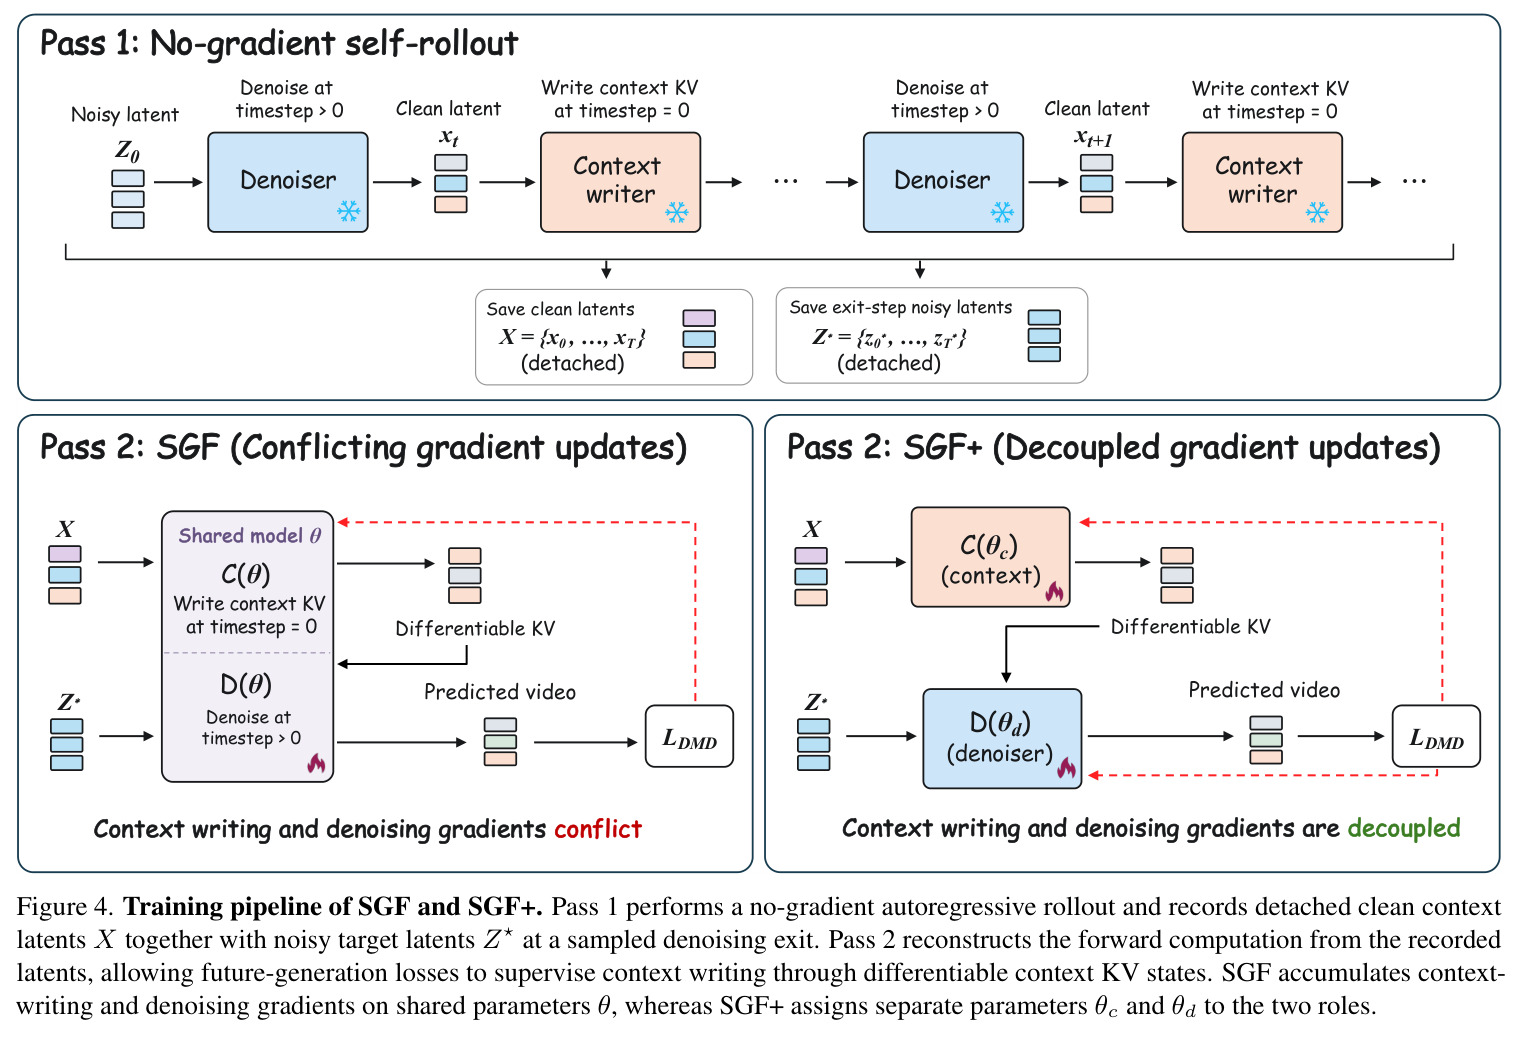
直觉上,这个网络同时打两份工:一份是"画画"——把带噪潜变量去噪成当前帧内容;另一份是"记笔记"——把画好的内容编码成 KV 写进缓存供未来帧读取。测量显示这两份工作对参数的梯度要求方向相悖(平均夹角超过 90°,全部配对余弦为负),在同一套权重上相加会互相抵消,同时拖累画质与长时程一致性。SGF+ 的解法直白而彻底:把模型显式拆成上下文写入器 $C_{\theta_c}$ 与去噪器 $D_{\theta_d}$ 两套独立参数(都从同一个自回归扩散模型初始化),前向计算保持耦合——去噪器要读写入器产生的 KV——但参数更新各走各的路径,冲突的梯度不再叠加在同一权重上。训练沿用 SGF 的两遍流程:Pass 1 做无梯度的自回归 rollout,采样并记录(stop-gradient 的)干净潜变量集合 $X=\{\tilde{x}_i\}$ 与随机选定去噪出口的带噪潜变量 $Z^\star=\{z^{t^\star}_i\}$;Pass 2 在因果重建掩码下并行重建前向计算,用 $X$ 以可微方式重算 KV 状态,再让 $Z^\star$ 在读取这些 KV 的条件下去噪,唯一的损失仍是原始的 DMD 分布匹配损失。
核心创新是把"自回归视频强迫"的设计空间从历史构造与监督信号推进到参数化本身。SF 冻结 KV 缓存,未来损失监督不到上下文写入(历史上下文梯度缺口);SGF 通过可微 KV 重建补上这条监督路径,但写入与去噪仍共享 $\theta$,共享线性层接收的梯度按 $g_W = g_C + g_D$ 相加($g_C$、$g_D$ 分别为写入 token 和去噪 token 的贡献),冲突部分相互抵消。SGF+ 的本质区别在于承认并尊重两个角色优化需求的差异:$\theta_c$ 只通过可微 KV 状态 $M_{\theta_c}$ 接收梯度(监督"怎么写"),$\theta_d$ 只通过目标去噪接收梯度(监督"怎么画"),两者由同一个 $L_{DMD}$ 联合驱动,无需为写入设计辅助损失或梯度投影。这与 MoE 式"只在 FFN 里放角色专家"的思路有本质不同——消融证明只在 Attention 或只在 FFN 分离都不充分,冲突横跨所有模块族,必须全参数分离才能吃满收益。
方法步骤详情
完整流程分四步。第一步,模型组装:以 Wan2.1-T2V-1.3B 为学生骨干,用 Causal Forcing 发布的 Teacher Forcing 权重初始化;另备冻结的 Wan2.1-T2V-14B 真教师和单独训练的 fake-score 网络(也从 1.3B 初始化),构成 DMD 蒸馏三件套。SGF+ 用两套完整参数实现角色分离(也支持双 LoRA 适配器,本文采用全参数),生成器参数从 1.4B 增至 2.8B。第二步,Pass 1 无梯度自回归 rollout:模型串行生成各块,对每块做多步去噪得到干净估计 $\tilde{x}_i$,再以 $t_{ctx}=0$ 调用写入器更新串行 KV 缓存,即 $KV_i = C_\theta(\tilde{x}_i, t_{ctx}\,|\,KV_{<i})$;随机采样去噪出口 $t^\star$ 并记录全部 $X$ 与 $Z^\star$,二者均从采样轨迹 detach。第三步,Pass 2 并行梯度重建:在因果重建掩码 $M_{rec}$ 下一次前向完成 $M_{\theta_c} = C_{\theta_c}(sg(X), t_{ctx}\,|\,M_{rec})$ 与 $\hat{X}_{tar} = D_{\theta_d}(Z^\star, t^\star\,|\,M_{\theta_c}, M_{rec})$,损失 $\mathcal{L} = \mathcal{L}_{DMD}(\hat{X}_{tar})$;梯度经 KV 状态到达 $\theta_c$、经目标去噪到达 $\theta_d$,回放潜变量与缓存轨迹保持 detached,因此无需对整个 rollout 反传。第四步,优化与推理配置:AdamW($\beta_1=0,\beta_2=0.999$),生成器学习率 $2\times10^{-6}$、critic $4\times10^{-7}$,每 5 次 critic 更新做 1 次生成器更新,推理用 4 步去噪;上下文策略为 sink+FIFO——帧级模式 4 个 sink + 16 个近期潜变量 + 1 个当前(窗口 21),块级模式 3 + 6 + 3(窗口 12)。训练数据只用 VidProM 过滤扩展提示上的 5 秒视频窗。
技术新颖性
新颖性有四点。其一,首次把自回归视频扩散中"写上下文"与"去噪"作为两个优化角色显式分离并定量刻画冲突:128 prompt × 4 去噪步测量中 Attention/FFN 平均梯度夹角 104.2°/106.3°,512 对配对余弦全负;且冲突在 Teacher Forcing 初始化时已存在——真实视频 50 步扩散 schedule 上,相邻步梯度方向在 0→1(干净上下文写入到带噪去噪的过渡)处发生突变,TF 阶段平均角色梯度夹角也达 95.1°/105.1°。其二,解决方案极简:不加辅助损失、不加数据、不延长训练时域,仅拆参数即得收益,工程上只是把 SGF 已有的梯度路径重新路由。其三,附录 G 给出局部优化理论:固定回放目标下,在欧氏预算 $\|\delta_c\|^2+\|\delta_d\|^2\le r^2$ 内,$D_{split}(r)^2 - D_{shared}(r)^2 = \frac{r^2}{2}\|g_C - g_D\|^2$;共享约束导致的下降损失占比 $\Gamma = 1 - \frac{\langle g_C,g_D\rangle}{E}$($E=\|g_C\|^2+\|g_D\|^2$),负对齐时 $\Gamma>1/2$;当 $g_C=-g_D$ 时绑定参数点成为共享目标的驻点而拆分目标并非驻点,同学习率下一步下降差距 $\approx 2\eta\kappa$($\kappa=-\langle g_C,g_D\rangle$)。其四,部分分离的残余损失有闭式刻画(式 29,正比于未分离块上 $\|g_C^{(b)}-g_D^{(b)}\|^2$ 之和),直接预言并解释了消融中 Attention-only/FFN-only 不如全分离的结果。
实验结果
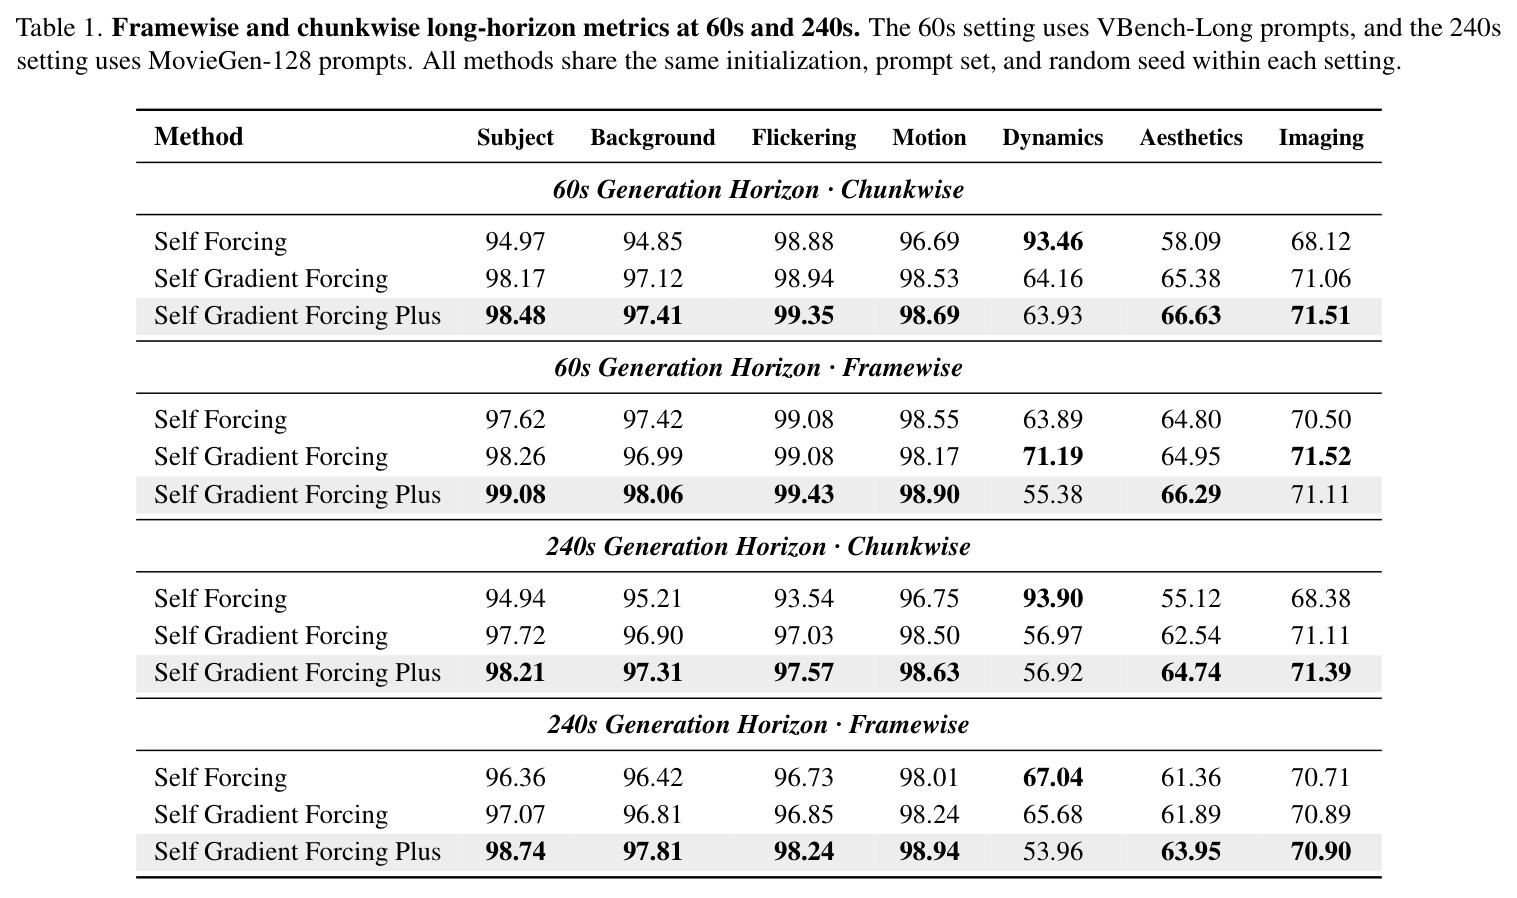
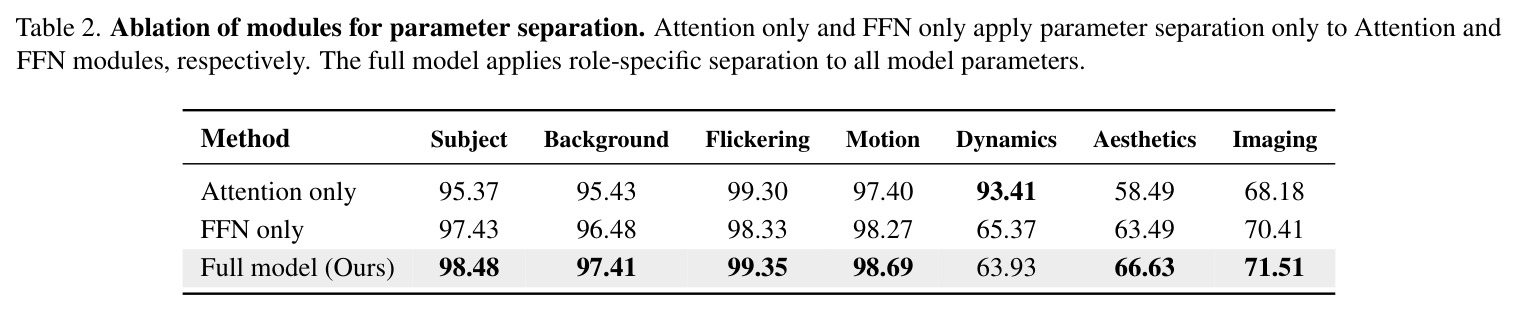
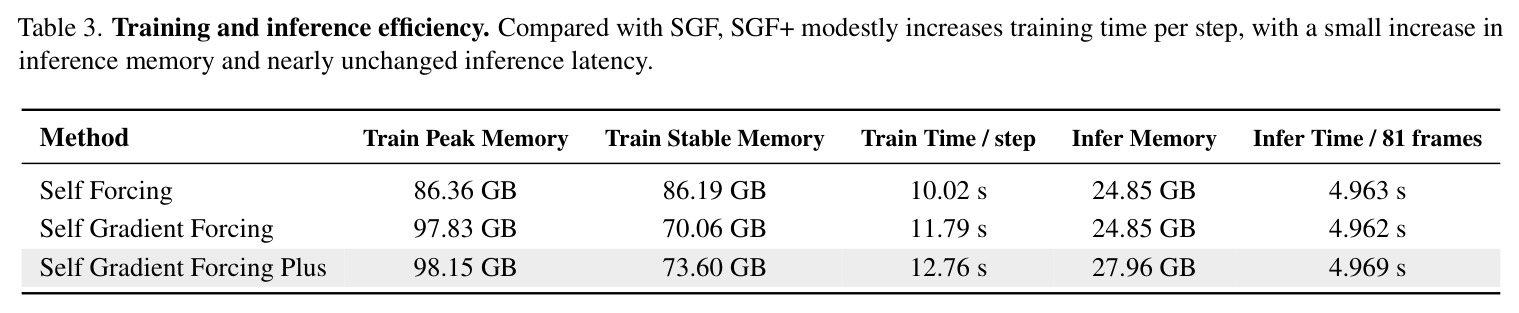
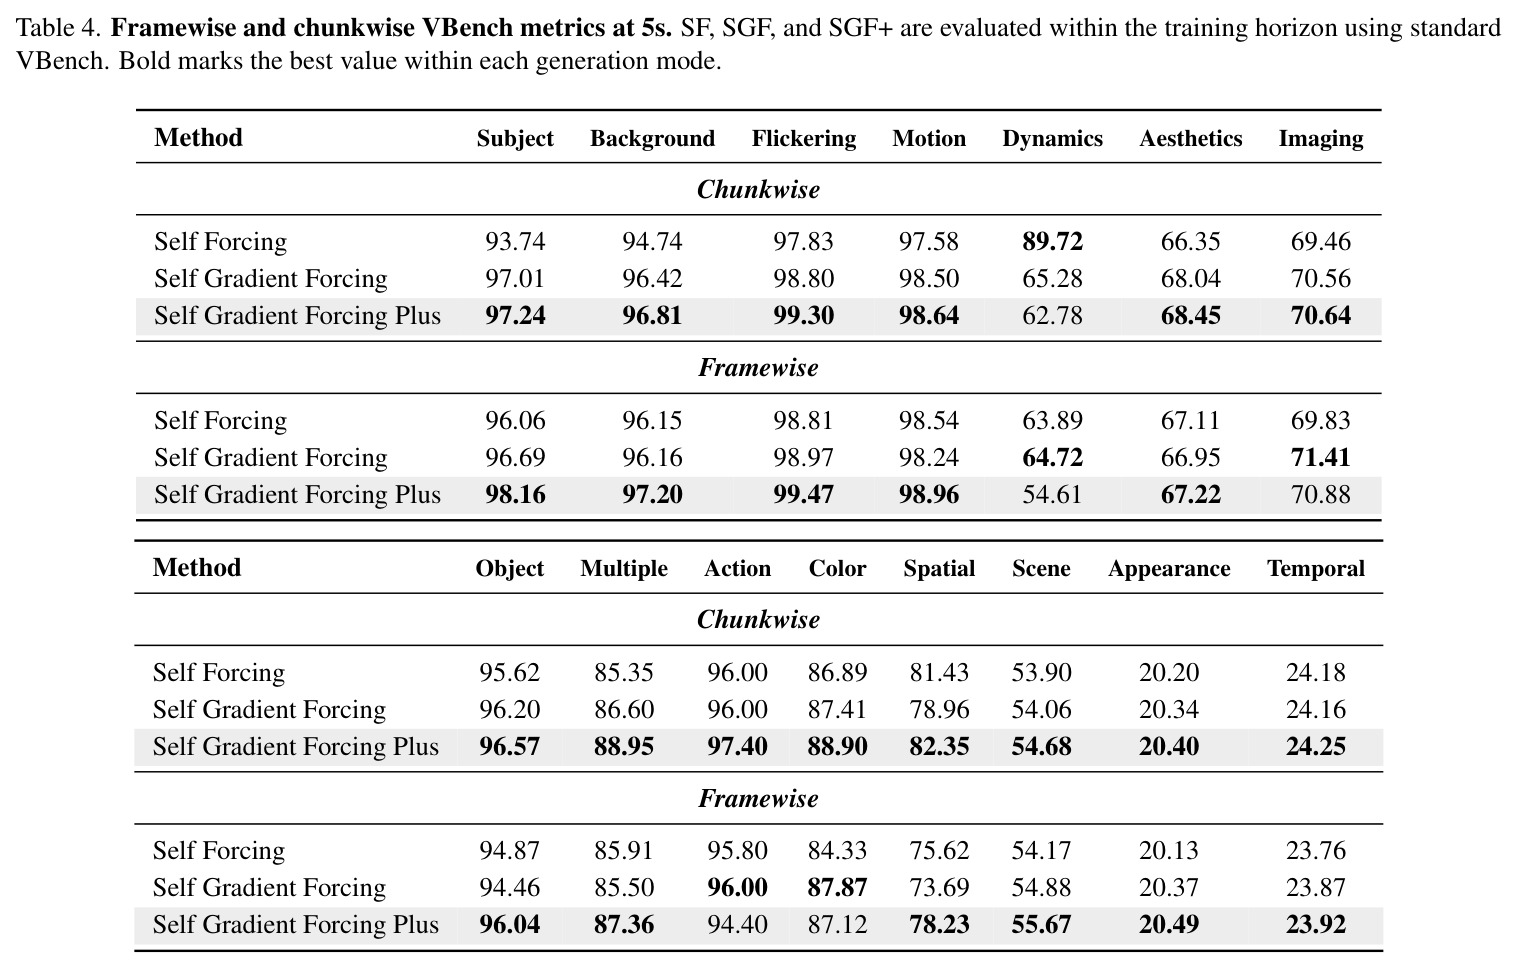
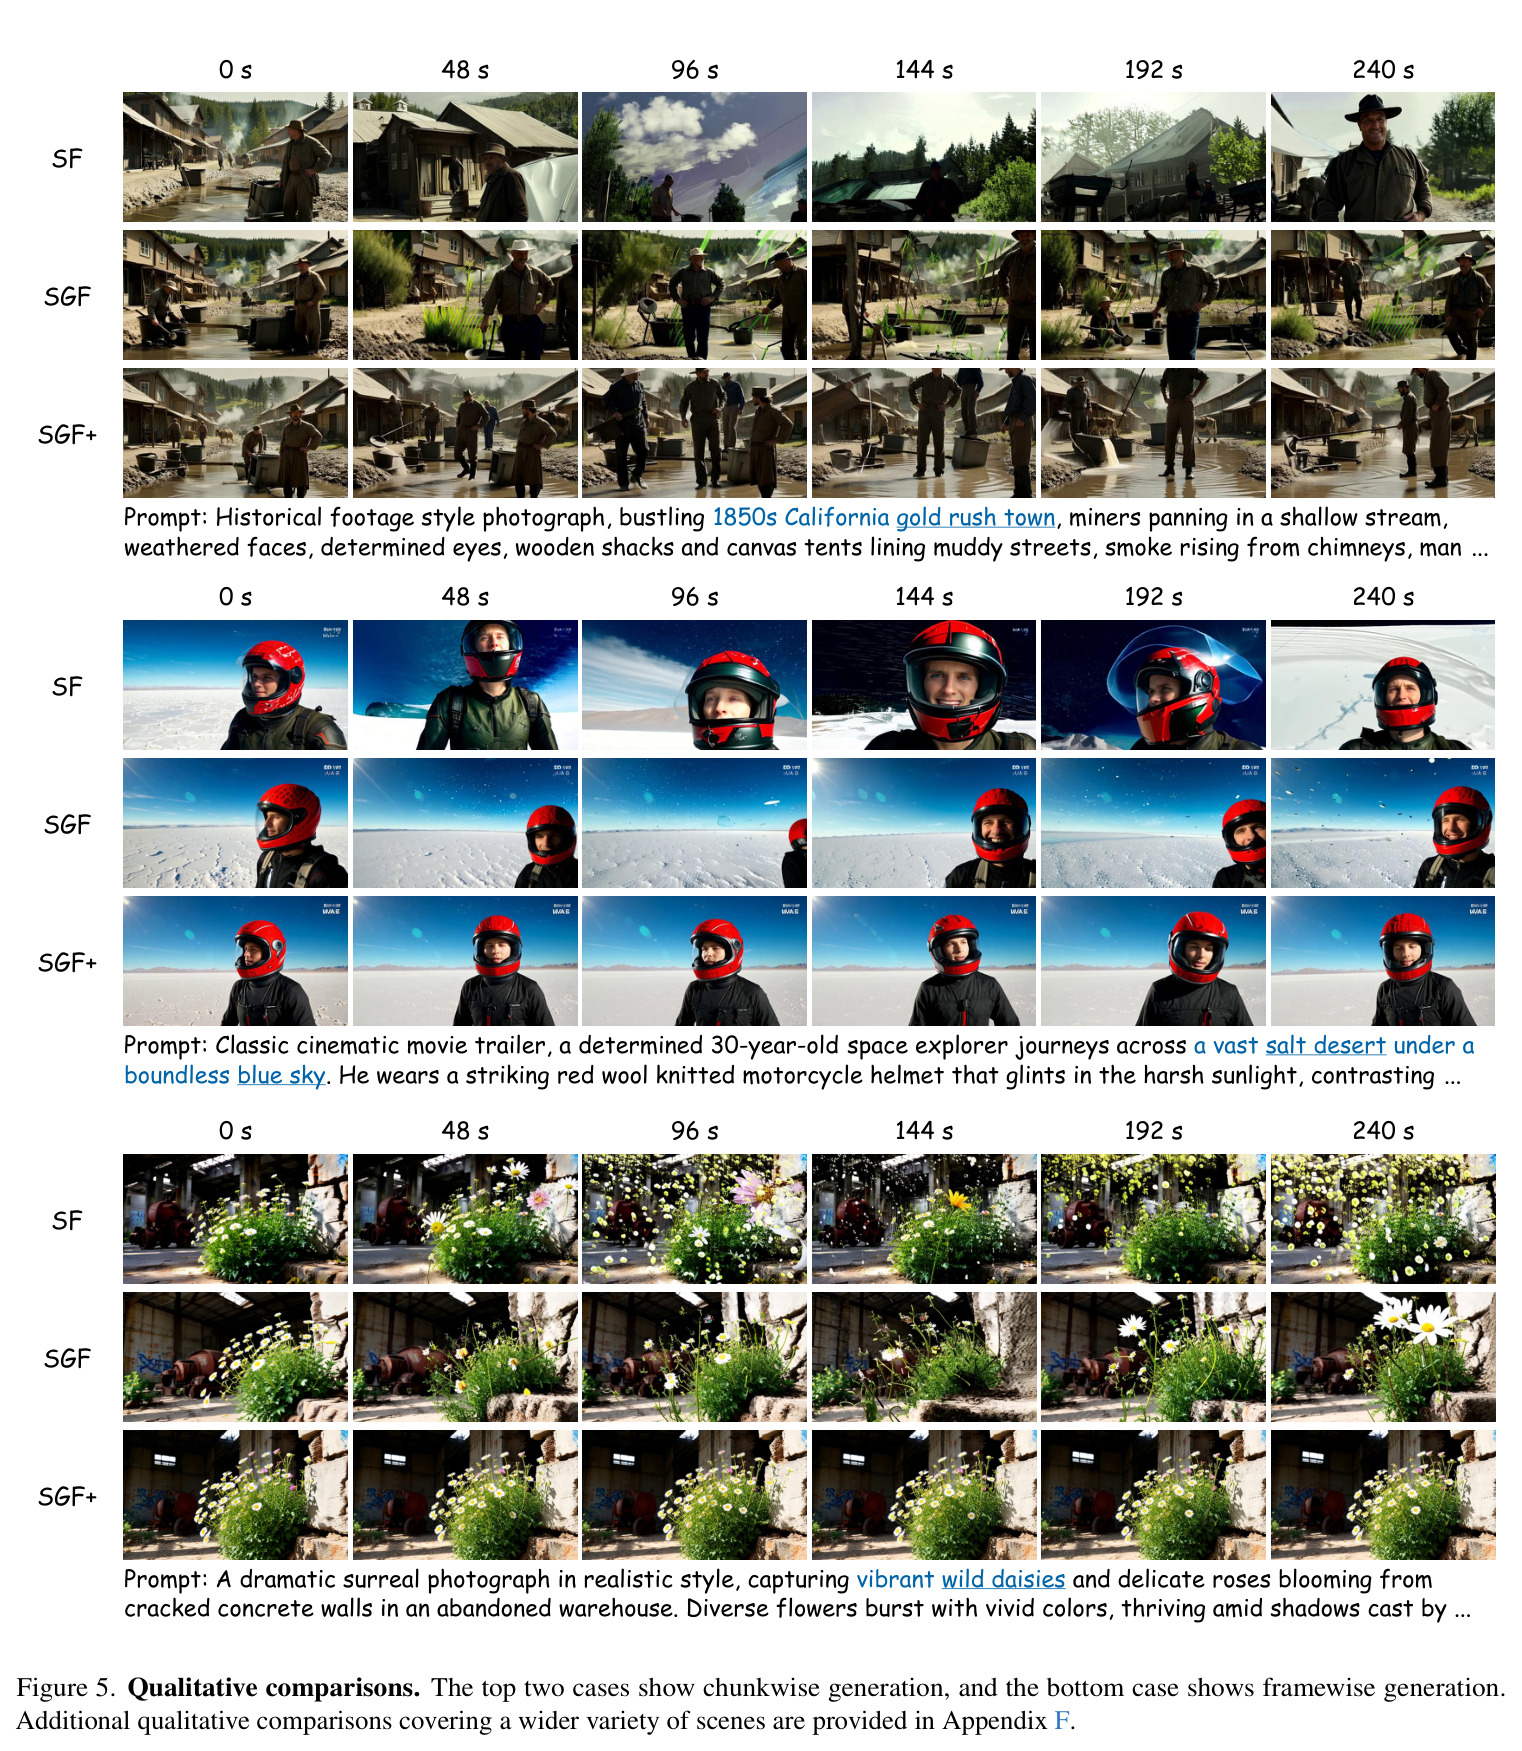
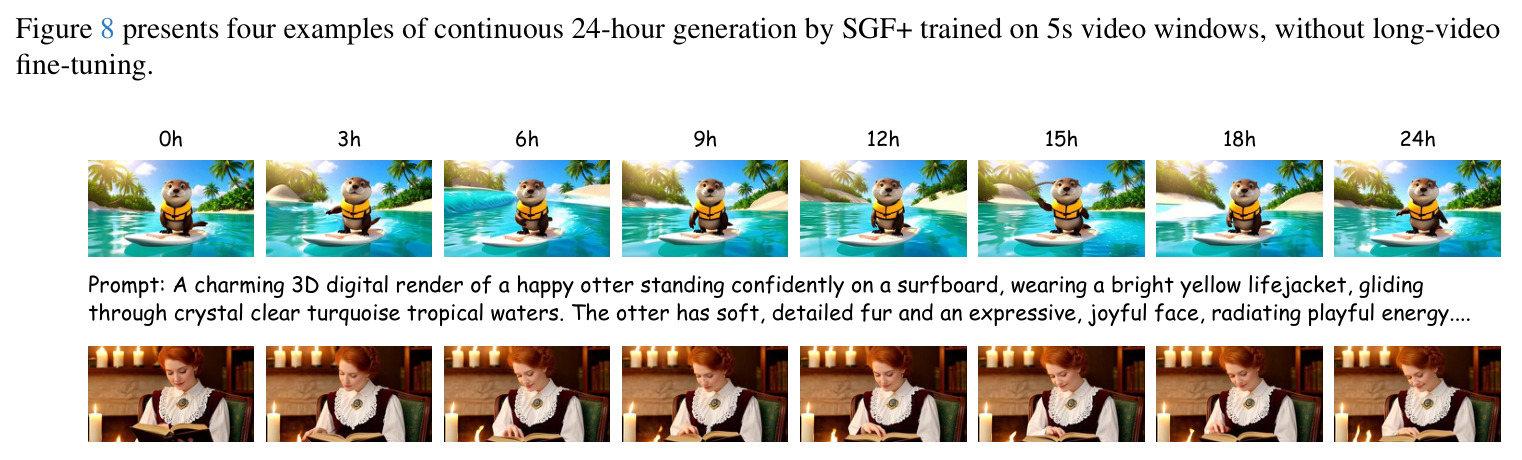
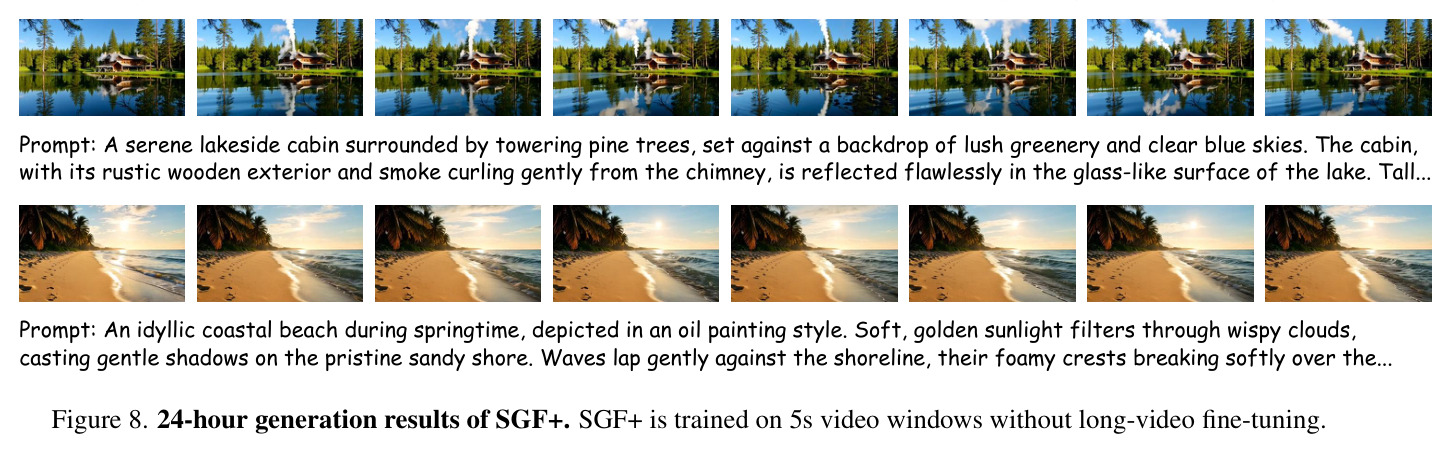
主实验在 5s(训练时域内,标准 VBench)、60s 与 240s(分别为训练窗的 12 倍与 48 倍外推,分别用 VBench-Long 与 MovieGen-128 提示)上评估,同一初始化、提示、种子对比 SF/SGF/SGF+。60s 块级:SGF+ 主体一致性 98.48(SF 94.97、SGF 98.17),背景一致性 97.41(94.85/97.12),闪烁 99.35,运动平滑 98.69,美学 66.63(58.09/65.38),成像 71.51。60s 帧级:主体 99.08(97.62/98.26)、背景 98.06、闪烁 99.43、美学 66.29。240s 块级:主体 98.21(94.94/97.72)、背景 97.31、闪烁 97.57、美学 64.74(55.12/62.54);240s 帧级:主体 98.74(96.36/97.07)、背景 97.81、闪烁 98.24、运动平滑 98.94、美学 63.95。动态程度(Dynamic Degree)是唯一例外:240s 帧级 SGF+ 仅 53.96 低于 SF 的 67.04,但作者结合图 1/图 5 证据指出 SF/SGF 的高分来自场景跳变、物体形变、主体消失、凭空多人的"大而不连贯"伪运动。消融(60s 块级,表 2):仅分离 Attention 主体一致性 95.37、仅分离 FFN 97.43、全分离 98.48,说明冲突横跨 Attention 与 FFN。效率(表 3):训练每步 12.76s(SGF 11.79s,约 +8.2%),训练峰值/稳定显存 98.15/73.60GB(SGF 97.83/70.06GB),推理 81 帧耗时 4.969s(SGF 4.962s,几乎不变),推理显存 27.96GB(+3.11GB)。5s 域内(表 4)帧级主体一致性 SGF+ 98.16 同样领先(SF 96.06、SGF 96.69)。定性上,5 秒训练的 SGF+ 可连续生成最长 24 小时视频(图 1 与附录 D 图 8),无需任何长视频微调。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 60s 长视频块级生成 | 主体一致性 Subject Consistency | 98.48 | Self Forcing 94.97 / SGF 98.17 | +3.51 / +0.31 |
| 60s 长视频块级生成 | 美学质量 Aesthetics | 66.63 | Self Forcing 58.09 / SGF 65.38 | +8.54 / +1.25 |
| 240s 长视频帧级生成 | 主体一致性 Subject Consistency | 98.74 | Self Forcing 96.36 / SGF 97.07 | +2.38 / +1.67 |
| 240s 长视频帧级生成 | 时间闪烁 Temporal Flickering | 98.24 | Self Forcing 96.73 / SGF 96.85 | +1.51 / +1.39 |
| 5s 域内帧级生成(VBench) | 主体一致性 Subject Consistency | 98.16 | Self Forcing 96.06 / SGF 96.69 | +2.10 / +1.47 |
| 60s 块级参数分离消融 | 主体一致性 Subject Consistency | 98.48(全参数分离) | 仅 Attention 分离 95.37 / 仅 FFN 分离 97.43 | +3.11 / +1.05 |
| 推理效率(81 帧) | 推理耗时 | 4.969s | SGF 4.962s | 基本持平(+0.007s),训练每步 +8.2%(12.76s vs 11.79s) |
局限与改进
作者承认与可观察到的局限包括:(1) 动态程度指标一致下降——240s 帧级 53.96 对 SF 的 67.04,60s 帧级 55.38 对 63.89,作者归因于对手的"伪运动"(场景跳变、形变灌水),但缺少人类偏好评估来确认 SGF+ 的运动质量确实不差;(2) 生成器参数从 1.4B 翻倍至 2.8B,推理显存增加 3.11GB,对 14B 级骨干成本将线性放大,论文提到双 LoRA 实现方式却未报告其效果数据;(3) 全部实验基于 Wan2.1-T2V-1.3B 蒸馏学生与 DMD 框架,结论对非蒸馏架构、更大模型、其他 forcing 框架的泛化未验证;(4) 24 小时生成只有定性展示(图 1、图 8),没有任何量化指标支撑该时程下的质量;(5) 理论分析是一阶局部分析且固定了回放内容,minibatch 场景要求聚合梯度负对齐结论才成立。我自己的补充观察:评估依赖 VBench 系列代理指标,小时级视频的语义漂移、情节记忆、因果一致性均未测量;约 98GB 的训练峰值显存也超出了常见 80GB 单卡配置,普通实验室难以直接复现。
独立分析的弱点
独立分析四点弱点。其一,运动保守化风险:SGF+ 在动态程度上一致偏低,虽然可解释为对手伪运动灌水,但对真实需要大幅运动的分布(体育、动作场面、镜头快速移动),更稳的更新规则可能系统性压低运动幅度;改进方向是引入运动感知的奖励或分布匹配项,把"稳定性"与"运动丰富度"解耦优化。其二,参数与显存成本:全参数分离使参数、优化器状态和缓存均近翻倍,在 14B 级模型上代价高昂;双 LoRA 变体只提了一句没有数据,值得系统消融 LoRA 秩与层级选择,并可借助附录 G 的块级公式(式 29)按 $\|g_C^{(b)}-g_D^{(b)}\|$ 挑选冲突最大的块做选择性分离,以小代价吃到大头收益。其三,评估面窄:VBench 类指标无法衡量小时级视频的语义连贯、情节记忆与世界状态一致性,长时程能力主要靠定性图支撑,应补充长期记忆探针任务和人类评估。其四,框架耦合:方法深度绑定 SGF 的两遍 replay 与 DMD 蒸馏设定,对非蒸馏自回归模型、块级世界模型是否同样受益未知;理论也只覆盖固定回放下一阶情形,非凸长期训练动力学缺乏刻画。
未来方向
作者明确提出的方向有二:一是把角色分离前移到 Teacher Forcing 阶段并推广到世界动作模型(WAM)——既然 TF 初始化时就存在 95.1°/105.1° 的角色梯度夹角,以 teacher forcing 训练、需要用历史 KV 预测视觉与动作的世界动作模型是天然应用场景,分离上下文写入与视觉/动作预测可能让历史表示学得更好;二是非对称架构:为上下文写入器定制更轻的容量,在受限缓存预算下从冗余视频历史学习压缩 KV 表示,只通过未来生成损失优化写入器、不动去噪器的参数与注意力接口,目标是同时降低参数存储、缓存显存和注意力成本。论文还提到模型合并(task arithmetic、TIES-Merging、DARE 等)可作为协调多角色优化的替代技术路线。基于本文成果还可延伸:按层/块梯度冲突度做自适应选择性分离;把角色分离与 FreqForcing、MemRoPE、attention sink 等免训练长视频技术叠加验证互补性;把压缩 KV 写入器发展为显式分层记忆模块,向长时程记忆世界模型演进。
复现评估
复现评估:项目页为 https://zihan-su.github.io/self-gradient-forcing-plus ,提供大量生成视频展示,但论文文本中未见明确的代码开源链接,复现可能需等待官方发布或按论文自行实现。所需外部组件均公开可得:Wan2.1-T2V-1.3B/14B 权重、Causal Forcing 的 Teacher Forcing 初始化权重、VidProM 提示集、VBench/VBench-Long/MovieGen-128 评测提示。附录 B 给出的超参与配置相当完整:AdamW($\beta_1=0,\beta_2=0.999$)、生成器学习率 $2\times10^{-6}$、critic $4\times10^{-7}$、1:5 生成器/critic 更新比、4 步去噪、sink+FIFO 上下文策略(帧级 4+16+1、块级 3+6+3)。算力门槛较高:训练峰值显存约 98.15GB、稳定显存 73.60GB(表 3),需要 H100 级单卡或多卡并行,且要同时容纳冻结的 14B 教师与 fake-score 网络;完整评测还需跑 VBench 全套指标。总体属于中等偏高难度:方法结构清晰(在 SGF 基础上拆参数、改两遍前向的参数路由),但缺少官方代码时,可微 KV 重建的显存工程细节(梯度检查点、并行重建)是最大门槛。
论文图表
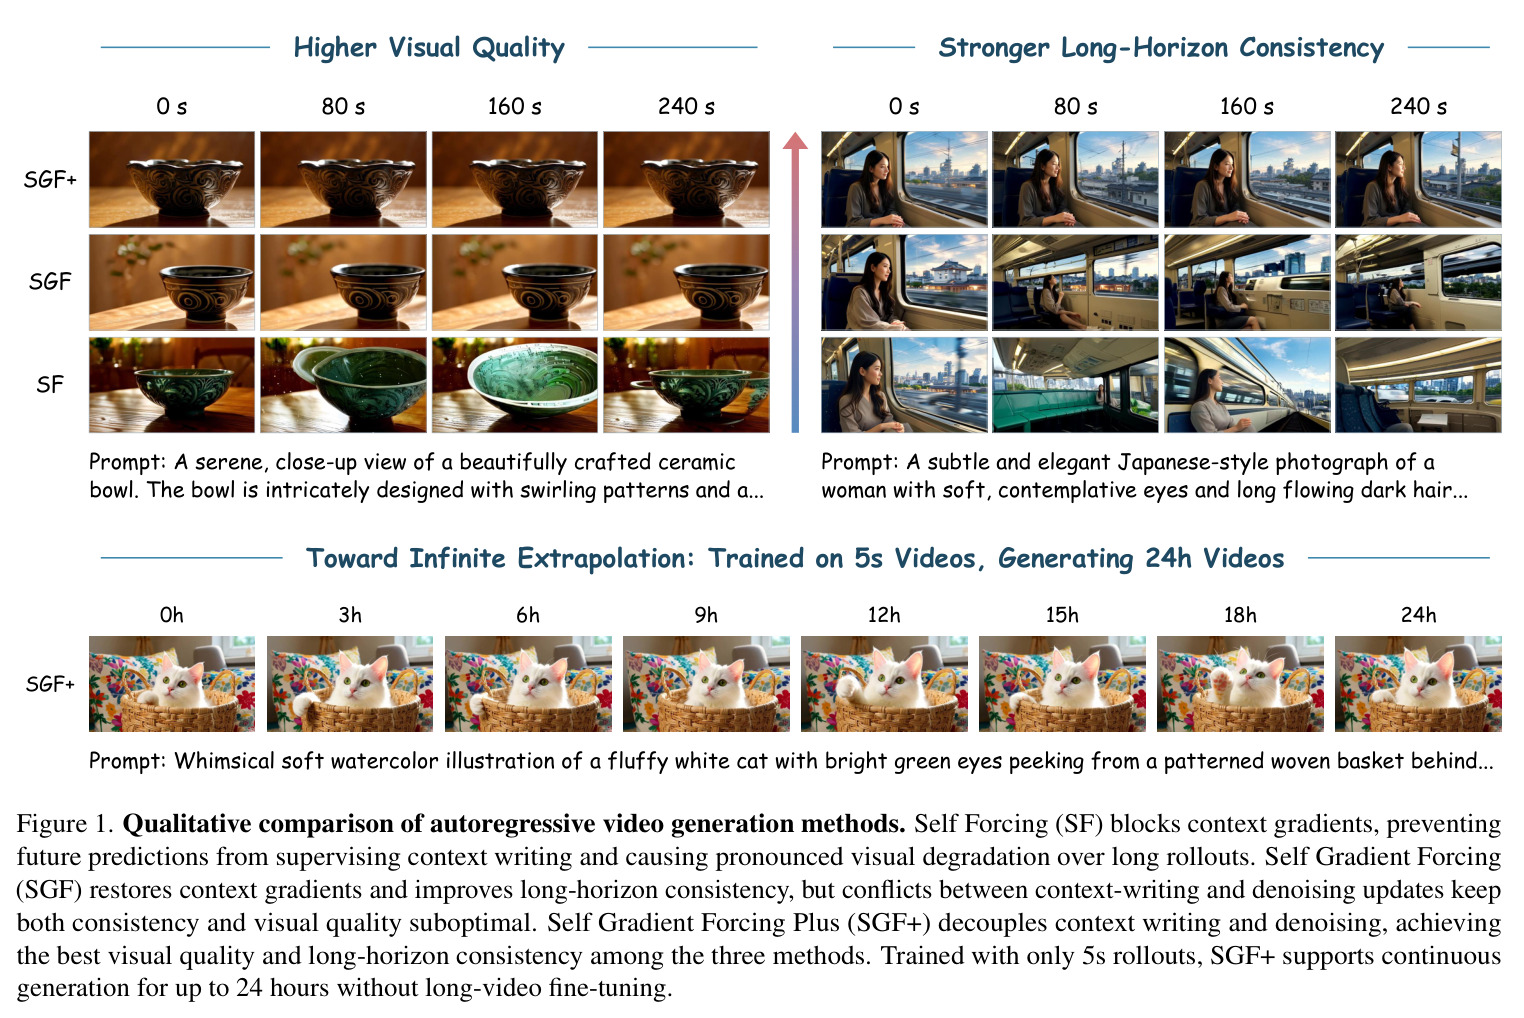
上半部分对比 SF、SGF、SGF+ 在陶瓷碗、日式人像两个提示下 0-240 秒长滚动中的画面质量:SF 随时间明显退化,SGF 保持一致但画质欠佳,SGF+ 两者兼得;下半部分展示 SGF+ 从 5 秒训练窗无微调连续外推到 0h/3h/6h/9h/12h/15h/18h/24h 的水彩猫视频。
一图概括全文两大卖点:相比 SF/SGF 的画质与一致性优势,以及 5 秒训练到 24 小时生成的原生外推能力,是读者理解工作价值的最快入口。
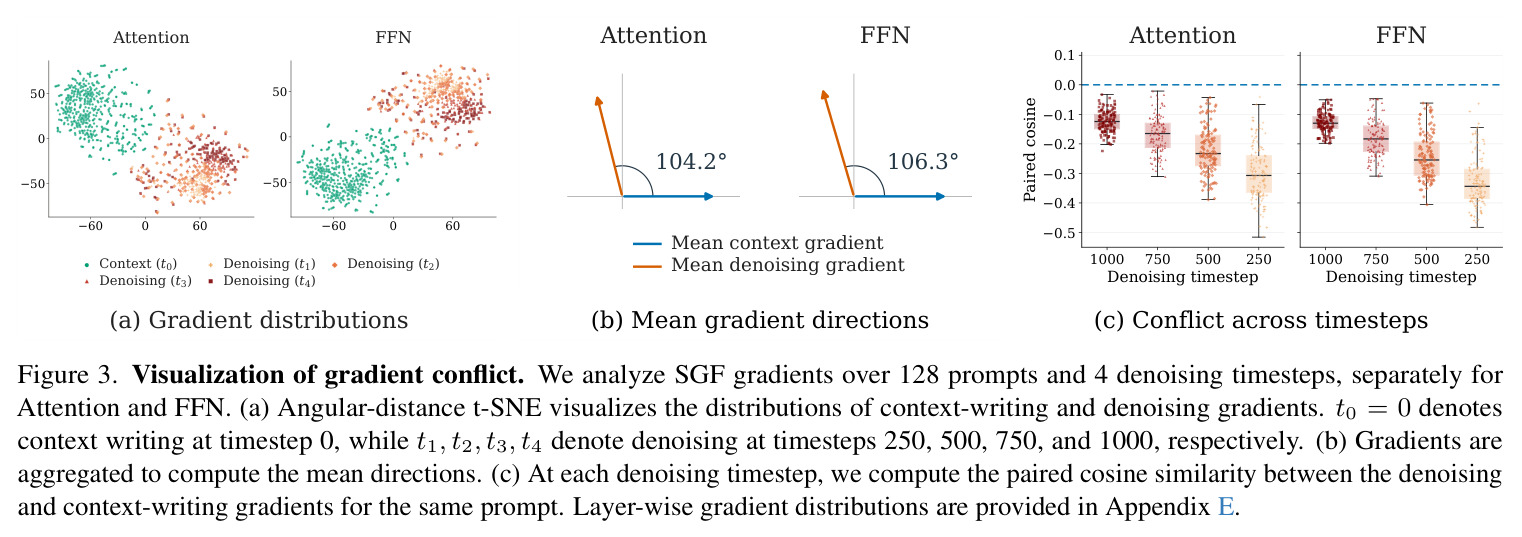
梯度冲突可视化,三联图:(a) 角距离 t-SNE 显示上下文写入(t0)与四个去噪步(t1-t4,对应 250/500/750/1000)的梯度分布明显分成两簇;(b) 聚合后的平均梯度方向在 Attention 和 FFN 中夹角分别达 104.2° 和 106.3°;(c) 同一 prompt 下逐对余弦相似度在所有去噪步上全为负(512 对),表明系统性负对齐。
这是全文核心论点——共享参数下两角色梯度冲突——的直接定量证据,是参数分离这一方法决策的实证基础。
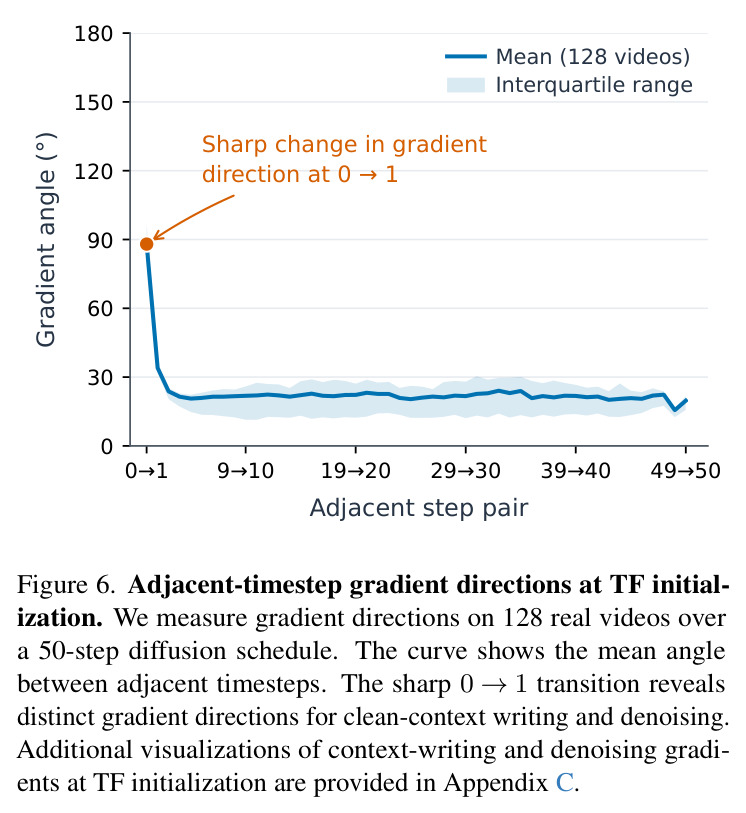
在 Teacher Forcing 初始化(未做任何 SGF 训练)时,对 128 个真实视频的 50 步扩散 schedule 测量相邻去噪步之间的梯度方向夹角:曲线在 0→1 步对处出现尖锐突变(对应干净上下文写入到带噪去噪的过渡),之后各相邻步夹角较小。
证明角色梯度差异是模型固有属性而非训练产物,直接支持"从 TF 阶段就应做角色分离"的论断和向世界动作模型推广的展望。
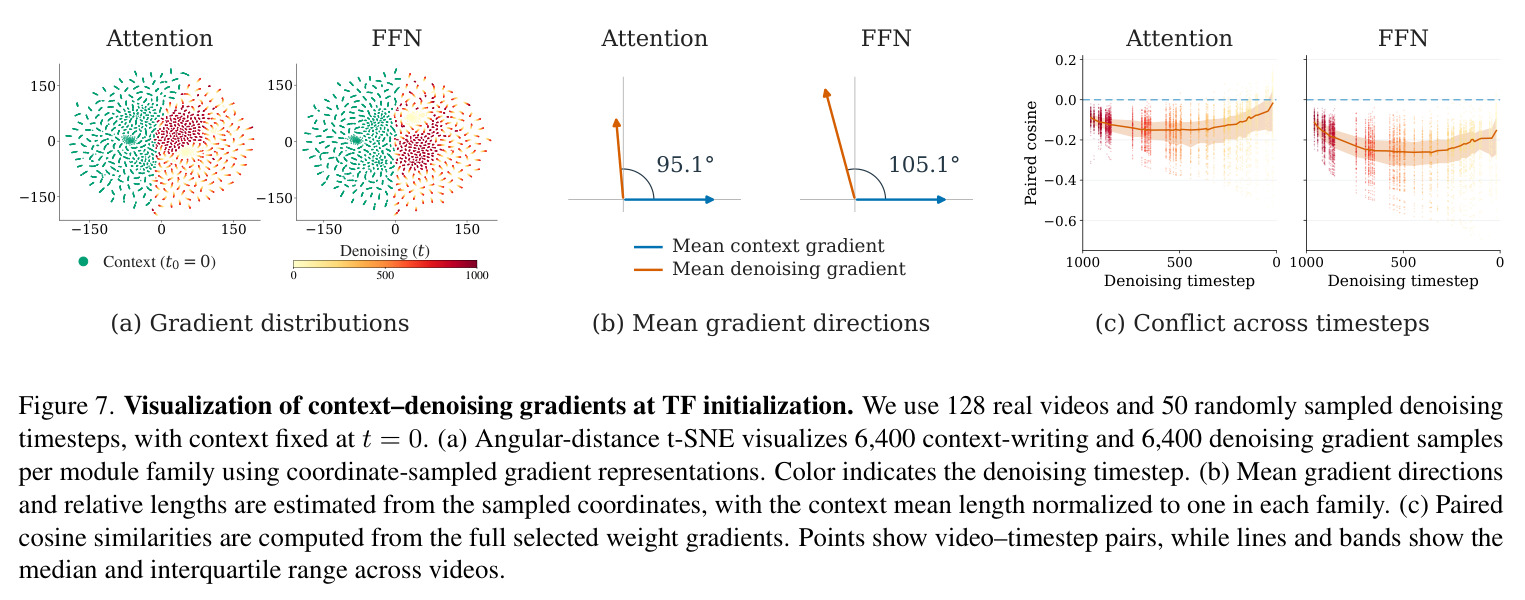
附录 C 中 TF 初始化阶段的梯度可视化:用 128 个真实视频和 50 个随机去噪步,t-SNE 显示每个模块族中 6400 个上下文写入与 6400 个去噪梯度样本分布明显分离,平均方向夹角 Attention 95.1°、FFN 105.1°,绝大多数配对余弦为负。
与 Figure 3 互为印证:Figure 3 是 SGF 训练中的冲突,Figure 7 说明冲突在训练起点就存在,是选择角色特定参数化的先验依据。
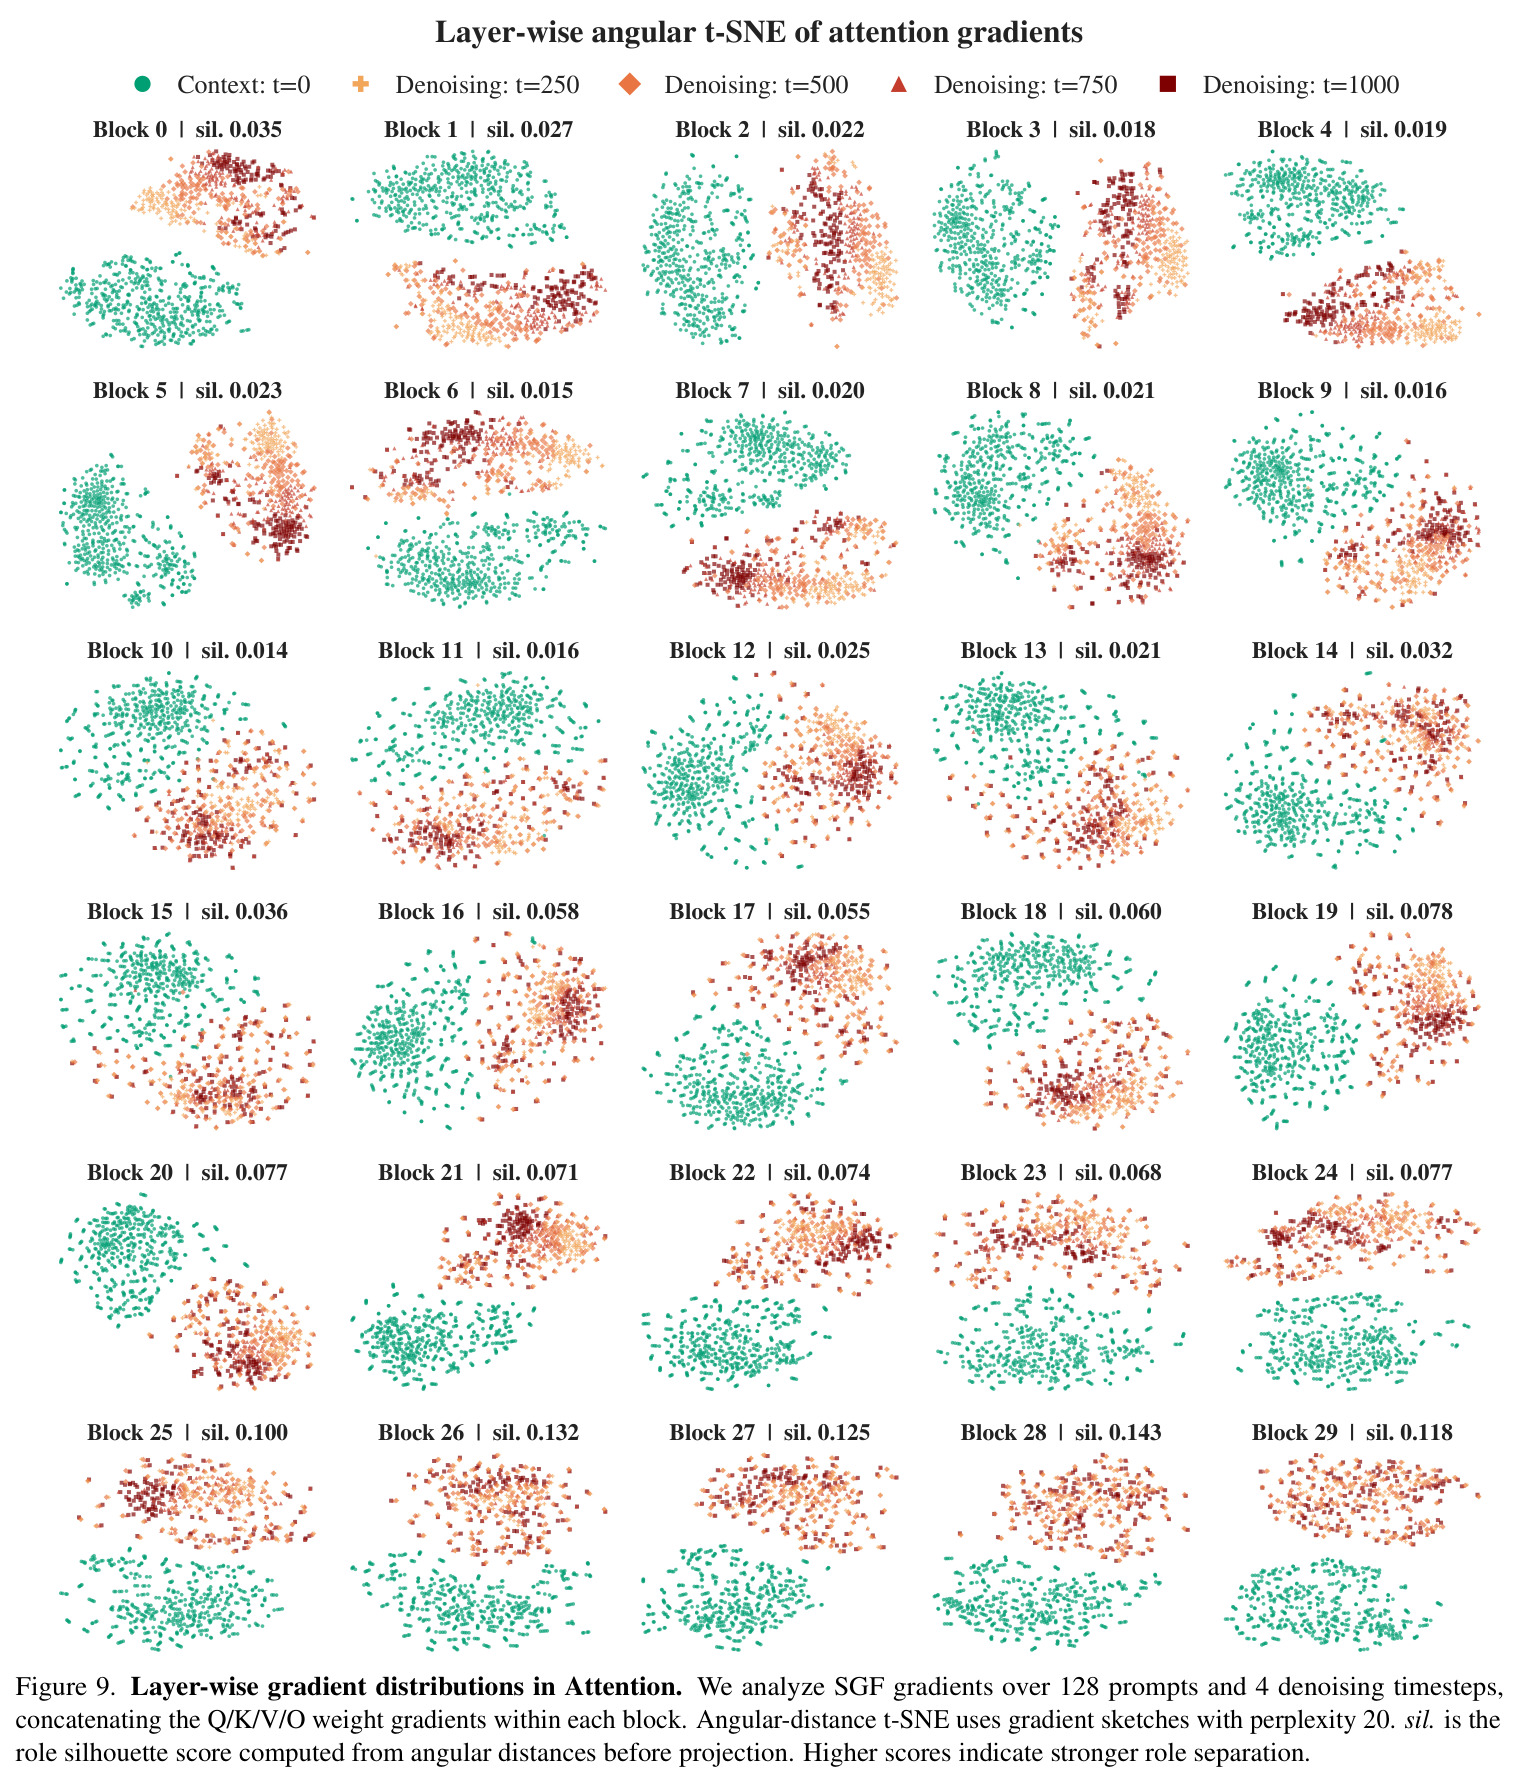
附录 E:对 30 个 Transformer 块逐层分析 Attention(Q/K/V/O 拼接权重)梯度,每块给出角色轮廓系数(sil.):浅层(0-14 块)多在 0.014-0.058,深层(15-29 块)升至 0.058-0.143,表明深层角色分离更显著。
逐层证据说明冲突遍布所有层且深层更强,为"不能只分离个别模块"的全参数分离设计提供细粒度支撑。
附录 E 的 FFN 版本(up/down 权重拼接):深层块角色轮廓系数高达 0.145-0.175;第 29 块对所有 512 个 prompt-步组合的上下文写入梯度均为零,角距离无定义故不显示 t-SNE。
与 Figure 9 一起完整呈现逐层梯度分离证据,且第 29 块零上下文梯度这一细节提示了各层角色分工的不均匀性。