更优视觉表征与端到端驾驶增益:ViRA 表征对齐框架研究 Do Better Visual Representations Always Lead to Better End-to-End Autonomous Driving?
ViRA 揭示 VFM 目标与辅助监督共同决定驾驶增益,达 92.3 EPDMS
前置知识
端到端自动驾驶
从原始传感器输入(本文为单帧多视角相机图像)直接预测未来自车轨迹的统一神经网络范式,无需人工拆分感知、预测、规划模块。形式化为编码器 $E_\theta$ 提取中间表征 $F_s$,策略头 $\pi_\psi$ 从中解码轨迹 $\hat{\tau}$,策略头可分为回归式(TransFuser)、扩散式(DiffusionDrive)、打分式(Rap*)三类。
本文的研究对象正是这类规划器的视觉表征质量,ViRA 作为 planner 无关框架需要能嫁接到三种异构策略头上,理解这一统一接口 $F_s=E_\theta(O),\ \hat{\tau}=\pi_\psi(F_s)$ 才能看懂实验设计。
视觉基础模型(VFM)
在大规模通用或领域数据上预训练的视觉编码器,本文涉及五类:DINOv3(通用语义)、VGGT(3D 几何)、SAM3(分割)、Depth Anything 3/DA3(深度)、DVGT(驾驶场景几何)。它们被冻结后作为「老师」提供表征级监督,训练完即丢弃。
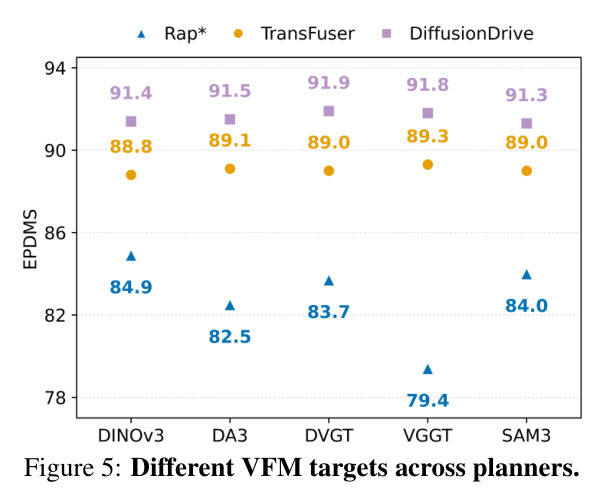
论文核心问题是这些 VFM 的表征优势何时、如何转化为驾驶收益,「目标 VFM 的选择」正是全文最重要的实验变量,五个目标带来的增益差异高达 5.5 EPDMS。
表征对齐与知识蒸馏
不迁移 logits 或显式标签,而是让学生网络的中间特征模仿老师特征的分布或统计结构。注意力蒸馏(attention transfer、相似度保持蒸馏)对齐空间依赖关系;对比学习对齐全局语义嵌入。REPA 在图像生成、Spatial Forcing 在 VLA 中已验证其有效性。
ViRA 的两个损失 SDA/SSA 正是「空间注意力对齐 + 全局对比对齐」的组合,理解这一谱系才能看懂损失设计、权重设定($\lambda_{\mathrm{SDA}}=1, \lambda_{\mathrm{SSA}}=0.1$)与消融结论。
KL 散度
衡量两个概率分布差异的非对称度量 $D_{\mathrm{KL}}(P\|Q)$。SDA 中先把 planner 与 VFM 的交叉注意力图经 softmax 归一化成概率分布,再用 KL 散度强迫 planner 复现 VFM 的空间自依赖结构,温度 $\gamma_{\mathrm{sda}}=0.07$。
SDA 是 ViRA 增益的主要来源:消融显示 KL+对比组合最优(89.0 EPDMS),而单独 MSE/Cosine/KL/对比均不超过 85.1,理解 KL 在其中的角色是读懂方法与消融的关键。
对比学习
拉近正样本对(同一场景的 planner 全局嵌入 $z_s$ 与 VFM 嵌入 $z_t$)、推远批内负样本对的表征学习范式。本文用双向 InfoNCE:$\mathcal{L}_{\mathrm{SSA}} = \frac{1}{2}[\mathrm{CE}(M,y) + \mathrm{CE}(M^\top,y)]$,相似度矩阵 $M = z_s z_t^\top / \gamma_{\mathrm{ssa}}$。
SSA 用它保证场景级语义一致性,是除 SDA 外的第二个对齐目标;双项权重 0.1 的设定源自 iREPA「空间结构比全局语义更重要」的发现。
EPDMS 与 NAVSIM/HUGSIM 基准
NAVSIM v2 是基于 OpenScene/nuPlan 的非反应式数据驱动仿真基准,navtest 含 12146 个场景;EPDMS = 乘法惩罚项(NC 碰撞、DAC 可行驶区域、DDC 方向、TLC 红绿灯)× 加权平均项(TTC、EP、LK、HC、EC)。HUGSIM 是 3DGS 重建的实时闭环仿真,周围车辆会对自车做出反应,指标为 HD-Score。
全部主结论都用这两个基准度量:开环 EPDMS 证明增益存在,零样本闭环 HD-Score 证明增益能迁移到交互式环境,只有理解子指标才能解读表格中 DAC/LK/EC 的变化。
研究动机
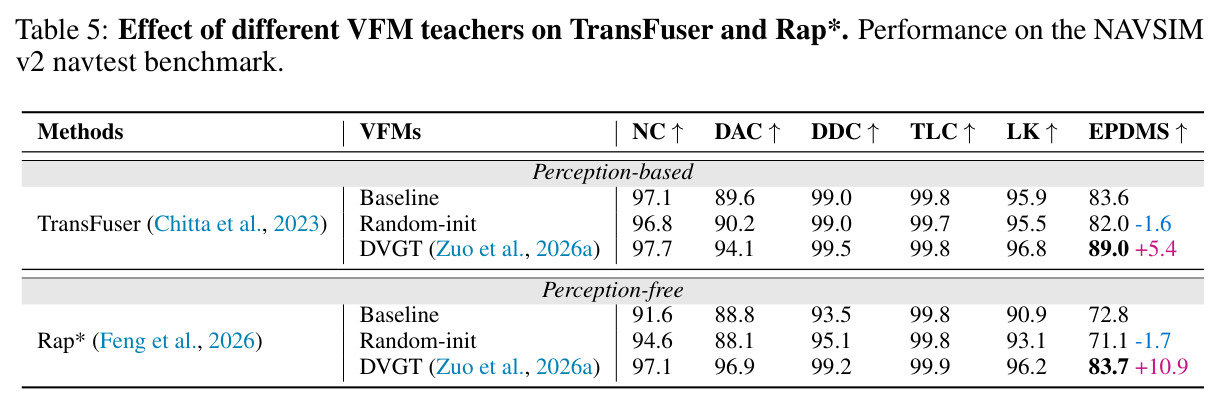
端到端自动驾驶社区正大规模引入视觉基础模型:或直接用 VFM 替换规划器视觉骨干,或用 VFM 的预测结果做辅助监督,或在任务特定架构中融合 VFM 特征。但这些工作几乎都只研究单一的 planner–VFM 配对(例如在某个特定系统里验证 DINOv3 或 DVGT 的收益),跨配对的系统性对比严重缺失。这导致一个基础问题悬而未决:VFM 在语义分割、深度估计等视觉任务上的优势,是否能稳定转化为驾驶性能提升?现实数据也说明这一点:在 NAVSIM v2 navtest 上,Rap* 基线仅 72.8 EPDMS、TransFuser 83.6、DiffusionDrive 84.5,不同 planner、不同 VFM 目标、有无辅助感知监督的组合会带来多大差异完全未知,研究者只能凭直觉和试错做选型,浪费大量算力。
本文的目标是本文的目标是建立一个受控的实验接口,系统回答三个问题:(1) VFM 引导的视觉表征能否在回归式、扩散式、打分式等异构 planner 上一致地提升驾驶性能,并把收益延伸到零样本闭环评估?(2) VFM 目标的选择对规划性能影响多大——特别是对已经用预训练 VFM 做骨干的 planner,换一个目标做对齐是否还有额外收益?(3) 辅助感知监督如何影响 planner 对 VFM 目标选择的敏感性?在此之上,作者还希望给出可落地的设计准则,并验证一个具体预测:去掉辅助感知监督、换上合适的 VFM 对齐目标,同样能训练出 SOTA 级别的规划器。
与已有工作不同的是,本文的独特切入是把「表征质量」从「架构设计」中解耦出来:ViRA 只在训练时用冻结 VFM 的中间特征对 planner 编码器施加表征级监督,推理时把 VFM 分支整个丢弃,planner 架构与推理成本完全不变。这使得不同 VFM 目标、不同 planner 之间的对比成为严格的控制变量实验,而不是不同系统之间的混同比较。此外作者设计了两个此前蒸馏工作没有的关键对照:其一,用随机初始化(而非预训练)的「假 VFM」做完全相同的对齐,以剥离对齐损失本身的正则化效应;其二,对 TransFuser 训练有/无辅助感知监督的双版本,在同样的五个 VFM 目标上扫描,从而分离出「监督设计 × 目标选择」的交互作用——这正是「更好的表征是否总是更好」这一问题的隐藏维度。
核心方法
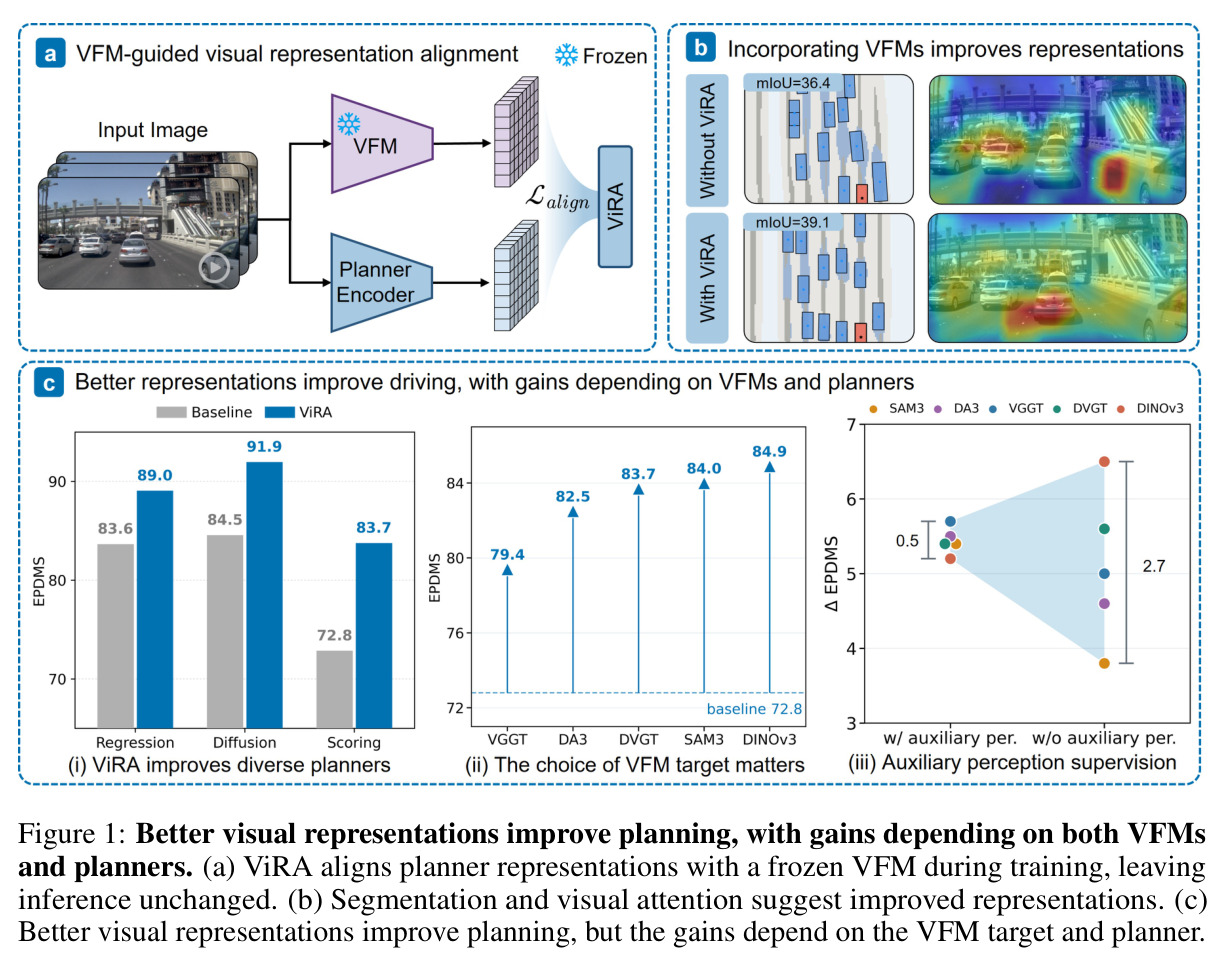
直觉上,端到端规划器的性能瓶颈常在编码器学到的视觉表征:它必须同时编码可行驶区域、车道结构、周围智能体等空间依赖与场景语义。ViRA 给 planner 配一位「表征老师」——训练时把同一多视角观测 $O$ 喂给冻结 VFM 得到 $F_t = T_\phi(O)$,与 planner 特征 $F_s = E_\theta(O)$ 在潜空间对齐;策略头 $\pi_\psi$ 仍只消费 $F_s$,VFM 特征从不进入策略头,也不需额外标注。总损失 $\mathcal{L} = \mathcal{L}_{\mathrm{planner}} + \lambda_{\mathrm{SDA}}\mathcal{L}_{\mathrm{SDA}} + \lambda_{\mathrm{SSA}}\mathcal{L}_{\mathrm{SSA}}$,其中 $\mathcal{L}_{\mathrm{planner}}$ 保持原 planner 的轨迹损失与辅助任务不变。默认目标是驾驶数据预训练的 DVGT,也兼容 VGGT、DINOv3-L、SAM3、DA3。训练后 VFM 与投影头被丢弃:推理架构零改动,延迟参数量不变(Rap* 保持 20ms/69M)。
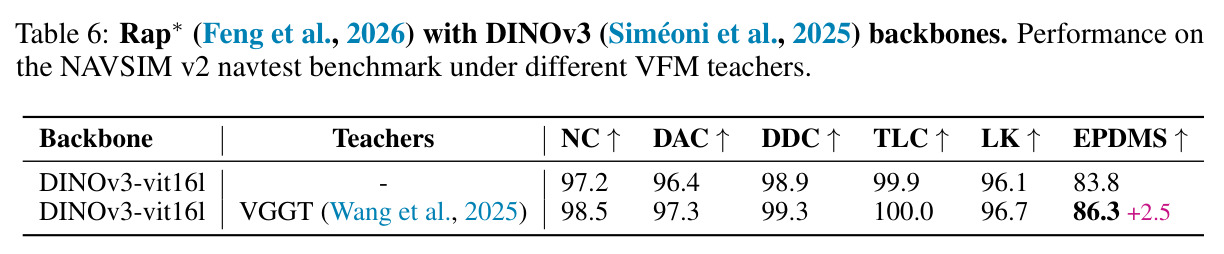
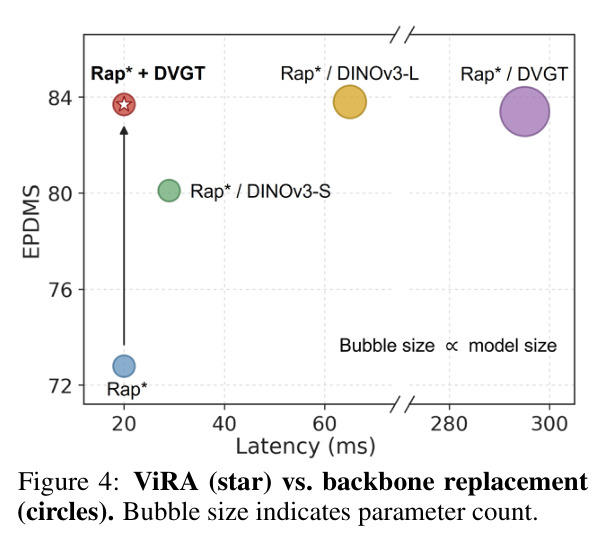
与已有 VFM 集成方式的本质区别有三点。第一,监督发生在潜空间而非输出空间:不用 VFM 的分割/深度预测做伪标签(那依赖显式解码与标注对齐),也不做逐点特征 MSE 回归(消融显示单用 MSE 只有 84.4 EPDMS),而是 SDA 用交叉注意力分布 $A^s = \mathrm{softmax}(Q_s K_t^\top / \gamma_{\mathrm{sda}})$ 匹配 VFM 的自依赖分布 $A^t$,传递「该关注哪里」的空间关系结构而非具体特征数值,温度 $\gamma_{\mathrm{sda}}=0.07$。第二,与骨干替换相比推理零开销:换 DINOv3-L 骨干需 65ms 延迟、351M 参数才达 83.8 EPDMS,ViRA 以 20ms/69M 达 83.7,几乎无损。第三,把对齐当作受控实验接口而非单纯刷点工具:借鉴 iREPA「空间结构比全局语义更关键」的结论设定 $\lambda_{\mathrm{SDA}}=1, \lambda_{\mathrm{SSA}}=0.1$,首次在驾驶领域定量回答目标选择与辅助监督如何交互这一科学问题。
方法步骤详情
流程分五步。(1) 特征提取:多视角图像 $O$ 分别输入 planner 编码器与冻结 VFM;DVGT 取 aggregator 四个中间层 token 特征、用可学习权重融合后重塑为空间特征图,其他 VFM 取任务预测头之前的特征图,避免显式伪标签。(2) 对齐准备:$F_s$ resize 到 $F_t$ 的分辨率,双方各经 1×1 卷积投影头映射到共享潜空间。(3) SDA:计算 $A^s=\mathrm{softmax}(Q_s K_t^\top/\gamma_{\mathrm{sda}})$ 与 $A^t=\mathrm{softmax}(Q_t K_t^\top/\gamma_{\mathrm{sda}})$($\gamma_{\mathrm{sda}}=0.07$),$\mathcal{L}_{\mathrm{SDA}} = \mathbb{E}_{b,i}\, D_{\mathrm{KL}}(A^t\,\|\,A^s)$。(4) SSA:池化得全局嵌入 $z_s, z_t$,相似度矩阵 $M = z_s z_t^\top/\gamma_{\mathrm{ssa}}$($\gamma_{\mathrm{ssa}}=1.0$),$\mathcal{L}_{\mathrm{SSA}} = \frac{1}{2}[\mathrm{CE}(M,y)+\mathrm{CE}(M^\top,y)]$。(5) 联合训练与部署:$\mathcal{L} = \mathcal{L}_{\mathrm{planner}} + \mathcal{L}_{\mathrm{SDA}} + 0.1\mathcal{L}_{\mathrm{SSA}}$,8×H100 上按官方协议训练(TransFuser/DiffusionDrive 100 epochs、batch 192;Rap* 30 epochs、batch 48),收敛后丢弃 VFM 分支与投影头,推理路径与基线完全一致。
技术新颖性
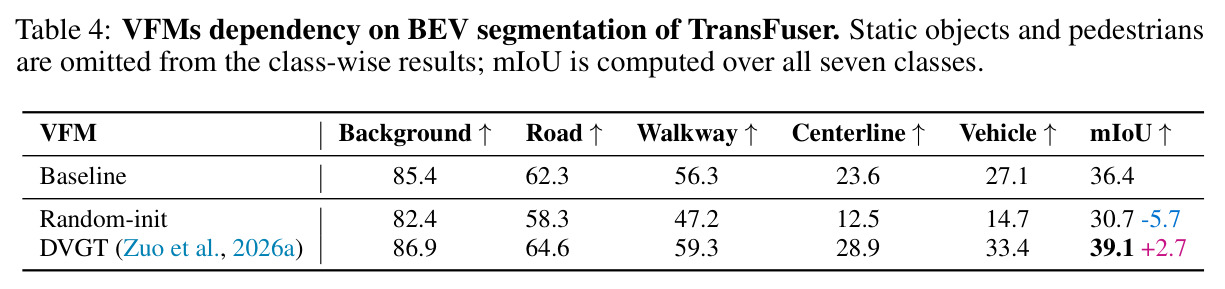
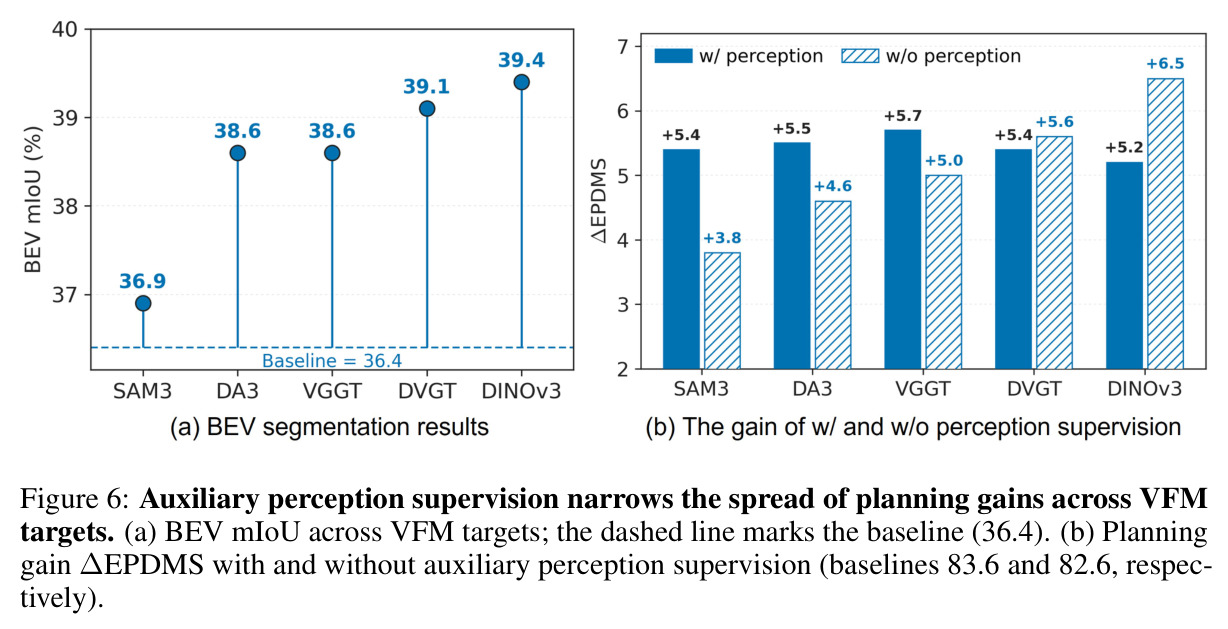
表征对齐并非新工具——REPA 之于扩散图像生成、Spatial Forcing 之于 VLA 都用了类似思想,本文新颖性在于三点。其一,首次把它作为端到端驾驶的受控实验接口,在 3 策略头 × 5 VFM 目标网格上系统量化「目标 × planner 设计 × 辅助监督」的三方交互,产出可迁移规律而非单点 SOTA。其二,发现辅助感知监督的「补偿效应」:TransFuser 带辅助监督时五个目标的 EPDMS 极差仅 0.5(88.8–89.3),去掉后扩大到 2.7(86.4–89.1),且最高分几乎不动(89.3→89.1)、最低分大跌 2.4 分(88.8→86.4),说明辅助监督主要在掩盖弱目标——这一因果结论依赖 ViRA 的隔离能力。其三,用随机初始化目标做安慰剂对照,证明增益来自预训练知识而非对齐损失的正则化(随机目标使 TransFuser 降 1.6、Rap* 降 1.7,BEV mIoU 从 36.4 掉到 30.7),并把结论转化为 ViRA-Diffusion:无辅助监督 + DINOv3 对齐的扩散规划器以 92.3 EPDMS 刷新 navtest。
实验结果
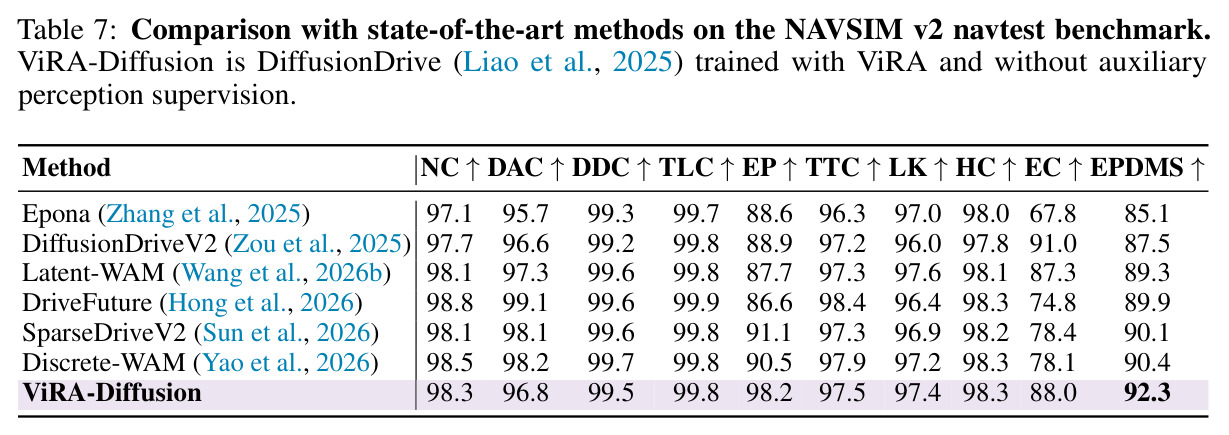
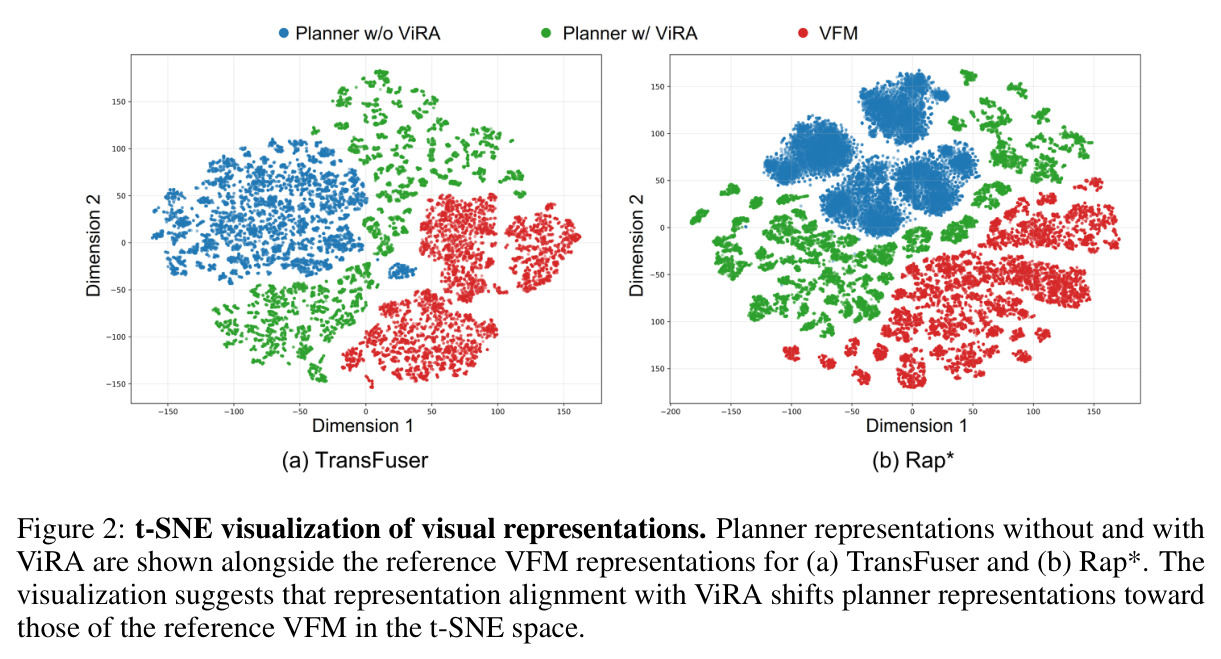
三组受控实验对应三个发现。其一,VFM 引导表征跨 planner 一致有效:navtest 上 TransFuser 83.6→89.0(+5.4)、DiffusionDrive 84.5→91.9(+7.4)、Rap* 72.8→83.7(+10.9);更难的 navhard 上分别 +4.1/+5.3/+16.4(Rap* 32.8→49.2);零样本闭环 HUGSIM 的 HD-Score 分别 +2.7/+6.4/+3.0,BEV mIoU 同步提升 0.5–3.0,t-SNE 显示表征向 VFM 靠拢。其二,目标选择很重要:五个 VFM 目标(DVGT/VGGT/DA3/DINOv3/SAM3)给 Rap* 带来 6.6–12.1 分增益(极差 5.5,DINOv3 最优 84.9),而带辅助监督的 TransFuser 极差仅 0.5;DINOv3-L 骨干的 Rap* 再对齐几何 VFM VGGT 还能 +2.5(83.8→86.3),证明异质表征互补。其三,辅助监督降低敏感性:TransFuser 去掉辅助监督后五目标极差从 0.5 扩到 2.7,最高分几乎不变而最低分 88.8→86.4。随机目标对照(mIoU 36.4→30.7、EPDMS 各降 1.6/1.7)证明预训练是必要条件。最终 ViRA-Diffusion 无辅助监督达 92.3 EPDMS,超最强对比方法 Discrete-WAM(90.4)1.9 分;消融中 KL+对比组合 89.0 最优。
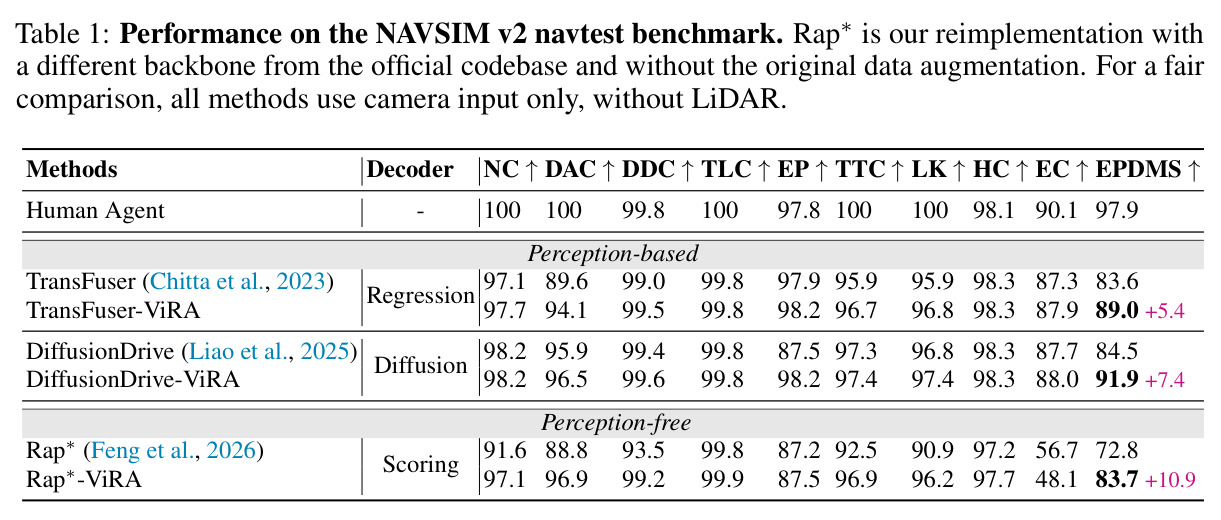
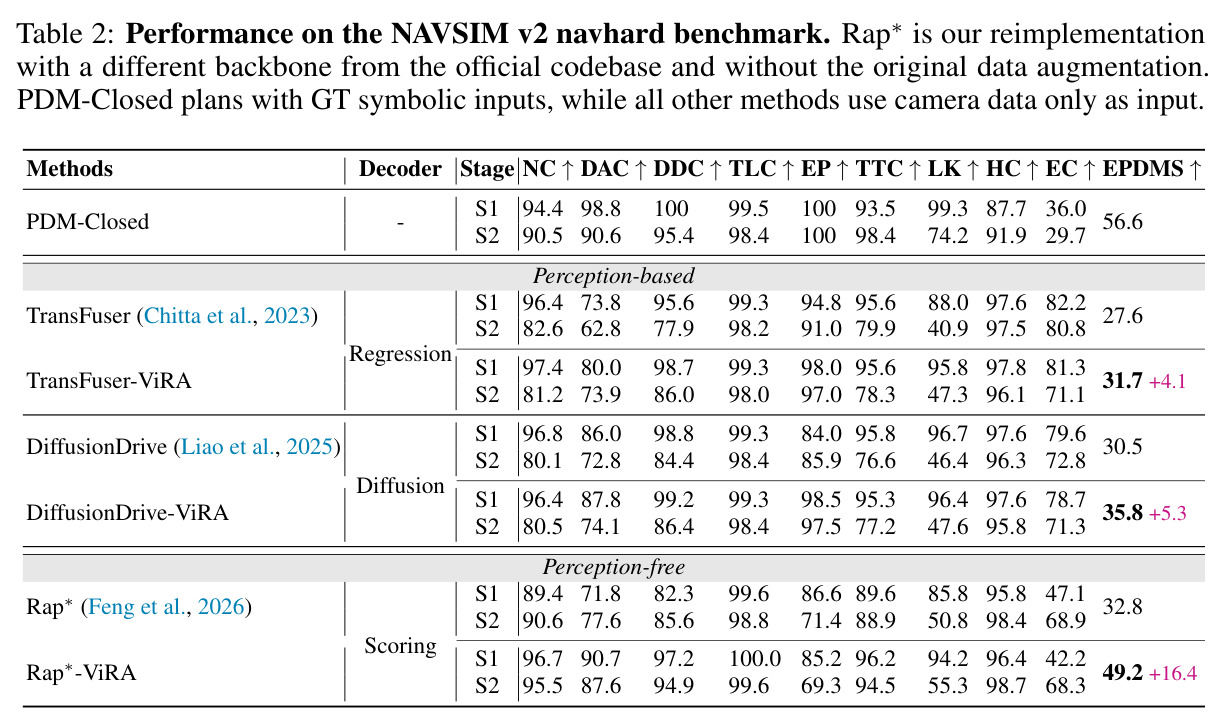
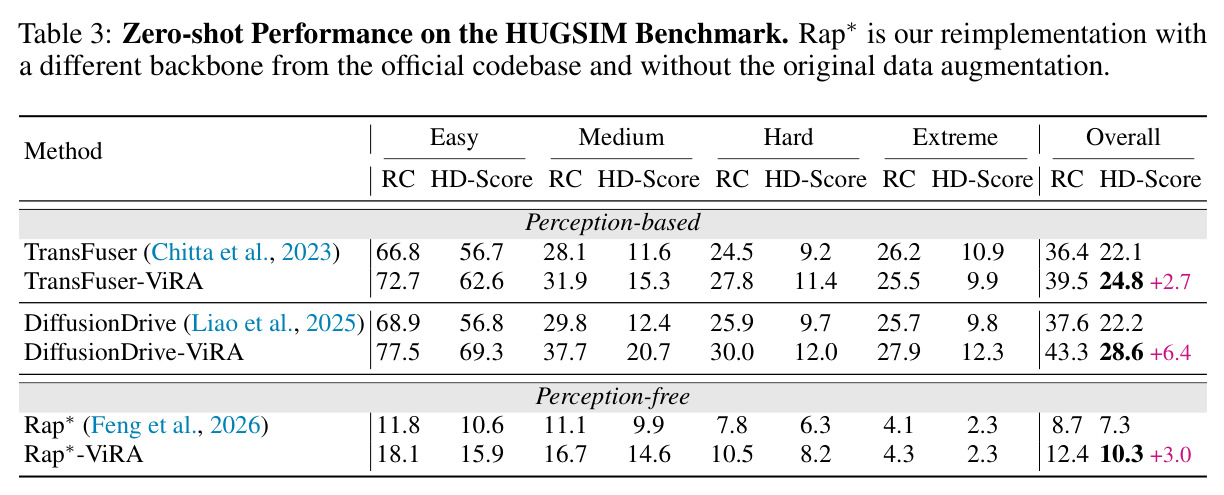
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| NAVSIM v2 navtest 端到端规划(对比 SOTA) | EPDMS | 92.3(ViRA-Diffusion:DiffusionDrive + DINOv3 对齐 + 无辅助感知监督) | 90.4(Discrete-WAM,为对比列表中最强方法) | +1.9 |
| NAVSIM v2 navtest(扩散式 planner) | EPDMS | 91.9(DiffusionDrive-ViRA) | 84.5(DiffusionDrive) | +7.4 |
| NAVSIM v2 navtest(打分式 planner) | EPDMS | 83.7(Rap*-ViRA,DVGT 目标) | 72.8(Rap* 复现版) | +10.9 |
| NAVSIM v2 navhard 挑战场景(打分式 planner) | EPDMS(两阶段) | 49.2(Rap*-ViRA) | 32.8(Rap*) | +16.4 |
| HUGSIM 零样本闭环评估(扩散式 planner) | HD-Score(Overall) | 28.6(DiffusionDrive-ViRA) | 22.2(DiffusionDrive) | +6.4 |
| TransFuser BEV 语义分割(表征质量) | mIoU(7 类) | 39.1(DVGT 目标;DINOv3 目标最高 39.4) | 36.4(无对齐基线) | +2.7(DINOv3 时 +3.0) |
局限与改进
作者承认的局限:训练时需要前向大型冻结 VFM 并存储其特征,8×H100×100 epochs 的开销不低,特征缓存、轻量蒸馏或选择性层对齐是缓解方向;实验仅覆盖三个 planner、单帧纯视觉输入、NAVSIM v2 与 HUGSIM,未涉及多模态融合、VLA 模型与实车部署。我的补充观察:其一,Rap*-ViRA 的 Extended Comfort 从 56.7 降至 48.1,navtest 总分提升有一部分被舒适性指标回吐,打分式 planner 的候选轨迹质量仍是瓶颈;其二,navhard 的绝对分数仍然很低(31.7/35.8/49.2),挑战性场景下表征改进的边际收益明显递减;其三,「辅助监督降低敏感性」的结论只在 TransFuser 上做了有/无对照,DiffusionDrive 未做同等实验,外推需谨慎;其四,BEV 分割中静态物体与行人类 IoU 在所有目标下都低于 0.5,ViRA 的提升集中在道路、可行驶区域等结构性类别,对罕见与细粒度类别帮助有限。
独立分析的弱点
第一,目标选择仍靠穷举试错:五个目标里 DINOv3 对 Rap* 最好(84.9)、DVGT 对带辅助监督的 TransFuser 最好(89.0),缺乏「给定 planner 该选哪个目标」的预测性指标,而每次试错都是 8×H100 级训练——可借鉴 iREPA 用目标表征统计量预测收益,先离线度量匹配度再训练。第二,SDA/SSA 只在单一融合特征上操作(DVGT 虽融合四层,最终仍是一份特征参与对齐),未探索多层、多粒度或按层选择性对齐,浅层几何与深层语义的互补信息可能被浪费。第三,辅助监督补偿效应只有现象和假设,缺少梯度流向或表征几何层面的机制分析,也缺 DiffusionDrive 对照。第四,舒适性与安全性的权衡未被讨论:Rap*-ViRA 的 EC 从 56.7 降到 48.1,提示对齐可能压缩轨迹分布多样性,或需加入轨迹分布正则。第五,HUGSIM 上 Rap* 仅 7.3 HD-Score(ViRA 后 10.3),说明 planner 跨域崩溃时表征对齐救不回来,鲁棒性还需数据与解码器层面协同改进。
未来方向
作者提出的方向:把结论外推到更多 planner 架构以及更广泛的「涉及决策的物理智能任务」(如机器人操作类 VLA 任务);用特征缓存、轻量 VFM 蒸馏、只对齐最有信息量的层与空间区域来压缩训练成本;在更多真实数据上检验「表征质量→规划增益」转换的 planner 依赖性。基于本文成果可自然延伸的研究:其一,建立 target–planner 匹配的预测理论,用少量探针训练或表征统计量预测某 VFM 目标的期望增益,把选型成本从全量训练降到一个前向统计;其二,将 ViRA 与闭环强化学习结合,检验对齐先验能否稳定 RL 微调(呼应 3DGS RL 训练路线);其三,在世界模型/生成式规划器(Epona、DriveFuture 一类)中做表征对齐,验证「空间结构优先于全局语义」是否跨生成式范式成立;其四,设计辅助监督与对齐目标的联合调度课程,例如训练早期用辅助监督打底、后期退火为纯 VFM 对齐,兼得稳定性与目标增益。
复现评估
代码与 demo 声明开源在 github.com/OpenDriveLab/ViRA(OpenDriveLab 开源记录良好);数据全部公开:NAVSIM v2(navtrain 训练,navtest 12146 场景、navhard 244 真实 + 4164 合成场景)与 HUGSIM;五个 VFM 目标均有官方 checkpoint(DVGT Apache 2.0,其余按各自官方协议)。论文给出完整超参:温度 $\gamma_{\mathrm{sda}}=0.07$、$\gamma_{\mathrm{ssa}}=1.0$,权重 $\lambda_{\mathrm{SDA}}=1$、$\lambda_{\mathrm{SSA}}=0.1$,以及各 planner 的优化器、学习率、batch 与 epoch(Table S.1)。主要门槛是算力与工程:单组实验需 8×H100(TransFuser/DiffusionDrive 100 epochs、batch 192;Rap* 30 epochs、batch 48),且要为多视角高分辨率输入批量提取并缓存 VFM 特征;Rap* 是作者复现版(不同骨干、去掉原数据增强),与官方数字不完全可比。总体复现难度中等,跑完整消融网格成本很高。
论文图表
方法细节总图:多视角图像分别经 planner 编码器与冻结 VFM 编码,学生/VFM 表征经投影头计算 SDA(Q/K 注意力 + KL)与 SSA(双向对比 CE)损失;VFM 分支仅用于训练,策略头只消费 planner 表征,训练后整条 VFM 分支移除。
复现方法必读:清楚交代数据流、损失计算位置与推理时丢弃的部分,消除「特征是否注入策略头」的歧义。
计算 planner 编码器特征与 VFM 特征的 Pearson 相关矩阵:原始 TransFuser 与 VFM 相关性弱且无结构,DVGT 监督后呈现更强、更有组织的相关模式。
为对齐有效性提供特征级统计证据,补充 t-SNE 的定性观察。
感知式 planner 在不同 VFM 目标下的定性对比,展示不同目标带来的 BEV 与轨迹差异。
补充主文定性结果,帮助理解目标间差异在具体场景中的表现。
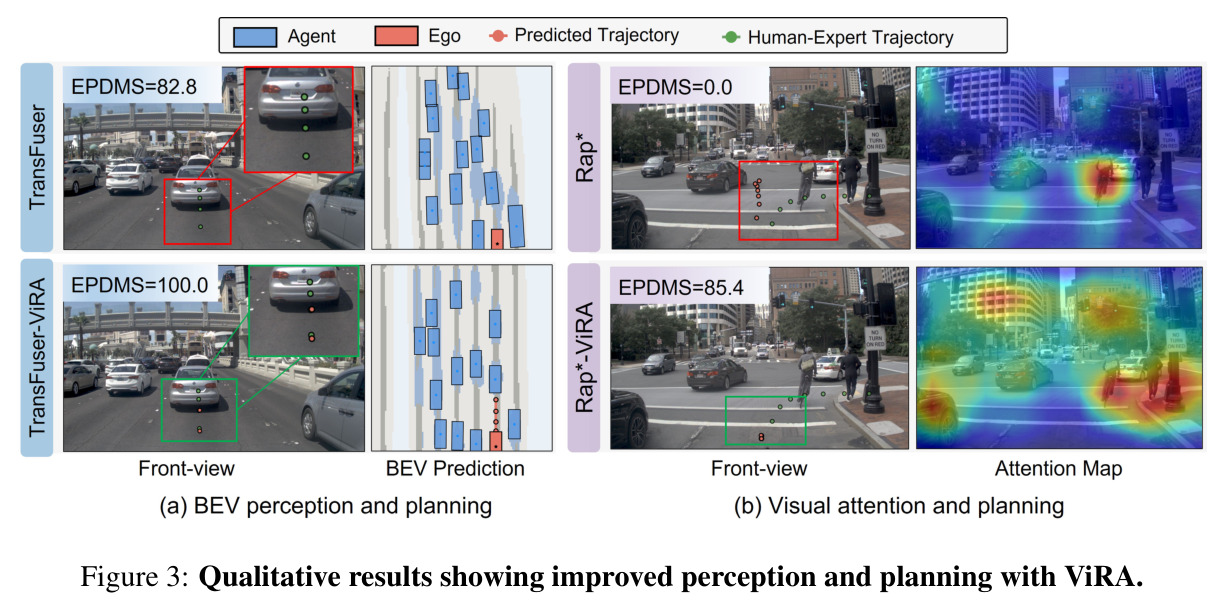
复杂路口等场景下感知式 planner 加 ViRA 前后的感知与规划对比示例。
提供更多复杂场景下的直观证据,佐证 DAC/LK 等子指标提升的行为含义。
无感知监督的 Rap* 在不同 VFM 目标下的定性对比,显示收益随目标与场景变化。
呼应「目标选择对无感知监督 planner 更敏感」的定量结论。
感知免费 planner 的失败案例:不同 VFM 目标呈现略不同的失败模式,提示其表征存在细微但实质的差异。
作者坦诚的失败分析,说明表征改进并非万能,是评估结论边界的重要材料。
感知式 planner 的失败案例:即使 ViRA 给出更完整的 BEV 语义图,规划轨迹在挑战场景仍可能偏离人类专家。
揭示「好表征 ≠ 好规划」的剩余瓶颈(轨迹解码、时序推理、交互建模),界定方法适用范围。
三个 planner 的模型与训练配置:传感器(3 或 4 相机)、分辨率、骨干均为 ResNet-34、参数量 56M/61M/69M、辅助任务设置,以及 8×H100 上的 epochs(100/100/30)、总 batch(192/192/48)、学习率与优化器(Adam/AdamW)。
复现的完整配方,也是理解各 planner 实验协议差异(如 Rap* 无辅助任务)的依据。
对齐目标消融(TransFuser):单用 MSE/Cosine/KL/对比分别得 84.4/85.1/84.3/84.6,组合中最差的 MSE+Cosine 仅 83.6,KL+对比最优达 89.0。
证明「对齐什么」比「是否对齐」更关键:匹配空间依赖分布 + 全局语义的组合是增益来源。
带辅助监督的 TransFuser 在五个目标下的完整子指标:EPDMS 88.8–89.3(增益 5.2–5.7),VGGT 最高 89.3;另含 Random-init 对照 82.0(-1.6)。
支撑「有辅助监督时对目标不敏感」结论的完整数据表。
去掉辅助监督后同一组实验:基线 82.6,五目标 EPDMS 86.4–89.1(增益 3.8–6.5,DINOv3 最高),极差从 0.5 扩到 2.7;Random-init 降到 80.1(-2.5)。
辅助监督补偿效应的直接证据表,与 Table S.3 对照即得核心发现三。
无辅助监督的 Rap* 在五个目标下:DVGT 83.7、VGGT 79.4、DA3 82.5、DINOv3 84.9、SAM3 84.0,增益 6.6–12.1,极差 5.5;EC 子项波动明显(36.5–60.1)。
目标选择重要性的最敏感测试床,同时暴露打分式 planner 的舒适项权衡。
七类 BEV 分割的类别级 IoU:所有预训练目标提升 mIoU 0.5(SAM3)至 3.0(DINOv3),但静态物体与行人类在所有目标下 IoU 均≈0,提升集中在 background/road/walkway/centerline/vehicle。
细化「表征改善」的具体类别构成,揭示对齐对结构性类别有效、对罕见类别无能为力的边界。