Qwen-Drive-1.0:迈向自动驾驶视觉语言基础模型的初步尝试 Qwen-Drive-1.0: An Initial Step towards a Vision-Language Foundation Model for Autonomous Driving
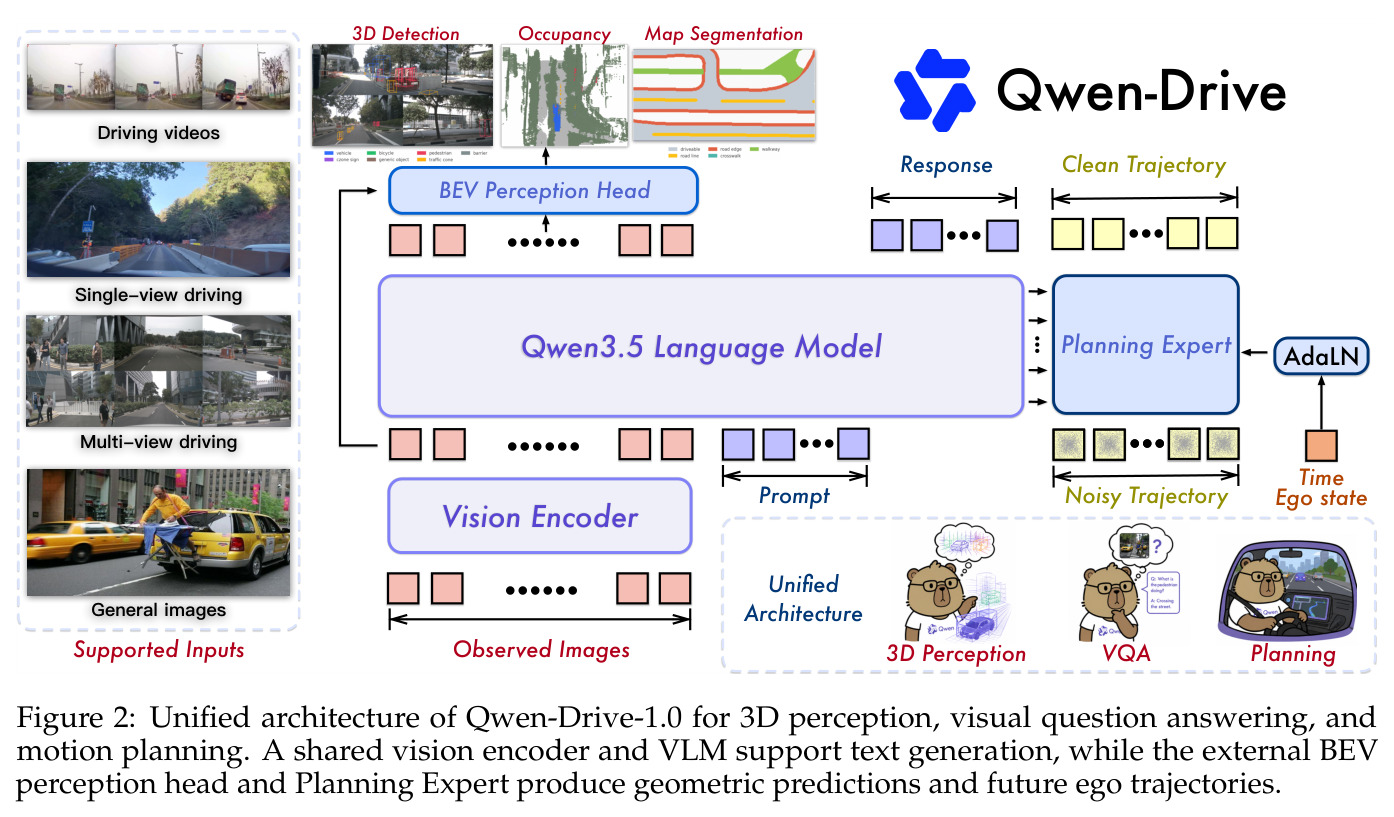
不改VLM架构,外挂BEV感知头与规划专家,统一3D感知、驾驶问答与运动规划
前置知识
VLM 与 VLA 模型
视觉语言模型(VLM)把图像编码为视觉 token,与文本 token 一起送入 transformer,自回归地生成回答;视觉语言动作模型(VLA)进一步把动作(如车辆轨迹)作为输出模态,用统一的序列生成接口连接场景理解、推理与控制。大规模预训练赋予其通用视觉与世界知识。
本文的全部设计都围绕'如何在不改动预训练 VLM 的前提下为其添加驾驶能力'展开,不理解 VLM/VLA 范式就无法理解其与从头训练的端到端管线的本质区别。
BEV 感知与鸟瞰图表示
BEV(bird's-eye-view)感知把多个相机的图像特征先通过预测的逐像素深度提升到 3D 体素空间,再按相机标定投影到以自车为中心的俯视网格上,形成统一的自车系表征,供检测、分割等下游任务解码。是环视自动驾驶感知的主流范式。
论文的 BEV 感知头正是用深度提升(式 2 的体素特征 $V(p)$)加查询式 BEV transformer 构建显式 3D 表征,这是理解其'感知探针'设计的核心。
语义占据预测(Occupancy)
语义占据预测对 3D 空间中每个体素预测占用状态与语义类别(如车辆、可行驶面、背景),不依赖预定义的 3D 框,能表达不规则障碍物。常用指标有 Occ mIoU 与沿射线评估的 RayIoU。
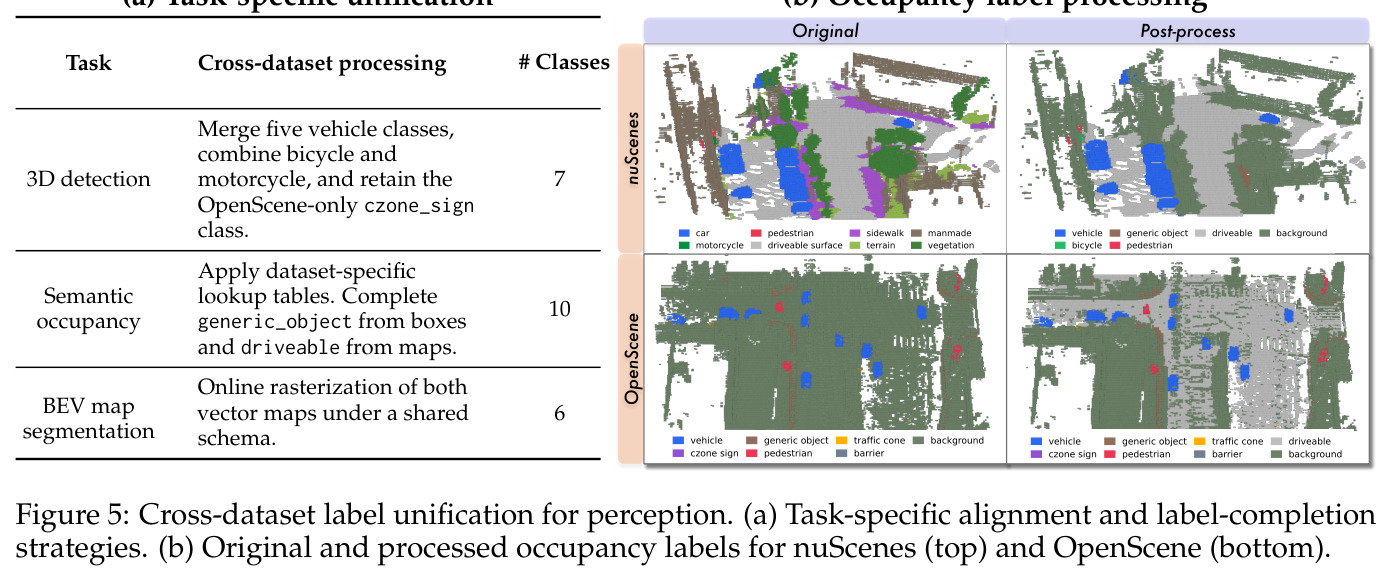
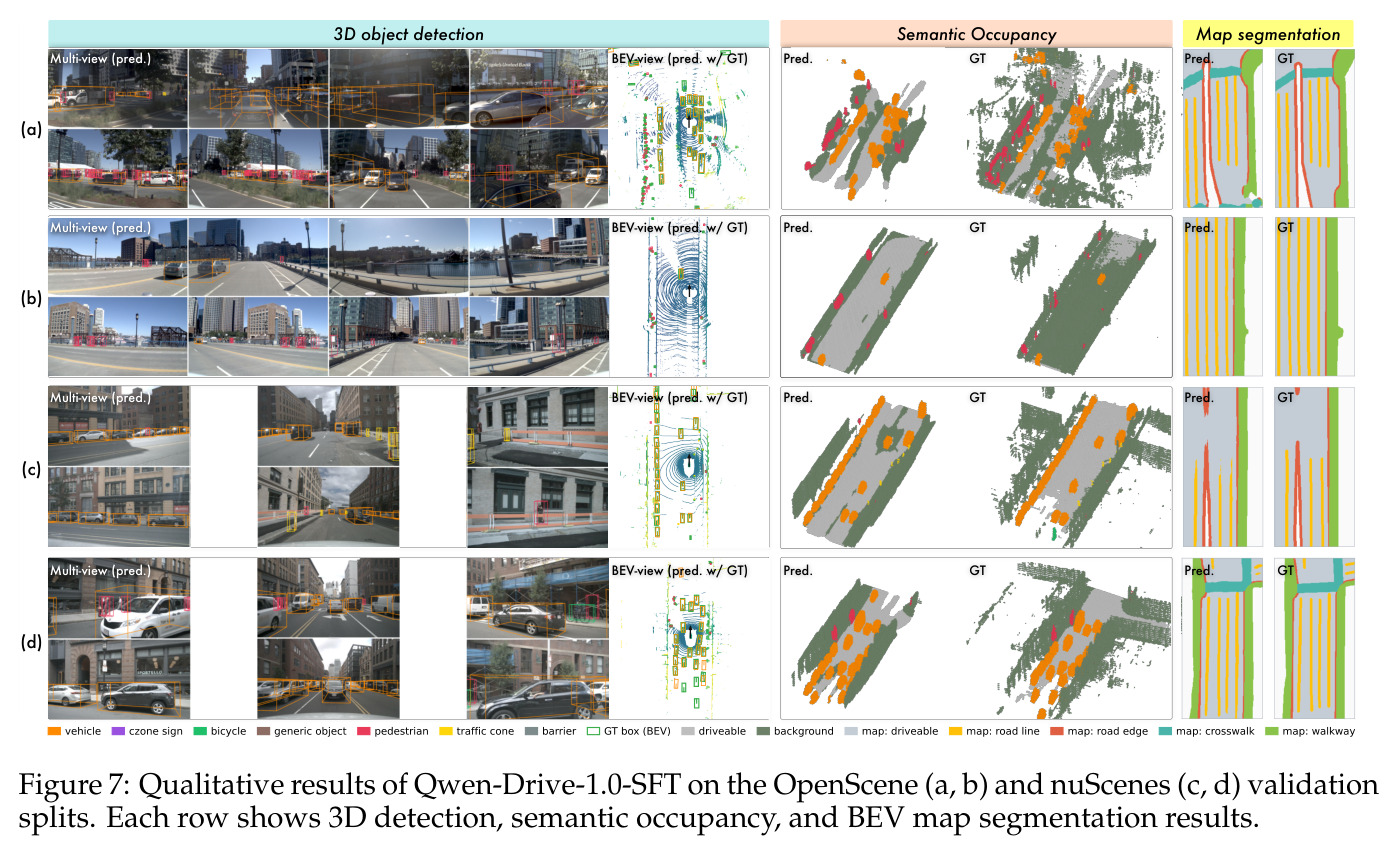
占据预测是本文三大感知任务之一,也是结果分析中暴露标签噪声问题的关键:OpenScene 的机器生成占据标签伪影直接压制了该任务指标。
Flow Matching 与扩散规划
流匹配是生成式建模方法:在噪声 $ au_0$ 与数据 $ au_1$ 之间定义线性插值路径 $ au_t=(1-t) au_0+t au_1$,训练网络预测该路径诱导的速度场,推理时从噪声出发用 Euler 积分走到数据分布。相比扩散模型训练目标更简单、采样步数更少。
规划专家用 flow matching 生成轨迹,且 RL 阶段'如何对一个确定性 flow 采样器做策略梯度'是论文最技术性的贡献,不懂 flow matching 无法读懂 Stage 4。
GRPO 式组相对优势
一种免价值网络的策略优化:对同一输入采样一组 $G$ 个 rollout,用组内奖励的标准化值 $A_i=(R_i-\bar{R})/(\sigma_R+\epsilon)$ 作为每个样本的优势基线,省去学习一个 critic。源自 GRPO,广泛用于 LLM 的 RLHF。
Stage 4 用 $G=8$ 个共享初始噪声的 rollout 组做组相对优势估计(式 13),是理解其强化学习配方的关键组件。
灾难性遗忘
模型在领域数据上微调后,覆盖或丢失预训练阶段学到的通用知识与能力(如多轮对话、通用视觉理解)的现象。常用缓解手段是混入通用数据回放或限制参数更新范围。
本文动机之二就是缓解遗忘:混入 26-31% 通用 VL 数据、冻结共享表征训练外挂模块,使通用 VQA 平均只掉不到 1 分,这是与专用驾驶模型的核心差异。
开环、伪闭环与闭环评估
开环评估只把预测轨迹与录制真值比 ADE 等(如 WOD-E2E、PAI-AV);伪闭环(NAVSIM)把预测轨迹经车辆模型传播打分(PDMS),但不重新查询规划器、他车不反应;闭环仿真(AlpaSim)反复重查询规划器、动作改变后续观测,能暴露误差累积。
论文刻意在三个层级递进评测规划能力,理解三者的差异才能正确解读 PDMS 90.7、RFS 7.91 与 AlpaSim score 0.37 各自的意义与局限。
研究动机
当前主流的驾驶 VLA(视觉-语言-动作)路线是拿一个通用预训练 VLM,用驾驶领域的视觉问答(VQA)数据继续训练,把异构驾驶任务统一成自回归文本接口。本文指出该路线有两大硬伤。其一,文本 VQA 目标不直接约束 3D 布局、深度与占据:即便预训练表征中已编码空间线索,纯文本监督既不要求模型输出显式 3D 预测,也无法直接评估其空间精度——作者的对照实验证实,直接在预训练特征上训练一个已收敛的感知头,nuScenes 检测 mAP 只有 35.60,比同等条件的多任务专用检测器 BEVFormerV2* 低 6.34 mAP、低 6.91 RayIoU,说明通用特征并不天然暴露 3D 结构,模型可以描述流畅却在三维空间中不精确。其二,大规模领域适配会造成灾难性遗忘:专用模型在通用基准上大幅退化(如 MiMo-Embodied 通用平均仅 26.53,Alpamayo-1.5 仅 14.65),而预训练知识本可用于罕见与分布外(OOD)场景推理,任何有限驾驶数据集都无法穷尽部署长尾。从部署看,座舱-驾驶一体化要求单一模型在一份算力预算下同时承担对话与驾驶,牺牲通用能力的专用模型反而需要第二个模型,抬高硬件与维护成本。
本文的目标是本文目标是构建自动驾驶视觉语言基础模型 Qwen-Drive-1.0:在一个保持不变的预训练 VLM(Qwen3.5-4B)之上,同时完成三类任务——显式 3D 感知(3D 目标检测、语义占据预测、BEV 地图分割)、驾驶视觉问答与因果推理、运动规划(生成未来 5 秒自车轨迹)。作者明确提出三条设计要求:第一,预训练 VLM 架构保持不变以保留易用性与可升级性;第二,用显式、可检查的感知探针暴露并评估 3D 场景信息,而不是依赖纯文本空间推理;第三,在获得驾驶知识的同时最大限度保留通用视觉语言能力,既支撑罕见场景的 OOD 泛化,又让一个模型覆盖座舱与驾驶两个域,省去单独座舱模型的算力开销。
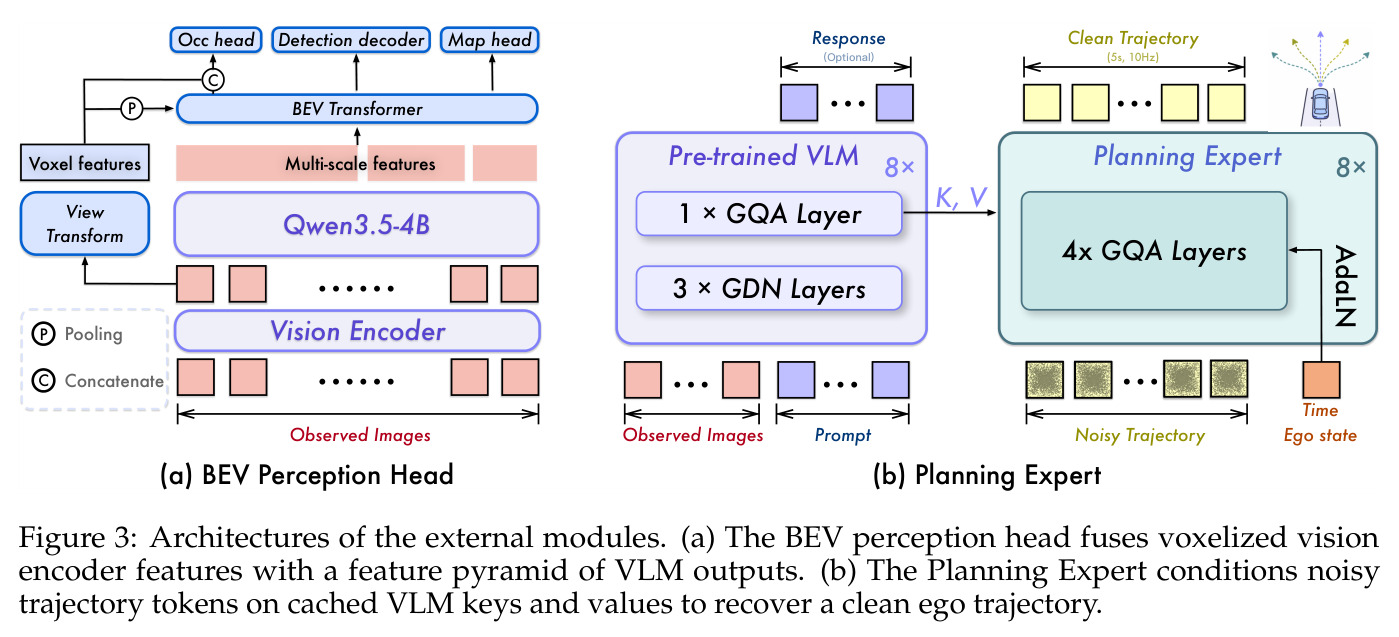
与已有工作不同的是,本文的独特切入是把外部模块定位为'探针'(probe)而非新架构。与 UniAD 类从头协同训练的模块化管线不同,也与仅靠语言监督适配的 DriveLM 类方法不同,作者坚持两个原则:架构不动、感知显式。BEV 感知头承担双重角色:一方面作为诊断仪器,测量'共享表征里到底有多少 3D 信息可以直接读出'(head-only 训练就是探针实验);另一方面其感知损失经 VLM 输出特征 $F^m$ 反传,为视觉编码器提供文本之外的第二条梯度通路,把预训练特征'掰'向几何感知。训练配方把'领域适配'与'能力保持'显式解耦:感知头用 20 倍于 VLM 的学习率快速适应,混合约三成通用数据防遗忘;规划侧用统一的 50 路点表示合并四个异构数据源联合训练;RL 阶段针对确定性 flow 采样无法求导的问题,设计了仅在末端低频子空间注入噪声的随机化方案。这种'加法式'扩展使驾驶能力成为可插拔的层,而非对基座的替换。
核心方法
先说直觉:把一个已经'会看图、会聊天'的 4B VLM 当作共享大脑,在外面挂两个小脑袋——一个把大脑中隐含的 3D 空间信息显式画出来(BEV 感知头),一个把大脑的理解转成未来 5 秒的自车轨迹(规划专家)。技术上,基座是原生多模态的 Qwen3.5-4B:视觉编码器把每张图变成视觉 token,VLM 与文本 prompt 一起自回归生成回答(损失 $\mathcal{L}_{ntp}=-\sum_t \log p(y_t|x,y_{<t})$)。输入用视图标签($\langle$FRONT VIEW$\rangle$ 等八个方向)和帧标签 frame: k 标注来源,QA 用帧优先序列、规划用视图优先序列以暴露时序变化。BEV 感知头读两路特征:视觉编码器特征 $F_v$(低层外观)与过完 VLM 的图像 token 特征 $F_m$(高层语义);深度网络(残差块+空洞空间金字塔,无深度监督)预测逐像素深度分布 $D_i$,按 $V(p)=\sum_{i\in\Omega(p)} D_i(u_i,v_i,d_i)F_v^i(u_i,v_i)$ 把特征沿相机光线分布进 3D 体素;再用查询式 BEV transformer 把 $F_m$ 展开的多尺度特征聚合到 BEV 平面 $B$,三个分支分别解码检测框、体素语义与栅格地图,联合损失 $\mathcal{L}_{perc}=\mathcal{L}_{det}+\mathcal{L}_{occ}+\mathcal{L}_{map}$。规划专家是 32 层 diffusion transformer(约 1.1B 参数,隐藏维 1024),缓存 VLM 全部 8 层分组查询 softmax 注意力的 RoPE 后 K/V,每层缓存条件连续 4 层专家层;自适应层归一化注入 flow time、导航指令与自车状态;以 flow matching 生成 $\tau=\{(x_k,y_k,\theta_k)\}_{k=1}^{50}$(5 秒、10 Hz)。
核心创新有三点。第一,'探针式'显式感知:与所有'纯 VQA 适配'方法的本质区别在于引入显式 3D 损失——head-only 已收敛配置下 nuScenes 仅 35.60 mAP,证明通用 VLM 特征不直接暴露 3D 结构;允许感知损失更新视觉编码器与 VLM 后(Stage 2),mAP 提升 10.46 至 43.95,而通用 VQA 掉分不足 1 点,说明显式几何监督可以在几乎不损伤通用性的前提下改造共享表征,这是文本监督做不到的。第二,规划专家的端点参数化 flow matching:不预测速度场或噪声,而是直接预测干净轨迹 $\hat{\tau}_1$,再诱导速度 $(\hat{\tau}_1-\tau_t)/(1-t)$,对四个异构数据源的传感器噪声更鲁棒;配合 $\tilde{t}\sim\mathrm{Beta}(1.5,1.0)$ 且 $t=\min\{\tilde{t},0.9\}$ 保证转换良定。第三,RL 阶段把确定性 Euler flow 变成可优化策略:仅在最后 3 步 $W=\{7,8,9\}$ 注入 $\sigma=0.03$ 的低频余弦子空间扰动($M=6$ 阶正交模态,单点扰动约 1.7 m 纵向、0.26 m 横向),用高斯条件导出的近似恢复 score 稳定扰动状态,组内 8 个 rollout 共享初始噪声、以组相对优势做折扣 $\gamma=0.6$ 的策略梯度,只更新随机步。这三个设计共同支撑了'不改架构、显式感知、能力保持'的论文主张。
方法步骤详情
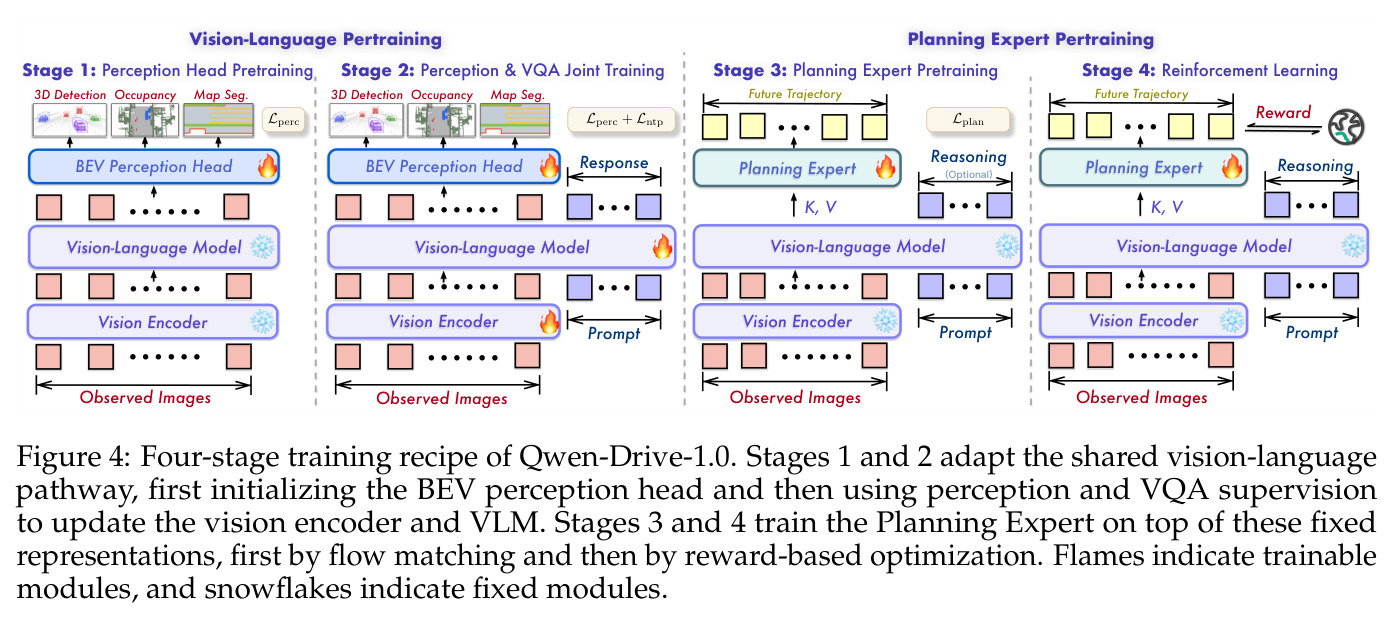
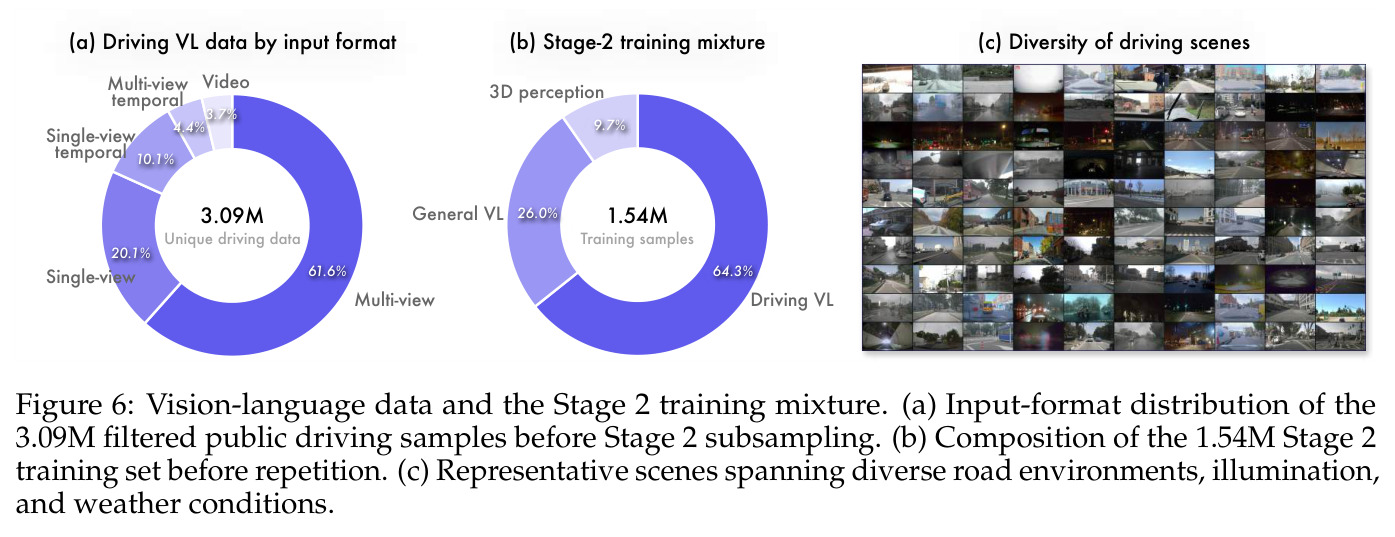
训练分四阶段(原文 Figure 4)。Stage 1 感知头预训练:冻结视觉编码器与 VLM,仅用 $\mathcal{L}_{perc}$ 训新初始化的 BEV 头,让视图变换、BEV transformer 与任务解码器先学会构建自车系表征。Stage 2 感知与 VQA 联合训练:BEV 头、视觉编码器、VLM 一起优化,感知样本用 $\mathcal{L}_{perc}$、视觉语言样本用 $\mathcal{L}_{ntp}$;感知头学习率为 VLM 的 20 倍;混合数据重复前为 1.54M 样本(9.7% 感知、26.0% 通用 VL、64.3% 驾驶 VL),重复后有效比例 12.7%/31.0%/56.3%。Stage 3 规划专家预训练:冻结视觉通路,仅训规划专家;输入为前/前左/前右三视图共 4 个时刻(历史帧 320p、当前帧 720p)、历史轨迹 $\tau_{hist}$、导航指令 $n$、自车状态 $e$,24.2% 样本附 CoC 规划推理文本 $r$ 作条件;损失 $\mathcal{L}_{plan}=\mathcal{L}_{fm}+2\times10^{-4}\mathcal{L}_{\Delta1}+2\times10^{-5}\mathcal{L}_{\Delta2}$(时序差分 Huber 正则抑制路点抖动),训 2.83M 样本得到 Qwen-Drive-1.0-SFT。Stage 4 强化学习:冻结 VLM 仅训规划专家,奖励取 NAVSIM 的 PDMS 与 WOD-E2E 的 RFS 并各加共享 ADE 项,训练集为 15K NAVSIM 场景 + 15K PAI-AV 场景 + 479 个带评分者偏好标注的 WOD-E2E 场景,得到 Qwen-Drive-1.0-RL。数据侧配套三步统一:感知标签对齐到 7 检测类/10 占据类/6 地图类并用辅助标注离线补全(如用 nuPlan 矢量地图补 driveable、用 3D 框补 generic_object);24 个公开 VQA 数据集先由 Qwen3.5-Plus 改写成统一对话格式、再由 Qwen3.5-Flash 做一致性过滤(5.53M→3.09M,保留率 55.9%);轨迹统一为自车系 50 路点($x,y,\theta$ 分别除以 165 m、25 m、$\pi/2$ rad)。推理时规划专家从高斯噪声出发,10 步 Euler 积分得到最终轨迹。
技术新颖性
技术新颖性可从四个层面评估。架构层面:这是作者所称首个在不改动预训练 VLM 结构的前提下统一 3D 感知、驾驶 VQA 与运动规划的工作——对比需从头协同训练的 UniAD 类管线、以及牺牲通用接口的 Cosmos-Reason/Alpamayo 类专用模型,外挂式设计让基座可随 Qwen 迭代整体升级。感知层面:BEV 头借用成熟的深度提升与查询式 BEV transformer,但新颖之处在于双流特征($F_v$ 提供几何、$F_m$ 提供语义)的融合,以及同一套头跨 6 相机 nuScenes 与 8 相机 OpenScene 训练评测(不使用 rig 专属相机嵌入);空间统一用特征级可微 trilinear 重采样适配两套占据网格(±40 m/0.4 m 体素与 ±50 m/0.5 m 体素),避免重采样类别标签造成监督失真。规划层面:端点参数化、时序差分正则与跨数据集统一路点表示是务实的组合创新。RL 层面:把 GRPO 式组相对优化嫁接到确定性 flow 生成器上——末端随机步、低频子空间限制、近似 score 修正三件套,在保护预训练 flow 的同时获得有效探索,这套技巧对其它扩散/流模型策略的 RL 训练有普遍参考价值。诚实地说,单项组件均有先例(BEVFormer 系、FlashOcc、flow matching、GRPO),系统集成本身是主要贡献。
实验结果
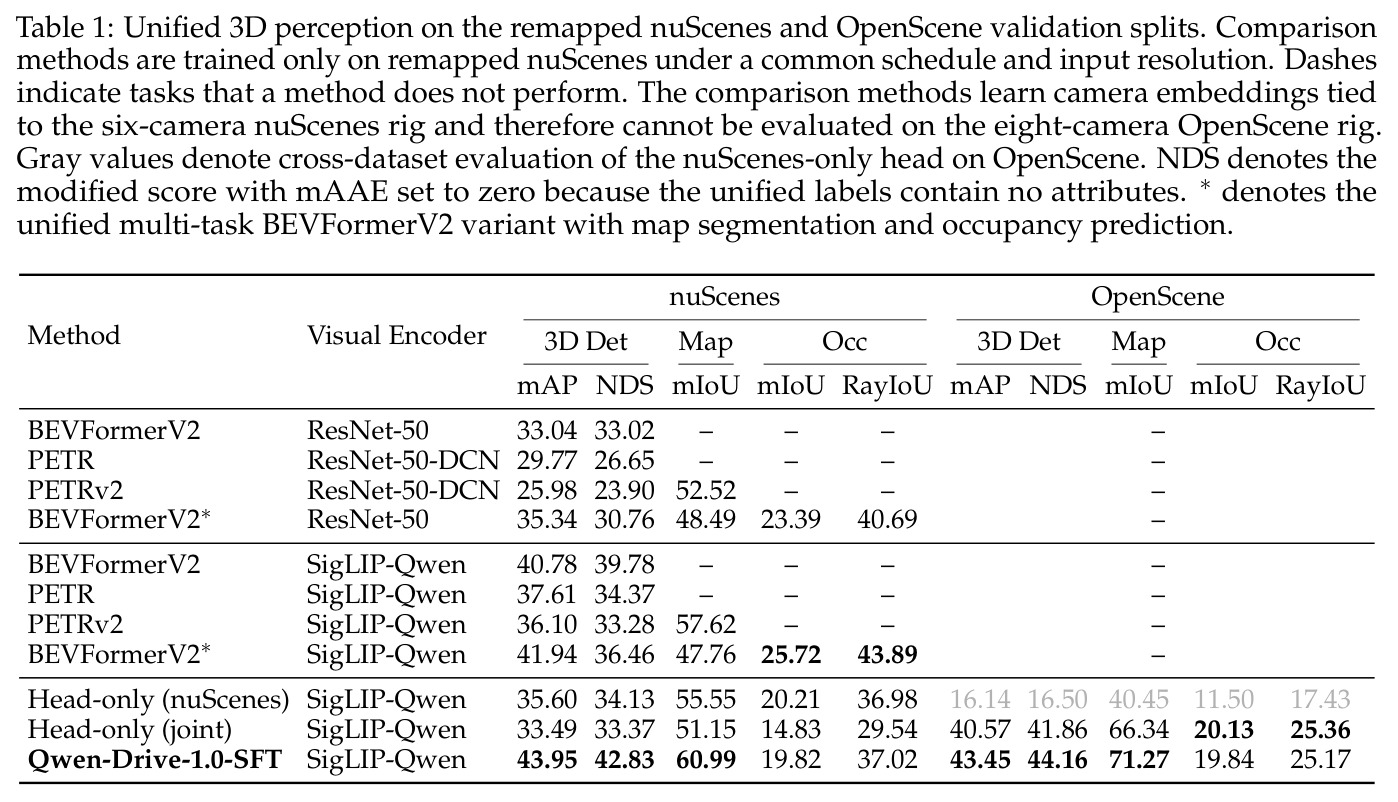
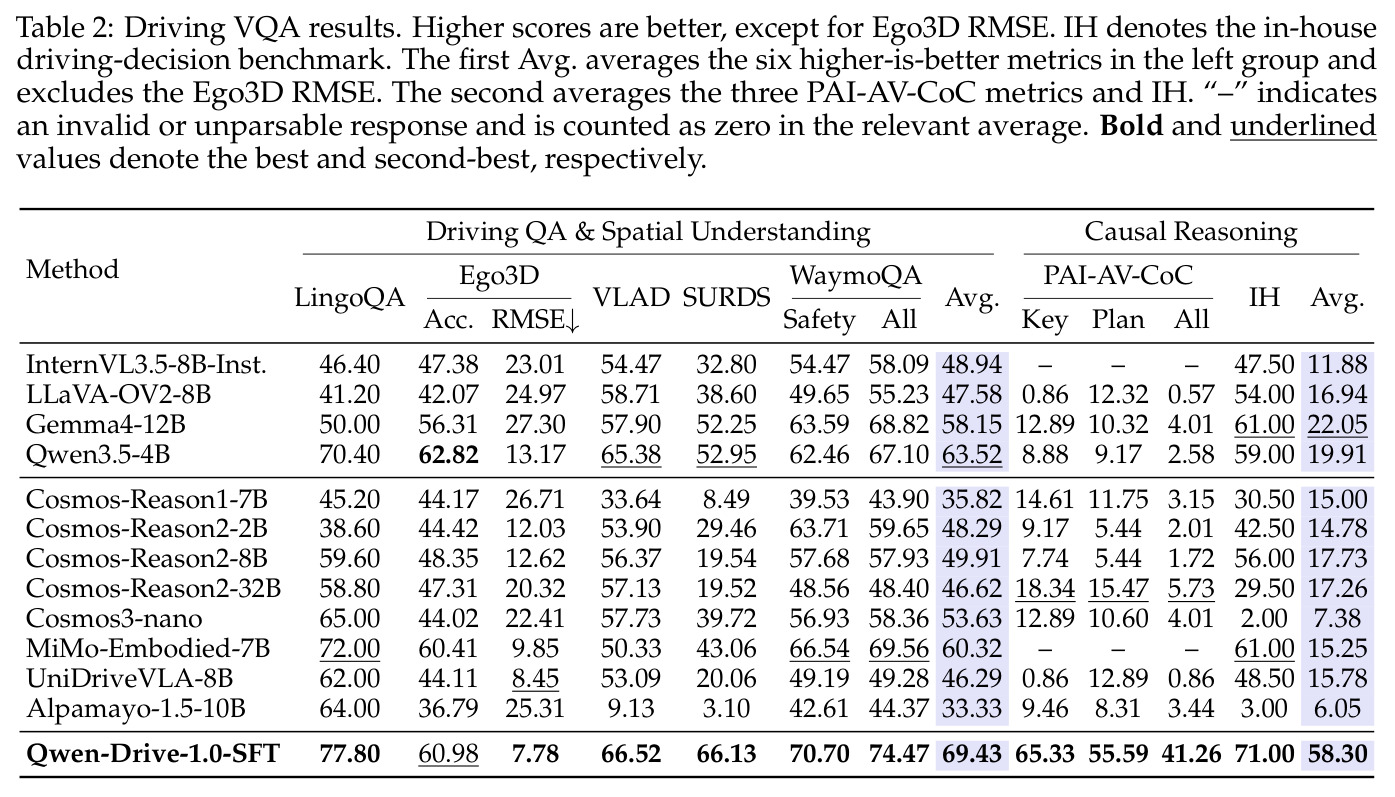
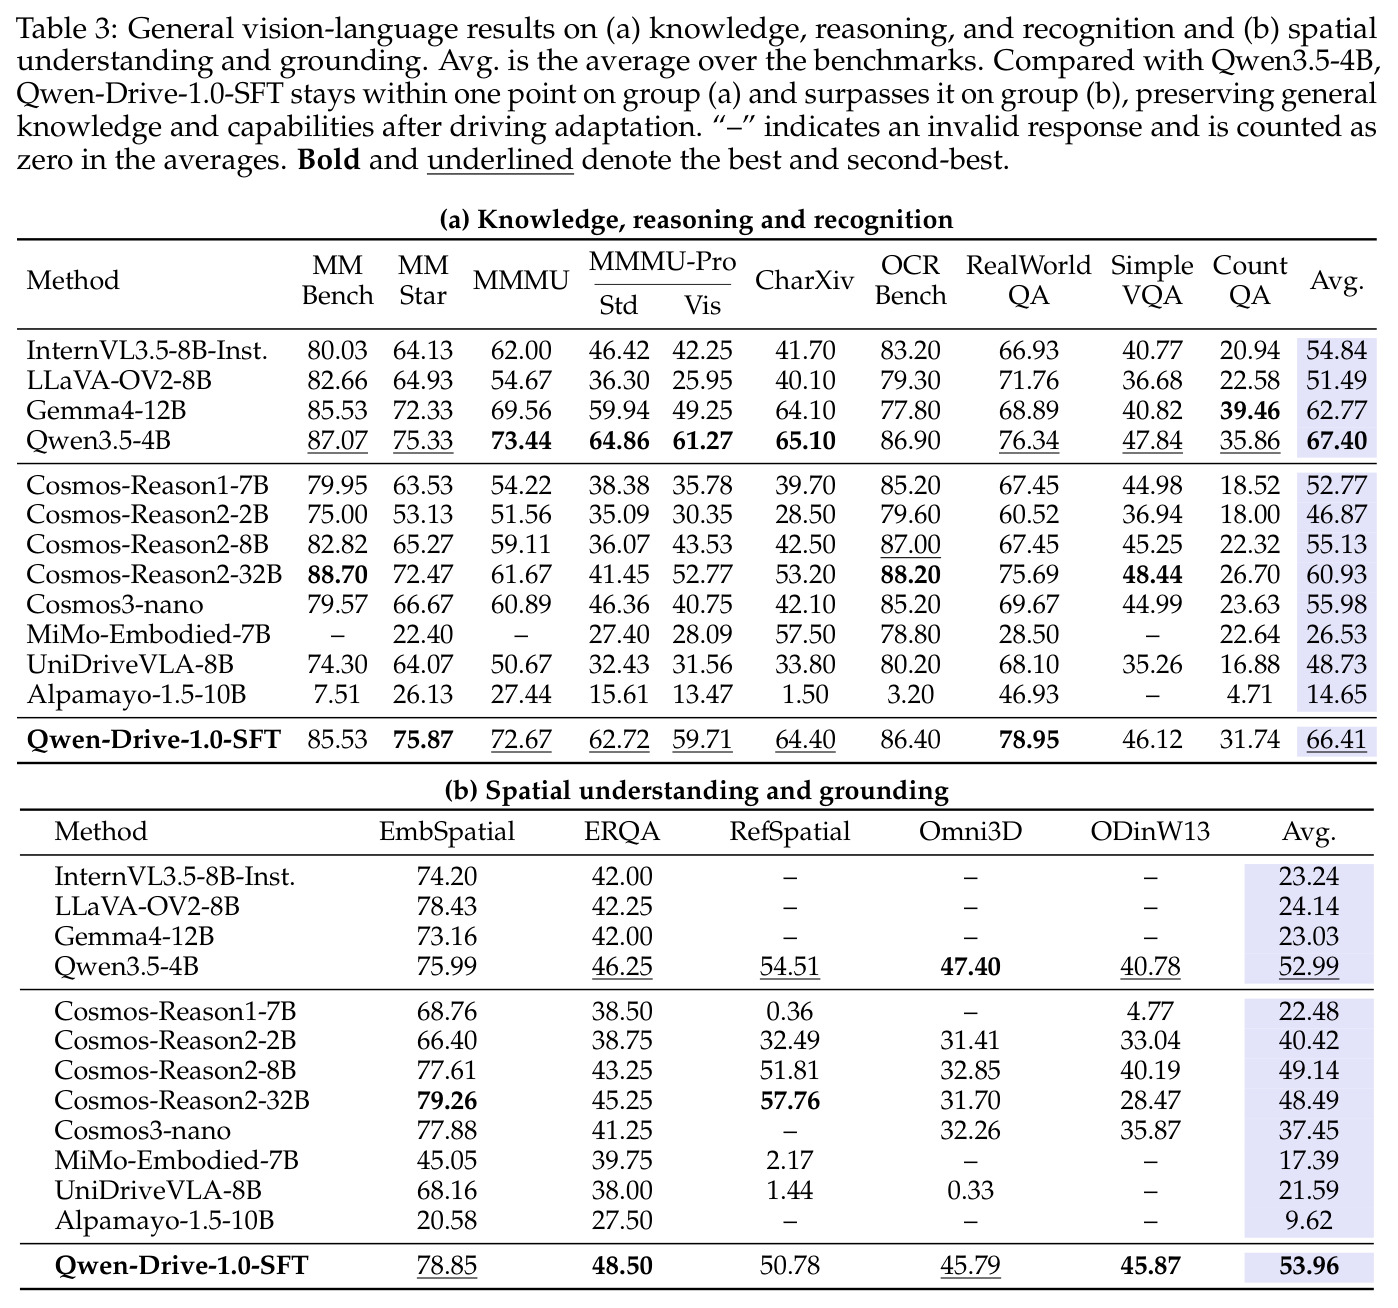
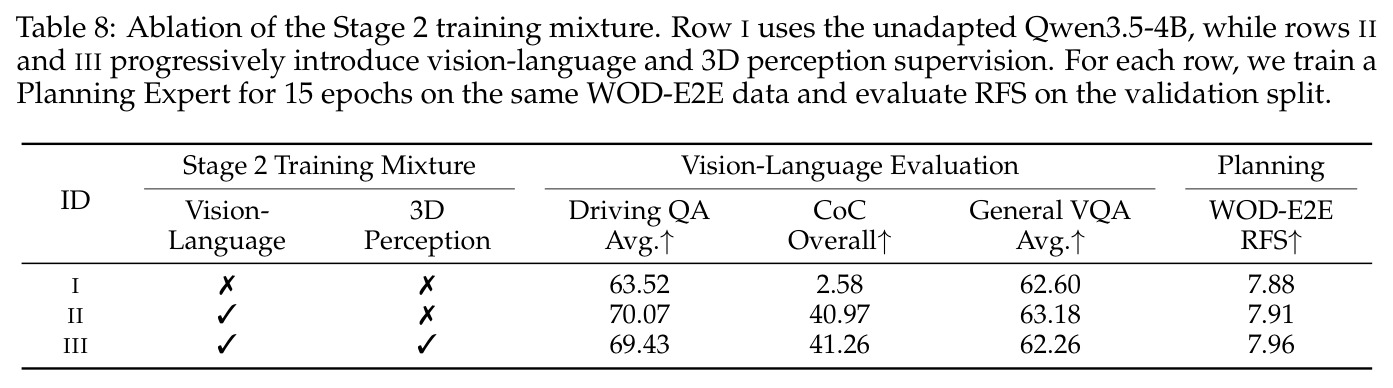
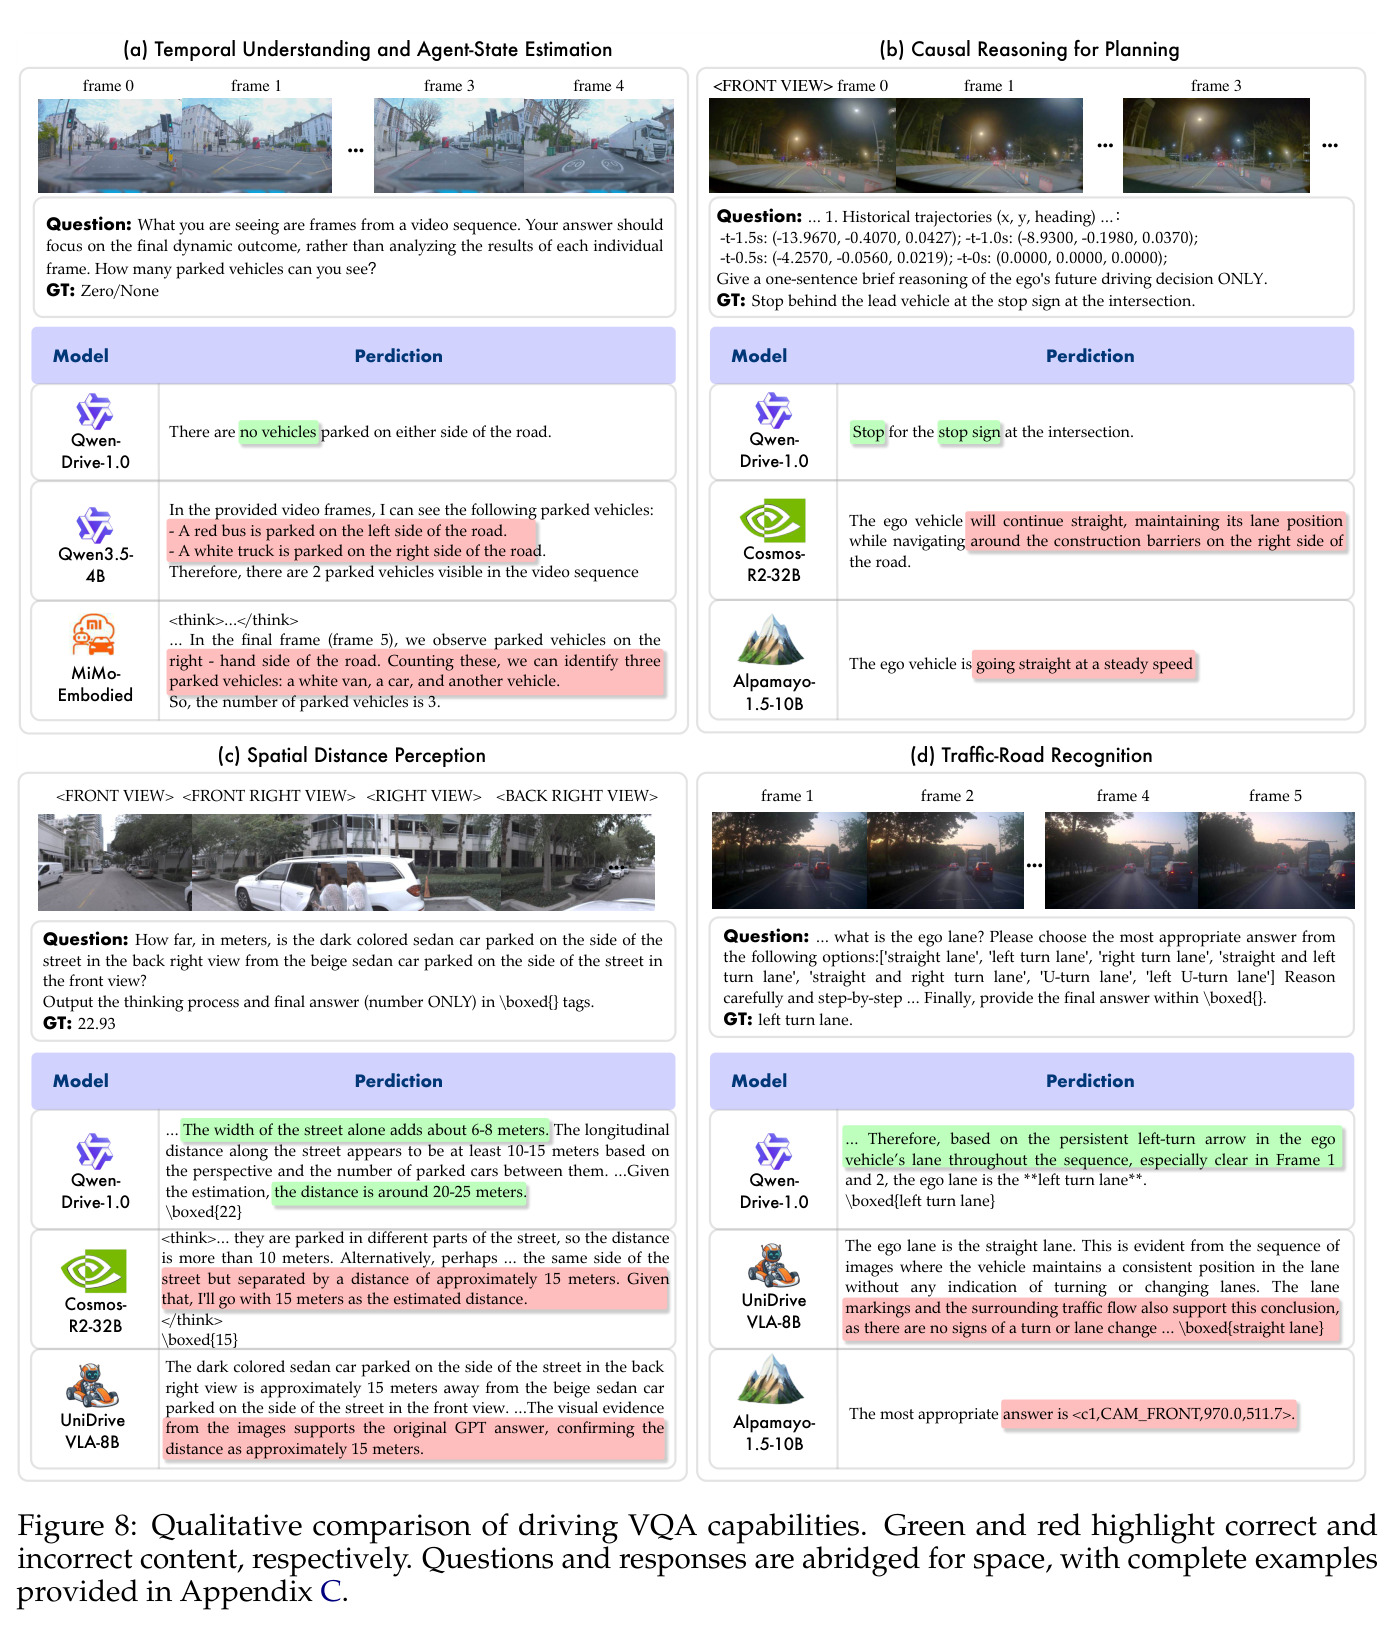
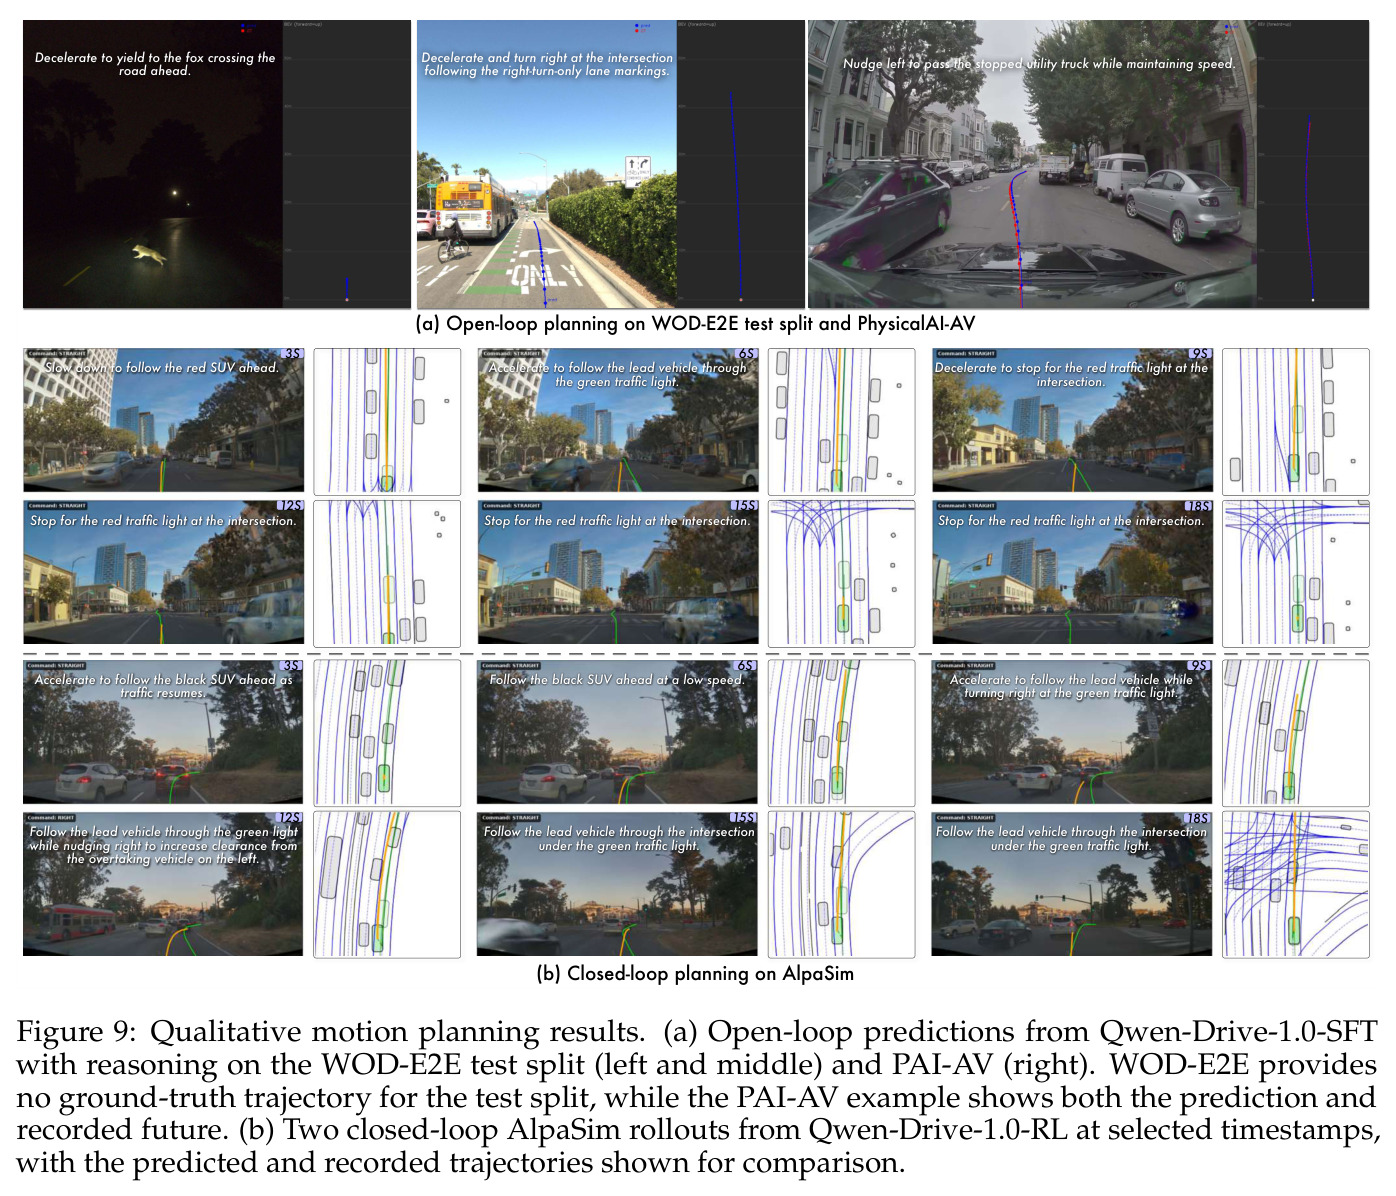
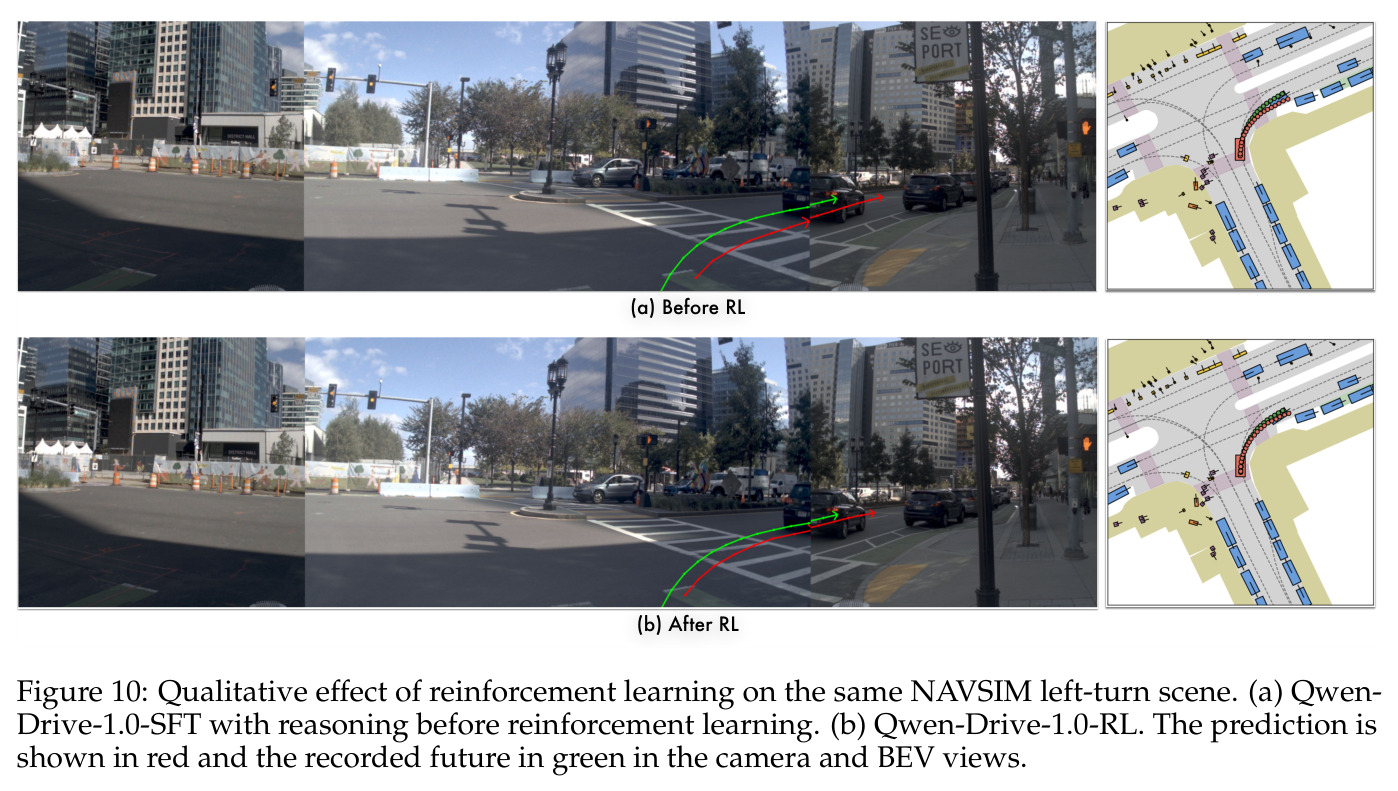
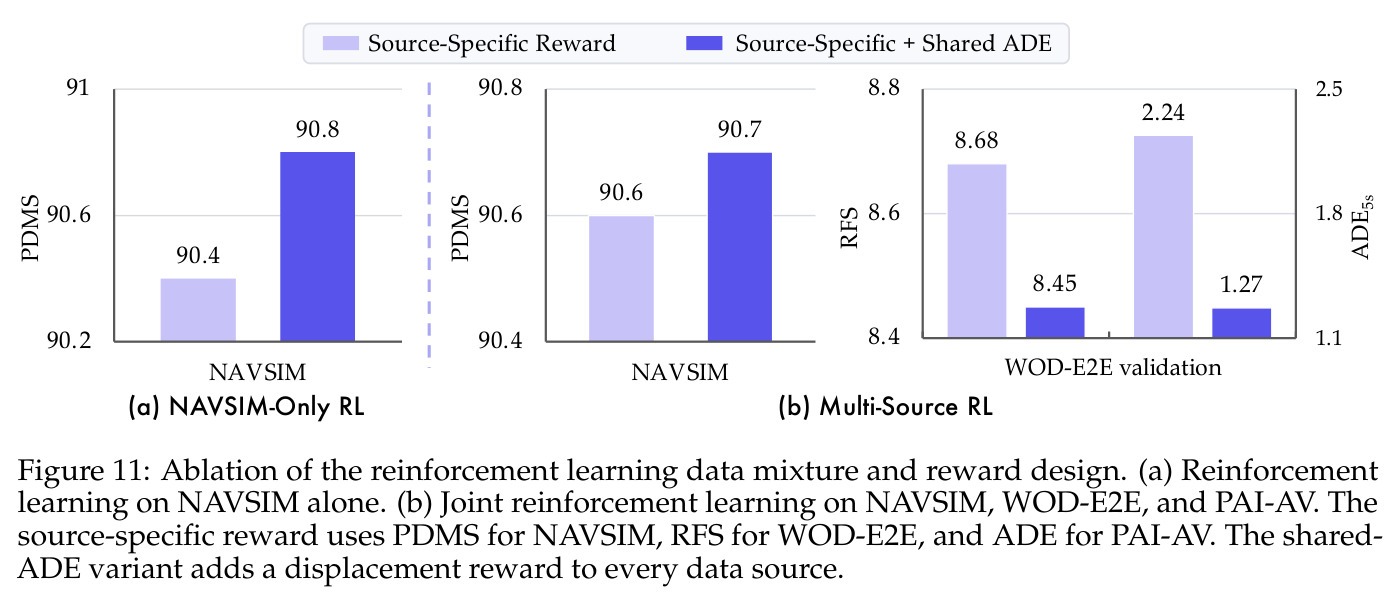
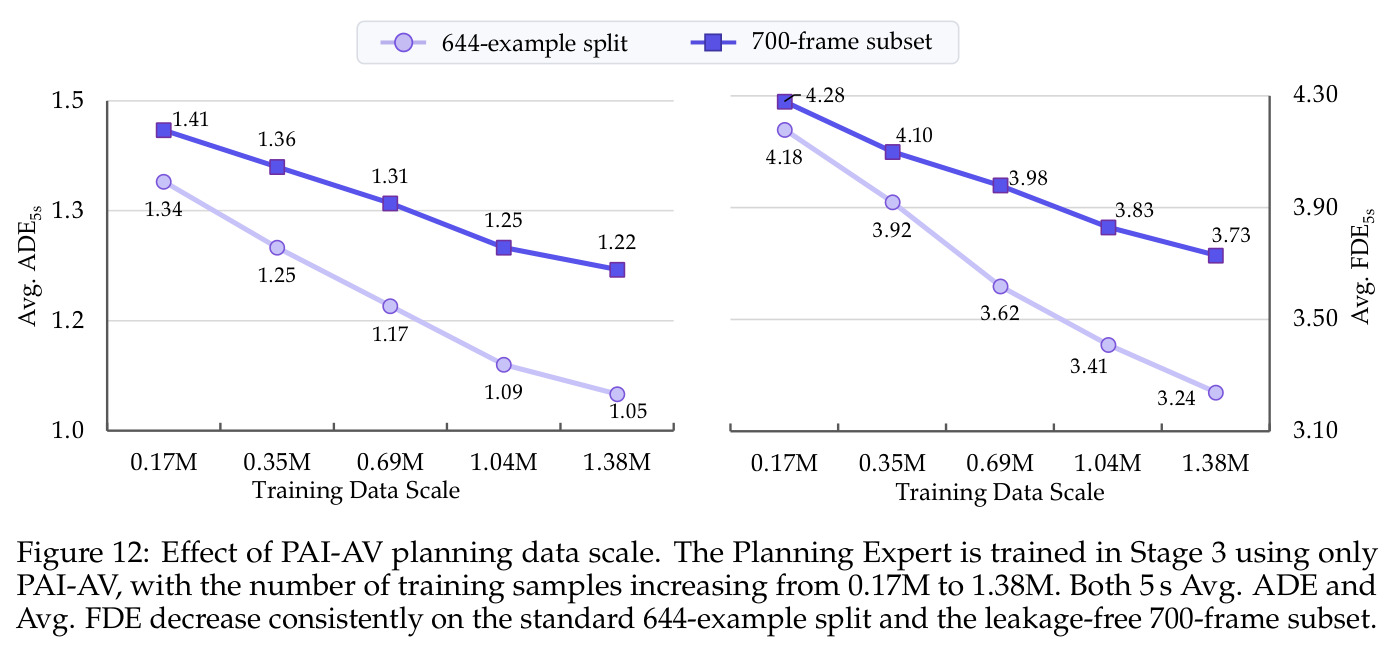
逐一过实验。3D 感知(Table 1):nuScenes 上 43.95 mAP / 42.83 NDS / 60.99 地图 mIoU,超过 SigLIP-Qwen 版 BEVFormerV2* 2.01 mAP、超过 BEVFormerV2 3.05 NDS、超过 PETRv2 3.37 地图 mIoU;OpenScene 上 43.45 mAP / 71.27 地图 mIoU 同样领先;但占据预测不领先(nuScenes 19.82 mIoU),归因于机器生成的 OpenScene 体素标签伪影。关键发现:head-only 收敛后仅 35.60 mAP,Stage 2 联合适配提升 10.46 mAP 与 9.84 地图 mIoU,证明 3D 能力来自定向适配而非免费午餐。驾驶 VQA(Table 2):六项平均 69.43,比基座 Qwen3.5-4B 的 63.52 高 5.91;SURDS +13.18(相对提升 24.9%)、LingoQA +7.40、Ego3D 距离 RMSE 降 40.9% 至 7.78;最突出的是因果推理:PAI-AV-CoC 平均 58.30 是次优 Gemma4-12B(22.05)的 2.6 倍,overall 41.26 超过 Cosmos-Reason2-32B(5.73)七倍,自建中文驾驶决策基准 71.00(训练集无同类数据,说明泛化)。通用能力(Table 3):知识/推理组平均 66.41 vs 基座 67.40(掉不到 1 分),空间/定位组 53.96 反超基座的 52.99。运动规划:WOD-E2E 测试集 RFS 7.76→7.78(加推理条件)→7.91(RL),超过 RL 后的 MindVLA-U1 7.87;PAI-AV 无泄漏子集 3s 平均 ADE 0.42 m(Alpamayo-1.5 为 0.36 m),但 minADE 0.39 vs 0.17 暴露多样性短板;NAVSIM PDMS 从 SFT 88.2(已超 DiffusionDrive 88.1)升至 RL 90.7,best-of-6 达 91.4;闭环 AlpaSim 上 RL 把 off-road 率从 24.0% 减半到 12.0%(低于两个 Alpamayo 版本)、at-fault score 从 0.27 升至 0.37,代价是进度 54.0%→48.0%。消融:Table 8 显示加 3D 监督后三项 VL 聚合指标变化均小于 1 分且 RFS 略升(7.91→7.96);Fig. 11 显示共享 ADE 奖励把 WOD-E2E 验证集 5s ADE 从 2.24 m 压到 1.27 m;Fig. 12 显示 PAI-AV 数据从 0.17M 扩到 1.38M 时 5s 平均 ADE 从 1.34 m 单调降到 1.05 m 且未饱和。
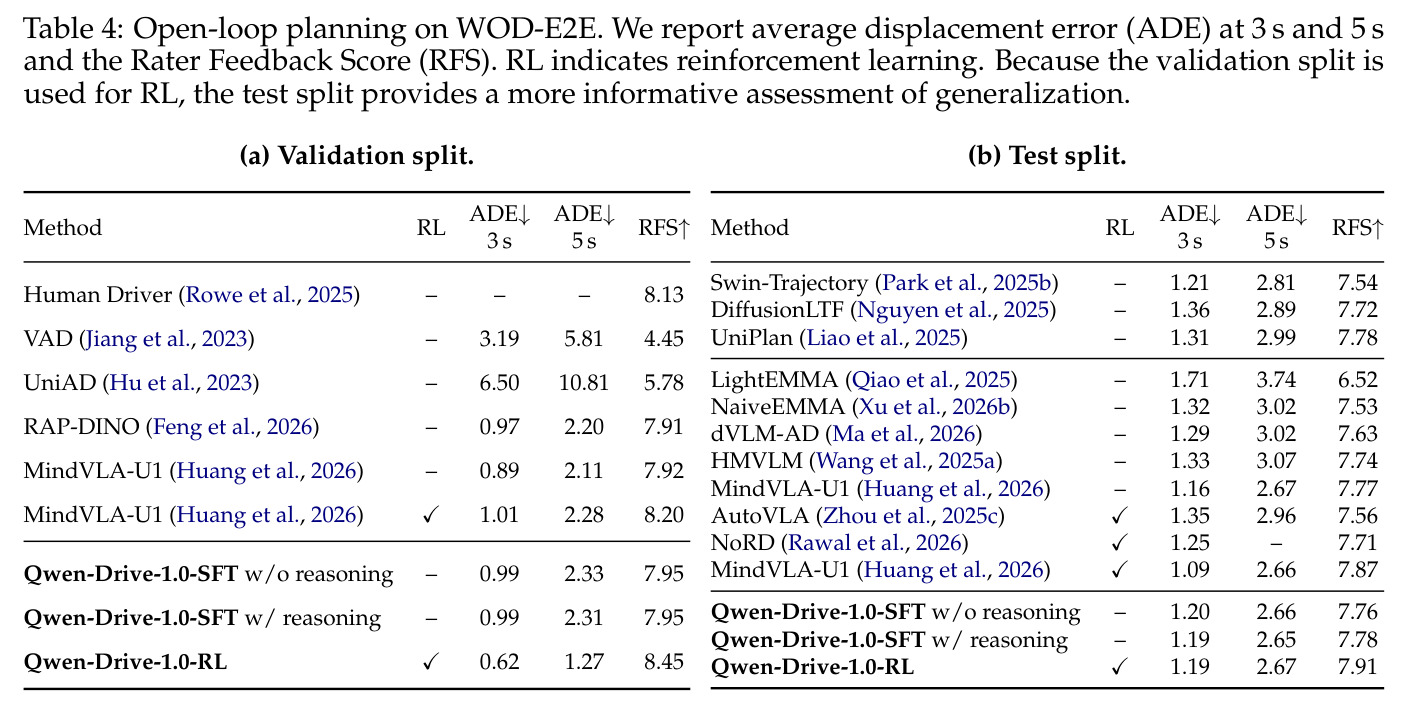
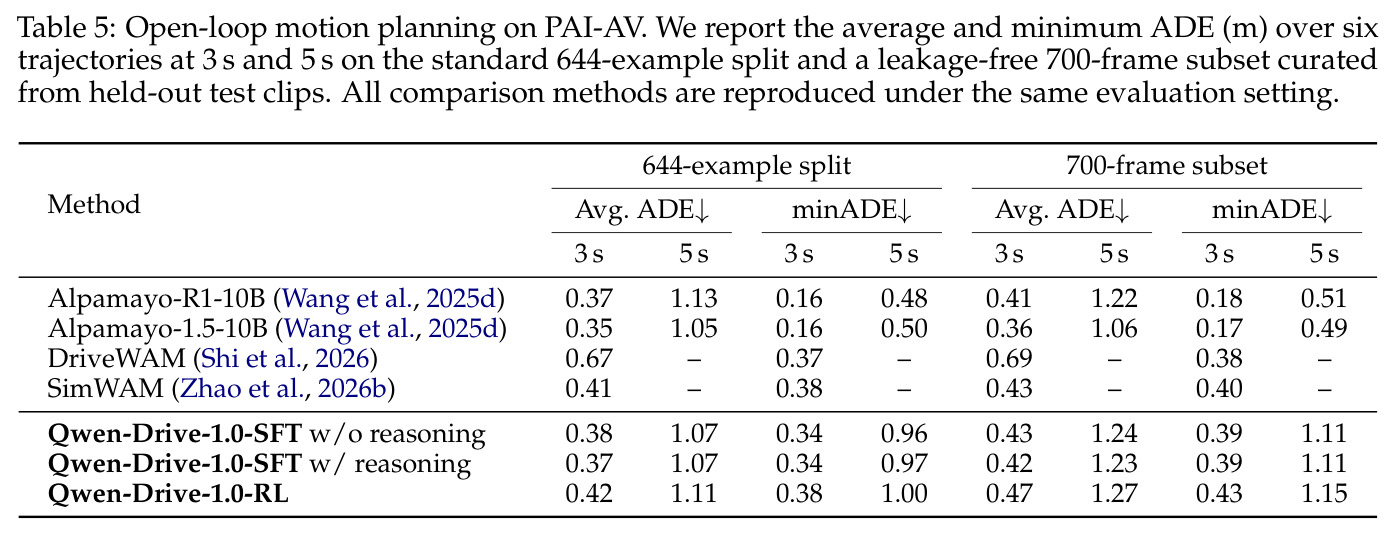
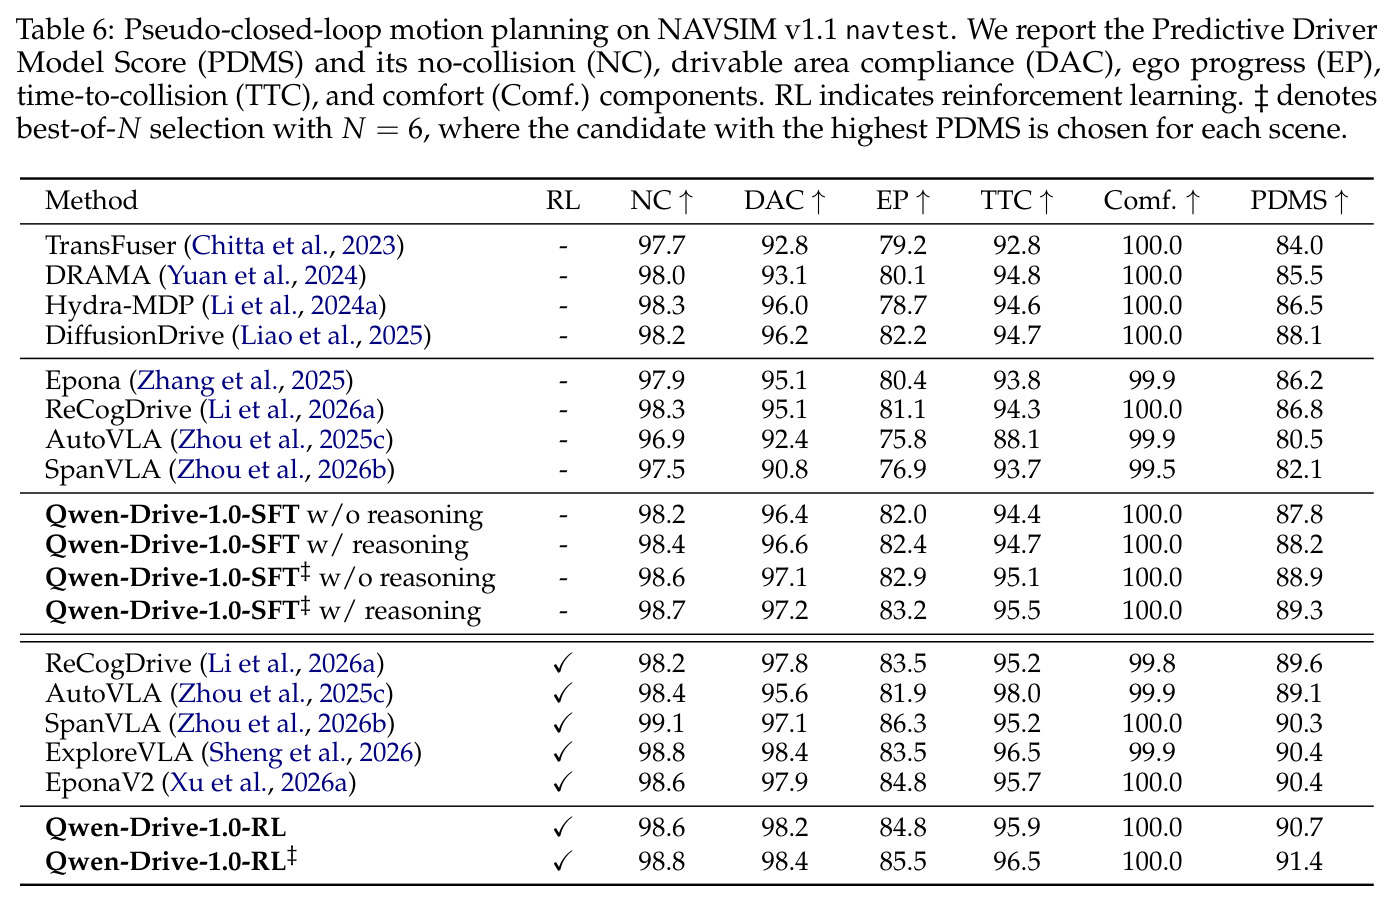
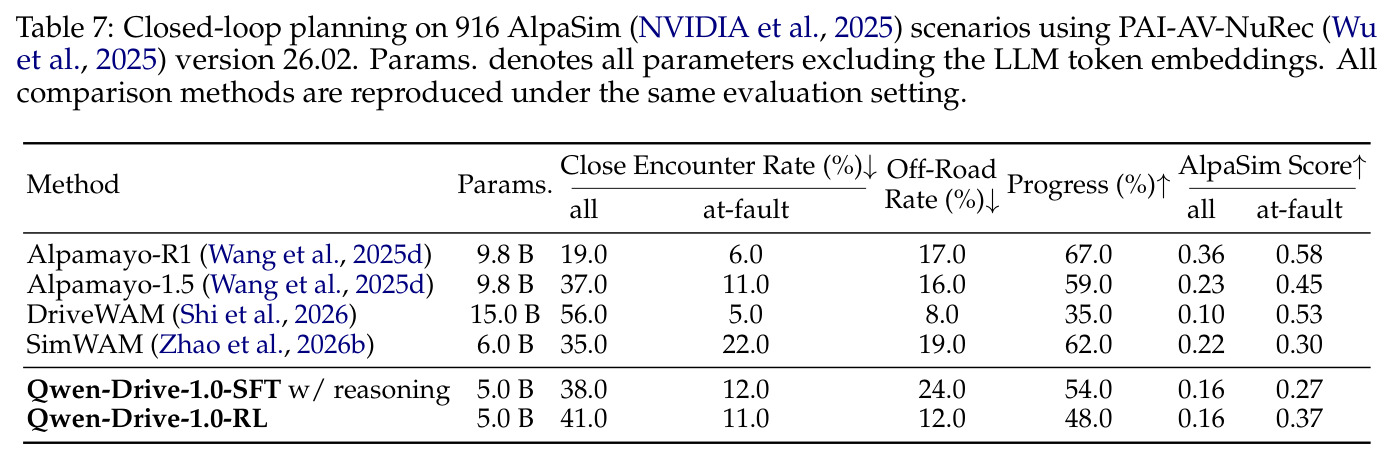
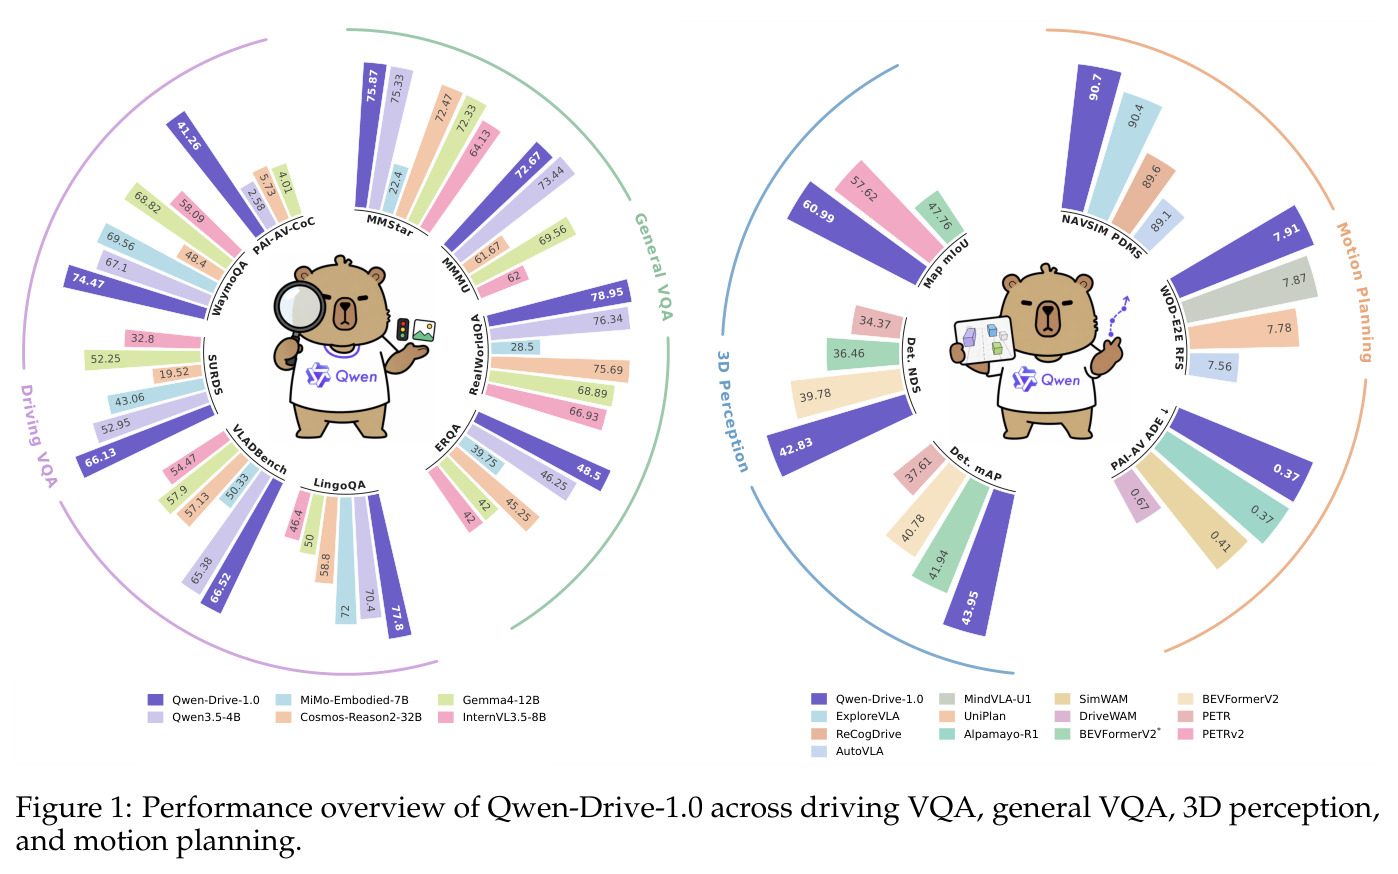
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| nuScenes 3D 目标检测(单帧环视) | mAP | 43.95 | BEVFormerV2*(SigLIP-Qwen)41.94 | +2.01 |
| nuScenes BEV 地图分割 | mIoU | 60.99 | PETRv2(SigLIP-Qwen)57.62 | +3.37 |
| OpenScene 3D 检测 / 地图分割 | mAP / mIoU | 43.45 / 71.27 | Head-only(joint)40.57 / 66.34 | +2.88 / +4.93 |
| 驾驶 VQA 六项平均 | Avg(越高越好) | 69.43 | 基座 Qwen3.5-4B 63.52 | +5.91 |
| PAI-AV-CoC 因果推理 | Overall 准确率 | 41.26 | 次优 Gemma4-12B 4.01 / 基座 2.58 | +38.68(vs 基座) |
| WOD-E2E 测试集开环规划 | RFS | 7.91(RL) | MindVLA-U1(RL)7.87 | +0.04 |
| NAVSIM v1.1 navtest 伪闭环 | PDMS | 90.7(RL) | ExploreVLA / EponaV2 90.4 | +0.3;best-of-6 达 91.4 |
| AlpaSim 闭环(916 场景) | Off-road 率 / at-fault score | 12.0% / 0.37 | Alpamayo-1.5 16.0% / 0.45 | off-road -4.0pp;score 落后 0.08 |
| 通用 VQA(知识/推理组) | 10 项平均 | 66.41 | 基座 Qwen3.5-4B 67.40 | -0.99(保持);空间组 53.96 反超 52.99 |
局限与改进
作者承认的局限:其一,规划推理并不总能抓住因果结构——驾驶决策混有不同时间尺度的原因(20 米外的红灯要求提前缓减、5 米内窜出的儿童要求立即制动),多因共存时模型难以稳定识别主导原因及其时间范围,即使趋势正确,未来 1-2 秒内执行的动作也可能不反映所述即时原因;其二,生成的轨迹并不总服从文本理由,部分推理增益可能来自自生成 trace 注入的模型内部信息而非真正因果对齐;其三,三个任务使用不同的输入格式、时序上下文与分辨率,限制跨任务表征迁移;其四,跨 rig 迁移(Fig. 13)无统一真值,只能定性展示。我的补充观察:占据预测明显弱于检测与地图(nuScenes 19.82 mIoU,且 Stage 2 对 OpenScene 占据指标改变不足 0.3 点),说明体素级标签噪声未被真正解决;WOD-E2E 验证集 RL 后 RFS 8.45 超人类 8.13 属于 in-sample 优化——评分标注本身就是奖励来源,作者也坦承这只说明偏好对齐有效而非超越人类;PAI-AV 六候选 minADE 0.39 远差于 Alpamayo-1.5 的 0.17,候选集中在相似运动;闭环进度从 54.0% 降到 48.0% 显示 RL 奖励组合诱导保守驾驶;此外 1.5 秒/4 帧的稀疏视觉历史在 AlpaSim 高频重规划下响应偏慢(at-fault score 0.37 落后 Alpamayo-1.5 的 0.45,作者归因于对方有 0.4 秒密集历史)。
独立分析的弱点
独立分析四个弱点。第一,推理-轨迹一致性缺乏显式监督:CoC 文本只是条件输入,没有任何损失强制轨迹服从所述理由,安全攸关场景下模型可能'说一套开一套',削弱可解释性的可信度——改进方向是引入理由-轨迹一致性损失,或用 VLM 判定轨迹是否与原因相符并把一致性加入 RL 奖励。第二,占据标签源头质量问题:OpenScene 占据由聚合 LiDAR 自动重建、无逐点语义,浮空体素伪影依然存在(Fig. 7(b) 可见预测反而抑制了部分伪影),既压制占据指标又可能污染共享表征——可用置信度加权损失、多帧时序一致性清洗或学习伪影判别器过滤。第三,轨迹候选多样性不足:PAI-AV 上平均 ADE 与 minADE 几乎重合(0.42 vs 0.39 m),说明六条候选集中在相似运动,在高不确定场景(避让、汇流、借道)缺少真正不同的备选——可在 flow 采样时按机动类型显式条件化,或在 RL 中加入多样性奖励。第四,闭环保守化与稀疏时序:RL 后进度从 54.0% 降至 48.0%,且 0.5 秒间隔的 4 帧历史在 AlpaSim 高频重规划下响应偏慢——可重新平衡奖励中的进度权重、加密近期帧采样或引入时序 token 压缩,在同等预算下容纳更密的历史。此外,三任务输入格式不统一(分辨率、视角数、时序长度均不同)也可能白白损失了跨任务协同收益。
未来方向
作者提出的方向:多时间尺度因果建模——让模型区分 20 米红灯这类渐变原因与 5 米行人这类即时原因,并把行为的时间范围与原因匹配;理由与轨迹之间的显式一致性监督;统一三个任务的输入配置,让感知、推理与规划能相互强化而非各训各的。基于成果可自然延伸:其一,推理时 best-of-N 已展示 0.7 PDMS 余量(90.7→91.4),可训练轻量打分器或用模型自评实现无真值候选选择,把这部分余量变成默认收益;其二,把 RL 框架(末端随机步+组相对优势)接到世界模型或闭环仿真奖励上,缓解 NAVSIM 类伪闭环对评分函数的过拟合风险;其三,跨 rig 适配:Fig. 13 显示感知通路对未见相机配置定性可用,用目标平台少量标注做参数高效微调是低成本上车路径;其四,座舱-驾驶一体化是架构动机,后续可发布对话/座舱基准验证单模型双域服务的实际效果;其五,占据任务的短板若由更干净的 4D 一致性真值补齐,显式 3D 监督的收益可能进一步放大;其六,数据规模曲线未饱和(Fig. 12),继续扩大统一轨迹数据(更多城市与长尾场景)是确定性收益方向。
复现评估
复现条件较好但工程量大。开源情况:模型权重在 HuggingFace 与 ModelScope 公开(Qwen/Qwen-Drive-1.0-4B),有 GitHub 仓库(QwenLM/Qwen-Drive-1.0),基座 Qwen3.5-4B 开源。数据方面:感知用 nuScenes(官方划分,28K 训练关键帧+6K 验证)与 OpenScene(自划 16 log 验证集,607K 训练帧),规划用 NAVSIM、OpenScene、WOD-E2E、PAI-AV 共约 2.83M 样本,均为公开数据;但 30K 中文感知 QA 为内部数据不可获得,且数据管线依赖 API 模型——Qwen3.5-Plus 改写 VQA、Qwen3.5-Flash 做一致性过滤、Qwen3.7-Plus 生成 CoC 推理——第三方复现需要替代模型或接受管线差异。算力方面:四阶段训练含 1.54M 联合样本、2.83M 规划样本与三源 RL,需要多机多卡集群(论文未给出 GPU 时数),规划专家本身 1.1B 参数、推理仅 10 步 Euler,部署侧压力可控。评测侧论文在统一协议(top-k=1、top-p=0.001、temperature 0.01)下复现了所有对比方法,包括 Table 5/7 的专有模型对比,公平性较好。综合判断:只做推理与评测很容易;完整复现训练主结果需要大规模算力与 API 预算,难度中高;逐字复现数据管线最难。
论文图表
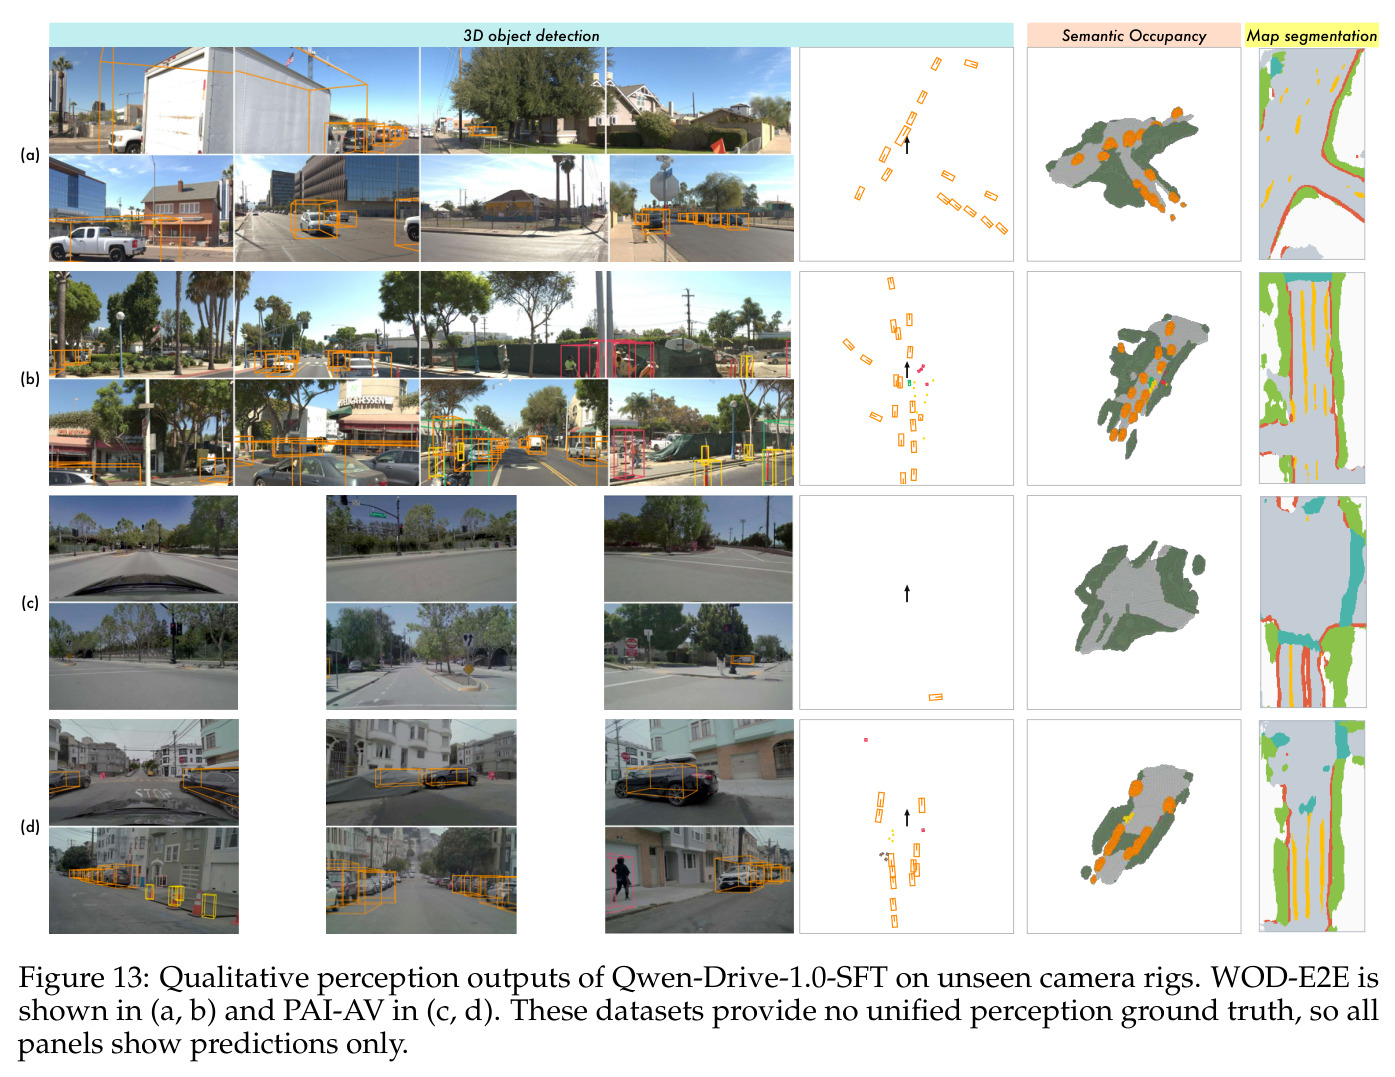
在训练中从未见过的 WOD-E2E 八相机环视 rig 与 PAI-AV 六相机 rig 上直接推理(仅做畸变校正):3D 检测框投影、语义占据与地图分割输出定性连贯,路面、可行驶区域、车道线与路缘均合理。因无统一真值,仅展示预测。
展示感知通路对未见相机配置的零样本迁移潜力,同时暴露无法定量评估的局限,适合作为局限与未来工作的素材。