RLHND:面向机器人学习的视频基础模型物理接地手部跟踪器 RLHND: Video Foundation Models as Physically Grounded Hand Trackers for Robot Learning
改造 Cosmos 3 视频基础模型为手部跟踪器,从单目视频联合估计解剖合理的手部姿态与接触力
前置知识
MANO 手部参数模型
MANO 是学界标准的三维手部网格生成模型:用 10 维形状参数 $\beta$(PCA 系数)和 45 维关节旋转 $\theta$(15 个关节各 3 个旋转自由度)控制一个含 778 个顶点、16 根骨骼的模板手,通过线性混合蒙皮把关节旋转传播成稠密网格。大量手部数据集(ARCTIC、DexYCB、HO3D 等)的标注就是 MANO 参数加关键点。
本文的输出空间(形状/关节角/相机系平移)、形状缓存 $\beta$、29 自由度解剖约束、LBS 特征扩散和逐顶点触觉全部定义在 MANO 之上,不理解 MANO 就无法理解方法的输出与损失设计。
视频扩散模型与干净潜变量条件化
视频扩散模型(如 Cosmos 3 Nano)在预训练中学会对带噪潜变量去噪,内部编码了手部运动与人手-物体交互的强先验。常见复用方式是把干净视频从去噪接口喂入(强行设噪声水平 $\sigma=0$,属分布外输入);干净潜变量条件化则改走预训练时专为参考帧设计的 conditioning-frame 接口,让模型充当确定性特征提取器。
这是 RLHND 编码器选型的核心论点——与预训练接口对齐才能保住先验,也是它与 ACE-Ego-Hand 等前作的本质差别;消融实验 A0 表明编码器是性能的最大来源。
LoRA 低秩适配
LoRA 冻结预训练权重,只在每层注入低秩增量 $\Delta W = BA$(秩 $r \ll d$),仅训练极少量参数即可完成下游适配。本文在 Cosmos 3 的生成通路上加 rank 64 的 LoRA,并额外重训 patch embedding,学习率区分对待(LoRA $1\times10^{-4}$,patch embedding $2\times10^{-5}$)。
理解“如何在保留视频基础模型先验的同时把手部跟踪能力注入进去”依赖 LoRA 机制;它也是该方法能以 20k 步、8 张 H100 微调 7.8B 参数模型的关键。
线性混合蒙皮(LBS)
LBS 是把骨骼级运动映射到网格顶点的标准蒙皮技术:每个顶点对每根骨骼有固定权重 $w_{v,j}$,顶点位置由各骨骼变换按权重混合得到。本文反向使用它做特征扩散:骨级 token 特征按 MANO 固定蒙皮权重 $W_{lbs}\in\mathbb{R}^{778\times16}$ 加权混合出每个顶点的特征,从而避免对 778 个顶点做昂贵注意力。
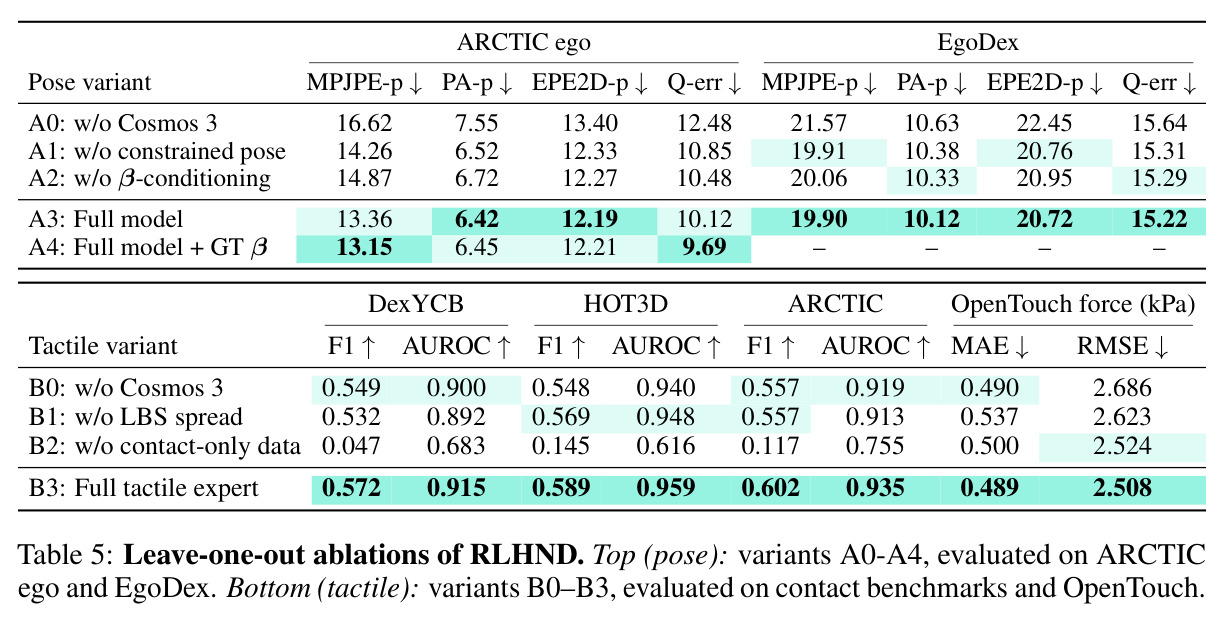
LBS 特征扩散是触觉专家流的核心效率设计,Table 5 的 B1 消融(换成可学习扩散矩阵反而更差)验证了利用固定蒙皮先验的价值。
尺度-深度模糊与 DexPilot 重定向
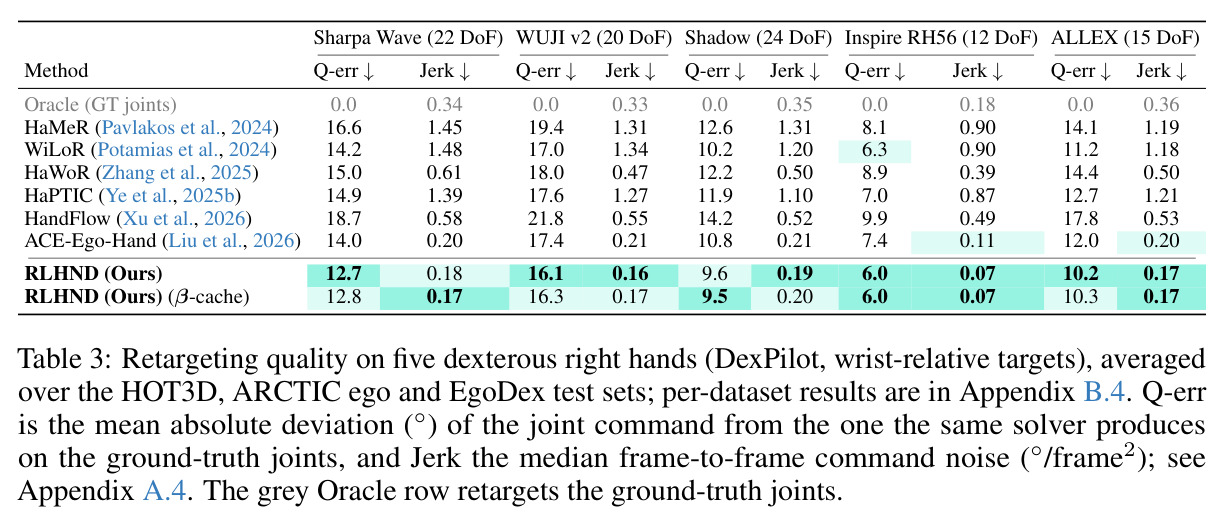
透视投影下单目相机无法同时确定物体大小与距离:同一成像既可能是“近而小的手”也可能是“远而大的手”,深度误差会被吸收进估计的形状参数,导致同一视频内手尺寸漂移(现有方法约 8mm)。DexPilot 则是把人手关节角优化映射为不同自由度灵巧手关节命令的经典遥操作重定向求解器。
前者是本文形状缓存($\beta$-cache)设计的直接动机(Figure 1 右图),后者是 Table 3/4 评估“跟踪输出对机器人是否可用”的标准工具。
研究动机
机器人数据远比视觉-语言数据稀缺且采集昂贵,而人类自我中心视频易于采集、覆盖大量难以遥操作演示的任务,正被越来越多地用于训练机器人基础模型。但把人类视频变成机器人可用的动作标签需要 3D 手部关节位置,而现有手部重建方法主要针对 2D 重投影优化,3D 预测不可靠:Figure 1 显示在 ARCTIC 测试集 850 帧片段上,HaMeR、WiLoR、HaWoR、HaPTIC 等基线的手腕深度相对真值剧烈振荡或漂移,同一只手在单一视频内估计尺寸可波动约 8mm——透视投影的尺度-深度模糊使深度误差被吸收进形状参数。这种时间不一致、物理不合理的 3D 轨迹对机器人学习是致命的,动作估计的小误差会导致显著不同甚至不可行的机器人动作。第二个缺口是物理信息缺失:新一代 VLA 模型开始融合触觉输入以区分“成功抓握”与“悬停在物体上”,但人类视频天然没有触觉标签,除非配备压力板(PressureVisionDB)或触觉手套(OpenTouch);纯视觉的接触/力估计模型(HACO、HOPE)远不如姿态估计成熟,且各压力数据集的传感器标定与手面表征互不兼容。
本文的目标是本文要构建一个统一的单目自我中心视频手部跟踪器 RLHND,同时输出两类信号:(i) 度量精确、解剖学合理、时间一致的双手 3D 运动——MANO 参数(形状 $\hat{\beta}$、带全局腕部旋转的解剖约束关节角 $\hat{\theta}_t$)、度量相机系平移 $\hat{\tau}_t\in\mathbb{R}^3$ 以及逐帧存在性/可见性;(ii) 手表面 778 个 MANO 顶点上的稠密触觉——接触概率 $\hat{c}_t\in[0,1]^{778}$ 与非负力 $\hat{f}_t\in\mathbb{R}_{\ge0}^{778}$。进而证明这些输出能直接充当机器人动作空间:在五种不同自由度的灵巧手上重定向误差与抖动最小,并能替代人工触觉标注,让基于人类演示的 Dexterous Point Policy 在真实双臂机器人上取得更高成功率。
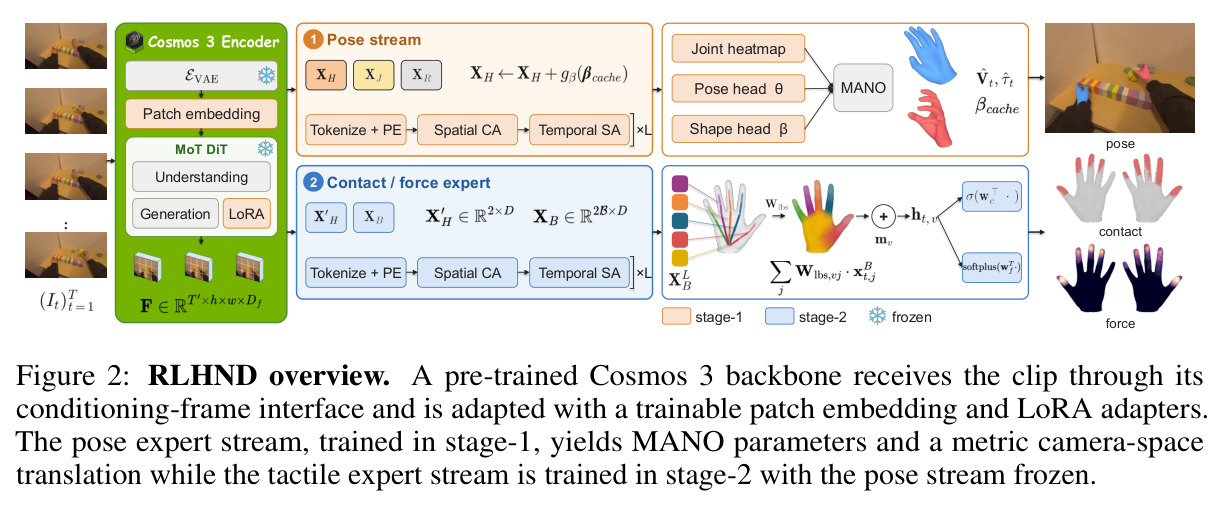
与已有工作不同的是,本文的独特切入角度有三点。其一,编码器接口层面:近期的视频基础模型手部跟踪器(Hamba 等,以及最接近的 ACE-Ego-Hand)把干净视频通过 Wan2.2 的去噪接口喂入(设 $\sigma=0$),这属于分布外输入;RLHND 改用 Cosmos 3 预训练时专门接收干净上下文帧的 conditioning-frame 接口,并输入空提示(视频流已经条件化于干净帧),使微调与预训练分布对齐。其二,部署驱动的设计:不同于所有逐帧或逐窗口回归手形状的做法,RLHND 缓存单一形状参数贯穿全视频,并支持直接注入操作员一次性标定的 $\beta$;同时把姿势参数化约束到人手解剖上可行的 29 自由度(而非 MANO 的 45),从表示层面消灭“尺寸漂移”和“不可行关节”两类失败模式。其三,训练结构层面:触觉监督远比姿态监督稀缺(压力数据集常缺姿态标签),RLHND 用解耦的触觉专家流在冻结姿态流之后单独训练,保证触觉监督永不扰动姿态;配合 LBS 特征扩散把逐顶点注意力降为 16 个骨 token 的骨架级推理。
核心方法
直觉是:视频基础模型在海量人类操作视频上预训练,内化了“手怎么动、手怎么接触物体”的先验,应当把这些先验搬进手部跟踪,而不是只用裁剪帧的小模型从头学。技术路线分三块。第一块是干净潜变量编码器:每个 $T=81$ 帧的 clip 经 Wan2.2 VAE 编码为干净潜变量 $z=\mathcal{E}_{VAE}(\mathcal{C}_w)$,送入预训练 Cosmos 3 Nano(7.8B 参数)的 conditioning 接口,只微调 patch embedding 与生成通路的 LoRA(rank 64),得到确定性时空特征网格 $F\in\mathbb{R}^{T'\times h\times w\times D_f}$。第二块是姿态专家流:将 $F$ 加空间位置与 Fourier 射线编码后 token 化,经 $L$ 层“空间 cross-attention + 双向时间 self-attention”交替解码双手 token,输出头给出关节角、形状、深度与存在概率,再用射线混合 PnP 求解器恢复度量相机系平移。第三块是触觉专家流:复用同一特征,在每手 16 个骨 token 级别做时间推理,输出端用 MANO 固定蒙皮权重把骨特征扩散到 778 顶点,读出接触概率与力。训练分两阶段:stage-1 只训姿态流(8 项损失),stage-2 冻结姿态流只训触觉流。
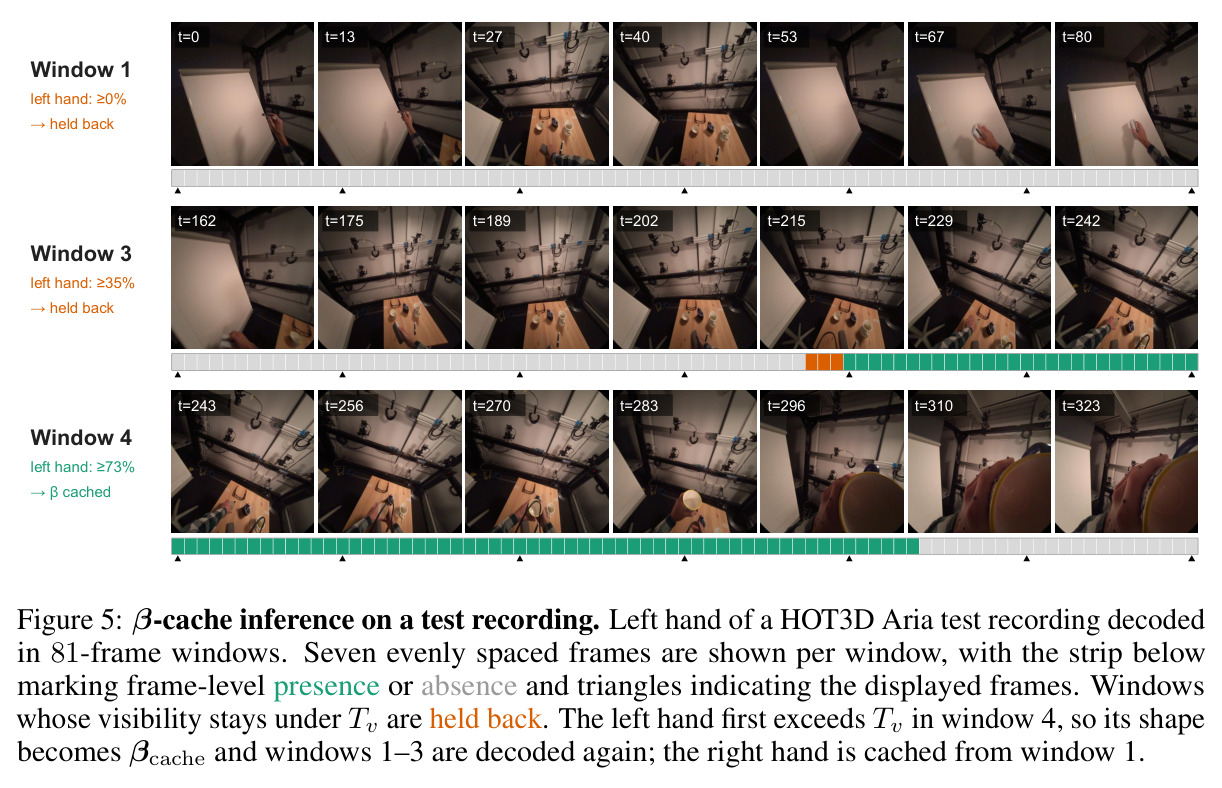
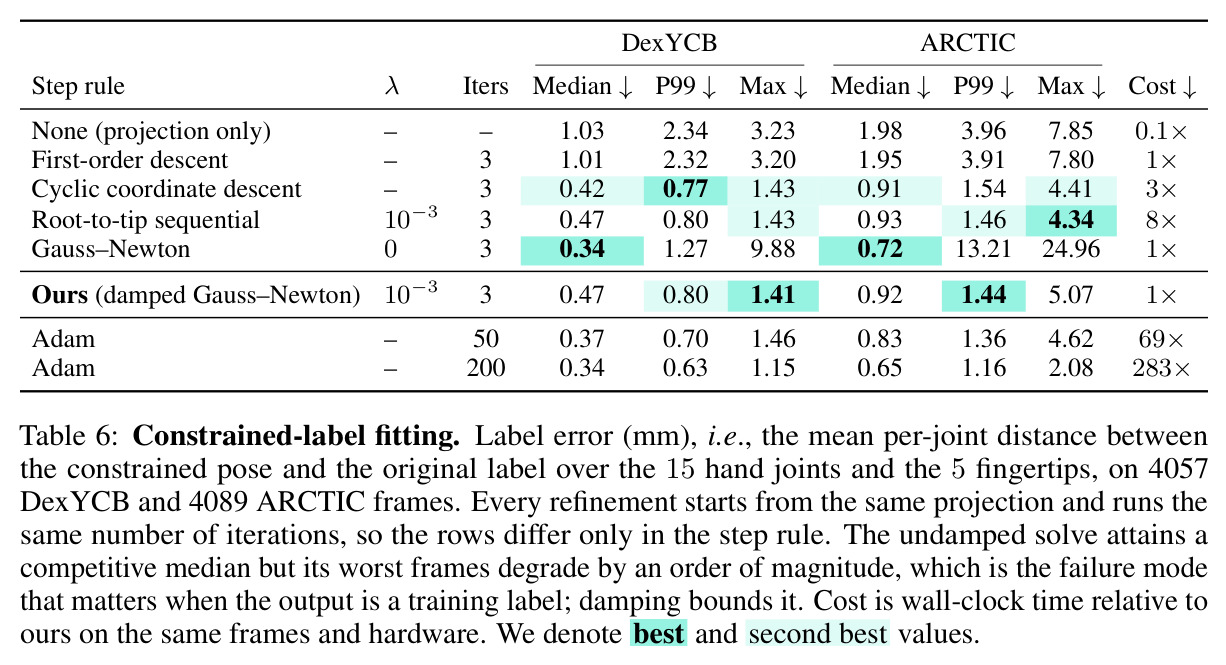
核心创新是与已有方法的三个本质区别。(1) 干净潜变量条件化接口:前作把 $\sigma=0$ 的干净视频从去噪接口喂入 Wan2.2,属分布外输入;RLHND 走 Cosmos 3 预训练时就用于干净上下文帧的 conditioning 接口,与预训练分布对齐——消融 A0 显示换回 Wan2.2 后 ARCTIC MPJPE-p 从 13.36mm 恶化到 16.62mm,证明编码器是最大性能来源。(2) 形状缓存与外部 $\beta$ 注入:现有模型每窗口回归一次形状导致尺寸漂移,RLHND 用首个足够可见 clip 的 $\hat{\beta}$ 缓存全程($X_w^H=q_H+g_\beta(\beta_{cache})$,$g_\beta$ 零初始化渐进引入,50% 概率 teacher forcing),并支持直接注入操作员一次性标定的手形状——这是机器人数据采集中手形状已知的部署视角设计。(3) 解剖学 29 自由度姿势参数化:把每关节旋转沿解剖定义的 twist/spread/bend 轴分解 $R_j=\exp(\phi^{twist}_j[a^{twist}_j]_\times)\exp(\phi^{spread}_j[a^{spread}_j]_\times)\exp(\phi^{bend}_j[a^{bend}_j]_\times)$,冻结 PIP/DIP 关节不可行的 twist 与 spread 轴(拇指因鞍状关节不约束),把 MANO 45 自由度压到 29;再用阻尼 Gauss-Newton 逆运动学(3 次迭代、$\lambda=10^{-3}$、中位拟合误差 0.47-0.92mm、成本仅 Adam 方案的 1/283)把现有标签转换到可行集,使回归的参数空间本身就物理可行。
方法步骤详情
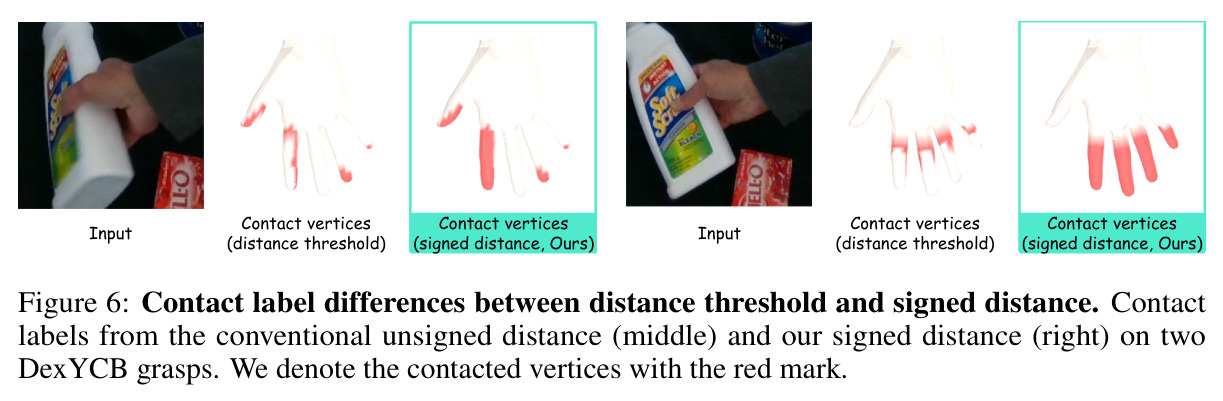
完整流程如下。第一步,输入与编码:单目视频切成 $W$ 个 $T=81$ 帧的 clip(480p),VAE 编码为干净潜变量,经 Cosmos 3 Nano conditioning 接口加 LoRA 得到特征网格 $F$。第二步,姿态解码:token 化并加空间位置与 Fourier 射线编码(射线头预测单位视线射线,受标定像素射线的余弦距离监督,其 Fourier 编码兼作位置嵌入);双手 token 为 $X_w^H=q_H+g_\beta(\beta_{cache})$;$L$ 层交替注意力解码后输出关节角、形状、深度与存在概率。第三步,度量平移恢复:深度头直出 $\hat{\tau}_{z,t}$,2D anchor 反投影成 bearing,按权重 $w_{t,j}=z_{t,j}^{-2}$ 闭式最小二乘解 $\hat{\tau}_{x,t},\hat{\tau}_{y,t}$,失败时回退到腕部放置。第四步,$\beta$-cache 推理(Algorithm 1):逐 clip 解码,缓存首个可见比例超过阈值 $T_v$ 的 clip 的形状并回溯重解码被扣留的 clips;有外部标定则零探测、每 clip 只解码一次。第五步,触理解码(stage-2,姿态流冻结):每手 16 个骨 token 做时间推理,输出端按式 (6) 用固定蒙皮权重扩散 $h_{t,v}=\sum_{j\in\mathcal{B}} X_{t,j}^{LB} W_{lbs,vj}+m_v$,MLP 读接触 logit 与力分布;每手总力 $\hat{F}_t$ 经 softplus 读出,顶点力 $\hat{f}_{t,v}=\hat{F}_t\,\mathrm{softmax}_v$。第六步,训练:stage-1 共 20k 步、8×H100、有效 batch 32、bf16,损失含旋转/形状/3D/2D/平移/存在性/时间平滑/射线 8 项;stage-2 共 20k 步、单张 A100,损失为正类权重 10 的加权 BCE 加力总量与顶点分布 CE。数据为 7 个姿态数据集(ARCTIC、HOT3D、H2O、OakInk2、DexYCB、HO3D、HRDexDB)、力标签源 OpenTouch(覆盖 205 顶点)与 PVDB(421 掌侧顶点),以及网格推导的 contact-only 标签——用签名距离 $\delta_c=5$mm 判定,解决网格互穿漏标(无符号规则在一个 DexYCB 抓握中漏掉 364 个真接触顶点中的 253 个)。
技术新颖性
新颖性体现在三个层面。第一,接口级的视频基础模型复用:把扩散主干改造成特征提取器并不新鲜,但本文细致论证了 conditioning-frame 接口才是与预训练对齐的干净帧入口,并以换用 Wan2.2 的消融(ARCTIC MPJPE-p 13.36 对 16.62mm)定量支撑,为“如何正确微调视频基础模型”提供方法论。第二,用表示层设计直接消灭两类被忽视的失败模式:形状缓存使 $\sigma_{shape}$ 严格为 0(Table 1 中 1.30→0.00),解剖学约束把不可行关节从参数空间排除,且二者互补——单独移除 A1/A2 分别使 MPJPE-p 退化到 14.26/14.87mm。逆运动学标签转换本身也经过系统求解器对比(Table 6:阻尼 GN 以 1× 成本逼近 Adam 283× 成本的精度,并避开无阻尼 GN 在伸直手指时 25mm 的最坏帧误差)。第三,触觉与姿态的解耦训练加 LBS 特征扩散:以 2|B|=32 个骨 token 替代 778 顶点注意力,用 MANO 固定蒙皮先验替代可学习扩散矩阵(B1 消融中可学习版本全面更差);B2 消融证明混入网格推导的 contact-only 数据是触觉性能关键(去掉后 DexYCB F1 从 0.572 崩到 0.047)。此外附录 B.6 的负结果(让触觉专家单向注意姿态 token 无增益,OpenTouch F1 反而 0.696→0.635)说明骨 token 已隐式携带姿态信息,同样有参考价值。整体是“基础模型先验 + 部署驱动的结构先验 + 数据工程”的系统化组合创新。
实验结果
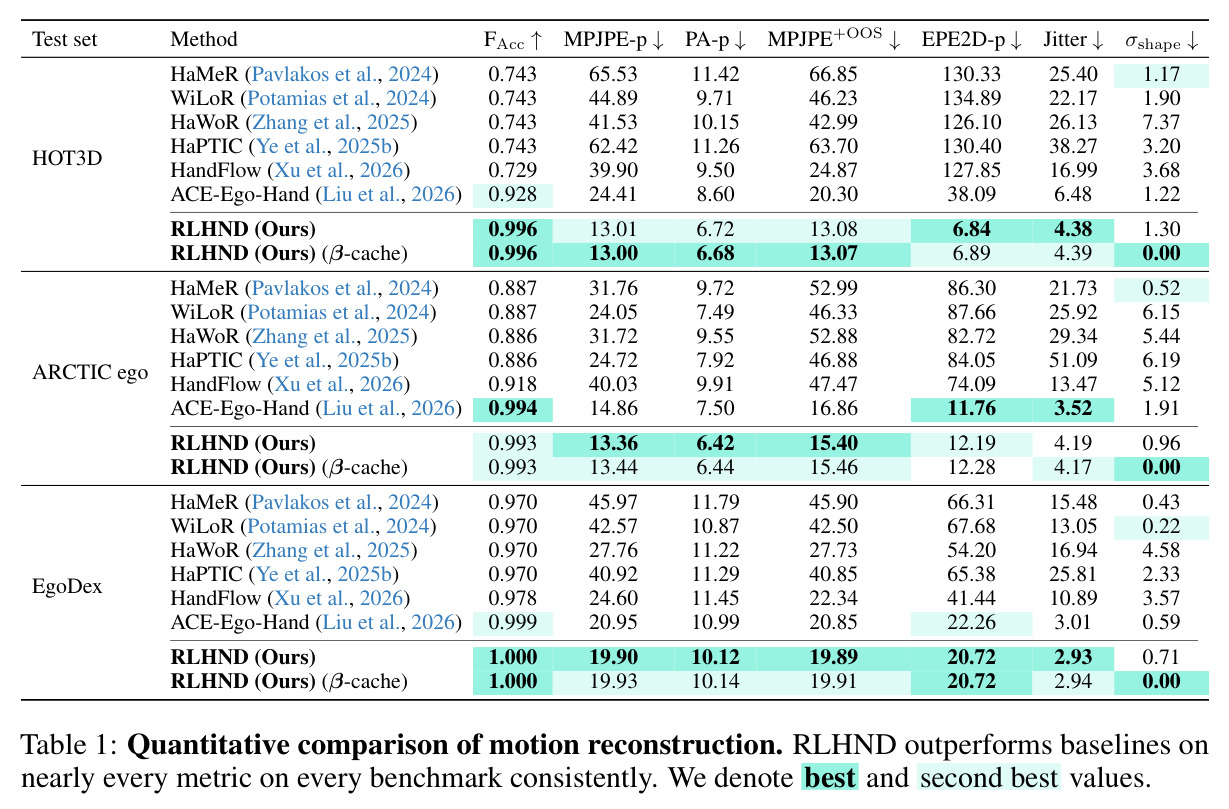
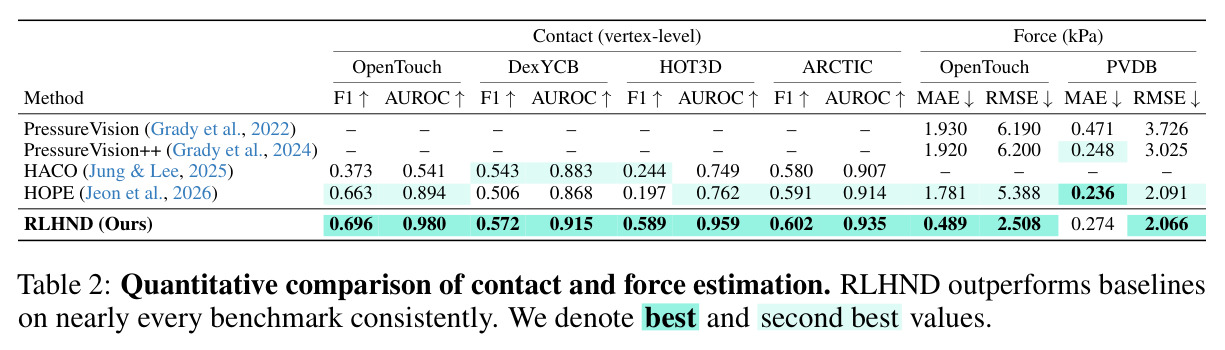
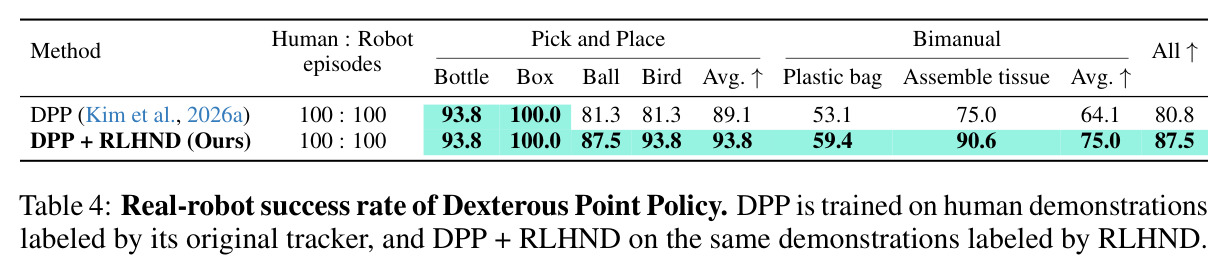
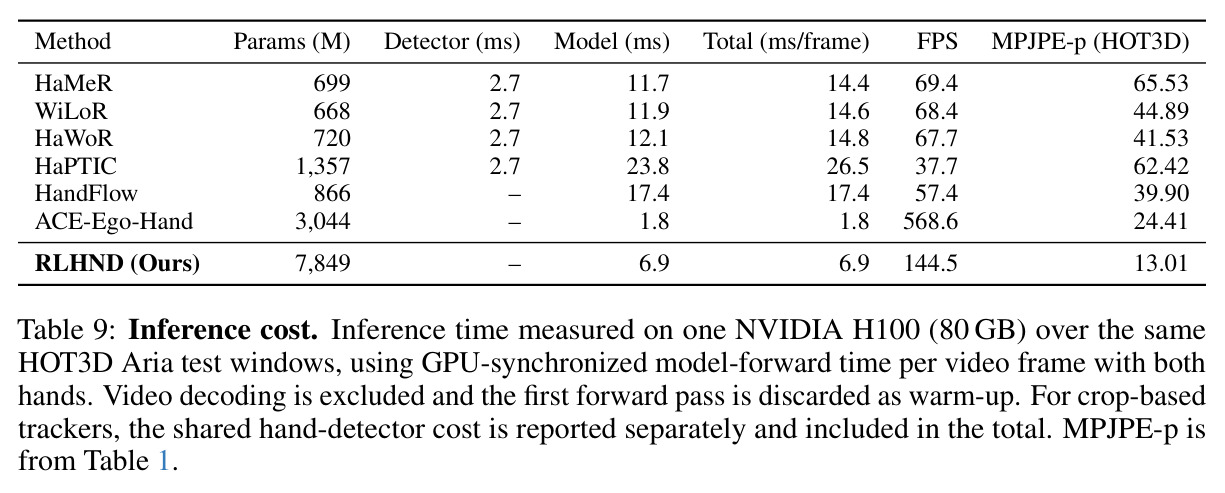
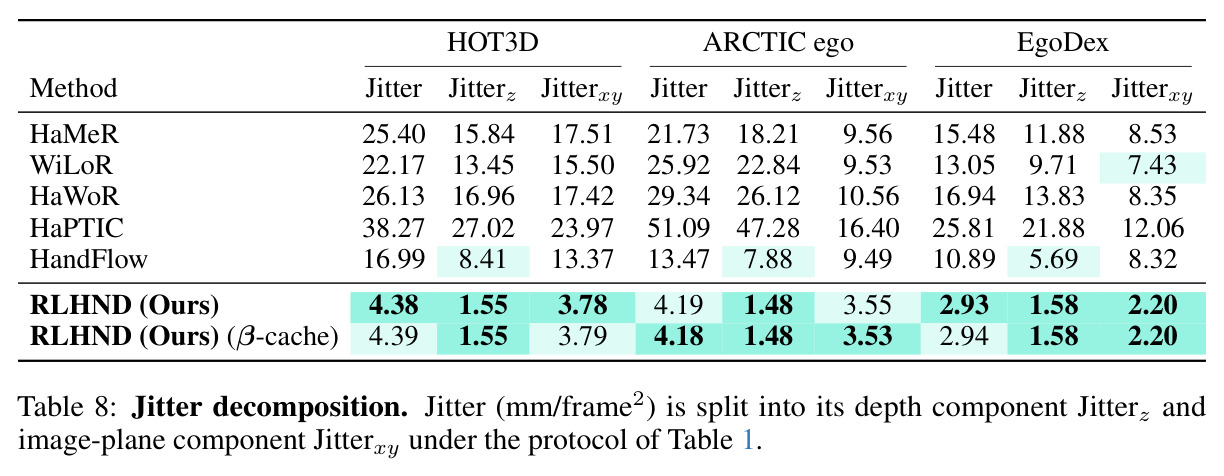
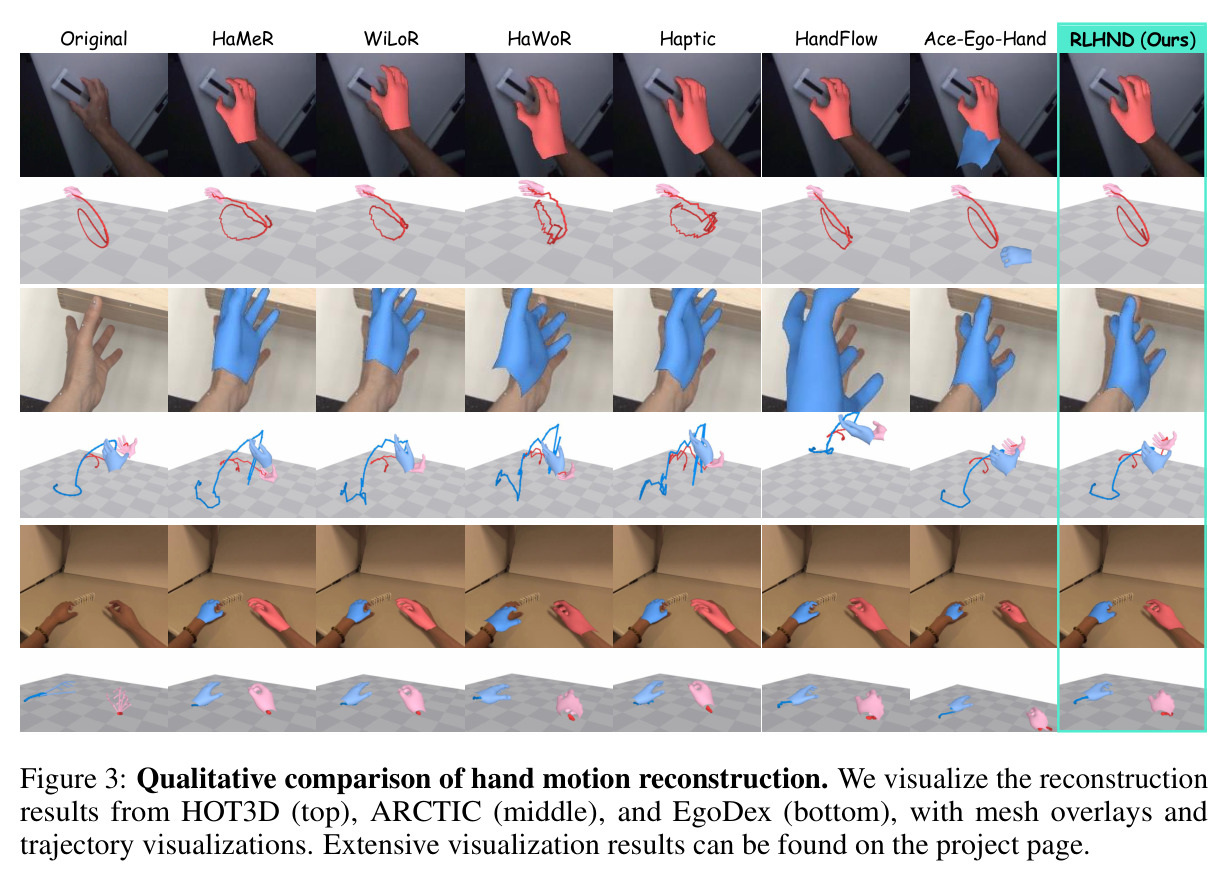
逐实验分析。(1) 姿态重建(Table 1):HOT3D 上 FAcc 0.996、MPJPE-p 13.01mm(ACE-Ego-Hand 为 0.928/24.41mm,降 46.7%),EPE2D-p 6.84 对 38.09 像素(降 82%),Jitter 4.38 对 6.48mm/帧²;ARCTIC ego 上 MPJPE-p 13.36 对 14.86、PA-p 6.42 对 7.50;全方法零样本的 EgoDex 上 MPJPE-p 19.90 对 20.95、FAcc 1.000。β-cache 使 σ_shape 严格为 0,但 B.2 显示残余 Jitter 约四分之三来自图像平面腕部锚点,而裁剪类方法的深度抖动是 RLHND 的 12-32 倍。(2) 触觉(Table 2):接触 F1 在 OpenTouch/DexYCB/HOT3D/ARCTIC 为 0.696/0.572/0.589/0.602 全部第一(HOT3D 为 HACO 0.244 的 2.4 倍),OpenTouch AUROC 0.980 对 HOPE 0.894;力 MAE 0.489 对 1.781 kPa(降 72.5%),PVDB MAE 0.274 略逊于 HOPE 0.236 但 RMSE 略优。(3) 重定向(Table 3):五种灵巧手 Q-err 全部最低(12.7°/16.1°/9.6°/6.0°/10.2°,ACE-Ego-Hand 为 14.0°/17.4°/10.8°/7.4°/12.0°),Jerk 亦最低或并列。(4) 真实机器人(Table 4):DPP+RLHND 成功率 87.5% 对 80.8%,双臂任务 75.0 对 64.1(+10.9 个百分点);B.1 补充 RLHND 腕部深度对立体深度中位偏差 2.3cm,比 HaWoR 低 17.8%。(5) 消融(Table 5):编码器主导(去 Cosmos 3 后 ARCTIC MPJPE-p 13.36→16.62),解剖约束与形状条件各贡献约 1-1.5mm,GT β 不改关节精度但 Q-err 10.12→9.69,说明固定形状稳定重定向。(6) 成本(Table 9):7.85B 参数、6.9ms/帧、144.5 FPS(H100),快于所有裁剪类方法(14.4-26.5ms),慢于 ACE-Ego-Hand 的 1.8ms。
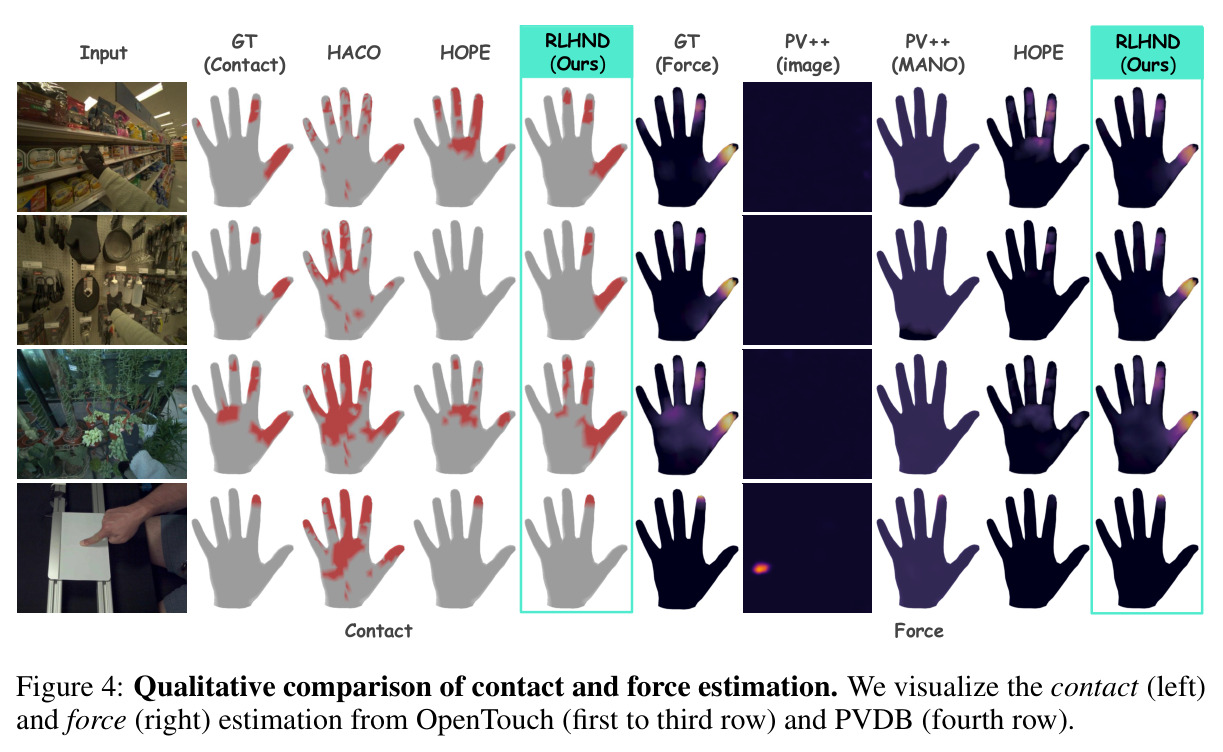
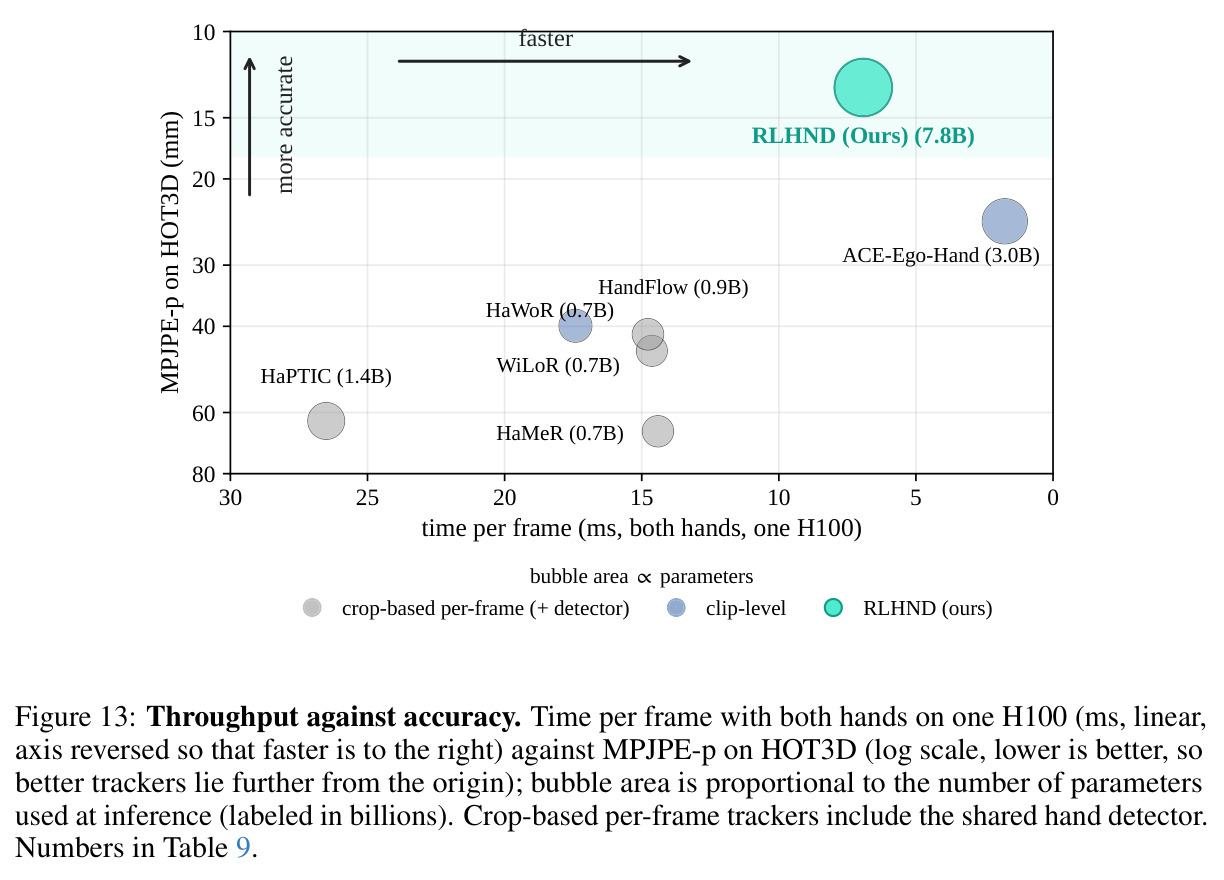
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 手部姿态估计(HOT3D 测试集) | MPJPE-p (mm) | 13.01 | ACE-Ego-Hand 24.41 | 降低 46.7%;对裁剪类基线(41-66mm)降低 68-80% |
| 手部姿态估计(HOT3D 测试集) | EPE2D-p (px) | 6.84 | ACE-Ego-Hand 38.09 | 降低约 82%(5.6 倍) |
| 手部姿态估计(ARCTIC ego) | MPJPE-p / PA-p (mm) | 13.36 / 6.42 | ACE-Ego-Hand 14.86 / 7.50 | 分别降低 10.1% 与 14.4% |
| 手部姿态估计(EgoDex,零样本) | MPJPE-p (mm) / FAcc | 19.90 / 1.000 | ACE-Ego-Hand 20.95 / 0.999 | 两者均为零样本设定下的最优 |
| 姿态时间一致性(三个测试集) | Jitter (mm/帧²) / σ_shape (mm) | 4.38 / 4.19 / 2.93;β-cache 下 σ_shape=0.00 | ACE-Ego-Hand 6.48 / 3.52 / 3.01;裁剪类 Jitter 13-51 | Jitter 降低约 17-33%,尺寸漂移严格清零 |
| 接触估计(HOT3D) | F1 / AUROC | 0.589 / 0.959 | HACO 0.244 / 0.749;HOPE 0.197 / 0.762 | F1 约 2.4 倍 |
| 接触估计(OpenTouch) | F1 / AUROC | 0.696 / 0.980 | HOPE 0.663 / 0.894 | AUROC 提升 8.6 个百分点 |
| 力估计(OpenTouch) | MAE / RMSE (kPa) | 0.489 / 2.508 | HOPE 1.781 / 5.388 | MAE 降低 72.5% |
| 力估计(PressureVisionDB) | MAE / RMSE (kPa) | 0.274 / 2.066 | HOPE 0.236 / 2.091 | MAE 略逊(+16%),RMSE 略优 |
| 灵巧手重定向(五手平均,DexPilot) | Q-err (°) / Jerk (°/帧²) | 10.9 平均(各手 12.7/16.1/9.6/6.0/10.2) | ACE-Ego-Hand 12.3 平均(14.0/17.4/10.8/7.4/12.0) | 五种手上 Q-err 全部最低,Jerk 最低或并列最低 |
| 真实机器人操作(Dexterous Point Policy,6 任务) | 成功率 (%) | 87.5 | DPP(HaWoR 关键点)80.8 | +6.7 个百分点;双臂子集 +10.9 个百分点(64.1→75.0) |
| 推理效率(HOT3D Aria,H100) | 毫秒/帧(双手) / FPS | 6.9 / 144.5 | ACE-Ego-Hand 1.8 / 568.6;裁剪类含检测器 14.4-26.5ms | 快于所有裁剪类方法,精度接近两倍于最便宜的 clip 级方法 |
局限与改进
作者在附录 C 承认三点:其一,β-cache 的质量取决于首个足够可见窗口,公共基准无法验证“操作员一次性手部标定”的真实收益(只能用 ARCTIC 真值 β 的 A4 消融间接佐证 Q-err 10.12→9.69);其二,力监督仅来自单一触觉手套(OpenTouch)和单一平面压力板(PVDB),压力量级与接触面多样性受限,新数据集的标定与表面参数化不统一难以并入;其三,从手标签到机器人动作仍有缺口——真实机器人实验用固定 IK、锁定外展关节、统一 15mm 接触偏移启发式,预测的连续力未真正用于控制,且 clip 级离线处理非实时、7.8B 主干远大于裁剪类模型。我自己的观察:触觉监督只覆盖传感器可感知顶点(OpenTouch 205/778、PVDB 421/778),其余顶点无监督,跨手形状的外推能力未被评估;大量接触真值来自网格几何 5mm 阈值的签名距离,本质与 MANO 拟合质量绑定;全部评估围绕 MANO 生态,对非 MANO 表征管线的适配成本未讨论;Jitter 与 Q-err 依赖稀疏标注(Oracle 行 Jerk 已达 0.13-0.43°/帧²),绝对值解读需谨慎。
独立分析的弱点
独立分析以下弱点。第一,实时性缺失:clip 级(81 帧)处理是离线批式的,遥操作、在线数据采集等低延迟场景无法直接使用,论文也未报告视频解码与窗口重叠的端到端延迟;改进方向是滑动窗口增量推理与潜变量级状态缓存(β-cache 思路可推广),或将 7.8B 编码器蒸馏为小型学生模型。第二,力的泛化受制于传感器:监督只覆盖手套 205 个、压力板 421 个顶点,kPa 数值与具体传感器标定绑定,换新数据源会有域偏移;改进方向是引入标定不变的物理中介量(接触面积、法向速度)或跨传感器归一化训练。第三,单目度量深度未闭环:真实机器人管线中 RLHND 关键点仍需按立体深度逐帧缩放对齐(中位偏置 +2.2cm),说明尺度-深度模糊只是被缓解;改进方向是把外部 β 标定与场景尺度线索(桌面平面、物体先验尺寸)融入平移求解器。第四,接触到力的决策断层:DPP 部署时接触概率仅以 0.05 阈值二值化并统一推进 15mm,连续力分布完全未用于控制;改进方向是力感知的注入量调节或结合阻抗控制。第五,两流完全解耦的天花板:B.6 显示直接注意力无增益,但也意味着触觉流无法利用姿态流的遮挡推理能力,可探索骨 token 之上的轻量跨流融合或 stage-2 低学习率联合微调。
未来方向
作者明确提出的方向包括:把 EgoPressure 等更新的自我中心压力数据集在统一表面表征与压力单位后纳入训练以扩大力监督规模;在无约束采集场景中验证外部 $\beta$ 标定与 $\beta$-cache 对劣质首窗口的鲁棒性;把预测力从二值接触升级为真实的控制信号(超越固定 15mm 偏移与锁定外展关节的固定 IK 重定向)。基于本文成果可自然延伸的研究还有:用 RLHND 对大规模互联网手部视频自动标注姿态、接触与力,构建“人类侧”VLA 预训练语料,打通人类视频到机器人策略的规模化路径;把稠密接触/力预测接入可微物理仿真,用于 sim2real 校准或策略的接触奖励构造;将 clip 级模型流式化以支持在线遥操作与实时数据采集质检;把输出从手扩展到手-臂整体(肘、腕、躯干线索)以及物体侧的接触/力联合估计,形成双向物理标注;以及针对作者伦理声明中自认的局限,系统审计跨被试、手型与肤色的性能差异并做针对性平衡。
复现评估
复现友好度较高。作者承诺开源代码与预训练权重(项目页 seungjun-moon.github.io/rlhnd),训练与评估全部使用公开数据集(ARCTIC、HOT3D、H2O、OakInk2、DexYCB、HO3D、HRDexDB、EgoDex,触觉用 OpenTouch 与 PressureVisionDB),不涉及新采集人类数据。附录 A 信息完整:伪标签生成可查(Table 6 给出 45→29 自由度转换各求解器的误差与成本、λ=10⁻³、3 次迭代;签名距离接触规则 δc=5mm;OpenTouch/PVDB 力标签提升与门控协议;Algorithm 1 伪代码);损失权重逐项列出(Table 7);训练超参完整(AdamW、bf16、分层学习率、stage-1 20k 步 / stage-2 20k 步);基线全部用官方权重在相同帧上重跑。算力门槛中等:完整复现 stage-1 需约 8 张 H100(有效 batch 32),stage-2 仅需单张 A100,只做推理或微调触觉专家门槛低得多。不可复现部分是真实机器人实验(RB-Y1 双臂机器人 + WUJI Hand 2 与专属遥操作数据),但重定向评估用公开 DexPilot 求解器在给出运动学参数的五个灵巧手上进行,可独立复现。潜在障碍主要是 Cosmos 3 Nano 权重获取许可,以及 HOPE checkpoint 需向作者索取。
论文图表
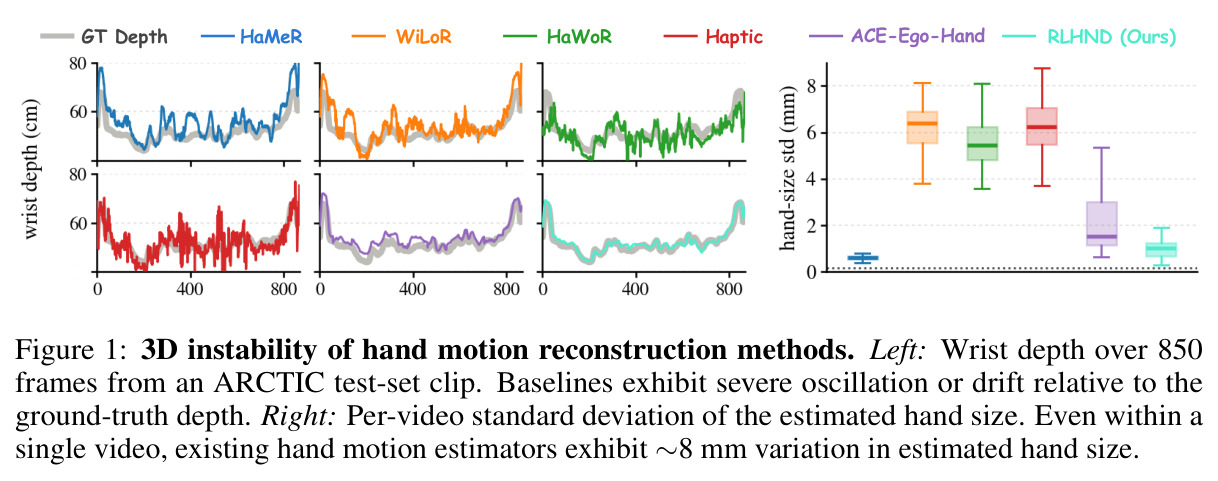
左图展示 ARCTIC 测试集一段 850 帧片段上各方法估计的手腕深度曲线:GT 深度平滑,而 HaMeR、WiLoR、HaWoR、Haptic、ACE-Ego-Hand 等基线相对真值剧烈振荡或漂移。右图统计每段视频内估计手尺寸的标准差,现有方法即使在同一视频内也有约 8mm 的手尺寸波动。
这是全文的问题陈述:直观展示了现有手部跟踪器的深度不稳定与尺度-深度模糊两大缺陷,直接引出 RLHND 形状缓存与解剖约束两条设计动机,也是理解 Jitter 与 σ_shape 两个指标的背景。