ARCS:通过结构化消歧实现精确的 Text-to-SQL ARCS: Towards Precise Text-to-SQL via Structured Disambiguation
提出结构化消歧范式并构建ARCS基准,歧义问题使最强模型端到端准确率仅51%
前置知识
Text-to-SQL
将用户的自然语言问题自动转换为可在关系数据库上执行的 SQL 查询的任务。系统需要理解问题语义,并将其对齐到具体数据库的模式(表、列、值)上,生成语法和语义都正确的查询。它是连接企业数据库与生成式 AI 的桥梁,主流基准 Spider 2.0 上最强系统已超过 80% 执行准确率。
本文的核心主张是基准成绩高不等于可落地,因为现有基准问题都是无歧义的,而真实用户问题充满歧义;理解 Text-to-SQL 的评测方式才能看出 ARCS 揭示的性能落差。
歧义与模糊(ambiguity 与 vagueness)
歧义指一句话存在多种离散的有效解释,例如“New York”可指城市或州;模糊指解释空间连续无界,例如“高交易额”中的阈值无法穷举。论文遵循先前工作把两者统称歧义,并将歧义点分为有限集 $A_{\text{finite}}$ 与无限集 $A_{\text{infinite}}$ 分别处理。
结构化消歧之所以可行,正是因为数据库模式元素有限,使离散歧义的解释空间可枚举成多选题;而模糊性必须用滑块加比较符处理,这一区分是方法设计的基石。
执行准确率(Execution Accuracy, EX)
Text-to-SQL 的主流评测指标:把预测 SQL 与标准 SQL 分别在数据库上执行,比较结果表是否一致,一致记 1 分。它比字符串匹配宽松,允许写法不同但结果等价。本文的 $\mathrm{EX}_{e2e}$ 衡量端到端性能,$\mathrm{EX}_{\text{disambiguated}}$ 衡量给定标准消歧后的纯 SQL 生成能力。
论文的核心数字(gpt-6-sol 仅 51%、开源模型不超 27%)都建立在这一指标上;其评分规则还允许预测结果表包含额外列,这影响对“全都要”策略为何得分的理解。
用户模拟器(User Simulator)
用一个 LLM 扮演真实用户来支持任意交互式系统的自动化评测:它暴露 ask user 接口,支持自由文本、多选和数值选择三类问题。模拟器持有每个歧义点的标准解释,随机采样一个作为用户真实意图,并保证最终意图 SQL 的执行结果非空。
ARCS 的端到端评测不约束系统架构,任何系统都可通过该接口自由提问,使不同消歧策略可比;其两阶段设计也反映了 LLM 模拟用户的信息泄漏风险。
识别而非回忆(Recognition over Recall)
人机交互领域的经典设计原则:让人从给定选项中辨认正确项,比让其在记忆中检索并自由表述更省力、更不易出错。对应到消歧场景,就是问用户“是 A 还是 B”,而不是开放式的“你是什么意思”。
这是结构化消歧范式的理论依据,解释了为什么多选面板加滑块能以更低的用户努力(token 计数)达到与多轮对话相当甚至更好的消歧效果。
研究动机
尽管最强系统在 Spider 2.0 上的执行准确率已突破 80%,论文指出这一成绩掩盖了关键问题:主流基准(Spider、BIRD、Spider 2.0 等)几乎都由无歧义、冗长且过度指定的问题构成,与真实用户的提问习惯严重脱节。真实问题中的歧义微妙且高度依赖领域和数据:例如“2025 年新开的 GitHub issue 有多少”需要区分是只数新建的、还是也包含 2025 年内重新打开的;“总销售额是多少”则取决于退款、取消和部分退货订单如何计入。当 text-to-SQL 的输出被用于设定年度预算等关键商业决策时,这类歧义会直接放大为业务损失。传统解决方案是对话式澄清,但论文指出它要求用户阅读、回忆并用自然语言复述约束,效率低、认知负担重,与真实工作流不匹配。在歧义问题的压力测试下,gpt-6-sol 端到端执行准确率只有 51%,没有任何开源模型超过 27%,说明歧义才是当前 text-to-SQL 落地的首要误差来源。
本文的目标是论文有两个相互支撑的目标。其一是提出并验证“结构化消歧”这一新交互范式:不依赖自由文本的多轮澄清对话,而是把歧义分解为若干歧义点,用多选题(枚举的候选解释)加数值滑块(阈值类模糊)这种显式、受限的界面让用户通过“辨认”而非“回忆”来解决歧义,同时立即渲染 SQL 与结果表、支持随时改选对比。其二是构建 ARCS(Ambiguity Resolution Corpus for SQL):首个在未修改的真实数据库上采集自然发生、不受约束歧义的 text-to-SQL 基准,提供 311 个真实消歧任务,完整标注所有有效歧义点、全部候选解释及对应 SQL(经用户模拟器多次采样后为 331 个任务实例、101 个独特问题、413 条独特 SQL),并配套二维歧义分类学、双阶段用户模拟器和端到端/细粒度两套评测协议,对 23 个 LLM 做系统评估。
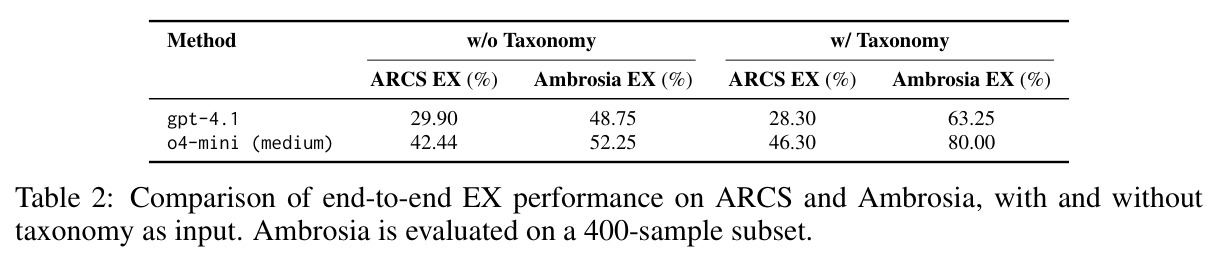
与已有工作不同的是,与先前工作的根本差异在于歧义的来源和交互的形态。歧义构造上,Ambrosia、Bhaskar 等人以及 Wang 等人的做法是先定义少量歧义类型,再把人工歧义注入问题和(常被改动过的)小型数据库,导致歧义模式可被分类学提示词破解——论文实验显示 o4-mini 在 Ambrosia 上拿到分类学提示后执行准确率从 52% 跳到 80%。ARCS 反其道而行:直接在 BIRD 的 5 个和 Spider 2.0 的 1 个未修改真实数据库(合计 8.3 GB)上发掘问题内在的、多个相互作用的歧义短语,因此对启发式和提示工程免疫。交互形态上,与对话式澄清及“生成所有完整句子解释”的非结构化方法不同,本文利用数据库模式元素有限这一观察,把开放式回忆问题转化为受限识别问题,并按歧义点分解决策,避免解释组合随歧义点数量指数爆炸,同时能优雅处理无法枚举的数值模糊。
核心方法
结构化消歧的直觉是:当问题落在一个具体数据库上时,有效解释的空间被模式元素(表、列、值、聚合方式)大幅收窄,因此可以把“用户是什么意思”变成一连串有限选择。技术路线分三阶段。第一阶段消歧:给定问题与数据库,系统输出歧义点集合 $A = A_{\text{finite}} \cup A_{\text{infinite}}$,其中有限歧义点附带全部有效解释 $I_a$,无限歧义点(数值阈值类)引入参数变量 $v_a$。第二阶段用户交互:呈现 $|A_{\text{finite}}|$ 个多选题和 $|A_{\text{infinite}}|$ 个滑块,用户选择解释或数值加比较符,也可拒绝误报的歧义点。第三阶段 SQL 生成:对用户选定的解释组合 $I^* \in \prod_{a \in A^+_{\text{finite}}} I_a$ 生成参数化 SQL,执行时用用户给的值实例化变量;用户改选时按需重新生成,或提前并行预生成全部组合并缓存以压缩延迟。生成模块与具体实现无关,任何 text-to-SQL 系统都能嵌入替换。
核心创新是把消歧从开放式自然语言对话改造成约束化的识别任务,本质区别有三点。第一,解释空间的可枚举性来自数据库而非语言本身:语言歧义在真空中近乎开放,但一旦绑定具体模式(比如库里只有 city 列,“New York”就不再歧义),枚举所有有效解释变得可行,这是先前对话式方法没有利用的结构性先验。第二,按歧义点分解而非罗列完整句子解释:若一个问题含 4 个歧义点、每个 2 到 4 个解释,全句组合可达 32 条(论文 Figure 3 中 retails 例子恰好有 SQL 1 到 SQL 32),逐点呈现多选加滑块把复杂度从解释组合的乘积降为各点之和,且滑块加操作符(如 $>$ 与 $\geq$)能处理“高余额”这类无法枚举的模糊。第三,用户只需辨认和调参,无需组织语言,配合即时 SQL 与结果表渲染,形成可反复对比、改选的交互回路,这正是 HCI“识别优于回忆”原则在 text-to-SQL 上的落地。
方法步骤详情
端到端流程如下。步骤一,歧义识别:输入是自然语言问题和数据库模式,输出歧义点集合 $A = A_{\text{finite}} \cup A_{\text{infinite}}$,每个有限歧义点附带全部候选解释,每个无限歧义点附带参数变量。ARCS 的细粒度评测在此打分:Full Recall 要求全部歧义点及解释被找出,Perfect 还要求不多不少。步骤二,用户交互:输入是步骤一的歧义集合,输出交互面板——多选题对应有限歧义点,滑块加比较符选择对应无限歧义点,用户可以拒绝任何错误歧义点。步骤三,SQL 生成:输入是被接受歧义点的选定解释组合与用户指定的变量值,输出参数化 SQL 并执行出结果表;系统支持并行预生成全部解释组合并缓存。基准侧的配套流程是:先用 gpt-4.1 按分类学批量生成候选问题(每个数据库 180 条),作者人工筛选并标注歧义点、解释和参数化 SQL(每题平均 2.5 小时),再由两阶段用户模拟器随机采样用户意图(每题多次采样得 331 个任务实例),并保证目标 SQL 执行结果非空。
技术新颖性
技术新颖性体现在四个层面。基准层面,ARCS 是首个坚持“真实数据库原样使用、歧义自然发生”的消歧基准,标注完备到每个解释组合都有对应 SQL,使消歧能力与 SQL 生成能力可解耦诊断——这正是 Table 1 中 $\Delta \mathrm{EX}$ 列($\mathrm{EX}_{e2e}$ 减 $\mathrm{EX}_{\text{disambiguated}}$,所有模型均为 -3.22 到 -29.26 的负值)能够成立的先决条件。分类学层面,提出语言维度(语义、句法)与数据库维度(列、表、值、计算)正交且各自穷举的二维框架,能区分“语言解析错误”和“模式对齐错误”,而先前工作只覆盖单一维度或将两者混为一谈。评测层面,区分真实歧义与全局标注约定(如 argmax 是否返回平局、是否四舍五入),把后者做成可嵌入提示的约定规范,避免数据集级惯例污染标注;评分规则还允许预测 SQL 返回覆盖所有解释的宽表,认可“不问而全答”的聪明策略。交互层面,双阶段用户模拟器先定位与问题相关的歧义点再作答,缓解了 LLM 模拟用户主动泄漏其他歧义信息的问题。
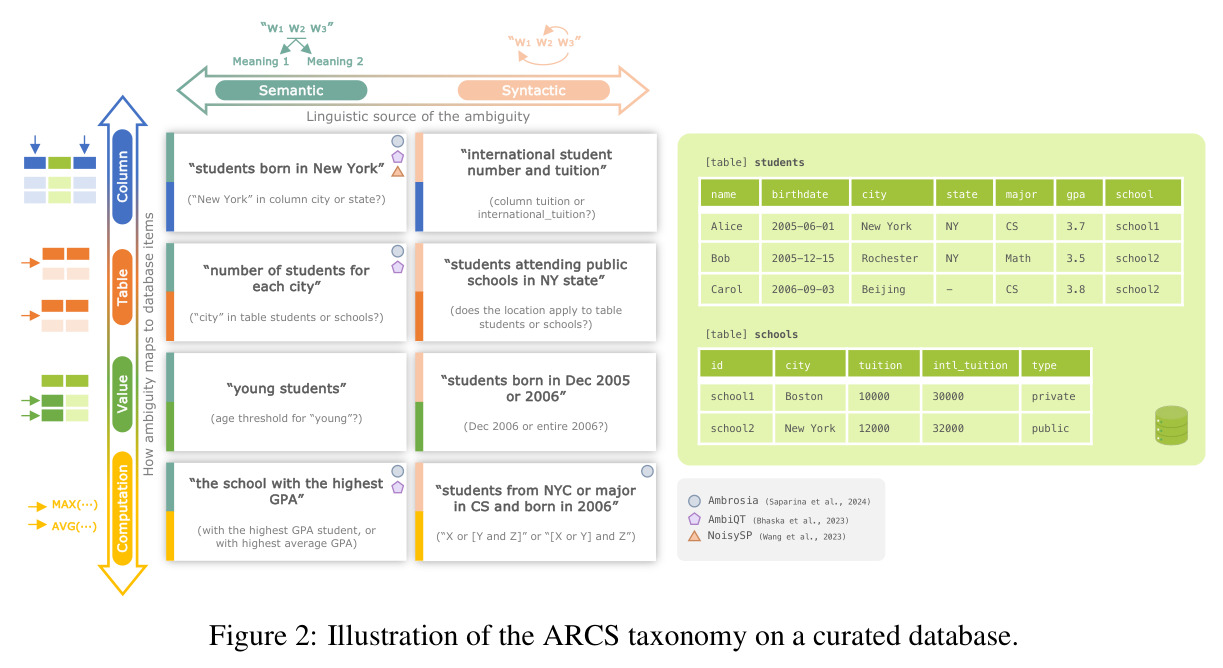
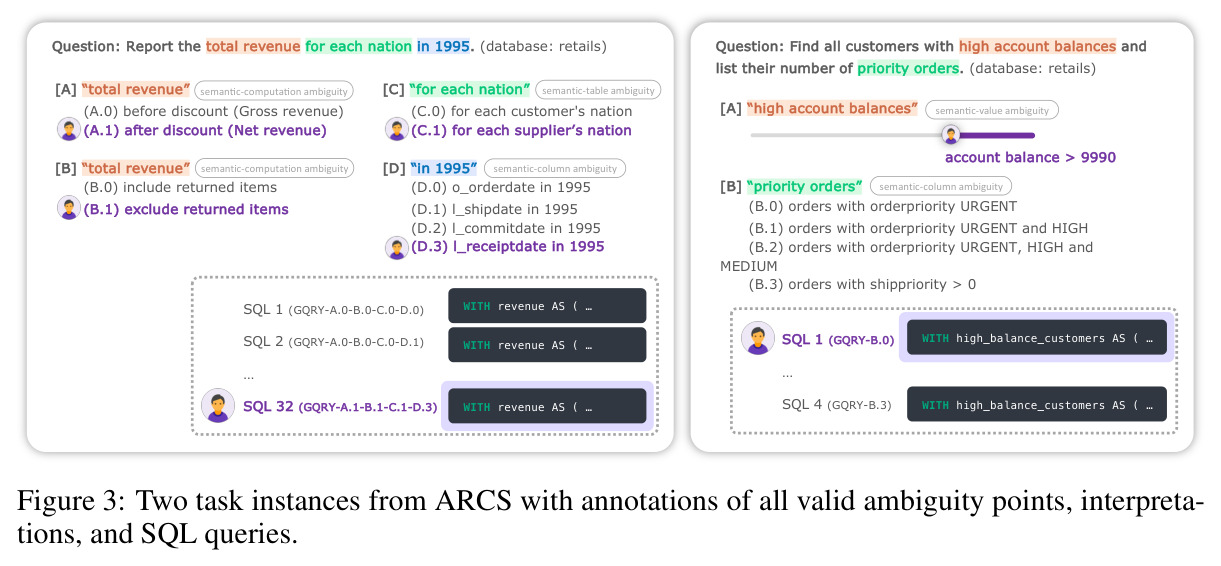
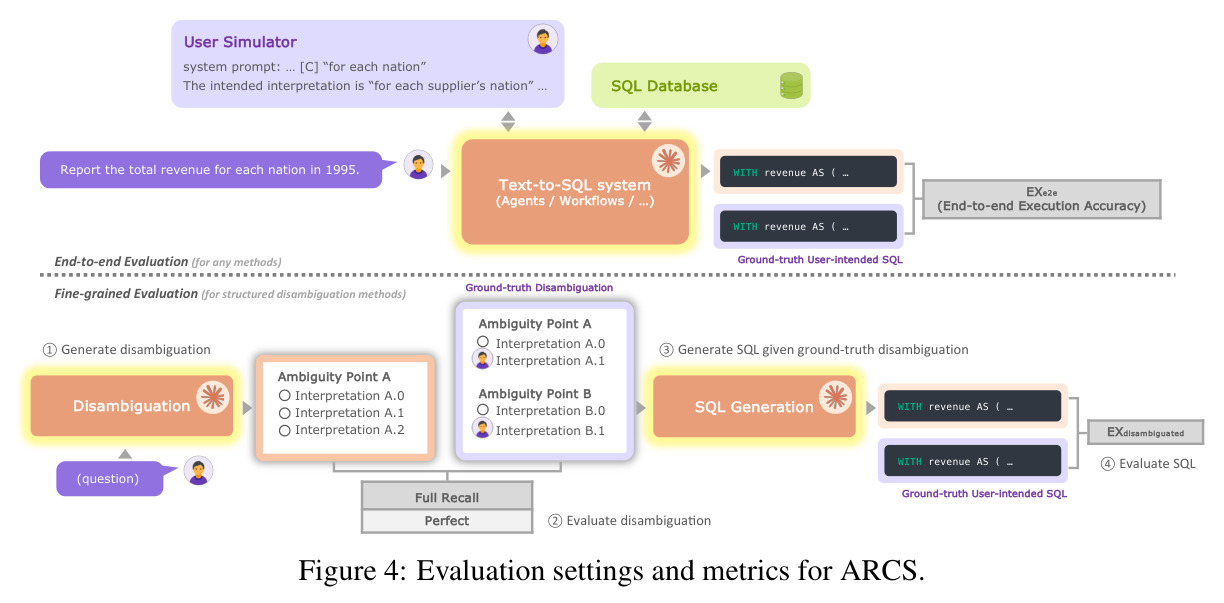
实验结果
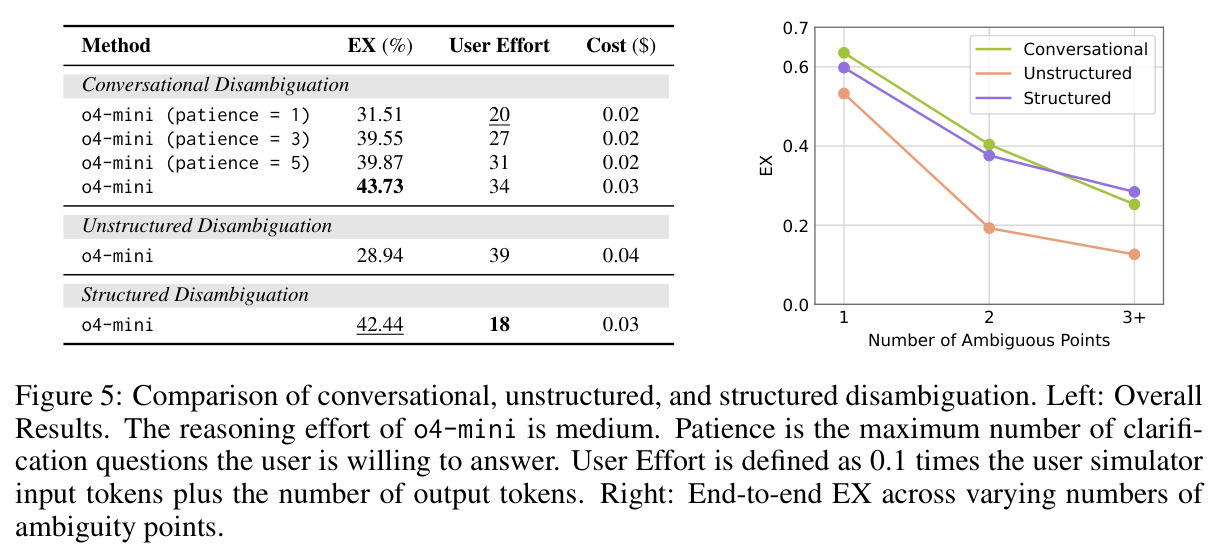
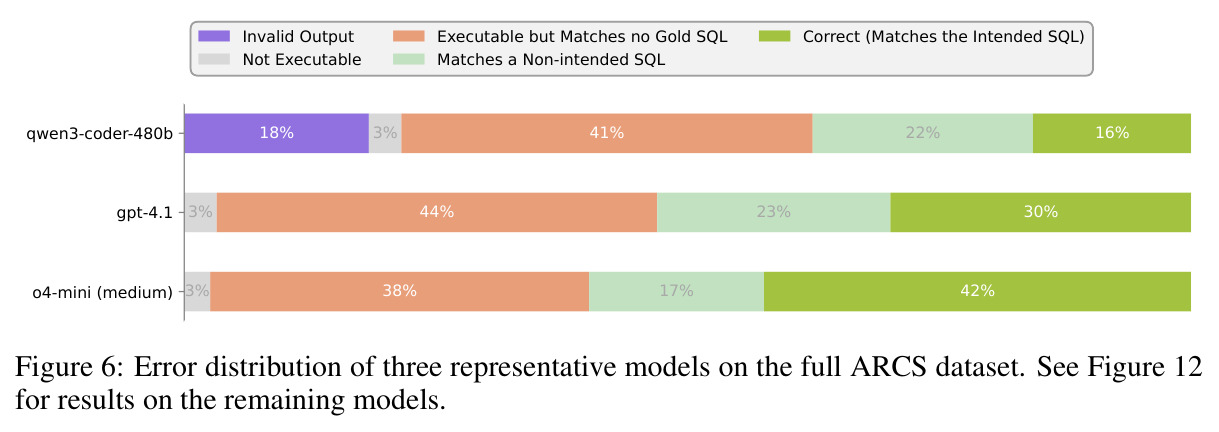
论文在 23 个模型(8 开源、15 闭源)上的发现可归纳为四点。其一,歧义下 text-to-SQL 依然很难:gpt-5(medium)端到端 $\mathrm{EX}_{e2e}$ 最高 57.88%,gpt-6-sol 51.77%,gpt-4.1 仅 29.90%,开源最佳 gptoss-120b 只有 26.05%。其二,消歧是主瓶颈:除 gpt-5 与 gpt-6-sol 外所有模型 Full Recall 不超过 30.55%,Perfect 最高仅 13.83%;gpt-5 的 Full Recall 高达 61.09% 但 Perfect 为 0,说明它系统性过度识别歧义。同期前沿模型 SQL 生成趋同($\mathrm{EX}_{\text{disambiguated}}$ 为 65.27%–68.81%)而消歧悬殊(22.51%–61.09%),暗示消歧在训练目标中被欠代表。其三,推理 effort 收益明显:gpt-5 从 minimal 到 medium 由 37.62% 升至 57.88%,o4-mini 从 low 到 high 由 36.01% 升至 44.05%。其四,Figure 5 中结构化消歧以 42.44% 超过对话式 patience=5 的 39.87%,用户努力从 31 降至 18 token;非结构化仅 28.94%且在多歧义点问题上急剧劣化。错误分析显示 gpt-4.1 有 44% 的输出不匹配任何标准 SQL、23% 匹配到非用户意图的 SQL,且计算歧义识别全员最差。
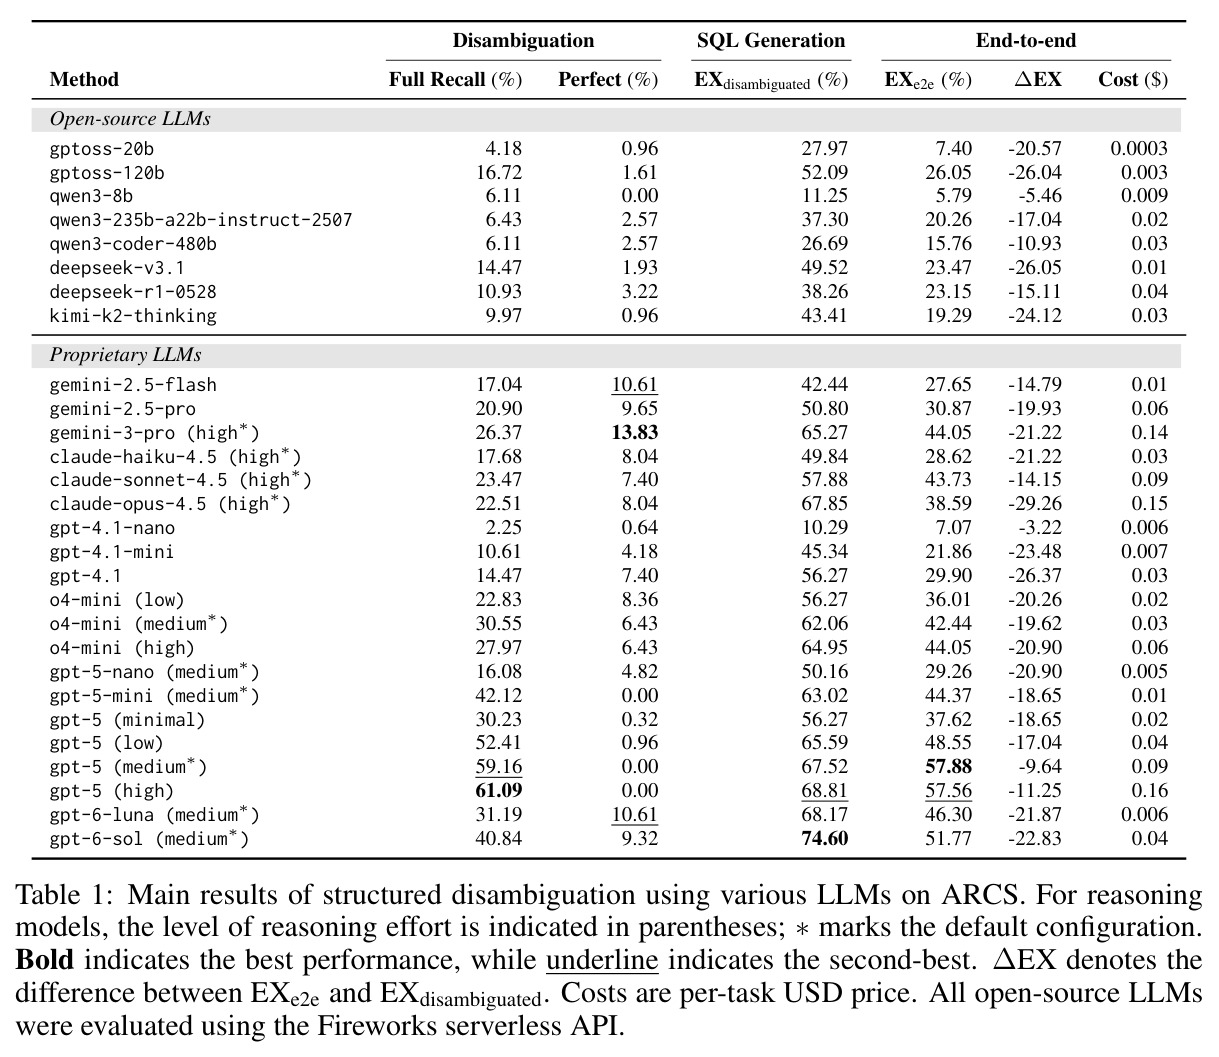
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 歧义问题端到端 Text-to-SQL(ARCS) | EXe2e 端到端执行准确率 | gpt-5 (medium) 57.88%;gpt-6-sol 51.77% | gpt-4.1 29.90%;开源最佳 gptoss-120b 26.05% | 最强闭源比 gpt-4.1 高约 28 个百分点,但绝对值仍远低于无歧义基准上 80%+ 的水平,凸显任务难度 |
| 结构化消歧 vs 对话式/非结构化消歧(o4-mini medium) | EXe2e 与用户努力(token) | 结构化消歧:42.44%,用户努力 18 | 对话式 patience=5:39.87%,努力 31;非结构化:28.94%,努力 39 | 以约六成的用户努力超越对话式 2.6 个百分点,比非结构化高 13.5 个百分点 |
| 给定标准消歧后的 SQL 生成 | EXdisambiguated | gpt-6-sol 74.60%(全场最高) | 开源最佳 gptoss-120b 52.09% | 差距 22.5 个百分点,印证消歧而非 SQL 生成是主要瓶颈 |
| 跨基准鲁棒性(ARCS vs Ambrosia,o4-mini) | EXe2e(提供 taxonomy 提示前后) | ARCS:42.44% → 46.30%(+3.9) | Ambrosia:52.25% → 80.00%(+27.8) | ARCS 几乎不被分类学提示词破解,抗启发式与提示工程能力显著更强 |
局限与改进
作者承认的局限包括:全部标注由作者本人完成,虽经两轮标注加终审,但缺乏独立标注者间一致性检验,每题平均 2.5 小时的人力成本也难以快速扩展;数据规模有限,331 个任务实例来自仅 101 个独特问题,数据库只有 6 个(5 个来自 BIRD、1 个来自 Spider 2.0,合计 8.3 GB),覆盖银行、零售、学生活动、NBA、Stack Exchange 和 GitHub 六个领域;端到端评测依赖 LLM 用户模拟器而非真人,虽有 NASA-TLX 用户研究佐证,但模拟器与真实用户行为的差异未被量化。我自己的观察是:结构化消歧的前提是歧义点识别质量,若系统产生大量误报歧义点,面板噪声反而可能压垮用户,而错误分析恰好显示误报(把无歧义短语错误放宽)是普遍失败模式;允许预测返回额外列的评分规则会系统性奖励“全都要”的宽表策略,可能低估真实部署中结果表过宽的可读性成本;此外成本指标未计入预生成全部解释组合的缓存开销,组合数会随歧义点数量指数增长。
独立分析的弱点
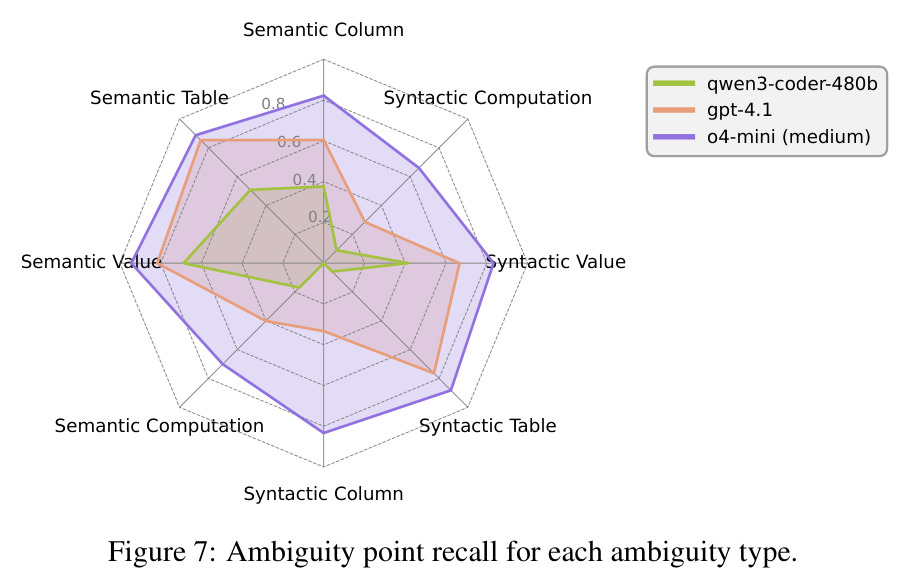
独立来看,论文有四个可攻击的弱点。第一,用户模拟器保真度:两阶段设计只缓解信息泄漏,但 LLM 用户对多选题的服从性、拒绝歧义点的倾向都与真人不同,“结构化优于对话式”的结论在真人实验中可能缩水——改进方向是把 NASA-TLX 小规模研究扩展为带成功率度量的真人对照实验。第二,误报歧义点缺乏过滤机制:交互面板会把系统想象出的歧义一并呈现,论文观察到模型会把“created pull requests”这类明确短语错误放宽成歧义——改进方向是引入基于数据库证据的置信度过滤,例如查询候选列的值分布来验证每个解释是否真的可行。第三,Perfect 消歧近乎全军覆没(最高仅 13.83%),主要源于过度碎片化和把全局约定当歧义——改进方向是把约定规范显式纳入训练目标,或训练专门的歧义检测头并与 SQL 生成解耦。第四,计算歧义识别在所有模型上最差(Figure 7),而聚合函数、逻辑运算符歧义恰是业务影响最大的类型——改进方向是构造针对性合成数据,或在后训练中加入 SQL 语义对齐任务。
未来方向
作者明确提出希望 ARCS 能催化歧义感知的 text-to-SQL 研究和更贴近真实用户工作流的交互范式。顺着这个方向有几条自然延伸。其一,把结构化消歧变成可训练目标:论文证明 $\Delta \mathrm{EX}$ 在所有模型上都是 -3.22 到 -29.26 个百分点,这提供了干净的奖励信号,可用于强化学习或偏好优化,让模型学会枚举解释、拒绝伪歧义。其二,把“识别而非回忆”的面板交互推广到其他结构化生成任务,如 API 调用参数、BI 看板配置、数据清洗规则——凡是输出空间被下游模式约束的场景都适用。其三,全局偏好个性化:论文把 argmax 平局、舍入等约定做成可配置规范,进一步可以学习每个用户或组织的历史选择,自动预热面板默认项,把交互成本压到接近零。其四,显式研究“宽表策略”:评分规则已允许一次返回所有解释的列,值得把“自动输出覆盖多解释的结果表”做成独立基线,探索何时优于逐点澄清。其五,用半自动标注管线把 101 题扩到千级规模,覆盖更多数据库方言与领域。
复现评估
复现基础相当好。数据侧:6 个数据库全部来自公开的 BIRD 和 Spider 2.0(转 SQLite 后 8.3 GB),项目页 megagonlabs.github.io/tabulaflow/research/arcs 已上线,标注指南和全部提示词(问题生成、用户模拟器、对齐评测)都写在附录 B 和附录 D 中。算力侧:所有开源模型用 Fireworks serverless API 推理,闭源模型用官方 API,温度设为 0,每任务成本仅 $0.0003 到 $0.15,学术实验室用数千美元预算即可复现主表 23 个模型的评测。主要障碍在标注环节:作者强调消歧标注需要语言学加数据库的双重专长,每题平均 2.5 小时且由作者亲自完成,第三方复现者难以低成本扩充数据,只能使用现成的 331 个任务实例;用户模拟器的采样随机性和用户意图分布也会带来端到端数字的波动。此外正文没有明确承诺开源评测代码仓库,需跟踪项目页的后续发布。总体评估:跑评测容易(依赖 API),扩展基准难(依赖专家标注)。
论文图表
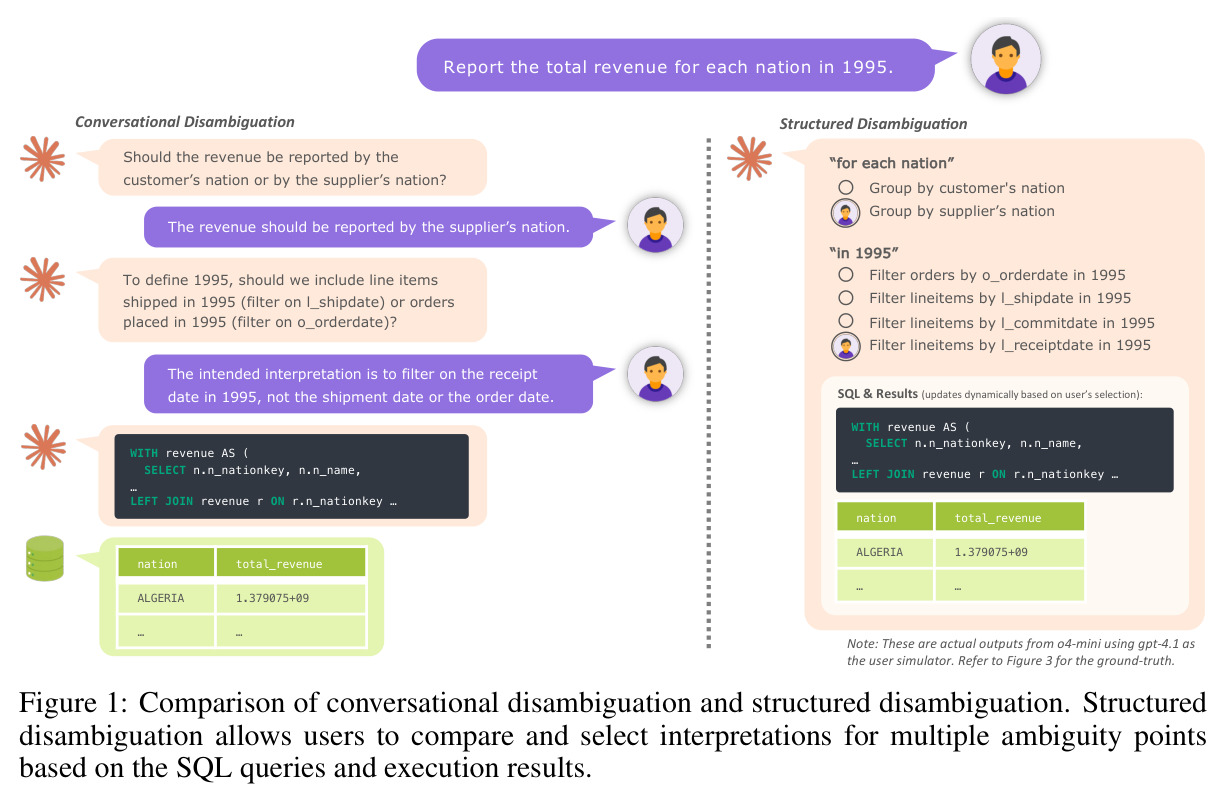
以 retails 数据库的“报告 1995 年每个国家的总收入”为例并排对比两种范式:左侧对话式需要用户用自然语言回答两轮澄清(按客户国还是供应商国分组、按哪个日期字段过滤 1995),右侧结构化把两个歧义点变成多选面板,用户点选后 SQL 与结果表即时更新。图中标注这是 o4-mini 配 gpt-4.1 模拟用户的真实输出。
这是全文方法动机的可视化宣言,一眼看清“回忆 vs 识别”的差异以及结构化界面如何降低用户负担,也是理解 Figure 5 定量对比的直观铺垫。