U-Space:揭示语言模型中不确定性的产生时机与根源 U-Space: Uncovering When and Why Uncertainty Arises in Language Models
用免训练的语义子空间 U-SPACE 定位并量化 LLM 推理中不确定性的来源
前置知识
残差流与 logit lens
Transformer 各层输出以增量形式累加在一条残差流上,最终层状态经 RMSNorm 增益 $\gamma$ 缩放后由 unembedding 矩阵 $W_U$ 映射为下一 token 分布。logit lens 把中间层状态直接套用同一套 unembedding,提前读出模型当下倾向的词汇,是无需训练即可观察内部状态的最简工具。
U-SPACE 的锚点拉回、逐 token 读出与 steering 全部发生在残差流上,理解这条语义主干道是读懂方法构造的前提。
J-LENS(Jacobian lens)
Gurnee 等人提出的透镜方法:对每层计算平均 Jacobian $\bar{J}_\ell = \mathbb{E}[\partial h_{L,t'} / \partial h_{\ell,t}]$,把中间残差状态线性化地映射进最终层表示空间,再用 unembedding 读出词汇倾向。相比 tuned lens 无需训练仿射解码器,只需一次平均雅可比估计,部分模型的工件已公开。
本文把词汇方向通过 $\bar{J}_\ell$ 拉回残差空间来构造 U-SPACE,U-LENS 的命名与机制都直接继承自 J-LENS。
不确定性量化与 AUROC/AUPRC/AURC
给每条模型输出打一个置信或风险分数,用于区分正确与错误答案。AUROC 衡量错误答案得分是否系统性更高,AUPRC 关注错误类上的精确率-召回权衡,AURC 总结按不确定性从高到低弃答时的风险曲线。length-controlled 版本按生成长度分十分位桶、桶内计算指标再按桶大小加权平均。
论文的全部结论都建立在这套指标及其长度控制版本上,尤其是控制长度后指标掉多少,是判断方法是否只学到长度捷径的关键诊断。
一阶与二阶不确定性
沿用 Fleming 与 Daw 的元认知框架:一阶不确定性体现在输出概率分布中,如逐步预测熵 $H_t = -\sum_{v \in V} p_t(v)\log p_t(v)$;二阶不确定性是模型对自身置信的可言语化表征,能以语义概念表达,且被证明与基于概率的置信度相互独立地预测弃答行为。
U-LENS 的核心主张是首次同时操作化两类信号:正锥对齐度 $A_{\mathrm{cone}}$ 对应二阶,推理迹平均预测熵 $\bar{H}(r)$ 对应一阶。
差异均值法与激活转向
差异均值法用两组反义样本隐状态的质心差 $\mathrm{norm}(\mu^+ - \mu^-)$ 构造概念方向,相减可消去两组共享成分、只留语义极性;激活转向则在推理时把该方向乘以剂量加回残差流 $\tilde{h} = h + \lambda\|h\|_2 u$,直接改变生成行为,可检验方向是否具有因果效力而非仅是相关。
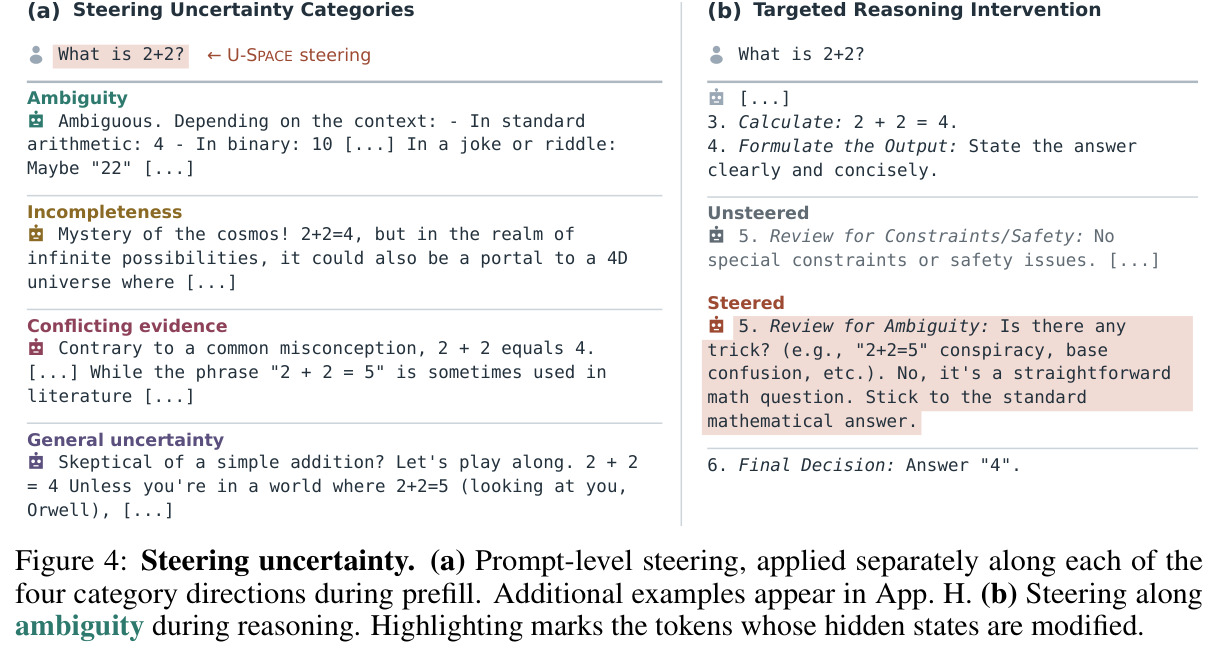
U-SPACE 基向量的构造与 Figure 4 的因果干预实验分别应用了这两个技术,是理解方法与 steering 结果的钥匙。
研究动机
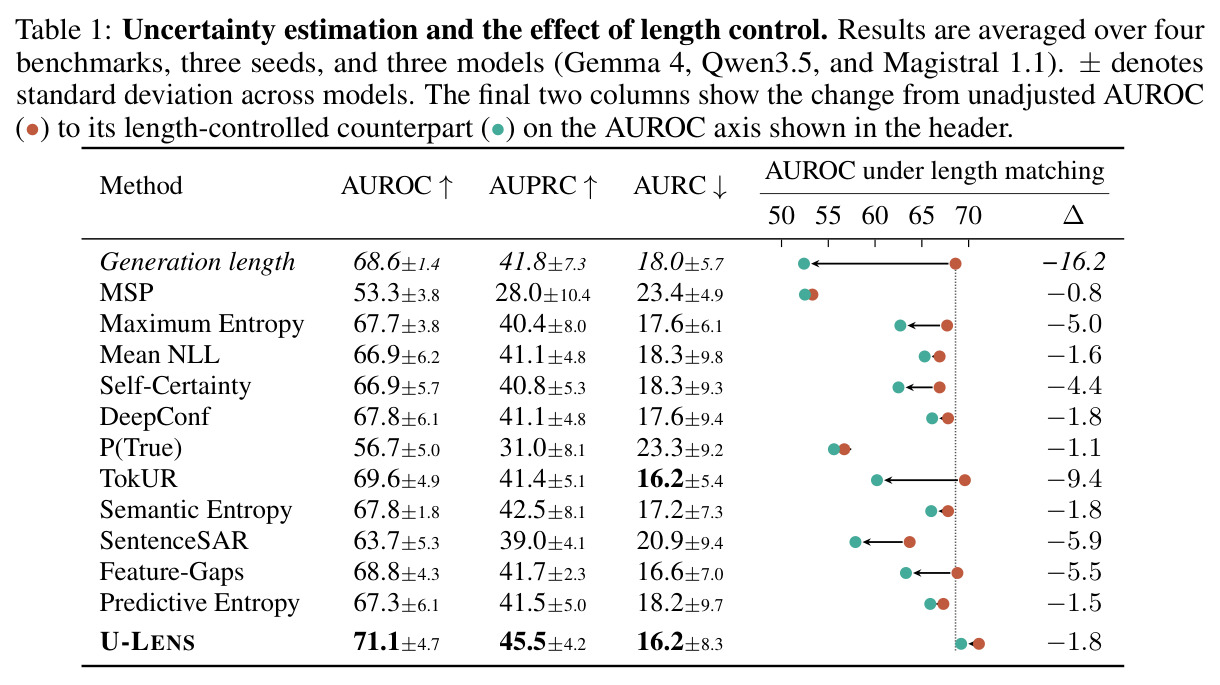
大模型正越来越多地参与高风险决策,但错误答案往往包装得流畅而权威,部署系统很难知道何时应把问题转交人类专家。现有不确定性量化方法短板明显:Semantic Entropy 需要采样 10 个答案并聚类语义等价类,P(True) 需要额外一轮自我评估,TokUR 需要五次前向传播(一次干净、四次权重扰动),推理成本高、工程复杂。更麻烦的是标量分数的黑箱性:它们只输出一个数字,无法告诉你不确定性产生在推理的哪一步、属于哪类原因,这对中间可能出错、最终却语气笃定的推理模型尤其危险。此外,生成长度与不确定性估计严重纠缠:论文数据显示,仅凭生成长度就能达到 68.6% 的 AUROC,几乎追平有监督的 Feature-Gaps(68.8%),只比五次采样的 TokUR(69.6%)低 1.0 个点,说明不少基线可能只是把答案长当作答案错的捷径。
本文的目标是本文的目标是构建一个无需训练、无需正确性标注、无需重复采样的不确定性估计器,同时回答模型有多不确定、以及不确定性何时以何种形式产生两个问题。具体而言,作者要在残差流中找到一组人类可理解的语义方向,覆盖歧义、信息不完整、证据冲突和一般性不确定这四类来源;用这些方向把每个推理 token 的隐状态映射成按类别分解的逐 token 不确定性图谱,再聚合出一个能与成熟基线竞争的迹级标量分数。评估上明确要求双重标准:既要在标准 AUROC/AUPRC/AURC 上超过既有方法,也要在按生成长度分桶的 length-controlled 评测下保持领先,证明捕捉的是真正的不确定性信息而非输出长度捷径。
与已有工作不同的是,论文的独特切入是把机制可解释性工具 J-LENS 引入不确定性量化,方向与常规读法相反:不问某个隐状态在说什么,而是把表达怀疑与确信的词汇方向通过平均 Jacobian 拉回残差空间,构造对比性的语义坐标轴。与在正确/错误标注上训练探针(如 Feature-Gaps)或用正确性监督训练时序分类器的路线本质不同,U-SPACE 的轴由语义锚点定义,天然可解释且免标签、跨任务可迁移。论文还首次把二阶(可言语化的)不确定性与一阶(分布性的预测熵)联合操作化为一个乘法分数,并用激活转向给出方向具有因果效力的证据,这是既有不确定性估计方法普遍缺乏的验证维度。
核心方法
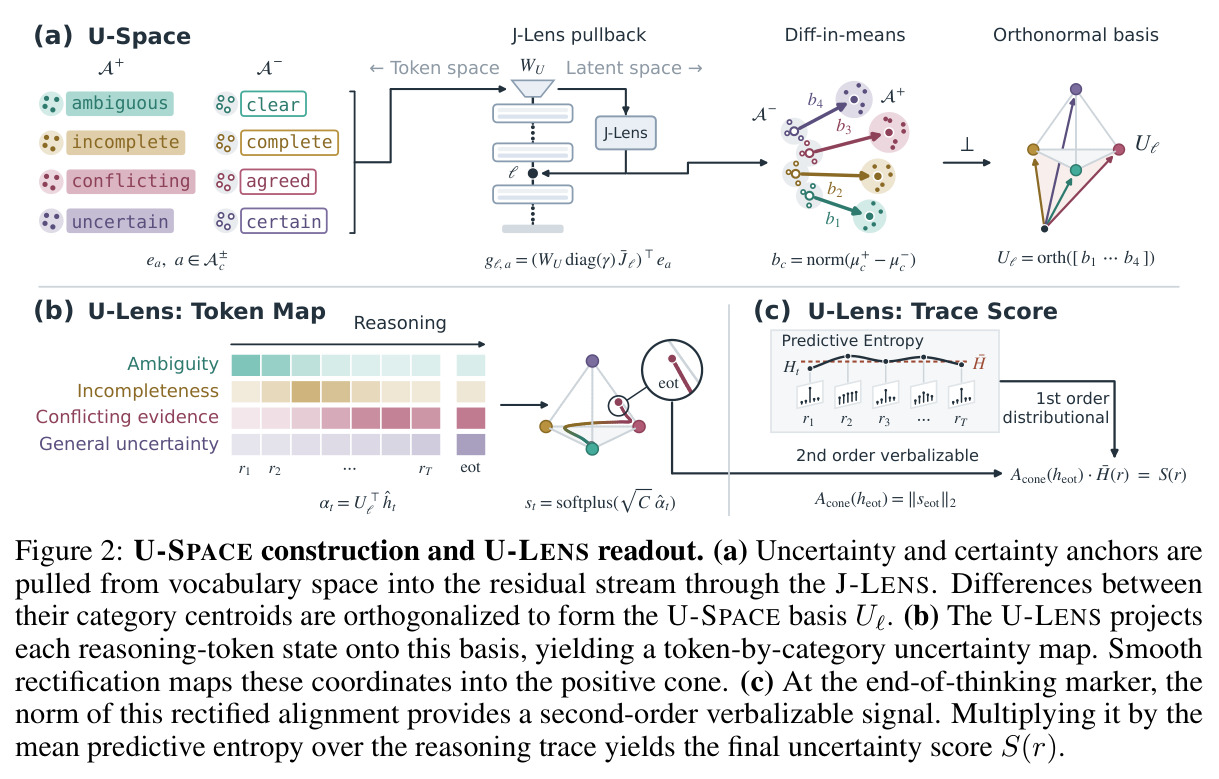
方法分两层:U-SPACE 是残差流中的一个四维正交子空间,基向量分别对应歧义、不完整、证据冲突、一般不确定四类不确定性;U-LENS 是把隐状态投影到该子空间的线性读出头。直觉上,模型词汇表中表达怀疑的词(如 ambiguous、incomplete、controversial、dubious)与表达确信的词(clear、complete、agreed、certain)在残差空间中应有稳定的对比方向;把这些方向经 J-LENS 的 Jacobian 从词汇空间拉回残差空间,做质心相减与正交化,即得到一组无需训练的不确定性坐标系。读出时,每个 token 的归一化隐状态投影得坐标 $\alpha_t = U^\top \mathrm{norm}(h_t)$,经 softplus 软整流聚合成正锥对齐度 $A_{\mathrm{cone}}$ 作为二阶可言语化信号,再乘以推理迹平均预测熵 $\bar{H}(r)$ 这一阶分布信号,得最终分数 $S(r) = A_{\mathrm{cone}}(h_{t_{eot}})\,\bar{H}(r)$。
核心创新有三点。第一,语义锚点的 Jacobian 拉回:词汇方向 $e_a$ 经 $g_{\ell,a} = (W_U\,\mathrm{diag}(\gamma)\,\bar{J}_\ell)^\top e_a$ 映射到第 $\ell$ 层残差空间,$W_U$ 是 unembedding 矩阵、$\gamma$ 是 RMSNorm 增益,无需任何梯度训练。第二,对比构造与正交化:每类用不确定与确信两组锚点的质心差 $\mathrm{norm}(\mu^+_{\ell,c}-\mu^-_{\ell,c})$ 消去共享分量,再正交化为 $U_\ell = B_\ell (B_\ell^\top B_\ell)^{-1/2}$,保证各坐标独立、可按份额解读。第三,正锥读出:以 $s_t = \mathrm{softplus}(\sqrt{C}\,\mathrm{norm}(\alpha_t))$ 软整流,某类负对齐不会抵消他类正对齐,四类被视为可共存的并列不确定性来源;在思考结束标记 $t_{eot}$ 处读锥体长度,天然获得固定位置、免池化的迹级汇总。全程零标签、零采样、零训练参数。
方法步骤详情
第一步,锚点:不确定词与确信词分别取自 Chen et al. (2018) 与 Rocklage et al. (2023) 的词典,剔除多 token 词后由轻量语义模型分入四类。第二步,拉回:按 J-LENS 把词汇方向 $e_a$ 送入第 $\ell$ 层残差空间;Magistral 1.1 按附录 A 自行估计平均雅可比。第三步,造基:极内质心相减归一化得类别方向,堆叠正交化为 $U_\ell$;读出层固定在约三分之二深度(Gemma 4 第 40、Qwen3.5 第 42、Magistral 1.1 第 27 层)。第四步,逐 token 读出:投影 $\alpha_t = U^\top \hat{h}_t$,软整流为非负类别分数后取范数,即锥体对齐 $A_{\mathrm{cone}}$。第五步,迹级打分:在思考结束标记 $t_{eot}$ 读 $A_{\mathrm{cone}}$,乘平均预测熵 $\bar{H}(r)$ 得 $S(r)$。第六步,干预:沿单类方向注入 $\tilde{h} = h + \lambda\|h\|_2 u_c$验证因果。
技术新颖性
与现有工作的本质区别有四。其一,相比 SelfCheckGPT、Semantic Entropy(10 次采样)、TokUR(5 次前向)等方法,U-LENS 只需一次生成加预先算好的透镜,边际推理成本近乎为零。其二,相比在正确性标签上训练的探针(Feature-Gaps)或正确性监督的时序分类器,锚点定义的方向无需任务标注;附录 D 还初步展示换一组 $A^\pm_c$ 即可把同一配方迁移到情绪分类与 reward hacking 检测,说明这是一套通用的语义性质子空间构造术。其三,首次以乘法 $S(r) = A_{\mathrm{cone}} \cdot \bar{H}$ 融合二阶可言语化与一阶分布不确定性,无需拟合相对尺度,且任一因子的全局正数缩放不改排序。其四,不止于读出:steering 实验让模型对 2+2 都产生怀疑,提供了方向塑造行为的因果证据;对比探针式方法只能给相关性。
实验结果
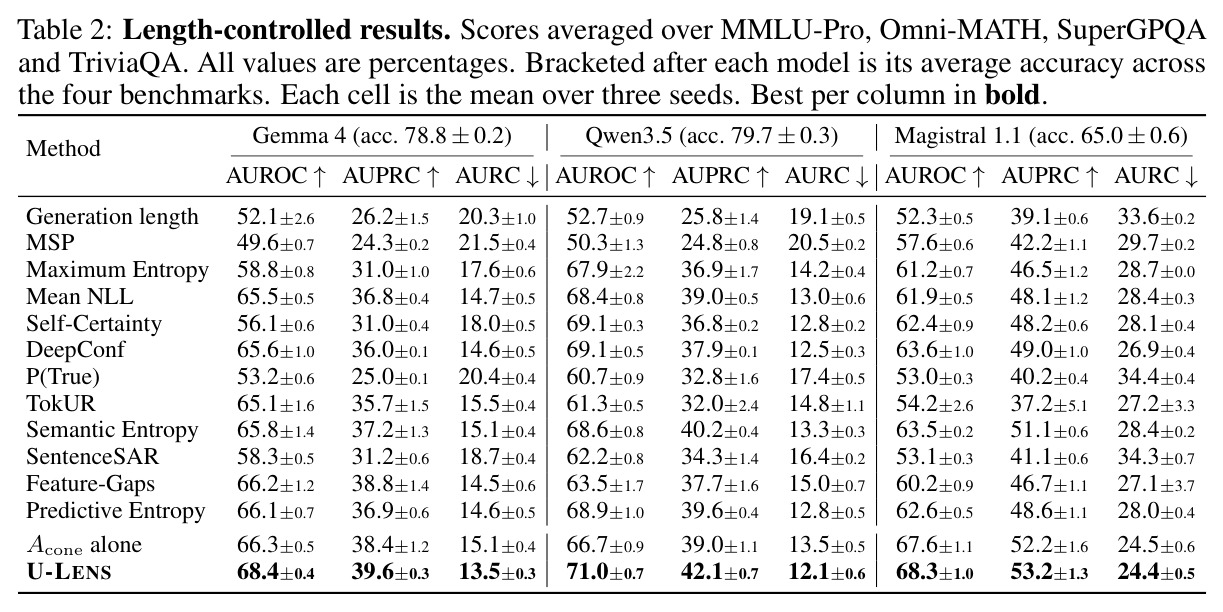
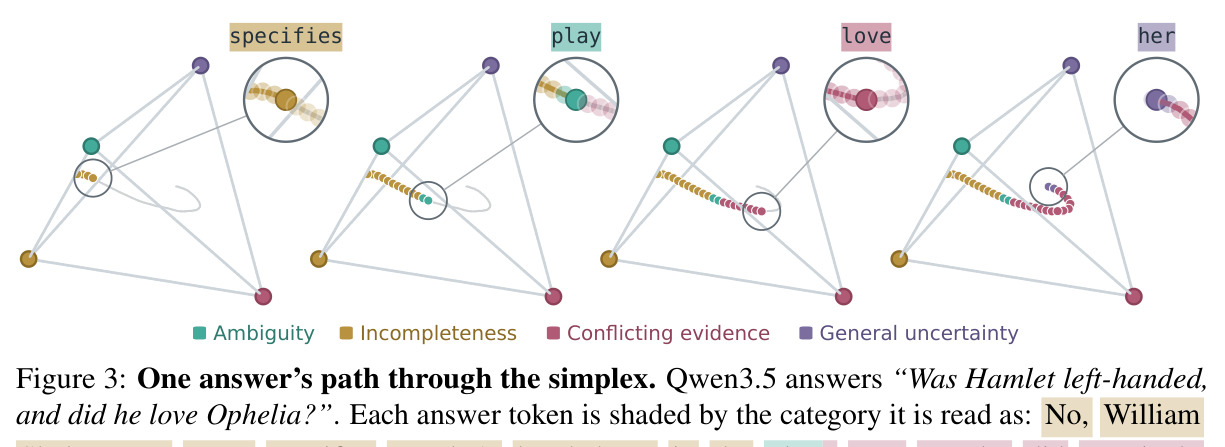
结果分三层。第一,标准评测(Table 1):U-LENS 得 71.1±4.7 AUROC、45.5±4.2 AUPRC、16.2±8.3 AURC,比最强传统基线 TokUR(69.6)高 1.5 点,AUPRC 比 Semantic Entropy(42.5)高 3.0 点。第二,长度控制最关键:生成长度从 68.6 跌至 52.4(−16.2),TokUR 跌 9.4、Feature-Gaps 跌 5.5,U-LENS 仅降 1.8 仍居首。分模型(Table 2)U-LENS 九项模型×指标全部第一:Gemma 4(acc 78.8%)68.4/39.6/13.5,Qwen3.5(79.7%)71.0/42.1/12.1,Magistral 1.1(65.0%)68.3/53.2/24.4,较各自最强基线 AUROC 提升 2.2、1.9、4.7 点。第三,可解释与因果:Figure 3 中 Qwen3.5 答哈姆雷特问题时逐 token 读数从不完整、歧义、证据冲突演化到一般不确定;Figure 4 中沿歧义方向 steering 让模型对 2+2 起疑。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 四基准平均标准评测(MMLU-Pro、Omni-MATH、SuperGPQA、TriviaQA,各 1000 题) | AUROC(越高越好) | 71.1±4.7 | TokUR 69.6±4.9(五次前向);有监督 Feature-Gaps 68.8±4.3 | +1.5,且无需重复采样与正确性标注 |
| 长度控制评测(十分位长度分桶,跨模型平均) | AUROC | 约 69.3(自 71.1 仅降 1.8) | 生成长度 52.4(暴跌 16.2);TokUR 约 60.2(跌 9.4);Feature-Gaps 约 63.3(跌 5.5) | 唯一跌幅小于 2 点且保持第一的方法 |
| Gemma 4 长度控制(acc 78.8%) | AUROC / AUPRC / AURC | 68.4±0.4 / 39.6±0.3 / 13.5±0.3 | 最强基线 Feature-Gaps:66.2 AUROC / 38.8 AUPRC / 14.5 AURC | +2.2 AUROC / +0.8 AUPRC / −1.0 AURC |
| Qwen3.5 长度控制(acc 79.7%) | AUROC / AUPRC / AURC | 71.0±0.7 / 42.1±0.7 / 12.1±0.6 | Self-Certainty 与 DeepConf:69.1 AUROC;Semantic Entropy:40.2 AUPRC / 13.3 AURC | +1.9 AUROC / +1.9 AUPRC / −1.2 AURC |
| Magistral 1.1 长度控制(acc 65.0%) | AUROC / AUPRC / AURC | 68.3±1.0 / 53.2±1.3 / 24.4±0.5 | DeepConf:63.6 AUROC / 49.0 AUPRC / 26.9 AURC;消融 Acone alone:67.6 AUROC | +4.7 AUROC / +4.2 AUPRC / −2.5 AURC |
局限与改进
局限方面:作者承认四类分类学并非详尽,只是能摆成三维单纯形的紧凑表达;方法依赖 J-LENS 的 Jacobian,目前仅部分模型公开透镜工件,Magistral 1.1 需自行拟合,限制了即插即用范围;伦理声明中也强调该读数不是经过校准的安全检测器,且 steering 能力有被滥用于削弱模型自信的风险。我的补充观察:其一,锚点词表来自英文不确定性/情感词典,跨语言与多语模型上的有效性未验证;其二,迹级分数绑定思考结束标记 $t_{eot}$,对无显式思考段的非推理模型需改造;其三,每基准仅抽 1000 题、每题采样一条回答,统计功效有限;其四,长度十分位分桶只控制了长度本身,题目难度与长度的残余相关未完全排除;其五,分数在训练分布外(新领域、对抗输入)的稳定性未有报告。
独立分析的弱点
独立分析出的弱点:第一,锚点到类别的绑定靠轻量语义模型自动分类,一旦分错会直接污染对应基方向,论文未报告该分类的准确率或敏感性分析,改进方向是人工校验或做聚类稳定性消融。第二,乘法组合 $S = A_{\mathrm{cone}} \cdot \bar{H}$ 虽免调参,但隐含两信号同向有效;Table 2 显示 Gemma 4 上两分量各有所长、Magistral 1.1 上 $A_{\mathrm{cone}}$ 单独已达 67.6 AUROC,说明不同模型的最优混合不同,可为每模型学一个标定权重而不破坏免训练性质。第三,正锥读出丢弃负对齐信息,某 token 明确远离所有不确定类别(即高置信)的证据没有被单独利用,可增设确定性轴。第四,steering 剂量 $\lambda$ 以状态自身范数为单位,跨模型可比仍需人工搜索,缺乏自动剂量选择准则。第五,评估集中于多项选择与短答案任务,长文本生成、代码等开放式场景的不确定性定位尚未验证。
未来方向
作者指出的延伸:同一免标签构造换锚点即可用于情绪分类与 reward hacking 检测,暗示语义性质子空间是一类通用工具;更广的方向包括把 U-SPACE 读数接入选择性预测与弃答策略,做成本感知的人机转交决策;追踪不确定性跨层演化(目前固定在约三分之二深度);在多轮对话与工具调用场景中定位信任崩塌点;把 steering 反向用于提升校准,例如抑制虚假自信。基于本文成果还可延伸:用 U-SPACE 坐标作为奖励塑形信号,在强化学习中训练模型表达校准的不确定性;构建多语言锚点检验多语模型的语义一致性;把逐 token 类别图谱发展为高风险领域的审计工具,自动生成错误归因报告;以及将四维基扩展为可增长的类别库,覆盖来源可靠性、时间敏感性等更多不确定性成因。
复现评估
复现条件较好:代码在 https://github.com/s2labres/U-Space 开源,提供锁定的 requirements.txt 与一键 run.sh 全流水线,可直接复现主结果 Table 2 与 Table 12;Gemma 4 与 Qwen3.5 的 J-LENS Jacobian 工件在 huggingface.co/neuronpedia/jacobian-lens 公开,Magistral 1.1 需按附录 A 用无标注通用提示自行拟合;三个模型 Gemma-4-31B-it、Qwen3.5-27B、Magistral-Small-2507 均为开放权重,四个基准公开且每基准做种子化分层抽样 1000 题。主要门槛在算力:27 到 31B 级推理模型的全量推理与 Jacobian 估计通常需要多卡 A100/H100 环境;锚点词表与类别划分细节在附录 B,中等规模实验室即可复现,难度评级为中等。
论文图表
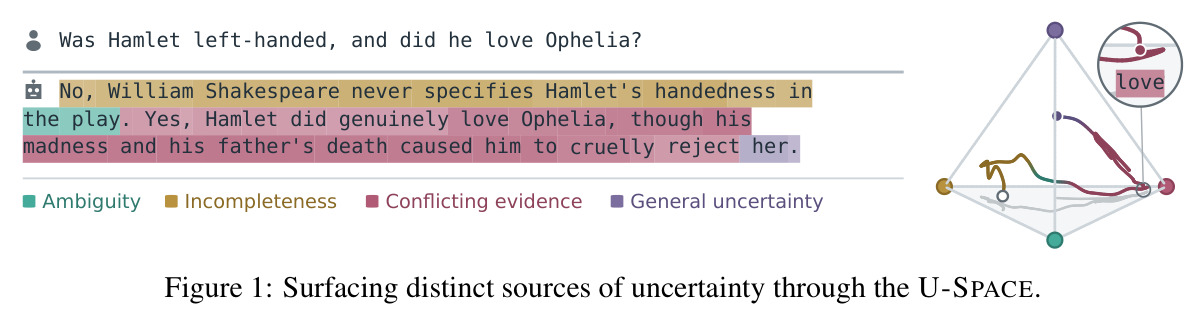
以哈姆雷特问题(Was Hamlet left-handed, and did he love Ophelia?)为例,展示模型的一段回答,并用四种颜色标注不同 token 被读出的不确定性类别:歧义、不完整、证据冲突、一般不确定,四类构成三维单纯形的顶点。
开篇即给出方法的直观样貌:不确定性不是单一标量,而是可分解为语义类别、随 token 演化的信号。理解这张图就理解了论文要解决的核心叙事,即何时与为何不确定。