人类第六感:多模态模型直觉视觉推理基准 Humanity's Sixth Sense: Benchmarking Intuitive Visual Reasoning in Multimodal Models
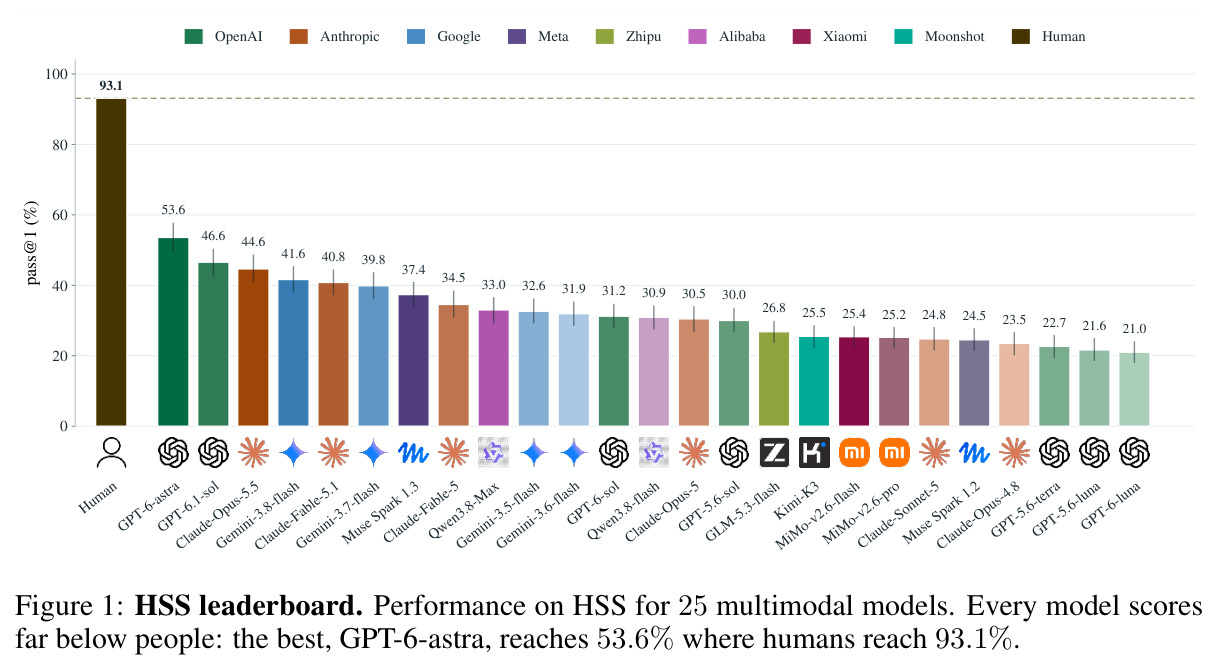
HSS基准显示最强模型直觉视觉推理仅53.6%,远低于人类的93.1%
前置知识
MLLM(多模态大语言模型)
统一接收文本与图像/视频输入并生成文本输出的大模型,通常由视觉编码器(把图像切成 patch 编码成向量序列)加语言模型骨干构成。视频输入要么原生送入(原生视频 token),要么按固定帧率抽成关键帧序列再当作多张图处理。
HSS 的评测对象就是 25 个前沿 MLLM,理解它们如何吃进图像/视频(原生视频 vs 抽帧、分辨率上限)是读懂实验设置与帧预算消融的前提。
pass@1
源自代码生成评估的指标:单次采样即解决问题的概率。本文中每题尝试 $A_i=3$ 次,一次尝试只有当人类撰写的全部 $k_i$ 条原子评分准则都被判为满足($c_i^a=\mathbb{1}[\sum_j v_{ij}^a=k_i]$)才算通过,再对全部任务取平均。
HSS 的所有数字都是 pass@1,且采用『全对才算过』的严格判定,理解这一点才能正确解读 53.6% vs 93.1% 的差距含义。
LLM-as-a-judge 与评分准则(rubric)
开放式自由回答无法用字符串匹配打分,于是用另一个强模型当裁判:把问题、人类参考答案、若干条可独立判定的原子准则和候选回答一起给裁判,逐条输出 met/unmet 及一句话理由。主要风险是裁判自身偏见(如自我偏好)。
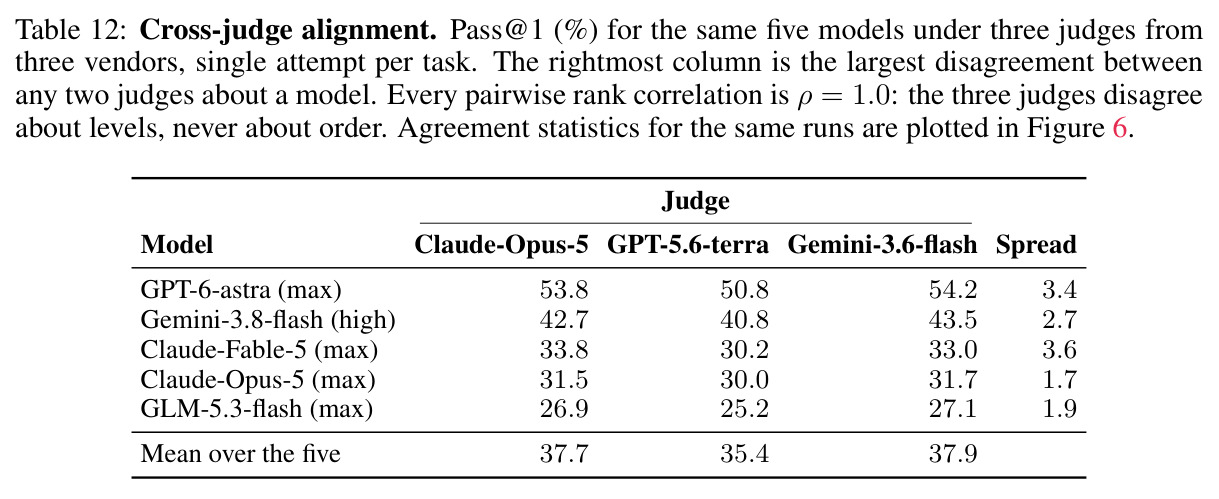
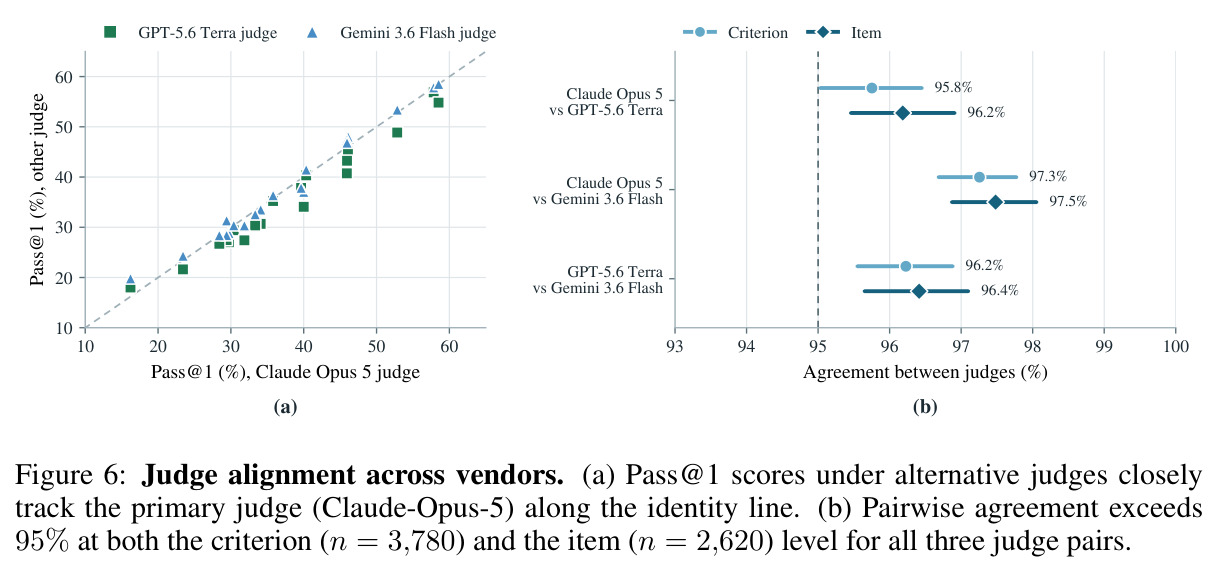
HSS 全部由 Claude-Opus-5 判分,论文专门用三家裁判交叉验证($\kappa\ge 0.92$、自我偏好 −0.44 点不可检出)来保证分数可信,这是评估本文结论效度的关键。
推理努力与测试时计算
推理模型可以在回答前先生成大量『思考 token』做链式推理,厂商通常提供 low/medium/high/xhigh/max 等努力档位。增加测试时计算是当前提升难基准成绩的主流手段。
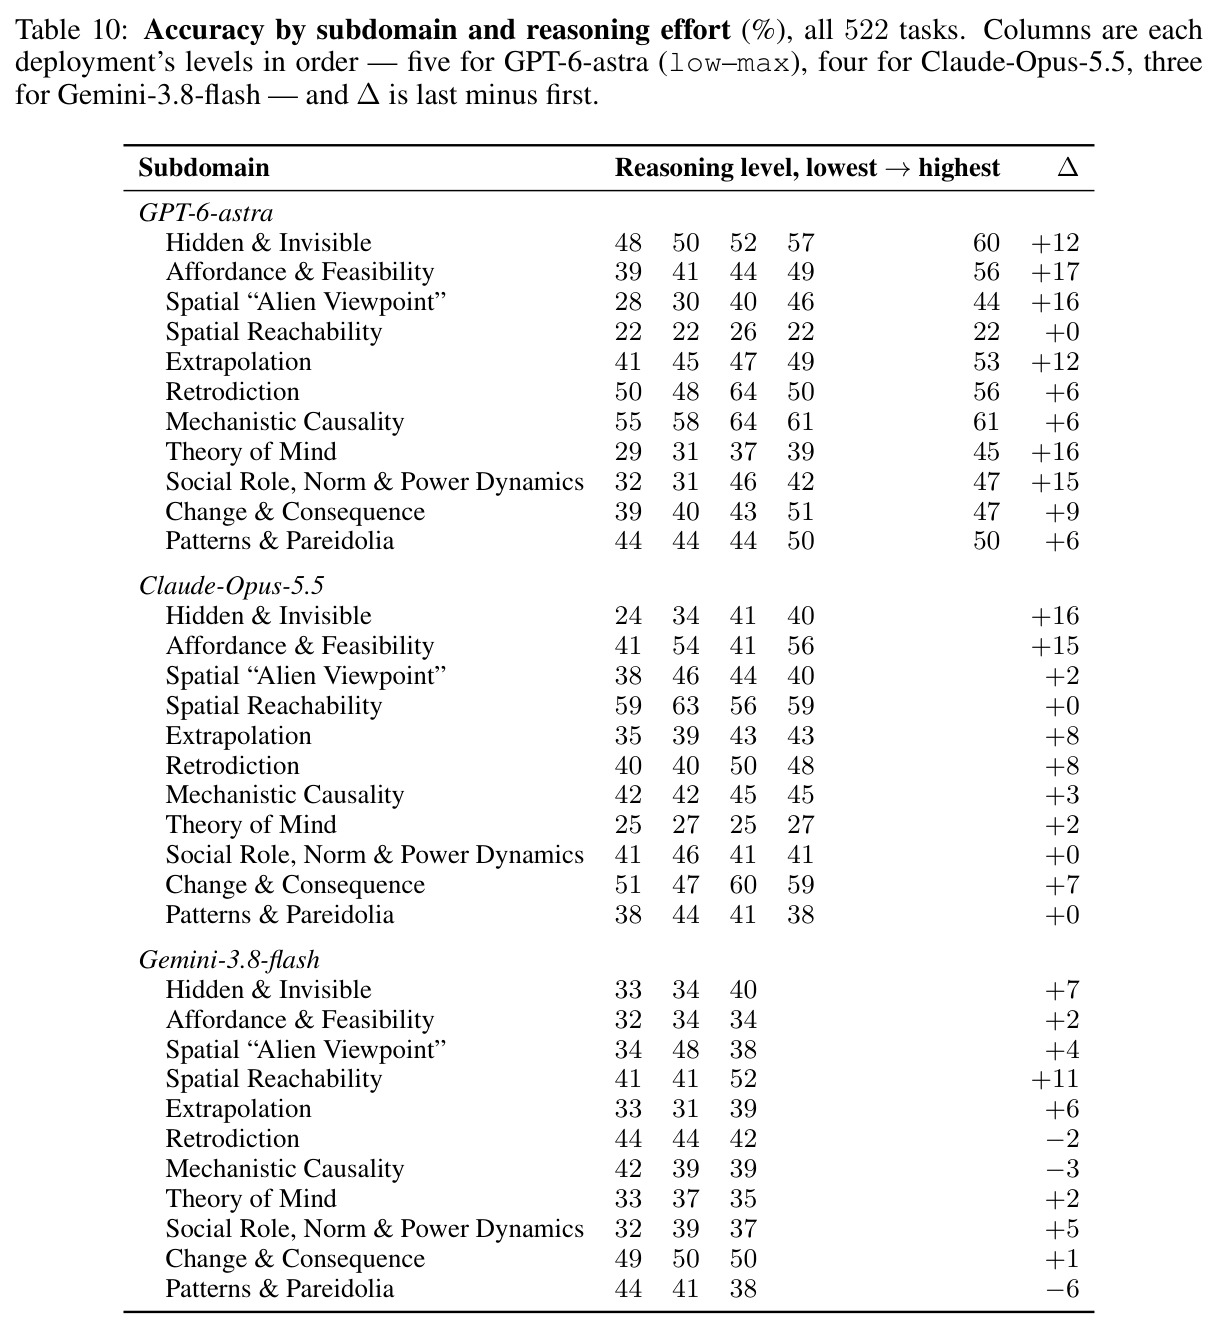
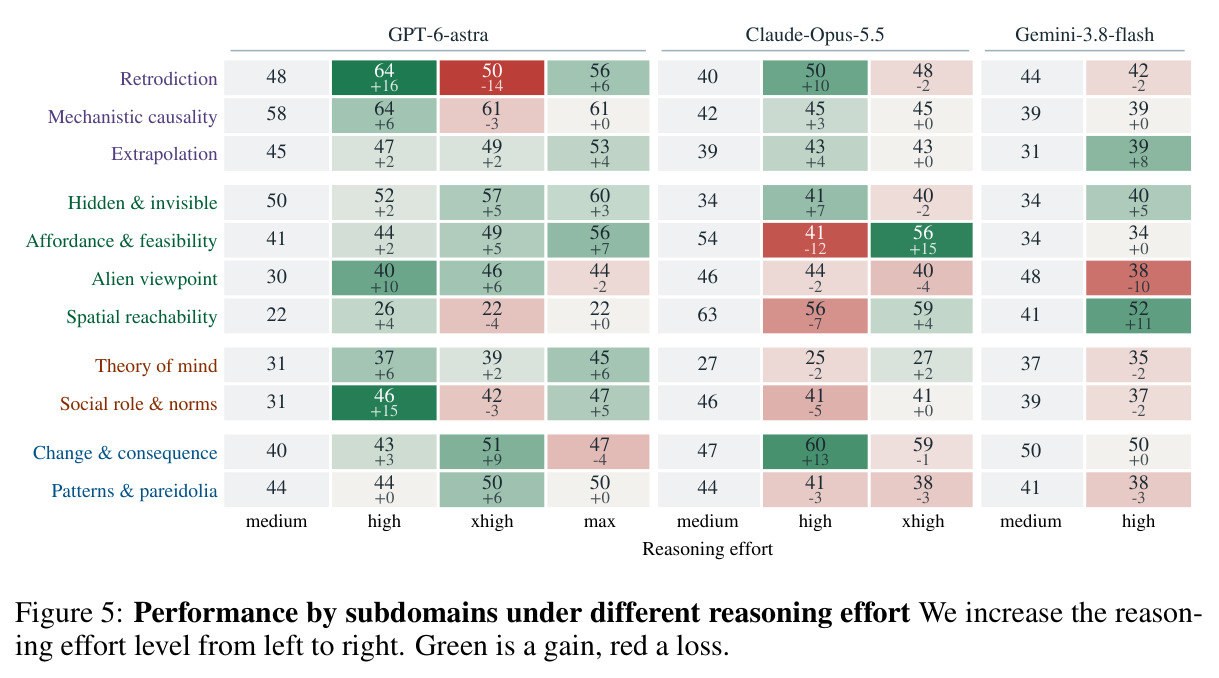
论文的核心反直觉发现之一是:提高推理努力对 HSS 帮助有限甚至有害(如 GPT-6-astra 在 Retrodiction 子域从 high 到 xhigh 掉 14 点),说明直觉推理不靠深思获得——这正是与人类『系统 1』的类比。
智能体工具循环(agentic harness)
把模型放进一个循环里,允许它调用工具后多轮迭代:对图像裁剪放大、对视频抽帧/重采样/拼接触点表(contact sheet)、写中间推理,直到主动决定提交最终答案,如 Claude Code、Codex。
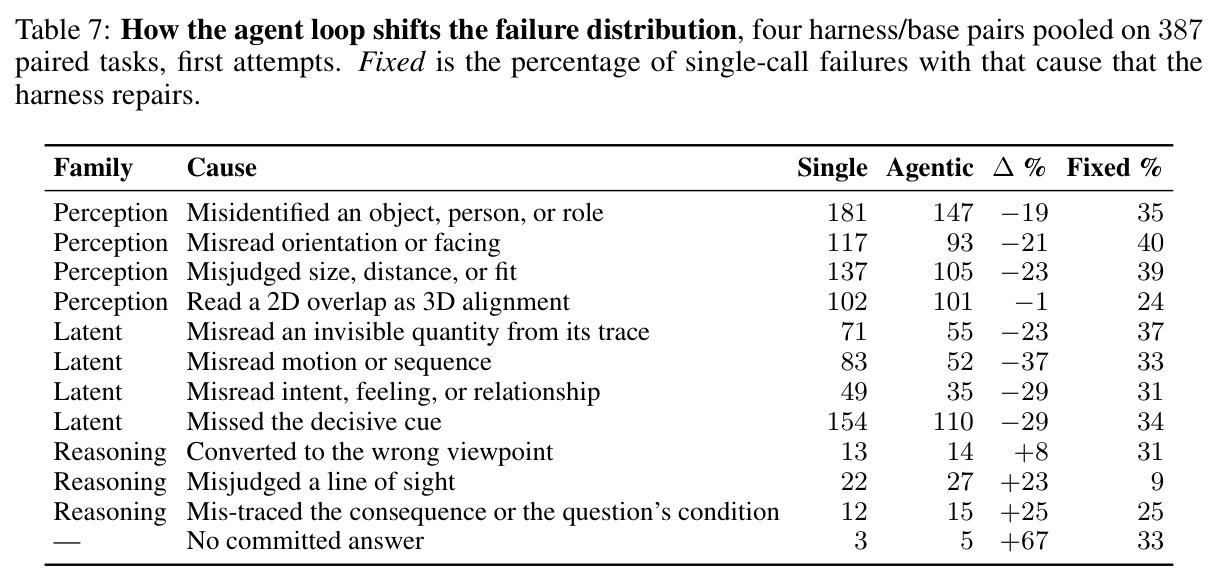
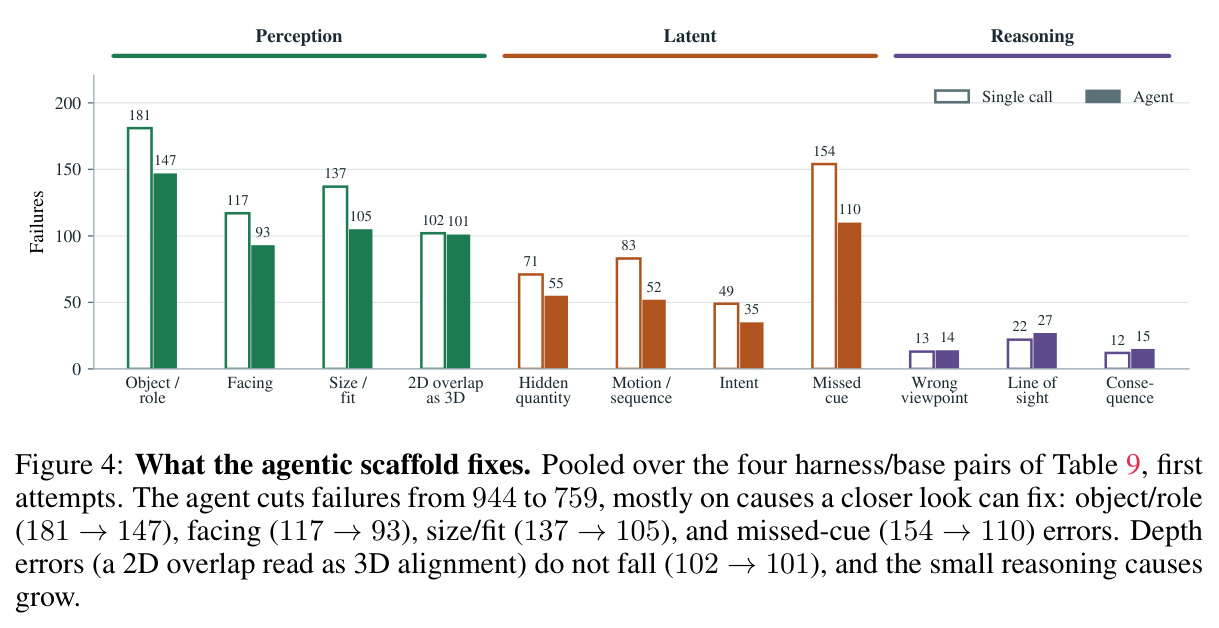
论文用智能体条件做诊断:如果失败源于『没看清』,主动再看应能修复;实验显示修复了感知类错误却修不掉 2D 重叠误读为 3D 的深度错误,直接支撑了『HSS 测的不是感知』的论点。
心智理论(Theory of Mind)
推断他人信念、意图、情绪与知识盲区的能力,即『读心』。认知科学中通过虚假信念任务等范式研究,是人类社会交互的基础,被认为是快速、自动的心理化过程。
ToM 是 HSS 社会理解域的两个子域之一(51 题,其中 46 题为视频),也是模型表现最差的能力区之一,理解这一概念才能明白模型在社会理解上平均仅 24.4% 意味着什么。
研究动机
现有视觉基准分成两大家族,但都测不到『直觉推理』这层能力。第一类把图像当作学术题的包装,如 MMMU、MathVista、Humanity's Last Exam:图像提供显式已知条件,难点在符号推理链,理论上把图完整转写成文字后题目依然成立。第二类测感知敏锐度,如 V*、MMBench、Video-MME/Video-MME-v2、BLINK:答案就在画面里,比拼的是找得准、跟得住。而人类在约 150ms 内即可完成自然场景分类,并毫不费力地推断隐含的物理动力、他人意图与社会结构。文本侧的 SimpleBench 已经证明前沿模型在常识性时空与社会推理上大幅落后人类;视觉侧最接近的 BabyVision 测的是『模型能否感知显式存在的东西』,而真实场景承载着大量从未明说的信息——人际张力、潜在意图、物理可供性、即将发生的后果。已有的物理/社会智能探针(VCR、IntPhys、Physion、SocialIQa、MMToM-QA 等)则各自碎片化、高度依赖合成场景,且多采用选择题格式,模型可以靠排除法蒙对而非真正的视觉推断。
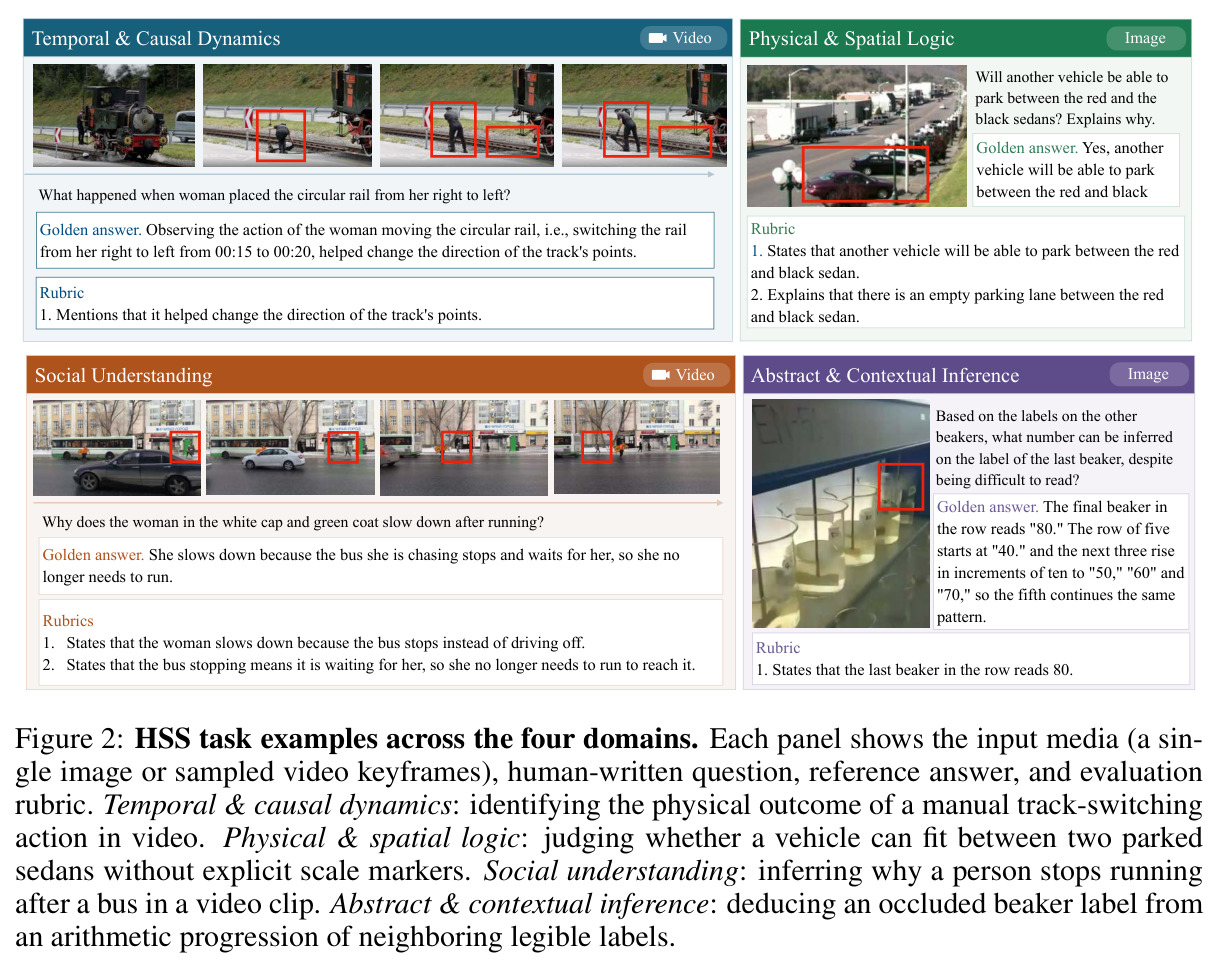
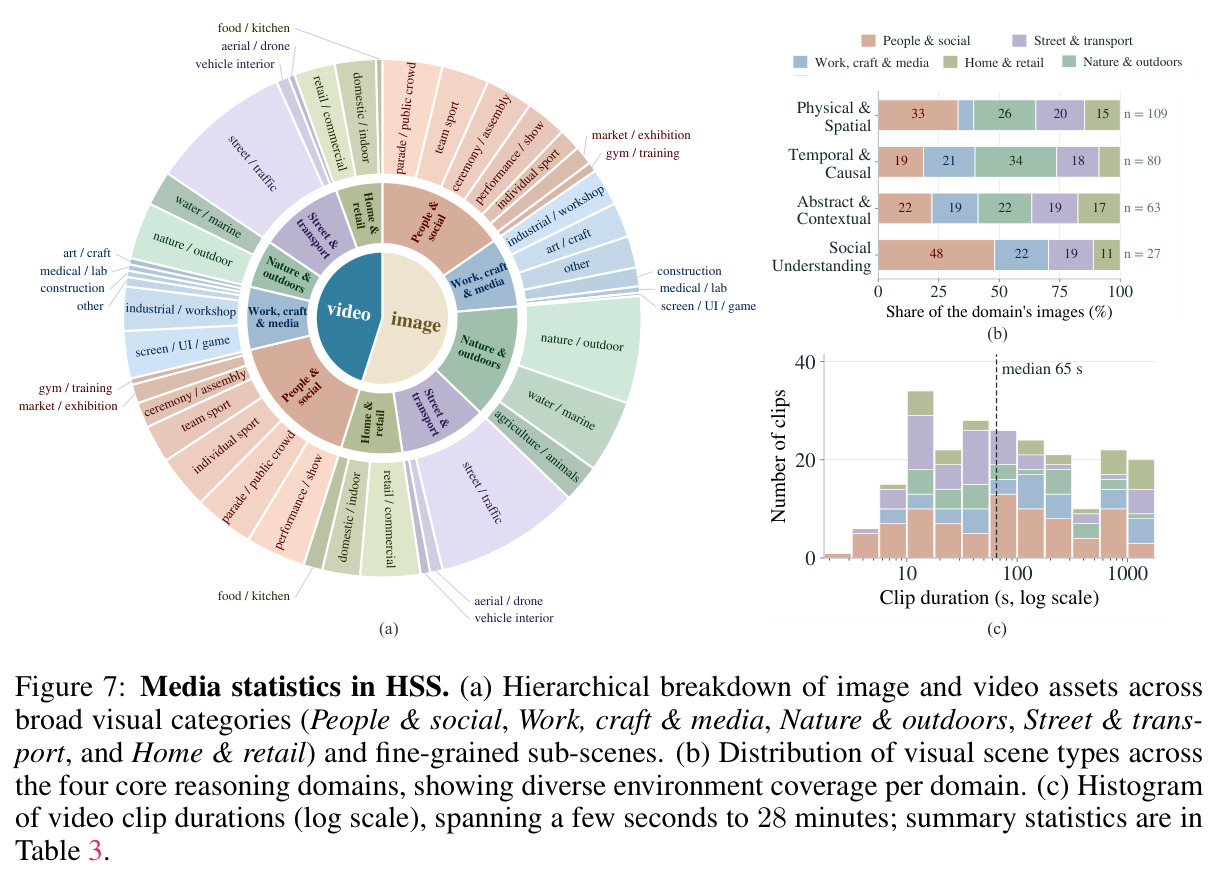
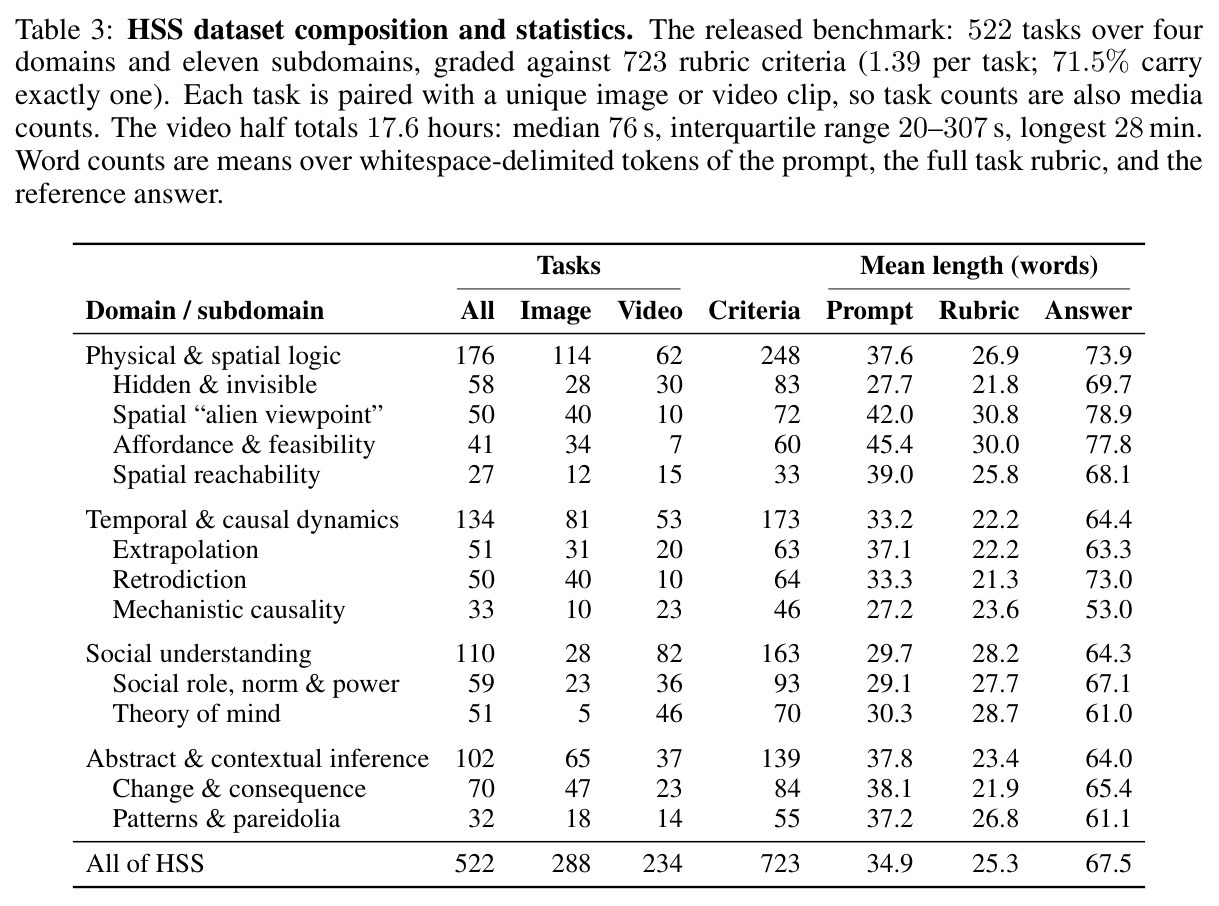
本文的目标是论文要构建 HSS(Humanity's Sixth Sense)基准,把『直觉视觉推理』——介于原始感知与刻意逐步逻辑之间的那层快速推断——变成可测量、可诊断的独立能力轴。具体目标包括:给出一个扎根认知科学的形式化分类学(四大域、11 个子域);建成一个由人类撰写、经多轮独立审校达成严格共识的基准(最终 522 题:288 张图、234 段视频共 17.6 小时,配 723 条原子评分准则);用开放式自由回答加逐条判分替代选择题,杜绝排除法作弊;在此之上系统评测 25 个前沿 MLLM,并检验测试时算力扩展、推理努力档位与智能体工具循环能否缩小人机差距。
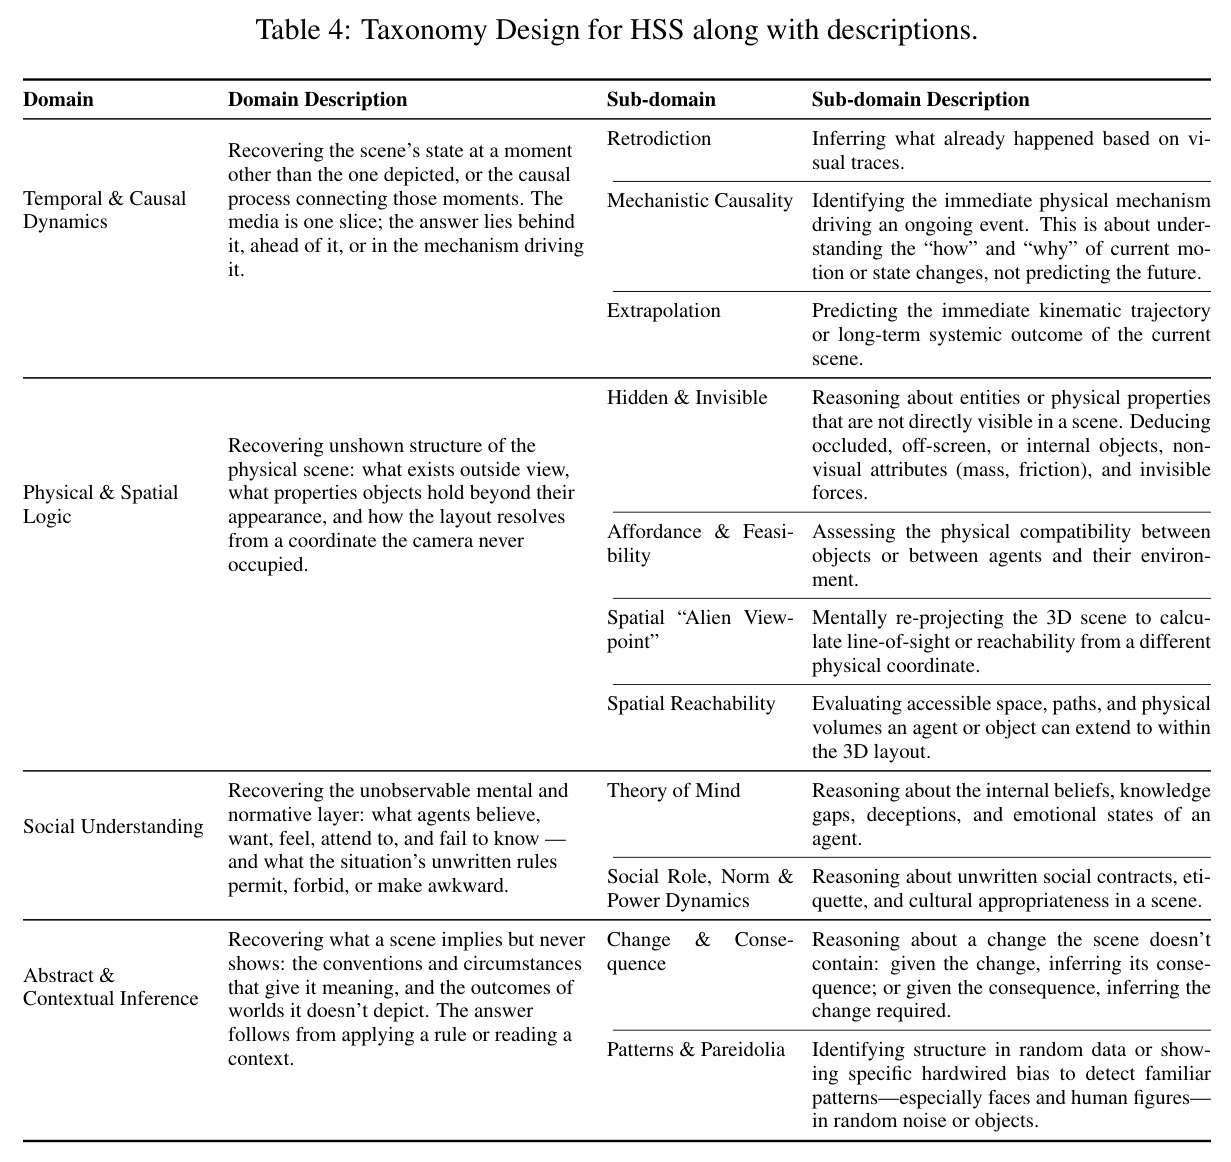
与已有工作不同的是,本文的独特切入是反着设计准入标准:其他基准怕题目太简单,HSS 专收『看多久都看不出答案、但人瞟一眼就知道』的题。三条铁律把直觉操作化——凡高清局部裁剪就能让答案显而易见的纯感知题一律丢弃;凡需要符号计算、学术或行业专业知识的题一律丢弃;凡问题或标准答案存在人类分歧、无法达成全票共识的题一律丢弃。这与 VCR/Sherlock 等接受『合理』续写的前作有本质区别:HSS 只收答案『被迫唯一』的题,这才使开放式评分成为可能。分类学上它把认知科学三个经典模块(Spelke 的物体与空间核心知识、Battaglia 的直觉物理、Baker 的心理化)整合为时间因果、物理空间、社会理解三域,再外加一个抽象规则域,形成统一的单一准入门下覆盖自然媒体的多维诊断框架。
核心方法
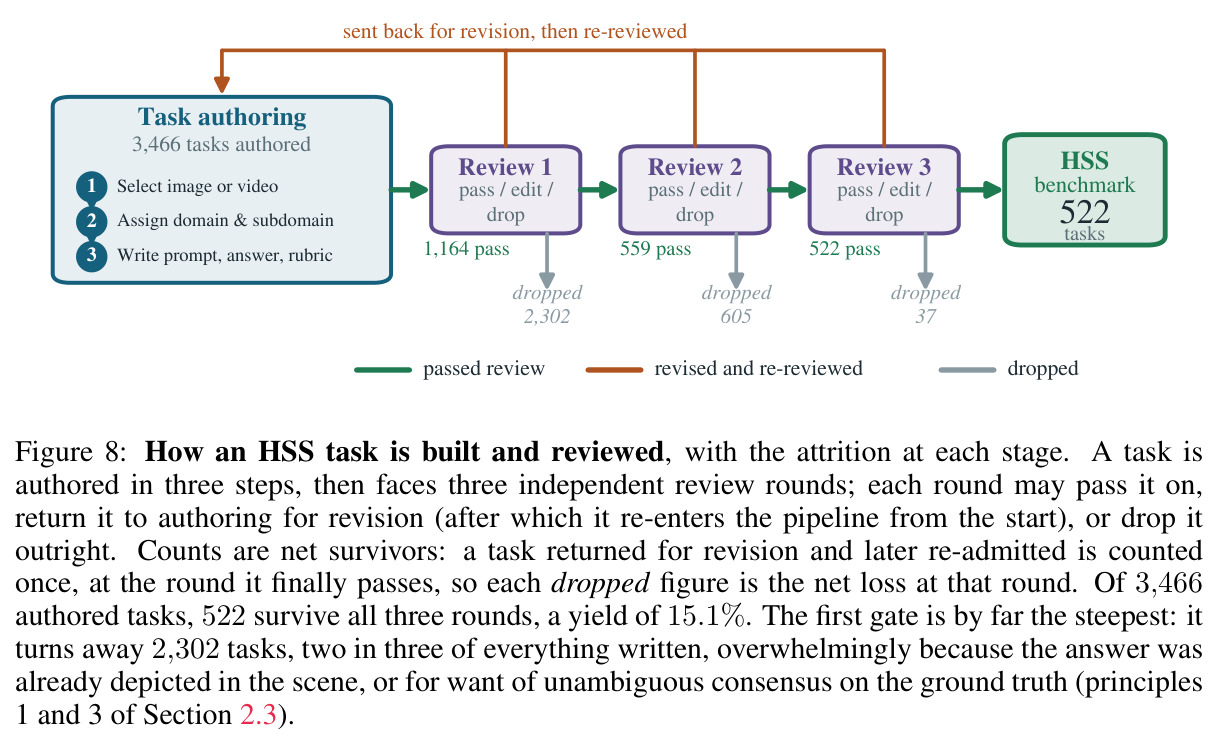
先说直觉:HSS 的每道题都像一个人类『第六感』测试——看一张图或一段视频,回答一个任何专注的成年人都能凭画面加日常经验立即答出的问题,比如『穿绿外套的女人为什么放慢了脚步』(因为追的公交车停下来等她了),而答案所需的信息从未直接出现在像素里。技术路线:每个实例是四元组 $(m, q, g, R)$——视觉媒体 $m$、自然语言问题 $q$、人类撰写的参考答案 $g$、原子评分准则集 $R=\{r_1,\dots,r_k\}$。标注员从授权媒体池选材、按分类学归类、撰写问题与答案并把答案分解为可独立判定的准则;随后经过三轮独立审校(Pass/Edit/Drop 三种裁决,Edit 打回重写后须从头再审),只有三轮全票通过才入库。评测时模型自由作答,Claude-Opus-5 担任裁判,对每条准则给出判定,全部 $k$ 条满足才算解出:$c_i^a = \mathbb{1}[\sum_{j=1}^{k_i} v_{ij}^a = k_i]$,pass@1 为 $\frac{1}{n}\sum_i \frac{1}{A_i}\sum_a c_i^a$。
核心创新在于把『直觉』这个模糊概念变成硬性的工程筛选标准。认知科学把直觉定义为快速、自动、基于日常经验、难以言传的判断,HSS 据此立下三条设计原则:其一,排除纯感知——如果目标区域的高分辨率裁剪能让答案一目了然,那测的是视力而非直觉;其二,排除专业特长——禁止任何需要符号运算、学术训练或小众职业知识的题目,确保测的是普通成年人的常识视觉直觉;其三,严格人类共识——问题与目标答案必须无歧义,只有独立审校者全票同意标准答案的题才被收录。与已有工作的本质区别有两点:一是准入判据从『答案在画面里找得到』(感知类基准)或『图可转写为文字』(学术类基准)反转为『答案根本不在画面里,但人类一看便知』;二是只收『被迫唯一』而非『合理即可』的答案,使开放式评分摆脱了多选题排除法与合理续写评分的主观性。85% 的淘汰率本身就是质量的来源。
方法步骤详情
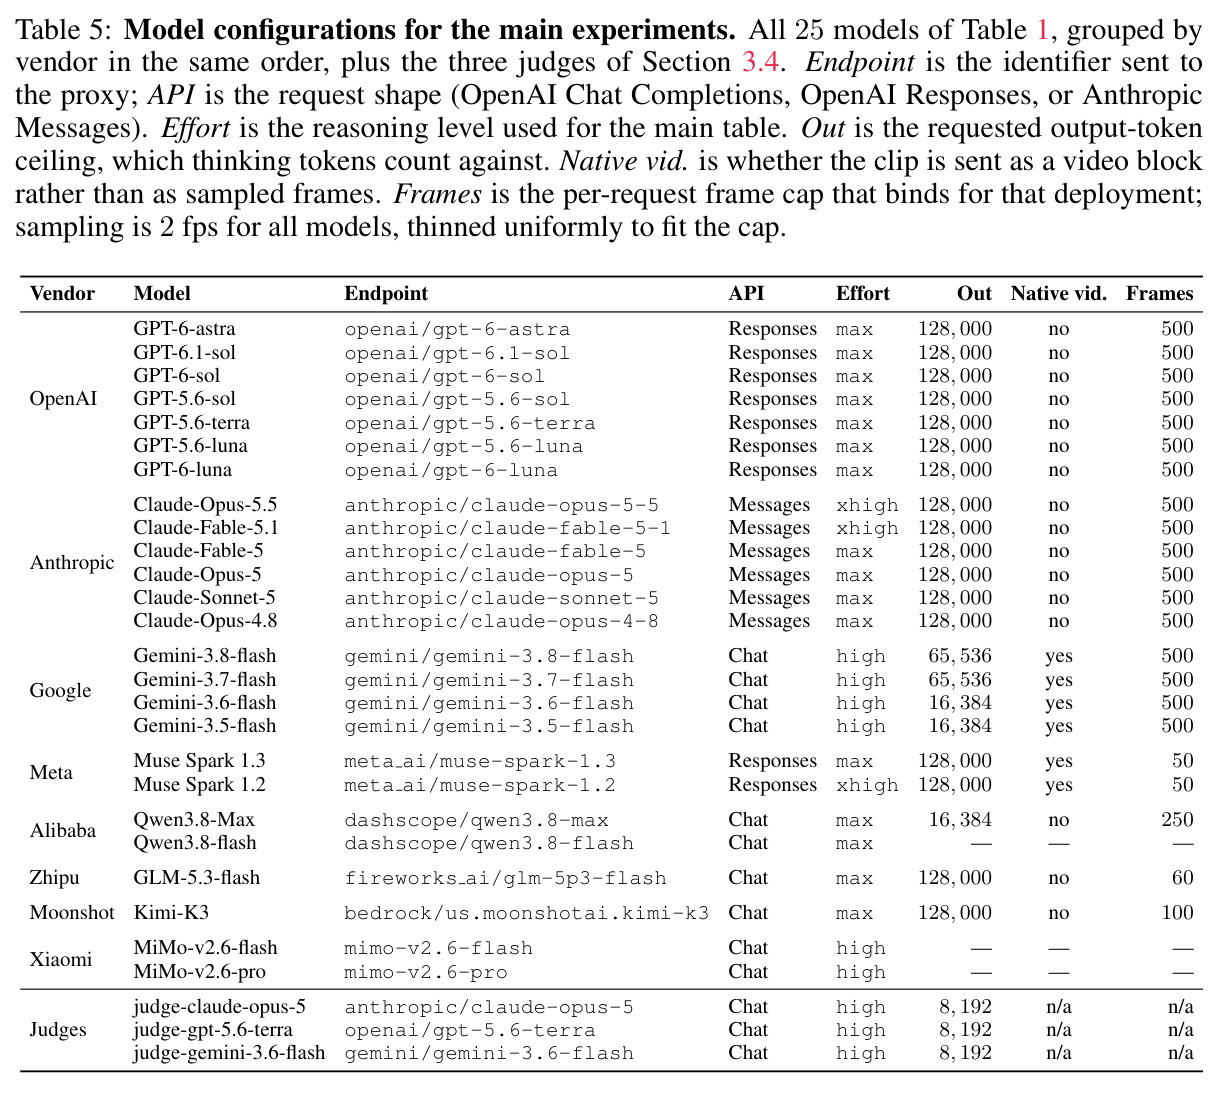
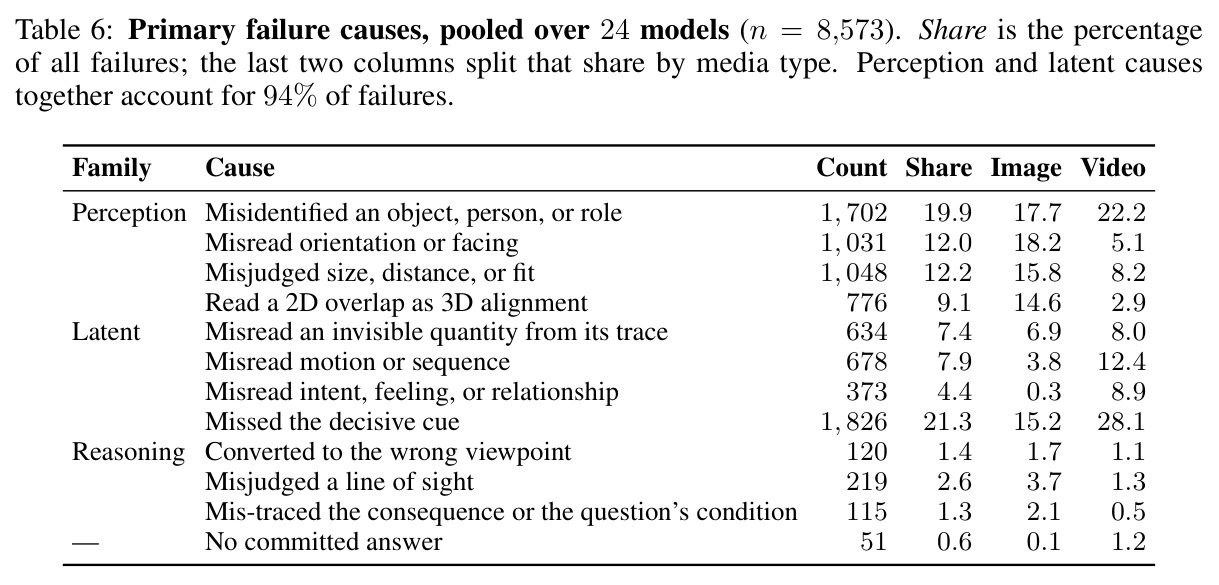
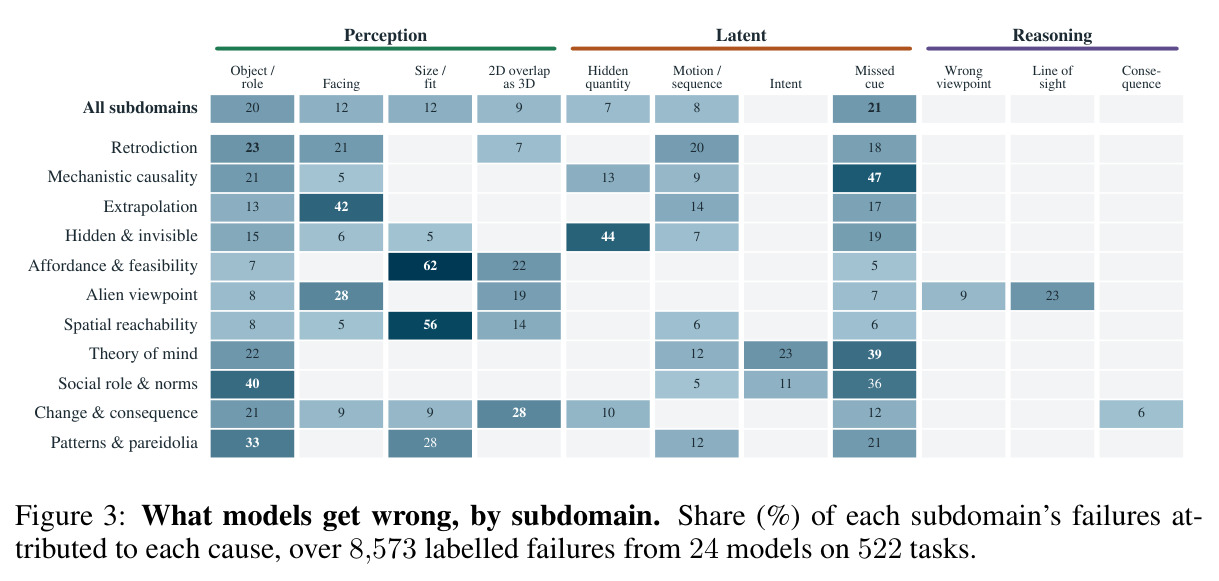
流程四段。(1)数据构建:3466 道初稿 → 一审过 1164(净淘汰 2302,主因答案已被画面呈现或共识不足)→ 二审 559 → 三审 522,端到端通过率 15.1%;媒体取自 Wikimedia Commons、Openverse、Internet Archive,仅收 Public Domain/CC0/CC-BY/CC-BY-SA 四种许可,视频剥离音轨。(2)评测输入:支持原生视频的模型直接接收视频块,其余按 $f_{\mathrm{eff}}=\min(f, N_{\max}/T)$ 以 2fps 均匀抽帧、帧带时间戳、上限 500 帧(超限均匀稀释保证全程覆盖);图像原生分辨率(最长边 4096px)送入,媒体内容寻址缓存保证字节级一致。(3)判分:Claude-Opus-5 作裁判,只见问题、参考答案、准则与候选回答(不看媒体),每条准则输出判定加一句话理由。(4)对照与消融:盲测(去媒体重跑最强模型);8573 个失败首答按 11 类原因标注;智能体条件(Claude Code/Codex 跑 388 题子集);推理努力档位扫描、10–500 帧预算扫描、三厂商裁判交叉审计。
技术新颖性
技术新颖性体现在四个层面。第一,分类学是双用途的:既是出题蓝图(强制 4 域 11 子域的多面覆盖,防止题目堆在某类直觉上),又是细粒度诊断框架(把成绩投影到 11 个认知维度而非只报总分,从而拆解出不同模型的能力画像),且每个子域对应一个明确的推断步骤定义。第二,在 LLM 深度参与数据生产的时代,HSS 的全部题目、参考答案与准则均由训练过的人类标注员撰写并经三轮人工审校,AI 只用于润色文稿和辅助编写评测代码——人工共识驱动的 15.1% 通过率是该基准最贵的资产。第三,方法论上把智能体工具当作诊断仪器而非涨分手段:若失败源于『没看清』,主动检查理应修复一切,而实验发现 2D 重叠误读为 3D 对齐的错误在智能体循环下纹丝不动(102→101,修复率仅 24%),恰好证明基准测的是看之外的东西。第四,对 LLM 裁判做了少见的完整审计:三厂商裁判 Spearman 秩相关恰为 1.0、条目级一致性 95.8–97.5%、$\kappa\ge 0.914$,且自我偏好残差小到不可检出(自评 −0.44 点)。
实验结果
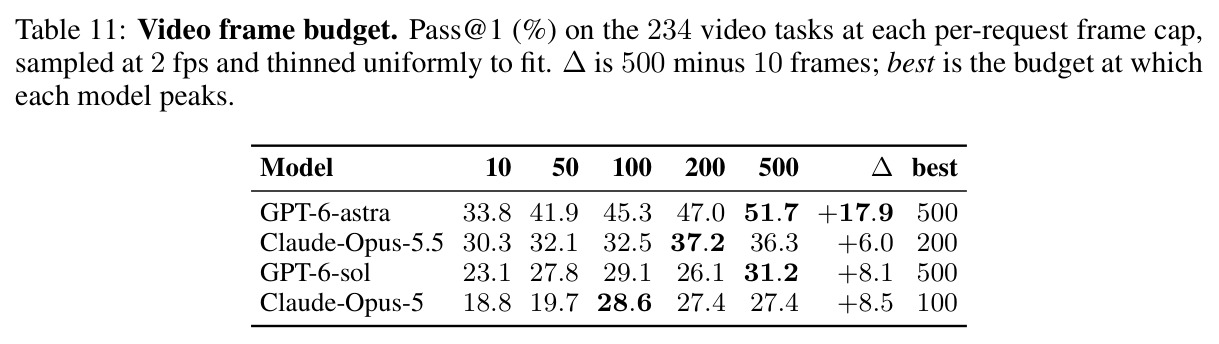
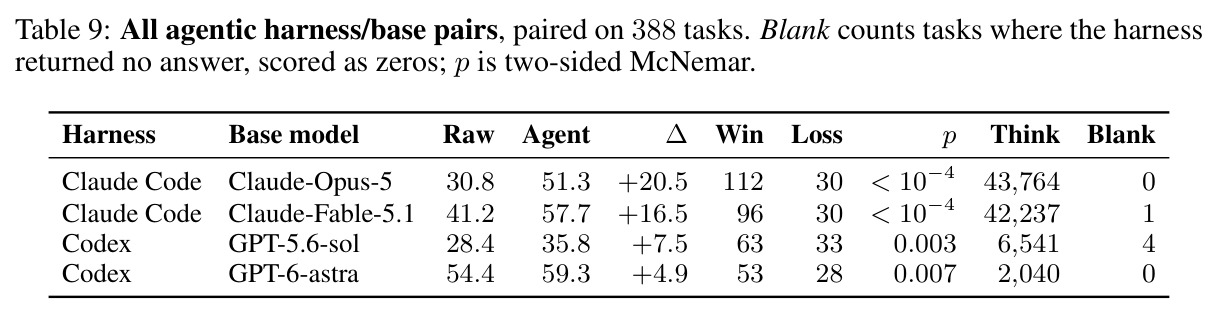
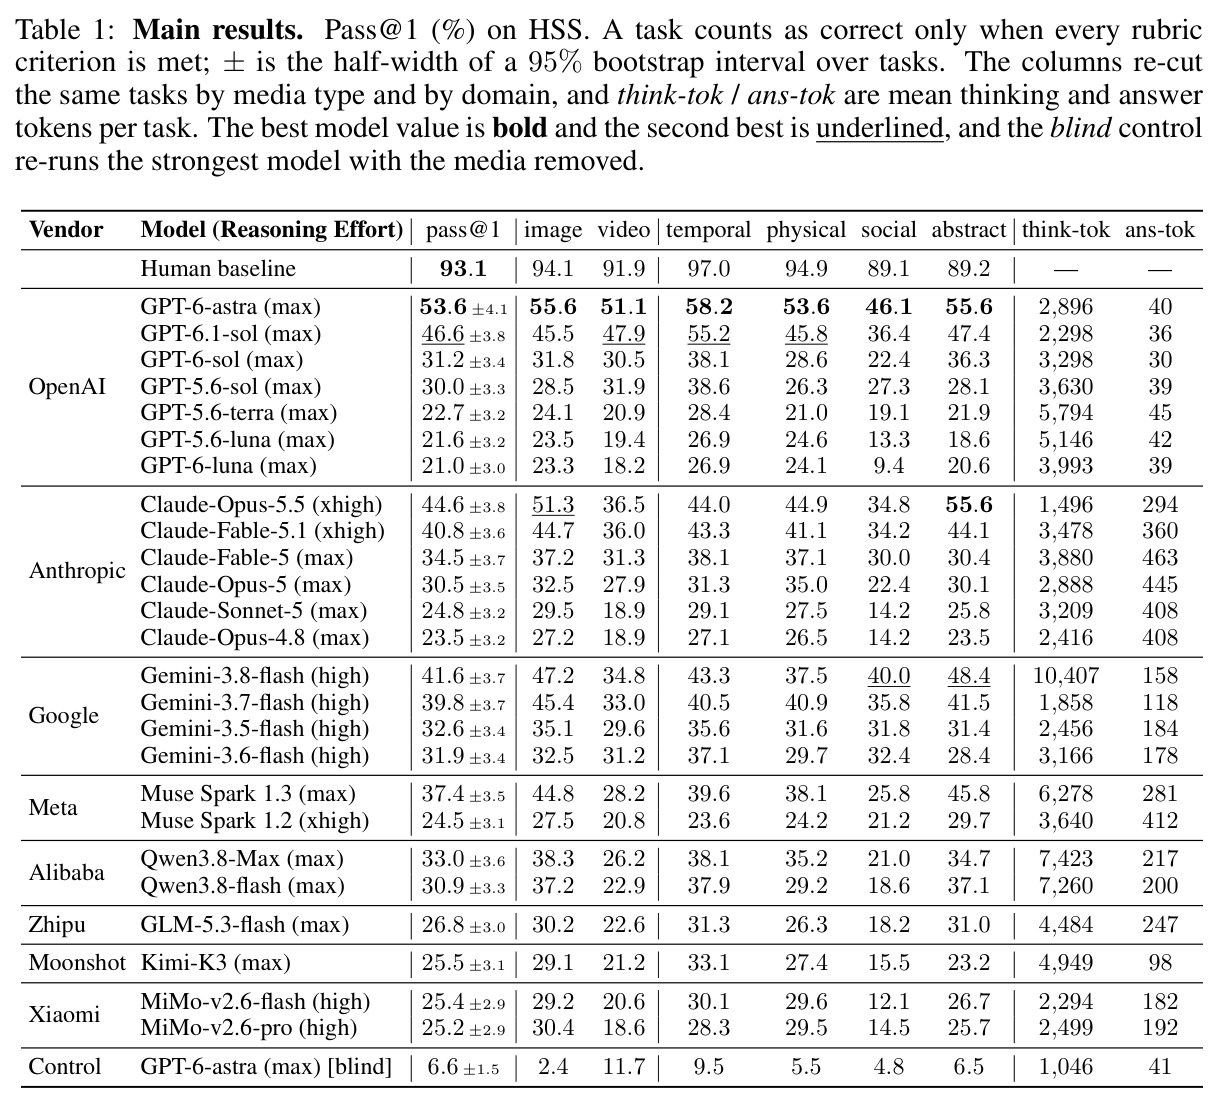
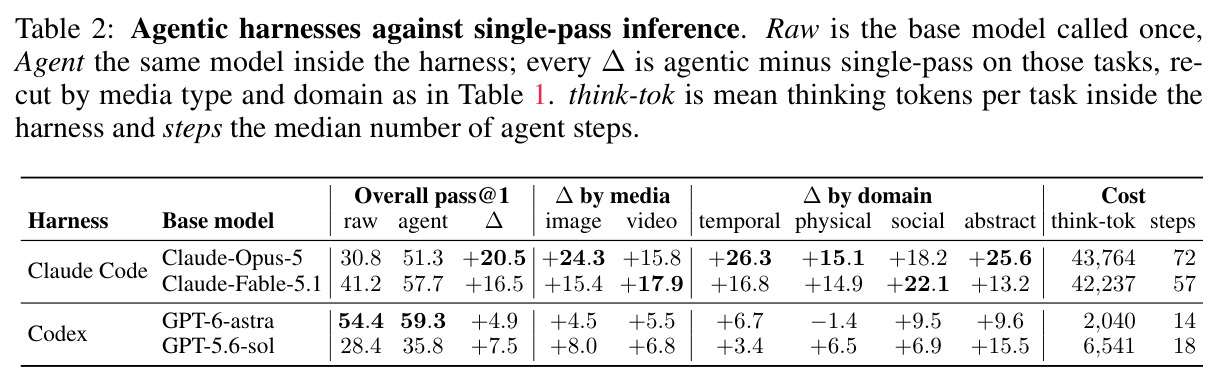
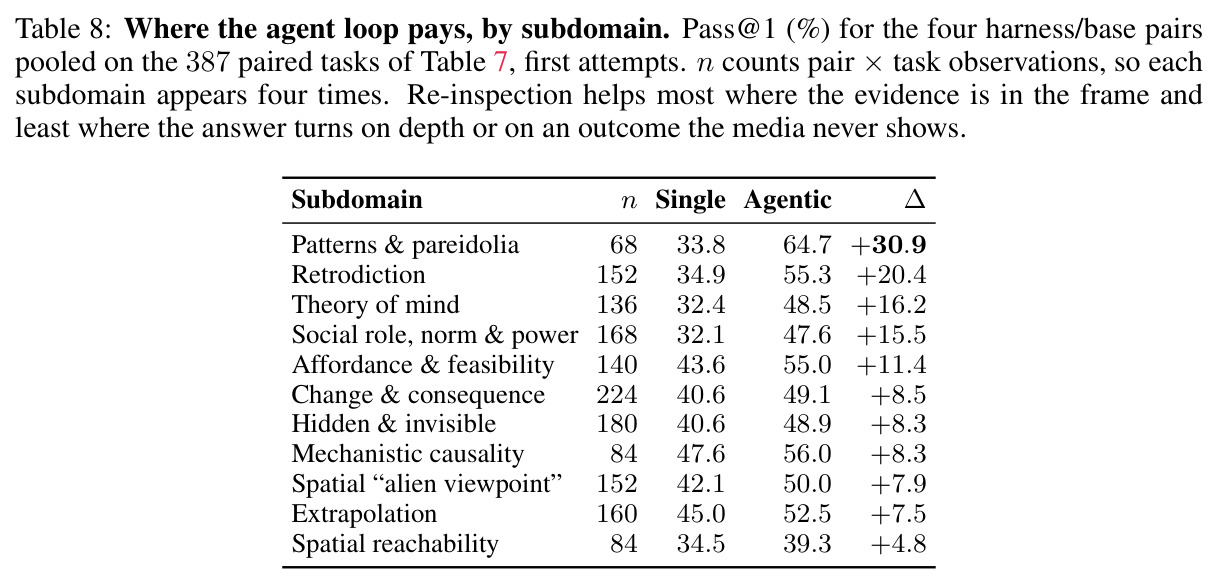
核心发现逐一分析。(1)总差距:25 个模型中最佳的 GPT-6-astra(最大推理档)pass@1 仅 53.6%(自助区间半宽 ±4.1),人类 20 名标注员达 93.1%,差距近 40 点;第二名 GPT-6.1-sol 46.6%,Claude-Opus-5.5 44.6%,多数模型低于 40%;所有模型平均每题生成约 4000 个思考 token——大量深思仍答不对。(2)媒体与域分解:23/25 个模型视频低于图像,平均降 7.3 个百分点;社会理解是最弱域,21/25 个模型在此垫底,平均 24.4%,其余三域平均 34.1%。(3)盲测对照:去掉媒体后 GPT-6-astra 从 53.6% 跌至 6.6%,522 题仅 4 题盲测三次全过,残余全是二选一题上的掷硬币,排除语言先验解法。(4)人类表现:标注员仅对 63/522 题(12.1%)不确定,确定题 94.1%、不确定题也有 85.7%。(5)失败分析:8573 个失败中感知占 53%、潜推理 41%、纯推理仅 5%;最大单一原因是漏看决定性线索(21.3%)与误认物体/人物/角色(19.9%);失败高度系统化——503 道 5 个以上模型皆败的题上,失败原因中位 80% 相同;图像失败 66% 属感知,视频失败 57% 属潜推理(漏看线索占 28%)。(6)智能体条件:Claude Code +16.5~+20.5 点但代价高(中位 57–72 步、每题超 4.2 万思考 token),Codex 仅 +4.9~+7.5,最好配置也只有 59.3%;修复集中在再看一眼能解决的错误(总失败 944→759),子域增益 Patterns & Pareidolia +30.9、Retrodiction +20.4 最大,空间可达性 +4.8 最小。(7)推理努力非单调:GPT-6-astra 在 Retrodiction 从 high 到 xhigh 反降 14 点,12 条模型×域曲线仅 5 条在最高档最佳。(8)帧预算:10→500 帧 GPT-6-astra +17.9 点,但 100→500 帧仅 +6.4/+2.1/+3.8/−1.3,约 100 帧后饱和。(9)裁判稳健:三裁判 Spearman 秩相关恰为 1.0,最严者也只整体低 2.4 点。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| HSS 全集直觉视觉推理(522 题) | pass@1 (%) | GPT-6-astra(max):53.6 ±4.1 | 人类标注员:93.1 | 模型落后人类 39.5 个百分点;此前无同任务基线,属新设立的挑战 |
| 盲测对照(去除视觉媒体,GPT-6-astra max) | pass@1 (%) | 6.6 ±1.5(仅 4/522 题三次全过) | 同模型有媒体:53.6 | 下降 47 点,证明语言先验无法解题 |
| 视频子集相对图像子集 | pass@1 差值(百分点) | 23/25 个模型视频更低,平均 −7.3 | 各自图像子集成绩 | —(视频为更难模态) |
| 社会理解域(110 题) | pass@1 (%) | 25 模型平均 24.4,21/25 个模型的最弱域 | 其余三域平均 34.1 | 低 9.7 个百分点,为全局最弱能力 |
| Claude Code + Claude-Opus-5(388 题子集) | pass@1 (%) | 51.3(智能体) | 30.8(单次调用) | +20.5 点,代价为 43,764 思考 token/题、中位 72 步 |
| Codex + GPT-6-astra(388 题子集) | pass@1 (%) | 59.3(智能体) | 54.4(单次调用) | +4.9 点,仍远低于人类 93.1%,基准远未饱和 |
| 视频帧预算扫描 10→500 帧(GPT-6-astra,234 视频题) | pass@1 (%) | 33.8 → 51.7(峰值在 500 帧) | 10 帧:33.8 | +17.9 点,但 100→500 帧仅 +6.4,约 100 帧后饱和 |
局限与改进
作者承认三条:只测视觉通道(视频剥离音轨与字幕,依赖语音的题按构造被排除);分数经 LLM 裁判中介(已知存在自我偏好等偏见,作者用跨裁判一致性与 oracle 条件限定影响但无法根除);媒体来自公共网络,个别素材可能已入训练集(问题与答案是针对媒体新写的,但无法完全排除对单个素材的先验暴露)。我的补充:522 题规模偏小,顶级模型置信半宽 ±4.1,帧预算消融单元误差约 ±6 点(作者承认 100 帧后的小增益无法分辨),最小子域(空间可达性)仅 27 题;全对才算过的判定偏严,多准则题会放大裁判误判;ToM 类推断依赖人口构成单一的标注者共识,共识不等于普遍正确(作者在伦理声明中亦承认,建议读作『与标注者判断的一致度』);这是纯诊断性工作,不提供缩小差距的方法;全部模型为闭源 API 快照且超参沿用厂商默认,跨模型比较有部署差异。
独立分析的弱点
(1)全有全无判定:$k$ 条准则全过才得分,28.5% 的多准则题对部分正确回答惩罚过重且放大裁判方差——改进:把论文已定义的 rubric score 升格为并行主指标。(2)裁判看不到媒体:准则须能脱离媒体核对,系统性偏向『说得清』的答案,而直觉恰恰难言传,可能低估表述含糊但判断正确的模型——改进:抽样让人类对照媒体复核裁判判定。(3)污染无法根除:公共网络素材可能已入训练集——改进:动态改写或对高热度素材做污染审计。(4)智能体实验只覆盖 388 题子集、仅两套厂商自家 harness,分不清『harness 质量』与『模型能力』——改进:统一开源 harness 交叉实验。(5)失败分析是现象学而非机理:说明了错在哪,没说明表征层为什么缺深度、尺度、意图——改进:对视觉编码器做探针实验。(6)人类基线仅 20 名单一供应商标注员,人口构成窄,ToM『共识真值』有文化偏置风险——改进:多背景标注员复测分歧度。
未来方向
作者方向与自然延伸:(1)补齐音频通道,测多模态直觉;(2)把 HSS 从评测工具变成训练信号——直觉推理对测试时算力不敏感,需在数据或目标函数层面干预,如直觉物理与社会脚本的预训练目标、世界模型式学习;(3)针对 2D→3D 深度错误的顽固性(智能体修复率仅 24%),研发显式深度估计或 3D 几何模块与 MLLM 融合——这正是『再看一眼修不掉』的错误类型;(4)针对最大失败源『漏看决定性线索』(21.3%),研究显著性引导的主动视觉注意力与关键帧定位——智能体实验证明时间戳接触表加变焦重采样使 Retrodiction +20.4 点,可内化为原生视觉循环;(5)『过度思考』(努力提高反掉分,Retrodiction 掉 14 点)指向系统 1/系统 2 路由问题,可研究自适应努力分配;(6)社会理解最弱(24.4%),可开发角色扮演合成数据与跨文化 ToM 验证;(7)把原子 rubric 评估范式推广到其他开放式生成任务。
复现评估
开源情况良好:数据集已在 HuggingFace 公开(ScaleAI/HSS),排行榜在 scale.com/leaderboard/hss;作者承诺公开评测 harness、模型注册表(configs/models.yaml,含 25 个模型与 3 个裁判的 API 端点、推理档位、输出上限、帧上限)与判分 prompt,附录 C.6 逐字给出全部提示模板;媒体内容寻址并本地缓存,保证字节级相同输入;确认性指标在冻结的 522 题版本上评出,每次运行记录数据版本与逐条判定。算力需求低:无需训练,成本主要是闭源 API 推理调用(522 题 × 3 次 × 25 模型,外加消融与裁判调用)。复现难度中低:主要工作是跨厂商 API 形状与各异帧上限的工程配置;主要风险是闭源 API 版本漂移——评测对象是特定模型快照,云端更新后数字会变,且个别部署未公布输出/帧上限;复现人类基线需重组 20 名标注员,成本较高但非必需。
论文图表