MiniMax-H3 能否推理物理世界:面向全模态生成模型的隐式提示评测基准 Can MiniMax-H3 Reason About the Physical World? An Evaluation of Omni-Modal Generative Model
构建517例隐式提示多模态评测集,MiniMax-H3物理世界推理成功率仅41.97%
前置知识
全模态生成模型
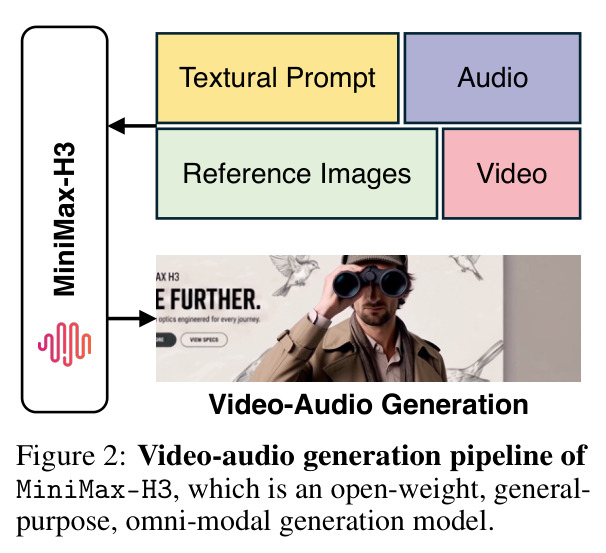
全模态生成模型指能在统一架构下同时接收文本、图像、视频、音频等异构输入并生成内容的模型。与仅接受一两种条件模态的传统文生视频模型不同,它可以对同一底层事件获得多种互补观测,并在联合上下文条件下生成音视频内容,典型代表是开放权重的 MiniMax-H3,它把多模态上下文理解与音视频联合生成结合在共享潜在框架中。
论文的评测对象与任务设计完全围绕全模态输入展开,四个任务分别对应多图像、图像+音频、前缀视频、视频+音频的输入组合,不理解 Omni-Model 的接口就无法理解任务定义与评测逻辑。
隐式提示
隐式提示指文本只规定要执行的任务操作、刻意省略关键事件语义的提示方式,缺失的信息被分散到多个输入模态中。每个模态仅提供部分证据,目标事件只有通过对齐并联合解读全部观测才能恢复,生成的视频则成为这一推理过程的行为读出。构造时须满足两准则:文本单独不披露答案,多模态输入提供充分证据。
这是本文区别于 VBench 等显式提示基准的根本设计,不掌握这一概念就看不懂该评测为何度量的是'推理'而非'渲染',也无法理解成功率数字的真正含义。
条件生成建模
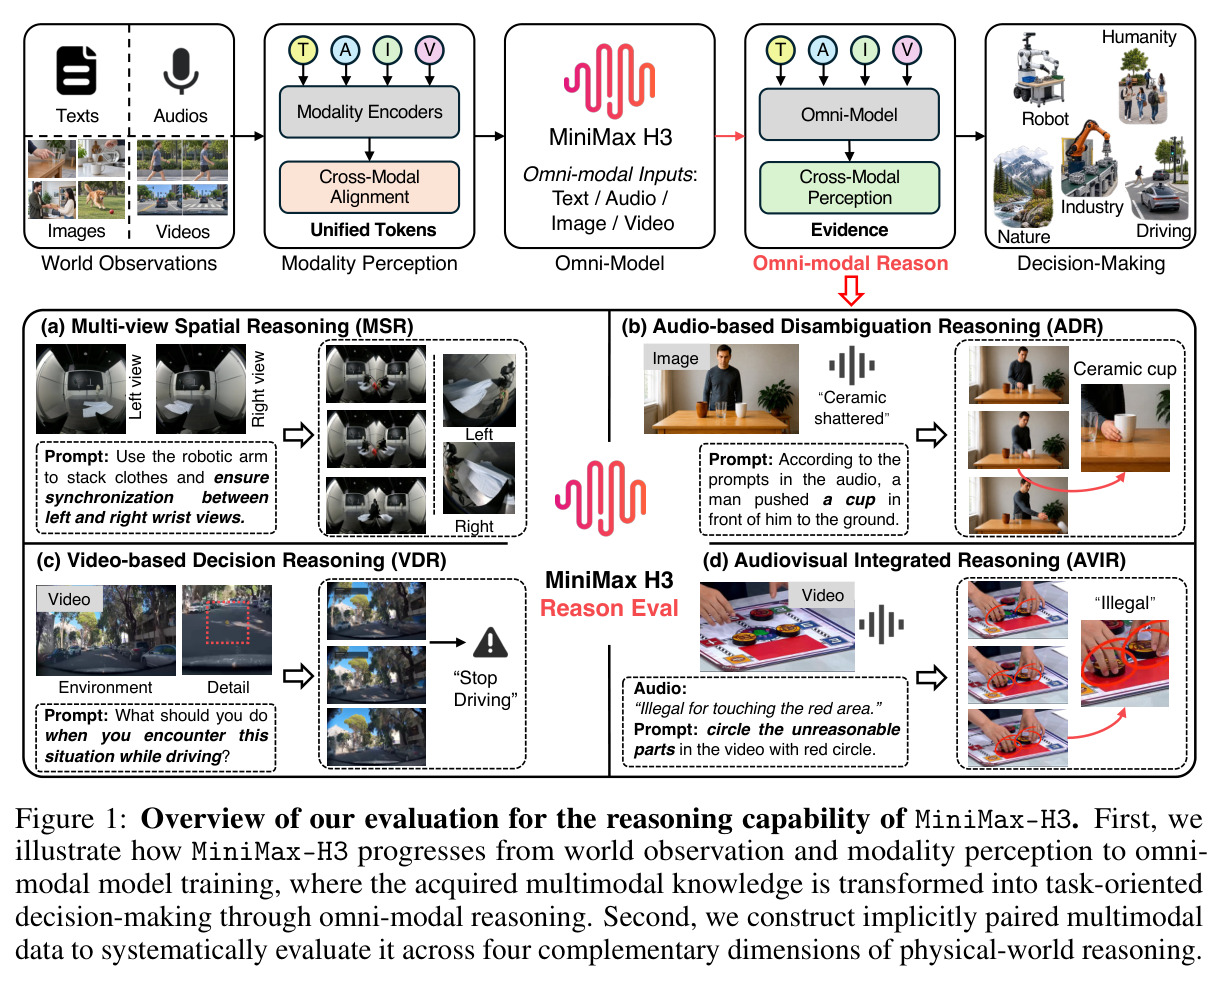
生成过程被形式化为条件分布 $\hat{Y} \sim p_\theta(Y|q,x)$,其中 $q$ 为任务提示、$x$ 为多模态观测、$\hat{Y}$ 为输出视频。论文的四个任务共享该框架,仅条件集不同:MSR 用 $K$ 张图像 $I=\{I^{(k)}\}_{k=1}^{K}$,ADR 用图像加音频 $(I,A)$,VDR 用前缀视频 $V_{1:T}$,AVIR 用视频加音频 $(V,A)$。
论文所有任务的数学定义都基于这一统一形式化,读懂条件分布的写法才能准确区分四个场景的条件差异,并理解成功率指标定义在输出视频与语义目标的匹配上。
世界模型
世界模型是对物理世界的状态、动力学与因果规律进行内部建模,并能预测环境如何随时间与交互演化的系统。评测界已有 WorldModelBench、WorldScore、WorldMark、Omni-WorldBench 等工作检验生成模型是否遵循重力、碰撞、物体状态转移等物理约束,以及生成环境的空间结构与交互一致性。
本文核心问题是'全模态对齐能否提升世界推理',气球受热变形、球滚落马路、轮胎压杯等评测案例直接考察模型对物理规律的内化程度,与世界模型评测一脉相承又有差异化定位。
研究动机
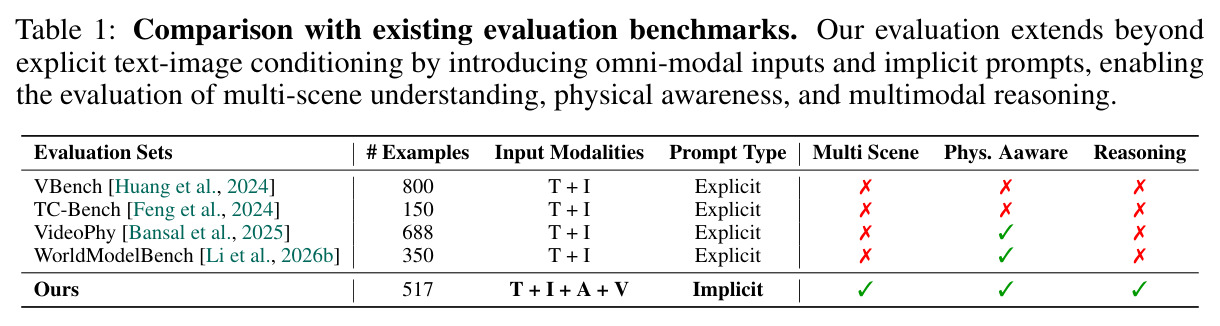
现有视频生成与世界模型评测基准都无法回答全模态模型是否真正具备跨模态推理能力。VBench(800例)、TC-Bench(150例)、VideoPhy(688例)、WorldModelBench(350例)全部只使用文本+图像输入且采用显式提示:提示直接描述期望输出,额外模态只是冗余或局部条件信号,模型无需识别输入之间的关系就能产出貌似合理的结果。这类基准本质上只测'模型能否忠实渲染被告知的事件'。另一边,MiniMax-H3 等全模态模型虽已能接受异构输入,但接受多模态输入并不等于跨模态推理——模型可能忽略非主导模态的证据、无法建立跨模态对应、或主要依赖文本语义先验。模型接口的快速演进与评测范式停留在双模态显式条件之间,形成了明显的能力度量断层。
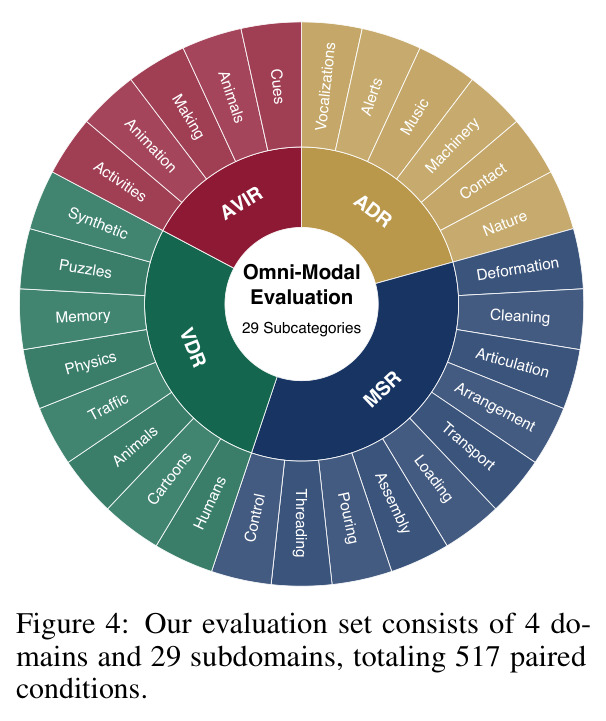
本文的目标是本文目标是构建一个专门利用全模态输入的物理世界推理评测框架,回答两个问题:多模态对齐能否提升 Omni-Model 的世界推理?全模态输入能启用何种新评测范式?具体交付包括:一套专家校验、共 517 个实例的评测集,覆盖多视角空间推理(MSR)、音频消歧推理(ADR)、视频决策推理(VDR)、视听综合推理(AVIR)四个场景与 29 个子类;每个实例由隐式提示、多模态观测和标注语义目标三元组组成;以三名专家独立评判生成视频是否满足输入证据所支持的语义约束作为成功判据;并以 MiniMax-H3 为测试床给出场景级和子类级成功率,定位其能力短板与失败模式。
与已有工作不同的是,本文的独特切入角度是评测'信息在输入模态间的分布方式'而非'生成质量'。已有基准问'模型能否生成它被告知的内容',本文问'模型能否确定它应该生成什么'。做法是把任务相关语义从文本提示中系统性移除,分散到图像、音频、视频等互补模态证据中:每个模态单独看都只提供部分证据,目标事件只有通过联合解读观测才能恢复。生成的视频因此成为整个证据识别、跨模态对应、隐事件推断链条的可观测读出,作者称之为 Chain-of-Frames,使跨模态推理从接口声明问题转化为可以用生成结果直接判定的行为问题,这是与所有已有基准在评测对象层面的本质差异。
核心方法
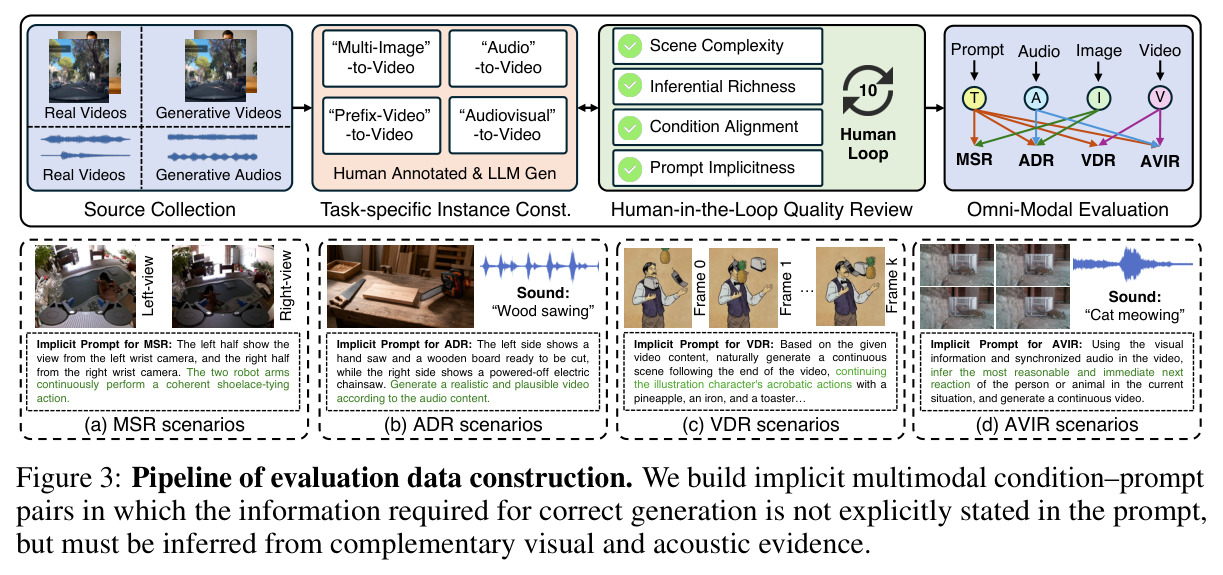
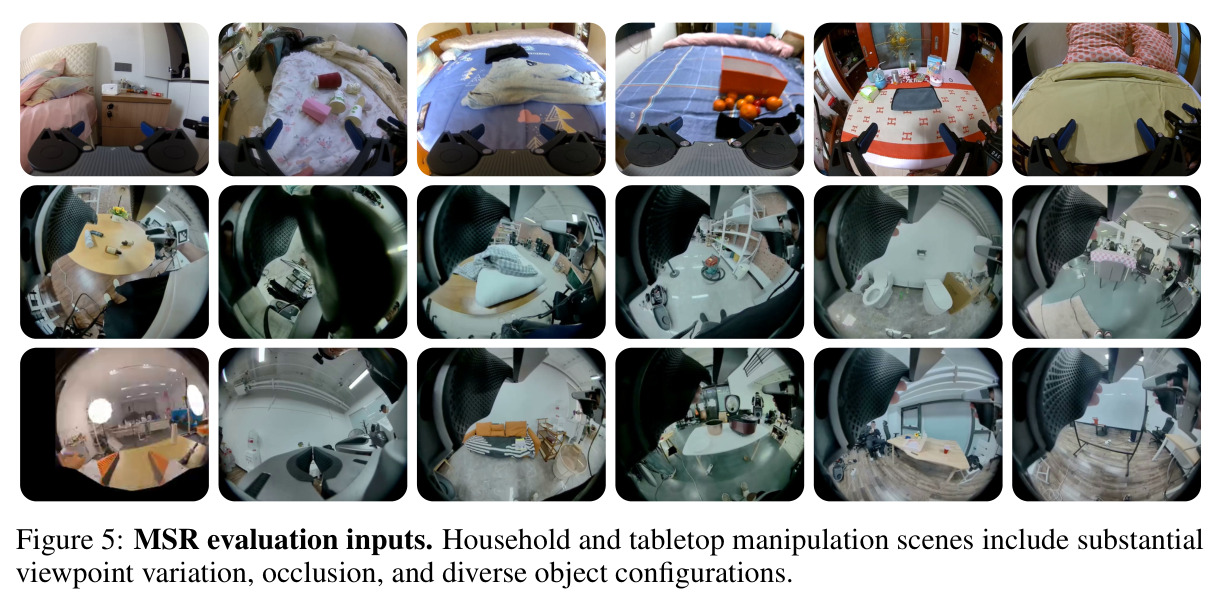
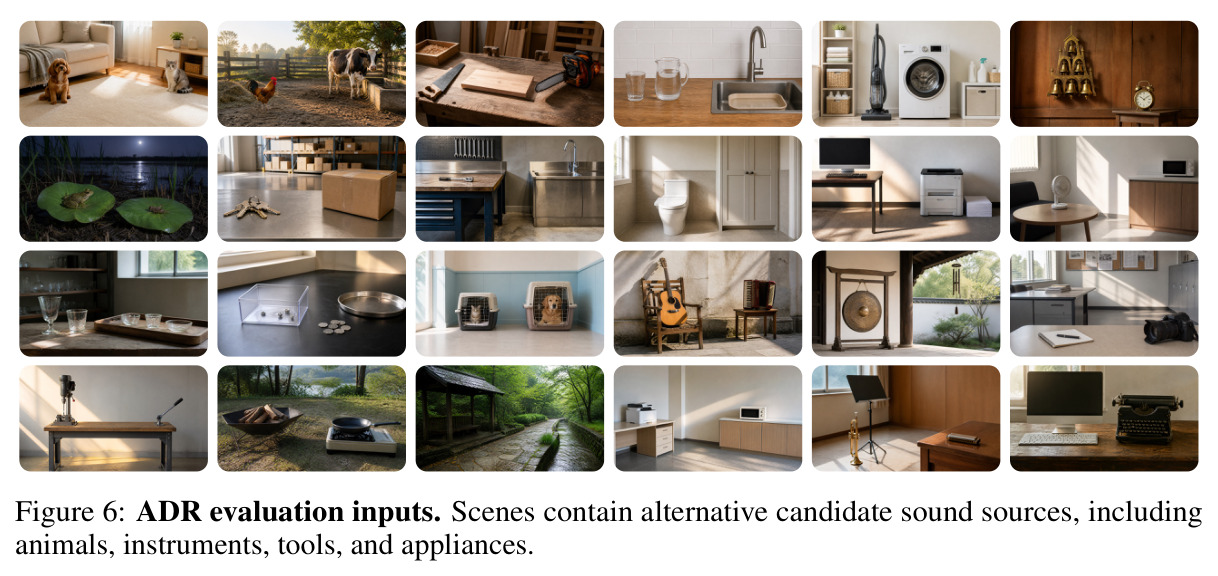
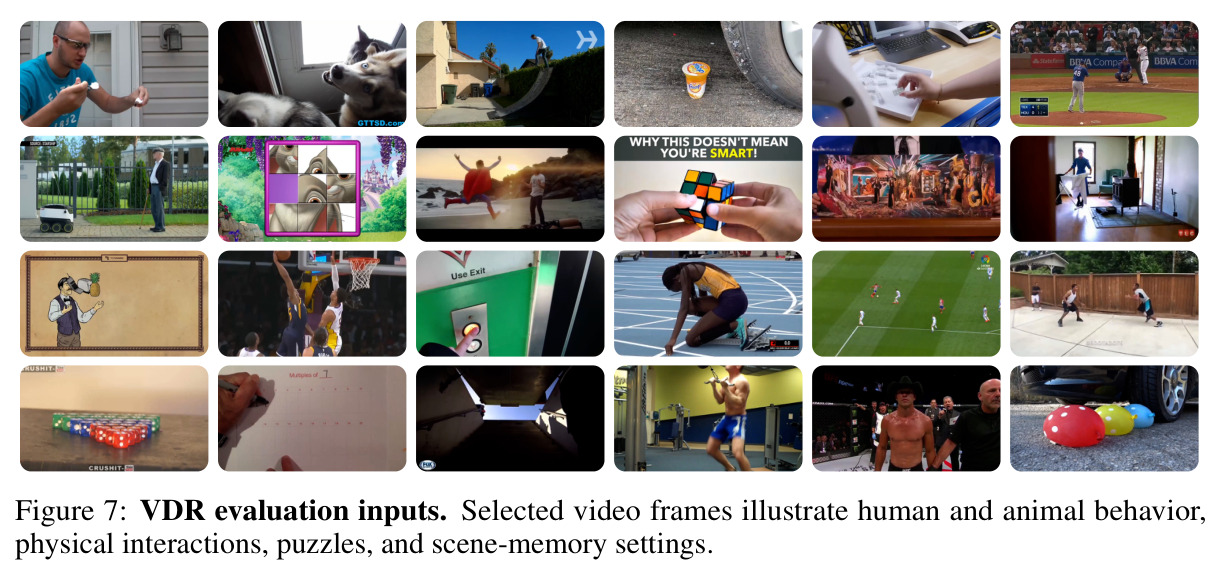
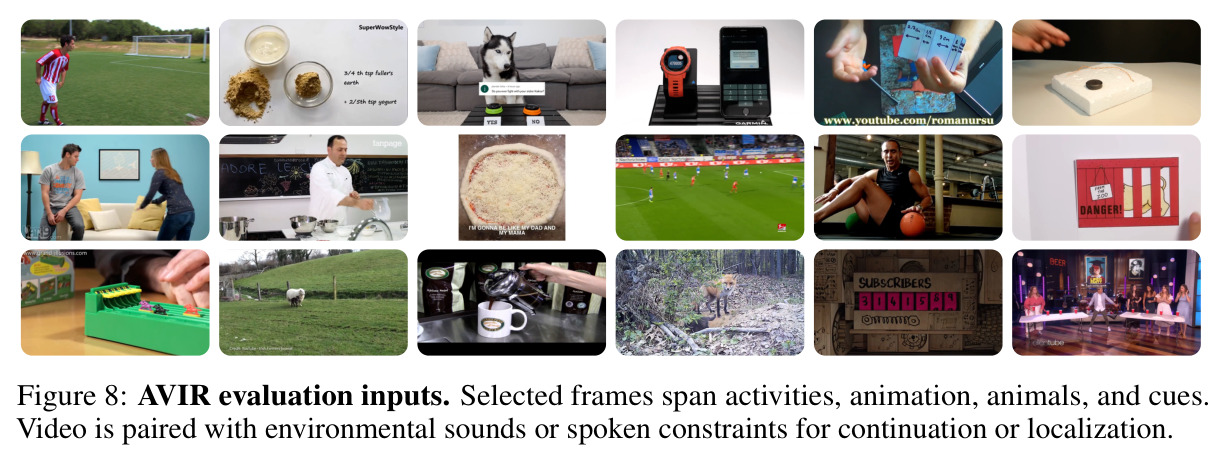
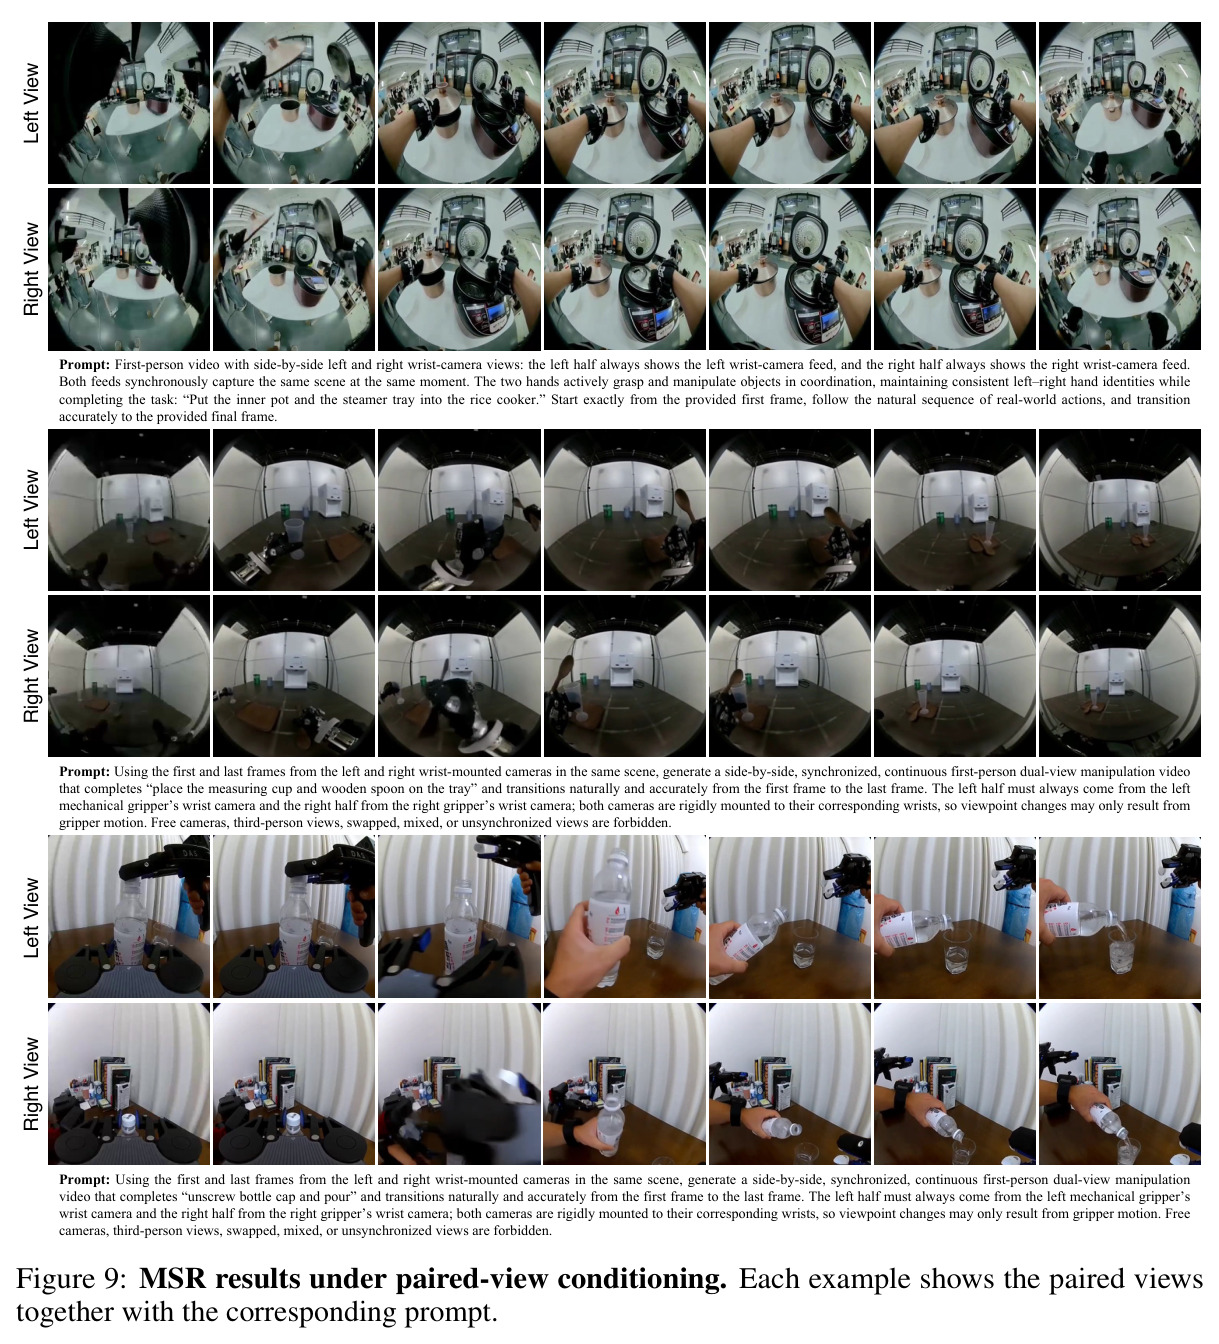
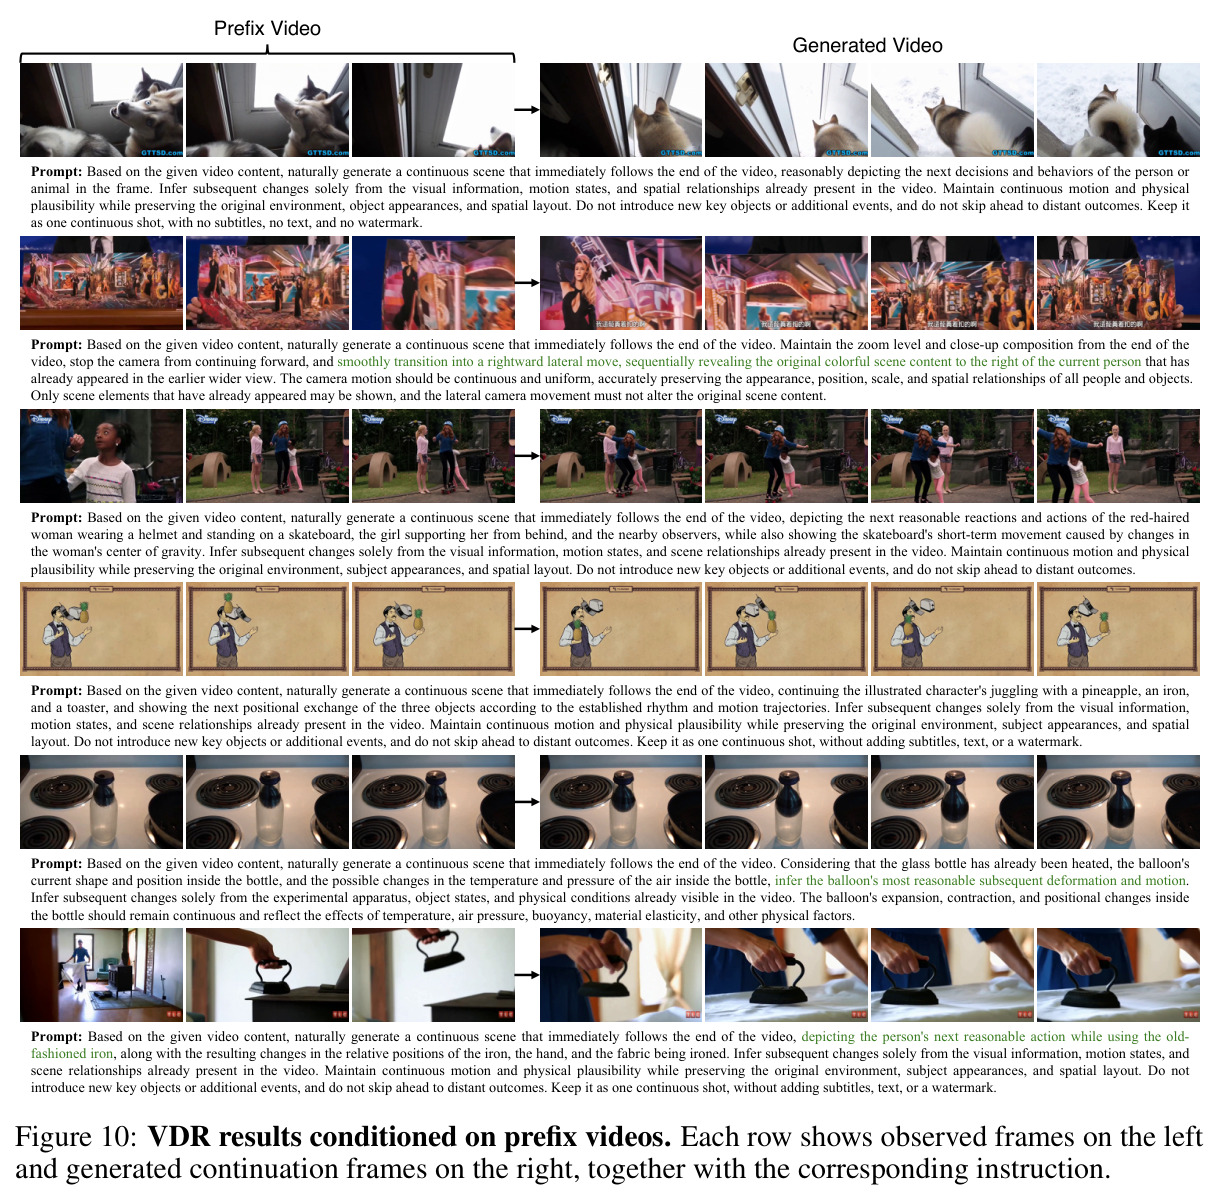
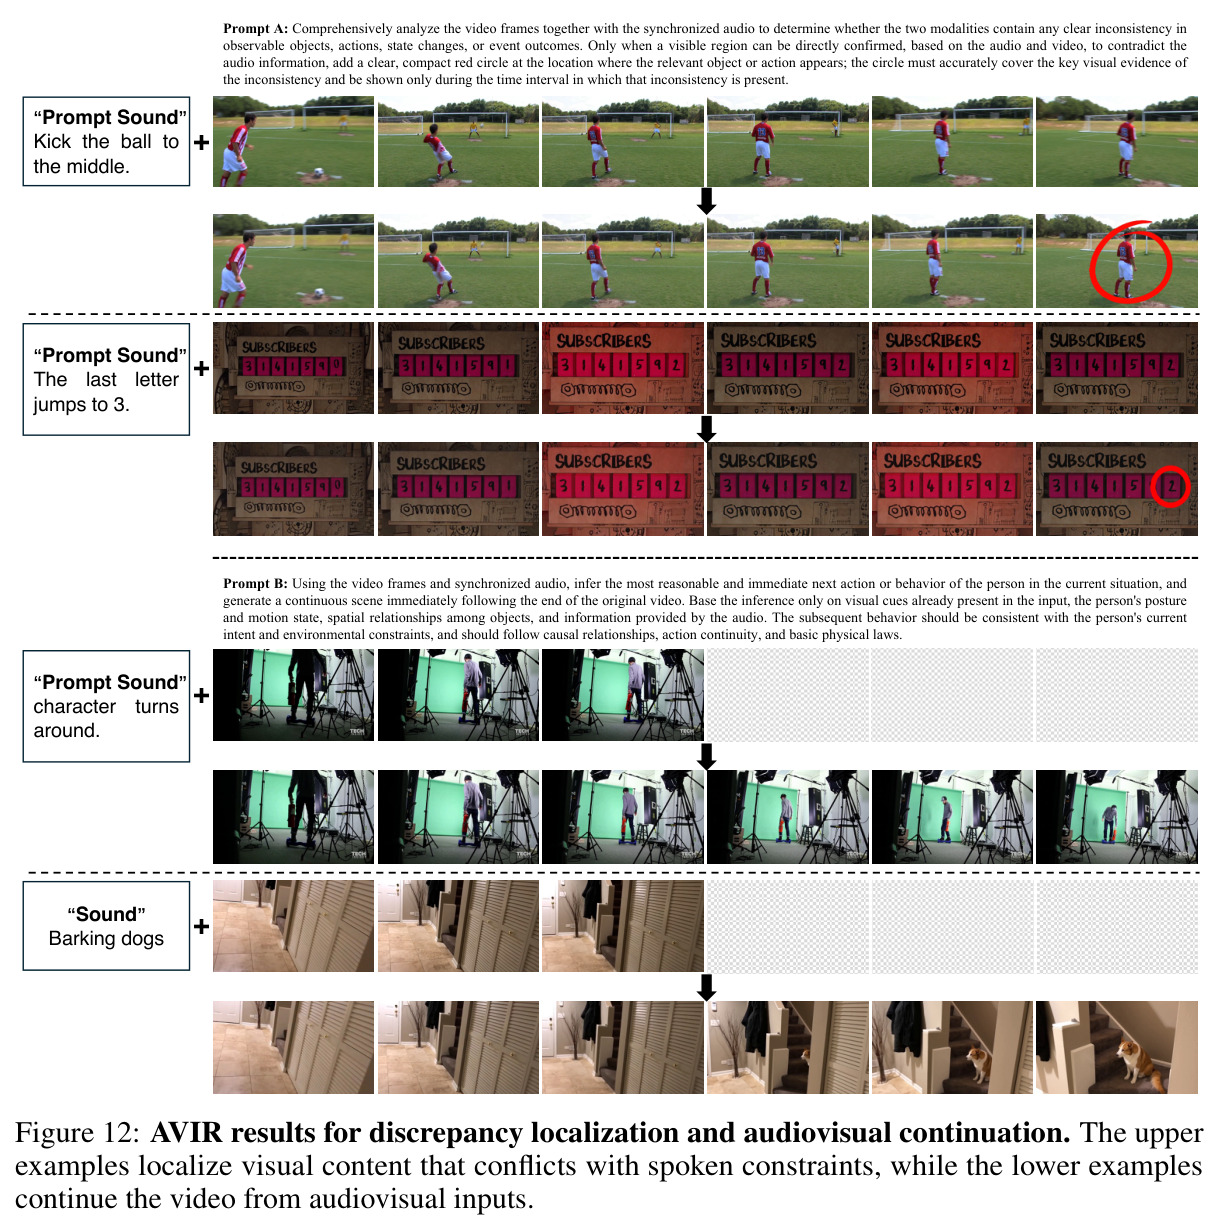
评测框架把物理世界推理统一形式化为条件视频生成:给定任务提示 $q$ 和观测 $x$,模型生成 $\hat{Y} \sim p_\theta(Y|q,x)$,四个场景仅在条件集上不同。MSR:$\hat{Y}_{MSR} \sim p_\theta(Y|q,I)$,$I$ 为 $K$ 张不同视角图像,要求建立跨视角对应并推断单视角不可见的空间关系(如双臂机器人左右腕视角的协同操作);ADR:$\hat{Y}_{ADR} \sim p_\theta(Y|q,I,A)$,静止图像存在多种合理解释,音频提供判别性证据(如三个不同材质杯子哪个掉落由落地声决定);VDR:$\hat{Y}_{VDR} \sim p_\theta(Y|q,V_{1:T})$,从前缀视频的运动与状态变化推断合理后续反应(如球滚入马路提示车辆应提前停车);AVIR:$\hat{Y}_{AVIR} \sim p_\theta(Y|q,V,A)$,联合视频与音频做续写或修订(如圈出违反语音约束的区域)。数据构建分三步:多模态源收集、任务特定实例构造、带四维标准的迭代专家评审;评测时 3 名专家独立按任务语义标准输出二值标签,计算 $SR(D)=\frac{100}{|D|}\sum_{i\in D}s_i$。
核心创新是'隐式条件-提示对'设计,与显式提示基准有本质区别:文本单独不得披露目标解释或生成内容,而多模态输入必须联合提供足以推断结果的证据,两条准则缺一不可。这相当于把任务关键语义从 prompt 通道迁移到跨模态证据通道,迫使模型完整执行识别相关证据、建立跨模态对应、推断隐事件、再用视频补全事件的链条。由此生成的视频成为推理过程的行为读出(Chain-of-Frames):一个视觉上再逼真的续写,若不满足输入证据支持的语义条件(例如音频指向的事件没有在画面中发生),仍被判为失败。评测对象因此从'渲染保真度'转向'证据利用正确性',这正是'接受多模态输入'与'真正跨模态推理'之间的分水岭。
方法步骤详情
第一步源收集:汇总真实与合成数据——多视角操作图像来自 HiFi-UMI-2K、VISTA-UMI-5K、HuMI-Unsheathe、Hy-Embodied-0.5-VLA-Data、10Kh-RealOmin-OpenData,视频来自 LLaVA-Video-178K,音频来自 FSD50K 与 ESC-50,另用 ChatGPT Voice 合成音频、Seedance 2.0 合成视频,并按感知质量、语义连贯性与任务适配性筛除不合格源。第二步任务特定实例构造:按 MSR(多视角图像)、ADR(图像+音频)、VDR(前缀视频)、AVIR(视频+音频)组织输入,为每例标注支持目标的证据与有效输出须满足的语义要求,要求针对推断本身而非外观的唯一实现。第三步隐式提示构造:用 ChatGPT 与开源 Qwen3 生成候选表述并由专家编辑校验,确保文本不泄露答案且多模态证据充分。第四步迭代专家评审:每个条件-提示对经 10 轮评审,从场景复杂度、推理丰富度、条件对齐、提示隐含性四个维度把关,不合格者修改输入或提示后重审。最终实例表示为 $E_i=(q_i,x_i,\tau_i)$,$\tau_i\in\{MSR,ADR,VDR,AVIR\}$,评测阶段 3 名专家独立评判并交叉核对,输出二值成功标签。
技术新颖性
技术新颖性体现在三点。其一,输入模态组合与提示类型均为首创:对比表 1,VBench(800例)、TC-Bench(150例)、VideoPhy(688例)、WorldModelBench(350例)均为文本+图像的显式提示,本文 517 例首次使用文本+图像+音频+视频四模态输入与隐式提示,并同时具备多场景、物理感知与推理标注。其二,音频被用作'消歧证据'而非生成目标:ADR 首次检验声学线索能否改变模型对静止视觉场景的解释,这是既有音频条件生成评测未覆盖的能力。其三,把生成输出当作推理的行为读出,将'通过生成做推理'(Video-ThinkBench、TiViBench、Gen-ViRe、RISE-Video)与'跨模态证据分布'两条此前分离的研究线连接起来,并以专家参与的 10 轮四维迭代评审流程保证提示隐含性与条件充分性,工程上形成了可复制的基准构建方法论。
实验结果
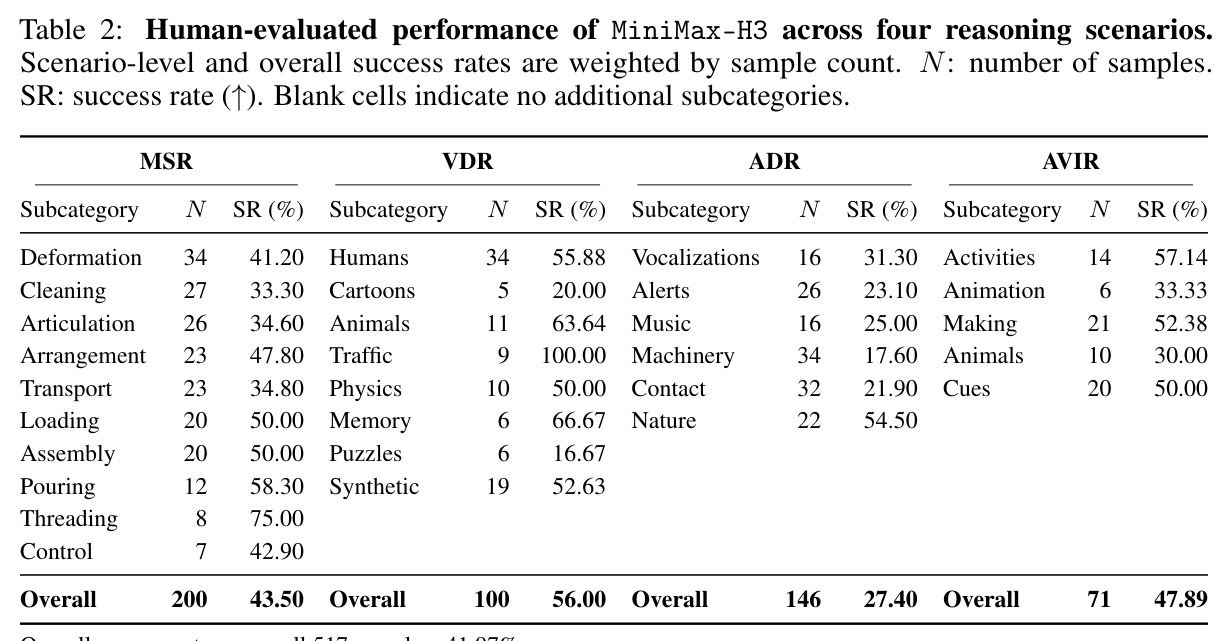
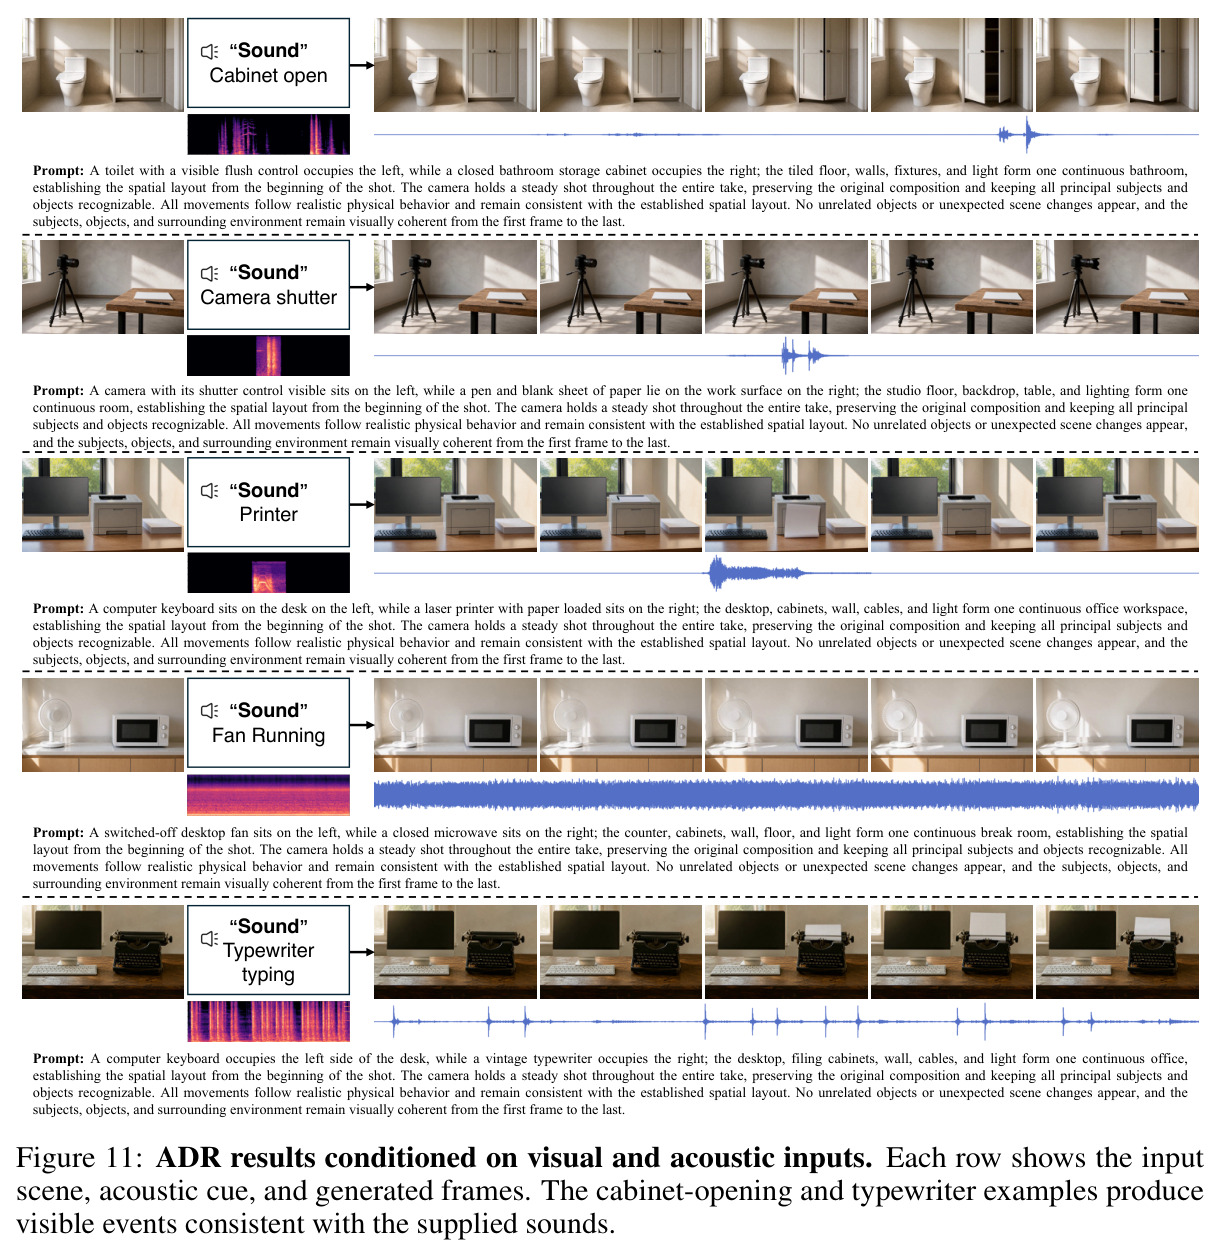
核心结果是 MiniMax-H3 在 517 个实例上整体成功率仅 41.97%,过半样本失败。分场景看:VDR 最高 56.00%(100例),AVIR 次之 47.89%(71例),MSR 为 43.50%(200例),ADR 最低仅 27.40%(146例),VDR 与 ADR 相差 28.60 个百分点,说明视频续写远比音频依赖型推理可靠(作者提醒各场景数据与提示不同,属任务级而非模态级对比)。子类层面:MSR 中 Threading 75.00%、Pouring 58.30% 最好,Cleaning 33.30%、Articulation 34.60%、Transport 34.80% 徘徊在三分之一,跨视角空间一致性维护困难;VDR 中 Traffic 达 100.00%(9例)、Memory 66.67%、Animals 63.64%,但 Cartoons 20.00%、Puzzles 16.67% 接近崩溃;ADR 中仅 Nature 54.50% 尚可,Machinery 17.60%、Contact 21.90%、Alerts 23.10%、Music 25.00% 全面低迷,暴露声学证据到视觉事件转换的瓶颈;AVIR 中 Activities 57.14%、Making 52.38% 尚可,Animation 33.33% 与 Animals 30.00% 偏弱。失败模式归纳为四类:证据错误绑定(猫狗声源混淆)、事件实现不完整、物理与构型违反(滑板、轮胎压杯、魔方)、时序状态不一致。定性上模型能跟随主导线索(柜门随声打开、打字机声引发纸张移动),但视觉合理性并不保证物理一致性。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 整体物理世界推理(517 例,29 子类) | 人工评判成功率 SR (%) | 41.97% | 无直接可比基线(该设定下首个基准) | — |
| MSR 多视角空间推理(200 例) | SR (%) | 43.50%(Threading 最高 75.00%,Cleaning 最低 33.30%) | — | — |
| VDR 视频决策推理(100 例) | SR (%) | 56.00%(四场景最高;Traffic 100.00%,Puzzles 16.67%) | — | 高于最弱的 ADR 28.60 个百分点 |
| ADR 音频消歧推理(146 例) | SR (%) | 27.40%(四场景最低;Nature 54.50%,Machinery 17.60%) | — | — |
| AVIR 视听综合推理(71 例) | SR (%) | 47.89%(Activities 57.14%,Animals 30.00%) | — | — |
| 基准设定对比(对 VBench/TC-Bench/VideoPhy/WorldModelBench) | 输入模态数 / 提示类型 / 多场景 / 物理感知 / 推理标注 | 4 模态(T+I+A+V)/ 隐式 / 全部具备 / 517 例 | 均为 2 模态(T+I)/ 显式提示 / 不具备(VBench 800例、TC-Bench 150例、VideoPhy 688例、WorldModelBench 350例) | 首次实现隐式提示下的全模态推理评测 |
局限与改进
作者明确承认的局限:四个场景的数据、提示与生成目标各不相同,场景级成功率只反映任务级表现,不能直接解读为'视频证据优于音频证据';一次失败可能源自输入理解、跨模态整合或视频生成本身三个环节中的任何一个,单一成功率无法解耦,需要移除单模态、固定视觉替换音频等受控消融实验;评测完全依赖 3 名专家人工评判并交叉核对,尚未自动化,扩展成本高。我自己的观察:整体评测集规模有限,多个子类样本极少(Cartoons 仅 5 例、Puzzles 6 例、Memory 6 例、Control 7 例、Threading 8 例),这些子类的成功率统计波动大,Traffic 100.00% 也仅基于 9 例;SR 是二值指标且以人工标注语义目标为准,无法刻画失败程度与生成质量的连续差异;数据含 Seedance 2.0、ChatGPT Voice 等合成源,可能引入分布偏差,且无法排除被测模型训练数据与评测源的潜在重叠;此外只评测了 MiniMax-H3 一个模型,结论对全模态模型群体的代表性有限。
独立分析的弱点
第一,单模型评测:全文只测 MiniMax-H3,无法区分发现是该模型的缺陷还是全模态范式的共性问题,改进方向是横向纳入多个开放权重 Omni-Model 形成对比矩阵。第二,人工评测不可扩展:3 名专家对 517 例独立评判并交叉核对,成本高且存在主观性,可引入 VLM-as-judge 并报告与人评的一致率作为校准,作者也计划开发自动化评测框架。第三,因素混杂:单一成功率无法定位失败发生在理解、整合还是生成阶段,应设计模态消融与提示显隐对照实验来归因。第四,小样本子类不稳:Puzzles(6例)、Cartoons(5例)等子类成功率方差极大,容易误导读者,应扩充样本或报告置信区间。第五,物理推理覆盖有限:任务集中在家庭操作、日常续写与声音消歧,缺少长程因果、流体、软体等复杂物理场景,可借鉴 Physics-IQ 的物理预测设定与 AV-Phys Bench 的跨流一致性检验来扩充维度。
未来方向
作者提出的方向:持续扩充评测集,纳入更多样的物理世界场景、模态组合与推理要求;开发能够可靠评估生成内容中推理结果的自动化评测框架,实现对未来全模态模型可扩展、可复现的测试;开展移除单模态、固定视觉替换音频等受控实验以分离失败因素。基于本文成果还可延伸:一是把 Chain-of-Frames 中的中间帧当作显式推理链做干预研究,定位误差首次出现的时刻,判断失败源于理解还是生成;二是把专家判据转化为训练信号,例如用于拒绝采样或 RLHF,专门改善 ADR 27.40% 的音频 grounding 短板;三是量化各模态对成功率的边际贡献,指导多模态架构的融合层设计;四是与机器人决策结合,VDR 的预测性反应(如提前避让)直接对应具身智能的安全推理需求;五是把隐式提示构造流程推广到音频生成与 3D 生成模型的推理评测,形成通用的'证据分布式评测'范式。
复现评估
论文给出项目页面(github.com/gulucaptain/MiniMax-H3-Reason),评测协议、隐式提示构造准则、四维评审标准与失败分类都描述得相当详细,工程可复现性较好。但完整复现需跨过多道门槛:评测数据由十余个第三方数据集拼装(HiFi-UMI-2K、VISTA-UMI-5K、HuMI-Unsheathe、Hy-Embodied-0.5-VLA-Data、10Kh-RealOmin-OpenData、LLaVA-Video-178K、FSD50K、ESC-50),需逐个申请获取且许可各异;被测模型 MiniMax-H3 为开放权重,但对 517 个实例逐一生成视频仍需可观的 GPU 算力与推理预算;最难的环节是人工评测——需要 3 名领域专家独立评判并交叉核对,既昂贵又难以完全标准化。总体评估:若数据与代码如约开源,复现定量结果难度中等,独立复刻整套人评流程难度较高,更现实的路径是复用其协议设计、改用自动评测替代专家评判。
论文图表
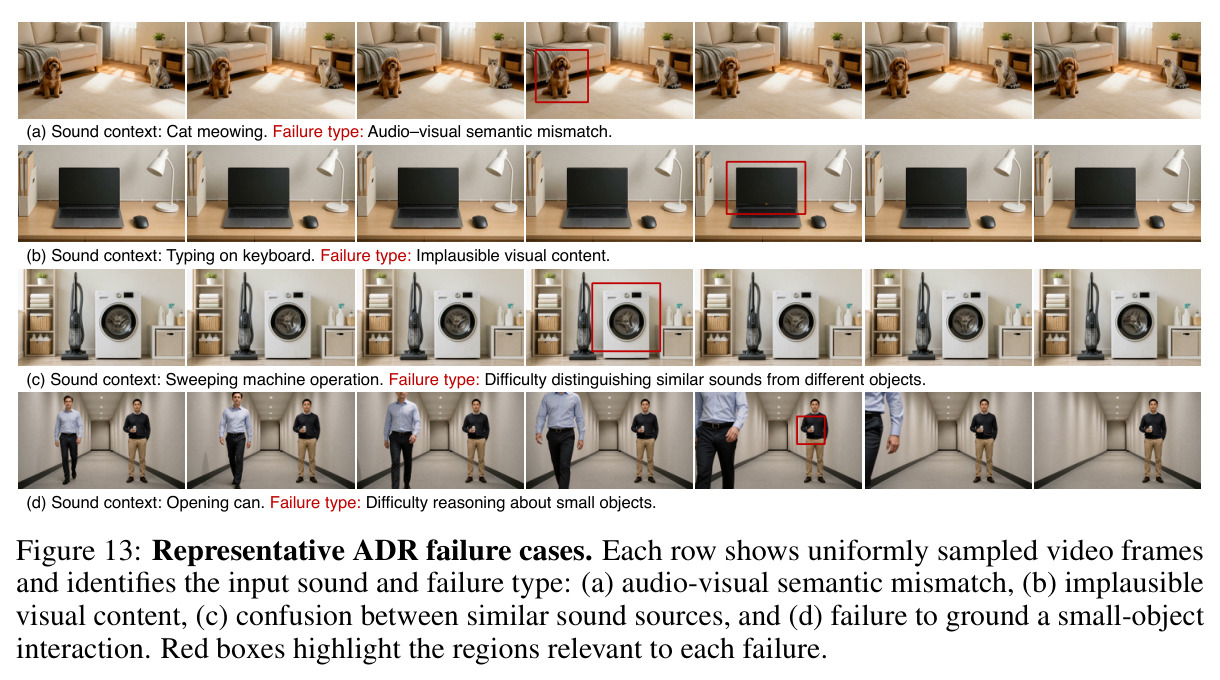
展示四个代表性 ADR 失败案例,红框标出失败相关区域:(a) 猫叫声输入却生成不匹配内容——音视频语义不匹配;(b) 键盘打字声——视觉内容不合理;(c) 扫地机运作声——难以区分不同物体的相似声音;(d) 开罐声——无法对小物体交互做推理。
具体化 ADR 的四类失败模式,说明 27.40% 成功率背后的机制性缺陷(证据错误绑定、小物体 grounding 失败等),是理解模型短板的关键。
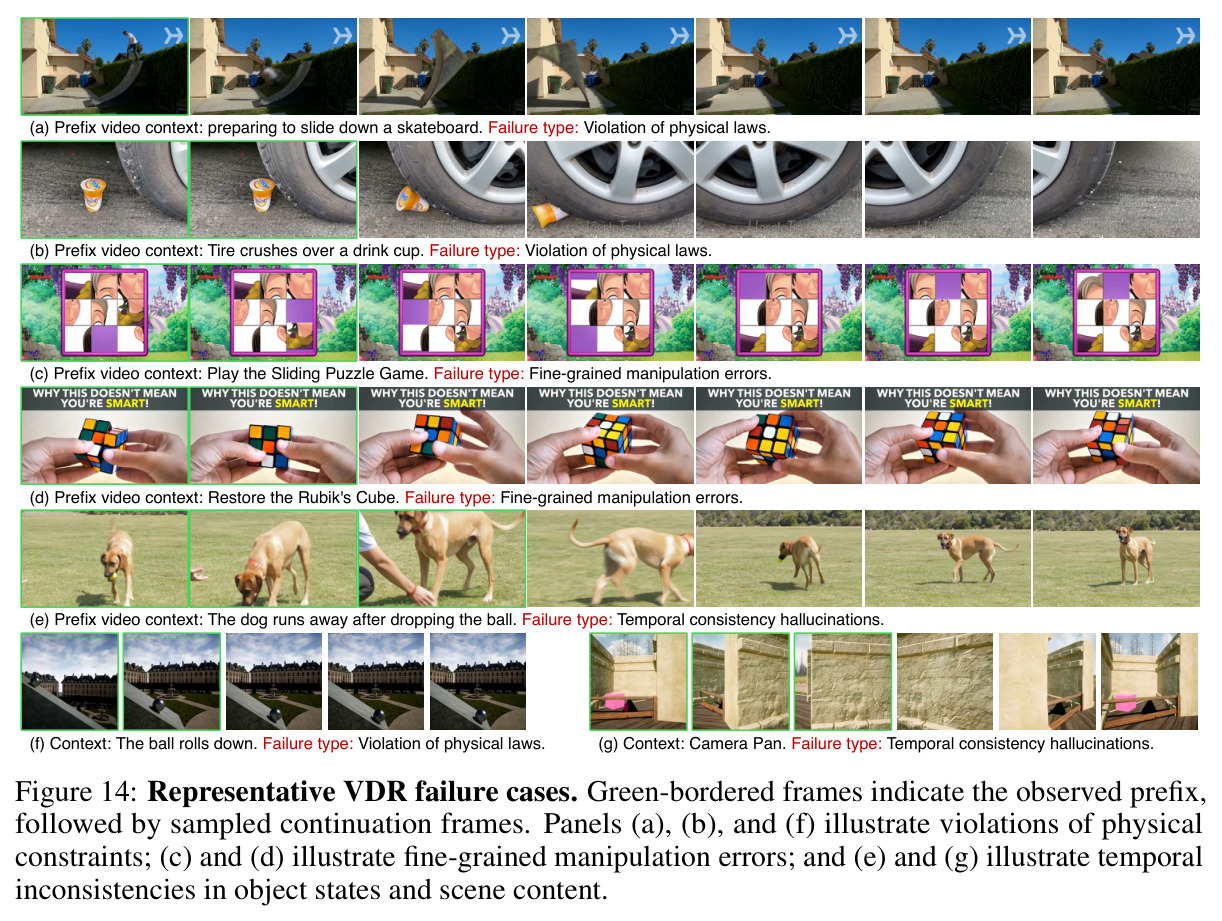
展示七个代表性 VDR 失败案例,绿框为观测前缀帧:(a) 滑板下滑准备、(b) 轮胎碾过饮料杯、(f) 球滚落——违反物理规律;(c) 滑块谜题、(d) 复原魔方——细粒度操作错误;(e) 狗丢球后跑开、(g) 相机平移——时序一致性幻觉。
与 VDR 最高成功率 56.00% 形成对照,揭示即使最好的场景也存在物理违反、细粒度操作与时序幻觉三类系统性失败。