论 KL 正则化策略优化:面向异步 LLM 智能体的免 Critic 单 Rollout 框架 On KL-Regularized Policy Optimization
以采样器为锚的 KL 正则策略优化:免 critic、单 rollout,适配异步智能体训练
前置知识
KL 正则化策略改进与 Gibbs 解
在最大化期望改进信号的同时惩罚与参考分布的偏离:$\max_\pi \mathbb{E}_{z\sim\pi}[f(h,z)] - \beta\,\mathrm{KL}(\pi\,\|\,\mu(\cdot|h))$。该问题有唯一闭式 Gibbs 解 $\pi^*_f(z|h) \propto \mu(z|h)\,e^{f(h,z)/\beta}$,是 REPS、MPO、策略镜像下降(PMD)与 RPG 共享的基础改进步骤。
KLPO 的全部推导都始于"以采样器为参考"的这一步 KL 正则化改进,再把其对数形式的最优性条件改写为最小二乘回归问题;不理解 Gibbs 解就无法理解回归目标从何而来。
重要性比率与 off-policy 裁剪
当训练器 $\pi_{\theta_t}$ 与产生数据的采样器 $\pi_{\theta_{t-k}}$ 不一致(checkpoint 陈旧或推理引擎数值差异)时,PPO 用比率 $\pi^{\text{trainer}}/\pi^{\text{sampler}}$ 加权梯度并裁剪到 $[1-\epsilon,\,1+\epsilon]$ 来控制方差;裁剪使更新有偏,且 token 级比率随轨迹变长、滞后变大而更极端。
训练器–采样器鸿沟是本文要解决的核心问题,KLPO 的卖点正是完全去掉这一比率;理解重要性加权方法的代价,才能体会本文设计选择的动机。
log 配分函数(log-partition)
Gibbs 解的归一化常数 $c_f(h)=\beta\log\mathbb{E}_{z\sim\mu}\big[e^{f(h,z)/\beta}\big]$,需要对上下文 $h$ 处所有可能结果的信号求期望:响应级要求每条 prompt 的多条 rollout,token 级要对整个词表求和,实践中无法精确计算。
本文的 profiling 技巧把这个不可解的常数替换为"信号均值 + 采样器到训练器的 KL 散度",是全文最关键的技术恒等式之一,也是免组采样、单 rollout 可行的原因。
优势函数与 critic
优势 $A(s,a)=Q(s,a)-V(s)$ 度量动作相对平均水平的好坏,标准计算需要价值网络(critic)。GRPO 用同一 prompt 一组响应的经验均值代替 $V$,代价是每条 prompt 多次生成;PPO 则显式训练一个 critic 追踪移动的策略。
KLPO 的 token 级实例以采样器优势为信号,却能从终止回报 $R$ 出发、经采样器中心化 score 或单轨迹残差两条路线恢复梯度,完全绕开 critic——这是论文的核心贡献,不熟悉优势与 critic 的耦合就看不到这一步的分量。
SPPO/GPO/REBEL/BPO:log-ratio 回归一族
近年偏好与奖励优化方法:SPPO 用胜率、GPO 用偏好分数、REBEL 用奖励差对策略 log-ratio 做回归;BPO 从 token 级策略镜像下降出发做免 critic 的轨迹回归。它们独立提出、损失形式各异,长期缺乏统一的总体目标解释。
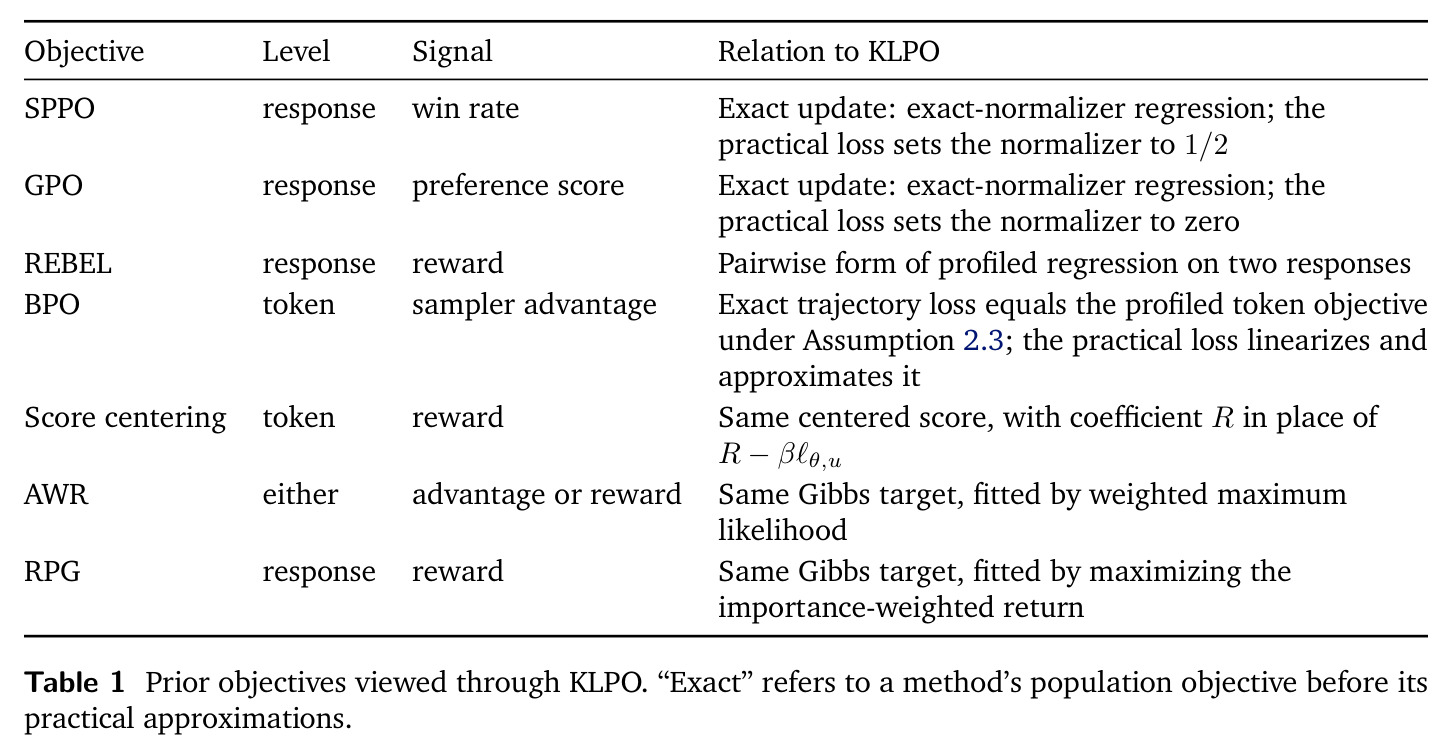
论文证明它们都是 KLPO 在不同上下文、信号与近似选择下的特例(Table 1);掌握这族方法有助于理解本文的统一定位,以及每个方法"实用损失"与"精确目标"之间的差距。
研究动机
面向 LLM 智能体的强化学习天然是异步的:单个 episode 常常持续数分钟、交错多次工具调用、结束时间不可预测,于是 worker 拿着手里最后一个 checkpoint 继续生成,learner 则边收到轨迹边更新。结果是每次更新都涉及两个策略——被改进的训练器 $\pi^{\text{trainer}}_{\theta_t}$ 与产生数据的采样器 $\pi^{\text{sampler}}_{\theta_{t-k}}$,后者滞后 $k$ 步且随轨迹各不相同,在工具延迟波动时没有固定上界;即便 $k=0$,推理引擎的采样变换、量化和数值内核也会使同一参数下两边概率不同。现有对策各有代价:PPO 对 token 级重要性比率裁剪,引入偏差且长轨迹上比率更极端;学习 critic 意味着第二个模型要追踪一个移动的策略;GRPO 用组相对优势免掉 critic,却要求每条 prompt 采样一组响应,当单条 episode 本身就很长(智能体任务里动辄数千 token、多次工具往返)时成本难以接受。
本文的目标是本文要构造一个天然围绕两个策略(训练器与采样器)构建的策略优化目标族 KLPO,使其同时满足:一、不需要重要性权重,因而没有需要裁剪、会沿长轨迹累积爆炸的比率;二、不需要 critic,也不需要学习的归一化器;三、每条 prompt 只需一条完整 rollout,适配 episode 昂贵的智能体任务;四、陈旧性($k>0$)与执行不匹配($k=0$ 但推理引擎与训练器概率不同)被同一机制覆盖;五、跨 checkpoint 的回放可以表示为逐版本良定义回归的混合。作者还要求给出从目标到可反传损失的完整推导、梯度无偏性证明,并说明 SPPO、GPO、REBEL、BPO 等已有方法如何作为特例落入该框架。
与已有工作不同的是,既有方法都把第二个策略当作"修正项":在单策略目标上乘以重要性比率再裁剪。本文的独特切入是反过来——把 KL 正则项的参考分布直接锚定在产生数据的那个策略上,让采样器同时充当 KL 参考与数据分布,因此不再需要单独的参考模型。这一改动使正则化改进步拥有闭式 Gibbs 解;对解取对数后,最优性条件变成"$\beta\log(\pi^*/\mu)=f-c_f$"的逐样本方程。关键一步是作者不再把这个 log-ratio 指数化并裁剪,而是把它当作回归变量,在采样器自己的轨迹上用最小二乘拟合该方程——重要性权重从乘法因子降格为回归的自变量,梯度中不再出现任何比率,而回归目标恰好就是正则化目标选出的那个策略。
核心方法
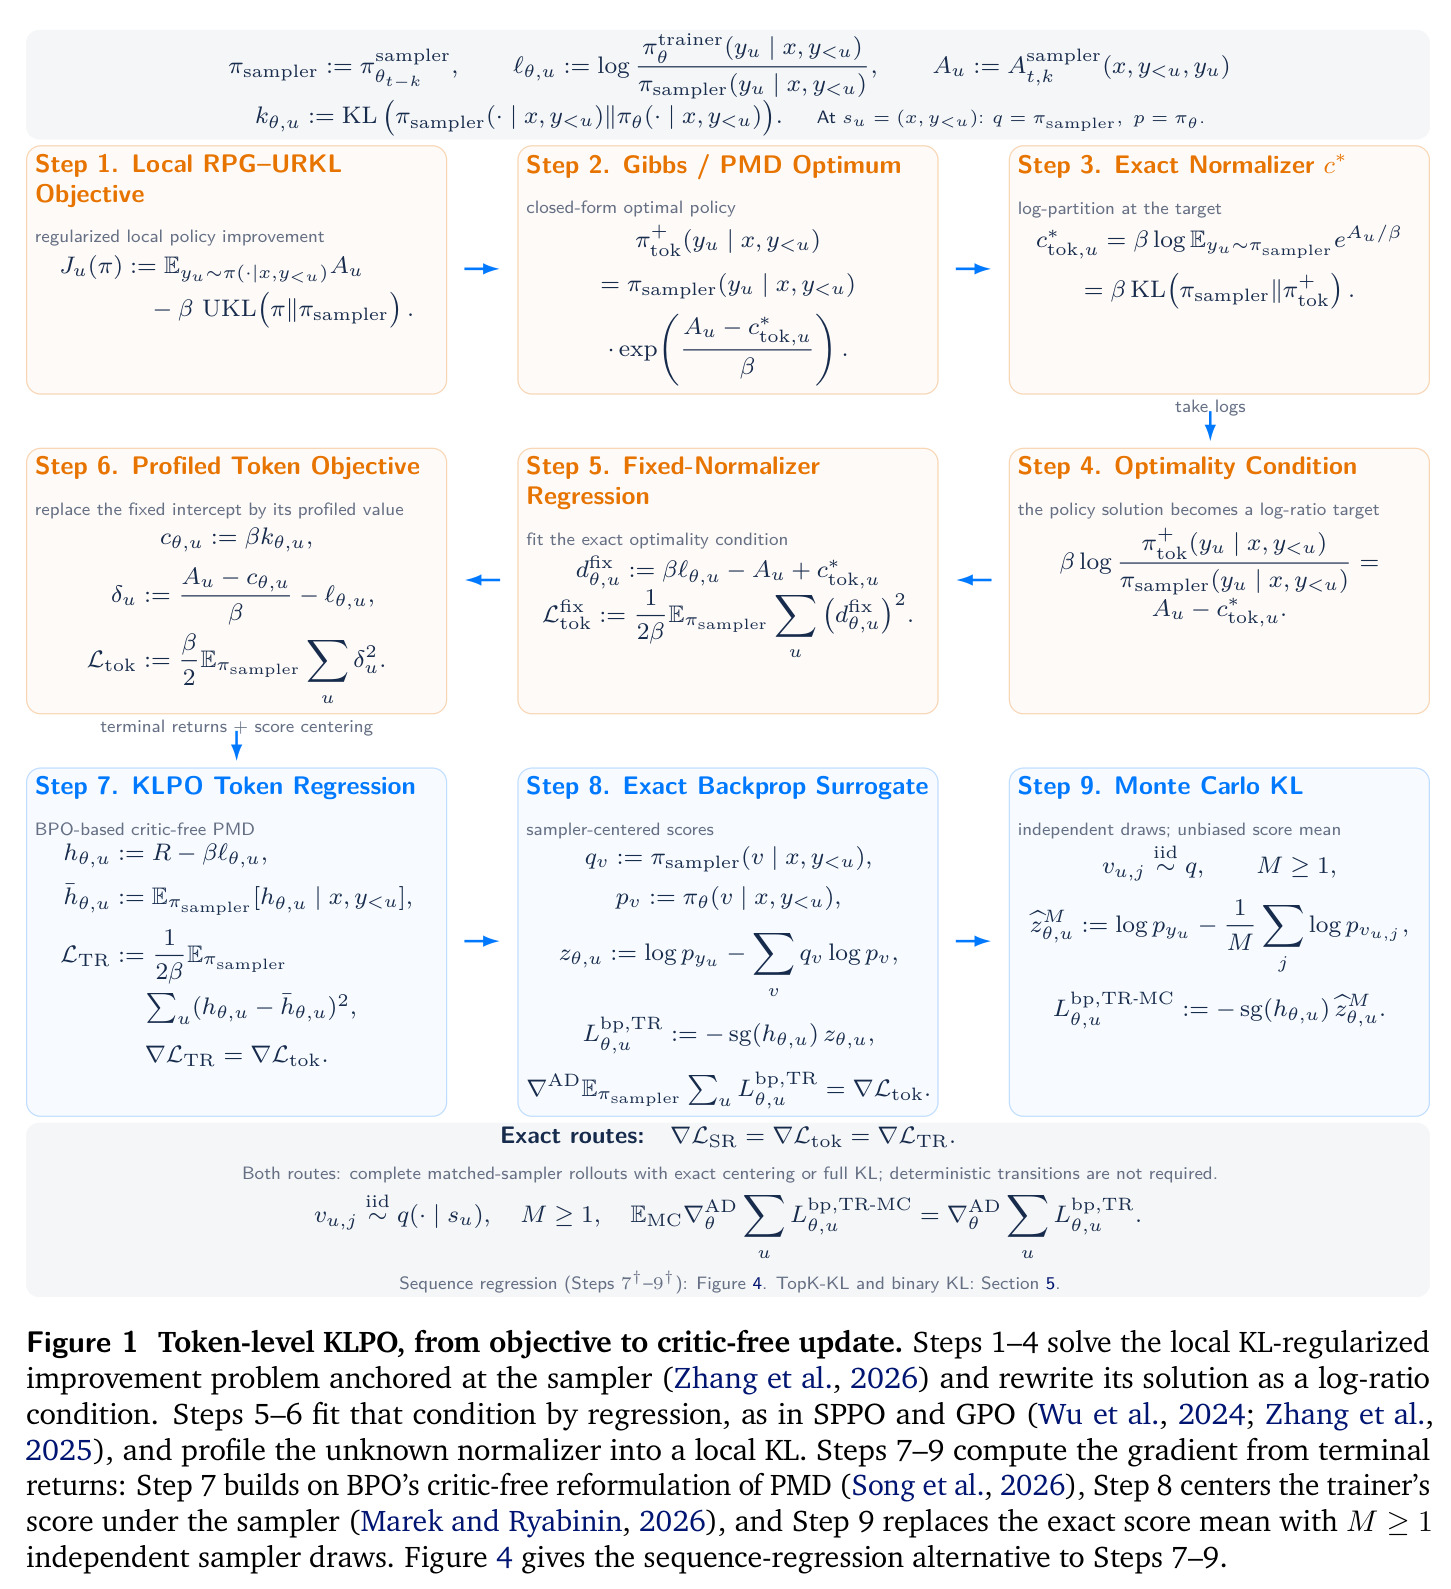
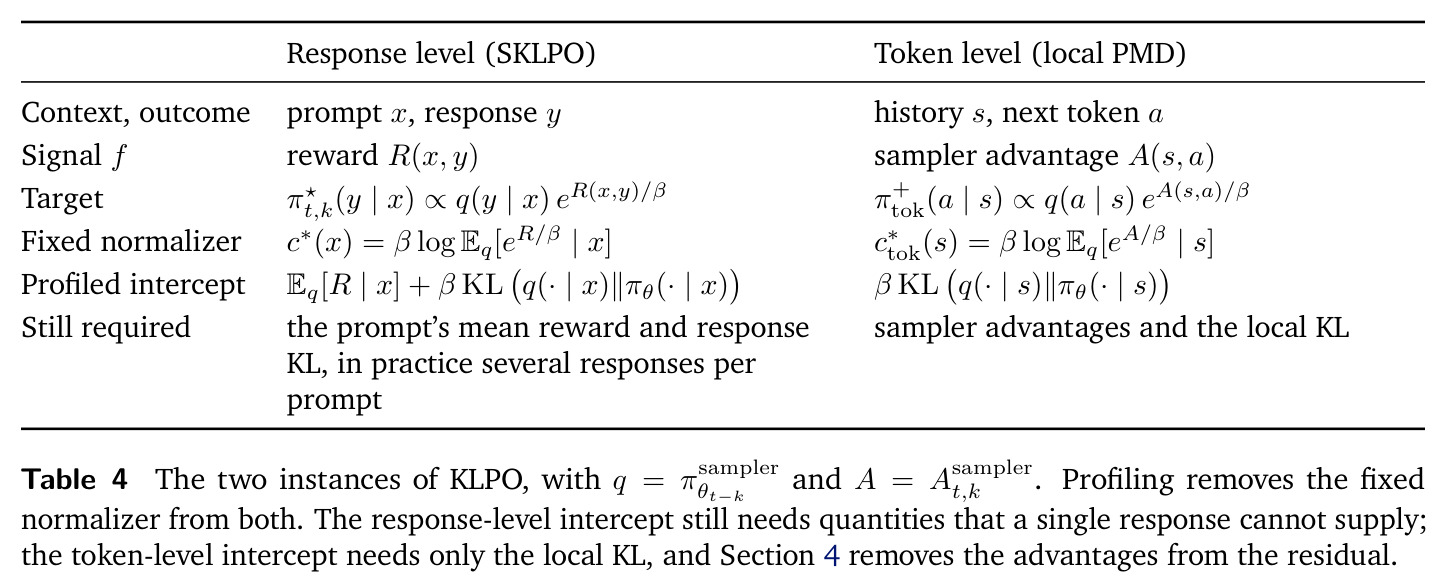
直觉上,与其用重要性权重"修正"别处采来的数据,不如承认数据属于采样器,直接对采样器做一步 KL 正则化改进。技术路线分四层。第一层(局部目标):在每个历史 $s$ 上最大化 $J_s(\pi)=\mathbb{E}_\pi[A^{\text{sampler}}_{t,k}]-\beta\,\mathrm{KL}(\pi\|\pi^{\text{sampler}}_{\theta_{t-k}})$,闭式解 $\pi^{+}_{\text{tok}}\propto\pi^{\text{sampler}}e^{A/\beta}$。第二层(回归化):对解取对数得 $\beta\log(\pi^{+}_{\text{tok}}/\pi^{\text{sampler}})=A-c^*_{\text{tok}}$,在采样器轨迹上以平方损失拟合;不可解的 log 配分函数通过 profiling 消去,得截距 $c_\theta(s)=\beta\,k_\theta(s)$,即采样器到训练器的局部 KL,可由两个 next-token 分布直接算出。第三层(去 critic):优势本需 critic,但两条路线从终止回报 $R$ 恢复梯度——token 回归用中心化 score $\hat g_\theta=g_\theta+\nabla_\theta k_\theta$ 乘 $h_{\theta,u}=R-\beta\ell_{\theta,u}$;序列回归把残差 telescoping 成单轨迹残差 $D_\theta=R-\beta\sum_u[\ell_{\theta,u}+k_\theta(s_u)]$。第四层(工程化):KL 校正用 MC、TopK、二值估计器近似,跨版本按各自采样器逐轨迹回归。
核心创新有三点。其一,锚定采样器:KL 正则的参考就是产生数据的策略,执行不匹配(推理引擎概率差异)与陈旧性被同时覆盖,回放变成"每个采样器版本一个良定义回归"的固定混合。其二,log-ratio 的角色翻转:重要性加权方法必须把 $\ell_\theta=\log(\pi_\theta/\pi^{\text{sampler}})$ 指数化并裁剪,KLPO 让它作为回归变量进入 $L^{\text{tok}}=\frac{\beta}{2}\mathbb{E}\sum_u\delta_u^2$,梯度 $-\beta\mathbb{E}\sum_u\delta_u g_\theta$ 中没有任何比率,回归目标恰是正则化目标选出的 Gibbs 策略。其三,profiling 恒等式:截距取 $c_\theta(h)=\mathbb{E}_\mu[f]+\beta\,\mathrm{KL}(\mu\|\pi_\theta)$ 时损失最小,从而 $c_f=\mathbb{E}_\mu[f]+\beta\,\mathrm{KL}(\mu\|\pi^*_f)$——log-partition 被"信号均值 + KL"替换。与 GRPO 的本质区别:组相对均值被解析截距取代,单条 rollout 即可无偏估计梯度;与 PPO 的本质区别:没有需要裁剪的比率,训练器–采样器鸿沟不再是偏差来源。
方法步骤详情
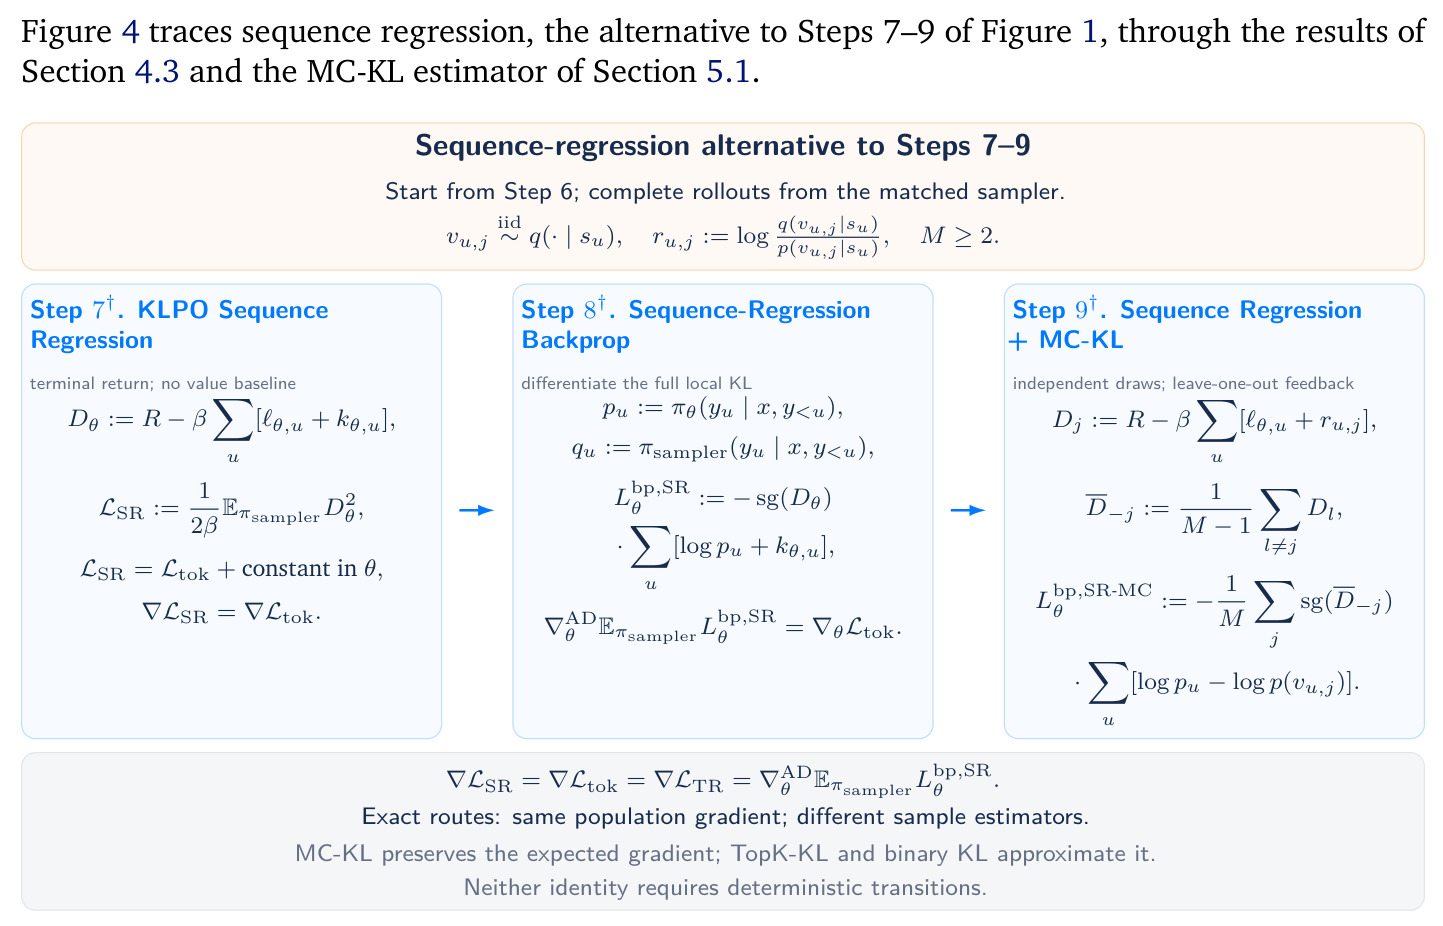
按 Figure 1 的九步走。Step 1 写下局部 URKL 目标 $J_s(\pi)$,以采样器为 KL 参考;Step 2 得 Gibbs 最优 $\pi^{+}_{\text{tok}}$;Step 3 算归一化器 $c^*_{\text{tok}}(s)=\beta\log\mathbb{E}[e^{A/\beta}]$;Step 4 取对数得逐 token 方程 $\beta\log(\pi^{+}_{\text{tok}}/\pi^{\text{sampler}})=A-c^*_{\text{tok}}$;Step 5 固定截距回归 $L^{\text{fix}}=\frac{1}{2\beta}\mathbb{E}\sum_u d^2_{\theta,u}$;Step 6 profiling 得 $L^{\text{tok}}=\frac{\beta}{2}\mathbb{E}\sum_u\delta_u^2$,$\delta_u=A/\beta-\ell_{\theta,u}-k_\theta(s_u)$,残差条件均值为零;Step 7 免 critic token 回归:中心化 score $\hat g_\theta=g_\theta+\nabla_\theta k_\theta$、系数 $h_{\theta,u}=R-\beta\ell_{\theta,u}$,恒等式 $L^{TR}=L^{\text{tok}}+\frac{1}{2\beta}\mathbb{E}[\sum_u(R-Q)^2]$ 表明多出项与 $\theta$ 无关;Step 8 可反传代理 $L^{bp,TR}_{\theta,u}=-\mathrm{sg}(h_{\theta,u})z_{\theta,u}$;Step 9 用 $M\ge1$ 个独立辅助 token 的 MC-KL 替换词表求和。序列路线(7†–9†)改用单残差 $D_\theta$ 与 $M\ge2$ 的 U 统计量。最后每条轨迹按其版本 $v_i$ 的采样器回归,训练器侧的量在复用时重算。
技术新颖性
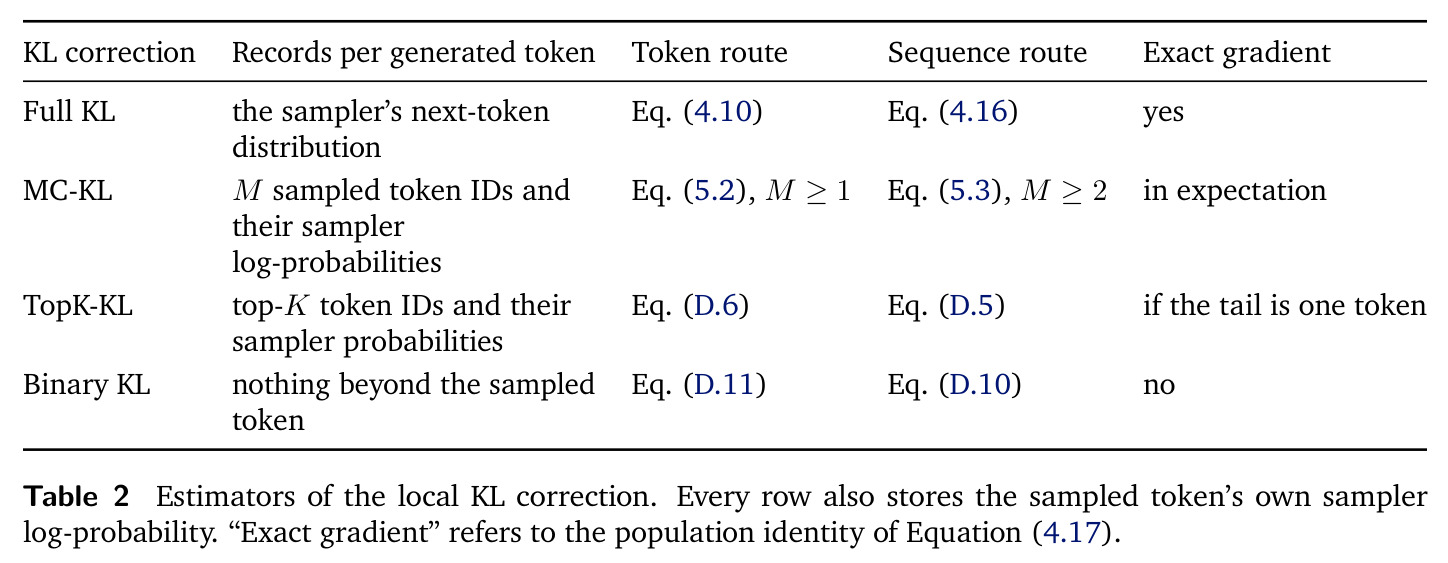
新颖性首先体现在统一:论文证明 SPPO 与 GPO 是响应级 KLPO 的精确归一化器回归(实用损失分别把归一化器设为 $1/2$ 和 $0$)、REBEL 是 profiled 响应级回归的成对形式、BPO 的精确轨迹损失与 profiled token 目标在 Assumption 2.3 下完全相等(Theorem 4.3),AWR 与 RPG 共享同一 Gibbs 目标但拟合方式不同。其次是若干新的理论恒等式:profiling 公式 (3.6)–(3.7);两条免 critic 梯度路线在总体上相等 $\nabla_\theta L^{SR}=\nabla_\theta L^{\text{tok}}=\nabla_\theta L^{TR}$,但估计器不同——token 回归逐 token 加权 $R-\beta\ell_{\theta,u}$,序列回归整条轨迹共享残差 $D_\theta$;序列情形的 MC-KL 必须用留一 U 统计量 $\tilde L=\frac{1}{2\beta M(M-1)}\sum_{j\ne l}D_jD_l$ 才无偏;TopK 与二值 KL 的精确缺口 $k_\theta-k^{\text{K}}_\theta=q_{\text{tail}}\mathrm{KL}(q_{\text{tail}}\|p_{\text{tail}})$。把"一组响应"替换为"解析截距 + 局部 KL 校正"在设计层面也是新的:归一化不再依赖数据增强,而是依赖两个分布的解析量。
实验结果
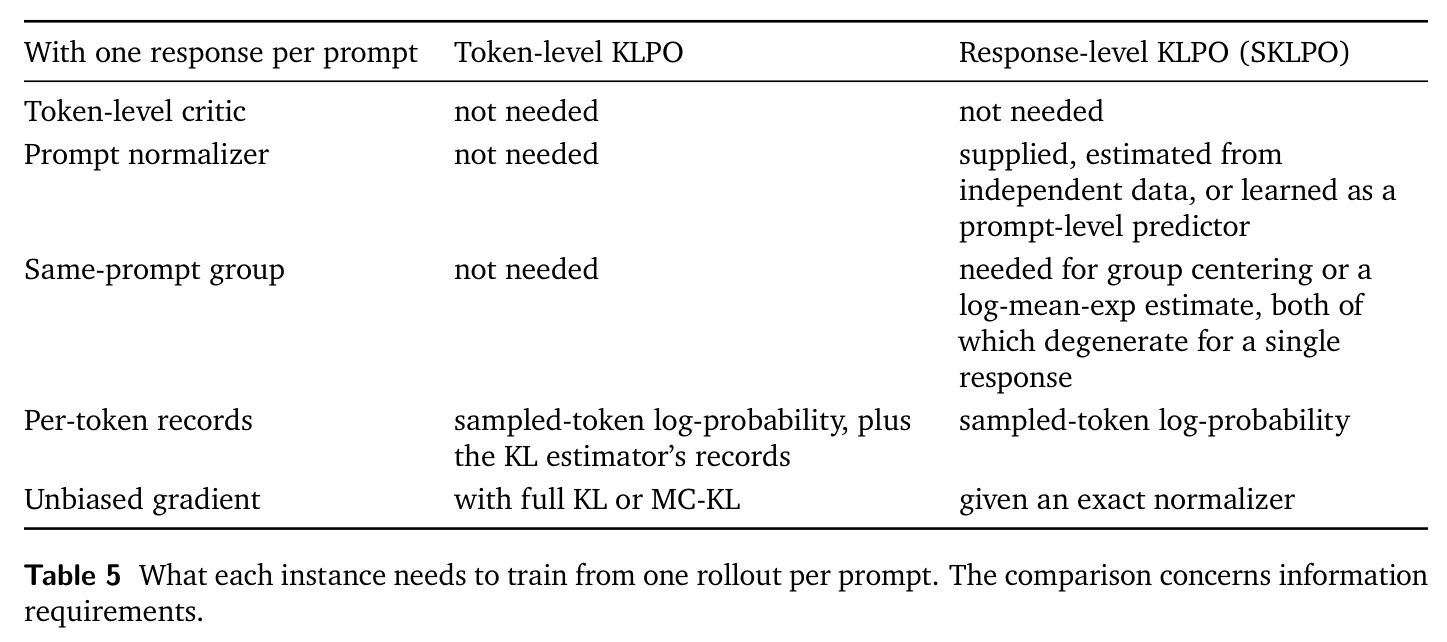
纯理论论文,无实验基准;其"结果"是一组定理与恒等式。Theorem 3.2(式 3.4):$\nabla_\theta L_f=\mathbb{E}_\nu[a\,r_\theta\nabla_\theta\log\pi_\theta]$,无重要性乘子;$\nu$ 覆盖支撑且目标可实现时零损失当且仅当 $\pi_\theta=\pi^*_f$。Proposition 3.3:profiling 截距 $c_\theta(h)=\mathbb{E}_\mu[f]+\beta\,\mathrm{KL}(\mu\|\pi_\theta)$,profiled 损失为 $\mathrm{Var}_\mu(f-\beta\ell_\theta)/(2\beta)$。Theorem 4.2:$L^{TR}=L^{\text{tok}}+\frac{1}{2\beta}\mathbb{E}[\sum_u(R-Q)^2]$,第二项与 $\theta$ 无关,从终止回报即得相同梯度、免 critic,随机工具输出只增方差不出偏差。Theorem 4.3:$L^{\text{tok}}=\frac{\beta}{2}\mathbb{E}[\delta^2_{\text{BPO}}]$,与 BPO 精确轨迹损失等价。Proposition 5.1:独立 MC draws 下 token 路线($M\ge1$)与序列路线($M\ge2$,U 统计量)期望梯度均等于满 KL 情形。式 (5.6):TopK 恰好差尾部散度 $q_{\text{tail}}\mathrm{KL}(q_{\text{tail}}\|p_{\text{tail}})$。Proposition 6.1:版本条件化批量梯度等于各版本目标的频率加权混合。反面例证 Proposition B.4:单响应时 SKLPO 自中心化使残差恒为零,响应级实例在异步场景退化,token 级 KLPO 不会。
局限与改进
作者明确承认三点未竟事项:大规模实证评估、有限样本与收敛性分析、以及随机环境下的价值学习(Appendix I.7)。此外还可观察到更多限制:其一,所有恒等式都在总体/期望层面成立,论文未量化估计方差——系数 $h_{\theta,u}=R-\beta\ell_{\theta,u}$ 把整条轨迹回报塞进每个 token 的系数,长 horizon 下序列残差 $D_\theta$ 的平方可能方差极大;其二,Assumption 2.1–2.3 要求有限词表、有界确定性奖励(如 verifier 分数)、正性支持,精确 telescoping 还需确定性转移(工具输出为历史的确定函数);其三,MC-KL 每个前缀需 $M$ 次额外采样,TopK 需存 top-K 表,二值 KL 最便宜但破坏零均值恒等式,导致两路线在总体上不一致、奖励偏移会改变更新方向;其四,混合多个采样器版本时,即使容量无限,训练器也只能收敛到依赖滞后分布的折衷(Proposition A.6);其五,logged 概率的误差会直接偏移 log-ratio 与 KL 校正,论文仅在 Appendix I.2 定性讨论。
独立分析的弱点
第一,理论–实践鸿沟:全文没有与 PPO/GRPO 的任何实证对比,闭式恒等式在真实异步系统(不同推理引擎、量化、连续发布 checkpoint)中的表现完全未知,改进方向是在智能体基准上做受控消融,测量 $\beta$、$M$、TopK 的 $K$ 等超参敏感性。第二,方差控制缺位:token 回归系数与序列残差都含整条轨迹回报,长轨迹下方差可能吃掉"免 critic"省下的成本,改进方向是利用论文已证明的基线不变性($R-b(x)$ 不改变期望梯度)引入 prompt 级基线。第三,MC-KL 的开销与陷阱:每个前缀 $M$ 次独立 draws 增加前向计算与存储,且单次估计可为负、截断到零会破坏无偏性,工程上很容易"顺手修坏",改进方向是自适应 $M$ 或共享前缀复用 draws。第四,版本折衷问题:多版本混合没有唯一目标,改进方向是按 lag 显式衰减加权,或为旧版本维护轻量适配头。第五,实现精度敏感:逐 token 记录采样器 log-prob 与 KL 记录,日志精度直接决定理论保证是否成立,需要配套数值校验工具。
未来方向
作者提出的下一步:大规模实证评估、有限样本与收敛性分析、为随机环境引入价值学习(Appendix I.7)。基于本文成果还可自然延伸:一、自适应 $\beta$ 调度——profiling 截距中的 $\beta\,\mathrm{KL}(\mu\|\pi_\theta)$ 项天然度量"当前训练器离目标的距离",可作为调度信号;二、把版本混合权重从经验频率改为显式设计的滞后衰减或置信加权,正面回应折衷问题;三、与 replay 优先级、课程学习结合,研究每条轨迹按其采样器版本的回归权重;四、实证测量执行不匹配(推理引擎 vs 训练器)在真实系统中的量级,验证"锚定采样器"相比 importance clipping 的实际收益;五、把 SPPO/GPO/REBEL/BPO 的实用技巧(平滑、裁剪、组归一化)逐项映射回 KLPO 框架做消融,找出各自真正必要的成分;六、将 token 级 KLPO 与策略镜像下降的收敛理论对接,给出非渐近速率与样本复杂度界;七、探索在偏好循环(非标量奖励)信号下 KLPO 的推广,论文的信号 $f$ 框架已为此留好接口。
复现评估
论文提供项目页 https://github.com/yifanzhang-pro/KLPO,但正文未附代码、数据或模型;作者说明使用了 LLM 辅助证明与润色。作为纯理论工作,"复现"包含两层。一是数学验证:主要恒等式——式 (4.8) 的 $L^{TR}$ 分解、式 (4.11)–(4.14) 的 telescoping 等价、式 (5.4) 的 U 统计量、式 (5.6) 的 TopK 缺口、Proposition 6.1 的版本混合——都可在小规模玩具设置(小词表、人工构造滞后采样器、确定性 verifier 奖励)中数值验证,普通工作站即可。二是算法实现:Algorithm 2 要求训练框架逐轨迹记录版本 $v_i$、采样器 log-probabilities 及 KL 估计所需记录(MC token id 或 top-K 表),在 vLLM 等异步栈上改造成本中等;理论上单 rollout 每 prompt 反而比 GRPO 便宜。总体评估:数值验证容易,忠实复现异步训练环境并测出相对 GRPO/PPO 的收益,则需要可观的工程与算力投入。
论文图表
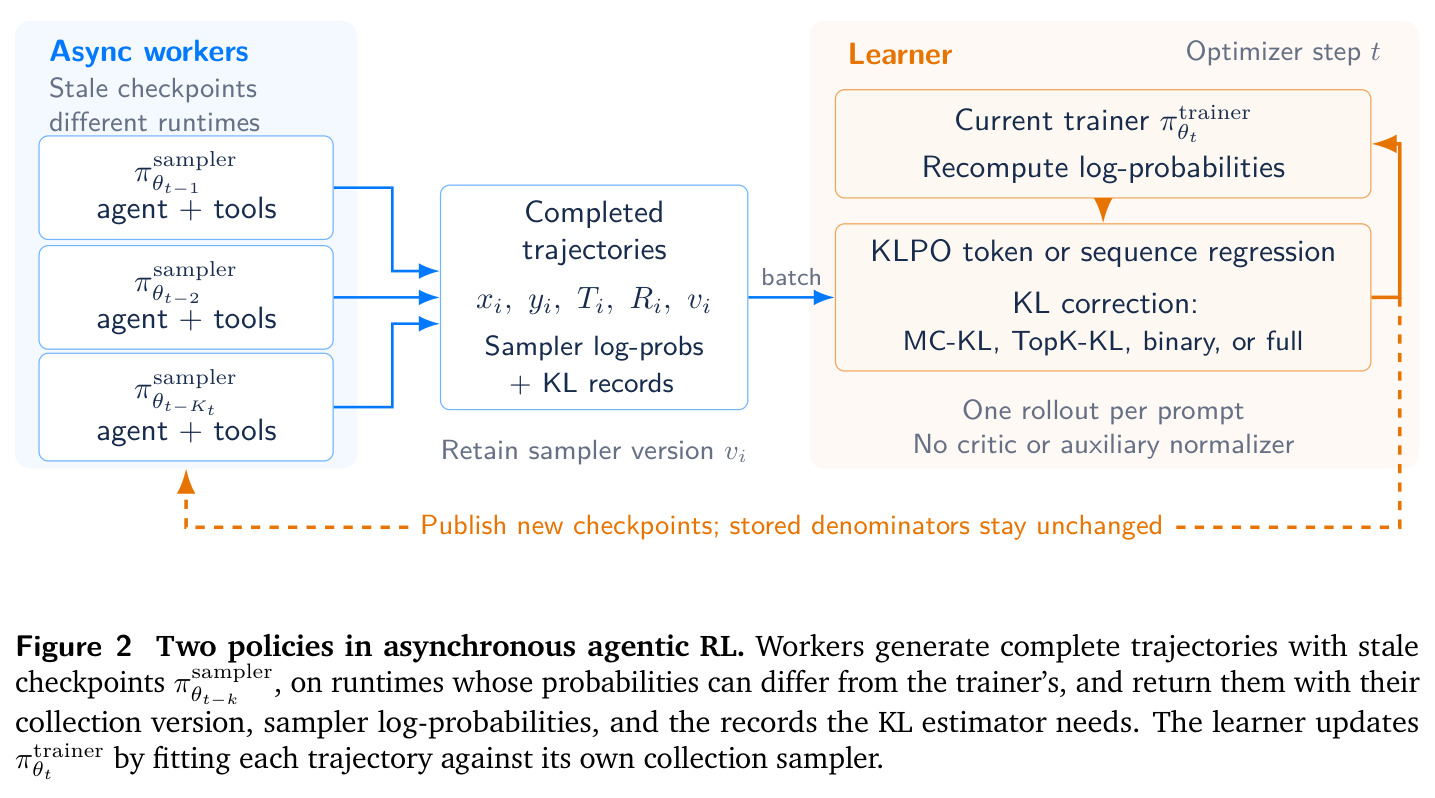
系统示意图:左侧多个异步 worker 各持不同陈旧程度的 checkpoint($\theta_{t-1},\theta_{t-2},\ldots,\theta_{t-K_t}$),在各自运行时(agent + tools)上生成完整轨迹,连同采样版本 $v_i$、采样器 log-probs 和 KL 估计所需记录一起交给 learner;右侧 learner 在优化步 $t$ 持有当前训练器 $\pi^{\text{trainer}}_{\theta_t}$,对每个 batch 重算 log 概率、执行 KLPO token 或序列回归、用 MC/TopK/二值或满 KL 做校正;每条 prompt 只需一条 rollout,无 critic 或辅助归一化器,旧 checkpoint 发布后其存储的分母保持不变。
它直观呈现了论文要解决的系统结构——陈旧性与执行不匹配从何而来,以及 KLPO 需要哪些运行时记录;不看这张图很难理解 Section 6 版本条件化更新的工程前提与数据管道要求。