NeMo-DCR:面向万亿参数智能体强化学习的比特精确增量压缩权重同步系统 NeMo-DCR: Bit-Exact Delta-Compressed Refit for Scalable Agentic RL at Trillion-Parameter Scale
利用BF16每步仅约1%权重变化,比特精确增量同步让1T模型refit从87.5分钟降至150秒
前置知识
BF16(bfloat16)浮点格式
BF16 是 1 位符号、8 位指数、7 位尾数的 16 位浮点格式,只有约 8 个有效二进制位。训练中的小步参数更新往往不足以让存储值跨越舍入边界,因此被舍掉:例如 0.5 附近的多个实数值共享同一存储模式 $0x3F01$,只有更新越过该边界,存储的比特才会改变。此外按存储比特比较还能发现浮点比较会漏掉的符号零变化($+0.0$ 是 $0x0000$,$-0.0$ 是 $0x8000$)。
论文的核心前提是每步只有约 1% 的 BF16 存储值发生变化,这直接源于 BF16 的低精度舍入;而逐比特(而非浮点值)比较是保证比特精确的基础。
Refit(权重重载/同步)
在解耦式(disaggregated)RL 架构中,训练集群运行优化器更新策略权重,rollout 集群用 vLLM 等推理引擎生成响应样本。每次策略更新后,必须在新 batch 开始前把新权重同步到所有 rollout 接收端,这一步叫 refit。训练侧按张量/专家并行分片存储,推理侧布局完全不同(vLLM 会融合 QKV、按 rank 切分专家),所以 refit 要跨越布局、并行度和集群边界。
agentic RL 中 rollout 占整体 wall-clock 的 70% 以上,因此训练与 rollout 解耦成为主流,refit 的延迟直接决定训练吞吐,是本文要优化的目标操作。
规范坐标(canonical coordinates)
指 HuggingFace checkpoint 格式中模型张量的名字与扁平索引,是训练框架和推理引擎共同认可的中间表示。训练分片通过转换任务映射到规范张量,推理引擎的原生 loader 再把规范张量写入各 rank 的本地存储 $P^v_r = L_r(W^v)$。本文让增量(delta)全部用规范坐标描述,从而与两端的分片方式解耦。
直接投影和原生 loader 放置这两个核心创新都建立在'用规范坐标描述变更'之上,不理解它就无法理解放置(placement)难题如何被消解。
XOR 掩码编码
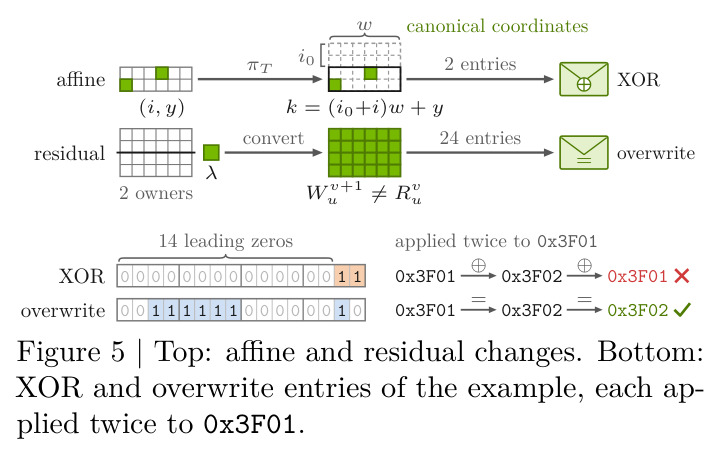
对每个变化的元素,不传输新值本身,而是传输旧存储比特与新存储比特的异或掩码 $x = I(S^{v+1})_j \oplus I(A^v)_j$,接收端把掩码异或到本地旧值上即得新值。小更新通常只影响低位,掩码有大量前导零,压缩率高;但同一掩码施加两次会还原旧值,因此必须去重,重试时需改用绝对覆盖。
混合 XOR/覆盖编码同时带来比特精确性(只翻转不同的比特)和压缩收益(payload 字节减少 38–40%),是本文效率贡献的核心。
MoE(混合专家)与专家并行
MoE 模型把每个 FFN 替换为大量专家,由 router 为每个 token 选择少数专家。专家权重按专家并行维度切分到不同 rank,例如 Qwen3-30B-A3B 有 18,432 个专家 gate/up/down 张量,占 61.06 GB checkpoint 的 94.95%。海量专家张量的分片映射结构决定了哪些转换是仿射的、可以本地投影。
论文评测的两个大模型都是 MoE,96.3%/97.0% 的仿射覆盖率结论直接来自专家张量可被固定映射类覆盖这一事实。
GRPO 与 agentic RL 训练
GRPO(Group Relative Policy Optimization)用同一 prompt 下多个响应的组内相对优势估计奖励,是 Qwen 等模型 RL 训练的主流算法。agentic RL 的 rollout 涉及多轮工具调用,耗时长,因此才要把 rollout 解耦到独立服务集群。本文的变化率测量和训练实验均基于 GRPO + agentic SWE(软件工程工具调用)任务,学习率 $10^{-6}$。
论文的元素变化率测量(Figure 2)和 50 步训练验证实验(Figure 9)都依赖这一训练设置,理解它才能评估实验的外部效度。
集合通信(NCCL)与跨集群集体
NCCL 等集合通信要求所有参与 rank 同时在线、同步参与 broadcast/all-gather。当训练集群与 rollout 集群之间没有 InfiniBand/EFA 直连路由时,跨集群集体容易超时,还把接收端成员和失败语义耦合到训练集群上。
需求 G4(无跨集群集体)以及对象存储/中继树两种传输设计,都是为了绕开跨集群集体的脆弱性与耦合而提出的。
研究动机
Agentic RL 把大部分时间花在生成样本上:论文指出 rollout 占整体 wall-clock 的 70% 以上,因此训练与 rollout 被解耦到不同集群——训练集群跑优化器,rollout 集群用 vLLM 等推理引擎生成响应,甚至可放到异地数据中心利用闲置 GPU。解耦的代价是每次策略更新都必须执行一次 refit:在下一批请求之前把更新后的权重送达所有 rollout 接收端。瓶颈在于模型尺寸与跨集群带宽的矛盾:在两个 AWS 区域之间传输 1T 模型的完整 checkpoint 需要 87.5 分钟,120B 模型(247.2 GB)经对象存储也要 750 秒。然而作者实测发现 BF16 训练每步只有 0.6–1.2% 的存储值发生变化(六个模型、GRPO 前五步平均、学习率 $10^{-6}$),其他报告也只给出 1.5–2.0%(Qwen3 RL)和 1,024 GiB checkpoint 的 1.98% 平均 delta。原因是 BF16 只有约 8 个有效位,优化器的小步更新大多被舍入掉。也就是说,全量传输的字节里 98–99% 花在未变化的元素上。
本文的目标是论文的目标是构建只传输变化部分的 delta refit 系统 NeMo-DCR,同时满足五项需求:G1 比特精确——接收端得到的参数与 buffer 比特与发送全量权重的 dense refit 完全一致(rollout–训练不匹配已知会破坏 RL 稳定性);G2 增量——传输量随变化的值、位置和元数据伸缩;G3 原生放置——由推理引擎自带的 loader 决定放置,refit 系统内不允许出现模型特定的放置规则;G4 解耦——不允许任何跨越训练与 rollout 集群的集合通信;G5 可恢复——能从 mid-refit 失败中恢复(包括修复部分写入),并用一条权威 commit 记录把每个新策略版本与其源侧基线绑定。最终目标是让跨集群逐更新 refit 在万亿参数规模下变得实用,量化锚点是:1T 模型在 3% 变化率下 refit 从 87.5 分钟降到 150 秒。
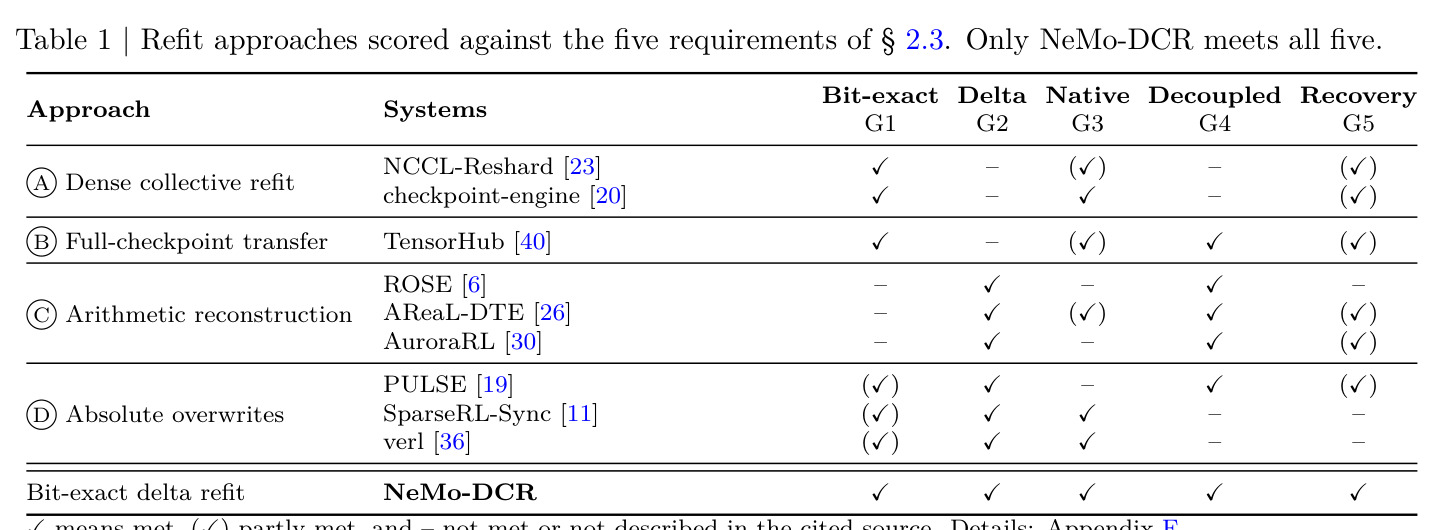
与已有工作不同的是,已有系统各只满足部分需求(Table 1):dense 集体 refit(NCCL-Reshard、checkpoint-engine)比特精确但传输全量;全 checkpoint 传输(TensorHub)解耦但仍全量;算术重建类(ROSE、AReaL-DTE、AuroraRL)传增量却可能引入浮点舍入误差——对旧值 $\alpha$ 与新值 $\beta$,舍入可使 $\alpha + (\beta - \alpha) \neq \beta$ 且误差跨版本累积;绝对覆盖类(PULSE、SparseRL-Sync、verl)避免舍入,但或在变化的值里重传未变比特、或需接收端维护基线副本。且 Table 1 中没有任何已有系统能完整满足 G5(mid-refit 失败恢复)。NeMo-DCR 的独特切入是把变更放在'规范坐标'中描述:固定仿射索引映射直接把训练分片上的变化投影到规范坐标(避免组装/转换整个张量),推理引擎的原生 loader 负责最终放置(避免重新实现放置规则),XOR/覆盖混合编码同时保证精确与可压缩,联合 commit 与覆盖重试解决恢复,流式传输则免去跨集群集体。
核心方法
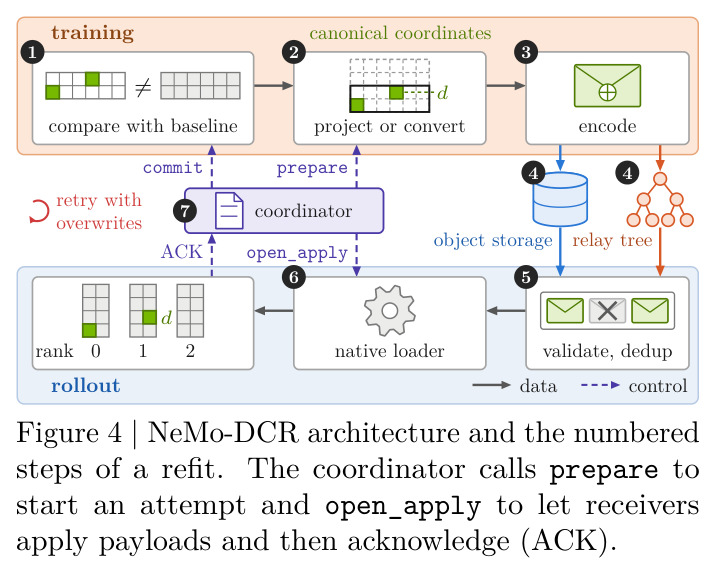
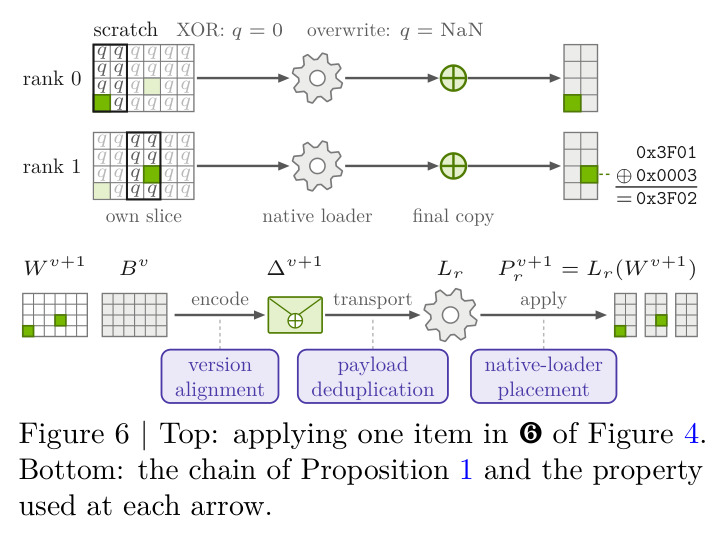
直觉上,NeMo-DCR 把一次 refit 拆成'构造增量—传输增量—应用增量—提交'四段并让它们流水线重叠。技术上,一次 transition(从版本 $v$ 到 $v+1$)包含七个编号步骤(Figure 4):① 每个分片的 owner(由稳定名字哈希从比特一致的数据并行副本中选出)将候选分片 $S^{v+1}_T$ 与提交基线 $A^v_T$ 逐比特比较,得到变化索引集 $C_T$;② 对仿射任务直接投影 $d = \pi_T(j)$、$o = I(Q_T(S^{v+1}_T))_d$,对残差任务(融合 QKV、共享缩放因子、tied embedding 等无支持映射的转换)先用 all_reduce_flags 选出受影响张量集 $\mathcal{U}_{req}$,组装转换结果并与分布式残差基线 $R^v_u$ 比较;③ 编码器把每条记录写成 XOR 条目 $(d, x)$ 或绝对覆盖 $(d, o)$,位置做 run/gap 编码,zstd level-1 压缩成 payload;④ 经对象存储或中继树流水线传输;⑤ 接收端校验、去重、按声明顺序入有界队列;⑥ 经 vLLM 原生 loader 应用:条目散布进 scratch 缓冲,dispatch hook 拦截 loader 的最终存储拷贝就地写入;⑦ 所有必需接收端确认后协调器做联合 commit,owner 就地更新基线。失败的 attempt 用全覆盖重试修复。
核心创新是用'规范坐标 + 原生 loader'把增量构造与接收端放置彻底解耦。训练分片位置不直接对应接收端存储位置:refit 可能 gather、拆分或置换张量,共享缩放因子还会在源值不变时改变大量转换后的值。已有系统要么重新实现服务引擎的放置规则(ROSE、AReaL-DTE),要么先组装完整张量再提取增量(AuroraRL、TRL、slime),两头都要付出代价。NeMo-DCR 则为 Megatron Bridge 支持的映射类(Direct、Replicated、ColumnParallel、RowParallel、GatedMLP 及合格的 Auto)写出固定仿射索引映射 $\pi_T$,owner 在本地即可算出每个变化元素的目的地,完全绕开张量组装——这覆盖了 Qwen3-30B-A3B 与 Nemotron-3-Ultra-550B-A55B 两个 MoE checkpoint 中 96.3%/97.0% 的权重字节;其余残差任务才做转换并与残差基线比较。放置完全交给 vLLM 原生 loader:系统只拦截其最终存储拷贝并规定一组 loader 条件,既不需要模型特定代码,又能得到与 dense refit 相同的比特(Proposition 1)。第二个关键点是 XOR 掩码既精确又可压缩:掩码只翻转不同的比特,小更新的高阶位不变、前导零多,zstd 后比覆盖值小 1.7–2.2 倍。
方法步骤详情
各步骤的输入输出与具体操作:① 变更检测:输入候选分片 $S^{v+1}_T$ 与 tracker $A^v_T$(基线驻留主机内存,约为 checkpoint 的 1.04×/1.03×;1,121 GB 的 Nemotron 由 32 个训练 rank 各摊约 36 GB),用 bitdiff 按存储比特比较(能抓住 $+0.0 \to -0.0$ 这类浮点比较漏掉的变化),输出 $C_T$;② 直接投影:对每个 $j \in C_T$ 计算 $d = \pi_T(j)$ 与更新值,例如 row-shard 上局部索引 $(i, y)$ 映射到规范索引 $k = (i_0 + i)w + y$,owner 无需知道接收端存储偏移;残差转换:owner 对变化的残差任务置标志,all_reduce_flags 结合转换依赖选出 $\mathcal{U}_{req}$,各 owner 转换自己那份,由规范名哈希选出的基线 owner 比特级组装 $W^{v+1}_u$ 并与 $R^v_u$ 比较得 $D_u$;③ 编码:表示保持且无重叠写的仿射记录用 XOR 掩码 $x = I(S^{v+1}_T)_j \oplus I(A^v_T)_j$,其余(如乘 $\lambda$ 再 cast、量化、nan_to_num)用覆盖值 $o$;记录按 chunk(64/256 MiB 目标)成桶(512 MiB),zstd 压缩并附 BLAKE2b-128 摘要,120B 时 32 个 owner 产出 482 个 payload;④ 传输:对象存储(owner 上传一次并维护 manifest,每个 rollout 节点各下载一次,跨集群流量约 $(1+N_{node})V_{payload}$)或中继树(每 payload 每次尝试只跨集群边界一次,$V_{cross} \approx V_{payload}$,ZeroMQ DEALER/ROUTER 流式转发);⑤ 接收:校验 attempt 有效性、摘要、schema、loader 分类,重复且字节相同的 payload 被忽略,然后按声明顺序进入有界队列(32 组×8 + 1 组装组,至多 264 个已解码 payload);⑥ 应用:写入 scratch(XOR 占位符 $q=0$、覆盖占位符 NaN),loader 解析名字并做 fused/split/转置等变换,dispatch hook 只更新活跃位置的就地存储副本;⑦ 提交:flush 收齐全部必需接收端的完成 ACK 后,控制平面以 compare-and-set 把提交记录 $K_v$ 原子换成 $(v+1, g)$,owner 读到新记录后就地更新 tracker 与残差基线;失败 attempt 先 mark_obsolete、stop_and_wait 停止写入,再从同一 $W^{v+1}$ 与未变的 $B_v$ 确定性重算完整变化集并全部改为绝对覆盖,因此无论先前哪些写入了,重试都得到 $L_r(W^{v+1})$。
技术新颖性
技术新颖性体现在四点。第一,直接投影:现有增量系统都不具备'从训练分片坐标一步映射到规范坐标'的能力——AReaL-DTE 要在接收端重排,SparseRL-Sync/verl 只支持置换类转换,而 NeMo-DCR 借助 Megatron Bridge 的映射元数据把 96% 以上的权重变化本地投影,使 Qwen3 的 delta 构建比全转换快 1.08–1.16×。第二,形式化的精确性保证:作者没有停留在'XOR 大概可行',而是给出明确的 loader 条件(比特保真、表示保持、无重叠写、显式 skip 报告等,Table A.2)并证明 Proposition 1:满足条件时 $\mathrm{bits}(\mathrm{apply}_r(\Delta^{v+1}, P^v_r)) = \mathrm{bits}(L_r(W^{v+1}))$ 对所有必需接收端成立,XOR 不变式 $\mathrm{bits}(P^v_r)|_\rho \oplus x = \mathrm{bits}(L_r(W^{v+1}))|_\rho$ 是证明核心。第三,恢复语义:'delta 只对它所基于的版本有效'这一事实被显式纳入协议——联合 commit 把策略版本与源基线绑定,覆盖重试无需接收端基线副本即可修复部分写,这是 Table 1 中所有已有系统都不完全具备的 G5。第四,构建与传输的流水线重叠:chunk/bucket 结构让 payload 在构建的同时流式发出,Nsight 追踪显示传输下界占 77–94% 的 refit 延迟,构建几乎被完全隐藏。
实验结果
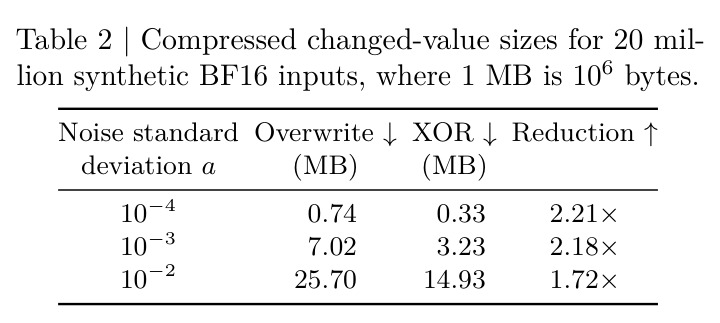
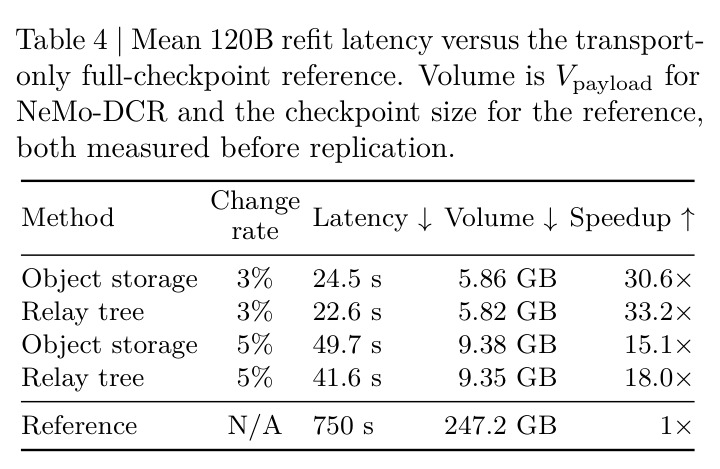
论文用六组实验回答六个 RQ。(RQ1,Table 2)合成编码基准:2,000 万个 BF16 标准正态值加高斯噪声后,XOR 掩码经 zstd-1 压缩比覆盖值小 1.7–2.2×:噪声标准差 $10^{-4}$ 时 0.33 MB vs 0.74 MB(2.21×),$10^{-3}$ 时 3.23 vs 7.02 MB(2.18×),$10^{-2}$ 时 14.93 vs 25.70 MB(1.72×)。(RQ2,Table 3)Qwen3 构建:直接投影(P vs F)使 delta 构建快 1.08–1.16×(30B 3%:X 2.96 s vs F 3.20 s),XOR 让 payload 比 overwrite-only 小 38–40%(30B 3%:1.49 vs 2.44 GB;235B 3%:11.37 vs 18.42 GB),代价是 X 比 P 的构建时间多 7–13%。(RQ3,Figure 9)Qwen3-30B-A3B 的 50 步 GRPO agentic 工具调用训练中,每 5 步杀死一个 vLLM 实例并 5 步后重启:dense NCCL 与两种 NeMo-DCR 传输的平均奖励同为 0.41,KL 轨迹一致,所有覆盖重试通过后验检查(真实变化率约 1.2%)。(RQ4,Table 4)120B:中继树 3% 时 22.6 s、payload 5.82 GB(参考 750 s,33.2×),对象存储 24.5 s(30.6×);5% 时 41.6 s vs 49.7 s(18.0× vs 15.1×);压缩 payload 含位置共占 checkpoint 的 2.4–3.8%,比未压缩变化值还少 21–24%。(RQ5,Figure 10)30B–1T:refit 从 8.3–14.5 s(30B)到 150–300 s(1T),相对参考全部快 12–40×;1T 3% 中继树 150 s(35×);5% 时中继树优势从 30B 的 1.13× 增至 1T 的 1.36×。(RQ6,Figure 11)中继树传输下界占 refit 延迟的 77–94%,构建下界仅 18–45%,finalization 0.2–1.7 s,其余 1.8–9.2 s 为启动/排空/阶段交接开销。比特精确性上,每个实测 refit 都与同一候选权重的 dense refit 逐比特一致(含未变元素),且全部通过写后检查。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 1T 模型跨 AWS 区域 refit(3% 元素变化率,中继树) | 端到端 refit 延迟 | 150 s | transport-only 全 checkpoint 传输 87.5 min(5,250 s) | 35× |
| 120B refit(3%,中继树 / 对象存储) | 延迟 / 压缩 payload 体积 | 22.6 s / 5.82 GB;24.5 s / 5.86 GB | 750 s / 247.2 GB(2.4–3.8% 的体积) | 33.2× / 30.6× |
| 120B refit(5%,中继树 / 对象存储) | 延迟 | 41.6 s / 49.7 s | 750 s | 18.0× / 15.1× |
| 30B–1T 全尺寸 refit(3% 与 5% 压力变化率,两种传输) | 相对传输参考的加速比 | 8.3–14.5 s(30B)到 150–300 s(1T) | transport-only 全 checkpoint 传输 | 12–40× |
| Qwen3 delta 编码(混合 XOR vs overwrite-only) | 压缩后 payload 字节 | 30B 3%:1.49 GB;235B 3%:11.37 GB | overwrite-only:2.44 / 18.42 GB | 字节减少 38–40% |
| 合成 BF16 编码基准(2,000 万值,噪声 σ=$10^{-4}$/$10^{-3}$/$10^{-2}$) | zstd-1 压缩后大小 | XOR:0.33 / 3.23 / 14.93 MB | overwrite:0.74 / 7.02 / 25.70 MB | 2.21× / 2.18× / 1.72× |
| Qwen3 delta 构建时间(直接投影 vs 全转换) | 构建耗时 | X 模式 2.96 s(30B 3%)–23.07 s(235B 5%) | 全转换+组装(F 模式):3.20–21.96 s | 1.08–1.16× |
| 训练一致性(Qwen3-30B-A3B,50 步 GRPO,每 5 步 mid-refit 杀死一个接收端) | 50 步平均奖励 / KL 轨迹 | 0.41(两种传输),KL 与 dense 一致,全部后验检查通过 | dense NCCL refit:0.41 | 持平(无退化) |
局限与改进
作者承认的局限:默认只覆盖 BF16 源与 loader 路径,不满足条件的 loader 路径会被提前拒绝,缩放/量化类转换强制走覆盖(Figure D.1);直接投影依赖 Megatron Bridge 的映射类,自定义 export hook 会禁用直接投影;基线常驻主机内存,约为 checkpoint 的 1.04×/1.03×;持久性故障(规范值冲突、写绕过 hook、owner 丢失基线)需人工干预并经 dense refit 恢复;接收端成员变动只能发生在 attempt 之间,新/重启接收端必须先做一次 dense refit 才能加入;训练侧要等 transition 结束才能执行下一个优化器步。我的补充观察:其一,latency 实验的 3%/5% 变化率是以约 $10^{-2}$ 相对幅度合成注入的压力场景(刻意高于 Figure 2 中所有真实速率),真实训练验证只有 30B、50 步,长程训练下变化率漂移与 XOR 可压缩性衰减未被检验;其二,参考基线刻意排除了 checkpoint save/load(对参考有利),但与'带 checkpoint 引擎的 dense 方案'的端到端对比仍不完整;其三,收益高度依赖低带宽跨集群场景(每节点 5 Gbps),在高带宽同集群环境下 NCCL dense refit 可能更快,而 235B 模型的构建开销就有 18–23 s,会变得显眼;其四,每次 transition 使 KV cache 失效,且异步 RL 中 gate 关闭期间 rollout 要暂停应用,对请求吞吐有影响。
独立分析的弱点
独立分析的弱点及改进方向:(1) 构建成本随模型规模而非变化量伸缩——owner 每步要扫描全部源分片并转换所需残差张量(235B 时 18–23 s),可把比特比较下放到 GPU、用增量哈希或持久化脏标记让构建成本也随变化量伸缩;(2) 基线内存约等于一个 checkpoint 的主机 RAM(32 rank 各 36 GB),可探索压缩基线或仅对残差任务保留基线;(3) 与 vLLM + Megatron Bridge 强耦合,移植到 SGLang、TensorRT-LLM 或 FSDP 训练需要重新走一遍 Table A.2 的 loader 条件验证,可构建自动化 loader 验证/一致性测试套件降低接入成本;(4) XOR 的安全性依赖 payload 级幂等去重与声明顺序应用,若传输层引入聚合、多播或 RDMA 直写,需要重新审视不变式成立条件;(5) 联合 commit 后 KV cache 全部失效,可结合 prefix-cache 感知调度或选择性失效减少浪费;(6) 真实训练评估仅 30B/50 步,应补充长程训练、不同学习率与优化器(如 FP32 master weights)下元素变化率的纵向研究,并测量 gate 关闭对服务 SLO 的影响。
未来方向
作者提出的方向较为含蓄,结论只强调让 per-update refit 成为跨集群 agentic RL 的默认操作。基于本文成果可延伸:其一,把混合编码推广到 FP8/量化 rollout 权重,或在训练-推理精度不一致时做量化感知的 delta 编码(目前量化转换全部退化为覆盖);其二,扩展仿射覆盖范围,为自定义 export hook 和更多映射类提供投影支持(当前会退化为残差路径并增加构建时间);其三,把 commit 协议与 RL 调度器结合,实现多版本共存——rollout 在旧版本上排空请求的同时新版本预热,缩短 gate 关闭窗口;其四,研究中继树与云骨干网/CDN 结合的跨大洲训练,并按实时变化率和带宽自适应切换对象存储/中继树拓扑;其五,把'规范坐标 + 原生 loader + 联合 commit'模式抽象为独立中间件(类似 checkpoint-engine 的定位),服务更多训练/推理框架组合;其六,从理论上刻画 delta 大小与学习率、优化器动量、数值位宽的关系,用于带宽预算与集群规划。
复现评估
复现友好度较高:代码以约 7K 行 Python 随 NeMo RL 开源(PR #2444,commit 72149d09),构建在 Megatron Bridge(commit 554c7b93)与 vLLM 之上;训练侧只需 conversion task 元数据,rollout 侧只需 prewarm/dispatch hook/staging queue 三个扩展点(Figure C.1),协议在附录 B 以伪代码完整规定,包括失败模型、commit 期限与 failover 规则。模型均为公开权重(Nemotron-3-Nano/Super/Ultra、Qwen3-235B-A22B;1T 点是 550B 加倍层数的自构 checkpoint,2,242 GB),GRPO 设置在附录 E 给全(swe1.jsonl、64 prompt×8 响应、batch 512、clip $[0.8, 1.28]$、lr $10^{-6}$),codec 基准给出随机种子(42/44)。主要门槛在算力:延迟实验需要 32 张 GB300(8 个训练节点)+ 64 张 H100(8 个 rollout 节点)分处两个 AWS 区域,每节点跨集群带宽 5 Gbps;训练实验另需 8 个 H100 节点。没有跨区域集群时,可用小模型加 tc 限速近似复现延迟趋势,比特精确性验证在单机多卡即可进行。总体属于'代码可得、环境昂贵'的中高难度复现。
论文图表
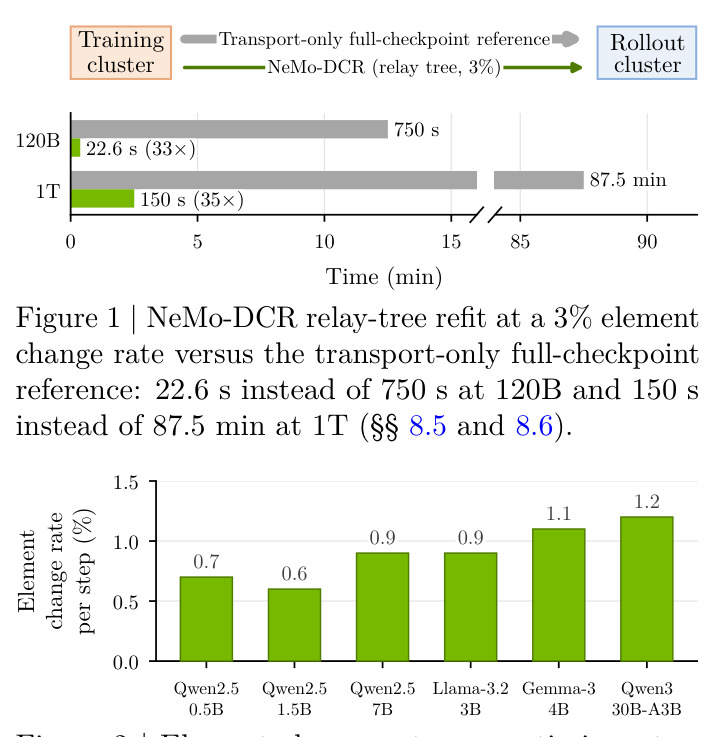
示意图对比训练集群与 rollout 集群间的两条路径:全 checkpoint 传输(120B 需 750 s,1T 需 87.5 min)与 NeMo-DCR 中继树(120B 仅 22.6 s,33×;1T 仅 150 s,35×)。
这是全文的头条结果,一图说明'只传 ~1% 变化'带来的数量级收益,是理解论文价值的入口。
六个模型(Qwen2.5 0.5B/1.5B/7B、Llama-3.2-3B、Gemma-3-4B、Qwen3-30B-A3B)GRPO 前五步的元素变化率柱状图,全部在 0.6–1.2% 之间。
整个方法的存在依据:BF16 存储值每步只有约 1% 变化,增量同步才有意义;此图给出实测证据。
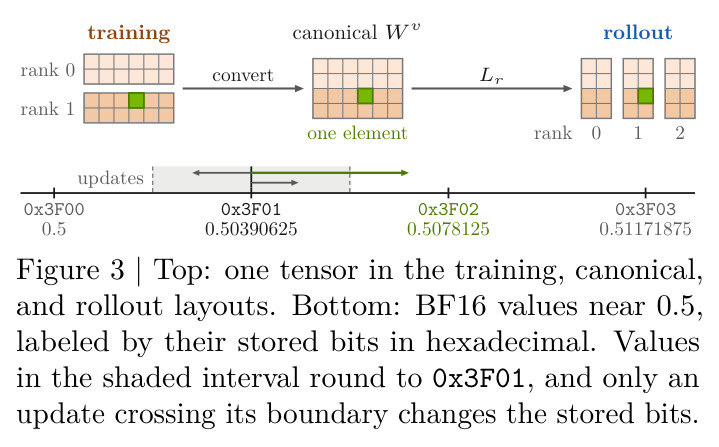
上半部分展示训练分片、规范张量、rollout 布局三者的映射关系(一个元素从 0x3F00 更新为 0x3F01 再到 0x3F02/0x3F03);下半部分用 0.5 附近的 BF16 值说明只有跨越舍入边界的更新才改变存储比特。
同时解释了布局不匹配(placement 难题)与 BF16 舍入(元素变化率的来源)这两大动机,是理解问题定义的基础。
对比两种传输拓扑:对象存储下 owner 各上传一次、每个 rollout 节点都要下载(跨边界流量随节点数增长,约 $(1+N_{node})V_{payload}$);中继树下 payload 经根节点经平衡树本地转发,每次尝试每个 payload 只跨集群边界一次。
解释 G4(无跨集群集体)如何实现,以及为什么 5% 变化率下中继树随规模扩大优势越来越明显(1.13×→1.36×)。
上:整张量组成 chunk(带记录的 chunk 进入 bucket,未变 chunk 为空 ∅),bucket 压缩成一个 payload;下:流水线时间线——owner 构建 bucket ℓ+1 时 payload ℓ 正在传输,异步 RL 下 rollout 持续服务版本 v,delta 传完并暂存后才关 gate、应用、再开门服务 v+1。
展示构建-传输-应用的流水线重叠机制和同步/异步 RL 的 gate 语义,是理解传输下界占 77–94% 延迟的前提。
50 步 GRPO 训练的奖励曲线与每 token KL:dense NCCL、对象存储、中继树三条曲线重合,平均奖励均为 0.41,KL 轨迹一致;NeMo-DCR 运行中每 5 步随机杀死一个 vLLM 实例。
证明 mid-refit 故障 + 覆盖重试不会影响训练动态,是 G5(可恢复)与 G1(比特精确)的实际训练层面验证。
上:30B–1T(63.2–2,242 GB)参考时间与 NeMo-DCR 延迟带(两种传输、3%/5%),标注 12–40× 加速与参考分钟数(1T 处 87.5 min);下:两种传输各自延迟,5% 时中继树全面优于对象存储且优势随规模增大。
核心可扩展性结果:给出从 30B 到 1T 的完整延迟/加速曲线,证明方法在万亿规模仍然有效。
中继树 refit 延迟分解为构建下界与传输下界(按最忙 owner/发送端的最长区间并集计算):3%/5% 下传输下界占 77–94%,构建下界仅 18–45%,finalization 另计 0.2–1.7 s。
证明流水线设计成功:传输主导延迟、构建几乎被完全隐藏,同时指出进一步优化的方向在传输本身。
Qwen3-30B-A3B 与 Qwen3-235B-A22B 在 3%/5% 下三种构建模式的对比:混合投影+XOR(X)、投影+覆盖(P)、全转换(F)。构建时间 X 2.96–23.07 s、P 2.77–20.42 s、F 3.20–21.96 s;payload X 1.49–17.58 GB,P=F 2.44–29.36 GB。
同时隔离两个贡献的收益:直接投影省时间(P vs F),XOR 省字节(X vs P),是方法各组件贡献分析的核心表。
上:数据并行副本间用稳定名字哈希选出每个分片的唯一 owner,保证每个源元素只比较一次;下:符号零检测——浮点相等把 $-0.0$ 与 $+0.0$ 视为相同而漏报,比特比较生成 XOR 掩码 0x8000 修正符号位。
说明比特级变更检测的必要性(浮点比较会漏掉符号零变化),以及所有权机制如何保证无重复无遗漏。
列出仿射/残差源路径与 XOR/覆盖/native-skip loader 路径各自允许的操作、集成强制规则与所需假设(如 XOR 要求比特保真且条目间无重叠写,覆盖要求占位符方案有效等)。
Proposition 1 成立的条件清单,决定了哪些模型/loader 组合可以用 XOR(更快更小)、哪些必须拒绝或走覆盖。
transition 期间候选权重 $W^{v+1}$、所有权、源成员与集成设置保持固定,基线 $B_v$ 在 commit 前固定;训练的下一个优化器步要等 transition 结束;失败 attempt 与其重试共享同一状态,commit 后 owner 才就地把基线更新为 $B(g)$。
定义了'版本状态机',是理解 delta 只对特定基线有效、重试为何安全、commit 为何必须原子的时间线基础。
代码级集成示意:共享核心(codec、接收检查、commit、恢复)+ 三个接口——传输适配器只需实现 send/stop_and_wait/cleanup 三个调用,训练侧遍历 conversion task(仿射走投影、其余走残差),rollout 侧 prewarm + dispatch hook + 原生 loader,无模型特定 refit 代码。
展示实现约 7K 行 Python 就能完成的关键:接口切分干净,这也是可移植性和开源复现的基础。
上:混合模式的编码决策树——仿射任务且表示保持且无重叠写才用 XOR,否则覆盖;下:源值掩码 0x0003 在'乘 1.5 再 cast'的转换下不再对应转换后值的掩码(0x3F42/0x3F43 的掩码是 0x0001),所以缩放+cast 必须用覆盖。
解释 XOR/覆盖划分的判定逻辑,说明为什么残差路径(含量化、缩放)天然用覆盖,是理解编码覆盖率的钥匙。
Nemotron-3-Ultra-550B-A55B(1,121 GB)的张量分类:50,176 个专家 up/down 张量占 93.86% 走仿射,662 个其他仿射张量占 3.13%,残差(Q/K/V、Mamba 输入投影与卷积、embedding/输出头)共 185 个张量占 3.01%。
量化支撑'直接投影覆盖 97.0% 权重字节'的论断,说明残差路径只需处理极小一部分数据。
Qwen3-30B-A3B(61.06 GB)分类:18,432 个专家张量占 94.95%、注意力输出投影 1.32%、router 0.04%、归一化 <0.01% 走仿射;残差为融合 Q/K/V(1.65%)与 embedding/输出头(2.04%),共 3.69%。
与 Table D.1 呼应,给出 Qwen3 的 96.3% 仿射覆盖率证据,并指出残差恰是需要组装的部分。
上:延迟测试台——一个 AWS 区域 8 节点×4 GB300 训练,另一区域 8 节点×8 H100 rollout,无共享 InfiniBand/EFA 路由,每节点跨集群流至多 5 Gbps;参考是每训练节点上传 1/8 checkpoint 到 S3、每个 rollout 节点全量并行下载。下:计时窗口 t0–t1 覆盖比较/投影、残差转换、编码压缩、传输、暂存、loader 应用、同步、ACK、commit 与基线更新,并给出构建/传输下界的区间并集算法。
明确实验环境与计时口径(NeMo-DCR 计入全部阶段而参考不含 save/load),对公平解读 12–40× 加速至关重要。
五个延迟实验用的 BF16 checkpoint:Nemotron-3-Nano-30B-A3B 63.2 GB、Super-120B-A12B 247.2 GB、Qwen3-235B-A22B 470.2 GB、Ultra-550B-A55B 1,121 GB、1T 点为 550B 层数加倍后的 2,242 GB。
定义横轴规模的五个实验点,其中 1T 是合成放大而非真实模型,解读 1T 结果时需注意。
50 步训练中的接收端杀死时间线:每 5 步随机选一个 vLLM 实例在 refit 中途杀死(×标记),5 步后重启(点标记),重启实例先经 dense refit 恢复提交版本再加入;被杀实例所在的 attempt 失败并触发其他接收端的覆盖重试。
具体展示 G5 故障注入实验的操作方式,帮助理解 Figure 9 中训练不受故障影响的结论是如何得到的。