Nereus:面向大语言模型RL后训练的自适应并行运行时 Nereus: Adaptive Parallelism for LLM Post-Training
Nereus用EMU状态抽象与代价感知控制器,让RL后训练作业在线适应资源与负载漂移并安全重分片
前置知识
RL后训练与PPO多模型工作流
RL后训练(如PPO、GRPO、ReMax)在预训练/微调之后用奖励信号继续优化语言模型。一个RL步内,actor模型生成回答,reward模型打分,critic估计价值,冻结的reference模型约束策略偏移,四个模型协同跑在生成、推理、训练三个阶段,任何阶段都可能成为瓶颈,且同一模型在不同阶段的计算与显存需求不同。
Nereus的全部设计都围绕多个耦合模型-阶段如何共享一组GPU展开,不理解这个工作流就无法理解为什么切换一个阶段的并行度会牵动其他阶段、为什么需要跨阶段协调转换。
DP/TP/PP三种并行策略
数据并行(DP)在不同副本间切batch并周期性同步;张量并行(TP)在层内切开权重矩阵,rank间靠集合通信紧耦合;流水线并行(PP)把层序列切成若干stage传递激活。一个执行计划就是给每个模型-阶段指派 (tp, pp, dp) 三元组和GPU集合。
Nereus的计划搜索空间、EMU的内部结构(TP/PP在单元内、DP等于副本数)以及Split/Merge/Extend/Destroy四种原语,全部建立在这三种并行耦合程度差异(TP/PP紧、DP松)之上。
KV cache与显存压力
自回归生成时需为每条序列缓存注意力键值张量,其显存占用与序列长度、batch大小成正比。RL训练中策略学会生成更长回答后,生成阶段的KV cache和训练阶段的激活显存都会快速增长,可能令原本可行的并行布局直接OOM。
论文实测Llama-3.1-8B生成序列长度在1000步内从500涨到8000 token(16倍),这是触发并行方案切换最主要的负载漂移来源,也是Figure 4实验的核心。
状态重分片与checkpoint
改变TP/PP布局后,参数和优化器状态必须按新切分方式重新分布(resharding)。传统做法是把状态写成checkpoint落盘、再按新布局重启重建(如UCP、MCP),代价是长时间停顿与大量I/O;细粒度方案(如Tenplex)按shard转移但规划复杂。
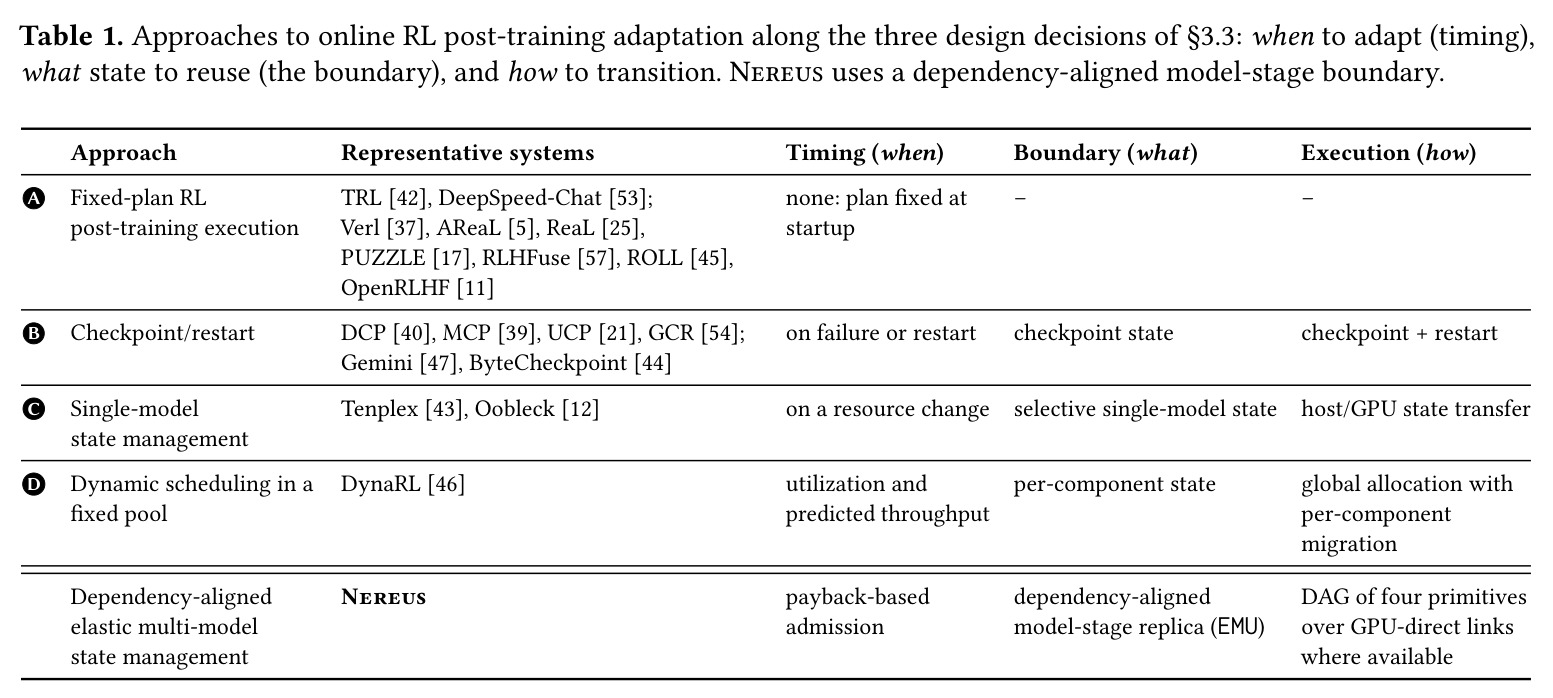
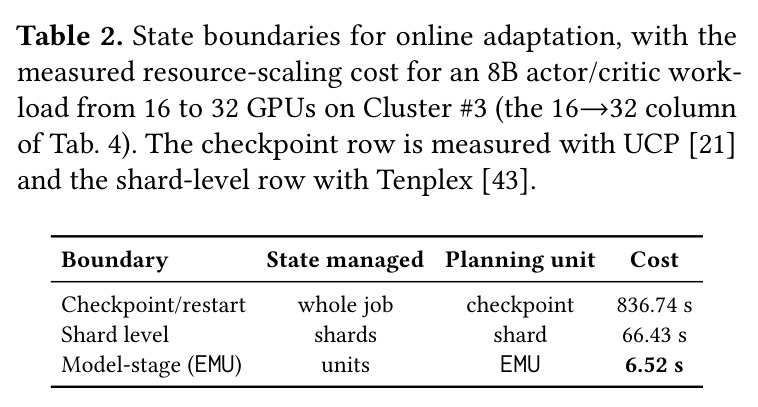
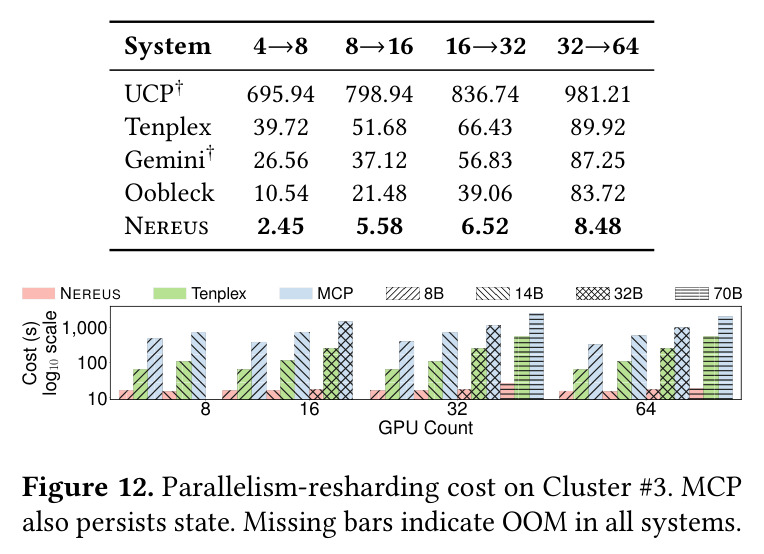
论文用状态边界的粒度(作业级/分片级/模型-阶段级)组织相关工作:16到32卡扩容中checkpoint边界耗时836.74秒、shard级66.43秒、EMU仅6.52秒,这组对比数字要靠该背景才能读懂。
payback偿还式准入
源自Pollux、Sia等集群调度器的投资回收期原则:只有当切换带来的单位时间收益能在预期剩余运行时间内摊销一次性切换开销时才值得切换。Nereus把它移植到单个耦合作业内部,准入条件为 $\Delta L > 0 \wedge \hat{L}_{tran} \le \gamma H_x$,其中 $H_x$ 估计触发信号下次跨越阈值前的可用步数。
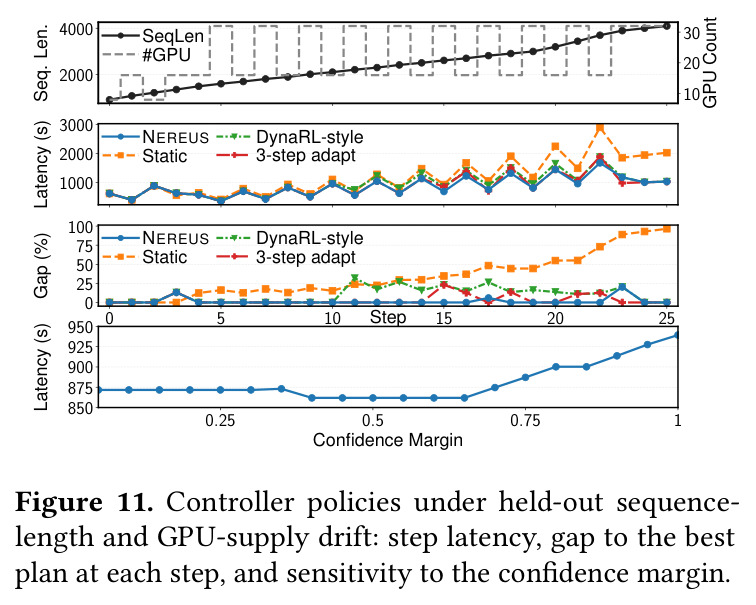
这是何时切换(when to adapt)决策的核心公式,理解 $H_x$(指数滑动平均的跨越间隔)与置信边际 $\gamma$ 才能看懂第4节准入策略及Figure 11的γ敏感性实验。
释放-再获取与转换DAG死锁
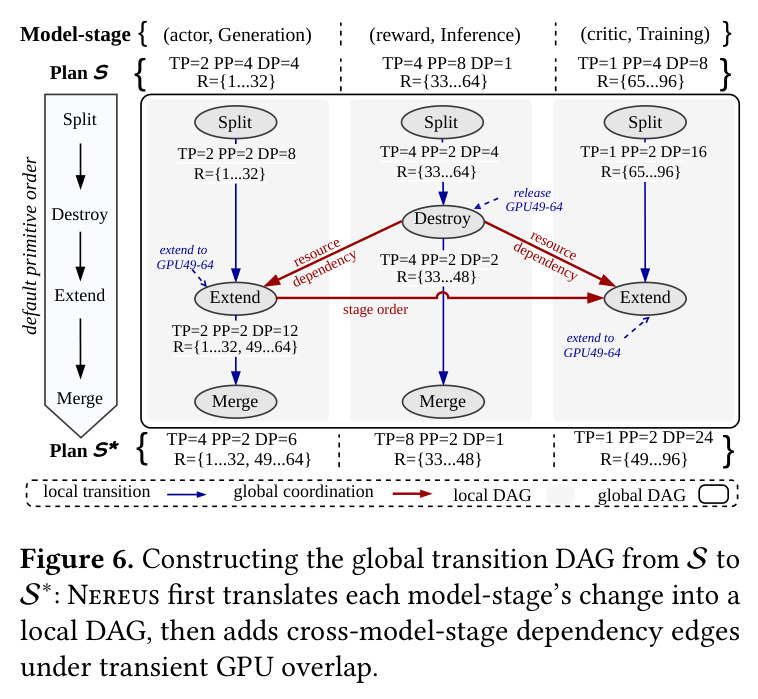
当GPU池接近满载时,一个模型-阶段必须先释放GPU,另一阶段才能扩展;若各阶段独立执行迁移,会互相等待对方释放资源,形成共享GPU死锁。把原语操作编排成带资源依赖边的有向无环图(DAG)、按拓扑序执行是资源受限项目调度的经典解法。
第6节的全局转换DAG(释放优先于获取、阶段序破平)和第7.4.4节死锁实验(DynaRL式独立迁移成功率仅34–62%,Nereus为100%)都依赖这一背景。
研究动机
RL后训练是LLM研发的关键环节,单次运行可消耗10万GPU小时,但作业运行期间环境持续变化。其一是资源供给漂移:spot实例可能被回收、共享集群调度器会重分配节点,AWS真实trace显示一个16卡作业在10小时内GPU可用性变化超过10次。其二是负载需求漂移:随着策略学会生成更长回答,Llama-3.1-8B的生成序列长度在1000步内从约500 token涨到8000 token(16倍),KV cache与激活显存随之膨胀。其三是硬件效率漂移:网络拥塞、降频与多租户干扰会改变既定计划的步时延。三者叠加使启动时最优的执行计划逐渐失效:16卡下(DP,TP,PP)=(4,2,2)在2K长度最快但4K时OOM,(4,4,1)在4K可行却在2K白付通信开销。更棘手的是PPO等算法把actor、critic、reward、reference四个模型耦合在生成、推理、训练三个阶段,瓶颈会在阶段间转移;而现有RL框架启动后固定计划、弹性训练系统只管单模型,均无法应对这种多模型耦合场景。
本文的目标是本文目标是构建一个在线、代价感知的运行时,让RL后训练作业在GPU集群上自动适应上述漂移。具体包括:在安全边界(同步执行的RL步完成处、异步执行的权重同步处)检测漂移;为全部耦合的模型-阶段选择显存可行、预测稳态步时延最低的全局目标计划 $S^*$;仅当预期每步时延节省能偿还一次性转换开销时才执行迁移(资源被夺走等紧急失效情形除外);迁移时复用GPU常驻的分布式状态而非落盘重建,并在无空闲GPU时跨模型-阶段安全协调资源让路。量化目标:所选计划逼近经验最优、转换开销占总运行时间千分之一以下量级、端到端吞吐显著超过OpenRLHF与Verl等固定计划框架,并兼容同步PPO/ReMax/GRPO与异步执行模式。
与已有工作不同的是,已有方案各只回答了三分之一问题。固定计划框架(Verl、OpenRLHF、AReaL、RLHFuse等)启动后不再调整并行度;弹性训练系统(Parcae、EasyScale等)只能管理单个模型;checkpoint系统(UCP、MCP、ByteCheckpoint)以整作业为状态粒度,转换需重启重建(16到32卡扩容耗时836.74秒);分片级状态管理(Tenplex)转移量小却把shard路由与集合通信协调暴露给规划器;DynaRL只在固定资源池内做按组件迁移,缺乏偿还式准入,独立迁移还会死锁。Nereus的独特切入是把状态边界与作业依赖结构对齐:TP/PP是紧耦合的、锁进EMU内部,DP是松耦合的、暴露为副本数。这一依赖对齐思想贯穿三个决策——何时(覆盖整个RL步的payback式准入)、复用什么(模型-阶段副本为状态单元)、如何转换(四原语编译成全局DAG),并用在线校准的代价模型替代不可靠的离线预测器(后者在8卡会选出不可行计划,64到256卡比实测最优慢至1.56倍)。
核心方法
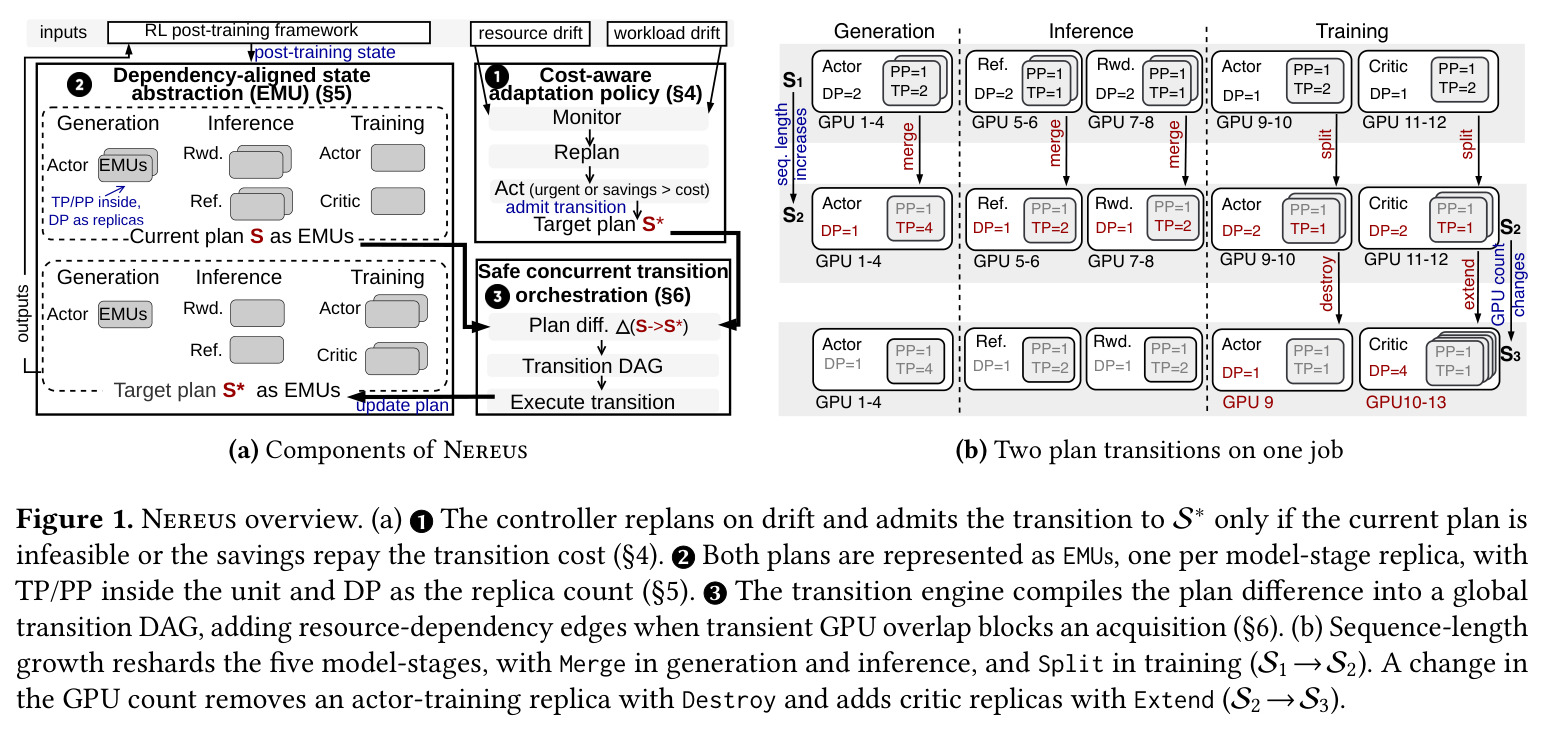
直觉上,如果每个模型在某阶段的副本自成一个自治单元,单元内部保持紧耦合的TP/PP布局不动,那么单元的增删就等价于DP缩放,计划切换便退化为对整单元的搬移与重组,无需重建全作业状态。技术路线分三块。(1)代价感知策略:监控序列长度、可用GPU池 $P_{gpu}$、峰值显存与实测计算/通信效率,GPU数变化或预测显存越界立即触发重规划,漂移信号相对参考值偏差超阈值(序列长度 $\delta_{len}=30\%$)也触发;CPU侧求解 $S^*=\arg\min \hat{L}_{step}(S)$,约束为每卡显存上限与各并发阶段GPU预算,代价模型按操作类(GEMM、attention、各类链路上的all-reduce)在线校准理论峰值与实测差距。(2)EMU状态抽象:把当前与目标计划都表示为EMU集合,定义Split/Merge/Extend/Destroy四个状态变换原语。(3)转换编排:把计划差异编译成全局转换DAG,资源释放优先于获取,安全并发执行。三者分别回答何时、何状态、如何转换三个开放问题。
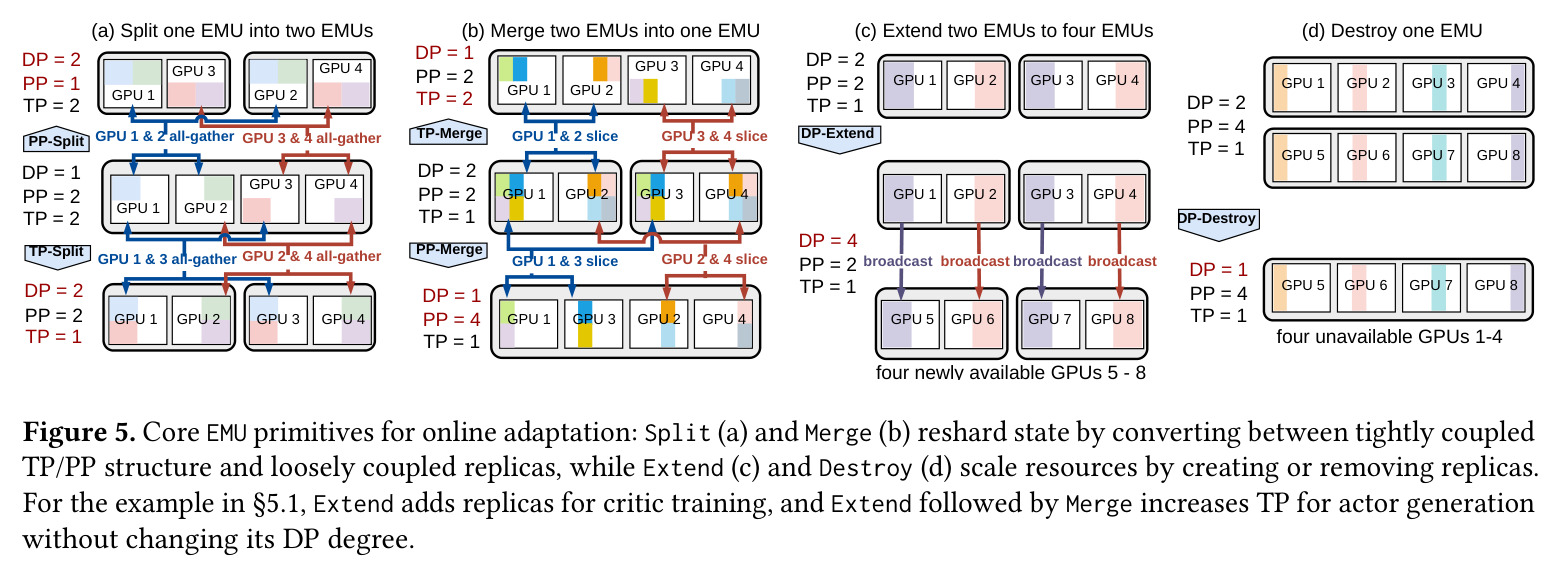
核心创新是弹性模型单元EMU:$EMU=\langle M, T_{tp\times pp}, R, \boldsymbol{\theta}, \boldsymbol{\omega}\rangle$,其中 $M=(model,stage)$ 标识模型-阶段(actor生成与actor训练算两个阶段),$T_{tp\times pp}$ 为TP/PP布局,$R$($|R|=tp\times pp$)为GPU集合,优化器分片 $\boldsymbol{\omega}$ 与参数分片 $\boldsymbol{\theta}$ 同布局(ZeRO-0,不跨DP切分),模型-阶段的DP度就是活跃EMU数。与已有方案的本质区别是状态边界粒度由依赖结构决定:TP/PP的rank间需集合通信与激活传递、牵一发而动全身,故锁在单元内部;DP副本可独立增删,故暴露在外。checkpoint以整作业为边界、转移冗余状态且需重启,Tenplex分片边界转移少但规划复杂,EMU在16→32卡扩容上仅需6.52秒(前两者为836.74秒和66.43秒)。四个原语覆盖整个power-of-two计划空间并保持训练语义:逻辑状态 $\Lambda=(\boldsymbol{\theta},\boldsymbol{\omega},c,v,p)$ 含更新计数、版本与minibatch位置,全局batch $dp\times b\times a$ 通过调 $b,a$ 保持不变,样本不重不漏。
方法步骤详情
第一步·监控:从Ray/NVML与框架插桩读取序列长度、$P_{gpu}$、峰值显存、核函数与集合通信耗时;$P_{gpu}$变化或预测显存越界立即触发重规划,序列长度相对参考值漂移超30%也触发,参考值每次重规划后重置;仅在RL步完成(同步)或权重同步(异步)等安全边界动手。第二步·重规划:为每个模型-阶段生成候选 $\pi_M=\langle tp_M,pp_M,dp_M,R_M\rangle$,剔除超显存与被支配者得到时延-资源前沿(TP组尽量同节点),动态规划在计划级显存约束与分阶段GPU预算下各选一个候选,目标 $\hat{L}_{step}$ 由执行重叠图关键路径给出;纯CPU运行,内存低于100MB。第三步·准入:可行性检查要求留存状态、中间单元、共存状态与通信buffer留10%余量;盈利性检查为 $\Delta L>0 \wedge \hat{L}_{tran}\le\gamma H_x$($\gamma=0.5$,$H_x$ 为触发信号跨越间隔的指数滑动平均);GPU被夺走时走紧急路径,豁免盈利性、可缩batch加重算,最坏退回checkpoint重启。第四步·执行:每阶段按Split→Destroy→Extend→Merge生成局部DAG,跨阶段仅在瞬态GPU重叠阻塞获取时加依赖边;Split用位置对齐AllGather,Merge重组目标布局(目标rank已有的分片不复制),Extend按秩对齐Broadcast逐分片连续传输,Destroy本地拆除;传输走NCCL/RCCL与GPU直连RDMA。
技术新颖性
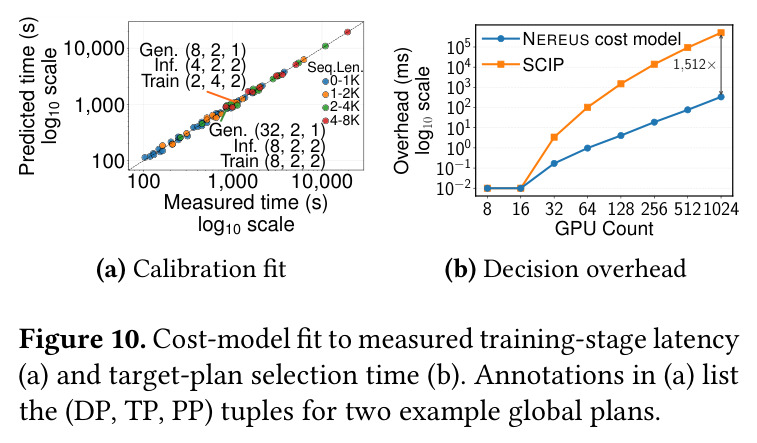
新颖性有四点。其一,首次把状态边界与作业依赖结构对齐确立为多模型RL后训练在线适应的设计原理,并论证模型-阶段副本是转移量与规划复杂度的正确折中:同样的16到32卡扩容,作业级checkpoint耗时836.74秒、shard级66.43秒、EMU仅6.52秒。其二,四原语代数:任意power-of-two的TP/PP变化可分解为Split/Merge,DP变化分解为Extend/Destroy,组合覆盖整个计划空间,规划器只在整单元粒度推理,原语内部隐藏集合通信细节。其三,跨模型-阶段的全局转换DAG:把无空闲GPU时谁先让路显式编码为资源依赖边,用释放优先与阶段序(生成→推理→训练)两条确定性规则保证无环无死锁,这是DynaRL式独立局部DAG做不到的——后者在重叠试验中因共享GPU死锁只有34%到62%成功率。其四,在线校准的代价模型:按操作类学习效率折扣、无需启动前完整profile,既修正离线分析器的错误(8卡选不可行计划、64到256卡慢1.56倍),又把决策开销压到1024卡338毫秒,比SCIP求解器的511秒快约六个数量级。
实验结果
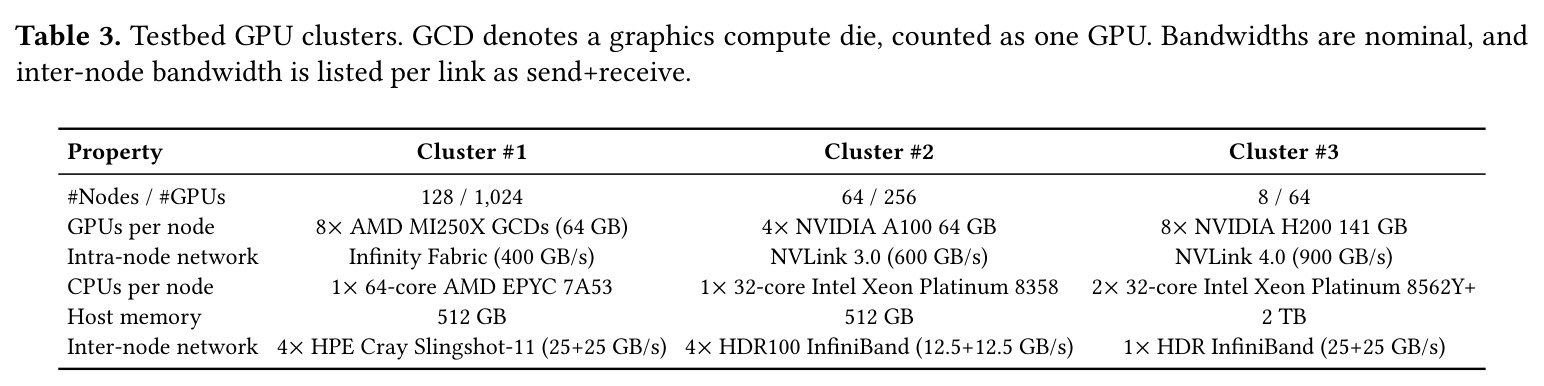
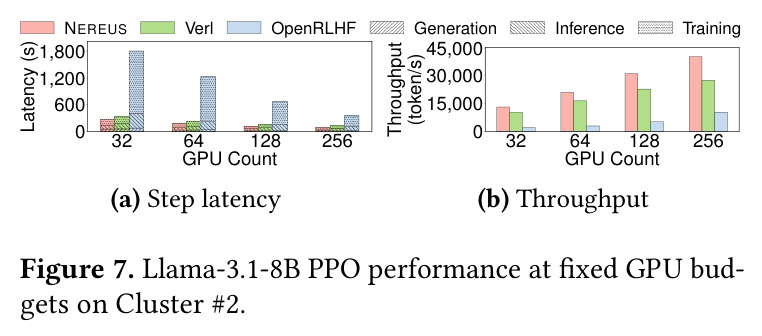
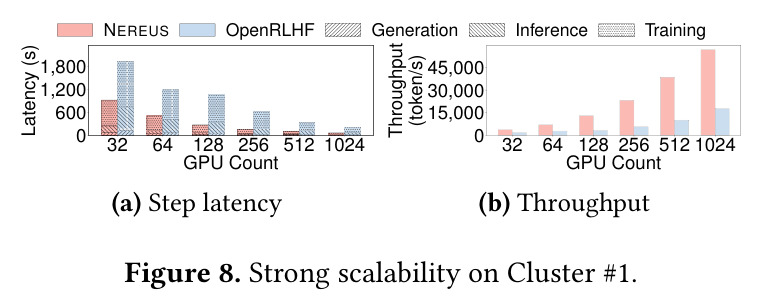
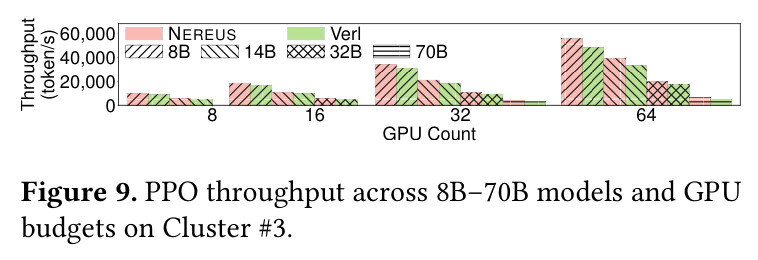
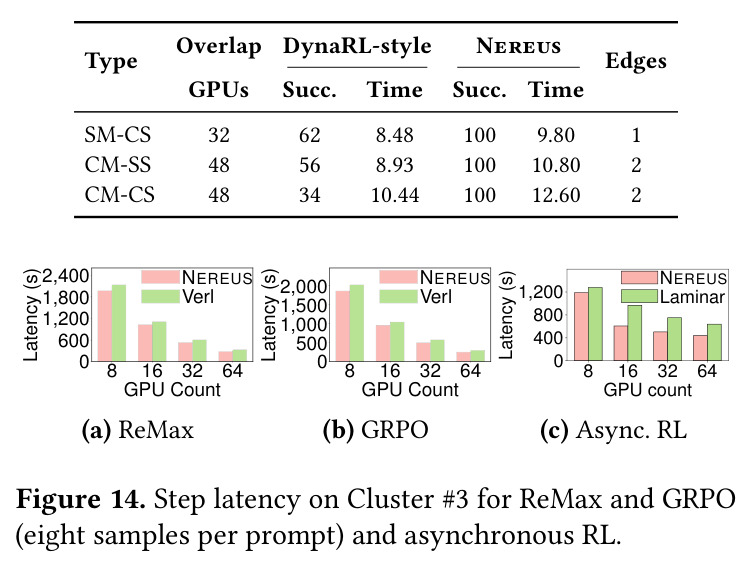
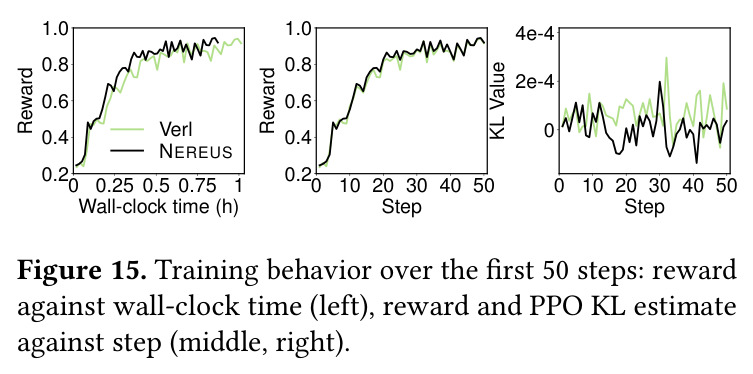
端到端:8B PPO在Cluster #2上相对OpenRLHF步时延最多降86.3%、吞吐最多升7.27倍(64卡),相对Verl最多降31.9%、升1.47倍;全集群与规模上对OpenRLHF加速2.14–7.27倍(中位3.99),NVIDIA集群上对Verl为1.10–1.47倍(中位1.21);阶段时延对Verl最多降11.5%/41.6%/29.6%(生成/推理/训练)。扩展性:Cluster #1从32到1024卡步时延降15倍(OpenRLHF仅10倍),1024卡领先3.20倍;8B至70B每个规模均超Verl。代价模型:72个held-out计划MAPE 4.96%、$R^2=0.9993$;480个实测计划18种设置中61.1%精确命中经验最优、全部差距≤5%(中位0%、p95为4.1%)。漂移决策:真实trace下平均步时延861.9秒,比固定TP/PP低27.7%、比DynaRL式准入低8.3%、比每3步盲切低2.5%;三条held-out trace平均858.7秒/步 vs DynaRL式928.3秒;$\gamma=1$时退化到939.5秒且14次转换得不偿失。转换效率:Extend耗时2.45–8.48秒(比UCP快115.7–284.1倍);70B重分片比MCP省99.1%、比Tenplex省96.7%;1000步扩至1024卡的六次转换仅占总时间49.5/62353秒即0.079%。协调:三类重叠转换各100次试验全部成功(9.80–12.60秒),DynaRL式仅34–62%且死于共享GPU死锁。泛化与训练行为:ReMax/GRPO时延最多降13.3%/15.8%,异步RL比Laminar低37.3%;50步内reward与KL和Verl吻合(步50 reward 0.9199 vs 0.9160,KL均值 $4.9\times10^{-5}$ vs $7.4\times10^{-5}$),含4次转换的50步墙钟省13.9%(3141 vs 3646秒)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Llama-3.1-8B PPO 端到端吞吐(3个集群、8–1024卡) | 相对基线加速比 | Nereus 在线自适应并行 | OpenRLHF(启动时扫参固定最快配置) | 2.14–7.27×(中位 3.99×);相对 Verl 为 1.10–1.47×(中位 1.21×),64 卡处最高 7.27× |
| 真实数据漂移 trace 下持续训练 | 平均步时延 (s/step) | 首条 trace 861.9 s;三条 held-out trace 平均 858.7 s(标准差 5.2 s) | 固定 TP/PP+DP 缩放 1,191.6 s;DynaRL 式准入 928.3 s;每 3 步盲切 873.8 s | −27.7%(vs 固定布局)、−7.5%(vs DynaRL 式准入)、−1.7%(vs 3 步盲切) |
| GPU 扩容状态迁移(8B actor/critic,16→32 卡,Cluster #3) | 迁移耗时 (s) | 6.52 s | UCP(checkpoint 级,含持久化)836.74 s;Tenplex(shard 级)66.43 s;Gemini 56.83 s;Oobleck 39.06 s | 比 UCP 快约 128×,比 Tenplex 快约 10× |
| GPU 扩容扫描(4→8 至 32→64 卡) | Extend 耗时 (s) | 2.45–8.48 s | UCP 695.94–981.21 s;Tenplex 39.72–89.92 s;Gemini 26.56–87.25 s;Oobleck 10.54–83.72 s | 比 UCP 快 115.7–284.1×,比 Gemini 快 6.7–10.8×,比 Tenplex 快 9.3–16.2×,比 Oobleck 快 3.8–9.9× |
| TP/PP 重分片(Split/Merge,8B–70B) | 转换耗时 | 8B 在 8–64 卡稳定于 15.7–16.1 s;70B@64 卡较 MCP 降 99.1%、较 Tenplex 降 96.7% | Tenplex 62.7–65.0 s;MCP 329.9–486.5 s(8B 每卡数) | 8B 上比 Tenplex 快约 4×、比 MCP 快 20–30× |
| 目标计划选择质量 | 与经验最优步时延差距(枚举 480 个实测计划、18 种设置) | 61.1% 设置精确命中经验最优,全部差距 ≤5%(中位 0%,p95 为 4.1%) | 离线预测器 llm-analysis:8 卡选出不可行计划,64–256 卡比实测最优慢至 1.56× | 唯一在全部设置下保持 5% 以内的方案 |
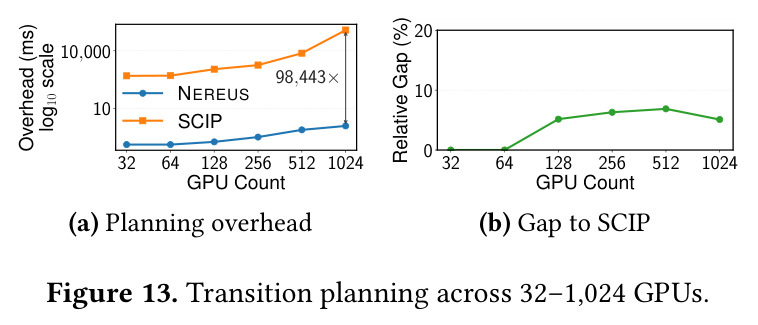
| 转换 DAG 规划(32–1024 卡) | 规划时间 | 1024 卡 1.22 ms(决策开销 0.17 ms@32 卡至 338 ms@1024 卡) | SCIP 求解器 120.10 s@1024 卡(3.4 ms 至 511 s) | 98,443×,且转换完成时间与 SCIP 差距 ≤6.9% |
| 跨模型-阶段重叠转换协调(SM-CS/CM-SS/CM-CS 各 100 次随机试验) | 成功率 / 成功试验耗时 | 100% / 9.80–12.60 s(插入 1–2 条资源依赖边) | DynaRL 式独立迁移 34–62% / 12.86–16.75 s(失败均为共享 GPU 死锁) | 彻底消除死锁,成功率提升 38–66 个百分点 |
| 泛化:ReMax / GRPO / 异步 RL | 步时延相对降幅 | ReMax 最多 −13.3%,GRPO 最多 −15.8%(vs Verl);异步 RL 比 Laminar 最多 −37.3% | Verl(同步)、Laminar(异步) | 收益跨算法与执行模式成立 |
| 训练行为一致性(前 50 步) | reward / PPO KL / 墙钟时间 | 步 50 reward 0.9199、KL 均值 4.9e-5;50 步含 4 次转换共 3,141 s;0.56 h 达 reward 0.90、0.84 h 达 0.94 | Verl:reward 0.9160、KL 7.4e-5;3,646 s;0.65 h / 0.99 h | 墙钟时间 −13.9%,训练曲线与 Verl 基本重合 |
局限与改进
作者承认的局限:转换只在安全边界(RL步完成或权重同步)执行,无法步中途响应;某单元最后副本因故障丢失时需依赖容错系统恢复,紧急路径最坏退回checkpoint/重启;计划空间限于power-of-two的TP/PP度与阶段内同构布局,优化器不跨DP分片(ZeRO-0),对显存极紧的超大模型可能不够;并发阶段必须占用不相交GPU集合,不支持同卡时间复用;上下文与专家并行(MoE)未纳入,仅列为未来方向。我的补充观察:(1)评测中actor/reference/reward/critic全部等大小,真实RLHF常配小reward模型,异构模型组合下的漂移与转换代价未验证;(2)trace只覆盖序列长度与GPU数两类漂移,代价模型虽支持效率漂移校准但无对应实验;(3)payback准入依赖 $H_x$ 预测未来,阈值(30%)与 $\gamma$ 的取值缺乏原则性指导,$\gamma=1$ 时退化到939.5秒说明该超参真实影响性能;(4)验证止步于1024卡与70B稠密模型,万卡与MoE未知;(5)27.7%的对照仅是启动时固定TP/PP加DP缩放,若基线也周期性离线重规划,收益会收窄。
独立分析的弱点
独立分析出六个弱点。第一,ZeRO-0限制:优化器状态不跨DP分片,一旦模型大到需要ZeRO-2/3,DP度等于副本数、增删即搬整单元的简洁性被破坏,Extend需搬分片,可改进为在单元内引入分片组子结构。第二,同构假设:同一模型-阶段的所有EMU布局相同,隐含GPU同构;异构集群(A100/H100混部、不同代互连)下无法按算力差异分配布局,而代价模型已按链路类型分类,扩展为按节点类型参数化布局是自然方向。第三,GPU独占:并发阶段使用不相交GPU集合,某阶段串行执行时另一阶段的GPU闲置;可借鉴PUZZLE式轻量上下文切换做同卡分时,但需把换入换出开销纳入代价模型与可行性检查。第四,准入短视:payback只比较下一步节省与 $H_x$,不考虑已知的未来事件(如调度器预告的缩容窗口),可接入预测信息做前瞻规划。第五,单作业视角:多作业共享集群时各自最优的转换可能互相挤占资源引发振荡,需要与ElasticFlow/Pollux类作业间调度器协同。第六,校准冷启动:新操作类从保守效率值起步,最初若干步计划可能次优;可用离线profile预填或跨作业迁移校准数据。
未来方向
作者明确提出的方向:把模型-阶段边界与模块化运行时扩展到上下文并行与专家并行(MoE训练中的专家重路由与专家并行度在线调整)、自动缩放外部工具服务、接入更多RL框架。基于其成果可延伸的:(1)异步/部分在途rollout下更细粒度的安全边界,让转换不必等整步完成;(2)预测性重分片——用奖励曲线或rollout长度分布预测负载漂移,从被动触发转为提前Split/Merge,把转换开销藏进空闲期;(3)多作业转换协商协议,避免邻居作业同时扩展引发拥塞或抢卡;(4)异构加速器间的转换,处理不同GPU型号间精度与算力差异;(5)与RL算法协同,研究并行度切换对训练动力学的长期影响(论文只验证了50步内KL/reward一致);(6)若开源,可将四原语标准化为Verl/OpenRLHF的可插拔弹性接口,成为社区RL基础设施组件。
复现评估
论文正文未给出开源代码链接。实现为约43k行Python/C++/CUDA/HIP,集成vLLM、DeepSpeed、Megatron-LM,仅用标准NCCL/RCCL集合通信与RDMA直连、未依赖私有RDMA栈,底层组件均开源。工作负载可复现性好:默认Llama-3.1-8B+PPO+vLLM,提示来自公开的OpenRLHF prompt-collection-v0.1;全部基线(OpenRLHF、Verl、Laminar、UCP、MCP、Gemini、Tenplex、Oobleck、SCIP)公开可得;评估协议细致(50步平均、1步预热、波动小于2%、协调实验100次随机试验)。主要门槛是算力:完整验证需三个集群,最大128节点1024张MI250X,1000步1024卡实验约62,353秒机时。小实验室可在8节点H200或数十张A100规模复现端到端对比、转换耗时、协调与训练行为实验;强扩展性结论需超算配额。总体:小规模复现中等偏难(需自行实现EMU运行时或等开源),完整复现困难。
论文图表
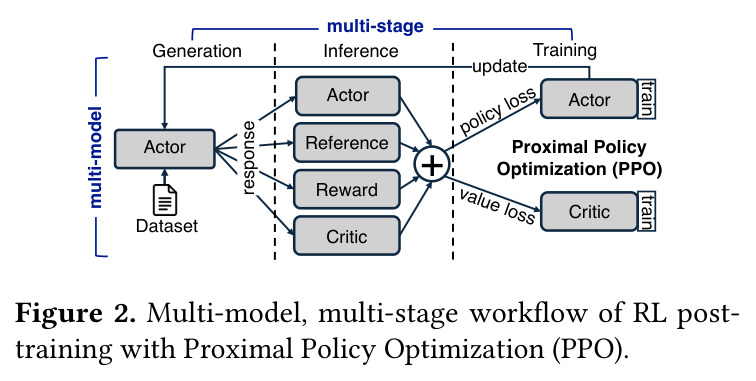
PPO的工作流图:actor生成回答(Generation),reward模型打分、critic估值(Inference),actor与critic分别用policy loss和value loss更新(Training),四个模型跨三个阶段耦合执行。
解释了为什么RL后训练的计划适应必须是多模型、跨阶段的全局问题,是理解模型-阶段(model-stage)概念的背景图。
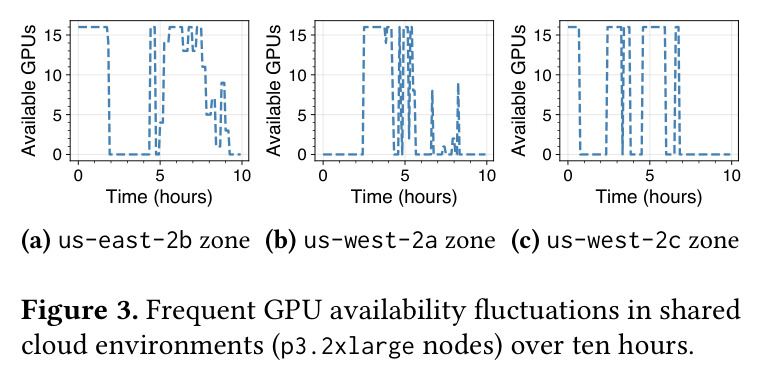
AWS三个可用区(us-east-2b、us-west-2a、us-west-2c)p3.2xlarge节点在十小时内的可用GPU数曲线,呈现频繁剧烈波动。
资源供给漂移的真实证据:16卡作业10小时内可用性变化超过10次,说明静态计划在共享云上不可持续,直接支撑论文动机。
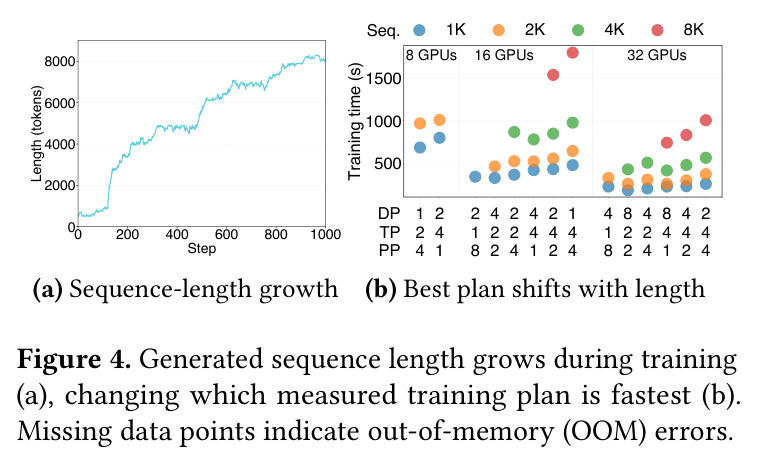
(a) Llama-3.1-8B生成序列长度在1000步内从约500 token增长到8000 token(16倍)。(b) 在16卡上不同序列长度桶(1K/2K/4K/8K)下各(DP,TP,PP)训练计划的实测时延:(4,2,2)在2K最快但4K OOM,(4,4,1)在4K可行但在2K更慢,最优点随长度漂移。
负载需求漂移的核心实验证据,直观展示固定计划必然失效、且最优计划随负载连续变化,是引入在线重规划必要性的关键图。
8B actor/critic负载GPU翻倍(4→8、8→16、16→32、32→64)的迁移耗时:Nereus 2.45/5.58/6.52/8.48s,Oobleck 10.54–83.72s,Gemini 26.56–87.25s,Tenplex 39.72–89.92s,UCP 695.94–981.21s。
Extend原语效率的完整数据,支撑比UCP快115.7–284.1倍、比Oobleck/Tenplex快3.8–16.2倍的结论。
三类重叠转换(同模型跨阶段SM-CS、跨模型同阶段CM-SS、跨模型跨阶段CM-CS)各100次随机试验:Nereus全部成功(9.80–12.60s,插入1–2条资源依赖边),DynaRL式独立迁移成功率仅62%/56%/34%(8.48–10.44s,失败为共享GPU死锁,计20s超时后为12.86–16.75s)。
全局转换DAG协调机制的直接实验验证,死锁消除是相对DynaRL的核心优势。