流匹配潜在推理的关键要素:FLaRe 训练配方 What Matters for Latent Reasoning with Flow Matching
系统消融提炼出 FLaRe 配方,让流匹配潜在推理达到显式 CoT 97% 精度、1/4 延迟
前置知识
思维链 (Chain-of-Thought, CoT) 与测试时扩展
思维链指模型在给出最终答案前先生成一段显式的中间推理文本,逐 token 自回归产出。测试时扩展(test-time scaling)则指通过更长的推理、采样多条轨迹再投票或验证等方式,用更多推理计算换取更高准确率。两者的代价都是推理成本随推理长度线性增长,且大量 token 花在对推理贡献很小的措辞上。
本文的全部动机是把显式 CoT 的中间计算搬进连续隐空间,理解显式 CoT 的成本结构和采样特性,才能评估潜在推理在五个维度上的优劣。
潜在推理 (Latent Reasoning)
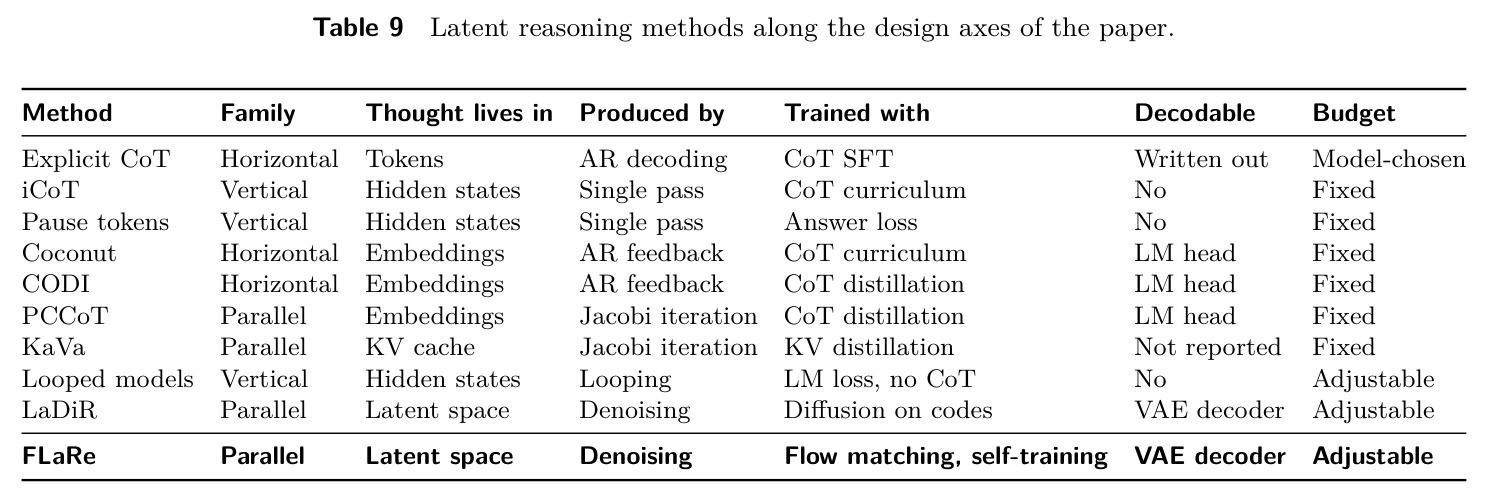
让模型的中间推理变量 $r$ 不再是离散 token 序列,而是连续隐状态:水平方法(如 Coconut)把连续表示逐槽反馈回输入;垂直方法在隐状态内部迭代或循环层;并行方法(如本文)同时精炼一整块连续槽位。推理时只在最后把答案 verbalize 出来,思维本身从不落地成文字。
本文比较的对象(Coconut、CODI、PCCoT、KaVa、LaDiR)分属这些家族,理解各自“思维存放在哪里、如何产生”才能看懂 Table 9 的设计轴对比和五个探针的结果差异。
流匹配 (Flow Matching)
一类生成建模目标:定义从高斯噪声 $\epsilon$($t=0$)到目标数据 $\bar{z}$($t=1$)的直线路径 $z_t=(1-t)\epsilon+t\bar{z}$,训练网络回归沿路径的恒定速度 $\bar{z}-\epsilon$,即损失 $\mathcal{L}_{\mathrm{FM}}=\mathbb{E}\|v_\theta(z_t,t,q)-(\bar{z}-\epsilon)\|^2$。推理时从纯噪声出发用 Euler 法积分若干步得到样本,步数可在推理时自由调节。
FLaRe 的思维生成就建立在流匹配上,时间分布怎么选、训练侧重哪个噪声区间、推理步数与可 refinement 性的关系,全部由流匹配的性质决定。
变分自编码器 (VAE) 与 β-VAE 目标
VAE 用编码器把输入压缩为隐代码 $z=\mu_\phi(r)+\sigma_\phi(r)\odot\epsilon$,解码器再从 $z$ 重建输入,目标为 $\mathcal{L}_{\mathrm{VAE}}=\mathbb{E}[-\log p_\psi(r|z)]+\beta\,D_{\mathrm{KL}}(q_\phi(z|r)\|\mathcal{N}(0,I))$。$\beta$ 权衡重建精度与隐空间正则性。本文 VAE 的编码器/解码器都是 LLM(Llama-3.2-1B/3B)。
流模型生成的目标就是 VAE 的隐代码,隐空间的容量、平滑性、编码哪种 CoT 格式直接决定下游流匹配能否成功,这是本文第一个核心消融对象。
无分类器引导 (Classifier-Free Guidance, CFG)
扩散/流模型的引导技巧:训练时以概率 0.1 把条件 $q$ 替换成空 token $\varnothing$,推理时用 $\tilde{v}_\theta(z,t,q)=v_\theta(z,t,\varnothing)+w\,[v_\theta(z,t,q)-v_\theta(z,t,\varnothing)]$ 外推条件与非条件速度,引导强度 $w$ 控制生成结果贴合问题的程度。
FLaRe 推理和 stage 2 rollout 全程使用 $w=4$ 的引导速度,stage 2 的答案损失还要反向传播穿过引导的两个分支,这是复现该方法绕不开的细节。
STaR / ReST-EM 式验证自训练
一类自提升方法:模型对只有标准答案的新问题采样多条推理,保留最终答案与参考一致的轨迹,再把这些轨迹当作新的训练目标迭代训练,从而无需额外 CoT 标注、奖励模型或强化学习目标。
FLaRe 的 stage 2 正是该思想在隐空间的移植:生成 $K=8$ 个隐思维、解码后验证最终答案、把通过的 CoT 重新编码为流目标,并让答案损失反向传播穿过完整去噪 rollout。
EMA 权重与 pass@k
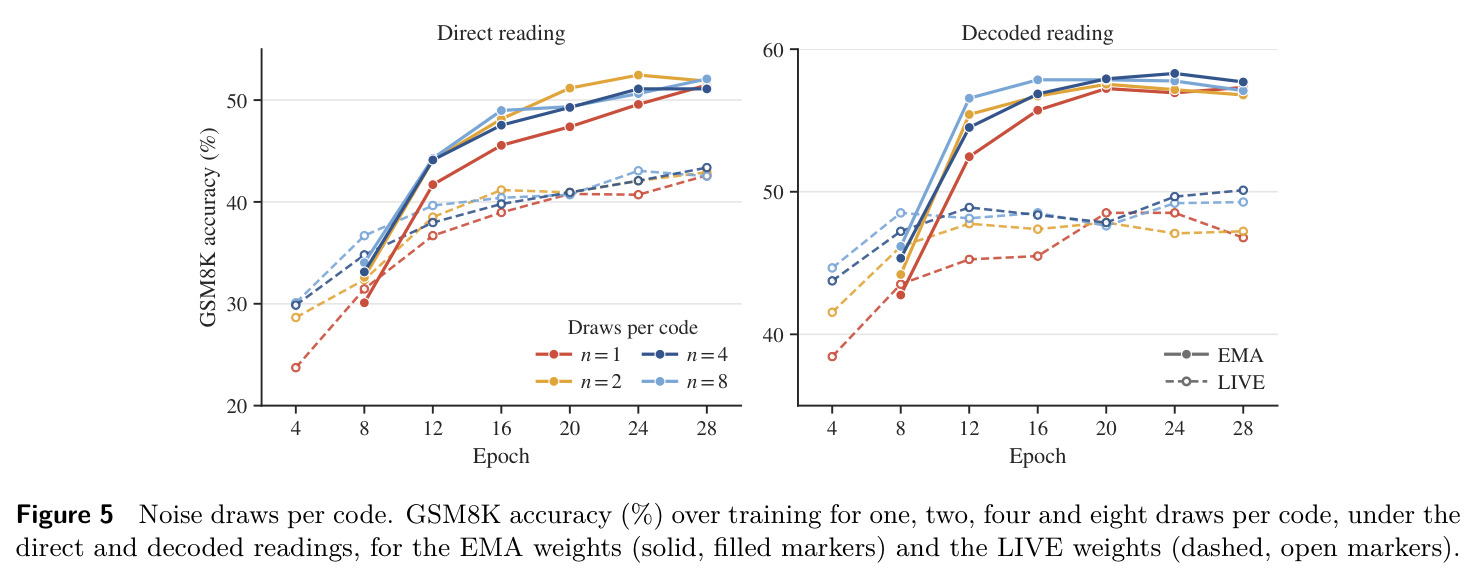
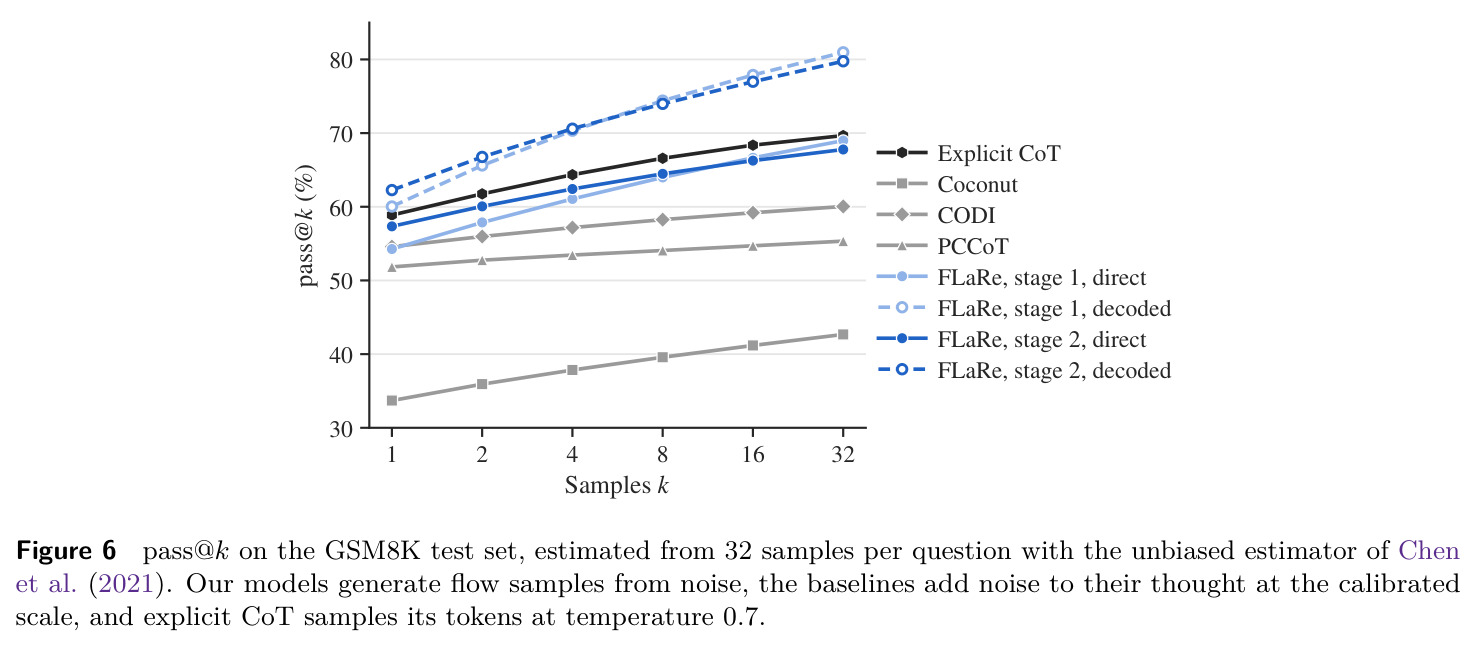
指数滑动平均(EMA)以衰减率 $\lambda$ 维护一份训练权重的影子副本($\bar{\theta}\leftarrow\lambda\bar{\theta}+(1-\lambda)\theta$),常比 LIVE 权重更稳。pass@k 表示每个问题采 $k$ 个样本时至少一个正确的比例,是衡量采样多样性与覆盖度的标准指标(通常用无偏估计量计算)。
本文用 pass@16 和多数投票探针衡量“多样性”需求,stage 1 用 EMA 权重评估、stage 2 用 LIVE 权重,这些细节直接影响对实验表格的解读。
研究动机
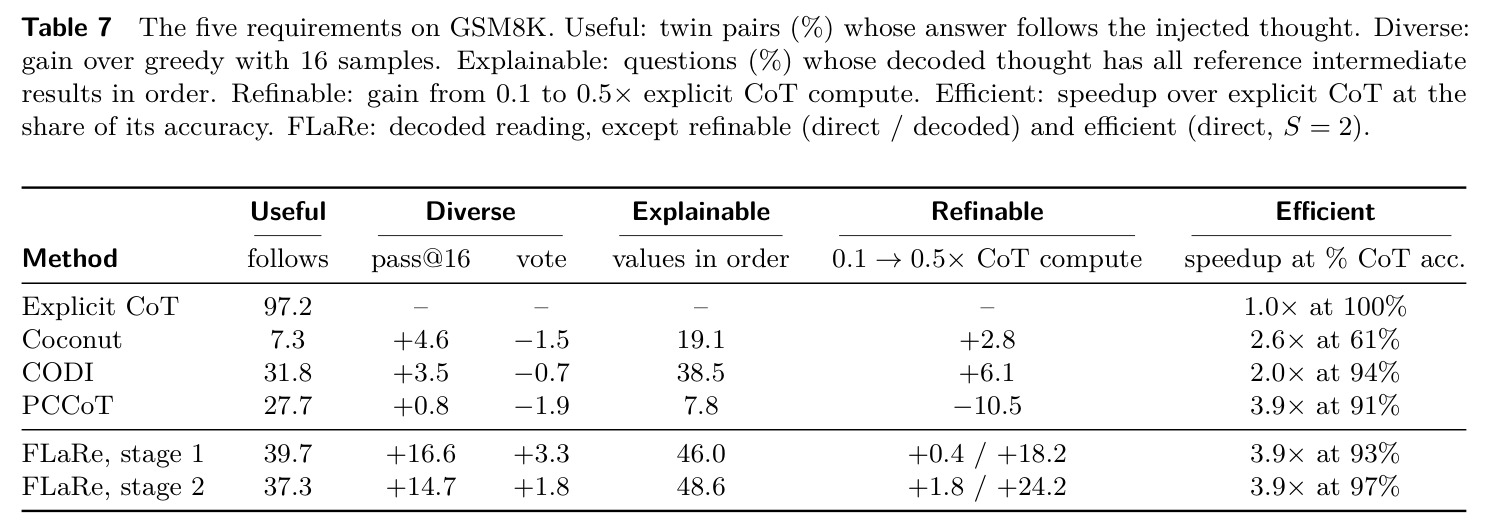
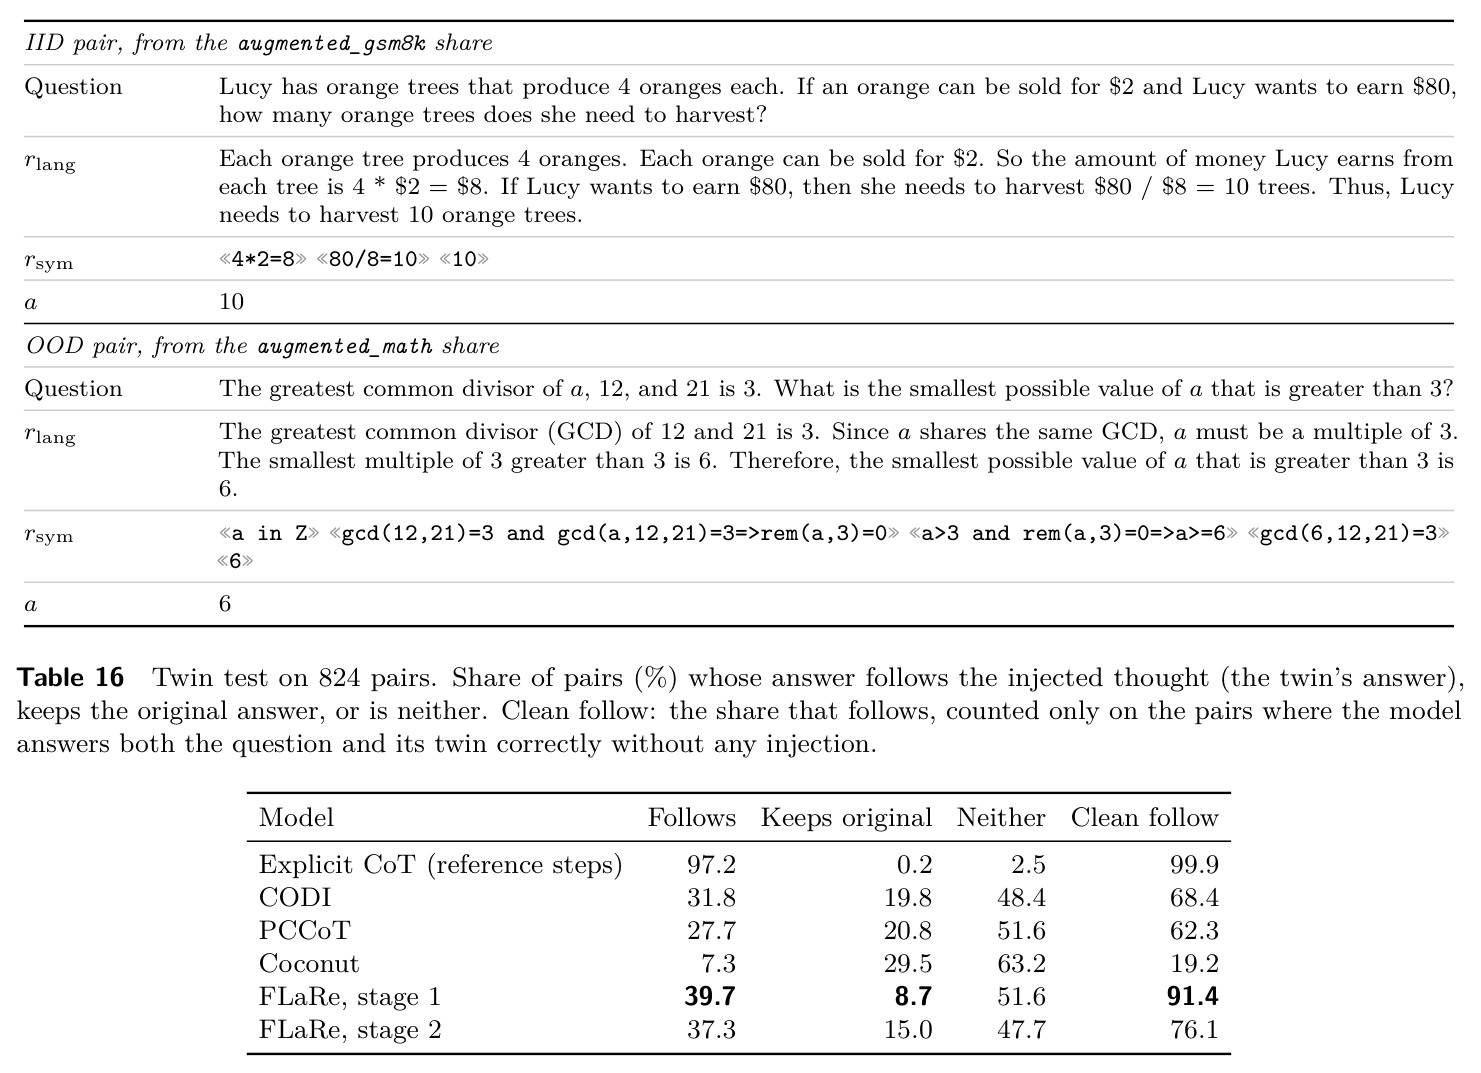
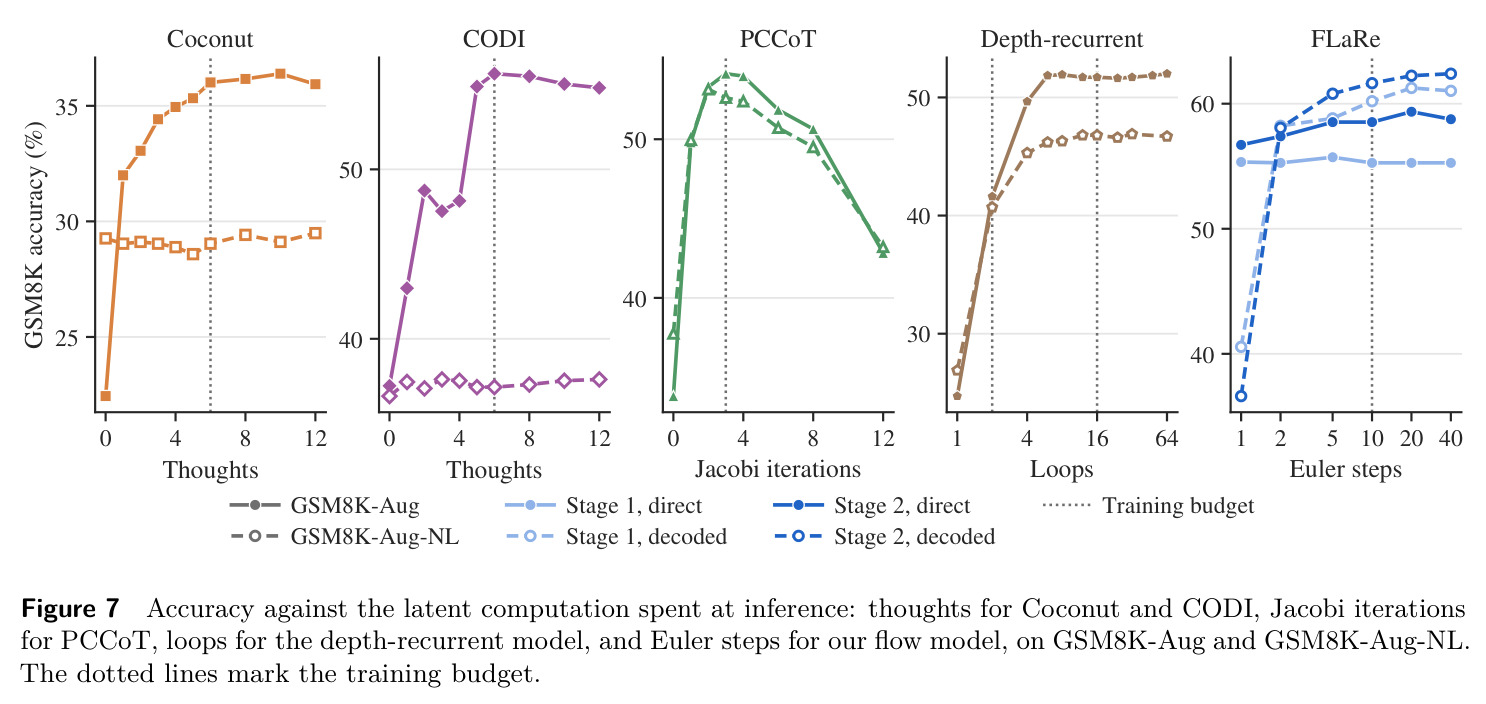
显式思维链(CoT)虽然有效,但存在三个结构性缺陷:成本随推理链长度线性增长(GSM8K 测试集上平均每题要生成 27.6 个 token、24 次顺序前向);大量成本花在对推理几乎没有贡献的措辞性文字上(Hao 等 2025 的观察);单次自回归 rollout 会在早期 token 上“下注”,一旦想探索另一条推理路径就必须重新生成整段文字。潜在推理试图用连续隐状态承载中间计算来规避这些问题,但现有方法普遍不达标:作者用“孪生注入测试”量化发现,把孪生问题的思维注入原问题后,显式 CoT 有 97.2% 的答案跟随被注入的思维,而 Coconut 只有 7.3%、PCCoT 27.7%、CODI 31.8%——说明这些方法的“思维”大都是从问题直达答案的捷径,CoT 被课程学习或蒸馏内化进了权重。精度上差距同样明显:1B 规模下显式 CoT 在 GSM8K 上 62.5%,Coconut 仅 36.1%。此外基线方法的推理预算被固定在训练时的水平(Coconut 超过 2 个思维就不稳定、CODI 峰值 6 个潜在 token、PCCoT 峰值 3 次 Jacobi 迭代),无法用更多推理计算精炼思维。
本文的目标是作者提出一个有效隐思维必须同时满足五个需求:有用(useful,答案确实依赖思维而非问题捷径)、多样(diverse,重采样能产生不同推理轨迹)、可解释(explainable,解码出的 CoT 反映答案实际遵循的推理)、可精炼(refinable,能用更多推理计算提升思维质量)、高效(efficient,同等精度下开销低于显式 CoT)。本文的目标有二:其一,聚焦作者认为最有潜力同时满足四项需求的家族——在学习到的隐空间中做流匹配(latent flow matching),通过受控消融逐一找出让这条管线真正有效的训练选择,并整合成简单配方 FLaRe(Flow-based Latent Reasoning);其二,为五个需求各设计一个可量化的探针,系统比较 FLaRe 与 Coconut、CODI、PCCoT 等先前方法,并给出最终权衡:达到显式 CoT 97% 的精度、1/4 的延迟。
与已有工作不同的是,本文的独特切入有三点。第一,先前潜在推理工作各自提出一个新机制,而本文反其道行之:固定“VAE+流匹配+自训练”的框架不变,对管线每一环(隐空间编码什么、如何塑形、流在哪里训练、答案如何读出、是否端到端)做受控消融,回答“什么才重要”。第二,作者指出一个反直觉事实:VAE 重建精度与下游流匹配准确率在 66 个 VAE 上的相关性仅 $\rho=-0.12$,重建越好反而可能越难生成——这推翻了“隐空间质量=重建质量”的默认假设,引出“平滑性比精度重要”的核心洞察,并用输入 token 替换、隐噪声、隐 dropout 三种腐蚀手段主动降低重建换取生成性。第三,作者为潜在推理领域首次定义了五需求及其探针(孪生测试、采样测试、按序读值测试、预算扫描、延迟测量),把“思维是否真的被使用”“是否可解释”这类此前只有轶事证据的问题变成可测量的指标。
核心方法
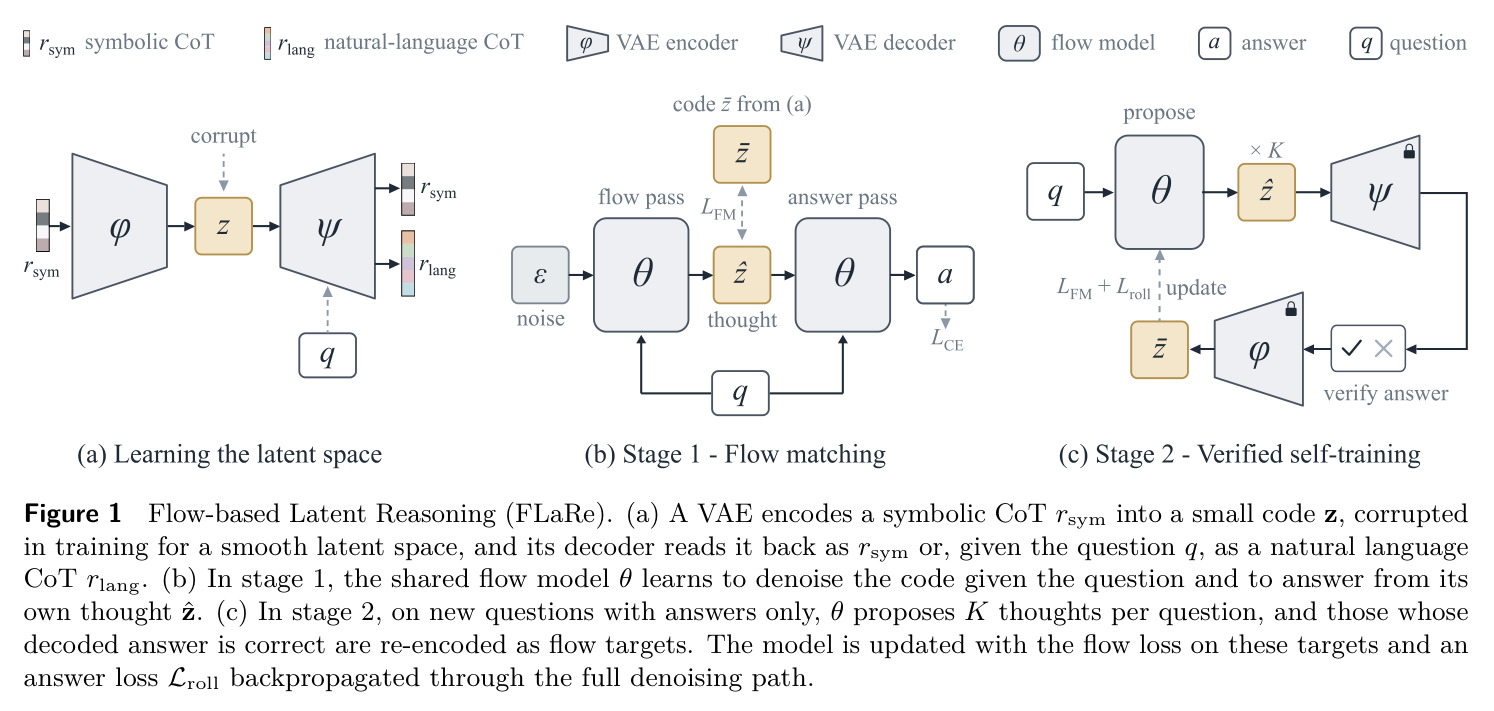
直觉上,FLaRe 把“思考”变成一个生成问题:给定问题 $q$,从高斯噪声出发,用流匹配在 VAE 隐空间中“去噪”出一个 8×512 的隐思维 $\hat{z}$,再由同一个共享模型自回归地读出答案。整条管线分两阶段。前置步骤是训练 VAE:编码器(Llama-3.2-1B)把符号化 CoT $r_{\mathrm{sym}}$(如 «4*5=20» 这样的极简推理步)压缩成 $M=8$ 个维度 $d=512$ 的槽位代码;解码器(微调过的 Llama-3.2-3B)通过“双路线”把代码分别重建回符号 CoT 和给定问题的自然语言 CoT。阶段 1 训练共享流模型 $\theta$(Llama-3.2-1B-Instruct):联合目标 $\mathcal{L}=\lambda_{\mathrm{FM}}\mathcal{L}_{\mathrm{FM}}+\mathcal{L}_{\mathrm{CE}}$($\lambda_{\mathrm{FM}}=5$),流损失让模型在问题条件下学会去噪代码,答案损失让模型学会从隐思维读出答案。阶段 2 是验证自训练:在 10 万个只有答案的新问题上,每题从中心化噪声采 $K=8$ 个思维,用冻结 VAE 解码器解码并验证最终答案,通过的 CoT 重新编码为流目标,同时答案损失反向传播穿过完整的 10 步引导去噪 rollout。推理时用 $S=20$ 步 Euler 积分加引导强度 $w=4$ 生成思维,同一模型贪心生成答案。
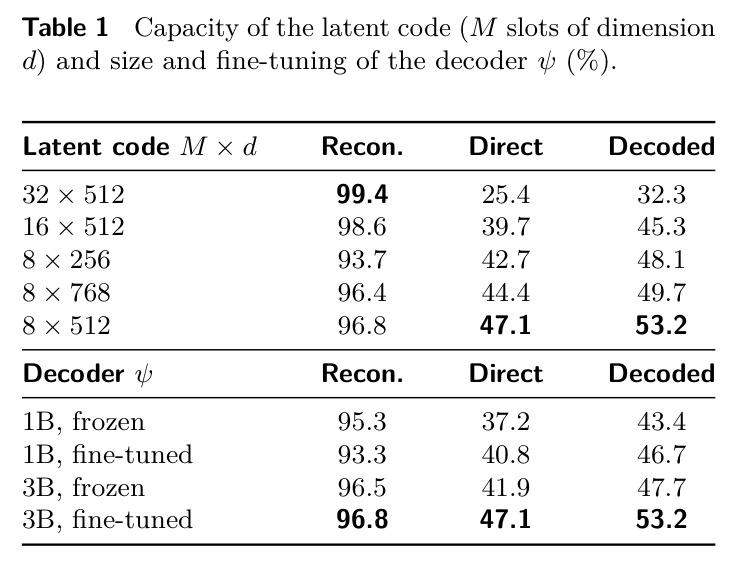
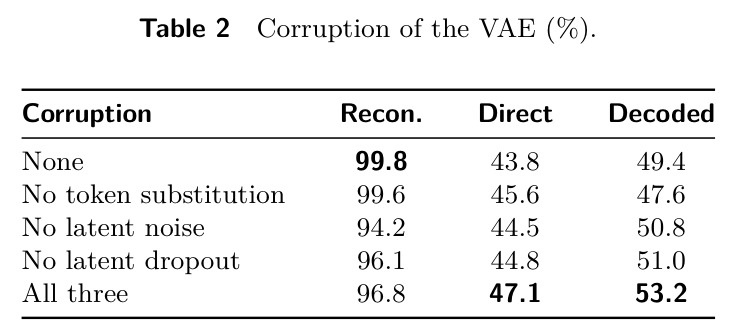
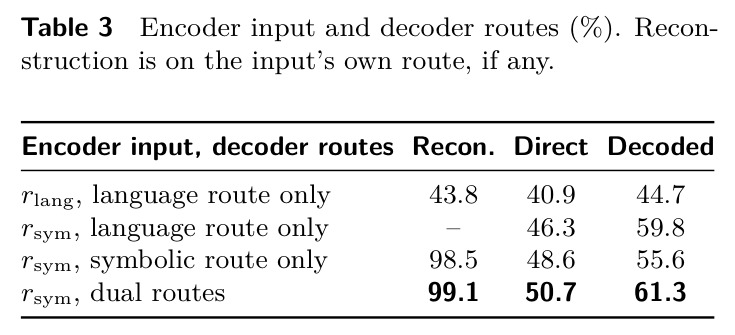
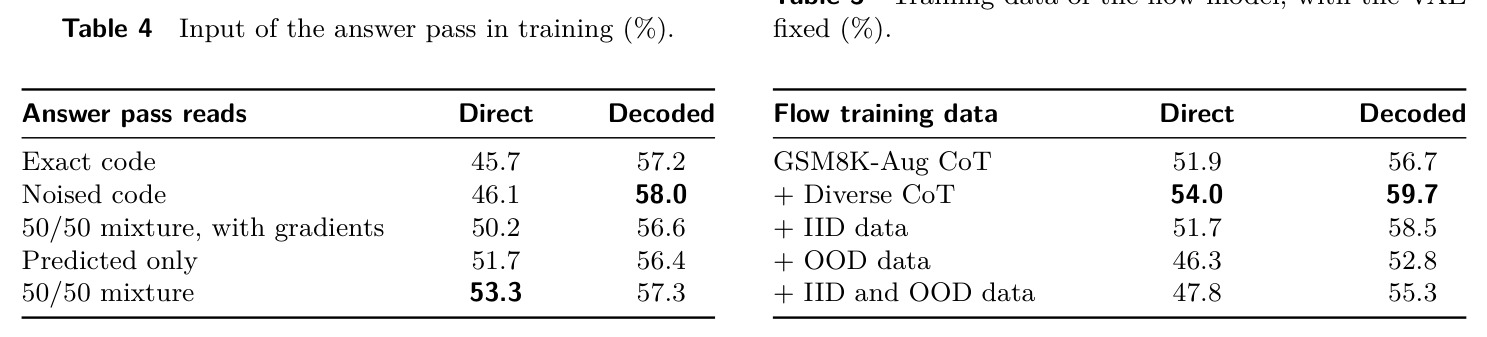
核心创新是四个反直觉的训练选择,它们与已有方法的本质区别在于“为生成而设计隐空间,而非为重建”。(1) 平滑重于精度:与其扩大代码容量或收紧 $\beta$-VAE 的 KL 项,不如在训练时腐蚀编码器输入($p_{\mathrm{sub}}=0.3$ 的 token 替换)和代码本身($\delta=0.7$ 的方差保持噪声、$p_{\mathrm{drop}}=0.4$ 的隐 dropout),让每个 CoT 对应隐空间中一片平滑区域而非一个精确点——推理时思维只需落入区域即可被正确解码,而不必精确命中某个代码。证据是把代码从 8 槽扩到 32 槽,重建从 96.8% 升到 99.4%,直接准确率却从 47.1% 跌到 25.4%。(2) 训练信号集中于噪声端:时间 $t$ 采样自 $t=\mathrm{sigmoid}(s),\ s\sim\mathcal{N}(-2,0.8^2)$ 的 logit-normal,因为推理从纯噪声出发,均匀采样会让模型只学会精炼近乎完整的代码。(3) 答案读出器必须见过“带瑕疵的思维”:训练时答案通以 50/50 混合读取带噪代码和模型自己的一步预测端点(后者 stop-gradient),使其适配推理时生成的不完美思维。(4) 每题多条 CoT 迫使流覆盖解空间而非记忆单一目标:用 Qwen2.5-32B-Instruct 为每题写 16 个解(保留 21.6 万条),这一项带来最大的单项增益。
方法步骤详情
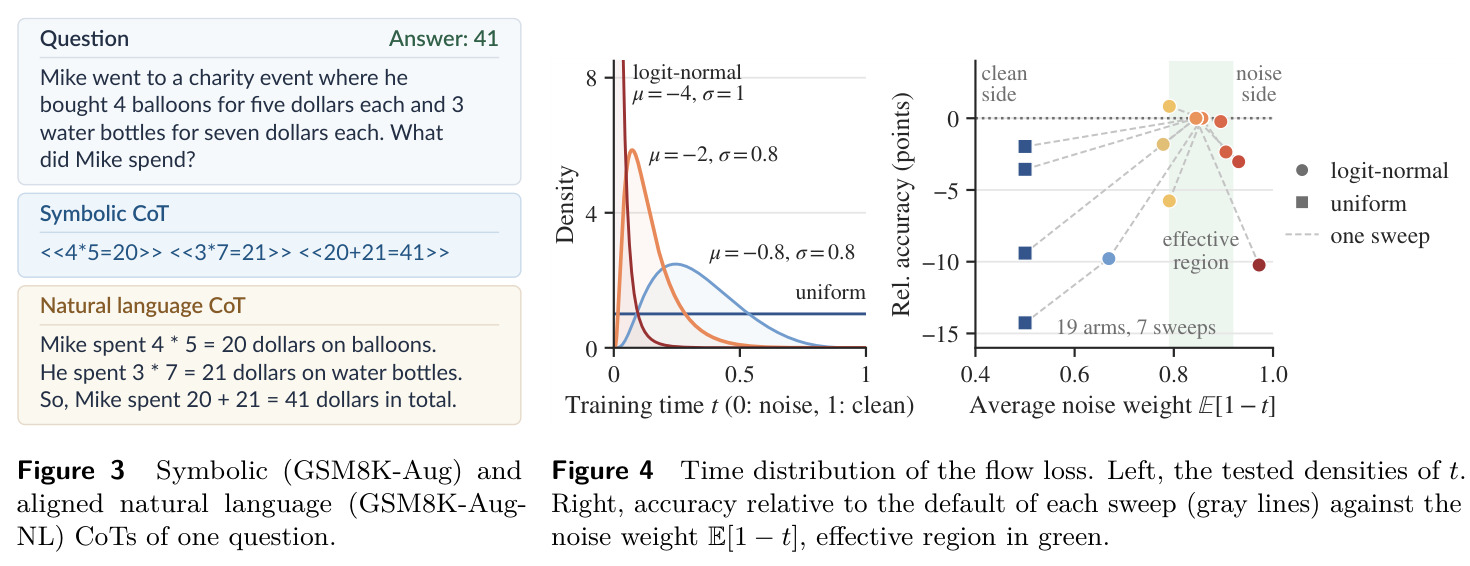
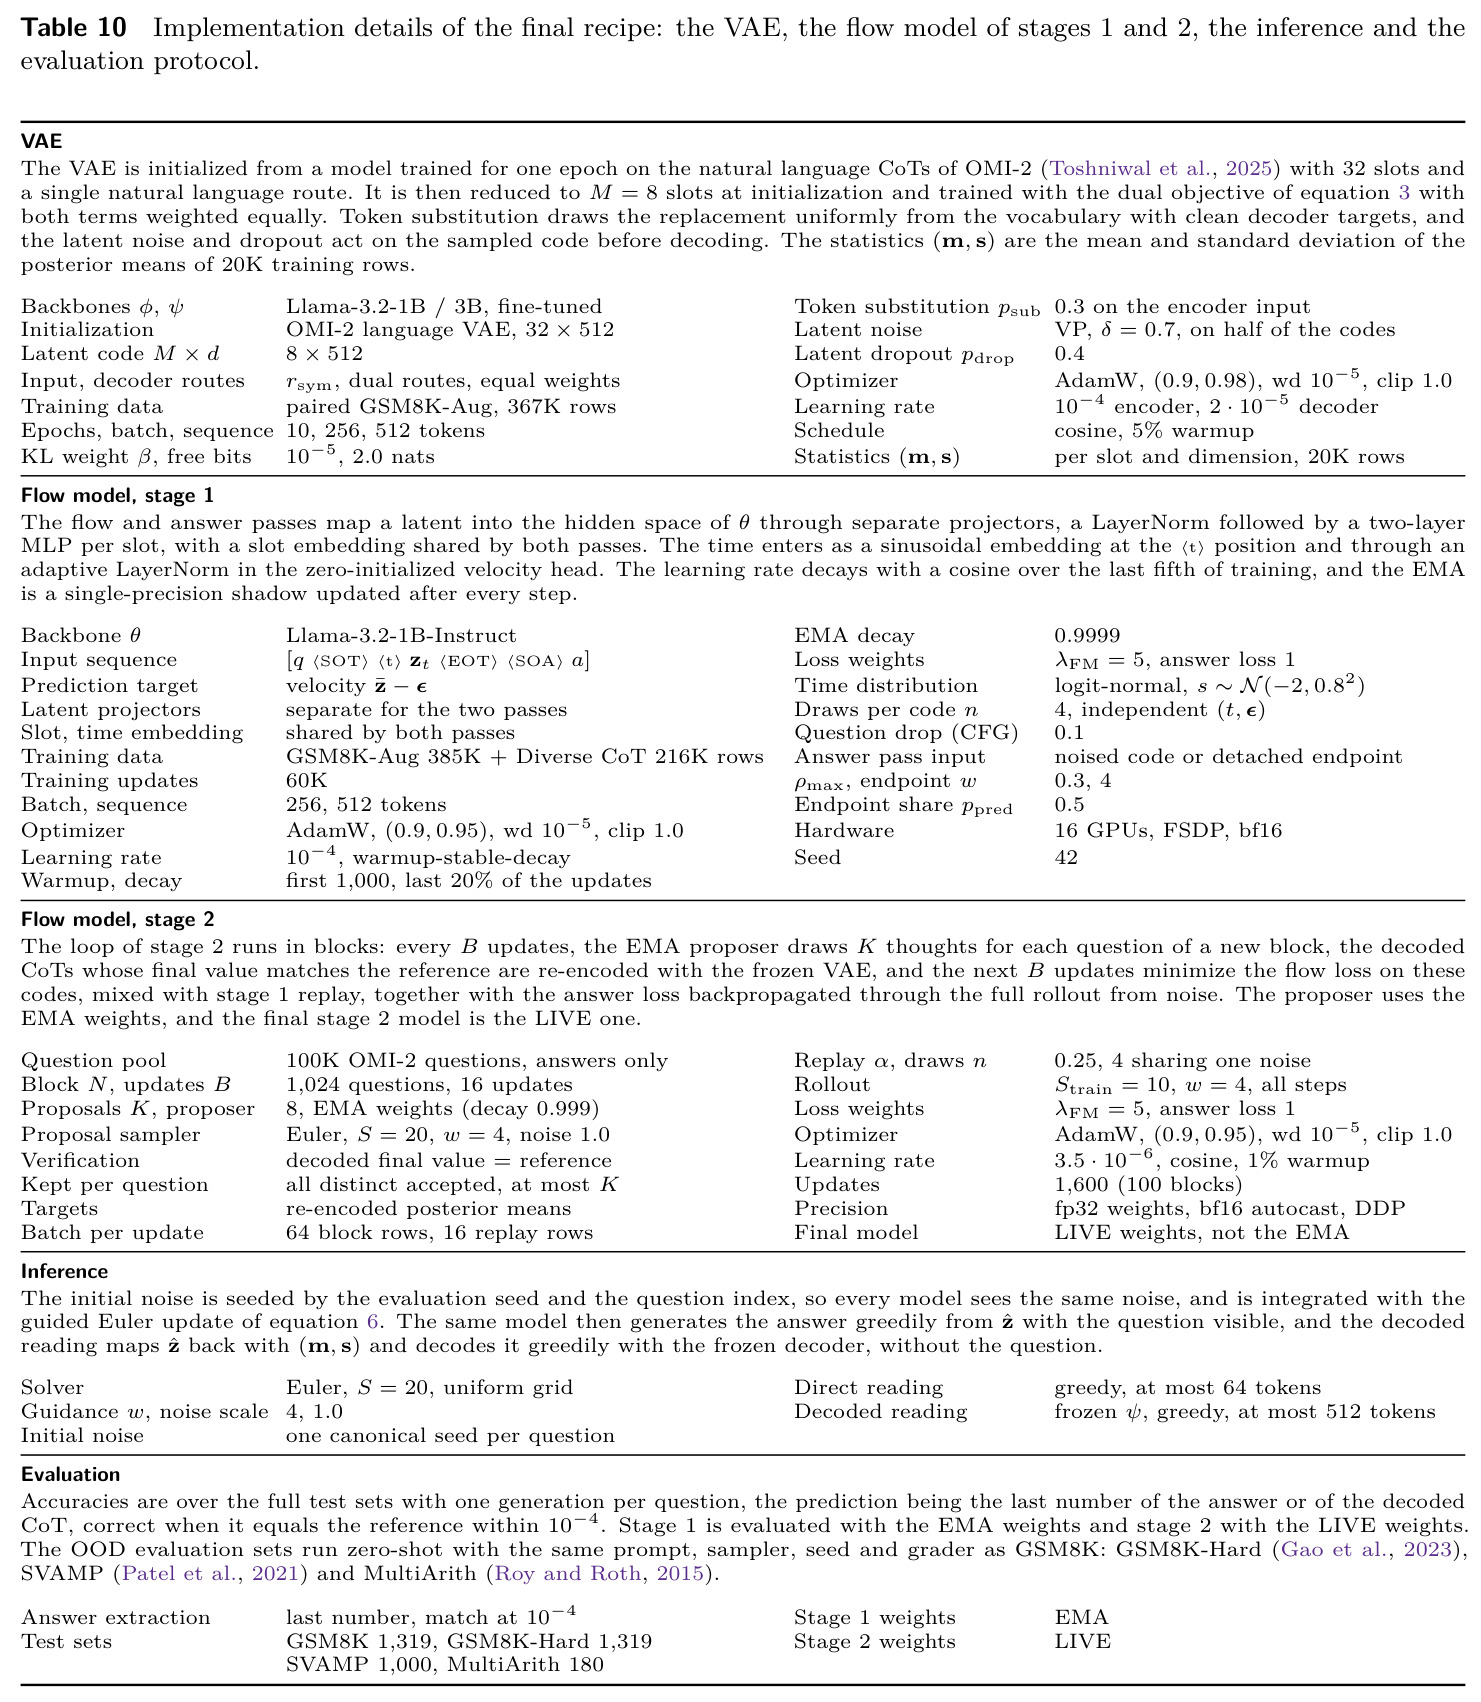
完整流程如下。第 0 步(数据准备):把 GSM8K-Aug 的符号 CoT 与对齐的自然语言 CoT 逐行配对成 $D_{\mathrm{vae}}$(36.7 万行);对只有自然语言 CoT 的语料(OMI-2),用 Qwen3.8-27B 按“小步符号语言”规则把每条 CoT 编译成符号形式,产出 62.98 万对。第 1 步(VAE 训练):编码器读 $[r_{\mathrm{sym}},\langle Z\rangle_1\cdots\langle Z\rangle_M]$,槽位最终隐状态给出后验均值与方差,采样得 $z$;解码器通过双路线最小化 $\mathcal{L}_{\mathrm{VAE}}=\mathbb{E}[-\log p_\psi(r_{\mathrm{sym}}|z)-\log p_\psi(r_{\mathrm{lang}}|z,q)]+\beta D_{\mathrm{KL}}$($\beta=10^{-5}$,free bits 2.0 nats),训练中施加三种腐蚀;流目标取按槽位标准化的后验均值 $\bar{z}=(\mu_\phi(r)-m)/s$。第 2 步(阶段 1 流训练,6 万次更新):每次迭代先做流通过——插值 $z_t=(1-t)\epsilon+t\bar{z}$,槽位双向注意力,回归引导速度,每代码取 4 组独立 $(t,\epsilon)$ 降低梯度方差,问题以 0.1 概率替换为空 token 以支持 CFG;再做答案通过——槽位处放 $z_{\mathrm{ans}}$(50% 概率是 detach 的一步端点 $\hat{z}=z_t+(1-t)\tilde{v}_\theta$,50% 是 pulled-toward-noise 的代码),最小化 $\mathcal{L}_{\mathrm{CE}}=-\log p_\theta(a|q,z_{\mathrm{ans}})$;权重用 EMA(衰减 0.9999)。第 3 步(推理):从 $z_0\sim\mathcal{N}(0,I)$ 出发按均匀网格跑 $S=20$ 步引导 Euler 更新得到 $\hat{z}$,同一模型以 $\hat{z}$ 为条件贪心生成长至 64 token 的答案。第 4 步(阶段 2 自训练,1600 次更新、约 6 小时/16 张 H100):每块 1024 个新问题,EMA 提议者从中心化高斯起点为每题生成 $K=8$ 个思维($S=20$ 步),冻结解码器解码成符号 CoT,最终答案匹配参考者全部保留并去重、重编码为流目标;随后 16 次更新混合在线流损失(权重 0.75)、阶段 1 回放(0.25)和穿过完整 10 步 rollout 的答案损失 $\mathcal{L}_{\mathrm{roll}}$,产出 LIVE 权重即最终模型。
技术新颖性
技术新颖性体现在四个层面。第一,与最直接的竞争者 LaDiR 同属“隐空间去噪”家族,但 LaDiR 逐块自回归地生成变长思维(每个推理步一个 3 槽代码块,每块都要完整去噪),而 FLaRe 是单块并行精炼:顺序前向只需 $2S$ 次且与思维宽度无关,实测 LaDiR 每题约 130 次顺序前向、1.5 秒,FLaRe 仅 40 次、0.46 秒;在相同训练数据下,仅凭 Sec. 3 的设计选择,FLaRe 阶段 1 就比复现的 LaDiR 高出 10.7 到 21.0 个点。第二,据作者所知,这是首个把答案损失反向传播穿过完整流匹配 rollout 的工作——扩散/流模型此前只做监督去噪,本文证明这正是把“解码读出准确率”与“思维生成质量”之间 4-6 个点差距关掉的关键(去掉该损失增益几乎全失,detach 端点损失 2.3/2.6 个点,一步 rollout 损失 2.8/1.9 个点)。第三,五需求探针框架(孪生测试、按噪采样、按序读值、预算扫描、延迟测量)是领域内第一套系统评估工具,此前 Coconut“超叠加坍缩”、CODI 思维可换等发现只有轶事级证据。第四,中心化噪声起点($K$ 个起点求和为零再重缩放)在不损失单样本精度(93.1% 候选正确率不变)的前提下,把每题去重后不同 CoT 中位数从 1 提到 2,多找到 5.3% 的问题的已验证 CoT,是对自训练采样的一个小而实用的改进。
实验结果
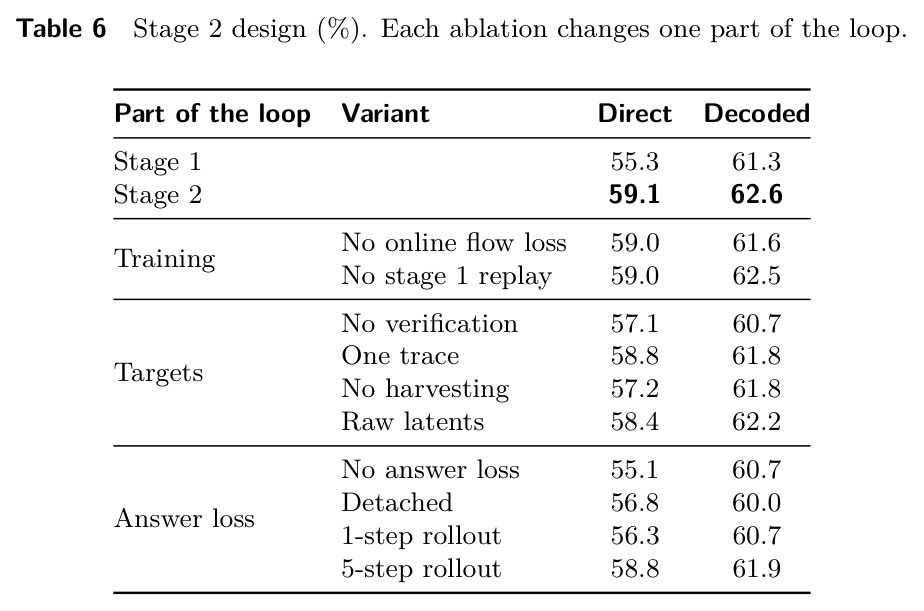
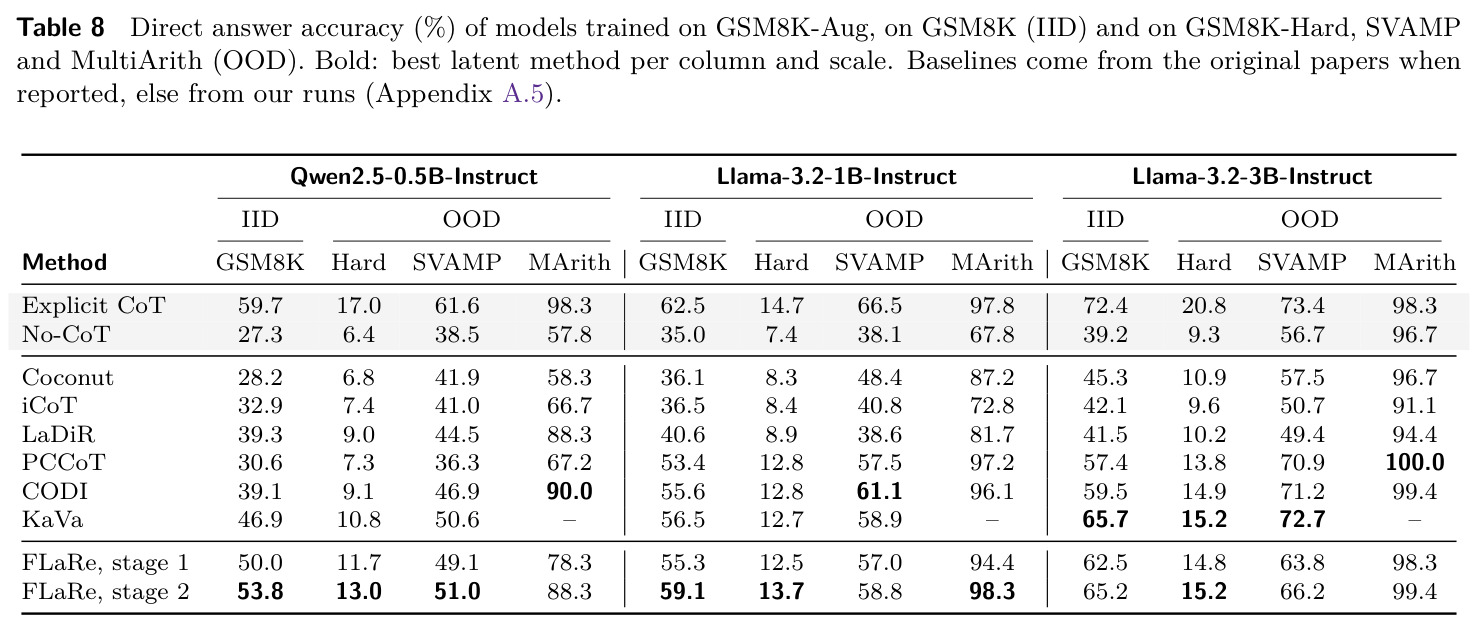
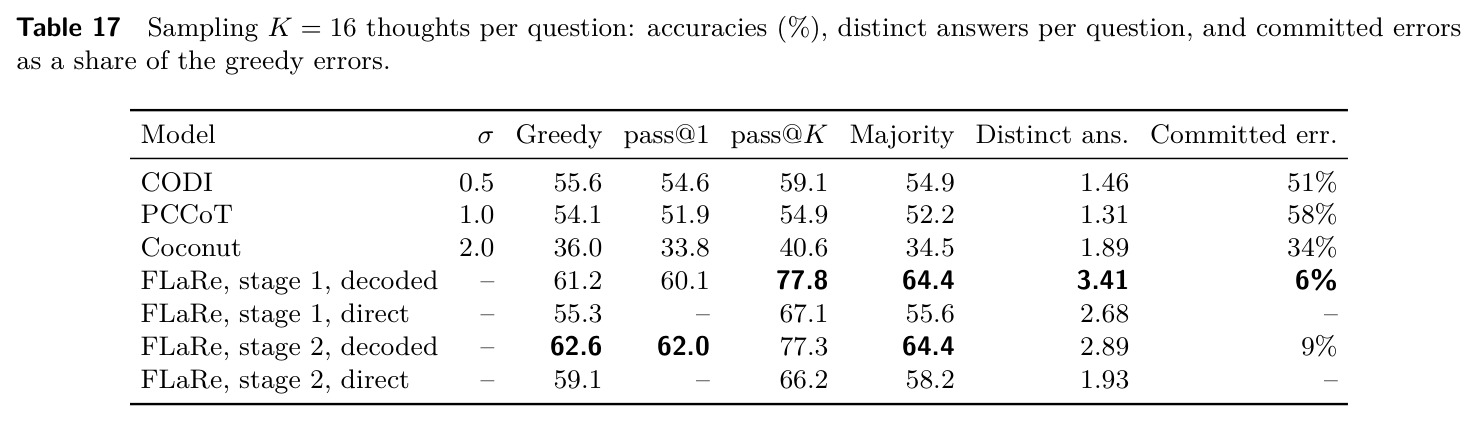
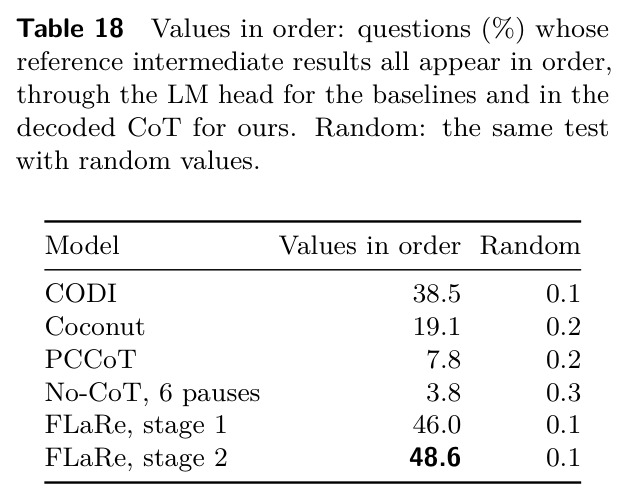
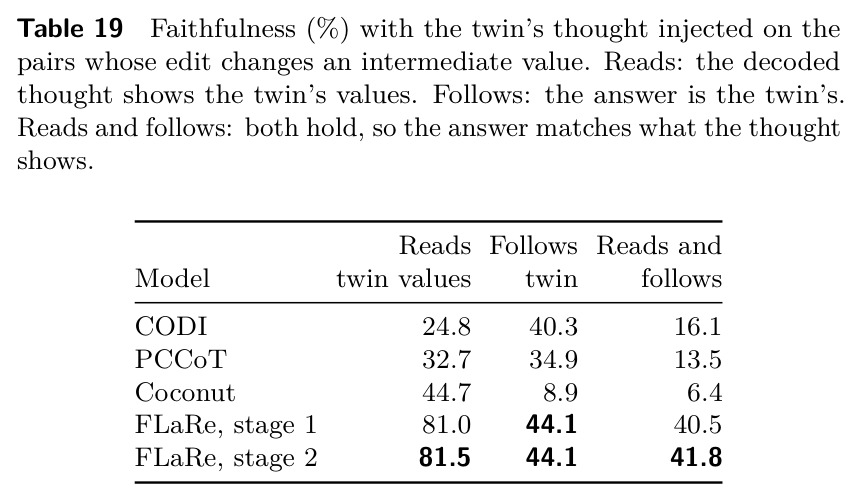
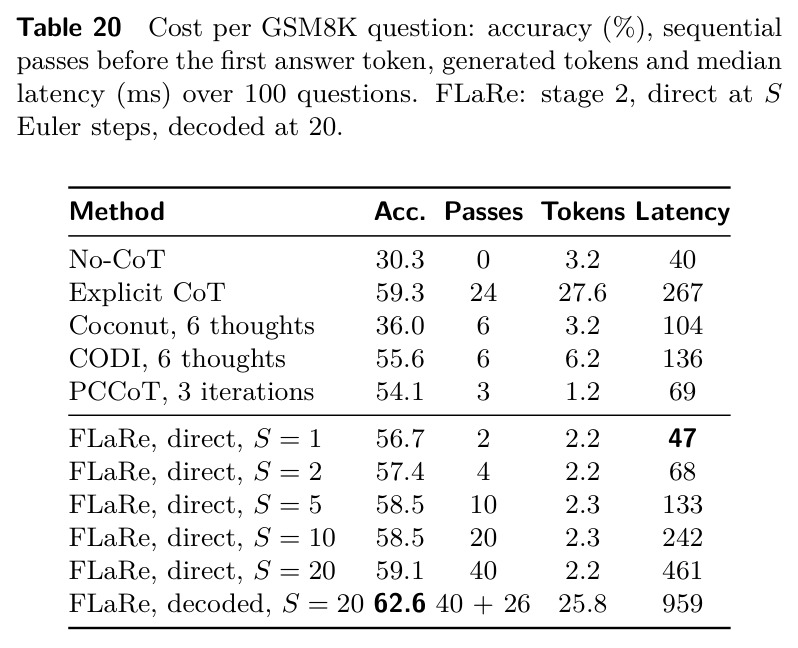
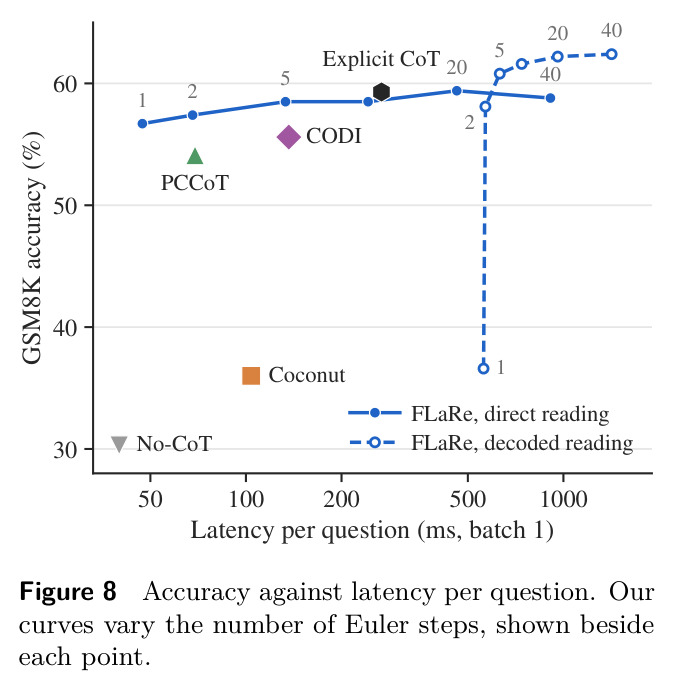
作者逐环消融并最终在三个骨干(Qwen2.5-0.5B / Llama-3.2-1B / Llama-3.2-3B-Instruct)上对比。隐空间消融(Table 1-3):容量上 8×512 优于 32×512(直接 47.1% vs 25.4%);66 个 VAE 的重建率与解码准确率相关性 $\rho=-0.12$;三种腐蚀全开最优(47.1/53.2),去掉 token 替换解码掉 5.6 个点;符号 CoT 编码优于自然语言 CoT(编码后者掉约 10 个直接点、17 个解码点),双解码路线再提升(50.7/61.3 vs 单符号路线 48.6/55.6);微调 3B 解码器最佳(53.2 vs 1B 解码器 46.7)。流匹配消融(Table 4-5):时间分布强偏向噪声端才学得动,均匀最差;答案通过 50/50 混合读取 detach 端点与带噪代码最优(53.3/57.3);多样 CoT 数据带来最大增益(51.9→54.0 直接、56.7→59.7 解码),同分布新问题帮助较小(51.7),异分布数据反而有害(46.3)。阶段 2 消融(Table 6):整体提升直接 3.8、解码 1.3 个点,增益几乎全部来自穿 rollout 的答案损失;验证不可少(去掉掉 2.0/1.9 个点)。五需求探针(Table 7):有用性上 FLaRe 孪生跟随率 39.7/37.3(干净对上 91.4/76.1),远超 CODI 31.8、PCCoT 27.7、Coconut 7.3,但仍低于显式 CoT 的 97.2;多样性上阶段 1 解码读法 pass@16 比贪心高 16.6 个点、投票再 +3.3,基线最多 +5 且投票从不提升(CODI 一半错误是“承诺错误”);可解释性上 46.0/48.6% 的问题解码思维按序包含全部中间结果(CODI 38.5、Coconut 19.1、PCCoT 7.8),孪生思维忠实性上“既读出又遵循”达 40.5/41.8% vs 基线 6-16%;可精炼性上预算从 0.1× 提到 0.5× 显式 CoT,解码读法 +18.2/+24.2 个点(基线最多 +6.1,PCCoT 反掉 10.5);高效性上阶段 2 直接读法 2 步 Euler 达显式 CoT 97% 精度、3.9× 加速。主基准(Table 8):1B 上 FLaRe 阶段 2 GSM8K 59.1%,超过 KaVa 56.5、CODI 55.6、PCCoT 53.4,逼近显式 CoT 62.5;0.5B 上 53.8% 领先 KaVa 6.9 个点;3B 上 65.2% 与 KaVa 65.7 持平;GSM8K-Hard 全尺度领先或持平。延迟实测(Table 20,单张 RTX 3090、逐题):一步 Euler 22ms,显式 CoT 每题 267ms/59.3%,FLaRe 两步仅 68ms/57.4%,20 步 461ms/59.1%,而 LaDiR 需约 1.5 秒。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GSM8K(IID,Llama-3.2-1B-Instruct) | 直接答案准确率 (%) | 59.1(FLaRe stage 2) | KaVa 56.5;CODI 55.6;PCCoT 53.4;Coconut 36.1;显式 CoT 62.5 | +2.6 vs 最强潜在基线 KaVa,达显式 CoT 的 94.6% |
| GSM8K(IID,Qwen2.5-0.5B-Instruct) | 直接答案准确率 (%) | 53.8(FLaRe stage 2) | KaVa 46.9;CODI 39.1;显式 CoT 59.7 | +6.9 vs KaVa,小模型上优势最明显 |
| GSM8K(IID,Llama-3.2-3B-Instruct) | 直接答案准确率 (%) | 65.2(FLaRe stage 2) | KaVa 65.7;CODI 59.5;显式 CoT 72.4 | 与 KaVa 基本持平(-0.5),超过其余全部潜在方法 |
| GSM8K-Hard(零样本 OOD,1B) | 直接答案准确率 (%) | 13.7(FLaRe stage 2) | KaVa 12.7;CODI 12.8;PCCoT 12.8;显式 CoT 14.7 | +1.0 vs KaVa,全尺度领先或持平 |
| SVAMP(零样本 OOD,1B) | 直接答案准确率 (%) | 58.8(FLaRe stage 2) | CODI 61.1;KaVa 58.9;显式 CoT 66.5 | -2.3 vs CODI(落后,作者归因于 SVAMP 近半数题目含干扰数字,训练分布罕见) |
| 效率:GSM8K 单题延迟(RTX 3090、batch 1) | 显式 CoT 精度百分比 × 加速比 | 97% 精度、3.9× 加速(stage 2 直接读法 S=2:57.4%,68ms) | CODI 94%、2.0×(55.6%,136ms);PCCoT 91%、3.9×(54.1%,69ms);显式 CoT 59.3%、267ms | 同等加速比下精度高 3-6 个点;LaDiR 需约 1.5s,慢 22 倍 |
| 有用性:孪生注入测试(824 对) | 答案跟随注入思维的比率 (%) | 39.7(stage 1)/ 37.3(stage 2);干净对上 91.4 / 76.1 | CODI 31.8;PCCoT 27.7;Coconut 7.3;显式 CoT 97.2 | +7.9 vs CODI(全部对),表明思维确实被使用但仍有捷径依赖 |
| 多样性:每题采 16 个思维(解码读法) | pass@16 相对贪心的增益 (点) / 多数投票增益 | +16.6 / +3.3(stage 1);+14.7 / +1.8(stage 2) | Coconut +4.6/-1.5;CODI +3.5/-0.7;PCCoT +0.8/-1.9 | 覆盖增益 3-20 倍于基线,且唯一能从投票中获益的方法 |
| 可解释性:按序读值测试 | 解码思维按序包含全部参考中间结果的问题占比 (%) | 46.0(stage 1)/ 48.6(stage 2) | CODI 38.5;Coconut 19.1;PCCoT 7.8;No-CoT 对照 3.8 | +7.5 vs CODI,且本文判据更严格(要求精确数值、替代路径算失误) |
| 可精炼性:推理预算 0.1×→0.5× 显式 CoT | 准确率增益(点) | +24.2 解码 / +1.8 直接(stage 2) | CODI +6.1;Coconut +2.8;PCCoT −10.5(超出训练预算即崩溃) | 解码读法增益约为最强基线的 4 倍,且 40 步时仍不退化 |
局限与改进
作者承认并正文讨论的局限:(1) SVAMP 是主要例外,1B 上落后 CODI 2.3 个点,作者归因于该数据集近半数题目含干扰性数字而 GSM8K-Aug 训练分布中罕见;(2) “有用性”指标本身不完美——即使只看模型两题都答对的干净对,跟随率也只有 91.4/76.1%,仍明显低于显式 CoT 的 99.9%,说明捷径学习未被根除,且 stage 2 自训练后对问题的依赖反而略增;(3) 直接读法与解码读法间仍有差距(阶段 2 为 59.1 vs 62.6),说明生成的思维与干净 VAE 代码之间仍有失配;(4) 可变宽度实验(Appendix A.4)在 GSM8K-Aug 上无收益,因为符号 CoT 中位数仅 21 个 encoder token,8 槽已重建 98.7%,固定宽度的局限未在富符号数据上验证;(5) 解释性只在算术类短推理上量化,且约四成孪生对出现“思维读出了孪生值但答案未跟随”。我自己的观察:(6) 全部实验局限于 GSM8K 系算术任务,最长 CoT 中位数 21 token、90% 低于 35 token,对需要长程规划的任务(代码、多步科学推理)是否成立完全未知;(7) 阶段 2 的验证依赖冻结解码器能把思维解码成可解析、答案正确的 CoT,这隐含要求领域存在可靠符号化与答案匹配器,开放性任务无法套用;(8) 符号化转换管线依赖 Qwen3.8-27B 级别的模型做离线编译,引入了对转换质量的隐性依赖(审核通过率 90.5%);(9) 计算成本不低——阶段 1 在 16 张 GPU 上训练 6 万步、每代码 4 次前向,阶段 2 再约 6 小时/16 张 H100,相比 LoRA 微调的基线方法贵一个量级;(10) 论文未提供代码发布链接,复现需依赖详尽的附录超参表。
独立分析的弱点
独立分析以下几个弱点。其一,捷径残留与有用性天花板:孪生测试的全对跟随率仅 37-40%,干净对也只有 76-91%,说明相当一部分正确答案仍可由问题直达;更值得注意的是 stage 2 自训练把“换掉思维后仅给问题”的准确率从 40.6(stage 1)抬到 39.3→对问题依赖度上升(40.6→39.3 无思维时),自训练可能在强化问题到答案的映射。改进方向:在阶段 2 的验证中不只匹配最终答案,还要求解码 CoT 的中间结果与参考逐步一致(本文只验证最终值),或引入“思维消融正则”(随机置零思维时惩罚答案正确)显式迫使答案依赖思维。其二,验证机制的领域特异性:答案匹配式验证只能用于有唯一数值/字符串答案的任务,且无法认证中间步骤正确性(碰巧答案对的错误推理也会被收为目标)。改进方向:结合执行反馈(把符号 CoT 当程序运行验证,作者在 Appendix D 已提出此方向)或训练过程奖励模型对中间步打分。其三,双读法失配未闭合:解码读法始终高于直接读法约 3.5 个点,意味着约 3.5 个点的正确思维被读出器浪费;可以训练一个轻量“思维投影头”把生成的 $\hat{z}$ 精确拉回 VAE 流形后再读出。其四,固定 8×512 宽度对难度不敏感:简单题与难题花同样的去噪计算,而 Appendix A.4 显示弹性/嵌套设计在短 CoT 数据上无增益;应在 CoT 长度差异大的数据集上重试,并把宽度作为推理时的思考预算。其五,基线公平性:FLaRe 用了额外数据(Diverse CoT 21.6 万条由 Qwen2.5-32B 生成)和两阶段训练,而多数基线只做 LoRA SFT;虽然作者证明 stage 1 在与 LaDiR 完全相同的数据上仍领先 10.7-21 个点,但与 CODI/KaVa 的对比中数据增量未被剥离。改进方向:给最强基线同样喂 Diverse CoT 数据做对照。
未来方向
作者明确提出的方向:(1) 符号化转换器可改为用执行反馈训练——把符号 CoT 写成可执行程序,以运行结果为准自动筛选训练信号;(2) 符号结构甚至可以不靠外部转换器,而是直接从任务反馈中在隐空间内诱导出来;(3) 可变宽度思维——嵌套(Matryoshka 式因果槽位注意力)与弹性(每宽度独立编码)两种设计已验证可训练可生成,在 CoT 长度差异更大的数据上,宽度将成为推理时可选的思考预算;(4) 干扰数字鲁棒性:针对 SVAMP 式失败,扩充含干扰实体的训练分布。基于本文成果可延伸的方向:(5) 把五需求探针社区化,作为潜在推理新方法的标准评测套件(孪生生成、pass@k、按序读值等均可自动化);(6) 把阶段 2 的穿 rollout 反向传播与强化学习结合——目前答案损失只对验证通过的思维做最大似然,可换成 GRPO 式组相对优势以利用失败样本;(7) 扩展到代码生成与定理证明等有执行验证器的领域,那里符号化与验证天然存在;(8) 探索隐思维的组合性——本文思维是单块 8 槽,若引入槽位间的层次结构或跨题共享的“思维原语”,可能提升迁移性;(9) 规模化研究:3B 上对 KaVa 优势消失,值得检验是数据规模、VAE 容量还是流模型容量瓶颈。
复现评估
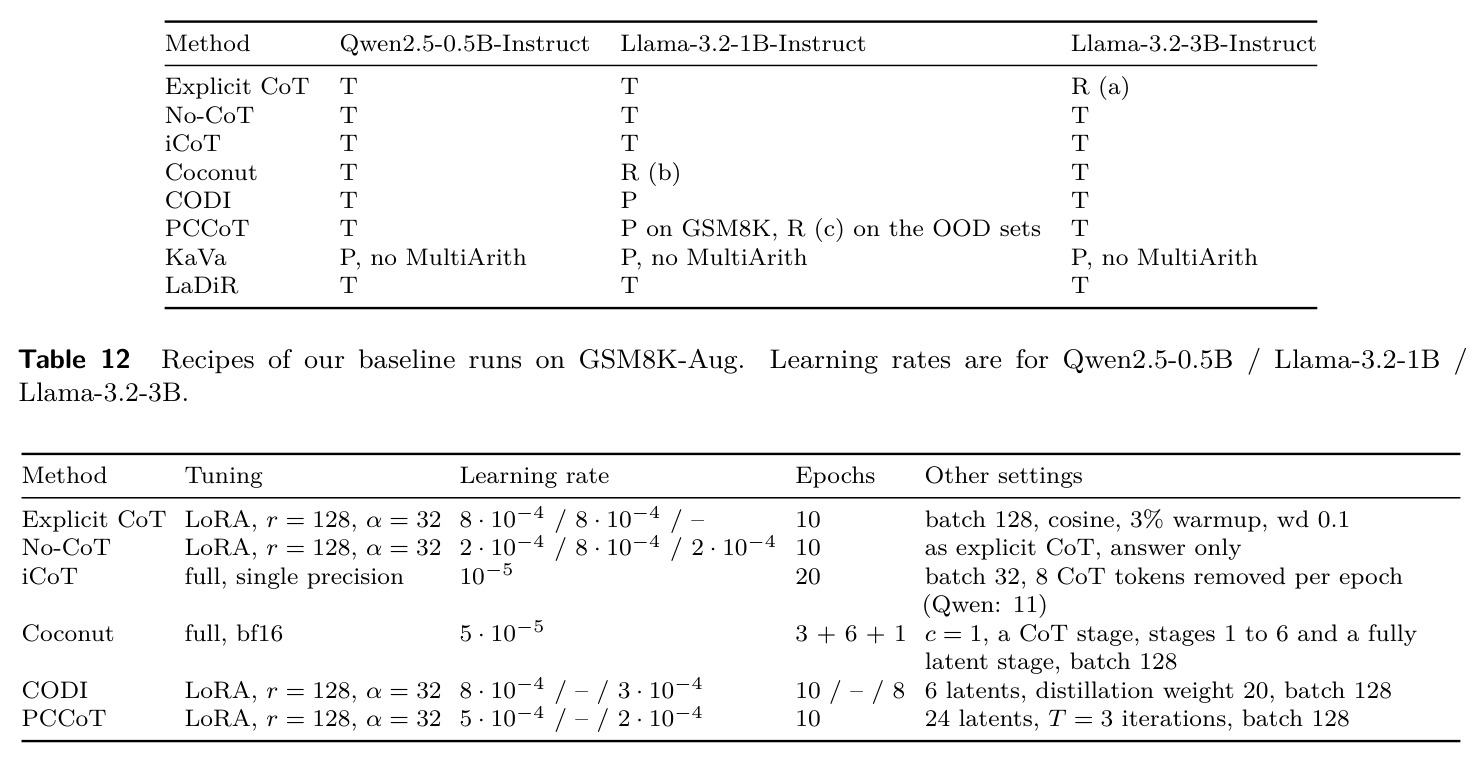
复现条件总体较好但有门槛。有利因素:(1) 论文给出空前详尽的实现细节——Appendix A 的 Table 10 列出 VAE 与两阶段流的全部超参(学习率、EMA 衰减 0.9999、时间分布 $\mathcal{N}(-2,0.8^2)$、腐蚀概率、CFG 概率 0.1、引导 $w=4$ 等),Appendix B 给出阶段 1、阶段 2 与推理的三个伪代码算法,几乎无歧义;(2) 全部数据公开:GSM8K-Aug(whynlp/gsm8k-aug)及对齐的 GSM8K-Aug-NL、OpenMathInstruct-2、基线用公开 checkpoint(CODI、PCCoT、Coconut 复现版)均有出处(Table 11 列明每个基线数字来源 P/T/R);(3) 基线评测协议可对齐:作者验证其评测与原论文打印值一致(CODI 55.6 vs 55.6,PCCoT 54.1 vs 53.35)。成本与难度:(4) 算力需求不低——VAE 训练 10 epochs(1B 编码器 lr 1e-4、3B 解码器 2e-5),阶段 1 流模型 6 万次更新、batch 256、16 卡 FSDP bf16、每行还含 CFG 双前向与 4 次 $(t,\epsilon)$ 采样,估算为数百 GPU 时级;阶段 2 另需约 6 小时 × 16 张 H100;推理很轻(2 步仅 68ms/题,单张 RTX 3090 可跑);(5) 主要复现风险点在符号化转换管线(依赖 Qwen3.8-27B 级模型、多轮过滤与审核,最终 62.98 万对)和 Diverse CoT 生成(Qwen2.5-32B 每题 16 解 + 双语义裁判),这两处离线数据工程的随机性会导致结果小幅波动;(6) 论文未见代码或 checkpoint 发布链接(截至阅读版本 v1),复现需按附录从零搭建,工程量主要在数据管线而非模型本身。综合评估:对有小规模 GPU 集群(≥16 张 A100/H100 级)的团队,1-2 周可复现 1B 主结果;仅做推理与分析则门槛很低。
论文图表
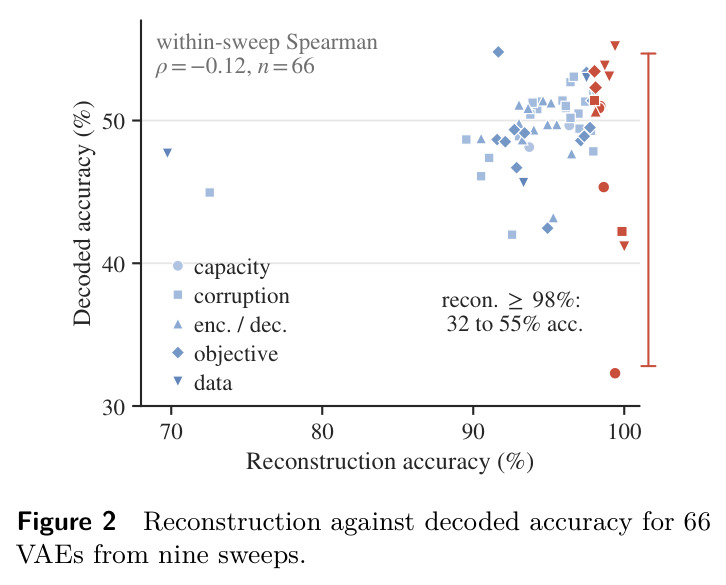
散点图:横轴为 66 个 VAE(来自容量、腐蚀、目标函数、编码器、解码器、数据九组扫描)在留出 CoT 上的精确重建率,纵轴为其代码训练出的流模型的解码准确率。两者相关性仅 ρ=−0.12,且重建最好的若干 VAE(≥98%)下游准确率反而只有 32-55%,标注点显示容量、腐蚀、目标、数据各维度都有反例。
这是全文最核心的实证洞察的直观证据:重建精度不等于可生成性,直接支撑“平滑性比精度重要”这一设计原则,解释了为何要主动腐蚀隐空间。
左图画出七种候选时间分布(均匀、三种 logit-normal、噪声侧与洁净侧偏置)的密度曲线;右图汇总 19 组实验、7 次扫描,横轴为训练信号的噪声权重 E[1−t],纵轴为相对各组默认设置的准确率,绿色高亮有效区域:只有强烈偏向噪声端(t 接近 0)的分布学得好,均匀分布最差。
证明“流必须在推理起点附近训练”这一关键选择,且揭示了所需偏移量随隐维度增大的规律,对迁移到其他隐维度设置有直接指导意义。