VepAgent:面向视频事件预测的因果过渡桥接与工具增强强化学习 VepAgent: Bridging Causal-Transition via Tool-Augmented Reinforcement Learning for Video Event Prediction
用因果过渡CoT数据加工具增强GRPO,让4B模型在视频事件预测上以小博大刷新SOTA。
前置知识
视频事件预测(Video Event Prediction, VEP)
VEP 要求模型只观察一段视频的部分内容(例如前 $T$ 秒),并结合查询 $Q$ 与候选未来事件集合 $O=\{o_k\}_{k=1}^K$,从候选中预测接下来最可能发生的事件 $y \in O$。它与普通的视频理解任务有本质区别:视频理解只需要对已观察内容做回溯式总结(retrospective summarization),而 VEP 需要向前推理,从观察到的终端状态推断出尚未发生的因果延续。
本文的全部问题设定、数据构造、奖励设计都围绕 VEP 展开。不理解“部分观察 + 预测未来”这一任务形式,就无法理解为什么模型会遇到因果逻辑鸿沟、语言先验捷径等问题,也无法理解后面工具库为什么要恢复“缺失的中间状态”。
多模态大语言模型(MLLM)与回溯式总结惯性
MLLM(如 Qwen-VL 系列)将视频帧编码为视觉 token 后交给语言模型做推理,擅长对观察到的内容生成连贯叙述。但论文指出,这种“重建历史事件链”的能力并不能自动外推出未来轨迹——模型习惯于描述已经发生的事,而不是推断“当前未完成的动作接下来会演变成什么”。
本文的三个核心问题(因果逻辑鸿沟、语言先验捷径、视觉证据遗漏)都是 MLLM 在 VEP 上的固有失败模式。理解了“回溯式总结 ≠ 前瞻式推理”这一对概念,才能理解为什么需要专门构造因果过渡型 CoT 数据来纠偏,而不是简单地把 VEP 数据丢给模型继续训。
GRPO(Group Relative Policy Optimization)
GRPO 是 DeepSeekMath/DeepSeek-R1 采用的策略优化算法。对每个查询 $q$,从旧策略 $\pi_{\theta_{old}}$ 采样一组 $G$ 条轨迹 $\{o_1,\dots,o_G\}$,用组内奖励归一化估计优势 $A_i = (r_i - \mathrm{mean}(\{r_j\})) / \mathrm{std}(\{r_j\})$,再做 PPO 风格的裁剪更新并加 KL 散度惩罚 $\beta D_{KL}(\pi_\theta \| \pi_{ref})$ 约束偏移。它省去了额外的价值网络。
VepAgent 的 RL 阶段完全建立在 GRPO 之上,其复合奖励 $R(\tau)=R_{format}\cdot(0.65R_{acc}+0.20R_{cau}+0.15R_{ant})$ 的每个分量都通过组内归一化变成优势信号。不熟悉 GRPO 就无法理解奖励设计如何转化为策略梯度,也难以复现其 250 步 RL、每样本 8 条 rollout 的训练配置。
思维链(CoT)与监督微调(SFT)冷启动
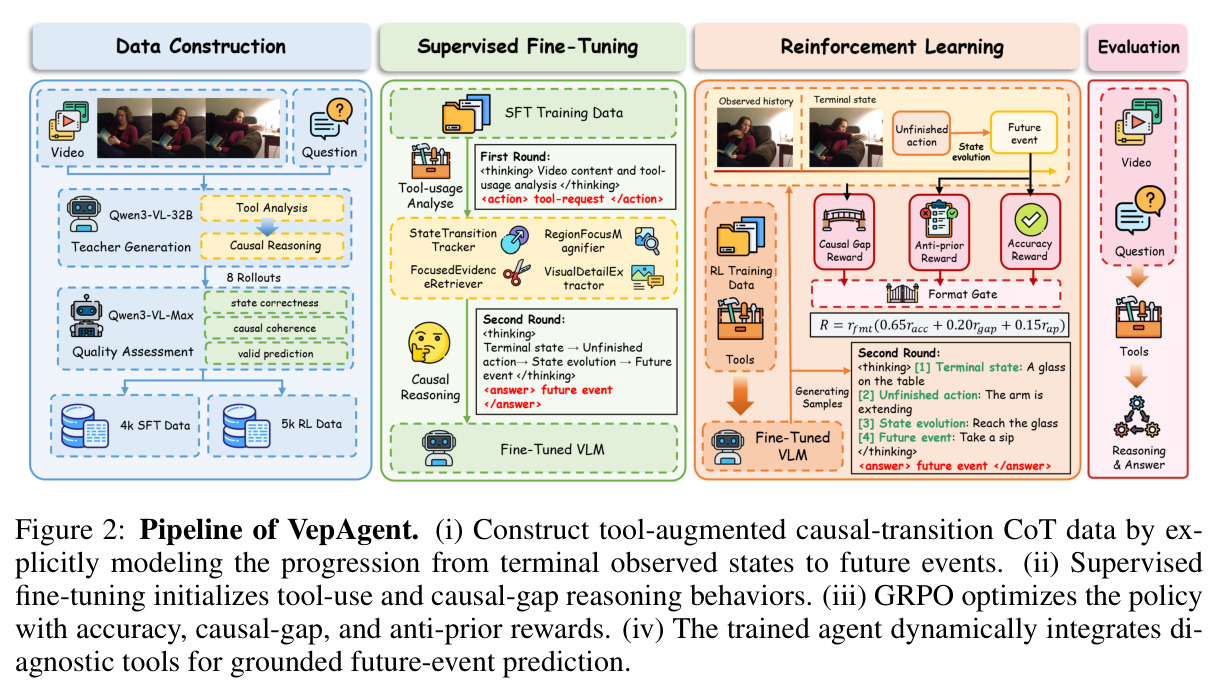
CoT 指在最终答案前显式生成中间推理步骤;SFT 用标准自回归负对数似然 $\mathcal{L}_{SFT} = -\mathbb{E}_{W\sim\mathcal{D}}\left[\sum_{t=1}^{L}\log p_\theta(\tilde{z}_t \mid X, Y, \tilde{z}_{<t})\right]$ 在高质量推理链上训练模型。本文用 Qwen3-VL-32B 做 8 次独立 rollout 生成推理路径,再用 Qwen-VL-Max 做专家校验,筛出约 4000 条链构成 futurebench-4K。
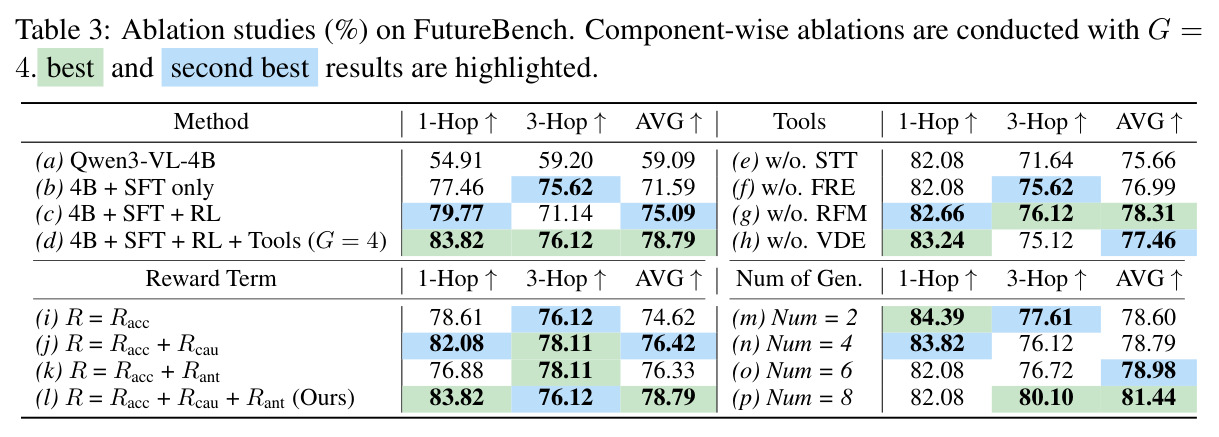
论文的关键经验发现是:直接 RL 会让工具调用频率在 rollout 中持续衰减(工具输出的分布与预训练数据存在分布差异),因此必须先用结构化 CoT 数据做 SFT 冷启动,教会模型“何时用工具、如何桥接因果”,RL 才能有效优化。理解 SFT 在两阶段训练中的定位是读懂消融实验(59.09% → 71.59% → 75.09% → 78.79%)的前提。
语言先验捷径(Language-Prior Shortcut)
指多模态模型不真正看视频,而是利用问题与选项之间的表层文本相似度作答——选与查询文本共现频率最高、词汇最像的选项。这在标注数据中往往是统计有效的捷径,但在视觉状态与文本先验冲突时会给出错误答案。检测方法是对查询与各选项计算句向量余弦相似度并排名,看模型是否总选文本上最“像”的那一个。
本文的反先验奖励 $R_{ant}$ 正是该捷径的直接对抗机制:预测正确时按正确选项的文本相似度排名 $k$ 给分 $R_{ant}=(k-1)/(K-1)$,正确选项越难靠文字猜中、奖励越高。这是全文最具辨识度的创新点之一,理解捷径的成因才能理解这个奖励项为什么能逼迫模型转向视觉证据。
工具增强智能体(Tool-Augmented Agentic System)
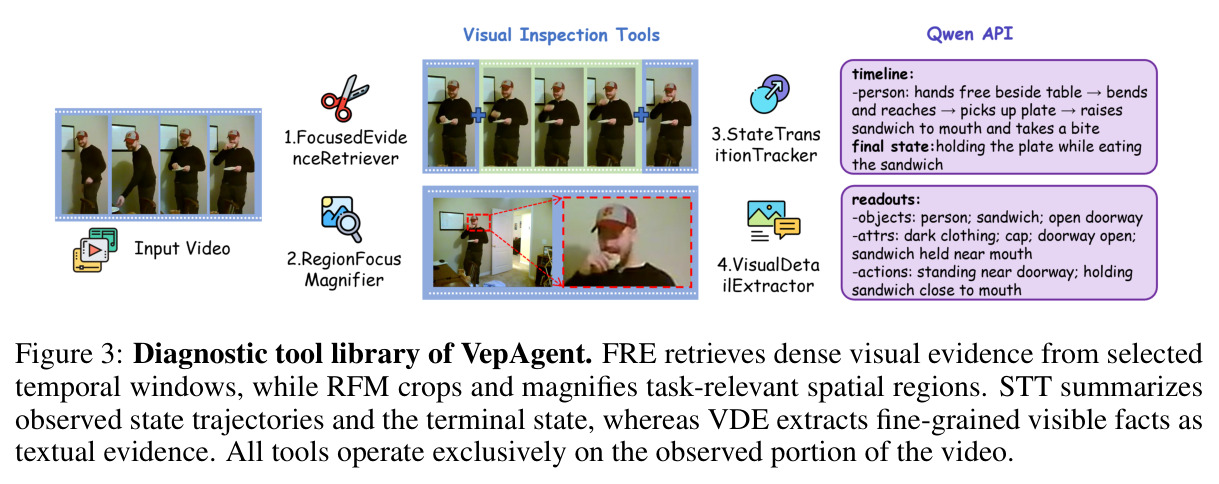
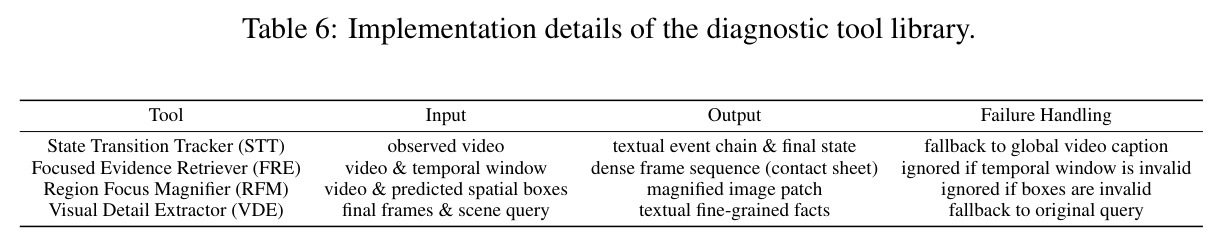
指模型在推理过程中主动调用外部工具获取、变换或验证证据,而非仅依赖一次性输入的视觉表征。典型范式如 LLaVA-Plus(学习调用工具)、TACO(推理与工具调用交织训练)、PyVision(动态生成视觉处理程序)。本文的特色是“诊断式”工具库:四个工具分别对应时序状态追踪、密集帧检索、区域放大、细粒度事实提取,且全部只作用于已观察部分。
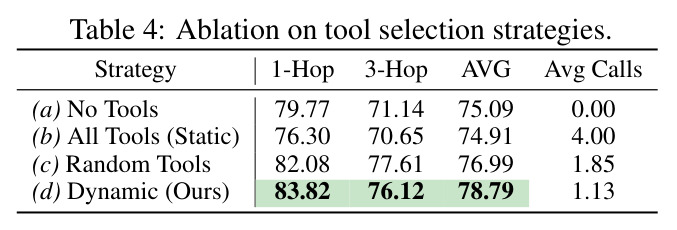
VepAgent 把 VEP 重新表述为“观察 → 按需取证据 → 因果桥接 → 预测”的智能体流程,政策网络 $\pi_\theta$ 只做一次工具选择 $C \subseteq \mathcal{T}$。消融显示动态选择(平均 1.13 次调用,78.79% AVG)优于静态全调用(4 次调用反而掉到 74.91%),理解工具增强范式才能把握这一设计的取舍逻辑。
研究动机
视频事件预测(VEP)要求模型根据部分观察的视频预测接下来最可能发生的事件,是主动机器人、自动驾驶、智能监控等前瞻性应用的基础能力。现有 MLLM 在这个任务上暴露出三个结构性缺陷。其一是因果逻辑鸿沟(Causal-Logic Gap):MLLM 擅长重建历史事件链,但这种回溯式总结不等于外推能力——从终端观察帧到未来事件之间存在未被观察到的中间状态转移,需要结构化的因果桥接,而不是靠历史依赖直接投影结果。其二是语言先验捷径(Language-Prior Shortcut):模型经常不忠实于视频内容,而是选择与查询文本相似度最高的选项,表层词汇共现模式压倒了真实视觉状态。其三是视觉证据遗漏(Visual-Evidence Omission):真实视频常因遮挡、快速运动或均匀帧采样而丢失关键的时空线索(例如杯子放下的瞬间恰好落在采样帧之间),没有动态恢复缺失瞬态动作或细粒度空间细节的机制,模型在模糊场景只能给出有偏估计。论文图 1 用一个涂黄油的例子直观展示了这些失败:普通 VLM 只预测观察动作的粗糙延续,选项驱动推理被文本先验带偏,因果鸿沟推理虽然捕捉到正在涂黄油的过程却因看不清“还有一片没涂”而选错续接。
本文的目标是本文的目标是把 VEP 从“被动猜测未来”重构为“主动的因果分析 + 视觉验证 + 时间定位”过程,并让一个 4B 的小模型在这个任务上超越 30B-72B 级别的大模型。具体拆成三个协同能力:第一,因果过渡推理(Causal-Transition Reasoning),显式建模从终端观察状态 $S_{final}$、经过正在进行的未完成动作 $A_{ongoing}$、到未来事件的逻辑轨迹,构造物理上合理的预测而非历史摘要的投影;第二,反先验强化(Anti-Prior Reinforcement),惩罚利用查询与选项间表层文本相似性的推理捷径,迫使预测建立在真实视频状态之上;第三,工具增强感知(Tool-Augmented Perception),动态集成多模态工具库来恢复遗漏的视觉证据、放大细粒度时空细节,把静态观察者变成能捕捉 fleeting 状态转移的主动感知者。量化目标是在 FutureBench 和 NEPBench 两个公开基准、相同 32 帧预算与评估协议下取得 SOTA。
与已有工作不同的是,本文的独特切入角度有三层。第一层是任务级重新表述:以往 VEP 工作(VidEvent、EventFormer、Video-CoE 等)主要在改进“已观察时序历史”的表示与组织,而 VepAgent 聚焦于从终端观察状态和未完成动作到未来事件的那个“未被观察的因果过渡”本身,提出用结构化 CoT 数据显式教模型“什么是终端状态、什么动作还没完成、因果鸿沟如何桥接”。第二层是奖励设计的对症下药:现有 RL 后训练方法普遍受语言先验捷径困扰,本文第一个为 VEP 设计了显式的反先验奖励项——用句向量相似度对正确选项的“文本可猜性”排名打分,文本越难猜中奖励越高,把“别靠语感、去看视频”直接写进了优化目标。第三层是工具语义的任务特化:VITAL、Video-STAR 等工具增强 RL 框架面向通用视觉推理或长视频理解,而 VepAgent 的四个诊断工具(状态追踪、帧检索、区域放大、细节提取)每一个都精准对应 VEP 的一种失败模式(时序歧义、瞬态动作丢失、局部细节模糊、细粒度事实忽略),且设计为单轮选择、只读已观察部分,保证不泄漏未来信息。
核心方法
先说直觉:VepAgent 想让模型像侦探一样断案——先明确“案发现场的最终状态是什么、哪个动作还没做完”,证据不清就主动去取证(回看密集帧、放大局部区域、提取细粒度视觉事实),最后基于扎实的证据推演“接下来物理上最可能发生什么”,而不是凭语感选一个与问题最像的答案。技术路线分四步(对应图 2 的 pipeline)。第一步,数据构造:用 Qwen3-VL-32B 在 VEP 训练集上做 8 次独立 rollout,只有至少一次命中的实例才算可解,再由 Qwen-VL-Max 专家校验剔除事实错误、逻辑不一致或语言捷径的链条,产出约 4000 条结构化因果过渡 CoT(futurebench-4K)用于 SFT,剩余验证过的轨迹约 5000 条留给 RL。第二步,SFT 冷启动:以 Qwen3-VL-4B-Instruct 为骨干,用标准自回归负对数似然联合优化推理 token 与最终答案,1 个 epoch、有效批大小 16、学习率 $5\times10^{-6}$。第三步,GRPO 强化学习:250 步、每样本 8 条 rollout、学习率 $1\times10^{-6}$、KL 系数 $\beta=0.04$、裁剪比例 $\epsilon_{low}=0.2$、$\epsilon_{high}=0.3$,用复合奖励(准确率 + 因果鸿沟 + 反先验,格式奖励作硬门控)优化策略。第四步,推理时智能体工作流:先做初始观察估计并单轮选择工具子集,工具执行一次后把返回证据融入上下文再给出最终预测 $p(y \mid V\oplus V_{aug}, Q\oplus E_{aug})=\pi_\theta(V\oplus V_{aug}, Q\oplus E_{aug})$。
核心创新有三点,本质上都在对抗“懒惰推理”。第一,因果过渡的结构化显式建模:已有方法从历史依赖被动投影未来,VepAgent 把推理强制结构化为“识别终端观察状态 $S_{final}$ → 识别未完成动作 $A_{ongoing}$ → 条件性调用诊断工具补证 → 桥接因果鸿沟 → 推演下一个物理合理状态”。这是数据层面的创新——futurebench-4K 的每条链都按这个三步生成管道构造,让模型在 SFT 阶段就学会“从没做完的事出发向前推”而非“复述看到的事”。第二,反先验奖励的形式化:对每个查询和 $K$ 个候选,用句嵌入余弦相似度计算正确选项的文本相似度排名 $k$,当预测正确时给 $R_{ant}=(k-1)/(K-1)$、否则为 0——这个连续设计让“靠文本相似性就能猜中”的题目奖励趋近 0,而“必须看视频才能答对”的题目奖励趋近 1,从优化目标层面根除语言捷径。第三,任务特化的诊断工具库:STT(把观察事件链与最终状态结构化为文本)、FRE(在指定时间窗内密集抽帧拼成 contact sheet)、RFM(裁剪放大人-物交互区域)、VDE(把末帧细粒度可见事实转成文本,只陈述事实不预测未来),四者分别对症时序歧义、瞬态动作丢失、局部模糊、细节忽略四种 VEP 特有失败模式,并与奖励中的因果鸿沟项形成“取什么证、怎么用证”的闭环。
方法步骤详情
完整流程如下。步骤一(问题形式化与第一阶段工作流):输入为部分观察视频 $V$、查询 $Q$、候选集 $O=\{o_k\}_{k=1}^K$。模型先形成终端观察状态 $S_{final}$ 与进行中动作 $A_{ongoing}$ 的初始估计,并构建未来轨迹的因果假设;对关键状态转移模糊、遮挡或被均匀采样错过的实例,策略网络 $\pi_\theta$ 执行单轮工具选择,从诊断工具库 $\mathcal{T}=\{T_s, T_f, T_r, T_v\}$ 中选出子集 $C\subseteq\mathcal{T}$。步骤二(第二阶段工作流):选中的工具各执行一次,输出融入推理上下文——$T_s$ 澄清动作序列、$T_f$ 恢复瞬态动作、$T_r/T_v$ 解决细粒度歧义(如手-物接触),随后按公式 (1) 条件化推断最终预测 $y$。所有工具只读已观察部分、绝不接触未来帧。步骤三(数据构造):三步因果过渡管道——先识别 $S_{final}$ 与 $A_{ongoing}$,再条件性引入 STT 或 FRE 等工具恢复时序证据,最后桥接因果鸿沟推导未来事件;8 次 rollout 至少一次命中 GT 才保留,Qwen-VL-Max 校验后得约 4000 条 SFT 链(futurebench-4K)和约 5000 条 RL 轨迹,全部只来自训练划分以防泄漏。步骤四(SFT):训练实例形式化为 $W=(X,Y,Z,O)$,推理过程与答案拼接为 $\tilde{Z}=[Z;O]$,按公式 (2) 的负对数似然联合优化。步骤五(GRPO):按公式 (3)-(5) 做组内相对优势更新;奖励按公式 (7) 复合 $R(\tau)=R_{format}\cdot(0.65R_{acc}+0.20R_{cau}+0.15R_{ant})$。其中 $R_{format}$ 要求含有效 thinking/answer 标签否则整条奖励清零;$R_{cau}$ 用 MiniLM 余弦相似度衡量生成终端状态与参考的 $\mathrm{sim}(s_1,r_1)$(权重 0.45)、因果过渡与参考的 $\mathrm{sim}(s_{34},r_4)$(权重 0.55),合成 $g_{raw}$ 后按公式 (9) 条件化于预测正确性:正确时 $\min(1, 0.20+0.80g_{raw})$,错误时封顶 $\min(0.35, 0.20g_{raw})$,防止错误预测蹭到过程分;$R_{ant}$ 按公式 (6) 依正确选项的文本相似度排名给分。
技术新颖性
从技术新颖性看,本文的贡献不是发明新算法,而是把三股已有技术(CoT 蒸馏、GRPO、工具调用)针对 VEP 的失败模式做了一次高完成度的对症组合,其中有几个真正新的设计。其一,反先验奖励 $R_{ant}$ 是新的:以往工作只是观察到语言捷径现象(如引用的 video reasoning 模型视觉利用率不足的研究),本文第一次把“正确选项的文本可猜性排名”直接转化为连续奖励信号,与准确率奖励耦合后形成了明确的对抗压力——猜难题要多得 0.15 权重的分,就必须真的去看视觉状态。其二,因果鸿沟奖励 $R_{cau}$ 是过程奖励而非结果奖励:它对推理链中的终端状态描述块和过渡推导块分别与参考链做加权相似度(0.45/0.55),再以预测正确性为门控(错误预测的过程分封顶 0.35),这种“结果主导、过程加成、错误封顶”的三段式设计在 VEP 场景下是精细的。其三,与 VITAL、Video-STAR、IndusAgent 等同门工具增强 RL 工作相比,VepAgent 的差异在于工具语义全部由 VEP 的失败模式反向定义,且消融(表 4)证明了“单轮动态选择”的必要性:静态调用全部 4 个工具反而比不用工具更差(74.91% vs 75.09%),说明证据注入是把双刃剑,模型必须学会何时取证——这正是 RL 学到的“when and why”而不仅是“how”。其四,两阶段训练的必要性有实证:作者先尝试 R1-Zero 式直接 RL,发现工具调用频率在 rollout 中持续衰减(工具增强视觉特征与预训练分布存在差异),这个负面结果支撑了 SFT 冷启动的设计。
实验结果
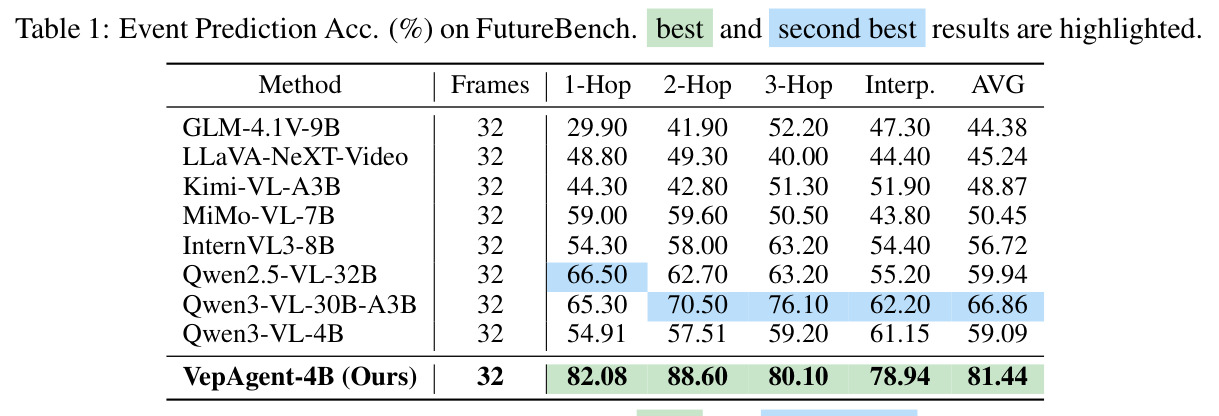
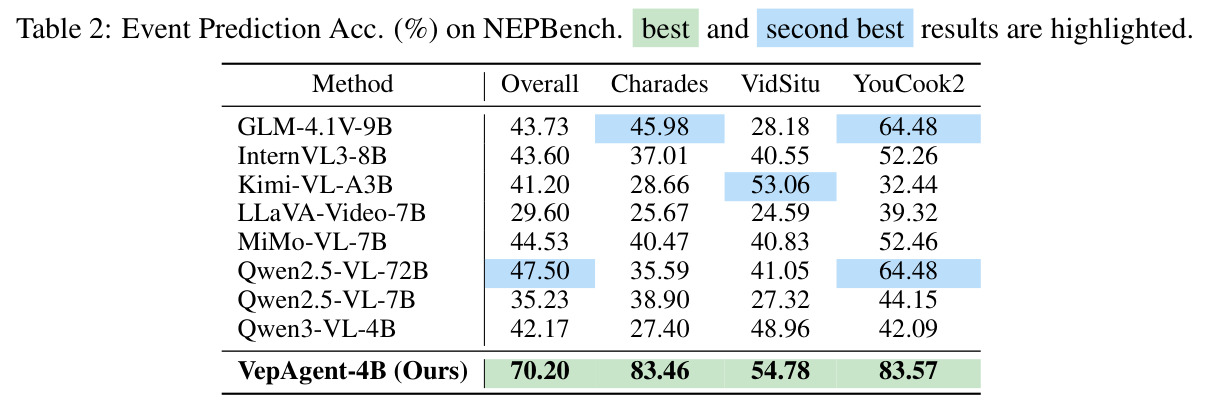
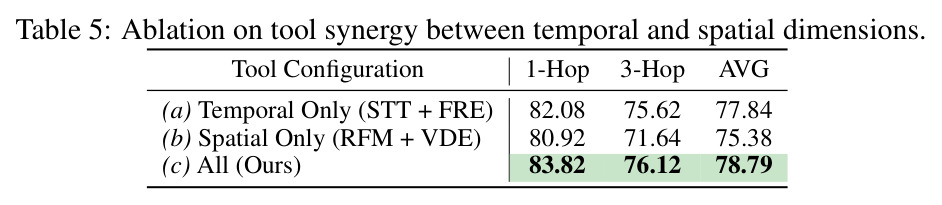
核心结果有两个基准的主实验和五组消融。主实验方面:在 FutureBench(表 1,32 帧预算),VepAgent-4B 取得 AVG 81.44%(1-Hop 82.08%、2-Hop 88.60%、3-Hop 80.10%、Interp. 78.94%),比之前最强的报告基线 Qwen3-VL-30B-A3B(66.86%)高 14.58 个百分点,比同尺寸骨干 Qwen3-VL-4B(59.09%)高 22.35 个百分点——一个 4B 模型全面碾压 30B 模型,且四个子项全部领先。在 NEPBench(表 2),VepAgent-4B Overall 达 70.20%,比最强基线 Qwen2.5-VL-72B(47.50%)高 22.70 个百分点,比同尺寸骨干(42.17%)高 28.03 个百分点;三个子集全部第一:Charades 83.46%(第二名 GLM-4.1V-9B 仅 45.98%)、VidSitu 54.78%(第二名 Kimi-VL-A3B 53.06%)、YouCook2 83.57%(第二名 64.48%)。消融方面(表 3,G=4 设置下全模型 78.79%):训练阶段递进显示 zero-shot 59.09% → 仅 SFT 71.59% → SFT+RL 75.09% → 加工具 78.79%,证明两阶段策略缺一不可;工具消融中去掉 STT 掉得最多(-3.13pp 至 75.66%),说明状态追踪是最关键的工具,其次是 FRE(-1.80pp)、VDE(-1.33pp)、RFM(-0.48pp);奖励消融中仅用准确率奖励只有 74.62%,加因果奖励到 76.42%,加反先验奖励到 76.33%,三者合一到 78.79%,证明两个新奖励项各自有效且互补;GRPO 生成数从 2 增到 8,AVG 从 78.60% 升至 81.44%,最终模型采用 Num=8。附录消融进一步显示:动态工具选择(78.79%,平均 1.13 次调用)优于随机选择(76.99%,1.85 次)和静态全调用(74.91%,4 次),时空工具协同(78.79%)优于仅时间工具(77.84%)和仅空间工具(75.38%)。定性案例(图 4-6)展示了一致的模式:基线倾向于复述已发生的事件(重复加肉、重复压叉子、重复加洋葱),VepAgent 通过工具确认“该动作已经完成、烹饪仍在进行”,从而向前推理出下一阶段。
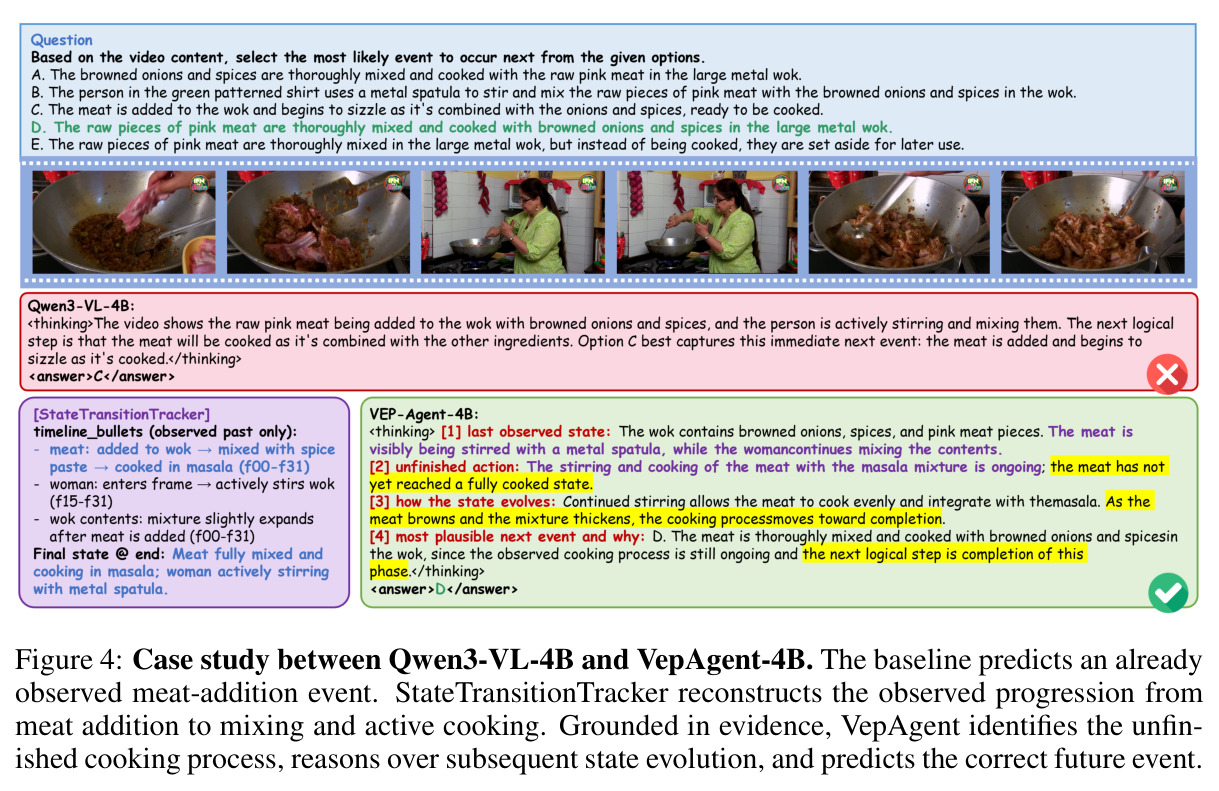
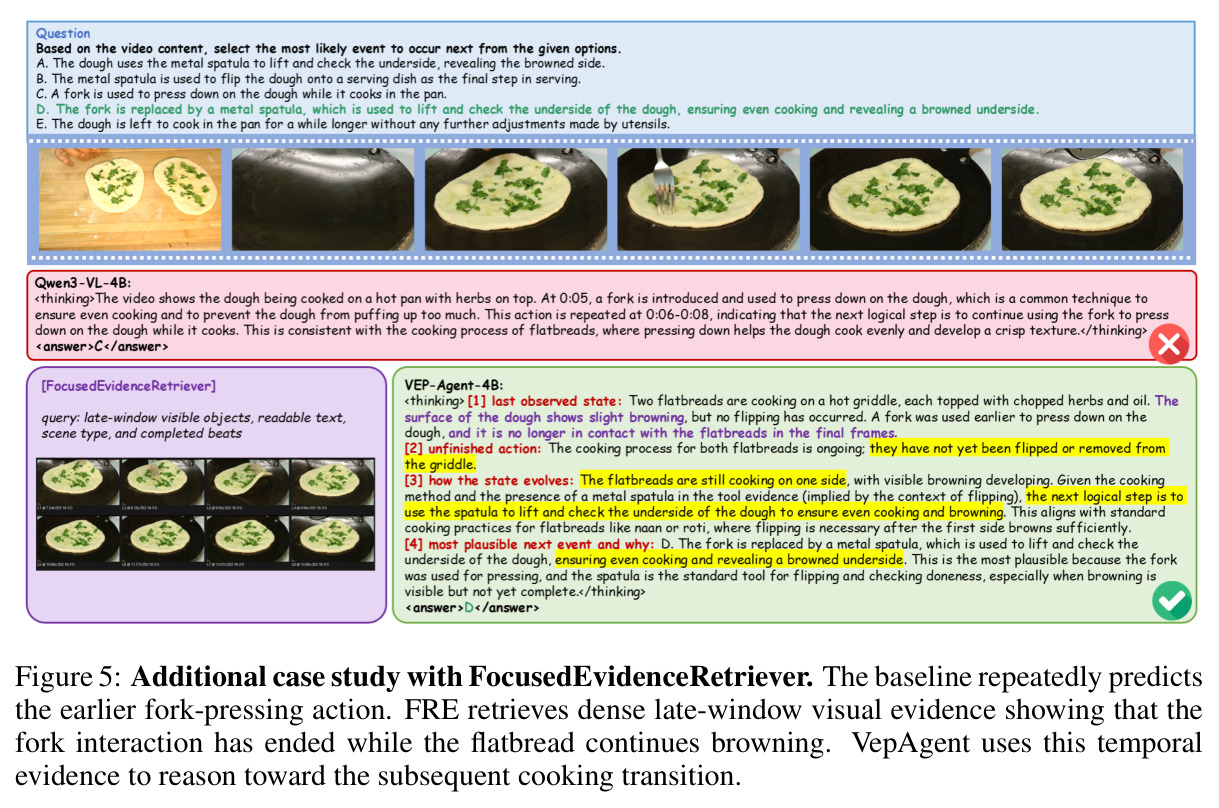
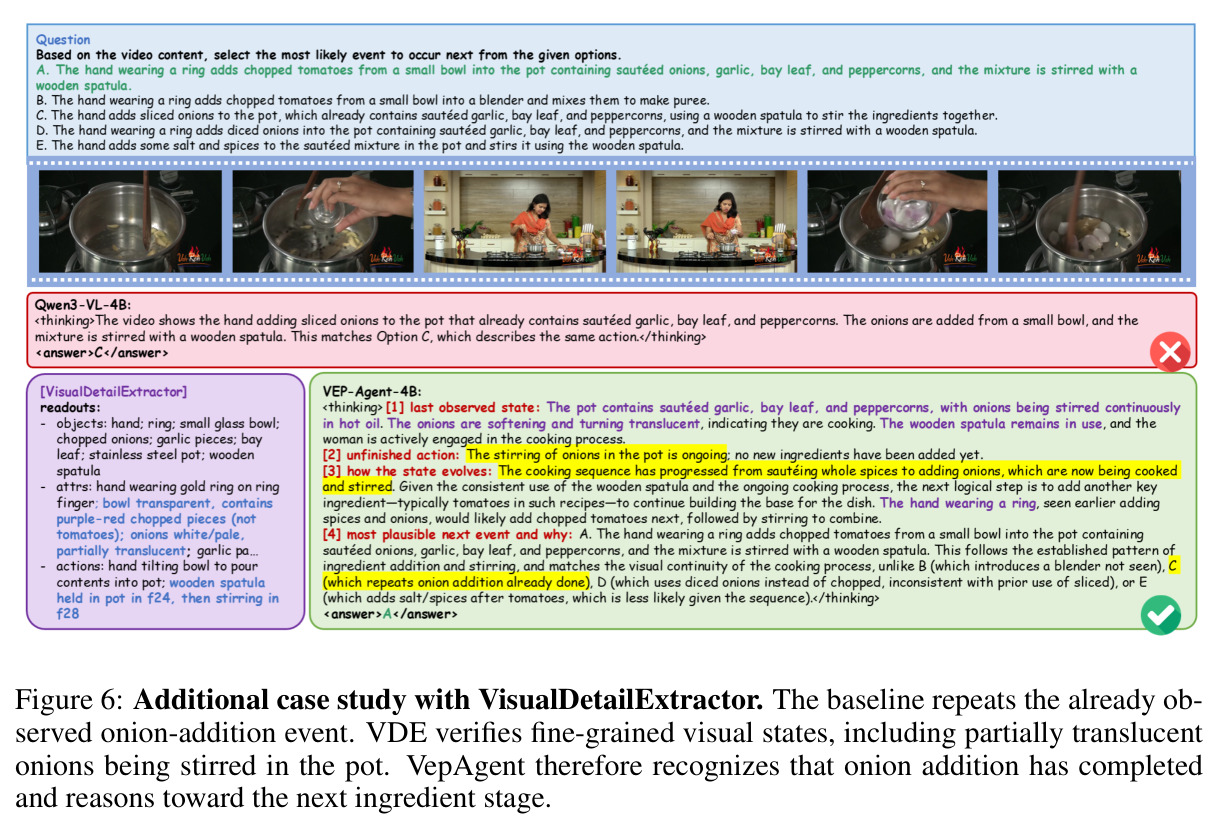
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| FutureBench 视频事件预测(整体 AVG) | 预测准确率 (%) | 81.44(1-Hop 82.08 / 2-Hop 88.60 / 3-Hop 80.10 / Interp. 78.94) | 66.86(Qwen3-VL-30B-A3B,先前最强报告基线) | +14.58 pp;相对同尺寸骨干 Qwen3-VL-4B(59.09)提升 +22.35 pp |
| NEPBench 下一事件预测(Overall) | 预测准确率 (%) | 70.20(Charades 83.46 / VidSitu 54.78 / YouCook2 83.57) | 47.50(Qwen2.5-VL-72B,先前最强报告基线) | +22.70 pp;相对同尺寸骨干 Qwen3-VL-4B(42.17)提升 +28.03 pp |
| 训练阶段消融(FutureBench AVG) | 准确率 (%) | 78.79(SFT + RL + Tools, G=4) | 59.09(Qwen3-VL-4B zero-shot)/ 71.59(仅 SFT)/ 75.09(SFT+RL) | SFT 贡献 +12.50 pp,RL 贡献 +3.50 pp,工具贡献 +3.70 pp |
| 奖励函数消融(FutureBench AVG) | 准确率 (%) | 78.79(完整 $R=R_{acc}+R_{cau}+R_{ant}$) | 74.62(仅 $R_{acc}$) | +4.17 pp;单独加 $R_{cau}$ 或 $R_{ant}$ 分别到 76.42 / 76.33 |
| 工具选择策略消融(FutureBench AVG) | 准确率 (%) / 平均工具调用次数 | 78.79 / 1.13 次(动态选择) | 75.09 / 0 次(无工具)、74.91 / 4 次(静态全调用)、76.99 / 1.85 次(随机) | 比无工具 +3.70 pp,比静态全调用 +3.88 pp 且调用次数只有 1/4 |
局限与改进
作者在结论中明确承认的局限:当前评估只覆盖 FutureBench 和 NEPBench 两个 VEP 基准,更广泛的视频理解场景(如长视频理解、时序定位、视频问答)尚未测试,工具库与因果过渡推理在这些设置下是否有效是未知数。我自己的观察还有更多。第一,推理开销与外部依赖:STT 和 VDE 通过 DashScope 托管的 VLM 实现,FRE/RFM 用 OpenCV/Pillow 实现,这意味着部署 VepAgent 需要额外的 VLM API 依赖,且每次工具调用都增加推理延迟——论文没有报告推理延迟和调用成本,动态选择的 1.13 次平均调用在生产环境中的代价不明。第二,任务形式狭窄:VEP 被完全表述为多选题(从 $K$ 个候选中选一个),反先验奖励依赖候选选项的文本相似度排名,这个设计无法直接迁移到开放式的未来事件生成任务。第三,评估口径问题:主实验是与“先前报告的基线”对比(Comparison with reported baselines),而非在完全相同的环境下复跑所有基线,不同模型的提示工程、帧采样策略差异可能影响公平性。第四,反先验奖励的度量本身依赖 MiniLM 句向量的质量,语义相似度排名是一个粗糙的代理,文本相似度高但视觉上确实合理的选项可能被误伤。第五,在 Num=8 的最终配置下 1-Hop(82.08%)反而低于 Num=2 的 84.39%,3-Hop 与 AVG 的提升伴随子项波动,说明组大小调优仍有空间。第六,训练数据由 AI 合成(Qwen3-VL-32B 生成、Qwen-VL-Max 校验),教师模型的偏见会传导给学生模型,且约 4000 条 SFT 数据的规模意味着能力上限可能受限于教师。
独立分析的弱点
独立分析,我认为有五个值得注意的弱点,每个都有对应的改进方向。弱点一:单轮工具选择的刚性——策略只做一次工具选择,工具执行后不再有第二次机会(论文明确写了 No additional tool-selection round),遇到 FRE 取回的密集帧仍然模糊的情况,模型无法追加调用 RFM 放大,只能硬猜。改进方向是引入多轮迭代取证并让 RL 学习何时停止(预算内探索与利用),类似 ReAct 的多步循环但带成本惩罚。弱点二:因果鸿沟奖励依赖参考推理链的语义相似度——$g_{raw}$ 用生成的终端状态/过渡描述与参考链的余弦相似度计算,而参考链本身来自 32B 教师模型,相似度奖励可能鼓励模型模仿教师的措辞风格而非真正学会因果推理(reward hacking 风险)。改进方向是引入基于状态的符号化验证(如视觉问答式的事实核查)替代纯文本相似度。弱点三:多选题格式带来的泛化天花板——$R_{ant}$ 的定义 $(k-1)/(K-1)$ 深度绑定候选集合结构,无法处理开放式 VEP(自由生成下一个事件描述)。改进方向是把反先验思想转化为对比学习目标或基于生成文本与视觉一致性打分的开放式奖励。弱点四:工具后端异构带来的工程与成本问题——STT/VDE 依赖外部商业 VLM API(DashScope),这既是部署障碍,也构成潜在的信息泄漏面(外部 VLM 的能力变化会改变系统行为)且复现依赖特定供应商。改进方向是蒸馏出轻量本地工具模型,或让骨干自身分身充当工具执行者。弱点五:缺少推理成本与效率的系统报告——论文没有给出工具调用带来的延迟倍数、token 开销,也没有与直接放大模型(如 7B/8B 不加工具)的算力公平对比,81.44% 的成绩有多少来自工具的额外计算并不透明。改进方向是在论文或开源仓库中补充 latency/FLOPs/成本曲线,展示精度-成本 Pareto 前沿。
未来方向
作者提出的方向:扩展诊断工具库(expanding the diagnostic tool library),并把因果过渡推理推广到更广泛的视频理解设置(broader video understanding settings)——包括当前未测试的长视频理解、开放式未来预测等。基于本文成果可以延伸的方向:其一,多轮主动感知循环——把单轮工具选择扩展为带预算约束的迭代取证(取证据 → 评估不确定性 → 决定是否继续取证),配合“不确定性触发”的课程让 RL 学会取证策略本身,而不是一次性决策。其二,开放式 VEP 的反先验泛化——将 $R_{ant}$ 的候选排名思想改造成生成式版本:对自由生成的未来事件,惩罚与查询文本高相似但与视觉状态无因果联系的输出,可以用视觉问答模型做事实核查器。其三,与世界知识结合——VEP 的“物理合理性”判断天然需要常识(黄油涂完会怎样、洋葱炒到半透明意味着什么),可以在奖励或工具层引入外部世界知识库/常识推理模型,弥补 4B 模型知识容量。其四,与具身任务衔接——论文相关工作里大量引用 VLA 与自动驾驶工作(AutoDrive-R2、CoC-VLA、Reasoning-VLA),VEP 的因果过渡推理正是 VLA 决策前的“预测会发生什么”模块,把 VepAgent 作为 VLA 的前瞻性推理前端是一个自然延伸。其五,测试时扩展(test-time scaling)——消融显示 GRPO 生成数从 2 到 8 带来 AVG 78.60% → 81.44% 的提升,暗示推理时多次采样 + 投票可能进一步提升,值得系统研究采样数、工具调用数与准确率的缩放规律。其六,跨域鲁棒性评估——NEPBench 的三个子集(Charades 家庭场景、VidSitu 电影场景、YouCook2 烹饪场景)已经很分散,但都是第三人称日常视频,第一人称(egocentric)视频和监控场景的迁移能力需要检验。
复现评估
复现条件总体友好但有几个坑。开源情况:代码在匿名仓库 https://anonymous.4open.science/r/VepAgent-42F82026 公开(匿名评审阶段,正式开源版可能随后发布),论文附录给出了完整的工具库实现细节(表 6:输入/输出/失败处理)、奖励实现的精确公式(公式 8-9 的权重 0.45/0.55、条件化封顶 0.35 等全部数值)和提示模板(附录 D),超参数交代得很细(KL 系数 0.04、裁剪 0.2/0.3、学习率、批大小、步数)。数据:futurebench-4K 与 RL 轨迹由 Qwen3-VL-32B 生成、Qwen-VL-Max 校验,训练数据仅取自 VEP 训练划分;复现者需要 DashScope API 访问权(Qwen-VL-Max 校验数据 + STT/VDE 工具后端),这是一笔 API 费用且国内以外用户可能受限。算力:8 张 NVIDIA RTX A5000(24GB)即可完成全部训练——SFT 1 epoch 加 RL 250 步,这对学界实验室是非常温和的需求,4B 骨干的显存占用在 24GB 卡上可承受。难度评估:中等偏易。难点主要在三处——GRPO + 工具调用的 rollout 管线工程(工具执行嵌入在策略采样循环里,需要处理无效时间窗/无效框的失败回退)、反先验奖励对 MiniLM 相似度排名的复现细节(不同句向量模型会导致 $R_{ant}$ 分布不同)、以及数据合成管线中“8 次 rollout 至少一次命中 + 专家校验”的过滤标准(论文未公布被拒比例和校验提示的完整判分规则)。基线对比方面,FutureBench 和 NEPBench 均为公开数据集,但论文是与报告数字对比,复现者想自证公平需要自己复跑基线。
论文图表
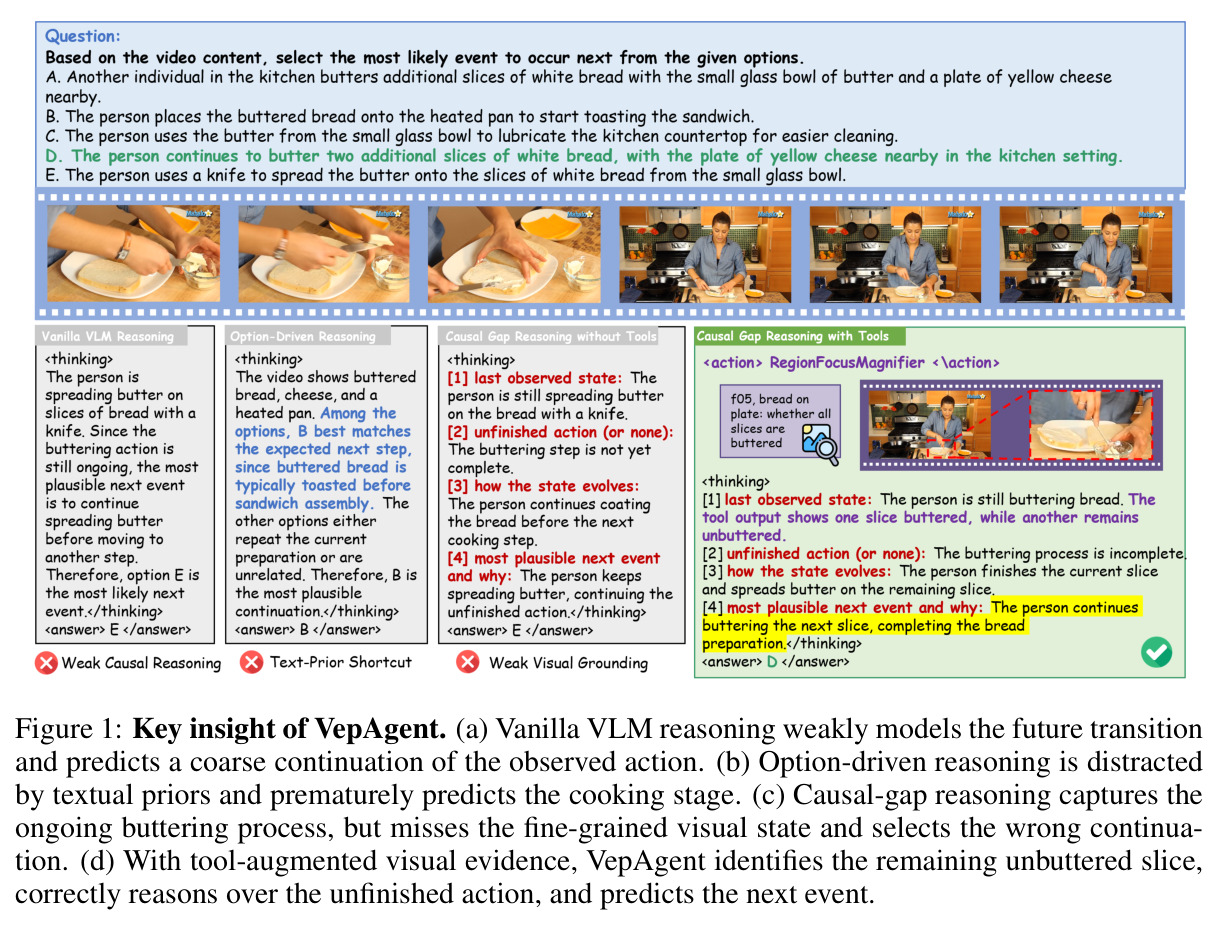
用同一涂黄油场景对比四种推理模式:(a) 普通 VLM 推理对未来过渡建模薄弱,只预测观察动作的粗糙延续;(b) 选项驱动推理被文本先验带偏,过早预测烹饪阶段;(c) 因果鸿沟推理捕捉到正在进行的涂黄油过程,但因看不清细粒度视觉状态而选错续接;(d) VepAgent 借助工具增强的视觉证据识别出尚未涂黄油的面包片,正确推理由未完成动作到下一事件。
这是全文的问题陈述图,四个子图精确对应了 MLLM 在 VEP 上的三种失败模式和本文的解法,是理解动机部分的最佳入口。