JLD:透过雅可比透镜的感知距离 JLD: Perceptual Distance Through A Jacobian Lens
从冻结视觉编码器的输出敏感度导出固定「雅可比透镜」,无标签感知距离全面超越 LPIPS/DISTS
前置知识
全参考图像质量评估(FR-IQA)与 SRCC
给定参考图与失真图,全参考指标逐对比较并输出一个差异分数;衡量其好坏通常把分数与人类主观分 MOS 做 Spearman 秩相关(SRCC)或 Kendall τ,或统计它与人类二选一偏好的一致率。SRCC=1 表示排序完全一致,0.9 以上即接近人类水平。
论文所有实验都以 SRCC 与 2AFC 一致率为准绳,Table 1、Fig. 4 等核心结果全部建立在这套评测语言上,不懂 SRCC 就无法读懂主表。
深度特征感知距离(LPIPS/DISTS/PieAPP/DreamSim)
把两图分别送入预训练网络(如 VGG),在多层提取特征并比较差异再加权求和。LPIPS 用人类二选一数据学一组线性权重,DISTS 拟合特征统计量的权重,DreamSim 干脆在人类三元组上微调编码器。它们效果好,但都「贴着」训练所用的评测集。
JLD 的动机与对标对象直接来自这一族方法:它们依赖人类标签、跨分辨率不稳定,本文与其逐项正面对比并全面超越。
自监督 ViT 与 patch token(DINOv2)
ViT 把图像切成 14×14 的 patch,每个 patch 经线性嵌入变成一个 token 向量,再依次通过含注意力的 block;DINOv2 用自蒸馏在无标签图像上预训练。其第一块 patch token 保留局部结构,最后的层归一化 CLS token 汇总全局语义。JLD 用第一块 token 度量局部变化、用 CLS token 定义「什么变化重要」。
整个方法建立在一个冻结的 DINOv2-S(ViT-S/14,12 块,每 token 384 维)之上,理解 patch token 的层级结构才能明白「早期特征 + 深层敏感度」的组合逻辑。
雅可比矩阵与回调度量(pullback metric)
$\mathbf{J}=\partial\mathbf{z}/\partial\mathbf{h}$ 描述早期特征的微小变化如何一阶地影响网络输出。把输出空间的欧氏度量经映射 $\mathbf{h}\mapsto\mathbf{z}$ 「拉回」特征空间,得到度量张量 $\mathbf{J}^\top\mathbf{J}$;再对像素求一次导,得到像素空间的 $\mathbf{G}(x)=\frac{1}{N}\sum_t \mathbf{A}_t^\top\mathbf{U}_k\mathbf{U}_k^\top\mathbf{A}_t$,其特征方向决定图像局部「哪里硬、哪里软」。
JLD 的名字、度量的合法性证明(伪度量、三角不等式)以及全部几何分析(等距椭圆、敏感度图、掩蔽效应)都由这一个概念支撑。
视觉掩蔽与色度对比敏感度
人眼在高纹理区域对微弱图案不敏感(掩蔽效应),且对颜色的空间分辨率远低于亮度——色度通道的对比敏感度随空间频率衰减更快(Mullen 1985)。传统指标用除法归一化或 S-CIELAB 式滤波显式建模这两点。
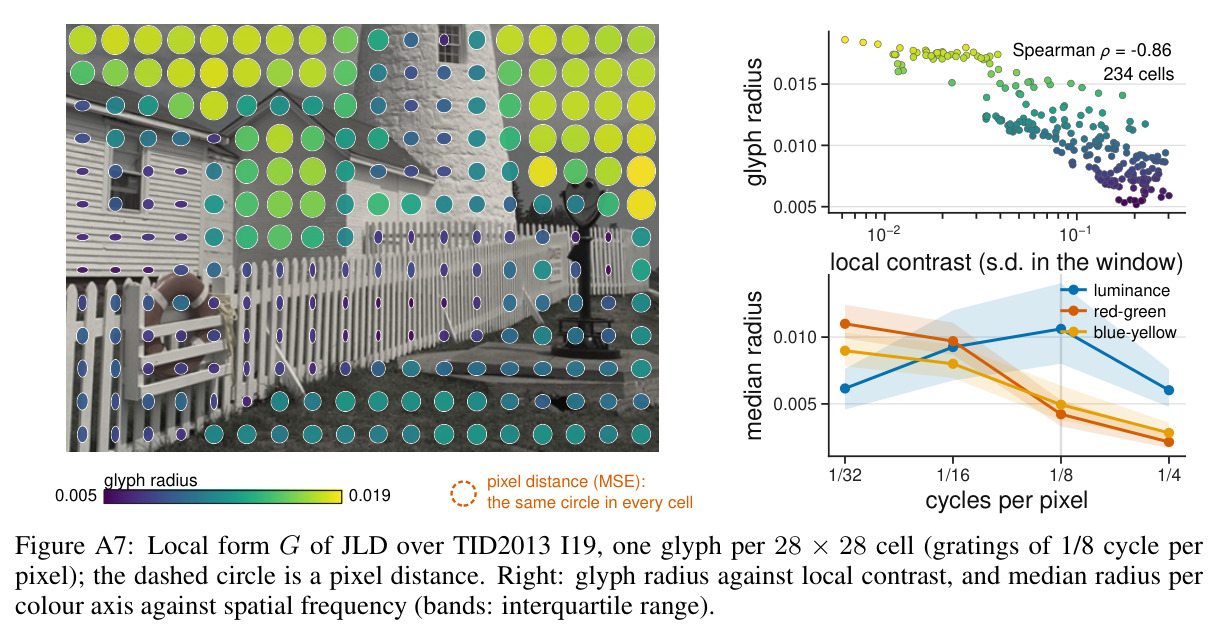
JLD 的色度预滤波($\sigma=2$ 像素高斯模糊 Cb/Cr、保留亮度 Y)与掩蔽分析(局部对比度 SRCC −0.86)都在检验其几何是否自然复现这两种人类视觉特性。
研究动机
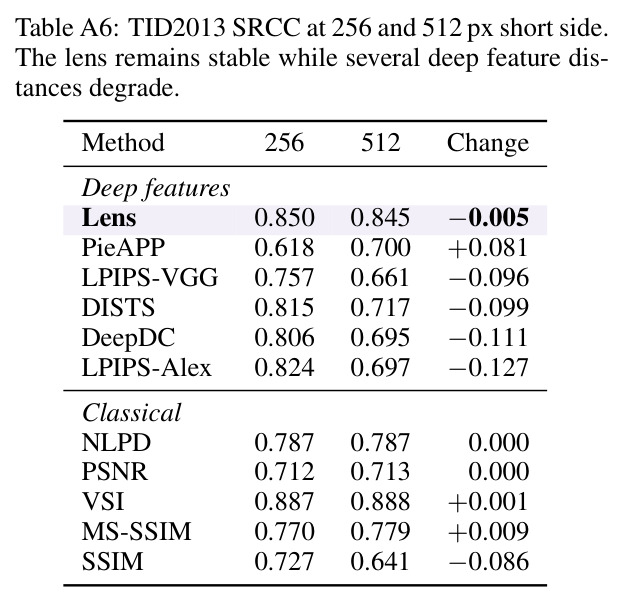
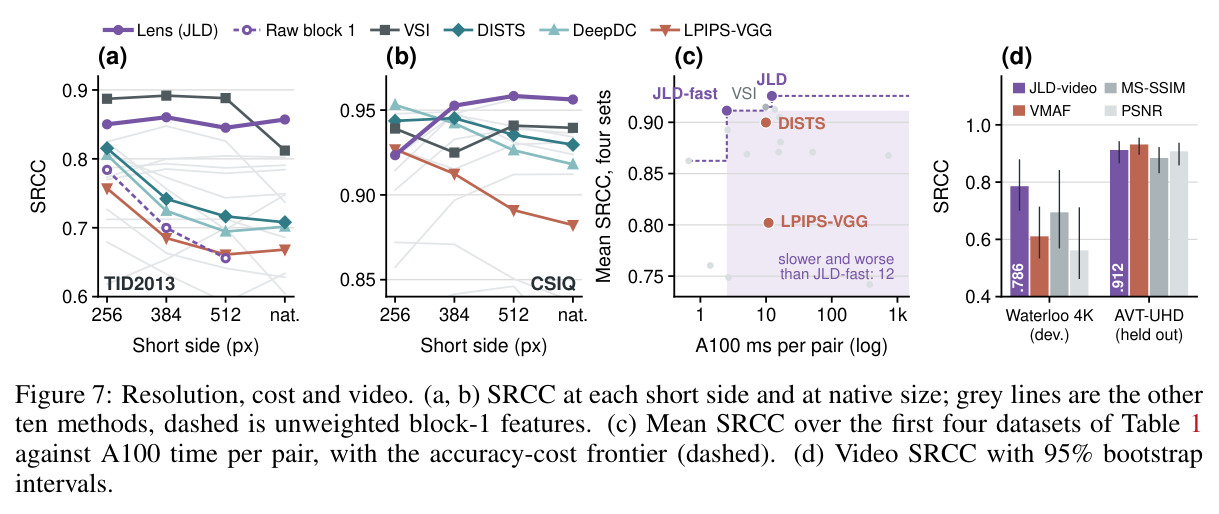
衡量两张图像「看起来」差多少是图像压缩、修复与生成的基础问题,但现有度量在两个方向上都有硬伤。像素误差(PSNR/MSE)对每个像素变化一视同仁:TID2013 中有五种失真(色彩噪声、高斯噪声、JPEG、局部块、稀疏采样)的 PSNR 几乎相同(26.8–27.2 dB),人眼评分 MOS 却从 5.58 一路跌到 2.64;在全部等 PSNR 的图像对上,PSNR 只有 51.1% 的概率选中人类偏好的那张,接近抛硬币。另一类以 LPIPS、DISTS、PieAPP、DreamSim 为代表的深度特征距离虽更准,却都要在人类评分上拟合权重,导致泛化性差:把 TID2013 从 256 像素重采样到 512 像素后,DISTS 与人类评分的 SRCC 从 0.815 跌到 0.717,LPIPS-VGG 从 0.757 跌到 0.661。而无需标签的几何化方法(如 IEM)原理优雅但代价难以接受:256×256 下每对图像需 725.7 ms,而本文 JLD 在 512×384 下只需 12.2 ms。
本文的目标是作者想回答一个看似简单的问题:一个只「学会看」、从未接触过人类评分的网络,自身是否已携带一把可用的感知尺子?具体目标是构造一个全参考感知距离,满足四个条件:(1)度量本身完全不用人工标注定义,从源头消除对特定评测集与分辨率的过拟合;(2)对局部结构失真敏感,同时知道哪些变化对人眼不重要,即兼顾早期特征的定位能力与深层表征的「重要性」判断;(3)具有明确、可解释、可在真实图像上直接分析的几何结构(局部为像素空间的回调度量),且处处可微、能当训练损失;(4)在分辨率翻倍时保持稳定,计算足够便宜(毫秒级),并能以最小改动扩展到视频质量评估。
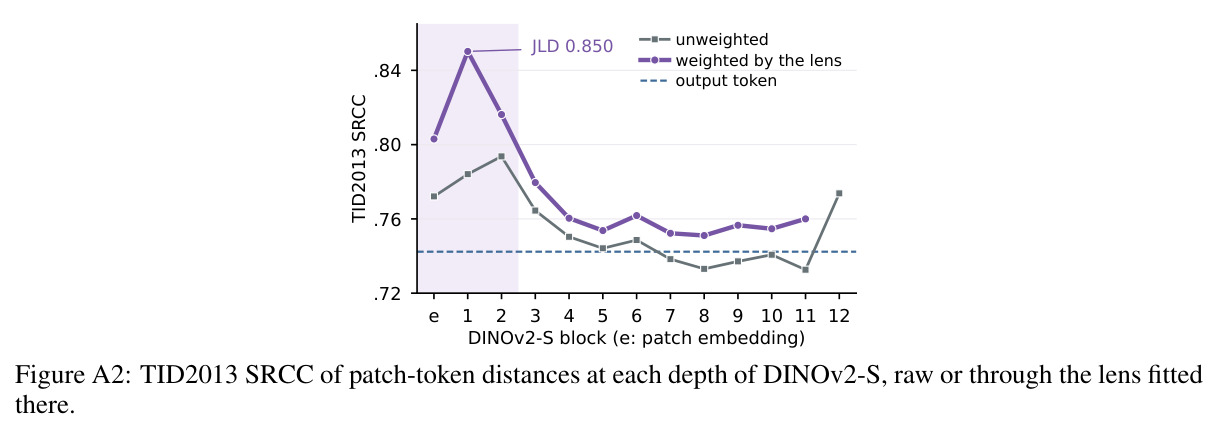
与已有工作不同的是,现有方法在「从哪里获得感知权重」上有三条路:人类标签(LPIPS 学对角矩阵 $\mathbf{Q}$、DISTS 拟合特征统计量、DreamSim 微调编码器)、手工早期视觉模型(SSIM/FSIM/VSI/GMSD 等)或学习的数据密度(IEM 的去噪误差积分、LASI 的推理时线性嵌入)。本文的切入点是第四条:被冻结编码器自己的输出。作者观察到任何单一深度都不够——DINOv2-S 第一块 patch token 等权使用 384 个方向在 TID2013 全集上只有 0.784 的 SRCC,最终输出 token 只有 0.742——但两者互补:早期特征有空间细节,深层特征知道什么重要,而连接二者的数学对象正是雅可比 $\mathbf{J}_t=\partial\mathbf{z}/\partial\mathbf{h}_t$。把输出敏感度 $\mathbb{E}[\mathbf{J}^\top\mathbf{J}]$ 一次性固定回早期特征,据作者所知是首个以此方式构造的感知距离,也区别于 active subspaces、潜空间解码度量、语言模型的 Fisher 回调等其他回调度量用法。
核心方法
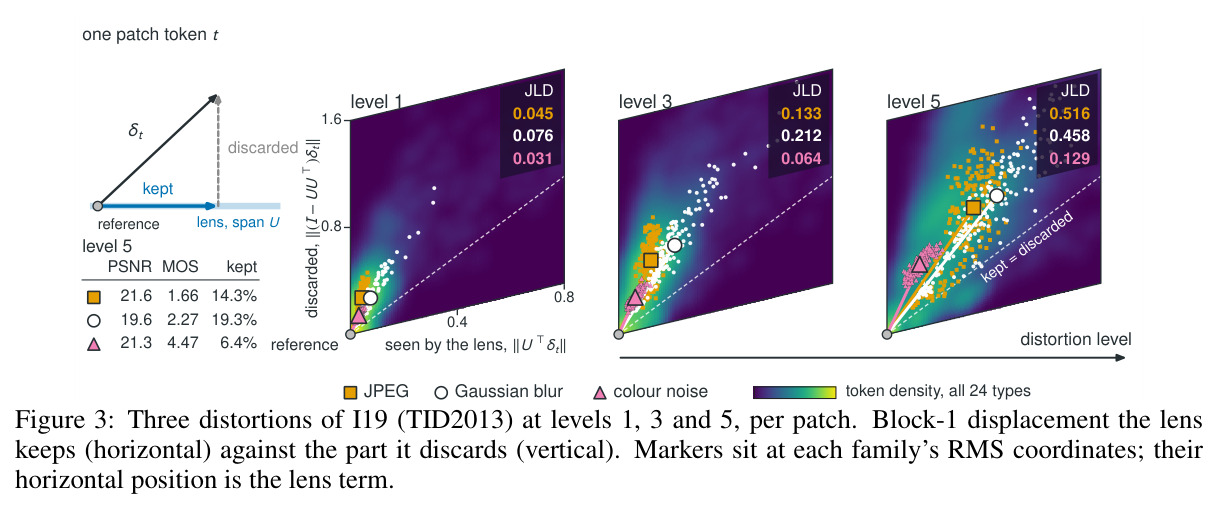
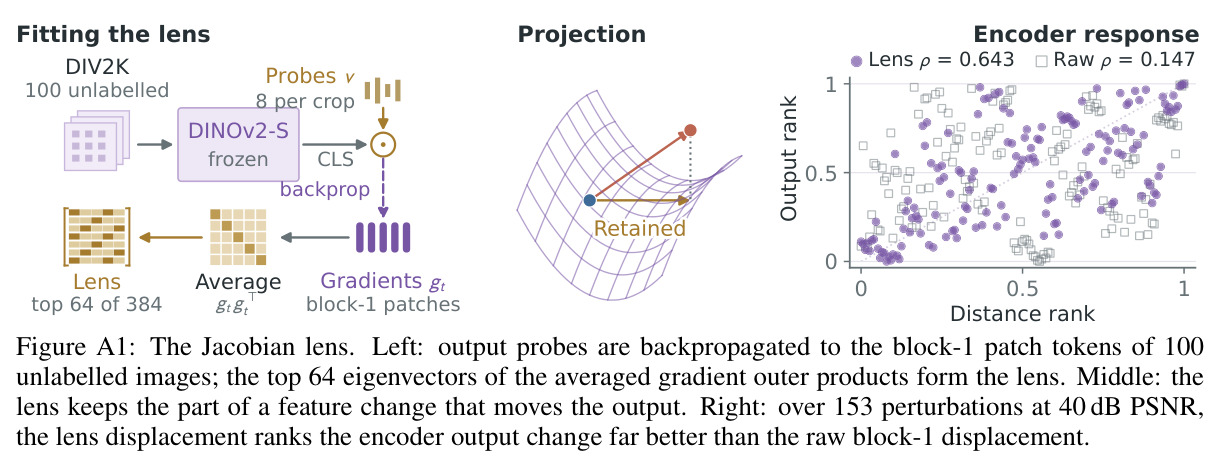
直觉上,视觉编码器第一块的 patch token 知道「哪里变了、变了多少」,但不知道「这个变化对网络输出重不重要」;网络输出正好相反。JLD 用雅可比把后者的知识「拉回」前者:对冻结的 DINOv2-S(ViT-S/14),计算输出(层归一化后的 CLS token $\mathbf{z}$)相对第一块 patch token $\mathbf{h}_t$ 的雅可比,在大量无标签图像与位置上平均其平方响应,得到一个固定的 $384\times384$ 度量张量 $\mathbf{M}=\mathbb{E}[\mathbf{J}_t^\top\mathbf{J}_t]$;它的前 64 个特征向量构成「雅可比透镜」$\mathbf{U}_k$——编码器真正关注的方向子空间(捕获 76.5% 的迹)。评分时,两张图先做保亮度的色度预滤波,再把逐 patch 特征差投影进透镜取 RMS 得到「透镜项」,加上半个 CLS 余弦距离作为「输出项」以捕捉整体色偏等全局变化。整个度量只是一个冻结编码器加一个 $384\times64$ 固定矩阵,几何上等价于像素空间中的回调度量 $\mathbf{G}(x)$,因此可以在真实图像上直接画出等距椭圆与敏感度图。
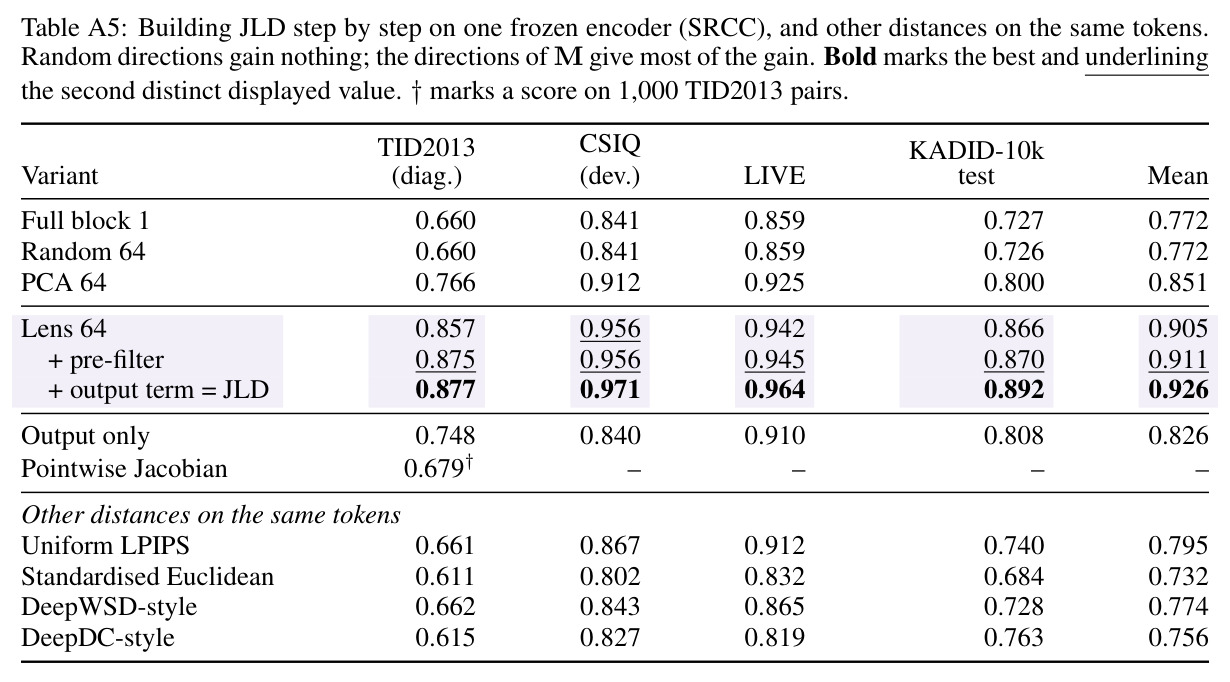
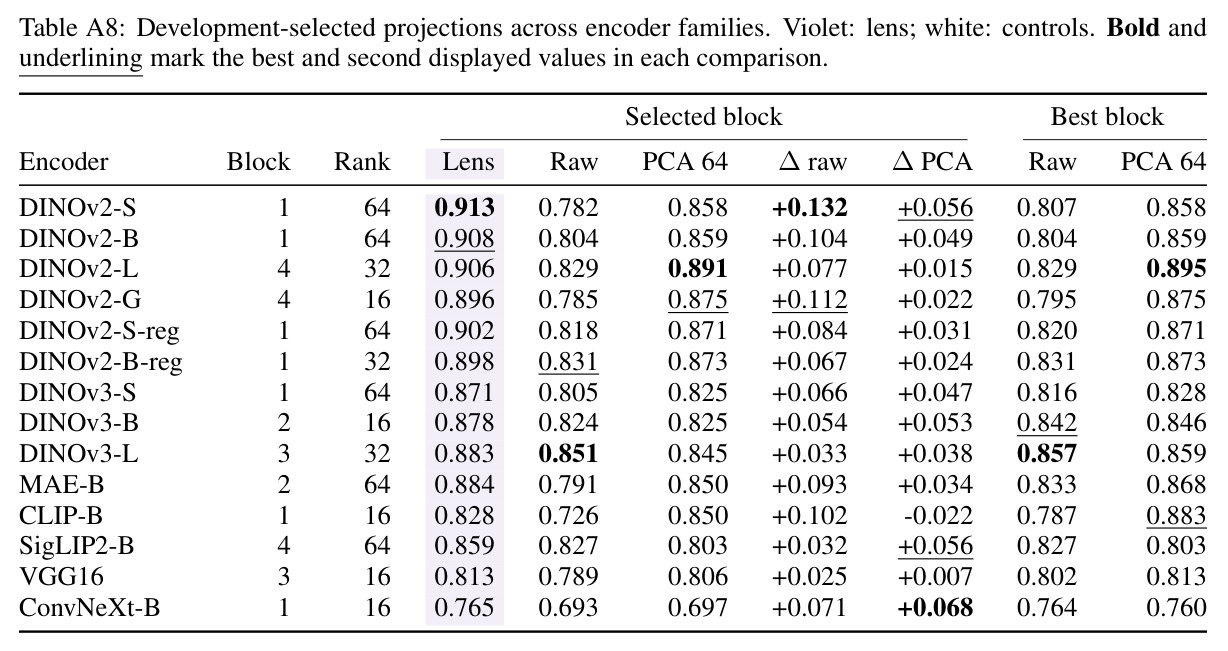
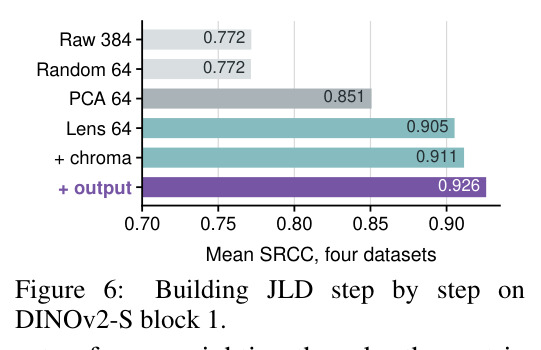
核心创新是把「输出敏感度」而非「特征方差」作为特征方向的排序准则,并把它固化成一个跨图像、跨位置、跨分辨率共享的度量张量。与 LPIPS 从人类判断学权重、DISTS 拟合统计量不同,JLD 的权重来自编码器自身:$\delta^\top\mathbf{M}\delta$ 给出沿 $\delta$ 扰动一个 patch 引起的期望平方输出变化,其特征向量按输出响应强度排列方向。这个选择效果显著:等权原始特征的四库平均 SRCC 只有 0.772,取 64 个随机方向仍是 0.772,取 64 个 PCA(方差)方向升到 0.851,而取 64 个敏感度(透镜)方向达到 0.905。透镜是所有秩-64 子空间中保留敏感度最优的(Ky Fan 极大原理):被丢弃的 320 个方向上等长位移的 RMS 输出响应最多只有主方向的 $\sqrt{\mu_{65}/\mu_1}=0.173$ 倍。拟合只需随机探针:对输出采样高斯向量 $\mathbf{v}\sim\mathcal{N}(0,\mathbf{I})$,一次反向传播即在所有 patch 同时得到 $\mathbf{g}_t=\mathbf{J}_t^\top\mathbf{v}$,100 张无标签 DIV2K 图 35 秒拟合完毕,无任何图像对、失真或人类标签。
方法步骤详情
方法分拟合与评分两阶段。拟合(Algorithm 1):取 100 张无标签 DIV2K 图,每张裁 4 个 224×224 crop;每个 crop 对输出采 8 个高斯探针 $\mathbf{v}\sim\mathcal{N}(0,\mathbf{I})$,一次反向传播得到全部 $N=256$ 个 patch 的梯度 $\mathbf{g}_t=\nabla_{\mathbf{h}_t}(\mathbf{v}^\top\mathbf{z})$;累积 $\hat{\mathbf{M}}\mathrel{+}=\frac{1}{N}\sum_t\mathbf{g}_t\mathbf{g}_t^\top$($\mathbf{M}$ 的无偏估计);对 $\hat{\mathbf{M}}$ 取前 64 个特征向量得 $\mathbf{U}_k$。整个过程 34.53 s、峰值显存 327.8 MB(单张 A100),两次独立重拟合的子空间重叠达 0.962。评分(Eq. 3):输入各自中心裁剪到 14 的倍数;做色度预滤波 $\mathbf{R}_x$(RGB→YCbCr 后对 Cb/Cr 做 $\sigma=2$ 像素高斯模糊、保留 Y);两次前向取第一块 token,逐 patch 算 $\Delta_t=\mathbf{U}_k^\top(\mathbf{h}_t(\tilde{\mathbf{x}})-\mathbf{h}_t(\tilde{\mathbf{y}}))$,对 $N$ 个 patch 取 RMS 得透镜项;输出项为 $\frac{1}{2}(1-\cos(\mathbf{z}(\tilde{\mathbf{x}}),\mathbf{z}(\tilde{\mathbf{y}})))$,权重 1/2 由开发集选定且不敏感(0.25–1 区间内均值仅波动 0.004)。全程可微可用作损失;JLD-fast 在第一块后截断(10.7 GFLOPs、2.5 ms/对);JLD-video 把编码器换成冻结 VideoMAE-Base 第 2 块、16 维透镜。
技术新颖性
技术新颖性有四点。第一,权重来源:感知权重的公认来源是人类判断或手工视觉模型,本文证明「仅仅学会看的网络」的输出雅可比就已包含与人类一致的方向敏感性——色彩比模糊软、JPEG 比噪声硬、掩蔽效应——无需任何标签。第二,估计方式:不显式构造 $\mathbf{J}_t$(那需要逐输出坐标各反传一次),而用高斯随机探针一次反传同时得到所有 patch 的 $\mathbf{J}_t^\top\mathbf{v}$,使 35 秒拟合成为可能,并给出无偏性与误差界(Proposition 2)。第三,几何可分析性:因为透镜是固定线性映射,透镜项是固定特征映射后的欧氏距离(严格伪度量,在 1.714 亿个三元组上零违反),局部形式是像素空间的回调度量 $\mathbf{G}(x)$,可像传统指标那样在真实图像上画出等距椭圆与掩蔽图;LPIPS/DISTS 的几何则难以直接解读。第四,工程上的简洁与普适:等权 flat 投影优于 $\sqrt{\mu_i}$ 加权(0.916 vs 0.897)与完整马氏度量,且同一构造对 14 种冻结编码器(DINOv2/v3、MAE、CLIP、SigLIP 2、VGG16、ConvNeXt)全部优于原始特征。
实验结果
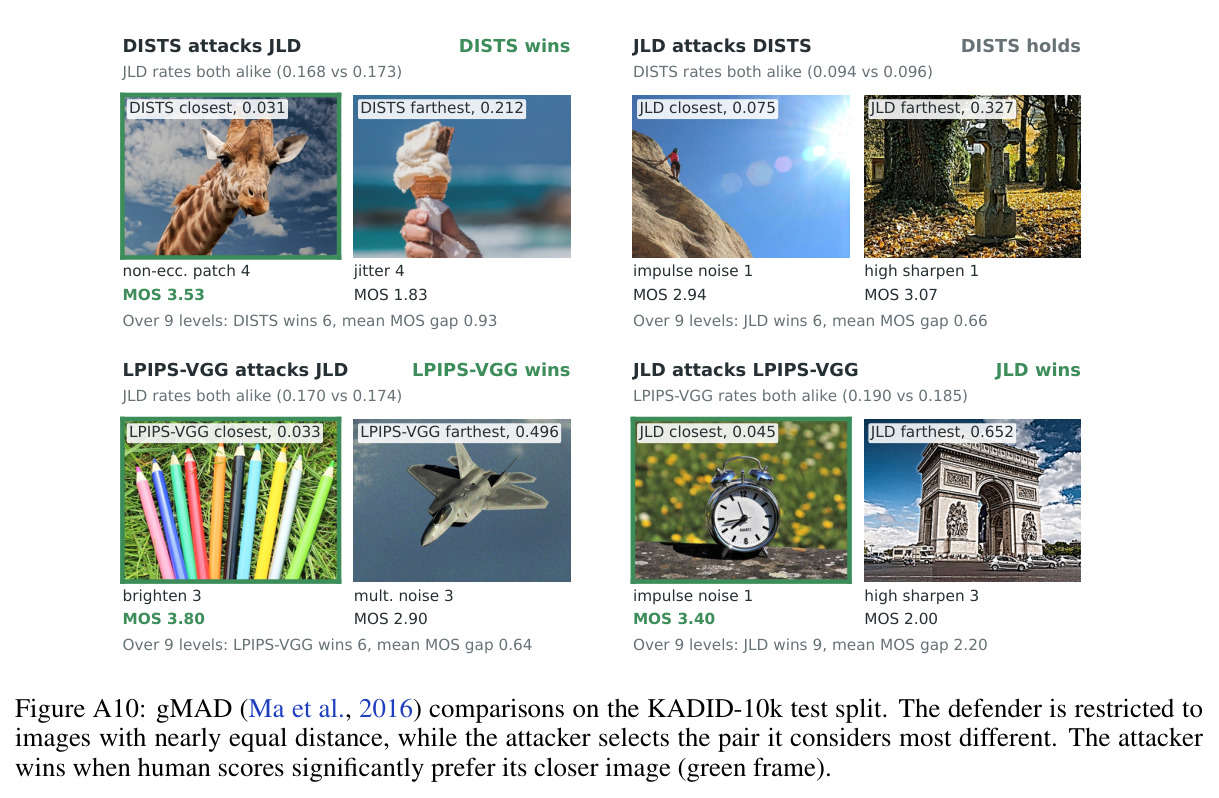
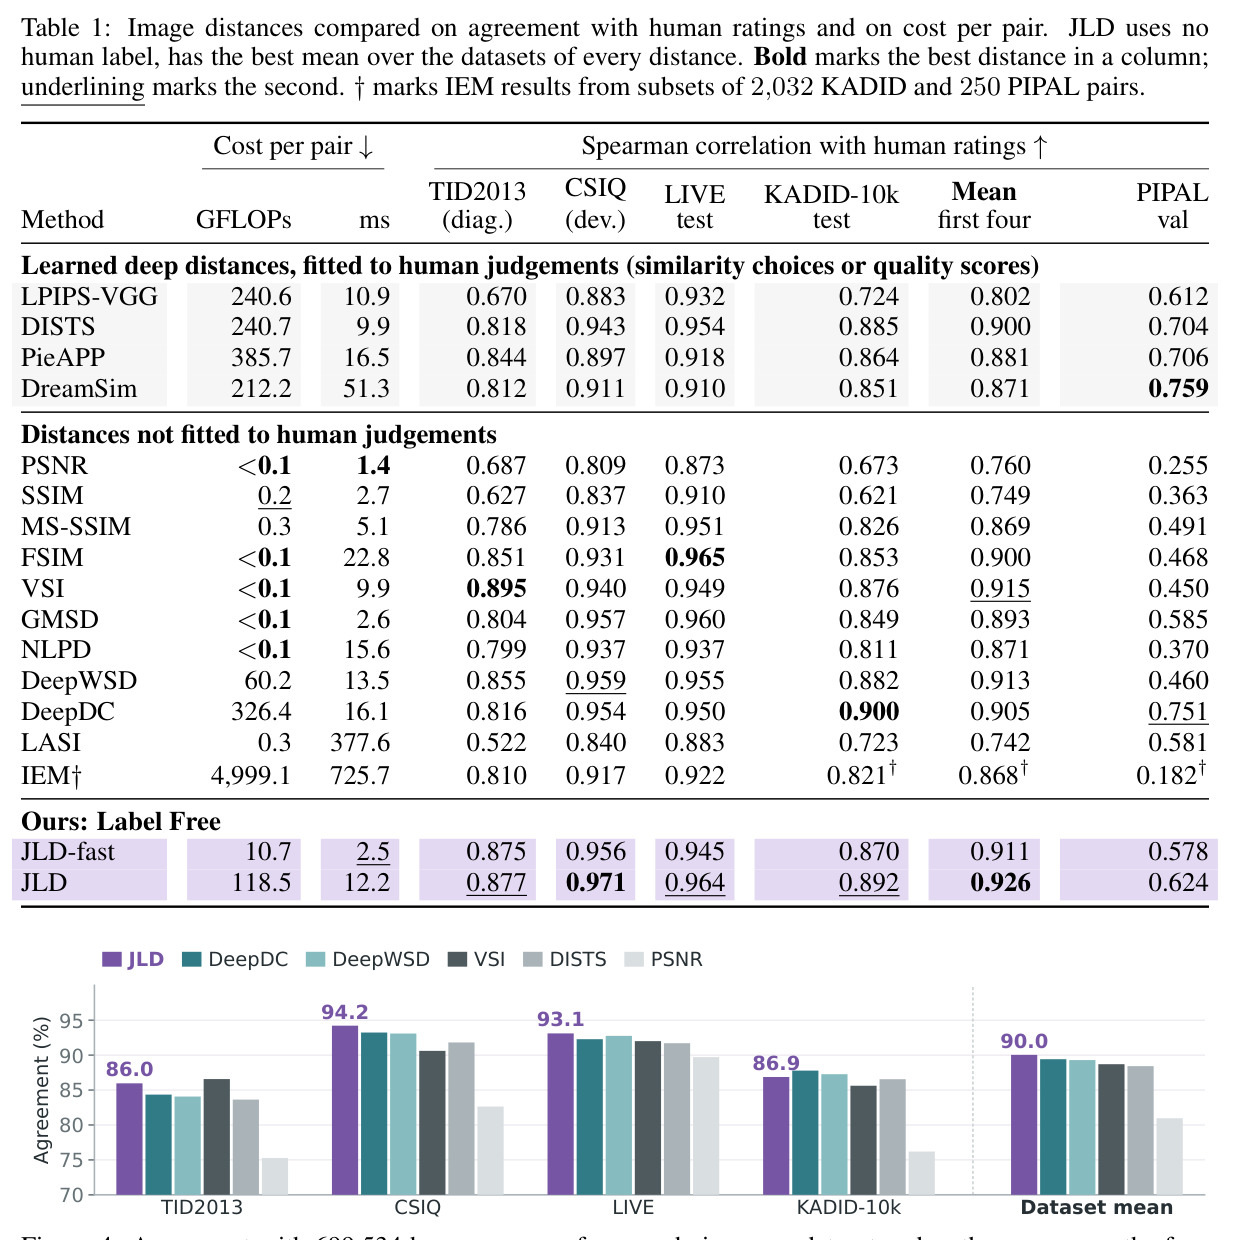
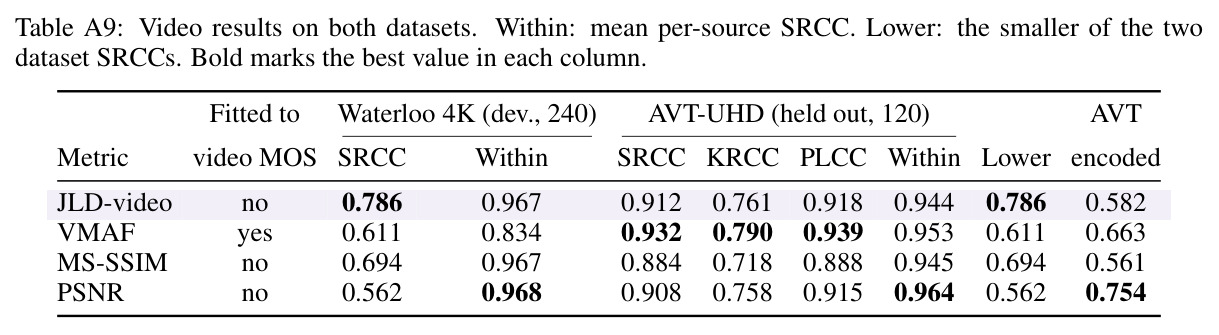
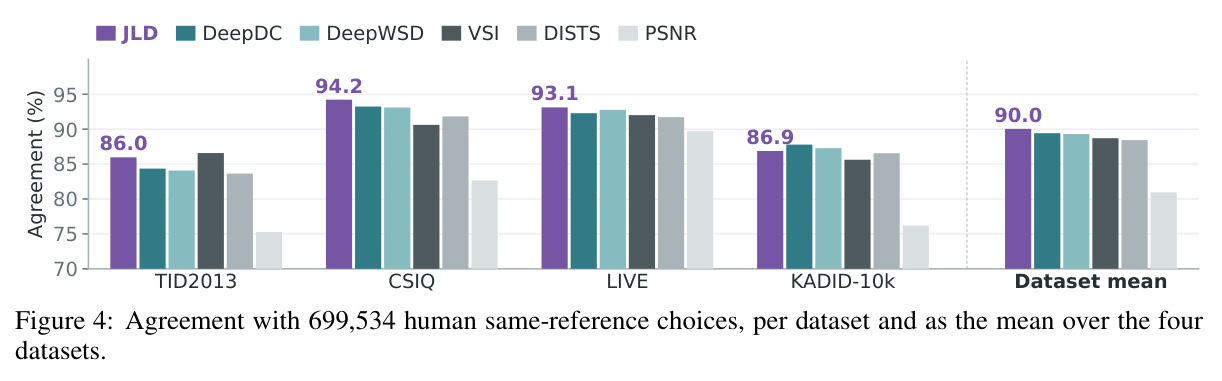
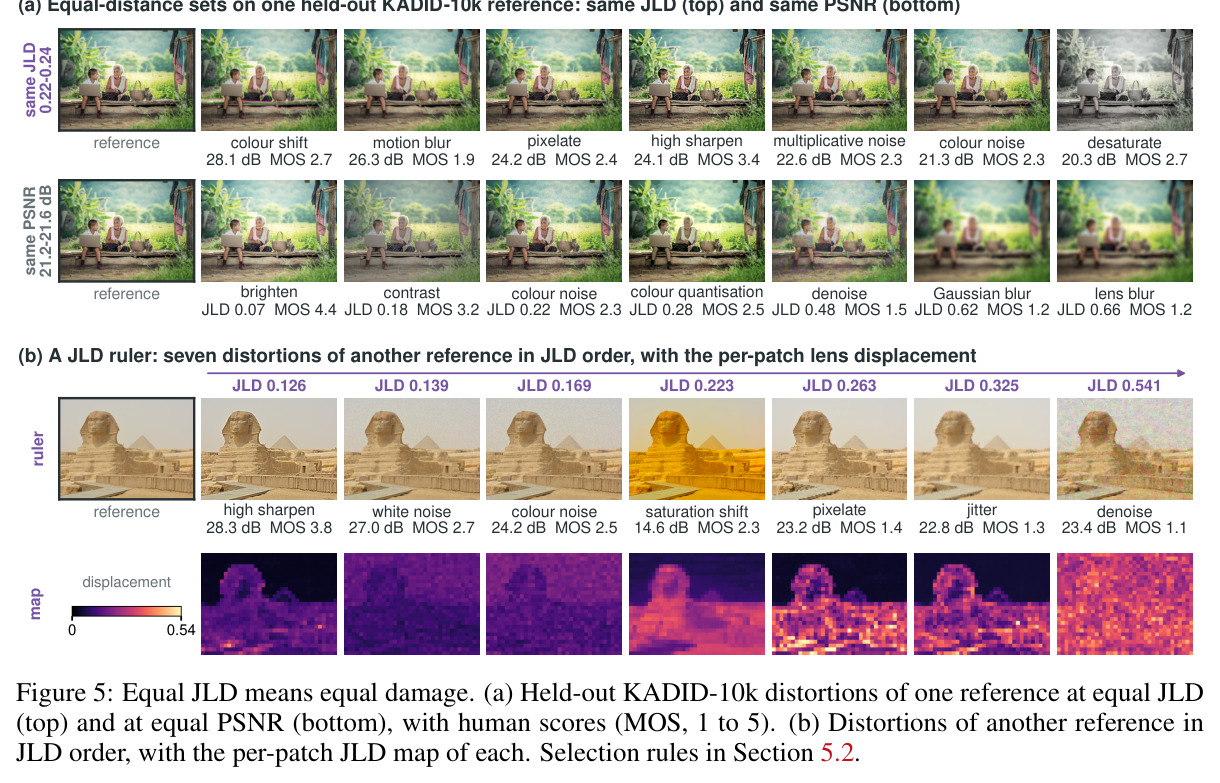
图像基准(Table 1):在 TID2013/CSIQ/LIVE/KADID-10k test 四库平均 SRCC 上,JLD 以 0.926 名列全部 17 个方法之首(VSI 0.915、DeepWSD 0.913、DeepDC 0.905、DISTS 0.900、LPIPS-VGG 0.802),逐库均为第一或第二(TID2013 0.877、CSIQ 0.971、LIVE 0.964、KADID 0.892),每个差距的 95% 置信区间不含零——在未用任何人类标签的情况下超过所有在人类数据上拟合的深度距离。分对决策:在 699,534 个同人参考对上 JLD 与人类偏好一致 90.0%,超过 DeepDC 89.4% 与 DISTS 88.4%;在 24,623 对 PSNR 差小于 0.25 dB 的样本上(PSNR 相当于随机 48.7%),JLD 达 76.0%(DISTS 74.4%、LPIPS-VGG 65.3%)。等距性(Fig. 5):等 JLD(≈0.233)的 9 种失真 MOS 标准差仅 0.46,而等 PSNR(21.5 dB)的 10 种失真 MOS 标准差达 1.26、JLD 值相差 9 倍;JLD 尺子上 7 档失真按人类分严格单调递减(3.8→1.1),该参考上 JLD SRCC 0.921 对 PSNR 0.566。消融(Fig. 6)证明收益来自方向选择而非降维:raw 384 = random 64 = 0.772 < PCA 64 0.851 < lens 64 0.905 < +色度滤波 0.911 < +输出项 0.926。分辨率稳定性:256→512 像素时透镜项 SRCC 仅从 0.850 降到 0.845,而 DISTS 0.815→0.717、LPIPS-VGG 0.757→0.661、原始特征 0.784→0.656;CSIQ 上还从 0.923 升至 0.958。视频:JLD-video 在 Waterloo IVC 4K 上 0.786,领先 VMAF(0.611)0.175;在 120 个 held-out AVT-UHD 对上 0.912,与在人类视频评分上训练过的 VMAF(0.932)仅差 0.020。几何验证(Fig. 2):等像素能量平面上 JLD 等距椭圆各向异性 2.33,编码器回调度量预测 2.07,长轴方向仅差 3°,半径误差 9.2%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 图像质量排序(TID2013/CSIQ/LIVE/KADID-10k 四库平均) | SRCC | JLD 0.926(JLD-fast 0.911) | VSI 0.915、DeepWSD 0.913、DeepDC 0.905、DISTS 0.900、LPIPS-VGG 0.802 | +0.011(对最强基线 VSI)至 +0.124(对 LPIPS-VGG),且无人类标签 |
| 修复类输出质量排序(PIPAL 验证集) | SRCC | 0.624 | LPIPS-VGG 0.612、DISTS 0.704、DeepDC 0.751 | 超 LPIPS-VGG +0.012 与全部经典指标,但低于 DeepDC/DreamSim(0.759) |
| 与人类二选一偏好一致率(699,534 个同人参考对) | 一致率 | 90.0% | DeepDC 89.4%、DISTS 88.4% | +0.6pp(第一);等 PSNR 子集上 76.0% 对 PSNR 随机水平 48.7% |
| 分辨率稳定性(TID2013 短边 256→512 像素重打分) | SRCC 变化 | 透镜项 0.850→0.845(−0.005) | DISTS 0.815→0.717(−0.098)、LPIPS-VGG 0.757→0.661(−0.096)、原始特征 0.784→0.656 | 退化幅度约为深度基线的 1/20 |
| 视频质量排序(Waterloo IVC 4K,240 对) | SRCC | JLD-video 0.786 | MS-SSIM 0.694、VMAF 0.611、PSNR 0.562 | 领先 VMAF +0.175;held-out AVT-UHD 上 0.912 对 VMAF 0.932 |
| 计算成本(A100,512×384 输入) | GFLOPs / ms 每对 | JLD-fast 10.7 / 2.5 ms;完整 JLD 118.5 / 12.2 ms | LPIPS-VGG 240.6 / 10.9 ms、DISTS 240.7 / 9.9 ms | JLD-fast 快 4.3× 且均值 SRCC 高 0.109;速度-精度 Pareto 前沿上仅 PSNR 更快 |
局限与改进
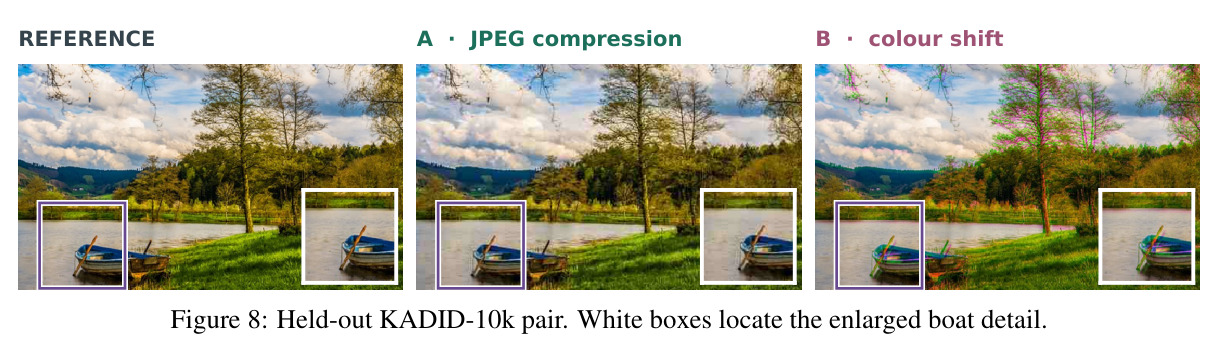
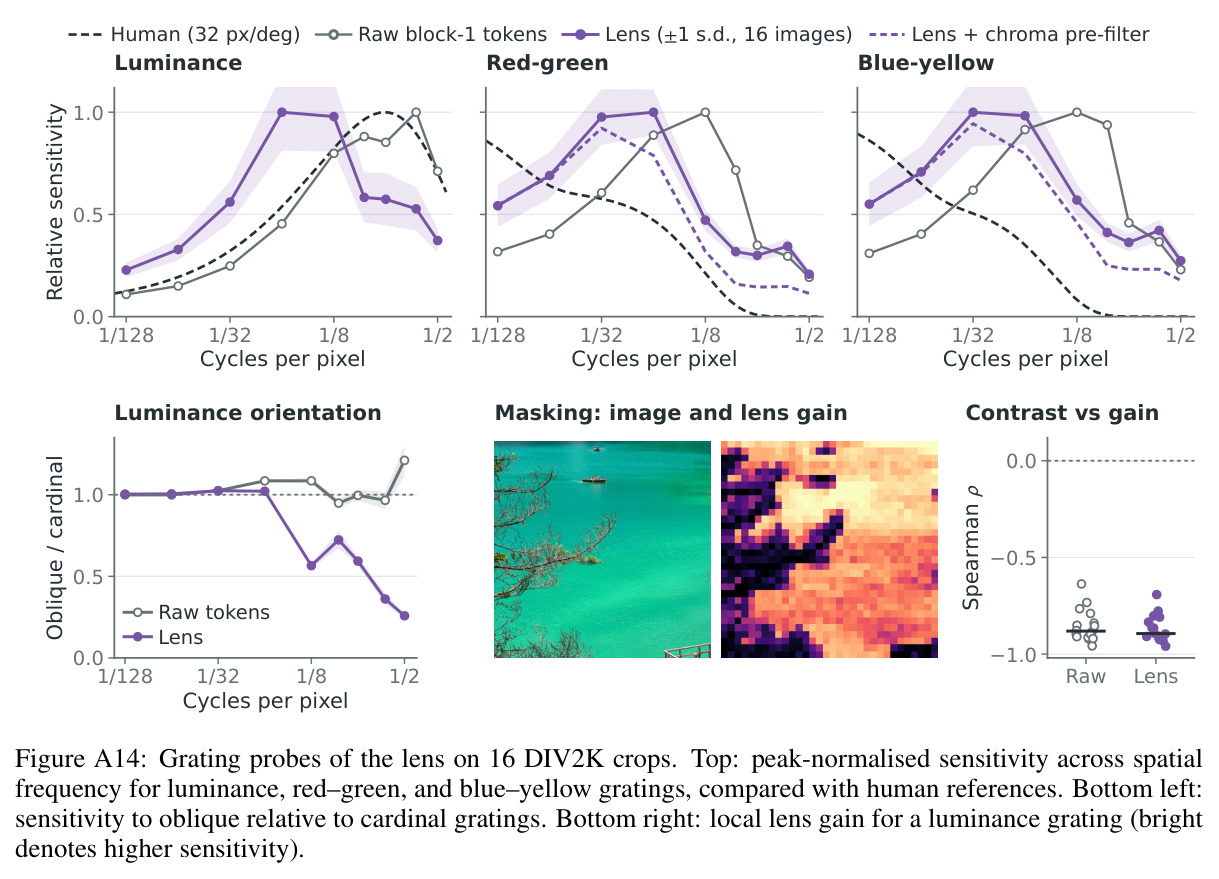
作者承认的局限(Appendix N):在修复类输出上较弱(PIPAL val 0.624,低于 DeepDC 0.751 与 DreamSim 0.759);对全局对比度变化不敏感(TID2013 对比度子集仅 0.378);透镜项存在非平凡零空间——320 个被丢弃方向上的扰动不可见,直接当训练损失会被「钻空子」;输出项虽补掉部分歧义却破坏三角不等式(实测每百万三元组最多违反 107 次、最大违反 3.6%);完整版 JLD 比 DISTS 慢,4 倍加速只属于 JLD-fast;人类实验只有 10 名参与者;且要求两图空间对齐。我补充几点:其一,「无标签」有边界——透镜本身不用标签,但块数、秩 k=64、输出权重 1/2 是在 245 个配置中由 CSIQ 与 KADID-10k 开发集的人类评分选出的,色度预滤波的设计也参考了 TID2013,严格说是「距离无标签拟合、超参有标签调优」;其二,编码器偏置被继承,光栅探针显示它并不复现人眼亮度对比敏感度函数(峰值频率偏低),对扩散模型等新型生成失真的覆盖有限(BAPPS 传统失真仅 0.681,低于 DISTS 0.749);其三,评测集仍以合成失真为主,MOS 数据自身的偏见会同时影响所有方法。
独立分析的弱点
独立分析的弱点与改进方向:(1)零空间是最大的实际隐患——320 个不可见方向意味着任何以 JLD 为损失的生成/压缩模型都会向这些方向漂移。metamer 实验(Fig. A16)显示 40 dB PSNR 的近似 metamer 使透镜距离仅升 1.23 倍而 LPIPS-VGG 升 14.5 倍,说明该盲区真实存在。改进:按作者建议用完整张量 $\mathbf{M}$ 封闭零空间,或用多个随机透镜的集成近似补全。(2)输出项权重 1/2 是开发集折中,全局色彩类失真仍系统性欠惩罚(KADID 上 colour block −0.72 MOS、colour shift −0.53),高锐化又被过惩罚(+0.51);改进:为输出项引入方向性建模或对已知系统性残差加校准。(3)透镜对域敏感,换域(医疗影像、遥感)需重新拟合——虽然只要 35 秒与 100 张无标签图,但块与秩的选择仍需带标签开发集;改进:用代理目标(下游任务性能或输出不确定性)自动选择块与秩。(4)要求严格空间对齐,对含轻微几何形变的真实场景(视频解码、超分输出)未验证;改进:前置轻量配准或在 token 匹配中允许局部对应。(5)未复现人眼 CSF 峰值频率;改进:用可学习的预滤波替代固定 $\sigma=2$ 高斯,并验证是否保持分辨率稳定性。
未来方向
作者提出的方向:把同一构造推广到任何可微编码器——音频、医学影像、3D——每个新域只需约 100 张无标签样本与一次 35 秒拟合;用完整度量张量封闭透镜的零空间,使其可安全地作为训练损失;附录还展示了无参考扩展的雏形(KonIQ 上 0.486,仍远低于 CLIP-IQA 的 0.685)。基于本文成果可延伸的方向:(1)把 JLD 作为扩散解码器、神经 codec 或超分模型的感知损失,检验训练稳定性(特别是零空间问题);(2)理论侧,论文已指出在输出各向同性噪声下 $\delta^\top\mathbf{M}\delta/\sigma$ 即 RMS 可检测性 $d'$,可进一步与 Fisher 信息、eigen-distortions 一脉对接,刻画「最优感知子空间」的一般条件;(3)视频方向目前只用了 16 维透镜与单一编码器,时序掩蔽与帧率依赖性值得系统研究;(4)多编码器透镜集成,以及把回调度量场 $\mathbf{G}(x)$ 本身用作无参考质量图或生成模型的判别器,都是自然的下一步;(5)分辨率稳定性目前对 block-1 只是经验结论(Theorem 1 只覆盖线性的 JLD-lin),补齐含注意力情形的理论会很有价值。
复现评估
复现条件非常友好。作者承诺发布完整代码库(含所有变体、预拟合的 DINOv2-S 透镜、拟合/评测/绘图脚本),并给出三行 API(JLD.pretrained("full"),另有 .map 返回逐 patch 透镜图、可微接口作损失);透镜是一个 384×64 矩阵,随附敏感度矩阵、特征协方差与校准元数据,推理无需梯度。算力需求极低:拟合在单张 A100 上 34.53 s、峰值显存 327.8 MB,评分每对 12.2 ms(完整版)或 2.5 ms(fast),十二线程 CPU 上 JLD-fast 比 LPIPS-VGG 快 14 倍,消费级 GPU 即可复现。数据全部公开:校准用 DIV2K(无标签),评测用 TID2013、CSIQ、LIVE、KADID-10k、PIPAL、BAPPS 及视频库 Waterloo IVC 4K、AVT-VQDB-UHD-1。注意点:须遵守其协议——CSIQ 与 KADID 开发集用于选择配置,LIVE/KADID test/PIPAL 保持 held-out;复现精确数字还需中心裁剪到 14 的倍数、A100 计时口径、IEM 子集等细节。总体难度:入门到中等,主要工作量在跑通 15+ 基线而非 JLD 本身。
论文图表
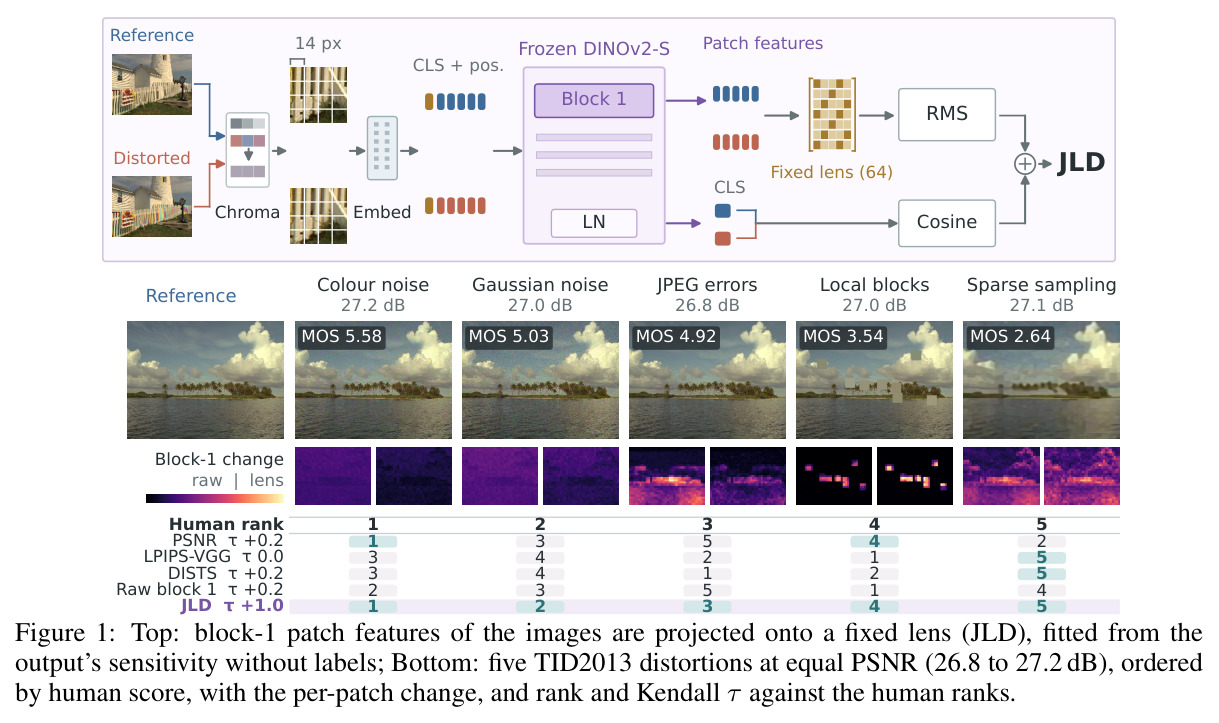
上半部分是方法总览:参考图与失真图过冻结 DINOv2-S,第一块 patch 特征投影到 64 维固定透镜,与 CLS 余弦项相加得 JLD。下半部分是动机实验:五种 PSNR 几乎相同(26.8–27.2 dB)的失真,人类排序为色彩噪声>高斯噪声>局部块>JPEG>稀疏采样(MOS 5.58→2.64),JLD 以 Kendall τ=1.0 完全复现人类排序,而 PSNR/原始特征 τ=+0.2、LPIPS-VGG τ=0.0、DISTS τ=+0.2。
一张图同时给出方法管线和核心论点:等像素误差的失真感知严重度天差地别,而只用编码器自身敏感度的 JLD 无需标签就能完全排对。
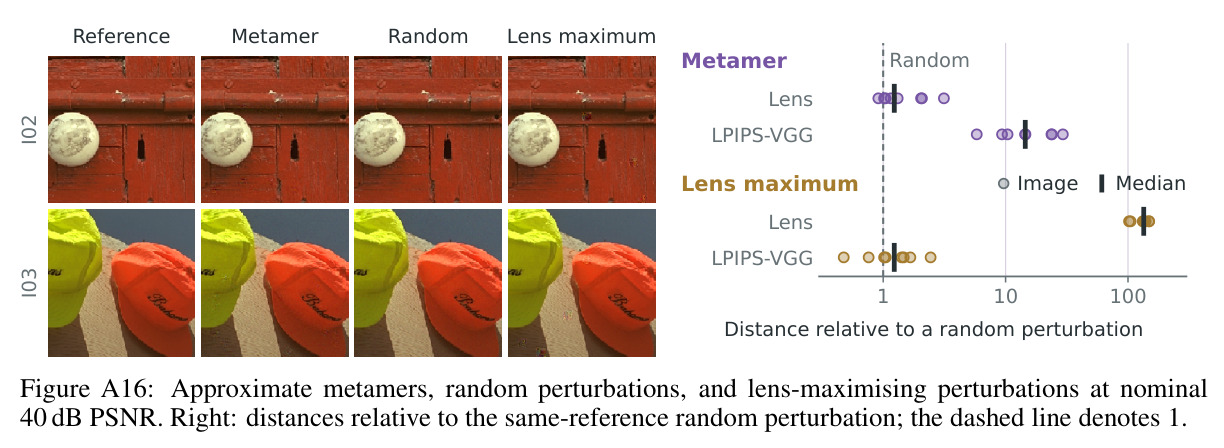
零空间探测:同参考的近似 metamer(透镜不可见方向上的扰动)使透镜距离仅升为随机扰动的 1.23 倍(LPIPS-VGG 升 14.5 倍);反向的透镜最大化扰动使透镜距离暴涨 134 倍而 LPIPS-VGG 仅 1.23 倍。
直接量化透镜的方向性与零空间大小,既是几何分析的有力证据,也是「作为训练损失会被钻空子」这一局限的实证。