FoMo:以生成轨迹的分叉时刻作为感知距离 FoMo: Forking Moment in Generative Trajectory as a Perceptual Distance
用扩散去噪轨迹的分叉时刻当免费距离标签,免人工标注训练出更强感知质量度量
前置知识
参考型图像质量评估(FR-IQA)
给定无失真的参考图与失真图,度量二者在人类感知意义上的差异,要求与主观判断的排序高度相关。LPIPS、DISTS、DreamSim 是代表方法,广泛用作图像复原(超分、去噪)任务的评估指标和训练损失。
本文训练的就是这样一把“感知尺”,全部实验与基准(PIPAL、TID2013、CSIQ、LIVE)都在此框架下评价,不懂 FR-IQA 无法理解论文目标。
MOS 与 2AFC 标注
MOS(均方主观分)让多名观察者在绝对量表上给单张图打分取均值,全局有序但噪声大、极其昂贵;2AFC(两选一强迫选择)让人回答哪张失真图更接近参考图,一致性好但只产出相对二元偏好,无法直接给出全局排序。
FoMo 的动机正是同时规避两者的缺陷,理解这两种标注范式的优缺点才能明白“逐点标签”的价值所在。
扩散模型与整流流
扩散模型通过前向过程逐步加噪破坏图像、再学习逆向去噪生成图像;整流流/流匹配把轨迹参数化为数据与噪声间的线性插值 $x_t=(1-t)x_0+t\epsilon$,轨迹更直、采样更高效,FLUX.1 即采用此形式。
FoMo 的标签完全来自去噪轨迹的中间状态,必须理解加噪-去噪过程与插值因子 $t$ 的含义才能读懂方法。
SROCC(Spearman 秩相关系数)
度量两组排序之间单调关系的相关系数,取值 $[-1,1]$,是 IQA 领域报告与主观判断一致性的事实标准指标。它对预测值的绝对标度不敏感,只看排序是否正确。
论文所有主表均以 SROCC 报告结果,且 RankBCE 损失的设计动机就是直接优化全局排序,与该指标天然对应。
研究动机
参考型图像质量评估(IQA)需要大量人类标注来学习符合人眼判断的距离度量,但两类主流标注方式都有硬伤。均方主观分(MOS)要求每张失真图由多名观察者在绝对量表上打分,噪声大且成本高:最大的 KADID-10k 数据集为得到 10,125 张失真图(仅来自 81 张参考图)的标签,动用了超过 2,200 名众包被试、每图 30 次评分,且同一失真图在不同数据集间得分差异显著,缺乏跨数据集可比的统一感知基准。作为替代的两选一强迫选择(2AFC)配对标注(BAPPS、PieAPP)虽一致性更高,但二值偏好只编码相对关系,一组二元比较结果并不能直接给出全局排序,训练目标与 IQA 所需的全局秩相关性存在结构性脱节;而要在数千张图上收集干净一致的逐点质量信号,在人工标注框架下成本高到不可行。
本文的目标是本文的目标是彻底绕开人工标注瓶颈:构建一条全自动的数据生成流水线,直接产生带逐点感知距离标签的图像对,用于训练参考型 IQA 度量。具体而言,希望标签不仅刻画同一参考图下两个变体的相对远近(2AFC 能做到的),而是支持任意图像对之间全局可比的绝对距离,从而可以直接用秩相关性目标优化全局排序;同时希望在 PIPAL、TID2013、CSIQ、LIVE 四个基准、七个骨干架构上超越用大规模人类标注训练的现有度量,证明自动生成的扩散标签可以成为比 MOS 和人工 2AFC 更强、更可靠、且可无限扩展的训练信号。
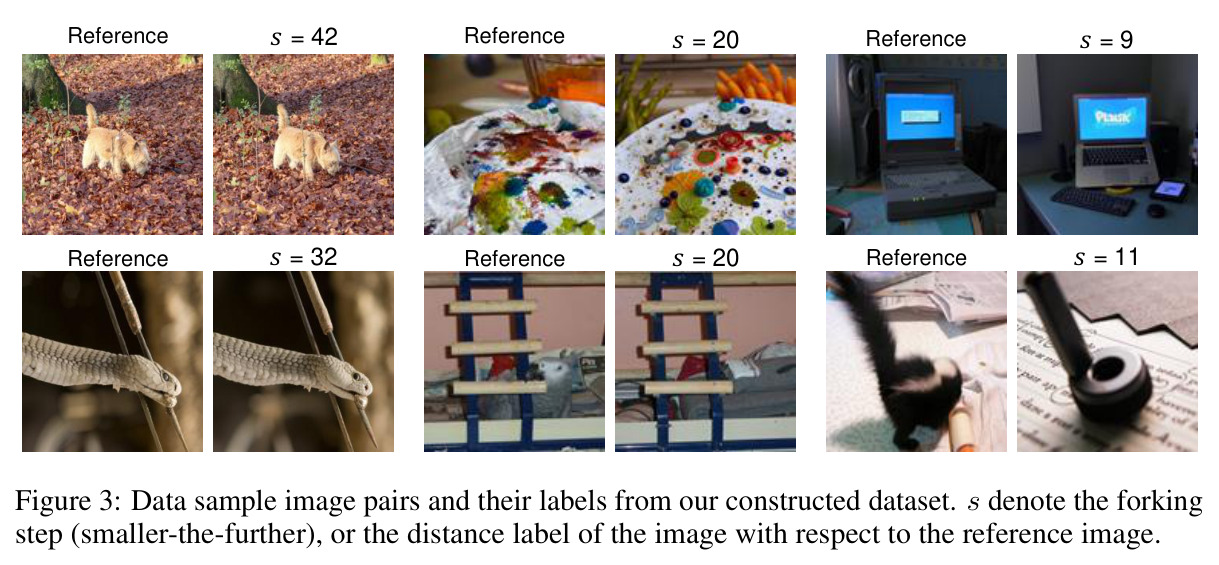
与已有工作不同的是,本文的独特切入是把标注工作交给生成过程本身。已有工作表明扩散生成轨迹具有分层结构:Choi 等人刻画了去噪过程在低噪声时恢复细微纹理、中等噪声时重建物体结构与纹理、高噪声时仅恢复颜色分布;Decatur 等人证明语义相近的图像可共享早期去噪步、从某时刻起树状分叉。但这些发现从未被当作距离标签使用。FoMo 的做法是把受控分叉(两个样本共享轨迹到时刻 $t$ 后独立重采样)的分叉时刻直接读作参考图与变体之间的感知距离,并用两轮人类实验和大规模指标对齐实验严格验证这一代理的有效性,从而首次把生成动力学转化为可扩展、逐点、跨锚点全局一致的距离监督来源。
核心方法
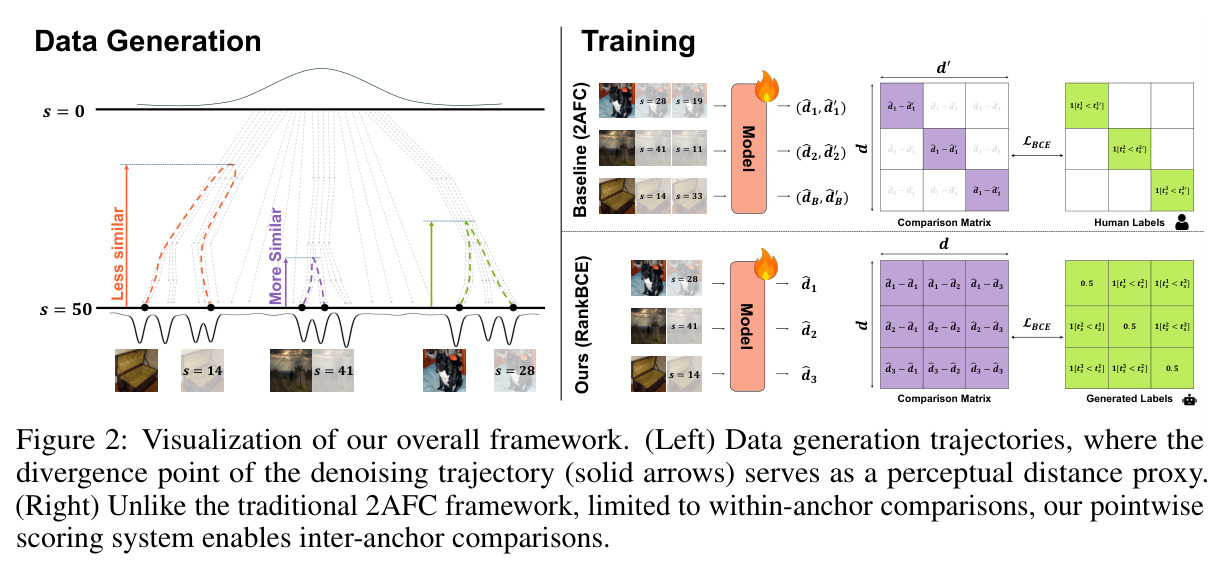
方法的直觉来自扩散模型生成的 coarse-to-fine 结构:去噪过程先在早期时间步确定图像的粗略布局、物体结构与颜色,后期时间步才填充人眼难以分辨的高频细节。据此,若让两个样本沿同一条去噪轨迹走到时刻 $t$ 再各自独立采样,分叉得越早($t$ 越大、被破坏的判别性信息越多)产物差异越大,分叉得越晚则只差细枝末节。技术上,作者采用 FLUX.1-dev(rectified flow,前向加噪为 $x_t=(1-t)x_0+t\epsilon$),对每张参考图 $x_0$ 在 $S=50$ 步内均匀采样分叉步 $s$,加噪到 $x_{t_s}$ 后只跑剩余 $S-s$ 步去噪得到变体 $x'_s$,并以插值因子 $t_s$ 作为该图像对的距离标签。共生成了 48 万对数据(24 万张 ImageNet 真实图加 24 万张 FLUX 合成图作参考),训练时用 RankNet 式的 RankBCE 损失在批内构建 $B\times B$ 比较矩阵,直接监督全局排序而非孤立的二元偏好。
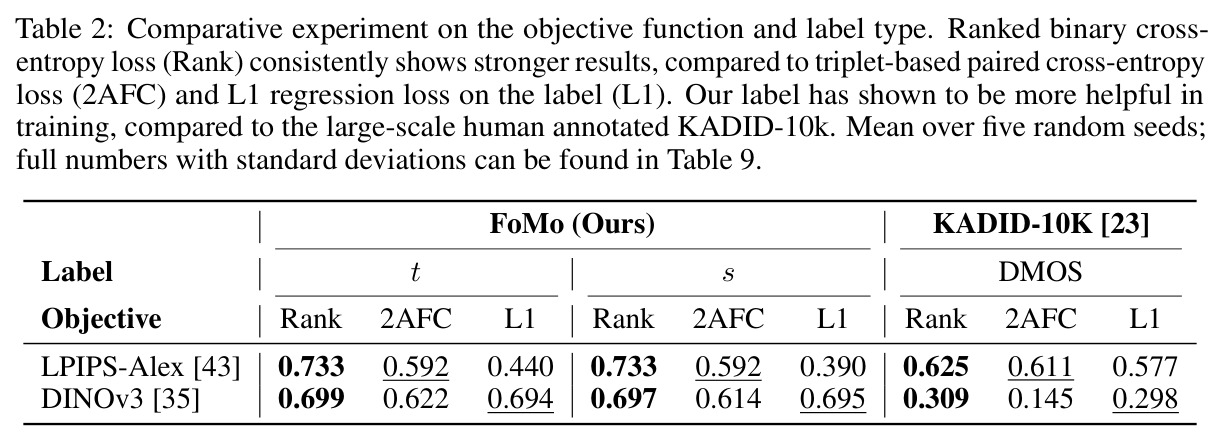
核心创新有二。其一,标签来源转变:传统方法(LPIPS、DISTS 等)从人工 2AFC 偏好或 MOS 分数中蒸馏感知距离,FoMo 则用生成轨迹的分叉时刻 $t_s$ 作逐点标签,它连续、稠密、可无限生成,每对图像携带独立绝对距离,无需共享锚点即可跨参考图比较,这是 2AFC 二元标签做不到的。其二,目标函数转变:标签逐点意味着批内任意两对都可比较,可构建真值比较矩阵 $y_{ij}=\mathbf{1}[t_i^s<t_j^s]$(相等取 0.5),对全部 $B\times B$ 组合施加二元交叉熵 $\mathcal{L}=-\frac{1}{B^2}\sum_{i,j}\left[y_{ij}\log\sigma(\hat{d}_j-\hat{d}_i)+\mathrm{sg}\big((1-y_{ij})\log\sigma(\hat{d}_i-\hat{d}_j)\big)\right]$,$\mathrm{sg}$ 为停梯度。相比三元组式 2AFC 损失,每步监督从 $O(B)$ 个比较增至 $O(B^2)$ 个并隐式强制传递性,消融显示其全面优于 2AFC 与 L1。
方法步骤详情
整条流水线分数据生成与训练两阶段。数据生成:任取一张参考图 $x_0$,在 $[0,49]$ 上均匀采样分叉步 $s$,经噪声调度映射为插值因子 $t_s=\mathcal{S}(s)$;采样噪声 $\epsilon$ 构造带噪隐变量 $x_{t_s}=(1-t_s)x_0+t_s\epsilon$;从 $x_{t_s}$ 出发执行剩余 $S-s$ 步去噪得到变体 $x'_s$;存储三元组 $(x_0, x'_s, t_s)$,$t_s$ 越大感知偏差越大。按此生成 480k 对,其中 240k 用 ImageNet 真实图、240k 用 FLUX 合成图作参考。训练阶段:冻结预训练特征提取器(LPIPS-Alex/VGG、DISTS、DINOv3、CLIP、MAE,仅 DreamSim 用 LoRA 微调),从头训练距离预测头;每个 batch 取 $B$ 对,预测距离 $\hat{d}_i$,构建比较矩阵 $Y$ 并计算 RankBCE 损失。全部实验约 240k 次迭代,单张 NVIDIA RTX A40 即可完成,评估统一报告 SROCC。
技术新颖性
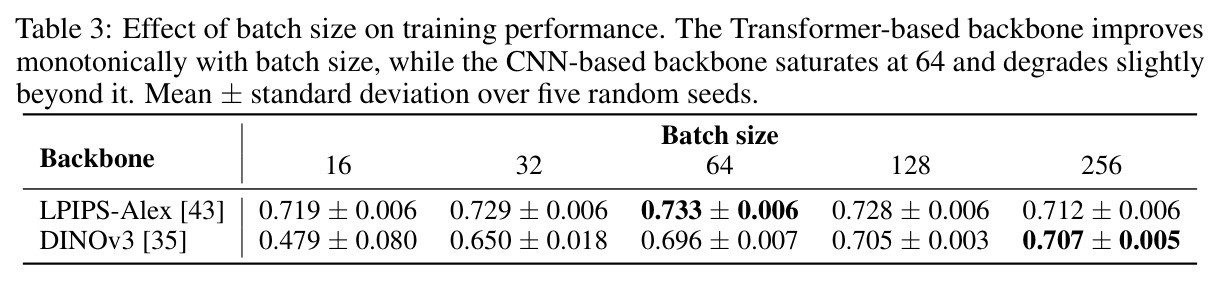
新颖性体现在三个层面。第一,把\u201c生成过程即标注器\u201d的想法第一次系统化地用于 IQA:Decatur 等人只用轨迹分叉做共享计算或结构化数据增广,FoMo 把分叉时刻提升为经过人类实验校准的距离标签,用生成过程替代了人工标注这一环节。第二,实证基础扎实:单参考实验测得人类排序与分叉时刻的 Spearman 相关 0.970(30 名被试、190 张图、1,982 次作答),跨参考 2AFC 实验个体一致率 90.2%、Fleiss' $\kappa=0.82$,且当两对标签差距超过 20 步时,与多数派共识及 LPIPS/DISTS/DreamSim 四个成熟指标的一致率均超过 99%,说明该标签是全局一致而非仅参考图内单调的。第三,工程上证明了可扩展性:仅用 10k 对(约主实验 2% 的数据量)训练,任何生成器都能超过最好的人工标注基线,且 DINOv3 骨干随 batch 从 16 到 256 单调提升(0.479 到 0.707),暗示更大的模型与批量还有红利可挖。
实验结果
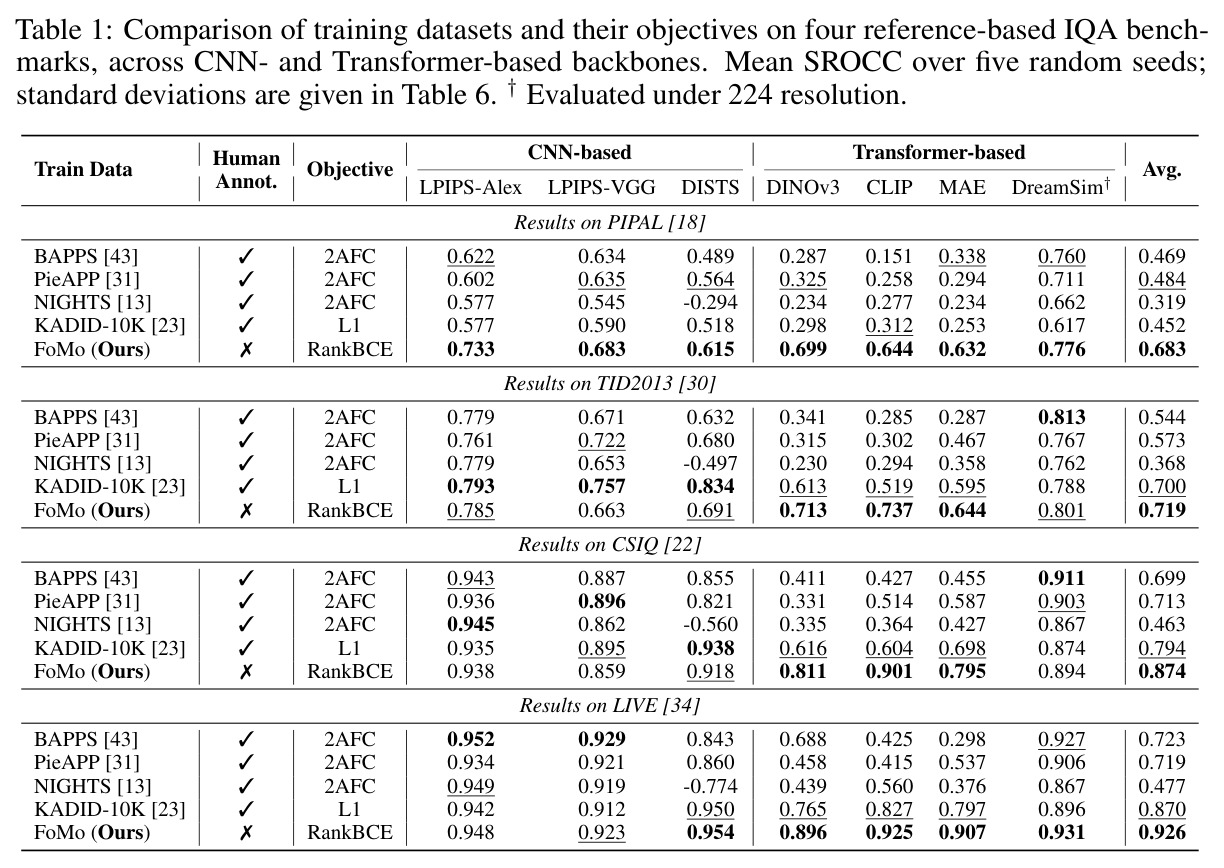
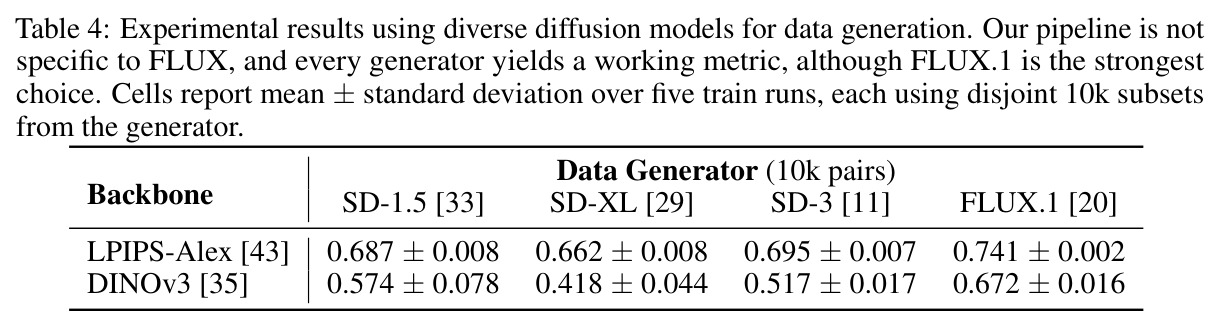
证据链分三层。人类验证:单参考实验中 30 名被试、190 张 ImageNet 图、1,982 次排序作答与分叉时刻的 Spearman 相关达 0.970;跨参考 2AFC 实验 250 题、5,713 次作答,个体一致率 90.2%($\kappa=0.82$),共识一致率 92.8%,按标签差距从 64.3%(1-10 步)单调升至 99.8%(41-50 步)。大规模验证:2 万对池化排序上,标签与 LPIPS-Alex/VGG、DISTS、DreamSim 的 SROCC 分别为 0.932、0.915、0.904、0.904。主结果(平均 SROCC):PIPAL 上 FoMo 达 0.683,超最好基线 PieAPP 的 0.484,七骨干全部第一(DINOv3 0.699 对 0.287);TID2013/CSIQ/LIVE 上 0.719/0.874/0.926,分别超 KADID-10k 基线 0.700/0.794/0.870。消融:RankBCE 优于 2AFC 与 L1(0.733/0.592/0.440);仅 10k 对训练即可超人工标注基线。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 参考型 IQA(PIPAL 基准,7 骨干平均) | SROCC | 0.683(FoMo + RankBCE,无人工标注) | 0.484(PieAPP + 2AFC,最好人工标注基线) | +0.199,且七个骨干全部第一,Transformer 骨干提升最大(DINOv3 0.699 对 0.325) |
| 参考型 IQA(TID2013 基准,7 骨干平均) | SROCC | 0.719 | 0.700(KADID-10k + L1);PieAPP 为 0.573 | +0.019(对比最强人工标注基线 KADID-10k) |
| 参考型 IQA(CSIQ 基准,7 骨干平均) | SROCC | 0.874 | 0.794(KADID-10k + L1) | +0.080 |
| 参考型 IQA(LIVE 基准,7 骨干平均) | SROCC | 0.926 | 0.870(KADID-10k + L1) | +0.056 |
| 跨参考感知排序(人类 2AFC 共识) | 一致率 / Fleiss' kappa | 总体一致率 92.8%,kappa=0.82;差距>20 步时 100% | 标签差距 1-10 步的窄区间内仅 64.3%(且人类自身一致率也仅 75.4%) | 证明分叉时刻是跨参考图全局一致的距离标签 |
局限与改进
作者与读者都能看到的局限:其一,标签质量受生成器能力制约,跨模型实验显示换用 SDXL 时 DINOv3 骨干 SROCC 仅 0.418,说明强生成器(FLUX.1)并非可有可无,方法隐含对生成模型保真度的依赖;其二,分叉产生的失真本质是\u201c部分加噪再重建\u201d式失真,与真实 JPEG 压缩、模糊等物理失真的分布不完全重合,CNN 骨干在 CSIQ/TID2013 上只与基线持平而非全面领先;其三,两对标签差距小于约 20 步时排序接近随机(人类一致率仅 64.3%、Fleiss' $\kappa=0.50$),标签分辨率存在下限,近邻区域的监督信号弱;其四,Transformer 骨干对 batch 大小敏感(16 时 DINOv3 仅 0.479 且标准差达 $\pm 0.080$),RankBCE 的 $O(B^2)$ 计算也随批大小增长;其五,噪声调度假设 $t$ 与感知距离单调对应,跨不同调度或分辨率时需用 $t$ 而非步数 $s$ 作标签,论文在附录中用分辨率方差解释但未给出理论保证。
独立分析的弱点
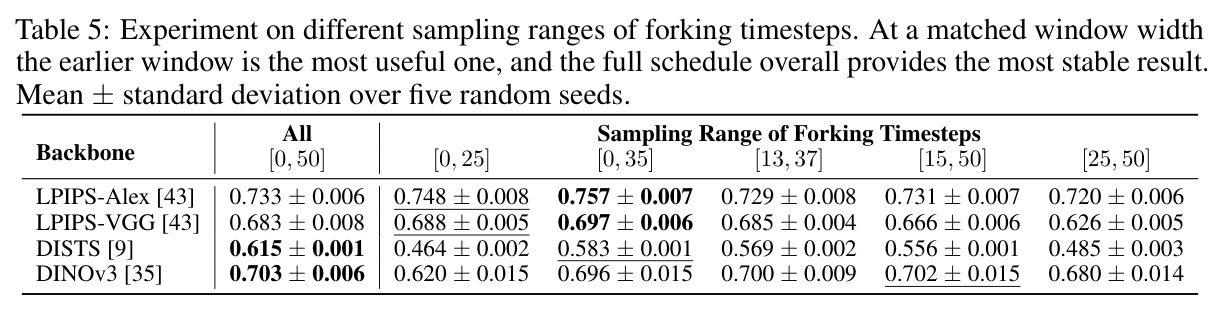
独立分析几点弱点并给出改进方向。第一,标签的单调性假设建立在 FLUX 特定噪声调度上,若换用调度高度非线性的模型,$t$ 与感知距离的映射可能弯曲,改进方向是为每个生成器拟合一个感知校准函数,例如用小规模人工标注回归 $t$ 到 MOS 的单调映射。第二,均匀采样 $s\sim U[0,49]$ 忽略了时间步感知重要性的不均匀性——表 5 显示最后 15 步几乎不携带感知信息却在训练中引入噪声(LPIPS 系去掉后反而提升到 0.757),改进方向是按信息量重加权采样或直接剪枝尾部时间步。第三,小差距标签不可靠且无法自行检测,可引入双样本一致性估计,或对同一参考在多个随机种子下分叉、用标签方差作为置信度在训练时加权。第四,失真集中于自然图像统计,对屏幕内容、医学影像等域外数据未测试,可按目标域替换参考图池做定向生成。第五,$O(B^2)$ 的批内比较受显存限制,可用分层采样、梯度检查点或跨 batch 记忆库近似扩展有效比较规模。
未来方向
可直接延伸的方向包括:把 FoMo 标签用作图像复原(超分、去噪、修复)模型的感知损失或奖励信号,替代以 LPIPS 微调的传统做法;扩展到视频质量评估(在时间维上分叉)和文生图对齐度量(把提示条件加入共享轨迹后再分叉);把生成式标签与少量人工标注融合,用半监督方式校准域偏移与失真类型差距;探索更大 batch、更大骨干的扩展规律(论文已显示 DINOv3 从 batch 16 到 256 单调增益且未饱和);以及在 RLHF/DPO 式偏好优化中用分叉时刻自动构造偏好对,省去昂贵的人类偏好数据收集。此外,分叉时刻本质上是一个\u201c可控失真强度\u201d的连续旋钮,也可反过来用于生成失真感知的数据增广、鲁棒性基准,或为生成模型本身提供感知层面的评估工具。
复现评估
复现条件较好。代码已开源(github.com/JHLew/FoMo),数据生成完全自动化、无需任何人工标注基础设施,标签生成只需 FLUX.1-dev 权重(HuggingFace 门控需申请)与常规 GPU 推理。训练门槛低:全部主实验在单张 NVIDIA RTX A40 上约 240k 次迭代完成,特征提取器冻结、只训练预测头(DreamSim 例外用 LoRA),论文报告 5 个随机种子的均值并给出标准差,结果可信。需要注意的成本点是 480k 对数据的生成量(FLUX 50 步采样共 48 万次),以及 RankBCE 的 $O(B^2)$ 显存开销(消融最大到 batch 256)。消融覆盖了标签类型、目标函数、batch 大小、生成器选择与采样范围,超参在正文和附录中均有明确说明,总体复现难度中等偏低。
论文图表
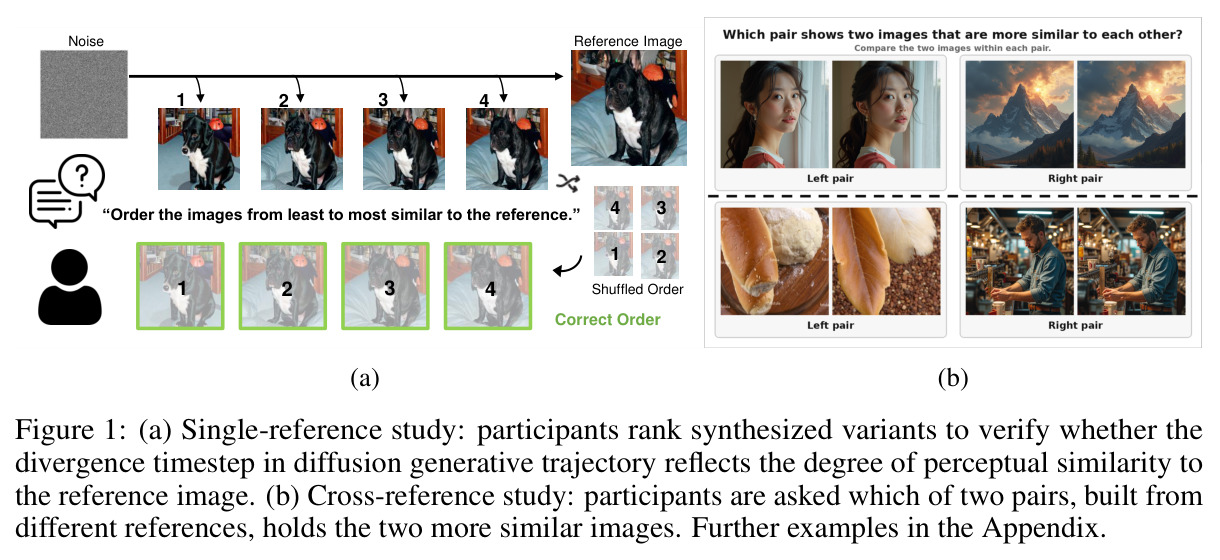
图 1 展示了两轮人类实验的问卷形式。(a) 给出一张参考图与其五个不同分叉时刻的变体,要求被试从最不相似到最相似排序,用于验证分叉时刻与感知相似度的对应关系;(b) 给出由两张不同参考图各构建的一对图像,以严格 2AFC 形式询问哪一对内部更相似,用于检验标签的全局一致性。
论文的核心主张是“分叉时刻可以当感知距离”,这张图解释了验证这一主张的实验设计。没有这两轮实验,后续把 $t_s$ 当监督信号的整个方法就缺乏经验基础;它也是理解 0.970 Spearman 相关与 90.2% 一致率这些关键数字的入口。