学会学习一门语言 Learning to Learn a Language
仅凭合成非语言先验预训练的300M字节级模型,以冻结权重在上下文中学会真实语言与数字规律
前置知识
先验拟合网络(Prior-Fitted Networks, PFN)
一种元学习范式:先人工设计一个任务分布(先验),从其中独立采样海量任务预训练一个神经网络;训练完成后,网络面对真实数据时等价于对该先验做摊销贝叶斯推断——不做任何梯度更新,仅靠前向传播就从上下文中推断出当前任务并给出预测。该配方最初用于表格分类与回归,后扩展到函数类回归、生存分析等场景。
PFLM 就是把 PFN 配方第一次搬到语言域:先验从函数类换成'合成语言族',理解 PFN 才能理解为什么一个从不见真实文本的模型也能在上下文中学会预测语言。
结构因果模型(SCM)
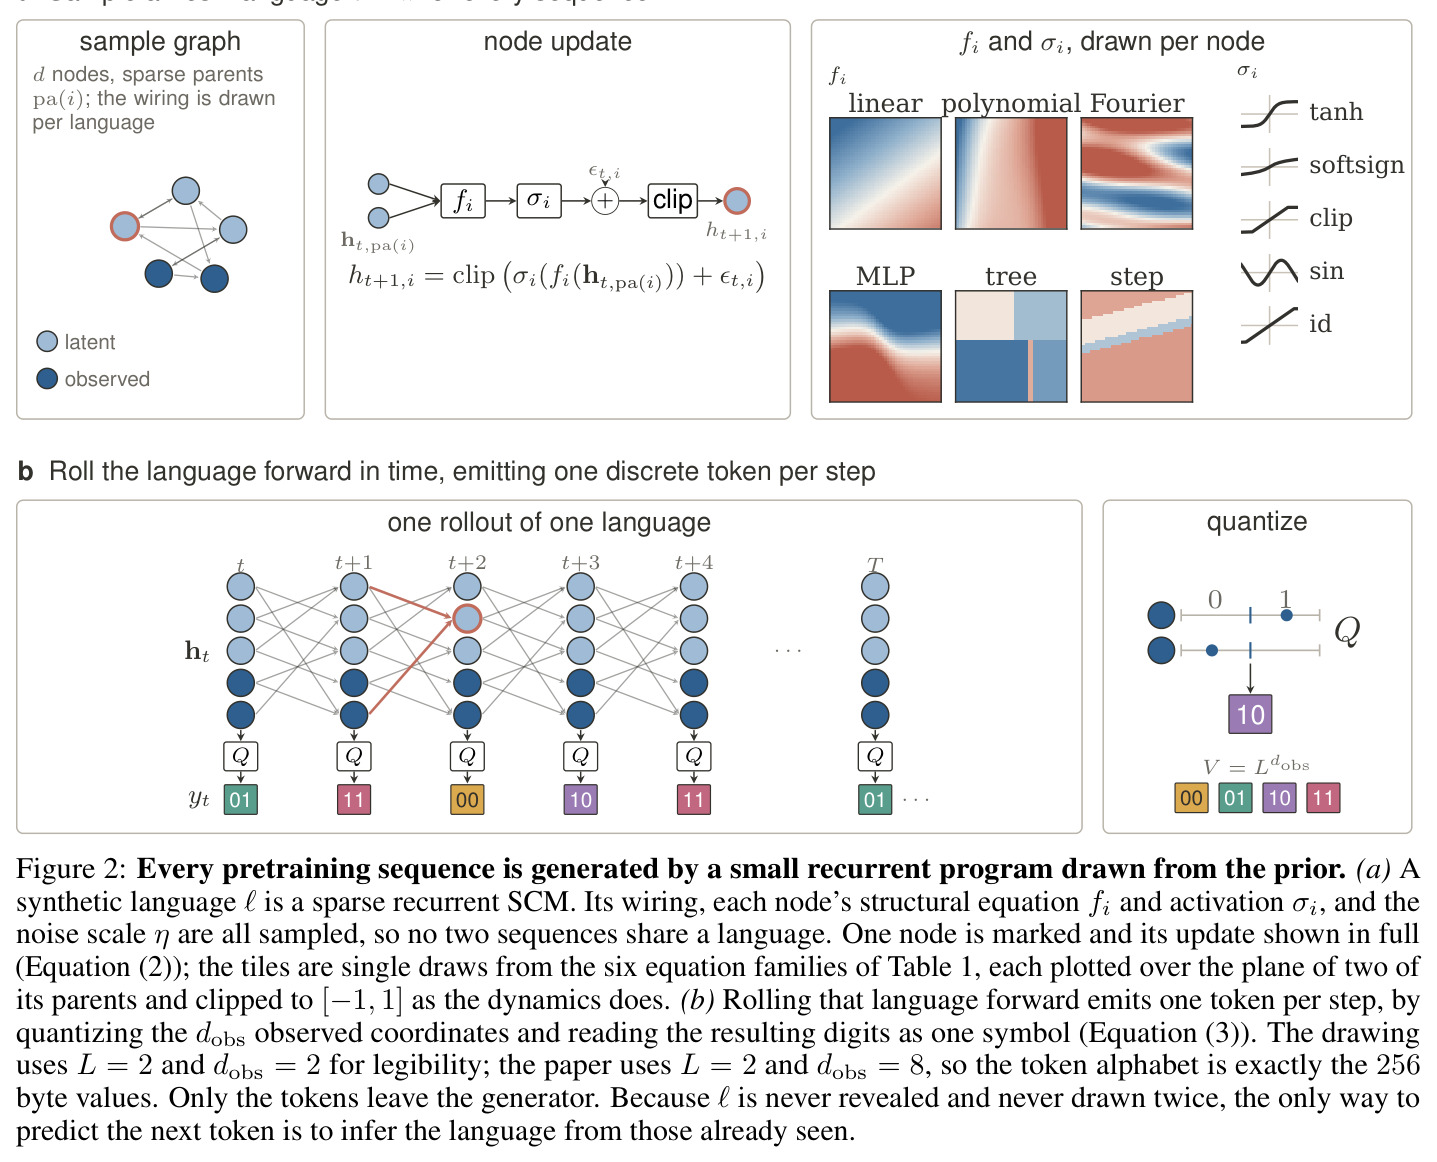
由一组结构方程构成的生成模型:每个变量由其父变量的函数加噪声决定,依赖关系由有向图刻画。本文用它构造合成'语言'——$d$ 个潜在节点按 $h_{t+1,i} = \mathrm{clip}(\sigma_i(f_i(h_{t,\mathrm{pa}(i)})) + \epsilon_{t,i})$ 随时间演化,图结构、方程族、激活函数、噪声尺度全部随机采样,一门'语言'就是先验的一次采样结果。
合成语言的具体构造是论文方法的核心,全部统计性质(齐普夫频率、慢熵率收敛、长程互信息衰减)都源自这个随机动力系统的设计选择,读懂它才能读懂方法章节。
上下文学习(ICL)及其贝叶斯解释
上下文学习指 transformer 不更新权重、仅凭提示中的前缀示例就完成新任务的能力。理论工作将其形式化为对隐变量(任务或语言 $\ell$)的隐式贝叶斯推断:模型内部维护后验 $p(\ell \mid y_{<t})$,随前缀增长而逐渐集中到真实生成源上,预测变成后验加权的平均预测。
PFLM 是这一理论的干净测试床:先验结构完全已知且不含任何真实语言,模型的全部上下文能力只能来自对先验的摊销推断,因此能严格检验贝叶斯解释。
熵率收敛与互信息衰减
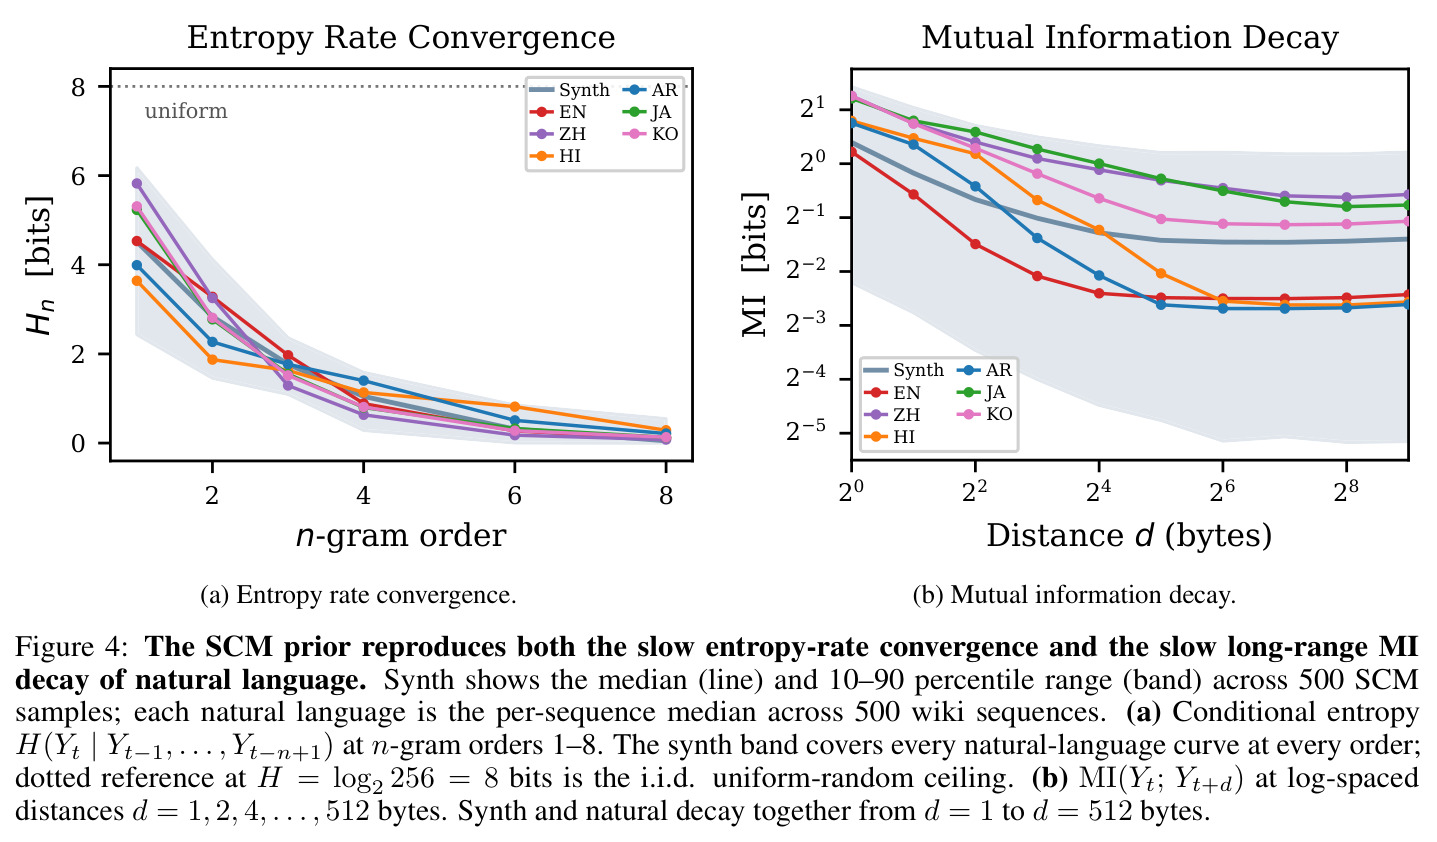
熵率 $H(Y_t \mid Y_{t-1},\ldots,Y_{t-n+1})$ 衡量给定 $n$ 阶上下文后每个符号的剩余不确定性,自然语言的特点是随 $n$ 增大下降缓慢(每增加一阶上下文剥离不到一比特);互信息 $MI(Y_t; Y_{t+d})$ 随距离 $d$ 衰减极慢且不归零,反映长程依赖。这两条曲线是区分自然文本与简单随机过程(i.i.d.、马尔可夫链)的统计指纹。
论文靠这两条曲线验证 SCM 先验与自然语言落在同一统计邻域,这是'先验合格'的核心证据,也是 Figure 4 的全部内容。
bits per byte(BPB)与逐符号比特数
逐字节/逐符号的对数损失:模型对真实数据每个字节(或符号)分配的平均信息量。均匀随机的字节流是 8 bits/byte($\log_2 256$),二进制序列的机会水平是 1 bit/symbol;数值越低说明模型从上下文中提取的规律越多,且与压缩率直接等价,因此可以直接拿 gzip、PPMd 等压缩器当基线。
论文所有主结果——六种语言、数字推理、确定性序列、六个非文本压缩领域——都用这一指标家族报告,它是贯穿全文衡量 in-context 学习成效的统一标尺。
研究动机
现代语言模型的训练范式依赖海量真实文本——GPT-3 级别的模型消耗数十万亿 token,而儿童只需接触数千万词的语音就能流利掌握母语,两者相差约六个数量级。作者指出这一差距的本质不是关于语言的事实,而是关于双方带入数据的先验知识量的差异:人类儿童的先验不是某门具体语言,而是对'任何语言可能是什么样'的预期,其假设空间被进化约束在人类语言占据的有界区域内;而现代语言模型的归纳偏置只是架构层面的平滑性与组合性压力,对语言本身的形态一无所知,所有规律都必须从语料中自行推断。这导致模型在一类人类轻松完成的推理上滞后:婴儿能从周围语音习得语言,儿童天生具备数量感并逐步学会数数、比较与近似加法,数学家能从数列前几项识别生成规则——这些能力都建立在关于语言、数字或序列'可能是什么'的结构化先验之上,而当前模型要么没有,只能从数万亿 token 里硬学。
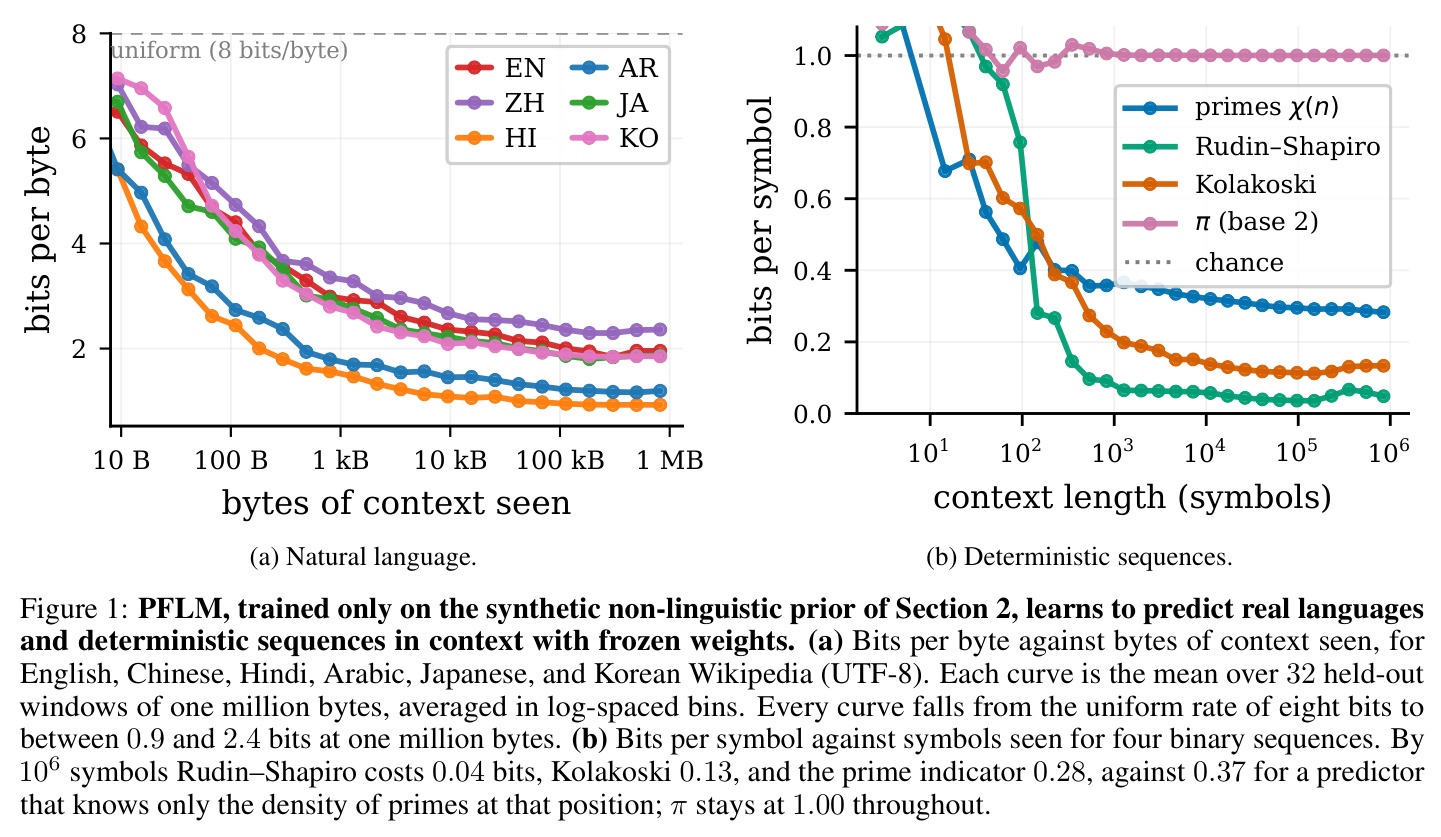
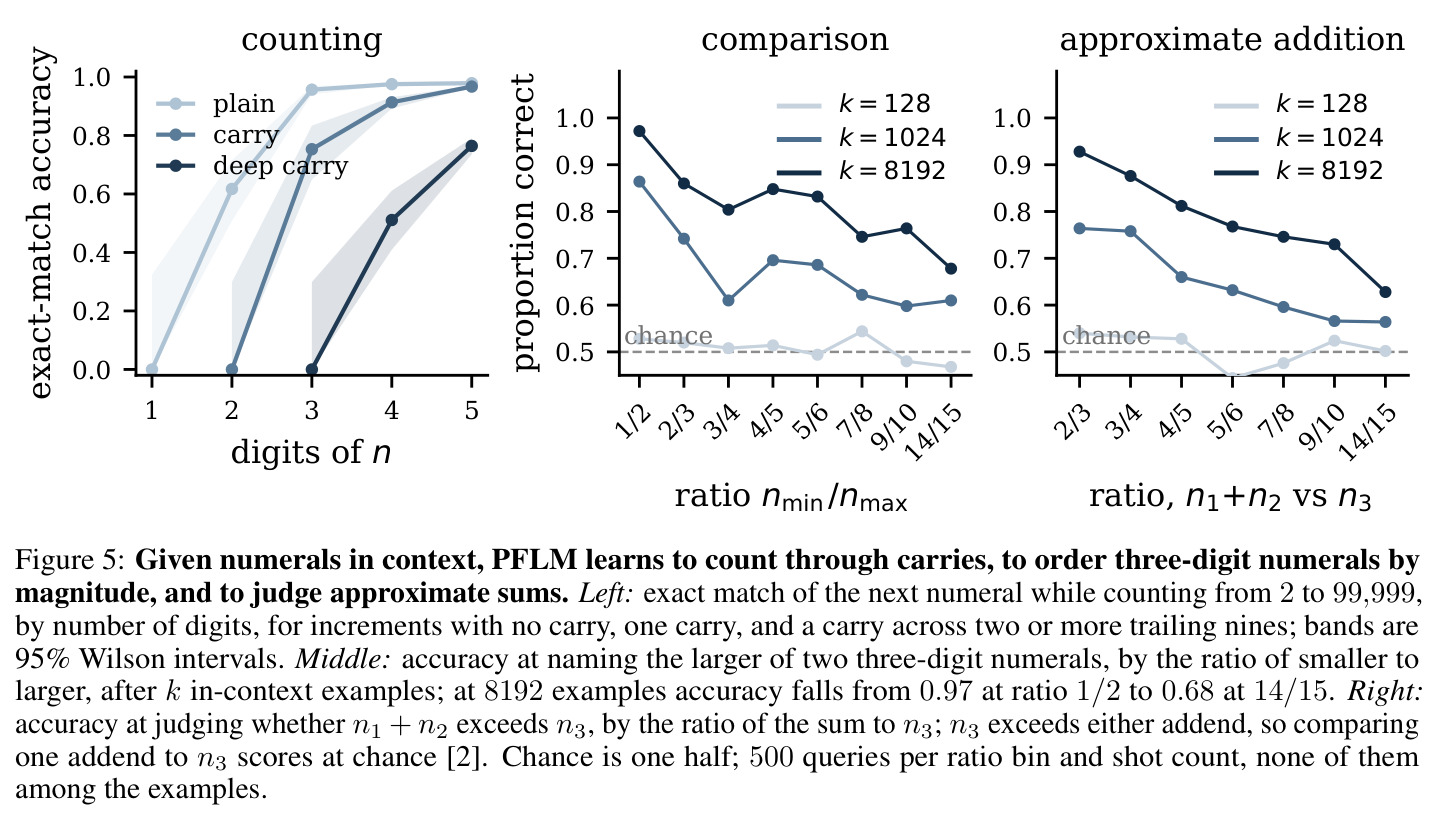
本文的目标是论文的目标是验证一个大胆命题:一个语言模型能否完全不从任何真实文本学习,仅通过在'可能语言的分布'上做预训练,就获得在上下文中习得全新语言的能力。具体而言,作者要构造一个覆盖合成语言家族的先验 $\pi$,使每条预训练序列来自独立采样的新'语言',模型在训练中从不重复见到同一门语言,从而在构造上被迫学会'如何获取语言'而非记住任何一门语言。在评估端,论文要求该模型在权重完全冻结的条件下完成四件事:(1) 在六种语言的维基百科上随上下文增长稳定降低逐字节预测代价;(2) 从数字上下文中学会数数(含进位)、三位数比较与近似加法;(3) 预测 Rudin–Shapiro、Kolakoski、素数指示等由生成规则而非频率定义的确定性序列;(4) 在源码、分子、蛋白质、DNA、音乐、语音六个非文本领域上压缩率优于 gzip 与 PPMd。
与已有工作不同的是,本文的独特切入是把 PFN 配方第一次完整搬到语言域,并与四条相关工作路线明确切割。TinyStories 与 Textbooks Are All You Need 虽用合成数据,但合成的仍是'自然语言文本'(以 GPT 生成的真实语言为蓝本);McCoy 与 Griffiths 把贝叶斯形式语言先验通过元学习蒸馏进网络,但之后仍在真实英语上训练;Grau-Moya 等人的 Learning Universal Predictors 用通用图灵机上的随机程序先验逼近 Solomonoff 普适先验,追求普适性而非面向特定领域的迁移;BabyLM 挑战保留真实数据、只把规模压到儿童的 10M 或 100M 词预算。PFLM 的先验既不与文本共享内容、也不共享语法,只共享统计特征——作者明确指出,此前没有任何工作证明只见过非语言合成序列的模型能在上下文中预测自然语言。
核心方法
直觉:与其教模型一门语言,不如教它'语言的普遍统计形态',再用海量新鲜语言逼它练成'见前缀、推规则'的能力。技术路线分三步。第一步构造先验:一门合成'语言' $\ell = (G, \{f_i\}, \{\sigma_i\}, \{\rho_i\}, \eta, Q)$ 是小型循环结构因果模型——$d$ 个潜在节点组成稀疏有向图,状态按 $h_{t+1,i} = \mathrm{clip}(\sigma_i(f_i(h_{t,\mathrm{pa}(i)})) + \epsilon_{t,i})$ 更新(当 $\rho_i(t)=1$,否则保持),每步把前 $d_{\mathrm{obs}}=8$ 个坐标量化为一个字节,取 $L=2$ 档、$V = L^{d_{\mathrm{obs}}} = 256$,词表恰好等于原始字节。第二步采样数据:每条序列从 $\pi$ 独立抽一门新语言,滚动动力学 $T$ 步发射字节流。第三步训练:300M 参数字节级 decoder-only transformer,门控线性注意力与注意力层按 3:1 混合(类似 Qwen3-Next),注意力限制在 $2^{18}$ token 滑窗内,分六阶段把上下文从 $2^{10}$ 增到 $2^{20}$,共 1500 亿 token。理论最优预测器是后验预测分布 $p^\star(y_t \mid y_{<t}) = \int p(y_t \mid y_{<t}, \ell)\, p(\ell \mid y_{<t})\, d\ell$,网络学的就是它的摊销近似。
核心创新是把'防记忆'设计进训练任务本身:每条序列来自从未见过、也永不再见的新语言,模型的唯一出路是从前缀推断出生成该序列的语言再预测后续,下一个词预测因此在构造上就是贝叶斯推断——后验 $p(\ell \mid y_{<t}) \propto \pi(\ell)\, p(y_{<t} \mid \ell)$ 随前缀增长集中到真实生成语言上。与 Grau-Moya 等的本质区别在先验选择:他们用通用图灵机上的随机程序逼近 Solomonoff 普适先验,问的是 transformer 能否逼近通用归纳;本文用领域定向的 SCM 先验,问的是定向先验能否迁移到训练中完全缺席的特定自然域。与 McCoy–Griffiths 的区别是本文先验不含任何语言、只有一般动力学,且网络从不见真实文本。另一个关键设计是多速率发射调度 $\rho_i$:节点按 2 的幂次速率(每 1、2、4、8…步)周期性更新,消融实验显示若固定所有 $\rho_i \equiv 1$,四个标量指纹不变但长程互信息积分下降 18%——慢节点的细尾正是携带跨多步依赖的载体。
方法步骤详情
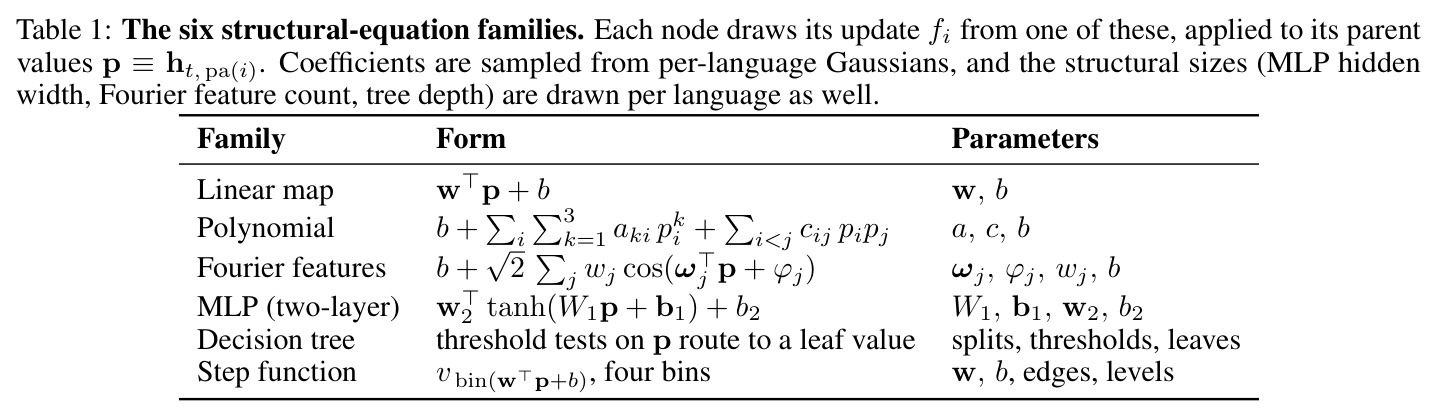
(1) 采样语言:逐节点构建稀疏图,父集大小从每语言范围均匀抽取;每个节点的结构方程 $f_i$ 从六族中抽取——线性映射、多项式、傅里叶特征、两层 MLP、决策树、四档阶梯函数——系数来自按语言采样的高斯;激活 $\sigma_i$ 从 {tanh, softsign, clip, sin, id} 抽取;发射速率 $\rho_i$ 为周期调度,速率 $r_i \in \{1, 2, 4, \ldots\}$ 服从偏向'多数节点每步发射、少数慢节点成几何细尾'的分布,相位 $\phi_i$ 均匀抽取以错开同速率节点;噪声 $\eta$ 与深度 $K$ 按语言采样。(2) 生成序列:从六族初始化分布(子区间均匀、高斯、Beta、近 ±1 两点、双峰、稀疏)抽 $h_0 \in [-1,1]^d$,滚动 $T$ 步,每步将前 8 个坐标经有限标量量化各分 2 档、混合基编码为一个字节。(3) 训练:150B token 分六阶段(20/60/40/15/10/5 B),上下文从 $2^{10}$ 逐阶段增到 $2^{20}$,每阶段从前一阶段初始化,NorMuon 优化器加 warmup-stable-decay 学习率。(4) 评估:权重冻结,在真实数据上测 BPB、数字任务准确率、二进制序列每符号比特数。
技术新颖性
技术新颖性体现在四个层面。第一,证明'语言习得能力'可以从零真实数据中学得:此前所有语言模型——无论课程多么合成——都在自然语言上训练过,PFLM 是首个只用构造性非语言先验就在上下文中学会预测自然语言的模型。第二,先验设计是'构造而非拟合':不做分布匹配优化,只保证样本与自然文本落在同一统计邻域(齐普夫频率、慢熵率收敛、多尺度互信息衰减),这使先验可解释、可消融——例如长程依赖被明确归因到多速率发射调度(去掉后长程 MI 积分降 18%)。第三,字节级词表 $V=256$ 的选择让合成流与 UTF-8 文本天然同域,无需任何映射或特殊处理,模型结构上无需区分训练与评估分布。第四,混合架构(3:1 的门控线性注意力与 $2^{18}$ 滑窗注意力)使百万字节上下文的训练在亚二次复杂度下可行:线性层以循环状态携带跨序列信息,注意力层提供窗内精确召回,与'从长前缀中过滤出隐状态后验'的任务需求严丝合缝。
实验结果
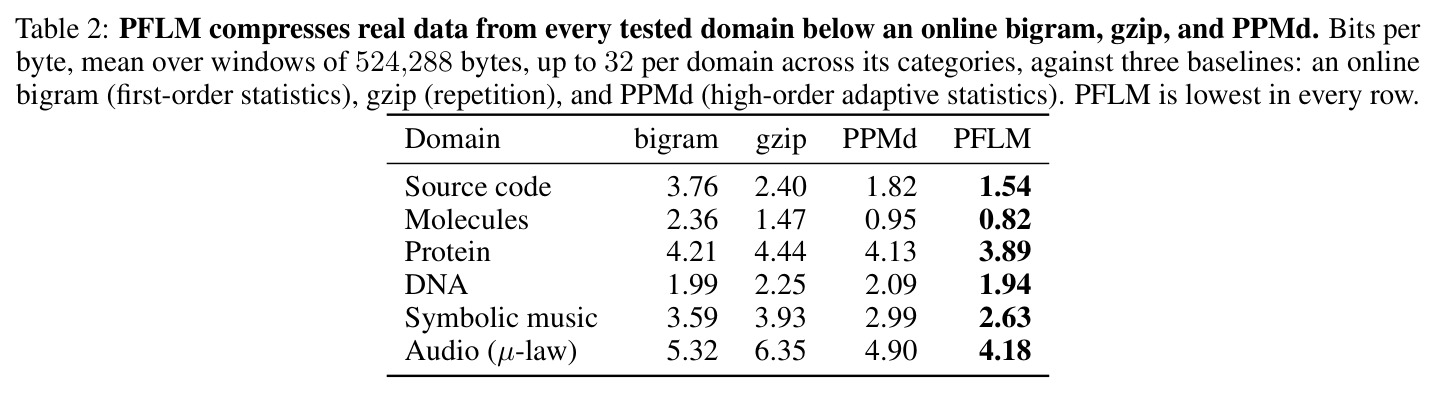
单一模型、单一份权重,四类评估全部成功。(1) 自然语言:在英、中、印地、阿拉伯、日、韩六语维基百科上,每条曲线在 100 万字节上下文内从均匀的 8 bits/byte 降到 0.9–2.4 bits/byte;语言间差异主要来自 UTF-8 编码成本(拉丁 1 字节、阿拉伯 2 字节、汉日韩与天城体 3 字节)。(2) 数字推理:数数时无需进位可精确到三位数,进位晚一位、跨尾九进位晚两位;8192 个示例下三位数比较准确率从比值 1/2 时的 0.97 降到14/15 时的 0.68,复现 Moyer–Landauer 距离效应;判断 $n_1+n_2 > n_3$ 的准确率从 0.93 降到 0.62,且在三者位数相同、无长度线索时依然如此,是儿童近似数感的定量特征。(3) 确定性序列:百万符号处 Rudin–Shapiro 每符号 0.04 bits、Kolakoski 0.13、素数指示 0.28(低于只知密度 $1/\ln n$ 的预测器的 0.37),而 π 的二进制位始终停在 1.00——可计算但前缀不泄露规则。(4) 压缩:六领域全部击败online bigram、gzip 与 PPMd,源码 1.54 对 PPMd 的 1.82,分子 0.82 对 0.95,音频 4.18 对 4.90,优势在音频与音乐最大、DNA 最小。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 自然语言预测(六语维基百科,100万字节上下文) | bits per byte | 0.9–2.4 bits/byte(随上下文从8持续下降) | 均匀随机 8 bits/byte | 降低约70%–89% |
| 源代码压缩 | bits per byte(52.4万字节窗口) | 1.54 | PPMd 1.82 / gzip 2.40 / online bigram 3.76 | 比最优基线PPMd低15.4% |
| 分子(SMILES)压缩 | bits per byte | 0.82 | PPMd 0.95 / gzip 1.47 / bigram 2.36 | 比PPMd低13.7% |
| 音频(8-bit µ-law语音)压缩 | bits per byte | 4.18 | PPMd 4.90 / gzip 6.35 / bigram 5.32 | 比PPMd低14.7% |
| 符号音乐(MIDI)压缩 | bits per byte | 2.63 | PPMd 2.99 / bigram 3.59 / gzip 3.93 | 比PPMd低12.0% |
| Rudin–Shapiro 序列预测 | bits per symbol(100万符号处) | 0.04 | 机会水平 1.00 | 降低96% |
| 素数指示序列预测 | bits per symbol(100万符号处) | 0.28 | 只知素数密度 $1/\ln n$ 的预测器 0.37 | 低0.09 bits/符号 |
| 三位数大小比较(k=8192个示例) | accuracy | 0.97(比值1/2)→ 0.68(比值14/15) | 随机猜测 0.50 | 在最大难度比值下仍高出0.18 |
局限与改进
作者承认的最大局限是上下文长度与最终性能:训练上下文 100 万字节约合 20 万英文词,在该长度上维基百科的预测仍显著落后于在数万亿 token 上训练的现代 LLM——上下文学习的天花板直接受限于上下文窗口。此外我观察到几点:其一,六语评估全部使用维基百科,论文未报告与现代 LLM 在同一语料、同一指标下的定量对比,'差距有多大'只有定性陈述;其二,Figure 3 所示统计指纹比较用的先验配置是'与自然语言统计最匹配的族',而训练配置按'向自然语言的迁移效果'选择,评估域信息以间接方式进入了先验设计环节;其三,数字任务只覆盖三位、四位数(2 到 99,999),未测试更大数值、多位精确加法或乘法;其四,压缩基线只有通用压缩器(online bigram、gzip、PPMd),未与领域专用模型或小型神经压缩器比较,'全面最低'的口径较窄;其五,论文未报告训练消耗的 GPU 时,150B token 虽远小于 LLM 预训练,但对'零真实数据'的卖点而言成本并不透明。
独立分析的弱点
独立分析几个弱点。(1) 统计邻域匹配是必要非充分条件:Figure 3 显示 SCM 先验在字节熵、gzip 压缩率、齐普夫指数、活跃字节数四个标量指纹上与自然语言重叠,但标量统计重叠不代表句法结构、语义组合等规律可被捕获——模型学到的可能只是'通用条件结构预测器'而非语言习得机制,改进方向是加入句法探针评估(主谓一致、嵌套依赖、长距依存)。(2) 后验集中依赖前缀信息量:噪声 $\eta > 0$ 保证 $\pi$ 对任意有限序列赋正概率、后验预测对任意前缀良定义,但对退化、对抗或分布外前缀,后验可能集中在错误的'语言'上且无法恢复,值得研究在线先验重加权或后验修正机制。(3) 消融只覆盖 $\rho_i$ 单一成分:六族方程、五种激活、图密度、深度 $K$ 对迁移质量各自的贡献未做系统归因,改进方向是成分级消融找出产生'语言性'的最小充分配置。(4) 熵率分析只到 8 阶 n-gram:自然语言的依赖远超 8 字节,模型在百万字节上下文中实际利用了多深的长程结构未量化,可用受控探测序列测量有效上下文利用长度。
未来方向
作者提出两条最值得投入的方向:一是把该先验用于数据稀缺域——低资源语言、未破译文字、动物通信,这些场景恰好没有万亿级语料可用,而 PFLM 证明了结构化先验可以替代数据;二是真实文本与先验样本联合预训练,用先验增强常规 LLM 的上下文学习能力。基于本文成果还可延伸:(1) 规模化研究——上下文从 $2^{20}$ 提到 $2^{24}$ 以上、参数从 300M 扩到数十亿,绘制 PFLM 范式自身的 scaling law,回答先验知识随规模如何折算;(2) 先验替换实验——把 SCM 换成程序、语法或动力系统族等其他结构化先验,检验'统计邻域匹配'假说的普适性与最小充分条件;(3) 认知科学建模——PFLM 的数感模式(距离效应 0.97→0.68、近似加法 0.93→0.62)与儿童行为数据定性一致,可做定量对齐,为'进化给先验、经验填参数'提供计算模型;(4) 神经压缩——PFLM 在六个领域超过 PPMd,可作为通用压缩器的在线预测组件;(5) ICL 理论实验台——先验结构完全已知,可严格检验'上下文学习即隐式贝叶斯推断'假说,例如直接测后验集中速度与预测精度的关系。
复现评估
复现条件较好。代码开源于 GitHub(github.com/cbl/prior-fitted-language-model),权重发布在 HuggingFace(hf.co/lennartcb/pflm1),附录 A 给出先验超参范围、附录 B 给出训练超参、附录 D 给出语料与评估协议。训练数据由程序采样生成,无需人工标注,理论上可无限再生;真实数据评估全部使用公开语料(维基百科、MIDI 钢琴演奏、蛋白质序列、SMILES 分子、细菌基因组、µ-law 语音)。主要门槛是算力:150B token、六阶段课程、300M 参数,估计需要数百至上千 GPU 时;SCM 采样器实现细节繁多(六族方程的参数分布、多速率调度、量化器、六族初始化),需仔细对照附录。难度中等偏高:从零训练需认真处理采样器的每个细节,但有了官方权重后,验证核心结果(BPB 曲线、数字任务、压缩表)只需推理算力,单卡消费级 GPU 即可复现全部评估表格。
论文图表
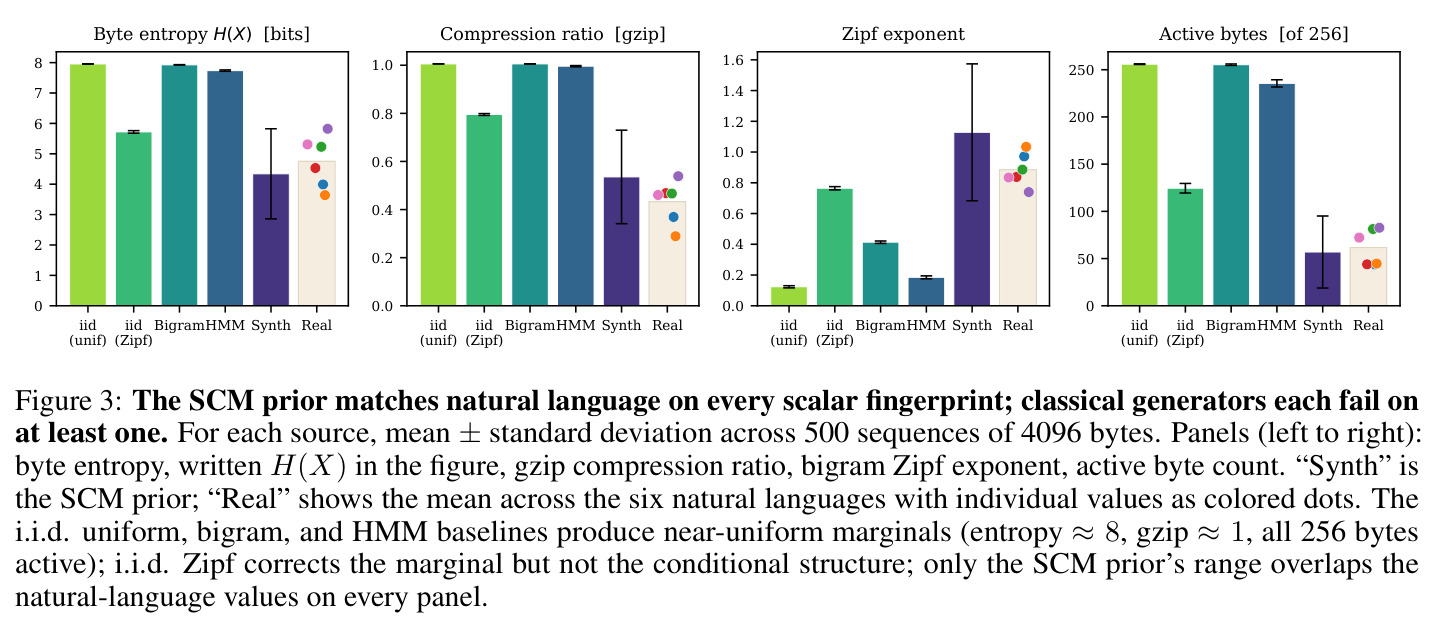
四个并排柱状/散点面板,对每类数据源(i.i.d. 均匀、i.i.d. Zipf、随机 bigram、随机 HMM、SCM 先验、六种自然语言)在 500 条 4096 字节序列上统计四个标量指纹:字节熵、gzip 压缩率、bigram 齐普夫指数、活跃字节数(每面板均值±标准差,自然语言为均值加彩色散点)。i.i.d. 均匀、bigram、HMM 的边缘分布近均匀(熵≈8、gzip≈1、256 字节全活跃);i.i.d. Zipf 修正了边缘但缺条件结构;只有 SCM 先验在全部四个面板上与自然语言的取值区间重叠。
这张图回答'为什么这个先验配得上叫语言的先验':它逐一排除朴素数据无关生成器,证明 SCM 先验与自然文本落在同一统计邻域,是先验设计合理性的直接证据。