超越语义相似度:面向复杂任务的智能体检索性能与成本研究 Beyond Semantic Similarity: Performance and Costs of Agentic Retrieval for Complex Tasks
ReAct智能体迭代调用稠密检索器探索语料,nDCG@10平均提升8.7分,代价是每查询107秒
前置知识
稠密检索
用双塔编码器把查询和文档映射为向量,通过余弦相似度 $\cos(\mathbf{q}, \mathbf{d})$ 在向量索引(如 ANN/Faiss)中选出 top-$k$ 文档。它一次编码、近线性检索,能在毫秒级筛查百万级文档,是 RAG 系统的标准检索组件;但相比 BM25 等稀疏检索,它完全依赖表面语义相似度,字面不相似但逻辑相关的文档会被漏掉。
本文所有对比的基线就是标准稠密检索,理解其『只看语义相似度』的本质,才能明白复杂任务为何失败、agent 的改进从何而来。
nDCG@10
Normalized Discounted Cumulative Gain,衡量排序质量的指标:$\text{DCG}@k = \sum_{i=1}^{k} \frac{2^{rel_i} - 1}{\log_2(i+1)}$,即位置越靠前、相关性越高的结果贡献越大,再除以理想排序的 DCG 做归一化(本文用 0-100 百分制),@10 表示只统计前 10 个结果。检索榜单普遍以它作为主指标。
论文的所有性能结论(平均提升 8.7 分、ViDoRe v3 的 69.22 对 64.36 等)全部以 nDCG@10 度量,不懂这个指标就读不懂实验部分。
ReAct 循环
Reasoning + Acting 的智能体范式:LLM 交替产出『思考』(推理、规划)与『行动』(工具调用),观察工具返回的结果后继续下一轮,直到给出最终答案。相比固定的 prompt 流水线,它让模型根据中间观察动态调整策略,且通过标准 JSON schema 工具调用实现,新增工具即可扩展能力。
NeMo Retriever Agent 的主体就是一个 ReAct 循环加三个工具(think/retrieve/final_results),这是理解方法部分必须掌握的框架。
RRF(倒数排名融合)
Reciprocal Rank Fusion,一种免调参的多排序列表融合方法:对文档 $d$ 计算得分 $\text{score}(d) = \sum_{r \in R} \frac{1}{k + \text{rank}_r(d)}$($k$ 常取 60),在某个列表中排名越靠前贡献越大。本文在 agent 出错(超出上下文窗口、内容违规)时,用它融合出错前各次搜索的排名列表,兜底产出最终排序。
这是论文可靠性设计的关键一环:检索 agent 比稠密检索器多了许多失败模式,理解 RRF 回退才知道失败时系统如何产出结果。
MCP 与进程内工具调用
Model Context Protocol 是向 LLM 暴露工具的标准协议,工具作为独立服务器进程运行,客户端经网络往返调用。但对检索 agent 这种『工具少、单工具调用极频繁』的场景,每次运行都要拉起服务器、把语料 embedding 载入 GPU、管理进程生命周期,网络往返还会给每次检索增加延迟,开销会复合累积。
论文用进程内线程安全单例检索器替代 MCP 服务器,这一基础设施决策是其吞吐与延迟优化以及工程贡献的核心,需要了解 MCP 才能体会其动机。
研究动机
现代信息系统(RAG、DeepResearch 等)普遍使用稠密检索处理海量非结构化数据,其核心假设是查询与文档在向量空间中的表面语义相似度,即通过余弦相似度 $\cos(\mathbf{q}, \mathbf{d})$ 选出 top-$k$ 文档。但在日益复杂的检索任务中这一假设失效:agent 拿到一道数学题,需要的却是可能有用的数学定理(如 BRIGHT 基准);检索工具规格说明需要真实系统的动力学知识;DeepResearch 需要迭代式探索。这些场景下查询与相关文档之间的表面语义相似度非常有限,纯相似度匹配找不到真正需要的内容。已有的改进方案(query rewriting、Query2doc、GenQREnsemble 等用 LLM 改写查询)本质上是静态流水线:LLM 改写一次查询后交给检索器就结束了,无法根据检索到的新信息动态调整后续搜索策略,限制了最终效果。
本文的目标是本文的目标是系统研究 agentic retrieval(智能体检索):把 LLM 的推理能力与稠密检索器的高效语料探索能力结合,让 agent 在 ReAct 循环中自主决定何时、用什么查询、调用多少次检索器,直到发现所有相关文档。作者围绕三个问题展开:(1) 有效性——在同样的 embedding 模型下,agentic retrieval 能比标准稠密检索提升多少 nDCG@10(答案:平均 8.7 分);(2) 泛化性——同一套流水线不做任何修改,能否同时在 ViDoRe v3(企业文档检索)和 BRIGHT(推理密集检索)两个异质基准上取得有竞争力的成绩;(3) 成本——相比 0.67 秒的标准检索,检索智能体在时延和 token 消耗上要多付出多少(答案:107.4 秒、76.4 万输入 token)。最终为检索智能体能否大规模部署给出实证依据。
与已有工作不同的是,本文的独特切入角度有三点。第一,与 query rewriting 等静态工作流不同,它把检索任务本身做成 agentic 的:不是让 agent 用标准检索去完成某个下游任务(如 DeepResearch 中的检索组件),而是造一个可复用的通用检索 agent,能作为许多下游系统的搜索组件。第二,作者不只报告性能,还系统量化成本——平均每查询 107.4 秒、76.41 万输入 token、5800 输出 token——这在检索文献中很少见,直指大规模部署的核心障碍,并指出检索成本模型从『由索引规模决定』变成了『由推理步数和 token 消耗决定』。第三,在工程层面发现 MCP(Model Context Protocol)对检索智能体这种少工具、多次调用的场景会带来复合开销(每次运行都要起服务器、加载 embeddings、网络往返),因而改用进程内线程安全单例检索器,这一 infra 层面的观察对智能体系统设计很有参考价值。
核心方法
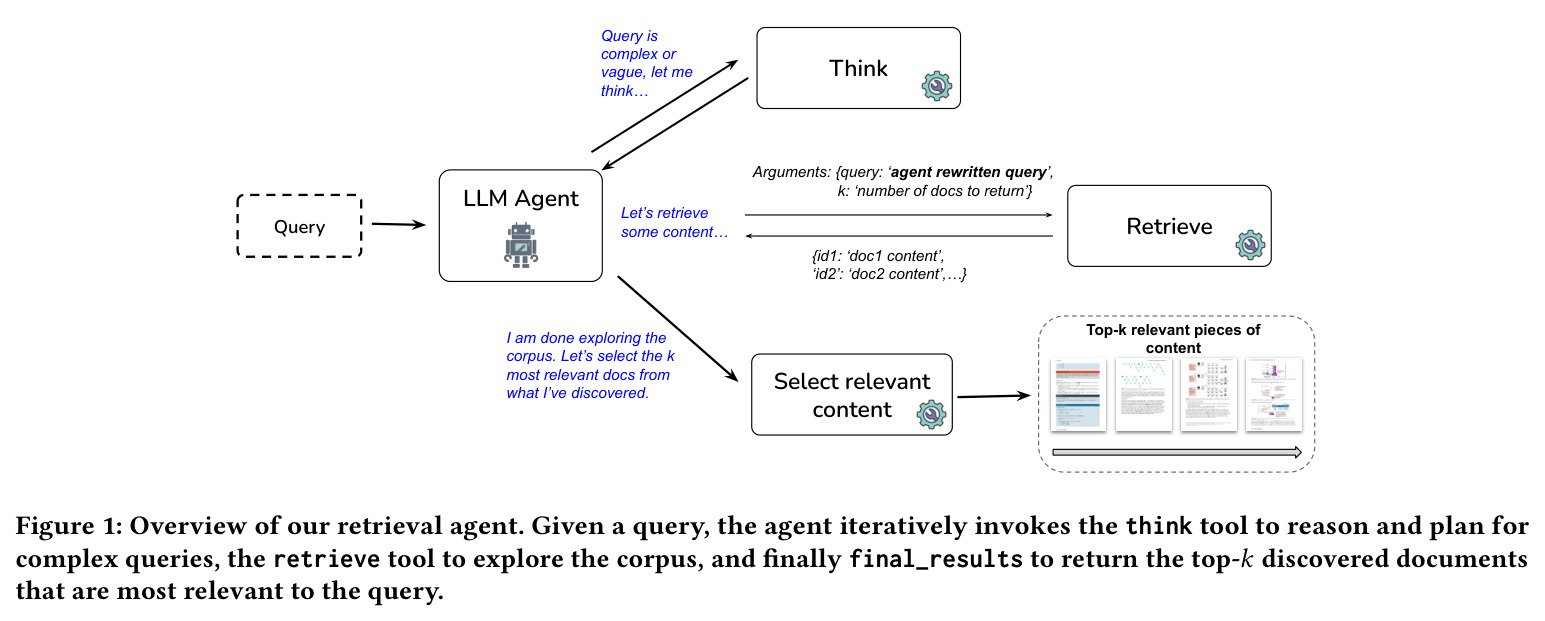
直觉上,LLM 拥有推理能力和世界知识但无法处理百万级文档,检索器能轻松筛查海量语料却缺乏推理能力,两者高度互补。NeMo Retriever Agent 用 ReAct 循环把二者缝合起来:系统提示说明任务目标是『发现所有相关文档』并逐个描述工具;第一条用户消息给出主查询,并附上稠密检索器对原始查询的初始检索结果——这既避免不必要的搜索尝试,更重要的是让 agent 提前理解语料类型(数学定理、函数描述等),从而调整搜索策略和后续查询。随后 agent 通过标准 JSON schema 工具调用在三个工具间循环:think 接收一个字符串参数用于推理和规划(无输出、不改变环境);retrieve 接收查询和整数 $k$,由稠密检索器返回 top-$k$ 文档内容及其唯一 ID;final_results 接收按相关性排序的 $k$ 个文档 ID 加选择理由,用于报告结果并终止交互。
核心创新在于动态自适应的搜索策略,这与静态流水线有本质区别。agent 每次拿到 retrieve 返回的文档后,可以细化查询、换角度重新表述、或把复杂的多部分问题拆解成多个目标明确的简单子问题——搜索策略由 LLM 根据已发现的信息在线决定,何时停止、搜索几次、用什么查询都不是预设的。论文总结了三种反复出现的成功模式:查询细化、持续改写直到找到有用信息、复杂度分解。相比『LLM 改写一次查询 + 检索器调用一次』的设计,这种闭环让同一个 embedding 模型被『用得更好』:同模型下平均提升 8.7 个 nDCG@10 点,且强弱 embedding 模型之间的性能差距被平均缩小 57%——说明 agent 的推理能力可以部分补偿小 embedding 模型的能力短板,这对为了扛住海量文档而不得不保持 embedding 模型很小的现实约束特别重要。
方法步骤详情
完整流程如下:(1) 输入查询 $q$,稠密检索器先用原始查询检索一次,结果放入首条用户消息,让 agent 了解语料类型;(2) agent 在 ReAct 循环中调用 think 生成推理 token、规划搜索策略,该工具无输出、不改变环境;(3) 调用 retrieve(query, k),底层稠密检索器对 query 与文档 embedding 计算余弦相似度并排序,返回 top-$k$ 文档内容与唯一 ID;(4) agent 根据返回内容决定继续搜索(细化/改写/分解查询)还是终止;(5) 调用 final_results 提交排序后的 $k$ 个文档 ID 及理由,数量不符会收到错误并重试。可靠性设计:若发生超出上下文窗口或内容违规等错误,回退到 RRF,对出错前每次搜索的排名列表用 $\text{score}(d) = \sum_r \frac{1}{k + \text{rank}_r(d)}$ 融合出最终分数。基建上用可重入锁保护的进程内线程安全单例检索器替代 MCP 服务器,embedding 只加载一次,同一接口可服务多个并发 agent。
技术新颖性
技术新颖性体现在四个层面。一是范式层面:把检索从『语义相似度的单次计算』升级为『由 LLM 推理驱动的迭代探索过程』,检索成本不再只由索引规模决定,还由推理步数和 token 消耗决定,这是对检索成本模型的重构。二是评测层面:首次系统给出检索智能体在两个异质基准(ViDoRe v3 跨 6 种语言 10 个领域的企业文档、BRIGHT 逻辑推理/代码/数学等推理密集文本)上的统一流水线成绩,并用 BRIGHT 榜一方法 INF-X-Retriever 的跨域实验证明泛化优势——INF-X 在 ViDoRe v3 上只有 51.01,换上同款 embedding 也只有 62.31,甚至低于纯稠密检索的 64.36。三是 infra 层面:用可重入锁保护的进程内单例替代 MCP,消除了每查询起服务器的复合开销,提升 GPU 利用率和实验吞吐。四是发现层面:实证表明 agent 能部分弥补弱 embedding 的缺陷,强弱 embedding 差距缩小 57%。
实验结果
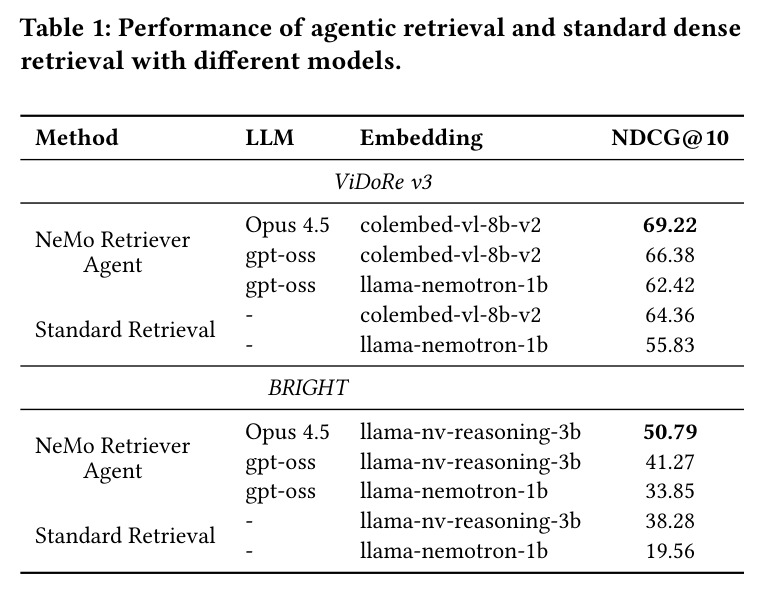
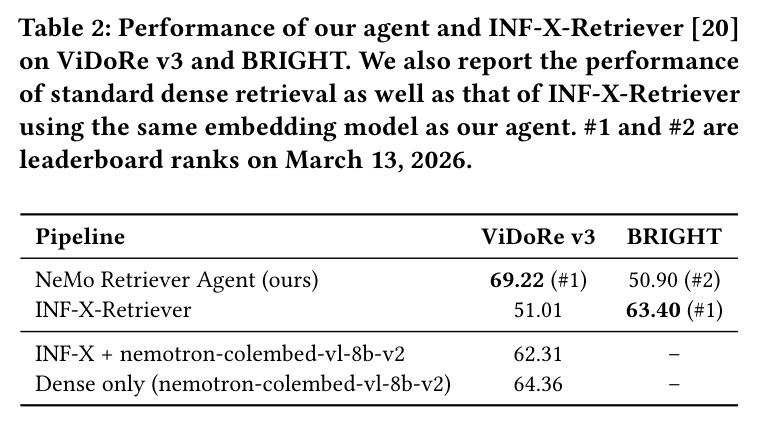
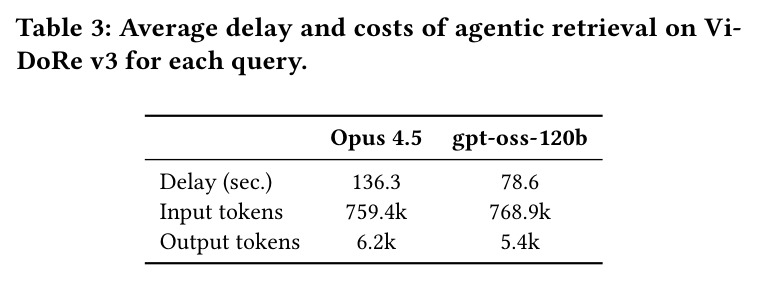
核心发现分三块。有效性:同一 embedding 下 agentic 检索平均提升 8.7 个 nDCG@10——ViDoRe v3 上 Opus 4.5 + colembed-vl-8b-v2 达 69.22 对标准检索 64.36(+4.86),gpt-oss-120b 为 66.38;BRIGHT 上 Opus 4.5 + llama-nv-reasoning-3b 达 50.79 对 38.28(+12.51);换小模型 llama-nemotron-1b 时 ViDoRe v3 62.42 对 55.83、BRIGHT 33.85 对 19.56(+14.29),弱模型上提升最大。泛化性:截至 2026-03-13,同一流水线不修改即列 ViDoRe v3 榜一(69.22)、BRIGHT 榜二(50.90);BRIGHT 榜一 INF-X-Retriever 在 ViDoRe v3 上仅 51.01,换同款 embedding 也只到 62.31,低于纯稠密的 64.36。模型差异:Opus 4.5 比 gpt-oss-120b 平均高 6.2 点、BRIGHT 上高 9.5 点,因其每查询平均 9.2 次搜索调用而 gpt-oss 仅 2.4 次。成本:每查询平均 107.45 秒(标准检索 0.67 秒,约 160 倍)、76.41 万输入 + 5800 输出 token;Opus 4.5 时延 136.3 秒,gpt-oss 78.6 秒。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ViDoRe v3 企业文档检索(Opus 4.5 + colembed-vl-8b-v2) | nDCG@10 | 69.22(ViDoRe v3 榜一) | 64.36(同一 embedding 的标准稠密检索) | +4.86 分 |
| BRIGHT 推理密集检索(Opus 4.5 + llama-nv-reasoning-3b) | nDCG@10 | 50.79(BRIGHT 榜二) | 38.28(同一 embedding 的标准稠密检索) | +12.51 分 |
| BRIGHT 小模型配置(llama-nemotron-1b) | nDCG@10 | 33.85 | 19.56(标准稠密检索) | +14.29 分(弱模型上提升最显著) |
| 跨域泛化:ViDoRe v3 上与 BRIGHT 榜一方法对比 | nDCG@10 | 69.22(同一流水线未做修改) | 51.01(INF-X-Retriever);62.31(INF-X 换用同款 embedding) | +18.21 / +6.91 分 |
局限与改进
作者坦承的最大局限是成本:平均每查询 107.4 秒、76.4 万输入 token,相比 0.67 秒的标准检索慢约 160 倍,token 开销使其难以在低时延或高吞吐场景大规模部署,论文因此把自己定位为『激励未来更高效的检索 agent』而非可落地系统。开源模型明显落后:gpt-oss-120b 与 Opus 4.5 平均差 6.2 点(BRIGHT 上差 9.5 点),推理型 embedding(llama-nv-reasoning-3b)不可用时 BRIGHT 成绩会大幅下滑(如 llama-nemotron-1b 标准检索只有 19.56)。我自己的观察:成本只在 ViDoRe v3 上测量,BRIGHT 的延迟与 token 消耗未报告;论文没有多次运行的方差或显著性分析,agent 行为有随机性,8.7 点提升的稳定性存疑;所有查询无论难易都全额付出 9.2 次搜索调用的成本,缺乏简单查询早退机制;RRF 回退路径自身的质量未被单独评估;两个基准都是学术评测集,真实生产语料(去重、增量更新、权限控制)下的表现仍是未知数。
独立分析的弱点
独立分析几个弱点。其一,所有查询一律进入完整 agent 循环:简单事实型查询本可 0.67 秒由标准检索返回,却被统一收取 100+ 秒、76 万 token 的成本,缺少难度感知的路由/早退机制,改进方向是先用标准检索加置信度判断,只对复杂查询升级到 agent(级联架构)。其二,工具调用严格串行,论文自己也承认并行 retrieve 调用(单轮多次搜索)能减少步数并为下一轮提供更多上下文,这是显而易见的低垂果实。其三,可靠性完全依赖 RRF 回退这种事后补救,没有在 token 预算内主动规划搜索深度,改进方向是把成本预算显式纳入 agent 状态与提示,让其在预算内自适应分配。其四,评测紧邻发表时间点,与榜单的对比(INF-X 用同款 embedding 后 62.31)虽巧妙但仍是快照对比;且缺少消融实验——例如去掉初始检索结果、去掉 think 工具、去掉 RRF 回退各会损失多少——无法定位各组件的独立贡献,这对声称『动态适应』的方法来说是关键缺口。
未来方向
作者提出的方向:(1) 开发专为 agentic retrieval 训练的开源模型——检索 agent 的任务清晰、边界明确、所需技能特定(迭代探索),有望比通用模型更高效也更便宜,弥补 gpt-oss-120b 与 Opus 4.5 之间 6.2 分的差距;(2) 借鉴 ANN 近似最近邻搜索的多种成本控制变体(如 Faiss 的量化/图索引取舍),为 agentic retrieval 设计可调的 token 与推理成本机制,让用户按应用适配;(3) 基础设施与系统设计适配任务,例如并行工具调用减少步数。基于其成果可延伸的工作:难度感知的级联检索(标准检索→重排→agent 三层按需升级);用 Opus 4.5 的 9.2 步搜索轨迹蒸馏训练小型检索 agent,把 136.3 秒压缩到秒级;把 agent 的查询分解轨迹转化为困难正负样本反馈训练 embedding 模型,从源头缩小与 agent 的差距;在流式/增量语料和多租户场景下重新校准其成本模型。
复现评估
复现条件总体较好。代码开源在 github.com/NVIDIA/NeMo-Retriever/tree/main/retrieval-bench(早期版本已作为 NeMo Retriever Agentic Retrieval pipeline 发布),三个 embedding 模型均可在 HuggingFace 直接下载,ViDoRe v3 与 BRIGHT 两个基准均公开。主要门槛在 LLM 侧:最优结果依赖 Anthropic Opus 4.5 闭源 API,且每查询约 76 万输入 token,复现整个 ViDoRe v3 的 API 费用不低;开源路线用 gpt-oss-120b 可得 66.38/41.27,但比 Opus 差 6-9.5 点。检索侧需要 GPU 加载 8B 级 embedding 模型并实现进程内单例与并发锁。总体属于『代码与数据齐全、API 与算力花费为主要门槛』的中等难度复现,建议关注多次运行的方差。
论文图表