Code2Games:让编码智能体生成游戏世界 Code2Games: Enabling Coding Agents for Gaming World Generation
用持久元素对应与执行引导修复,把游戏意图和底座场景变成可运行的UE5游戏世界
前置知识
编码智能体(Coding Agent)
以大语言模型为核心、能自主编写和修改代码并调用外部工具完成多步任务的系统,典型代表如 Claude Code、Codex、Qwen Code。其工作方式是“生成—执行—观察反馈—再修改”的循环:模型先写代码,运行后把报错或测试结果喂回去,迭代直到任务完成。
本文的四个专职智能体全部建立在编码 LLM 之上,基线对比对象(Claude Code、Codex、OpenGame、AutoUE)也都是编码智能体;理解这一范式才能看懂本文“多智能体+执行反馈”的定位。
共享中间表示(Shared Intermediate Representation)
在多个生成阶段之间传递的统一数据结构,把场景约束、玩法需求和元素身份编码在一起,使场景分析、玩法规划、世界生成、引擎重建各阶段读写同一份信息,而不是各自独立生成后再拼接。
本文的核心贡献就是一套场景-玩法共享表示 $S$、$D$、$\mu(e)$:论文所有“保持一致性”的论证都依赖它,是读懂方法章的前提。
交互可供性(Interaction Affordance)
环境为智能体提供的能力描述,例如某区域“可行走”“可放置物体”“可触发事件”。本文中每个场景区域 $q_j$ 携带一个可供性集合 $\alpha_j$,用于约束哪些玩法元素能放在该区域、哪些交互能在那里发生。
可供性是放置约束公式 $J_e=\{j\mid \mathrm{Compat}(\tau_j,e)=1\wedge\mathrm{Afford}(\alpha_j,e)=1\}$ 的组成部分,不理解它就看不懂场景约束放置这一步。
导航网格(Navigation Mesh)
游戏引擎为角色寻路预计算的可行走表面网格。把场景切成可行走区块后,寻路算法(如 A*)可在其上计算任意两点间的通路,用于判断某个位置是否“可达”。
本文用导航网格验证候选放置点的可达性 $\mathrm{Reachable}(p)$,保证游戏目标落在玩家能走到的区域——这是“目标不能锚定在不可达角落”这一动机的技术基础。
UE5 Actor 与触发体积(Trigger Volume)
在 Unreal Engine 中,Actor 是可放入场景的可实体化对象;触发体积是不可见的空间区域,当其他对象进入/离开时触发事件。两者是引擎里实现“物理元素”和“逻辑玩法区域”的标准构件。
本文的持久对应记录把物理元素映射为 Blender 对象 + Unreal Actor、逻辑区域映射为区域标注 + 触发体积,这是“声明式玩法落地为引擎实现”的具体机制。
LLM-as-a-Judge
用一个强模型按固定评分标准(rubric)和提示词模板给生成结果自动打分的评测方法。通常要求裁判只依据提供的输入(视频、代码、动作轨迹)打 0–100 分并给出证据,温度设 0 保证可复现。
GameCode4D 的交互保真度、工件质量和可玩性指标几乎全靠 Qwen3.8-Max 裁判打分,评分协议决定了所有实验数字的含义与可信度。
Code2Worlds
同一团队的前置工作(arXiv:2602.11757),用编码 LLM 从文本生成 4D 世界,输出 Blender 场景。它停在几何、外观与仿真配置层面,不涉及玩法。
本文不从零生成场景,而是把 Code2Worlds 由同一游戏意图生成的 Blender 底座世界作为空间基底,在其上“长出”玩法——这是论文最重要的条件化设定。
研究动机
从一句自然语言游戏意图生成高质量游戏世界,需要同时对场景结构、空间布局、玩法目标、可交互实体和可执行游戏逻辑进行联合推理。现有编码智能体虽然能分别生成资产、静态场景或玩法脚本,但这些组件往往是独立生成、独立评估的:一个物体可能视觉上合理却被放在不合适的区域,一个玩法角色可能没有绑定到正确的实体,一个游戏目标可能锚定在玩家根本到不了的场景角落——各自“合理”的组件拼起来仍是一个偏离设计意图的世界。难度还随场景类型剧烈变化:场景复杂度随物体数量与多样性、空间关系、可通行布局增长,玩法复杂度随目标数、交互元素、状态转移和事件依赖增长。作者在 Figure 2 中用对数坐标展示其场景覆盖从较简单的滑雪、跑酷到战斗、怪物狩猎、开放世界探索的连续谱,实体数和可执行行为数跨越约一个数量级。而 Genie、GameNGen 等世界模型只生成交互式视频观测,不产出可编辑的引擎工程;AutoUE、OpenGame 等智能体开发系统把整个工程当作无差别代码生成,缺乏场景与玩法之间的对应保证。
本文的目标是本文的目标是构建一个智能体框架 Code2Games:输入同一游戏意图对应的两样东西——自然语言意图 $u$ 和由 Code2Worlds 从同一意图生成的 Blender 底座场景 $W_B$——输出一个可在 Unreal Engine 5 中编译、运行并通过玩法测试的可执行工程 $U^*$。生成的世界必须同时满足三个条件:(1) 视觉组织尊重底座场景的空间结构;(2) 玩法语义(目标、角色、交互规则)正确落地为场景中的实体和逻辑;(3) 场景元素、Unreal 表示与可执行逻辑之间保持持久对应,使引擎适配与运行时暴露的错误可以局部化修复而非整体重生成。为系统评测,作者还提出 GameCode4D 基准:10 个固定游戏提示,从视觉质量、交互保真度、多模态工件质量、可玩游戏质量四个维度打分,并要求生成项目在无人干预下通过编译、启动、关卡加载和预定义路线执行的标准化检查。
与已有工作不同的是,本文的独特之处在于“条件化”方式的改变:智能体不是从零生成游戏,而是同时接收游戏意图和由该意图生成的 Code2Worlds 底座世界,把已生成的场景当作玩法的空间基底——目标、角色、元素、交互都锚定到场景区域上,用持久标识符把 Blender 对象与 Unreal Actor、触发体积、可执行逻辑连接起来。与 world model 路线(Genie、GameNGen、Hunyuan-GameCraft 生成交互式视频而非可编辑工程)不同,本文处在“把结构化世界变成可运行游戏项目”这一阶段;与 text-to-3D 及程序化生成(停在几何、外观或仿真配置)不同,本文让玩法真正落到场景里;与 AutoUE、OpenGame 等把工程当无差别代码重建的系统不同,本文的持久对应记录使修复是局部的——只改受影响组件,不必把项目整个重新生成。用编译诊断、运行时反馈和玩法测试共同驱动的执行引导重建,也是对“一次性生成”范式的替代。
核心方法
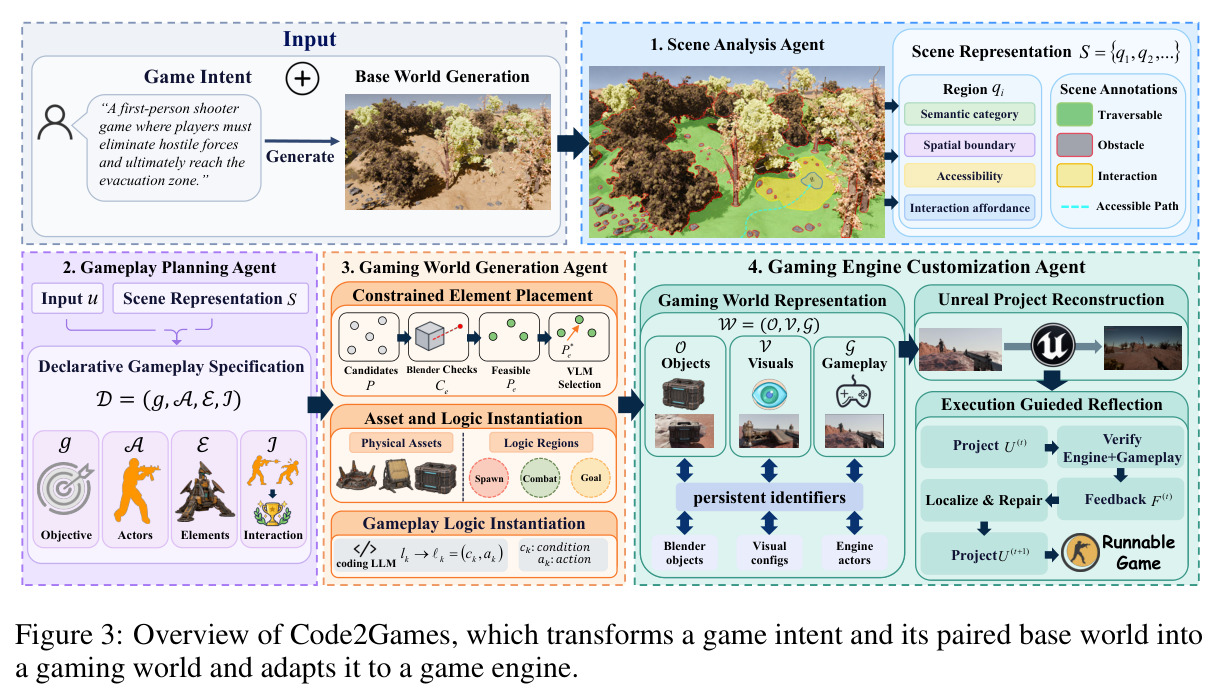
直觉上,一个游戏世界是三样东西的耦合:场景(什么东西在哪)、玩法(玩家要做什么、规则如何变化)和代码(引擎里如何实现)。三者由不同模型、不同表示生成,最容易出问题的是它们之间的“错位”。Code2Games 的解法分两步:第一步,用共享的场景-玩法表示把三者绑在一起——先把 Blender 底座场景解析成带语义类别、空间边界、可达性和可供性的区域集合 $S$,把意图解析成声明式玩法规范 $D=(g,\mathcal{A},\mathcal{E},\mathcal{I})$,再在几何与语义双重约束下把每个玩法元素实例化到场景中;第二步,用执行反馈闭环兜底——把生成的世界重建成 UE5 工程,编译、运行、跑玩法测试,用编译诊断、运行时错误和玩法断言失败定位错误组件,借助持久对应记录做局部修复并迭代。四个专职智能体分工:场景分析(Scene Analysis)、玩法规划(Gameplay Planning)、游戏世界生成(Gaming World Generation)、引擎定制(Gaming Engine Customization),全部通过共享表示协调。实现上,语言与视觉推理用 Qwen 系列模型,玩法资产用 Hunyuan3D 生成,场景操作通过 Blender 4.2.0 的 Python API 完成。
核心创新是“持久元素对应”(persistent correspondence):每个玩法元素 $e$ 带一个对应记录 $\mu(e)=(id_e,\kappa_e,\beta_B(e),\beta_U(e),\mathcal{I}_e,\mathcal{L}_e)$,其中 $id_e$ 是贯穿全程的持久标识符,$\kappa_e$ 区分物理元素与逻辑区域,$\beta_B(e)$ 是 Blender 实现(场景对象或区域标注),$\beta_U(e)$ 是 Unreal 实现(Actor 或触发体积),$\mathcal{I}_e$ 是涉及该元素的交互集合,$\mathcal{L}_e$ 是实现这些交互的逻辑单元集合。这条链把声明式玩法规范、场景实现、引擎表示和可执行代码拴在一起,带来两个本质改变:其一,放置变更、资产替换、逻辑修复可以沿对应关系传播到受影响组件,而不是把整个工程当成无差别代码重新生成——这是与 AutoUE、OpenGame 等基线的根本区别;其二,执行阶段暴露的错误可以反查到具体元素,使“编译失败或玩法行为错误”变成可定位、可修复的局部问题。配套的场景约束放置(几何过滤加 VLM 语义排序)和执行引导重建是该思想的落地机制。
方法步骤详情
第一步,场景分析智能体把 Blender 底座场景解析为区域集合 $S=\{q_j\}_{j=1}^M$,每个区域 $q_j=(\tau_j, b_j, \rho_j, \alpha_j)$ 依次是语义类别、空间边界、按导航网格判定的可达性、交互可供性集合。第二步,玩法规划智能体从意图 $u$ 和 $S$ 产出声明式规范 $D=(g,\mathcal{A},\mathcal{E},\mathcal{I})$:$g$ 是目标与胜负条件,$\mathcal{A}$ 是角色,$\mathcal{E}$ 是玩法元素(每个元素带持久标识符、功能描述、类型 $\kappa_e$ 与放置约束 $C_e$),$\mathcal{I}$ 中每条交互 $\iota_k=(P_k,t_k,c_k,\Delta s_k)$ 描述参与者、触发事件、前置条件和状态更新。第三步,世界生成智能体做约束放置:先取语义兼容且可供性匹配的区域 $J_e$,从其边界采样候选点,再过滤掉不满足 $C_e$、无有效支撑(向下射线检测)、有碰撞(包围盒求交)或不可达(导航网格寻路)的点;对幸存候选构建俯视观测 $T_e$,用 VLM 按 $p^*_e=\arg\max_{p\in P_e}s_{\mathrm{VLM}}(e,p,T_e)$ 选出语义最合适的点;随后实例化资产或区域标注,并把每条交互编译为逻辑单元 $\ell_k=(bc_k, ba_k)$(条件检测加动作执行),经持久标识符绑定到参与者。第四步,引擎定制智能体重建 UE5 工程:物理元素还原为 Actor、逻辑区域还原为触发体积,视觉配置 $V$ 翻译为材质与灯光,逻辑单元绑定运行时条件与动作,组装出初始工程 $U^{(0)}=\mathrm{Assemble}(W,D)$。第五步,执行引导修复:编译运行收集 $F^{(t)}=(F^{(t)}_{\mathrm{engine}}, F^{(t)}_{\mathrm{game}})$,用 $C^{(t)}=\mathrm{Localize}(F^{(t)},\{\mu(e)\}_{e\in\mathcal{E}})$ 定位受影响组件并局部修复,迭代直到玩法目标通过或预算耗尽(实验中所有项目最多 5 轮内达到可运行状态)。
技术新颖性
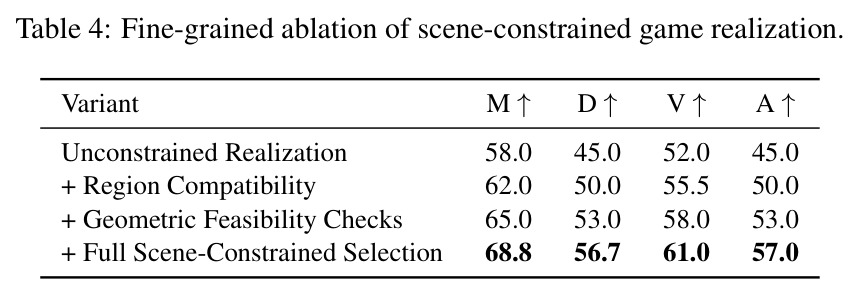
技术新颖性体现在四点。第一,表示层面:把“场景-玩法持久对应”形式化为 $\mu(e)$ 记录,明确连接声明元素、Blender 实现、Unreal 实现与逻辑单元,这在智能体游戏生成文献中是新的——此前工作要么没有场景对应(纯代码生成),要么停在场景层不接玩法。第二,放置层面:把“几何合法性”与“语义合适性”解耦为两级过滤——射线检测、包围盒、导航网格先做硬过滤,VLM 再对候选做语义排序,比纯规则或纯端到端生成更可靠,消融(表 4)显示两类约束解决的是互补的失败模式。第三,修复层面:执行引导重建不是简单的“报错重试”,而是用对应记录做错误定位,只修受影响组件,并区分引擎级反馈(编译/运行时)与玩法级反馈(目标断言、脚本化交互轨迹),消融证明两者贡献不同。第四,评测层面:GameCode4D 用同一意图配对生成底座世界与游戏世界,首次把视觉、交互、工件、可玩性四维指标和无人干预构建成功率 Build 组合成统一协议。整体属于系统集成创新而非单点算法突破,但工程闭环完整、可检验性强。
实验结果
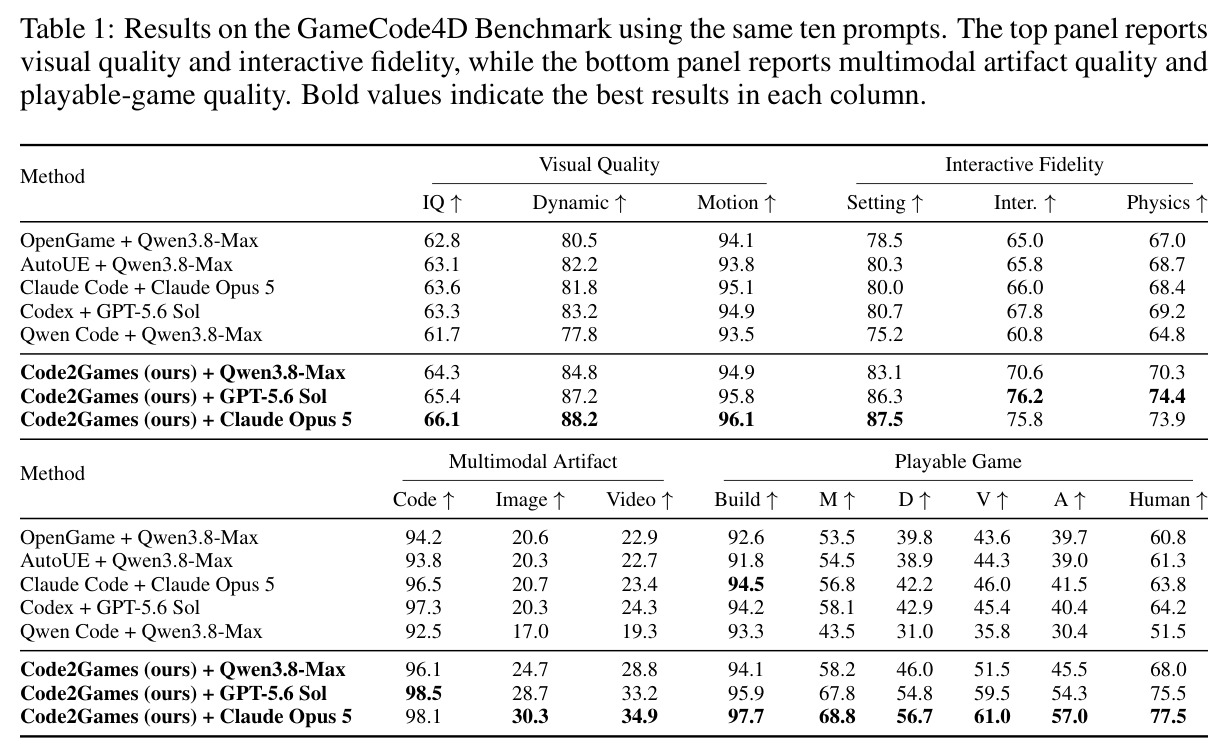
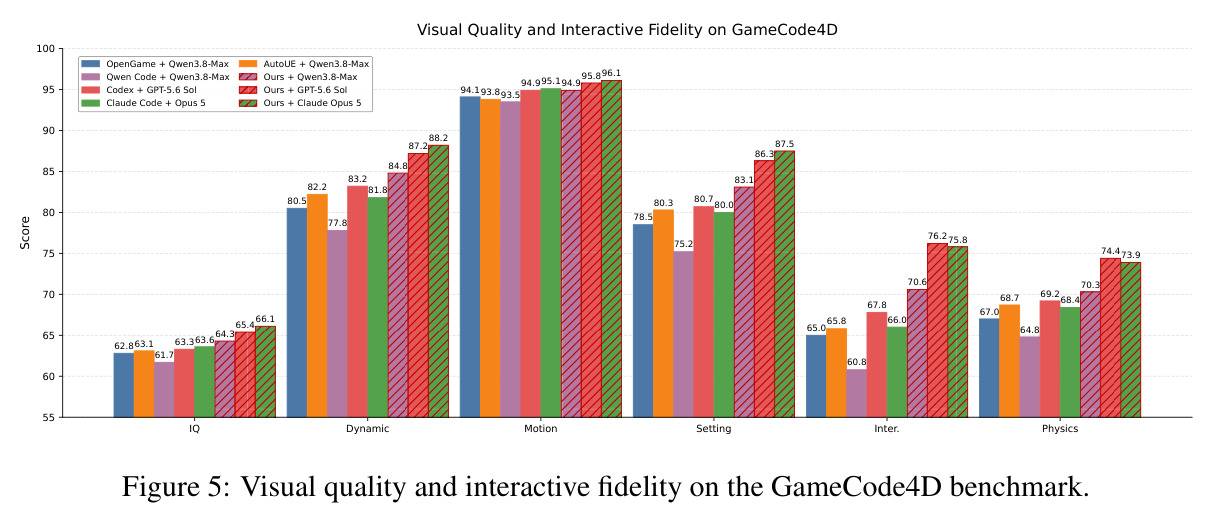
主实验在 GameCode4D 的 10 个固定提示上比较 OpenGame、AutoUE、Claude Code、Codex、Qwen Code 五个基线与三个 Code2Games 配置(分别换用 Qwen3.8-Max、GPT-5.6 Sol、Claude Opus 5 后端),每个游戏录两条约 50 秒的未剪辑 rollout,共 20 个视频取平均。最强配置(Claude Opus 5)在 15 项指标中的 12 项领先:IQ 66.1、Dynamic 88.2、Motion 96.1、Setting 87.5、Inter. 75.8、Physics 73.9、Code 98.1、Image 30.3、Video 34.9、Build 97.7%、M 68.8、D 56.7、V 61.0、A 57.0、Human 77.5;GPT-5.6 Sol 配置则在交互符合度(76.2)、物理合规(74.4)和代码质量(98.5)上领先。与逐列最强基线相比,增益最大的是艺术表现 +15.5(41.5→57.0)、功能性视觉 +15.0(46.0→61.0)、内容深度 +13.8(42.9→56.7)、人类评分 +13.3(64.2→77.5),而 Motion 仅 +1.0,说明收益主要来自“场景锚定的玩法”而非视觉打磨。同骨干对比下,连最弱的 Qwen3.8-Max 配置也在 15 项中的 12 项超过最强基线。消融方面(表 2):去掉场景表示使 Setting 从 87.5 掉到 78.2,去掉玩法规范使 Inter. 从 75.8 掉到 69.8,去掉场景约束使 Physics 从 73.9 掉到 66.2;渐进加入执行反馈(表 3):仅引擎反馈修复使 Build 从 78.5 升到 88.7,再加玩法反馈修复升至 97.7、Inter. 从 58.0 升到 75.8;细粒度消融(表 4):区域兼容+几何可行+完整场景约束选择使 M 从 58.0 一路升到 68.8、V 从 52.0 升到 61.0。
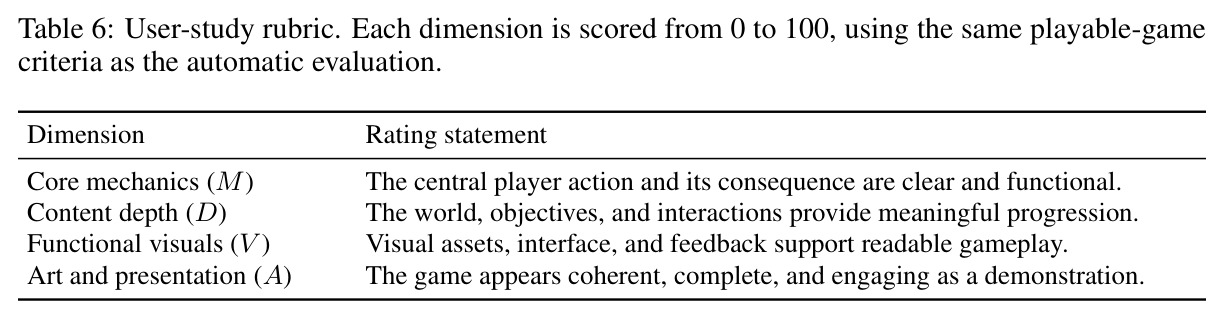
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 图像质量(视觉质量) | IQ | 66.1(Code2Games + Claude Opus 5) | 63.6(Claude Code + Claude Opus 5,逐列最强基线) | +2.5 |
| 场景设定符合度(交互保真度) | Setting | 87.5(Code2Games + Claude Opus 5) | 80.7(Codex + GPT-5.6 Sol) | +6.8 |
| 交互符合度(交互保真度) | Inter. | 76.2(Code2Games + GPT-5.6 Sol) | 67.8(Codex + GPT-5.6 Sol) | +8.4 |
| 物理合规性(交互保真度) | Physics | 74.4(Code2Games + GPT-5.6 Sol) | 69.2(Codex + GPT-5.6 Sol) | +5.2 |
| 自主构建可靠性(可玩游戏质量) | Build | 97.7%(无人干预通过编译/启动/关卡加载/路线执行) | 94.5%(Claude Code + Claude Opus 5) | +3.2 |
| 核心机制(可玩游戏质量) | M | 68.8 | 58.1(Codex + GPT-5.6 Sol) | +10.7 |
| 内容深度(可玩游戏质量) | D | 56.7 | 42.9(Codex + GPT-5.6 Sol) | +13.8 |
| 功能性视觉(可玩游戏质量) | V | 61.0 | 46.0(Claude Code + Claude Opus 5) | +15.0 |
| 艺术与表现(可玩游戏质量) | A | 57.0 | 41.5(Claude Code + Claude Opus 5) | +15.5 |
| 人类评分(15 人用户研究,0-100) | Human | 77.5 | 64.2(Codex + GPT-5.6 Sol) | +13.3 |
| 截图工件质量(多模态工件) | Image | 30.3 | 20.7(Claude Code + Claude Opus 5) | +9.6 |
| 视频工件质量(多模态工件) | Video | 34.9 | 24.3(Codex + GPT-5.6 Sol) | +10.6 |
局限与改进
作者承认的局限是 Blender→UE5 适配的视觉保真度缺口:两个引擎在材质表示、程序化着色器节点、光照与渲染上的差异会改变重建场景的颜色、表面细节、透明度和氛围,Unreal 重建不能完全保留源场景外观。我自己的观察还有几点:(1) 基准规模很小——只有 10 个固定提示、每个方法 20 条约 50 秒的视频,且类型(FPS、怪物狩猎、赛车、滑雪、水下探索等)都是单人短流程玩法,未检验长线、多目标、NPC 行为复杂的游戏;(2) 评测主裁是 Qwen3.8-Max,而它同时是被测骨干之一,存在潜在自我偏好风险(尽管所有方法用同一裁判配置);(3) 绝对分数显示离“真实游戏”还很远——Image/Video 工件分最高仅 30.3/34.9,可玩性四维中内容深度最高 56.7,说明生成的仍是轻量级演示级游戏;(4) 修复预算设为 5 轮,在这些中等复杂度任务上全部成功,但没有分析失败模式分布、修复成本(token、时间)以及在更复杂工程上的可扩展性;(5) 系统强依赖 Code2Worlds 底座场景质量,底座失败会级联到整个游戏;(6) 目标引擎锁定 UE5,管线对 Unity、Godot 等其他引擎的迁移成本未讨论。
独立分析的弱点
(1) 裁判与被评对象同源:LLM-as-a-Judge 用 Qwen3.8-Max 打分,而它也是一个被测骨干,可能存在自我偏好;改进方向是引入多裁判集成(不同厂商模型 + 人工校准子集)并报告裁判间一致性。(2) 评测动作路线是预定义的:每局两条约 50 秒 rollout 走固定路线,只能覆盖设计者预想的交互,无法发现未测试路径上的坏玩法;可引入随机探索智能体或 LLM 玩家做开放测试并统计异常率。(3) 视觉适配损耗:材质与着色器翻译目前是规则管线,作者自己指出会丢色彩、透明度和氛围;可以学习 Blender→UE 的材质映射模型,或用渲染校准网络做后处理对齐。(4) 逻辑单元粒度:交互被编译为“条件+动作”对 $\ell_k=(bc_k,ba_k)$,难以表达持续行为(巡逻 AI、物理谜题、多阶段剧情);可扩展为行为树/状态机的结构化生成,并让对应记录追踪状态机节点。(5) 资产质量瓶颈:Image 分数仅约 30,说明 Hunyuan3D 资产与场景光照的整合仍是短板;可引入资产检索库或针对游戏风格微调资产生成模型。(6) 缺乏成本分析:论文未报告生成一个游戏的 token 消耗、模型调用次数与端到端时间,而“四智能体+多轮修复”的成本可能显著高于直接生成基线,性价比论证不足。
未来方向
作者明确提出的方向是改进材质翻译与渲染校准,缩小 Blender→UE5 的视觉差距。在此基础上有几条自然延伸:(1) 把执行引导修复变成学习信号——五轮内的编译、运行时和玩法反馈本质上是免费的环境奖励,可用于强化学习微调代码生成模型,减少对提示工程和多智能体编排的依赖;(2) 扩展玩法复杂度:引入 NPC 行为树生成、多阶段任务、存档与经济系统,检验持久对应表示在长程状态管理下是否仍然有效;(3) 多引擎与跨引擎一致性:把 UE5 定制智能体泛化到 Unity/Godot,研究同一世界表示 $W$ 自动适配多引擎并量化视觉/行为漂移;(4) 基准扩展:GameCode4D 目前只有 10 个提示,可程序化生成“提示-底座场景”对,形成更大规模、复杂度可控的评测集,并补充修复轮数、token 成本等效率指标;(5) 与 world model 结合:用生成的可执行游戏作为 world model 的数据飞轮或验证环境,两个方向互补;(6) 交互式迭代创作:让用户在生成的世界里标注不满意之处,通过对应记录反推到声明式规范做局部修改,形成人机协同的游戏创作循环。
复现评估
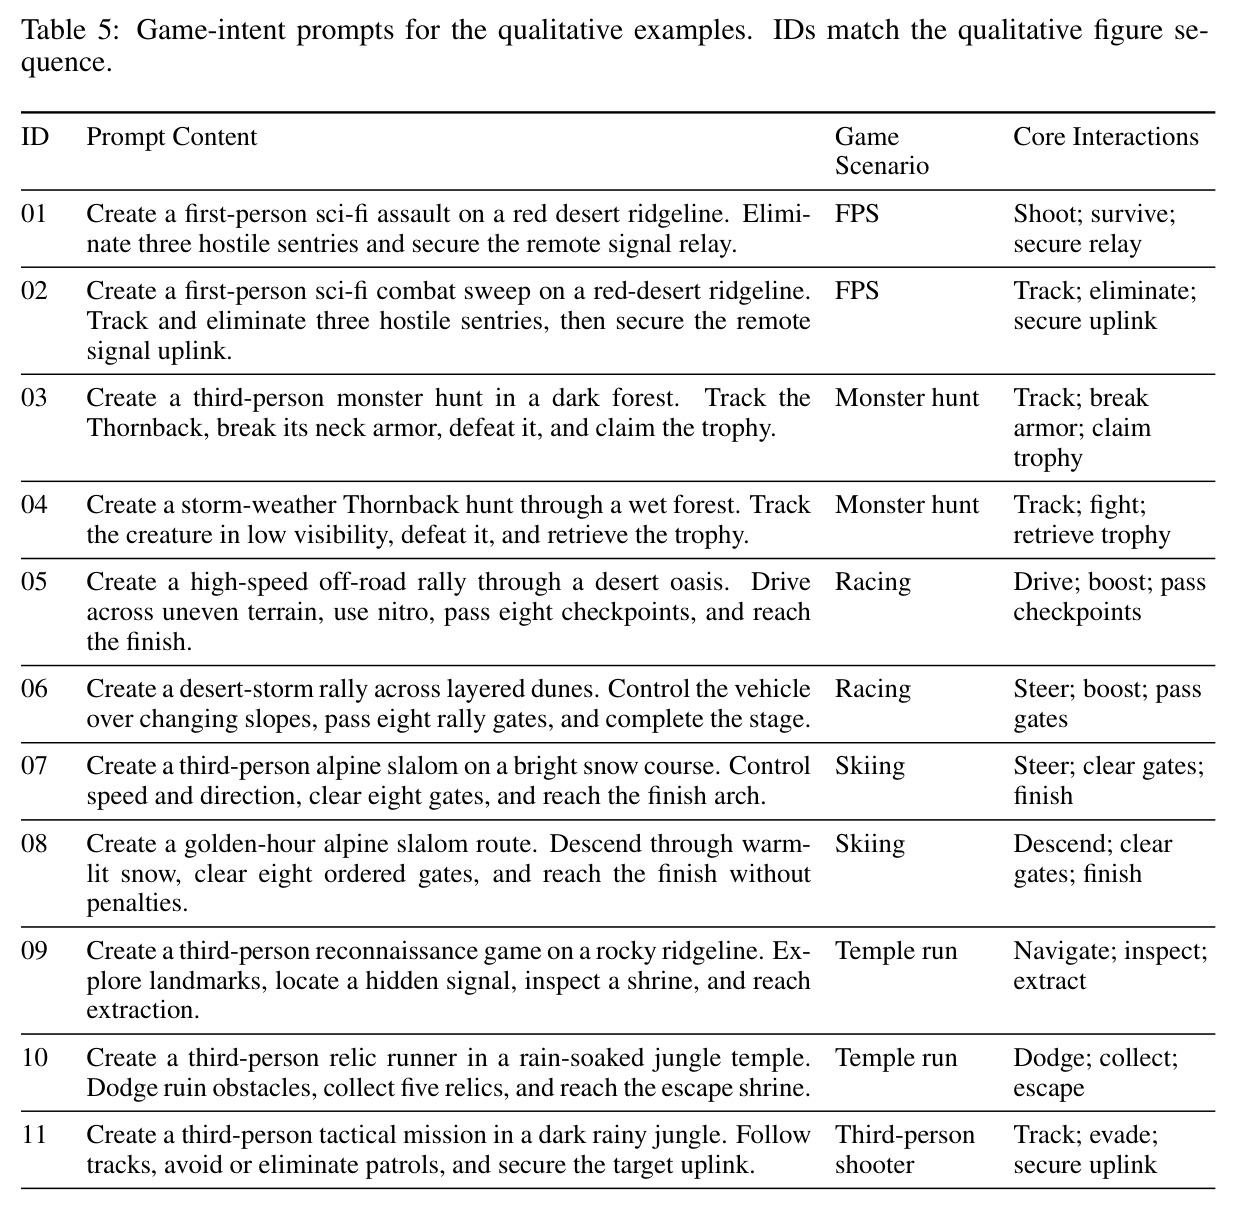
复现条件中等偏上。有利因素:论文附有网站与代码链接,附录完整公开了 10 个基准提示原文(表 5)、约 50 秒双 rollout 的录制与聚合协议、全部 LLM 裁判的 rubric 与提示模板(含 Setting/Inter./Physics、Code/Image/Video、M/D/V/A 的逐条评分标准和封顶条件),以及各智能体的系统提示(附录 G),透明度很高。技术栈明确:Blender 4.2.0 Python API 做场景理解与放置、Qwen 系列做语言/视觉推理、Hunyuan3D 生成资产、UE5 作为执行后端。门槛在于:(1) 需要多个商业闭源模型 API——Qwen3.8-Max、GPT-5.6 Sol、Claude Opus 5,生成与裁判都要花 API 费用;(2) 需要能无人干预编译和运行 UE5 工程的环境,UE 项目自动化构建对机器配置和脚本要求较高;(3) 依赖同组的 Code2Worlds 生成底座场景,需一并部署。无 GPU 训练需求(纯推理+规则检查),单机可跑,但端到端复现完整评测(10 游戏 × 20 视频 × 多裁判 × 多方法)预计需要数百美元级 API 开销与较强的工程调试能力。
论文图表
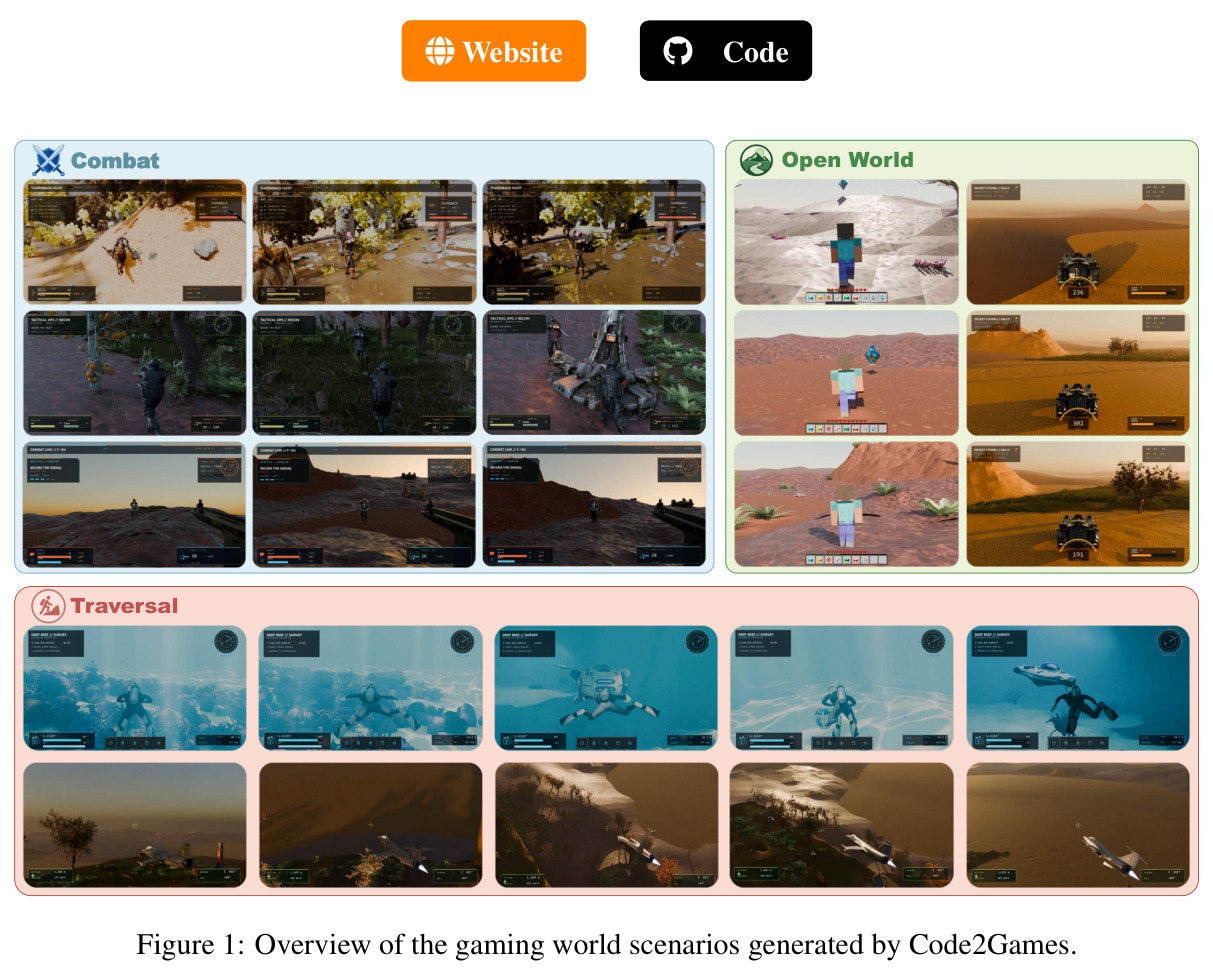
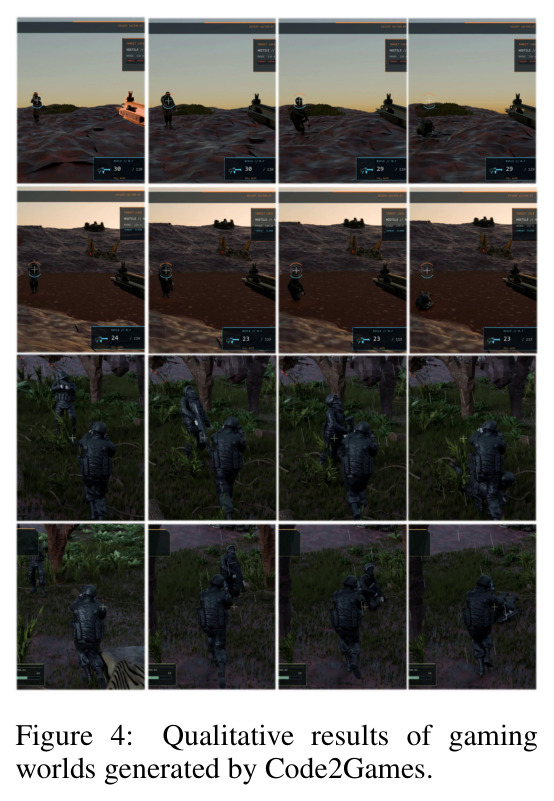
展示 Code2Games 生成的游戏世界场景总览,画面分别对应战斗(Combat)、开放世界(Open World)和跑酷/穿越(Traversal)等类别,呈现第三人称角色在雪地、山地等环境中的实际游戏画面。
一眼看出框架能覆盖的玩法类型与视觉完成度,是理解任务范围和最终产物形态的第一入口。
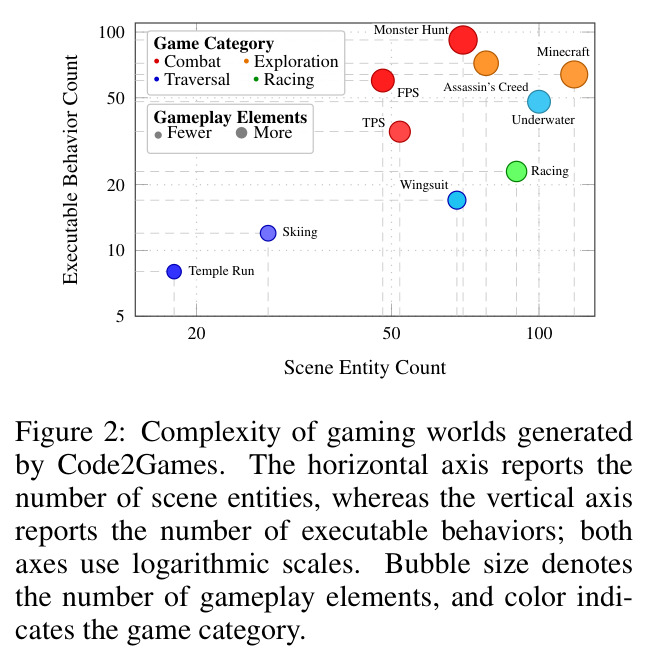
散点图:横轴是场景实体数、纵轴是可执行行为数(两轴均为对数刻度,范围约 20–100+),气泡大小表示玩法元素数量,颜色区分游戏类别(Minecraft 风格、FPS、刺客信条风格、赛车、怪物狩猎、Underwater 等),展示生成的世界从简单滑雪/跑酷到战斗、开放世界的复杂度连续谱。
量化了任务的难度空间,直观说明为什么需要能同时保持视觉组织与交互语义的框架——复杂度跨越约一个数量级,简单提示词拼装难以应对。
场景锚定组件消融:逐个移除场景表示、玩法规范、场景约束。去掉场景表示使 Setting 从 87.5 降到 78.2;去掉玩法规范使 Inter. 从 75.8 降到 69.8;去掉场景约束使 Physics 从 73.9 降到 66.2。
证明共享表示的三个组成部分各自不可或缺,且失效模式与组件功能一一对应(场景信息丢→设定不符,规范丢→交互错误,约束丢→物理错误)。
执行反馈渐进消融:从无反馈的初始 Unreal 重建(Build 78.5、Inter. 58.0)出发,加入引擎反馈修复后 Build 升至 88.7,再加入玩法反馈修复后 Build 达 97.7、Inter. 达 75.8、Physics 达 73.9。
分离了两级反馈的贡献:引擎反馈主要解决工程级失败,玩法反馈带来交互保真度的最大跃升,支撑“执行引导重建”这一核心主张。