DiVeR:面向 VLA 测试时扩展的决策关键验证器学习 DiVeR: Decision-Critical Verifier Learning for VLA Test-Time Scaling
用动作表征散度找到决策关键状态,加权训练轻量验证器提升VLA测试时扩展
前置知识
VLA 模型(Vision-Language-Action)
视觉-语言-动作模型是在大规模多模态演示数据上微调预训练视觉-语言骨干得到的机器人通用策略,输入当前视觉观测与语言指令,输出机器人动作,代表工作有 π0、π0.5、OpenVLA。其能力提升通常依赖扩数据、扩参数,而机器人数据采集成本高昂,这构成了核心瓶颈。
本文的决策关键度估计与验证器输入都取自冻结 VLA 策略的内部模块,必须先理解 VLA 的输入输出形式与内部结构(主干 + 动作专家)才能读懂方法设计。
测试时扩展(Test-Time Scaling)与 Best-of-N
指在推理阶段投入更多计算换取性能,而非继续训练或收集数据。并行式 TTS 把预训练 VLA 视为随机生成器:在每个决策步采样 N 个候选动作块,由验证器给每个候选打分,选出最可能通向任务成功的一个执行;与之相对的顺序式 TTS 则是延长 rollout 或迭代修正。
DiVeR 正是一个验证器引导的 Best-of-N 框架,理解并行 TTS 中生成器-验证器的分工,才能明白验证器为什么重要、其训练信号从哪来。
动作块与动作专家表征
VLA 通常一次预测未来 H 步的动作序列(动作块 $a_t=(a_{t,1},\dots,a_{t,H})$)而非单步动作。π0 等流匹配模型内部的动作专家模块负责生成连续动作,把候选动作块映射到的隐藏向量 $z_t\in\mathbb{R}^d$ 取出,就得到一个策略条件化、信息充分且免于图像处理的候选特征空间。
DiVeR 用同一动作块在多个采样下的表征散度度量决策关键度,并直接在表征空间训练验证器,这是全文的技术基石。
Success-Visitation Ratio 判别器
用成功轨迹与失败轨迹诱导的状态-动作访问密度 $\rho^+(s,a)$、$\rho^-(s,a)$ 训练二分类判别器 $f_\theta$。在两类平衡采样下,总体最优判别器满足 $f^\star=\rho^+/(\rho^++\rho^-)$,其 logit 恰好等于密度比的对数 $\log\frac{\rho^+}{\rho^-}$,越大说明候选越像成功轨迹中的行为,可直接作为排序分数。
这是 DiVeR 验证器目标(式 3-6)的统计学基础,理解它才能明白验证器输出的 logit 含义,以及为什么轨迹级成败标签足以支撑候选排序。
流匹配(Flow Matching)与随机动作生成
流匹配是一类生成建模范式,学习从高斯噪声到数据分布的速度场,常用于生成连续机器人动作。由于输出由初始噪声决定,固定条件、更换初始噪声即可独立采样出多个不同候选;推理时还能用 KV 缓存复用视觉-语言主干的计算,摊薄多次采样的开销。
DiVeR 正是通过独立采样初始高斯噪声获得 K/N 个候选动作,训练时的关键度估计和推理时的 Best-of-N 都依赖策略的可重复采样性质。
研究动机
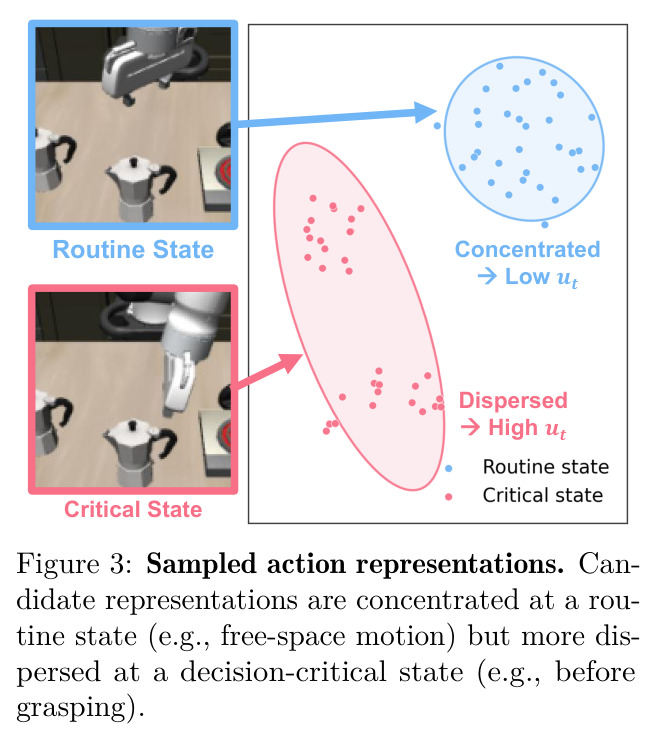
VLA 模型(π0、π0.5、OpenVLA 等)通过大规模演示学习通用机器人策略,但进一步提升受制于机器人数据采集的高昂成本。测试时扩展提供了一条不重训、不加数据的路:每个决策步采样 N 个候选动作块,由验证器挑出最可能成功的候选。现有轻量方案是分类式验证器(TACO、SVM 等),只用轨迹级成败标签训练判别器,避开昂贵的步级标注与外部 VLM 评审的高延迟(如 RoboMeter 单次验证需 0.743 秒)。问题在于这类方法把轨迹结局均匀传播到所有访问状态上,隐含假设各状态对候选判别同等有用。作者的核心观察是:长时程操作中大量『常规状态』(自由空间移动、抓取后搬运)的候选动作高度相似,选哪个几乎不影响结局;只有稀疏的『决策关键状态』(抓取前对齐、放置前对齐)才存在分歧明显的候选,选错会实质改变成败。对 500 条冻结 π0 的 LIBERO-Long 轨迹的统计(Figure 1(b))显示高关键度状态稀疏且时间上局部化,均匀加权会让这些稀疏但关键的监督信号被海量常规状态稀释。
本文的目标是本文的目标是构建一个仍然只依赖轨迹级成败标签、不需要步级标注、不需要额外环境交互的轻量验证器,但能把学习重心自动聚焦到动作选择最要紧的稀疏决策关键状态上,从而在推理时通过验证器引导的 Best-of-N 采样选出更可能成功的动作块。同时要求验证器本身推理开销可忽略——轻到能嵌入实时控制回路,在两个仿真基准(LIBERO-Long、RoboCasa)和一台真实 Franka Research 3 上跨策略(π0、π0.5、OpenVLA)一致提升任务成功率,并大幅超越 VLM 验证器的精度-延迟权衡。
与已有工作不同的是,已有 VLA 测试时扩展分三类:VLM 验证器(RoboMeter 等)精度尚可但延迟约 0.743 秒难以实时;无验证器方法(KDPE 核密度、MG-Select 掩码置信度)不与任务结局挂钩;分类式验证器(TACO、SVM)轻量但均匀加权所有状态。本文的独特切入是把语言生成中『高熵分叉 token』的非均匀性洞察迁移到机器人控制:正如 LLM 中只有少数高熵 token 决定生成走向,轨迹中也只有少数状态的动作分歧会导向截然不同的下游结局。作者进一步用冻结策略内部动作专家表征的采样散度作为决策关键度的免费代理,对验证器 BCE 目标做逐状态指数加权,填补了『轨迹级监督 × 非均匀状态重要性』这一空白。
核心方法
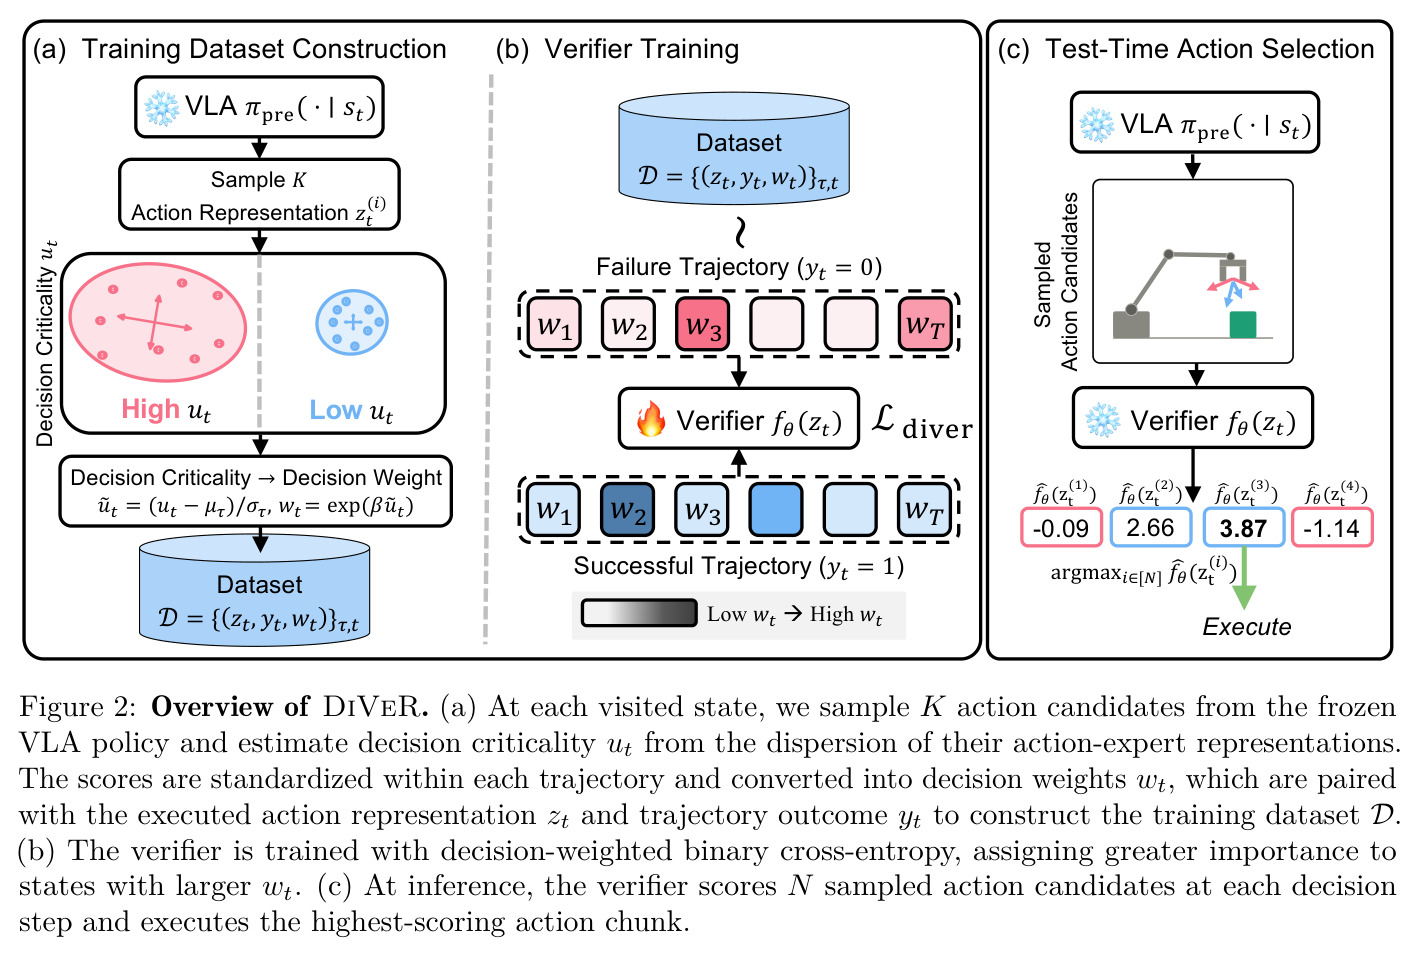
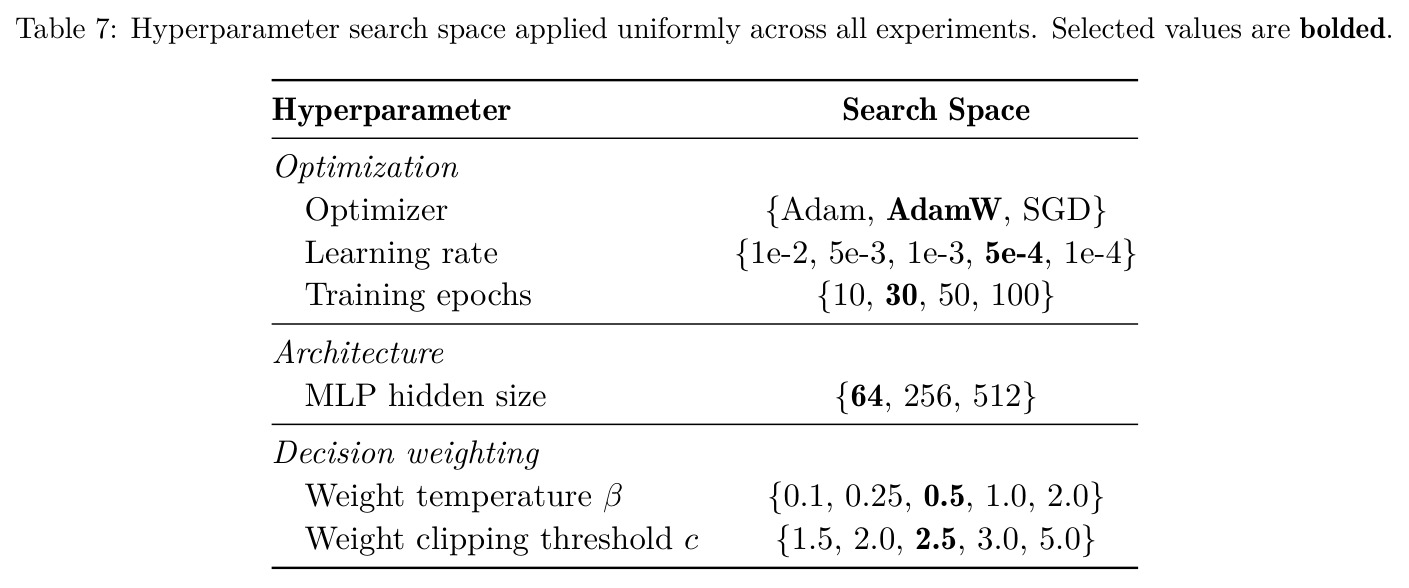
直觉:若冻结策略在某状态采出的多个候选动作在内部表征空间高度分散,说明『接下来做什么』存在真正分歧,选对候选影响重大;反之候选挤成一团,怎么选都差不多。DiVeR 把候选表征散度当作决策关键度,为验证器训练样本加权。技术路线:(1) 离线用冻结 VLA 采集带成败标签的轨迹,对每个状态额外采样 K 个候选,取动作专家表征 $z_t^{(k)}\in\mathbb{R}^d$,以逐坐标平均方差为关键度 $u_t=\frac{1}{d}\mathrm{Tr}\,\mathrm{Cov}_{k\in[K]}[z_t^{(k)}]$;(2) 轨迹内标准化 $\tilde u_t=(u_t-\mu_\tau)/\sigma_\tau$ 后指数化成权重 $w_t=\exp(\beta\tilde u_t)$,与执行表征 $z_t$、结局标签 $y_t$ 组成训练集 $\mathcal{D}=\{(z_t,y_t,w_t)\}$;(3) 用决策加权 BCE 训练约 66K 参数的 MLP 验证器,推理时每步对 N 个候选取 logit 最大者执行。
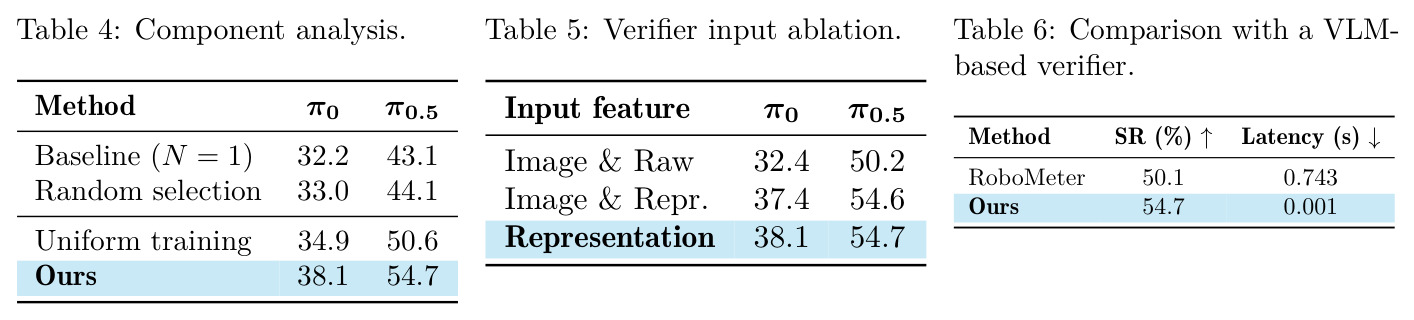
核心创新是把『验证器该重点学哪些状态』从均匀假设改成由策略自身分歧驱动的非均匀加权。与 TACO/SVM 等对全部状态一视同仁的分类式验证器的本质区别在于:DiVeR 证明高关键度状态稀疏(Figure 1(b),500 条 LIBERO-Long 轨迹统计)且可以零成本估计——决策权重 $w_t$ 只由候选表征散度决定,不需要步级成功标注、不需要额外环境交互,甚至与轨迹结局 $y_t$ 解耦。另一个关键设计是验证器输入只用动作专家表征:在平衡采样下最优判别器的 logit 等于成功-失败访问密度比 $\log\frac{\rho^+(s,a)}{\rho^-(s,a)}$(success-visitation ratio),在该表征空间估计密度比既保留策略条件化的判别信息,又免去图像特征处理。消融证实表征输入(38.1/54.7)优于原始动作+图像(32.4/50.2),再加图像特征无额外收益(37.4/54.6),说明动作专家表征已编码了足够的任务相关信息。
方法步骤详情
第一步,数据构建:输入为冻结策略 $\pi_{pre}$ 的带成败标签离线轨迹集 $\mathcal{T}$。对每个时间步 t:(a) 固定条件、独立采样初始噪声得 K 个候选动作块;(b) 提取各候选动作专家表征 $z_t^{(k)}$,按式(8)算关键度 $u_t$(低=常规状态,高=关键状态);(c) 轨迹内标准化得 $\tilde u_t$,经温度 $\beta\ge0$ 指数化成权重 $w_t=\exp(\beta\tilde u_t)$;(d) 存下执行表征 $z_t$、结局 $y_t\in\{0,1\}$ 与 $w_t$。第二步,验证器训练:以加权 BCE $\mathcal{L}_{diver}(\theta)=-\mathbb{E}[w_t(y_t\log f_\theta(z_t)+(1-y_t)\log(1-f_\theta(z_t)))]$ 训练 MLP 判别器 $f_\theta$,权重只改样本贡献而不改标签。第三步,测试时选择:每步采样 N 个候选,执行 $\arg\max_{i\in[N]}\hat f_\theta(z_t^{(i)})$ 对应动作块;附录验证 $u_t$ 与 oracle rollout 关键度相关,且方法对自回归 OpenVLA 同样适用。
技术新颖性
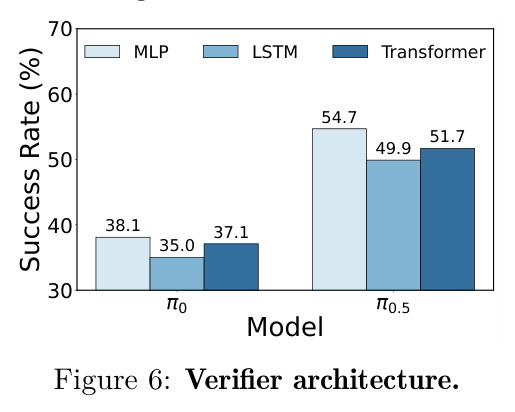
技术新颖性体现在四个层面。问题层面:首次系统指出 VLA 验证器学习中的状态非均匀性,并给出与 LLM 高熵 forking token(Bigelow et al.、Wang et al.)的类比,把『稀疏分叉点』概念引入机器人控制。度量层面:提出决策关键度的零成本代理——动作专家表征采样散度 $u_t$,既无监督又无需环境交互或步级标注,附录用与 oracle rollout 关键度的相关性佐证其有效性。目标层面:把关键度经轨迹内标准化与指数温度 $\beta$ 转成样本权重塞进加权 BCE,改动极小却稳定有效(相对均匀训练 +3.2/+4.1 个百分点),且权重与结局标签解耦、理论解释清晰(最优判别器 logit 即对数密度比)。系统层面:验证器仅 66K 参数、单步验证延迟 0.001 秒,比 VLM 验证器 RoboMeter(0.743 秒)快 700 倍还高 4.6 个百分点,且 MLP 已优于 LSTM 和 Transformer(Figure 6),证明『表示空间选对了,轻量模型就够了』。
实验结果
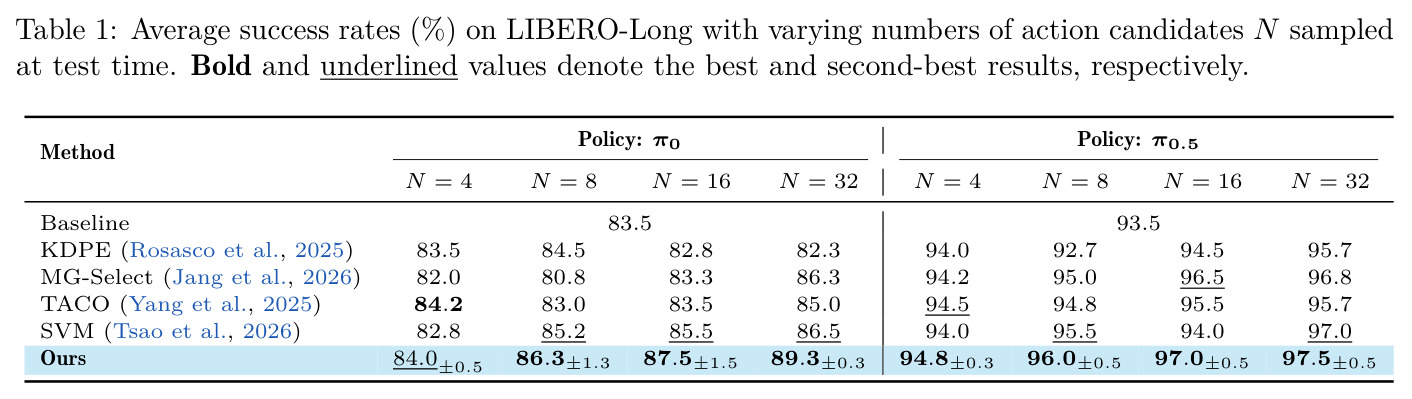
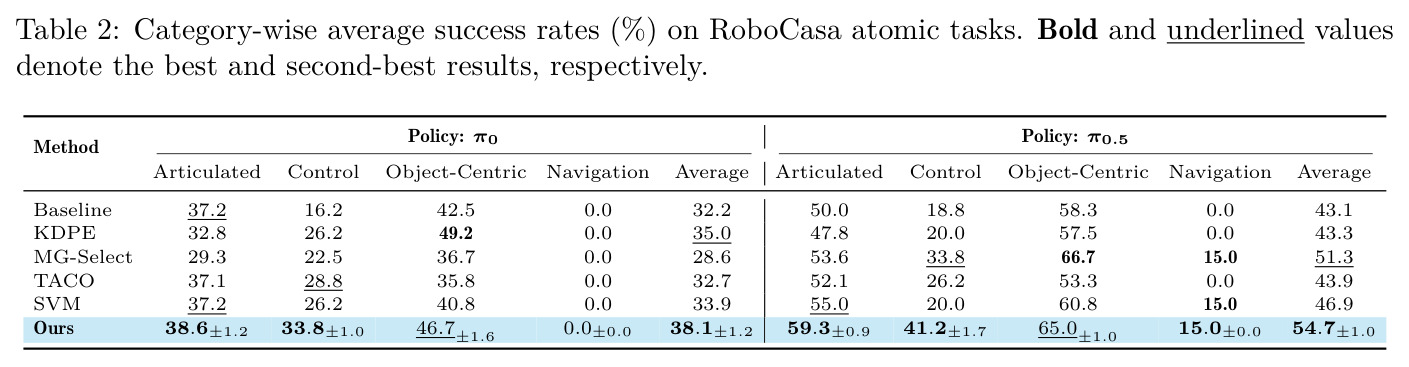
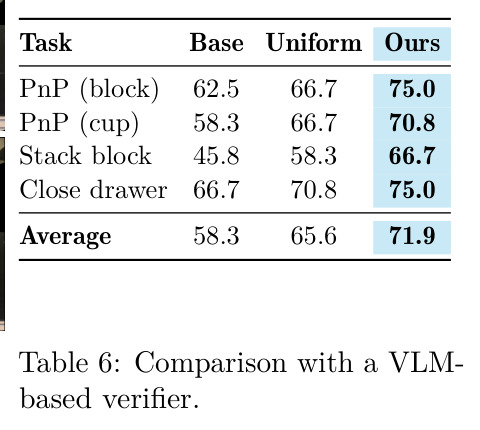
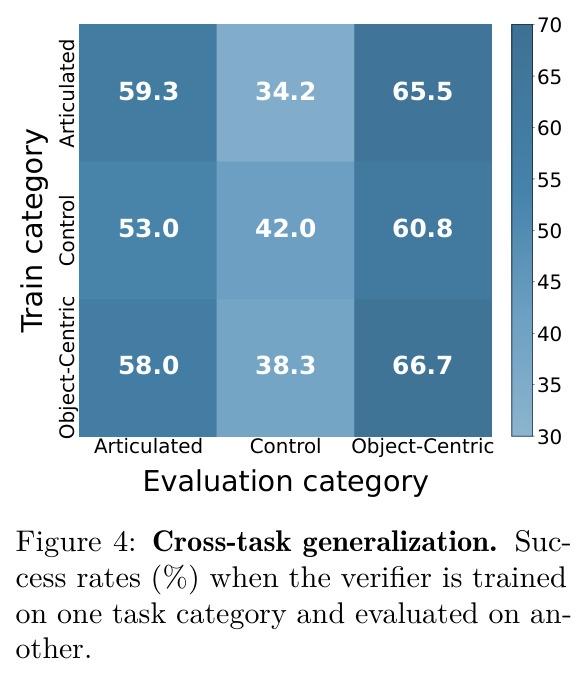
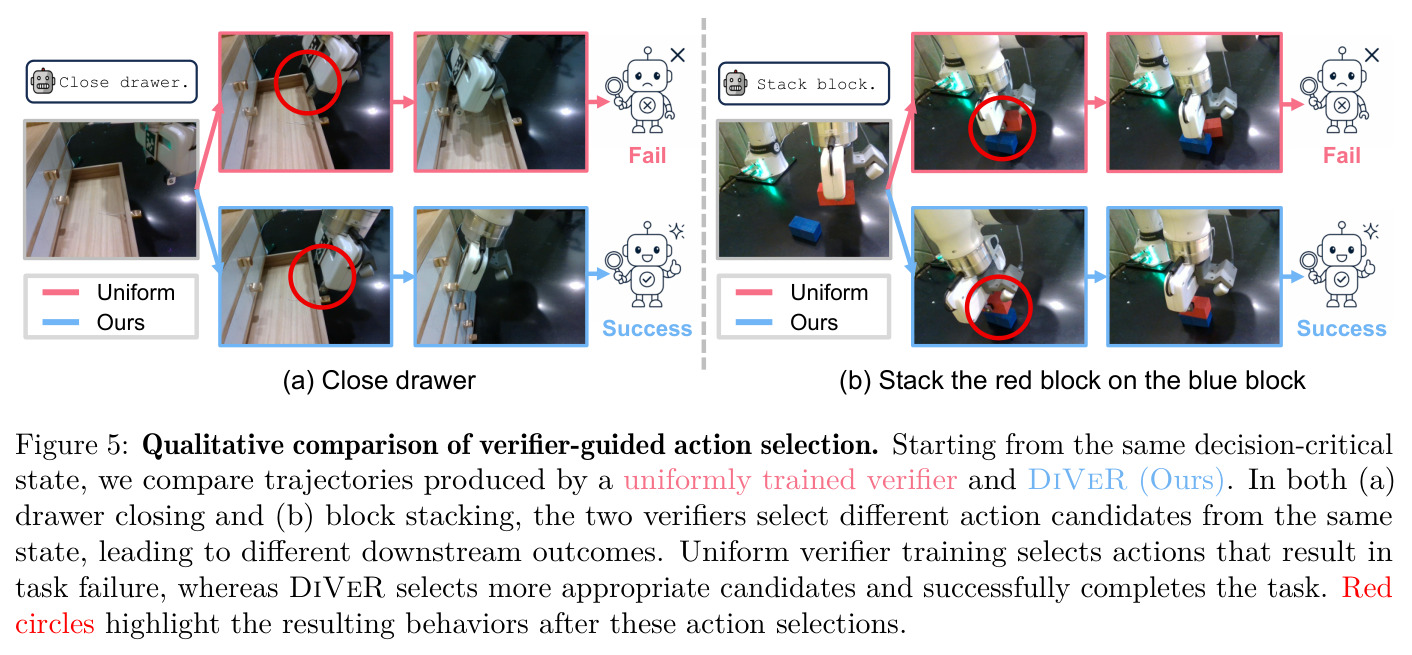
LIBERO-Long(Table 1):π0 基线 83.5%,DiVeR N=32 达 89.3±0.3(+5.8,较最强基线 SVM 86.5 +2.8);π0.5 从 93.5 升至 97.5±0.5。RoboCasa 原子任务(Table 2,N=16):π0 平均 32.2→38.1(+5.9),π0.5 43.1→54.7(+11.6,较最强基线 MG-Select 51.3 +3.4),Control 类 π0 16.2→33.8、π0.5 18.8→41.2。真实机器人(Table 3):FR3 四任务各 24 次评估,Base 58.3%、Uniform 65.6%、DiVeR 71.9%(+13.6/+6.3),堆叠 45.8→66.7。消融(Table 4):随机选择仅 33.0/44.1;均匀训练 34.9/50.6;加权后 38.1/54.7(+3.2/+4.1)。vs VLM 验证器(Table 6):54.7% vs RoboMeter 50.1%,延迟 0.001s vs 0.743s(>700×)。Figure 4 显示跨类别迁移有效;Figure 5 展示同一关键状态下 DiVeR 选对候选而均匀验证器失败;Figure 6 显示 MLP 优于 LSTM 与 Transformer。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO-Long(π0,N=32) | 平均成功率 (%) | 89.3±0.3 | 单次采样基线 83.5;最强基线 SVM 86.5 | +5.8 / +2.8 个百分点 |
| LIBERO-Long(π0.5,N=32) | 平均成功率 (%) | 97.5±0.5 | 单次采样基线 93.5;最强基线 SVM 97.0 | +4.0 / +0.5 个百分点 |
| RoboCasa 原子任务(π0,N=16) | 类别平均成功率 (%) | 38.1±1.2 | 单次采样基线 32.2;最强基线 SVM 33.9 | +5.9 / +4.2 个百分点 |
| RoboCasa 原子任务(π0.5,N=16) | 类别平均成功率 (%) | 54.7±1.0 | 单次采样基线 43.1;最强基线 MG-Select 51.3 | +11.6 / +3.4 个百分点 |
| 真实 Franka Research 3 四任务(π0.5,N=16) | 平均成功率 (%),每任务 24 次评估 | 71.9 | 单次采样基线 58.3;均匀训练验证器 65.6 | +13.6 / +6.3 个百分点 |
| RoboCasa vs VLM 验证器 RoboMeter(π0.5,N=16) | 成功率 (%) / 单次验证延迟 | 54.7 / 0.001 s | RoboMeter 50.1 / 0.743 s | +4.6 个百分点,延迟降低 700 倍以上 |
局限与改进
作者可见的局限:(1) RoboCasa 的 Navigation 类任务上所有方法(含 DiVeR)均为 0.0%,Best-of-N 只能在候选中挑选,候选全错时验证器无能为力,说明 TTS 上限受候选多样性约束;(2) 决策关键度依赖策略采样的离散度,若策略分布过于尖锐或任务中候选天然相似,$u_t$ 信号会变弱,且 $u_t$ 只在轨迹内标准化(式 9),跨轨迹的绝对可比性有限;(3) 标签仍是轨迹结局向所有步传播,加权只调节样本贡献而不能修正标签,早期『小错』若发生在低分歧段仍可能被降权,信用分配依旧粗糙;(4) 验证器按 benchmark 内多任务共享训练,跨 benchmark 未验证,温度 $\beta$ 等超参数敏感性未在正文详述。我的补充观察:(5) 训练时每个状态需额外 K 次候选采样与表征提取,离线数据构建有可观计算开销;(6) 推理时 N 次策略前向虽可用 KV 缓存摊薄,但实机高频控制下可用 N 仍受限;(7) 实机实验限于单平台 Franka FR3 的 4 个任务、每任务 24 次评估,统计样本较小。
独立分析的弱点
弱点一:候选全错即失效。Navigation 类任务全 0% 暴露 BoN 的结构性上限——验证器只能做相对选择、不能创造好动作。改进方向:与顺序式 TTS(回退重规划、树搜索)或世界模型 rollout 结合,当验证器发现所有候选分数都低时触发重试或更换条件。弱点二:关键度代理的理论保证较弱,$u_t$ 是表征散度而非真实后果差异,附录 C.1 只验证了相关性;当策略过尖锐或表征各向异性时散度可能失真。改进:引入 rollout 校准的关键度做蒸馏,或改用多条件扰动下的表征散度以增强鲁棒性。弱点三:轨迹级结局传播不解决信用分配,指数加权只能放大/缩小样本而不能修正标签。改进:结合时间差分价值估计或 hindsight 反事实重标注,给中间步更精确的软标签,并与决策权重相乘。弱点四:验证器 per-benchmark 训练且依赖策略内部动作专家表征,接入有侵入性。改进:学习跨环境、跨具身共享的表征级验证器,或把验证器蒸馏为仅依赖外部观测的接口,降低对特定策略架构的耦合。
未来方向
作者层面:正文明确只做并行式 TTS,自然延伸是把决策关键度引入顺序式扩展(迭代修正、延长 rollout、树搜索)中的节点选择;DiVeR 只要求策略可采样并暴露动作表征,OpenVLA(附录 C.2)已验证可行性,可扩展到更多策略架构与机器人平台;验证器分数还有望用作 RL 微调的奖励信号或演示数据过滤准则。基于成果可延伸的方向:(1) 关键度加权思想可推广到过程奖励模型训练、主动学习与数据筛选——用策略自身分歧定位信息量大的状态;(2) 在线自适应计算分配:部署时实时估计 $u_t$,只在关键状态启动多候选采样以省算力;(3) 与世界模型结合,在表征空间预测候选后果辅助排序;(4) 理论化:建立表征散度与任务后果差异的正式关系并给出关键度估计误差界;(5) 在更长时程任务上检验稀疏关键状态的加权收益是否随视界增长,以及跨任务类别迁移(Figure 4)能否扩展到跨具身泛化。
复现评估
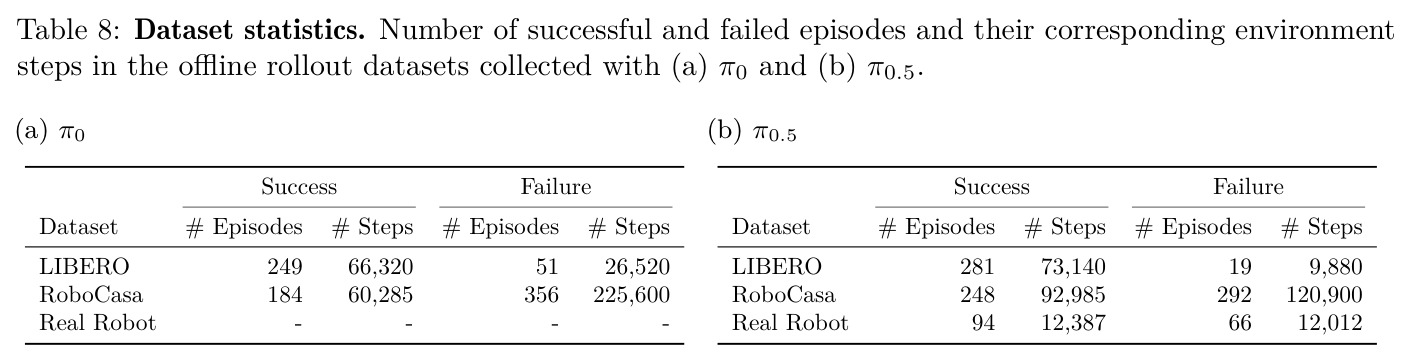
可复现性中等偏友好。基准全部公开:LIBERO-Long(每任务 50 episodes,30 训练/20 评估)、RoboCasa(18 个原子任务,同样划分);策略 π0、π0.5 有开源实现(openpi),自回归 OpenVLA 亦开源,附录 C.2 验证兼容。方法本身不需要步级标注与额外环境交互,验证器仅 66K 参数 MLP,训练算力需求很小,主要开销在冻结策略的 K/N 次候选采样前向(可用 KV 缓存复用摊薄)。实机部分门槛较高:需要 Franka Research 3、RealSense D435、每任务 40 条人工遥操作演示及每任务 24 次评估。结果为 3 个随机种子平均并附标准差,实现细节(表征抽取、超参 K/N/β、基线复现)在附录 B/E。正文仅给出项目页与视频链接,未明确承诺开源代码;若需自行实现,核心是加权 BCE 与表征抽取,约一至两周可复现仿真部分。
论文图表
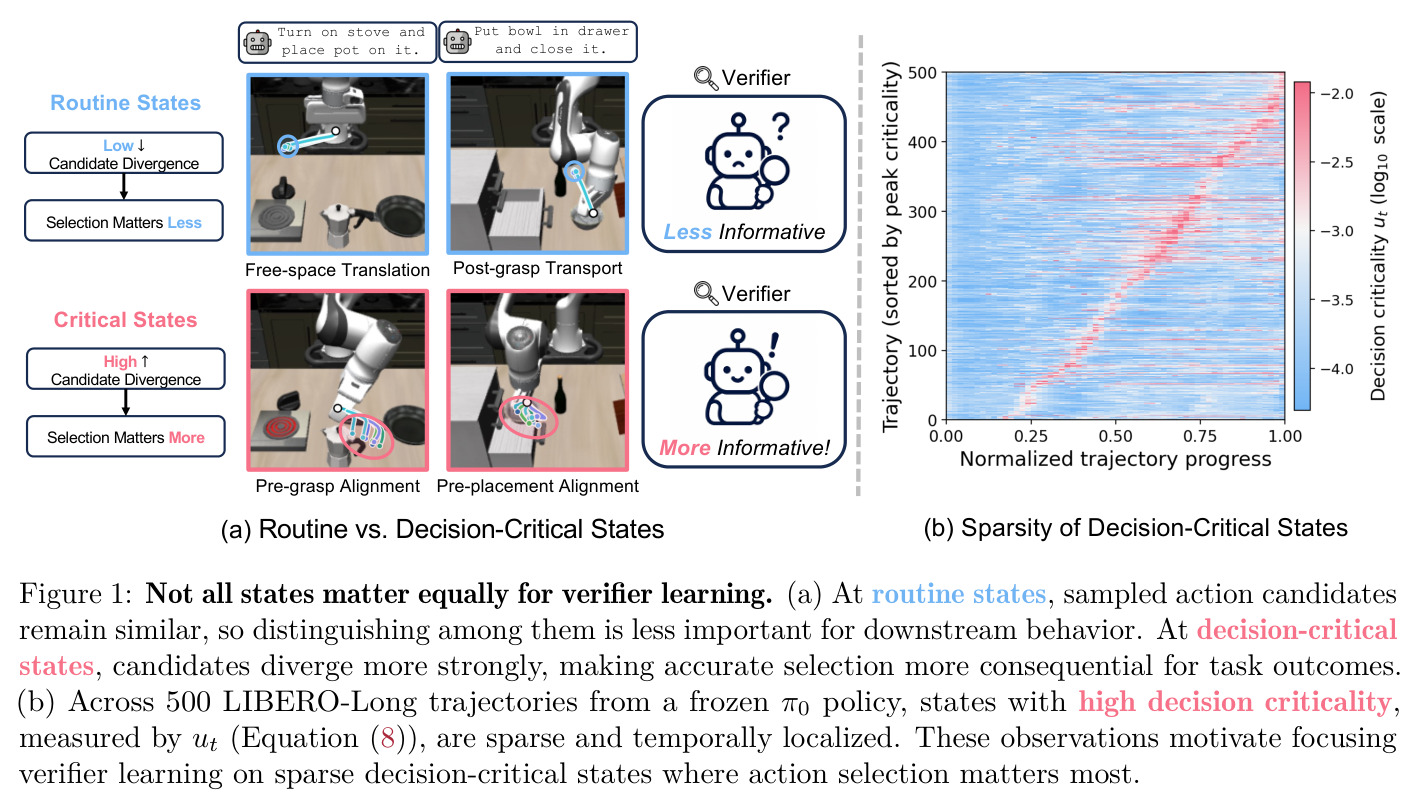
(a) 对比常规状态与决策关键状态:自由空间移动、抓取后搬运等常规状态下候选动作相似、选择影响小;抓取前/放置前对齐等关键状态下候选强烈分歧、选择显著影响结局。(b) 统计 500 条冻结 π0 的 LIBERO-Long 轨迹,按式(8)的关键度 $u_t$ 度量,高关键度状态稀疏且在时间上局部化。
这张图是全文动机的可视化证据:它直观呈现『轨迹中只有少数状态值得验证器认真区分』这一核心观察,理解它才能理解为什么均匀加权会稀释监督信号。