PaLoRA:面向持续学习的节奏化低秩适配 PaLoRA: Paced Low-Rank Adaptation for Continual Learning
推导出梯度步长应随历史知识有效秩按√R增长的节奏律,实现持续学习稳定-可塑性的最优平衡
前置知识
LoRA(Low-Rank Adaptation)
参数高效微调(PEFT)的主流方法:冻结预训练权重 $W_0 \in \mathbb{R}^{d\times d}$,用低秩分解 $W = W_0 + BA$ 表示任务特定更新,其中 $A \in \mathbb{R}^{r\times d}$、$B \in \mathbb{R}^{d\times r}$、秩 $r \ll d$。只训练 $A,B$ 两个小矩阵即可适配下游任务,推理时可合并回原权重、不增加任何推理开销,兼得计算效率与表达能力。
本文的整个框架建立在 LoRA 参数化之上:节奏律(pacing law)直接作用于 LoRA 因子 $B_t$ 的梯度,SVD 压缩的对象正是累积的 LoRA 更新。不懂 LoRA 的结构与初始化方式($B$ 置零)就无法理解为什么缩放 $B_t$ 的梯度能调控整个任务更新。
灾难性遗忘与无样本类增量学习(EFCIL)
模型按任务序列 $\mathcal{T}_1,\dots,\mathcal{T}_T$ 顺序训练,且训练任务 $t$ 时完全无法访问旧任务数据(example-free 类增量设定),新任务训练会使旧任务性能骤降,即灾难性遗忘。推理时模型需在累积标签空间 $\mathcal{Y}_{1:T}$ 上预测且不知道任务身份。常用指标是学完全部任务后的最终精度 $ACC_T$ 与全程平均精度。
这是本文的问题设定:PaLoRA 声称不存储任何旧数据、不访问任务身份就能抑制遗忘,评估协议(10/20/25/50 个任务划分、最终/平均精度)也全部由该设定定义。
零空间投影(Nullspace Projection)
把累积更新 $C_{t-1}=U\Sigma V^\top$ 的前 $R$ 个右奇异向量张成的空间视为旧任务输入子空间,其正交补 $V_\perp=[v_{R+1},\dots,v_d]$ 称为零空间。将新任务增量约束为 $\Delta_t = M V_\perp$(即投影矩阵 $P=V_{[R:]}V_{[R:]}^\top$)后,理论上旧任务输入 $x_{old}$ 的前向传播不受影响($\Delta_t x_{old}=0$),代表 InfLoRA、GPM 等方法的核心方向约束思想。
PaLoRA 用投影矩阵约束 $A_t$ 的梯度,而本文理论部分分析的正是有限精度下投影无法完美约束、更新会向历史子空间"泄漏"的现象——这是引出幅度配速的关键前提。
有效秩与 SVD 截断
矩阵的"有效秩"指其谱中携带主要能量的分量个数:对累积更新做奇异值分解 $\Delta W = U\Sigma V^\top$ 后,取最小的 $R$ 使得前 $R$ 个奇异值的累积能量占比超过阈值 $\tau$。相比假设每个任务固定增加秩 $r$(即 $(t-1)r$ 的线性增长),有效秩通过剔除跨任务冗余方向,给出"历史知识量"的紧凑、自适应度量。
节奏律 $s^*=\sqrt{R/c}$ 中的 $R$ 就是这个有效秩:它是连接"历史知识有多少"与"步长该多小"的桥梁,Stage I 的自适应 SVD 压缩正是它的估计器。
后向迁移(BWT, Backward Transfer)
衡量持续学习遗忘程度的指标:$BWT$ 等于各旧任务在学完全部 $T$ 个任务后的精度,减去该任务刚学完时的精度,再取平均。$BWT=0$ 表示完全没有遗忘,负值越大(越负)表示遗忘越严重。它与方法"最终精度高但遗忘多"还是"稳定但不学新东西"的定性无关,能单独刻画稳定性。
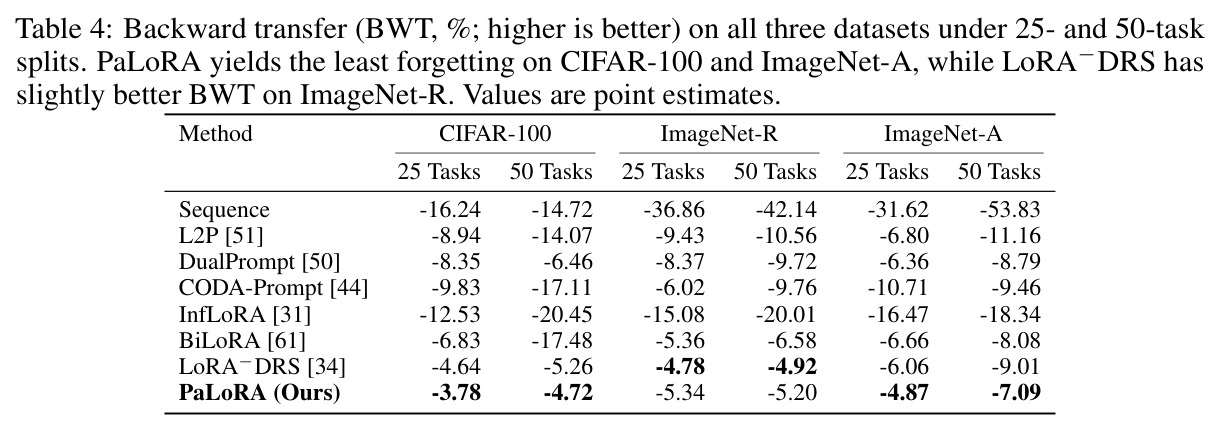
论文 Table 4 用 BWT 检验 PaLoRA 是否真正"少遗忘":结果是其最终精度领先的同时在 CIFAR-100(-4.72)和 ImageNet-A(-7.09,50 任务)上遗忘最少,这是支撑方法主张的关键独立证据。
研究动机
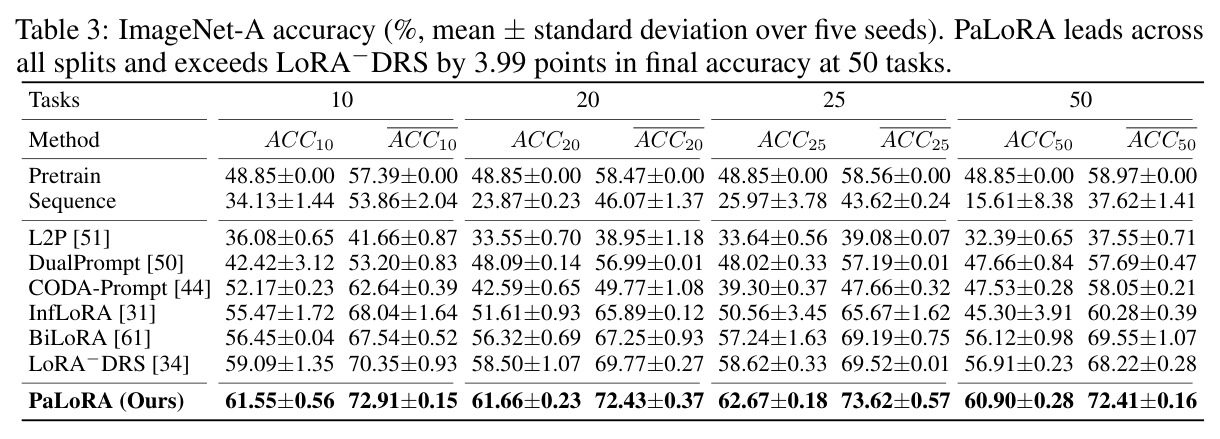
现有 LoRA 持续学习方法(O-LoRA、BiLoRA、InfLoRA、LoRA−DRS 等)几乎都依赖"方向约束 + 小学习率"的组合:前者把新任务更新限制在历史知识的零空间,后者作为固定启发式限制参数更新的幅度。但小学习率只是沿用 SLCA 的经验做法,缺乏理论支撑——为什么限制更新幅度能缓解遗忘?随着任务累积、历史知识的体积与复杂度增长,这个固定强度的限制为何以及应如何演变?论文指出,有限精度下的更新会沿多个方向泄漏进历史子空间,小学习率只能衰减单步泄漏,却无法阻止累积遗忘随历史知识有效秩的增长而加剧。实证上问题很严重:ImageNet-A 上无保护的序列微调(Sequence 基线)在 10 任务划分时最终精度为 34.13%,50 任务时暴跌到 15.61%;即使用 InfLoRA,50 任务时最终精度也从 10 任务的 55.47% 掉到 45.30%,说明固定的幅度策略在长任务序列下系统性失效。
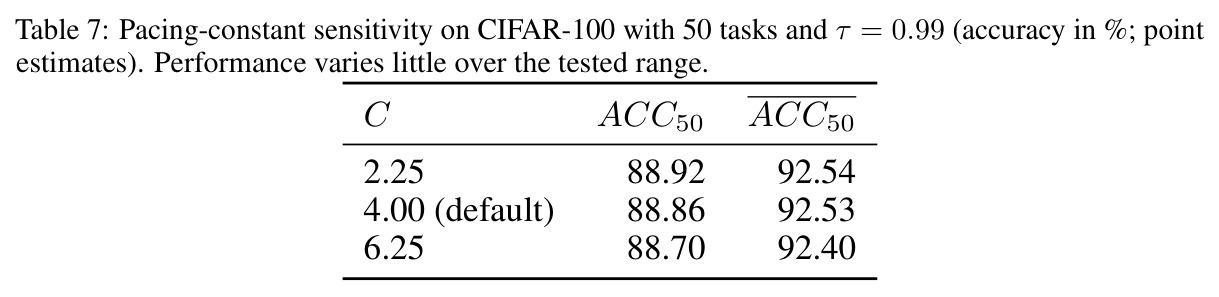
本文的目标是本文要回答一个此前"没有收到原则性研究"的问题:更新幅度的限制应如何随任务积累自适应变化,并把它变成可计算的公式。具体目标有三层。第一层是理论:在单层线性模型、各向异性泄漏($E[\epsilon_i^2]=\eta^2\gamma_i^2/s^2$)和局部二次旧任务敏感度(曲率 $\lambda_i$)假设下,推导最优梯度步长分母 $s^*$ 与历史累积更新有效秩 $R$ 的解析关系 $s^*=\sqrt{R/c}$($c$ 为每步遗忘预算系数),并证明其在预算约束下的 Pareto 最优性。第二层是算法:把该原则工程化为 PaLoRA 框架——自适应 SVD 秩压缩、零空间投影与秩感知梯度配速,外加一个经验性的三元组正则补偿可塑性。第三层是验证:在不存储旧数据、不知道任务身份的类增量设定下,于 CIFAR-100、ImageNet-R、ImageNet-A 的 10/20/25/50 任务划分上,同时超越 InfLoRA、BiLoRA、LoRA−DRS、SD-LoRA 等强基线,目标场景是此前方法退化最严重的 50 任务长序列。
与已有工作不同的是,已有方法的共同盲区是"只管方向、不管幅度":O-LoRA 用正交正则隔离任务间参数方向,BiLoRA 让不同任务占用近乎不相交的参数项,InfLoRA 与 LoRA−DRS 做子空间投影——它们都在方向层面做文章,把幅度控制交给"沿用 SLCA 的小学习率"这一固定启发式,没人追问该启发式的最优强度是什么、该不该随任务演变。本文的独特切入是把被忽视的幅度维度理论化:把遗忘建模为有限精度更新沿 $R$ 个历史奇异方向的各向异性泄漏 $E[\epsilon_i^2]=\eta^2\gamma_i^2/s^2$($\eta$ 为基础学习率、$\gamma_i$ 为方向相关泄漏尺度、$s$ 为步长分母),把稳定性-可塑性权衡形式化为"在每步遗忘预算 $\epsilon_0=c\,\epsilon_{dir}$($\epsilon_{dir}=\eta^2\Gamma^2/2$)约束下最大化新任务一阶进展"的约束优化。解出的答案是限制强度应随有效秩按 $\sqrt{R}$ 增长——这是首个给出该缩放解析式与最优性证明的工作,也解释了 Figure 1 中受约束轨迹为何应随任务数向旧解偏移。
核心方法
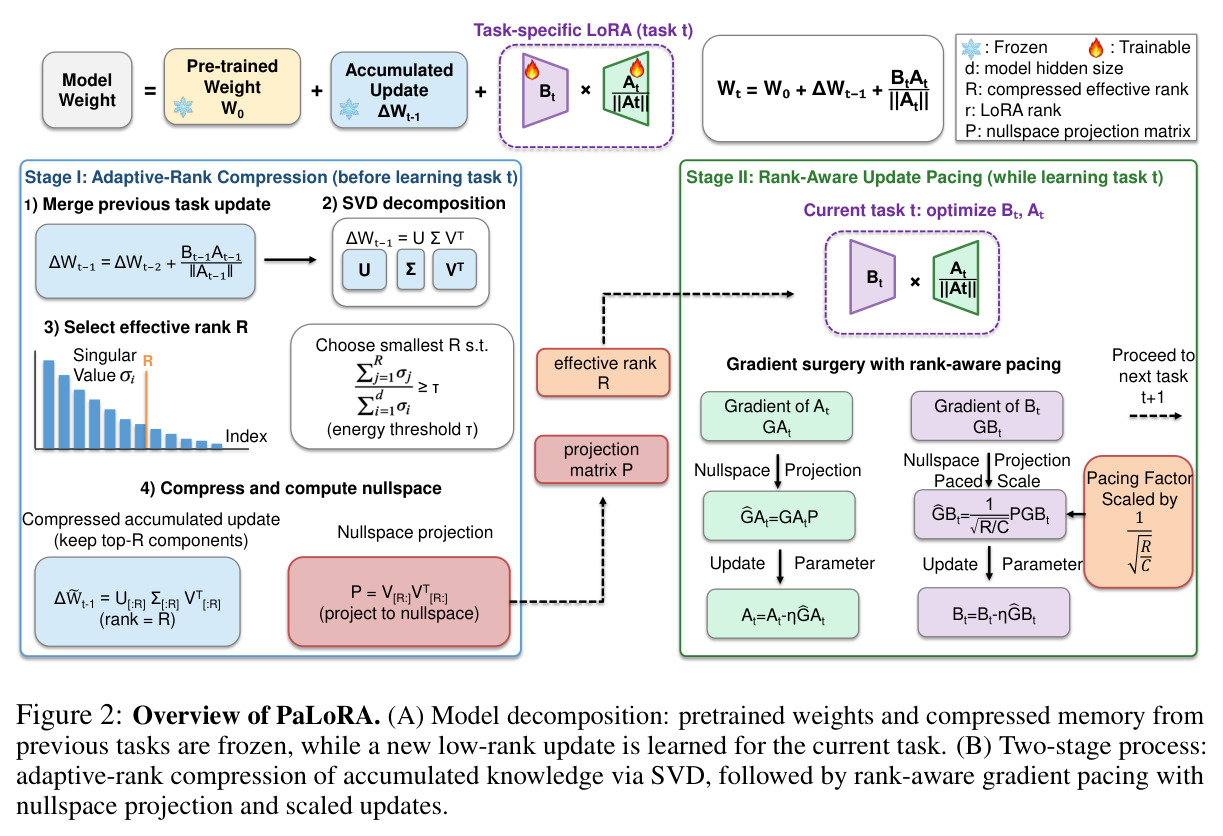
直觉:模型学过的任务越多,当前参数承载的历史知识越丰富(用累积更新的有效秩 $R$ 度量),新任务的最优解就越偏离联合最优,限制更新的"缰绳"应当越收越紧。技术上分两阶段。Stage I(自适应秩压缩):学习任务 $t$ 前,把上一任务更新 $B_{t-1}A_{t-1}/\|A_{t-1}\|$ 合并进累积矩阵 $\Delta W_{t-2}$,SVD 分解后保留累积能量超过阈值 $\tau$ 的前 $R$ 个分量作为压缩记忆,并输出零空间投影矩阵 $P=V_{[R:]}V_{[R:]}^\top$,随后冻结预训练权重与压缩记忆。Stage II(秩感知配速):只训练 $(A_t,B_t)$,$A_t$ 的梯度经 $\hat{G}_{A_t}=G_{A_t}P$ 投影到历史零空间,$B_t$ 的梯度乘以 $\sqrt{R/C}$ 实现秩感知缩放。理论依据:各向异性泄漏下每步遗忘 $E[\Delta L_{t-1}]=\eta^2 R\Gamma^2/(2s^2)$ 随步长分母 $s$ 二次衰减,而新任务一阶进展只线性损失,预算约束下最优分母即 $s^*=\sqrt{R/c}$。
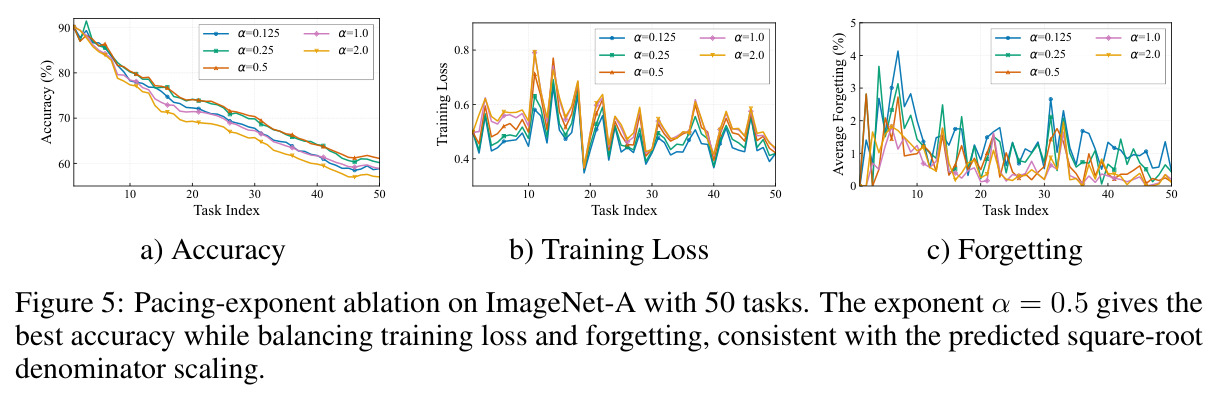
核心创新是把稳定性-可塑性权衡从"固定小学习率"升级为"随历史知识有效秩按 $\sqrt{R}$ 自适应增长的梯度配速律"。与已有方法的本质区别有三。第一,InfLoRA、BiLoRA、LoRA−DRS 等只约束更新方向(零空间投影或方向隔离),配速只是固定的经验性小学习率;本文证明有限精度下泄漏不可避免,配速强度必须随 $R$ 增长才能把每步遗忘压在预算 $c\,\epsilon_{dir}$ 上——$s<\sqrt{R/c}$ 违反预算,$s>\sqrt{R/c}$ 白白牺牲进展,$s^*$ 是该预算问题的唯一 Pareto 最优点。第二,历史知识不按固定秩 $(t-1)r$ 累积,而用能量阈值 $\tau$ 下的自适应 SVD 截断估计有效秩 $R$,自动剔除跨任务冗余方向,使配速因子反映真实知识量而非任务数的线性函数。第三,通过归一化 $A_t$并让 $B_t$ 从零初始化(承载全部幅度),缩放 $B_t$ 的梯度即可直接调控整个任务更新的学习动态。消融中配速指数 $\alpha=0.5$(即 $\sqrt{R}$)在精度、训练损失与遗忘间最优,与理论预测精确吻合。
方法步骤详情
每个新任务三步。第一步(自适应秩压缩):输入累积更新 $\Delta W_{t-1}=\Delta W_{t-2}+B_{t-1}A_{t-1}/\|A_{t-1}\|$,SVD 后取最小 $R$ 使累积能量 $\ge\tau$,输出压缩记忆与投影矩阵 $P=V_{[R:]}V_{[R:]}^\top$,冻结 $W_0$ 与压缩记忆。第二步(秩感知配速):只优化 $B_tA_t$,$A_t$ 梯度先投影 $\hat{G}_{A_t}=G_{A_t}P$,$B_t$ 梯度缩放为 $\hat{G}_{B_t}=\sqrt{R/C}\,PG_{B_t}$,再以学习率 $\eta$ 更新,实例化配速律 $s^*=\sqrt{R/c}$。第三步(可塑性补偿):以 $L_{total}=L_{CE}+\lambda L_{reg}$ 训练,$L_{reg}=\frac{1}{N}\sum_i(d_i^+-d_i^-+m)_+$ 为 easy-positive 三元组;正样本集含锚点自身使 $d_i^+=0$,实际强制类间最小间隔以补偿可塑性。任务结束后回到第一步,循环至第 $T$ 个任务。
技术新颖性
新颖性体现在三个层面。理论上,首次为"持续学习该用多小的步长"给出解析答案:在各向异性泄漏 $E[\epsilon_i^2]=\eta^2\gamma_i^2/s^2$ 与局部二次曲率 $\lambda_i$ 假设下,每步遗忘 $E[\Delta L_{t-1}]=\eta^2 R\Gamma^2/(2s^2)$($\Gamma^2=\frac{1}{R}\sum_i\lambda_i\gamma_i^2$)对分母 $s$ 二次依赖而进展只线性损失,引理 3.1 证明 $s^*=\sqrt{R/c}$ 是预算约束问题的唯一 Pareto 最优点,且每步遗忘恰好等于预算 $c\,\epsilon_{dir}$。表示上,用能量阈值 $\tau$ 的自适应 SVD 截断估计有效秩,取代固定秩增长假设 $(t-1)r$。优化上,$A_t$ 方向归一化加 $B_t$ 幅度承载的参数化使配速只作用于 $B_t$ 梯度即可全局生效。作者还诚实划界:Pareto 最优性只在单层线性模型成立,推广到深层 ViT 是近似原则而非形式保证,三元组正则明确不在理论覆盖内。
实验结果
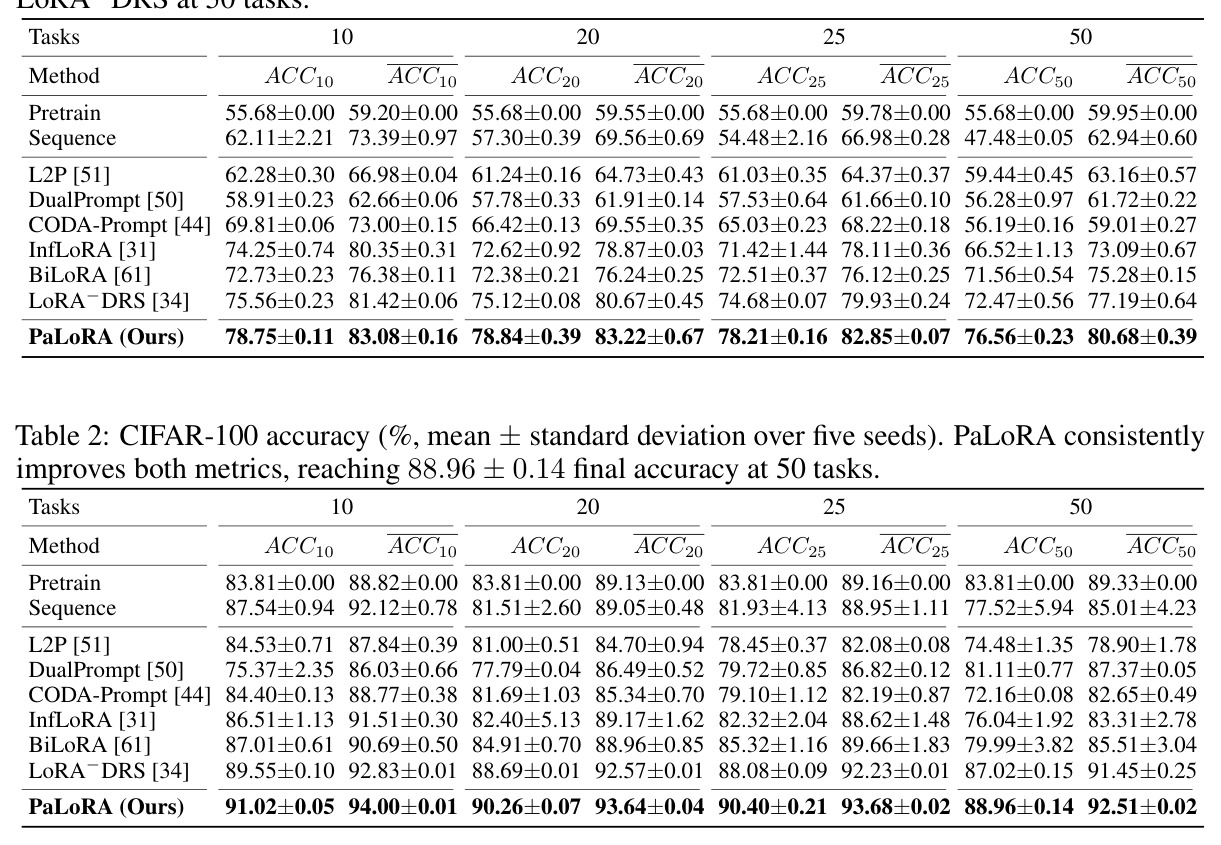
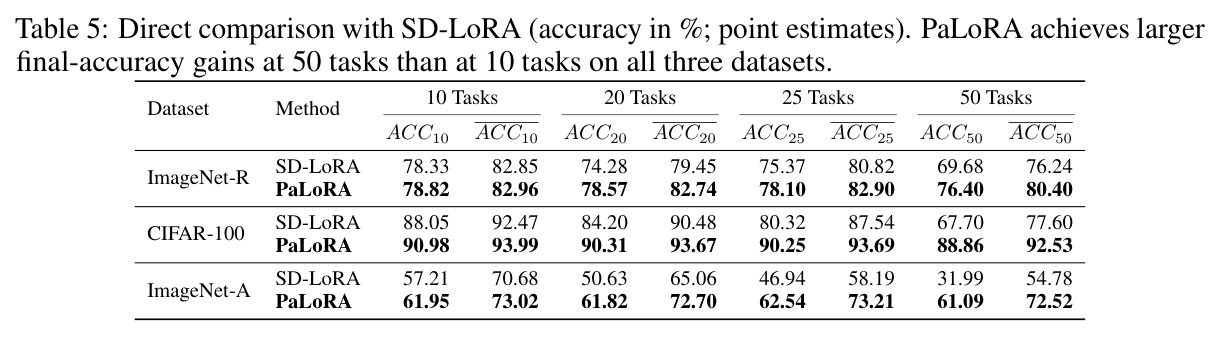
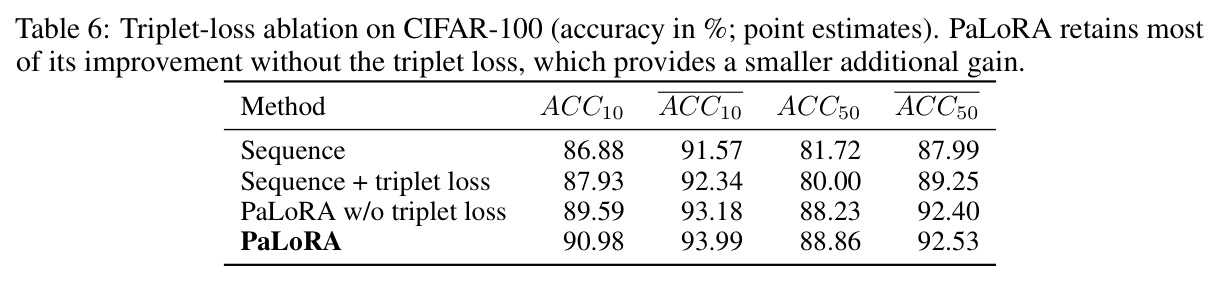
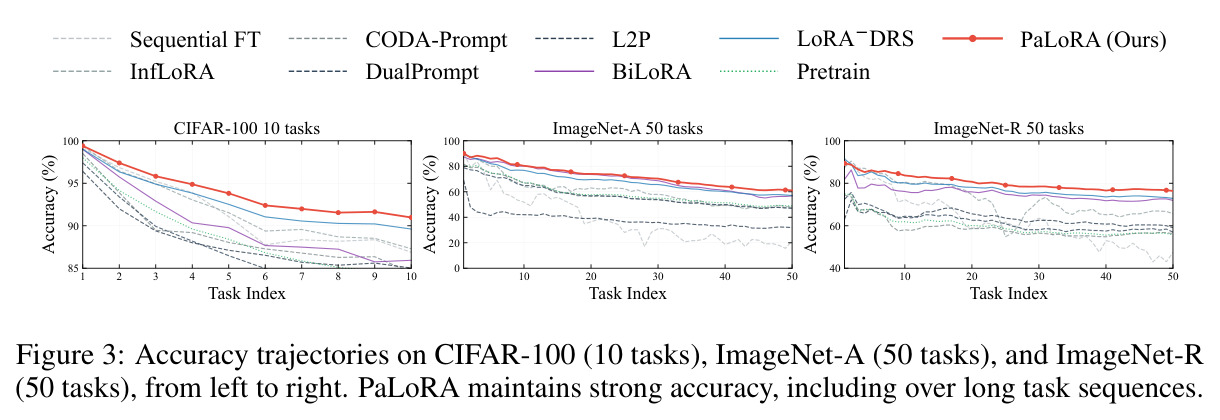
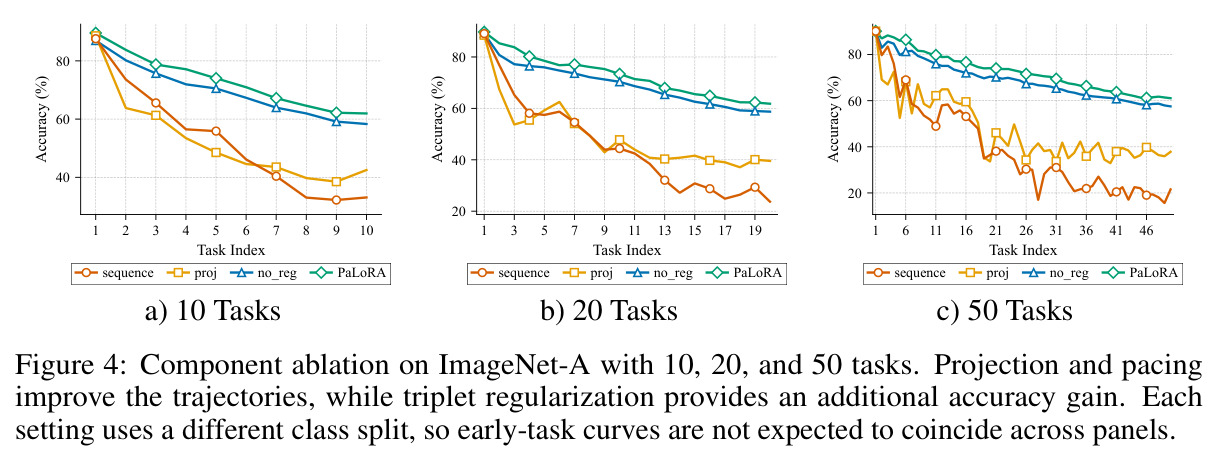
五种子实验显示 PaLoRA 在全部 12 个设置的最终与平均精度均第一。50 任务长序列:ImageNet-R 最终精度 76.56±0.23 对最强基线 LoRA−DRS 72.47±0.56(+4.09 点,平均精度 80.68 对 77.19);ImageNet-A 60.90±0.28 对 56.91±0.23(+3.99 点);CIFAR-100 88.96±0.14 对 87.02±0.15。从 10 到 50 任务,ImageNet-R/ImageNet-A 最终精度仅降 2.19/0.65 点。BWT 上 50 任务 CIFAR-100 -4.72、ImageNet-A -7.09 均最优(LoRA−DRS 为 -5.26、-9.01)。与 SD-LoRA 对比,50 任务增益 6.72/21.16/29.10 点。消融:Figure 4 显示投影缓解遗忘、配速进一步抬升;Table 6 中三元组贡献 0.63 点(88.23→88.86),加到无配速的 Sequence 反而降 1.72 点;Figure 5 中配速指数 $\alpha=0.5$ 最优。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet-R 类增量持续学习(50 任务划分) | 最终精度 ACC(五种子均值±方差) | 76.56±0.23 | LoRA−DRS:72.47±0.56 | +4.09 个百分点;平均精度 80.68 对 77.19(+3.49) |
| ImageNet-A 类增量持续学习(50 任务划分) | 最终精度 ACC(五种子均值±方差) | 60.90±0.28 | LoRA−DRS:56.91±0.23 | +3.99 个百分点;平均精度 72.41 对 68.22(+4.19) |
| CIFAR-100 类增量持续学习(50 任务划分) | 最终精度 ACC(五种子均值±方差) | 88.96±0.14 | LoRA−DRS:87.02±0.15 | +1.94 个百分点;平均精度 92.51 对 91.45(+1.06) |
| ImageNet-A 50 任务(与 SD-LoRA 直接对比,点估计) | 最终精度 ACC | 61.09 | SD-LoRA:31.99 | +29.10 个百分点(CIFAR-100 +21.16、ImageNet-R +6.72 同期对比) |
| 遗忘度量:CIFAR-100 / ImageNet-A(50 任务) | 后向迁移 BWT(越高越好) | -4.72(CIFAR-100)/ -7.09(ImageNet-A) | LoRA−DRS:-5.26(CIFAR-100)/ -9.01(ImageNet-A) | 遗忘分别减少 0.54 和 1.92 个百分点;ImageNet-R 上 -5.20 略逊于 LoRA−DRS 的 -4.92 |
局限与改进
作者承认的局限:配速律 $s^*=\sqrt{R/c}$ 在单层线性模型、各向异性泄漏与局部二次敏感度假设下推导,用于深层 ViT 只是近似缩放原则而非形式保证,实验未验证这些假设在真实非线性网络中成立;预算常数 $C$ 与能量阈值 $\tau$ 依赖敏感性实验选定,更广泛设定下行为未知;评估仅限图像分类,未触及 LLM/MLLM。我的补充观察:其一,理论把各方向泄漏-曲率乘积平均成单一量 $\Gamma^2$,掩盖方向间数量级差异,增益可能部分来自投影与压缩而非配速本身——Figure 4 中 proj 到 no_reg 的配速增量无单独量化数字;其二,SVD 压缩的额外计算与显存开销正文未给具体数字;其三,ImageNet-R 上 BWT 略输 LoRA−DRS(-5.20 对 -4.92),"更高精度+稍多遗忘"的张力仍在;其四,example-free 设定下当任务分布剧烈漂移时,基于旧更新谱的有效秩估计可能失真;其五,三元组正则在增量后期新类样本稀少时的行为未分析。
独立分析的弱点
第一,理论-实践鸿沟:$\Gamma^2=\frac{1}{R}\sum_i\lambda_i\gamma_i^2$ 把方向异质性压缩成标量,若个别历史方向曲率极大,全局均匀配速会对所有方向"一刀切",可改为按方向曲率加权的各向异性配速 $s_i^*=\sqrt{R\,c_i/c}$。第二,预算系数 $C$ 及 $\tau$、$\lambda$、$m$ 靠敏感性实验手选,缺少自动选择机制,可用新任务验证集在线估计 $C$。第三,每任务一次的全矩阵 $d\times d$ SVD 在大模型上代价高,可用随机化 SVD 或只在注意力投影层做秩估计降本,正文未报耗时数字。第四,评估止步于 ViT 图像分类,而 LoRA 持续学习的主战场是语言模型指令流,有效秩 $R$ 在语言任务上是否合适待验证。第五,三元组正则只贡献约 0.63 点(CIFAR-100 50 任务)且无配速时为负收益,性价比存疑。第六,未报告方差随任务位置的演化:50 任务 ImageNet-A 上 Sequence 的 ±8.38 与 PaLoRA 的 ±0.28 差异巨大,缺少长序列训练稳定性的细粒度分析。
未来方向
作者提出的方向:把 PaLoRA 扩展到生成模型的持续适应(LLM、MLLM);探索 LoRA 之外架构中"累积知识量"的合适度量(因为更新配速原则本身可能普适于其他 PEFT 形式),以及在更广泛的持续学习设定中检验配速常数与 SVD 阈值的行为。基于本文成果可以延伸的:把单层线性模型下的 $s^*=\sqrt{R/c}$ 推广到多层非线性情形,例如用神经切线核(NTK)或 Fisher 信息替代方向曲率 $\lambda_i$、为各向异性泄漏建模方向相关预算,争取更接近形式化的保证;将全局标量配速细化为逐层或逐模块配速 $s_l^*=\sqrt{R_l/c_l}$,因为不同层有效秩差异通常很大;与轻量经验回放结合,研究有小规模旧数据时预算 $c$ 的动态调整;把有效秩估计在线化(流式 SVD / 增量特征值追踪),免除每任务一次的全量分解并支持更细粒度的中途配速;研究配速与自适应优化器(Adam 二阶矩)的交互——当前分析基于固定步长 GD,泄漏模型在自适应优化器下需重新推导;最后在多模态与指令微调流上验证 $\sqrt{R}$ 律的跨模态普适性。
复现评估
复现条件总体较好。代码已在 GitHub 开源(https://github.com/liyuxuan-github/PaLoRA),三个基准 CIFAR-100、ImageNet-R、ImageNet-A 均为公开数据集,任务划分采用社区标准的 10/20/25/50 类切分,主表报告五种子(0–4)的均值±标准差,附录 B 提供实现细节、更多精度轨迹、有效秩比较、敏感性分析、计算开销、LoRA 变体与骨干网络替换实验,可复现性信息相当完整。方法超参数不算多:LoRA 秩 $r$、能量阈值 $\tau$、预算系数 $C$、正则权重 $\lambda$、间隔 $m$ 及基础学习率 $\eta$。主要成本在于:需要 ViT 预训练骨干按任务序列训练,任务数最多 50,完整主表为 3 数据集 × 4 划分 × 5 种子,训练量可观;SVD 压缩在 $d\times d$ 累积矩阵上的开销随模型宽度增长。综合判断:研究生级别可先跑 10 任务划分在单卡上验证核心结果,完整复现全部五种子表格需要较多算力与数天时间,难度中等偏易。
论文图表
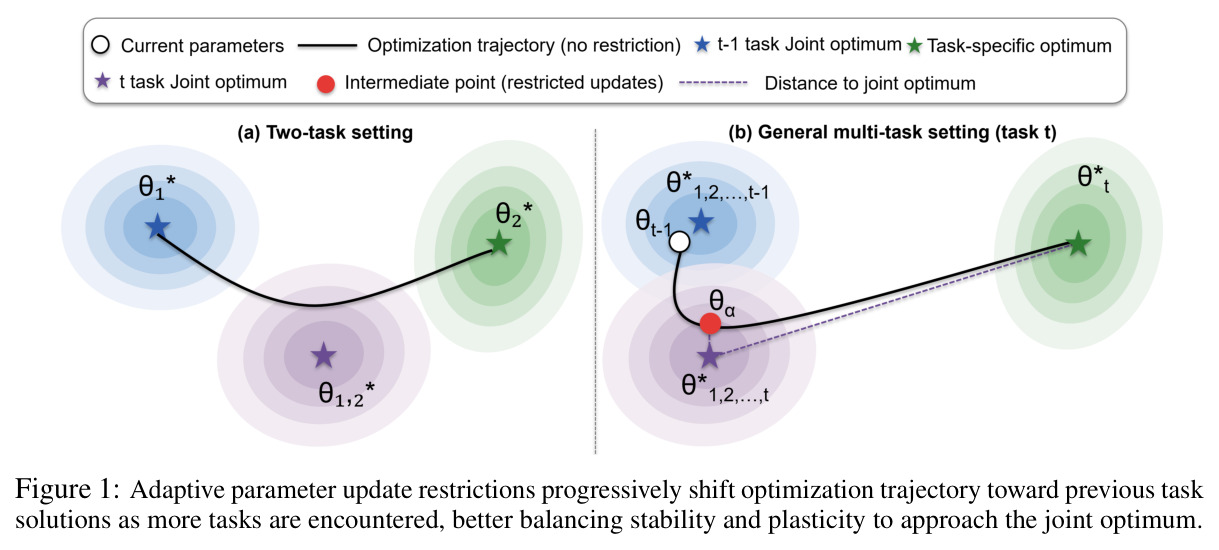
两幅示意图解释限制更新幅度的作用机理。(a) 两任务设定:$\theta^*_1$、$\theta^*_2$ 分别是在任务 1、任务 2 上单独训练的最优解,$\theta^*_{1,2}$ 是联合最优解;无约束微调会跑到 $\theta^*_2$(偏离联合最优),而限制参数移动幅度会把模型约束在 $\theta^*_1$ 与 $\theta^*_2$ 之间轨迹的中间点,更接近联合最优。(b) 推广到 $t$ 任务设定:学完 $t-1$ 个任务后模型处于 $\theta_{t-1}$,无约束训练任务 $t$ 会到 $\theta^*_t$;随着任务增多,$\theta_{t-1}$ 越来越能代表所有历史任务的性能,最优折中点 $\theta^*_\alpha$ 逐渐向 $\theta_{t-1}$ 偏移,说明限制强度应随任务数增加。
这是全文直觉的图示来源:它回答了"为什么限制更新幅度能缓解遗忘"以及"为什么限制强度应随任务积累而收紧"两个动机问题,是理解 $\sqrt{R}$ 节奏律的直观基础,Figure 1b 中折中点随任务数向旧解偏移正是配速律的几何解释。