ProAR:用自回归视频模型学习前瞻性推理 ProAR: Learning Prospective Reasoning with Autoregressive Video Models
以目标帧预测与未来表征自对齐双重引导,让自回归视频生成从被动反应走向前瞻推理
前置知识
自回归(AR)视频生成
视频被切分为 $N$ 个潜空间 chunk,模型按因果分解 $p_\theta(z_{1:N}|c)=\prod_{i=1}^{N}p_\theta(z_i|z_{<i},c)$ 逐块生成,每块只依赖历史与条件 $c$(如输入图和文本)。训练时用 teacher forcing 并行去噪所有块,推理时逐块滚动并把生成结果追加进历史,天然支持长视频、流式与交互式应用。
ProAR 的全部设计都在这个框架内展开,理解 chunk 化、因果掩码以及训练-推理的不对称(并行 teacher forcing vs 不可逆滚动)是读懂其动机与方法的前提。
Flow Matching(流匹配)
一类连续归一化流生成模型的训练目标:对干净数据 $z^0$ 构造线性插值的噪声中间态 $z^t=(1-t)z^0+t\epsilon$($\epsilon\sim\mathcal{N}(0,\mathrm{I})$),训练速度场网络 $v_\theta$ 用 MSE 回归 $\epsilon-z^0$,推理时沿学到的速度场积分完成去噪。本文的 AR 视频模型每个 chunk 的条件分布都用流匹配建模。
论文的三个损失 $\mathcal{L}_{current}$、$\mathcal{L}_{goal}$、$\mathcal{L}_{AR}$ 全部建立在该公式上,且 goal 帧与当前块在同一时刻 $t$ 加噪、联合去噪,不懂流匹配就看不懂 Outcome 模块。
Teacher Forcing(教师强制)
序列训练技巧:训练时用真实的历史(ground truth)而非模型自己的生成结果作为条件,从而所有目标块可在一次前向中并行去噪,各自只通过因果掩码看到干净历史。代价是训练与推理分布不一致(推理只能依赖自己生成的历史)。
Transition 模块的点睛之笔正是利用 teacher forcing 的副产品:干净的下一块 $z_{i+1}^0$ 本来就要编码进历史流,其隐状态可以'免费'拿到,这是理解单次前向自监督的关键。
非对称注意力掩码
让不同 token 集合之间的注意力单向可见的掩码设计。本文中目标帧 token 只能看到干净历史和自身(被屏蔽于 noisy 当前块之外),而当前块 token 则额外关注目标 token,形成 'target-first' 的依赖方向。
这是 Outcome 引导的核心机制,用于解决一对矛盾需求:既要防止不确定的当前状态污染目标信念,又要让目标引导当前生成,读懂 Fig. 2(b) 必备。
扩散/DiT 中间层表征与自对齐
研究表明扩散模型的中间层隐状态编码了丰富的语义与时间抽象,且强内部表征可以指导弱表征(自蒸馏思路)。典型做法是用逐 token 余弦距离把学生表征对齐到 stop-gradient 固定的教师表征,梯度只回传到学生侧与轻量投影器。
Transition 引导就是一个模型内部的自对齐:干净 next chunk 表征当教师、noisy 当前块表征当学生,理解该范式才能明白为什么它能'教'当前状态预期未来。
研究动机
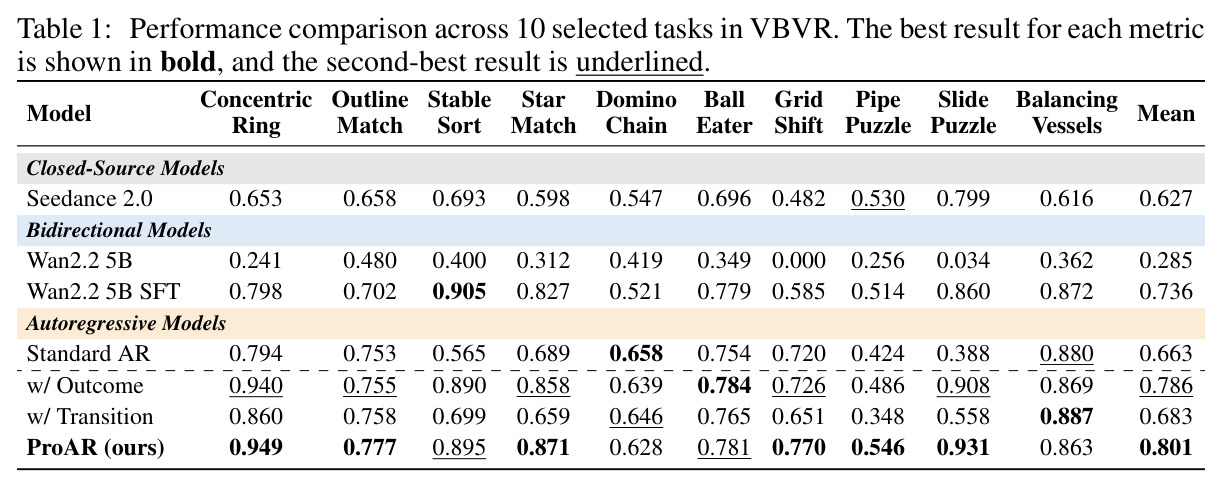
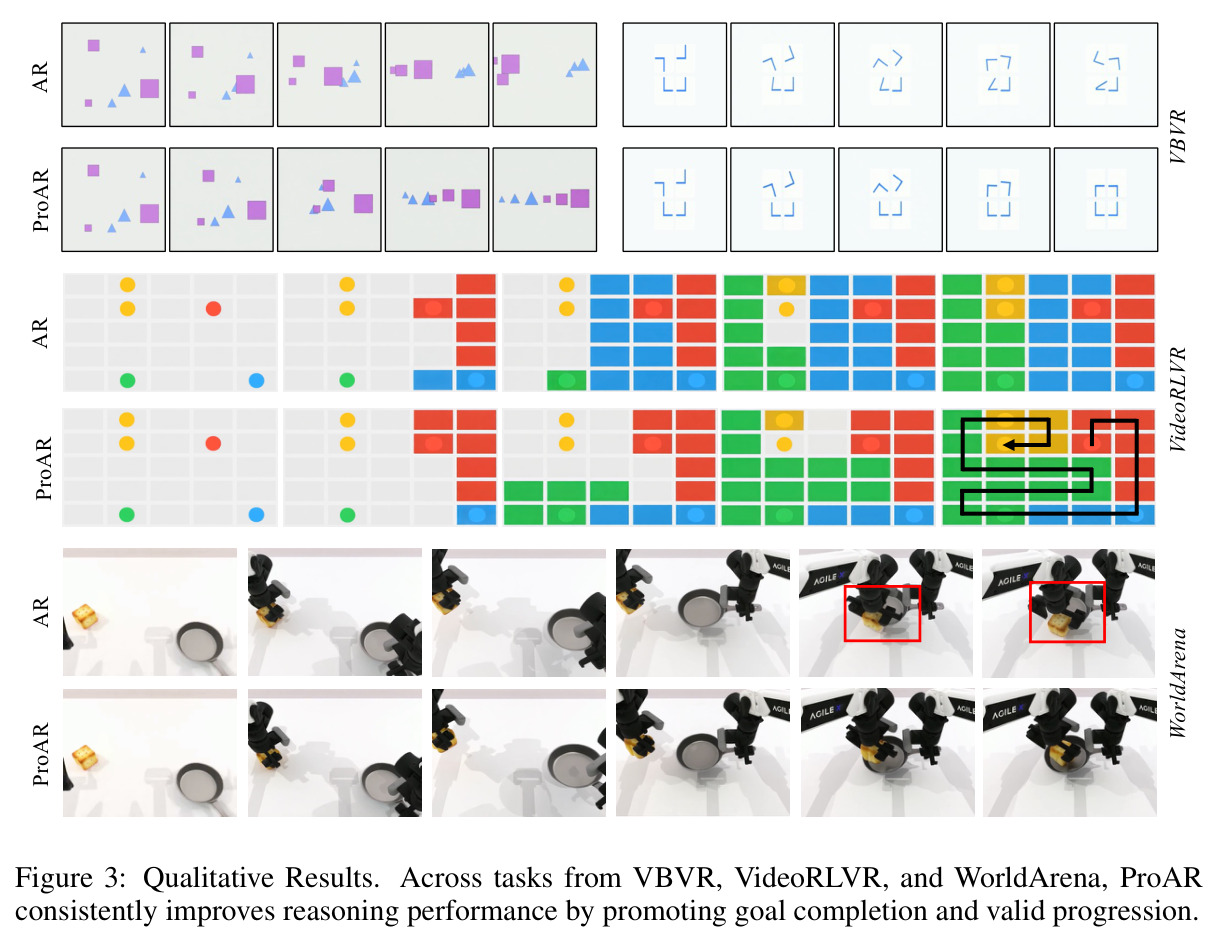
自回归(AR)视频模型逐块因果生成,天然适合长视频与流式交互应用,但其训练目标 next-chunk prediction 本质上只优化'给定历史下当前块的局部视觉合理'。形式上,流匹配损失 $\mathcal{L}_{AR}=\mathbb{E}_{i,t,\epsilon}\big[\lVert v_\theta(z_i^t,t\,|\,z_{<i}^0,c)-(\epsilon-z_i^0)\rVert^2\big]$ 从不检查当前预测是否服务于最终任务目标、是否为后续转移留出有效空间。这对'视频原生推理'(生成过程本身就是解题过程,如走迷宫、滑块拼图)是致命的:推理时每个生成块都被追加进历史且不可修改,早期局部合理但方向错误的小偏差会复利式累积,一条局部流畅的 rollout 最终可能彻底偏离目标。数据上,在 VBVR 的 10 个感知与空间推理任务上,teacher-forcing 训练的标准 AR 平均分仅 0.663,低于双向 Wan2.2 SFT 的 0.736;定性上(Fig. 5)标准 AR 出现两类典型失败:Goal Failure(过程流畅但最终未达成任务)与 Rule Violation(中间步骤违反任务规则或物理约束,如推箱子穿墙)。现有工作大多聚焦视觉质量、时序一致性或预测视野扩展,并未直面这种短视性。
本文的目标是本文要让 AR 视频生成从'被动反应历史'转变为'前瞻规划未来',即赋予模型作者定义的 prospective reasoning 能力:基于已有观测预期可能的未来结果与状态转移,并用这种预见引导当前生成。具体拆成两个互补目标:长程上,模型应在每个生成步骤维护对最终结果的预期(goal belief),使每一步都朝目标收敛,解决 goal completion(结果对不对);短程上,模型应预期即将发生的转移方向,保证中间步骤符合任务逻辑与物理约束,解决 progression validity(过程合不合法)。同时框架必须满足工程约束:不改变逐块因果生成的基本流程、推理开销几乎为零、训练开销控制在 12%–14% 以内,并在感知、空间、抽象和具身四类异构推理任务上都取得一致增益。
与已有工作不同的是,已有工作的切入点大致两类:一类只拉长预测视野或改进稳定性(如 Next-Forcing 多块预测、层次化粗到细去噪),作者指出视野扩展能改善视觉质量但对任务导向生成并不充分;另一类依赖外部监督信号——Video-Mirai 需要额外一次前向传递把双向表征蒸馏进因果特征,VideoREPA 等需要对齐 JEPA/DINOv2 外部编码器。此外多数视觉推理方法构建在可全局交互的双向生成器上,AR 模型严格的因果性(看不到未来、不能回头改错)使这些方案无法直接迁移。ProAR 的独特切入有二:其一,把未来引导解耦为'显式-稀疏'的结果监督与'隐式-稠密'的转移监督两条互补通道,而非单纯延长视野;其二,巧妙利用 AR 训练自身的 teacher-forcing 性质——干净的未来块本来就作为条件出现在同一前向的历史流中,从而无需外部编码器、无需额外前向即可获得干净的教师表征,把'预知未来'的成本压到接近零。
核心方法
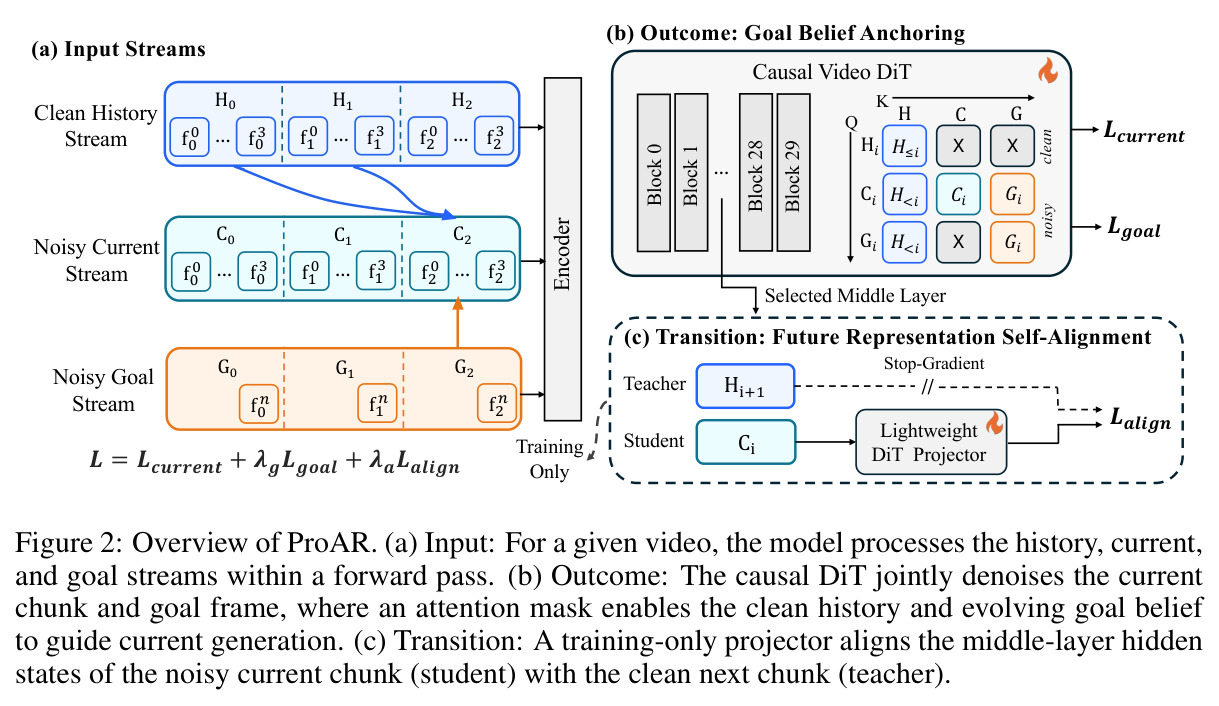
直觉上,ProAR 给 AR 视频模型同时装上'目标感'(我要去哪)与'方向感'(下一步往哪走)。技术上它保留标准 AR 视频扩散框架:视频切成 $N$ 个潜空间 chunk,按 $p_\theta(z_{1:N}|c)=\prod_{i=1}^{N}p_\theta(z_i|z_{<i},c)$ 因果分解,每个条件分布用流匹配建模,噪声中间态为 $z_i^t=(1-t)z_i^0+t\epsilon$;骨干采用开源 Wan2.2-TI2V-5B 改造成的因果视频 DiT。每次去噪的前向中并行处理三条流:干净历史流、noisy 当前块流与 noisy 目标帧流。总损失为 $\mathcal{L}=\mathcal{L}_{current}+\lambda_{goal}\mathcal{L}_{goal}+\lambda_{align}\mathcal{L}_{align}$,其中 $\mathcal{L}_{current}$ 即标准 AR 去噪损失,$\mathcal{L}_{goal}$ 监督目标帧预测,$\mathcal{L}_{align}$ 做未来表征自对齐;默认权重 $\lambda_{goal}=0.25$、$\lambda_{align}=0.01$(加权后对齐项约占总损失的 3%–10%)。推理时模型逐块滚动生成:目标信念随历史增长每步重新估计、逐步精化,对齐投影器被完全丢弃,因而不带来额外推理成本。
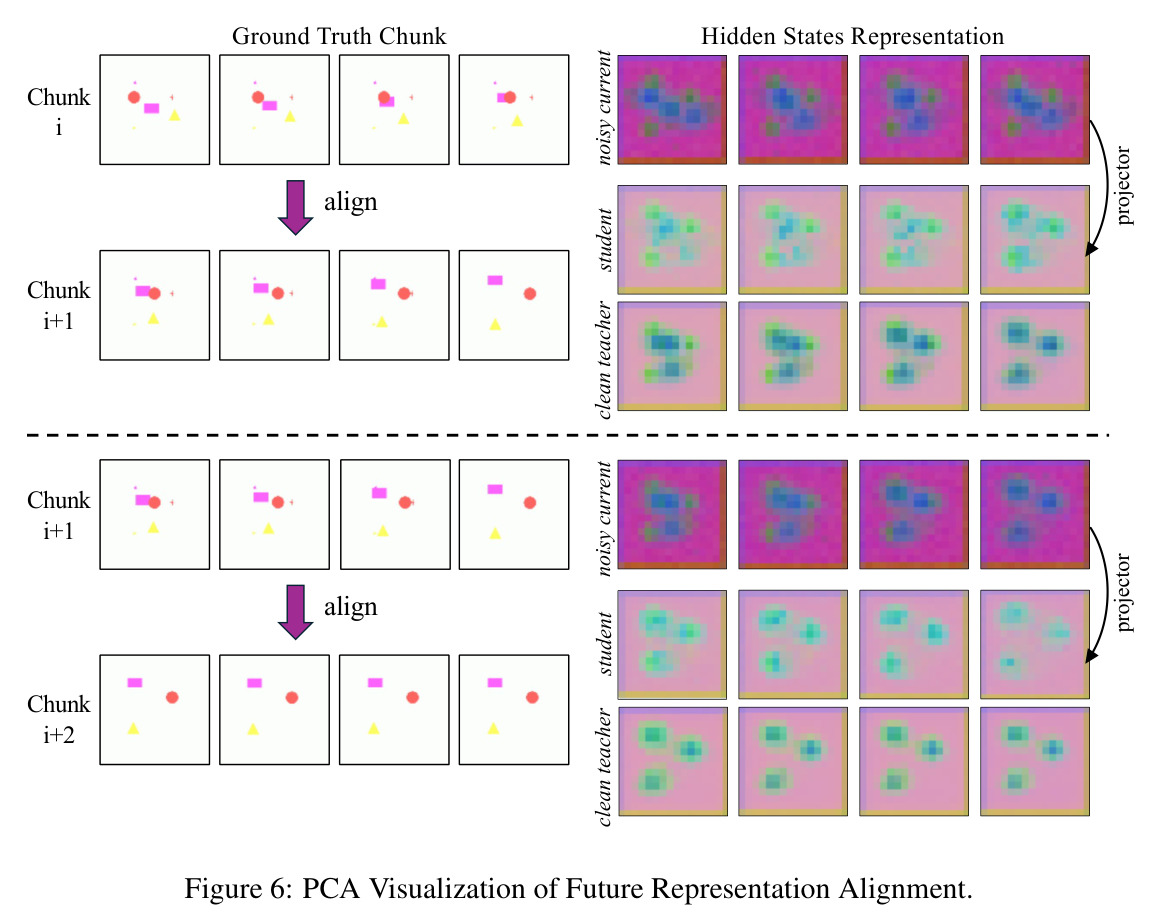
核心创新是两个互补引导机制及其信息流设计。Outcome 引导(目标信念锚定):在 AR 循环内联合预测当前块与代表最终状态的目标帧,并引入非对称注意力掩码——目标 token 只能看到干净历史和自身、被屏蔽于 noisy 当前块之外,而当前 token 额外关注目标 token。这种 target-first 依赖保证不确定的当前状态不会污染目标信念,目标却能持续引导当前生成;且目标信念不是一次性规划的静态条件,而是随历史增长每步被重新估计的'演化信念'。Transition 引导(未来表征自对齐):让当前 noisy 表征去预期下一步。关键洞察是 teacher-forcing 训练中干净的下一块 $z_{i+1}^0$ 本来就要编码进历史流去条件化后续去噪目标,因此其隐状态与 noisy 当前块的隐状态可在同一次前向中'免费'获得——干净的未来表征天然充当教师,noisy 的当前表征充当学生。这与 Video-Mirai(需额外前向蒸馏)或 REPA 类外部编码器对齐有本质区别,也是'显式稀疏 + 隐式稠密'双重监督得以成立的根基。
方法步骤详情
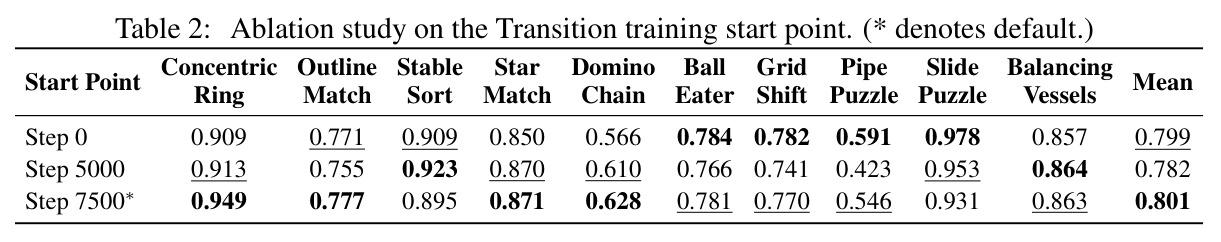
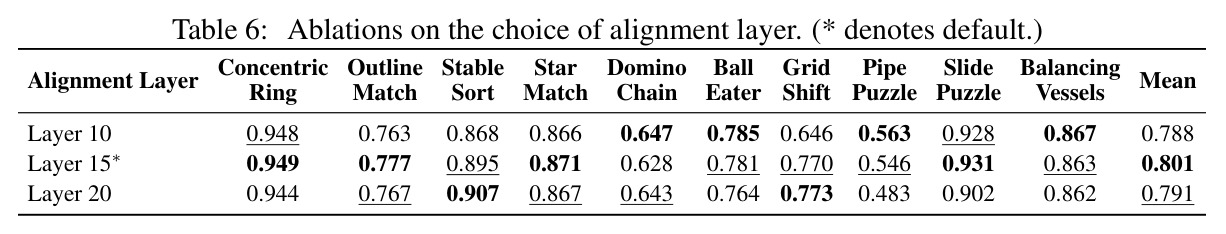
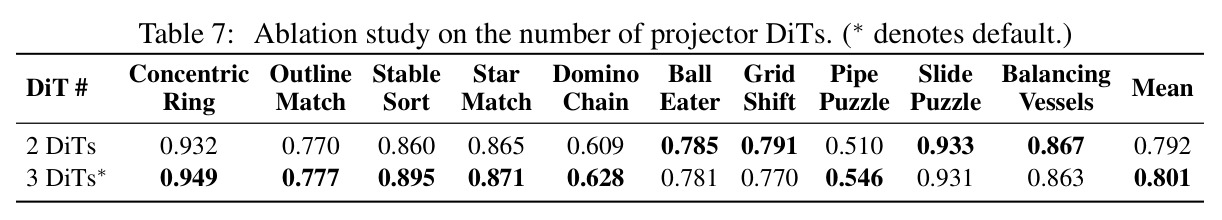
完整流程如下。(1)输入构造:给定条件 $c$(输入图+文本),把目标视频切成 chunk(VBVR/VideoRLVR 每块 4 帧,WorldArena 每块 8 帧),取视频最后一帧为干净目标 $g^0$。(2)噪声构造:当前块与目标帧在同一流匹配时刻 $t$ 独立加噪:$z_i^t=(1-t)z_i^0+t\epsilon_{z,i}$,$g_i^t=(1-t)g^0+t\epsilon_{g,i}$。(3)联合去噪:共享 DiT 单次前向同时预测两条流的速度场;当前流由 $\mathcal{L}_{current}$ 监督,目标流由 $\mathcal{L}_{goal}=\mathbb{E}\big[\lVert v_\theta^g(g_i^t,t|z_{<i}^0,c)-(\epsilon_{g,i}-g^0)\rVert^2\big]$ 监督;非对称掩码规定目标 token 只看干净历史与自身,当前 token 额外看目标 token。(4)表征对齐:在骨干第 15 层(共 30 块)提取干净下一块的教师表征 $H_{i+1}^\ell$ 与 noisy 当前块的学生表征 $C_i^\ell$,轻量投影器 $P_\phi$(3 个 DiT 块,236M 参数,仅为骨干的 4.7%)把学生映射为 $\hat{H}_{i+1}^\ell=P_\phi(C_i^\ell)$,与 stop-gradient 固定的教师做逐 token 余弦损失 $\mathcal{L}_{align}=\mathbb{E}\frac{1}{M}\sum_{m=1}^{M}\big[1-\cos(\hat{H}_m, H_m)\big]$,梯度只回传到 $P_\phi$ 与骨干的学生分支。(5)训练调度:Transition 从训练后期才激活(VBVR 第 7500/10000 步、VideoRLVR 第 3000/5000 步、WorldArena 第 7000/10000 步),此时骨干表征已稳定。(6)推理:丢弃 $P_\phi$,逐步联合去噪当前块与目标帧但只把当前块追加进历史,目标信念用扩展后的历史重新估计,全程无需真值未来帧。
技术新颖性
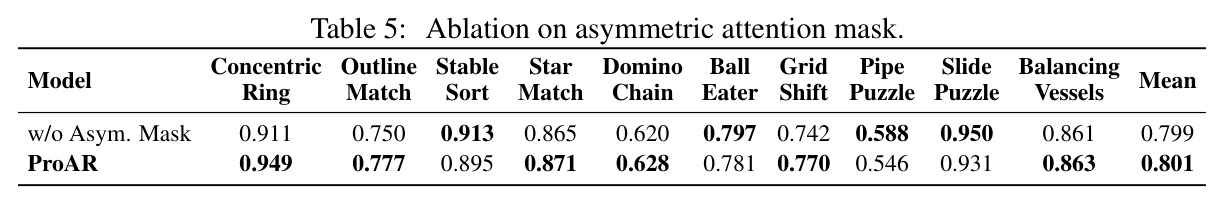
技术新颖性体现在四点。第一,目标信念被设计成 AR 循环内的'一等公民'而非一次性规划输出:每步重估、随证据演化,配合非对称掩码同时满足'噪声当前状态不得污染目标'与'目标必须引导当前生成'这对反向信息流需求,消融(Table 5)显示其整体分数 0.801 略优于无掩码的 0.799 且注意力更稀疏高效。第二,Transition 的单次前向自监督是对 AR 训练范式的巧用:干净未来块的表征本来就存在于历史条件流中,使其成为几乎零成本的未来感知方案(训练仅增 2%–3% 计算、推理零开销),明显优于需要额外前向的 Video-Mirai 和需要外部编码器的 REPA/VideoREPA。第三,late-start 调度:Table 2 显示从第 0 步就开对齐反而略差(0.799 vs 7500 步启动的 0.801),说明教师表征的质量依赖骨干先在目标任务上形成稳定结构,这一'先热身、后对齐'策略本身是可迁移的训练经验。第四,双重监督的互补性被系统验证:VBVR 上单独 Outcome 0.663→0.786、单独 Transition→0.683、合并 0.801;VideoRLVR 上平均精度 61.56→64.82→63.50→67.17,呈同样的超加性模式,证明长程结果感知与短程转移预期提供的是不同维度的引导。
实验结果
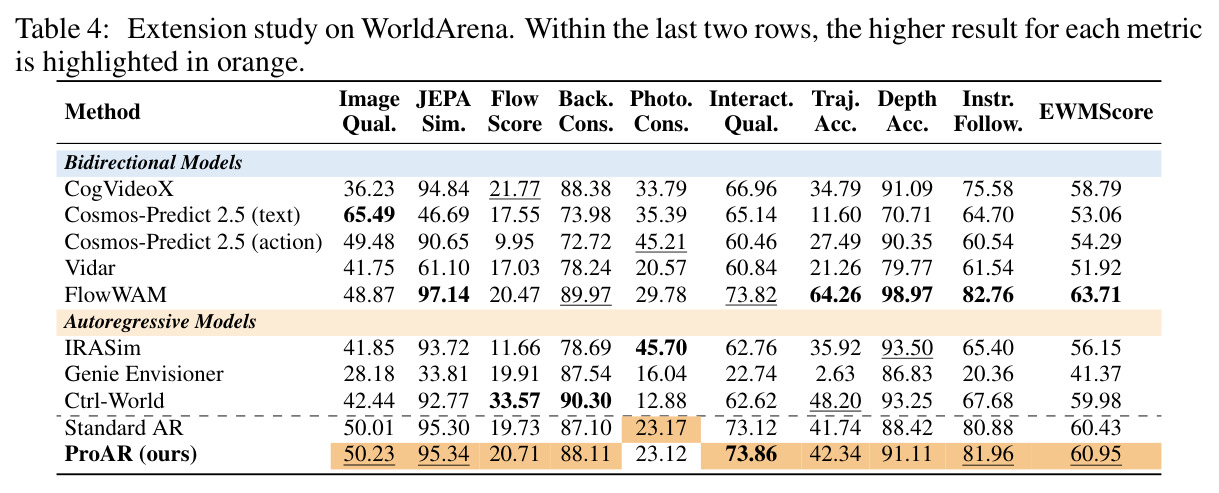
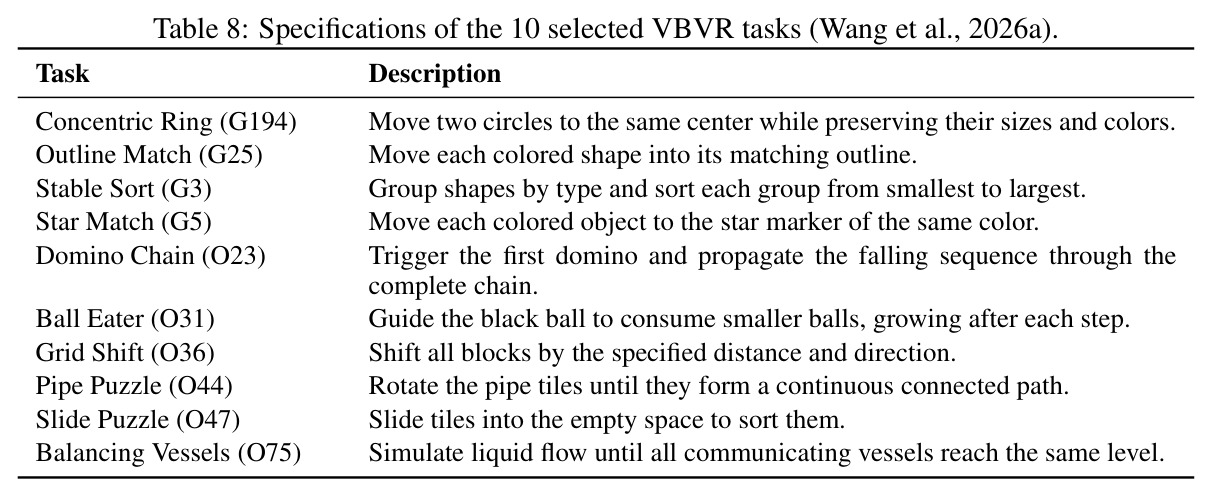
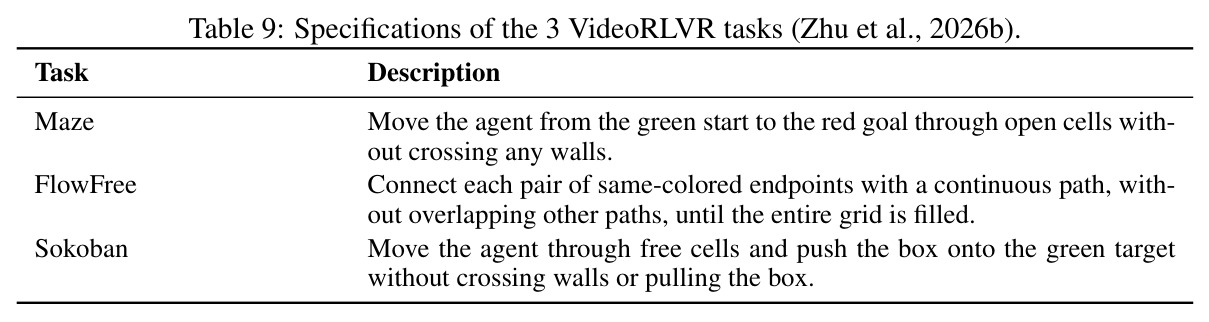
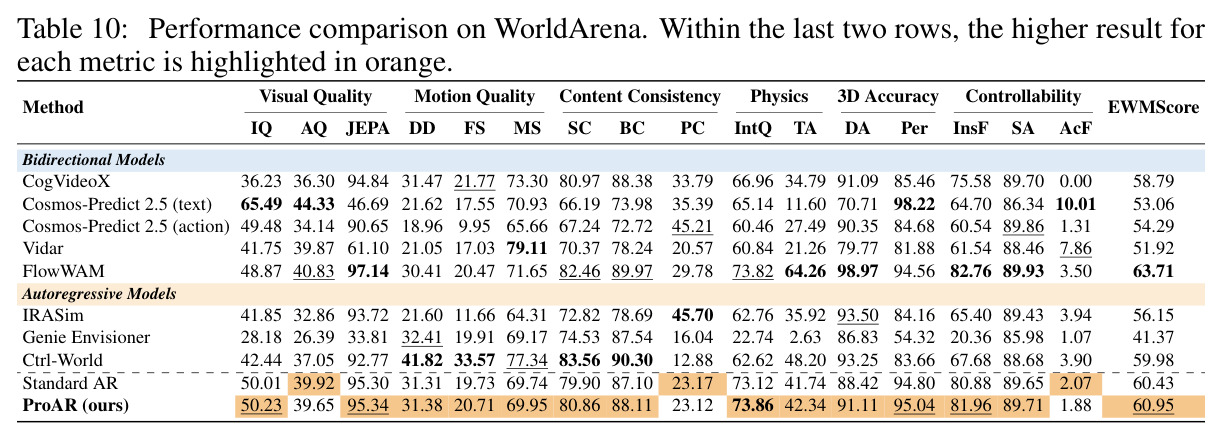
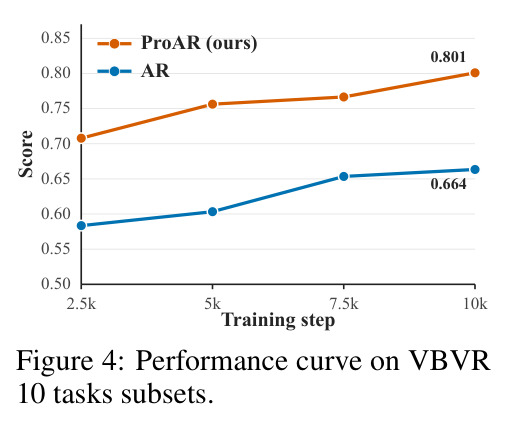
(1)VBVR 10 任务(每任务 50 个测试例,共 500 例):ProAR 平均分 0.801,比标准 AR 的 0.663 相对提升 20.8%,10 个任务中 8 个占优,其中 Slide Puzzle +0.543、Stable Sort +0.330、Pipe Puzzle +0.122;同时超过闭源 Seedance 2.0(0.627)0.174、超过双向 Wan2.2 SFT(0.736)0.065,而未微调的 Wan2.2 5B 仅 0.285,说明增益来自训练目标而非骨干能力。(2)VideoRLVR 3 个抽象推理游戏:teacher-forcing 的标准 AR 本就大幅超过双向基线(如 Sokoban SR 44.00 vs RL 后的 6.10),暗示因果生成天然契合顺序状态转移;ProAR 在此强基线上把平均成功率从 50.97 提到 52.97、平均精度从 61.56 提到 67.17,三个游戏的精度全部上升(Sokoban 40.18→47.62 最显著),SR 也全部上升(Maze 82.70、FlowFree 30.20、Sokoban 46.00)。(3)训练效率:ProAR 仅 2500 步即达 0.708,超过标准 AR 训满 10000 步的 0.663——即用 25% 的训练步数超越完全训练的基线;Transition 在 7500 步激活后分数从 0.7666 跳升至 0.8010。(4)WorldArena 具身扩展(50 个 RoboTwin 2.0 双臂操作任务):EWMScore 60.95,AR 系第一、全场第二(最高为 FlowWAM 63.71),16 项指标中 13 项优于标准 AR,如 Depth Accuracy 88.42→91.11、Instruction Following 80.88→81.96、Background Consistency 87.10→88.11,且推理仅增约 8% 时间。消融进一步确认:对齐层第 15 层最优(0.801,对比 L10 0.788 / L20 0.791),投影器 3 块优于 2 块(0.801 vs 0.792)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| VBVR 10 任务(感知与空间推理) | 平均任务分 | 0.801 | Standard AR 0.663;双向 Wan2.2 SFT 0.736;闭源 Seedance 2.0 0.627 | 相对 Standard AR +20.8%(绝对 +0.138),超过最强双向基线 +0.065 |
| VideoRLVR(Maze/FlowFree/Sokoban) | 平均成功率 SR | 52.97 | Standard AR 50.97 | +2.00,且三个游戏 SR 全部提升 |
| VideoRLVR(Maze/FlowFree/Sokoban) | 平均 Precision | 67.17 | Standard AR 61.56 | +5.61,其中 Sokoban 40.18→47.62 |
| 训练效率(VBVR 10 任务) | 超越满训基线所需训练步数 | 2500 步达 0.708(> AR 10000 步的 0.663) | Standard AR 需 10000 步达 0.663 | 仅用 25% 训练步数即超越满训基线,收敛约提速 4 倍 |
| WorldArena 具身推理(50 个双臂操作任务) | EWMScore(16 项指标均值) | 60.95 | Standard AR 60.43;全场最佳 FlowWAM 63.71 | +0.52,AR 系第一、全场第二,16 项指标中 13 项优于 Standard AR |
局限与改进
作者承认的局限(A.6):Outcome 引导用视频最后一帧作为目标,这在多数目标导向任务中有效,但在最终帧语义信息弱的场景(任务完成后进入闲置状态、或纯过程驱动的动力学)中监督信号会很弱,长程引导可能失效。我的补充观察:其一,VideoRLVR 的成功率提升幅度很小(50.97→52.97),且 FlowFree 上单用 Outcome 反而把 SR 从 29.40 拉低到 23.20,说明目标锚定对中间路径复杂的任务并不总是有利;其二,与专门的具身世界模型 FlowWAM(63.71)相比仍有约 2.8 分差距,ProAR 的优势主要体现在与 Standard AR 的受控对比而非全面 SOTA;其三,非对称掩码的整体收益很小(0.801 vs 0.799,10 任务中仅 6 个更好),其主要价值可能是稀疏注意力带来的计算效率而非性能;其四,整套方法依赖训练时能拿到干净的最终帧与下一帧真值(teacher forcing),隐含要求任务有可预测的终态与确定性参考解,对开放式的、多解的或随机动力学的环境并不直接适用;其五,所有评测都基于规则可验证的拼图/操纵类任务,对生成质量类指标(美感、多样性)的潜在副作用未报告。
独立分析的弱点
独立弱点分析:(1)最终帧目标启发式——在过程性任务(如倒水、化学反应)中最后一帧可能只是'停下来的样子',改进方向是作者提出的自适应里程碑引导:动态检测序列中最显著的关键帧或瓶颈状态作为灵活子目标,甚至可让模型生成多个候选目标帧再自我验证。(2)Transition 本质上是'模仿参考解的下一步',属于自模仿式监督,在多解任务上可能把模型锁死在训练分布的解法上——可与 VideoRLVR 式可验证奖励 RL 结合,用学生-教师余弦距离作为 rollout 的密集奖励或价值函数初始化。(3)推理时目标信念完全依赖模型自身估计,早期目标预测错误且未被纠正时会持续误导整条 rollout——可在测试时对 goal belief 做多候选采样加一致性打分,或引入时间回溯搜索。(4)推理开销虽小但非零(+8%~12%),对实时交互应用仍需优化,例如在低分辨率或稀疏 token 上预测目标帧。(5)对齐只在单一中间层(第 15 层)进行,多层联合对齐或分层对齐(浅层对齐外观动力学、深层对齐任务语义)可能进一步释放表征潜力;此外 236M 投影器的容量-收益关系(2 块 0.792 → 3 块 0.801)值得继续扫描更深层是否饱和。
未来方向
作者明确提出的方向:从固定末帧目标转向自适应里程碑引导——在视觉序列中动态检测最显著的关键帧或关键瓶颈状态,作为灵活目标或中间子目标,把前瞻推理推广到更开放、更复杂的物理环境。基于本文成果可自然延伸:(1)与强化学习融合:把前瞻对齐信号变成密集奖励,与可验证奖励的稀疏信号互补,统一解决'预期下一步'与'验证完成';(2)测试时规划:把每步重估的 goal belief 当作规划信号,做束搜索、回溯或目标条件一致性检查,进一步压低不可逆 rollout 的累积误差;(3)真实机器人策略学习:WorldArena 只是仿真评测,ProAR 式目标锚定可迁移到 action-conditioned 世界模型中稳定长程 rollout,服务零样本策略;(4)长时程视频生成:'目标信念随历史演化'的机制天然适合分钟级生成中的漂移抑制,可与流式 AR 推理系统结合;(5)用 VLM 自动挖掘里程碑/子目标标注,摆脱对人工终态标注与确定性参考解的依赖,让方法适用于多解与随机环境。
复现评估
复现条件总体较好。骨干为完全开源的 Wan2.2-TI2V-5B;三个基准(VBVR、VideoRLVR、WorldArena/RoboTwin 2.0)均为公开数据集或生成器,VBVR 官方每任务只有 5 个测试例,作者用官方数据生成器扩展到每任务 50 个(共 500 例),协议明确可复现。训练成本适中:2–4 块 NVIDIA B200、AdamW、学习率 $5\times10^{-6}$、全局 batch 16、训练不超过 10000 步,对 5B 模型属于中等规模实验室可负担的范围。超参在附录 A.1 给得相当完整:chunk 大小(4/8 帧)、$\lambda_{goal}=0.25$、$\lambda_{align}=0.01$(WorldArena 0.05)、Transition 激活步数(7500/3000/7000)、第 15 层对齐、3 块 236M 投影器、推理每 chunk 20 步去噪、各基准的分辨率与帧数(512×512;832×480/81 帧;640×480/121 帧)。未明确说明训练代码开源(仅给出项目主页),AR 化改造(因果注意力 + teacher forcing 并行去噪)与三个基准的规则评测器需要自行实现,评测器实现若有偏差会直接影响分数可比性。综合判断:有视频生成工程经验的团队复现核心结论难度中等,主要工作量在训练管线与评测协议的搭建。
论文图表
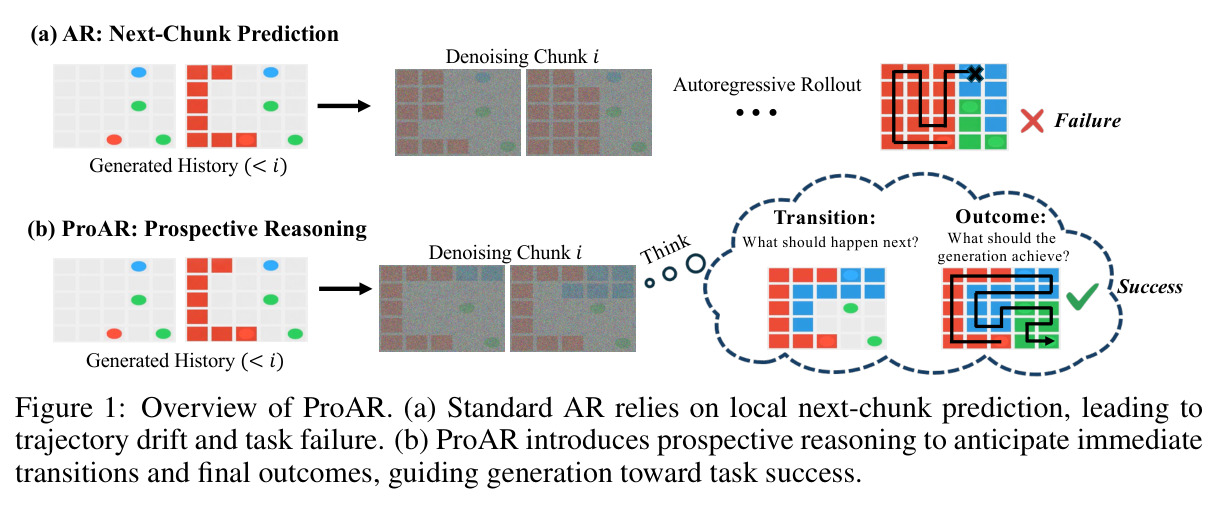
对比图:(a) 标准 AR 只做局部 next-chunk 预测,自回归滚动中轨迹逐渐漂移并以任务失败告终;(b) ProAR 在每个去噪块处同时思考'接下来该发生什么'(短程转移)与'生成要达成什么'(长程结果),引导生成走向成功。
这是全文的问题陈述与方法直觉的浓缩:一张图同时说清 AR 的短视失败模式与 ProAR 双重引导的设计哲学,是理解论文动机的入口。
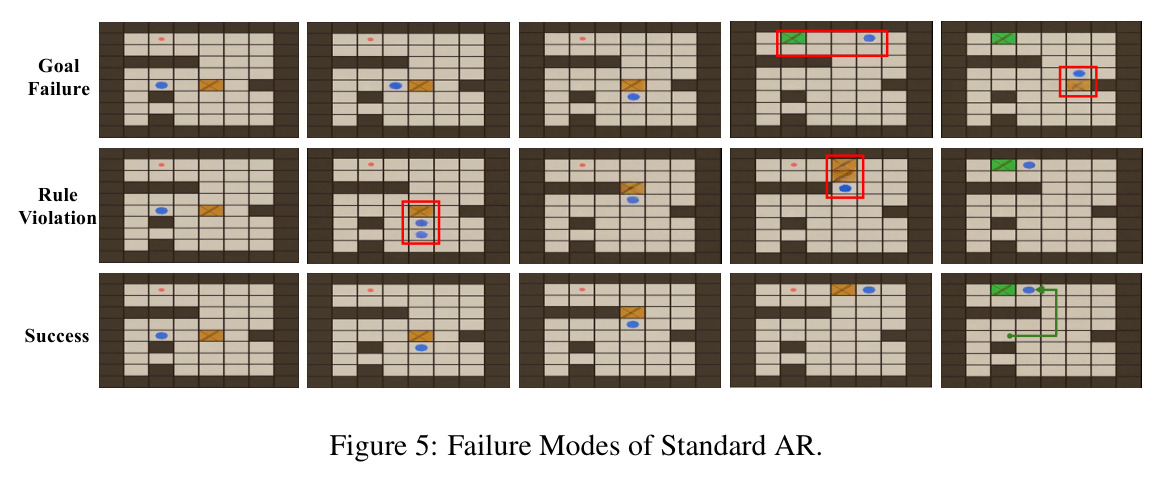
标准 AR 的三类典型行为:Goal Failure(局部合理但最终未完成任务)、Rule Violation(中间步骤违反任务规则,红框标出错误状态)、Success(转移合法并到达目标,绿色箭头标出成功路径)。
把 3.1 节抽象的'goal completion 与 progression validity 两个需求'具象成可视案例,是理解为什么需要双重引导的最直接证据。
VideoRLVR 三游戏(Maze/FlowFree/Sokoban)的 Precision/Recall/F1/SR 完整对比:双向 Wan2.2 SFT 与 RL 变体大幅落后(如 Sokoban SR 分别 2.70/6.10),Standard AR 已达 SR 79.50/29.40/44.00,ProAR 进一步提升到 82.70/30.20/46.00,平均精度 61.56→67.17。
展示'因果生成天然适合顺序状态转移任务'这一有趣发现,并验证 ProAR 在强基线上仍有一致增益,是第二核心基准的证据表。