HyperBrowseComp:网页浏览智能体的多语言多模态压力测试基准 HyperBrowseComp: A Multilingual and Multimodal Stress Test for Web-Browsing Agents
423道13语言人工创作的多模态浏览难题,最强模型仅得31.68%
前置知识
网页浏览智能体(Web-Browsing Agent)
以 LLM 为核心、能自主调用搜索和浏览工具的智能体系统。它把用户问题分解成一系列搜索查询,交替进行'推理—调用工具—阅读结果',最终综合多处证据给出答案。与普通 RAG 的区别在于它可以多轮、多跳地在开放互联网上自主规划搜索路径,而不是从固定语料库检索一次。
本文的整个基准就是为这类智能体设计的:题目要求跨视频、地图、扫描件等多跳搜寻,考察的正是智能体的持久信息搜寻与证据整合能力。
ReAct 范式
Reasoning + Acting 的缩写,一种让 LLM 交替输出'思考步骤'和'工具调用动作'的智能体协议。模型先推理当前该做什么,再发出一次搜索或抓取请求,观察返回结果后继续推理,循环直至给出最终答案。本文的评测在 Inspect AI 框架下实现,限制最多 25 个研究步骤。
内置搜索和 Exa 两种评测设置都采用 ReAct 协议,理解它才能明白模型'答错'可能发生在规划、检索还是综合任何一个环节。
BrowseComp 式基准与参数化知识饱和
BrowseComp 系列基准的特点是'答案难找但易验证':每题只有一个简短、唯一、可判定的答案(实体、日期、数值),难度全部来自寻找过程。其最大威胁是参数化知识泄漏——模型训练时见过答案就能跳过搜索直接作答,导致基准迅速失去区分度(即'饱和')。
本文用 7 个无联网模型审计剔除可被记忆回答的题目(500 剔 77),理解这个机制才能看懂数据构建流程为何如此设计。
检索工具链/评测框架
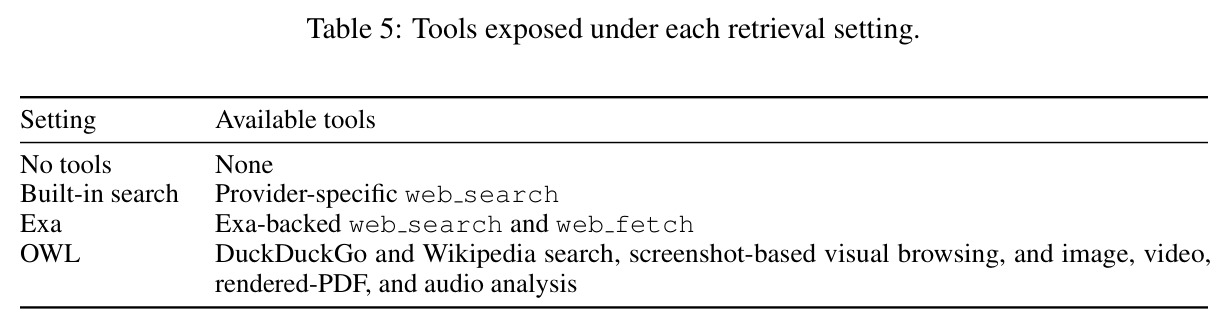
同一模型配上不同搜索后端构成的完整系统。本文对比三种:厂商内置搜索(如 Gemini 绑定 Google 搜索)、Exa(提供标准化 web_search/web_fetch 接口的第三方搜索 API)、OWL(CAMEL 框架的多智能体工作流,含任务经理、协调员、网页专员、多模态专员等角色分工)。
本文最重要的实证发现之一就是 harness 敏感性:换工具链后同一模型成绩波动可达 9 个百分点以上,模型能力与工具集成必须解耦看待。
LLM-as-Judge(模型自判分)
用 LLM 而非人工来判定模型答案是否正确,向判分器提供题目、完整回答和参考答案,输出二元判定。风险是'自我偏好'——模型可能偏袒自己生成的回答。缓解手段是答案足够短且无歧义,并用多个不同判分器交叉验证一致性。
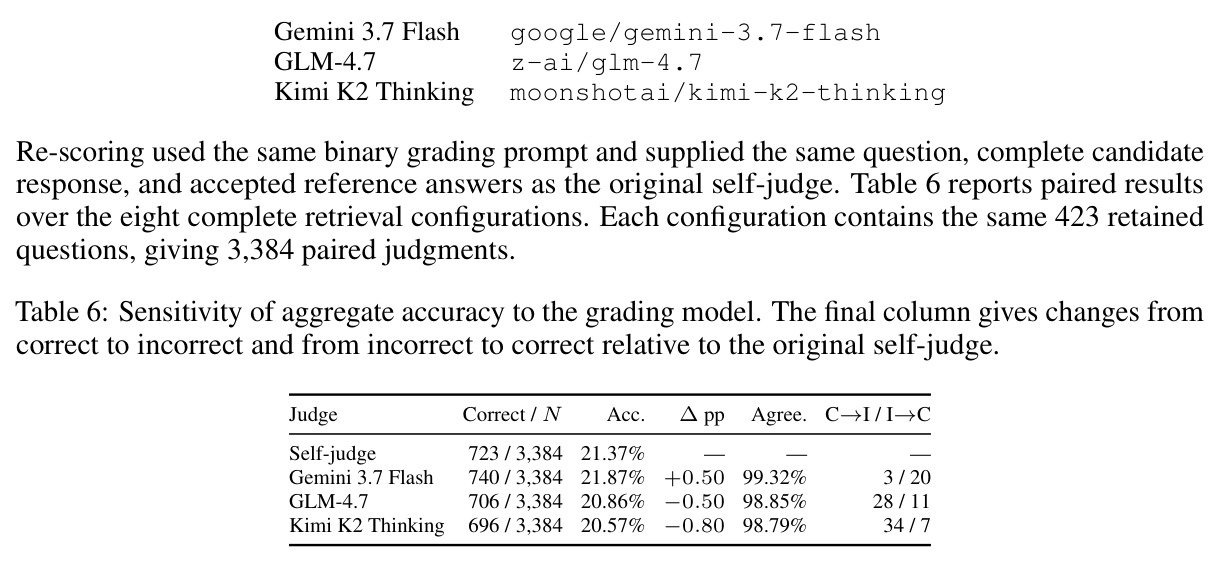
本文采用生成模型自判,并用 3 个替代判分器重判 3384 个样本验证稳健性(一致率 >98.7%,波动 ≤0.80pp),这个验证设计是评测可信度的关键。
研究动机
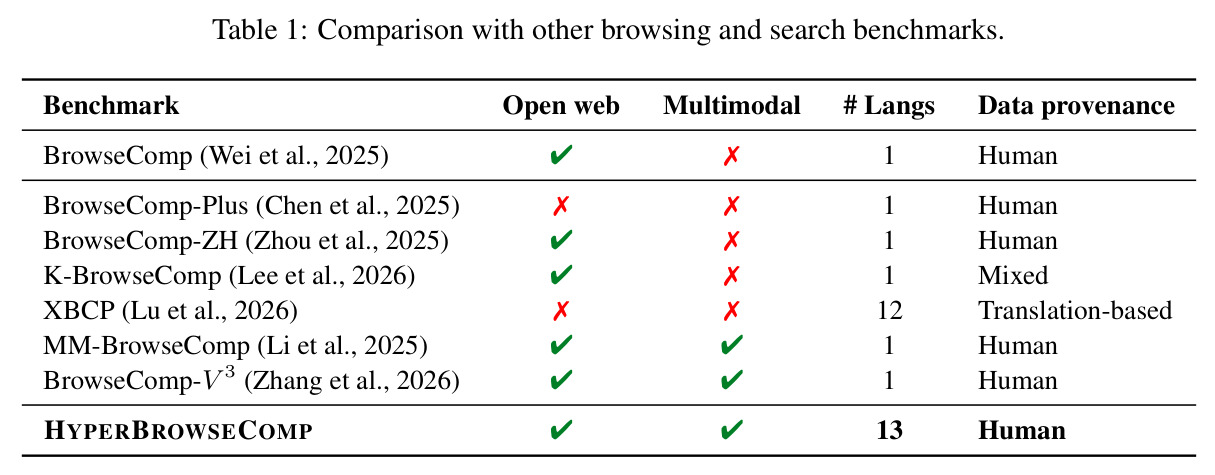
现有浏览类评测各自只切分了真实搜索难题的一个切面,三者交叉的困难场景完全空白。原版 BrowseComp 强调开放网络的持续检索,但以英语为中心、证据几乎全是文本,且题目偏'冷知识问答'风格,随着大模型参数知识膨胀而迅速饱和;BrowseComp-ZH 和 K-BrowseComp 把中文、韩文本地网络生态纳入考察,但仍是单一语言、纯文本;BrowseComp-Plus(XBCP)虽横跨 12 种语言,却采用受控翻译式构造——问题和答案仍是英语,只是把支撑文档翻译成多语言,无法反映各语言互联网真实的信息生态;MMSearch、MM-BrowseComp、BrowseComp-V3、MERRIN 把评测扩展到图像、视频、音频证据,但全部只覆盖英语。换言之,'多语言原生创作 × 多模态异构证据 × 开放动态网络'三者同时成立的评测此前不存在,模型在这种复合场景下到底多弱、弱在哪,无法量化。
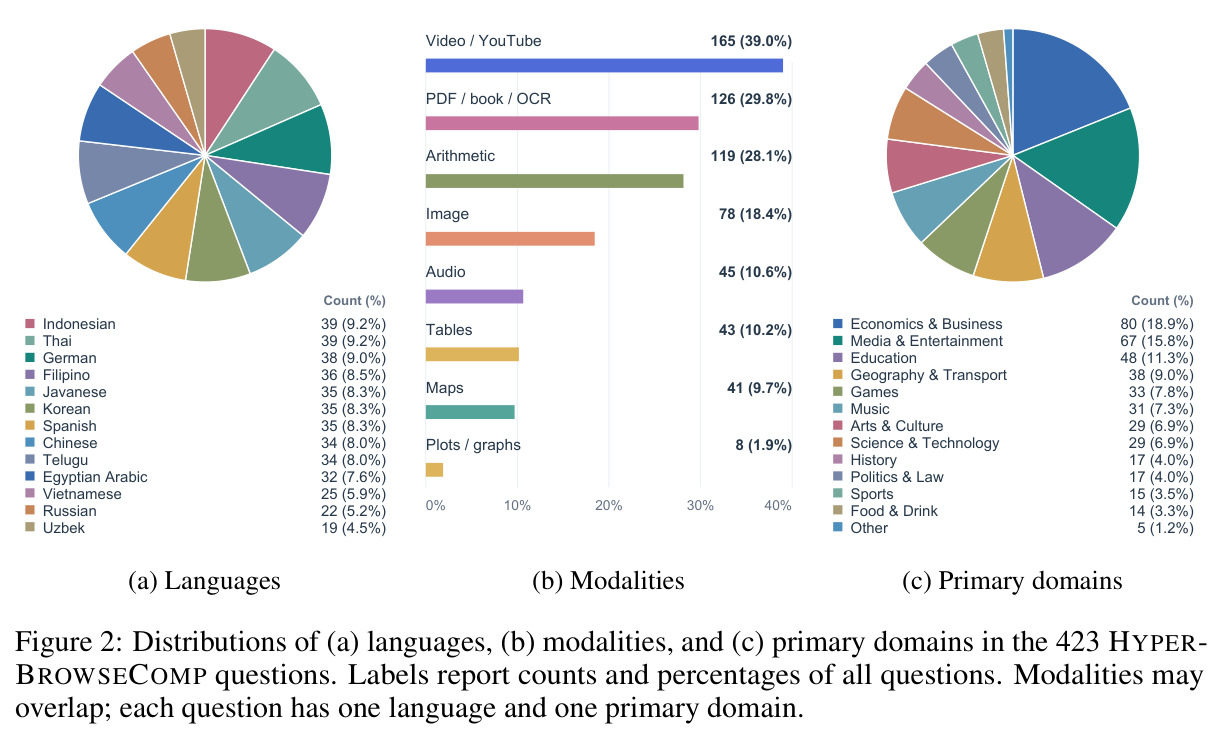
本文的目标是本文要构建一个能长期保持区分度的浏览智能体压力测试基准。具体目标有三:第一,题目必须由母语或准母语者用各自语言独立撰写(不用英语种子集翻译),扎根于对应语言和文化的网络信息生态,共 13 种语言 423 题,覆盖爪哇语、泰卢固语、乌兹别克语、埃及阿拉伯语等低资源变体;第二,答案必须简短、唯一、公开可验证,但寻找答案需要定位冷门证据、跟随多跳线索链或检视视频、扫描件、地图、音频等异构来源,约 64.3% 的题目至少需要一种非文本模态;第三,通过'无网模型难度审计'主动剔除可凭参数知识回答的题目(500 题初稿剔除 77 题),确保分数衡量真实的信息搜寻能力而非记忆。最终要回答:当前最强的联网智能体在这种解释性搜索任务上距离可用还差多远。
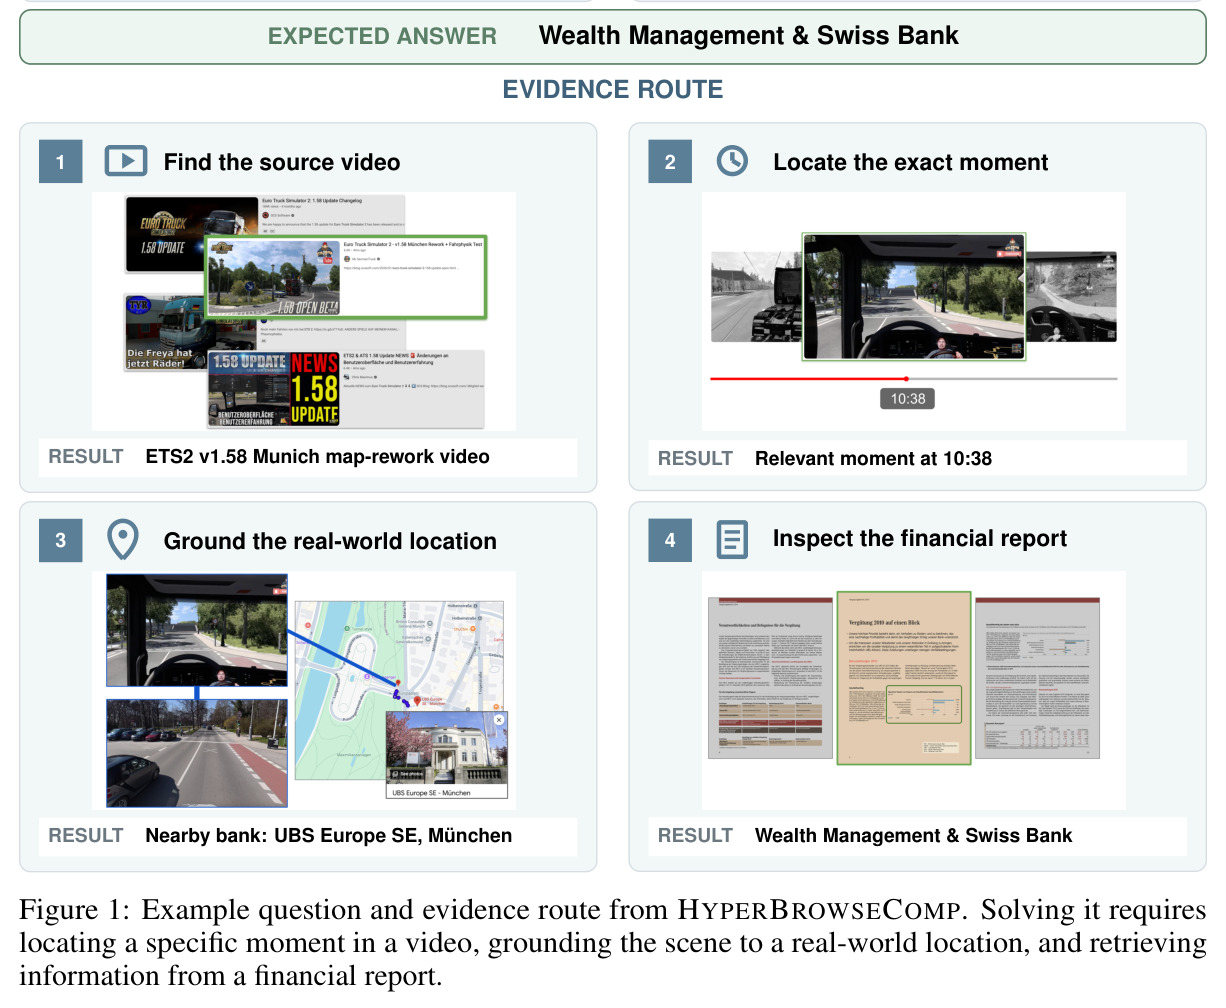
与已有工作不同的是,本文的独特切入是'解释性搜索'(interpretive search):每道题答案唯一,但相关实体、关系、来源和证据模态都是隐含的,模型必须先判断'该搜什么、去哪搜'。论文的德语例题最能说明:题目要求从一段《欧洲卡车模拟2》1.58 更新的游戏视频中辨认出展示地图重制的片段(10:38 处),将画面锚定到慕尼黑的真实街景,找到路边一家银行,再翻出该行 2010 年度薪酬报告,回答经营利润第二高的持续经营业务线是什么(答案:Wealth Management & Swiss Bank)。这与传统'关键词检索实体'的 trivia 式问答有本质区别。方法论上还有三个少有工作做到的点:用 7 个无联网模型做难度审计并组合'至少两个模型答对即剔除 + 单模型答对但答案高度具体也剔除'的规则;引入'指纹'式消歧约束(如'该书恰好有 13 幅猫的插图')——对检索毫无帮助但能锁定答案唯一性;把模型与检索工具链解耦评测,量化 harness 对成绩的影响。
核心方法
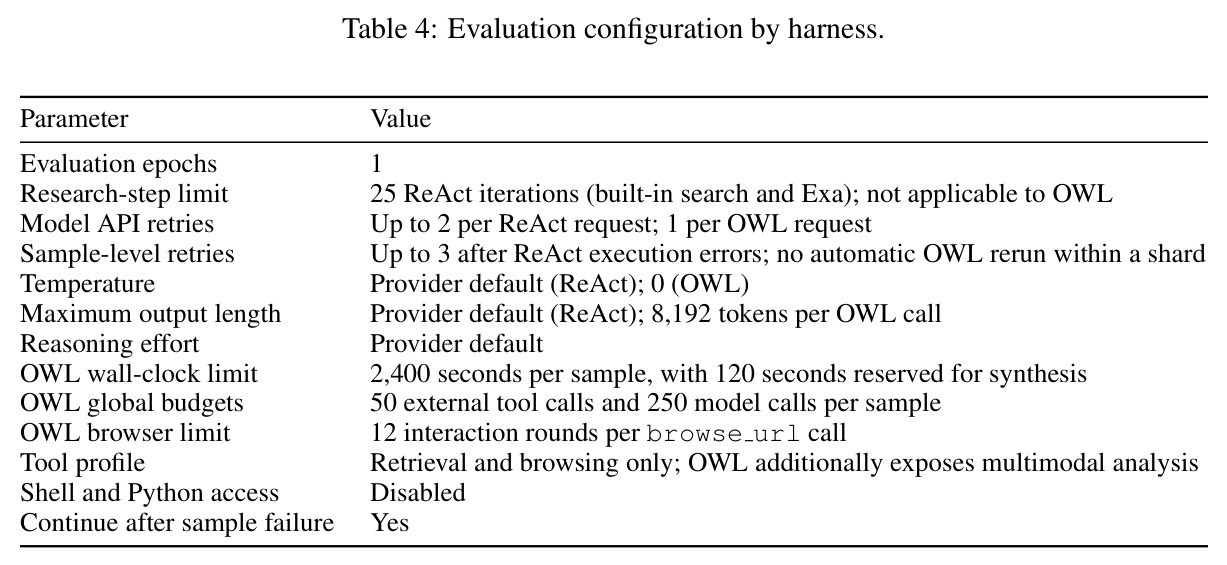
整体思路是先造一批'难找但好判'的题,再用多重过滤保证难度,最后在统一协议下评测。直觉上,一道好的浏览难题应该像侦探小说:答案是一个短实体,但线索分散在视频时间戳、扫描 PDF、地图坐标等不同介质里。技术路线分四步:(1) 撰写:13 种语言的母语/准母语标注者从'公开可验证的答案+证据'出发反推题目,提交时附规范答案、可接受别名、URL、精确证据位置(引文/页码/时间戳/地图位置)和解题轨迹;(2) 验证:第二标注者检查题目可解释、答案唯一、证据可访问,不达标时要求追加非引导性'指纹'约束,采用'通用验证人 + 核心成员'两级验证;(3) 难度审计:用 Gemini 3.1 Pro、Gemini 3.7 Flash、GLM-4.7、GPT-OSS-120B、Kimi K2、MiniMax-M2、DeepSeek-V3.2 七个无网模型试答,按组合规则剔除 77 题;(4) 评测:在 Inspect AI 框架下以 ReAct 协议(至多 25 步)测试 5 个前沿模型 × 3 种检索设置(内置搜索、Exa、OWL),LLM 二元判分。共收到 500 道题,最终保留 423 道。
核心创新是把'原生多语言''多模态隐含证据''开放网络''极端难度'四个此前互不相交的轴合并进一个基准,并用系统性审计保证每个轴真实生效。与最接近工作的本质区别在于:XBCP 的多语言是翻译出来的(题目和答案留在英语,只翻译文档),本文的题目在各语言中独立创作,保留了语言特有的措辞、术语、文化指涉和各语言网络环境独有的信息分布;MM-BrowseComp 等多模态基准只有英语,且通常在题面声明证据模态,本文约 64.3% 的题需要非文本证据但不明说该看视频还是地图——模态本身是待发现的信息;BrowseComp-Plus 用固定语料库保证可控对比,本文坚持在活网上作答,更接近真实智能体面临的开销与不确定性。难度控制上,'无网模型审计 + 答案特异性 LLM 评估 + 人工复核'的三级排除流水线,加上验证人可在小组讨论后主动要求加难,形成了一套可复用的基准建造方法学,目标是让基准寿命超越几代模型。
方法步骤详情
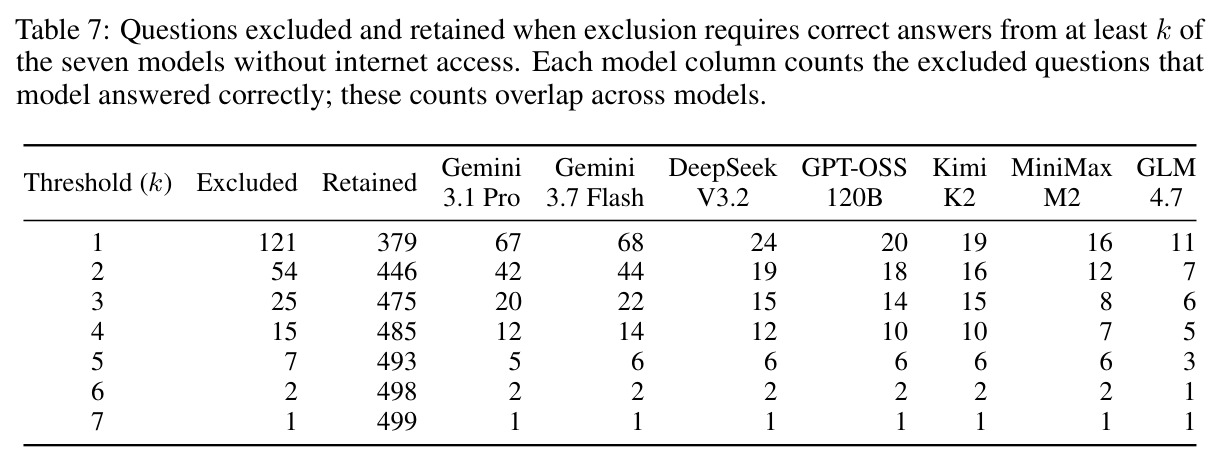
第一步,标注者经指南宣讲与试写考核后方可参与。第二步题目创作:从答案与证据出发构造题目,遵守来源政策——不得付费、登录或依赖私人社交账号,排除个人孤立帖子与私人敏感信息。第三步双重验证:验证人检查可解释性、答案唯一、证据可访问、时间表述有边界;不足时要求加入'指纹'(不利检索但可定案的约束),并可要求加难。第四步难度审计:7 个无网模型全部试答,500 题中 121 题被至少 1 个模型答对、54 题被至少 2 个模型答对;执行'≥2 模型答对即剔除(54 题)+ 仅 1 模型答对但答案高度具体也剔除(23 题)'的组合规则,剩 423 题。第五步后验标注:用 gpt-5.6-sol 对域和模态分类并人工复核,判定 64.3% 需要非文本模态。第六步评测:ReAct 基于 Inspect AI,交替生成与工具调用至多 25 步;Exa 提供 web_search/web_fetch 标准接口;OWL 是多智能体工作流,限 2400 秒墙钟、50 次外部工具调用、250 次模型调用预算;判分由生成模型自判,输入题目、完整回答与参考答案,输出二元正确性。
技术新颖性
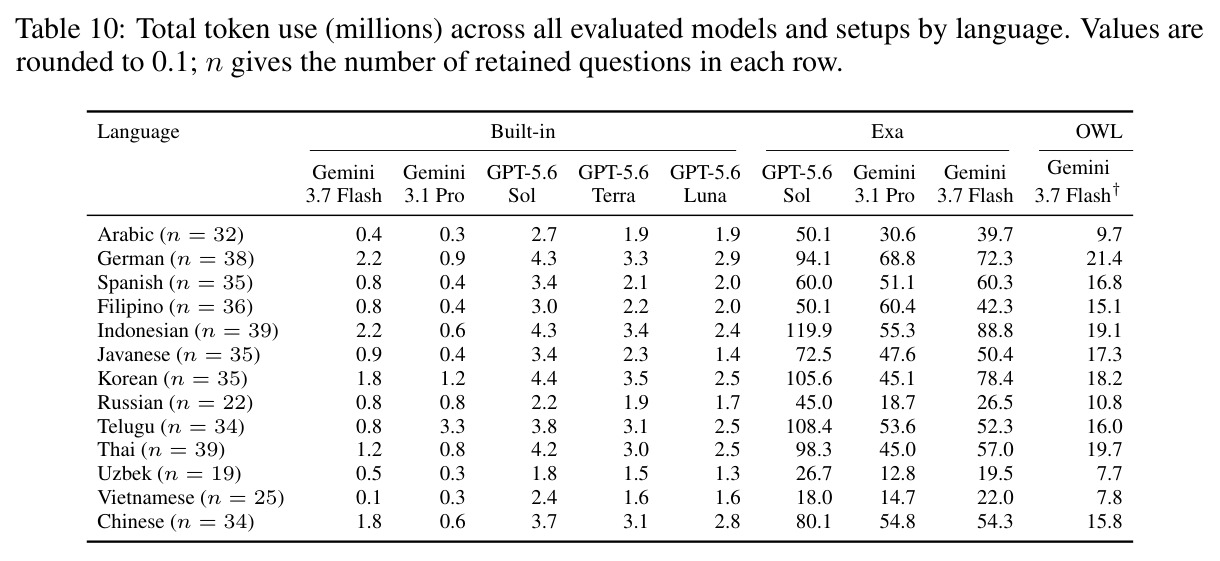
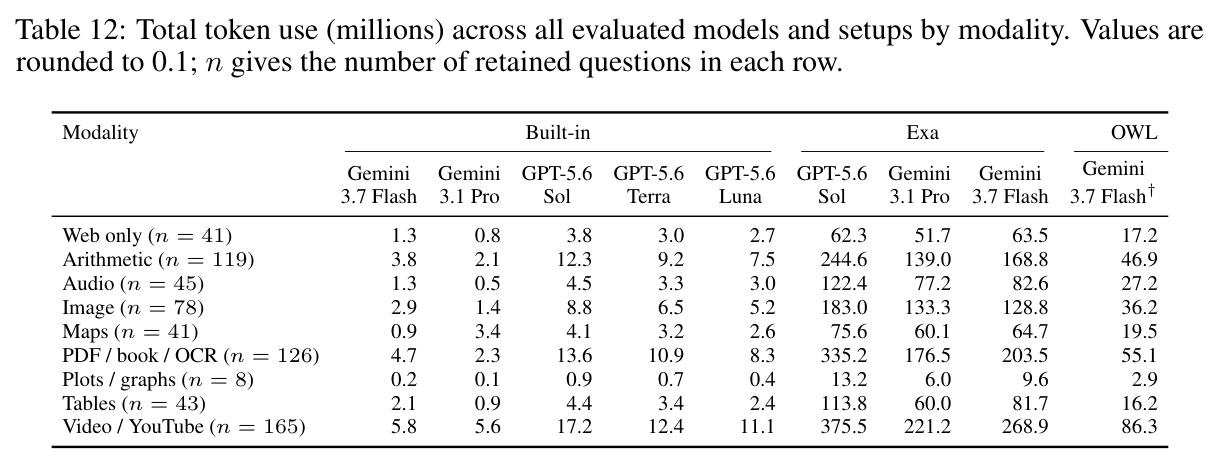
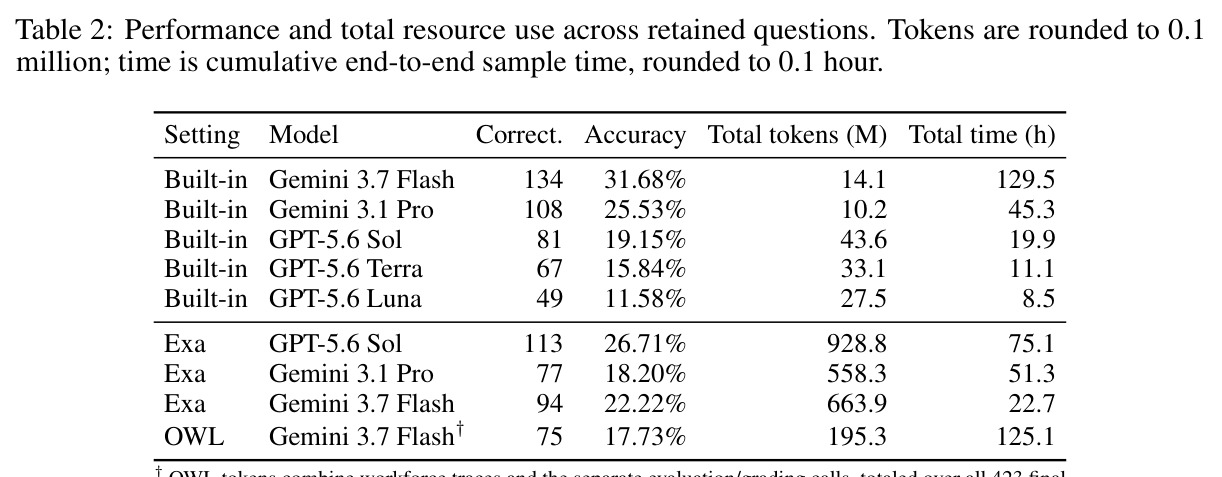
技术新颖性体现在三方面。其一,基准设计方法学:'无网模型审计 + 答案特异性评估 + 人工复核'的三级排除机制附带完整的敏感性分析(表 7)——排除阈值 k 从 1 提到 7 时,剔除量从 121 题单调递减到 1 题,规则选择透明可控,这比大多数基准只用'人工感觉难'要严谨得多。其二,评测协议的严谨性:作者正面回应了自判分的公正性质疑——用 Gemini 3.7 Flash、GLM-4.7、Kimi K2 Thinking 三个替代判分器重判 8 个完整配置共 3384 个判定,一致率超过 98.7%,总分波动不超过 0.80 个百分点,说明短答案二元判分对判分器选择不敏感。其三,把成本与 harness 敏感性纳入基准报告的维度:同一模型换检索工具后成绩波动可达 9 个百分点以上(Gemini 3.7 Flash 内置 31.68% vs Exa 22.22%),每题 token 消耗相差一个数量级(内置约 3.3 万–11.6 万 vs Exa 约 132 万–220 万),这为'模型能力 vs 工具集成质量'的解耦分析提供了首个多语言多模态场景下的系统实证。
实验结果
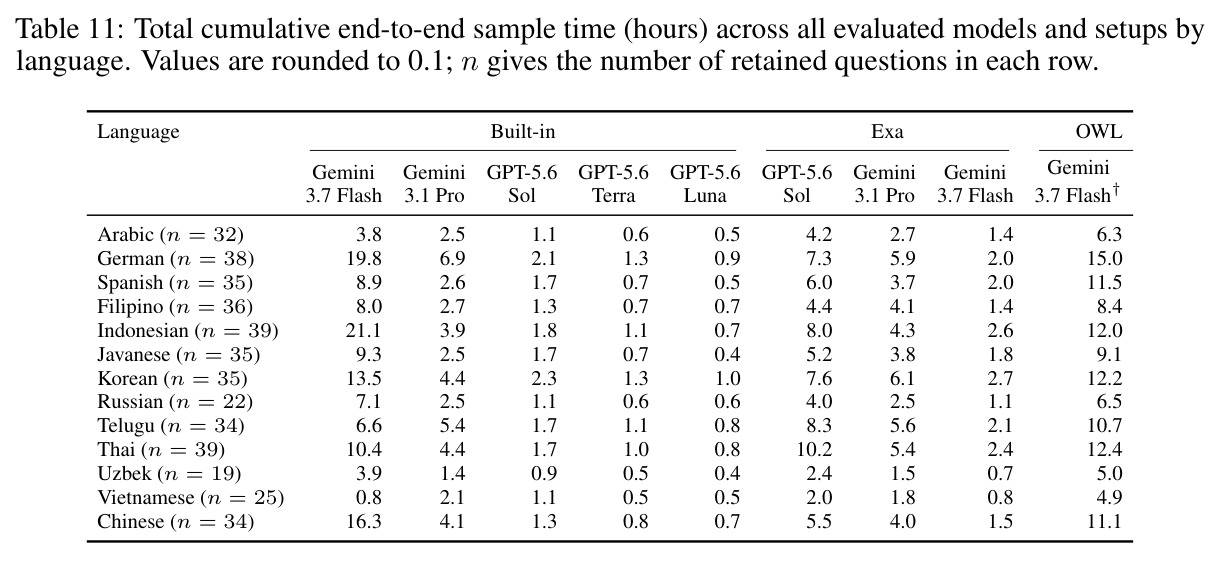
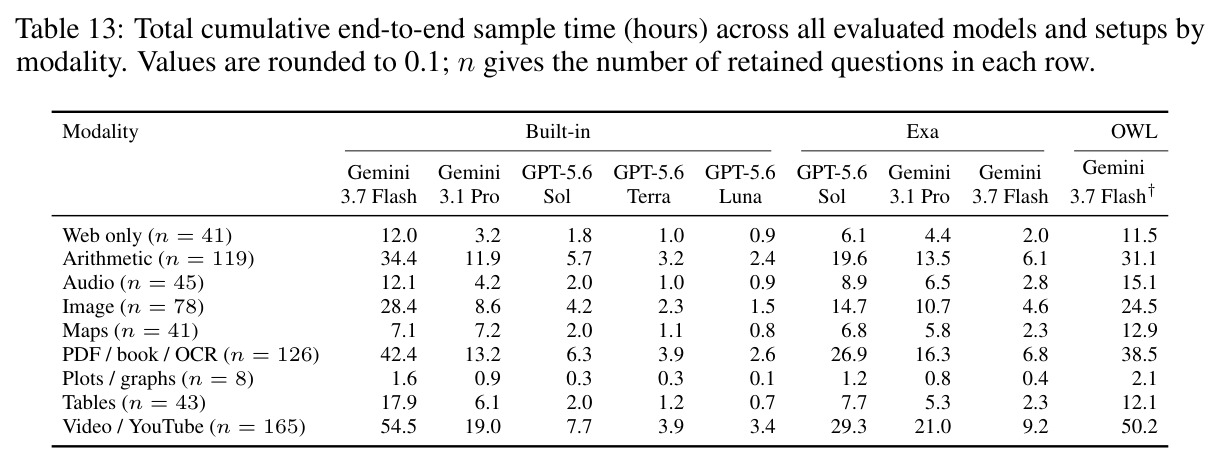
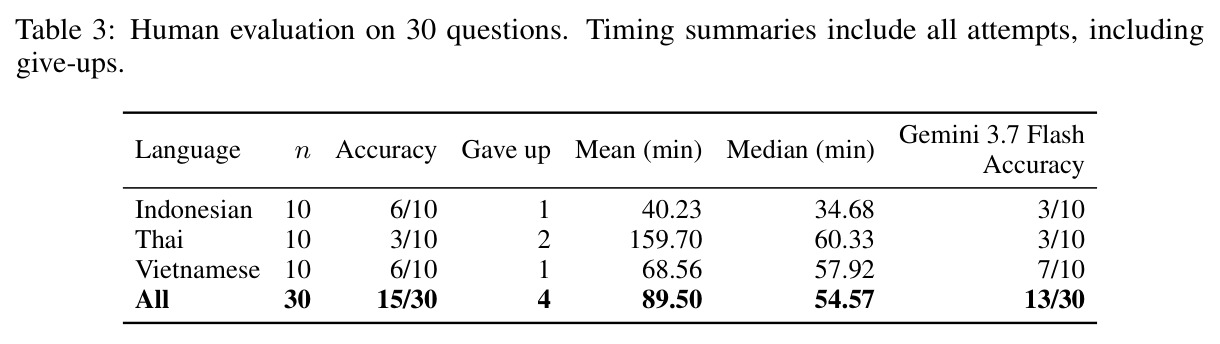
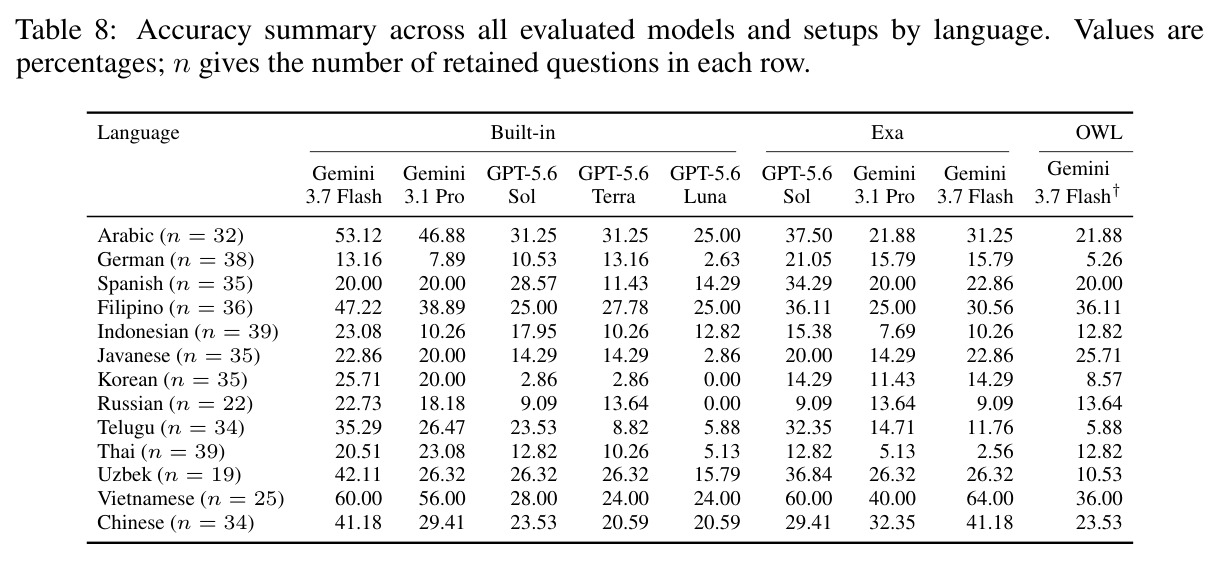
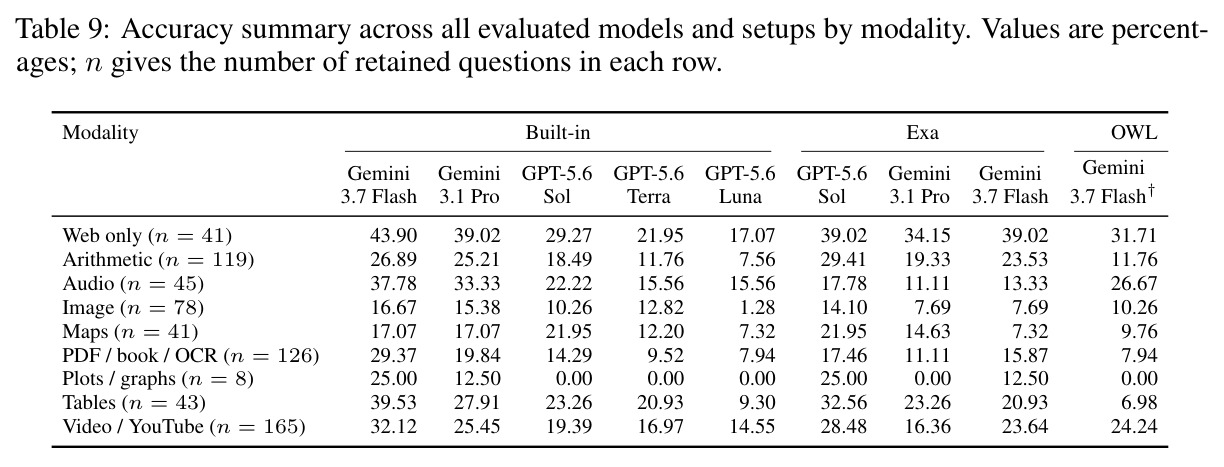
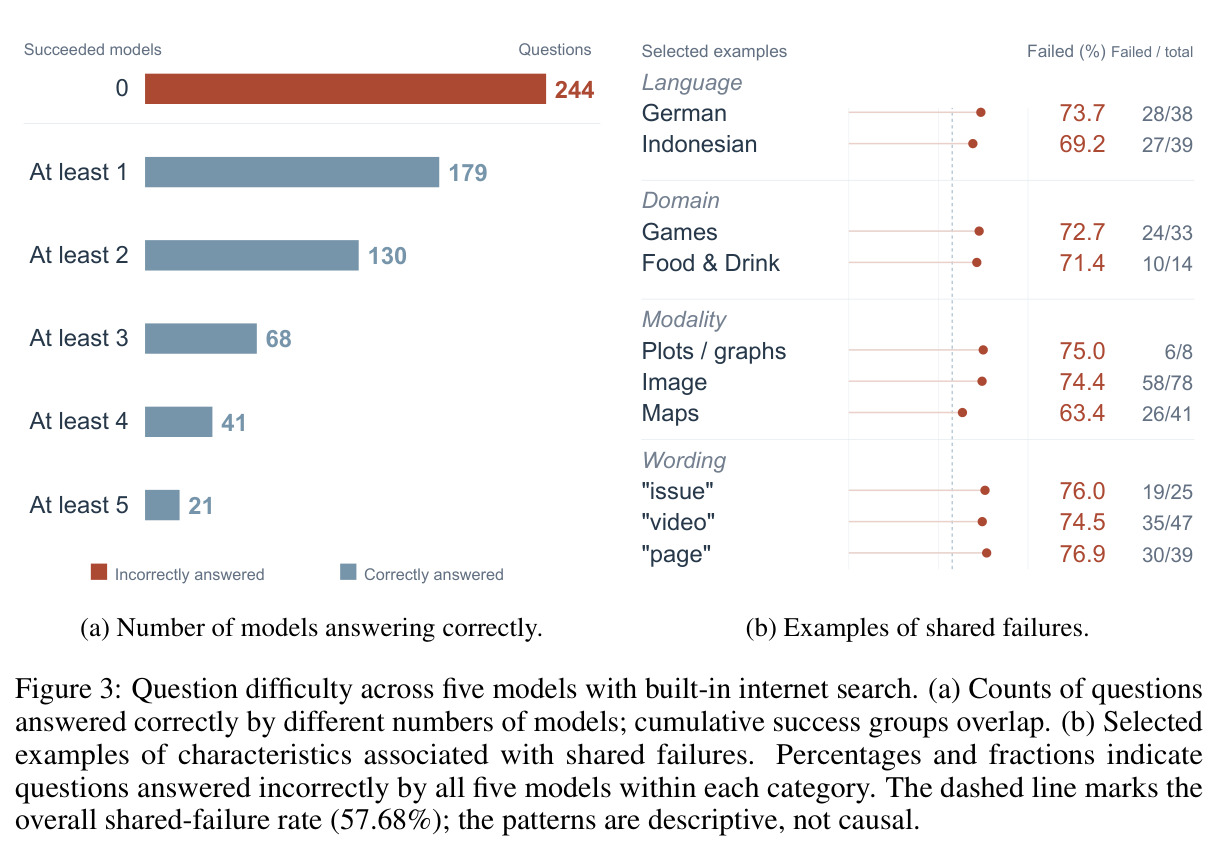
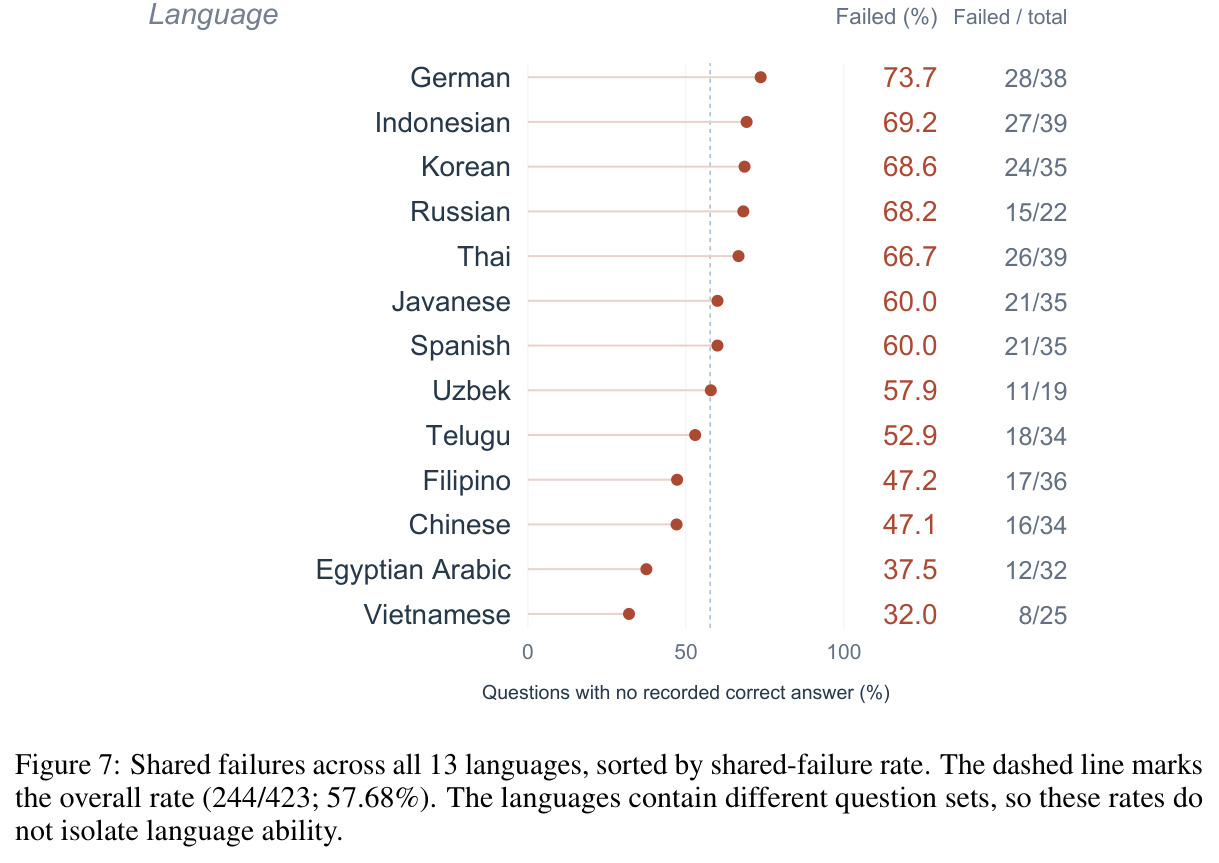
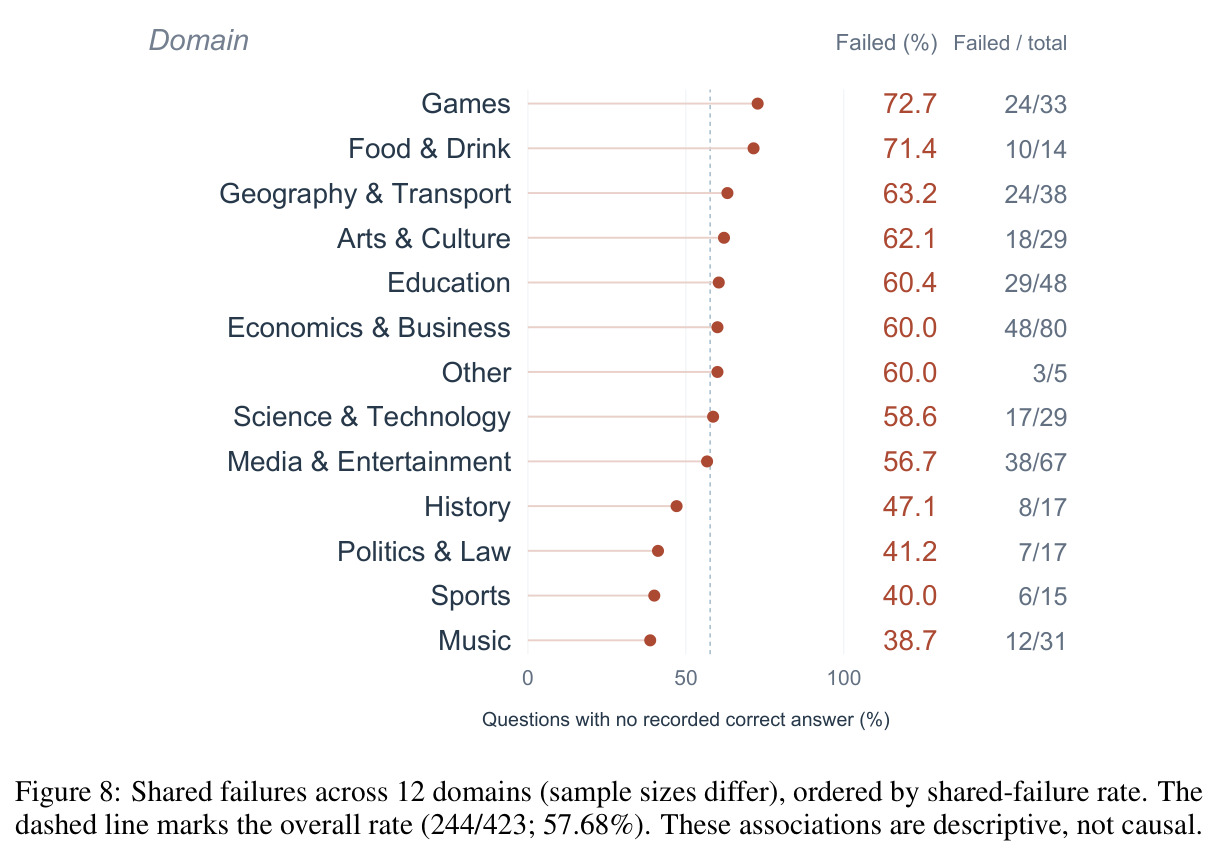
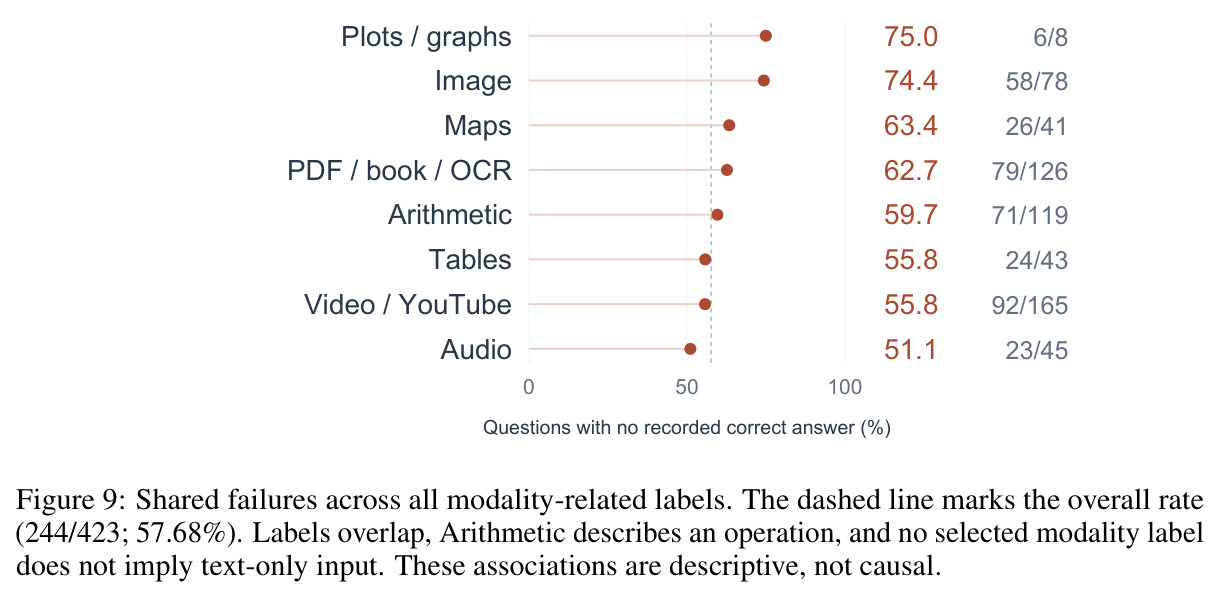
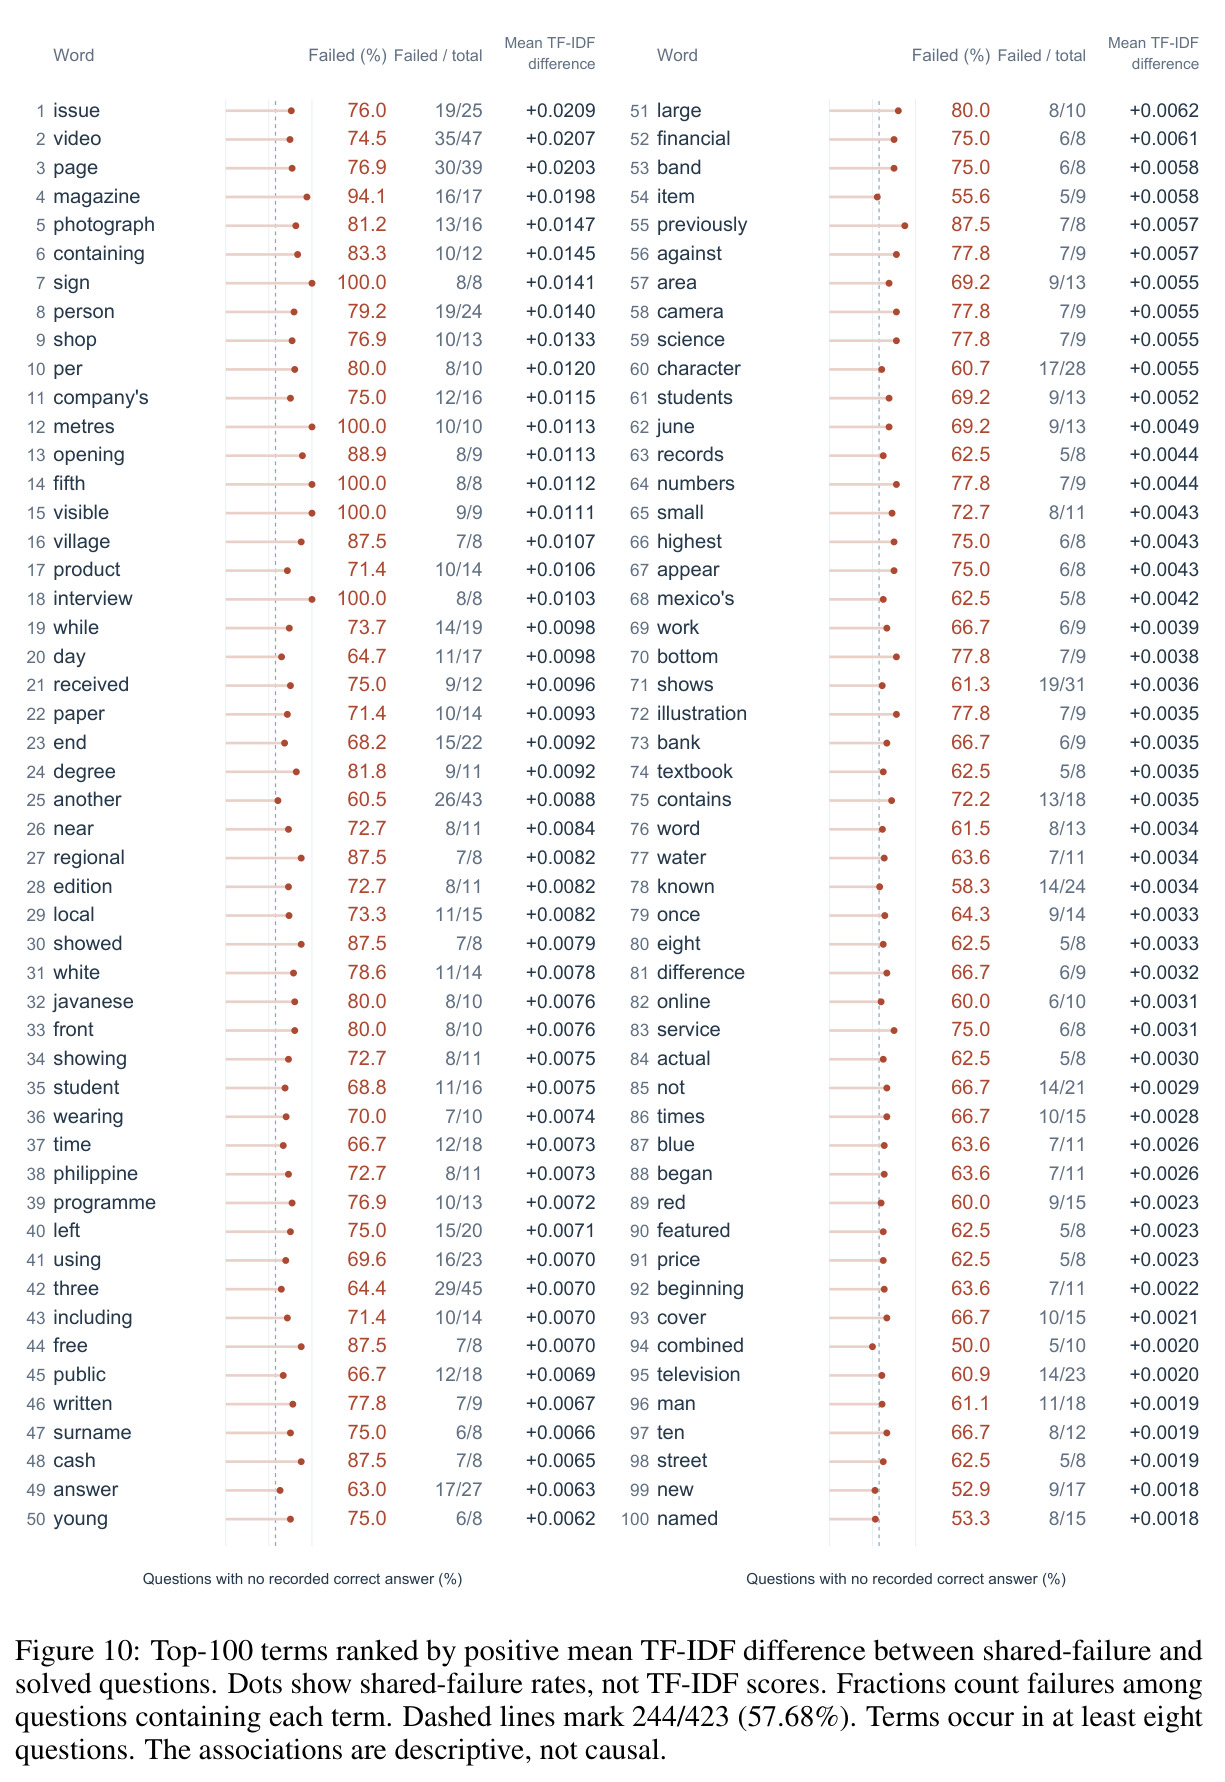
发现一:整体准确率极低。内置搜索下最强的 Gemini 3.7 Flash 仅 31.68%(134/423),Gemini 3.1 Pro 25.53%,GPT-5.6 三档仅 11.58%–19.15%;五模型在 244 题(57.68%)上全军覆没,全部答对仅 21 题。发现二:成绩高度依赖工具链。换用 Exa 后 GPT-5.6 Sol 升至 26.71%,两个 Gemini 反而大跌;OWL 仅 17.73%(93 次失败计 0 分)。发现三:成本与性能不相关——Exa 每题耗 132 万–220 万 token,Gemini 内置搜索却最准又最省(仅 14.1M token)。发现四:人类对照(30 题)中人类 15/30 正确,与 Gemini 3.7 Flash 的 13/30 相当,但仅同时答对 8 题——难点不重叠。发现五:失败集中于视觉模态(图表 75.0%、图像 74.4%、地图 63.4%)和德语(73.7%)、印尼语(69.2%),越南语最易;含 'magazine' 的题 94.1% 失败,'sign''visible' 等视觉词题目 100% 失败。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 开放网络浏览问答(内置/原生搜索,ReAct ≤25 步,423 题) | 二元准确率 | Gemini 3.7 Flash:31.68%(134 题正确,14.1M tokens,129.5 小时) | 同为内置搜索的 GPT-5.6 Luna 11.58%(最强竞品 GPT-5.6 Sol 19.15%) | 比 GPT-5.6 Sol 高 12.53 个百分点,比最弱的 GPT-5.6 Luna 高 20.10 个百分点 |
| 同一模型切换到 Exa 统一检索接口 | 准确率变化(harness 敏感性) | GPT-5.6 Sol 26.71%(较内置 +7.56pp);Gemini 3.7 Flash 22.22%(−9.46pp)、Gemini 3.1 Pro 18.20%(−7.33pp) | 各模型自身的内置搜索成绩 | Exa 令 GPT 提升、令 Gemini 大幅下降,首次在多语言多模态场景量化了模型与原生搜索生态的耦合程度 |
| OWL 多智能体框架(Gemini 3.7 Flash) | 准确率 | 17.73%(93/423 次运行终端失败计 0 分;仅计完成的 330 次为 22.73%);11,486 次外部工具调用,195.3M tokens,125.1 小时 | 同模型内置搜索 31.68% | 低 13.95 个百分点,失败主因是 51 次步骤超时与 28 次耗尽 250 次调用预算 |
| 人类对照(30 题:印尼语/泰语/越南语各 10 题,允许上网、禁用 AI) | 准确率与用时 | 人类 15/30(50%),平均 89.5 分钟、中位 54.6 分钟,放弃 4 题 | 同子集上 Gemini 3.7 Flash 13/30(43.3%) | 人类略优 6.7 个百分点,但两者仅同时答对 8 题,难点分布不重叠(人类印尼语又快又准、泰语普遍卡壳) |
| 无网难度审计(7 个无联网模型试答 500 道初稿题) | 可凭参数知识答对的题数 | 121 题被≥1 模型答对、54 题被≥2 模型答对;组合规则共剔除 77 题,保留 423 题 | 未审计的 500 题初稿 | 确保剩余题目的得分反映信息搜寻而非记忆,是基准效度的核心保障(阈值敏感性详见表 7) |
局限与改进
作者承认的局限:这是压力测试,不代表日常查询的自然分布;活网评测天然不稳定——搜索排名、页面内容、地域可用性和工具行为都会随时间漂移,只能靠保存全部轨迹缓解;13 种语言不代表所有语言社区,各语言可搜索信息的数量与质量差异巨大;因单次运行需数天和数亿 token,只评测了 5 个前沿模型,Exa 只测了子集,harness 研究不完整。我的补充观察:其一,各语言题目难度显然不均衡(共享失败率德语 73.7% vs 越南语 32.0%),作者也承认无法据此得出'模型德语能力差'的结论,这削弱了多语言维度的横向可比性;其二,OWL 的 93 次终端失败里 51 次是步骤超时、28 次是耗尽 250 次调用预算,失败更多源自工程配置而非模型能力,'OWL 不如内置'的结论对超参敏感;其三,每语言仅 19–39 题,图表模态仅 8 题,细粒度切面的统计功效不足;其四,自判分虽经 3 个替代判分器验证,仍只覆盖短答案二元判定,无法评估部分正确或过程质量。
独立分析的弱点
独立分析的弱点与改进方向:(1) 语言难度未标准化是最主要缺陷——德语 38 题共享失败率 73.7%、越南语 25 题 32.0%,但题目由不同标注者独立撰写,难度分布天然不可比;改进方向是按先验难度分层配平,或为每个语言补充人类基线,使跨语言比较有效。(2) 规模太小:423 题平摊到 13 语言 × 8 模态,最细格子只有几道题(图表类仅 8 题),任何'哪个模态最弱'的结论都建立在个位数样本上;改进是把基准做成持续扩展的社区贡献池,作者的两级验证机制天然适合这种模式。(3) 判分只看最终答案的二元对错,无法区分'找对了证据但表述错'与'瞎猜蒙对',也没有部分得分;可引入基于解题轨迹的证据链评分。(4) harness 结论时效性短——商业内置搜索每季度都在进化,31.68% 这个数字的半衰期很短,且'内置最好'可能只反映厂商垂直整合的暂时优势;改进是定期重跑并公布时间序列。(5) 隐私边界靠人工把关,'仅限公众人物'的尺度在 13 种文化语境里并不一致,规模化扩展时需要更明确可执行的判定规则。
未来方向
作者明确提出的方向:保持模型固定、在可比资源预算下系统比较不同检索工具与工具使用策略,把基准扩展成'harness 进步的度量尺';标准化跨语言难度水平;扩展语言覆盖。基于本文成果可自然延伸的方向包括:为题目添加过程级子目标标注(类似 BrowseComp-V3 的做法),把基准从纯结果评测升级为可用于监督训练的奖励信号来源;利用已保存的轨迹做失败模式聚类(检索失败 vs 证据解读失败 vs 推理失败),为模型改进定位靶点;针对共享失败率最高的视觉模态(图表 75.0%、图像 74.4%)设计专门的证据定位与解读模块;研究 OWL 类多智能体框架的超时与预算管理策略,把 22% 的终端失败率压到接近零;构建活网页面的快照归档以应对答案源消失,探索在网页漂移下维持评测长期有效的机制;以及研究人类与模型难点不重叠(仅 8/30 重合)这一现象本身——它暗示模型可能缺乏人类熟练搜索者使用的本地化搜索策略与常识性导航直觉。
复现评估
复现友好度较高但成本不低。开源方面:论文承诺发布时公开完整数据集、标注指南和代码,附录 B/C 提供所有解析后的提示词、工具 schema、模型与 API 标识符、重试与错误记录、判分结果和成本明细;数据集以编码形式发布并提供解码密钥,防止被自动化爬虫意外吞入训练语料,有意访问者可用密钥解码。数据方面:423 题附带规范答案、可接受别名、URL、精确证据位置和完整解题轨迹,验证材料完备,跨语言对照分析所需的英文翻译也已由标注者提供。算力方面:不需要训练,但完整评测昂贵——Exa 配置单次全量运行耗 5.58 亿–9.29 亿 token(数千美元级 API 费用),内置搜索相对便宜(Gemini 3.7 Flash 全程 14.1M token)但需约 130 小时挂钟时间,OWL 单配置 125 小时。难度评估:复现单个模型配置对有 API 预算的团队完全可行(数天);复现完整的 9 配置矩阵需要数千美元与较长周期;活网漂移意味着即使严格复现协议,具体数字也会有出入,作者建议以保存的 traces 做审计对照。综合评级:中等偏高难度,瓶颈在预算与时间而非技术。
论文图表