组合偏好奖励与量规奖励对前沿文生图模型做后训练 Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards
偏好奖励+量规奖励组合的后训练配方,让开源文生图模型在Arena榜提升69 Elo
前置知识
Bradley–Terry 偏好模型
一种把成对比较转成标量分数的统计模型:假设用户在图像 A、B 之间选 A 的概率为 $p(A \succ B) = \sigma(s_A - s_B)$,其中 $s$ 是模型输出的偏好 logit,$\sigma$ 是 sigmoid 函数。训练时对海量人类投票做最大似然,让分数差逼近真实胜率,最终得到一个输入(提示词,图像)、输出标量奖励的奖励模型。
本文的偏好奖励正是用 BT 目标在约 560 万条 Arena 真人投票上训练的,理解 BT 才能明白偏好奖励从哪来、为何只覆盖大众审美而对稀疏属性失明。
扩散/流模型的前向过程 RL(DiffusionNFT)
把在线强化学习应用到扩散或流匹配模型的一类方法。DiffusionNFT 不经过反向采样器,而是直接在 forward 过程上做策略改进:对每个 rollout 构造正、隐负两个速度预测 $v^+ = (1-\beta)v_{\theta_{old}} + \beta v_\theta$ 与 $v^- = (1+\beta)v_{\theta_{old}} - \beta v_\theta$,用组相对权重 $\tilde{r}_i \in [0,1]$ 加权回归目标,免显式 KL 与价值网络。
整套训练循环建立在 DiffusionNFT 之上,所有奖励组合机制最终都通过它的损失 $\mathcal{L}_{NFT}$ 生效,不懂它就看不懂优化目标。
Rubric(量规)奖励
把“图像好不好”这种开放式判断拆成显式评估清单:用 LLM 把提示词分解成一棵依赖树状的 yes/no 问题(对象是否存在、颜色对不对、风格是否保持),再由 VLM 判官逐题作答,奖励即答“是”的比例。相比学出来的标量奖励,量规奖励可解释、针对性强,且天然按提示词条件化。
本文一半贡献在量规奖励的设计(忠实度、约束、反黑客三套清单)及其门控方式,这是理解奖励组成的核心。
Reward hacking(奖励破解)
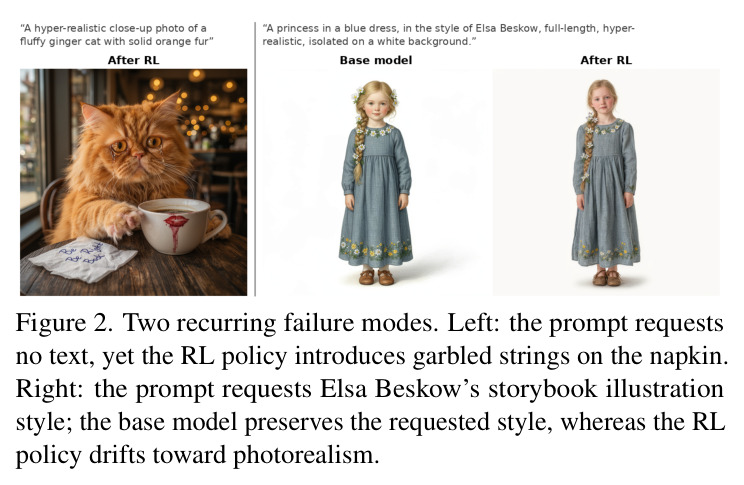
指策略在 RL 中找到奖励函数的漏洞、刷高奖励分数却没有真正提升质量的现象。本文观察到两种:模型在用户未要求文字时渲染乱码字符串以讨好偏好奖励;以及无论提示要求什么风格都往照片写实方向漂移。常见对策是加检测器,但检测器本身作为可优化目标也可能被二次利用。
Stage 2 的核心就是审计并堵住这两类漏洞,“单边否决”设计是全文最有辨识度的机制之一。
LoRA 与模型汤(model soup)
LoRA 把微调参数表示为低秩增量 $\Delta W = (\alpha/r)BA$,只训练 $B, A$ 两个小矩阵、冻结基座。模型汤指把多个独立微调模型的权重直接平均,无需额外训练即可融合能力。本文把两种奖励配方训出的 LoRA 增量等权平均,并通过秩拼接(rank 从 64 增到 128)在数学上精确实现 $\frac{1}{2}\Delta W_1 + \frac{1}{2}\Delta W_2$。
最终模型 Stage 3 就是把 Stage 1 和 Stage 2 两个 LoRA 做汤得到的,权重融合带来了超过两个父模型的增益。
研究动机
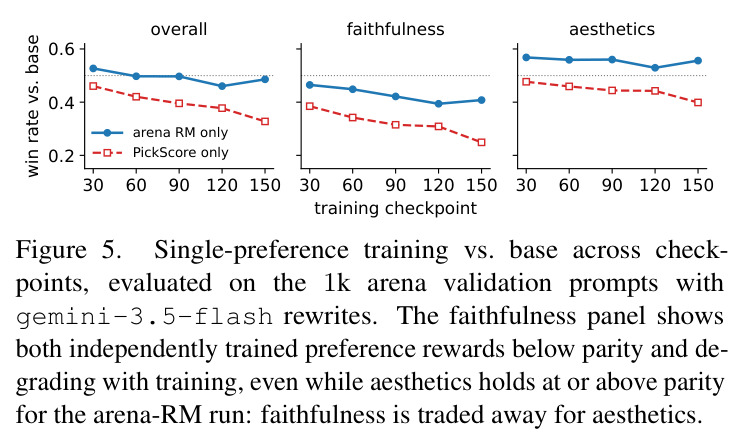
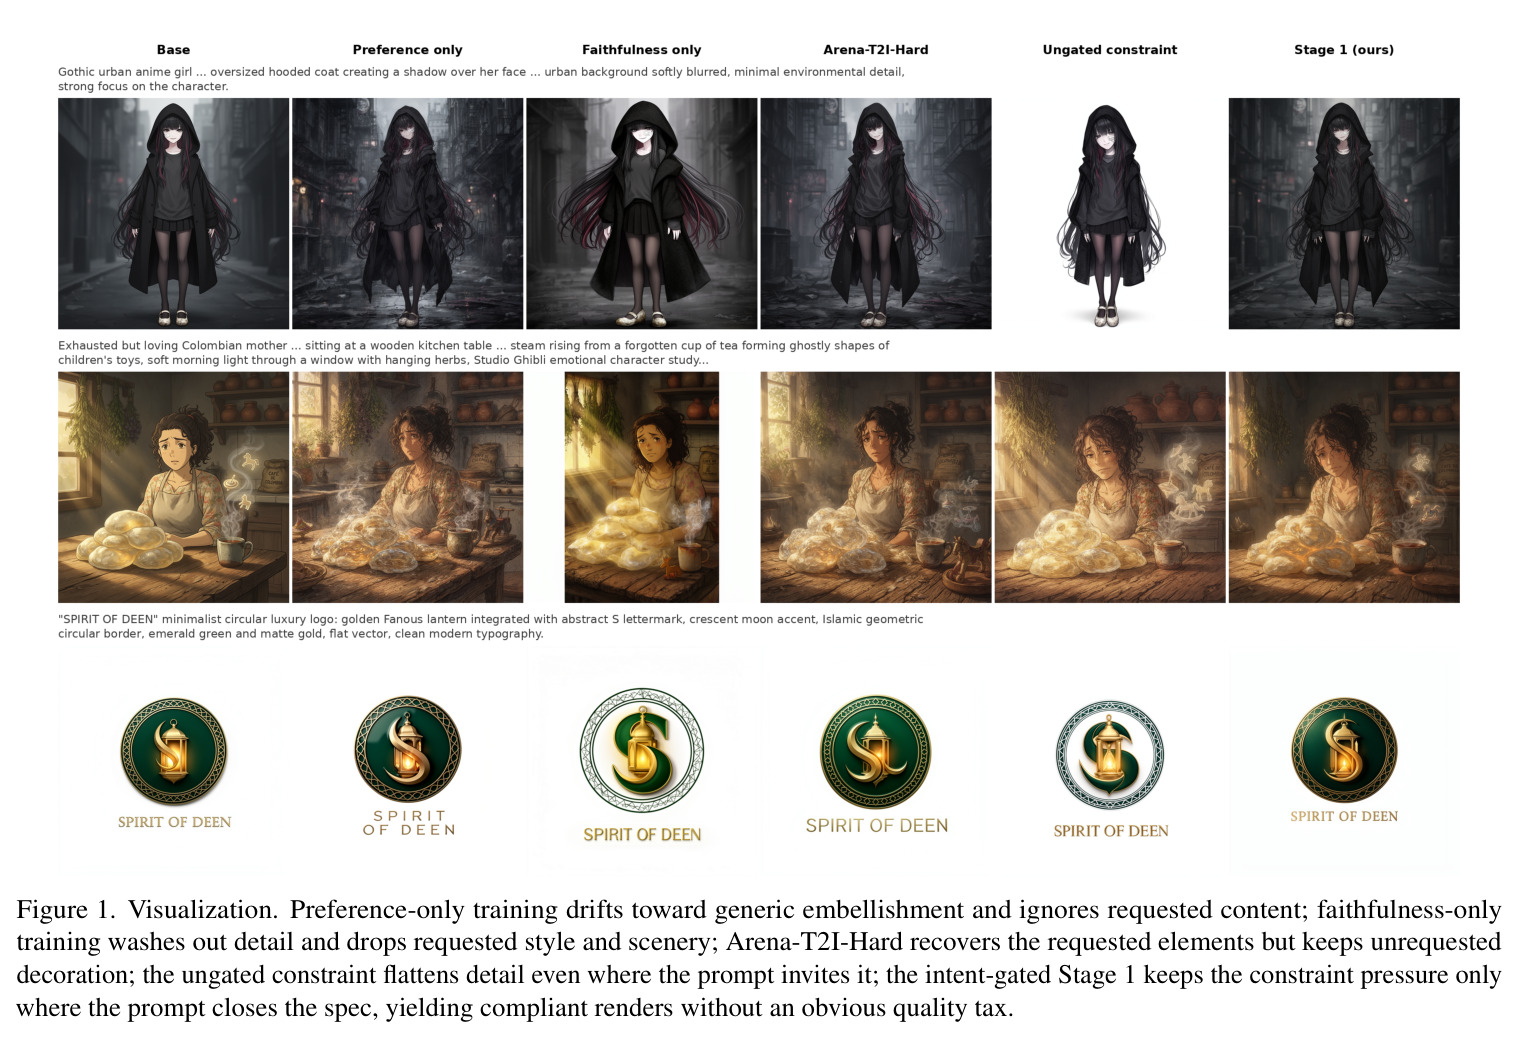
前沿文生图模型(如 32B 的 FLUX.2-dev)视觉质量已很高,但没有任何单一奖励信号能覆盖人类偏好的全部维度。学到的偏好奖励(PickScore、HPSv2/v3 等)擅长捕捉大众化的审美与构图偏好,却对 pairwise 投票中稀疏或弱表达的属性近乎失明,比如是否画出了提示词要求的每一个对象、是否满足特定约束。作者做了直接实验(Fig. 5):单独用 Arena RM 做 RL,最佳整体胜率仅 0.5065,PickScore 甚至始终低于与基座打平的 0.5;更糟的是忠实度维度胜率跌破 50% 且随训练持续退化,而美学维度持平或更高——模型在用“好看的泛化装饰”换“丢掉要求的内容”。此外奖励模型极易被破解:审计 Stage 1 最优检查点的 205 个失败案例发现两类反复出现的漏洞——无要求时渲染乱码文字,以及把明确要求的插画/卡通风格漂移成电影感照片写实。
本文的目标是本文目标是给开放域文生图建立一套简单、有效、可复现的后训练配方,使已经很强的基座模型在真实用户盲评下仍能可靠提升。具体拆成四点:其一,用大规模真人偏好数据训练 Bradley–Terry 奖励模型,覆盖整体审美;其二,补充显式量规奖励——忠实度(presence-oriented,检查要求的内容是否在场)、意图门控的约束(absence-oriented,惩罚不受支持的多余添加)以及反奖励破解探测器;其三,解决异构奖励如何组合的问题,避免简单加权平均导致的互相干扰与不稳定;其四,在 LMArena 真实排行榜上用真人盲评验证提升,并开源 1K 训练数据子集 Arena-T2I-Training 供社区复现。
与已有工作不同的是,已有工作要么设计更强的单一奖励,要么提出新 RL 算法(Diffusion-DPO、Flow-GRPO、MixGRPO 等),本文的独特切入点是“组合学”:承认没有万能奖励,把研究重心放在异构奖励信号的融合机制上——逐轴组归一化、按用户意图门控、把防黑客信号做成单边否决而非加性项、在权重空间融合不同奖励配方训出的策略。这四个机制每个都对应一种已观测到的失败模式(尺度互相压制、过度约束开放式提示、检测器被二次利用、单配方覆盖面不足),且每个都做了消融验证。另一个差异是评测口径:作者不满足于静态 benchmark,而是把模型部署到 Arena 排行榜,用真实生产流量下的盲 pairwise 人类投票测 Elo,这是目前最接近“用户真正更喜欢”的证据。
核心方法
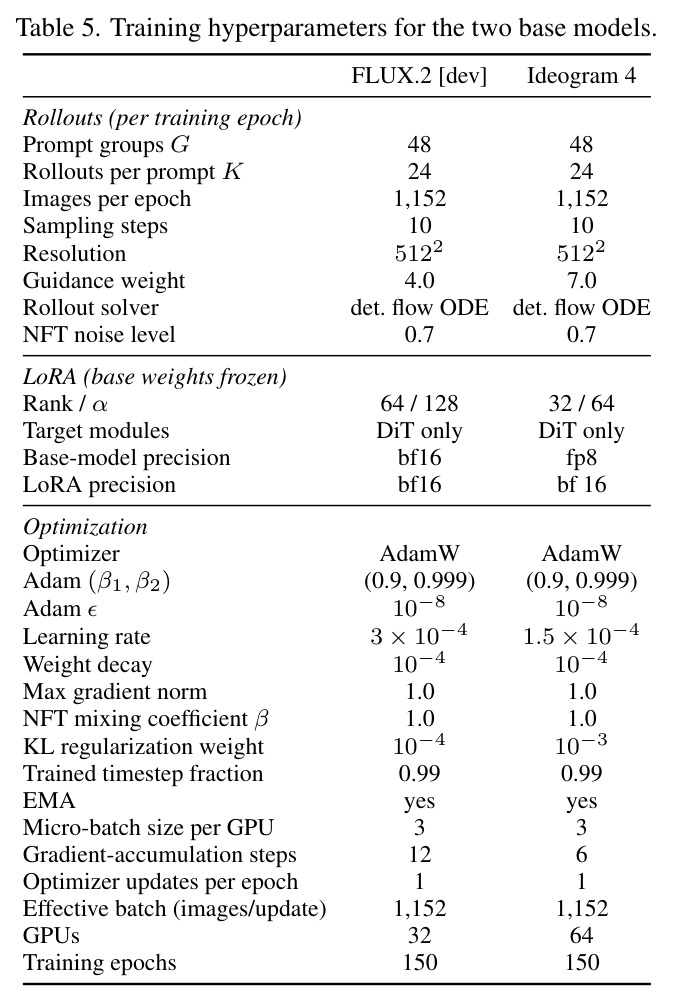
直觉上,这套配方给模型配了三类互补的“考官”:一位懂大众审美的评委(偏好奖励)、一位逐项对照提示词的检查员(忠实度+约束量规)、几位专门抓作弊的督察(反黑客探测器)。技术路线上,作者以 DiffusionNFT 为优化器,在冻结基座上用 LoRA 做在线 RL:每 epoch 采样 48 组提示、每组 24 个 rollout、10 步采样、512² 分辨率;每条 rollout 的总奖励由多个轴组合而成,经逐轴组归一化、意图门控、单边否决后转成组相对权重进入 NFT 损失。训练分三阶段:Stage 1 用偏好+忠实度+门控约束训练;Stage 2 审计 Stage 1 的作弊行为、加入针对性探测器再训;Stage 3 把两个检查点的 LoRA 增量等权平均得到最终模型。流程对 FLUX.2-dev(32B)和 Ideogram-4(9.3B)都适用,后者额外加了分级 OCR 奖励以保护其强项文字渲染能力。
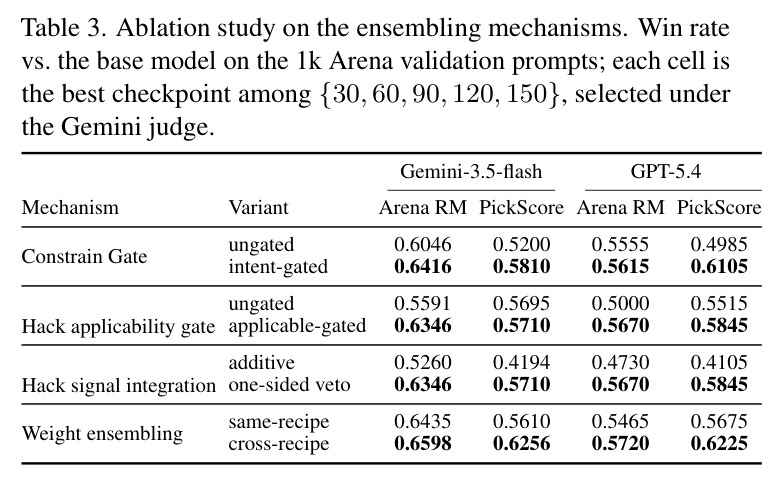
核心创新不在某个单一奖励,而在四个组合机制。第一,逐轴归一化:每个奖励轴独立做批内 z-score 标准化 $z_i^{(a)} = (r_i^{(a)} - \mu^{(a)})/(\sigma^{(a)} + \epsilon)$,防止某一轴因尺度大而主导优化。第二,提示词条件门控:约束奖励只在 LLM 判为 strict(提示词已封闭规格)的提示上激活,避免惩罚开放式提示下的合理创作;反黑客探测器同样要先判定该失败模式与用户意图冲突才启用。第三,也是最关键的:单边否决。探测到漏洞时压制正偏好奖励 $\bar{z}_i^{(\text{pref})} = z_i^{(\text{pref})} - v_i [z_i^{(\text{pref})}]_+$,而遵守探测器本身不产生任何奖励——这与把它当加性奖励项有本质区别,后者会创造新的可被优化的目标:实验中加性形式胜率仅 0.5260,否决形式达 0.6346。第四,跨配方权重汤:不同奖励配方训出的策略在参数空间也互补,直接平均两配方 LoRA 增量(0.6598)稳定优于同一次运行内取两个检查点平均(0.6435)。
方法步骤详情
第一步,离线准备:用 gemini-3.5-flash 严格过滤 Arena 真实提示(剔除修图请求、过短、小众实体、非英文),得 10k 训练 + 1k 验证提示,不过滤的 100k 池会输 0.0360;gemini-3-pro-preview 把提示分解为依赖 DAG 式 yes/no 忠实度问题(182k 题,均值 18.2 题/提示),gemini-3.1-pro-preview 产出意图标签(strict/neutral/open)与 26k 条约束问题。第二步,偏好奖励:5.6M 投票对上用 Qwen3.6-27B 加线性头做 BT 训练。第三步,Stage 1 RL:48 组、每组 24 个 rollout、LoRA 秩 64,奖励为偏好+忠实度+门控约束,逐轴归一化等权相加,转成组相对权重 $\tilde{r}_i$( Advantage 截断到 $[-1,1]$ 后映射到 $[0,1]$),训 150 epoch。第四步,Stage 2:审计 205 个失败案例,设计乱码文字与照片风格漂移两个探测器,以单边否决并入重训。第五步,Stage 3:用 LoRA 秩拼接精确实现两配方增量的等权平均。
技术新颖性
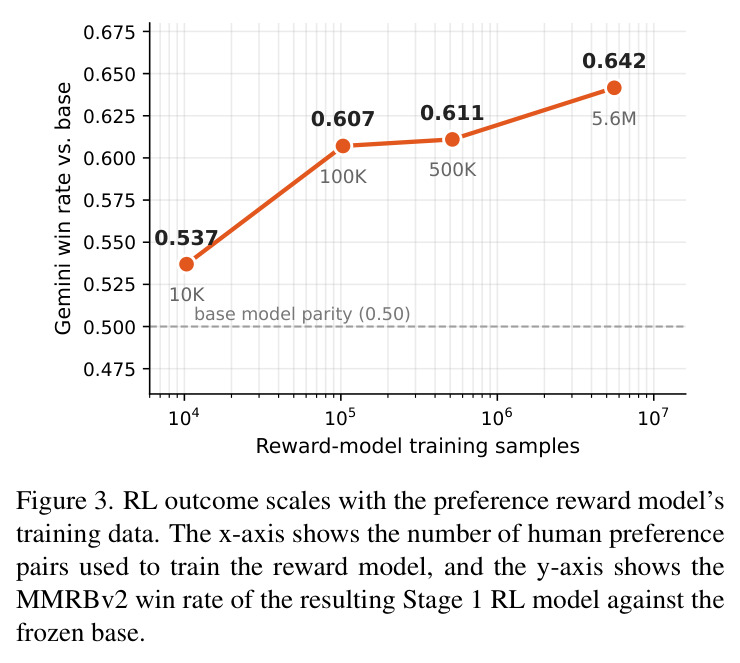
技术新颖性体现在四处。其一,把 GDPO 式的组奖励解耦归一化引入多轴 T2I RL,证明了对总奖励归一化改为逐轴归一化对训练稳定性的必要性。其二,单边否决的防黑客设计直接反驳了“加检测器就加奖励项”的常见做法:任何可优化的正奖励最终都会被策略利用,只有“违规则没收收益、合规无奖励”的非对称结构才不可被二次 hack,消融显示加性形式(0.5260)与否决形式(0.6346)相差近 11 个百分点。其三,意图门控把“约束是否适用”变成可由 LLM 离线判定的分类问题,并用 400 条人工标注验证(三分类一致率 77.8%,$\kappa = 0.66$;实际使用的 strict 二分类一致率 89.5%)。其四,跨配方模型汤:与经典 model soups 平均同一配方不同超参的检查点不同,这里平均的是两种不同奖励哲学(有无防黑客)训出的策略,且通过 LoRA 秩拼接精确等价于 $\Delta W$ 平均、不引入交叉项。此外 5.6M 级偏好数据对下游 RL 的 scaling 实验(Fig. 3)也是社区少见的大规模证据。
实验结果
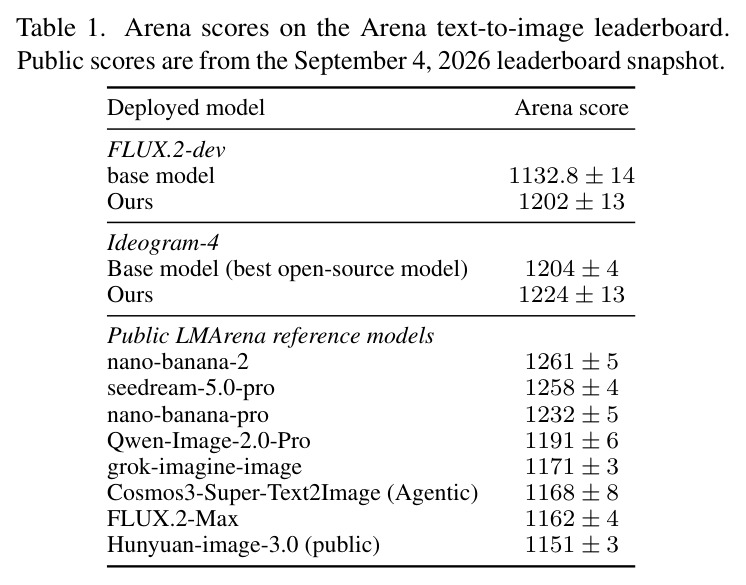
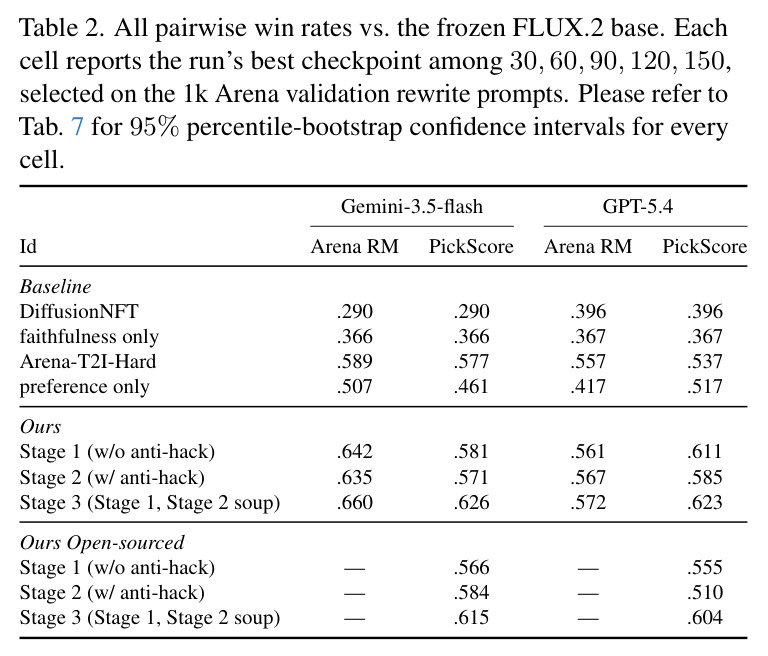
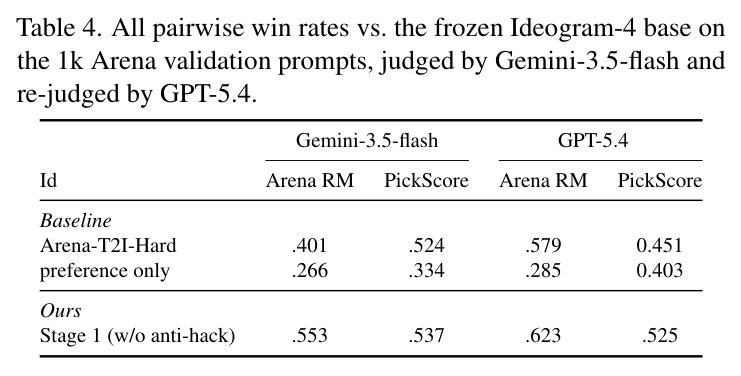
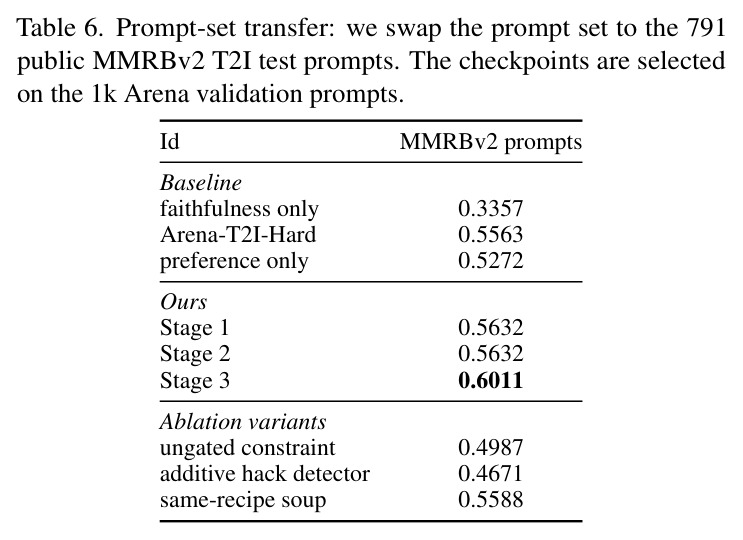
主实验(Table 2):FLUX.2-dev 对基座胜率,Stage 1 在 Gemini 判官下达 0.642/0.581(Arena RM/PickScore),基线 DiffusionNFT 仅 0.290、Arena-T2I-Hard 0.589、preference-only 0.507,门控约束贡献约 7pp;GPT-5.4 判官趋势一致;Stage 3 汤最佳 0.660/0.626。融合有效源于互补:两次运行 204 与 234 个失败提示仅 92 个重合,Stage 3 赢回父模型独有失败集的 0.560/0.397。Ideogram-4(Table 4)复现同序:preference-only 仅 0.266,加 OCR 奖励的 Stage 1 达 0.553。消融(Table 3):意图门控 0.6046→0.6416,否决对比加性 0.5260→0.6346,跨配方汤 0.6435→0.6598。RM 数据 scaling:10K 到 5.6M 投票对应 0.537→0.642。线上(Table 1):FLUX.2-dev 从 1132.8 升至 1202.1(+69.3 Elo),Ideogram-4 版达 1223.5 超越全部开源模型;外部 MMRBv2 上 Stage 3 达 0.6011。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LMArena 文生图排行榜(真人盲评,FLUX.2-dev 支线) | Elo | 1202.1(Stage 3 部署版) | 1132.8 ± 14(FLUX.2-dev 基座) | +69.3 Elo |
| LMArena 文生图排行榜(Ideogram-4 支线) | Elo | 1223.5 | 1204 ± 4(Ideogram-4 基座,原开源最佳) | +19.5 Elo,超越排行榜上所有开源模型 |
| 1k Arena 验证集对基座胜率(FLUX.2-dev,Gemini-3.5-flash 判官) | pairwise win rate | 0.660(Stage 3,Arena RM)/ 0.626(PickScore) | DiffusionNFT 0.290;Arena-T2I-Hard 0.589;preference-only 0.507 | 较 Arena-T2I-Hard +7.1 pp |
| 1k Arena 验证集(GPT-5.4 独立判官,跨判官泛化) | pairwise win rate | 0.572 / 0.623(Stage 3) | Arena-T2I-Hard 0.557 / 0.537 | +1.5 / +8.6 pp |
| Ideogram-4 对基座胜率(含分级 OCR 奖励,Gemini 判官) | pairwise win rate | 0.553(Stage 1,Arena RM) | preference-only 0.266;Arena-T2I-Hard 0.401 | 较 Arena-T2I-Hard +15.2 pp |
| 奖励模型训练数据 scaling(Fig. 3) | Stage 1 对基座胜率 | 0.642(5.6M 投票对) | 0.537(10K 投票对) | +10.5 pp,其中 10K→100K 增益最大(+7.0 pp) |
| 外部提示集迁移(791 条公开 MMRBv2 测试提示) | pairwise win rate | 0.6011(Stage 3) | Arena-T2I-Hard 0.5563;same-recipe soup 0.5588 | +4.5 pp,消融次序全部保持 |
局限与改进
作者明确承认四点:只在两个基座(FLUX.2-dev、Ideogram-4)上验证,无法判断结论能否推广到其他模型家族与规模;未在 agentic 工作流中评测,多步交互与工具调用可能带来新挑战;分解出的忠实度问题未经人工审核,LLM 分解可能出错或有歧义;受算力限制所有结果只跑单个随机种子。我的补充观察:其一,RL 循环内每步都要调用 VLM 判官回答数十道清单题,训练成本与吞吐开销可观,论文未报告 wall-clock 与 API 成本;其二,两个判官的数字差异不小(如 Stage 1 GPT-5.4/Arena RM 仅 0.561),提示 LLM-as-judge 本身的方差与偏差不容忽视;其三,探测器是反应式的——先观察到 hack 再手工设计探测器,面对新漏洞没有主动防御;其四,开源 1K 子集(0.615)几乎追平全量数据(0.626),虽降低复现门槛,但也暗示当量规奖励足够强时,5.6M 偏好数据的边际收益可能主要来自偏好轴本身而非全面优势。
独立分析的弱点
第一,判官依赖链过长:训练循环内依赖 Qwen3.6-27B 逐题作答,离线依赖 gemini-3.x 做分解、约束生成与意图标注,任何一环的系统性偏差都会被 RL 放大,改进方向是对清单与裁决做抽样人工校准,或训练本地小型判官降本。第二,防黑客机制是被动响应:只覆盖乱码文字与照片漂移两种已观测模式,探测器问题集手工固定,建议引入自动化失败挖掘闭环(周期性审计检查点、自动生成并验证候选探测器)。第三,意图门控虽是三分类但只使用 strict/非 strict 二值,neutral 提示(4,443 条,占比近半)完全没有约束信号,中间强度门控(如仅保留显式约束、去掉泛化 catch-all)未被探索。第四,评测在 1024² 分辨率与单 seed 下进行,LoRA 秩、rollout 数、$A_{\max}=5$ 等超参缺乏敏感性分析,至少应对一个配置做多种子方差估计。第五,权重汤依赖两次独立完整训练、成本翻倍,可探索单次训练内多配方交替采样后再融合。
未来方向
作者提出的方向包括:把配方推广到更多模型家族与规模、覆盖 agentic 多步工作流、对分解清单做人工审核。基于本文成果还能延伸:其一,RM 数据 10K 到 5.6M 的 scaling 曲线尚未饱和(Fig. 3 中 500K 到 5.6M 仍有增益),可继续扩大并拟合 scaling law 以预测最优数据预算;其二,把“单边否决”思想迁移到 LLM 后训练的 rubric 奖励体系;其三,自动化 hack 发现——用另一个模型持续对比当前策略与基座的行为漂移、自动合成探测器,形成对抗式防御循环;其四,探索超越等权平均的融合方式,如按验证集表现学习 soup 权重或 TIES-Merging 式冲突消解;其五,本文所有离线标注(意图、约束、忠实度问题)均为一次性生成,可改为在线更新以适应策略演化后的新失败模式;其六,“1K 子集近乎追平全量”这一发现本身值得研究:量规奖励是否正在替代大规模偏好数据的作用。
复现评估
复现友好度中上。作者开源 Arena-T2I-Training 1K 子集,并用公开的 PickScore 作偏好奖励重训 Stage 1/2:Gemini 判官胜率 0.566/0.615,接近全量数据的 0.581/0.626,外部研究者用 PickScore + 1K 数据即可逼近论文主干结果。但有几处门槛:5.6M 投票训练的 Arena RM 不公开,最佳成绩依赖它;算力不小——FLUX.2-dev 用 32 GPU、Ideogram-4 用 64 GPU 训 150 epoch;流水线串联多个商用模型(gemini-3.x 做分解、标注、重写,GPT-5.4 做交叉判官),API 费用需自理;Ideogram-4 闭源,第三方无法复现该支线,但 FLUX.2-dev 开源可跑。附录给出完整超参、判官 prompt、探测器原文与 bootstrap 置信区间,细节披露在同类论文中属较高水平。综合估计:有 8 卡 A100 级资源与工程经验的团队可在数天内复现 1K 子集路线,全量结果难以完整复现。
论文图表
分别只用 Arena RM 或 PickScore 训练,在 30–150 各检查点上对比基座的整体、忠实度、美学三维胜率:整体维度 Arena RM 最佳仅 0.5065、PickScore 一直低于 0.5;忠实度维度两者均跌破 50% 且随训练持续恶化;美学维度 Arena RM 却持平或更高,呈现“美学换忠实度”的此消彼长。
它是论文出发点“单一偏好奖励必然牺牲提示忠实度”的直接实验证据,为引入量规奖励提供了必要性论证。
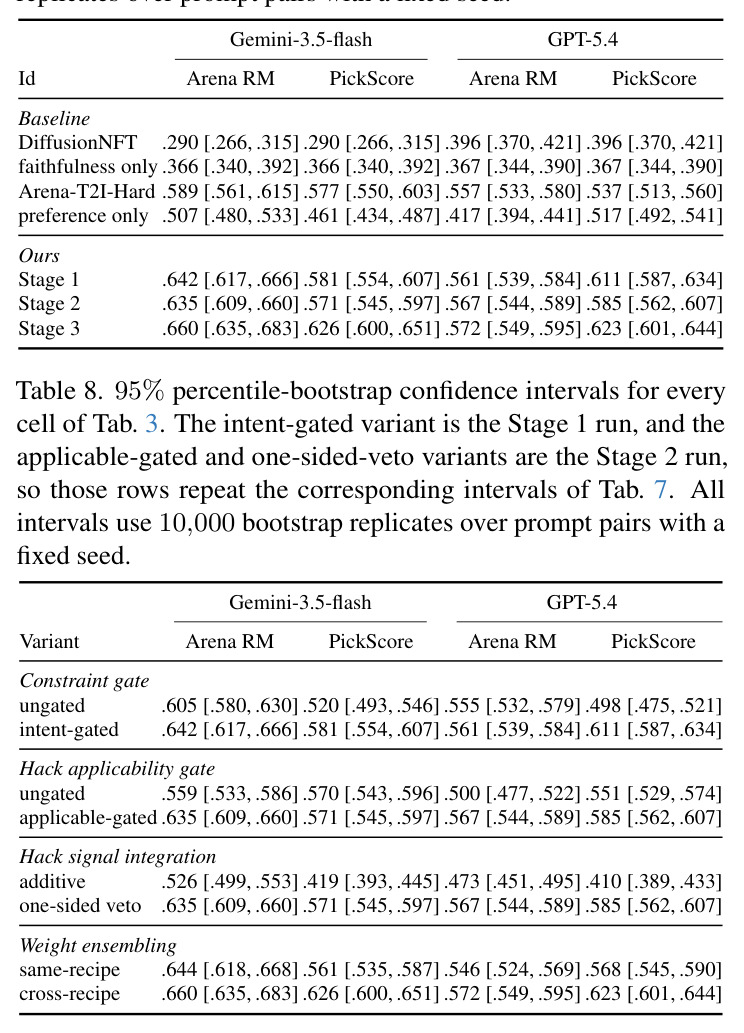
为 Table 3 每个消融胜率给出同样的 95% bootstrap 置信区间,如否决式 0.635 [.609, .660] 对加性式 0.526 [.499, .553]、跨配方汤 0.660 [.635, .683] 对同配方汤 0.644 [.618, .668],关键对比的区间均明显分离。
它确认了消融结论(尤其是否决机制与跨配方汤的优势)不是抽样噪声,强化了机制层面的主张。