Skill2Real:面向零样本 Sim-to-Real 机器人操作的智能体技能学习 Skill2Real: Agentic Skill Learning for Zero-Shot Sim-to-Real Robot Manipulation
仿真中用三智能体验证两级技能库,冻结后经共享代码接口零样本迁移到真实机械臂
前置知识
零样本 Sim-to-Real 迁移
在仿真器中训练机器人策略,然后不经任何真实世界任务训练或微调,直接部署到物理机器人上。核心难点是“现实差距”:仿真与真实在光照、材质外观、接触动力学、机器人本体等维度的差异,会使仿真中学到的行为在现实中失效。传统应对手段包括域随机化、系统辨识以及在真实数据上微调策略。
本文的最终目标就是零样本迁移:所有技能只在 LIBERO-90 和 Robosuite 仿真中学得,冻结后直接在真实 UR5e 上执行,理解这一设定才能体会“冻结技能库而非调参数”设计的意义。
域随机化与非对称(特权)学习
域随机化在仿真中随机化光照、纹理、物体形状等属性,迫使策略学到对域变化不变的特征;非对称 actor-critic 让评论家访问仿真器特权状态(如物体真值位姿)辅助训练,而行动者只用真实可得的观测执行。两者的学习预算常被耗在与任务无关的底层表征建模上。
Skill2Real 的 Proposer-Verifier-Governor 结构是特权思想在智能体框架下的推广:Verifier 独享特权仿真证据做诊断,但其反馈被约束为公共可表达,保证特权信息只用于训练、绝不进入部署策略。
代码即策略(Code as Policies)
用大语言模型直接生成可执行程序(调用感知、规划与控制 API)作为机器人策略,而非输出网络的连续动作。优点是可组合、可解释、能复用成熟软件接口,代表工作有 Code as Policies 与 ProgPrompt;局限是通常只能组装人工预定义的原语,缺少从执行经验中改进技能本身的能力。
本文延续代码策略范式但更进一步:技能以“自然语言指导 + API 代码模板 + 结构化状态描述”的形式从经验中自动习得、验证并写入库;共享 API 契约正是程序能跨仿真/现实复用的关键载体。
视觉-语言基础模型(VLM)
在海量图文数据上预训练、可对图像做语言推理的大模型(如 GPT、Claude 系列)。它们具备零样本跨域视觉理解能力:对仿真渲染图和真实照片都能进行物体识别、空间关系推理与代码生成,无需针对目标域微调。
Skill2Real 把 sim-to-real 的桥接重任交给 VLM 的跨域 grounding 能力:策略的执行核心是一个冻结 VLM(Proposer),同一模型直接消化仿真和真实的 RGB-D 观测;实验还横跨 GPT-6 Astra、GPT-5.6 Sol、Claude Opus 多个模型验证学习增益与基座正交。
分层技能学习与技能库
把长时程任务分解为可复用的子技能并在其上做任务级组合,是分层强化学习(Options、MAXQ、HIRO)的核心思想。近期工作将其落为“技能库”形态:以程序、语言描述或潜变量存储技能,供任务层检索与组合,以提升长时程操作的成功率与泛化能力。
本文的两级层次直接借用“小脑(Cerebellum,局部操作技能)—大脑(Brain,任务级组合与恢复)”分工,并通过“Stage II 冻结小脑库”的顺序训练显式构造层级依赖,是读懂 C1-C3、B1-B4 训练曲线设计的钥匙。
研究动机
零样本 sim-to-real 操作的核心矛盾是:仿真提供了可扩展的经验来源,但外观、动力学、接触与本体差异使仿真策略难以在真实机器人上可靠运行。传统路线把学习预算大量花在与任务无关的底层表征上——外观主导的域随机化在建模光照、纹理变化上消耗容量,非对称 actor-critic 用特权状态训练的也是低层表征——真正可复用的任务级知识反而学得少。对长时程操作问题更严重:机器人不仅要可靠执行局部抓放等技能,还要把它们组合成任务级行为,并在中间步骤失败时恢复;现有代码生成方法(Code as Policies 等)只能组装人工给定的原语,不从执行经验中习得新技能;代表性技能库系统(LRRL、ASPIRE 等)依赖人类引导或真实世界执行反馈,难以规模化。基线数字很说明问题:不带任何习得技能的强 VLM 在未见过的 LIBERO-Pro Long 上,GPT-6 Astra 的 Overall 成功率只有 2.0%,Opus 5 只有 0.5%——纯靠基础模型通用推理,长时程操作几乎不可用。
本文的目标是本文目标是构建一个智能体策略框架,在仿真中自动习得“经过验证、可复用、可组合”的任务级知识,并以冻结知识(而非模型参数)的形式零样本迁移到真实机器人。具体拆成三点:(1) 设计共享代码策略接口,使同一套技能程序在仿真和现实有共同语义的执行形式,把“学什么”与“在哪执行”解耦;(2) 设计非对称的 Proposer-Verifier-Governor 多智能体循环,让特权仿真证据最大化转化为训练监督,同时绝不泄漏进部署策略;(3) 构造两级技能层次——Cerebellum 学可复用的局部操作技能,Brain 在小脑库冻结后学长时程任务程序与失败恢复——并验证知识在跨任务套件、跨 Proposer 模型、跨仿真/现实三个维度的迁移能力,例如把 LIBERO-Pro Long 上 Astra 的成功率从 2.0% 提到 56.3%,真实 UR5e 平均完成率从 27.50% 提到 78.75%。
与已有工作不同的是,本文的独特切入是重新定义 sim-to-real 迁移的“单位”:不是迁移网络参数或表征,而是迁移以公共 API 语义表达的可执行任务知识。核心分离原则是:监督技能学习所需的信息(仿真器特权状态、成功判定)与执行已学技能所需的信息(公开观测 + 文档化 API)彻底解耦——Verifier 可看特权证据做诊断,但必须把诊断翻译成 $f \in \mathcal{F}_{pub}$(仅用公共观测和 API 语义可表达的反馈);Governor 只依据验证 rollout 的实证证据 $e_\delta$ 准入更新。这样特权信息成为纯训练期资产。与 Zetta 围绕冻结基础策略演化运行时 harness 不同,本文是完整多智能体系统在学习两级技能层次;与既有技能库系统依赖人类或真实反馈不同,本文靠 VLM 跨域 grounding 加仿真内验证闭环,把学习预算全部集中在任务级可复用知识上。
核心方法
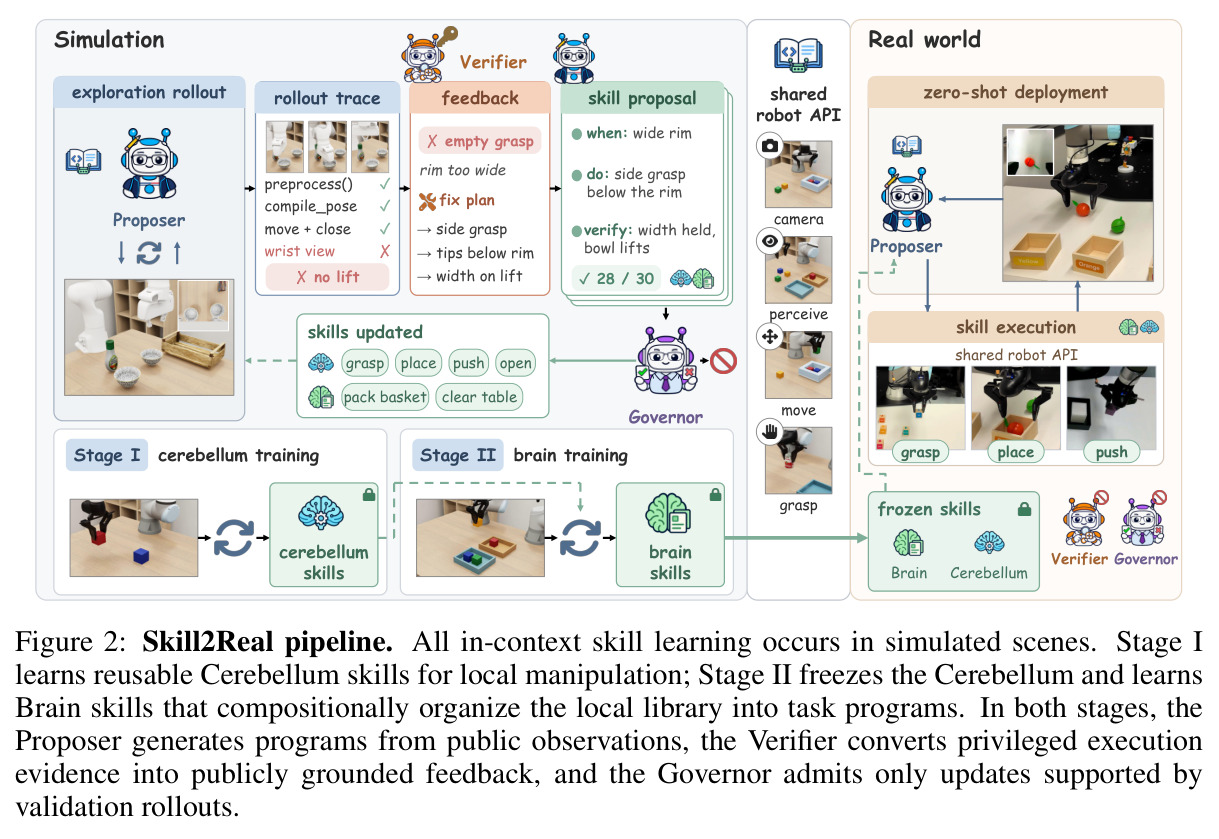
直觉上,作者想让“机器人技能”像软件库:写成对公共 API 契约的程序,由仿真还是真实后端执行无所谓,语义一致即可复用。技术分三块。(1) 共享代码策略接口:仿真环境 $E^{sim}$ 与真实环境 $E^{real}$ 共享 18 个文档化操作的契约 $\mathcal{A} = \{a_k\}_{k=1}^{K}$(图像获取、SAM 分割、几何测量、位姿编译、运动命令等),策略只经接口推理,各后端自实现感知、标定与底层控制——接口即迁移边界。(2) PVG 循环:Proposer(VLM)依 $c_t \sim \pi_M(c \mid g, o_{\leq t}, \mathcal{D}_\mathcal{A}, S_{cer}, S_{brain})$ 采样程序并执行;确定性评估器给出 $e = E_{exec}(\tau, x^{priv}_{0:T})$;Verifier 转成公共反馈 $f$;Proposer 据此起草候选更新 $\delta$;Governor 检查验证证据 $e_\delta$(25 个独立种子 rollout 的完成、失败与回归)后准入。(3) 两阶段训练:Stage I 学小脑库,Stage II 冻结小脑后学大脑库;部署只留 Proposer、接口与冻结记忆。
核心创新是“非对称信息访问 + 验证准入”的技能学习机制,与已有方法的本质区别有三。第一,对比域随机化/非对称 actor-critic:它们把特权信息用于训练神经表征,迁移的仍是参数;本文特权信息只用于生成公共可表达的反馈($f \in \mathcal{F}_{pub}$),迁移的是程序化知识,因此同一知识库可换 Proposer 模型、换物理后端复用。第二,对比 Code as Policies 类方法:它们组装人工预定义原语;本文技能从失败与成功经验中归纳、经 Verifier 诊断、由 Governor 用验证 rollout 筛选后写入库,并附适用条件、预期效果与失败边界。第三,层次结构靠顺序依赖显式构造:$S^*_{cer} = \text{TrainStage}(\mathcal{Q}_{cer}, \varnothing)$,$S^*_{brain} = \text{TrainStage}(\mathcal{Q}_{brain}, S^*_{cer})$,大脑学习以冻结小脑为只读上下文,只能学组合、排序、重绑定与恢复,不能改写局部技能,保证两级知识职责清晰且互补增强。
方法步骤详情
流程四步。第一步 Stage I(Cerebellum):从空记忆开始,在 $\mathcal{Q}_{cer}$ 任务上跑 PVG 循环——Proposer 执行局部操作任务(抓取、放置、开抽屉),每任务 5 个种子 rollout;Verifier 定位第一个失败转移并译成公共反馈(如“夹爪闭合完成不等于物体被保持住”);Proposer 把反馈凝练成候选技能(自然语言指导 + API 代码模板 + 紧凑状态描述);每候选用 25 个独立种子验证 rollout 生成 $e_\delta$,Governor 综合证据后准入或拒绝。共 3 轮(C1-C3)。第二步 Stage II(Brain):冻结 C3 小脑作只读上下文,同流程在 $\mathcal{Q}_{brain}$ 上学任务级技能(目标排序、实体重绑定、进度保留、恢复策略),4 轮(B1-B4);LIBERO-90 每迭代 450 episodes、共 3,150 个。第三步冻结评测:Proposer 仅凭公开观测与 API 文档在 LIBERO-Pro Long(20 任务 x 10 种子)评测。第四步零样本真机部署:UR5e 后端实现同一 18 操作 API(RealSense RGB-D、手眼标定、ROS 控制),无示范、无微调、无在线更新,直接执行 R1-R4。
技术新颖性
技术新颖性有四点。(1) 迁移边界的工程化定义:18 个操作的 API 契约明确排除仿真器对象句柄、真值位姿、隐藏场景结构与成功谓词,连深度都必须由标定双目立体视觉重建而非读取深度缓冲——把“什么算公共信息”变成可检查的契约而非口头约定。(2) Verifier 的公共性约束:诊断可动用特权证据,但输出必须落在 $\mathcal{F}_{pub}$ 内,且要给出“下一步可用公共观测完成的判别性测试”,这是非对称 actor-critic 思想在 LLM 智能体语境下的重构。(3) Governor 的实证准入:候选更新不因单次成功即入库,需 25 个验证 rollout 支持其声称的改进且无回归;附录 D 的碗-托盘案例中 4 个候选只准入 1 个,层级越界(把小脑级接触规则写进大脑)与未实现未测试的条款都被拒收。(4) 两级顺序依赖(公式 3)把“技能习得”与“技能组合”变成可分别度量、可分别消融的两个阶段;消融显示去掉 Verifier/Governor 分别损失 17.25 与 13.25 个百分点,证明该机制并非工程点缀。
实验结果
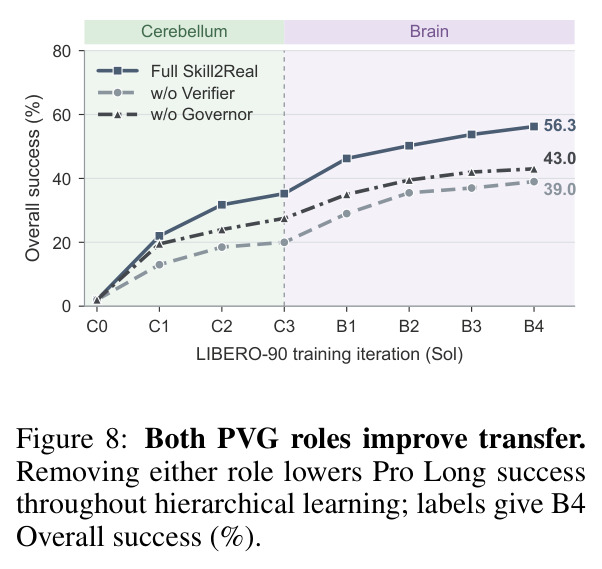
证据链覆盖四层面。(1) 两级层次贡献:LIBERO-90 训练向未见 LIBERO-Pro Long 迁移(20 任务 x 10 种子),Astra Overall 从无技能 2.0% 升至 C3 小脑 35.3%、B4 完整层次 56.3%;Opus 5 从 0.5% 到 29.3% 再到 49.0%,证明技能跨 Proposer 迁移。B4 时 Task/Pos 为 76.0%/36.5%(Astra)与 66.5%/31.5%(Opus),位置变化仍是短板。Robosuite 七任务独立训练:Sol 均值 16.6%→45.6%→85.1%,Opus 19.4%→49.6%→89.4%,Brain 阶段 +39.6/+39.9 点且七任务全部提升,螺母装配 +62/+50 点、双臂传递 +52/+60 点。(2) 真实迁移:UR5e 四任务各 20 次试验,完整层次均值 78.75%(R1 95、R2 85、R3 85、R4 50),对比无技能 27.50%、仅小脑 56.25%、仅大脑 37.50%;只有完整层次能完成抽屉任务。(3) 横向比较:固定 Sol 的 C3/B3 库,Astra 上 Overall 55.3%、Task 75.0% 均最佳(Zetta 51.5%/63.0%,ASPIRE 30.5%),但 Pos 上 Zetta 以 40.0% 领先本文 35.5%。(4) 消融:去 Verifier 掉至 39.0%(-17.25 点),去 Governor 掉至 43.0%(-13.25 点);源域 Sol 14.2%→38.2%→62.0%,Opus 18.7%→43.8%→73.3%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO-90 → LIBERO-Pro Long 迁移(GPT-6 Astra 评测,Overall) | 任务成功率 (%) | 56.3(B4 完整层次) | 2.0(C0 无技能);35.3(仅 Cerebellum C3) | +54.3 个百分点 |
| LIBERO-90 → LIBERO-Pro Long 迁移(Opus 5 评测,Overall) | 任务成功率 (%) | 49.0(B4) | 0.5(C0);29.3(C3) | +48.5 个百分点 |
| LIBERO-Pro Long 指令扰动(Task)横向对比(固定 C3/B3 库) | 成功率 (%) | 75.0(Astra) | Zetta 63.0;CaP-Agent0 38.3;ASPIRE 30.5 | 较最强基线 +12.0 个百分点 |
| Robosuite 七任务均值(Opus 5 从零独立训练) | 平均成功率 (%) | 89.4(B4) | 19.4(C0);49.6(C3) | +70.0 个百分点,Brain 阶段再 +39.9 |
| 真实 UR5e 四任务 R1-R4(各 20 次试验) | 平均任务完成率 (%) | 78.75(完整层次) | 27.50(无技能);56.25(仅小脑);11.25(CaP-Agent0) | 较无技能 +51.25 个百分点 |
| PVG 角色消融(Pro Long Overall,B4) | 成功率 (%) | 56.25(完整 PVG) | 39.0(去 Verifier);43.0(去 Governor) | 两角色分别贡献 17.25 / 13.25 个百分点 |
局限与改进
作者承认的局限:(1) 成功率是固定库的记录评测点估计,未重复独立训练,不反映训练随机性;(2) 曲线按训练迭代而非累计 rollout 成本索引,阶段比较混淆“更多训练”与“更高层次”,未在匹配预算下隔离层次贡献;(3) LIBERO 本身基于 Robosuite,该实验不构成跨物理引擎迁移;(4) 当前是纯 code-as-policy 接口,VLM 推理延迟限制闭环速度。我的补充观察:(5) 位置扰动明显弱于指令扰动(Astra 36.5% 对 76.0%),窄空间抓放(bowl-in-drawer 仅 20.0%,Zetta 的端到端 VLA 达 75.0%)暴露代码接口反应式控制粒度不足;(6) 真实评测仅单台 UR5e、4 任务、各 20 次试验,R4 仅 50%,未覆盖柔性物体、动态干扰与人机共享场景;(7) 依赖顶级商业 VLM(GPT-6 Astra、Claude Opus 5),每候选 25 个验证 rollout 的调用与仿真成本可观,效果与 VLM 版本强耦合;(8) API 不承诺对象保持静止,方法隐含静态或准静态场景假设。
独立分析的弱点
独立分析四个弱点。其一,窄空间与位置泛化弱:Pos 下 bowl-in-drawer 仅 20.0%、mug-in-microwave 15.0%,被 Zetta 的闭环 VLA 反超,根因是代码接口下感知-动作回路较粗(先测量、再编译位姿、再执行);改进方向是按作者设想把端到端策略封装成 API 内可调用工具,形成代码层规划 + 神经层反应的混合接口。其二,验证准入成本高:每候选 25 个验证 rollout、每迭代全任务重跑,LIBERO-90 共 3,150 个 episodes 外加大量 LLM 调用;可引入序贯检验(early-stopping 统计测试)或按历史准入率做优先级采样削减预算。其三,技能库无冲突管理与回归测试:Governor 逐条准入但不做全局回归与版本管理,库增大后条款可能冲突,论文也未报告最终库规模与检索方式;可加准入后全任务回归套件与知识去重。其四,真实评测面窄且定性:光照/桌布变化(附录 A.2)只给定性记录不进表;建议补充多物体堆叠、柔性物、动态干扰任务并报告置信区间;跨具身(换夹爪/臂型)理论上被后端抽象支持但未实测。
未来方向
作者在结论中提出两个方向:把端到端策略作为可调用工具暴露进当前纯 code-as-policy 接口,以及降低 VLM 推理延迟以支持更快的闭环执行。基于成果可自然延伸:(1) 跨物理引擎与跨具身迁移——目前 Robosuite 实验未离开同一仿真栈,可在 Isaac/MuJoCo 与不同机器人上检验 API 语义兼容假设的边界;(2) 技能库的终身演化——库当前完全冻结,可在部署后受控积累,用人工确认或视觉语言批评模型充当真实世界 Verifier,做带准入门槛的在线更新;(3) Governor 的形式化——把准入决策变成带统计功效分析的假设检验或贝叶斯 bandit,自动决定验证 rollout 数量并控制入库错误率;(4) 层次边界的自动协商——当前层级越界靠 Governor 人工规则审查(附录 D 案例),可让小脑在能力缺口出现时主动申请扩容并触发 Stage I 增量重训;(5) 与 VLA 的互补融合——结果已呈 Task 强/Pos 弱的互补格局,混合架构(VLA 做局部反应控制、本文层次做任务编排与恢复)是明确的工程方向。
复现评估
复现评估:项目页 skill2real.github.io,附录质量极高——附录 C 完整给出 18 个 API 操作的公共契约(Table C.1/C.2),附录 E 给出小脑/大脑技能模板实例,附录 F 给出六个角色的完整提示词,附录 G 给出训练伪代码 Algorithm 1,附录 D 复盘真实准入案例,方法层面接近白盒。硬性依赖是顶级商业 VLM(GPT-5.6 Sol、GPT-6 Astra、Claude Opus 5/4.6,推理 effort 为 medium),API 费用不菲且模型版本更迭会改变结果;算力上无 GPU 训练需求(不训练神经网络),主要是仿真 rollout 时间(LIBERO-90 共 3,150 个训练 episodes,另每候选 25 个验证 rollout)与 LLM 调用成本。真机需 UR5e + Pika 夹爪 + RealSense D435/D405 + ROS Noetic 及手眼标定;仿真用 LIBERO/Robosuite 可低成本起步。未见明确代码开源声明,若闭源需按附录重建契约与提示词,工作量中等偏大。综合难度:仿真复现中等,完整真机复现需要机器人工程经验。
论文图表
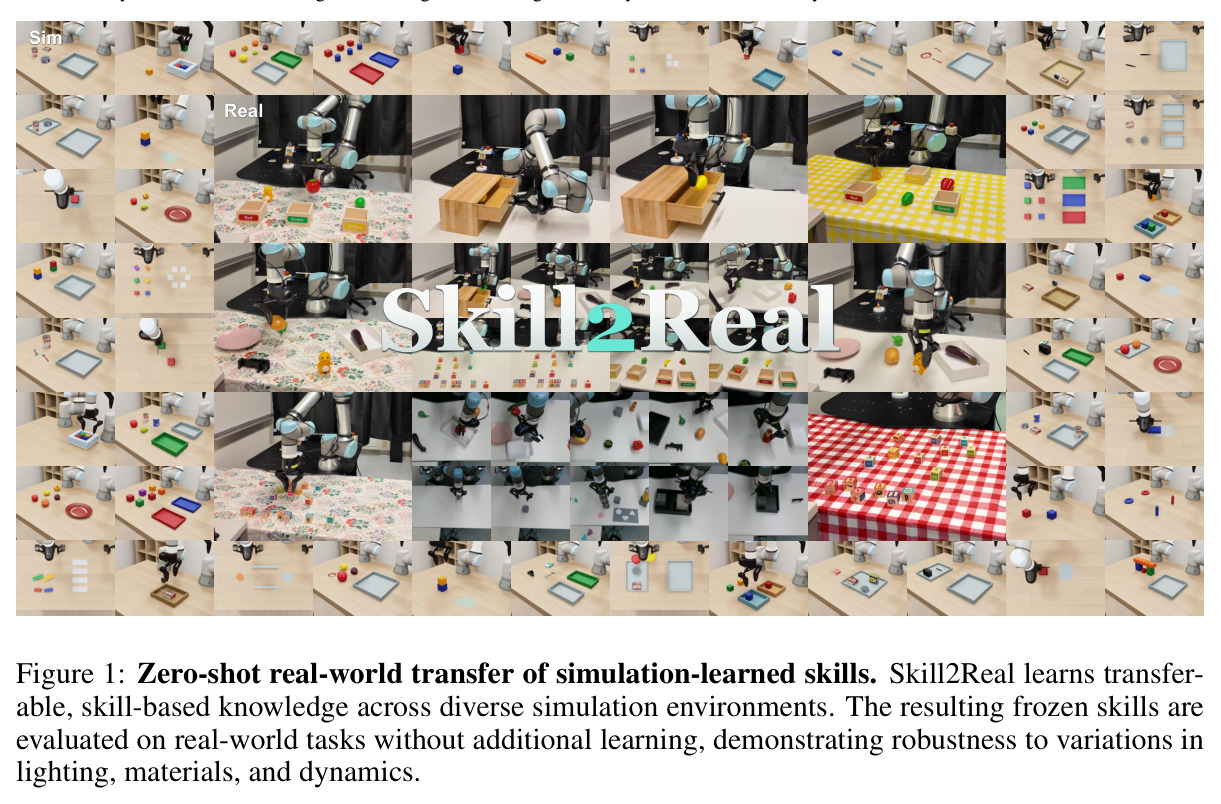
顶部并列展示仿真(Sim)与真实(Real)两组场景照片:Skill2Real 在多样仿真环境中学习可迁移的技能知识,得到的冻结技能在真实世界任务上不加任何额外学习直接评测,并对光照、材质与动力学变化保持鲁棒。
一图点题:迁移的单位是仿真中学到的技能知识而非模型参数,零样本真机执行是全文的核心主张,先看这张图能建立对问题设定的正确预期。
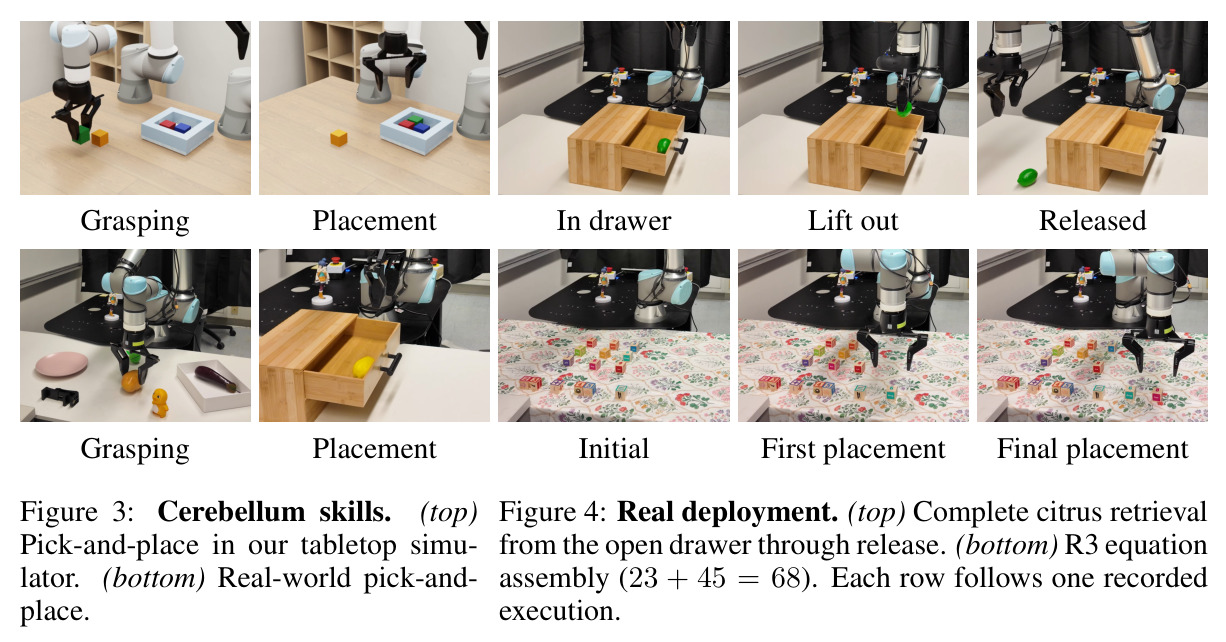
上排记录完整的真实柑橘取回任务:从打开的抽屉中抓取、取出到释放;下排记录 R3 方程装配任务(23+45=68)的初始状态、第一次放置与最终放置,每个任务一行连续执行帧。
展示冻结层次在真机上的长时程行为:既有小脑级的局部抓取,也有大脑级的任务编排(先取抽屉中物体再释放、按顺序摆放答案方块),对应真实 UR5e 评测的定性证据。
两条学习曲线面板:(a) LIBERO-90 训练的各冻结检查点(C0-C3 小脑、B1-B4 大脑)迁移到未见过的 LIBERO-Pro Long 的成功率——Astra 从 2.0% 升至 56.3%,Opus 5 从 0.5% 升至 49.0%;(b) Robosuite 独立训练库的成功率——Sol 达 85.1%,Opus 达 89.4%。两阶段(小脑/大脑)背景分区标注,所有评测库均冻结。
最重要的定量结果图:清晰展示小脑与大脑两阶段的互补增益,且增益在 Astra、Sol、Opus 三个基座模型上一致出现,支撑“学习增益与底层 VLM 正交”的关键论断。
与 CaP-Agent0(CaP-X)、ASPIRE、Zetta、π0、π0.5 在 LIBERO-Pro Long 上的柱状对比:Skill2Real(Astra + 固定 Sol C3/B3 库)Overall 55.3%、Task 75.0% 均为最高;Zetta 在位置扰动 Pos 上以 40.0% 领先 Skill2Real 的 35.5%;Opus 4.6 版本 Overall 35.3%,高于 ASPIRE 的 30.5%。
定位本文在当前 agentic/VLA 方法谱系中的位置:优势与短板(窄空间位置扰动)同时可见,是评价其真实贡献边界的核心对比实验。
Sol 与 Opus 独立训练库在 LIBERO-90 源任务套件本身的学习曲线(每迭代 450 个保留初始状态评测):Sol 从 14.2% 经 38.2%(C3)到 62.0%(B4);Opus 从 18.7% 经 43.8% 到 73.3%,大脑阶段在 C3 小脑冻结时再加 23.8/29.6 个百分点。
补充源域(非迁移)的学习动态,与 Figure 6(a) 的迁移曲线互为印证:技能既提升源任务性能也提升迁移性能,说明学到的是可复用知识而非过拟合。
按六个任务族(铰接存储、堆叠、炉灶操作、caddy 收纳、篮/托盘收纳、表面放置)分别画学习曲线,各用自己的归一化满分与纵轴。显示大脑阶段在 caddy 收纳、篮/托盘收纳、表面放置上的增益大于堆叠:Opus 的 caddy 收纳从 C3 的 56.7% 升到 B4 的 100.0%,而堆叠停在 40.0%。
揭示平均数字背后的结构性差异:不同操作类型从两级层次中的受益不均,帮助读者判断该方法适用于哪类操作,避免被单一总分误导。
七个 Robosuite 任务(立方体举起/堆叠/再堆叠、螺母装配、擦拭泼洒、双臂举起、双臂传递)的共享纵轴学习曲线。从 C3 到 B4:螺母装配 Sol/Opus 分别 +62/+50 点,双臂举起 +48/+46 点,双臂传递 +52/+60 点;B4 时 Opus 在五项任务领先,Sol 在立方体举起(98% 对 95%)与擦拭(100% 对 99%)更高。
展示方法在双臂与装配类操作上的扩展性——这是长时程操作中最难的类别之一,逐任务数字支撑“Brain 阶段改善全部七个任务”的声明。
三种训练变体(完整、去 Verifier、去 Governor)在 LIBERO-90 源套件上的学习动态:三者同从 C0 的 14.2% 起步,完整版每个迭代后都最高,B4 达 62.0%,去 Verifier 为 38.0%、去 Governor 为 40.0%;去 Governor 的变体从 B2 起停滞在约 40%。
与 Figure 8 形成源域/迁移域双重验证:去掉任一角色在源任务上损失更大(24.0/22.0 点),说明两个角色影响的是技能习得本身而非仅迁移表现。
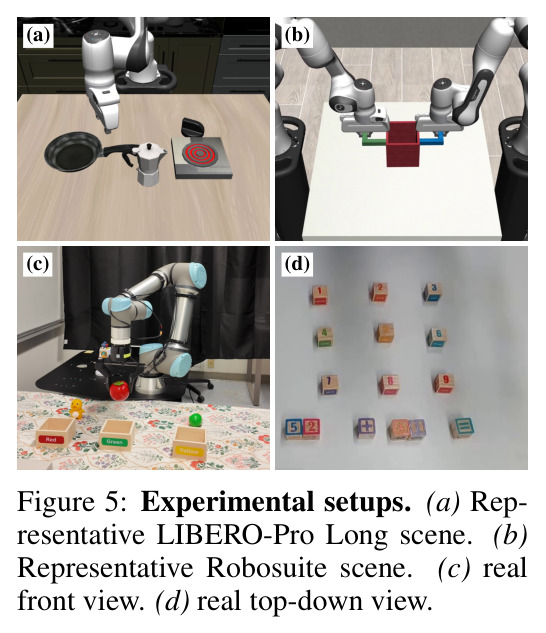
四个真实任务的代表场景:(a) R1 抓取物体放置到盘子;(b) R2 按颜色分拣物体到带色标签的盒子;(c) R3 用答案方块摆出 23+45=68;(d) R4 抽屉操作。
给出 R1-R4 四个任务的直观定义,读 Table 1 的真实机器人数字前需要知道每个任务的完成条件,否则无法判断 78.75% 意味着什么难度。
真实部署的桌布与光照变化记录:(a) 白色桌面;(b) 花布桌面(同一土豆放盘操作任务完成);(c) 红色格纹布(三个物体分拣全部入盒);(d) 昏暗侧光下执行两次答案方块抓放。所有图像保留原始曝光,属定性证据。
支撑零样本迁移对域变化的鲁棒性声明:冻结技能在训练时未见过的外观与光照条件下仍能完成任务,是“知识级迁移”最直观的视觉证据。
真实 UR5e 四任务完成率:CaP-Agent0 均值 11.25%;Astra 无习得技能 27.50%(R4 为 0);仅大脑 37.50%;仅小脑 56.25%;完整 Skill2Real 78.75%(R1 95、R2 85、R3 85、R4 50)。加大脑后 R1-R3 分别提升 15、5、20 个百分点,且唯一能完成抽屉任务(50%)。
全文最关键的真机结果表:用同一 Proposer(Astra)与同一接口的受控对比,逐一隔离小脑、大脑两个记忆层的贡献,直接支撑“层次化知识在真实世界有效”的核心结论。
定义 R1-R4 四个真实任务的指令模板与完成条件:R1 把指定物体放入指定容器;R2 按颜色或语义类别分拣;R3 移动方块组成所求等式且顺序正确;R4 打开目标抽屉、放入指定物体、关闭抽屉。
真实评测的判分标准来源:完成条件决定 Table 1 中每次试验成败的判定口径,是复现真机实验与理解结果必备的定义表。
LIBERO-90 六个分析用任务族及其操作范围与归一化满分:铰接存储 95、堆叠 20、炉灶操作 40、caddy 收纳 60、篮/托盘收纳 85、表面放置 150,六个分母合计 450。
理解 Figure B.2 分族分析的口径:不同族满分不同、按套件级平均而非族等权,是正确解读分族增益数字的前提。
固定 C3/B3 库在十个 Pro Long 任务上位置扰动的逐任务成功率:Skill2Real+Astra 均值 35.5%,Opus 4.6 为 24.0%,ASPIRE 22.6%,Zetta 40.0%。亮点如炉灶+摩卡壶 100.0%,短板如碗入抽屉 20.0%(Zetta 75.0%)、双摩卡 5.0%、汤+奶油奶酪 0.0%。
暴露方法真实短板的粒度:位置扰动下窄空间抓放被端到端 VLA 明显反超,逐任务数字是评估适用边界、改进方向的关键依据。
指令扰动设置的逐任务成功率:Skill2Real+Astra 均值 75.0%(十项中五项 90% 以上、三项 100%),Opus 4.6 为 46.5%,ASPIRE 38.3%,Zetta 63.0%。同任务跨设置波动大:汤+番茄酱 Pos 80.0% 而 Task 仅 30.0%。
与 Table B.2 对照呈现 Pos-Task 不对称性:指令改写时层次化可复用知识优势显著,位置变化时反应式控制更重要,这一对比是理解本文能力模型的核心。
18 个共享 API 操作中 8 个感知类操作的公共语义:场景/俯视/腕部图像获取、标定双目立体视图、立体度量深度、SAM 框选分割、可见几何测量(3D 中心、包围盒、主轴、置信度)、候选观测发现。强调它们提供证据而非保证操作结果。
定义“公共信息”的具体边界:感知操作明确排除仿真器深度缓冲与真值位姿,深度须由立体视觉重建,这是迁移边界契约可执行化的核心证据。
10 个状态、编译与控制类操作:preprocess 刷新观测、查询前序公共状态(含保持物体几何)、由抓取中心与闭合轴编译工具位姿、放置模式编译携带/释放/撤退位姿、末端位姿查询、回home、goto_pose、gripper_goto、双臂同步 goto_pose_both。
展示技能代码可调用的全部执行原语:位姿编译与运动命令的语义在仿真与真实后端一致,是程序级知识可跨域复用的工程基础。
记录一次碗-托盘转移中 Governor 对 4 个候选更新的裁决:相对参照物规则被准入(程序实现了该规则且写明何时需重新考虑);接触绑定、目标几何、进度检查三条被拒——分别因属于冻结小脑的层级越界、超出大脑允许的局部放置程序、包含未实现未测试的同动检测条款。
Governor 准入机制唯一的过程性案例:展示“层级边界审查 + 证据一致性审查”如何实际过滤技能入库,是理解记忆质量控制的关键材料。
训练伪代码:TrainStage(Q, C) 从空记忆出发循环——采样任务 q,Proposer 生成 rollout τ,确定性评估器产出 e=E_exec(τ, x_priv_0:T),Verifier 返回公共反馈 f 并要求 f∈F_pub,Proposer 在新上下文凝练候选 δ,收集验证证据 e_δ,Governor 裁决 accept/reject,接受则更新记忆;Stage I 得 S*_cer=TrainStage(Q_cer, ∅),Stage II 得 S*_brain=TrainStage(Q_brain, S*_cer)。
方法的精确形式化:把信息流约束(f∈F_pub)、验证准入(基于 e_δ 而非单次成功)与两级顺序依赖压缩在 19 行内,是复现训练流程的最小完备规范。